
営業企画やマーケティング担当者にとって、競合他社の動きを継続的に監視し、自社の営業チームへ有効な情報として配信することは重要な役割です。しかし、ウェブサイトの変更、新しいコンテンツの公開、検索順位の変動など、追うべき情報は多岐にわたるため、手作業での収集と分析には限界があります。
現在、この課題を解決するために多くの競合調査AIが提供されています。本記事では、競合情報の収集から営業向けバトルカードの作成までを担うCrayon、Klue、Kompyteの3製品に加え、ウェブ上のデジタル推定指標を比較するSimilarwebとSemrush、そして特定ページの変更検知に特化したVisualpingの合計6製品を比較します。
競合調査AIを比較選定する際は、ツールが収集したウェブ上の観測事実、アルゴリズムによって算出されたトラフィックなどの推定指標、そしてそれらを自社の文脈に当てはめた社内解釈を、明確に分離して扱うことが求められます。情報源や取得日を追跡可能な状態で維持し、推測を事実と混同させない設計がツール選びの基準となります。
導入を成功させるためには、カタログスペックでの機能比較にとどまらず、実際の運用を想定した検証が不可欠です。記事の後半では、実際の競合3社を対象に30日間の監視テストを行い、自社に必要なバトルカードを作成できるかを確認し、採用の合否を決める具体的な手順を解説します。
競合調査AIは観測・推定・解釈を分けて選ぶ
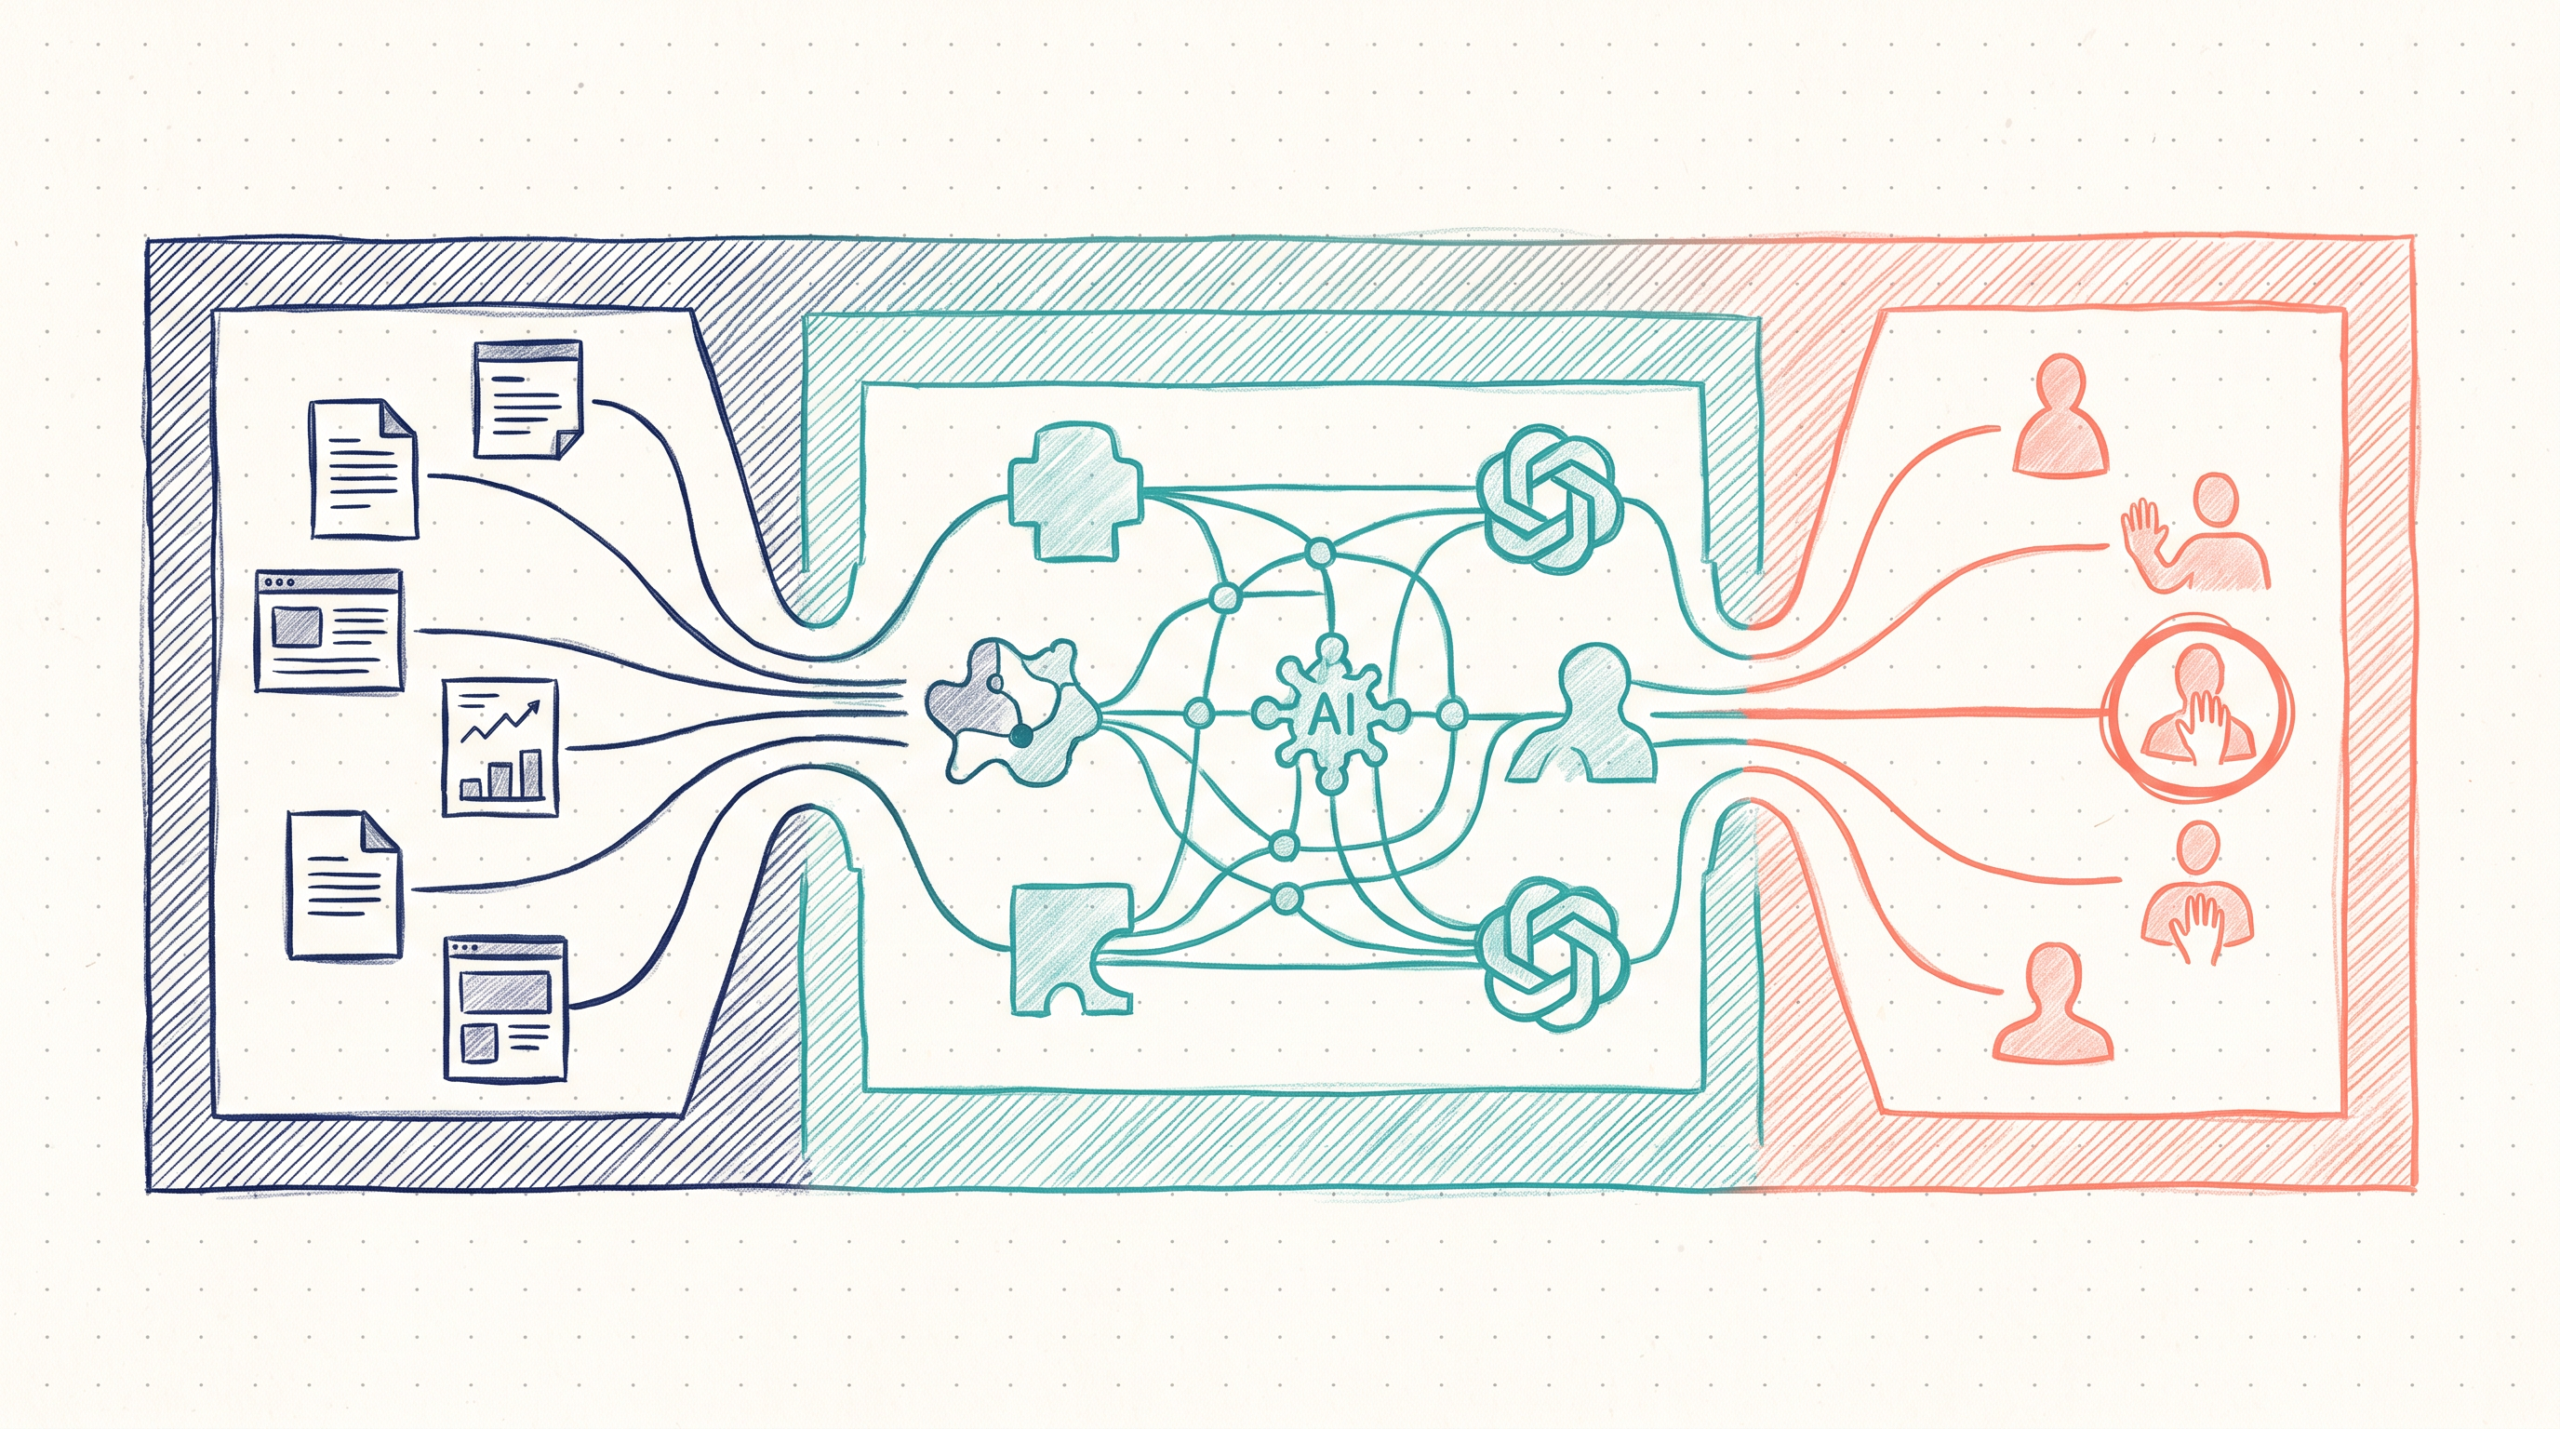
競合他社の動きを継続的に監視し、営業活動やマーケティング施策へ迅速に反映させるためのツールとして、AIを活用した競合調査製品の導入が進んでいます。本記事では、継続的な競合監視と営業配信の用途に適した6製品を比較します。競合情報に特化したCI(Competitive Intelligence)製品であるCrayon、Klue、Kompyteの3製品、デジタル指標を分析するSimilarwebとSemrush、そしてウェブページの変更検知に特化したVisualpingです。
これらの製品を自社の業務要件に合わせて選定するための比較軸は、ツールが入力として受け取り出力する情報を、観測事実、推定指標、社内解釈の3種類に分けて捉えることです。製品ごとにどの領域を自動化し、どこに人の手を介す設計になっているかが異なります。
第一の観測事実は、競合のウェブサイトの更新、ニュースリリースの配信、製品の機能追加や価格改定、求人情報の公開など、外部から直接確認できる客観的な事実を指します。監視対象のウェブページや情報源を入力として設定すると、AIが前回の巡回時からの変更箇所を検知し、その内容の要約を出力します。ここで重要なのは、AIによる要約文だけを独立して扱うのではなく、誤情報の混入や文脈の欠落に備え、必ず情報の原典となるURLと、システムが情報を確認した取得日がセットで出力され、さかのぼって確認できる仕組みを持つことです。
第二の推定指標は、ウェブサイトへのトラフィック量、流入経路、検索順位、デジタル広告の出稿状況などのデータです。これらは各ツールが独自に収集したパネルデータやアルゴリズムに基づいて算出する推定値であり、競合企業が内部で計測している実測値とは異なります。そのため、これらの指標は競合の実際の売上高や、公開されていない事業戦略そのものを直接明らかにするものではないという限界を理解しておく必要があります。単一の数字の正確性を問うのではなく、自社や市場全体と同じ条件で長期間にわたり相対的な推移を比較するための指標として用います。
第三の社内解釈は、収集した観測事実や推定指標を基に、それが自社にとってどのような脅威や機会になるのかを意味付けした情報です。その代表的な出力先が、営業担当者が競合との商談時に活用するバトルカードです。最近のAIは、競合の機能追加という観測事実を入力として、自社の優位性を強調する反論トークの草案を生成するところまで支援できます。しかし、その解釈が自社の営業方針として適切かどうかはAIには判断できません。誤った対応方針が現場に広がるのを防ぐため、営業チームへ配信する前には、専門的な知見を持つ事業企画やプロダクトマーケティング担当者による人の確認と承認を経るプロセスを必ず組み込む必要があります。
さらに、社内解釈を交えた競合情報やバトルカードは、社外秘の重要なアセットとなります。そのため、情報の管理担当者には編集権限を与え、一般の営業担当者には閲覧権限のみを付与するといった、役割に応じた柔軟な権限設定ができるかもツール選定の要件となります。ツールが扱う情報の性質と限界を見極め、自社のプロセスに合う製品を選ぶことが継続的な運用の鍵となります。
Crayon・Klue・Kompyte|情報統合からバトルカードまで
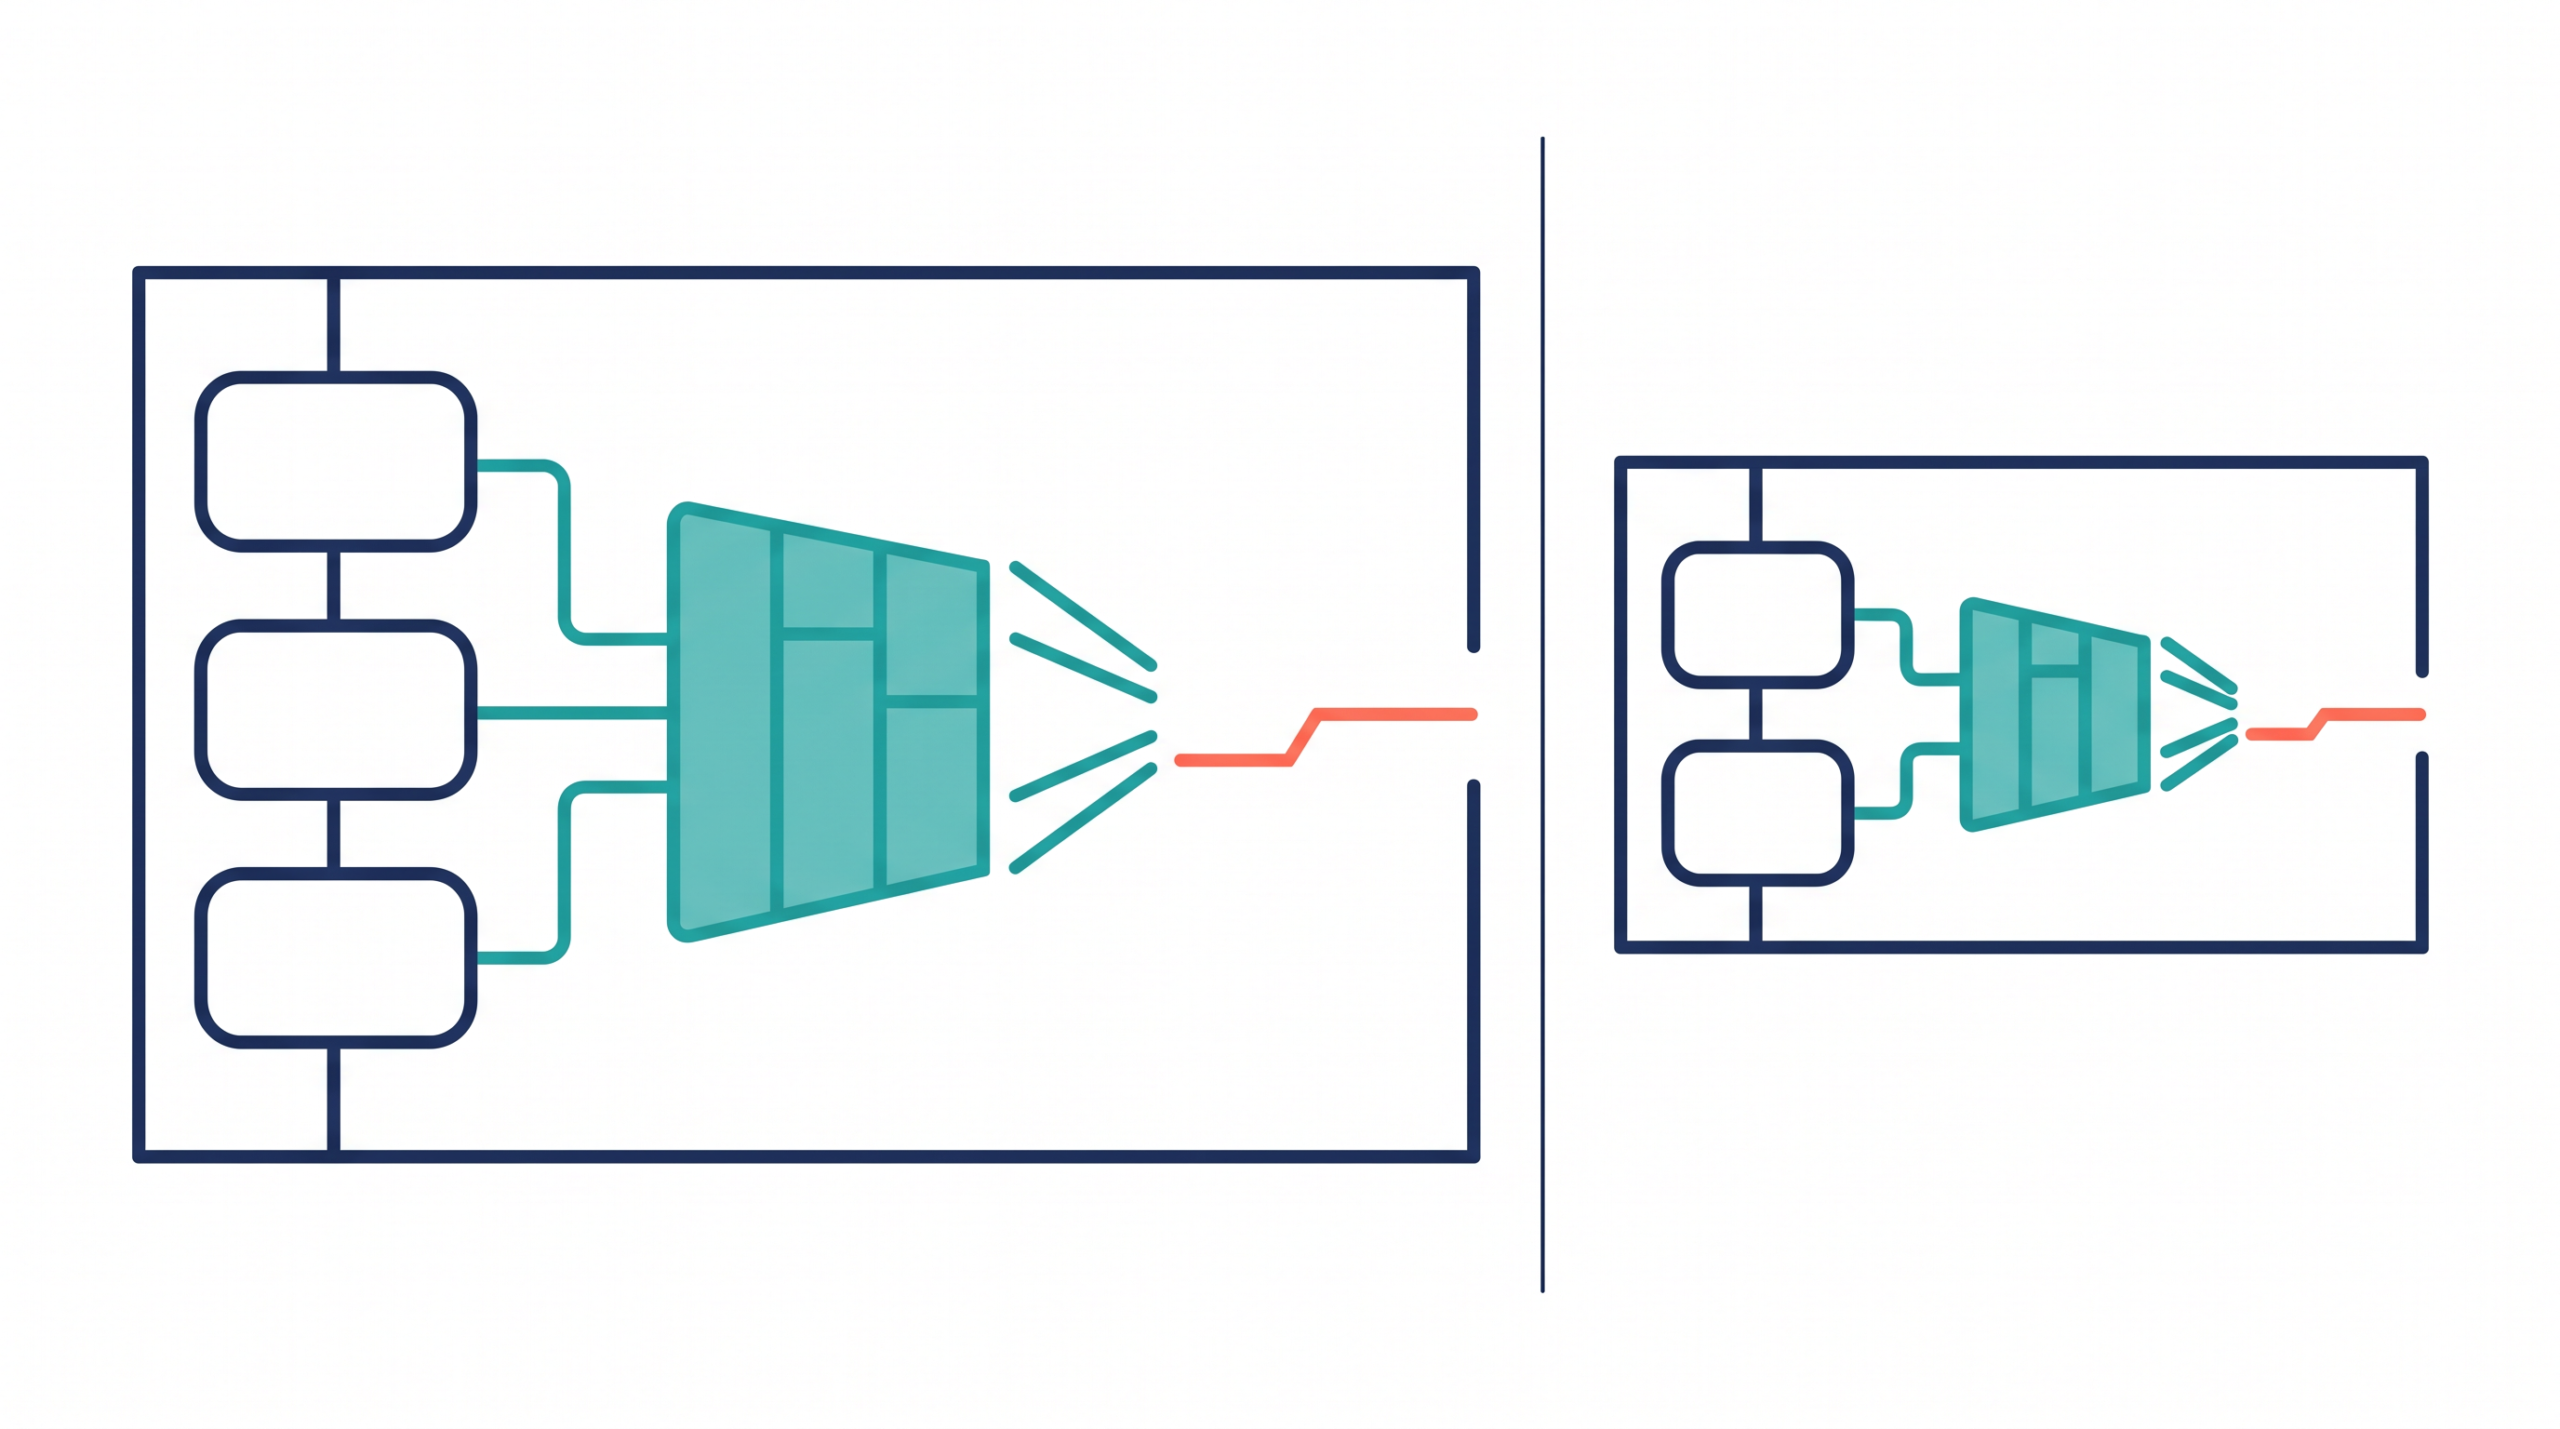
競合情報専門のプラットフォーム(CIツール)は、社内外に散在する情報を統合し、営業向けのバトルカードやアラートとして出力する役割を担います。ここでは代表的な専用CIツールであるCrayon、Klue、Kompyteの適合条件を比較します。それぞれ得意とする入力情報と処理の重点が異なります。
Crayonは、競合企業のウェブサイトをはじめとする広範なデジタル上の変化収集に強みを持ちます。競合の製品ページ、価格表、ニュースリリースなどを入力とし、AIが変更内容の要約と重要度付けを出力します。収集された情報はCIツール内に蓄積されるだけでなく、CRMや営業支援ツールとの連携を通じて、商談中の営業担当者へタイムリーな営業配信を行うことが可能です。自社にとっての意味合いを整理する前さばきをAIに任せ、大量の観測事実から重要なシグナルを見落とさないための監視網として適しています。
Klueは、ウェブ上の外部情報に加えて、社内の商談データを用いた勝敗分析を重視する組織に向いています。商談の通話録音、顧客レビュー、社内文書などを入力とし、AIが複数の情報源を横断して自社が競合に勝った理由や負けた理由を抽出します。このAIによる回答と原典の引用をもとに、競争上の優位性や弱点をプロファイルとして出力し、バトルカードの構成要素へ組み込むことができます。社内の暗黙知を構造化し、実践的な営業メッセージとして還元するプロセスに優れています。
Kompyteは、競合の動向を漏れなく捉えるための多チャネル監視を特徴とします。ウェブサイトやレビューにとどまらず、SNSの投稿、デジタル広告の出稿状況、求人情報の変化などを統合的に監視します。たとえば特定職種の求人開始を観測した場合、新しい事業領域への投資は仮説として記録し、製品発表や開示資料で反証を探します。生成されたインサイトはバトルカードへ反映され、営業部門へ共有されます。
3製品とも収集情報からバトルカードの草案を作れます。営業へ配信する前に、競合情報担当者が原典のリンクと取得日、勝敗分析に使った商談記録を確認し、自社の製品との差と対抗話法を承認します。たとえば競合が新機能を発表した場合、発表文に書かれた機能と、営業担当者が商談で言える自社の強みを別の欄に記録すると、観測事実と営業上の解釈を混同せずに更新できます。
Similarweb|トラフィックとオーディエンスを同じ条件で比べる
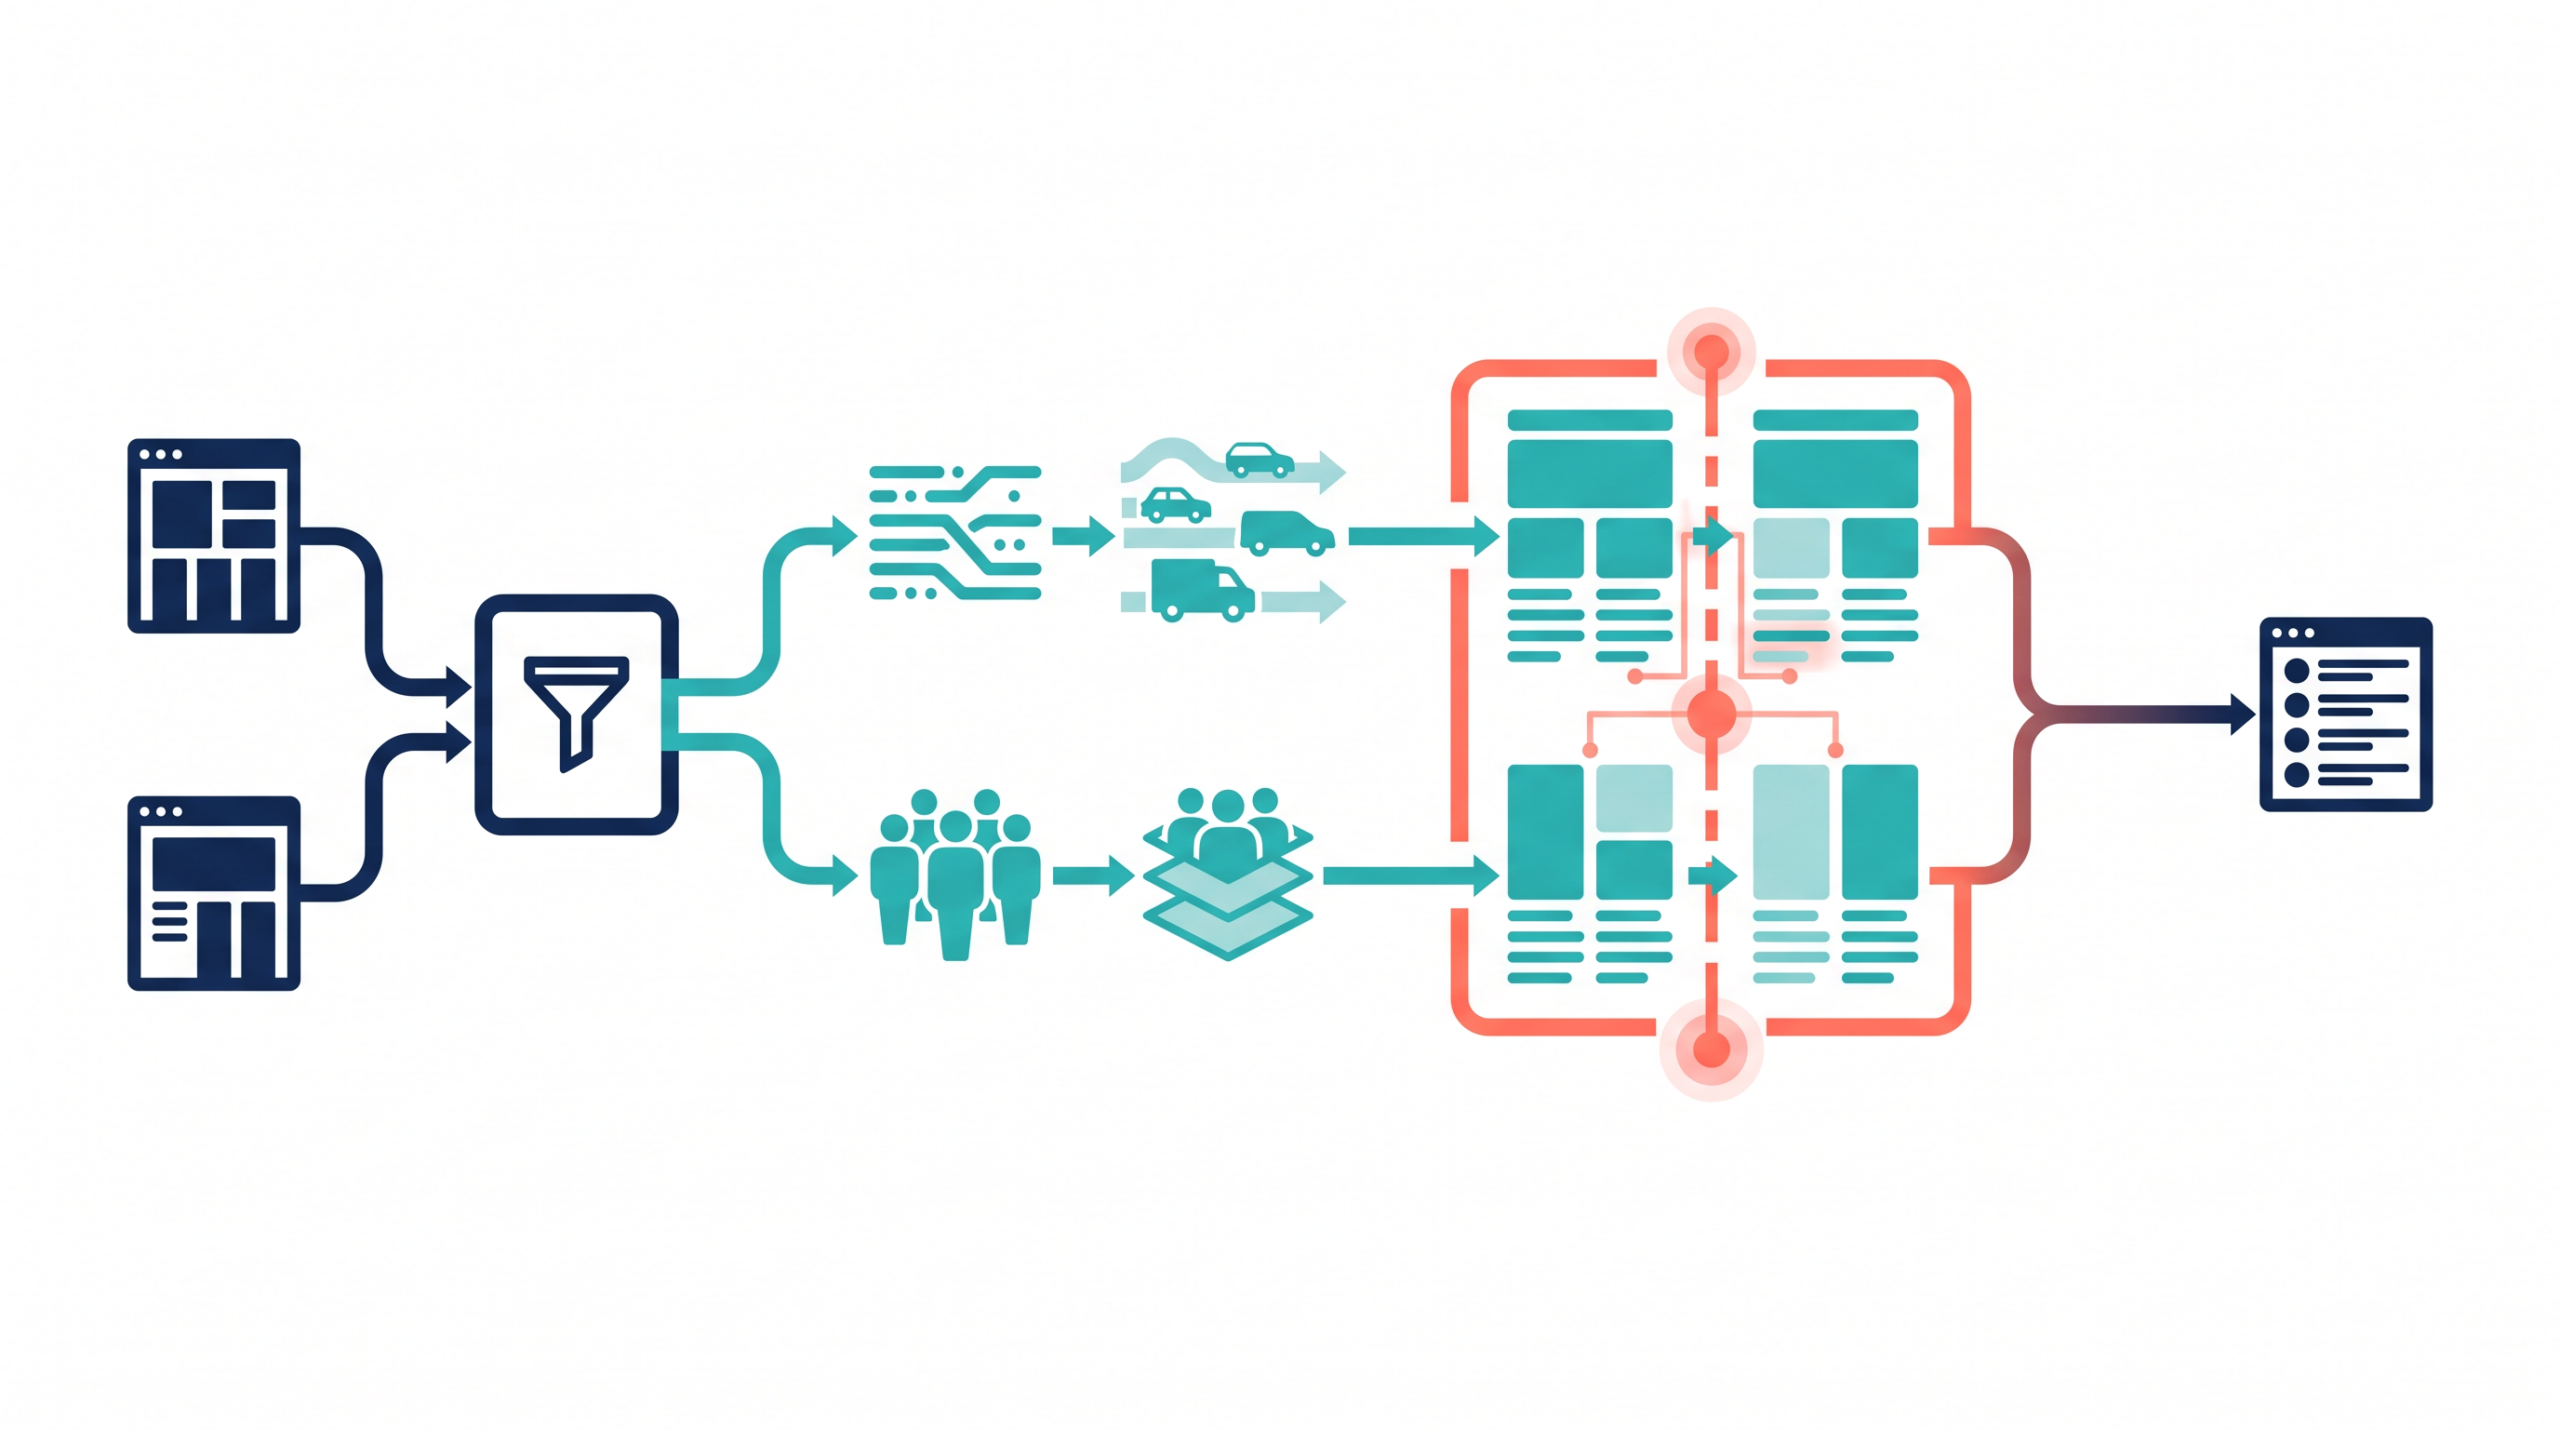
Similarwebは、自社からは直接観測できない競合サイトのウェブトラフィックやオーディエンスの動向を、同一の基準で比較するための製品です。ここで得られるトラフィック数やエンゲージメント指標は、パネルデータやクローラーなど複数の情報源から独自のアルゴリズムで算出された推定値です。そのため、自社が導入しているアクセス解析ツールが示す実測値と、Similarwebが示す自社の推定値を直接照合して誤差を修正しようとするのは適切な使い方ではありません。推定値はあくまで、競合と自社の相対的な差や、市場全体におけるシェアの変化、トレンドの推移を定点観測するために用います。
競合比較を成立させるための入力操作として最も重要なのは、すべての対象サイトに対して分析条件を厳密に揃えることです。対象とする地域、閲覧に利用された端末、集計の対象となる期間という三つの変数を固定します。たとえば、自社は日本国内のモバイル端末における過去30日間のトラフィックを指定しているにもかかわらず、競合については全世界のすべての端末のトラフィックを参照してしまうと、誤った前提で社内解釈を下すことになります。比較する競合3社についても、全く同じ地域、端末、期間のフィルターを適用してデータを抽出します。
出力されるデータには、訪問数、ページビュー、平均滞在時間、直帰率のほか、検索、ソーシャル、直接流入といったチャネル別のトラフィック割合が含まれます。注意すべき限界として、立ち上がったばかりの製品サイトや、対象を極めて限定したニッチなBtoBサイトなど、トラフィック規模が極端に小さいウェブサイトを分析対象とした場合、十分なデータサンプルが得られず数値が欠損することがあります。また、地域や端末の条件を細かく絞り込みすぎた場合も同様に欠損が発生しやすくなります。データが表示されない場合は、集計期間を月次から四半期へと広げたり、地域設定を広域に変更したりして、傾向を掴める水準まで条件を緩める必要があります。
継続的な競合調査のプロセスにおいては、担当者がSimilarwebの管理画面にログインして手動で数値を記録し続ける運用は推奨されません。継続取得が必要で、契約と実装体制が合う場合は、Similarweb APIで必要な推定指標を社内のデータ基盤へ取り込む方法を検討します。これにより、社内に分散している他の市場データや自社の実測値と並べて、ダッシュボード上で統合的に監視できるようになります。
AIやアルゴリズムが提示するのは、特定の期間における特定のチャネルのトラフィックが増減したという推定の指標までです。なぜそのチャネルのトラフィックが急増したのかという理由は直接出力されません。検索流入が増加していれば特定のコンテンツ施策が当たった可能性があり、ソーシャルからの流入が増えていれば新しいキャンペーンが展開された可能性があります。変化の兆候をデータとして捉えた後は、人が実際の競合サイトやSNSアカウントの原典を確認し、どのようなマーケティング施策が行われたのかを特定して、自社の営業企画や戦略にどう影響するかという社内解釈を加える必要があります。
Semrush|検索・広告・バックリンクの競争を追う
Crayon、Klue、Kompyteといった競合情報専用製品による情報の統合や、Similarwebによるウェブアクセス全体の推定、あるいはVisualpingによるウェブページの視覚的な変更検知とは異なり、Semrushは検索エンジンという公開された競争環境の比較評価に特化しています。この製品は、ウェブサイトへの自然検索流入、リスティング広告の出稿状況、および外部からの参照リンクの獲得状況を観測し、競合他社が検索結果上でどのような立ち位置にいるかを推定指標として出力します。
Semrushの入力として競合他社と自社のドメインを指定すると、対象サイトが検索結果上で獲得している推定トラフィックや可視性スコアが出力されます。出力されるデータのなかでも、オーガニック検索におけるキーワードの順位と分布は、競合がどの領域でコンテンツを強化しているかを把握する比較条件となります。対象企業名や製品名を含むブランド語での検索流入と、それ以外の一般名詞による非ブランド語での流入を分けて比較することで、指名検索によるブランド認知度の変化か、新規層を獲得するためのコンテンツ拡充か、といった傾向の違いを観測できます。
リスティング広告の領域では、競合がどのようなキーワードに対して広告を出稿しているか、過去にどのような広告コピーを用いていたかという履歴データが出力されます。広告運用の推定費用や出稿キーワードの重複状況を自社と同じ基準で比較することにより、自社がカバーできていないキーワードや、競合が注力し始めている領域を特定する材料となります。ここでも入力となるのはドメインや特定のキーワードであり、出力されるのは検索結果画面から観測された広告の掲載事実と独自の推定値です。
さらに、検索エンジンの評価に影響を与えるバックリンクの観測も検索マーケティングにおける重要な比較条件となります。競合サイトがどのような外部サイトからリンクを獲得しているか、リンク元の権威性やアンカーテキストの分布はどうなっているかを出力します。これにより、競合がどのような広報活動や外部連携を展開しているかの事実ベースの手がかりを得ることができます。
Semrushのトラフィックや広告費は推定値として扱い、競合の実際のアクセス数や売上とは区別します。あるキーワードの順位が上がったら、検索結果、広告文、リンク元のページを開き、競合がどのテーマの発信を増やしたかを確かめます。そのうえで、自社が同じテーマへ投資するか、別の顧客課題を狙うかを営業企画で決めます。
Visualping|価格と製品ページの変更を絞って検知する
競合他社のウェブサイトにおいて、価格改定や新製品の追加、仕様変更といった具体的な更新をいち早く知りたい場合、ページ監視ツールの導入が選択肢となります。その中でVisualpingは、指定したURLにおける視覚、テキスト、コードの変更を定期的に検知し、通知する製品です。競合サイト全体の動向を大まかに追うのではなく、特定のページにおけるピンポイントの変更監視に特化しています。
運用を開始するための入力設定として、まず監視対象となるURLと、チェックの頻度を指定します。Visualpingの強みは、ページ内の特定の領域だけを監視範囲として設定できる点にあります。例えば、価格表の数値部分や、製品紹介ページの機能一覧のみを枠で囲んで指定することで、それ以外の場所で発生した変更を無視できます。
この範囲指定は、ウェブサイト監視における最大の課題である誤通知を防ぐために不可欠です。ウェブサイトには、動的に切り替わるバナー画像や、アクセスするたびに表示が変わるポップアップ、あるいはシステムによる微細なコード変更など、ビジネス上の意味を持たない可変要素が多数存在します。これらを監視範囲から除外設定しないまま運用を始めると、些細な変化をすべて拾い上げてしまい、大量の誤通知に埋もれて重要な情報を見落とす結果となります。変更を絞って検知する設計は、運用担当者の負担を減らすための必須条件です。
設定した条件に一致する変更が検出されると、システムからの出力として通知が送られます。Visualpingは検知した変更内容に対して、AIによる要約と重要度の評価を付与する機能を提供しています。さらに、複数の変更を定期的なレポートとしてまとめる機能も備えており、日々の細かい通知を追うのではなく、週次や月次で重要な変化だけをまとめて確認する運用も可能です。
Visualpingの通知を受けたら、変更前後のページを開いて価格や仕様の差分を確認します。値下げなら対象プランと適用日を記録し、自社の該当製品との価格差を計算します。新機能なら実装範囲と提供条件を調べてバトルカードに反映します。AIの重要度評価は、どの通知から読むかを決める手がかりとして使えます。
競合3社を30日監視してバトルカードまで作る
競合調査AIを本格的に導入する前に、自社の情報収集と営業支援の運用サイクルが成立するかを検証する期間が必要です。検証期間は30日に設定し、監視対象を直接競合3社に絞り込みます。対象を広げすぎると、初期設定と日々の評価にかかる手間が膨張し、ツール選定のための正しい採用判断ができなくなるためです。このテストを通じて、情報の入力から出力、そして人の確認工程までの一連のワークフローを実行可能にします。
最初のステップは監視ツールの入力条件の統一です。Similarwebを利用してトラフィックやオーディエンスの推定指標を比較する場合や、Semrushでオーガニック検索キーワード、広告出稿、バックリンクの動向を追う場合は、競合3社と自社とで地域、端末、計測期間といった同じ指標条件を厳密に設定します。条件が少しでもずれていれば、相対的な比較そのものが無意味になります。また、Visualpingを用いて競合の製品ページや価格ページの変更を監視する際は、アクセスごとに変わる動的な要素を監視対象から除外する設定を行い、意味のあるテキストの書き換えや視覚的変更だけを検知できるように監視範囲をチューニングします。
次に、収集した情報をAIがどう仕分けるかを評価します。30日間の運用において、新機能のリリースや価格改定といった自社の営業活動に影響を与える重要変更と、単なるウェブサイトのレイアウト調整や著作権表記の年号更新のような無関係変更を定義します。Crayon、Klue、Kompyteといった専門の競合情報統合ツールでこれらの監視データを処理する際、どの程度の精度で重要変更を見逃さずに通知できたかという検出率と、無関係変更をノイズとして警告してこなかったかという誤通知率を日々記録します。AIは企業戦略の裏側や文脈を完全に理解できるわけではないため、どうしても誤通知は発生します。情報の意味づけにおけるAIの限界を把握することが、このテストの重要な目的の一つです。
最終的な出力として、営業担当者が実際の商談で活用できるバトルカードの最小構成を作成します。カードの最小構成には、いつ何が変わったかという観測事実、その事実を確認できる原典へのリンク、情報取得日、関連するデジタル上の推定指標の変化、そして最も重要な要素である自社としての対抗話法や強みの再定義といった社内解釈を含めます。
ここで不可欠なのが人の承認プロセスです。AIが自動で情報を収集し、要約やバトルカードの原案を作成したとしても、それをシステム任せでそのまま営業現場へ配信してはいけません。競合情報担当者は通知を受け取ったら必ず原ページへアクセスして事実関係の裏付けを取り、自社の戦略と合致した解釈が正しく反映されているかを審査します。人が確認し承認したものだけを正規のバトルカードとして公開し、指定された権限に基づいて現場へ届けるというワークフローを30日間のテスト内で確立させます。これにより、導入後の運用を具体化し、要件に最も合う製品を採用することができます。
よくある質問
競合調査AIは一製品の導入で完結しますか
一製品で足りるかは、監視対象と営業配信の要件で決まります。Crayon、Klue、Kompyteは競合情報の統合とバトルカード生成に長けていますが、トラフィックや検索の推定指標までは網羅しません。デジタル指標が必要ならSimilarwebやSemrush、特定ページの変更が必要ならVisualpingを追加します。重複通知を整理し、更新元にする競合情報台帳を一つ決めます。
推定トラフィックはどのように活用すべきですか
推定トラフィックは、パネルデータや公開情報などを元に各社独自のアルゴリズムで算出されており、自社がアクセス解析ツールで計測した実測値とは必ず差が生じます。競合調査における推定指標の目的は、正確な数値を割り出すことではなく、同一条件で複数サイトを比較して相対的な規模や傾向の変化を把握することにあります。期間や地域、端末などの条件を統一して定点観測し、自社との差分がどう変化しているかを見るための指標として解釈してください。
スクレイピングによる競合サイト監視の注意点は何ですか
ツールを用いた自動収集は、対象サイトの利用規約で禁止されている場合があるため確認が必要です。robots.txtでのクロール制限や、大量のアクセスによるサーバーへの負荷にも配慮しなければなりません。各製品の取得対象と頻度を確認し、ログインが必要なページや許可されていない非公開情報を取得対象にしません。導入テストの際は、自社の法務部門と連携して権限や監視範囲を決定してください。
競合情報の更新や監視の頻度はどう設定しますか
監視対象の性質に合わせて設定します。価格改定やキャンペーン告知など判断に直結するページは、見逃し許容時間とサイト負荷を基に監視頻度を決めます。一方で、会社概要やIR情報などは週1回や月1回で十分な場合が多く、頻度を上げすぎると重要度の低い変更による誤通知が増えてしまいます。まずは競合3社を対象に30日間の監視テストを実行し、担当者が手動で原典を確認し、社内解釈を添えて承認できる無理のない頻度を見極めてください。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント