SnorbeとSakana AIを同じ表に並べて比較すると、つい「どちらが高性能か」という疑問が先に立ちます。しかし、そもそも比べる対象の枠組みが異なります。
Snorbeは、調査の履歴を蓄積する一つのサービスです。一方のSakana AIは、AIの新しい仕組みを研究し、企業への導入や利用者向けの製品展開までを手がける会社全体を指します。
両者には、複数の情報源やAIモデルを組み合わせるという共通点があります。ただし、公開資料で示す設計対象は違います。
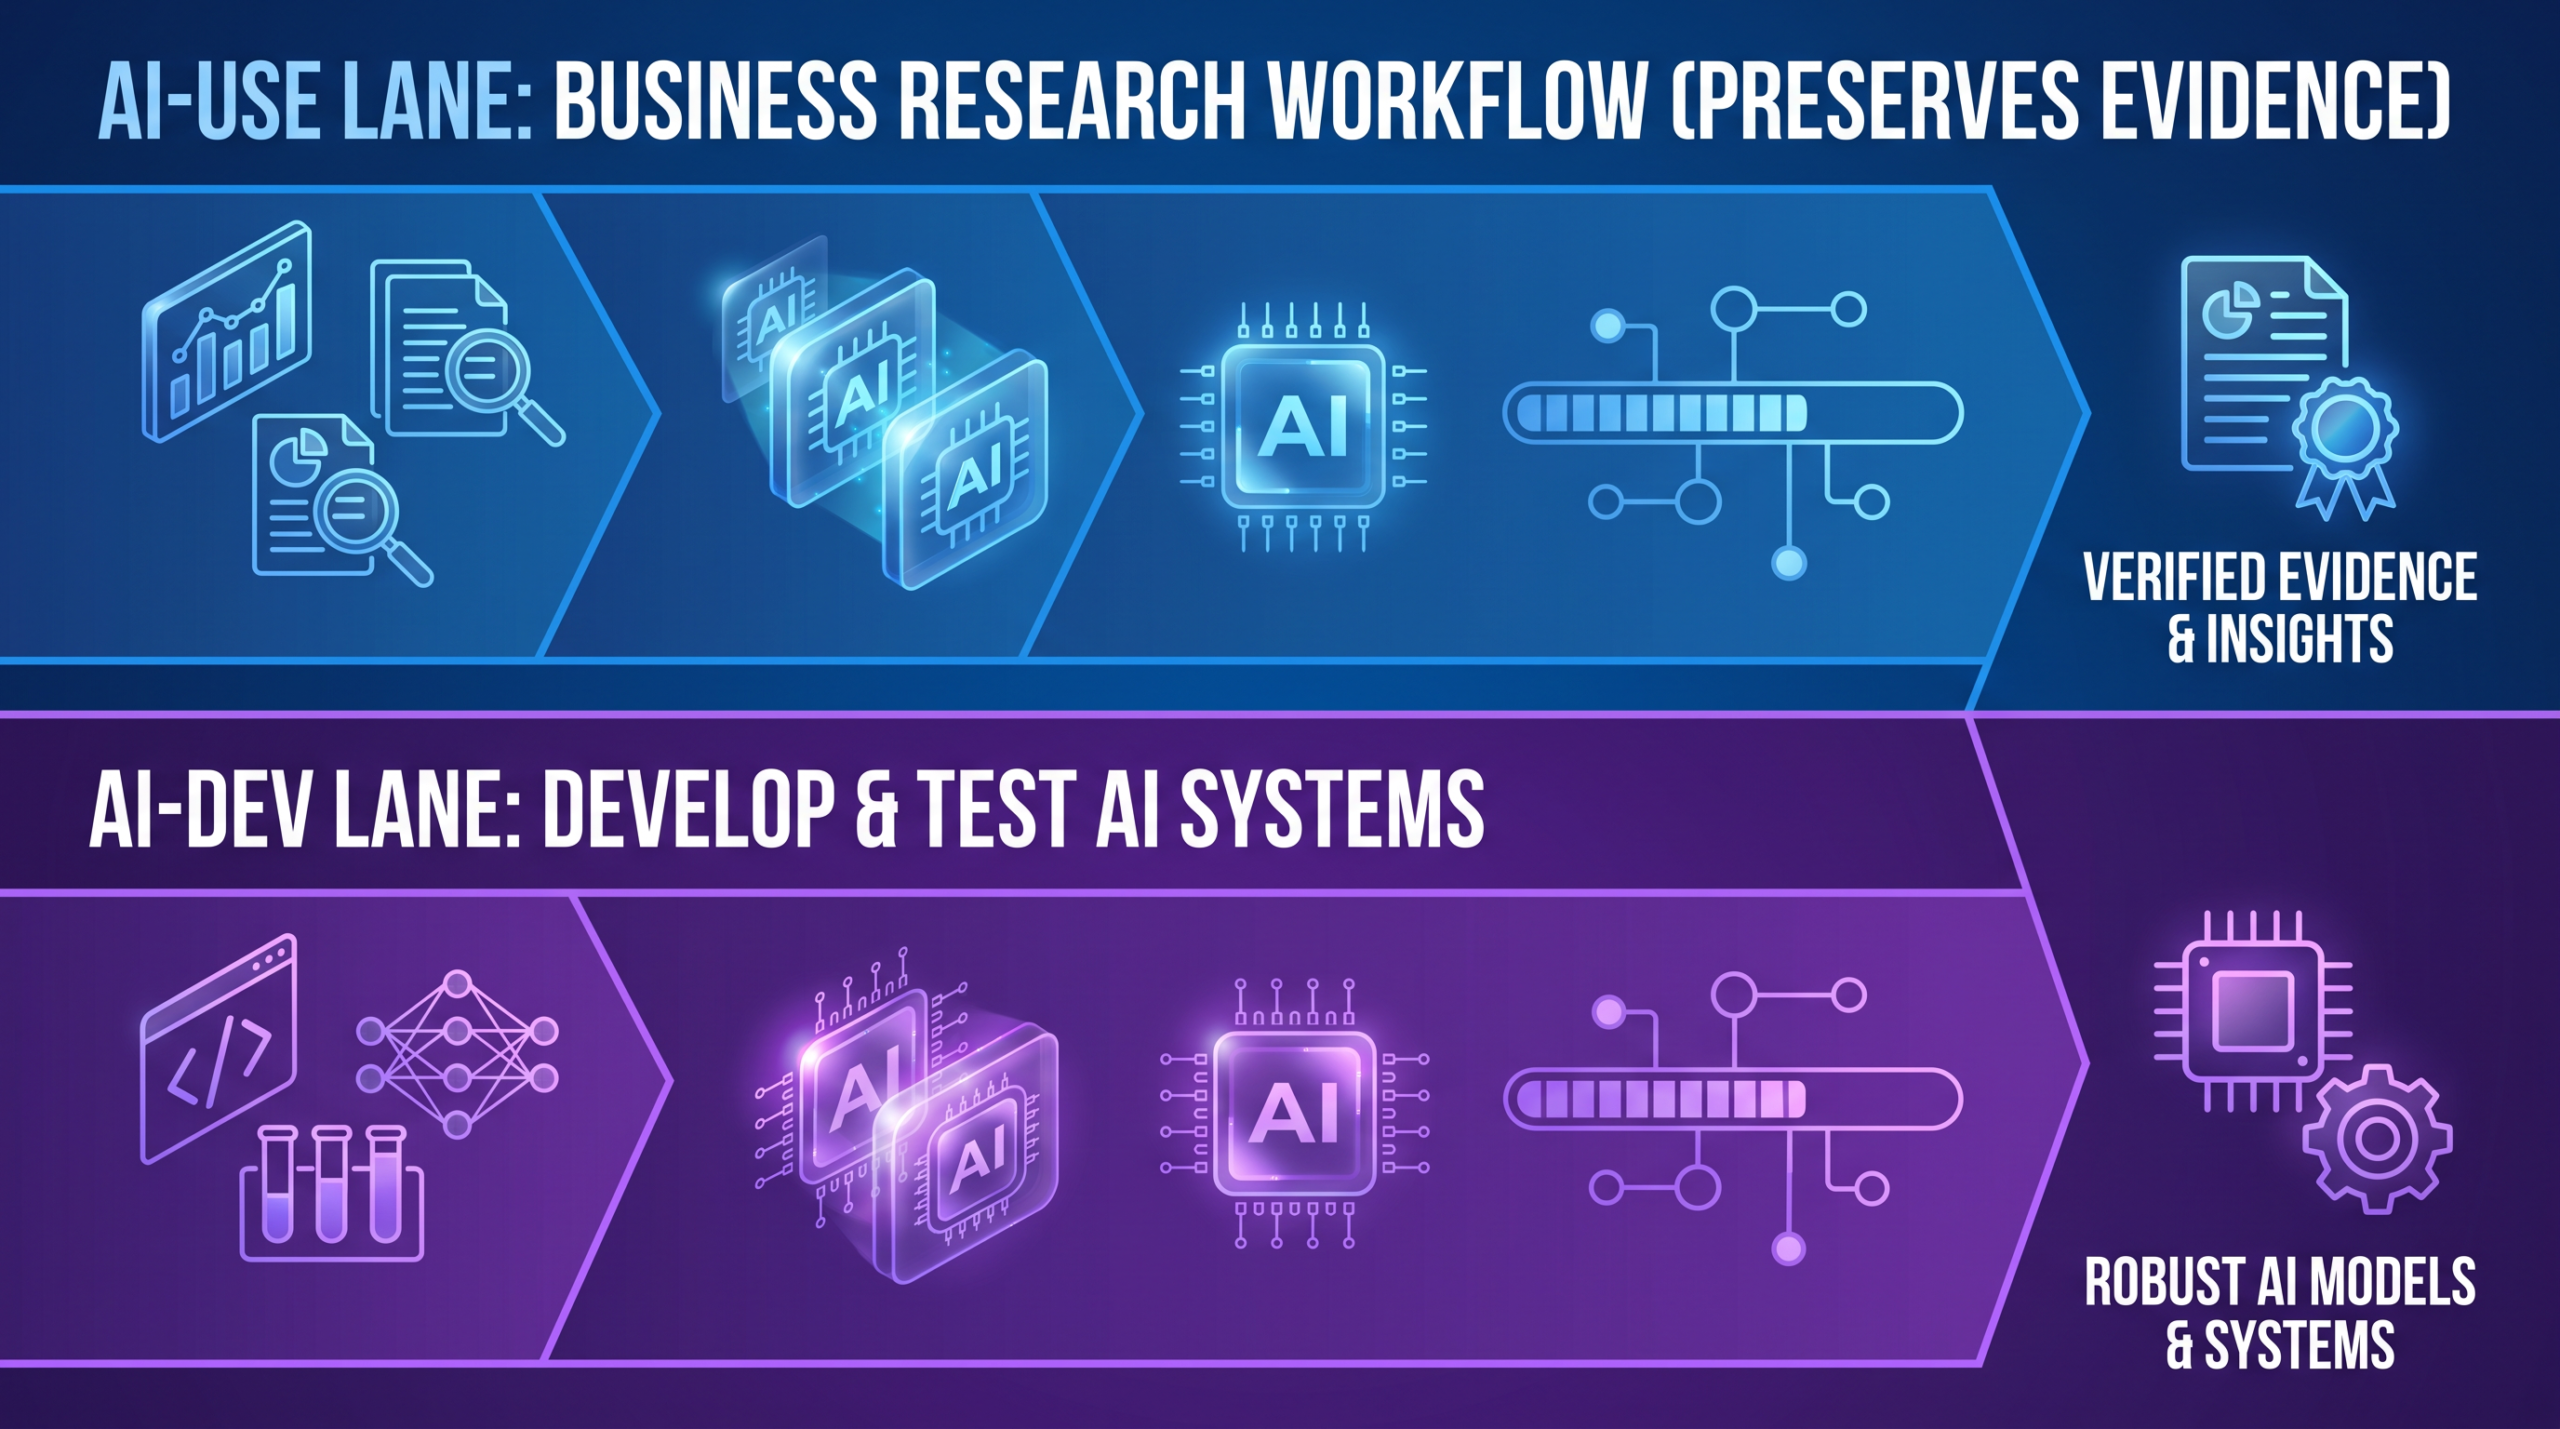
Snorbeは、調査で得た根拠や関係を次の調査へ使う流れを説明しています。Sakana AIは、モデルの作り方や推論方法を研究し、Research、Applied、Productの活動を分けています。研究成果が特定製品へそのまま移るとは仮定しません。
会社の規模やモデル数では比較しません。組織の調査知識を次回へ残すのか、AIの新しい構成を研究するのか、一回の会話で成果物を作るのかを先に決めます。まず、会社、サービス、研究成果、一般向け製品の粒度をそろえます。
Snorbe vs Sakana AIを同じ製品として比べない
Snorbe公式サイトは、公開資料と社内資料を使い、実行前のPlan、Webや専門データベースの調査、ナレッジグラフへの蓄積を行う流れを説明しています。未調査領域や関係は候補として表示されます。利用者は、次回の調査で対象、関係、出典を再利用できるかをPoCで確かめます。
一方、Sakana AIはサービス名ではなく、AIの新しい仕組みを作る研究開発会社です。Sakana AIの会社情報は、活動をResearch(研究)、Applied(応用)、Product(製品)の3つに分けています。
研究用のプログラムコード、企業や公共分野に向けた個別システム、一般の利用者が使う製品を、すべて同じ条件でSnorbeと比べることはできません。
導入候補として同じ条件で比較できるのは、SnorbeとSakana Chatに共通するファイル起点の作業です。Snorbeのマルチモデル調査とAB-MCTSは、複数モデルという言葉の意味を比べる対象にはなりますが、同じ購入候補として採点しません。研究コードは、評価データ、計算資源、再現性を別の試験で確認します。
Snorbeは調査の根拠と関係を育てる
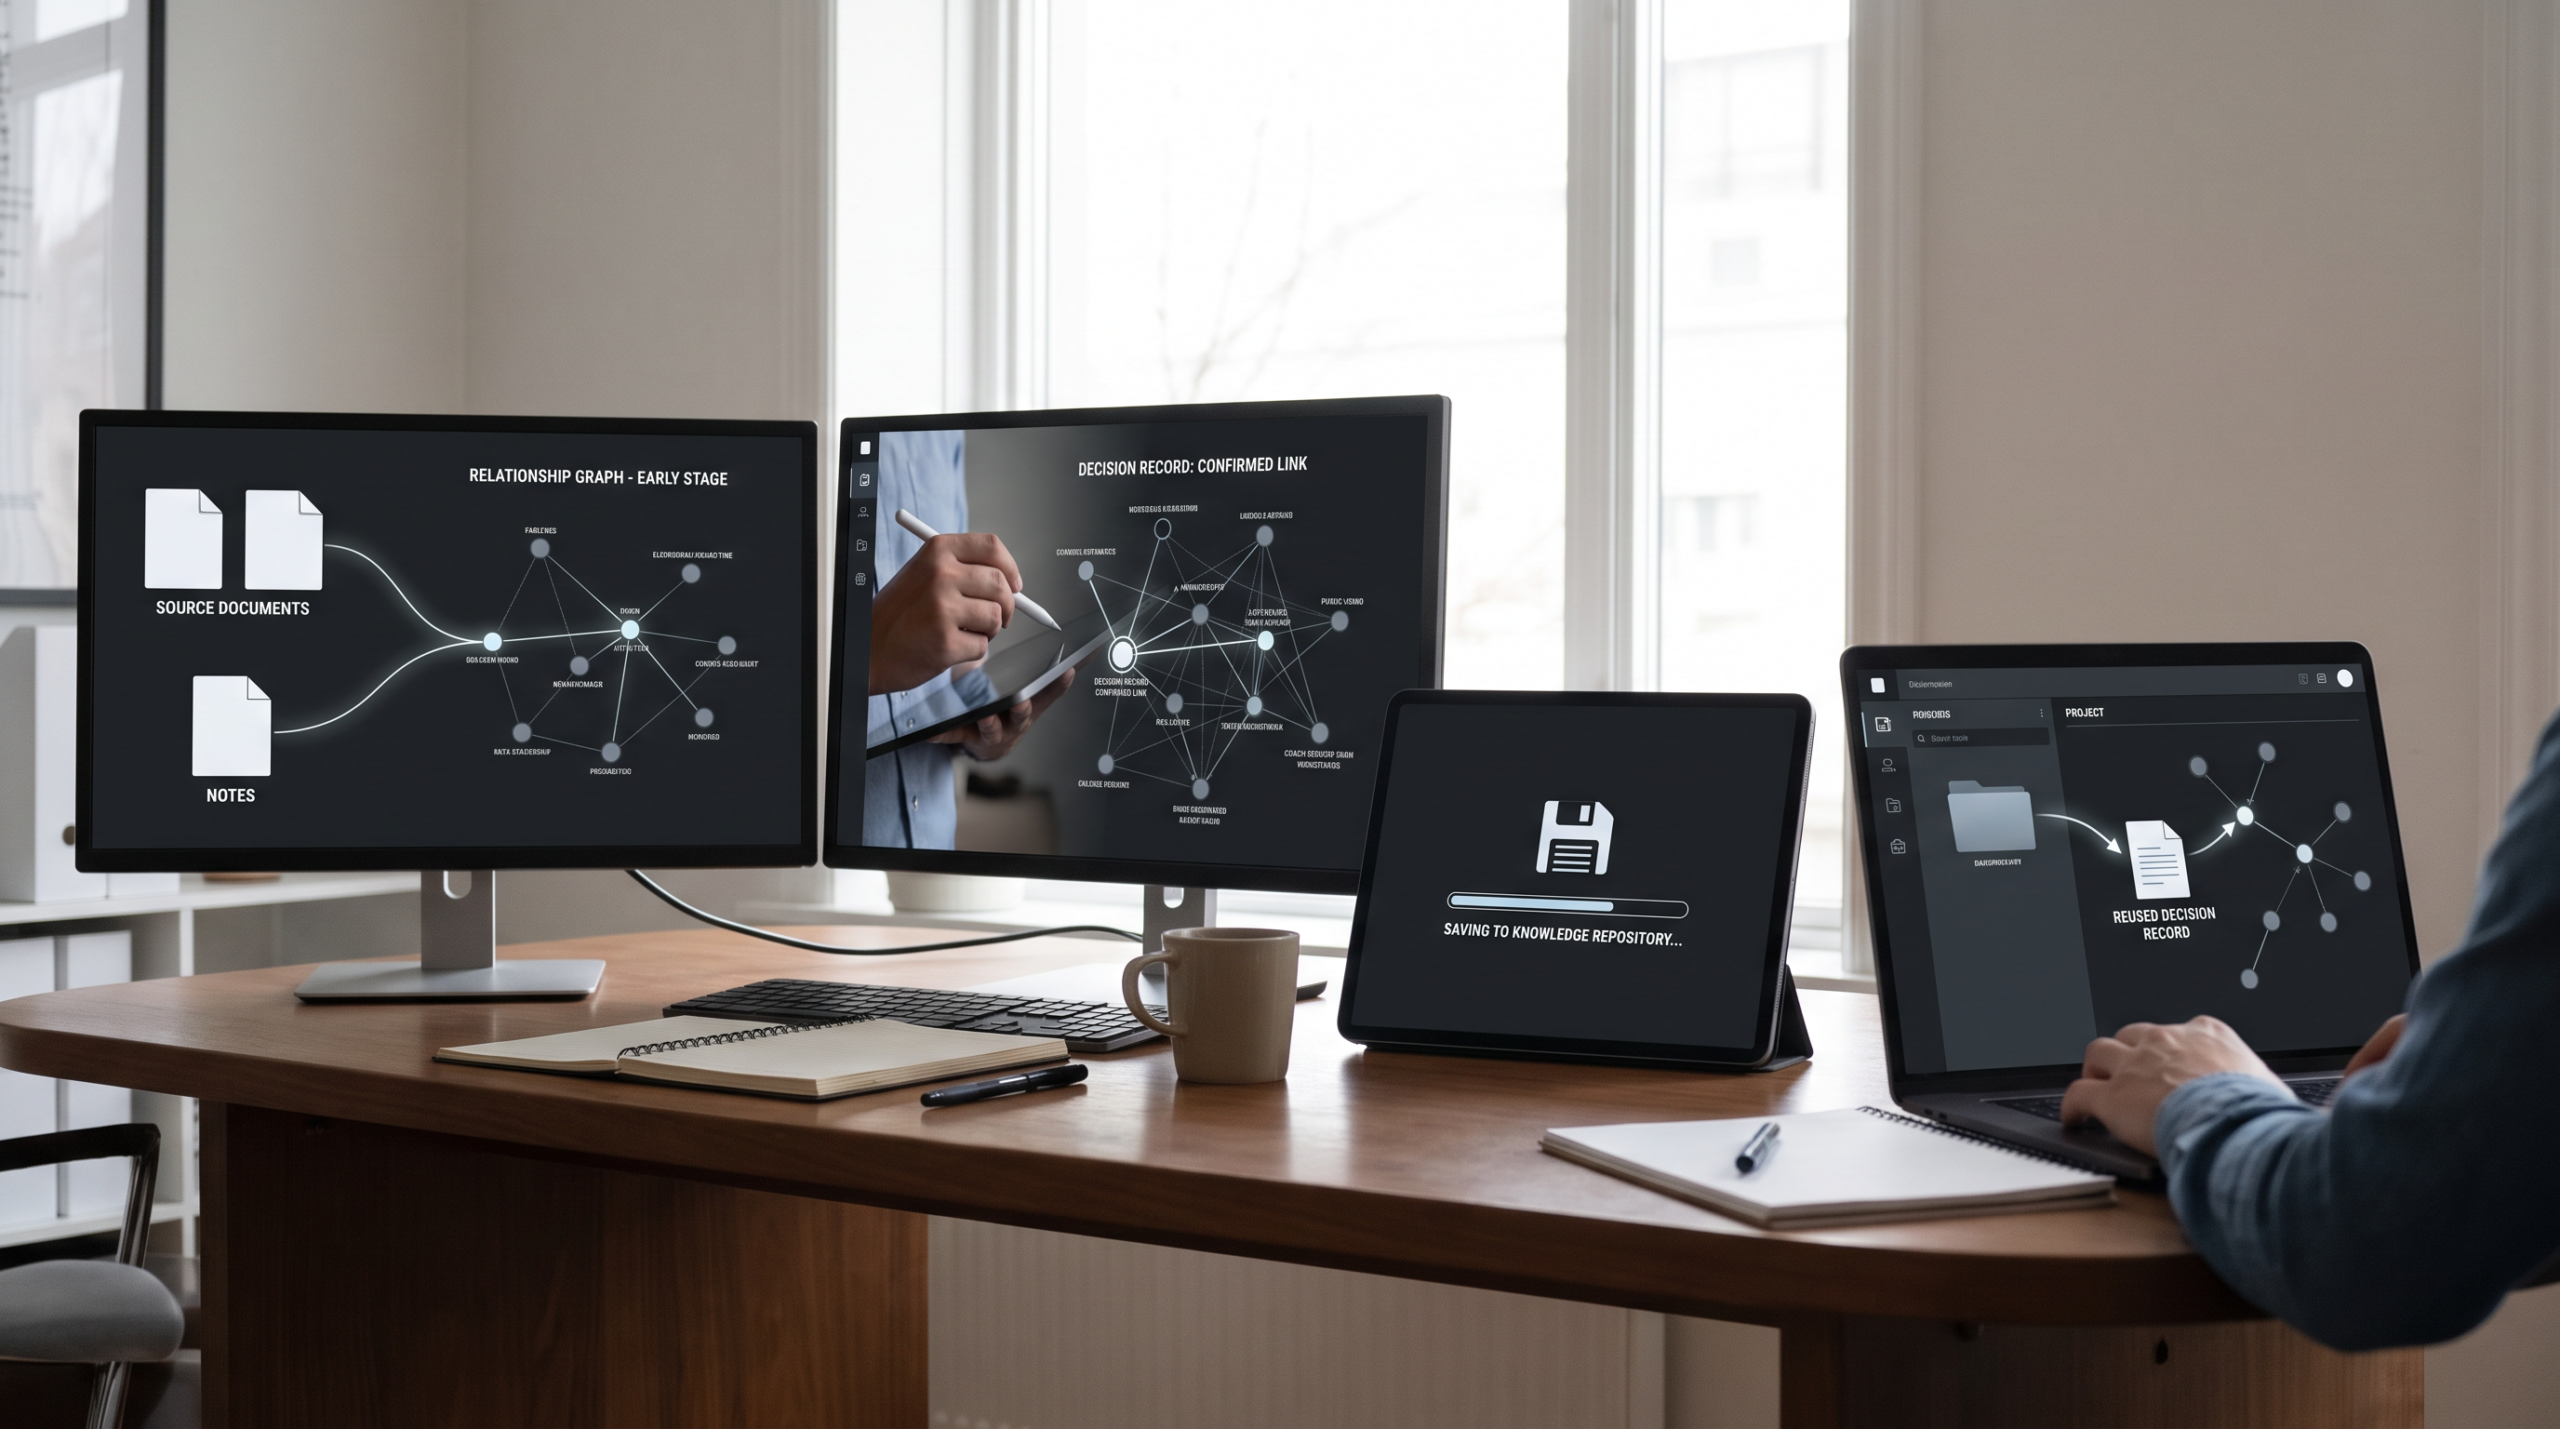
Snorbeが繰り返し使うのは、モデルの構造や重みではなく、これまでの調査の文脈です。前回の調査で見つけた情報どうしの関係や反対意見、まだ調べていない領域を、次の調査の問いへ引き継ぎます。Snorbe公式ドキュメントは、保存した知識を再び取り出す機能を説明しています。名称はリコール探索、対立リコール、つながりリコール、エージェントメモリです。
継続調査のPoCでは、担当者が過去レポートや許可済みの社内資料を添付し、過去調査を参照対象にします。実行前にPlanの対象期間、情報源、除外条件を確認します。出力後は、前回以降の新しい根拠、反証、未確認項目が原典と一致するかを人が確かめます。
出力されたグラフや比較表を受け取った後も、人が内容を評価する作業は欠かせません。収集した範囲でまだ情報が結ばれていない場所が見つかっても、それがそのまま新しい市場機会の証明になるわけではないからです。また、抽出の誤りや古い資料が混ざり、AIが関係の意味を取り違える可能性もあります。
そのため実務で使う際は、利用者が引用元の公報や論文へ戻って確かめる手順や、誤った関係を誰が直すかといった運用をあらかじめ決めます。このように情報を結びつけて組織の調査知識を育てるアプローチに対して、AIモデルやシステムの作り方そのものを広げようとする研究開発もあります。
Sakana AIはAIシステムの作り方を広げる
Sakana AIの研究活動(Research)は、自然界の進化や生き物の集団が持つ知恵をヒントにします。Snorbeのように調査の文脈を保存するのではなく、AIモデルの組み合わせ方や、推論の進め方、研究工程そのものを新しくすることが目的です。
たとえばEvolutionary Model Mergeは、すでに公開されているモデルを材料にして、より良い組み合わせ方を進化の仕組みで探す研究です。特定の能力を持つ基盤モデルを開発する手順を、自動化することを目指しています。
AB-MCTSは、AIが答えを導く推論の計算方法を広げる手法です。新しい答えの候補を広く作り出すか、いまある候補を深く改善するかを切り替えます。複数のモデルを使う仕組みでは、次の計算にどのモデルを使うかも選びます。
The AI Scientistは、初期コードを起点にアイデア、実験、原稿、レビューへ進む機械学習研究用の仕組みです。公式ページは、誤実装、不公平な比較、数値比較の誤りなども限界として挙げています。研究コードは隔離した環境で実行し、人が再現手順、コード差分、実験結果を確認します。
Sakana AIの会社情報は、企業・公共分野の個別実装をApplied、利用者向けの製品をProductとして分けています。Researchの評価値をApplied案件やProductの業務効果へそのまま移しません。
研究用のプログラムで計測した性能を、そのまま製品版の業務効果として扱ってはいけません。次は、SnorbeとSakana AIがそれぞれ何を組み合わせる仕組みなのかを分けて確認します。
集合知と複数モデルの意味は両者で違う
SnorbeとSakana AIは、どちらも「集合知」や「複数モデル」という言葉を使いますが、その仕組みが指す対象は異なります。
Snorbeが扱う集合は、資料、対象、関係、そして調査履歴の集まりです。AIが複数の情報源を横断し、蓄積した知識から次の問いを作ります。一方のSakana AIにおける集合知は、複数のモデルが持つ能力を組み合わせる研究原理として現れます。
「複数モデル」の扱いも同じではありません。Snorbeでは、利用者が調査に使うモデルを選びます。Snorbe公式サイトは、OpenAI、Anthropic、Google、xAIを選択肢として挙げています。
これに対してSakana AIは、推論の途中で次にどのモデルを使うかを選んだり、既存モデルの組み合わせ方を探索したりする計算対象として複数モデルを扱います。利用者が画面でモデルを選ぶ機能と、システムがモデルを協調させる仕組みは別の技術層です。
公開資料が自動化の対象として示す工程も違います。SnorbeはPlan、情報源の選択、検索、知識の保存、レポート作成を一つの調査フローに置きます。
The AI Scientistは、機械学習研究のアイデア、実験、原稿、レビューを対象にします。Sakana Chat Updateは、会話内のコード実行と成果物生成を説明しています。
自動化する工程、保存対象、人が確認する箇所は同じではありません。次は、継続調査、研究コード、単発の成果物作成を分けて候補を選びます。
実務では何を残したいかで選ぶ
同じテーマを繰り返し調べ、根拠と関係を次回へ残す場合は、SnorbeをPoC候補にします。モデル開発や推論アルゴリズムを研究する場合は、Sakana AIのResearch成果を候補にします。評価データ、計算資源、ベースラインをそろえ、再現性と実行環境を検証します。
一回の会話でExcelを集計し、グラフやスライドを作る場合は、Sakana ChatをPoC候補にします。2026年8月13日の更新は、ファイル添付、Python実行、成果物のプレビューを説明しています。計算式と成果物は人が確認します。
SnorbeとSakana Chatの共通範囲は、同じファイルから比較結果を作る作業です。月次の競合三社調査を使い、「保存済みの前月調査や成果物を再利用する方法は、同じ原典から新しく調べる手順より出典一致率を下げずに総確認時間を短縮できる」という事前仮説を置きます。
初月は、同じ三社の公開資料と許可済みメモを両製品へ渡します。翌月は、保存済みの前月調査や成果物を再利用する条件と、再利用しない条件を各製品で実行します。
翌月の二条件には、同じ前月原典と同じ更新資料を渡します。再利用する条件では、Snorbeは保存した前月調査を参照し、Sakana Chatは前月成果物をファイルで添付します。再利用しない条件では、保存済みの調査結果を参照せず、同じ原典から新しく調べます。
両製品へ次の依頼文を渡します。
3社の前月資料と今月資料を比較してください。前月から変わった主張、仮説に反する証拠、未確認項目を分けてください。各項目に根拠ファイル名と該当箇所を示し、推測で関係を補わないでください。
出典一致率の分母は、判断に使う全主張です。根拠再利用率の分母は、試験前に再利用対象と定めた前月の根拠です。総確認時間には、前月成果物の準備、AIの実行、人の原典照合、修正を含めます。合格値は試験前に数値で定めます。
同じ月次案件を三回実行します。出典一致率または根拠再利用率が合格値を下回る場合や、総確認時間が基準値より短くならない場合は事前仮説への反証です。各製品が合格条件を満たした場合に採用候補とします。研究コードの採否は、この比較試験では決めません。
比較で断定できないこと
公開されている資料だけでは、どちらのサービスが高性能か、安いか、正確かを断定することはできません。共通の入力データや作業内容を用意し、実行にかかる時間や費用、人が確認する手間まで条件をそろえた比較試験を行っていないからです。Sakana AIの研究で使われる評価の基準を、Snorbeの調査業務の成果へそのまま当てはめることはできません。
Sakana Chatの更新情報は、ファイル添付、コード実行、文書生成を説明しています。この範囲はSnorbeのファイル起点作業と重なりますが、代替できるかは同じ月次案件で測る必要があります。組織の資料を関係として蓄積し、次回へ呼び出す同条件の機能は、今回のSakana Chat更新情報からは確認できません。
併用する場合は、Sakana Chatの成果物を人が原典と照合した後、許可されたファイルだけをSnorbeの調査資料へ加えます。公式の直接連携は公開資料で確認できません。利用規約、保存先、機密区分を確認します。出典と版を残し、手動の受け渡し時間もPoCへ含めます。
よくある質問
SnorbeとSakana AIは競合ですか?
会社全体と一つのサービスを同じ条件では比べられません。Snorbeは調査の履歴を蓄積するサービスです。一方のSakana AIは、AIモデルの研究開発から製品の提供までを行う会社を指します。
Snorbeと製品版のSakana Chatが行うファイルの処理には重なる部分があります。しかし、継続して調査の知識を蓄えることと、AIの仕組みそのものを研究することは別の設計対象です。
SnorbeとSakana Chatはどう使い分けますか?
過去の根拠や関係を次の調査へ残す場合はSnorbeを、一回の会話でファイルから成果物を作る場合はSakana ChatをPoC候補にします。月次調査では、同じ根拠集合を使い、出典一致率、根拠再利用率、総確認時間を測って選びます。
Sakana AIのAB-MCTSはSnorbeのマルチモデル機能と同じですか?
同じ仕組みではありません。Sakana AIのAB-MCTSは、AIが答えを導く推論の途中で、次にどのモデルを使うかを計算によって選ぶ研究です。
これに対してSnorbeのマルチモデル機能は、調査に使うモデルを利用者が画面から選ぶ仕組みとして説明されています。
どちらが正確ですか?
同じ月次調査を実行するまで、正確性の優劣は未確認です。
月次の同じ三社調査で、使える根拠集合と依頼文をそろえます。判断に使う全主張の出典一致率、前月根拠の再利用率、人の確認と修正を含む総確認時間を測ります。研究ベンチマークはこの比較へ使いません。
両方を併用できますか?
システムどうしを直接つなぐ公式の連携機能は確認できません。
Sakana Chatで作ったファイルをSnorbeへ保存するといった、ファイルを出力して再び読み込ませる併用は考えられます。ただしこの場合は、機密情報の扱いや保存先を確認し、利用規約や情報の出典をあらかじめ整理しておく必要があります。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント