海外企業の提携候補や競合を初めて調べる事業開発や新規事業の担当者に向けて、候補の発見から事業実態の確認までを再現できる手順を説明します。AIを活用して情報を整理する作業と、人が原典を読んで事実を確認する作業を明確に分けることが、この調査の基本です。
AIに技術領域や地域などの条件を入力し、企業の候補一覧を出力させる作業は、あくまで調査の入口です。AIが作成したリストをそのまま事実として扱うのではなく、比較表の列に情報を整理したうえで、どの項目を人が原典で確かめるかというAIと人の分担を決定します。
候補となる企業が見つかったら、公的記録で裏付ける手順に進みます。たとえばイギリスの法人であれば、Companies Houseの検索画面で会社情報、提出履歴、役員などの情報を直接調べます。
ただし、Companies Houseは提出情報の正確性を検査していないと明示しており、登記情報があることだけで事業実態が保証されるわけではない点に注意が必要です。そのため、民間データベースの情報だけで断定せず、法人の提出書類などを確認する作業が求められます。
実際に市場シェア、強みと弱み、参入機会、参入障壁、間接競合を確認する場面では、事実と企業の主張を区別して判断します。調査を効率化するためにプログラムを利用する場合でも、AIへ渡すのは公開情報のみとし、APIキー等の認証情報を入力データに含めないように管理します。これらの手順を順番に進めることで、提携や競合の候補を絞り込む判断ができるようになります。
調査目的を一文にして対象範囲を固定する
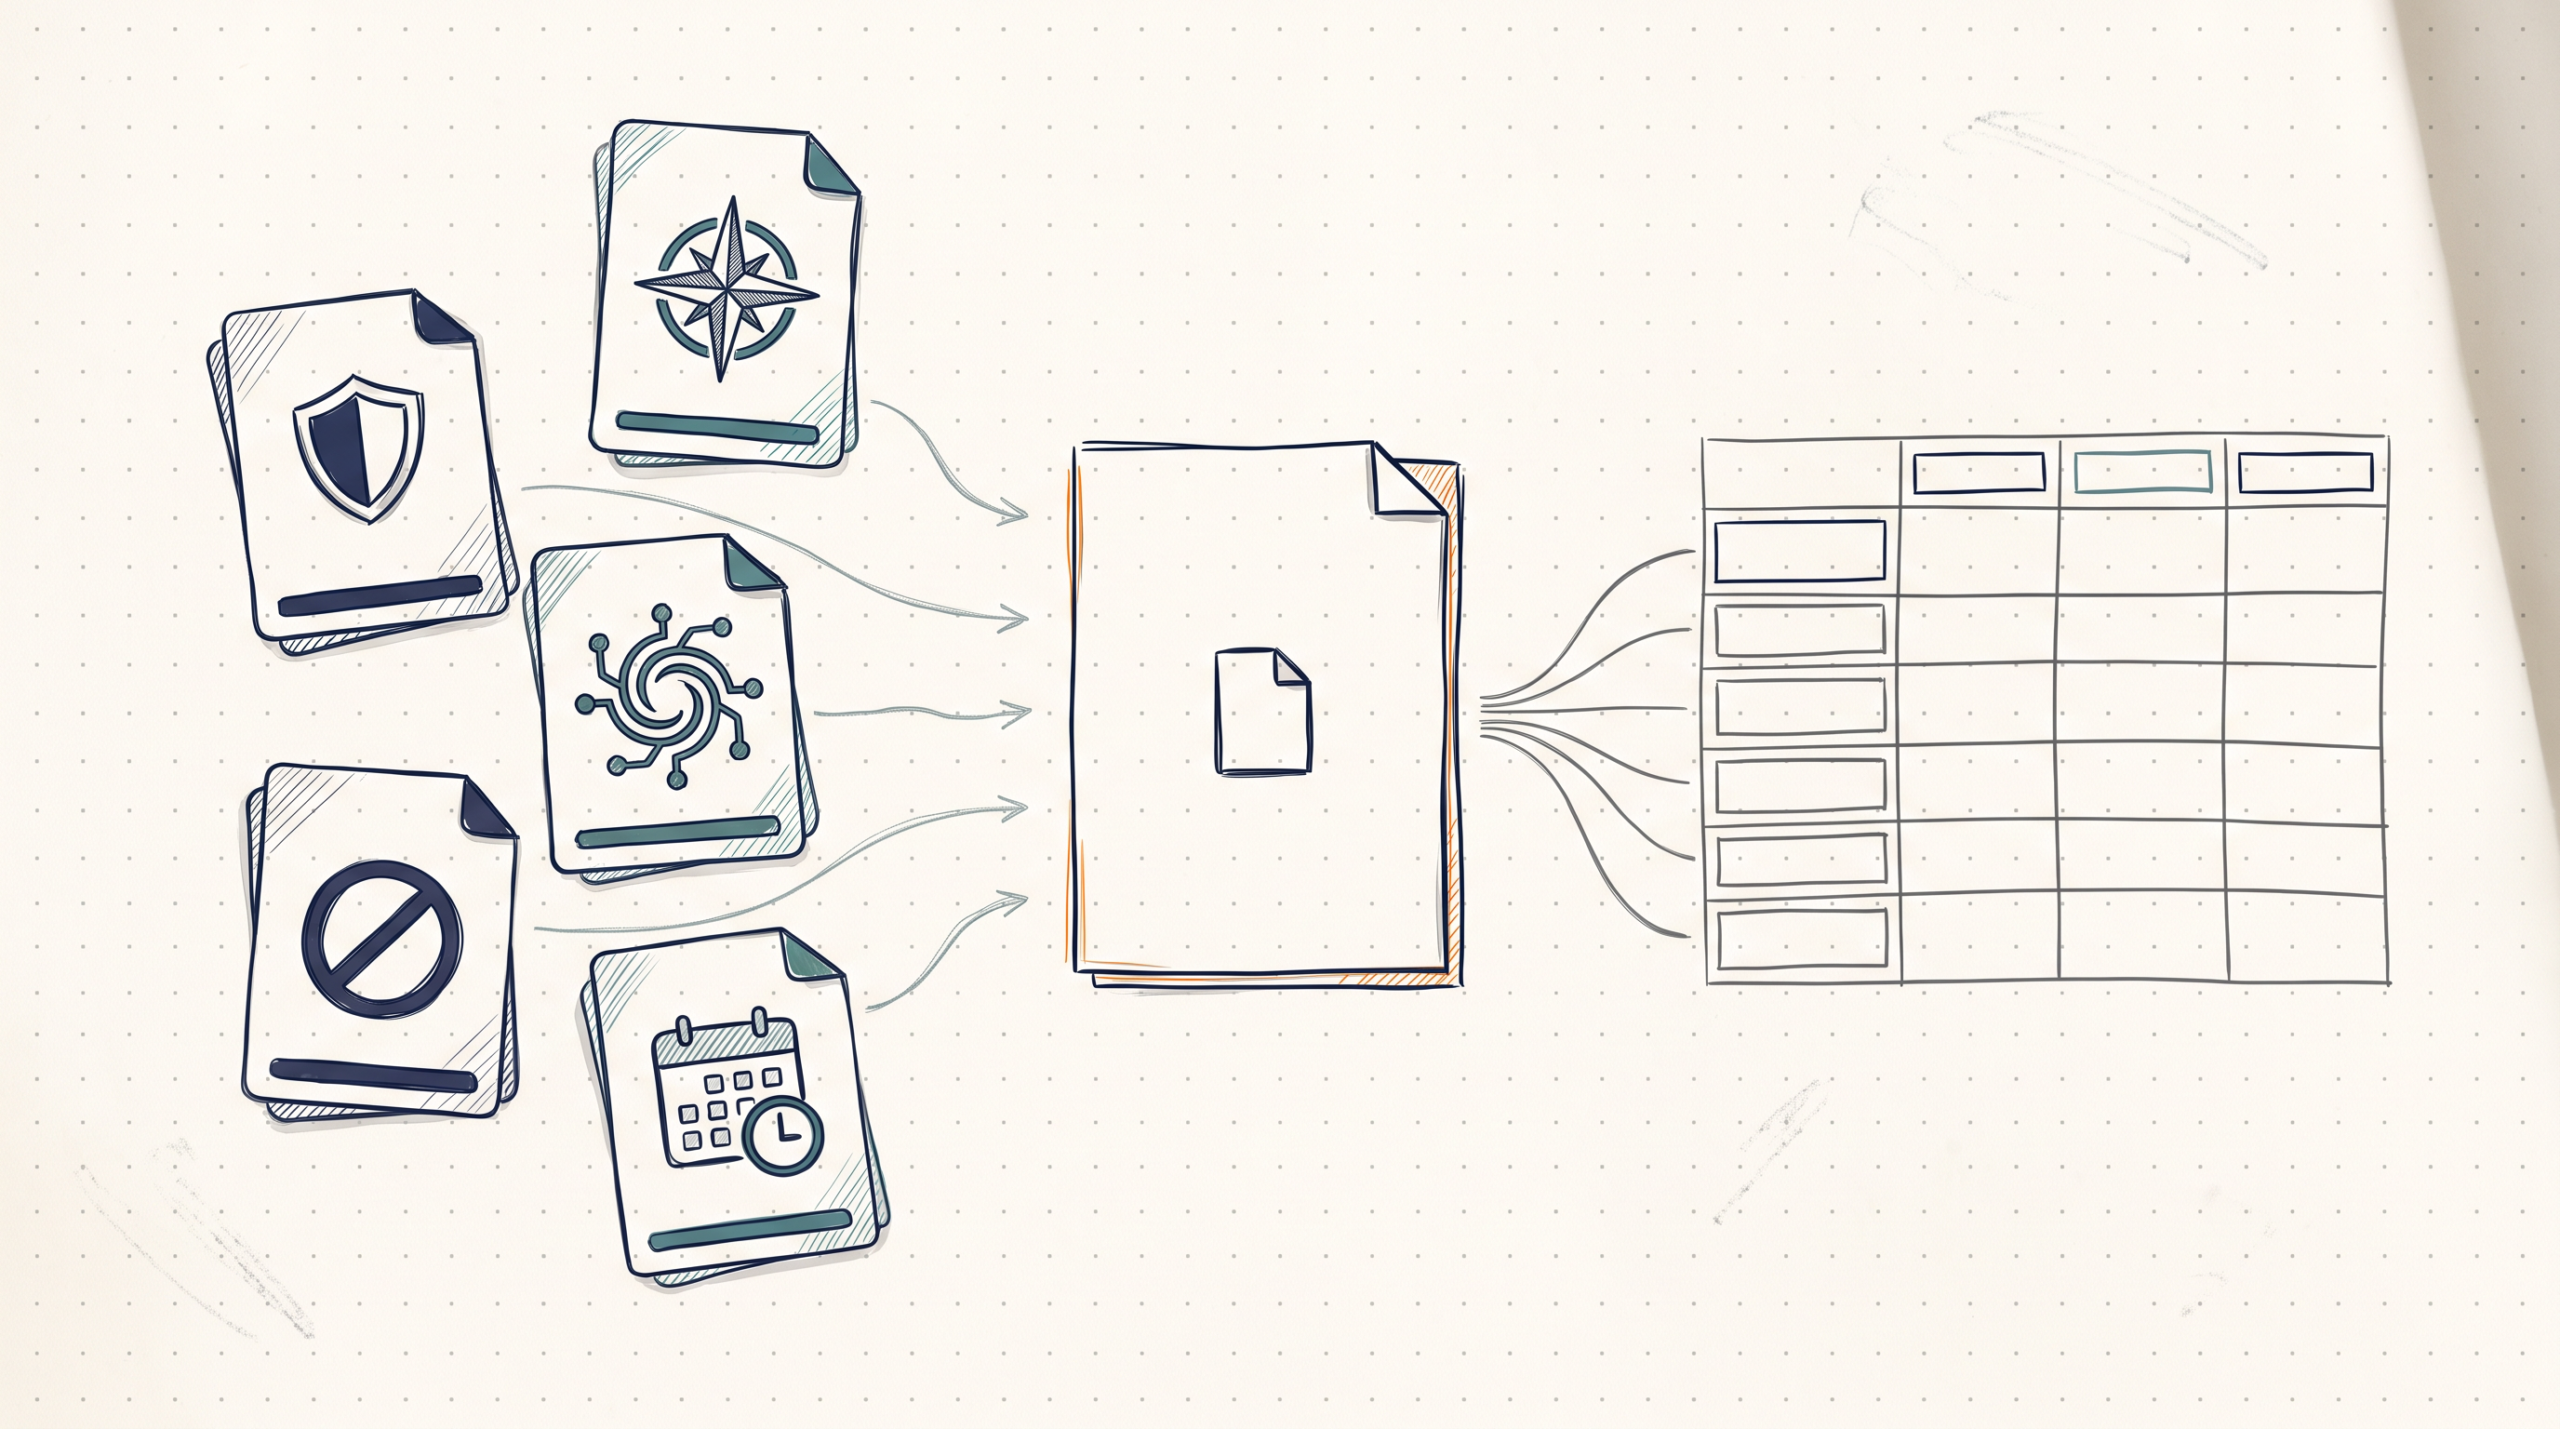
海外のスタートアップ企業を調べるとき、いきなり検索エンジンへキーワードを入力してはいけません。目的が曖昧なまま企業名を集め始めると、リストに名前が並んだ後になってから、比較するための評価列を次々と後付けすることになります。これを防ぐため、検索作業を始める前に調査の目的を一文でまとめ、対象範囲をあらかじめ固定します。
対象範囲を決める際は、用途、地域、技術領域、除外条件、基準日の5つの項目を明確にします。AIを利用して調査を進める場合、これらの条件をあらかじめテキストとして整理しておくことで、AIへの入力や指示がぶれなくなります。具体的な手順として、手元のテキストエディタでresearch-brief.yamlというファイルを作成し、次のように条件を書き出して保存します。
用途:自社の新規事業における提携候補のリストアップ 地域:イギリス、EU加盟国、アメリカ 技術領域:産業用画像認識 除外条件:上場企業、販売代理店のみ、法人未確認 基準日:2026年9月12日
次に、このファイルに書かれた公開情報だけをAIのプロンプト画面に入力し、「この条件で提携候補を比較する場合、どのような評価軸をスプレッドシートの列として用意すべきか出力してください」と指示します。AIからは、技術の成熟度、主なターゲット顧客、直近の資金調達段階といった調査項目の案が出力されます。
ここで、AIの出力をそのまま使うのではなく、人が調査の手引きとなる視点を取り入れて最終的な評価列を判断します。たとえば米国中小企業庁が提供する事業計画に関する資料では、市場調査と競合分析で市場シェア、強みと弱み、参入機会、参入障壁、間接競合を確認するよう案内しています。
海外スタートアップを提携候補として探す場合でも、将来的に自社の間接競合になり得るか、あるいは技術的な参入障壁をどう築いているのかを把握することが欠かせません。そのため、AIが提案した項目に対して、市場シェアや参入障壁といった要素を人の手で補い、比較表の見出しとして決定します。
このように、調査の入口で何のためにどの範囲を調べるのかを文章にして固定し、比較表に並べる列を確定させることが最初の作業です。調査の目的と評価軸が決まることで、対象から外れる企業を迷わずに省くことができ、調査を再現可能な手順にすることができます。
AIで候補を広げ、法人名とブランド名を分ける
調査の範囲と評価のための列が決まったら、実際に候補となる企業を集めていきます。ここでの課題は、条件に合う企業を見落としてしまうことと、同じ企業を別の企業として二重にリストへ追加してしまうことをどう防ぐかです。
候補を探す際は、民間が提供する企業データベースの検索機能だけに頼ると、データベースに未登録の企業が漏れたり、最新の社名変更が反映されていなかったりすることがあります。そのため、複数の情報源から情報を集めます。たとえば米国国際貿易局が公開している資料が役に立ちます。
市場状況、機会、規制、商慣行を国別に提供するCountry Commercial Guidesや、市場参入、政治経済、販売方法、規制などを扱う国別ガイドには、各国の主要な事業者や業界動向が記載されています。
こうした公的な報告書や、業界団体の加盟社一覧、展示会の出展者リストなどから、条件に合いそうな企業名やサービス名が書かれたテキストを収集します。
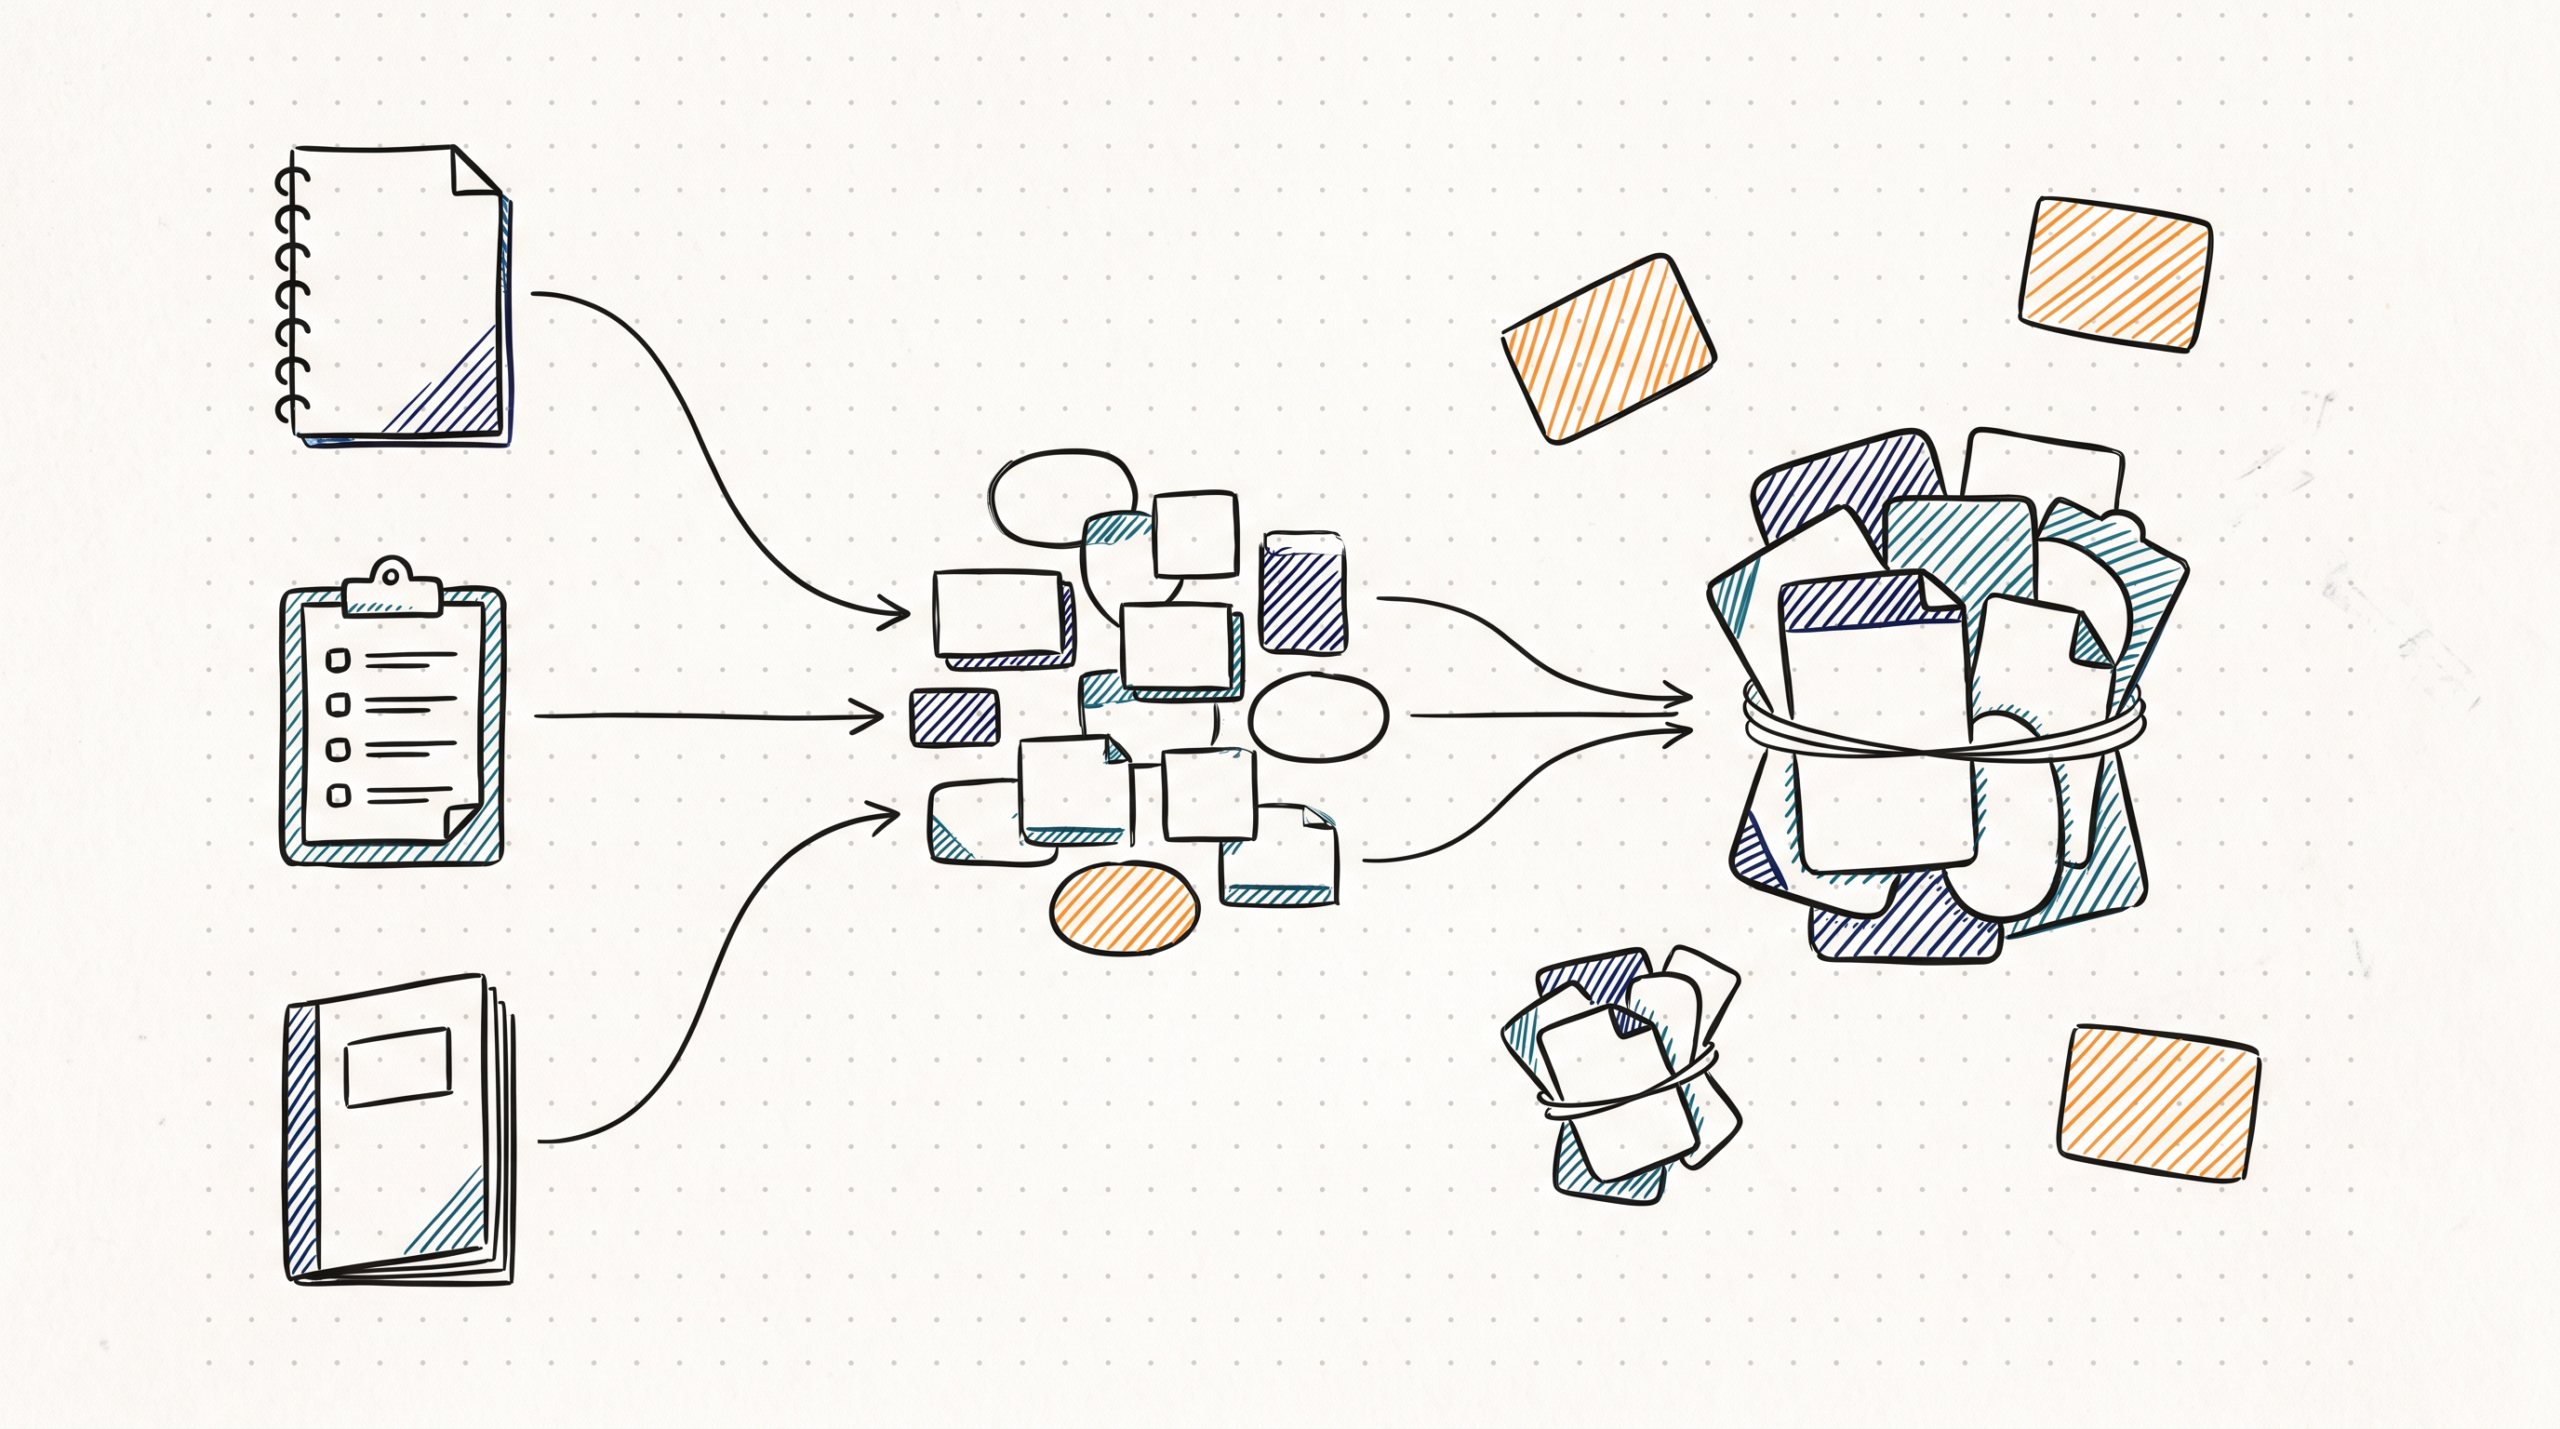
次に、集めたテキストからAIを使って候補を整理します。スタートアップ企業は、正式な法人名と製品のブランド名が異なることが多く、これが一覧を作る際の混乱を招きます。手元のテキストファイルに集めた公開情報だけをAIの入力画面に貼り付け、「この文章に含まれる事業体について、法人名とブランド名と思われるものを分けて抽出してください」と指示します。
AIは文章の文脈から、どれが会社を指す名前で、どれがサービスを指す名前かを推測して一覧表として出力します。
ここで重要なのは、AIの出力をそのまま完成品としないことです。AIの整理結果を人が確認し、表記揺れを修正します。人が判断した結果を残すため、手元でcandidate-companies.csvというファイルを作成します。このCSVファイルには、「推定される法人名」「ブランド名」「発見した元のURL」という列を用意します。
AIの画面に出力された結果を見比べ、同じ会社が提供する別のサービスがそれぞれ独立した別の会社として扱われていないか、あるいは略称や旧社名が別の法人として認識されていないかを人が確認し、CSVファイルに入力していきます。
このように、複数の情報源からテキストを集め、AIの入力による機械的な整理と人の確認を組み合わせて法人名とブランド名を分ける手順を踏みます。これにより、比較の土台となる候補の集合を、漏れや誤統合を減らした状態で準備することができます。
企業登記と提出書類で法人の存在を確かめる
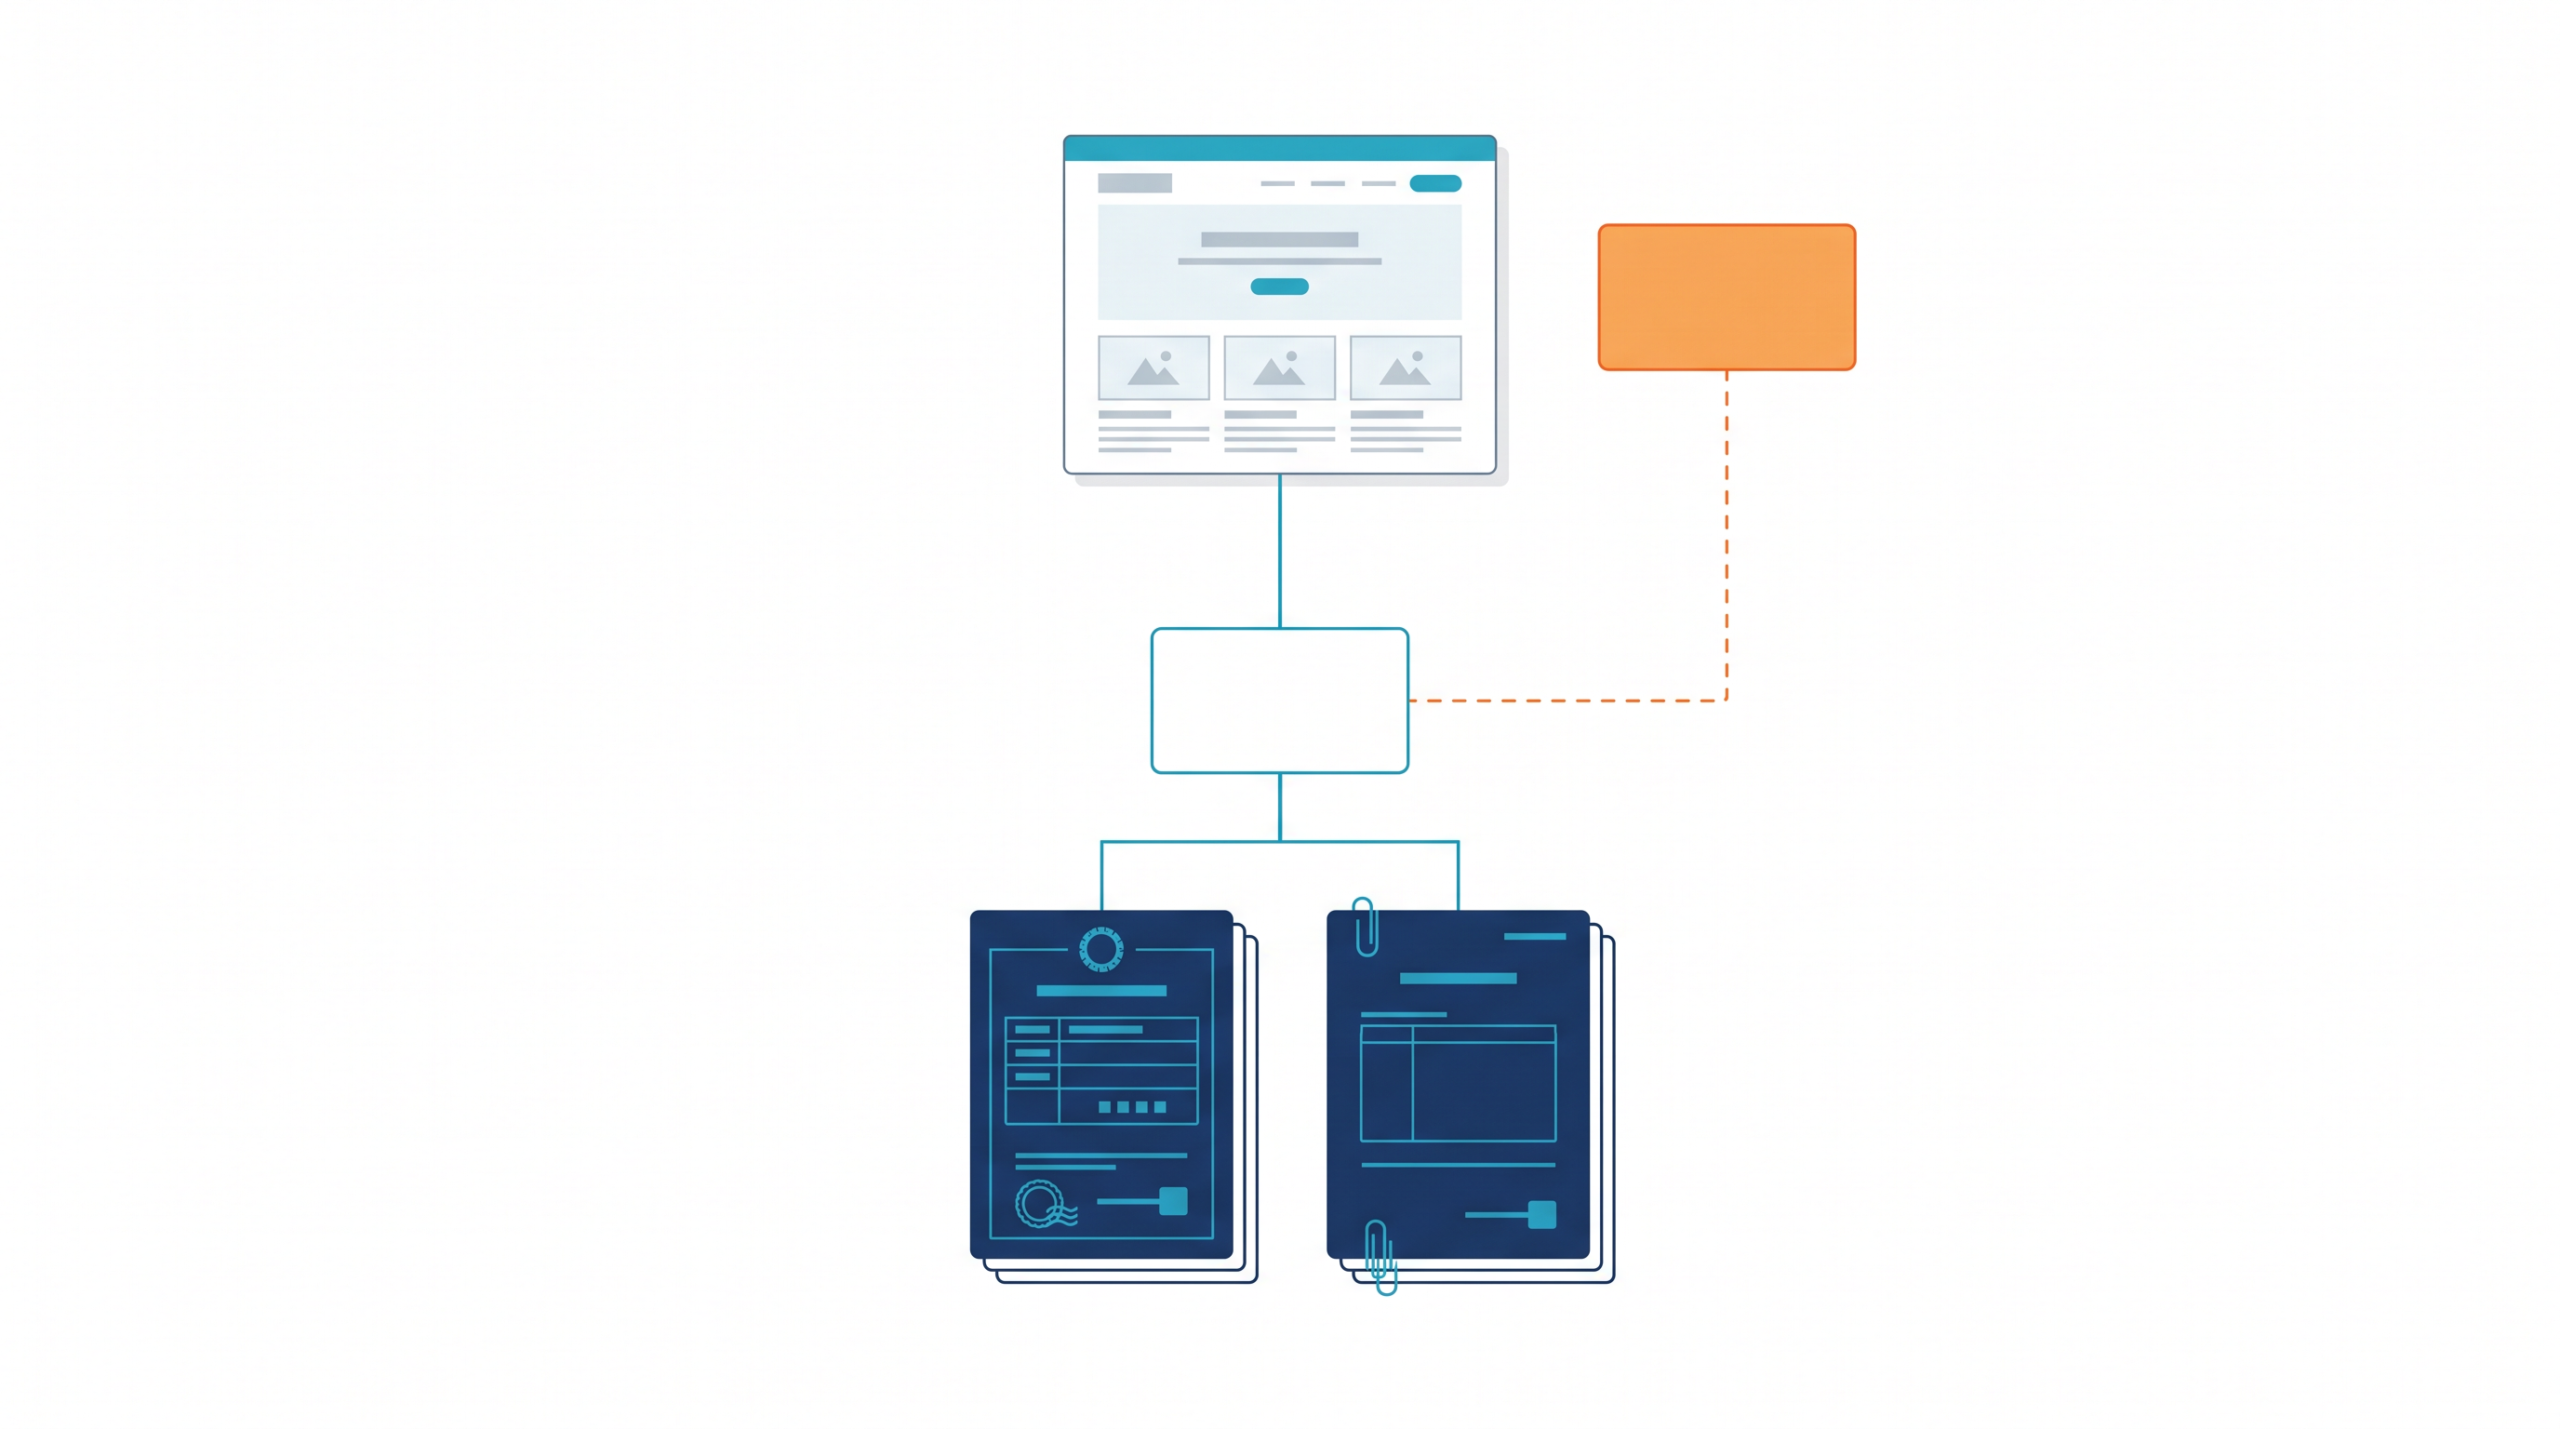
前の手順で集めた候補のリストがあっても、公式サイトの会社説明だけでは実際の法主体はわかりません。法的な主体が特定できなければ、後の資金調達や事業内容の比較が不正確になります。そのため、民間が提供するデータベースだけを見て断定するのではなく、各国の公的機関が提供する登記記録や提出書類を自ら検索して法人の存在を裏付けます。
調べる対象がイギリスの企業であれば、イギリスの公的機関によるCompanies House検索を使います。Companies Houseでは会社情報、SIC、状態、提出履歴、役員、担保、倒産情報などを確認できるため、法人が現在も存続しているかがわかります。
ヨーロッパ大陸の企業であれば、EU・EEAの企業登記を接続し、会社や国外支店の検索を可能にする仕組みであるBRISを利用して探します。また、アメリカの企業や、株式を公開している親会社などが関わる場合は、EDGARを利用します。
EDGARは公開企業などの提出書類、提出履歴、XBRLデータを検索・取得できる仕組みであり、企業の実態を確かめる手がかりになります。
この作業を効率よく進めるため、AIと手作業を組み合わせます。まず、候補となる企業の公式サイトから、利用規約やプライバシーポリシーといった運営元の情報が書かれていそうな公開ページの文章をコピーします。
このテキストだけをAIの入力画面に貼り付け、「この文章を運営している法人の正式名称と、記載されている登録番号や住所を抽出してください」と指示します。
大量の候補を調べる際、Companies Houseは公開情報をREST APIでも提供し、利用には認証が必要であるため、システムに認証情報を設定して自動化することも可能ですが、調査の初期段階では画面上で人が検索して確認する手順をとります。
AIが出力した正式名称の候補をもとに公的なデータベースで検索し、確認できた結果は手元に新しく作成した company_identity.csv というファイルに記録します。このファイルには「ブランド名」「登記上の正式名称」「法人登録番号」「登記国」の列を用意し、検索結果の画面を見ながら人が埋めていきます。
ただし、登記記録が存在するからといって、その企業の事業が順調であるとは限りません。公的記録であっても、Companies Houseは提出情報の正確性を検査していないと明示するように、登録されている内容が現在の実態をそのまま表している保証はありません。
登記情報の限界を理解し、あくまでその法人が法的に存在していることを確認するための手続きと割り切ることが必要です。事業が実際に動いているかどうかは、別の証拠を探して照合しなければなりません。
資金調達額と事業実態を別々に照合する
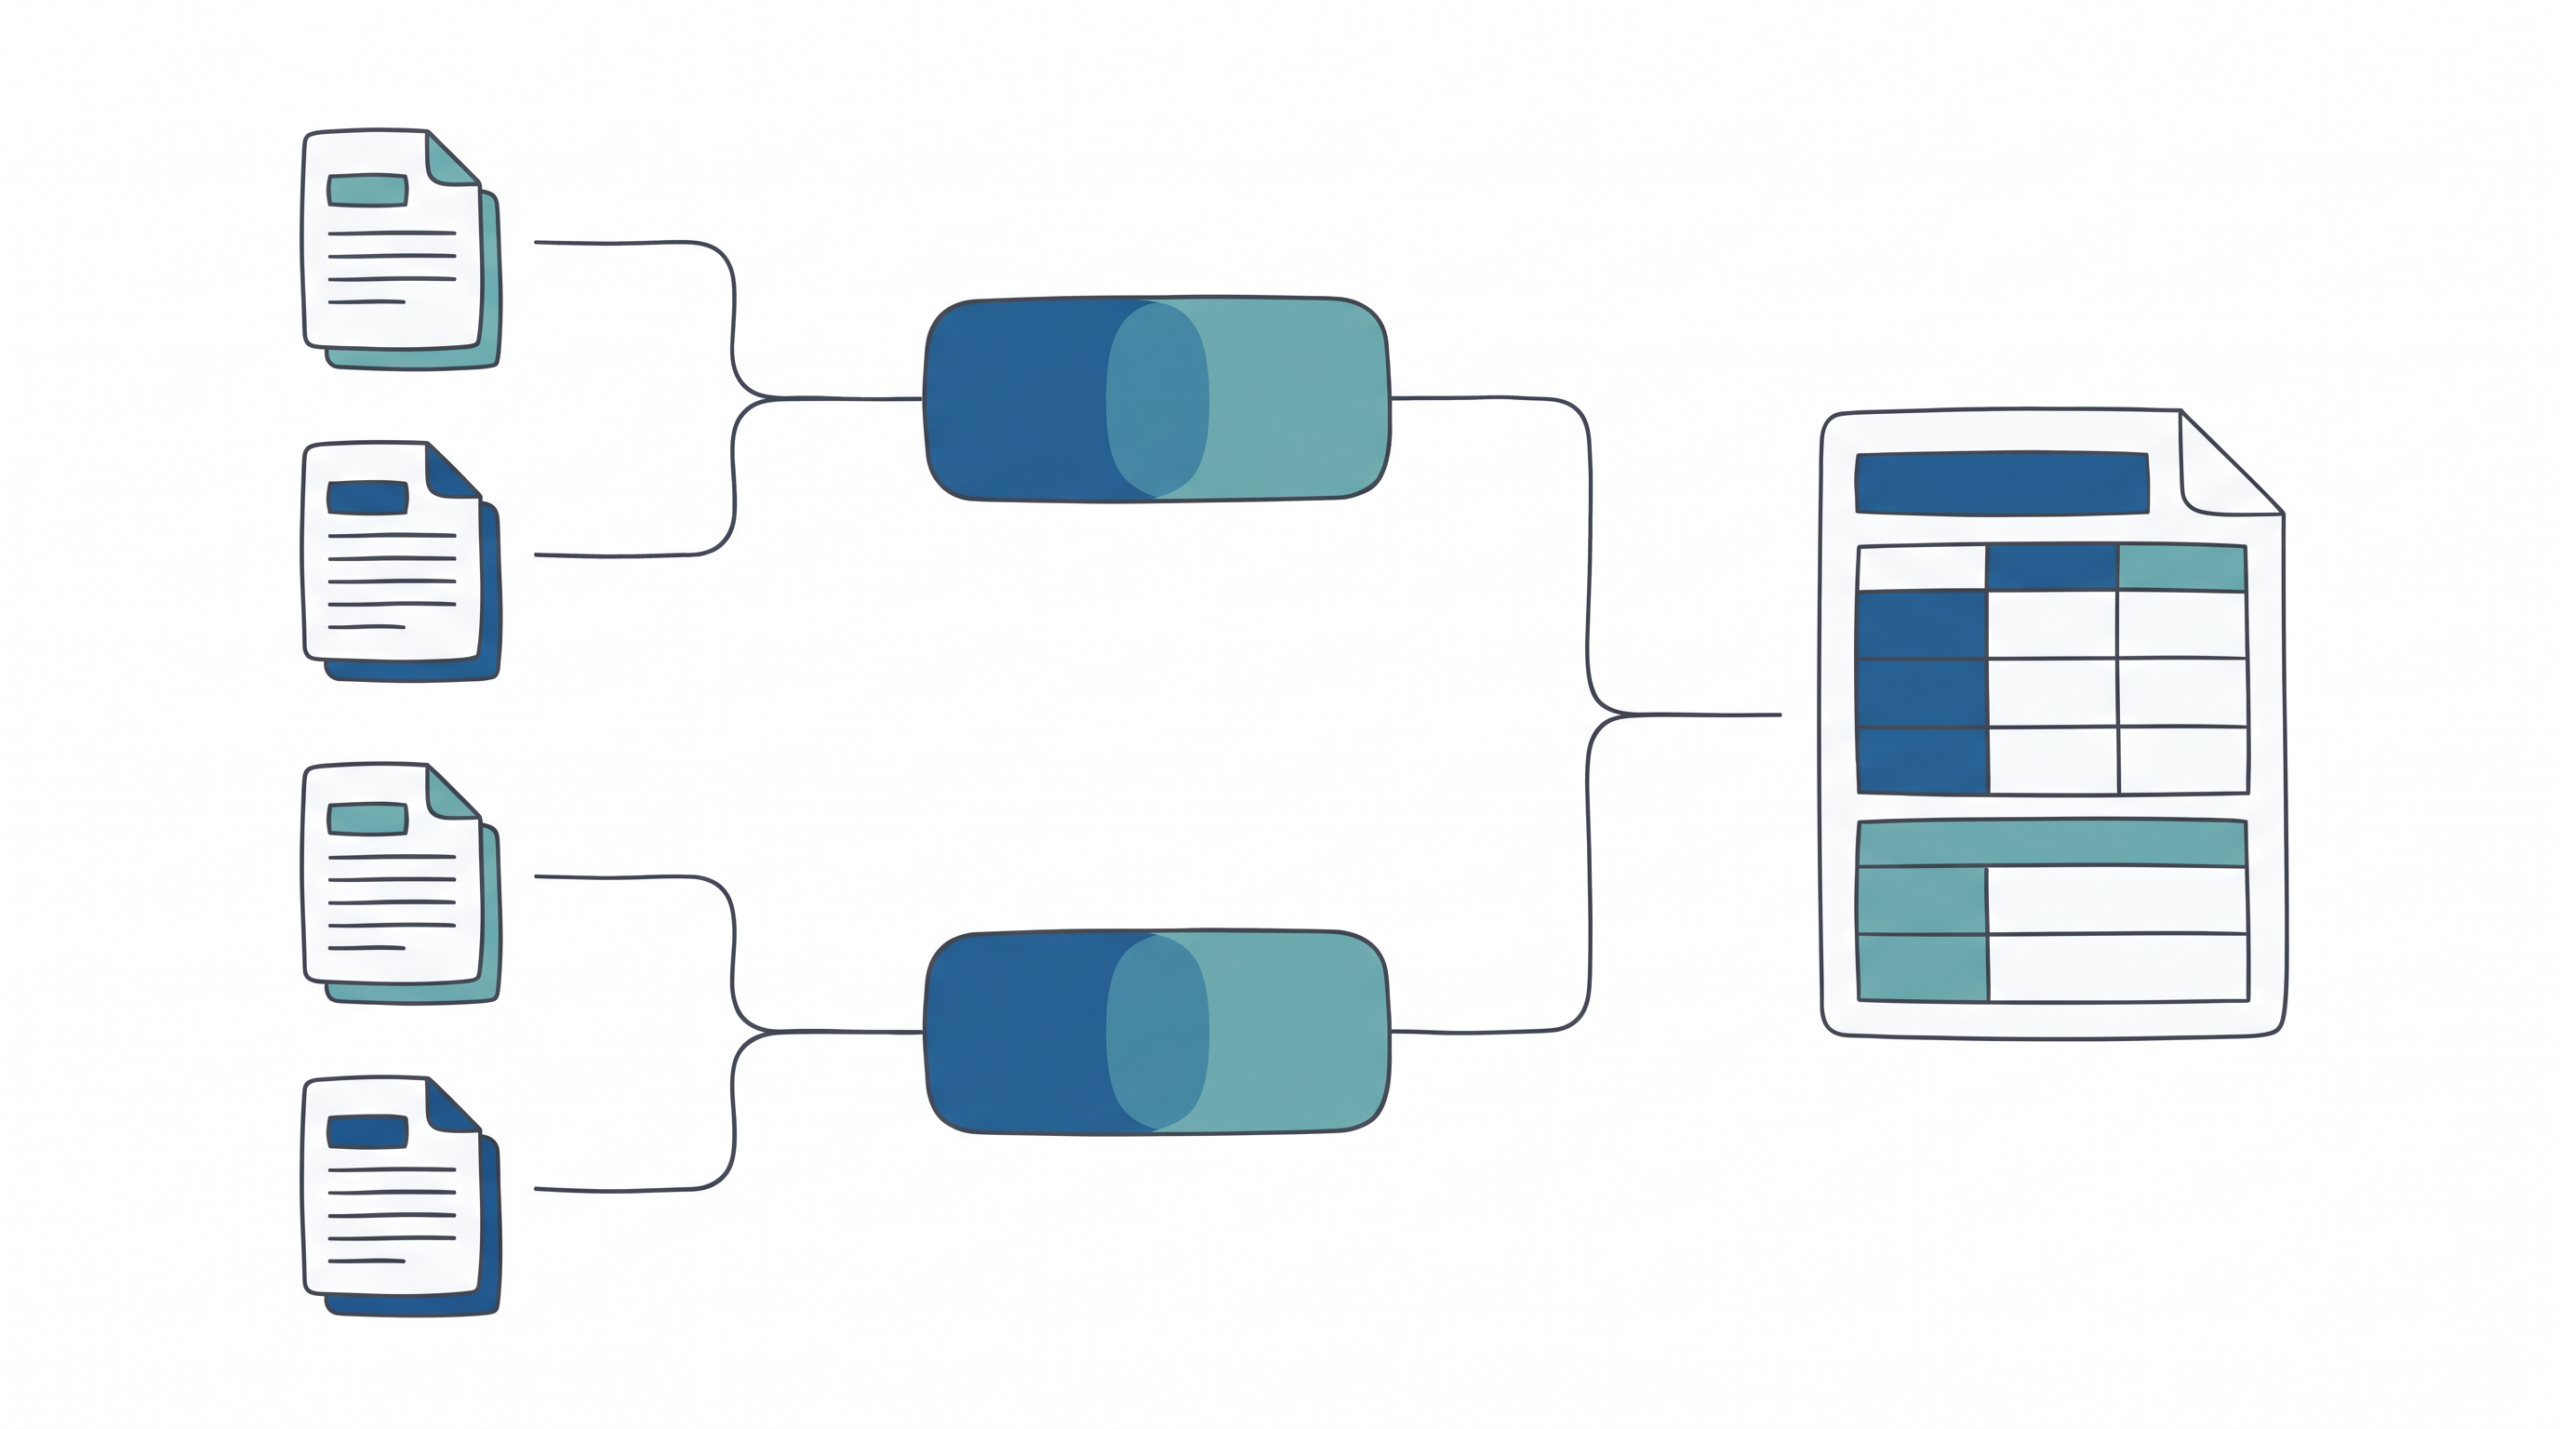
法人の存在が公的記録で確認できたら、次はその企業がアピールしている資金調達額や事業の導入実績が事実であるかを照合します。スタートアップ企業を調べる際、複数のニュース記事で同じ資金調達が何度も報じられることや、短い期間の実証実験にすぎないものを本格的な導入と誤って読んでしまうことがよく起こります。
このような金額や導入実績の二重計上と誤読を防ぐには、資金調達の記録と事業の稼働実態を別々に調べ、情報の発信元を整理することが重要です。
前の手順でも触れた通り、公的登記も事業説明そのものの正確性を保証しないため、事業の実態は自ら証拠を集めて判断する必要があります。民間が提供するデータベースの情報だけで断定せず、一次情報に当たります。
まず資金調達額の確認について説明します。手元の環境に funding-events.csv というファイルを作成し、「調達時期」「金額」「出資者」「発表主体と確度」「情報の出どころ」という列を用意します。
次に、企業や投資家が公開しているプレスリリースの文章をコピーしてAIの入力画面に貼り付け、「この文章から資金調達の金額、時期、出資者となる組織名を抽出してください」と指示します。
AIは文章から数値を拾い上げて整理しますが、同じ調達ラウンドについて企業側と投資家側の両方が別々の日に発表していると、AIはそれぞれを別の出来事として抽出してしまうことがあります。
ここで人が画面を見比べ、同じ出来事に対する別の発表ではないかを確認し、二重計上を防ぎながら funding-events.csv へ記録します。
さらに、アメリカに関連する企業であれば、証券取引委員会のEDGARでは会社名やCIKで会社を特定し、提出日や文書種別で絞り込めるため、未公開企業の資金調達に関する提出書類を探し、ニュース記事の記載だけでなく公的な記録とも金額を突き合わせます。
続いて、事業実態と導入実績の確認に移ります。製品が実際に売れて使われているかを確認するために、 evidence-matrix.csv というファイルを作成します。この表では、集めた証拠を「会社発表」「投資家発表」「提出書類」「顧客側資料」という証拠種別で分けます。
候補企業のウェブサイトにある導入事例や、顧客側が公開している事例紹介の公開テキストをAIに渡し、「この文章で説明されている製品の使われ方と、導入による具体的な成果の数値を抽出してください」と指示します。
AIが要約した内容を人が読み、それを evidence-matrix.csv に記録する際、それが誰の発言なのかという発表主体と確度を列として書き残します。
たとえば、自社のウェブサイトで「導入企業多数」と書かれているだけの会社発表よりも、顧客側の企業が自らの資料で「このシステムを導入して業務を改善した」と明記している顧客側資料のほうが、実際に事業が動いている確度が高いと判断できます。
このように、資金調達の出来事と事業の証拠をそれぞれ別のファイルに分け、AIの抽出結果をもとに人が発表主体と確度を評価することで、誇張や二重計上に惑わされることなく事業の実態を確かめることができます。
比較表には事実、主張、未確認を分けて残す
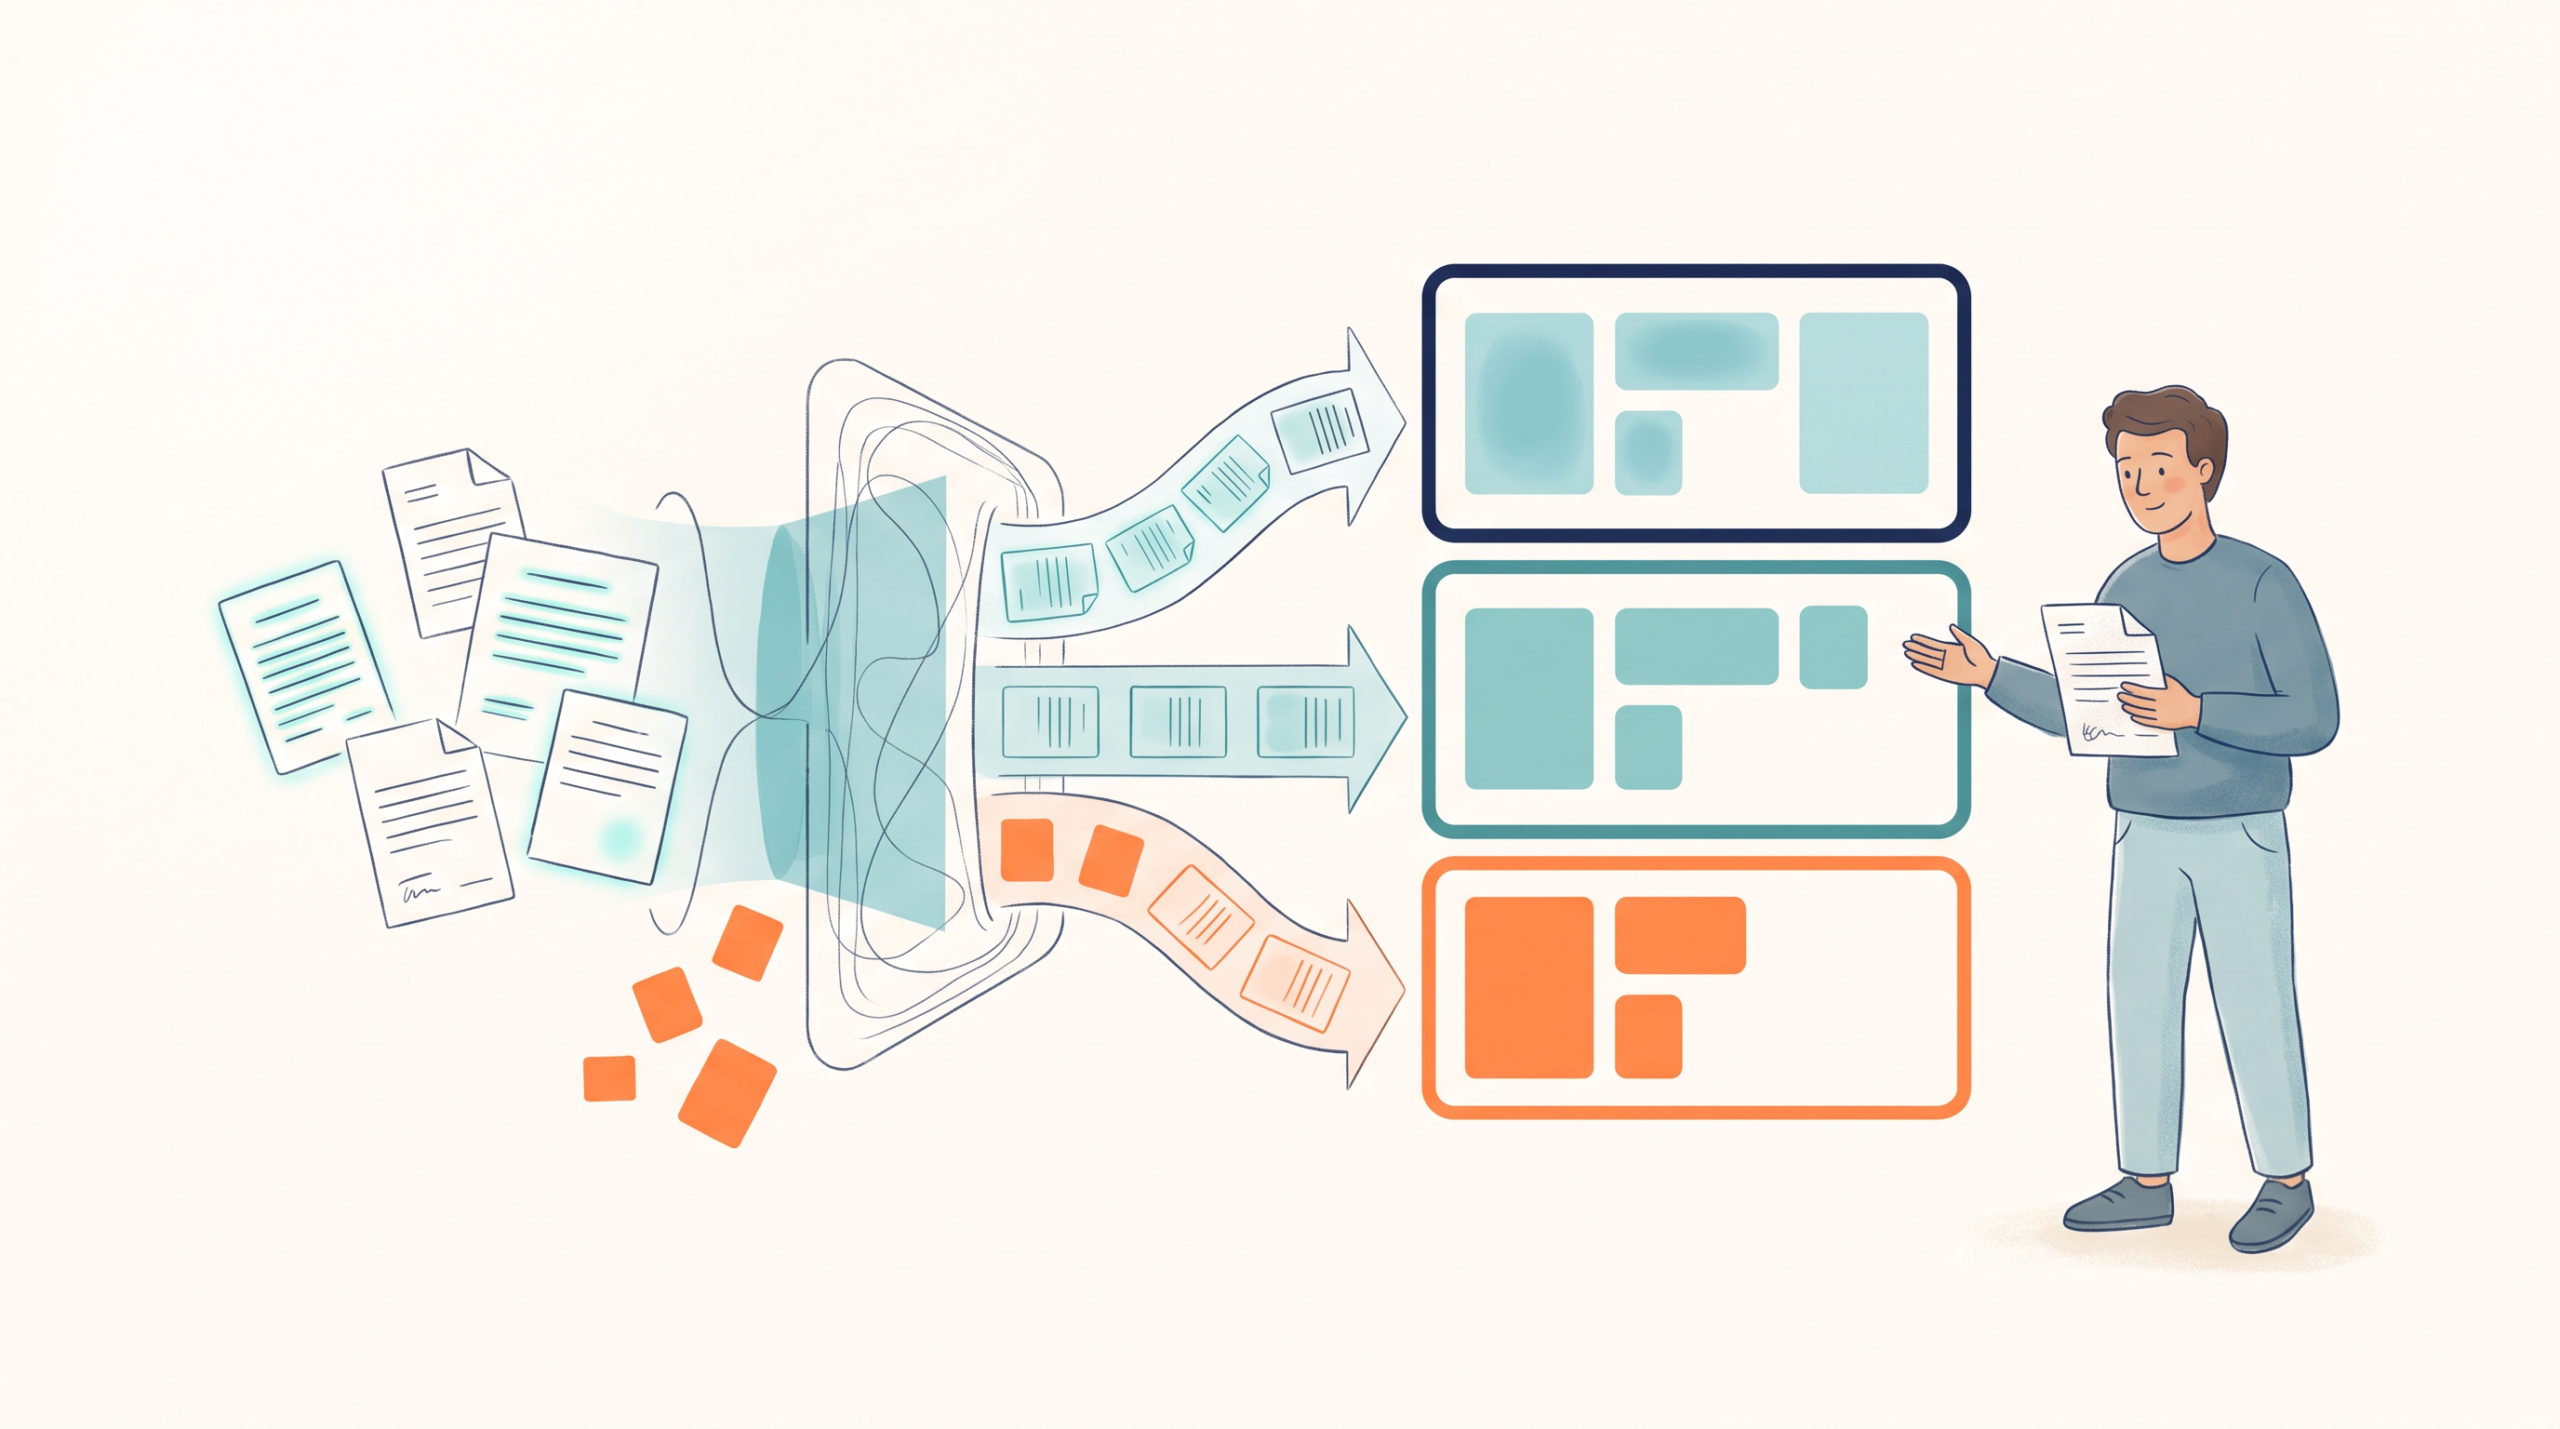
前段で作った evidence-matrix.csv に集めた個別の証拠を、意思決定に使える比較表へと仕上げていきます。複数の企業を同じ基準で比較するためには、単に情報を並べるだけでなく、その情報がどれくらい信用できるかを分ける必要があります。そこで比較表の中に情報の「状態」という列を新しく追加し、それぞれの項目を事実、主張、未確認の3つに分けて記録します。
たとえば、企業自身のウェブサイトに「業界で最も選ばれている」と書かれているだけの情報は、企業側の「主張」として扱います。一方、顧客の企業が自ら公開している事例資料や、公的な書類によって裏付けがとれた導入実績は「事実」として記録します。
いくら探しても根拠となる情報が見つからなかった項目については、空白にしておくのではなく「未確認」と明記します。このように分けることで、表を見たときにどの企業の実態が確かなのかがひと目でわかるようになります。
こうした情報を大量に整理するために、ここでもAIを活用します。ただし、AIとシステムを組み合わせて使うときは、権限とデータ送信の境界を明確に守ることが重要です。
たとえば、イギリスの企業情報を集める場合、Companies House APIはJSON形式のREST APIで会社情報を扱うため、プログラムから機械的にデータを取得することができます。
このシステムを利用する際、Companies House APIはAPIキー等の認証情報を要求し、APIキーはBasic認証のユーザー名として送る仕組みになっています。
AIに情報を抽出させる際、こうしたAPIキーなどの認証情報をAIの入力画面に貼り付けてはいけません。AIへ渡すのは、APIを通じて取得した公開情報のデータや、ウェブサイトから手動でコピーした公開テキストのみに限定します。その上で、「このJSONデータから、企業の設立日と役員の名前を抽出してください」と指示を出します。
AIは指定された公開情報の中から必要な項目を抜き出して画面に出力します。
AIが出力した結果をそのまま完成品とするのではなく、最終的に人が原典のデータと見比べて確認し、 evidence-matrix.csv の列に入力していきます。このとき、どのような手順で調べたのかという過程もあわせて記録しておきます。
手元の環境に research-log.jsonl というファイルを作成し、調査を行った日付、元にした公開情報のURL、AIに入力した指示文、そして人が事実か主張かをどう判断したかの理由を1行ずつ記録していきます。
成果物として evidence-matrix.csv の比較表と research-log.jsonl の作業記録がセットになることで、後から別の担当者が調査結果を見たときでも、なぜその企業が提携候補として残ったのかという比較と判断の経緯を辿ることができます。
AIに任せる情報の整理と、人が行う証拠の確認を切り分けることで、誰が読んでも納得できる信頼性の高い比較表を作ることができます。
更新トリガーを決めて調査を一度きりにしない
前節までで証拠を整理し、比較表として作り上げました。しかし、スタートアップ企業の状況は日々変わるため、作成した直後から表の内容は古くなり始めます。企業状態の変化をどう追うかという問題を解決しなければ、せっかくの調査が一度きりのものになってしまいます。
これを防ぐため、 evidence-matrix.csv に「次回確認日」という列を追加し、いつ見直すのかという運用を成果物の中に組み込みます。
次回確認日を待つだけでなく、企業側に動きがあったときに気づく仕組みも用意します。イギリスの企業を例に挙げると、Companies Houseでは企業情報を無料で確認でき、更新時のメール通知も設定できる仕組みが用意されています。
この機能はCompanies House Followと呼ばれ、対象の企業が新しい書類を提出したり、役員が変更されたりしたときにメールで通知を受け取ることができます。このような公的機関の通知機能を更新トリガーとして設定しておけば、すべての企業を毎日手作業で見に行く手間を省くことができます。
ただし、新しい登記書類が提出されたという通知があったとしても、その企業の実態が健全であるとは限りません。公的な記録であっても、登記情報は提出者由来であり、正確性を登記機関が保証するものではないからです。
登記が更新されたという事実だけをもって事業が順調だと判断するのではなく、新しい情報が出たことをきっかけとして、実際の事業に変化がないかを調べ直すための合図として扱います。
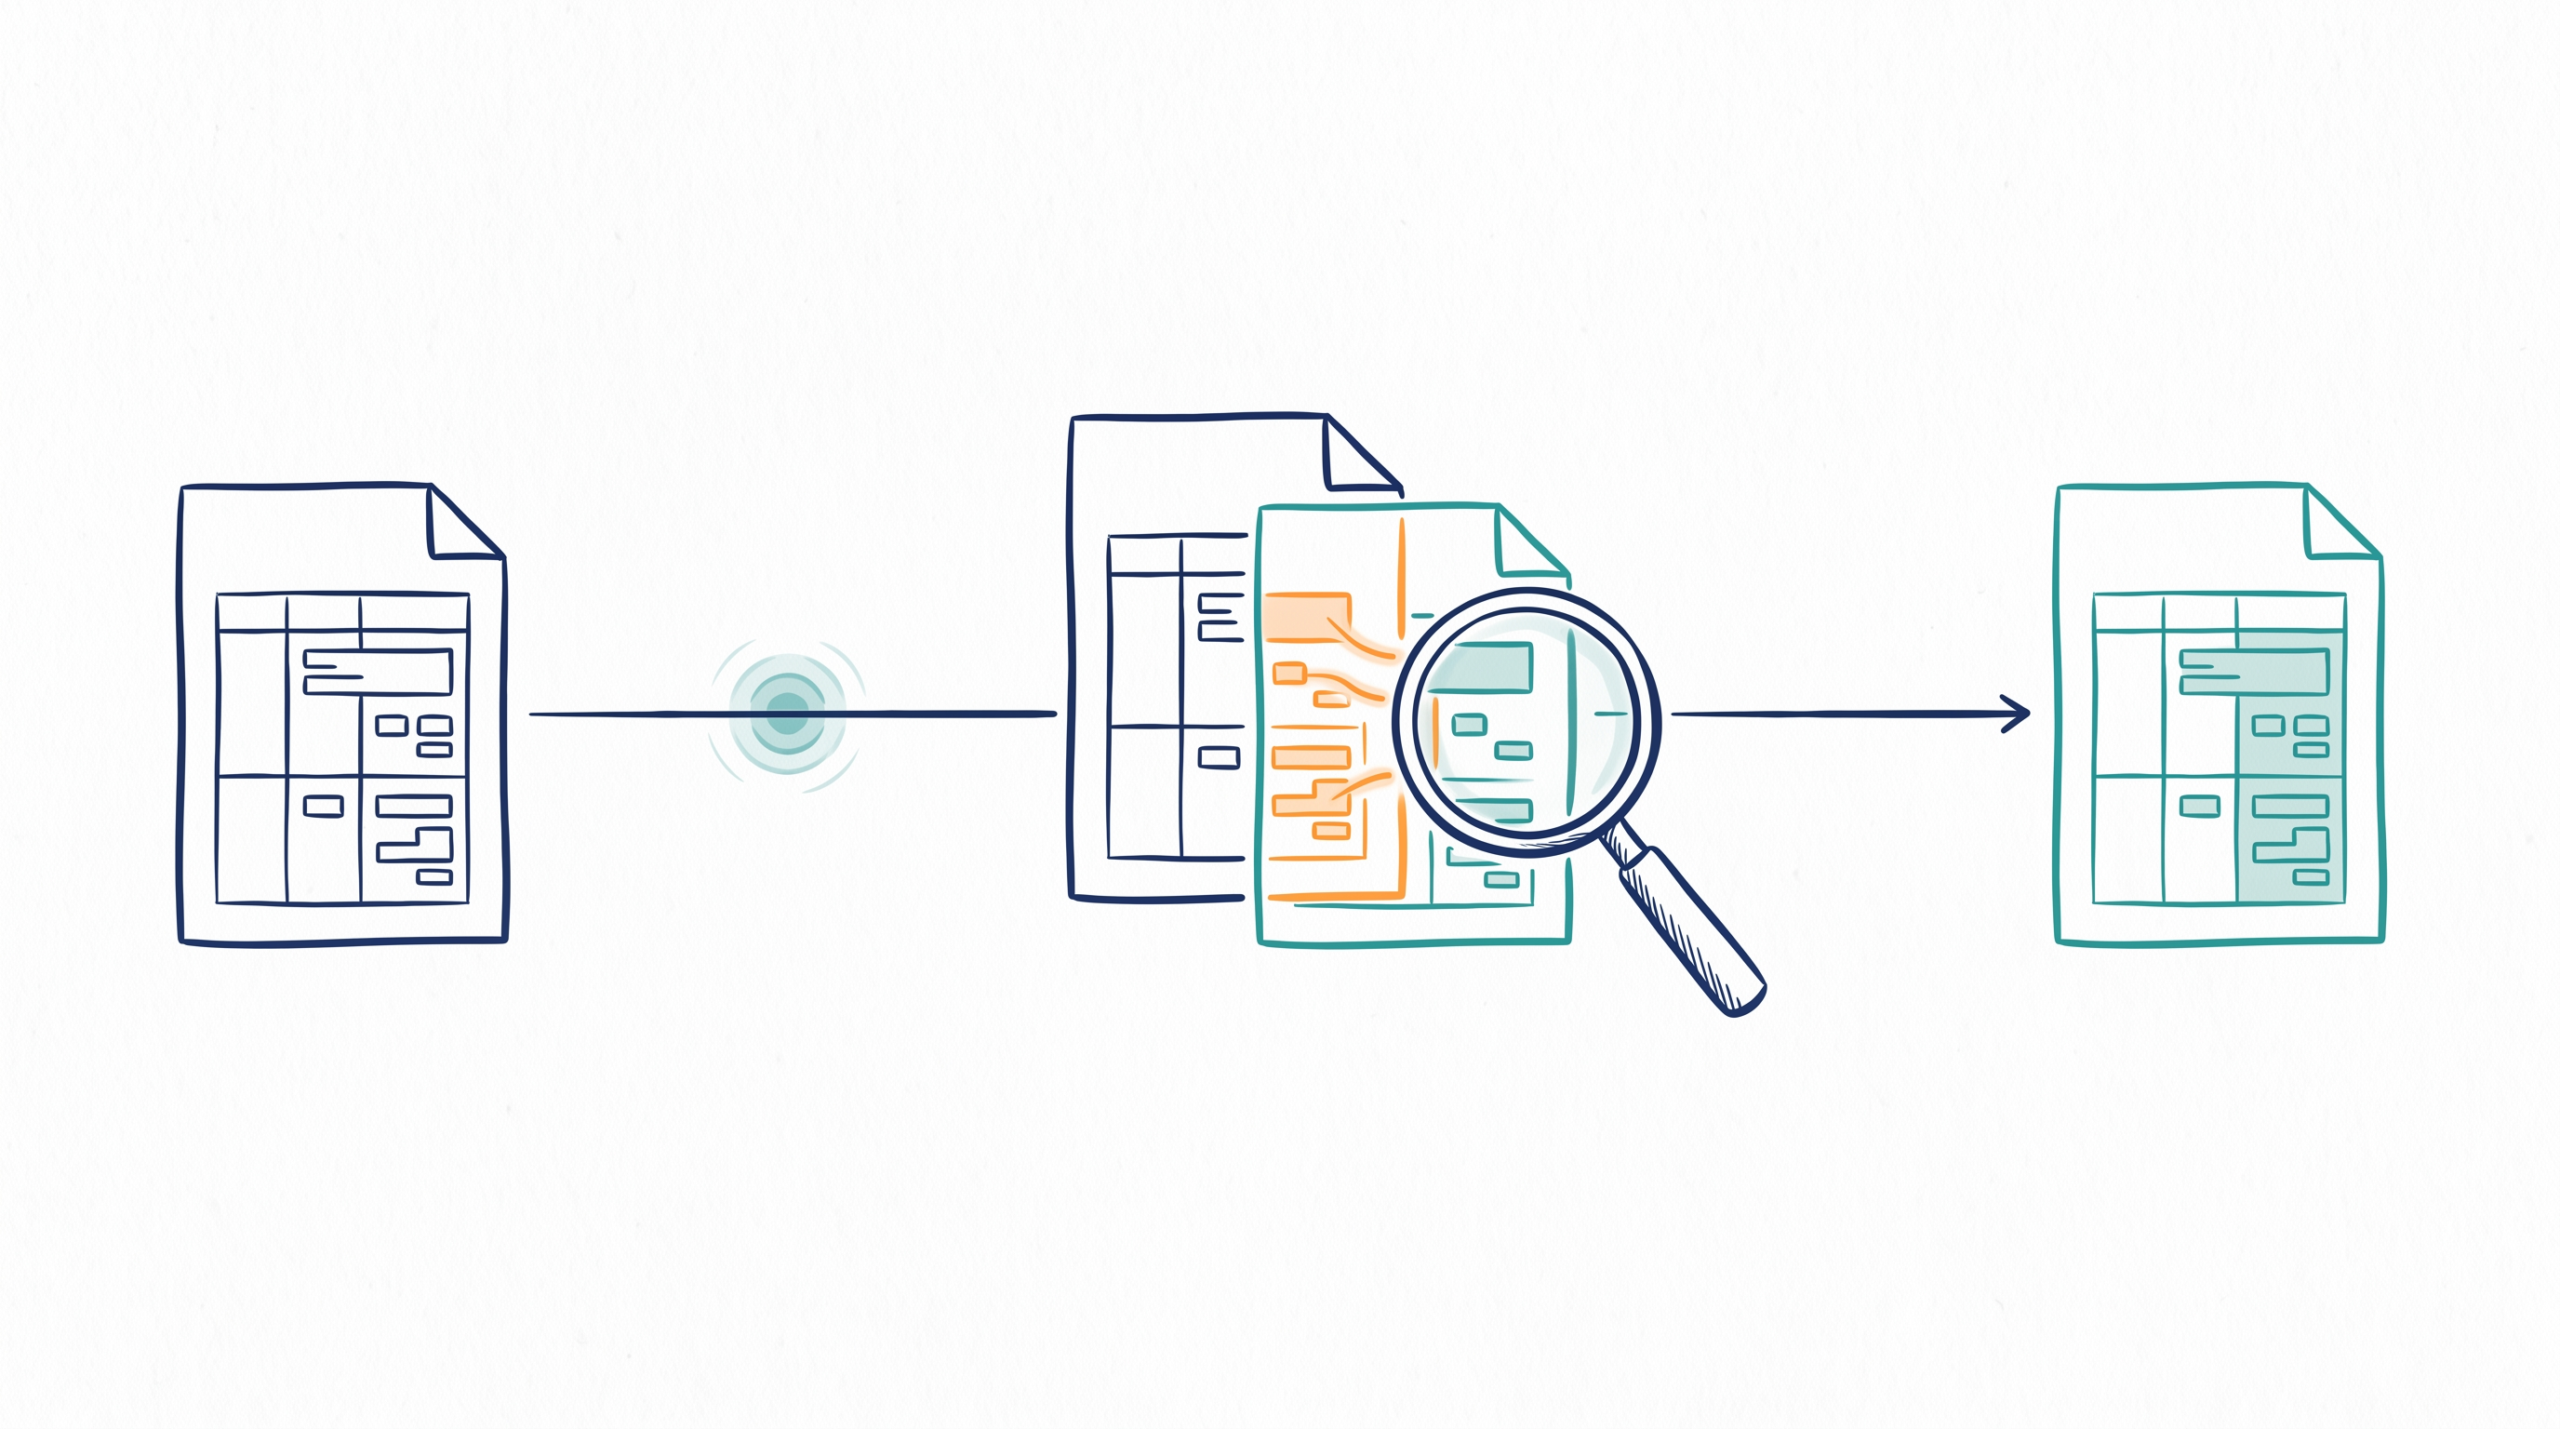
更新トリガーが働き、企業に何らかの動きがあったとわかったら、AIによる差分抽出と人の再確認を行います。まず、前回の調査時に research-log.jsonl へ記録しておいた公開情報のテキストと、現在のウェブサイトやニュースリリースから新しく手動でコピーしたテキストを手元に用意します。
これら二つの公開テキストだけをAIの入力画面に貼り付け、「過去の文章と現在の文章を比較し、サービスの機能、導入企業数、経営陣の構成に関する差分を箇条書きで抽出してください」と指示を出します。
AIが画面に出力した差分の一覧を見て、それを人が原典となる公開情報と見比べます。前回は「開発中」という企業側の主張だったものが、今回は顧客側の事例発表による「事実」へ変わっているかなどを再確認します。
この人が判断した結果をもとに、 evidence-matrix.csv の該当する列を上書きし、 research-log.jsonl には更新した日付と理由を追記します。
このように、更新トリガーとなる次回確認日や通知の設定と、AI差分と人の再確認という手順を組み込むことで、比較表が常に新しい状態に保たれ、変化を見逃さずに提携候補の調査を続けることができます。
よくある質問
Q1. 無料でどこまで海外スタートアップを調査できますか
公的な機関が提供する情報は、その多くが無料で調べられます。たとえばイギリスの企業を調べる場合、Companies Houseの検索画面を使うことで、企業情報を無料で確認でき、更新時のメール通知も設定できる仕組みが利用可能です。
調査の初期段階では、company_identity.csvの登記国や法人登録番号の列を埋めるために、無料の公的データベースを人が画面で確認し、法人の存在を確かめる判断を行うことができます。
Q2. 民間データベースにある情報をそのまま比較表に入れてもよいですか
民間のデータベースに書かれている情報だけで断定してはいけません。データベースに未登録の企業が漏れたり、最新の社名変更が反映されていなかったりするためです。民間データベースの画面で見つけた情報は、一度candidate-companies.csvの推定される法人名という列に記録します。
その後、その情報をAIへ渡して整理させ、最終的には公的な提出書類や顧客側資料など別の公開情報と見比べて、人が原典を確認する判断場面を必ず設けてください。
Q3. 登記記録が見つからない企業はどう扱えばよいですか
公的なデータベースの検索画面で登記が見つからない場合は、company_identity.csvの登記上の正式名称の列を未確認として記録して残します。また、登記が見つかったとしても、公的登記も事業説明そのものの正確性を保証しないことに注意が必要です。
登記が見つかったかどうかにかかわらず、evidence-matrix.csvで企業側の主張と裏付けのある事実を分ける判断場面を省略せず、事業の実態を自ら確かめる手順を続けます。
Q4. 資金調達額がニュース記事ごとに違う場合はどう整理しますか
金額や時期が記事ごとに異なる場合は、funding-events.csvの情報の出どころという列と、発表主体と確度という列を使って整理します。まず、企業側の公開テキストと投資家側の発表テキストをそれぞれ別々にAIの入力画面へ貼り付け、金額や時期を抽出させます。
AIが出力した数値を人が画面で見比べ、同じ調達に対する別の発表ではないかを確認する判断を挟むことで、資金調達額の二重計上を防ぎます。
Q5. APIを使って取得したデータはどのようにAIへ入力すればよいですか
APIを利用して取得したデータをAIへ渡すときは、認証情報をAIの入力画面に貼り付けないようにします。たとえばイギリスの企業情報を取得する際、システムはAPIキー等の認証情報を要求し、APIキーはBasic認証のユーザー名として送る仕組みになっています。
AIへ入力するのは、API経由で取得した公開情報のJSONデータやウェブサイトのテキストのみに限定し、AIの抽出結果を人が確認してからevidence-matrix.csvの各列へ入力する判断を守ってください。
Q6. 比較表はどのくらいの頻度で更新すればよいですか
すべての企業を毎日手作業で調べる必要はありません。evidence-matrix.csvに用意した次回確認日の列で定めた日や、公的機関からの更新通知を受け取った日を更新のきっかけとします。
通知を受け取ったら、過去にresearch-log.jsonlへ記録したテキストと、最新の公開テキストの両方をAIの入力画面へ貼り付け、差分を抽出させます。AIが抽出した変化を人が元のウェブサイトの画面で再確認し、比較表の列を上書きする判断を行います。
調査手法について
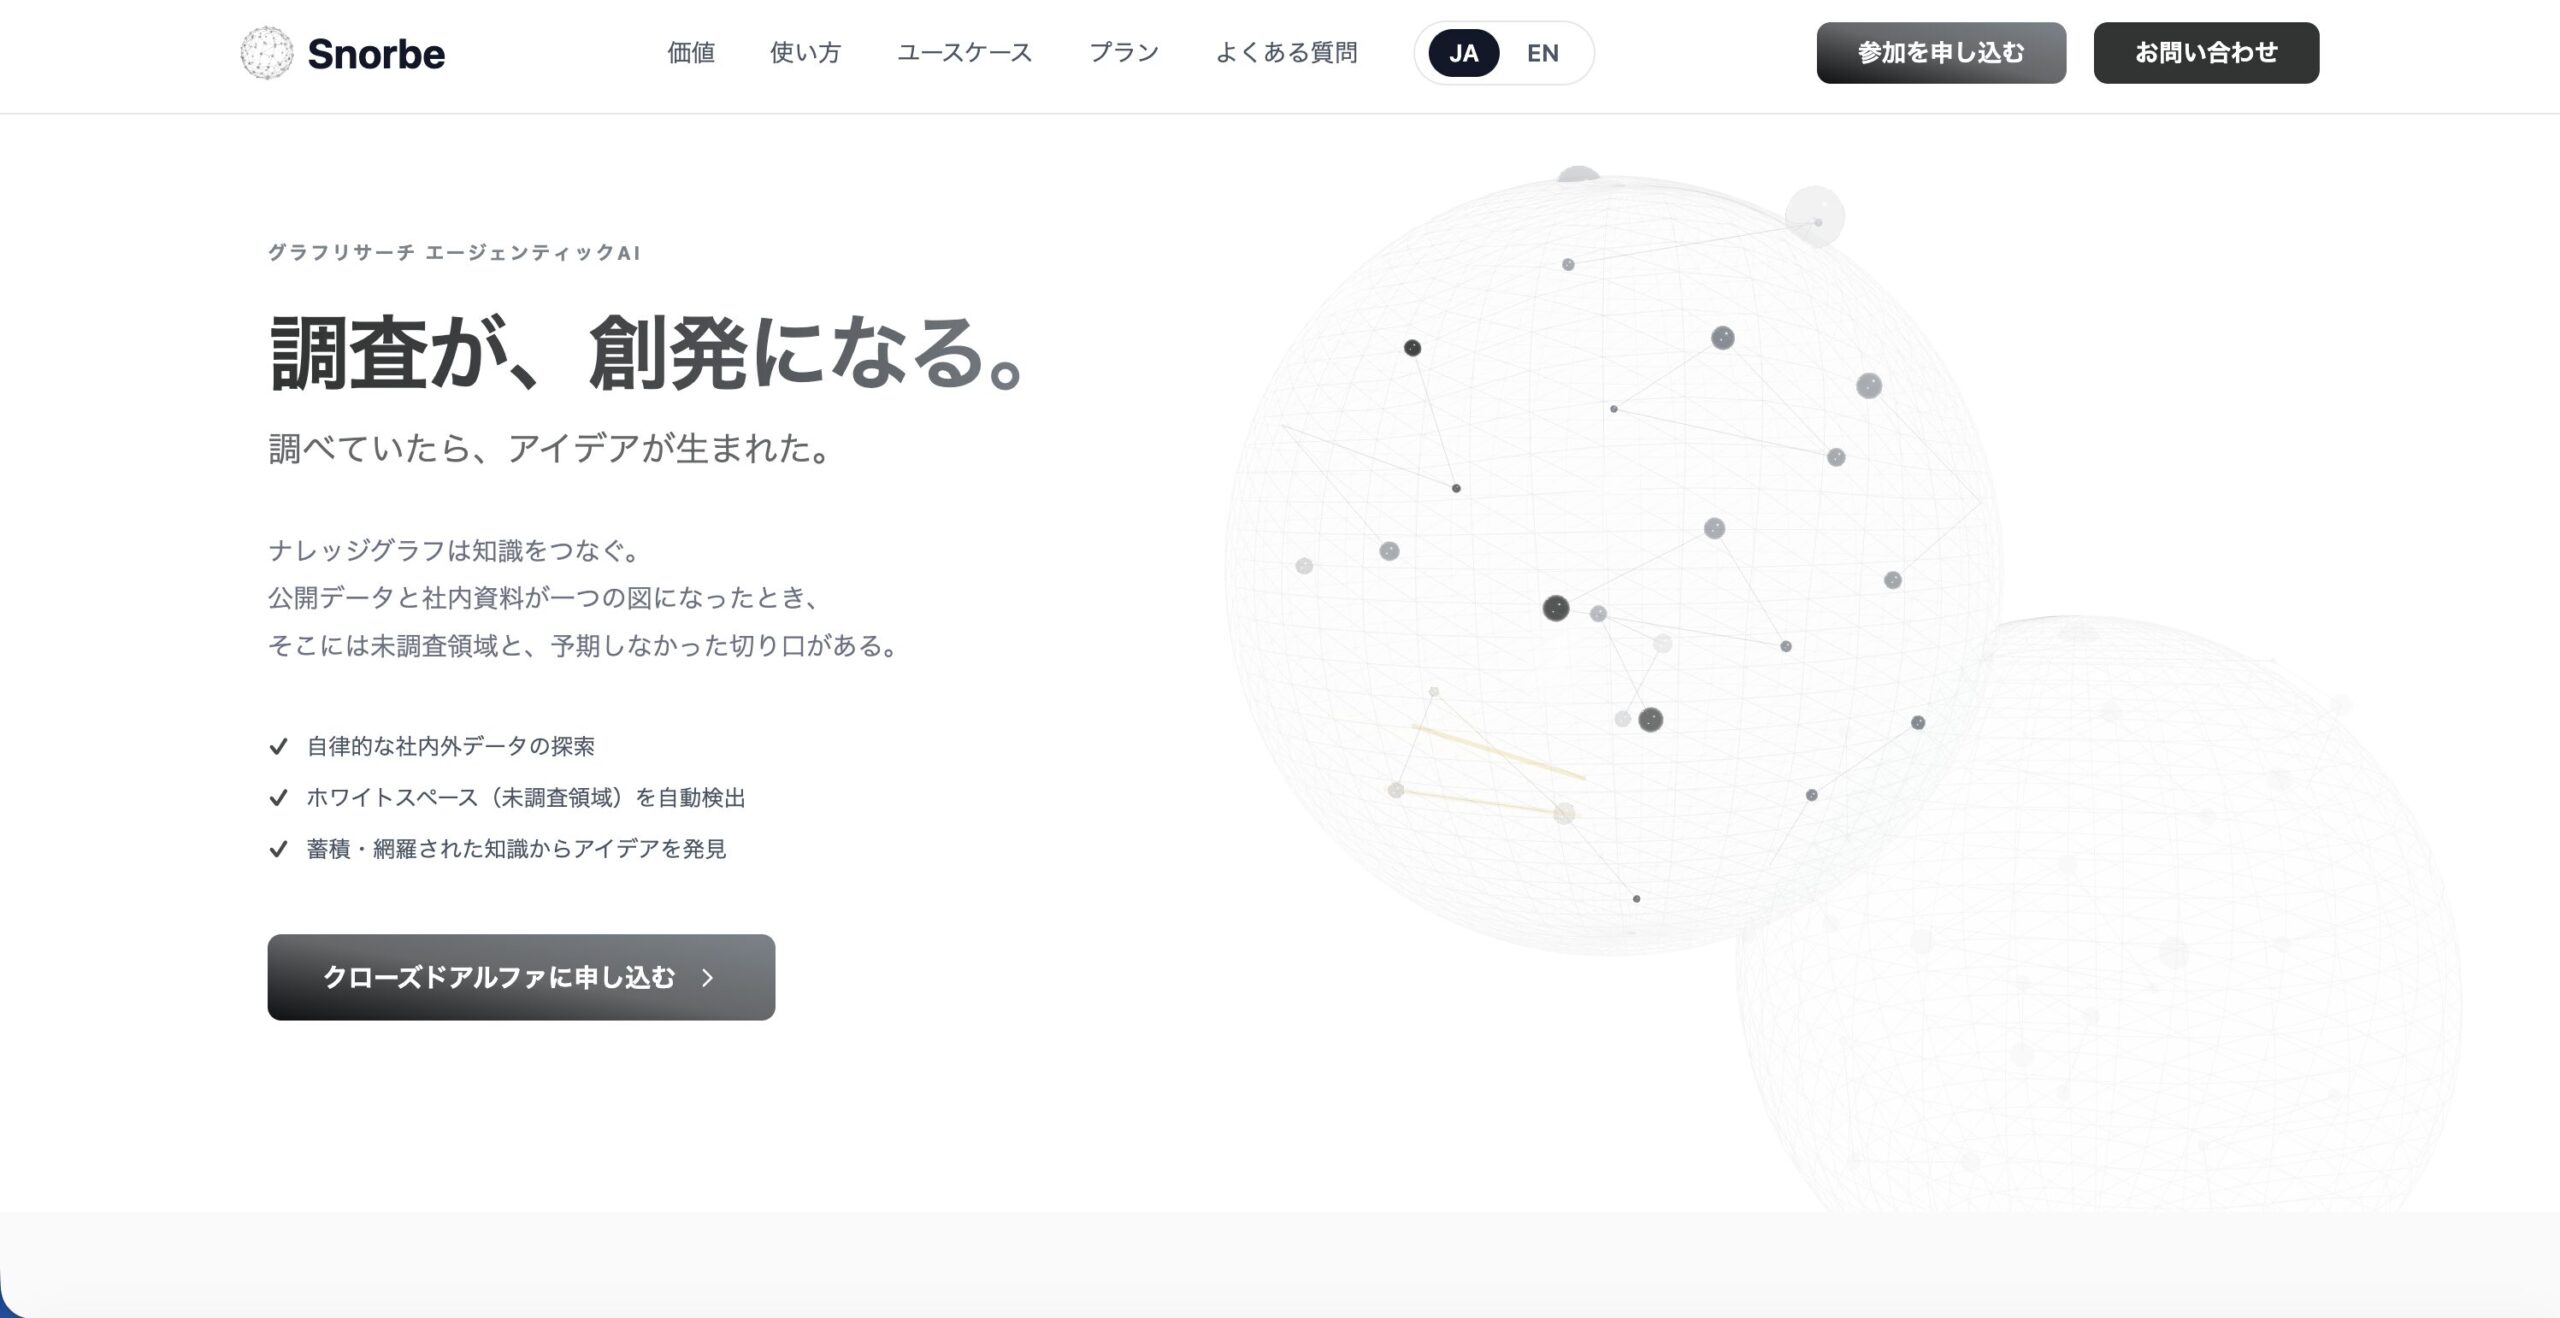
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント