OpenAIがミレニアム懸賞問題の1つ「ナビエ・ストークス問題」に関する新しい研究結果を発表したことで、AIが数学の難問を解いたという話題が広がっています。結論から言えば、今回示されたのは数学界の注目を集める有力な解決候補であり、証明として正式に認定されたわけではありません。
Clay数学研究所のルールでは、適格な媒体での公開から2年以上の検証期間や専門家の審査が必要とされており、現在も公式には未解決問題として扱われています。
この研究成果において重要なのは、「AIが解いた」という一言で終わらせず、どのモデルが何を担当したのかを正しく見ることです。数式の計算を進め、解析的な証明を組み立てたのは未公開の内部モデルであり、約1万のAIエージェントが約88時間にわたって並列して探索を続けました。
一方で、最新モデルとして知られる「GPT-6 Astra」は、その作られた証明をプログラミング言語(Lean)の形式に書き換えて機械検証する作業を担当しています。
また、AIが他の研究者の未公開データを盗用したのではないかという疑問の声も上がっています。ある数学者が個人的な共同研究の草稿をモデルに入力したことは事実ですが、それが今回のナビエ・ストークス問題の証明に直接使われたかは分からず、告発でもないと述べています。
OpenAI側は、別の研究成果の噂を聞いてこの問題に資源を集中させたことは認めつつ、発表前2か月に別の研究者が入力したデータがAIの学習や内部モデルに影響を与えることはなかったと自己調査の結果を報告しています。ただし、外部の独立した監査結果は未公開のままです。
このようにAIによる科学研究が急速に進む中、私たちは新しい技術の成果と課題を冷静に見極める必要があります。ここからは、OpenAIが水の流れを示す方程式の何をどうやって解こうとしたのか、情報漏えいの疑惑に関する事実関係はどうなっているのかを整理します。
そのうえで、研究者や企業の担当者が自分の機密データを安全に扱うために、どのようなAI環境と検証方法を選ぶべきなのかを順番に考えていきましょう。
結論|OpenAIは有力な解決候補を公開した
ニュースなどで大きく取り上げられている「OpenAIがミレニアム懸賞問題を解いた」という話題について、現在どこまでが事実として確認されており、どこからがこれからの検証待ちであるのかを整理します。
OpenAIは2026年9月8日、数学における世紀の難問の一つである「3次元非圧縮ナビエ・ストークス方程式」について、ある特定の答えを見つけたと発表しました。
彼らが主張しているのは、初期速度がゼロであり、エネルギーが有限のままであるにもかかわらず、滑らかな外力が加わることで特定の時刻である「時刻1」に流体の速度が無限大に発散してしまう「反例」を構成したというものです。
クレイ数学研究所が公開している公式の問題文を見ると、この問題にはいくつかの選択肢が明記されています。OpenAIは、その中の「滑らかな外力を許した反例」にあたる条件である問題Cおよび問題Dに対する解決策を提示したとしています。つまり、OpenAIは公式問題文が認める条件に沿って反例を組み立て、その証明を公開した状態です。
しかし、この発表をもって「ミレニアム懸賞問題が正式に解かれた」と結論づけることはできません。なぜなら、数学の証明として認められるための道のりはまだ始まったばかりだからです。
クレイ数学研究所が定める賞の規則では、正式な解決と認定されるために複数の厳格な手順が設けられています。第一段階として、適格な学術媒体を通じて論文として内容が公開される必要があります。第二段階として、公開から2年以上の期間をかけて、世界中の数学者による徹底的な検証を受けます。この過程で、論理の飛躍や誤りがないかが入念に調べられます。
第三段階として、数学界全体でその証明が正しいと一般的に受け入れられる状態にならなければなりません。そして最終段階として、研究所による審査を経て、初めて正式な認定に至ります。
実際に、2026年9月12日時点でのクレイ数学研究所の問題一覧を確認すると、ナビエ・ストークス問題は依然として未解決のまま表示されています。
現状を正確に表現するならば、Leanによる形式検証を通過した有力な解決候補が提出された段階と言えます。AIが提示した成果物が数学的に本当に正しいのか、人間の手でどこまで確認できるのか、数学者たちがこれから点検していくプロセスが待っています。
では、AIが膨大な計算資源を費やして挑み、世界中の研究者が長年証明できなかったナビエ・ストークス問題とは、一体どのようなものなのでしょうか。発表の現在地を把握したところで、次はこの問題が何を問うているのか、なぜそれほどまでに難しいのかを身近な現象から理解していきます。
ナビエ・ストークス問題を水の流れから理解する
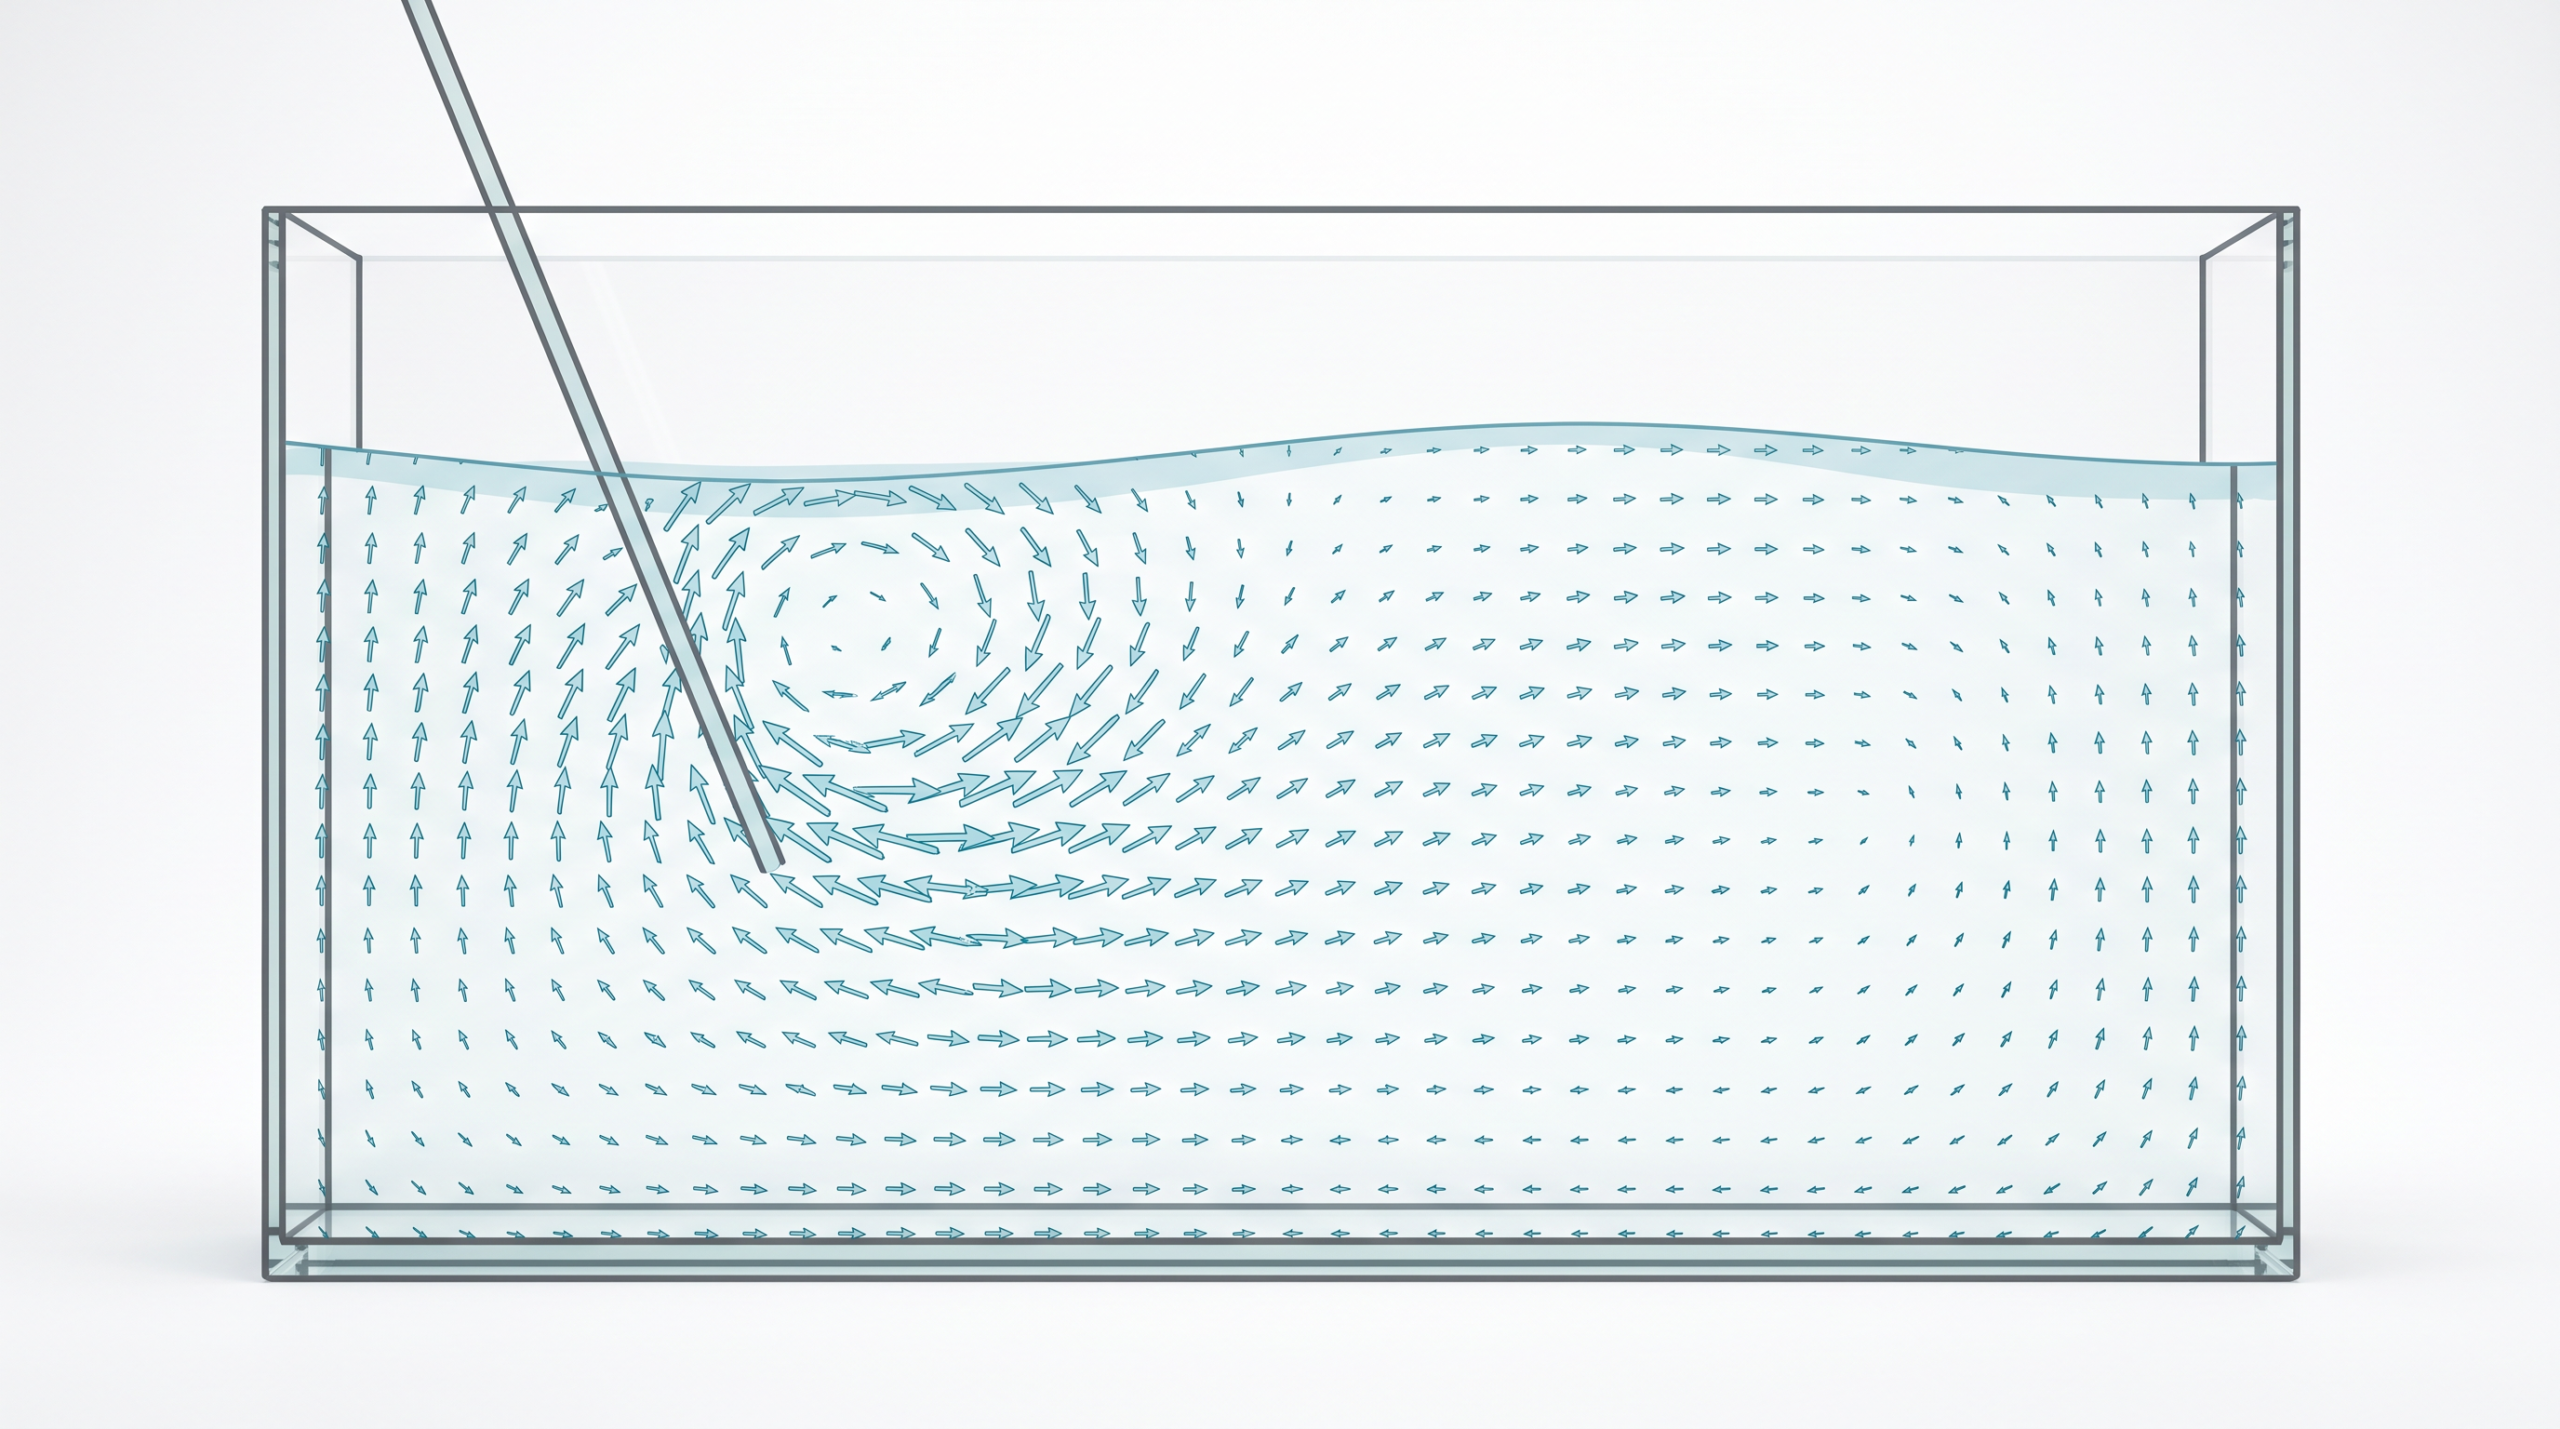
私たちが日々目にする川の流れや、空を吹く風の動き。ナビエ・ストークス方程式は水や空気などの流れを記述するための数学の道具です。物理学や工学の世界では、天気予報から飛行機の設計まで幅広く使われていますが、数学の視点から見ると、この方程式にはまだ解明されていない根本的な謎が残されていました。
この方程式が何を表しているのか、透明な水槽に入った水の動きを例に想像してみます。 水槽の中のすべての場所に、水の動く向きと速さを示す「速度の矢印」と、水が周囲を押す「圧力の数値」が置かれていると考えます。計算を進めるための未知数は各場所と時刻の速度uと圧力pであり、時間が進むにつれてこれらがどう変化していくかを導き出すのがこの方程式の役割です。
矢印の変化を決める要因はいくつかあります。第一に、現在の流れがその先の水を押し流していくという性質があり、これは時間が経つほど動きが複雑に絡み合う原因になります。第二に、シロップのように動きを引き止める粘り気です。第三に、周りの水同士が押し合う圧力があり、第四に、外から水槽を揺らしたり棒でかき混ぜたりするような外からの力があります。
方程式の中では、これらの時間変化、流れが自分を運ぶ非線形項、粘性、圧力、外力が釣り合いを保っています。 さらに、水はギュッと押しても体積が縮まないため、非圧縮条件では流入分と流出分が釣り合うという前提も満たさなければなりません。
この釣り合いの計算は、スーパーコンピューターを使えばある程度の近似値を出すことができます。しかし、数学が求めているのは近似値ではなく、条件を満たす限りどんな状況でも計算が破綻しないかという厳密な証明です。 懸賞問題としての核心は、極端な現象が起きないかどうかの確認です。
最初は矢印の長さや向きがきれいな状態からスタートしたとき、滑らかな初期状態から全時刻で滑らかな解が続くか、有限時間で滑らかさが壊れる反例があるかという点が問われています。
滑らかさが壊れるとは、ある時刻に近づくにつれて、水槽のどこかで速度の矢印が際限なく長くなるような数学上の破綻を意味します。現実の流体で同じ現象がそのまま起きると示す話ではありません。もし滑らかさがずっと続くならその仕組みを証明し、壊れるならその反例を示すことが、この問題のゴールです。
人間の研究者は長年、どちらが正しいのか見当をつけながら証明の糸口を探してきましたが、決定的な答えには届いていませんでした。今回、OpenAIは公式問題文の条件をAIへ与え、複数の解法を探索させることで、計算が破綻する反例を一つの証明として提示したと主張しています。
では、速度が無限大になるような現象を人為的に起こすため、AIはどのような条件を組み立てたのでしょうか。次は、細い渦などを組み合わせたという反例の作り方を、数式を使わずに追っていきます。
細くなる渦と振動パルスで反例を組み立てた
OpenAIが発表した論文では、特定の条件のもとで水の速度が無限大になってしまう「反例」をどのように組み立てたのかが記されています。論文の中心となる主張は、最初は水が完全に止まっている状態からスタートし、全体のエネルギーが有限に保たれているにもかかわらず、「時刻1」という特定の瞬間に水の最大速度が無限大へと発散してしまう解を構成したというものです。
速度が無限大になる現象を人工的に作り出すために、彼らは水の中に特殊な渦の動きを想定しました。それは、同じ形を保ったままどんどん小さくなっていく渦です。この渦が内向きに巻き込みながら軸の方向へ細く伸びていくことで、流れる速度が極端に増幅されていく仕組みを利用しています。
しかし、ただ細くなる渦を置くだけでは、問題の条件をクリアできません。数学のルール上、渦の動きに合わせて外から加える力も計算しなければなりませんが、渦だけを想定した計算では、外力の形が滑らかにならず、荒くてギザギザした部分が残ってしまいます。これを計算の残差と呼びます。
この残差の相殺こそが、今回提示された反例の重要な工夫です。縮む渦だけでは荒くなってしまう外力を打ち消すために、細かく小刻みに震えるような高周波の振動パルスを加えました。この小さな振動が生み出す複雑な動きの勢いを使うことで、外力の荒い部分をきれいに相殺したのです。
さらに、わずかな追加の補正を行い、外力が影響する範囲を有限に収めることで、懸賞問題の厳しい条件である「滑らかかつ限られた範囲で働く外力」を成立させたと主張しています。
このような、エネルギーの移動を工夫してある瞬間に破綻を起こさせるというアプローチは、完全にゼロから生まれたわけではありません。方程式を平均化して扱いやすくした条件での有限時間爆発の構成など、先行研究で蓄積されたアイデアが背景にあります。
今回の発表は、単にAIが自律的に問題を解いたというものではありません。人間が問題設定と先行研究を与え、AIが多くの解法候補を探索し、複雑な渦と振動パルスを組み合わせる証明へ到達したものです。見つかった証明はLeanへ形式化されていますが、その定義が元の問題と一致するか、数学者が理解できる形で隙間なくつながるかは、人間も確認していく必要があります。
では、この緻密な数学のピースを組み立てるため、OpenAIはどのようなシステムを用いたのでしょうか。数学の仕組みから視点を変え、次はこの複雑な探索操作を実行したAI研究環境の構成について確認していきます。
GPT-6ではなく約1万のAI研究チームが探した
「AIが難問を解いた」と聞くと、最新のAIが一つだけあって、質問を入力すると一発で完璧な答えを返してくれたような想像をするかもしれません。しかし、今回の探索プロセスはそれとはまったく異なります。
実際には、多数の探索班がそれぞれに候補を作り出し、それをまとめる統合役がいて、最後にルール通りか検査する係が残った候補を確かめるという、巨大な研究組織のような役割分担で行われました。
OpenAIの発表によると、複雑な渦と振動を組み合わせるという証明の核となるアイデアを見つけ出したのは、Astraより高性能と説明される未公開の内部モデルです。これは、すでに一般向けに提供され、提供条件や料金、使い方などが解説されている公開モデルの「GPT-6 Astra」とは別のモデルです。
内部モデルの名前、規模、学習データ、詳しい推論方法は公開されていません。
この未公開モデルを動かし、約1万のエージェントと呼ばれるAIの作業単位が用意されました。彼らは約88時間もの間、約270万件のメッセージをやり取りし、約1300億もの出力トークンと呼ばれる言葉の断片を生成するという膨大な作業を行いました。
複数のグループに分かれて関連する問題を同時に調べ、途中の結果を互いに共有しながら、答えの候補を少しずつ絞り込んでいったと説明されています。
このようにして未公開モデルが論理のピースを見つけ出した後、それを数学的に厳密な形式に翻訳する役割を担ったのが、公開されているGPT-6 Astraです。発表では、解析証明の後にGPT-6 Astraが17時間かけてLean形式化と検証を進めたとされています。
Lean(リーン)とは、数学の証明がルール通りに正しく組み立てられているかを自動でチェックする検証ツールのことです。公開されたLeanのリポジトリを見ると、主証明では未証明の穴を示すsorryの件数が0で、審査状態はself-assessedと記録されています。
しかし、このLeanによる機械的な検証が保証するのは、定義した命題が公理と補題からルール通りに導けるかという点だけです。機械的な検査を通過したからといって、自然言語で書かれた元の問題文と完全に一致しているか、物理的な意味として正しいか、先行研究の貢献が正しく反映されているか、そしてクレイ数学研究所の認定基準を満たしているかまでは自動で保証されません。
このように、AIが行ったのは一度の回答ではなく、莫大な計算力と役割分担による探索と機械検証でした。こうした技術の分担が明らかになる一方で、この証明の基となったデータはどこから来たのかという疑問がインターネット上で広がっています。次は、情報源とクレジットの論争について、現在確認されている事実と噂を整理していきます。
研究データを盗んだのかを時系列で分ける
今回の発表にあたり、インターネット上では「ライバル企業であるAnthropicの勤務者が入力した未公開データが盗まれたのではないか」という疑問が広がりました。この論争を正しく理解するためには、情報がAI開発側に伝わる経路を「噂などによる問題選択への影響」「モデル学習への取り込み」「入力内容の実行時参照」の三つに分けて考える必要があります。
事の発端は、研究者のTristan BuckmasterとAnthropic勤務のLevent Alpögeによる声明です。彼らは個人的共同研究として別の方程式を研究し、その過程でAIツールのCodexなどに未公開草稿を入力していました。
しかし、彼ら自身はナビエ・ストークス問題そのものを解いたわけではなく、データがOpenAI側に使われたかどうかも分からないため、告発する意図はないと述べています。つまり、現時点でデータが盗用されたと断定できる事実はありません。
一方で、OpenAI側の説明は発表後に変化しています。WIREDの記録によると、初版の発表では特定ユーザーデータへの直接アクセスを否定しつつ、匿名化された利用データがモデル改善へ寄与した可能性を排除できないとしていました。
その後、OpenAIは発表内容を更新し、研究成果に関する噂が問題選択と資源投入へ影響したことは認めたものの、データの流用については明確に否定しました。自己調査の結果として、発表前2か月のBuckmasterのCodexプロンプトは学習を含め内部モデルへ影響できなかったと公表しています。
ただし、この自己調査の具体的な方法や、第三者による独立監査の結果は未公開のままです。
現在確認できる事実として、他者の研究が進んでいるという「噂」がAIの計算資源をナビエ・ストークス問題に振り向けるきっかけ、すなわち問題選択への情報にはなりました。OpenAIは、個別の未公開データがAIの「モデル学習」に組み込まれたり、探索中に「実行時参照」されたりしたことを否定しています。
ただし、OpenAIが調査方法やログ照合の内容を公開していないため、第三者が同じ結論を再確認できる状態にはなっていません。
こうした状況に対し、数学者のテレンス・タオらによる共同声明が発表されています。彼らは今回の証明の具体的な誤りを指摘したのではなく、理解可能な説明や先行研究の帰属、慎重な検証を後回しにする競争的なAI数学開発の文化そのものを批判しています。
AIが莫大な計算力で複雑な成果物を生み出し、機械的なチェックを通過させる一方で、その背景にあるデータの扱いや人間の研究者への敬意が問われている状態です。
この一連の騒動は、私たちが未発表のデータをAIサービスに入力する際、情報がどのように扱われるのかという切実な課題を浮き彫りにしました。自分の大切な研究データや業務情報が意図せずモデルの学習に使われないようにするためには、システムの仕組みを正しく把握する必要があります。
次は、情報の機密度に合わせて、どのようなAI環境を選び、安全に検証を進めていけばよいのかを見ていきます。
研究者は機密度でAI環境と検証方法を選ぶ
今回の一連の出来事は、AIに入力した未発表データがどう扱われるのかという、研究者や生成AIを業務で使う人々にとって重要な教訓を残しました。自分の研究データや業務情報を守るためには、手元の情報がどの程度の機密度を持つのかを四段階に分け、それに応じて適切なAI環境と検証方法を選ぶ必要があります。
具体的な四段階の入力判断として、すでに世に出ている「公開情報」、外部には出せない「社内資料」、これから発表を控えている「投稿前論文」、そして絶対に漏れてはならない「特許や個人情報」に分けて考えます。それぞれの情報に合わせて、データを渡す経路を変える工夫が求められます。
まず、個人向けのChatGPTやプログラミングを支援するCodexを利用する場合、設定に応じて入力内容がモデル改善へ使われる場合があるため、投稿前の論文を入力する前に契約と設定を確認します。「Improve the model for everyone」という設定をオフにすると、新しい会話を学習へ使わないように管理できます。
次に、社内資料や投稿前論文のような機密データを扱う場合は、より安全な経路を選びます。Business、Enterprise、Edu向けのプランや、プログラムに組み込んで使うAPIは、既定で入力データを学習へ使わない仕組みになっています。
しかし、学習に使われない設定にしたからといって、データがサーバー上に全く残らないわけではありません。例えばAPIを使う場合、不正利用を監視するためのログとして最大30日間データが保持される場合があり、会話の状況などを記憶する状態を持つ機能では、ユーザーが削除するまでデータが保持される場合がある点に注意が必要です。
データを全く保存しない「Zero Data Retention」という仕組みも提供されていますが、これは承認された顧客と特定の対応機能に限られており、すべての機能が対象ではないとされています。
このように、データの保護は単純な設定の変更だけでは解決しません。アメリカの国立標準技術研究所が公開しているガイドラインでも、誤情報、データプライバシー、情報セキュリティ、知的財産を別のリスクとして扱うよう求めています。
特許や個人情報などを扱う際には、外部のサーバーにデータを送るクラウド型AIを使う前に、学習しない設定だけでなく保存期間、契約内容、権利の所在、入力する範囲を確認する手順を踏みます。損失が大きい情報は、対応機能を確認したZero Data Retentionか、外部通信、同期、ログ、遠隔IDEを止めて管理できるローカル環境を候補にします。
モデルを端末へ置くだけでは安全になりません。
今回のナビエ・ストークス問題の発表が示しているのは、AIが人間の代わりになんでも解決してくれる未来ではありません。AIは入力された条件に従って膨大な探索操作を行い、成果物を組み立てて、機械的な検証を通すことにおいては強力な道具になります。
しかし、どのような情報を安全な環境で入力するかという最初の判断と、AIが提示した成果物を人間が長年かけて検証し、正式な証明として確かめる最後の工程は、これからも私たちの責任として残されています。
よくある質問
Q1. 本当にミレニアム懸賞問題を解決したのですか?
Leanによる形式検証を通過した解決候補が発表された段階であり、まだ正式に解決したとは言えません。クレイ数学研究所が定める規則では、論文としての公開から2年以上の期間をかけて人間の数学者が検証し、数学界で広く受け入れられた後に審査が行われます。そのため、現在も問題一覧では未解決として表示されています。
Q2. 滑らかな外力がある条件も懸賞問題の対象に含まれるのですか?
はい、滑らかな外力がある条件も懸賞問題の対象に含まれています。クレイ数学研究所の公式な問題文では、滑らかな外力を許した状態で計算が破綻する反例の提示が、問題の選択肢として明記されています。今回OpenAIは、膨大な探索操作を通じてこの条件に合う例外のパターンを見つけ出したと主張しています。
Q3. 最新の公開モデルであるGPT-6がこの問題を解いたのですか?
証明の核となるアイデアを見つけ出したのはGPT-6 Astraではなく、未公開の内部モデルです。約1万のAIエージェントが並行して探索作業を行い、少しずつ答えの候補を絞り込んでいきました。その後、見つかった成果物を数学的に厳密な形式へ翻訳し、ルール通りか検査する作業をGPT-6 Astraが担当しました。
Q4. 機械的な検証に使われたLeanとはどのような仕組みですか?
Leanとは、数学の証明が公理と補題からルール通りに正しく組み立てられているかを自動で検査する検証ツールです。公開リポジトリでは、主証明の未証明部分を示すsorryの件数が0と記録されています。しかし、この機械検証は、自然言語で書かれた元の問題文との一致や物理的な意味、正式な認定基準を満たしているかまでは自動で保証しません。
Q5. AIが証明を見つけるために他者の研究データを盗用したのですか?
現時点でデータが盗用されたと断定できる事実はありません。他者の研究が進んでいるという噂が問題選択と資源投入へ影響したことはOpenAIも認めています。一方で、発表前の他者の入力データが学習を含め内部モデルへ影響したことは否定していますが、自己調査の詳しい方法は公開されておらず、第三者による確認はこれからです。
Q6. 機密性の高い情報を扱う場合はローカルAI環境を使うべきですか?
漏えい時の損失が大きい機密情報では、外部通信を止めて管理できるローカルAI環境が候補になります。ただし、クラウド同期、遠隔IDE、ログ送信が動いていれば、モデルが手元にあっても情報は外へ出ます。APIや企業向けのプランは既定で入力データを学習に使われませんが、全くサーバーに保存されないわけではありません。
不正利用監視などのために一定期間データが保存される場合があるため、情報の機密度に応じた使い分けが必要です。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント