
短い分岐や単純な分類を従来の文章生成AIで扱う際、意図しない自由な文章が出力されることへの対応や指定形式へ整える手間が課題となることがあります。この課題に対して注目されているのが、文章を生成するのではなく、与えられた入力状態に対して型付きの判断を返すことに特化したAIモデル「Jev」です。
本記事では、Jevがどのような入力から何を出力するのかという基本から、実際の使い方や強み、限界について初学者にも分かりやすく解説します。あわせて、現在確認できる先端事例と今後広がり得る用途といった現行と将来の可能性を区別しながら、他のAIラボが提供する機能とも比較し、AI開発の次をどう見極めるべきかを整理します。
Jevとは何か|文章ではなく選択肢・点数・真偽を返す
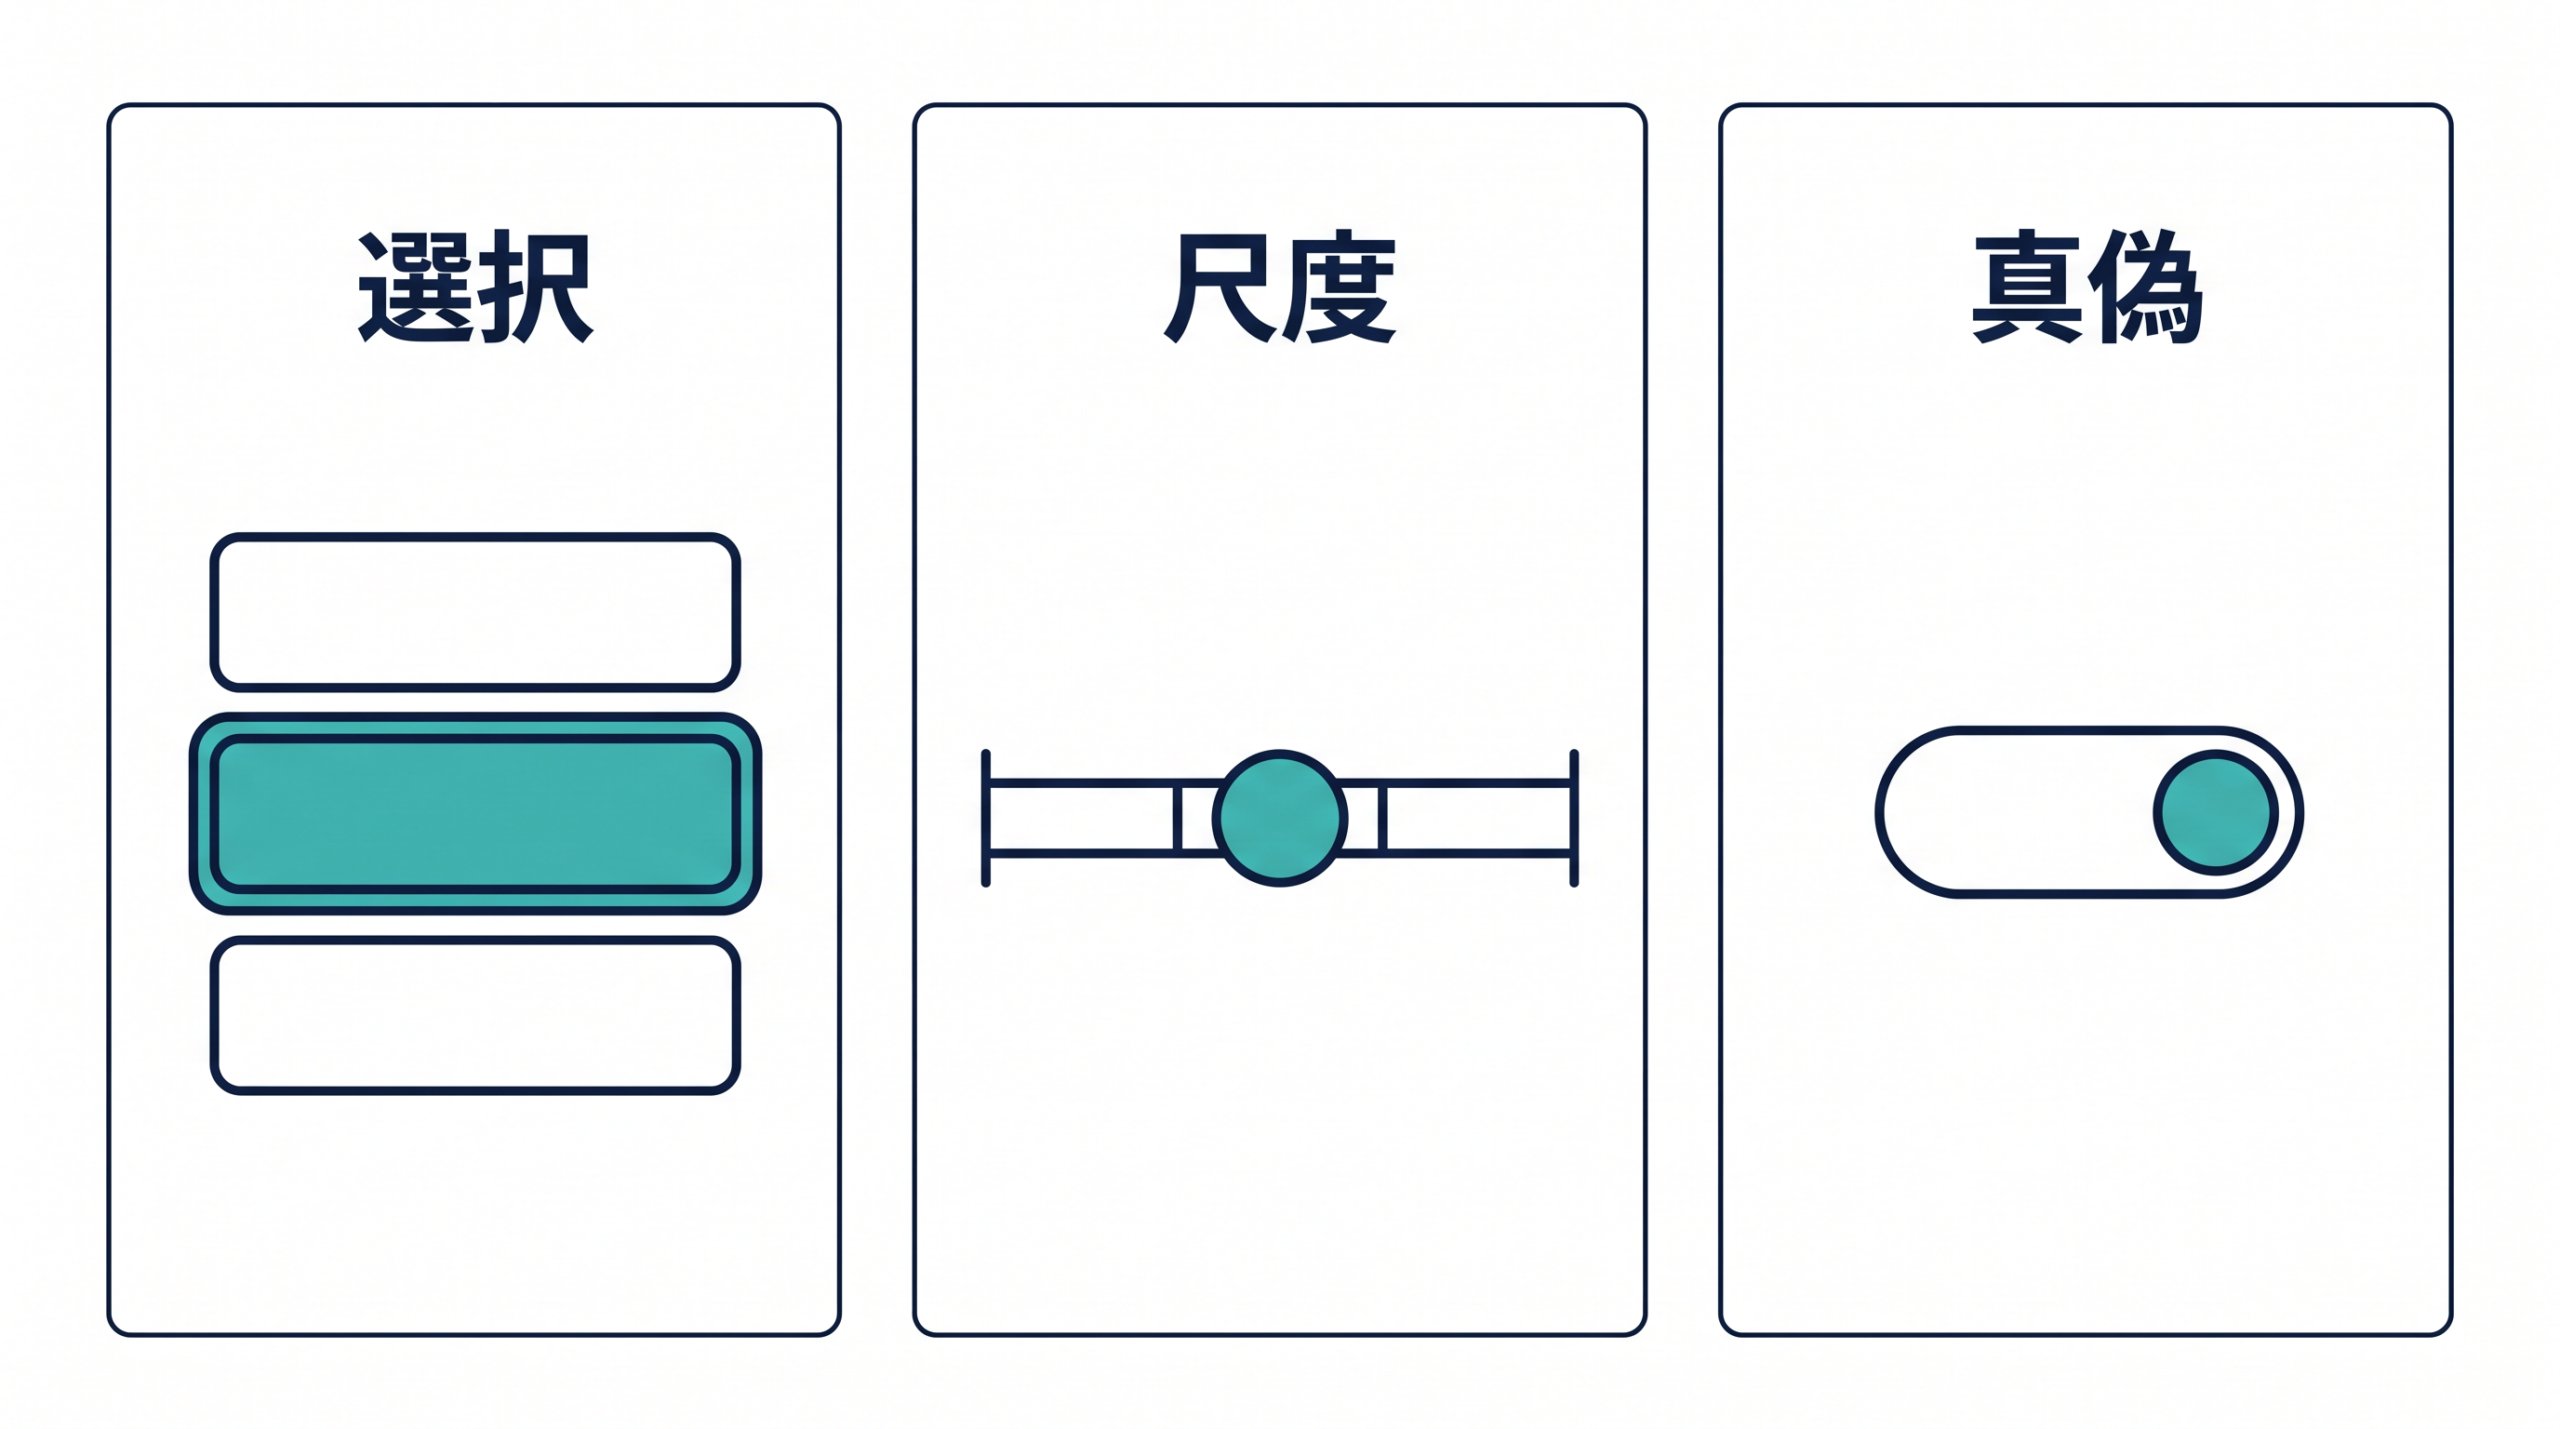
Jevは、TypeSafe AIが2026年9月15日に公開したAIモデルです。一般的なチャットAIのように文章を生成するのではなく、与えられた状態に対する型付きの判断を返すことに特化しています。公開APIは、判断対象となるデータを受け取るstateと、判断基準を指定するquestionsを受け取り、Choice(選択肢)、Score(点数)、Noulといった形式で結果を返します。
この入力と出力の仕組みについて、顧客からの問い合わせをどの窓口へ送るかを分類する架空の例を用いて説明します。
まず入力として、顧客からの問い合わせ本文をstateへ渡します。同時に、questionsを用いて「billing」「technical」「sales」のどれに該当するかを指定します。Jevはこの入力に対して説明の文章を生成せず、指定された選択肢から選んだ結果であるChoice(例えば「technical」)、候補ごとの確率、confidenceを出力として返します。そして最終的な人の確認として、返ってきたChoiceおよび確率を元の問い合わせ本文と照合し、振り分けが正しいかを判定します。
このように、Jevは本文などの入力から指定された形式の判断を出力し、人がその結果を確認するという役割に絞った使い方が想定されます。
Jevの強み|速度・費用・形式・確率を条件付きで見る
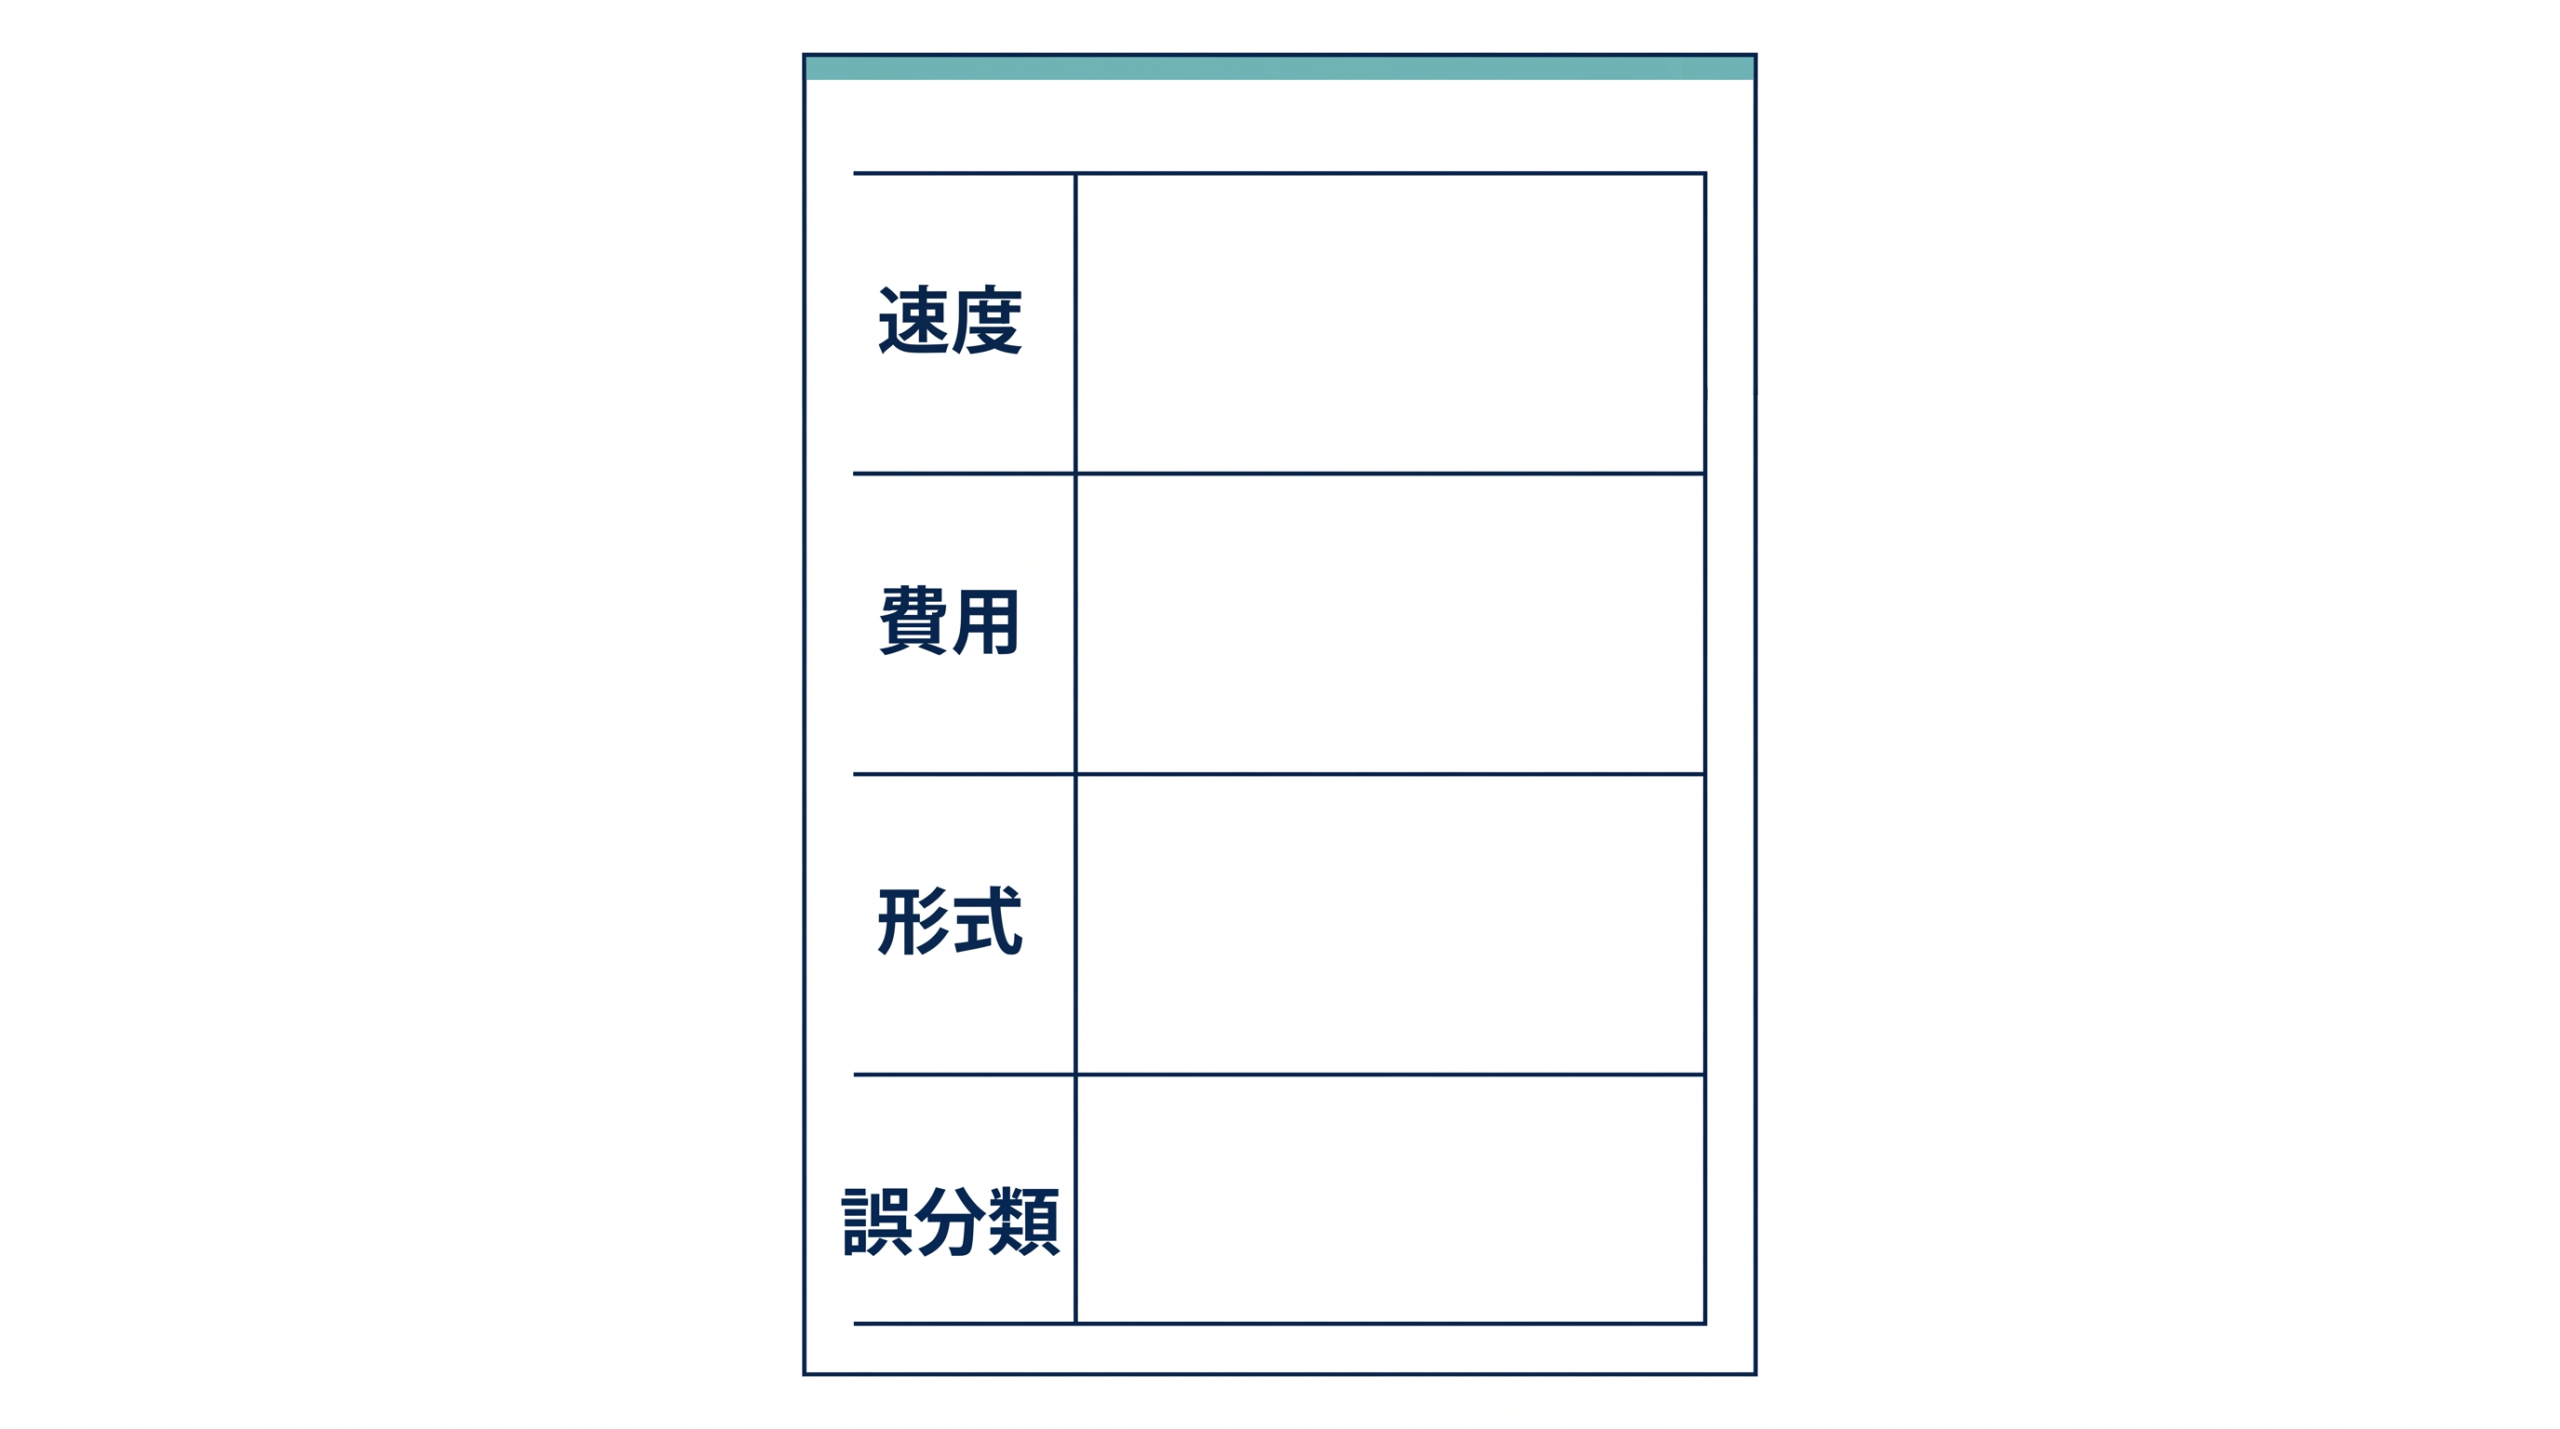
Jevの強みは、処理の速度、APIの費用、指定した形式を確実に返す機能、そして確信度を示す確率を出力する点の4つにあります。ただし、これらの強みを評価する際は、速度と費用の実測値が測定環境に依存することと、形式の保証は判断の正確さを保証しないことを明確に分ける必要があります。
まず速度と費用について、TypeSafe公表の数値では、米国西海岸から同社サービス近くでのend-to-end応答時間が70〜500msとされています。費用は入力100万トークン当たり0.042ドルで出力トークンは無料です。同社のワークフロー評価の高い側の値として193.6倍高速、444.6倍低費用という倍率が示されていますが、これは正解基準をAstraとFableの予測平均としたものであり、TypeSafe自身がワークフロー設計に自社側の偏りがあることを認めています。一方で、標準ベンチマークではない独立した小規模API試用において、東アジアから短いリクエストを送信した場合の応答時間は253〜378ms(中央値284ms)であったと報告されており、前提となる測定条件で結果が変動します。
次に形式と確率について、Jevは自由な文章生成を行わないため形式エラーを防ぐ強みを持ちます。しかし形式が指示通りであることと、分類が正しいことは別の問題です。ChoiceとScoreは判断結果とともにprobabilitiesとconfidenceを返しますが、Noulは0から1の値を返し同じconfidence項目を持ちません。これらの確率をどのように扱うか(閾値)は、用途ごとの誤判定コストと実データをもとに人が決める必要があります。
具体例として、「ログインできない」といった短い文の担当部署分類を100件繰り返す架空の試験を想定し、実際に記録する項目を別列で比較します。このとき、測定結果の数値は作らず、入力、操作、出力、人の確認がどう関係するかを整理します。
| 入力長 (入力) | API応答時間 (操作・出力) | 請求額 (操作・出力) | 形式エラー (出力) | 誤分類 (人の確認) |
|---|---|---|---|---|
「ログインできない」などの短い文をstateへ渡す際のトークン数。速度や費用の前提条件となります。 |
リクエストを送信する操作から結果が出力されるまでの実測時間(ms)。 | 100件のAPI呼び出しにかかった実際の費用(ドル)。 | 指定したChoiceなどの形式に合致した出力になっているかを確認します。 | 出力された確率やconfidenceの数値と元の文を照らし合わせ、人が分類の正誤を判定した結果。 |
実際の運用においては、公表された倍率をそのまま鵜呑みにするのではなく、自社の固有の入力条件でAPI応答時間と請求額を測定する操作を行い、得られた出力の確率を参考に人が誤分類を確認して総合的に評価することが不可欠です。
現在の使い方|問い合わせ分類をAPIで試す
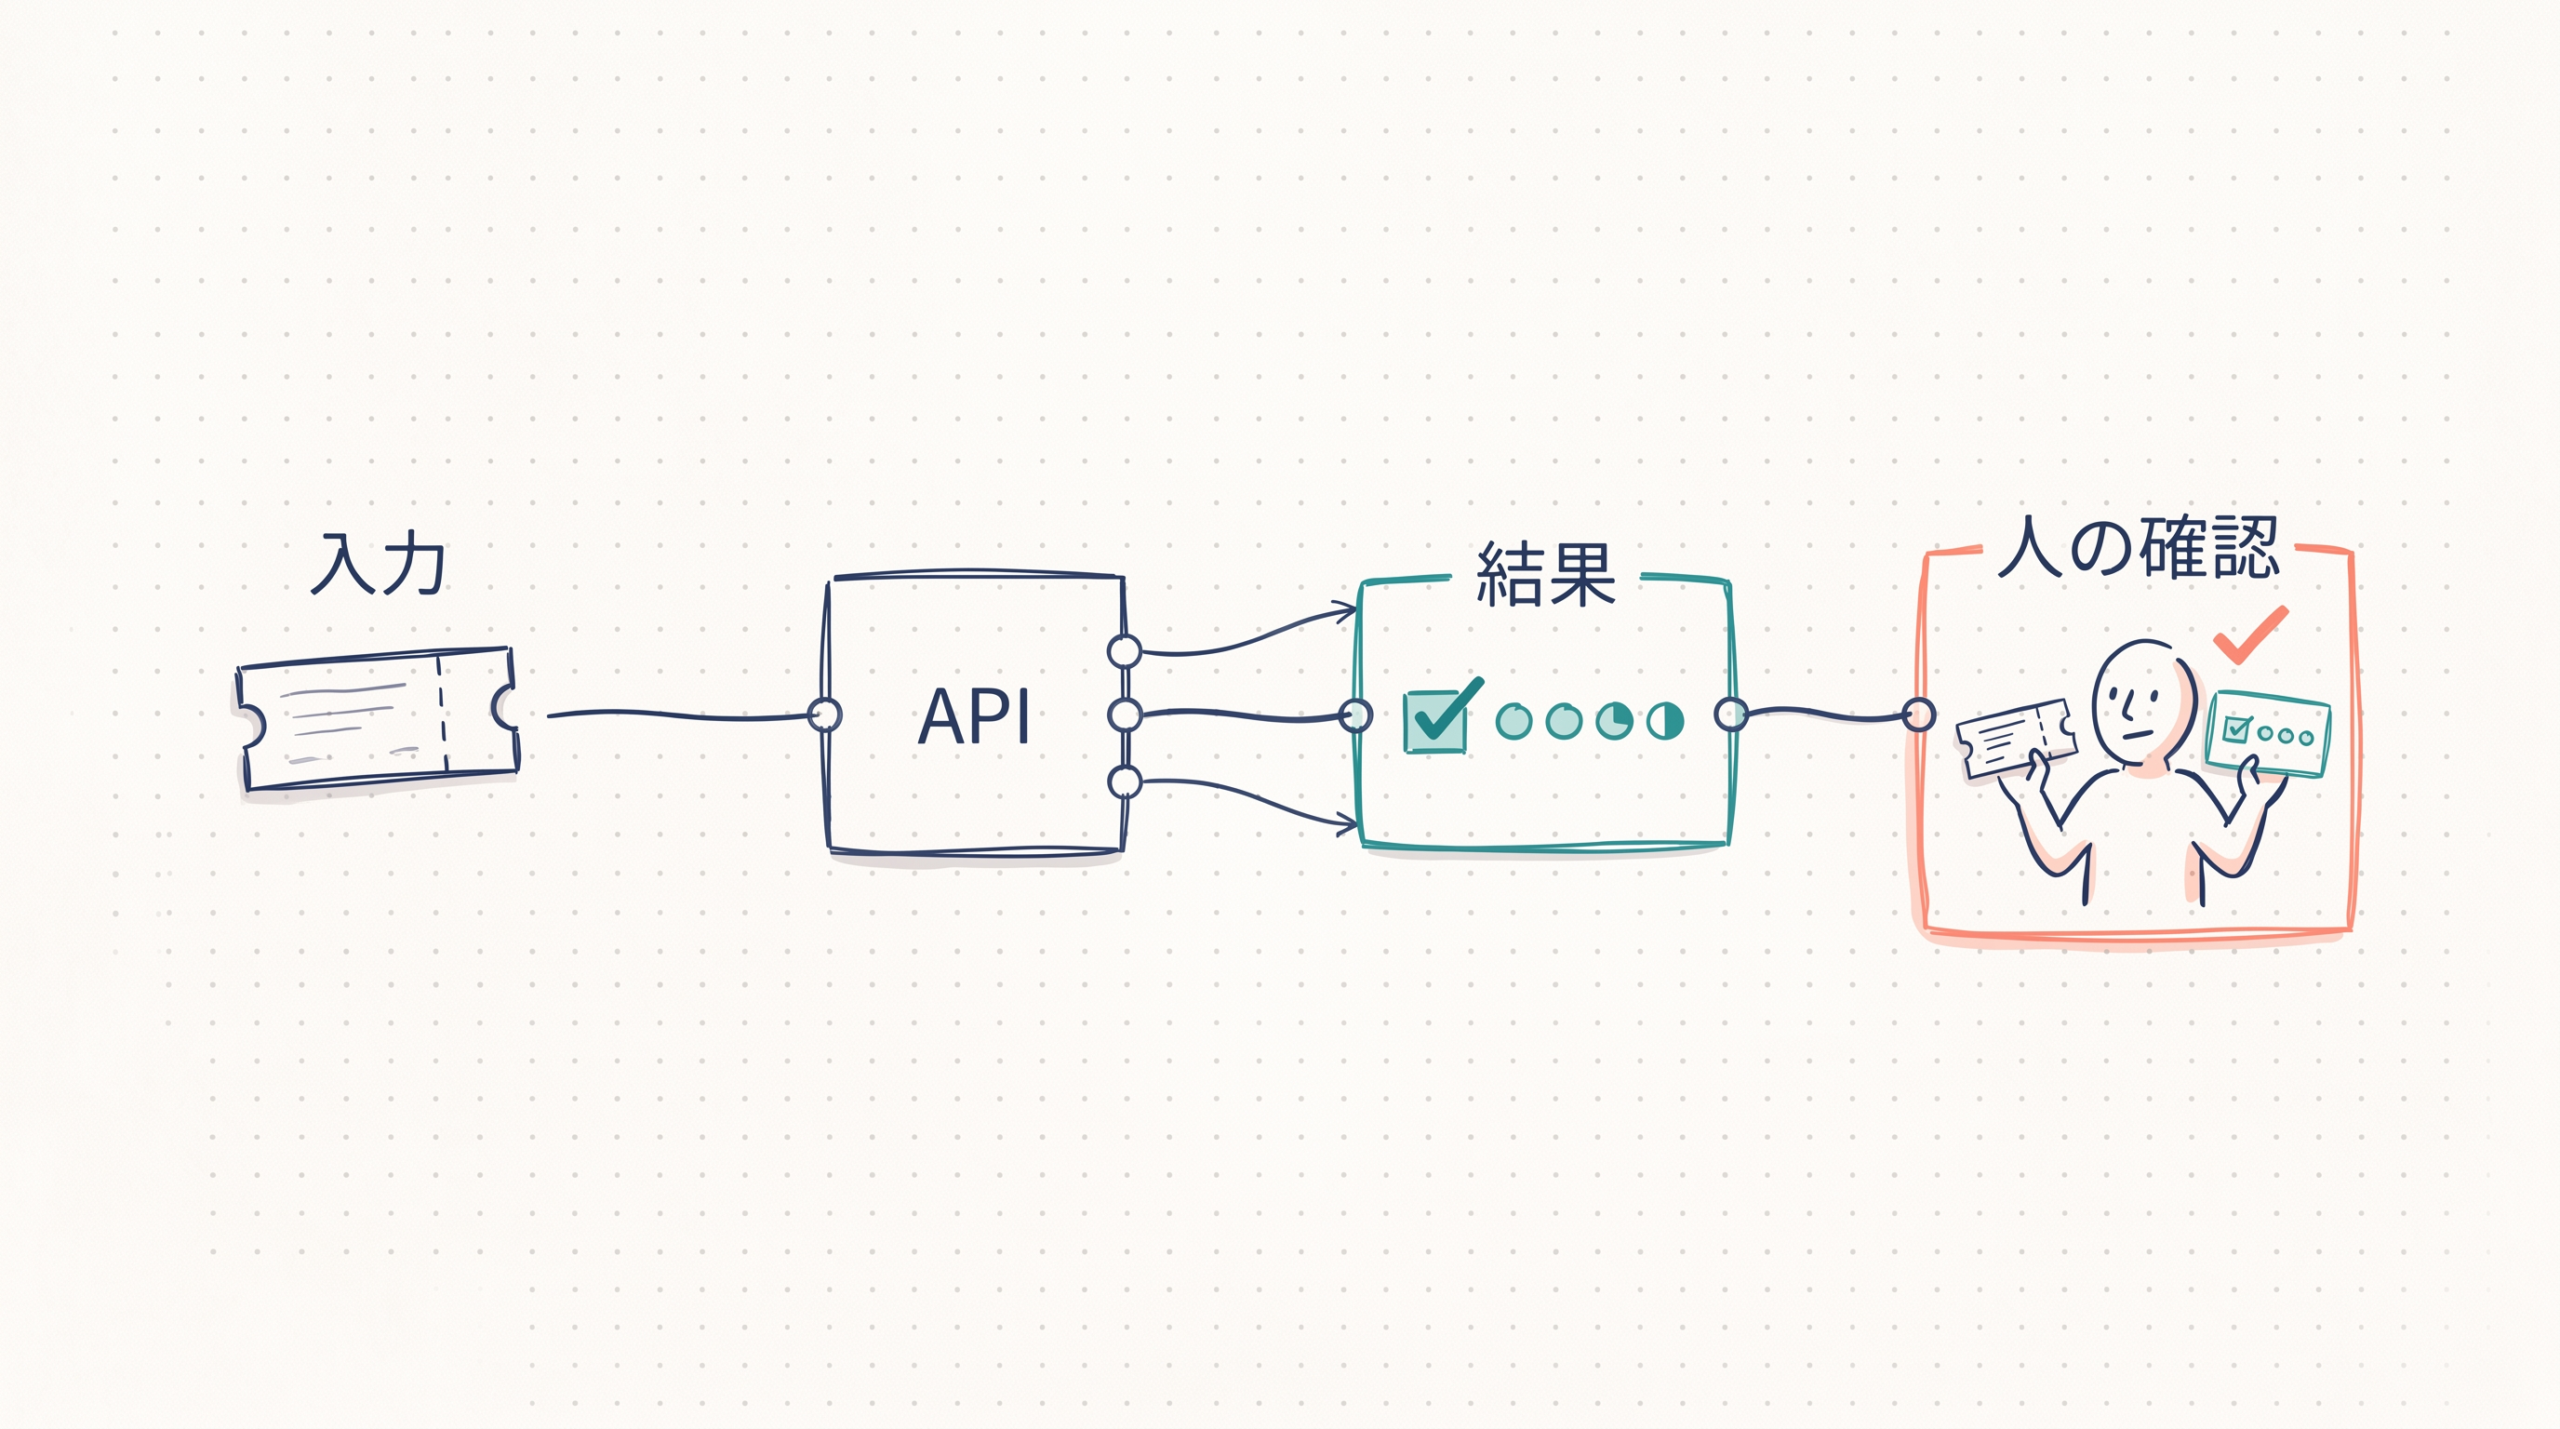
公式のクイックスタートに沿って、実際の使い方を追います。この手順では、早期アクセスとして公開されたJevを、ブラウザ上のPlaygroundから試す経路と、APIを直接呼び出す経路の2つに分けて説明します。具体例として、「Stripe接続に3日失敗し、売上を失っている」という問い合わせを分類するケースを見てみましょう。
まず、Playgroundの経路では、console.typesafe.aiへログインし、画面上で問い合わせ本文をstateに貼り付け、質問を追加して結果を得ます。
一方、APIを直接呼び出す経路では、ダッシュボードから取得したAPIキーを用いて外部へデータを送信し、API課金が発生する境界を越えることになります。入力と操作として、POST https://api.typesafe.ai/v1/systemoneに対して、ヘッダーにAuthorization: Bearer <API_KEY>とContent-Type: application/jsonを指定し、以下に示す公式例のJSONデータを送ります。
{
  "model": "jev-latest",
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": ["Calm, just stating facts", "Frustrated but civil", "Very angry, strong language"]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}次にJevからの出力として、これらの項目に対する型付きの決定がanswersという形で返ってきます。公式サンプルの応答から、主な戻り値を抜粋すると以下のようになります。なお、これは公式のサンプル応答であって、実際の結果の再現保証ではありません。
{
  "answers": {
    "department": {
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": {
        "technical": 0.85
      }
    },
    "frustration": {
      "score": 1.0
    },
    "is_urgent": {
      "noul": 1.0
    }
  },
  "usage": {
    "input_tokens": 392,
    "output_tokens": 65
  }
}最後に人の確認として、受け取ったanswersの値を元の問い合わせ原文と照らし合わせます。department.choiceで選ばれた担当窓口が「technical」で妥当か、frustration.scoreやis_urgent.noulによる不満度と緊急度の判断ミスが起きていないかを人が確認します。このように、APIキーを利用したデータ送信から出力を得た後、人が結果を確認するという一連の流れで構成されています。
先端事例|ゲームと道具選択デモで見えたこと
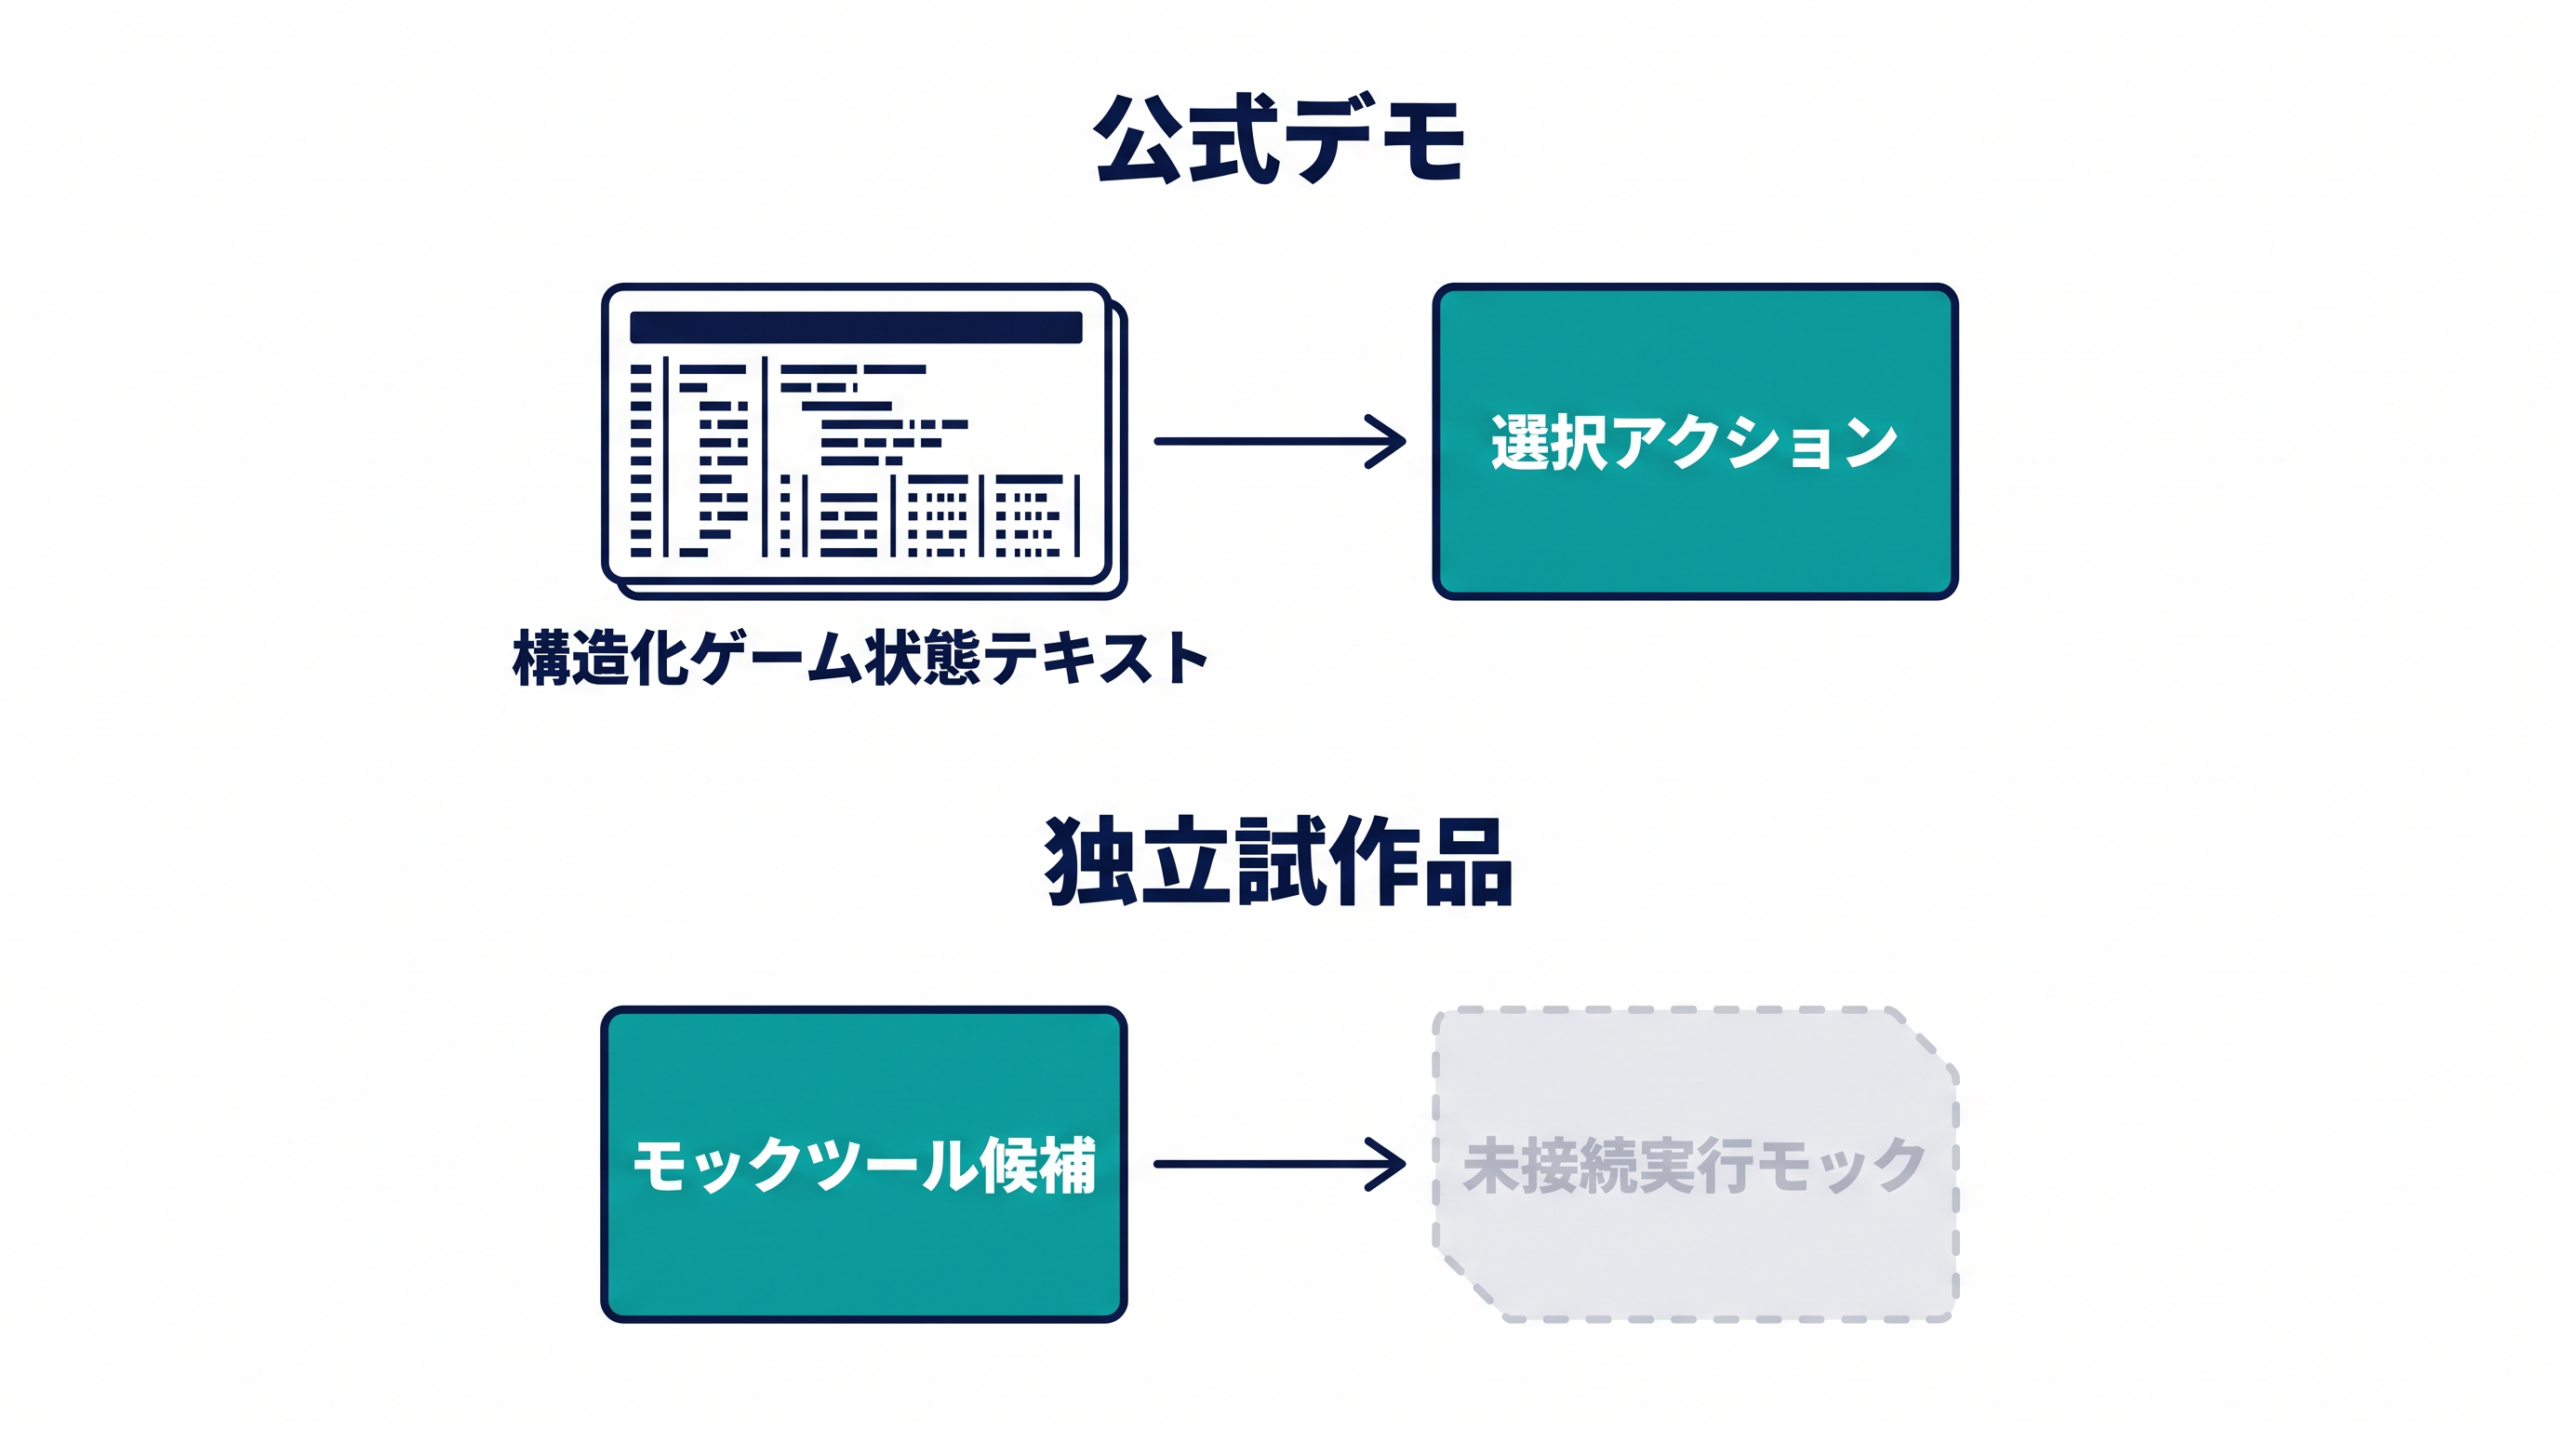
前節で確認したAPIによる分類から進み、より動的な環境におけるJevの先端事例を確認します。ここでは、公式が提供するデモと、独立したコミュニティによる試作品の段階を明確に区別します。
まず公式デモとして、Doomの構造化テキスト状態から行動を選ぶ事例と、Wikipedia候補リンク選択の事例があります。Doomのデモでは、ゲーム内の現在の状況を構造化テキストとして入力し、次に取るべき行動を出力として選択させます。Wikipediaのデモでも同様に、文脈を入力して適切な候補リンクを出力させます。これらは、Jevが状態に対して形式的な判断を下す範囲を確認できる公式の実行例です。
具体例として、もう一つの事例であるTypeSafeAI/typesafe-playgroundのmock tool routerを取り上げます。このリポジトリは見た目の組織名から公式実装と断定されやすいですが、独立コミュニティのプレイグラウンドと明記されています。この試作品における実行範囲は以下の通りです。
入力として、ユーザーの要求などをJevへ渡します。このとき操作の段階で、秘密情報の取得候補をコードで除外し、Jevには安全な候補ノードだけを選ばせます。Jevは候補の中から適切なノードと確信度を出力しますが、確信度が低い場合に停止する仕組みが組み込まれています。最後に人の確認として、最終的に選ばれたノードが妥当であったか、停止の判断が適切であったかを検証します。
このmock tool routerは、後段のエージェントやツール実行、承認は模擬であるため、実運用事例ではなく独立した公開試作品の段階にとどまります。公式の機能や実運用事例と混同せず、現在の実行範囲を正確に把握することが重要です。
今後の用途|短い判断をどこへ増やせるか
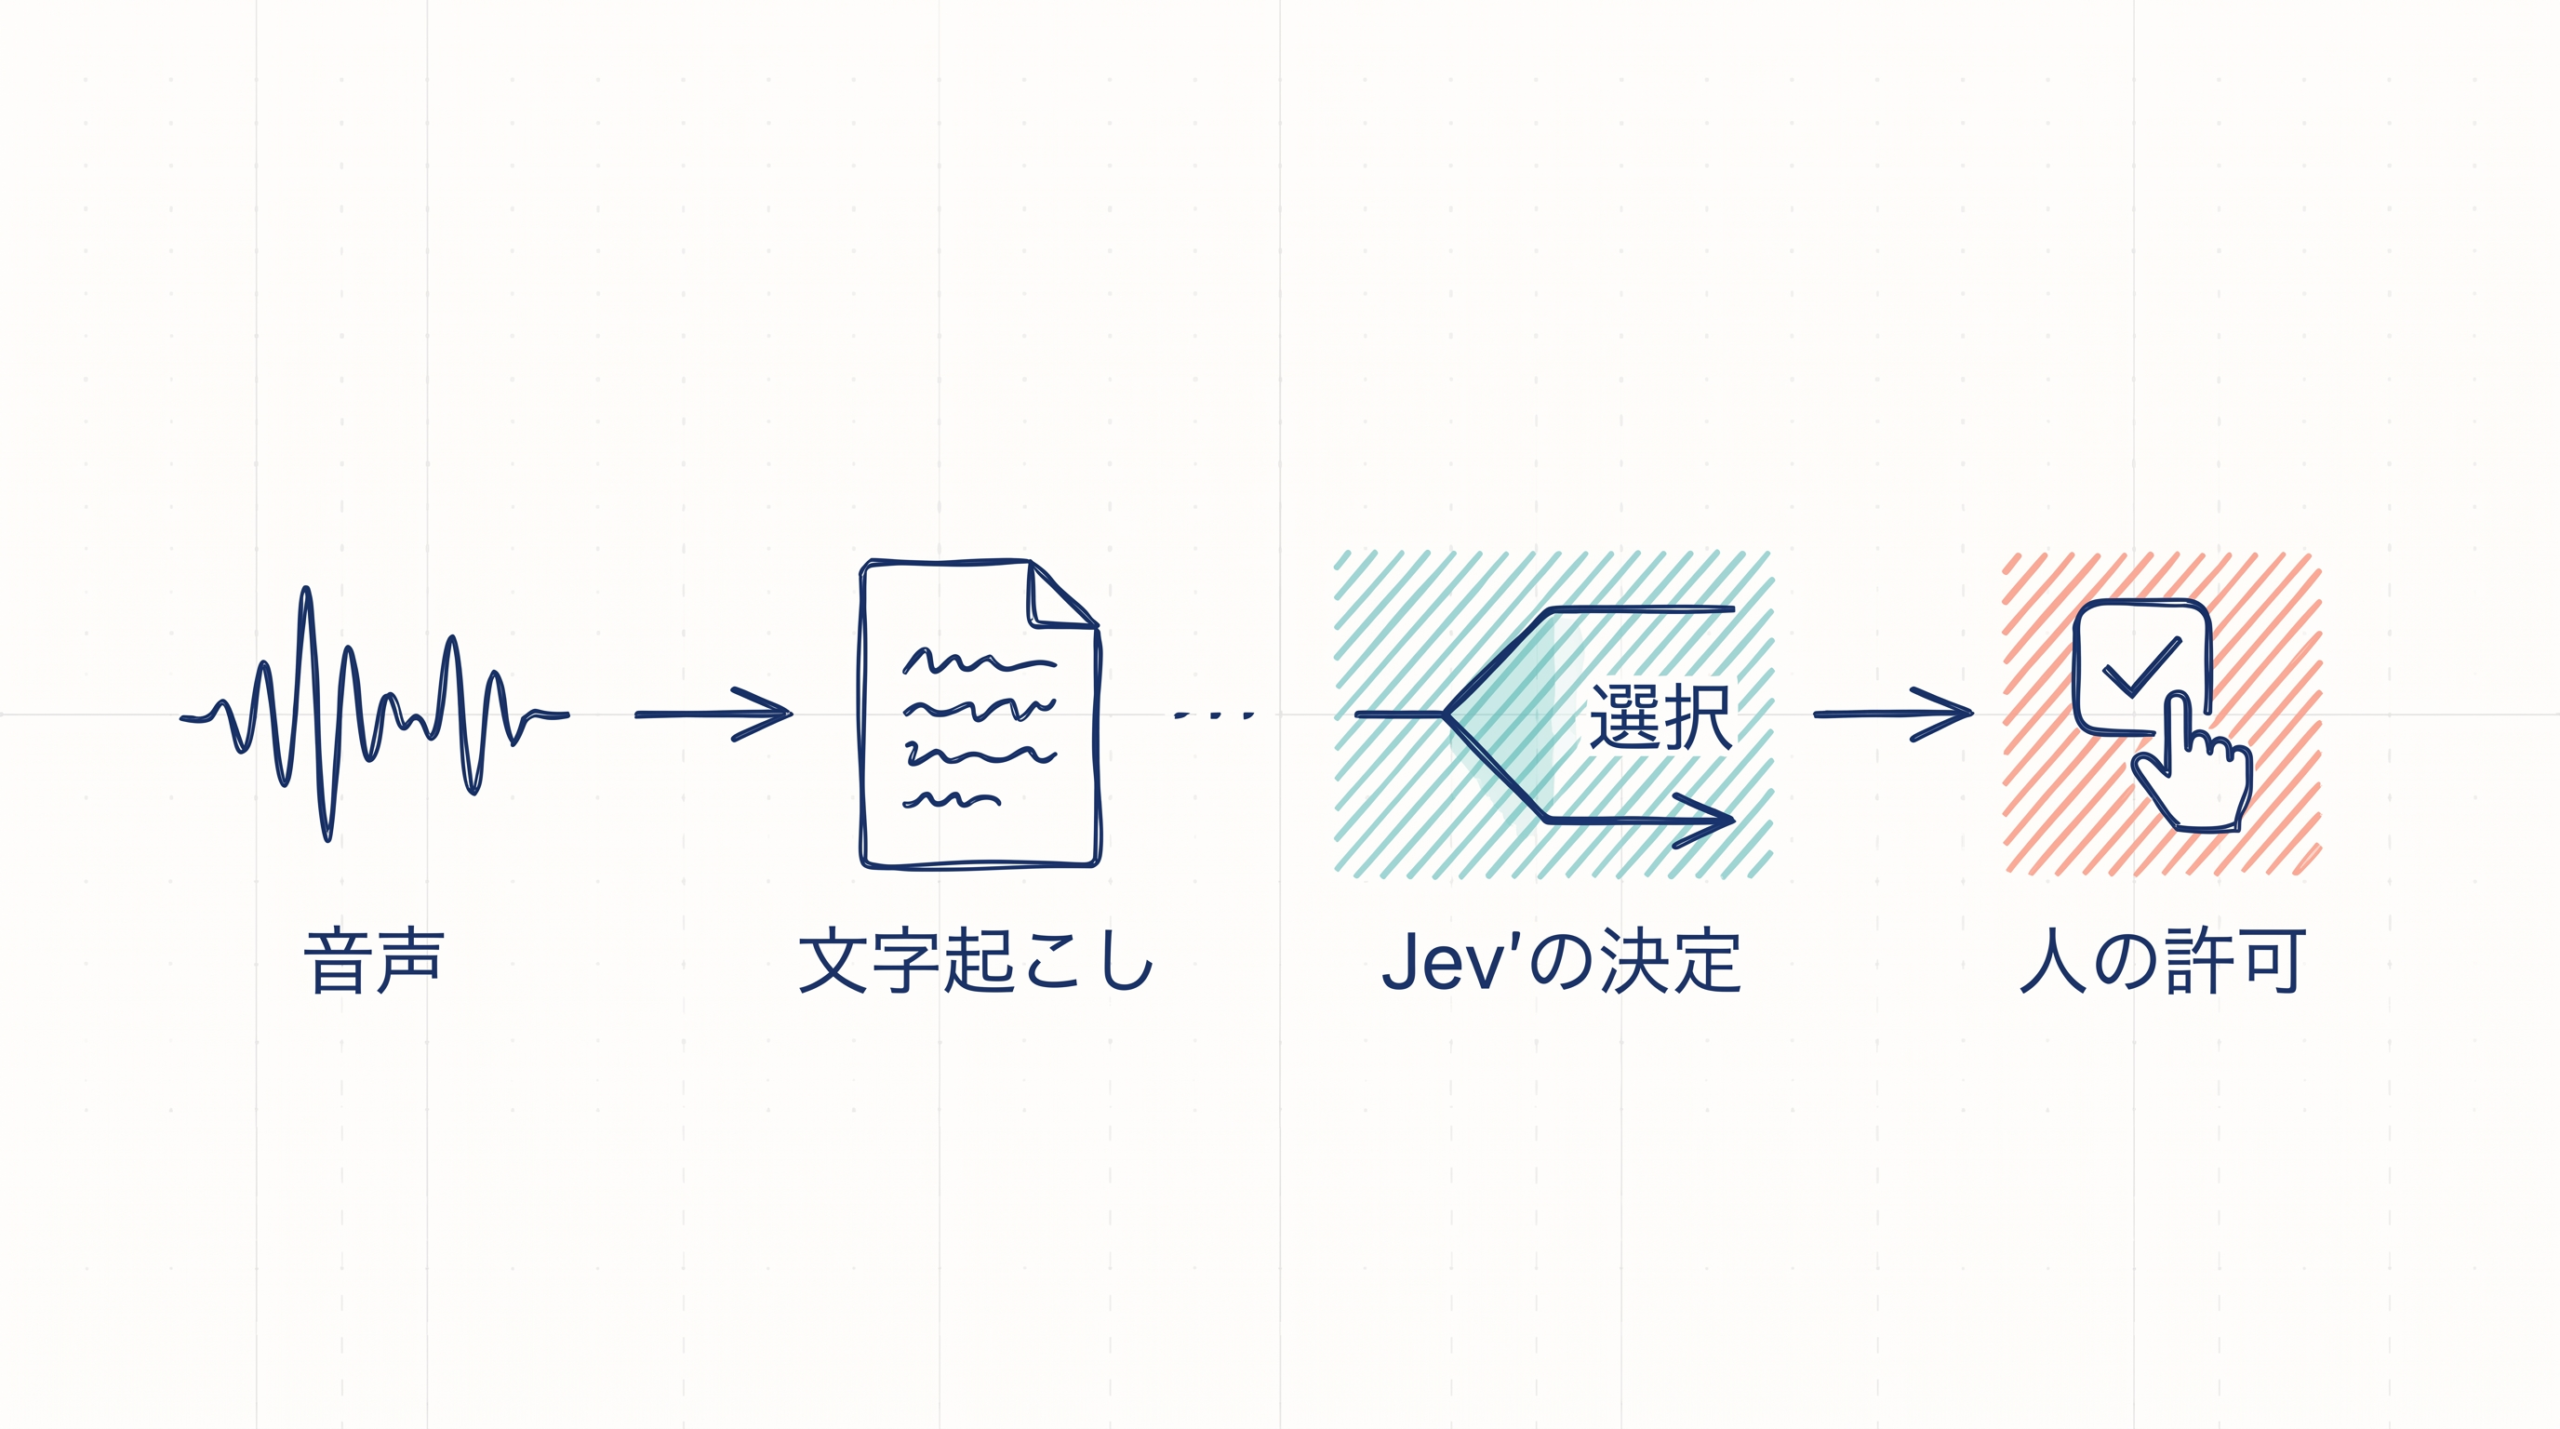
前節で確認したデモや試作品における判断の仕組みを踏まえると、自由な文章ではなく型付きの決定を返すというJevの特性は、今後さらに多様な場面へ応用できると考えられます。ここでは現行仕様からの推論を仮説として示します。
具体例として、音声による操作指示を処理する架空のシステムを仮定します。このシステムでは、入力、操作、出力、そして人の確認という一連の要素が次のように関係します。
まず入力として、別の音声認識システムでテキスト化された指示の原文を、JevのAPIのstateへ渡します。次に操作として、questionsを用いて、あらかじめ許可済みの行き先を候補一覧として指定します。
これに対し、Jevからの出力として、指定された候補一覧から一つを選んだChoiceの形式で結果が返り、あわせて確率とconfidenceが得られます。最後に人の確認として、Jevが選んだ行き先を実行する前に、人が音声の誤認識による原文の誤りがないか、そしてその操作の実行権限が適切であるかを確認します。
このように、入力と出力の間にJevの短い判断を挟み込み、最終的な人の確認と組み合わせることで、人の確認が必要な操作の補助などに用途を増やせる可能性があります。現段階ではあくまで仮説ですが、文章生成ではなく状態に対する型付きの判断を返す機能は、こうした短い意思決定を支援する仕組みと相性が良いと言えます。
Jevの限界|形式が正しくても判断は誤る
前節で考えた短い判断の応用において、注意すべき限界があります。Jevは指定されたデータ型に従って結果を返しますが、形式の保証は判断の正確さを保証しません。ここでは、曖昧な入力や長い推論が必要な場面での誤判断と、しきい値の調整について整理します。
具体例として、「請求に心当たりがない」という曖昧な文を返金要求として誤分類した場合を想定した架空の例で、関係する各要素を追います。 まず入力として、「請求に心当たりがない」という元の文をAPIへ渡します。次に操作として、問い合わせの分類基準を指定して実行します。 このとき出力として、Jevは候補一覧から一つを選んだChoiceと、そのconfidenceを返します。形式としては正しく出力されても、長い推論を前提とする用途には設計されておらず、この架空例では単なる事実確認を返金要求として誤分類する可能性があります。 これを補うため、最後に人の確認として、元の文と出力されたChoice、およびconfidenceの数値を照らし合わせます。実際の誤振り分け率を人が確認した上で、許容できるconfidenceの閾値を調整し、基準を下回る場合は別の処理へ回すといった判断が求められます。
このように、入力が曖昧であったり複雑な文脈理解が必要であったりする場合、形式的なエラーがなくても判断を誤る可能性があります。Jevを運用する際は、出力された数値を基準にして人が確認を行い、適切に閾値を調整することが次の判断を進めるための条件となります。
他ラボの現行機能と今後の可能性
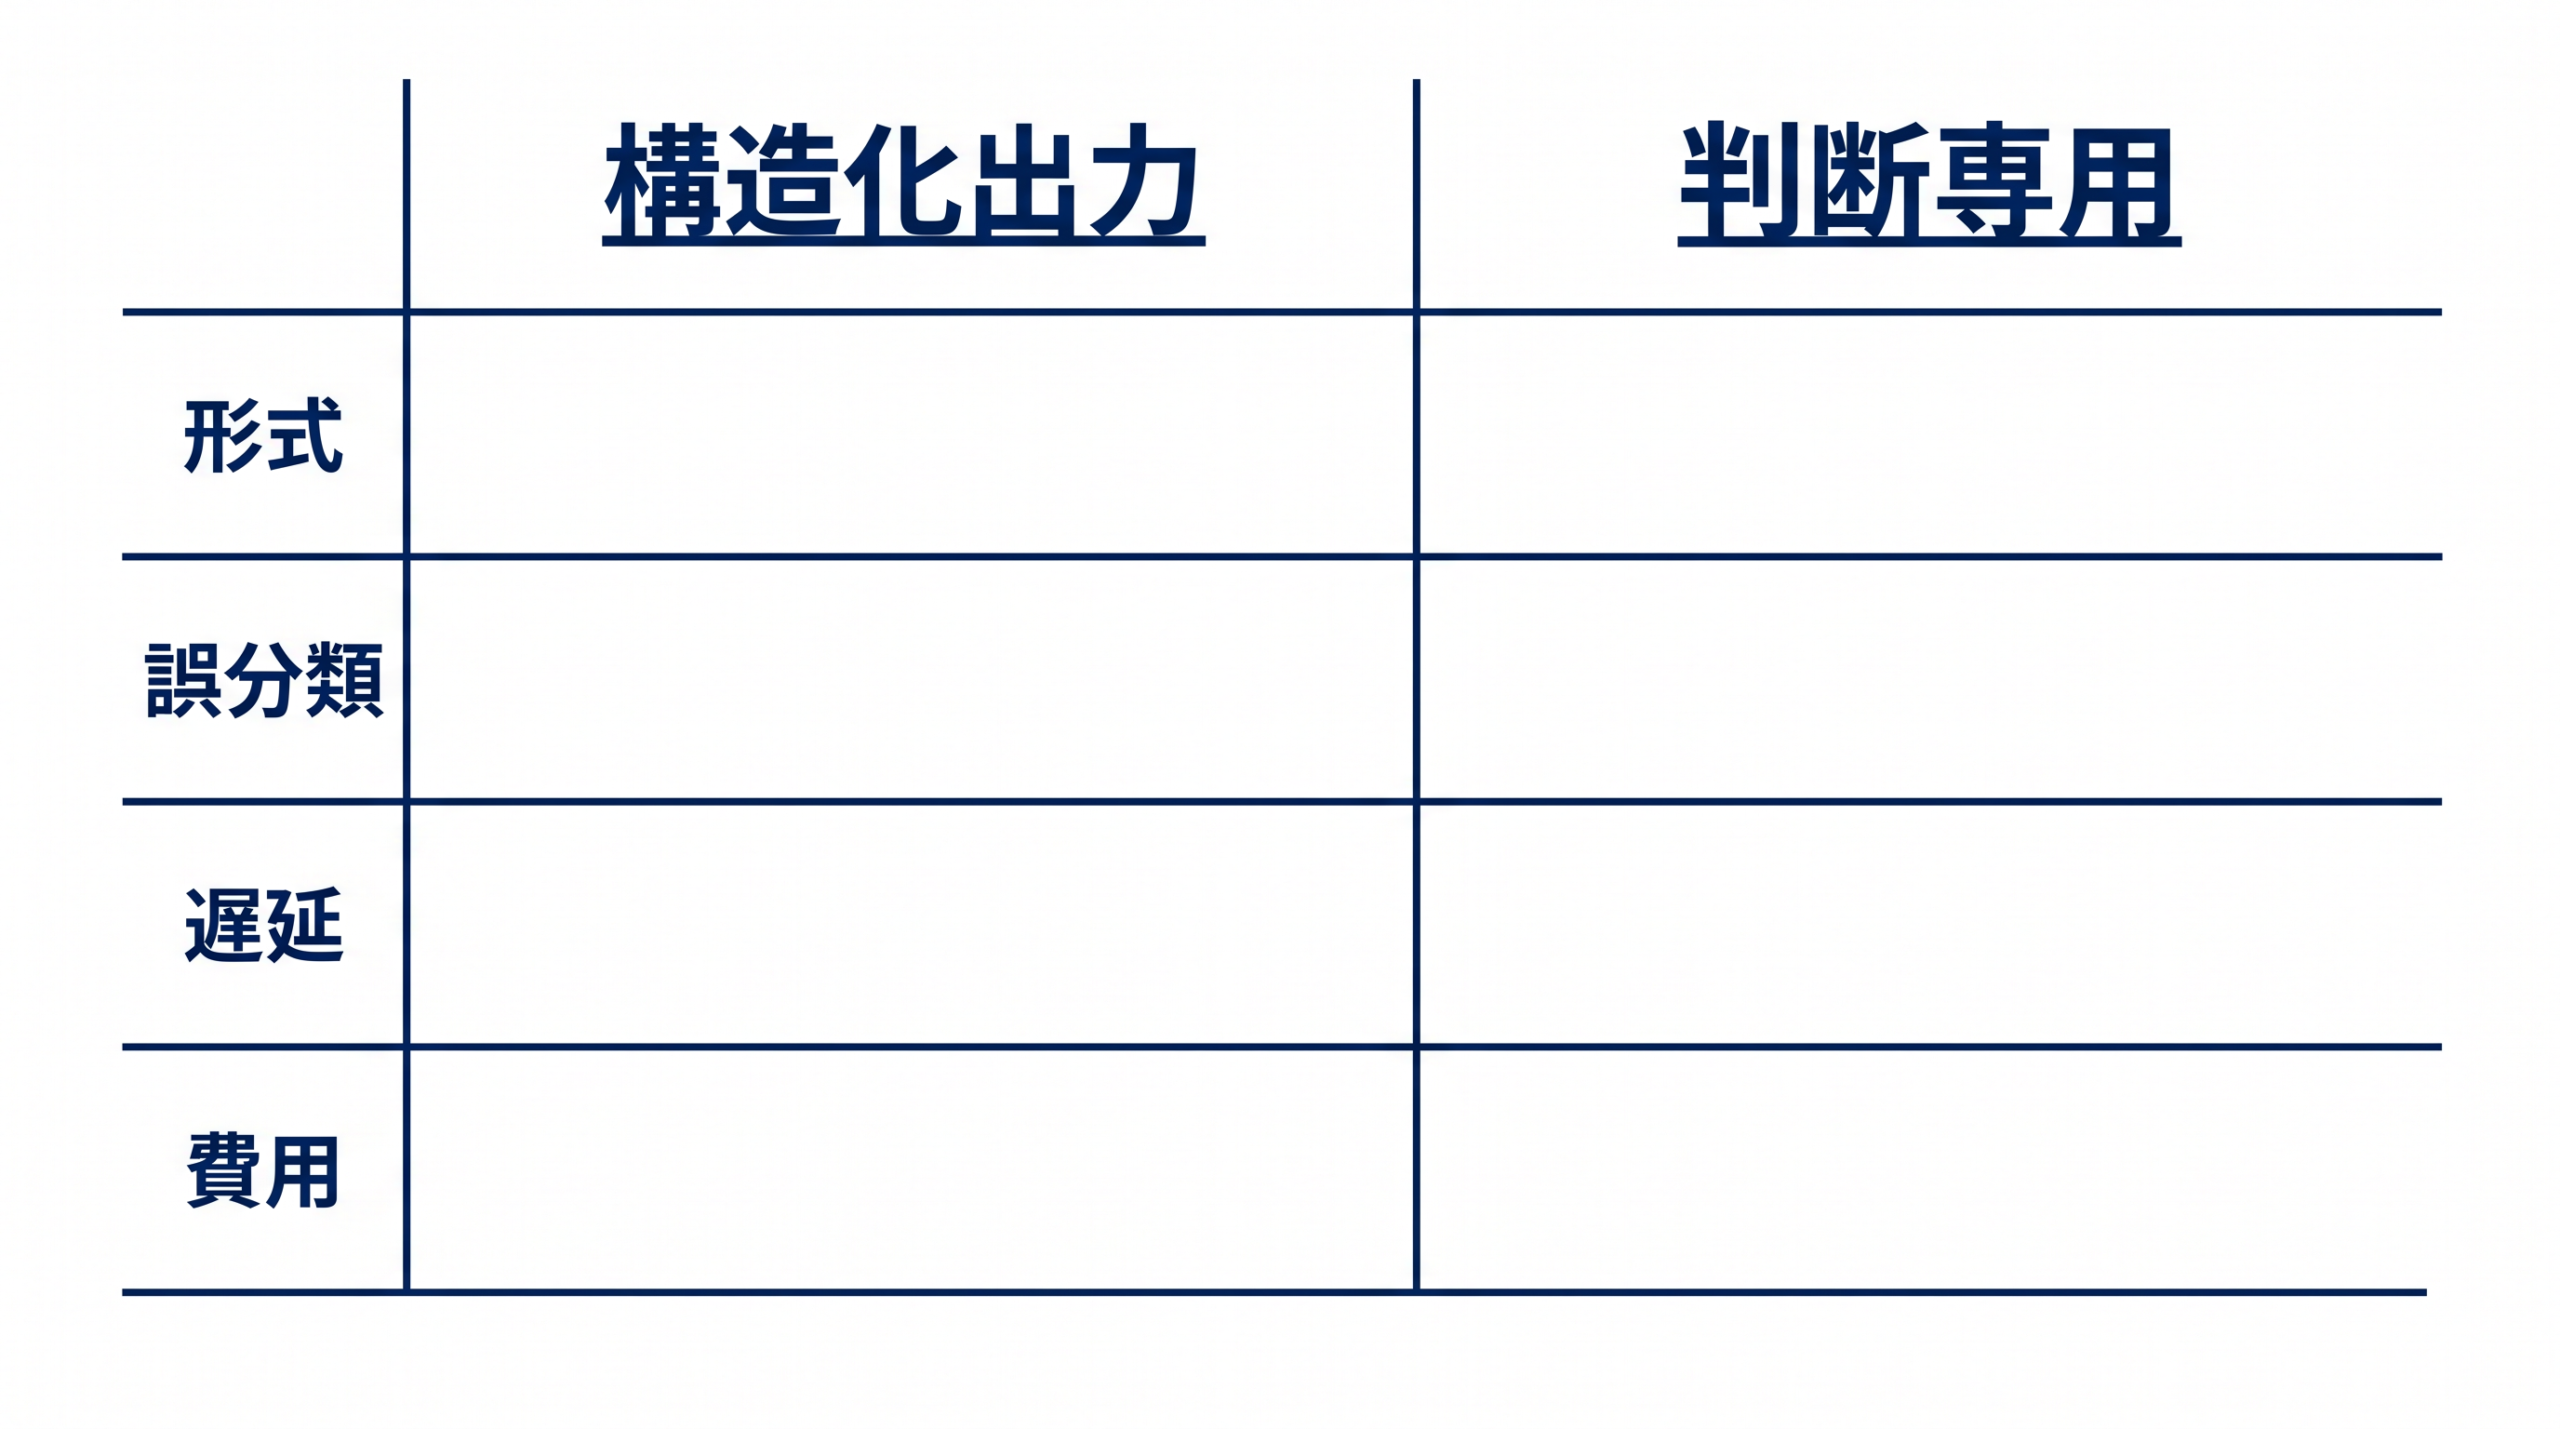
OpenAI、Anthropic、Googleは、文章生成モデルから指定スキーマに沿う結果を返す構造化出力を提供しています。これらはいずれも自由文の生成を前提とする機能を指定形式に合わせる仕組みであり、専用判断モデルの発表資料ではありません。これらをJevと比較する場合、「指定形式へ収められるか」だけではなく、「確率をどう返すか」「短い分岐での遅延と費用をどう評価するか」が重要な視点となります。
具体例として、「パスワードを忘れた」という問い合わせを3択へ分類する架空の検証を想定し、関係する要素を追います。 まず入力として、同じ問い合わせ本文を各社のモデルとJevへ渡します。次に操作として、他ラボのモデルには「技術」「請求」「営業」の分類先をJSONスキーマで指定し、Jevには同じ3択をChoiceとして指定してAPIを実行します。 その結果の出力として、他社モデルは自由文の生成を経て指定のJSONスキーマに沿った形式で分類を返し、Jevは生成文章を捨て、事前定義した型付きの選択や確率を返す設計に基づき、Choiceの「技術」という決定と判断の確率を返します。最後に人の確認として、これらの出力を受け取り、指定通りの形式かだけでなく、確率の確からしさ、応答にかかった遅延、APIの費用、そして実際の誤分類率を同条件で比較評価します。
ここからは現行機能の事実とは異なる編集上の推測ですが、他ラボが今後どのような対応をとるかについては条件付きで2つの道が考えられます。一つは既存の文章生成モデルにおける構造化出力をさらに改良し、速度や精度を高める道です。もう一つは、短い判断に特化した専用判断モデルを独自に試す道です。これらは未発表の計画を示すものではなく、他社が将来必ず同じアーキテクチャを出すとは断定できません。また、Jevがすべての用途で常に優れるわけでもないため、現時点では既存の構造化出力と判断専用モデルの特性を実測し、自社の用途に合うかを人が見極めることが次のAI開発へ進む条件となります。
よくある質問
Q1. JevはチャットAIの代わりですか
完全な代わりにはなりません。Jevは一般的なチャットAIのように自由な文章を生成せず、与えられた入力に対して選択肢や点数などの型付きの判断を返すことに特化しています。そのため、文章の作成には向いておらず、短い意思決定や分類の用途に絞って利用されます。
Q2. Jevを試すにはAPIキーが必要ですか
APIを直接呼び出す操作を行う場合は必要ですが、ブラウザ上のPlaygroundを入口とする方法も用意されています。そのため、手元の環境でコードを書かずに画面上で状態を入力し、操作と出力の確認を試すことが可能です。
Q3. 確率が高ければ判断は正しいですか
確率の数値が高くても判断が正しいとは限りません。指定した形式通りに結果を返す機能と、判断の正確さは別の問題です。複雑な文脈理解が必要な入力では誤判断が起こり得るため、出力された確率の数値を参考にしながら人が最終的な確認を行う必要があります。
Q4. Doomのデモではゲーム画面を直接見ていますか
ゲームの映像や画像を視覚的に直接見ているわけではありません。ゲーム内の現在の状況を構造化テキストとして入力し、そのテキスト情報をもとに次に取るべき行動を選択して出力する仕組みで実行されています。
Q5. 他のAIラボにも同じ機能がありますか
OpenAI、Anthropic、Googleなどは指定スキーマに沿う構造化出力を提供していますが、これらは自由文の生成を前提としたモデルの機能です。現状の事実として、Jevと同じアーキテクチャの専用判断モデルを他ラボが提供しているとは発表されていないため、実行時の遅延や確率の算出方法を含めてそれぞれの特性を実測して評価する必要があります。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント