
商品写真の背景変更や切り抜きといった制作作業において、「Qwen-Image-2.1」をどのように導入すればよいのでしょうか。このモデルは、生成・編集・透過・複数画像の参照をひとつのパイプラインで処理できる公開ウェイトの画像AIです。商品画像とテキスト指示を入力して合成画像や透過PNGを出力し、担当者がロゴや商品形状の同一性を最終確認するような実務へ応用できます。ただし、よく「7Bモデル」と呼ばれますが、これは視覚生成部分のみのサイズであり、実際の実行系にはテキスト・条件画像エンコーダー(Qwen3-VL 8B)やRGBA VAEも含まれます。そのため、「Qwen-Image-2.1をどの経路で試し、生成や編集の機能を実際の制作へ使えるのか、そして実行系全体で必要な資源と利用条件をどう判断すべきか」が重要な疑問となります。
本記事では、このモデルを安全かつ効果的に評価するための判断基準を整理します。実行環境としては、提供者のWebブラウザから試す「オンライン画面」、外部サービスをプログラムから呼び出す「第三者API」、自社で管理する「クラウドGPU上の自前推論API」、そしてComfyUIやDiffusersを用いる「ローカルPC」の4経路を明確に区別します。記事を読み終えることで、これらの中から最初の検証経路を選び、同じ解像度や手順を用いた比較テストと、非商用の評価目的か別途許諾が必要な商用利用かを分けたライセンス確認をすぐに始められるようになります。
Qwen-Image-2.1は生成と編集を一つにつなぐ
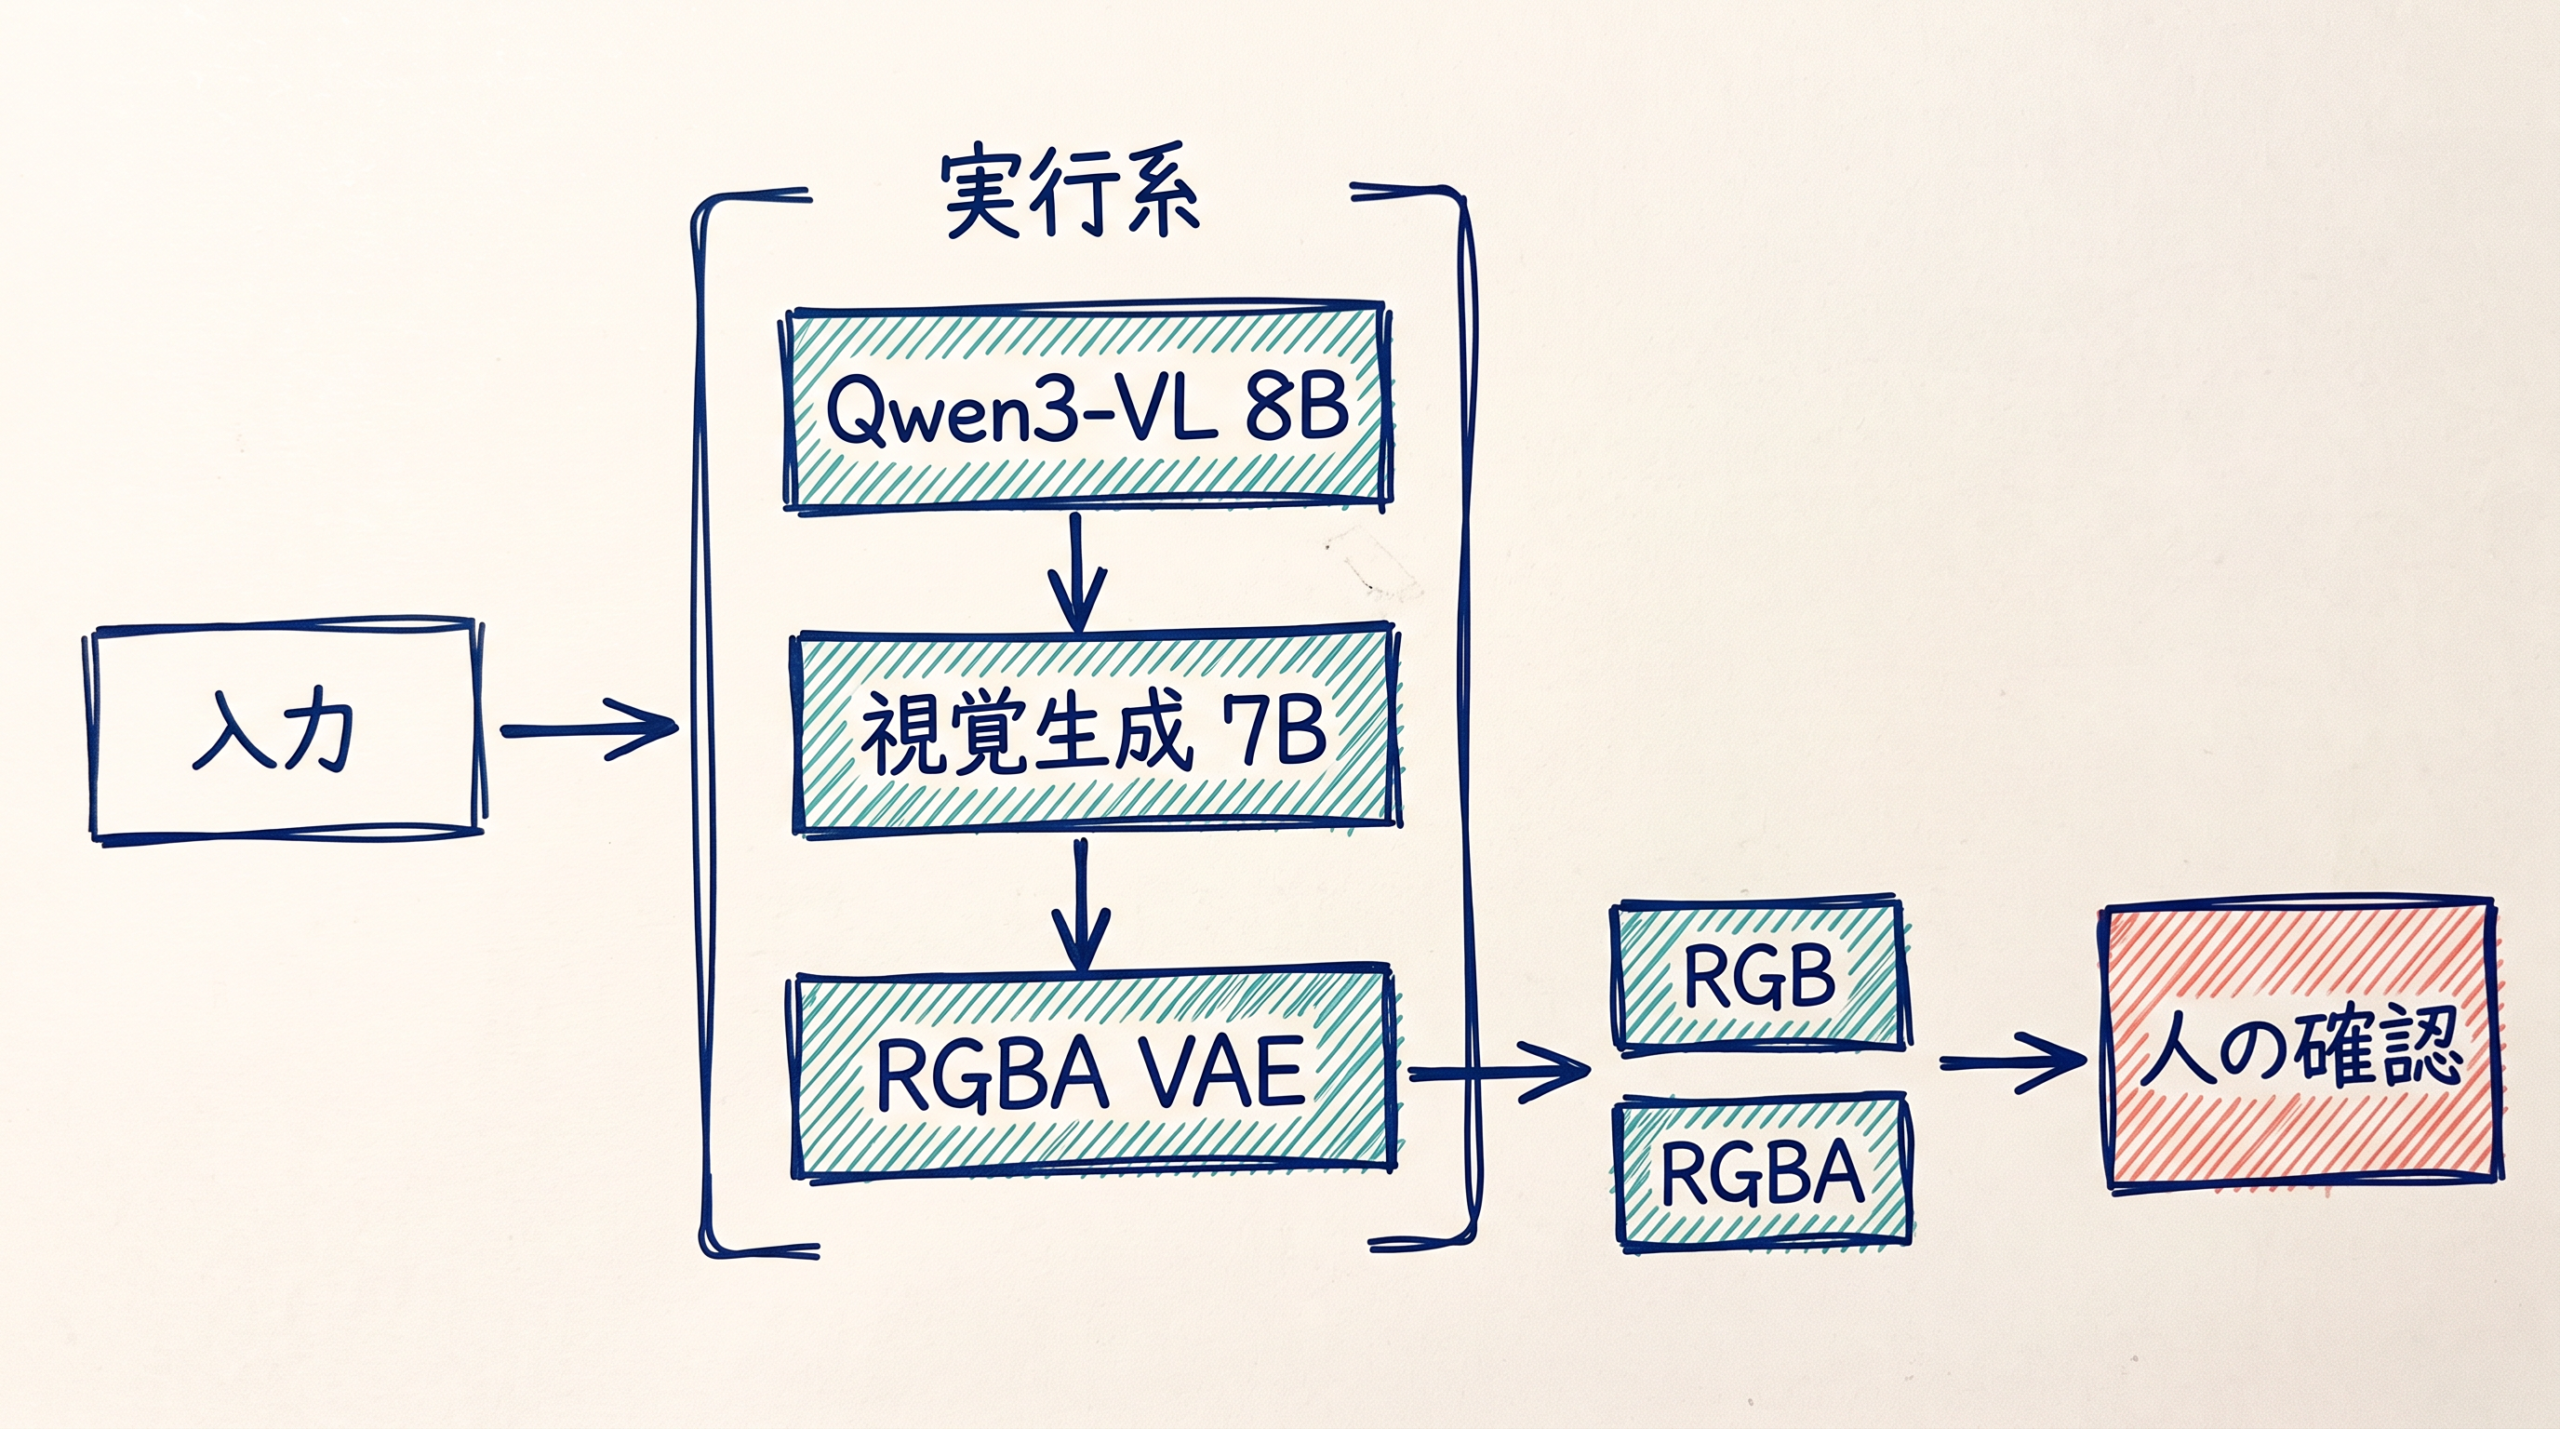
Qwen-Image-2.1は、テキストからの画像生成と既存画像の編集を一つのパイプラインで実行できる公開ウェイトの画像モデルです。透過RGBA画像の出力や、最大10枚の参照画像を利用した生成、さらに円や塗り、マスク指定による局所編集にも対応しています。
このモデルはよく7Bのモデルとして紹介されます。しかし、公式リポジトリが7Bとしているのは、32層のsingle-stream DiTで構成される視覚生成部分のみです。実際の実行環境では、文章と条件画像を同じ表現へエンコードするQwen3-VL 8Bと、64チャネルで16倍の空間圧縮を行いながら4チャネル入出力を保つRGBA VAEも動作します。そのため、7Bという数字だけを見てディスク上のファイルサイズや実行時に必要なVRAMを判断することはできません。
Qwen-Image-2.1の価値は、単にきれいな画像を生成することではなく、実際の制作作業で求められる処理をつなげる点にあります。たとえば商品画像の制作において、元の商品写真と「商品本体を変えず、背景を秋の店頭へ変更する」というテキスト指示をモデルへ渡します。モデルは同一のパイプライン上で処理を行い、秋の背景へ変更された合成画像や、背景が透明に切り抜かれたRGBA画像を出力します。
出力後には、担当者が商品名、ロゴ、商品の形、色、付属品、影、半透明部分、そして透過のアルファ境界が元画像と正しく合致しているかを照合します。このように、背景案の反復生成や切り抜き候補の作成といった作業をAIへ担わせつつ、最終的なロゴや商品表示の承認を人が行う実用的な制作ワークフローを構築できます。
新機能はRGBA・最大10枚参照・局所編集
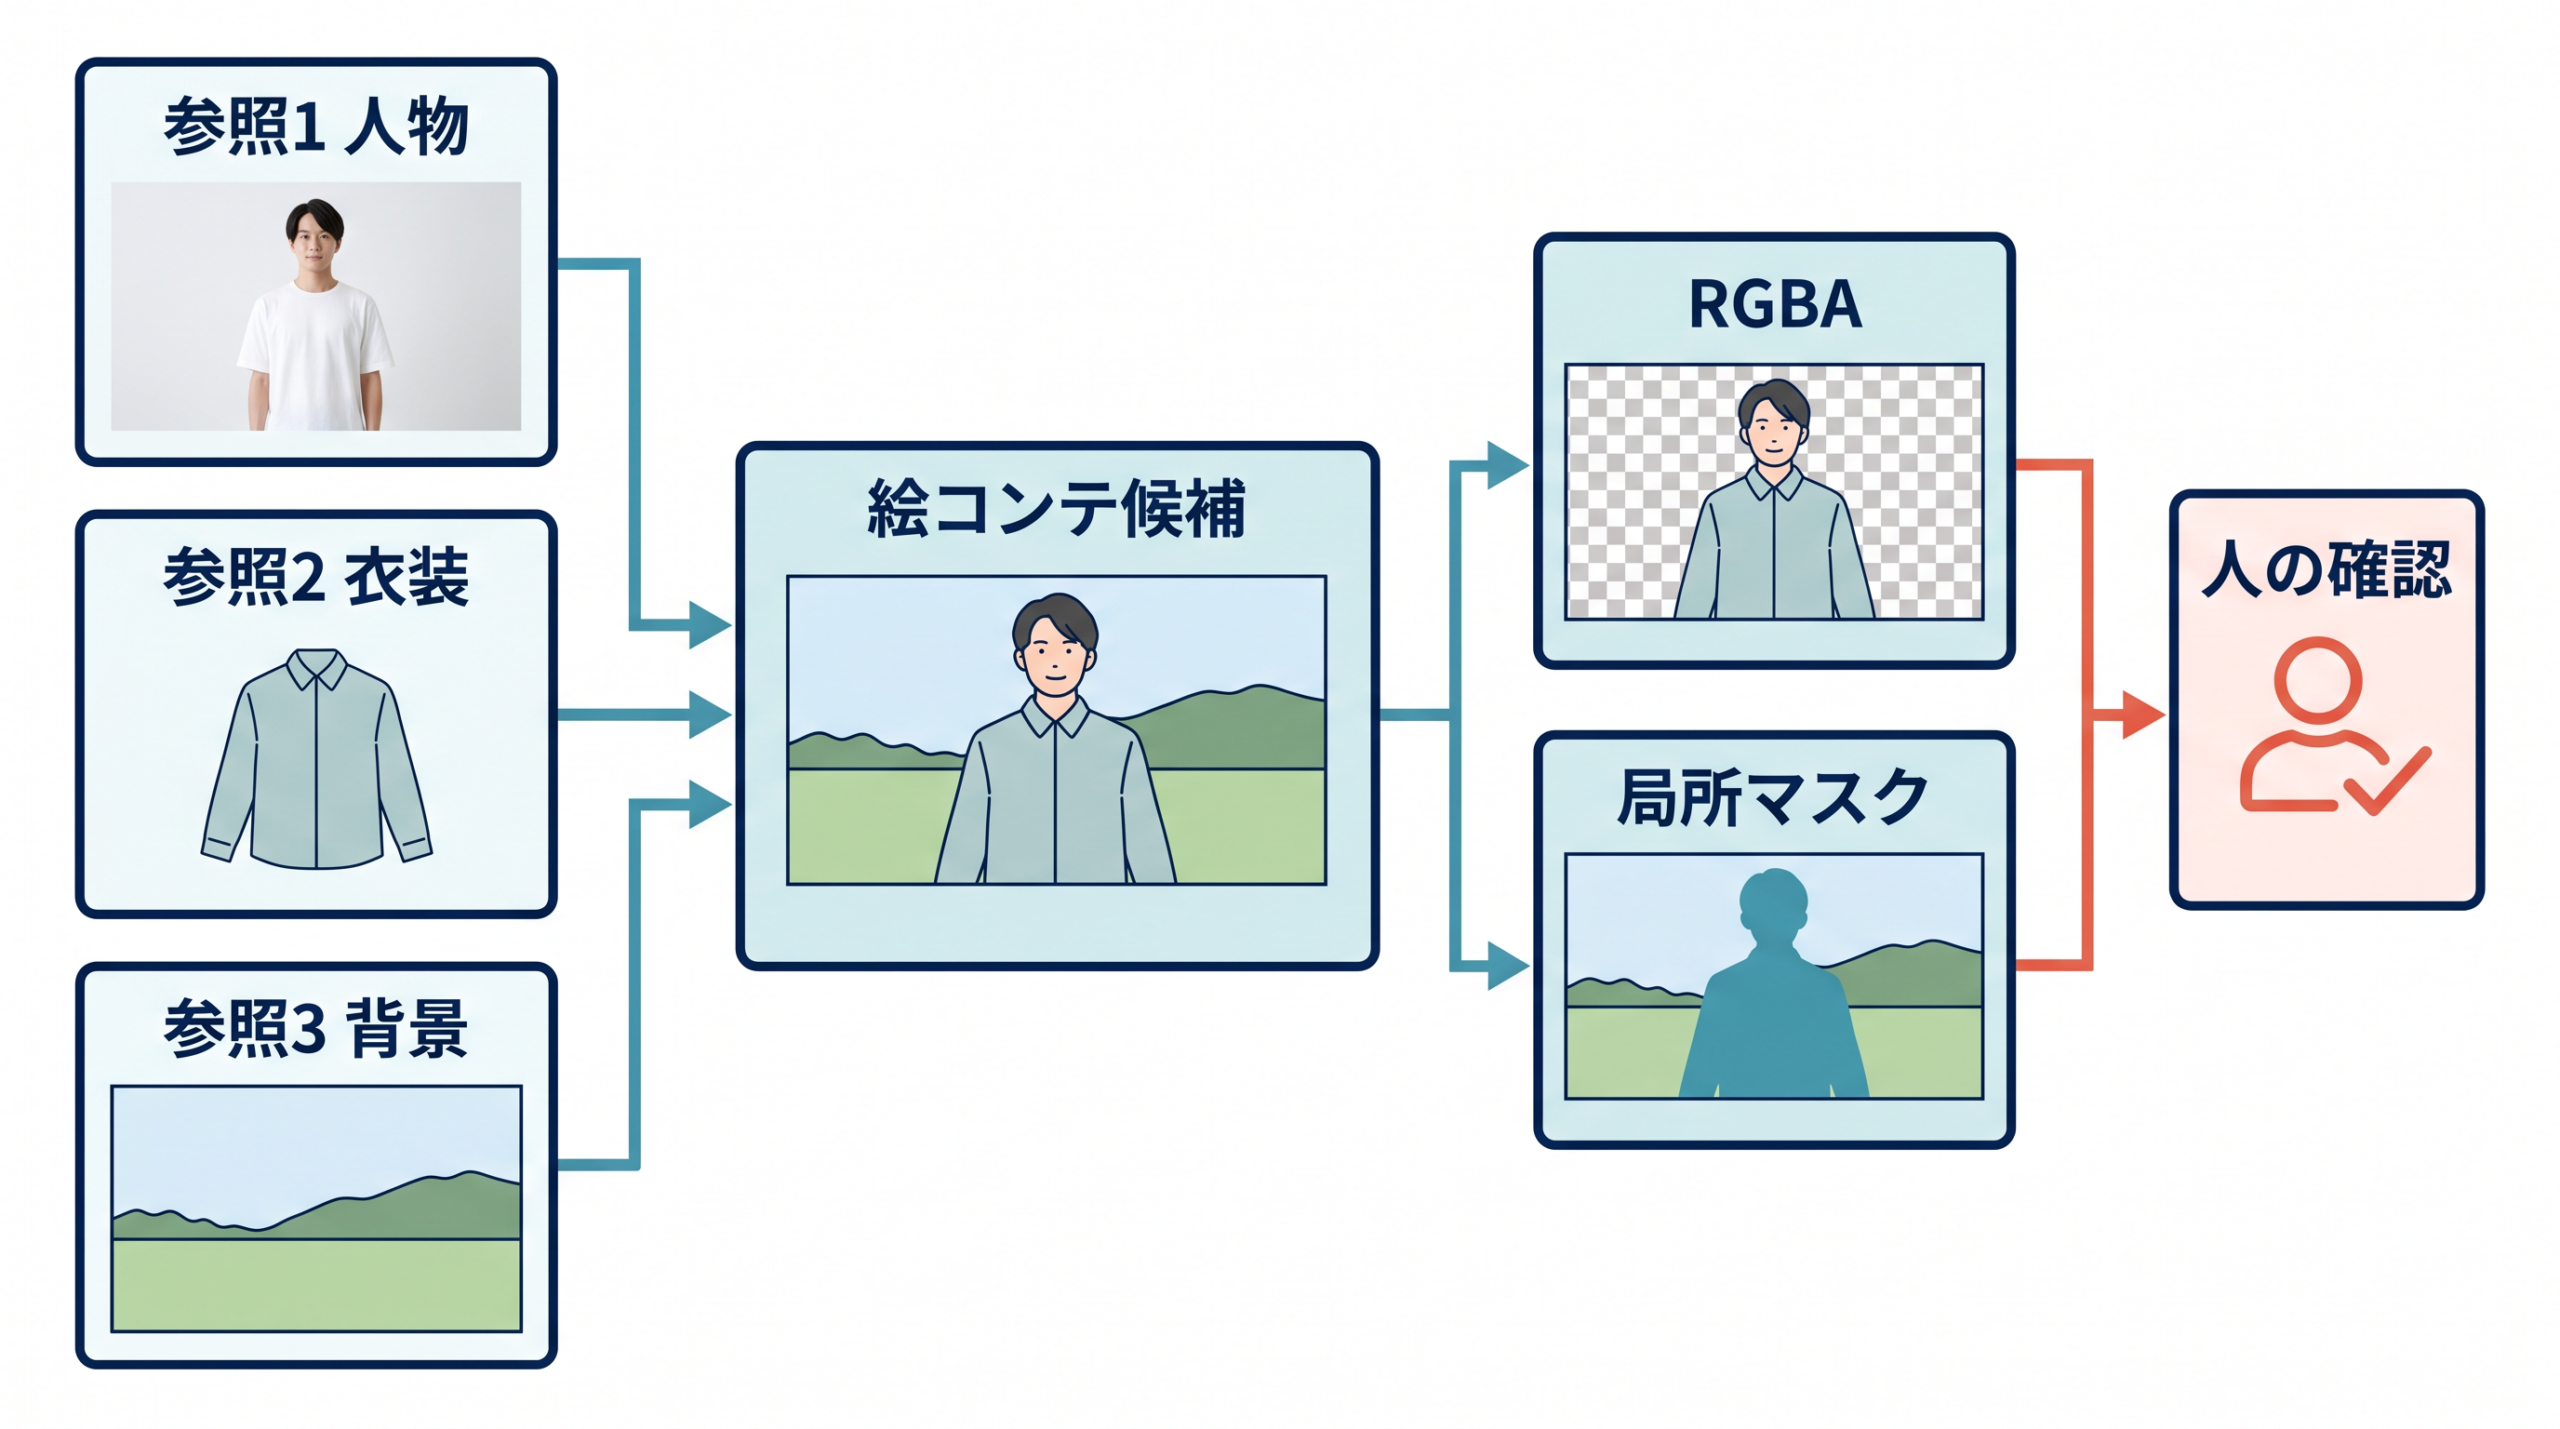
従来の画像生成AIは、テキストから一枚の新しいRGB画像を出力する機能が中心でした。これに対してQwen-Image-2.1は、テキスト画像生成と画像編集を一つのパイプラインで扱い、実際の制作作業へ直結する機能を提供しています。
とくに複数画像の参照機能では、公式リポジトリの説明にある通りQwen3-VL 8Bが文章と条件画像を同じ表現へエンコードします。さらにDiffusers公式資料で解説される混合粒度attentionとprefix KV cacheにより、編集時の入力画像と指示の計算結果を最初のステップで保存し、後続のステップで再利用します。これにより、複数枚を参照した際の重複計算を減らす設計になっています。
この機能を漫画や映像の絵コンテ制作へ応用する場合、人物、衣装、背景などの参照画像を順序付きで渡し、どの参照画像がどの要素に対応するかをプロンプトへ明記して構成させます。ただし、最大10枚まで参照できる仕様は10人のキャラクターの同一性が自動で完全に保証されるという意味ではありません。出力された候補画像に対して、担当者が顔、髪、衣装、人数、手足の形、前後カットとの連続性に破綻がないかを目視で確認する工程が不可欠です。
また、透過画像の生成に対応している点も特徴です。RGBA VAEが4チャネルの入出力を保つ設計となっており、RGBAと背景透明を明記する推奨形式が公開されています。これにより、別の背景と合成するための切り抜き素材を直接得ることができます。
さらに局所編集では、円の指定、塗りつぶし、または独立したマスクと修正指示を入力することで、特定の部分だけを変更できます。この編集作業においても、担当者は出力結果の境界線、影、光源、そして指示外の領域が勝手に変わっていないかを元画像と差分確認する必要があります。もし、絶対にピクセル単位で変えたくない要素がある場合は、AIだけで編集を繰り返すのではなく、承認済みの元画像と画像編集ソフトを用いた手作業での合成へ切り替える判断が求められます。
利用経路はオンライン・第三者API・クラウド・ローカル
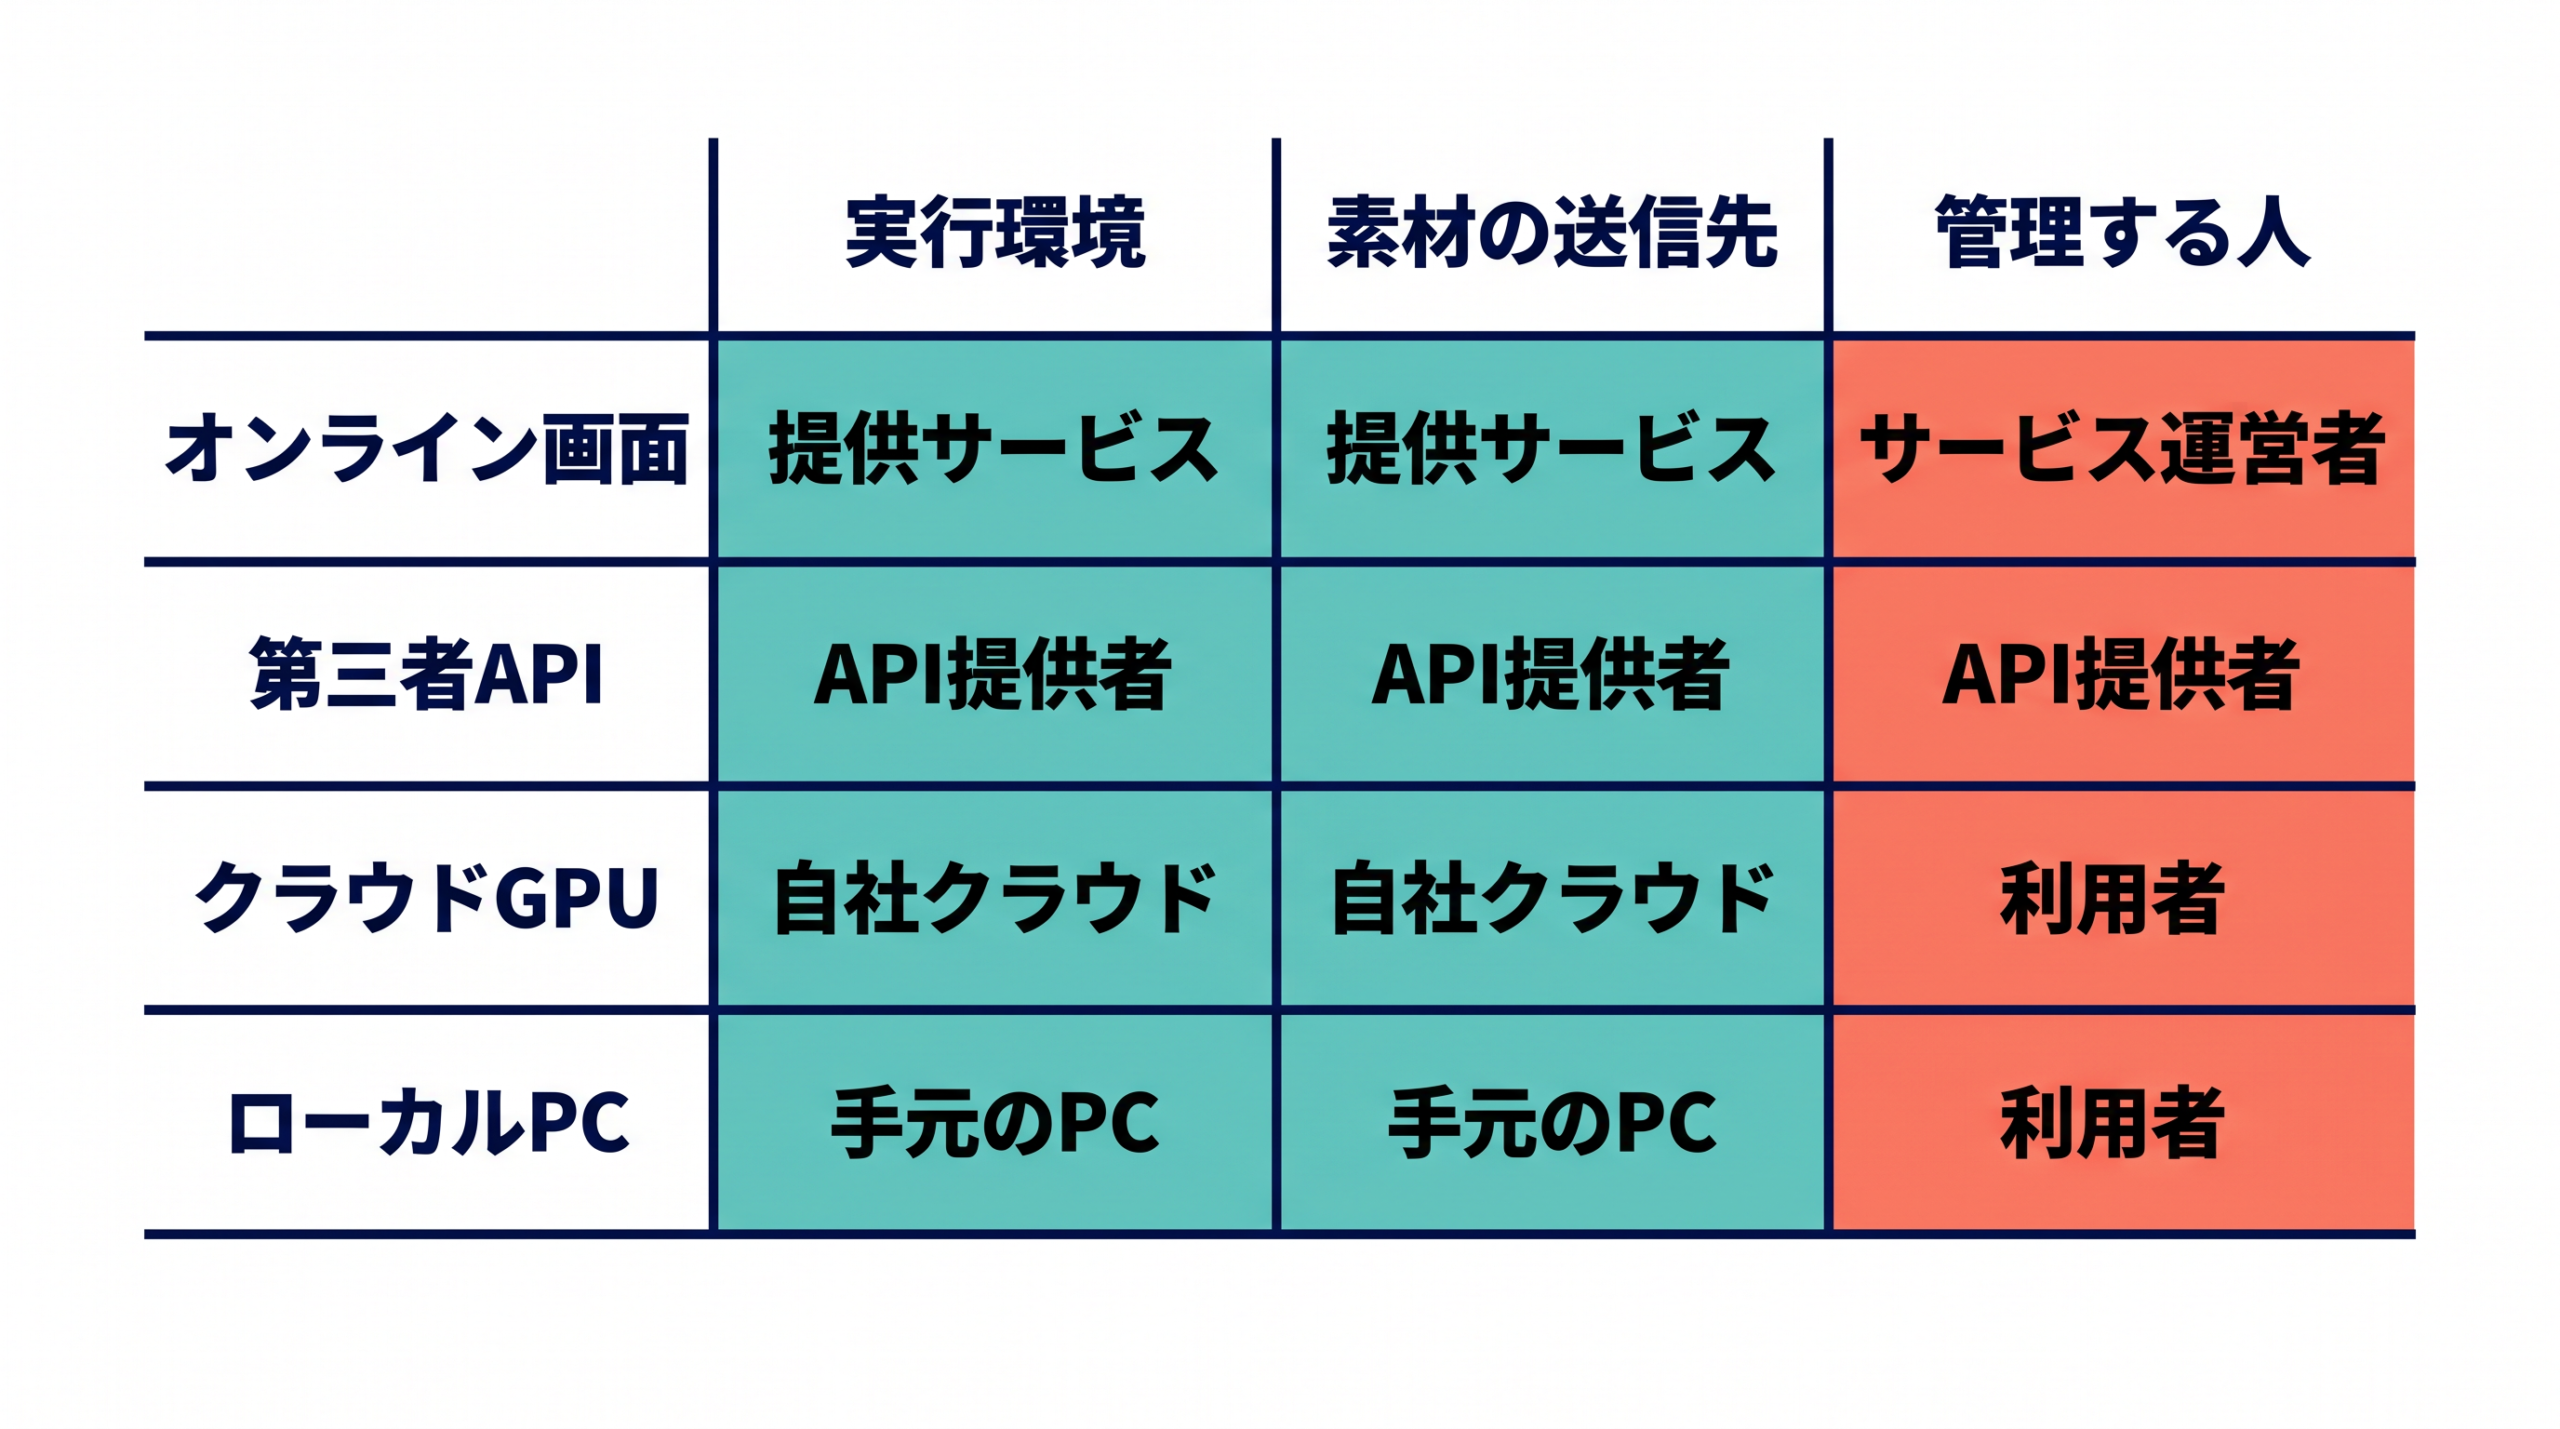
Qwen-Image-2.1をどこから使うかは、実行環境を誰が用意し、誰の環境へ画像素材を送るかによって4つの経路に分かれます。導入を検討する際は、いきなり本番のデータを流し込むのではなく、社外秘ではない商品写真などを用いて、各経路のデータ送信先、課金体系、ユーザー権限の管理が自社のセキュリティ要件に合うかを確認します。提供者、費用、送信先、責任の観点から4つの経路を整理します。
オンライン画面 中国本土向けのwuli.artはChatboxとCanvasで全機能を無料提供し、ModelScopeはオンライン生成とLoRA学習に対応します。これらはサービスの運営者が提供する画面へ素材を送る経路です。無料という記述だけでは、地域制限、アカウント条件、データの保存期間、AI学習への利用有無、ユーザー自身によるデータ削除方法までは確定しません。そのため、公開前の商品画像など社外秘の素材を安易に入力しない運用責任が求められます。
第三者のホスト型API Layerなどの第三者サービスが設けた推論APIを呼び出す経路です。注意点として、これはLayerが運営するAPIであり、QwenまたはAlibaba Cloudの公式Qwen-Image-2.1 APIではありません。なお、2026年9月22日時点のAlibaba Cloud Model Studioの画像モデル一覧にはQwen-Image-2.1というモデルIDはなく、WanやZ-Imageなどが掲載されていますが、これらを公開ウェイトの2.1と同じ公式APIとしては扱いません。この経路では、APIキーの発行、従量課金、レート制限、入力と出力データの保存ポリシー、サーバーの設置地域、提供側のライセンスを、第三者サービス側で個別に確認する責任が生じます。
クラウドGPU上の自前推論API クラウドプロバイダーからGPUを借りて公式ウェイトを置き、利用者自身で推論APIを立てる経路です。vLLM公式レシピやSGLang公式Cookbookなどを参考に構築します。第三者のホスト型APIを利用する経路とは異なり、利用者がGPUリソース、モデルの保存、認証、TLS通信、ログ、入力画像、生成物、システムの起動停止、そしてインフラ費用をすべて自社で管理します。送信先が自社のクラウドリソース内になるためデータの統制は効きますが、インフラ構築と運用の責任を負います。
ローカルPC ComfyUI用配布ファイルやDiffusersを用いて、手元のPC内で実行する経路です。第三者の生成APIやサーバーへ入力素材を一切送らない構成を作りやすいため、最もデータ送信先が限定されます。ただしクラウド管理が不要になる一方で、モデルのダウンロード元、端末内に残るキャッシュ、ローカルログ、PCのユーザー権限、バックアップの管理は利用者が担います。また、後述するResearch Licenseの適用条件は、ローカルで動かす場合であっても免除されません。
オンライン画面とホスト型APIで試す
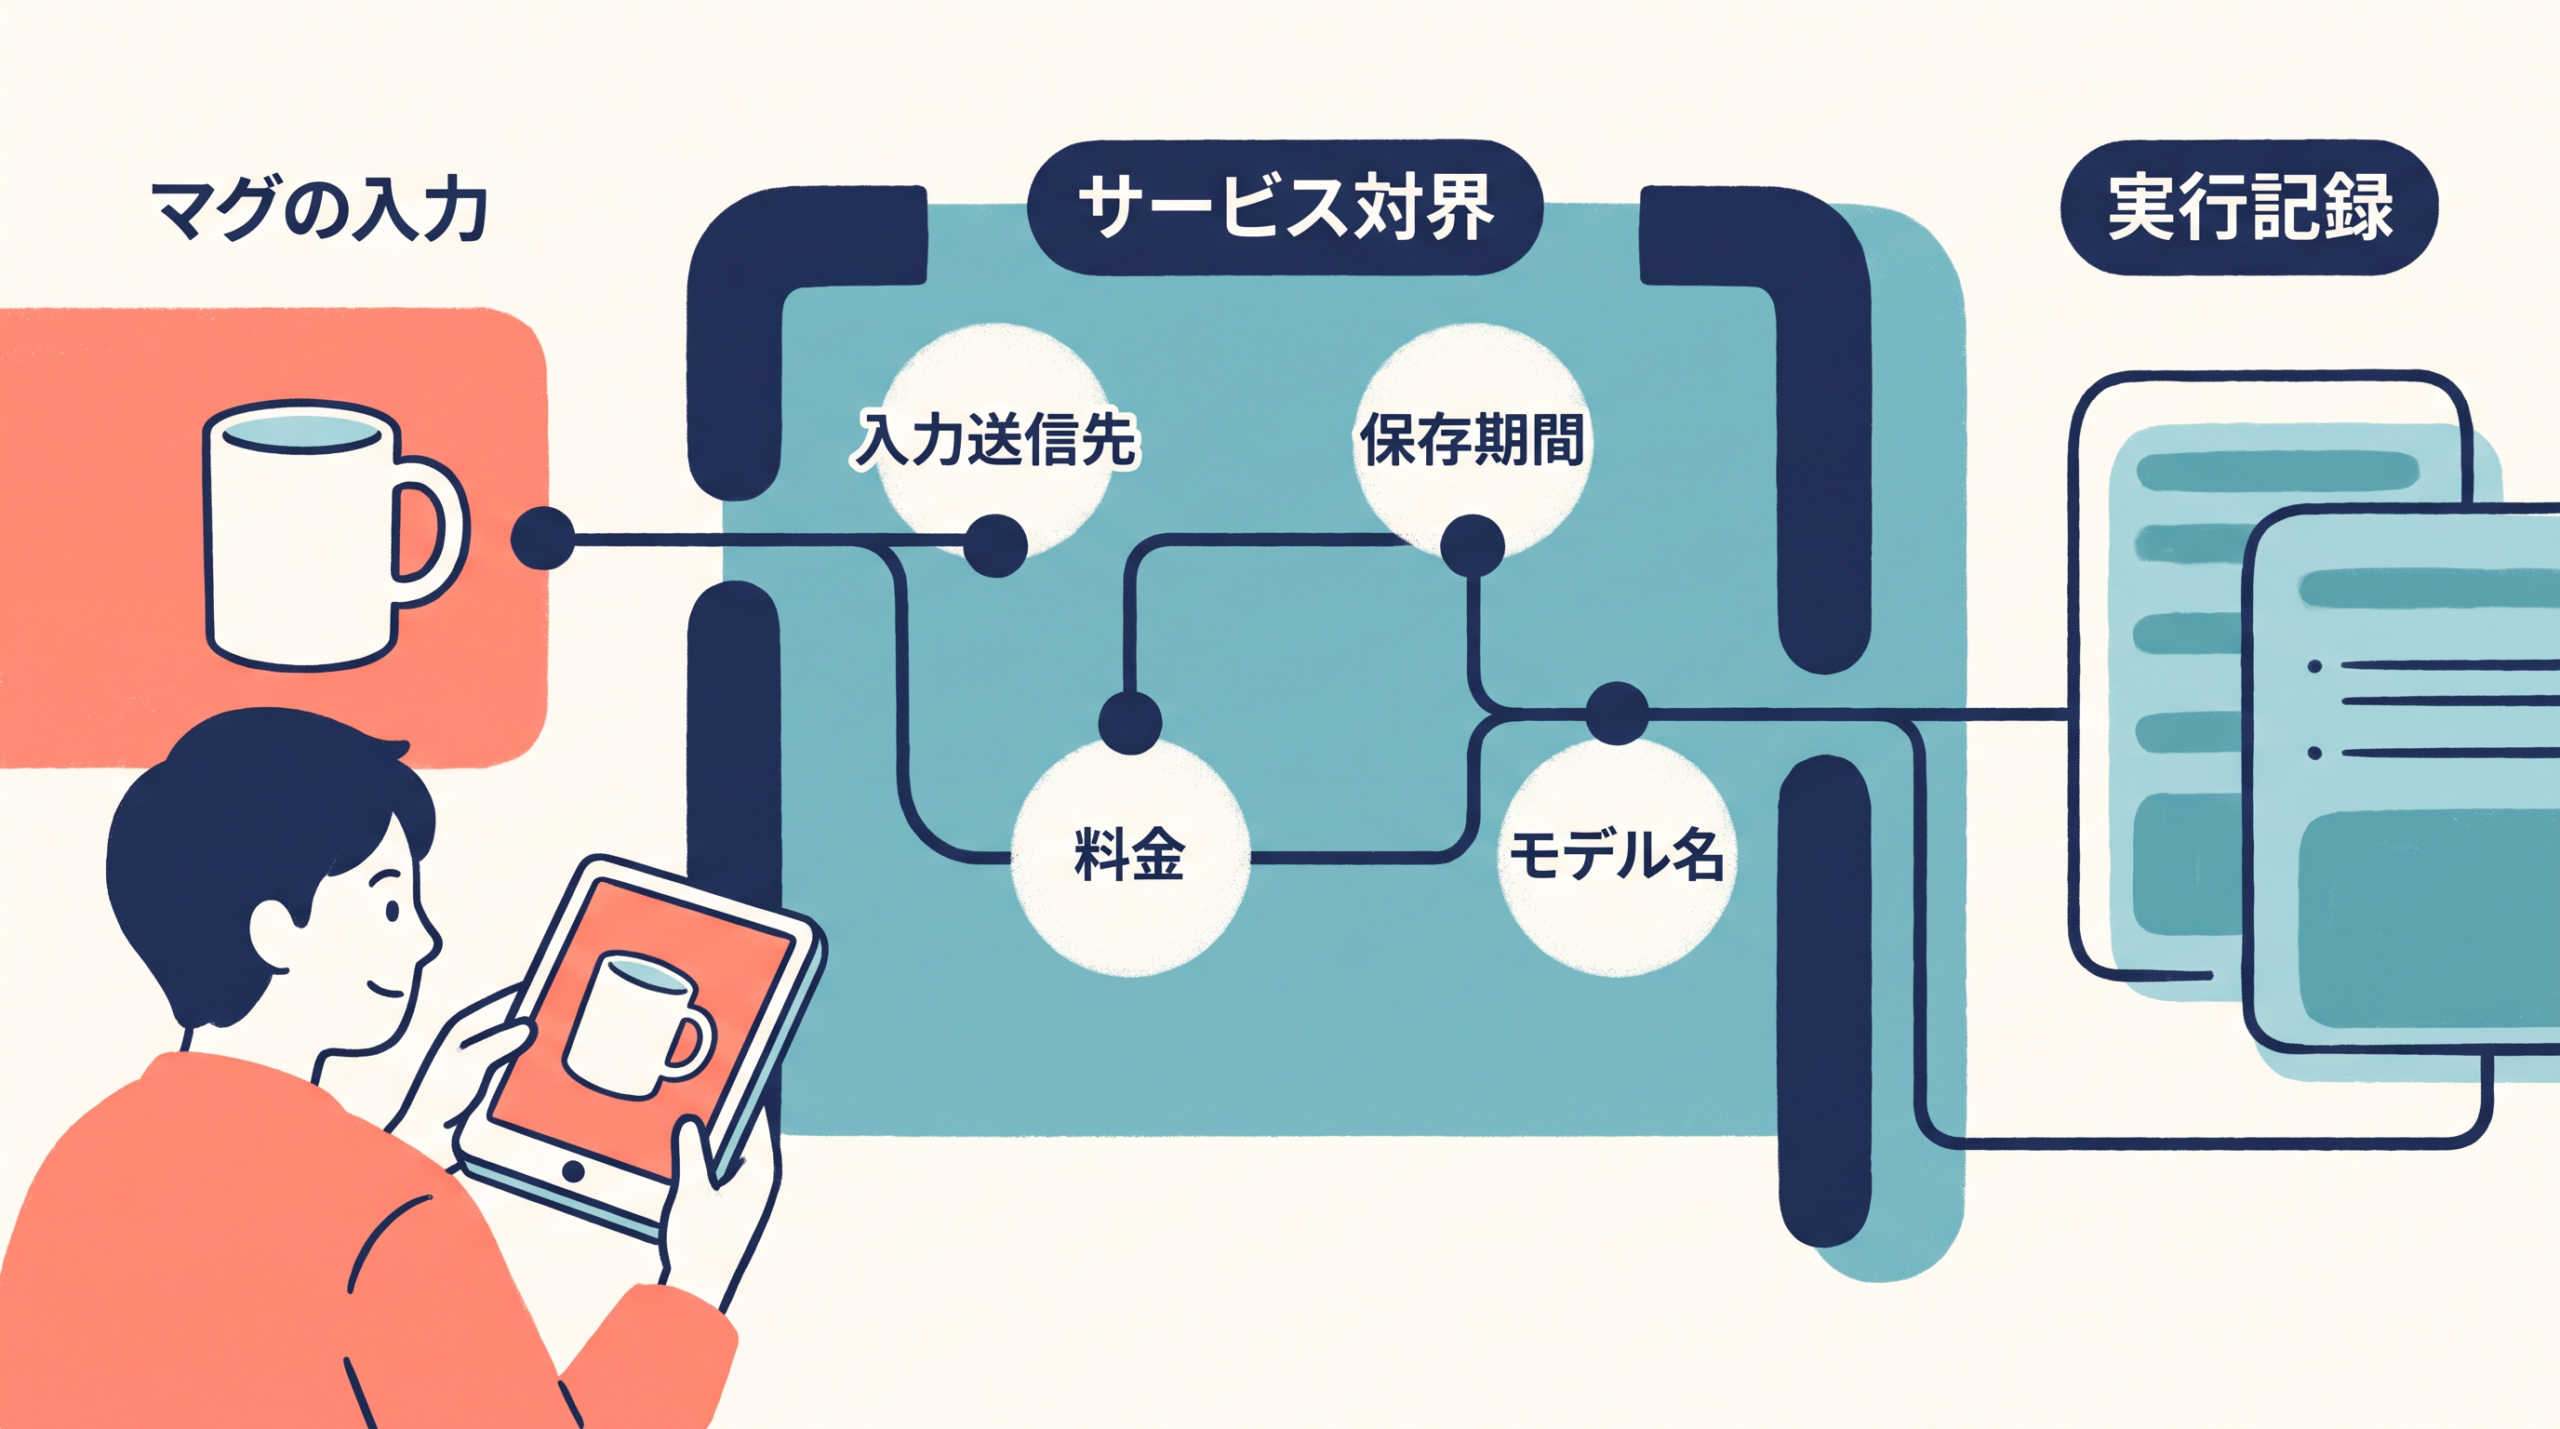
GPUを用意せずに試すには、オンライン画面かホスト型の推論APIを使います。サービスを選ぶ際は、提供者と画像の送信先を確認します。
公式資料で案内されているオンライン画面としては、中国本土向けにChatboxとCanvasで全機能を提供するwuli.artや、オンライン生成とLoRA学習に対応するModelScopeがあります。両サービスの画面へ画像を送る前に、アカウントと地域の条件、素材の保存と削除の扱いを確認します。
プログラムから呼び出す場合は、Layerなどの第三者サービスがQwen-Image-2.1の推論APIを提供しています。ここで注意すべきは、これはLayerが独自に運営するホスト型APIであり、QwenやAlibaba Cloudが提供する公式APIではないという点です。APIキーの取得、従量課金、レート制限、入出力の保存、利用地域、ライセンスに関する条件はすべてLayer側で確認します。
これらの環境を使って実際にテストを行う際は、公開可能なマグカップ画像のようなテスト素材を用意し、背景を変更するといった編集指示を送信して挙動を試します。利用するサービスの規約を事前に確認したうえで生成を実行し、画像の送信先が意図したサーバーであるか、システム側に残るデータが自社の要件に合致しているか、そして実行されたモデル名が間違いなくQwen-Image-2.1であるかを利用者自身で確認します。手元にGPU環境がなくても、このような手順を踏むことで、外部サービスを利用する際の責任範囲と仕様を具体的に把握できます。
ComfyUIとDiffusersでローカル実行する
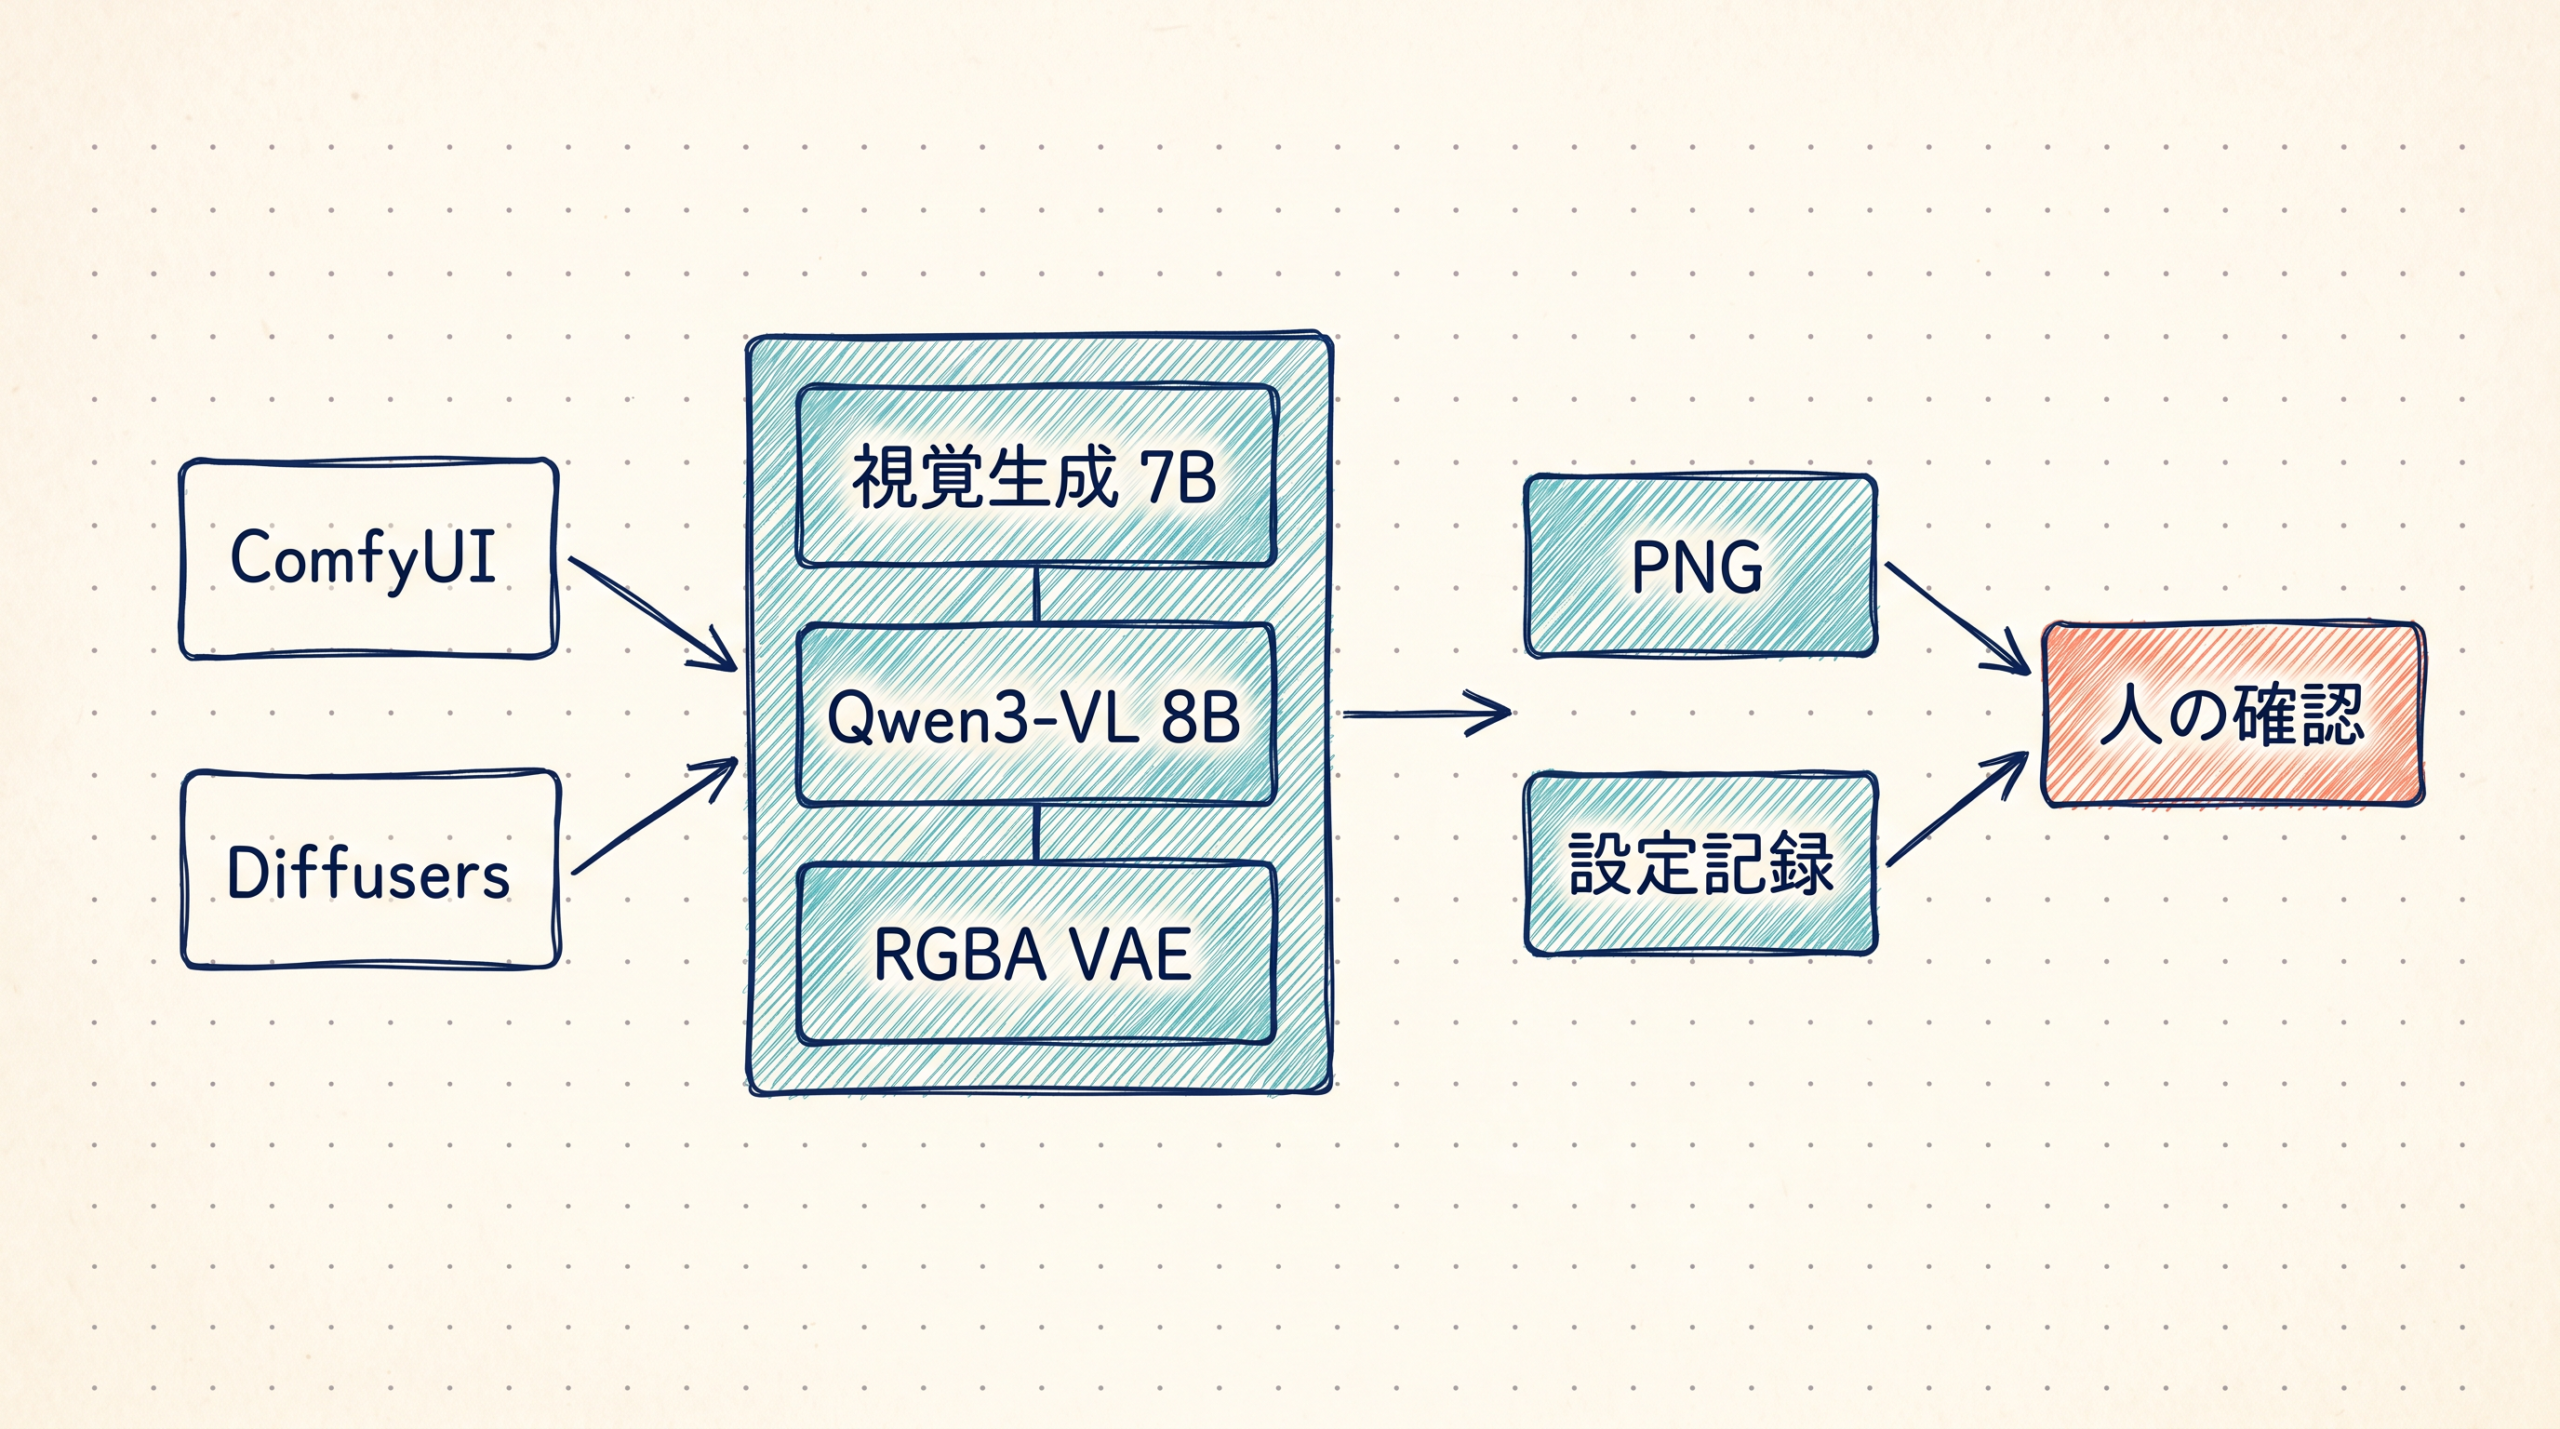
外部サービスへ画像を送らずに試すには、手元のPCか自社管理のサーバーにあるGPUで実行します。生成物とキャッシュの保存先、PCの利用者権限は、自社の環境に合わせて設定します。
自分のGPUでQwen-Image-2.1を実行するには、主にノードベースのUIであるComfyUIを使用する方法と、PythonライブラリであるDiffusersを使用する方法の二種類があります。
ComfyUIを使う場合は、ComfyUI配布先から必要なウェイトを取得し、公式ComfyUIワークフローを読み込みます。このとき、7Bの視覚生成部分だけでなく、テキストおよび条件画像エンコーダーであるQwen3-VL 8BとRGBA VAEを正しく配置する必要があります。実行時には、公式の標準例として案内されている40ステップや解像度、シード値を指定し、生成や編集の指示となるプロンプトを入力して結果のPNG画像を得ます。担当者は、設定記録を元に意図したモデル部品が使われているか、データの保存先が正しいローカルディレクトリになっているかを照合します。
Diffusers公式資料を利用する場合は、Pythonスクリプト内で公式ウェイトを直接指定し、パイプラインの構成を明示的に記述して実行します。この手順を踏むことで、GPU上でどのようなコンポーネントが動いているかを正確に把握しつつ、入力データが外部へ送信されていないことを明確に担保できます。
Macでの実行と注意点
ブラウザからオンライン画面やAPIを経由して利用する場合は端末を選びませんが、Mac本体でローカル実行する場合にはいくつかの条件と報告があります。Hugging Face Diffusersの一般資料は実行先候補としてMPSを示していますが、これはQwen-Image-2.1固有の全機能保証ではなく、Qwen公式リポジトリの標準例はCUDAを前提としています。また、Intel Macでのローカル実行は現時点で確認できていません。
Apple Siliconを搭載したMacでのテキストからの画像生成については、利用者の自己報告として、M2搭載で32GBメモリのMacBook Proを使用し、DiffusersのパイプラインをMPSへ載せて1024×1024ピクセル、40ステップの画像を約16分で生成した例があります。これは1台の端末による報告であり、公式の保証や一般的な性能を示すものではありません。
一方、入力画像を用いた編集機能については課題が報告されています。ComfyUIのGitHub Issueでは、M5 Max搭載で128GBメモリの環境において、MPS上で実行するとVAEによるエンコードが画像編集用の入力を破損する現象が指摘されています。CPUでVAEを処理することで品質低下を回避できたとされていますが、このIssueは未解決のままです。テキストからの生成はデコードのみを使用するため同報告内でも正常に動作したとされていますが、Mac環境ではテキストからの生成と画像を入力する編集とで動作状況が異なる点に注意が必要です。
必要スペックはVRAMだけで決めない
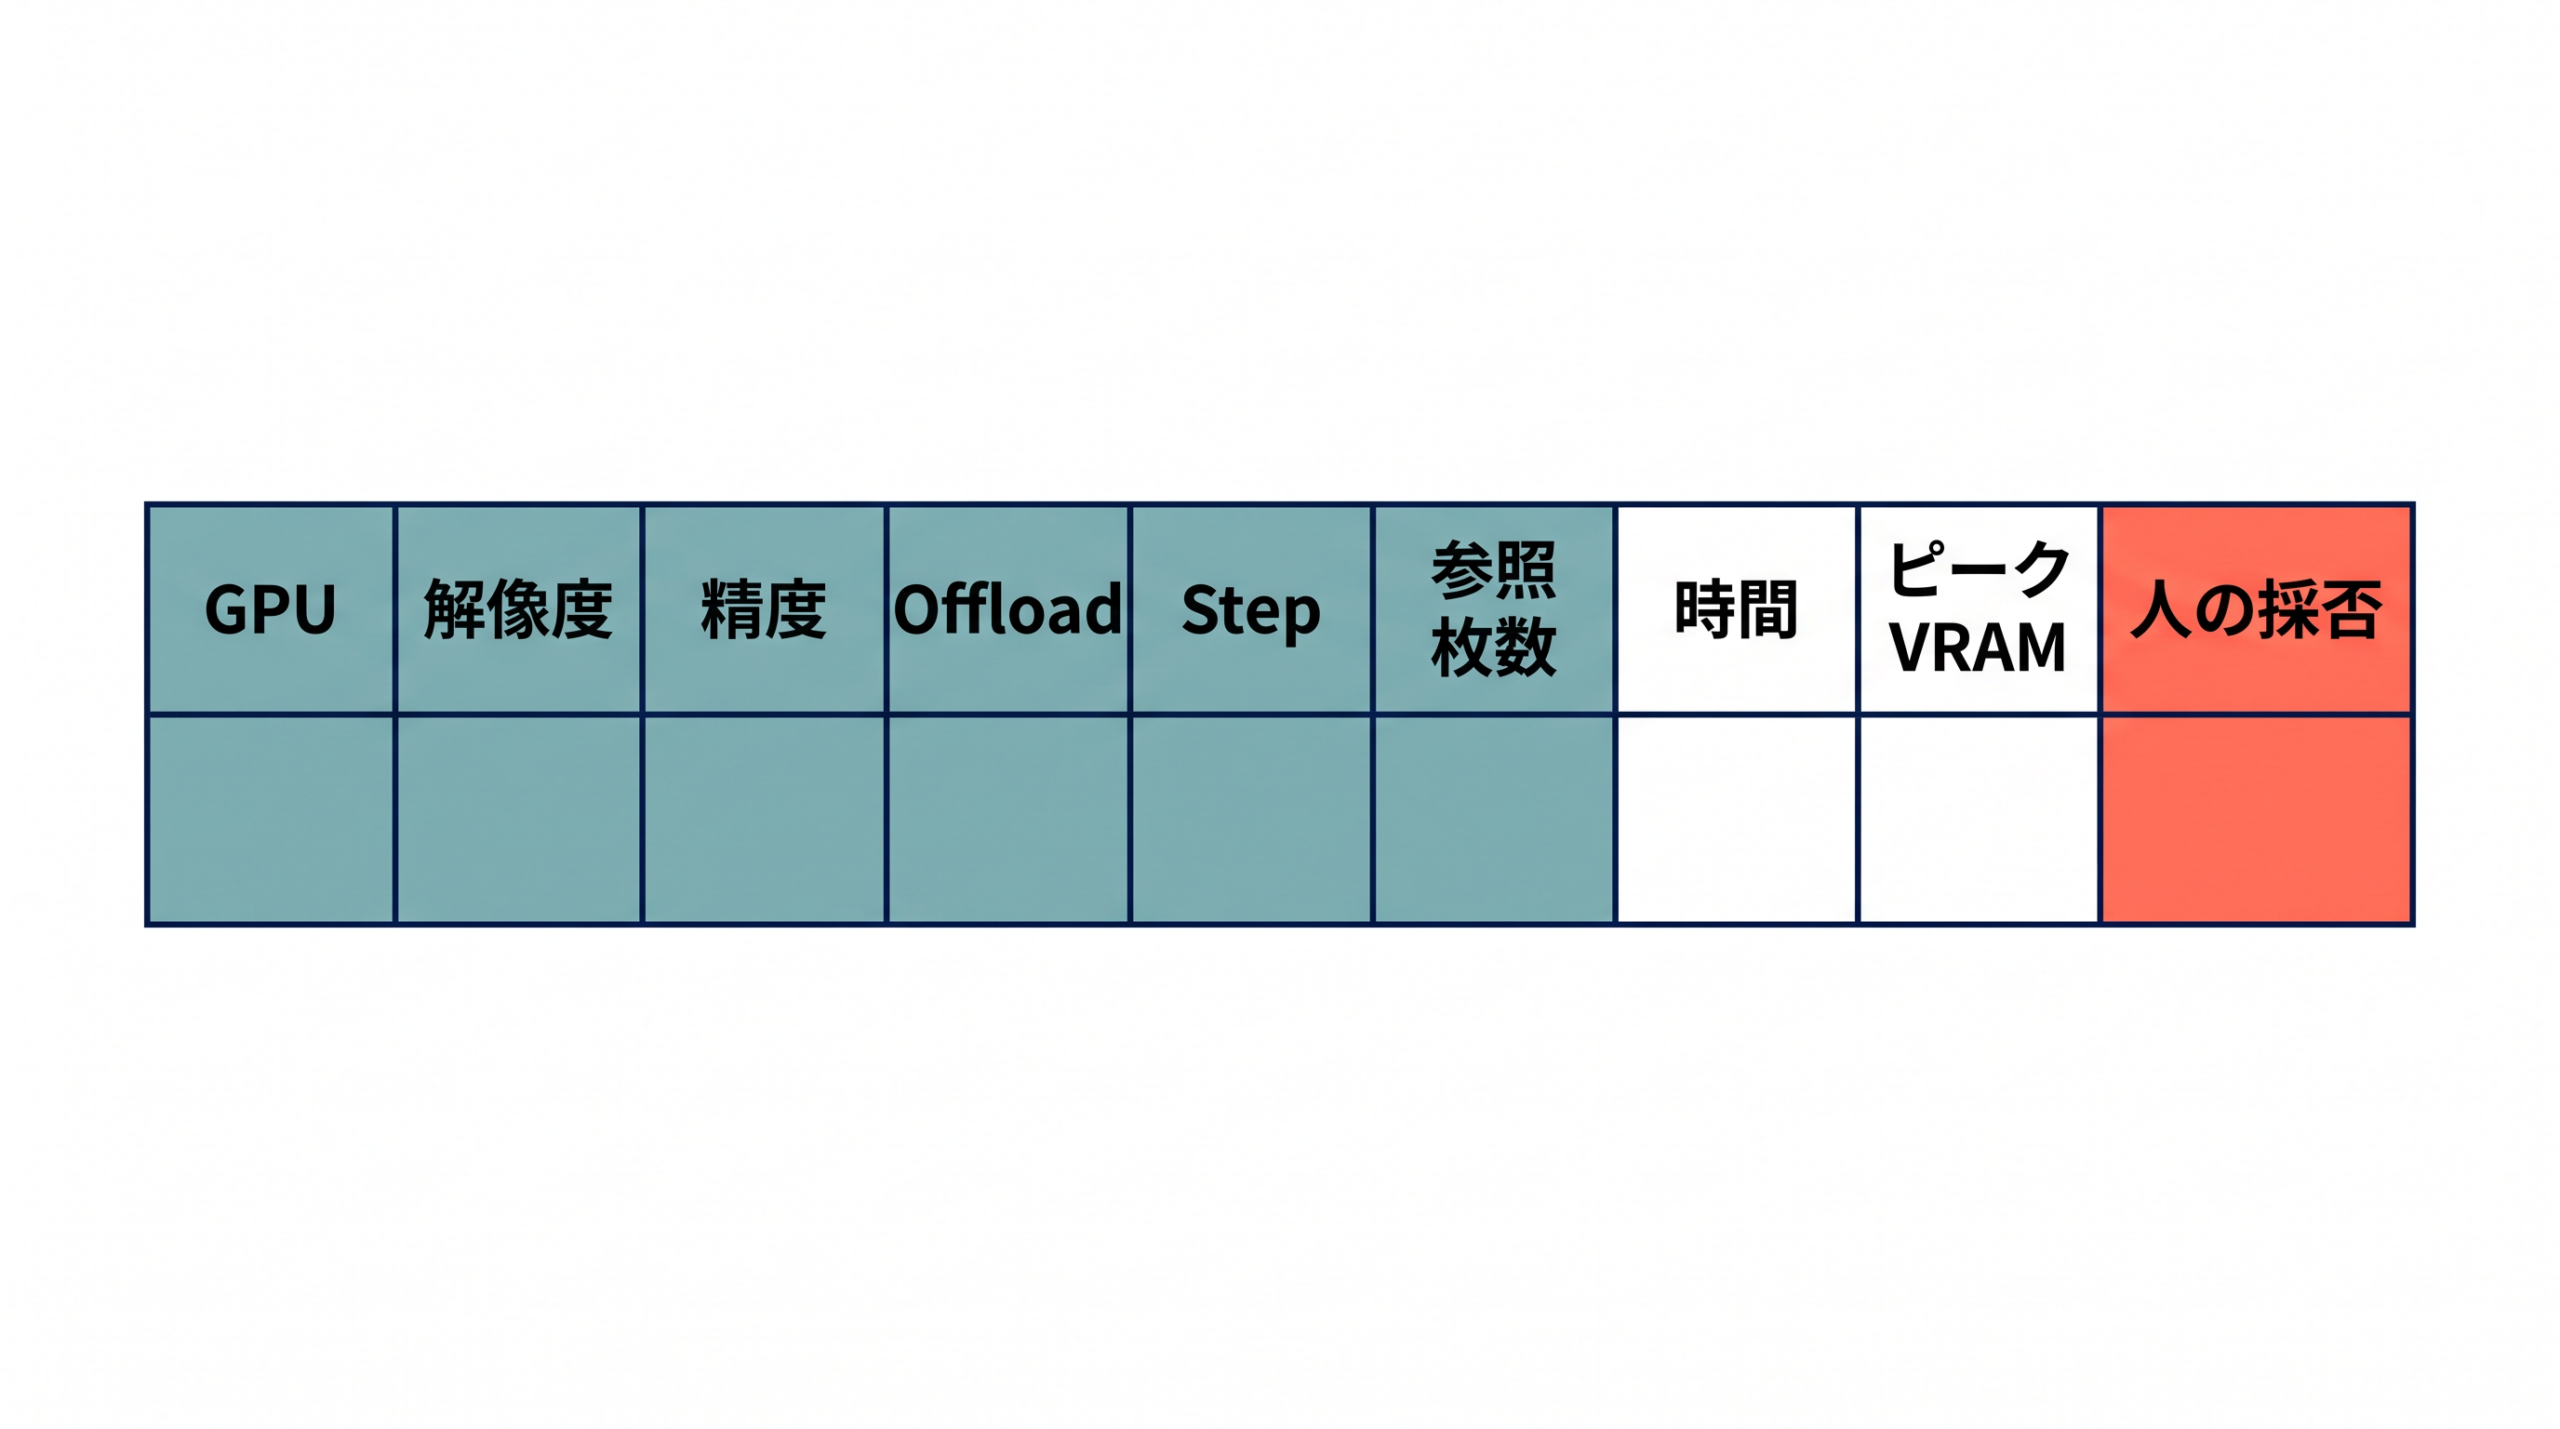
ローカル環境や自前の推論APIで実行する際、何GBのVRAMがあれば動くのかという疑問が必ず生じますが、開発元はすべての消費者向けGPUに共通する最低VRAMを公式には示していません。「7Bモデル」という説明は視覚生成部分の32層のDiTを指しており、これに加えてテキストや条件画像を処理するQwen3-VL 8BとVAEが動作するため、パラメータ数と保存容量、実行時のVRAMを同じ数値として扱うことはできません。
vLLMの公式レシピでは、解像度1024×1024、40ステップの条件において、NVIDIA GB300上のbf16実装で生成時間が4.5秒、ピークVRAMが34.0GBという実測値が公開されています。テキストエンコーダーのみFP8にした特定条件では約27.5から28.1GBに下がるとされていますが、これらは特定のデータセンター向けGPUと特定の設定における結果であり、一般的なPCでの最低要件ではありません。
また、解像度を上げるほどVRAM、生成時間、保存容量は増加します。Qwen-Image-2.1の標準的な正方形サイズは2048×2048であり、1024×1024のベンチマーク結果をそのまま約2Kサイズの所要時間へ読み替えることはできません。さらに、ネガティブプロンプトやCFGスケールを1より大きく設定すると、Diffusers公式資料で説明されている通り、DiTが1ステップ当たり2回動作するため時間は概ね倍になります。
消費者向け端末での動作については、M2チップ搭載で32GBメモリのMacBook Proを使い、1024×1024サイズの画像を約16分で生成したという利用者の自己報告が存在します。一方で、ComfyUIのGitHub Issueでは、MPS環境で入力画像をVAEエンコードした際に画像が破損し、CPU処理へ切り替えることで画質が戻ったという報告も上がっています。テキストからの生成はデコードのみを使うため正常だったとされており、Mac環境では新規生成と入力画像を使う編集とを分けて考える必要があります。
限られた環境で動かすための低メモリ化手法としては、モデルのCPUオフロード、FP8や量子化の導入、複数GPUへの分散などが候補になります。ネット上の断片的な情報だけで実行の可否を決めるのではなく、読者自身の環境において条件を揃えた実測を通して判断することが重要です。
具体的な測定手順としては、解像度、ステップ数、精度、シード値、オフロードの有無などの条件を固定して実行を指示し、その際にかかった生成時間とピークVRAMの数値を一つの記録として残します。その結果をもとに、生成された画質が実務の要件を満たしているか、実際の待ち時間が許容範囲か、ストレージ容量を圧迫していないか、VRAM不足による失敗が発生していないかなどを担当者が総合的に確認して、必要スペックを満たしているかを判定します。
商品画像・広告・漫画での実践ユースケース
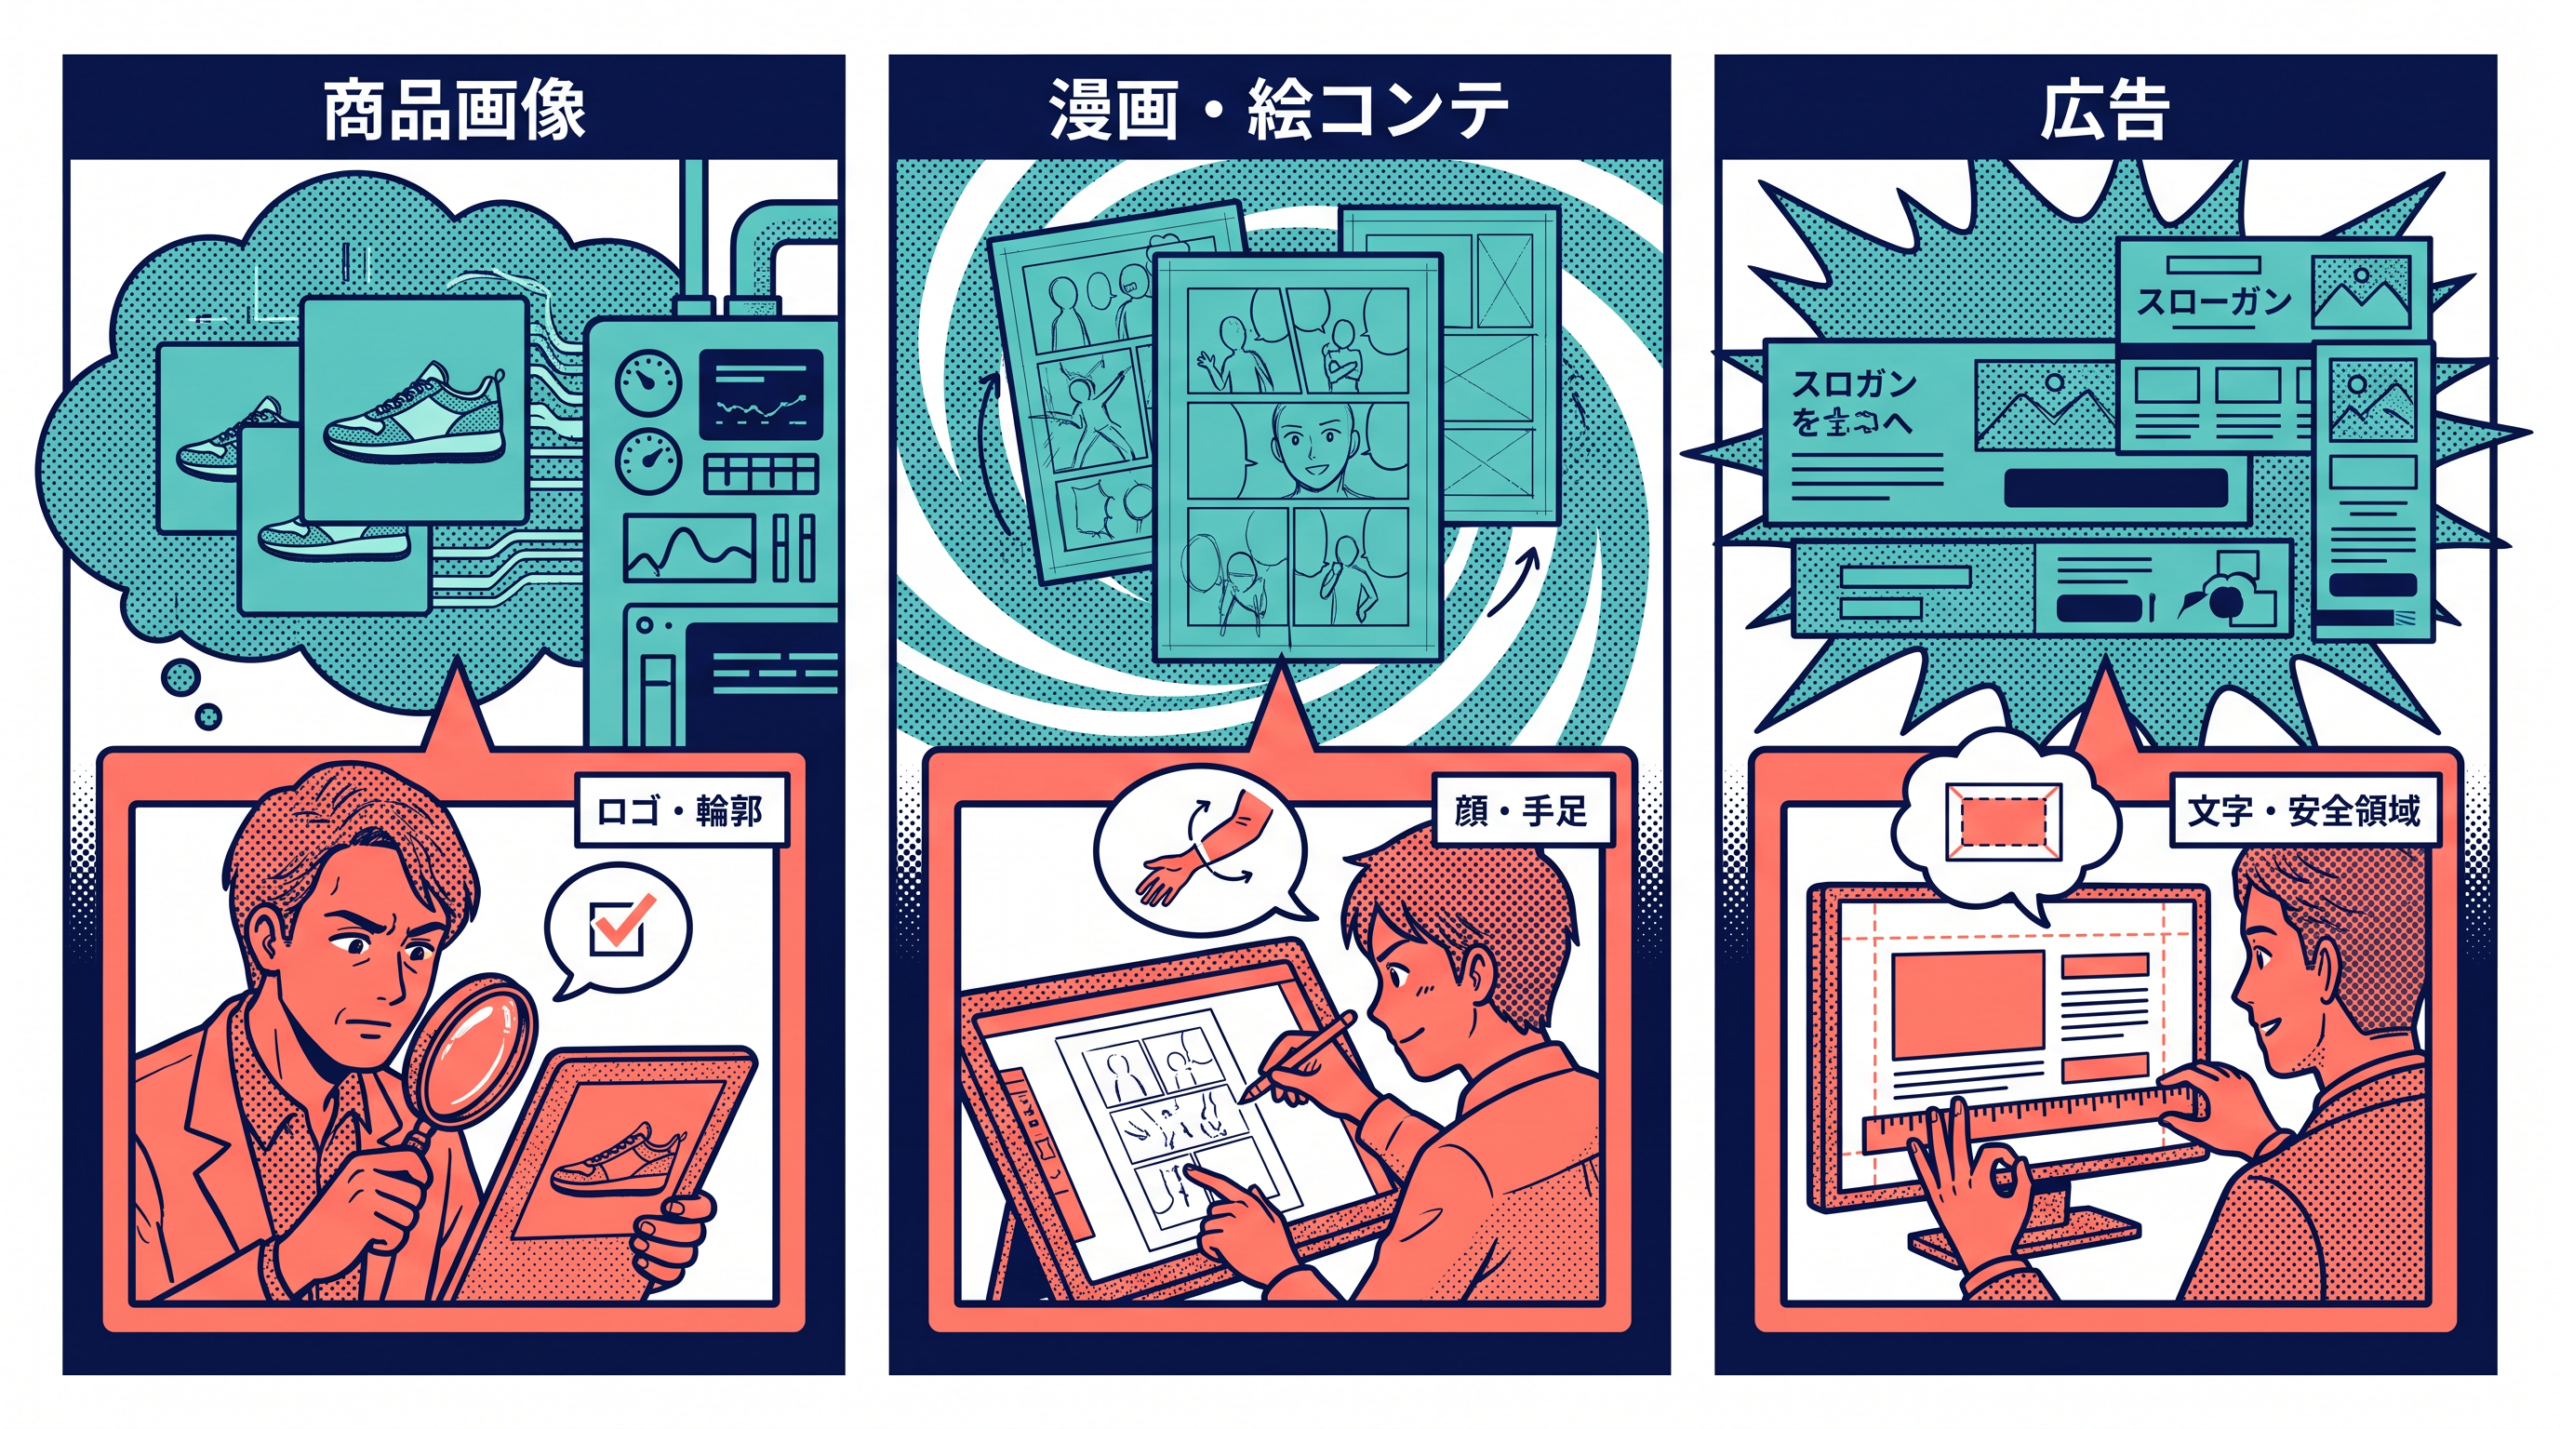
動作条件の確認と環境構築を終えたら、Qwen-Image-2.1を実際の制作作業へどう組み込むかを検討します。通常の切り抜きや合成は既存の画像編集ソフトでも行えますが、このモデルを採用する意義は、生成、編集、複数画像の参照、透過出力を一つのパイプラインでつなぎ、多数の候補を自然言語で反復作成できる点にあります。ここでは架空の事例ではなく、利用者がコミュニティへ投稿した実践的なワークフローと自己報告を基に、どのような出力が得られるかを確認します。いずれも公式ベンチマークではなく個人の報告ですが、実際の用途を想像する手がかりとなります。
M2 Macでの猫画像生成と動作報告
消費者向けハードウェアでの動作例として、M2 MacBook Proと32GBメモリの環境で猫の画像を生成した報告があります。この事例では、DiffusersパイプラインをMPSへ載せ、1024×1024ピクセル、40ステップの生成を約16分で完了させています。同条件での出力を試すことで実機の性能を測れますが、これは特定の端末による自己報告であり、公式が保証する一般性能や全機能の対応を示すものではありません。
参照画像を使ったポーズや照明の移植
複数画像の参照機能を活用し、参照画像から人物のポーズ、壁の質感、照明、背景を移す編集ワークフローがComfyUI向けに共有されています。漫画や絵コンテの制作において、要素ごとに画像を渡し、どれがどの要素かをプロンプトで指定して一つの場面を構成する用途に似ています。ただし、最大10枚を参照できる仕様はキャラクターの完全な同一性を自動保証するものではないため、顔や手足の形、前後カットとの連続性に破綻がないか人間が目視で確認する必要があります。
2K解像度での細部補完とアップスケール
画像の総画素数を約2048×2048相当を上限とし、縦横比を保ちながら2K解像度へ細部を補完するワークフローも共有されています。商品画像や広告素材をより高い解像度で出力したい場合に役立ちます。この処理を行う際は、単純なピクセル拡大とは異なるため、元の構図が正しく保持されているか、追加された細部が不自然でないかを別々に確認する工程が求められます。
表情の局所編集と高解像度出力
局所編集の機能を使って中央の人物を笑顔に変更する編集例では、色ずれが少なく自然な仕上がりが報告されています。この投稿者は7040×3520ピクセルの出力を約5分で処理したとしています。使用したハードウェア構成や詳細な設定は記載されていないため、自分の環境では同じ入力画像と設定で処理時間を測ります。広告や商品画像で局所編集を行う場合、指示した部分以外が勝手に変わっていないか差分を確認し、ピクセル単位の不変性が求められるロゴや文字部分は画像編集ソフトでの手作業へ切り替える判断も必要です。
正確なロゴや法定表示、商品の厳密な形状、人物の同一性などは、モデル自身が承認することができません。AIが得意とする候補の反復作成と、人間が担う最終的な照合および承認を明確に分けることが、実践においてモデルを採用する判断基準となります。
生成画像は商用利用できるがモデル利用は別途ライセンスが必要
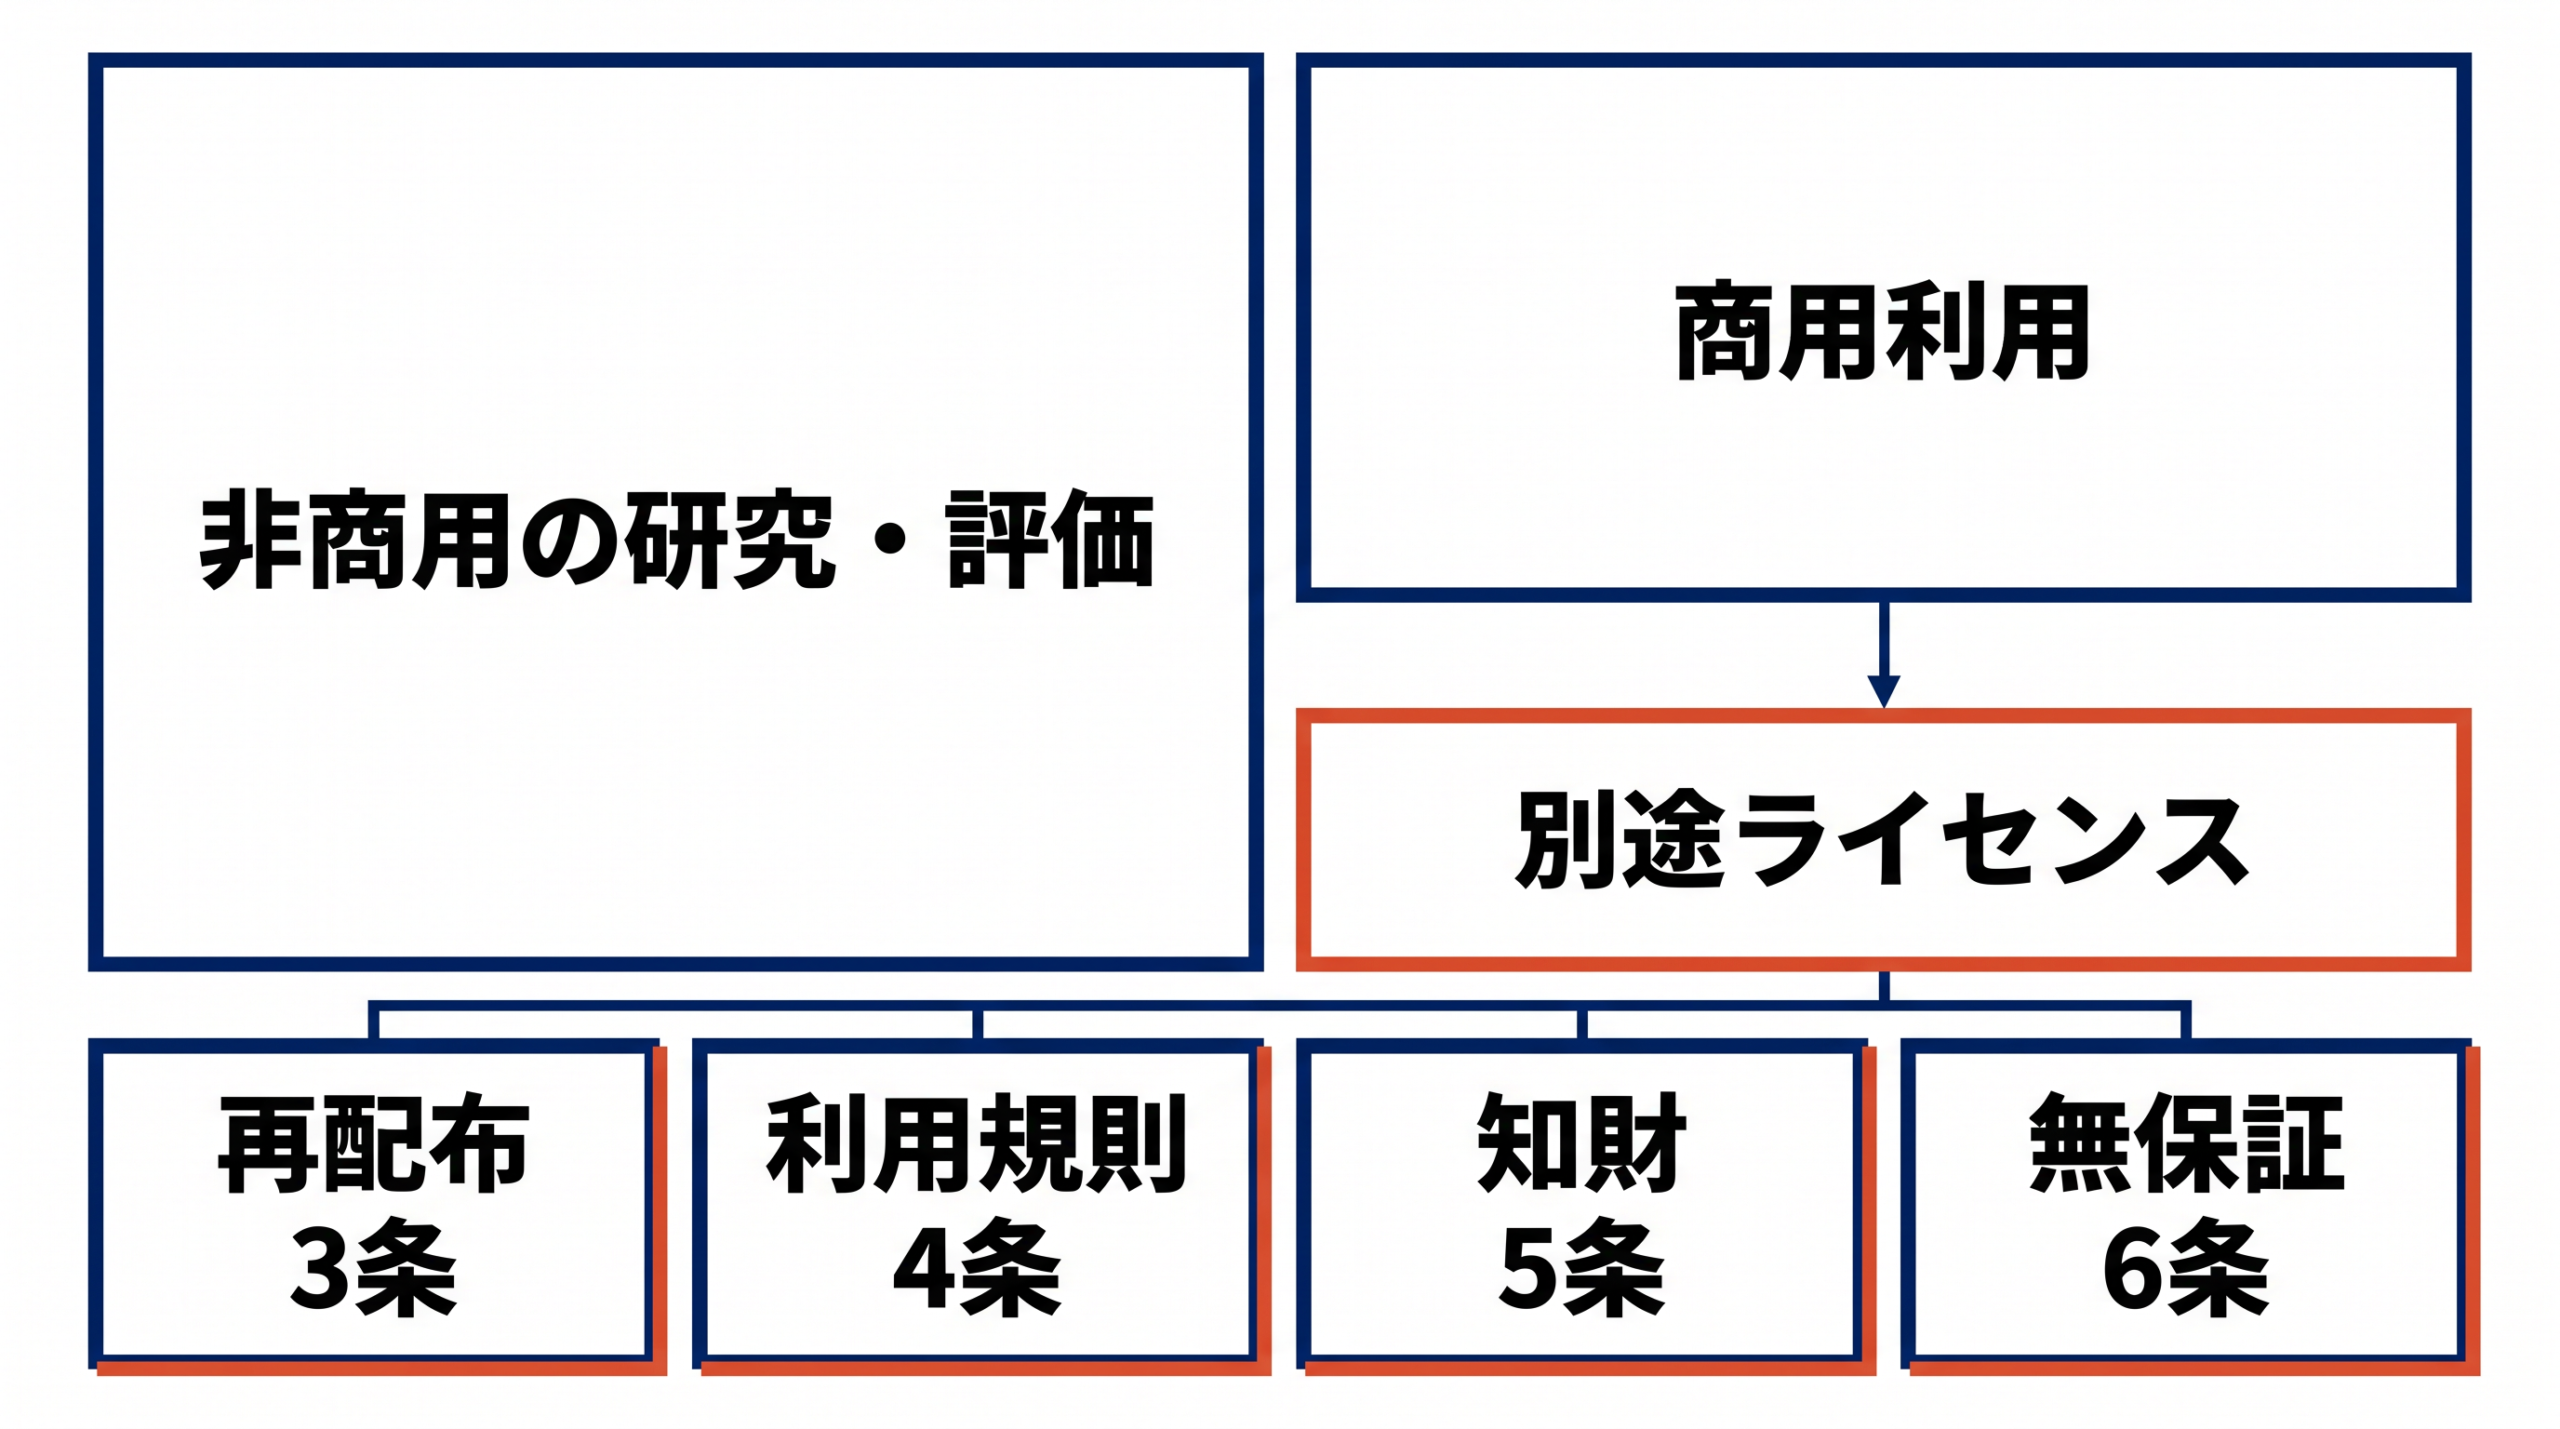
商用利用は、生成画像などの出力と、公開ウェイトや改変モデルの利用を分けて判断します。Qwen Developersの公式投稿は、モデル出力はResearch LicenseのMaterialsに含まれず、ユーザーは生成した画像などの権利を保持すると説明しています。この説明に基づけば、生成画像を広告、受託制作、商品素材などへ使うことは、Qwen Research Licenseの非商用制限によって禁止されていません。
一方、公式のResearch Licenseの1(i)項は非商用を研究または評価目的のみと定義し、2(a)項は公開ウェイトなどMaterialsの使用、複製、配布、変更、派生物作成を非商用目的に限定しています。モデルを有料アプリやAPIへ組み込む場合や、改変モデルやLoRAを商用サービスで利用する場合は、2(b)項に基づく別途の商用ライセンスが必要です。商用アプリへの組み込み可否を尋ねた投稿でも、表示されるGrokの返信はモデルの組み込みに別途許諾が必要と説明しています。これはQwenの公式回答ではなく、ライセンス本文と照合するための議論例です。
StudioYebisuさんの投稿は、この公式説明を「生成画像は商用OK」と解釈し、同じスレッドでモデル改変による収益化にはAlibabaへの連絡が必要と補足しています。ただし、同じスレッドには「出力の帰属が利用者にあることだけでは、商用利用の明示許諾とは限らない」という慎重論もあります。本記事では、Qwen Developersが出力をMaterialsから明確に除外した点を根拠に、Research Licenseの非商用制限は生成画像自体には及ばないと整理します。
非商用目的の範囲で第三者へ提供する場合でも、3(a)から(d)項に従う必要があります。再配布先へライセンス文書を渡すこと、変更ファイルに変更表示を付けること、指定のNoticeを保持することなどが求められます。これらはすべて非商用の許諾範囲が前提となります。
4(a)から(c)項では、輸出管理など各国の法令遵守を求めています。また、提供物や出力を用いて配布や公開される別のAIモデルを作成、訓練、改善する場合には、製品文書へBuilt with QwenまたはImproved using Qwenと表示する義務があります。派生物や製品の主要な名称としてQwenを使うことは禁じられていますが、説明的な利用は認められます。
権利関係について定めた5(a)から(c)項では、提供された素材の知的財産を提供者が保持しつつ、契約遵守を条件として利用者が作った変更物や派生物は利用者が所有するとしています。ただし、Noticeの保持や通常の説明利用を除く商標ライセンスは与えられません。また、提供物や出力が利用者の権利を侵害したとして提供者を訴えた場合、このライセンスは終了します。
最後に6(a)から(c)項により、提供者にはサポートや更新、将来版などを提供する義務がないこと、現状有姿での提供であり安全性や安定性を保証しないこと、利用や利用不能による損害の責任を負わないことが明記されています。
ユーザーが出力の権利を保持するという説明は、各国法で著作権が必ず成立することや、第三者の著作権、商標、肖像権を侵害しないことまで保証するものではありません。生成画像を公開・販売する場合は第三者の権利を別途確認し、モデル自体を商用利用する場合は指定窓口(model-business@notice.qwencloud.com)へ許諾を確認してください。
導入前は同じ条件で比較テストする
通常の切り抜きや合成は既存の画像編集ソフトでも行えます。Qwen-Image-2.1を採用する理由は、生成、編集、複数画像の参照、透過出力を一つのモデルでつなぎ、多数の候補を自然言語の指示で反復作成できることにあります。一方で、正確なロゴ、法定表示、商品の形、人物の同一性、著作権、商標、商用利用の可否をモデル自身が承認することはできません。
そのため、制作ワークフローへの採用を決めるには、利用経路や実行資源、ライセンスを総合的に評価する比較テストが必要です。
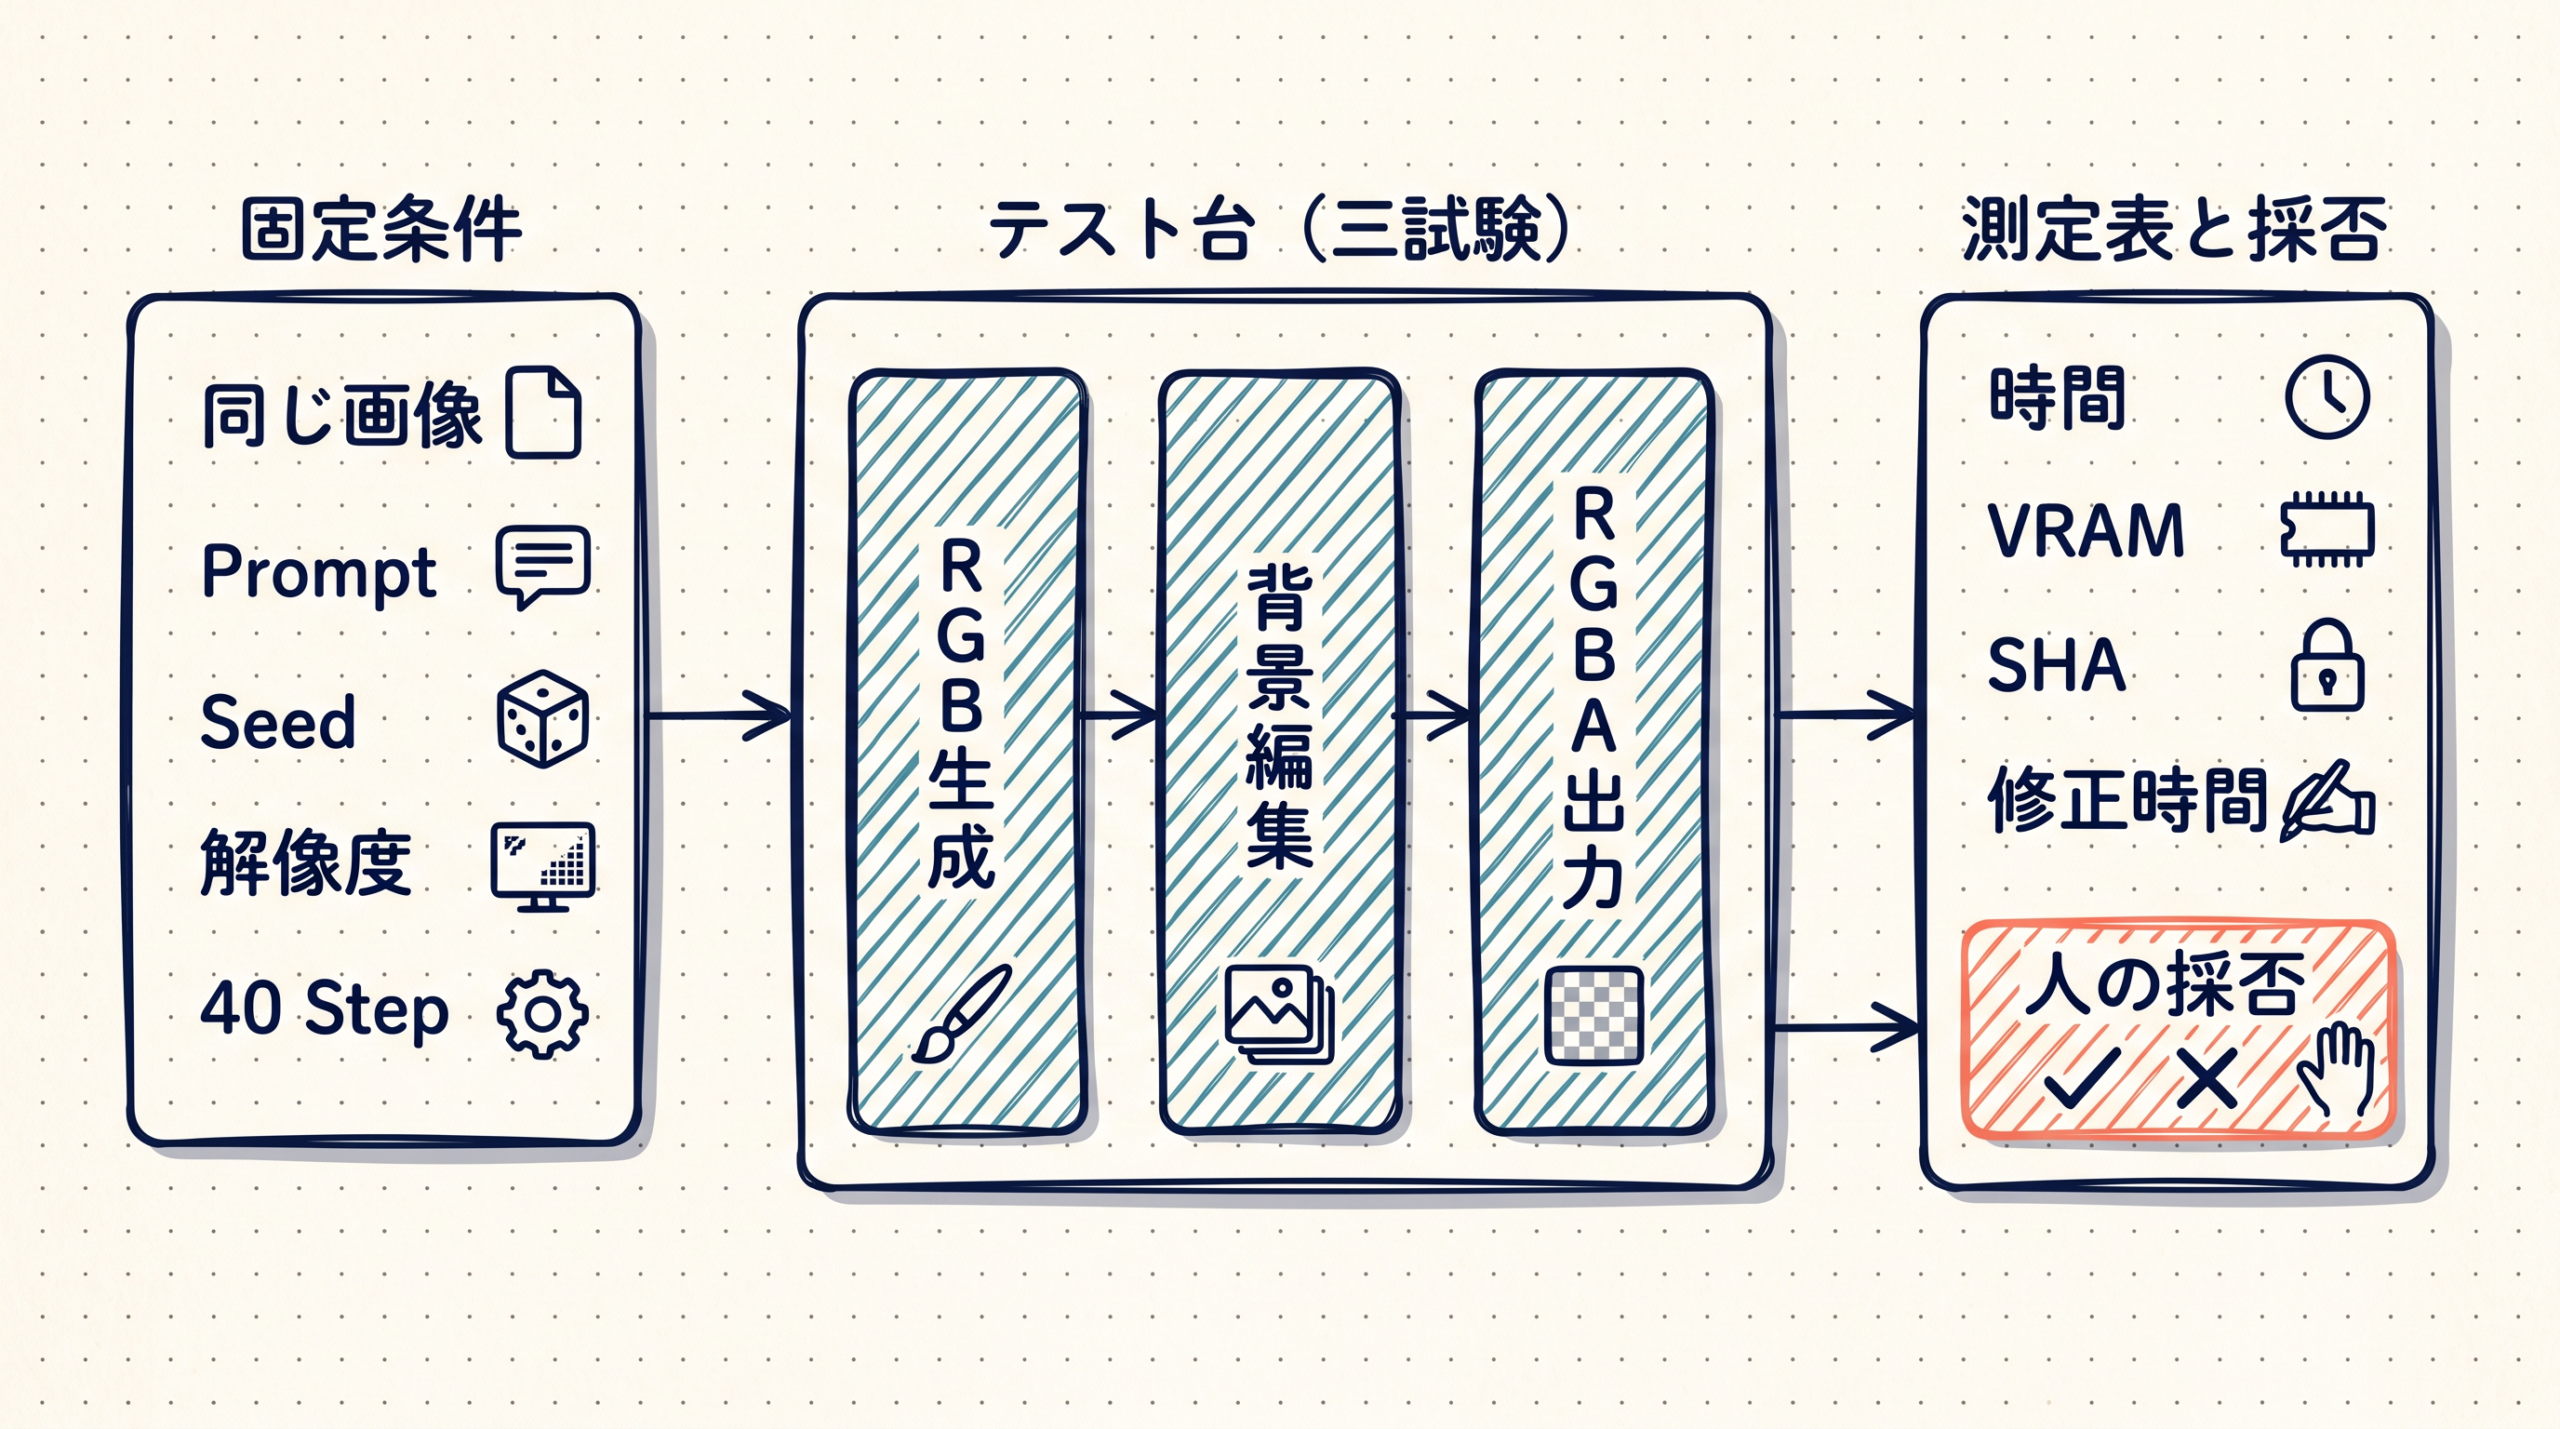
まず、比較の基準を揃えるために、入力画像、プロンプト、シード値、解像度、標準例である40ステップなどのステップ数、演算精度、オフロード条件を固定します。この状態でRGB生成、背景編集、透過出力をそれぞれ実行し、結果を記録します。
テスト環境を漫然と扱わず、オンライン画面、第三者API、クラウドGPU上の自前API、ローカルPCのどれを利用しているかを区別してください。誰の環境へ素材を送るのか、誰が認証や課金、データの保存と削除を担うのかを明確にすることがセキュリティと運用ルール上の要件を満たすために重要です。例えばローカルPC環境の例として、MacのComfyUI環境で画像編集用の入力が破損する不具合が利用者の自己報告Issueとして挙がっているように、実行先固有の制約も運用前に見極める必要があります。
実行時の記録には、使用したGPU名、解像度、精度、設定したオフロード条件と隣接させる形で、生成にかかった時間とピークVRAMをまとめます。vLLMの公式レシピではNVIDIAのGB300を用いた一例として4.5秒、ピーク34.0GBという記録が示されていますが、これは消費者向けPCの最低要件ではありません。利用する環境ごとに同じ条件で記録し、出力画像の同一性を確認するハッシュ値、失敗の有無、および手修正にかかった時間を測ります。
最後に、作成した記録をもとに出力物の品質と再現性が実務に耐えうるかを確認します。同時に、運用時の費用やQwen Research Licenseに基づく許諾条件を照合し、生成画像だけを商用利用するのか、公開ウェイトや改変モデルを商用サービスへ組み込むのかを分けて確認します。すべての技術的要件と権利上の基準を統合することで、最終的な導入を決定できます。
よくある質問
Q1. Apple Silicon搭載のMacで動かすことはできますか?
公式の標準例はCUDAを使うため、Macでの実行は公式保証ではありません。テキストからの生成については、M2・32GBのMacBook ProでDiffusersをMPSへ載せ、1024×1024、40ステップを約16分で生成した利用者の自己報告があります。一方で入力画像を使う編集については、M5 Max・128GBの報告環境において、MPS上のVAE encodeが編集入力を破損し、CPU VAEで回避できたという未解決Issueがあります。この報告内でもテキストからの生成は正常だったとされています。なお、Intel Macのローカル実行は確認できていません。
Q2. 自分のPCで動かすための最低VRAMはどのくらいですか?
「7Bモデル」と呼ばれますが、この数値から必要VRAMは決められません。7Bとは視覚生成部分(32層single-stream DiT)のみのサイズであり、実際の実行系にはテキスト・条件画像エンコーダー(Qwen3-VL 8B)やRGBA VAEも含まれるためです。
開発元は消費者向けGPUの最低VRAMを示していません。
Q3. ComfyUIを使ってローカル環境で動かすにはどうすればよいですか?
ComfyUI用配布ファイルと公式ワークフローを使い、diffusion model、Qwen3-VL 8B、RGBA VAEを配置します。
Q4. 複数画像の参照機能を使えば、キャラクターの同一性を完全に固定できますか?
最大10枚を参照できますが、同一性は保証されません。顔、手足、衣装、前後カットを人が確認します。
Q5. 背景が透明な透過画像を直接出力することはできますか?
RGBA VAEと推奨プロンプトを使って透過PNGを出力できます。境界と半透明部分は確認が必要です。
Q6. 受託制作や広告など、商用利用の公開物に使うことはできますか?
生成画像を広告、受託制作、商品素材へ使うことは、Qwen Research Licenseによって禁止されていません。Qwen Developersの公式説明では、モデル出力はライセンス対象のMaterialsに含まれず、ユーザーが生成画像などの権利を保持するとされています。ただし、公開ウェイト、改変モデル、LoRA、モデルを動かす機能を有料アプリやAPIへ組み込む場合は別途商用ライセンスが必要です。生成画像についても、第三者の著作権、商標、肖像権は別途確認してください。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント