
複数国の市場で事業を展開する企業では、法務、コンプライアンス、品質保証、事業企画の担当者が各国の規制更新を追います。 公式の一次資料から更新を継続的に取得し、社内の対応判断へ的確に引き渡すことが重要です。日々発出される膨大な情報の中から、自社に影響する更新を確実に捉え、具体的な対応タスクとして担当部署へどう渡せばよいのでしょうか。
この仕組みを構築するうえで鍵となるのは、「公式文書の状態」の厳密な区別です。受信した情報が意見募集中の提案規則なのか確定した最終規則なのかを区別します。そして、文書の公開日と実際の「施行日」を混同せずに対応の要否を判断することです。
本記事では、複数国の規制動向を実務プロセスへ落とし込む手順を解説します。まず、監視対象の固定や、公式APIやRSSを用いた取得経路の構築を行います。次に、文書の進行段階に応じた通知条件の設定を行います。また、AIによる差分要約と人が担う確認担当の役割分担を決めます。最後に、継続的な精度を保つための再監査のルールを決定します。
規制モニタリングは対象と通知条件から設計する
規制動向の監視を始める際、ニュースを無作為に大量収集することは避けるべきです。監視システムの合格条件は、通知の多さではありません。重要な更新を期限内に検出し、担当者と対応期限を明確に定め、不要な通知を抑えつつ確実に原文へ戻れる状態を作ることが目的となります。
この目的を達成するためには、情報の取得経路を構築する前に監視範囲を固定する必要があります。具体的には、監視台帳を用いて以下の要素をあらかじめ決定します。
- 対象国と事業拠点
- 監視する当局
- 関連する法令分野
- 対象となる製品
- 監視頻度
- 通知先となる担当者
これらの前提条件を設計しておくことで、収集した情報を担当者へ振り分けられます。監視頻度はAPIやRSSの配信間隔に合わせて決め、最終取得時刻も台帳に残します。
AIを活用した監視プロセスでは、AIに更新候補の分類と差分要約の作成を担わせます。しかし、AIによる要約や分類は法的判断ではありません。法的効力の有無、具体的な適用対象、経過措置などの例外については、必ず人が確認する体制を構築します。公開日とは異なる正確な施行日と最終的な対応責任についても同様に人が確認します。
AIの確信度だけで対応の優先順位を決めることは避けます。提案規則と最終規則の区別も含めて通知条件を厳密に設計します。この設計が実務に耐えうるモニタリングの土台となります。
米国・EU・日本の公式更新を取得する
監視設計が完了したら、次に情報を取得する経路を構築します。二次的なニュース記事だけで規制の更新を確定させることは避けます。各国の当局が提供する公式APIやRSSを利用して一次資料を取得します。
ただし、これらのシステムを通じたデータの取得は、当局が情報を公開した瞬間に無遅延で受信できることを意味するものではありません。取得間隔、APIの更新タイミング、RSSの遅延、レート制限といった配信元の仕様に左右されることを前提として運用します。
米国の規制監視では、主に2つの公式配信を利用します。1つ目はFederal Registerです。公式のAPIドキュメントおよび文書検索APIを利用し、管轄機関、文書種別、公開日、施行日などのメタデータを保存します。この際、提案規則、最終規則、通知といった文書種別を明確に区別し、公開日と実際の施行日を混同しないように扱うことが重要です。
2つ目のRegulations.govでは、公式API仕様と開発者向け資料を参照し、書類やコメントの動きを検索します。意見募集中の文書は確定した最終規則ではないため、改訂版や添付資料を個別のIDで追跡します。
EUの動向については、EUR-LexのRSSとWebserviceを活用します。公式の再利用案内に基づき、情報を取得する際はCELEX番号や文書種別を確認します。採択日、公布日、発効日、適用日を個別に分けて管理します。また、読みやすさを目的として提供される統合版の法令は、法的行為そのものではない場合がある点に留意が必要です。
日本の法令は、e-Gov法令検索の法令API仕様と法令検索システムを利用して取得します。法令本文のデータだけでなく、改正法、施行期日、附則も含めて確認します。パブリックコメントについては、e-Govの公式ページで案件ごとの進行状態と締切を追跡します。
横断的な公式プラットフォームに加えて、自社の事業に関わる当局別のフィードも併用します。例えば、医療機器や医薬品を扱う場合は、FDAが提供するメール更新機能や公式RSSを追加します。化学物質を取り扱う場合は、ECHAが公開するニュースや規制情報を直接監視します。このように業界ごとの一次資料経路を組み合わせることで、正確な情報の取得基盤が完成します。
文書IDと本文ハッシュで更新を正規化する
各国や当局の公式経路から取得した規制情報は、配信元によってデータ形式が異なります。取得した結果を継続的に比較可能にし、監視の精度を保つためには、すべての受信文書を統一した形式に正規化して保存する設計が不可欠です。
この保存先として、例えば regulation-monitor.csv のような台帳を作成し、受信文書を記録します。ここでは取得したデータを単に流し込むのではなく、文書種別や公開日などを管理します。施行日や現在の状態も明確に分けて管理します。
具体的には、情報源や管轄や当局の列を設けます。文書IDやタイトルや文書種別も記録します。公開日、施行日、適用開始日、対象製品範囲の列も追加します。状態、原文URL、本文ハッシュ、確認日も設けます。
提案規則と最終規則を明確に区別します。文書の公開日と実際の施行日を混同せずに別の列として保存することが、期限誤認を防ぐための前提となります。
運用を続けるうえで重要となるのが、同じ文書の改訂をどう追うかという課題です。当局のウェブサイトでは、同じURLのまま内容が差し替えられたり、文書が更新されても一部のメタデータが変わらなかったりするケースがあります。そのため、URLの変更だけで新しい更新を判定しようとすると、重要な改訂を見逃すおそれがあります。
これを防ぐために、取得システムでは当局が付与する個別の「文書ID」を利用します。取得したテキスト原文から生成する「本文ハッシュ」を用いて更新を判定します。文書IDによって同一案件の進行を紐付けつつ、本文ハッシュの不一致で中身の変更を正確に検知します。
この仕組みにより、法案の廃案や規則の改訂などを確実に追跡します。適用猶予や例外の追加なども追跡対象となります。古い状態の通知が現行の義務として台帳に残り続けることを防ぎます。
AIで旧版と新版の差分要約を作る
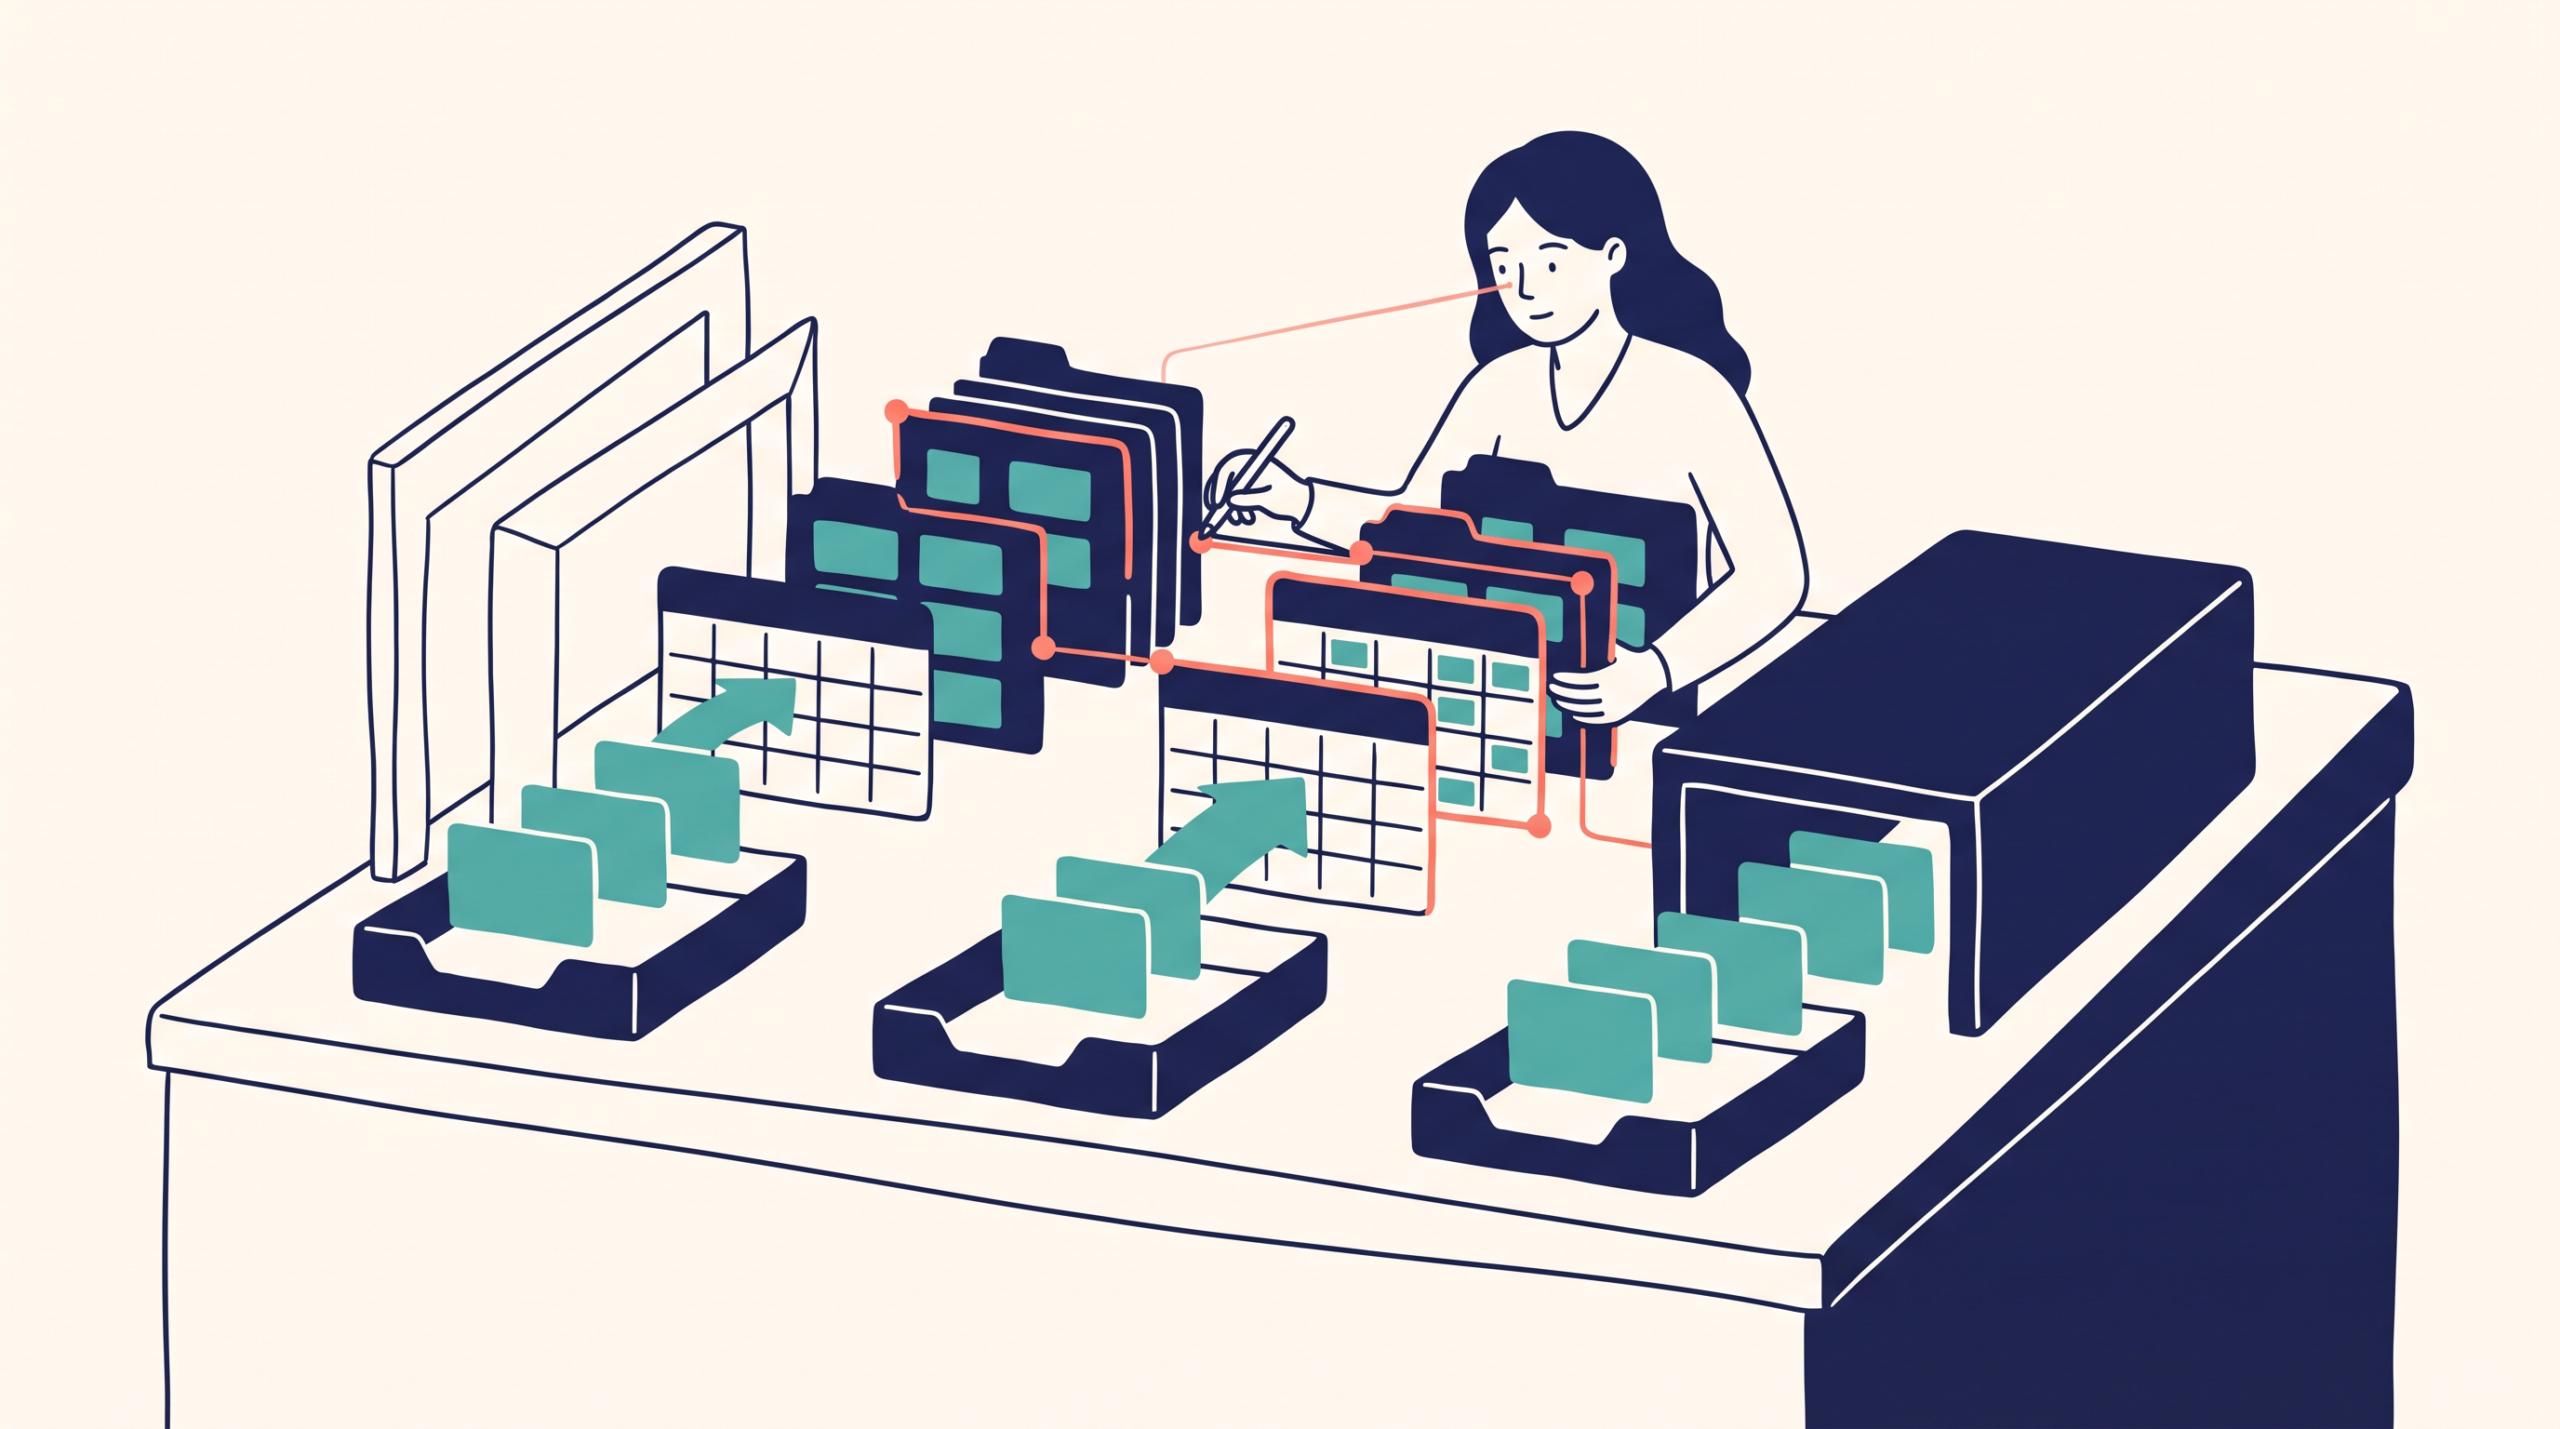
文書IDや本文ハッシュの不一致によって同一文書の更新が検知された後は、その変更点を整理します。整理した情報を社内の担当者へどう渡すかが次の課題となります。ここでAIを活用し、膨大な公式文書の中から具体的な変更箇所を特定する工程を挟みます。
手作業で新旧の文章を読み比べ、変更箇所を条文ごとに追って製品台帳と照合する従来の方法があります。AIを活用すれば、従来の方法に比べ、人が確認する候補箇所を同じ形式にそろえられます。
公式APIやRSSから取得して保存した旧版と新版の原文は、まずはローカル環境で機械的なテキスト差分として比較します。そして、変更があった部分だけを外部のAIへ送ることで、処理を最適化します。
GoogleのGemini APIが提供する文書理解機能を利用します。PDF形式の規制文書に含まれる本文や表や図を扱い、情報を構造化形式へ抽出できます。ただし、無償サービスを利用する場合、利用規約上の注意があります。送信したデータが製品改善に利用される可能性があります。
そのため、公開法令の情報と社内の機密情報は分離しなければなりません。社内の製品辞書や未公開の設計情報をそのまま送ることは避けます。対象製品を匿名コード化した照合用の辞書を作成します。公開されている法令の差分と、必要最小限の属性だけをAPIへ渡します。
また、大きな規制文書を処理するためにFiles APIへファイルをアップロードすることがあります。そのファイルは、データ保持設定に応じた管理仕様を確認します。処理完了後に利用者が明示的に削除する必要があります。
実行前に、Gemini APIの認証案内に従ってGoogle Cloudプロジェクトに紐づく認証キーを用意します。APIの課金状態をCloud Billingで確認します。Gemini APIへ指示を出す際は、単なる要約を求めるのではなく、JSON Schemaによる構造化出力を活用します。
条文番号や旧文や新文を指定します。変更の整理や候補となる影響や確認事項といった項目も指定し、JSONとして出力させます。このとき、文言の単なる「追加」や「削除」だけを抽出させるのではありません。事業者に対する「義務」や用語の「定義」を抽出させます。施行などの「日付変更」といった実務的な意味変化も、原文からの引用付きでAIに抽出させます。
出力された change-review.json は、アプリケーション側で change-review.md へ変換して担当者へ渡します。次は、実在する法令の内容を示すものではない架空の書式例です。
### 条文番号: 第15条第2項
- 旧文: 「事業者は、対象物質の記録を3年間保存しなければならない。」
- 新文: 「事業者は、新指定物質の記録を2027年4月1日以降、5年間保存しなければならない。ただし小規模事業者は免除する。」
- 変更の整理:
  - 追加: 「ただし小規模事業者は免除する。」(例外規定の追加)
  - 削除: 旧来の「3年間保存」の指定
  - 義務変更: 保存義務の期間延長(3年から5年)
  - 定義変更: 対象物質が「新指定物質」へ変更
  - 日付変更: 適用日が「2027年4月1日以降」に変更
- 候補影響: 匿名コードP-1200の対応要否
- 確認事項: 小規模事業者の定義、経過措置の有無
ただし、JSON Schemaでデータ構造を強制できても、出力された値や実務への影響はアプリケーション側で検証する必要があります。安全性と事実性のガイドが示すように、AIが不正確な出力を返す可能性は残ります。
担当者はAIの出力を受け取った後、公式原文で条文番号と用語の定義を照合します。例外規定と附則も確認します。施行日と適用対象を確かめ、その結果をもとに対応要否を判断します。
化学メーカーの場合、AIが抽出した物質情報と製品台帳を照らし合わせます。塩や異性体などが該当しないかを品質保証やコンプライアンスの専門家が確認します。法務担当者も、AIが示した「義務変更」の文脈を原文で読み解き、対応要否を最終的に確定させます。
このように、AIによる構造化出力の抽出と人による原典の厳密な確認作業を組み合わせます。これにより、監視プロセスはより確実なものとなります。
提案・最終・施行で通知先を変える
AIと人の確認によって規制の差分が整理されたら、次はその内容を社内の業務対応へ引き渡します。ここで重要になるのは、「何をいつ、誰に通知するか」という判断ルールです。
すべての更新情報を全関係者に一律で送信すると、情報過多によって本当に必要な対応が見逃されるリスクが高まります。そのため、文書の法的効力や自社への適用範囲を基準にして通知の重要度を決定します。対応期限や事業への影響度合いも基準に含めます。AIが算出した確信度だけで優先順位を決めてはいけません。
この引き渡しを正確に行うために、規制の進行状況に応じた「三段階通知」の仕組みを構築します。第一段階である「提案段階」の文書は、意見募集などが行われている状態であり、確定規則ではありません。したがって、この時点では即座に対応タスクを発生させません。今後の動向を追うための「継続監視」として扱います。
第二段階として規則の「最終化(採択)」が行われた際には、法務部門やコンプライアンス部門へ通知します。そこで法的要件の解釈や事業影響の評価といった法務確認を行います。そして第三段階として「施行日確定(適用開始)」となった際には、製品や事業の担当部署へ通知します。具体的な対応タスクと対応期限を登録し、実務への移行を促します。
この各段階で送られる通知には、担当者が迷わず次の行動へ移れるよう、「原文URL」「変更箇所」「未確認事項」「次の確認日」を必ず含めるようにします。この三段階の切り分けは、発出される文書の種別や法的性格が多様な業界ほど重要になります。
例えば化学規制の領域において、ECHAからの制限提案や候補リストの更新を受信することがあります。この場合、対象物質が「候補」「意見募集」「採択」「適用開始」のどの状態にあるかを正確に分けます。これにより、意見募集中の段階の物質を、すでに確定した義務であるかのように誤認する事態を防ぎます。
医療機器の分野でも同様の注意が必要です。FDAが発出する規則やガイダンスなどは、それぞれ法的性格が異なります。Safety CommunicationsやRecallなども同様です。これらを単一の「規制変更」という通知に丸めることは避けます。
製品分類や申請区分や対象市場などを別々の情報として管理します。発効日や推奨対応なども分けて管理します。とくに、ガイダンス案への意見募集の文書は確定した必須要件ではありません。誤解して社内の品質手順へ反映してしまわないよう、状態ごとの対応ルールを徹底させます。
このように、提案規則と最終規則を厳密に分けます。公開日と施行日を混同せずに段階に応じて通知先を変えます。これにより、不要な混乱を抑えつつ、必要な部署へ確実に業務を引き渡すことができます。
週次・月次・四半期で見逃しを監査する
監視システムの合格条件は、通知の数を単純に増やすことではありません。重要な規制の更新を期限内に検出し、担当者と対応期限が的確に決まり、かつ不要な通知を抑えながら確実に原文へ戻れる状態を維持することが目的となります。この継続精度を保つためには、一度構築した情報取得の仕組みを放置せず、定期的に運用を監査して通知の質を改善へつなぐプロセスが不可欠です。
日々の運用において、各国の公式APIやRSSを通じた情報取得は停止するリスクがあります。原因は認証エラーやレート制限や配信元の障害などです。システムの停止によって監視が静かに止まってしまう事態を防ぐため、システム側で記録を維持します。最終成功時刻やHTTP状態や取得件数や直近の文書日付を常に記録します。
通常の取得件数が急にゼロになった場合は「更新なし」と見なすのではなく、情報取得の異常として管理者に通知される仕組みを設けます。
そのうえで、週次・月次・四半期のサイクルで具体的な監査を実施します。週次の点検では、取得の失敗やデータの重複や誤分類を確認します。更新の見逃しが発生していないかも確認します。
APIの障害や配信の遅延に備え、完全にシステムへ依存することは避けます。各当局の公式一覧ページに掲載されている最新文書を確認します。そして、台帳に保存済みの文書IDと人が突合するフォールバックの工程を残します。もし欠落が見つかった場合は、対象の更新情報を再取得します。
月次の運用では、週次点検で把握した傾向をもとに、監視対象とする製品辞書や検索条件のメンテナンスを行います。事業環境の変化に合わせて対象国や法令分野が適切に維持されているかを見直します。
さらに四半期ごとの監査では、過去に発生した既知の重要更新「20件」を用いて監視プロセス全体のテストを実施します。この20件の監査を通じて、更新の検出率や関係のない部署への誤通知率を計測します。抽出した内容の原典一致率および人が内容を確認するのに要した時間も計測します。
もし見逃しや誤った判断が生じていた場合は、その原因を特定します。原因を「検索条件の不備」や「配信元の遅延」や「文書種別の分類エラー」に切り分けます。「担当者への引継ぎルールの欠陥」の可能性も確認します。特定した原因を、次回の通知精度を底上げするための改善策へ反映させます。
よくある質問
Q1. 公式APIを使えば、情報をリアルタイムに無遅延で取得できますか?
当局が情報を公開した瞬間に無遅延で受信できる保証はありません。取得タイミングは、取得間隔やAPIの更新やRSSの配信遅延に左右されます。認証状態やレート制限といった配信元の仕様にも影響されます。
そのため、通常の取得件数が急にゼロになった場合は「更新なし」とはしません。取得異常として管理者に通知します。そして公式一覧ページを人が確認するフォールバック手順を設けておく必要があります。
Q2. 意見募集中のガイダンス案や提案規則は、社内の必須要件として扱うべきですか?
提案段階の文書は確定した最終規則ではないため、即座に社内の手順へ反映すべきではありません。Regulations.govの開発者資料などを用いて意見募集文書を取得した際は、「継続監視」として扱います。
将来採択されて最終化された段階で、初めて法務部門へ確認を依頼します。このように、文書の法的性格に応じて取り扱いを厳密に分けます。
Q3. 文書の公開日を基準にして、社内の対応期限を設定してもよいでしょうか?
文書の公開日と実際の施行日は異なるため、これらを混同して期限を設定してはいけません。米国のFederal Register APIやEUのEUR-Lexからデータを取得する際は注意します。公開日、施行日、適用日をそれぞれ別の項目として保存します。
施行日が明確に確定した段階で、初めて担当部署へ具体的な対応期限を登録します。
Q4. AIの差分要約で自社の対象製品が抽出されなかった場合、非該当と判断してよいですか?
いいえ。AIが作成した要約や分類は法的判断ではありません。抽出結果において物質名や用途が完全に一致していなくても、塩、異性体、群指定、包括名などに該当する可能性があります。そのため、AIの出力のみで安易に対象外とはせず、必ず管轄の専門家が原文の定義、附属書、除外用途などを確認して最終的な適用判断を行います。
Q5. 規制が更新された際、すべての関係部署へ一斉に通知するべきですか?
全関係者への一律の通知は、情報過多を引き起こし重要なタスクの見逃しにつながるため避けてください。通知の重要度は、文書の法的効力や適用範囲や対応期限によって決定します。事業への影響度も考慮します。
提案段階は監視にとどめ、最終化されたら法務確認へ回します。施行日が確定したら担当部署へ通知するといったように、段階に応じて通知先を変えます。また、AIの確信度だけで優先順位を決めることはできません。
Q6. 構築した監視システムが正しく機能しているか、どのように確認すればよいですか?
週次で取得失敗や見逃しを確認し、月次で監視対象や検索条件を更新します。さらに四半期ごとに、過去の既知の重要更新を20件用いてシステムの監査を実施します。
このテストを通じて検出率や誤通知率や原典一致率を計測します。確認に要した時間も計測します。もし見逃しがあれば、原因が検索条件や配信元の遅延のどこにあるかを特定します。分類エラーや担当への引継ぎの欠陥なども確認し、改善へつなげます。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント