DeepSeekは2026年10月、推論エンジン「DeepInfer」をオープンソースとして公開しました。DeepInferで利用できる範囲と、DeepSeekと同じようなオンラインサービスを作る際に別途必要なものを確認します。
結論から言うと、公式リポジトリで公開されたDeepInferは、対応機器上でDeepSeek-V4.1-Flashの計算を行う「オフライン推論エンジン」です。
これ単体を入手しただけでWebサービスが完成するわけではなく、オンラインサービスとして運用するには、今回の公開に含まれない部品を用意する必要があります。
たとえば、自社のシステムで「この会議資料を要約して」という依頼を受け付け、回答を返すまでの流れを想像してみてください。今回公開されたDeepInferは、対応モデルを動かして回答を生成する計算を担います。しかし、ユーザーからの依頼を通信で受け付ける窓口や、モデルの重みデータ、そして大量のアクセスをさばくためのインフラ基盤などは同梱されていません。
公開範囲を知ると、既存APIを使うか、対応機器でオフライン推論を試すか、オンラインサービス全体を構築するか判断できます。
DeepInferはモデルを動かす推論エンジン
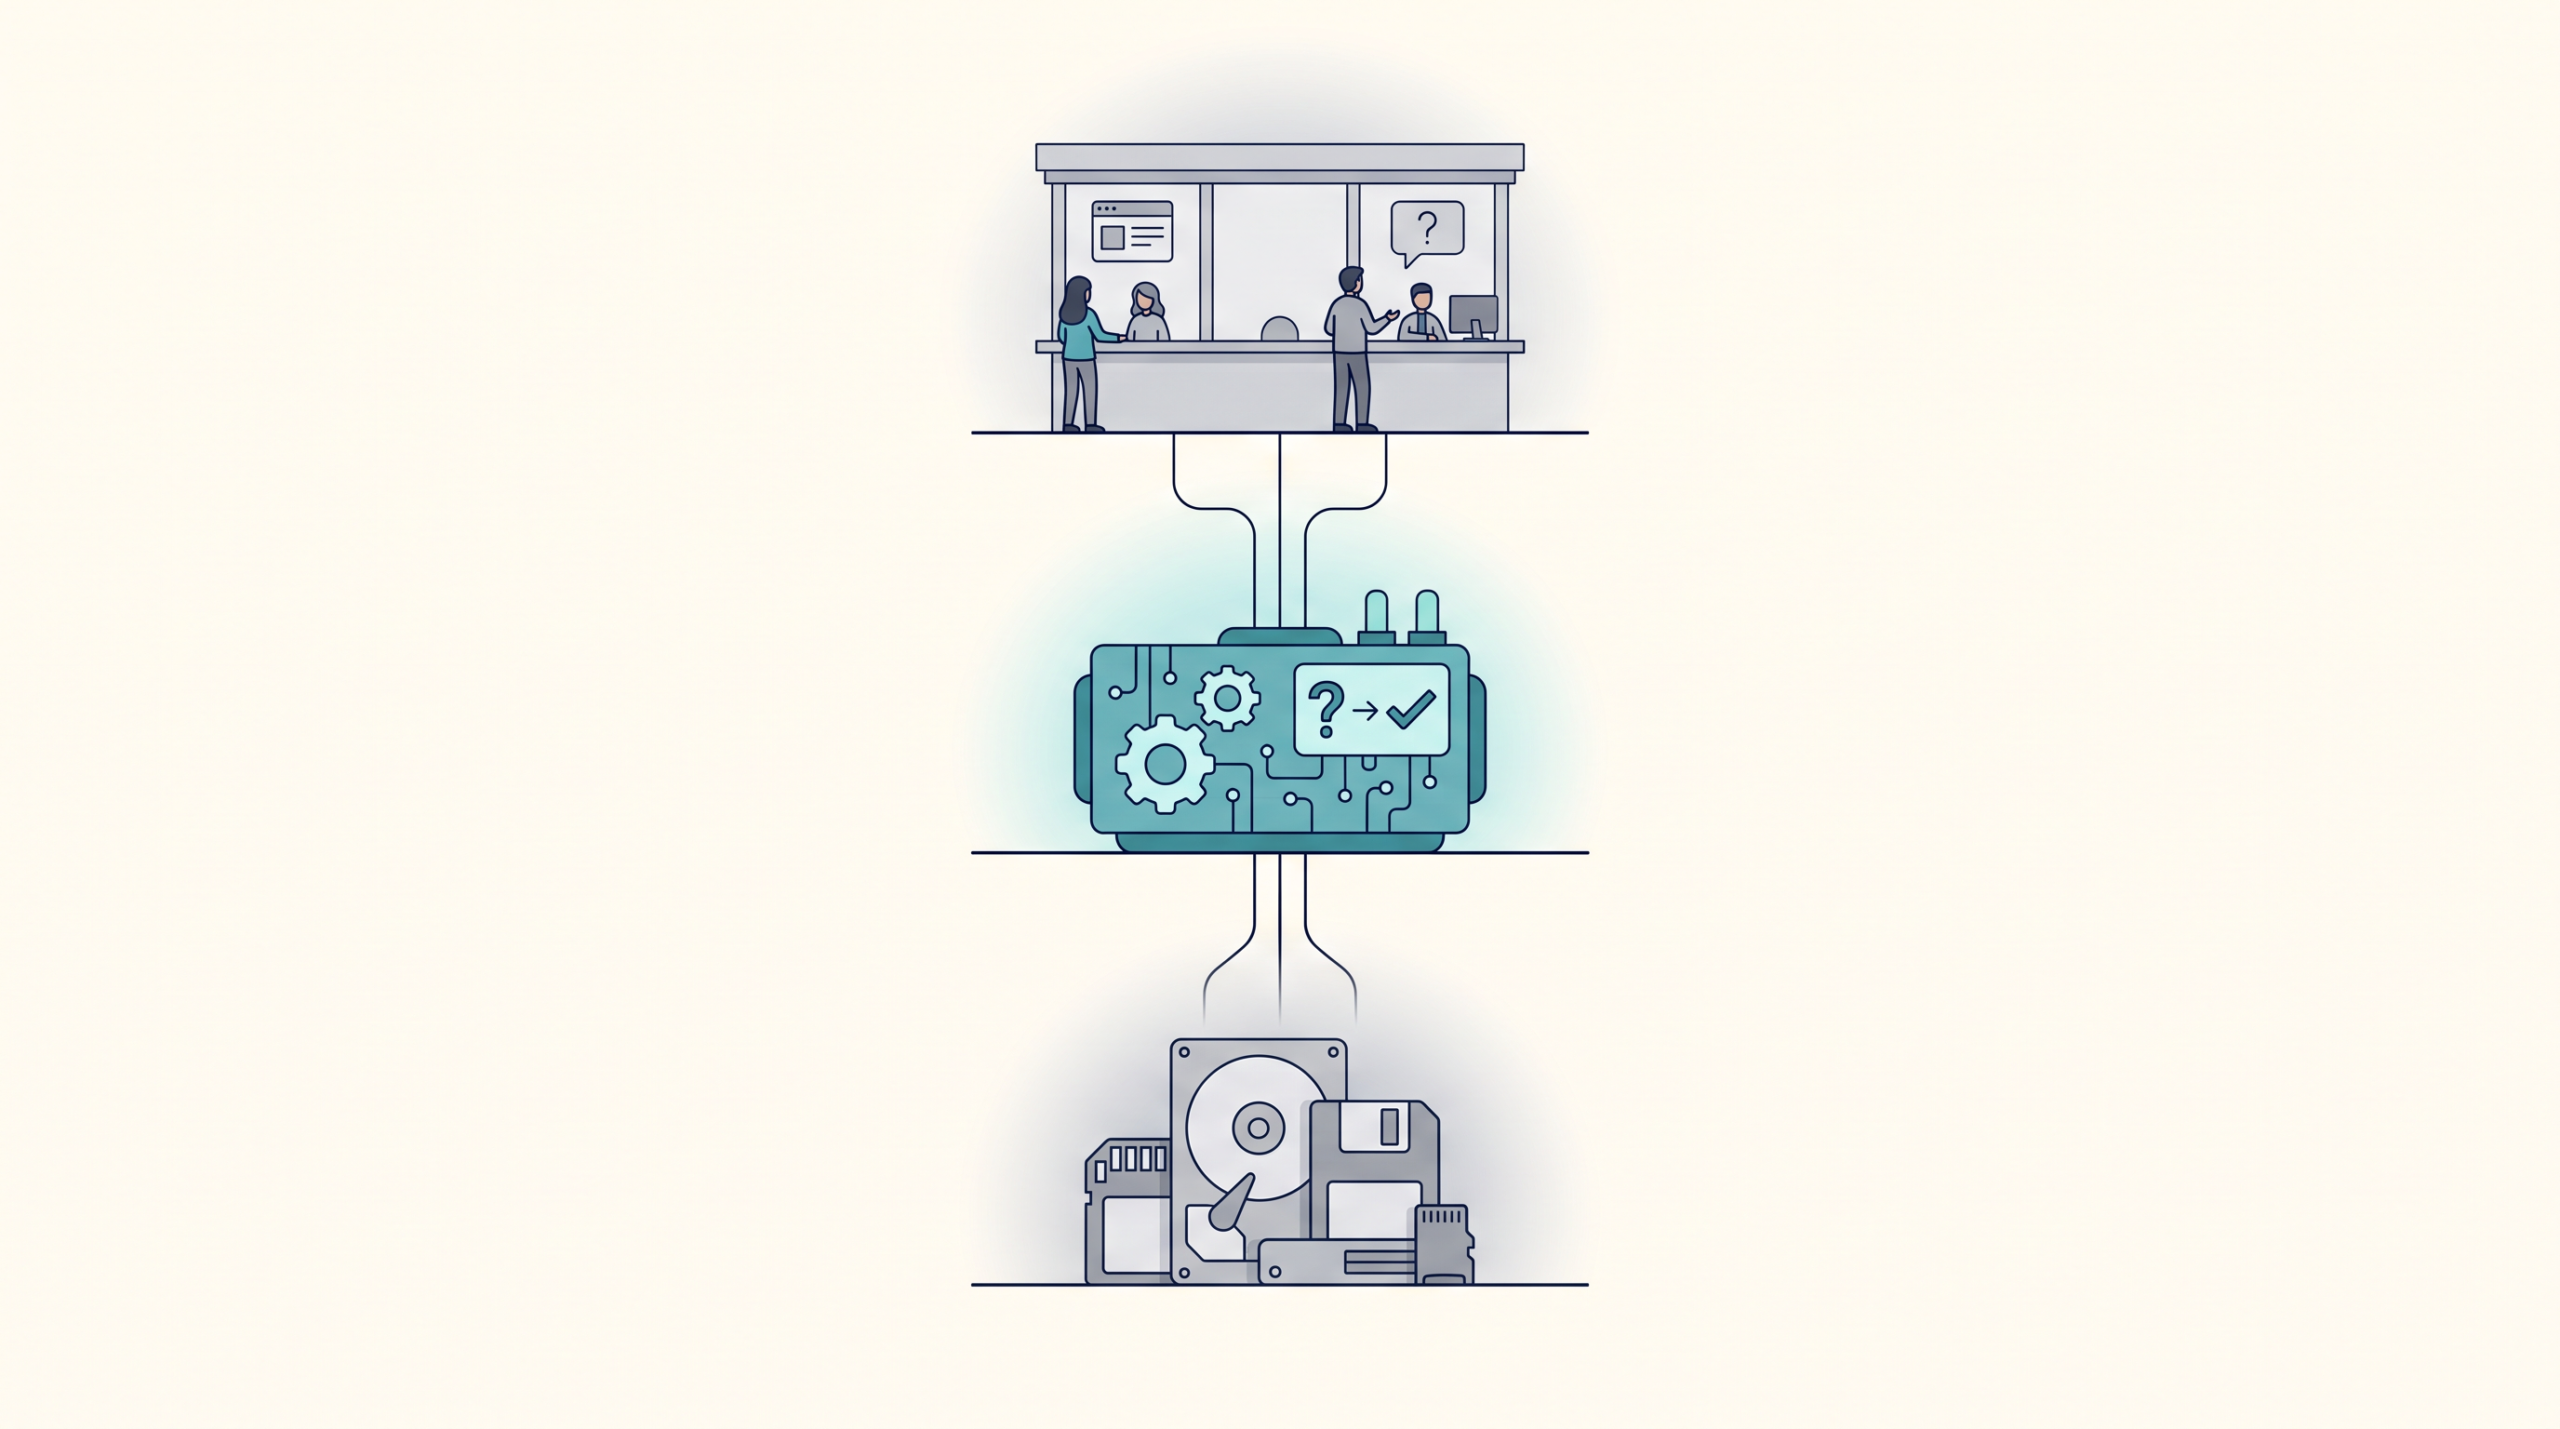
DeepInferは、DeepSeek-V4.1-Flashの学習済みモデルを動かす「推論エンジン」です。今回の公開版はオフライン推論の入口を提供します。対応モデルの重みと、利用者の依頼を受け付けるオンラインサービスは別に考えます。
資料要約サービスへ質問が届いた場面で、モデル、エンジン、オンラインサービスを分けてみます。
「モデル」は、学習によって得た計算上の重みです。「エンジン」は、その重みを計算機で動かし、入力から出力を生成するプログラムです。今回公開されたDeepInferは、大規模サービスを支える推論フレームワークとしてこのエンジンの役割を果たします。 「オンラインサービス」は、APIやチャット画面で利用者の依頼を受け付け、推論処理へ渡し、結果を返すシステム全体です。
架空の資料要約システムに「この会議資料を要約して」という依頼が届くと、オンラインサービスが依頼を受け付けて推論処理へ渡します。DeepInferは、モデルの重みを用いて、回答をトークン単位で生成します。生成された回答を利用者へ返す処理は、オンラインサービス側の仕事です。
そのため、自社でDeepInferを動かすには、エンジン単体だけでなく対応モデルの重みが別途必要になります。
実際のDeepInferのオフライン推論でも、最初の実行時にHugging Face上で別に公開されている「DeepSeek-V4.1-Flash-1017」のチェックポイント(重みデータ)を取得する仕組みになっています。
また、DeepInferは公式が列挙する計算環境を前提としており、現在公式に対応している機器はNVIDIA SM100 GPUとHuawei Ascend 950 NPUです。
既存のDeepSeekのチャットやAPIを使う場合は、DeepSeek V4.1 Flash 1017の記事で利用手順と料金を確認できます。
公開されたエンジンとオンラインサービス全体の境界
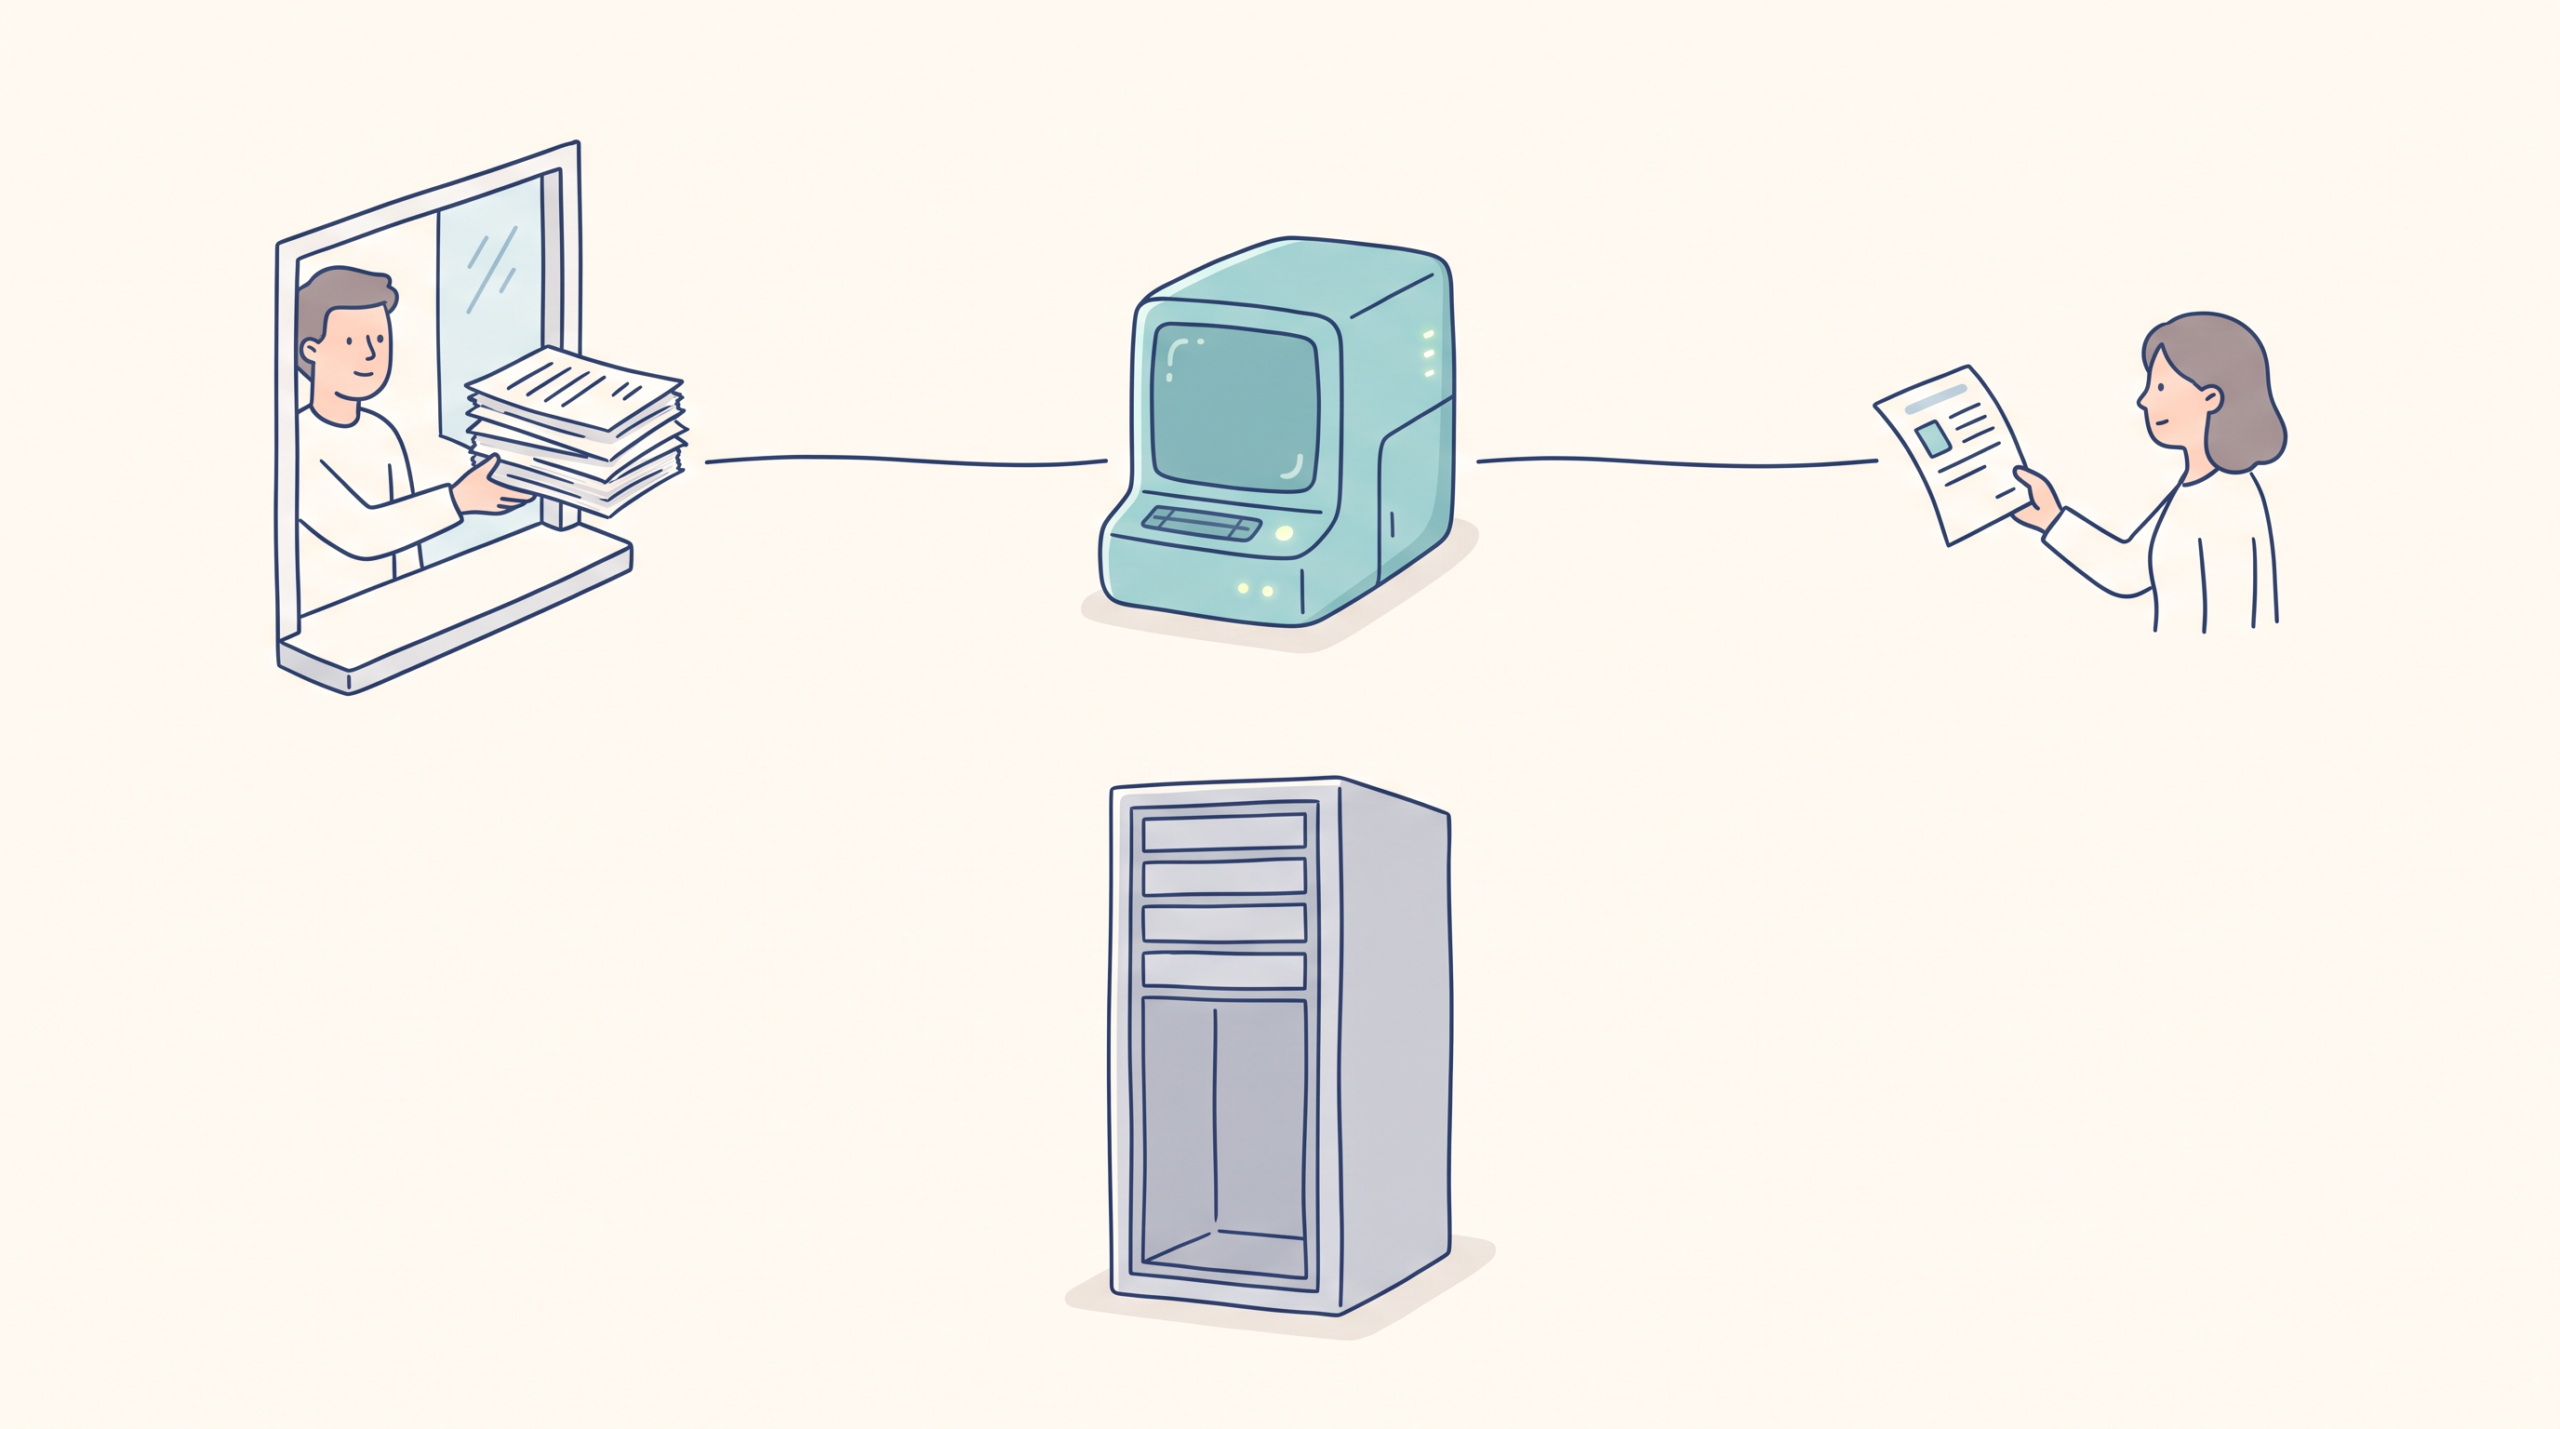
オンラインサービスを構築する場合、公開されたDeepInferはモデルの推論処理を中心に担います。チャット画面やAPIからの依頼を受け付ける機能や、多数の依頼で計算結果を再利用するキャッシュや、処理を複数のサーバーへ分ける仕組みは同梱されておらず、別途組み合わせて用意する必要があります。
架空の資料要約システムでは、「この会議資料を要約して」という依頼が届いてから回答を返すまで、受付、形式変換、推論、返却の処理が続きます。
まず、ユーザーが送信した依頼はサーバーに到達します。このときのHTTPで依頼を受け付ける仕組みは、呼び出し側が用意します。
次に、受け取った依頼文をAIが処理できる数字の列(トークン)に変換します。
別途公開された「deepseek-recipe」は、Chat CompletionsなどのAPI形式をDeepSeekの会話形式へ変換し、トークン列を作る部品を提供します。呼び出し側はこの部品を自社の受付処理や推論処理と接続します。
そして、変換されたデータを受け取り、対応モデルの重みを使い、回答をトークン単位で生成する計算をDeepInferが担います。
しかし、実際のオンラインサービスでは、複数のユーザーから同時に大量の資料要約依頼が飛び込んできます。オフライン推論の例では計算を試せますが、多数の利用者に応答するオンラインサービスとしては、別の部品も必要です。
公式のREADMEでは、今回の公開が「オフライン推論」向けのコードであると明記されています。完全な推論サービスを稼働させるために不可欠な、以下の機能は未同梱となっています。
- 計算済みのキーと値を再利用するための「KVキャッシュシステム」
- 画像を扱う場合のVision Encoder、入力を処理するPrefill、出力を生成するDecodeを別のサービスへ分けて配置する仕組み
- 複数の機器間で処理を分担するレプリカ間の「負荷分散」
公式の運用Q&Aは、キャッシュ管理と負荷分散の部品が社内インフラに密接で、コードを完全には公開していないと説明しています。
つまり、DeepInferを使ってDeepSeekと同じようなオンラインサービスを自社で動かすには、通信の受け口やトークン化の処理を組み合わせるだけでなく、大量の依頼をさばくためのインフラ基盤を自前で補う必要があるのです。
大量の依頼を処理する工夫は何を受け持つか
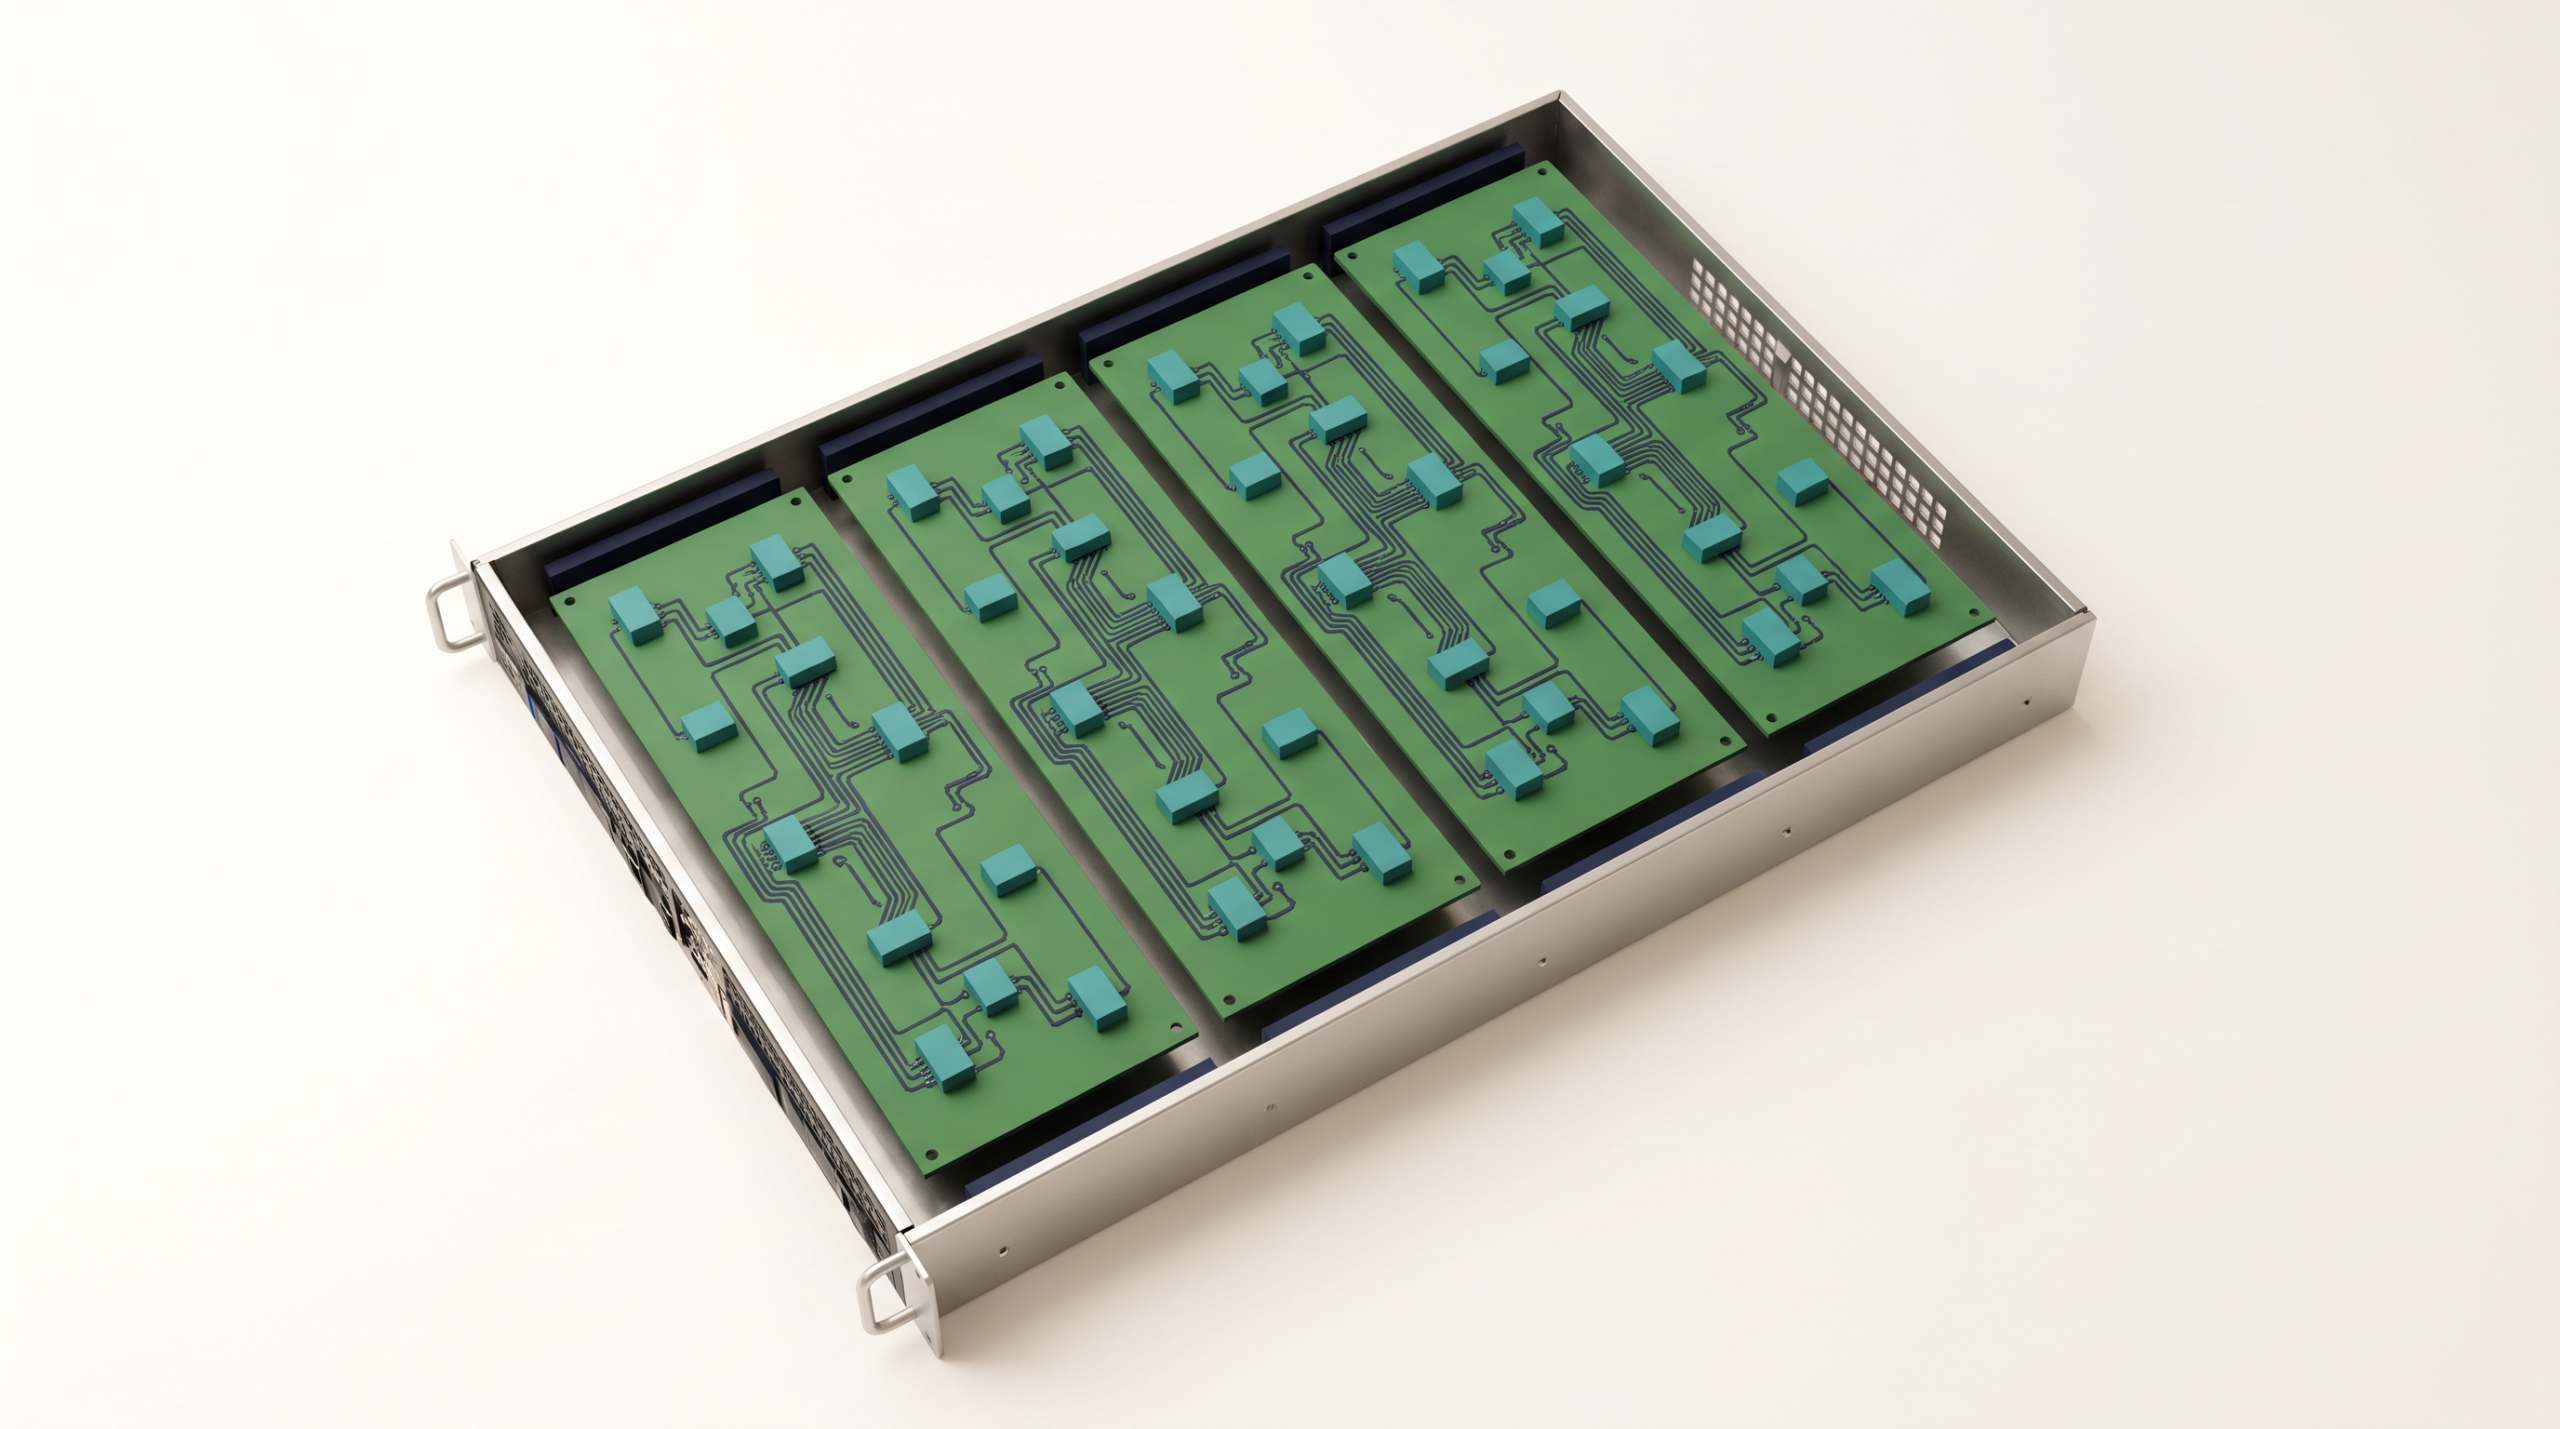
DeepInferはシステム全体の通信管理やインフラ構築を含まない一方で、渡された推論処理を高速かつ効率的に終わらせるための複数の内部機構を備えています。
公開されたエンジンはExpert Parallelism(EP)、先読み検証、SWA bounded replay、非同期スケジュールなどを備えています。これらは対応機器上の推論計算を効率化する機能で、前節のオンラインサービスに足りない部品を補うものではありません。
資料要約の依頼をモデルで処理するとき、それぞれの機能が担う仕事は異なります。
1つ目は「MoE(Mixture of Experts)のExpert Parallelism(EP)と負荷分散」です。DeepSeek-V4.1-FlashはMoE(複数の専門家部分を持つモデル)を使い、入力に応じて一部の専門家を選んで計算します。
公式のREADMEに記載があるように、公開されたエンジンは複数の計算装置に専門家を配置して並列計算し、Expert Parallelism Load Balancingで専門家間の負荷の偏りを調整します。
2つ目は「DSparkの先読み候補の検証」です。推論エンジンはトークンを順に生成するだけでなく、後続のトークン候補を先読みし、採用できる候補を検証する仕組みを持っています。これにより、条件が合う場合は出力処理量を改善できます。
3つ目は「SWA bounded replay(Sliding Window Attentionの再計算)」です。SWA(スライディングウィンドウアテンション)の状態が必要になった際、長い入力全体をやり直す代わりに、限られた末尾部分だけを再計算する仕組みです。
READMEはV4.1向けの既定値として再計算に残す末尾140トークンを示しています。これは資料要約で入力できる文章の長さではありません。
4つ目は「CPUスケジュールと装置計算の重ね合わせ」です。これは、計算の指示出しを行うCPUと、実際の計算を行う装置(GPUやNPU)の作業タイミングをずらして同時に動かす非同期の仕組みです。CPU側の次の計算の準備を装置側の実行と重ね、装置の待ち時間を減らします。
公式の運用Q&Aは、本番で入力の読み込み(Prefill)と出力の生成(Decode)を別のサーバー群へ分ける配置を説明しています。ただし、公開版だけでは両方のサーバー群を運用する仕組みはそろいません。エンジン内の並列化と、オンラインサービス全体の負荷分散は別の層の仕事です。
性能図と1日155兆トークンの読み方
DeepInferの性能図や「1日155兆トークン」といった数字は、異なる条件で示された測定結果と運用報告です。これらは自社環境での性能保証や、ビジネス上の利益を直接表すものではありません。公開された資料の数値は、測定対象や条件を正確に分けて読み解く必要があります。
まず、公式のREADMEに掲載されている性能図の読み方です。推論処理は、入力された文章を読み込む「Prefill」と、続きのトークンを生成する「Decode」に分かれており、それぞれ別の条件で測定されています。具体的には、NVIDIA SM100 GPUを用い、Prefillに4基、Decodeに64基を割り当てた環境での結果が示されています。
Prefillのグラフは、入力のうちキャッシュされていない部分の処理量と遅延を表しています。一方、Decodeのグラフは、出力の処理量と、利用者ごとの生成速度を別軸で示しています。
また、測定方法の解説によると、生のDecodeの処理量(スループット)は「先読みした予測候補がすべて採用された」という理想的な仮定で計算されていると説明されています。
Decodeの性能図は横軸が利用者ごとの出力速度、縦軸がGPU当たりの出力処理量です。曲線の作成には、先読み候補の採用率を75%と置く別の条件が使われています。これは実測された採用率を意味せず、自社の資料要約依頼で同じ速度になるとも判断できません。
次に、公式の運用Q&Aに記載された「単一クラスターが1日155兆トークンを処理し、利用が少ない時間帯の料金で計算したGPU1基・1時間当たりの総収入が38米ドル」という運用報告についてです。
これはDeepSeekが自社の単一クラスターについて報告した値です。しかし、公表された文書からは、使用されたクラスター全体の総GPU数や、入力・出力トークンの詳細な内訳までは特定できません。さらに「38米ドル」という数字は総収入(売上)の報告であり、運用コストを引いた「利益」やインフラの「GPUレンタル料金」を意味するものではない点に注意が必要です。
たとえば、自社で「会議資料の要約システム」を構築する場合を想像してみてください。ユーザーから依頼された長文資料の読み込み(Prefill)や、要約文の生成(Decode)という計算処理自体は、公開されたエンジンが担う領域です。しかし、性能図は機器台数だけでなく並列配置、入力長、バッチ数、先読み候補の採用率などの条件に依存します。
また、公開されたエンジン単体を入手しても、そのまま1日155兆トークンもの大量の要約依頼をさばけるわけではありません。大量のユーザーからの依頼を受け付け、複数のサーバーに処理を振り分け、運用費用を把握する仕組みは今回の公開エンジンだけからは得られないため、これらは別途自社で用意・構築する必要があるのです。
自社で動かすときの準備と欠けている部品
自社でDeepInferを動かしてAIサービスを構築するためには、公式が対応を示す計算機器とソフトウェア環境を準備し、オフライン推論から試していく必要があります。公式が示すオフライン推論の入口から検証できますが、既定モデルの重みは初回に別途取得します。オンラインサービスまで作るなら、キャッシュや負荷分散なども設計します。
まず、DeepInferを動かすための前提環境について確認しましょう。公式のREADMEによれば、OSはLinux、コンパイラはGCC 13以上、プログラミング言語はPython 3.12が必要です。
さらに、計算を担う機器としてNVIDIAのSM100 GPU(CUDA 13環境)またはHuaweiのAscend 950 NPU(CANN 9.2環境)という機器が公式の対応機器として指定されています。
公式READMEにあるNVIDIA向けの入口を抜き出すと、次の3行です。Linux、GCC 13以上、Python 3.12、CUDA 13と対応GPUを用意します。リポジトリを取得してルートディレクトリで実行します。
詳細な依存関係は公式の導入手順で確認してください。Ascendでは環境変数の値をascendに変えます。
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py
この例は対応機器での推論処理を試すためのもので、オンラインサービスを起動するコマンドではありません。初回実行時は既定モデルの重みデータをHugging Faceから取得するため、通信と保存領域も必要です。
このプログラムで確認できるのは対応機器上のモデル推論です。資料要約のオンラインサービスとして多数の依頼を受け付けるには、受付や振り分けなどを追加します。
その際に重要となるのが、入力テキストの読み込み(Prefill)と、要約文の生成(Decode)をそれぞれどの機器に担当させるかという配置設計です。公式の運用Q&Aでは、このサーバー配置について解説されています。
前節のPrefill4基とDecode64基はそれぞれの性能図の測定条件です。
運用Q&Aは別に「Prefill用に64基、Decode用にも64基」を効率的な構成と説明する一方で、「1 Prefill+1 Decode」という配置も可能であることが明記されています。つまり、64基+64基は公式が述べる効率面の構成であり、DeepInfer単体の起動最低条件ではありません。
対応機器でのオフライン検証と、多人数向けオンラインサービスの構築は分けて計画します。後者では、キャッシュ、段階別の配置、レプリカ間の負荷分散をどう用意するか判断します。
既存サービスの利用者・開発者・運用者が決めること
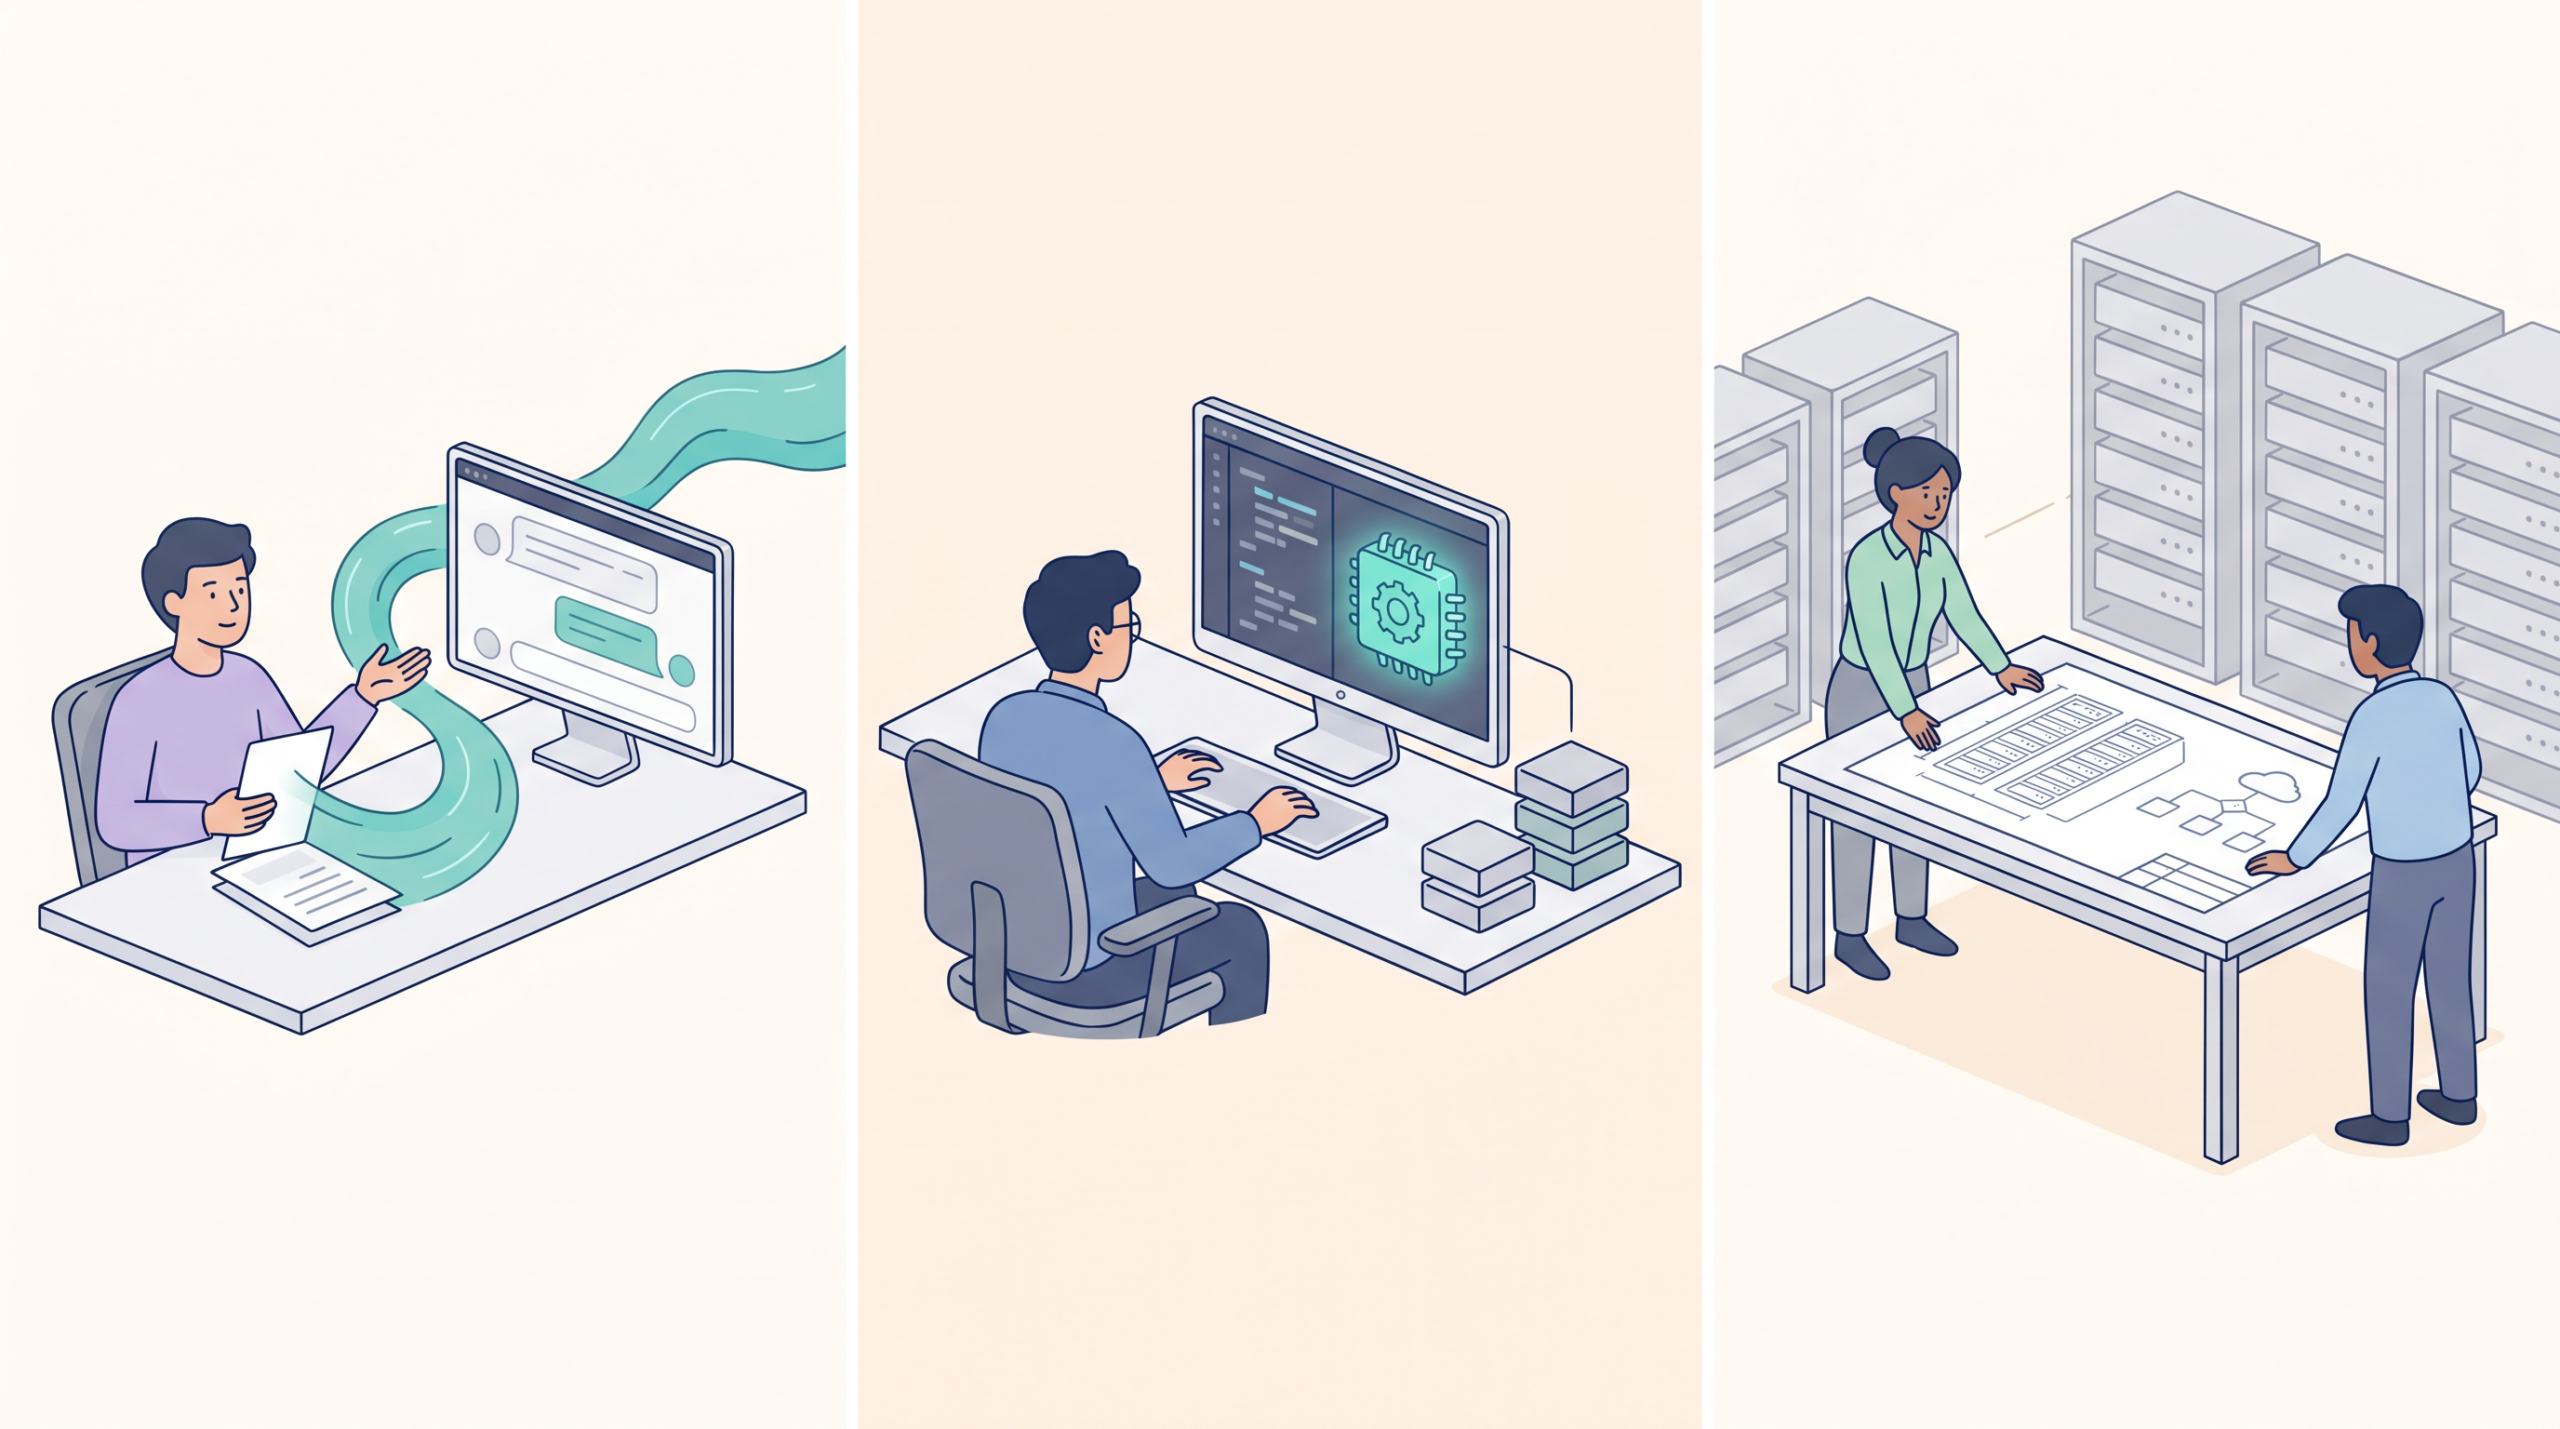
DeepInferの公開を受けて、読者が次に取るべき行動は「既存サービスの利用者」「開発者」「運用者」のどの立場にあるかによって異なります。今回公開されたのはオフライン推論を中心とするエンジンであるため、自社の目的に応じて既存のサービスを使うか、検証ツールとして活用するか、不足している部品を補ってシステム全体を構築するかを選択する必要があります。
これまで例に挙げてきた「会議資料の要約」という依頼が、システムの受付から回答へ進むまでの流れに沿って、それぞれの立場における次の行動を見ていきましょう。
まず、DeepSeekの既存サービスを利用する立場です。チャットで資料要約を頼む人と、公式APIを自社アプリへ組み込む開発者が含まれます。この場合、要件を満たす最新機器を用意して推論エンジンを自社で構築する必要はありません。
サーバーやモデルを自前で管理せずとも、すでに提供されているDeepSeekモデルのチャット画面や公式APIを利用すれば、要約依頼を送信して回答を得られます。チャットを使う人は利用規約と資料の送信先を、APIを組み込む人はAPIの利用条件と資料の送信先を確認します。
次に、公式対応機器を使って自社環境で推論を検証する開発者の立場です。開発者は、公開されたツール群を組み合わせて推論の流れをテストすることになります。
たとえば、要約システムに届いた依頼文を、AIが処理できるメッセージ形式に変換する部分は「deepseek-recipe」が担ってくれます。ただし、同ツールが担うのは形式変換とトークン化までです。
受付窓口となるHTTP通信のプログラムや、変換後のデータをモデル推論に引き渡す処理は、呼び出し側である開発者自身が記述しなければなりません。そのうえで、要約文を生み出す実際の計算部分はDeepInferのオフライン推論を利用して検証する、という切り分けになります。
開発者は生成された要約と元資料を照合し、重要な情報が抜けていないか確認します。抜けがあれば入力形式や要約の指示を見直し、対応機器で再び試します。
最後に、自社のインフラで資料要約の依頼をさばく推論基盤を運用したい「運用者」の立場です。DeepInferは計算処理を高速に担う推論エンジンですが、単体ではオンラインサービスとして成立しません。
公式資料によると、エンジンの公開版はオフライン推論の入口を提供します。一方、計算済みのキーと値を再利用するKVキャッシュシステム、入力と出力の段階別分離、複数サーバー間の負荷分散は未同梱です。
運用者は、これら不足するインフラ部品をどう調達・実装するかを判断し、全体構築に踏み切るかどうかを決断する必要があります。
このように、公開されたDeepInferは回答を計算する推論エンジンです。資料要約依頼の受付から回答に至るシステム全体の中で、自分たちがどの領域を必要としているかを見極め、次の行動を選択してください。
よくある質問
Q1. DeepInfer単体で資料要約のWebAPIになりますか?
A. 単体ではWebAPIになりません。DeepInferはオフラインで計算を行うエンジン本体であり、WebAPIとして通信を受け付ける機能は持っていません。また、文章の形式を整える「deepseek-recipe」もHTTPサーバーの機能は持っていないため、要約依頼の受付から回答へ至るオンラインサービスを作るには、通信の窓口を別途用意する必要があります。さらに、複数人からの依頼を同時にさばくためのKVキャッシュシステムや、サーバー間の負荷分散の仕組みも別途補う必要があります。
Q2. 手元の一般的なパソコンやGPUで動かせますか?
A. 結論として、公式には対応していません。現在の公式READMEは、対応機器としてNVIDIA SM100 GPUとHuawei Ascend 950 NPUを列挙しています。公式READMEは一般的な消費者向けGPUを対応機器として列挙していないため、手軽にAIによる資料要約機能を試したい場合は、自社でエンジンを構築するのではなく、既存のDeepSeek公式APIなどを利用するのが一つの選択です。
Q3. 性能図にある「Decode throughput」は、実際の出力速度と同じですか?
A. そのまま実際の出力速度として捉えることはできません。公式資料によれば、Decodeの処理量(スループット)は「先読みした予測候補がすべて採用された」という理想的な仮定で算出されています。画面に表示される速度には先読み候補の採用率、同時利用者数、通信などが関わります。図の「利用者ごとの速度」と、出力処理量の軸を分けて読んでください。
業務に合うAIシステムの開発をご相談ください
AIを試せても、社内のデータや既存システムにつないで使うには、入力・出力・権限・確認手順を決める必要があります。Deskrexでは、業務に合わせたAIエージェントや自動化システムの開発をご支援しています。
まず、つくりたいシステムと現在の業務、接続するツールやデータを伺います。技術の選定と小規模な試作を通じて、必要な機能と実現方法を確かめ、開発の範囲を整理します。
Difyやn8nを使う自動化、独自のAIエージェント、セルフホスト型システム、既存システムとの連携に対応します。試作から本開発、導入、保守・運用まで、案件の目的に合わせて進めます。
つくりたいシステム、扱うデータ、接続先をお知らせください。受託開発のご案内をご覧ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai