中国のAI企業DeepSeekが提供する「DeepSeek V4.1 Flash 1017」は、高度な処理能力と低コストを両立したと謳われる生成AIの最新モデルです。テキスト処理に加えて画像の読み取りにも対応し、プログラミングや複雑なタスクの自動化をこなす能力を備えています。
しかし、初めてこのモデルを知る方にとっては、「そもそも何ができて、どこから使い始めればよいのか」「日本語の資料整理や小さな開発作業で本当に実用になるのか」といった疑問があるはずです。
本記事では、DeepSeek V4.1 Flash 1017の基本仕様と、ブラウザのチャットやAPIを通じた利用手順をわかりやすく整理します。そのうえで、実際にAPIを用いた日本語での2回の実測結果や、出力上限に関する注意点、時間帯で変わる料金の仕組みを交えながら、実務へ安全に導入するための使いどころを解説します。
DeepSeek V4.1 Flash 1017とは
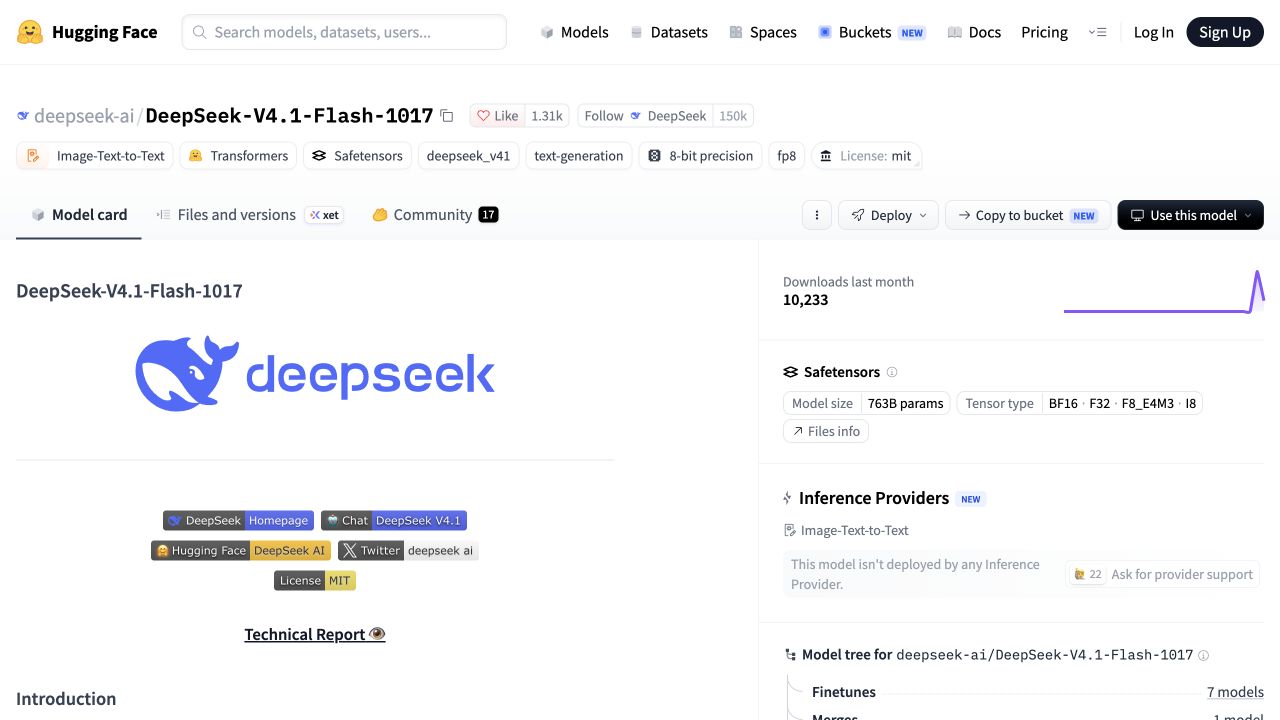
DeepSeek V4.1 Flash 1017は、DeepSeekが公開している生成AIモデルです。2026年9月に新しいアーキテクチャを採用して発表された「DeepSeek V4.1 Flash」に対して、機能改善を施した10月17日のマイナーアップデート版にあたります。公式のモデルカードでも公開されており、オープンソースモデルとしてMITライセンスが付与されています。
AIを活用するにあたり、まずは頭脳である「AIモデルそのもの」と、それを利用するための「窓口(道具)」を分けて考えることが重要です。DeepSeek V4.1 Flash 1017はあくまで情報を処理するモデルであり、私たちが実際にこれを使う際には、ブラウザ上で手軽に利用できるチャット画面やスマートフォン向けアプリ、自社のシステムに組み込むためのAPI(プログラムからAIを呼び出す仕組み)、あるいは「DeepSeek Harness」と呼ばれる開発用の実行環境といった、目的に応じた窓口を通すことになります。
モデルの仕様とできること
このモデルの大きな特徴の一つが、ネイティブな視覚理解能力を備えている点です。テキストだけでなく画像の入力にも対応しており、写真の内容を説明させたり、スクリーンショット内の文字を読み取ったり、グラフのデータを分析させたりすることができます。ただし、モデルが生成できる出力はテキストのみです。入力された画像を理解することはできても、新しい画像や動画を作り出す画像生成器ではない点には注意が必要です。
また、一度に処理できる情報量(コンテキストウィンドウ)の大きさも特徴です。仕様上、入力と出力を合わせた総容量として約100万(1,048,576)トークン(AIが文章を処理する際の単位)を扱うことができ、APIを利用した際の最大出力数は約38万(393,216)トークンに設定されています。大量の資料を一度に読み込ませて長文の回答を得るような用途に向いていますが、容量が大きいからといって、入力したすべての資料を常に一言一句完璧に理解することが保証されるわけではありません。
さらに、モデルは自ら外部の道具を使うための「ツール呼び出し」の機能を備えています。たとえば、モデルが回答を生成する過程で「この情報を検索したい」「ファイルを作成したい」と判断した場合、その操作要求を出力として返します。しかし、モデル単体が勝手にインターネットを検索したり、パソコンのファイルを直接書き換えたりするわけではありません。実際にWebから情報を取得(Search & Fetch)したり、プログラムのコマンドを実行したりするのは、AIの指示を受け取って動く「Harness」などの実行環境側の役割となります。
このように、DeepSeek V4.1 Flash 1017は、高度なテキスト処理と画像理解を備えた強力な頭脳であり、適切な道具や環境と組み合わせることで、複雑な作業を大きく効率化する可能性を秘めています。
旧版から何が進化したのか
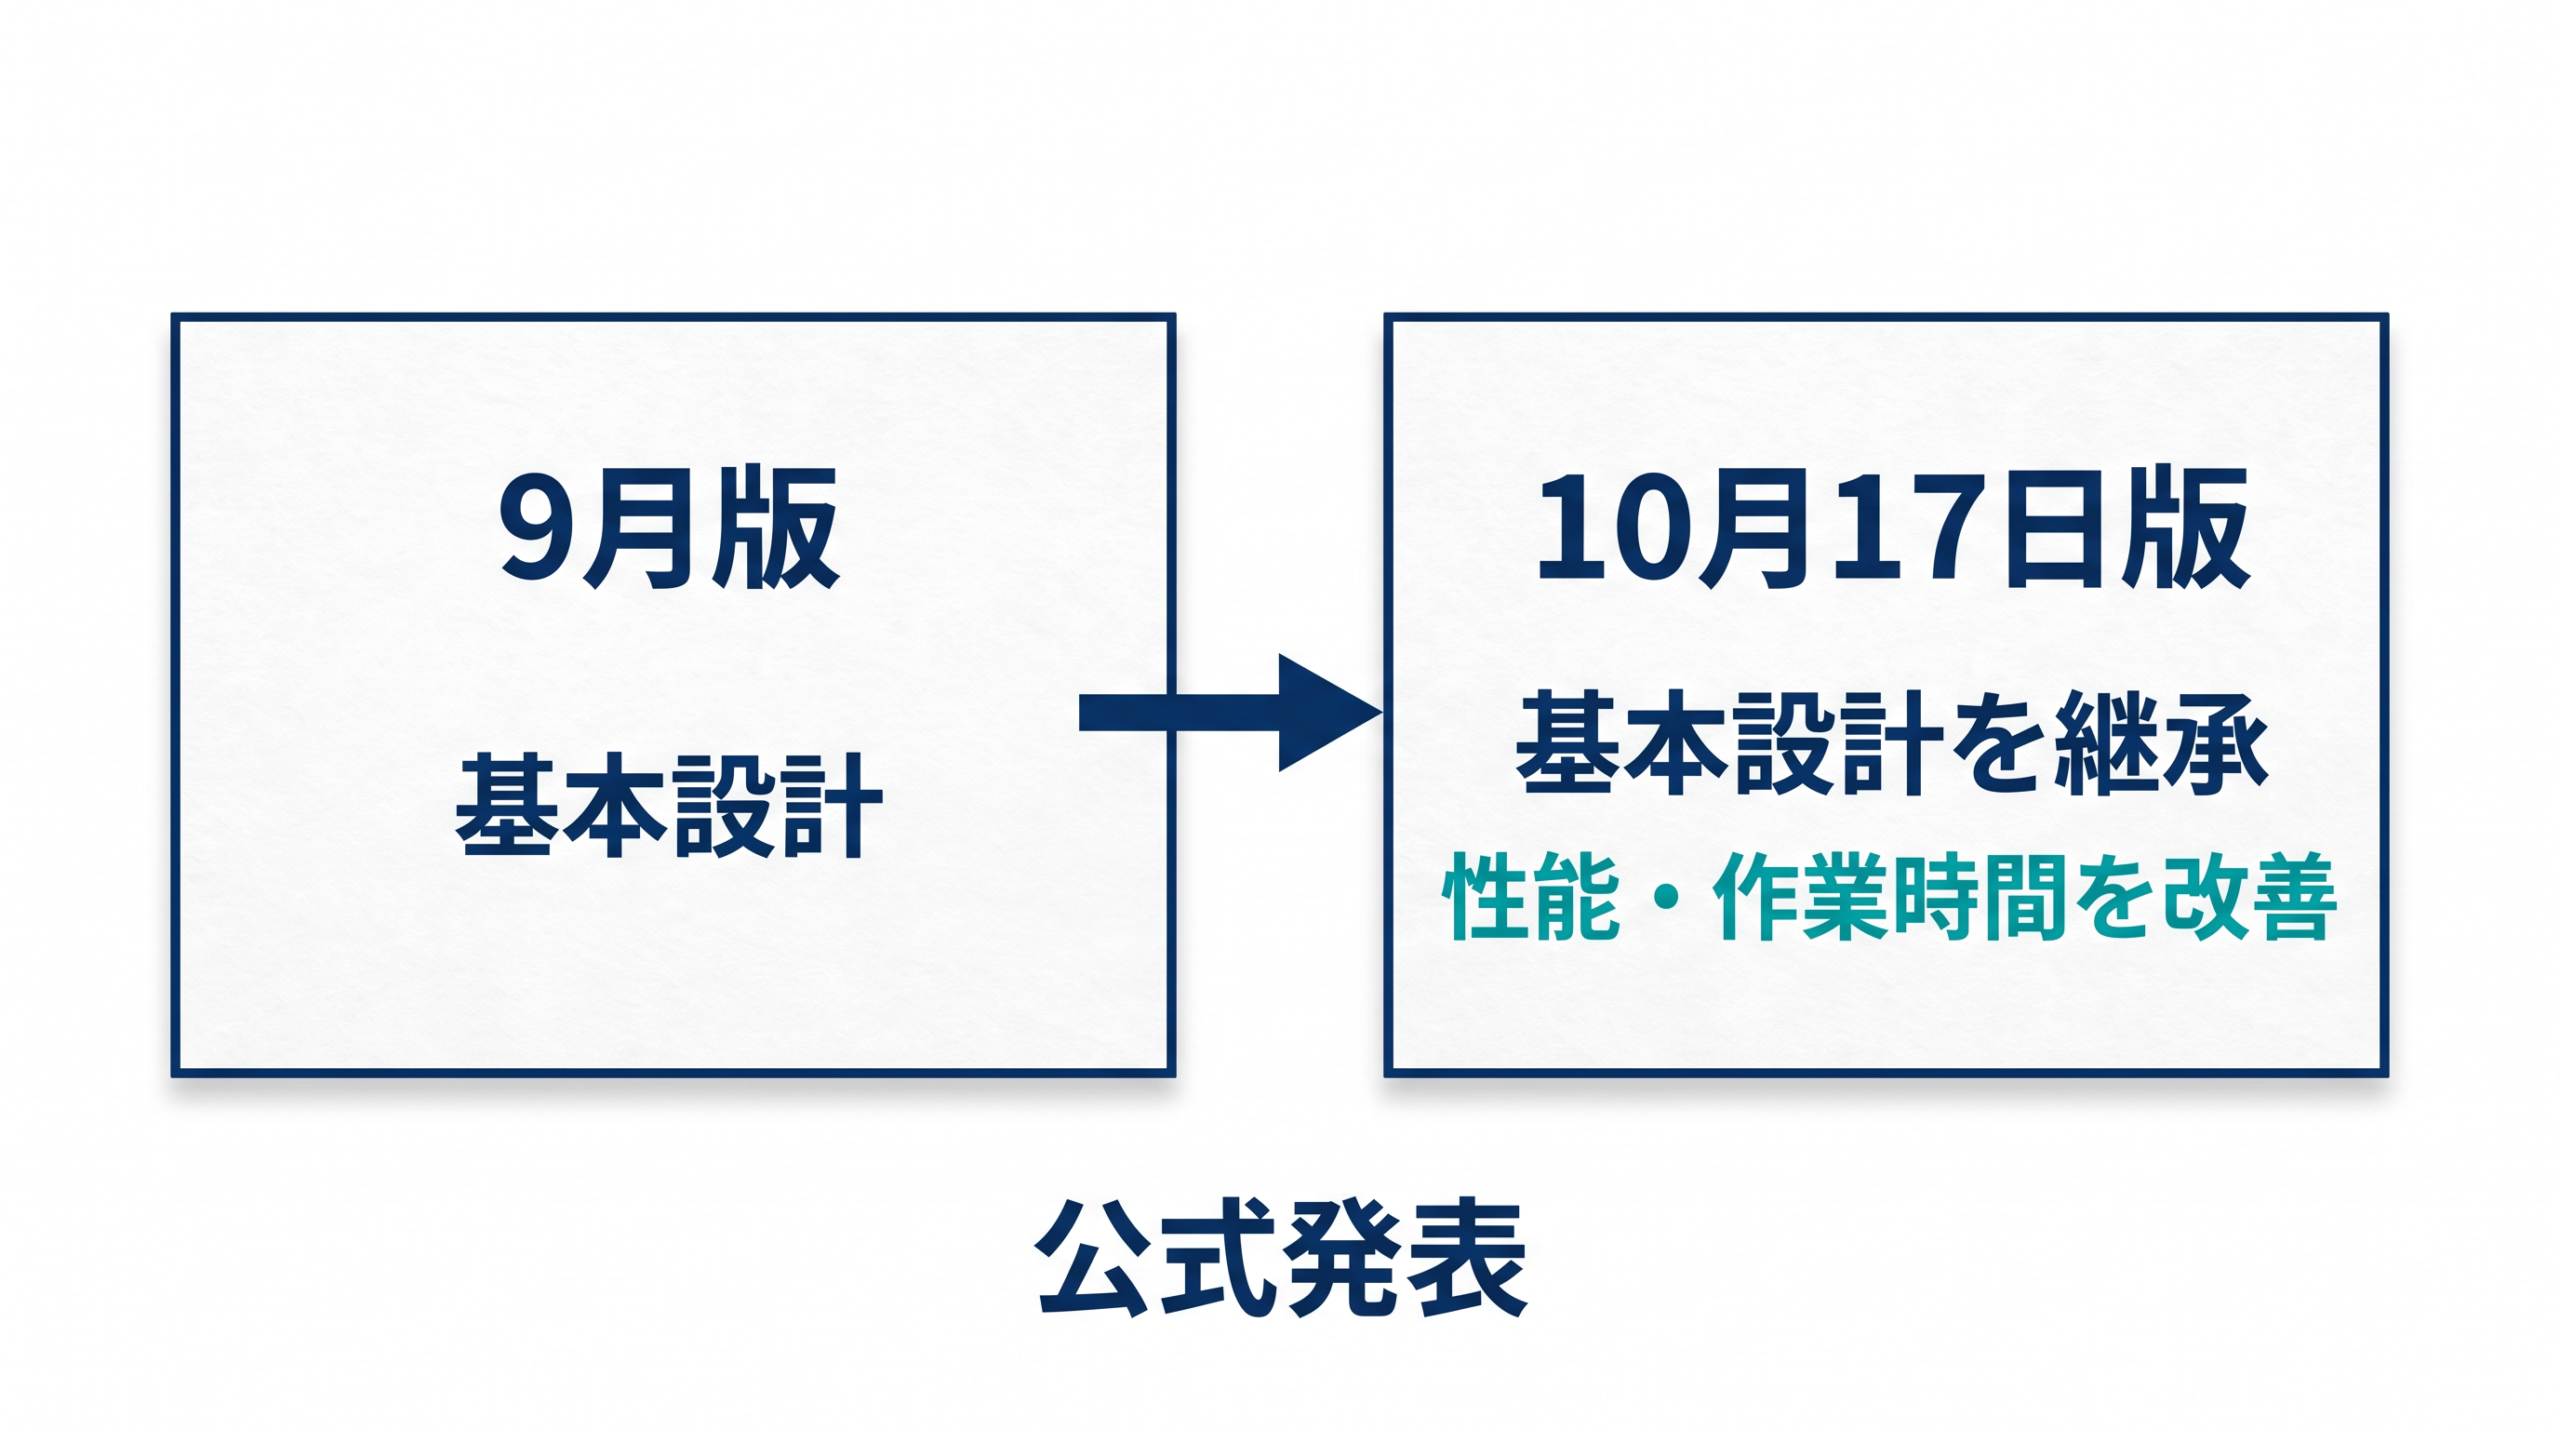
10月17日の公式発表によると、新しい1017版は9月の旧版から推論、コーディング、エージェントタスク、および視覚評価の面で大幅な改善を果たしたマイナーアップデートモデルです。最大の進化は、単に賢くなっただけでなく、タスクの実行時間と出力量を削減した点にあります。無駄の少ない出力によって、より早く、低コストで作業を完了できるようになったと説明されています。
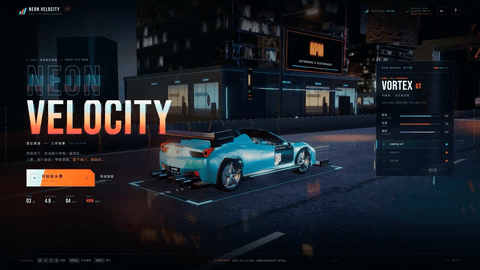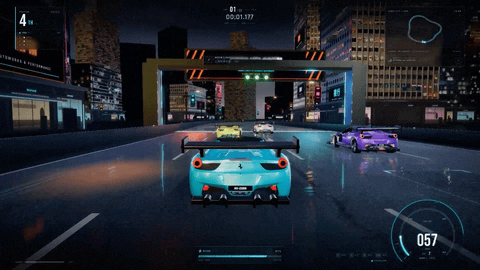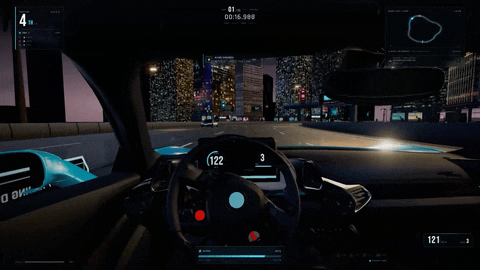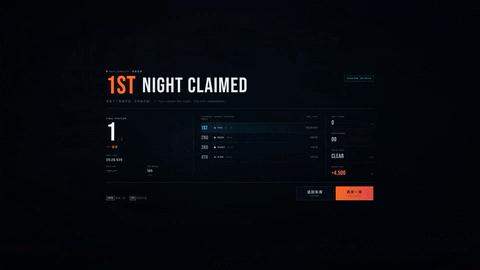
また、自己フィードバックを伴う強化学習を取り入れることで、プロジェクトを最初から最後まで完成させる能力が強化されました。公式のデモでは、紫禁城の3Dモデル生成や、Webベースのレースゲーム開発、ゲームエンジンであるGodotを使った3D空間の構築など、複雑で連続した作業をこなす例が挙げられており、AIエージェントとしての実用性が底上げされています。なお、AIエージェント実行環境を利用する場合は、今回のモデルに最適化されたDeepSeek Harnessのv0.2.1-rc.1以降のバージョンが推奨されています。
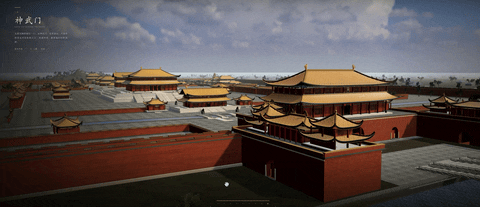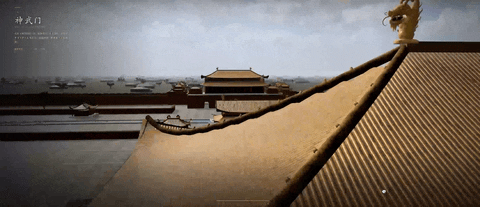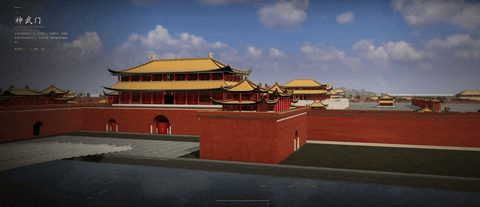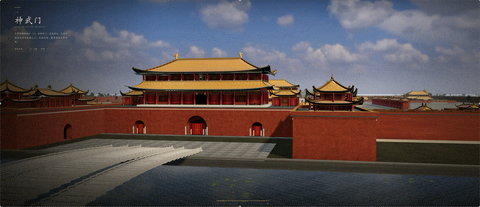
具体的な性能の変化について、公式モデルカードで公開されているベンチマーク(性能評価)の比較表から、旧版との差を見てみましょう。
コマンドライン環境の操作を評価するTerminal-Bench 4.0は旧版の31.2から42.3へと大きく向上し、プログラミング能力を測るProgramBenchも20.3から29.1へと上昇しました。さらに、ソフトウェア開発の課題を解くDeepSWE v1.1は74.2から77.0へ、タスク自動化を評価するAutomation-Bench v1.0.6は54.8から60.5へ改善しています。幅広い専門分野の難問への対応力を見るHLE(ツールなしの評価)も36.8から42.6へ伸びており、基礎的な推論能力から実践的な開発タスクまで、全般的にスコアが向上しています。
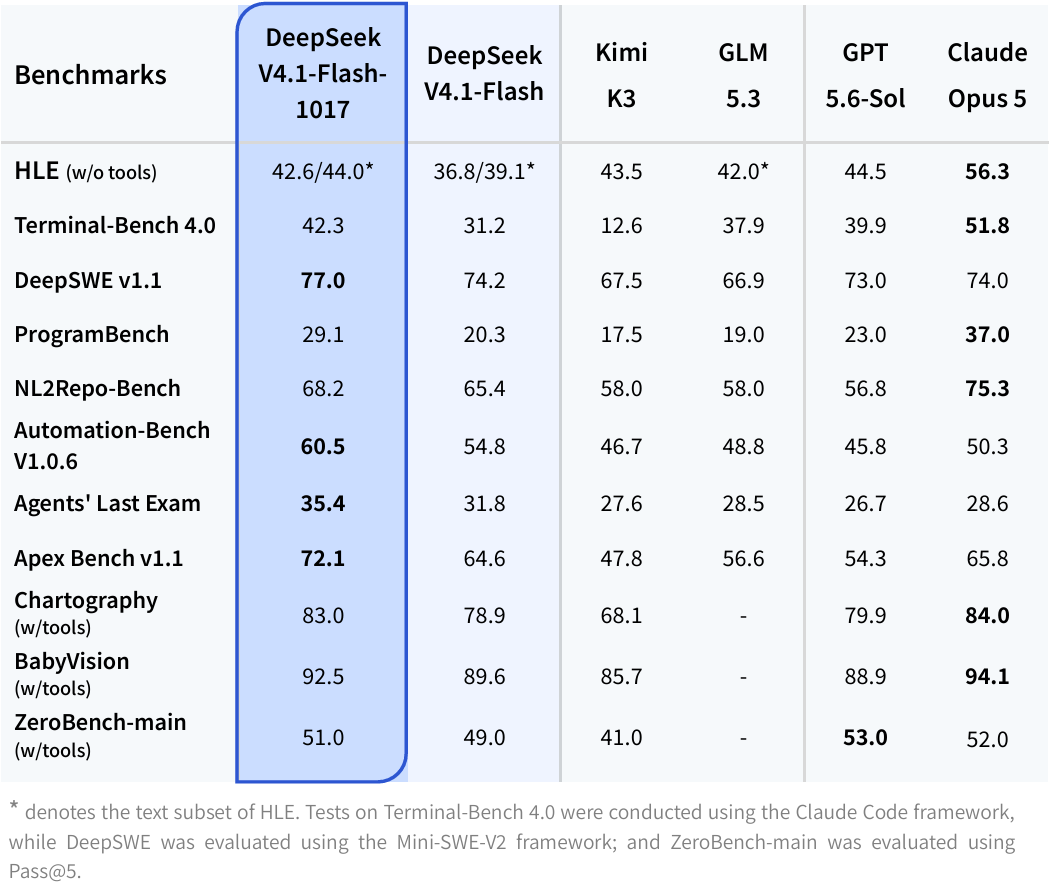
ただし、これらの数値はいずれもDeepSeekによる公表値であり、第三者による独立した測定結果ではありません。また、一部の評価はClaude CodeやMini-SWE-V2といった特定の実行環境を用いて測定されたという注記があり、モデル単体ではなく、ツールと環境を組み合わせた結果である点に留意が必要です。
この比較表では、他社の高性能モデルであるOpus 5との比較も行われており、1017版の得意な分野と不得意な分野の傾向が読み取れます。
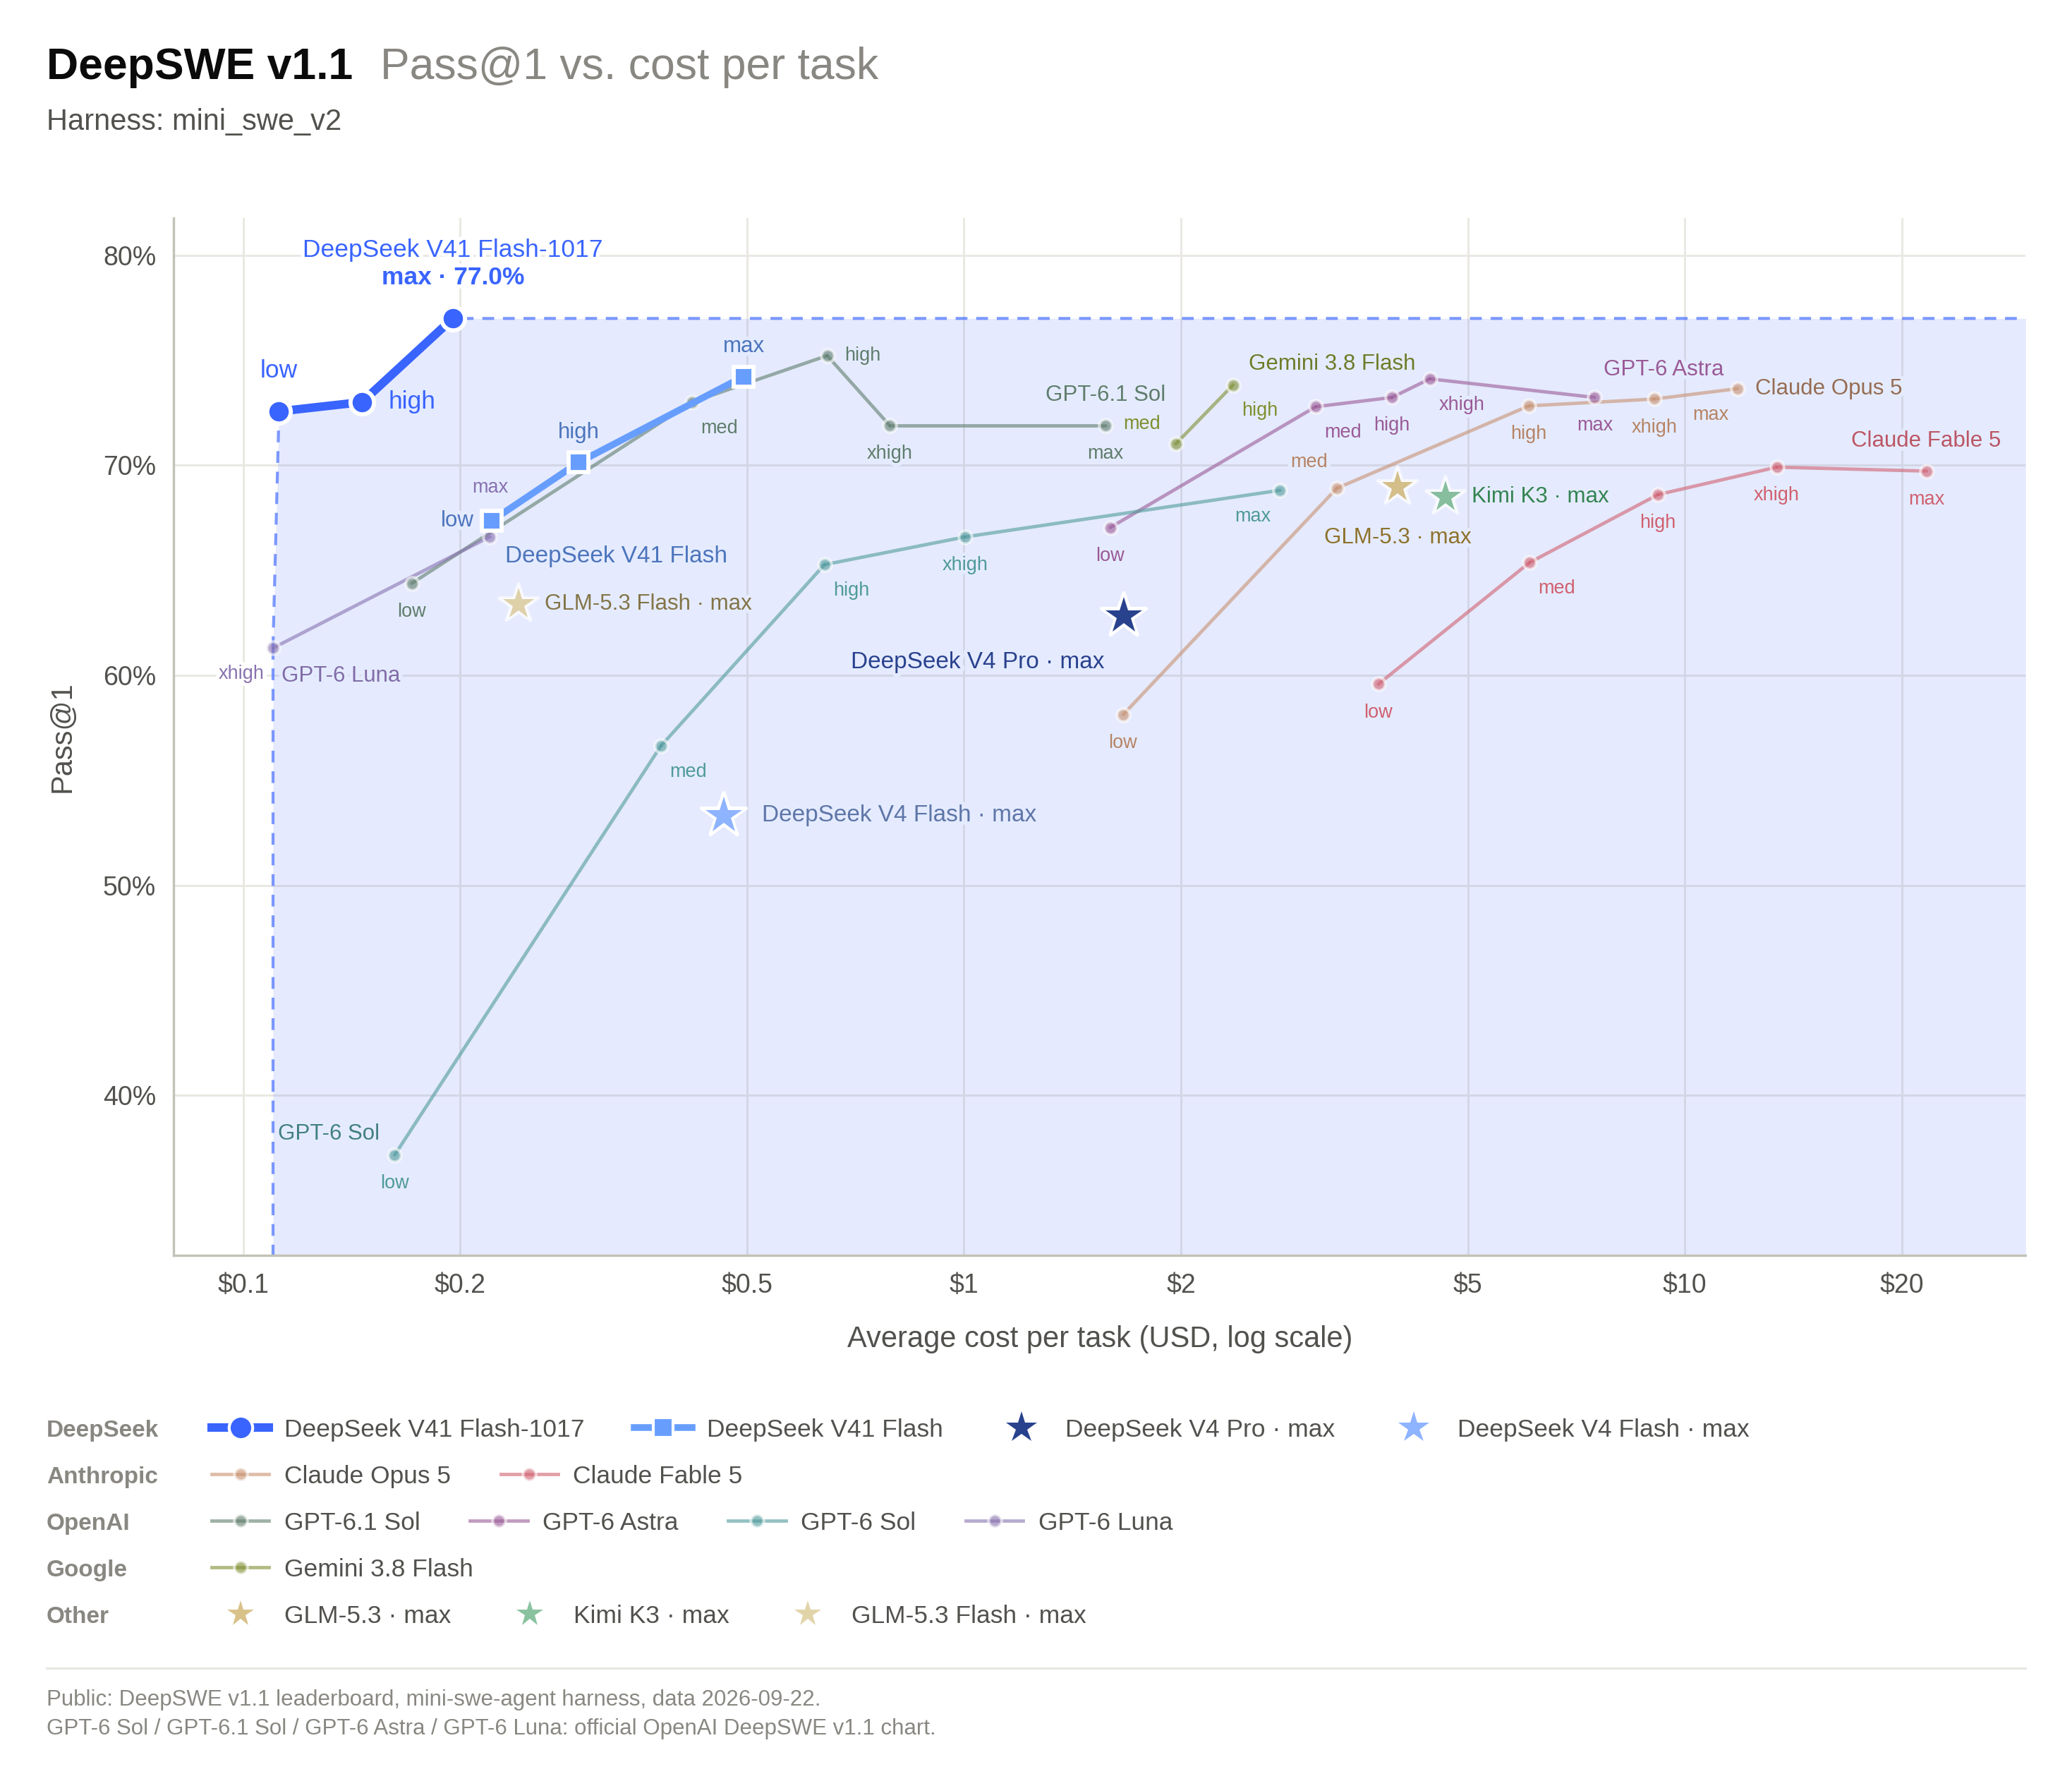
1017版は、ソフトウェア開発の課題解決(DeepSWE v1.1:1017版77.0に対しOpus 5は74.0)やタスク自動化(Automation-Bench v1.0.6:60.5対50.3)においてOpus 5を上回っています。他にも、AIエージェントの性能を測るAgents’ Last ExamやApex Bench v1.1を含め、計4つの評価指標で上位に立ちました。
一方で、残る7つの評価ではOpus 5に届いていません。例えば、コマンド操作(Terminal-Bench 4.0)やプログラミング評価(ProgramBench)、専門的な難問(HLE)では差をつけられています。また、グラフなどの視覚情報を読み解くChartographyやBabyVision、外部ツールを利用する評価(ZeroBench-main)においても、Opus 5のスコアが上回っています。
1017版は旧版から着実に性能を伸ばし、処理速度やコスト効率の面で魅力的な選択肢となりましたが、すべての分野で他モデルを凌駕しているわけではありません。特定のソフトウェア開発や自動化の分野で強みを見せる一方で、高度な専門知識の推論や一部の視覚・ツール利用タスクでは上位モデルに及ばない部分もあります。実務に投入する際は、この特性を踏まえて適した用途を選ぶことが重要です。
どこで使える?チャット・アプリ・APIの始め方
DeepSeek V4.1 Flash 1017の能力を引き出すには、ご自身の目的や技術力に合わせて適切な「窓口」を選ぶことが第一歩です。手軽に試したい方向けの無料サービスから、本格的な開発環境への組み込みまで、主な利用方法を整理します。
コードを書かずに試す方法
プログラミングの知識がなくても、DeepSeekが提供する公式サービスを使えばすぐにモデルの性能を体験できます。Web版チャットとスマートフォン向けアプリはAPIキーの取得が不要です。
まず、最も手軽なのがブラウザからアクセスできるWeb版チャットです。アカウントを作成するだけで、日本語での対話や資料の要約などをすぐに試すことができます。また、スマートフォン向けには公式のAIアシスタントアプリ(iOSおよびAndroid対応)が無料で配信されており、外出先でも利用可能です。
さらに、パソコン内のファイルを直接編集させたり、時間のかかる複雑な作業をバックグラウンドで処理させたい場合には、「DeepSeek Harness」というデスクトップ向けの実行環境(macOSおよびWindows対応)が用意されています。AIモデル単体ではパソコンの操作はできませんが、このHarnessがAIの指示を受け取って実際にコマンドを実行したりファイルを書き換えたりする役割を担います。
他にも、Claude CodeやGitHub Copilotなど対応するAIエージェントツールをすでにお使いの場合、接続先やモデル名、DeepSeekのAPIキーを設定して利用できます。
APIを利用して自社システムに組み込む方法
自社のシステムに組み込んだり、独自の自動化スクリプトを作成したりする場合は、公式のAPIを利用します。無料で利用できるWebチャットやアプリとは異なり、APIは処理したデータ量(トークン数)に応じてあらかじめチャージした残高から費用が引き落とされる従量課金制です。
DeepSeekのAPIはOpenAIやAnthropicの形式と互換性があるため、既存のSDK(ソフトウェア開発キット)を少し書き換えるだけで簡単に接続できます。以下は、PythonのOpenAI SDKを利用してAPIを呼び出す際の基本的な設定例です。
# 事前にpip3 install openaiでSDKをインストールする
import os
from openai import OpenAI

# APIキーは環境変数から読み込み、直接コードに書かない
client = OpenAI(
    api_key=os.environ.get('DEEPSEEK_API_KEY'),
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "あなたは優秀なアシスタントです。"},
        {"role": "user", "content": "こんにちは!"}
    ],
    stream=False,
    reasoning_effort="high",
    extra_body={
        "thinking": {
            "type": "enabled"
        }
    },
)

# 思考プロセス(CoT)の取得
print(response.choices[0].message.reasoning_content)
# 最終的な回答の取得
print(response.choices[0].message.content)
プログラムから呼び出す際に押さえておきたい設定項目は以下の通りです。
1. エンドポイントとモデルの指定 APIの接続先(base_url)には https://api.deepseek.com を指定します。利用するモデル名(model)は deepseek-flash です。現在、この名前を指定すると自動的に最新の1017版が処理を担当します。なお、過去の名称である deepseek-v4-flash などを指定した場合でも1017版へ接続され、同じ料金で処理されます。
2. 認証情報の安全な管理 APIキー(パスワードのようなもの)は、ソースコード内に直接書き込むと情報漏えいの原因になります。上記の例のように、OSの環境変数(DEEPSEEK_API_KEY)などに保存し、プログラムから読み込ませるようにしてください。
3. 思考モード(Thinking Mode)の制御 DeepSeekのモデルは、最終的な回答を出力する前に、内部で論理的な推論(Chain-of-Thought)を行う「思考モード」を備えています。公式のドキュメントによれば、この機能は標準で有効になっており、推論の深さ(reasoning_effort)も標準で「high」に設定されています。 PythonのOpenAI SDKを使う場合は、extra_body という項目を通じて明示的に思考モードを有効化できます。APIからの応答では、モデルが考えた過程が reasoning_content に、最終的な回答が content に分けて格納されるため、それぞれを独立して取得・検証することが可能です。
APIで2回使って分かったこと
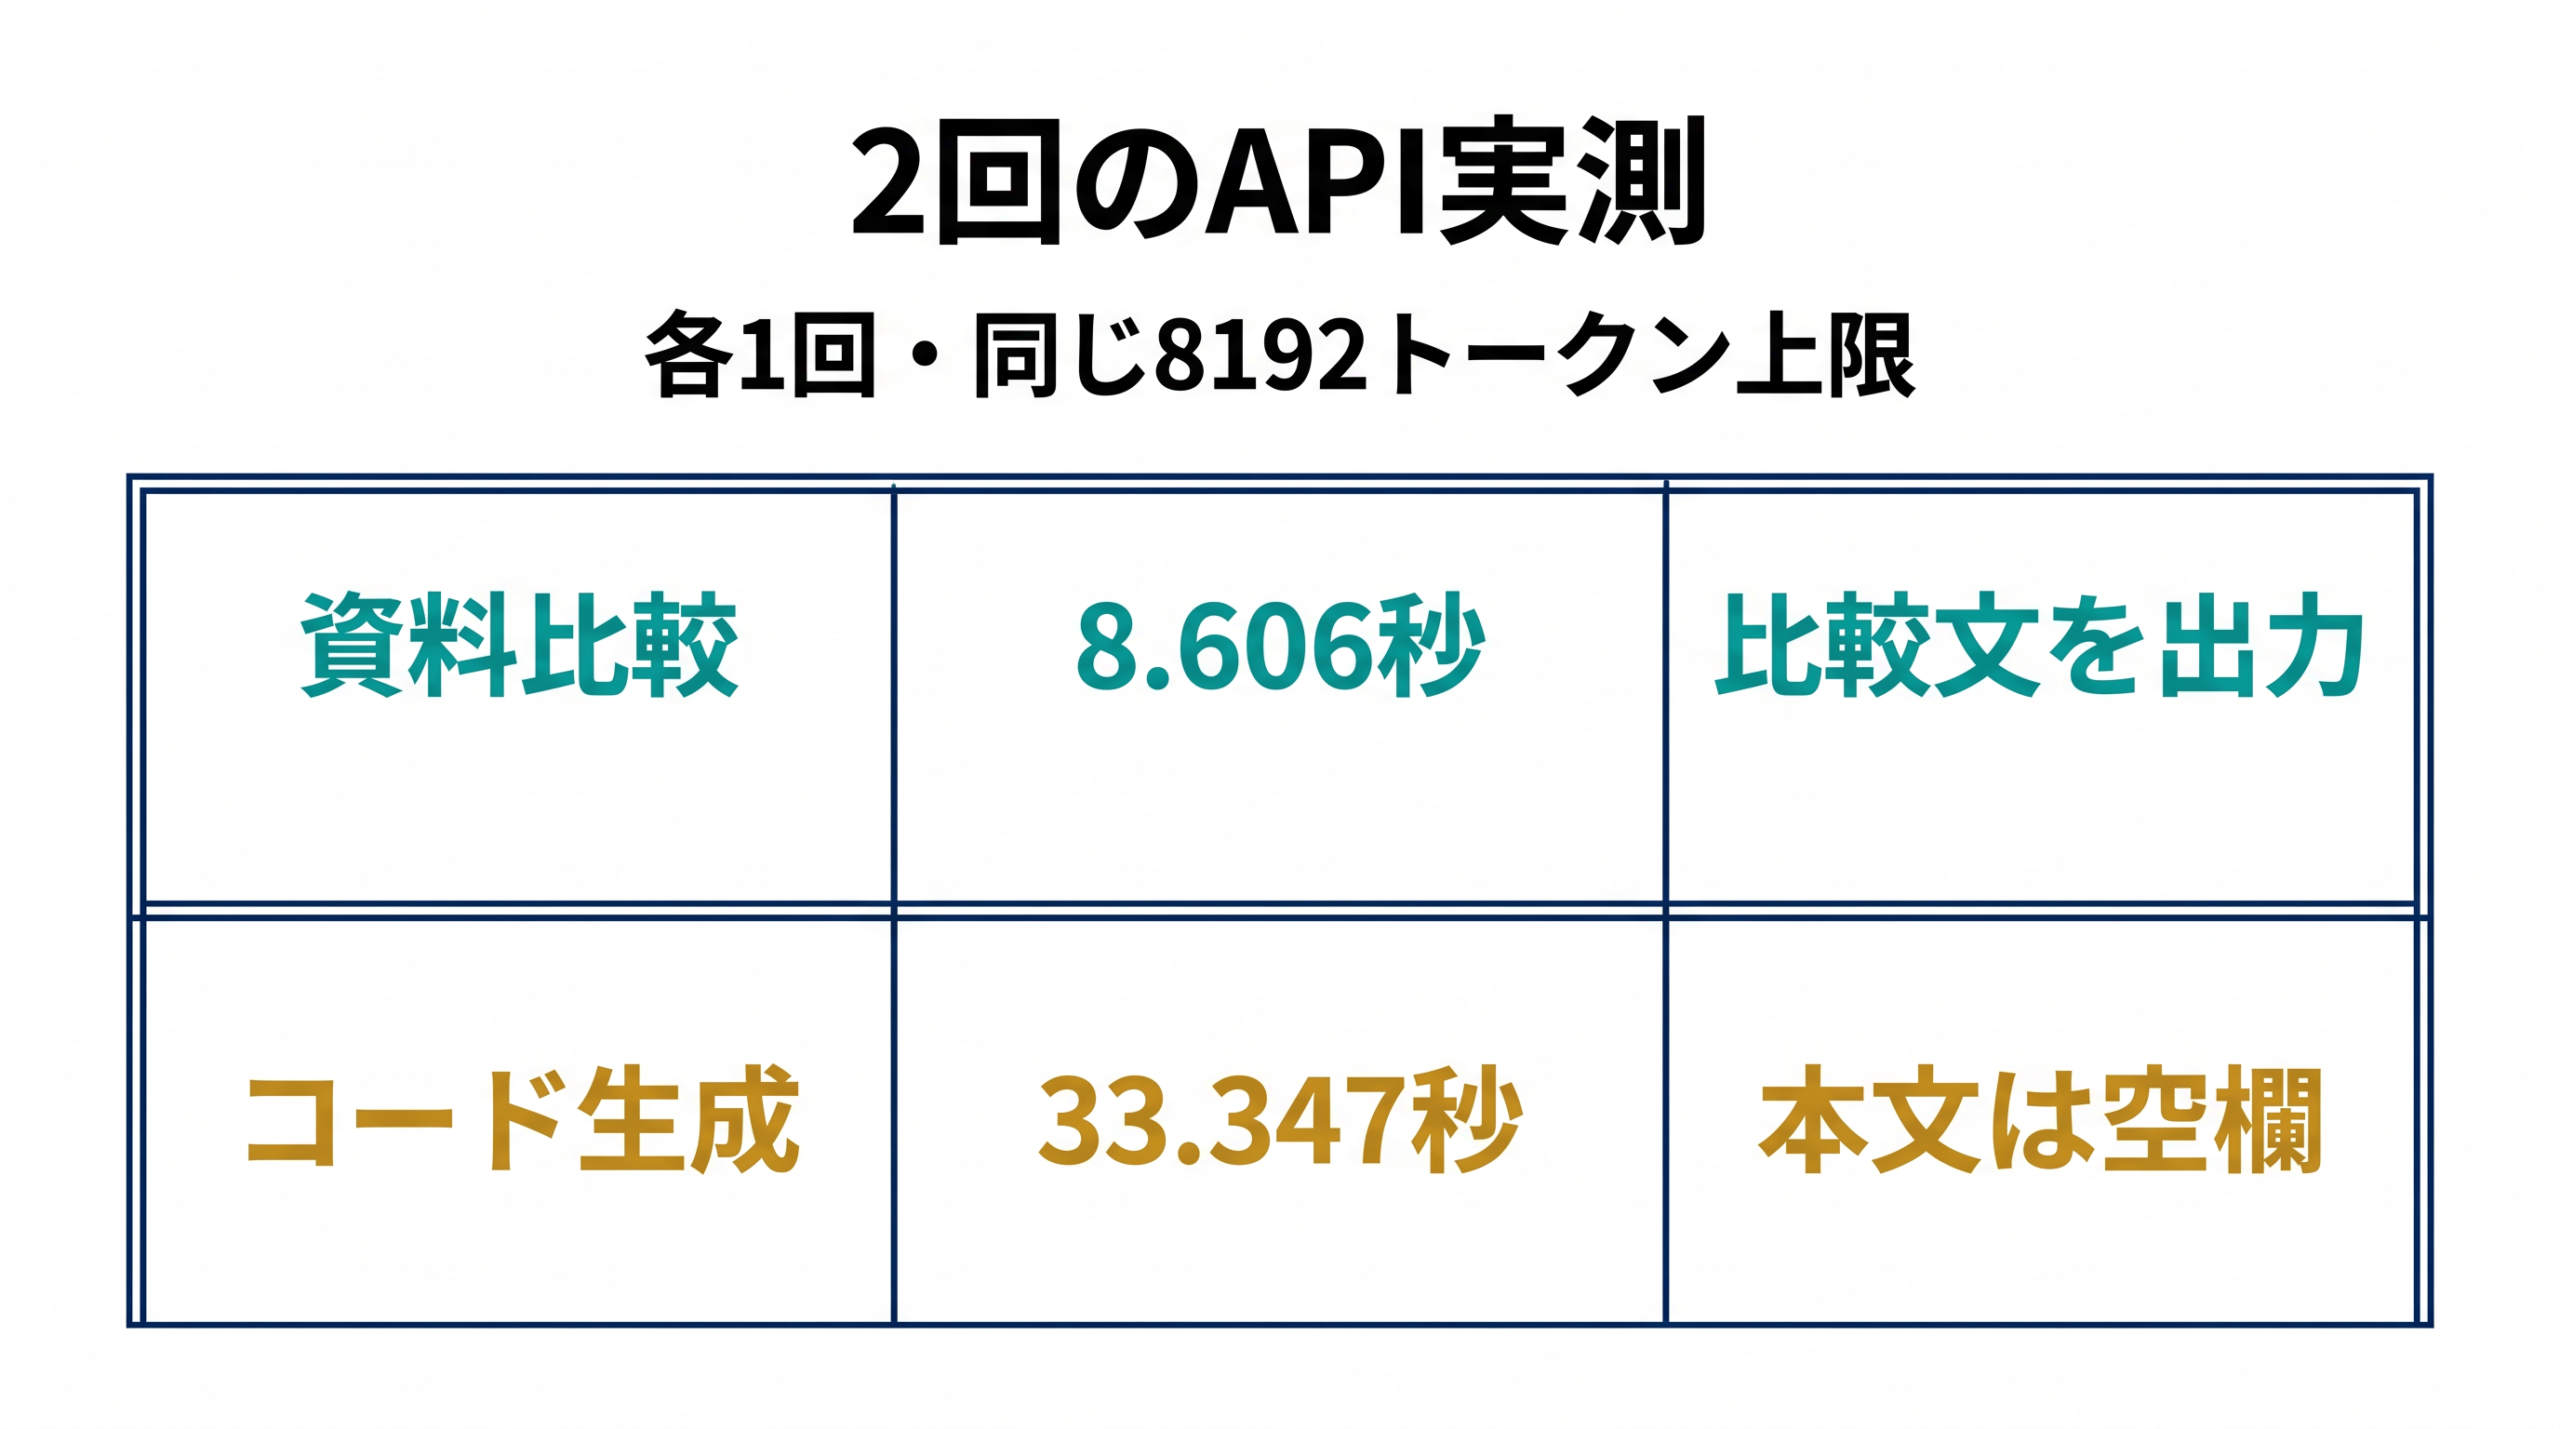
実務での利用を想定し、2026年10月18日にAPIを用いたテキスト生成のテストを2回実施しました。提供した資料に基づく情報整理と、詳細な条件を指定したコード生成の2パターンです。これらの実行結果から、モデルの読み取り精度や、思考モードを利用する際の挙動、そして出力上限の設定に関する具体的な課題が見えてきました。
1回目:提供資料に基づく比較と計算(成功例)
1回目は、Chat Completions APIを利用して固定資料を比較させるテストです。公式の性能表から抜き出した5つの指標と料金表のテキストデータを入力し、日本語で「旧版からの改善幅」「Opus 5との上下関係」「閑散時の費用計算例」を尋ねました。あわせて「全面的に超えたと言えるか」の判断も求めています。
このテストは入力資料のみを使って回答させるものであり、Web検索ツールは与えていません。また、顧客データや社内文書といった機密情報は送信していません。
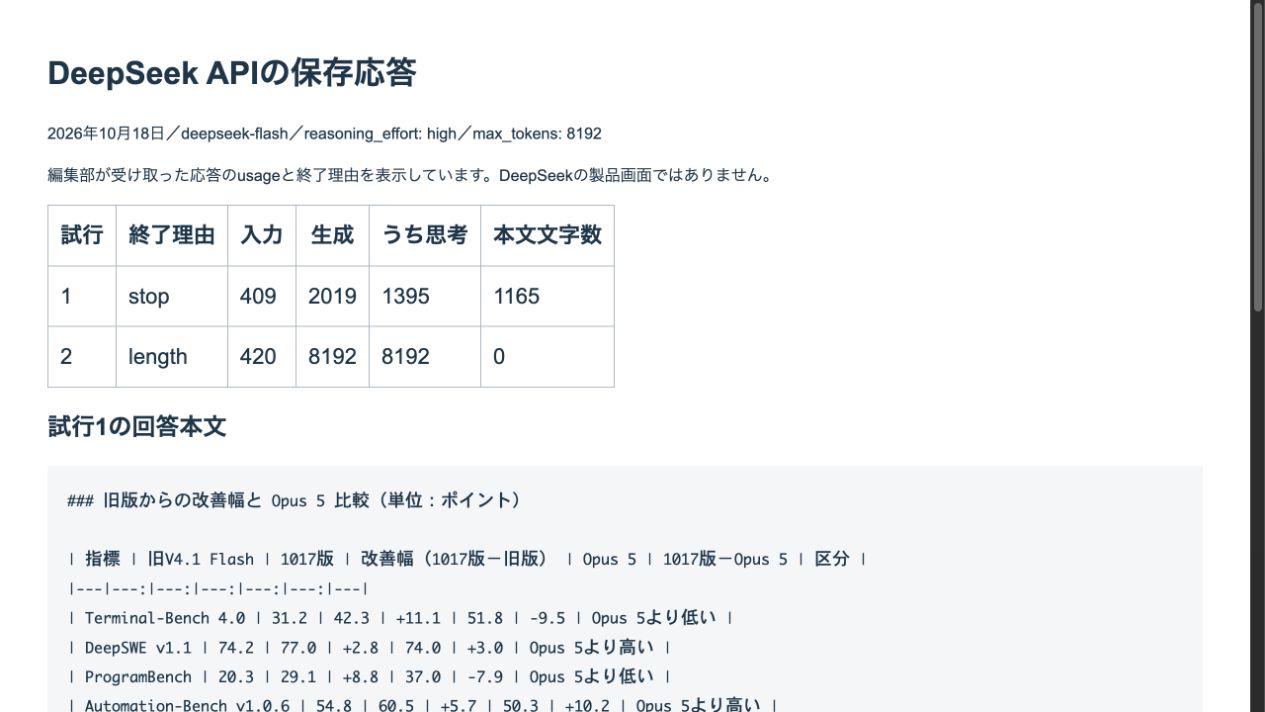
結果は8.606秒で正常に終了(終了理由:stop)し、回答本文が出力されました。消費されたトークン数は入力が409、生成が2019でした。なお、生成された2019トークンのうち、1395トークンはモデルが回答を導き出すための思考プロセスに費やされています。
回答内容を検証すると、5項目の改善幅の数値(11.1、2.8、8.8、5.7、5.8)はすべて一致しました。Opus 5よりスコアが高い分類(DeepSWEとAutomation)と、低い分類(Terminal・ProgramBench・HLE)の抜き出しも正確でした。また、100万入力と10万出力時の閑散時費用計算例も0.21米ドルと正解を導き出し、「全面的に超えたとは言えない」「公式の自己申告である」といった冷静な分析も提示されました。表と理由が明確に読み取れる日本語が出力されています。
一方で、回答の最後に「次に試す仕事」を尋ねた部分については、弱い指標の追加評価という抽象的な提案に留まり、依頼者が現場ですぐに使える具体的な業務例にはなっていませんでした。この結果は、利用者側でプロンプト(入力指示)をより具体的に設計するための材料となります。
今回の利用量(usage)から算出した単価ベースの推定費用は、409×0.15/100万 + 2019×0.60/100万 = 0.00127275米ドルでした(キャッシュヒットは0)。これはAPI利用時の計算に基づく推定額であり、前述の仮定の計算例(0.21米ドル)や実際の請求確定額とは異なります。回答を元の入力と一つずつ照合した結果であり、この数項目の正解をもって日本語能力全般の正解率と見なすことはしません。
2回目:条件を指定したコード生成(上限到達で未出力)
2回目は、Pythonの標準ライブラリだけで動く summarize_csv(text: str) -> dict という関数の生成を依頼しました。
CSVの列構成(company、revenue、currency、period)を提示したうえで、「通貨と期間を分け、Decimal型で金額を加算する」「空欄、N/A、負値、NaN、Infinity、通貨や期間の欠落が含まれる行は無効行として処理する」という仕様を指示しました。同時に11行の検証用CSVテキストを渡し、JSON形式の code キーにコード全文を入れるよう求めています。なお、モデルにファイルの書き込み権限やネットワーク権限は渡していません。
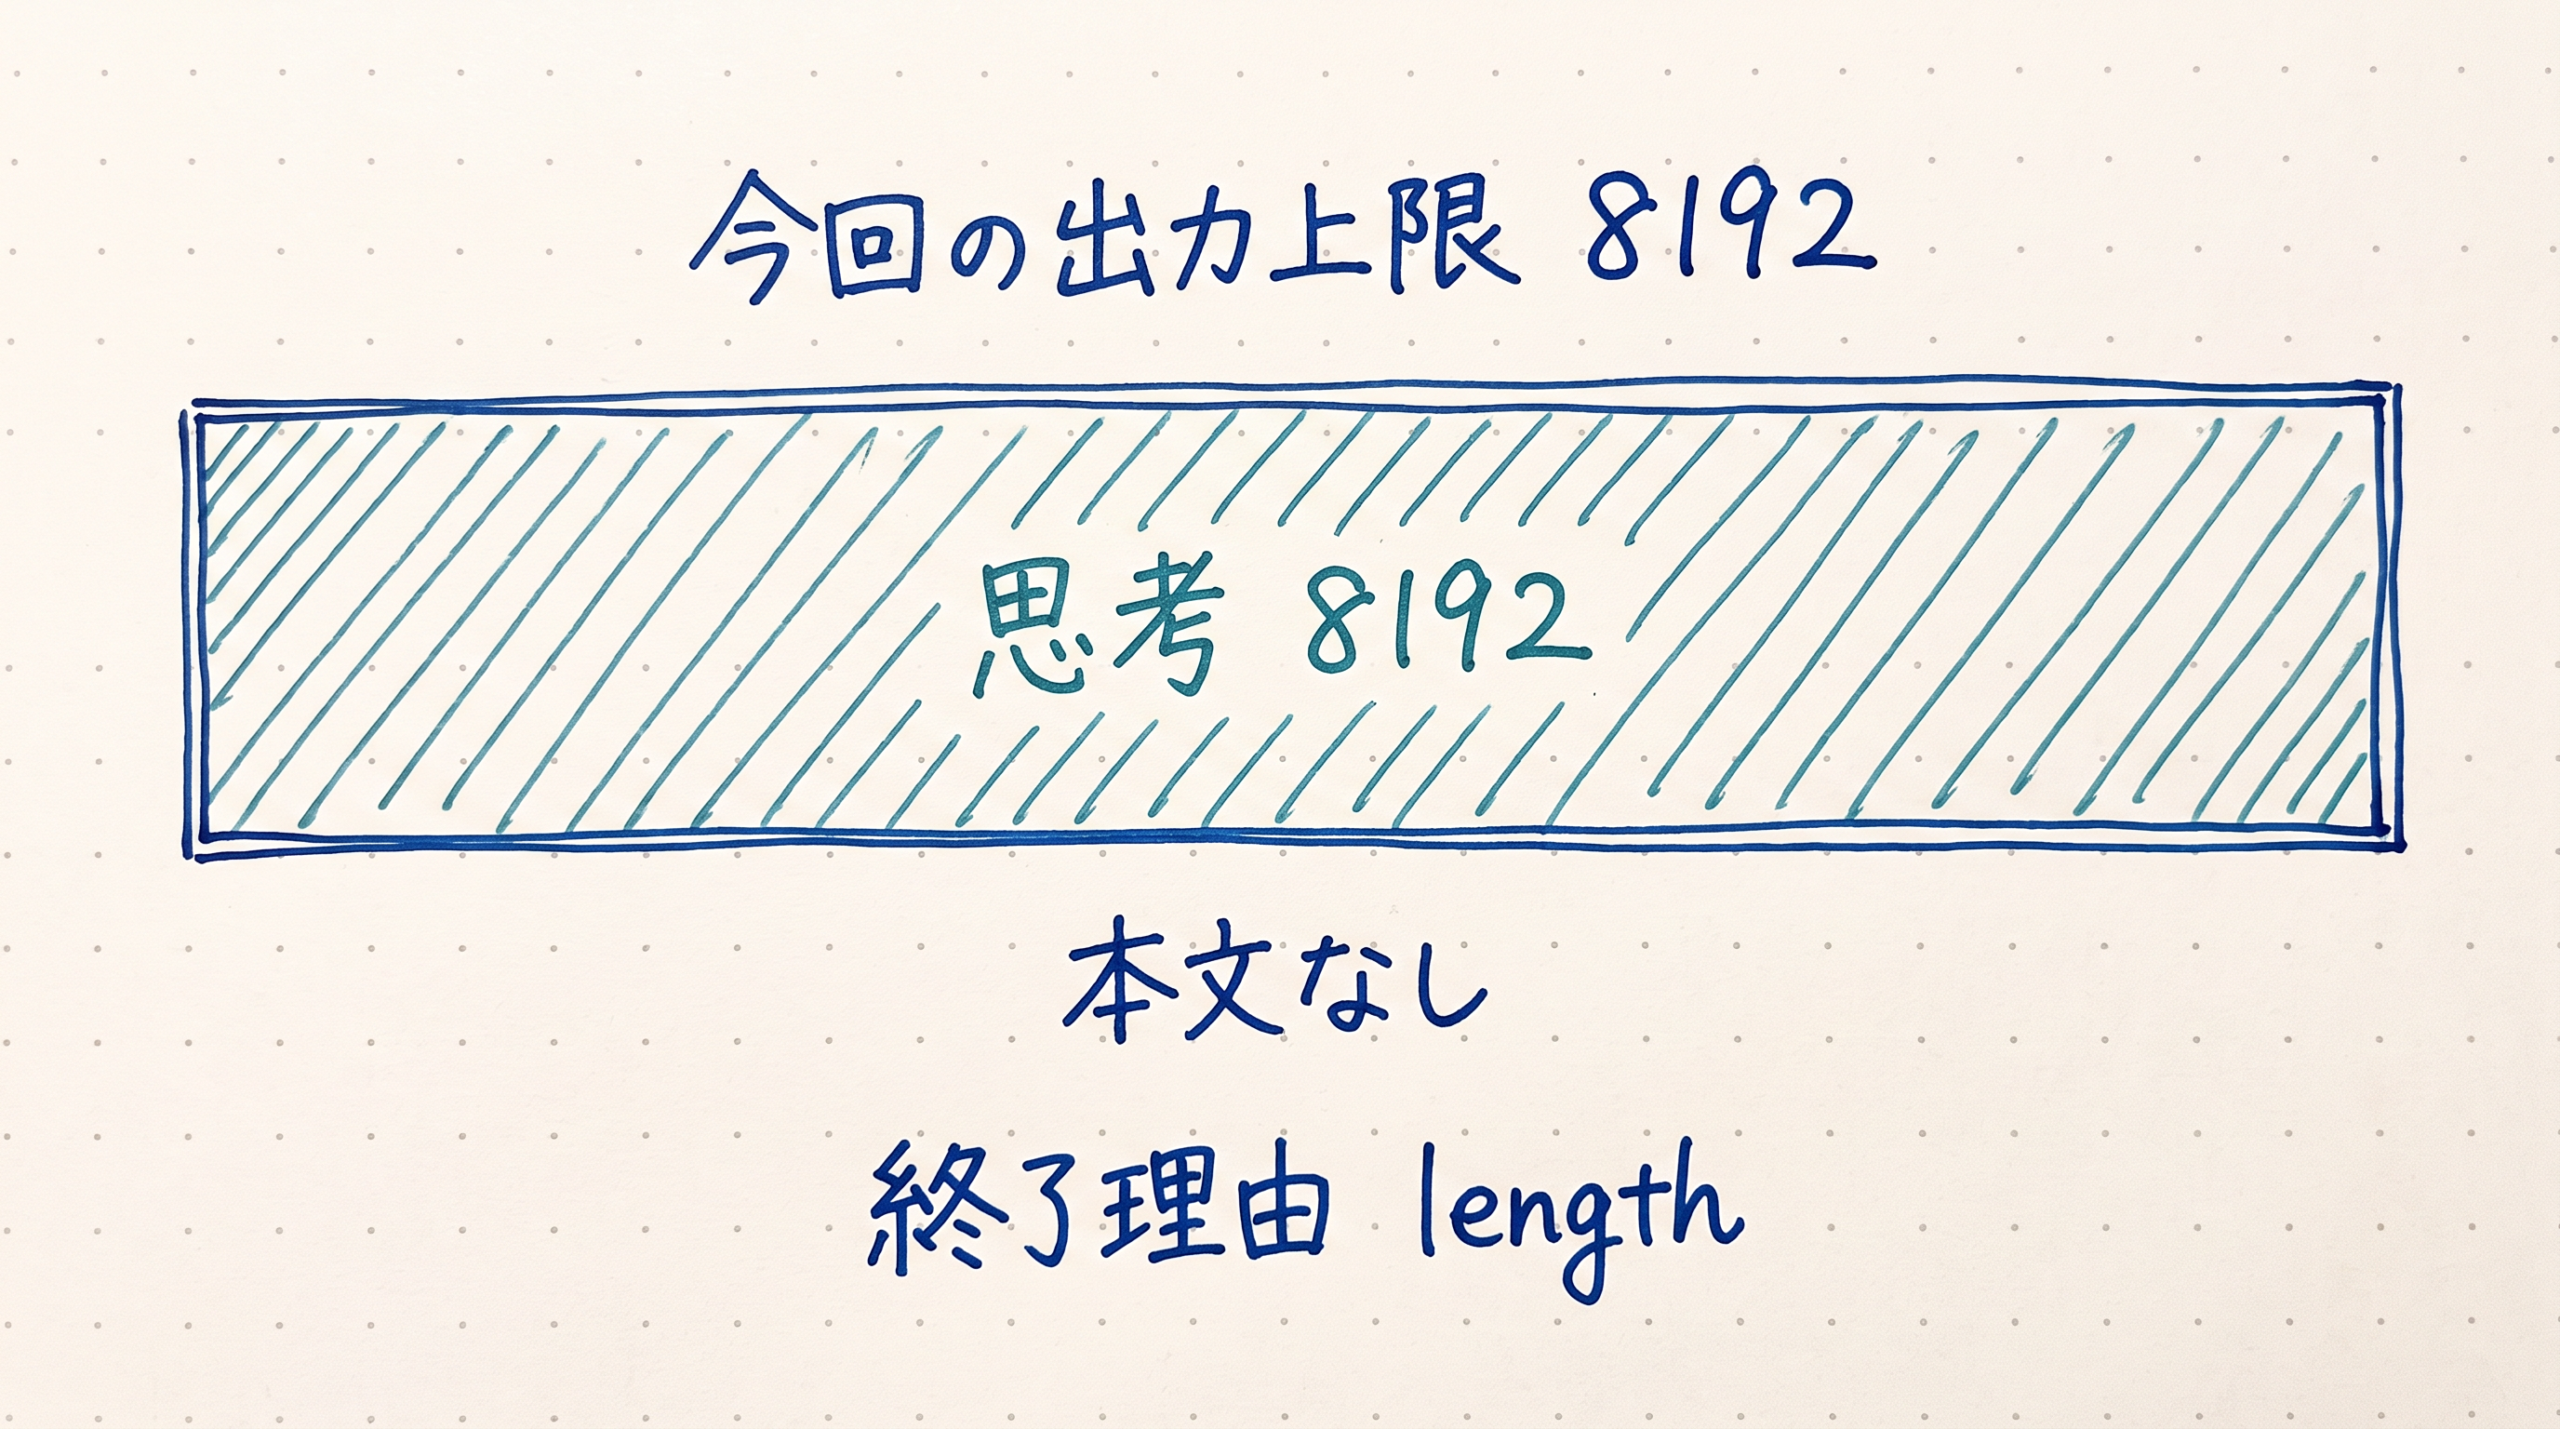
結果は33.347秒で処理が停止しましたが、終了理由はトークン上限への到達(length)でした。入力420トークンに対し、生成された8192トークンすべてが思考プロセスに費やされてしまったのです。そのため、最終的な回答本文(content)は空文字列となり、実行可能なコードは一切出力されませんでした。
入力を先に用意した検証CSVの期待結果(例えば「USD/2026が20」「無効行が5件」など)は人が定めたものであり、今回はモデルからコードが出力されていないため、「CSVが正しく集計できた」「境界値のテストを通過した」とは書けません。
この2回目の単価からの推定費用は、420×0.15/100万 + 8192×0.60/100万 = 0.0049782米ドルです。最終的な成果物が空であっても、APIの仕様に基づき、生成されたトークン分の利用量は報告され、課金の対象となります。
ここから導けるのは、今回の思考の深さ(high)の設定と8192トークンという上限の中では、本文の出力まで到達しなかったという条件付きの事実です。上限を増やしたり、思考の深さ(effort)を変えたりすれば成功したのかは、今回の2回では測定していません。
この実測から得られる運用上の示唆は、単価の安さだけを見るのではなく、「出力が最後まで完成したか」「どのような理由で停止したか」をプログラム側で正しく受け取り、必要に応じて処理を分岐させる運用設計が求められるということです。
料金と日本語の仕事で使う際の注意点
実務でDeepSeek V4.1 Flash 1017を組み込むにあたり、APIの料金体系と、コストや出力精度を踏まえた使いどころの判断が重要になります。
時間帯で変動するAPI料金と費用の試算
APIを利用する際、コストを低く抑えるためには利用時間帯を意識することが効果的です。このAPIは、時間帯によって閑散時と混雑時の料金が変動する仕組みになっています。
日本時間で平日10〜13時と15〜19時は混雑時間(中国の祝日を除く)にあたり、それ以外の平日夜間や早朝、土日と中国の祝日は終日、閑散料金が適用されます。
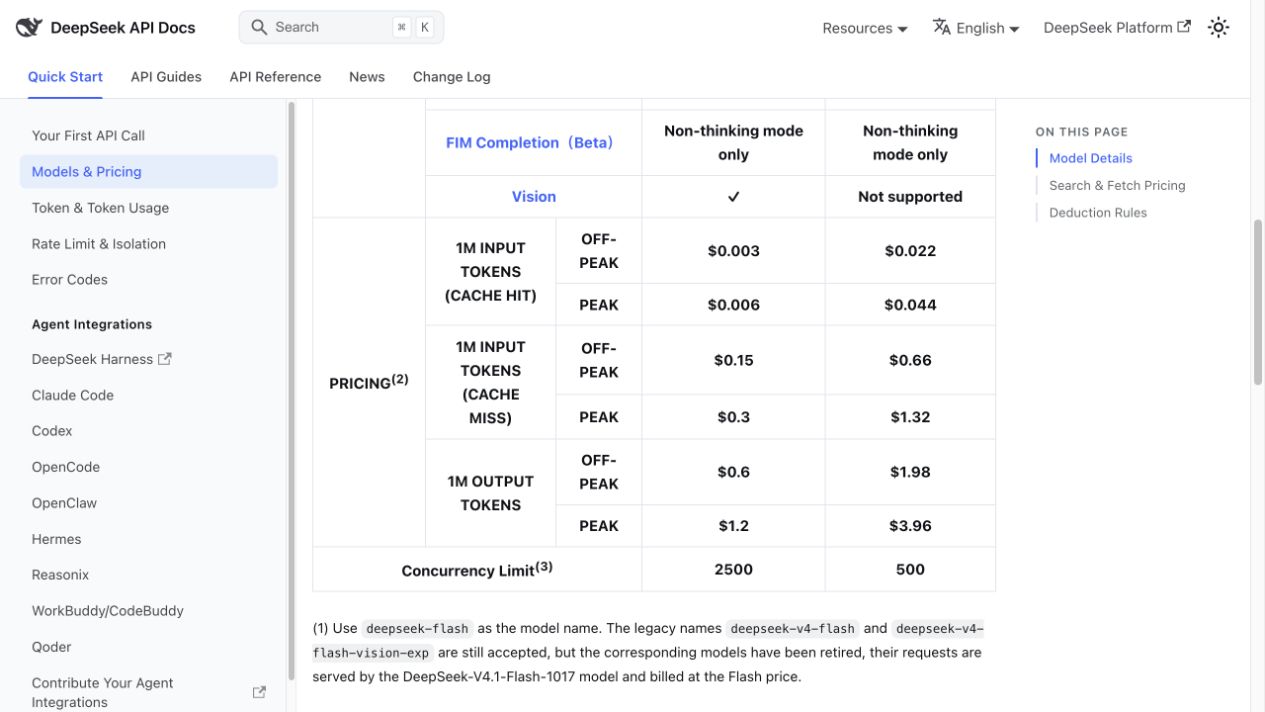
公式料金表によると、閑散時の100万トークン当たりの単価は、入力(キャッシュなし)で0.15米ドル、入力(キャッシュあり)で0.003米ドル、出力で0.60米ドルに設定されています。混雑時はこの単価がそれぞれ2倍(入力0.30米ドル、出力1.20米ドルなど)になります。
たとえば、入力100万トークン(キャッシュなし)と出力10万トークンを閑散時に利用したと仮定すると、入力分0.15ドルと出力分0.06ドルを合わせて0.21米ドルという計算例になります。
なお、ツール呼び出し経由でWeb検索などを行うSearchおよびFetch機能は、モデルのトークン消費とは別のAPIとして課金され、それぞれ1000成功要求あたり0.75米ドルがかかります。DeepSeek Harness・Claude Code・Codexのサーバー側ツール経由でこれらを呼び出す場合の無料期間は日本時間2026年11月1日の午前1時で終了して課金が始まるため、無料期間外の利用費は、実際の検索・取得回数を取得してからモデル料金と合算して計算する必要があります。
なお、本記事で言及している実測の費用はすべて公式単価と応答データの利用実績(usage)から試算したものであり、実際の請求明細と照合した実費ではありません。
思考プロセスによるトークン消費と完了確認
Thinkingガイドに記載されている通り、思考モードは既定で有効になっており、推論の度合い(reasoning_effort)も「high」が標準です。今回の2回の実測テストでもこの標準設定を用いました。
前述の2回目のテストのように生成上限(max_tokens)を8192に設定した場合、モデルが複雑な処理を試みた結果、上限の8192トークンすべてを思考プロセスだけで使い切ってしまうことがあります。この場合、終了理由(finish_reason)は上限到達を示す「length」となり、最終的な成果物である回答本文は空のまま返ってきます。
この現象から分かるのは、通信自体が成功(HTTPステータスコード200)していても、期待した出力が得られているとは限らないということです。自動化スクリプトや開発作業に組み込む際は、単価の安さだけでなく、プログラム側で終了理由が正常な完了(stop)であることと、本文が空欄になっていないことを検査し、未完成の場合にどう処理するかを設計しておくことが不可欠です。
他者の試用報告から考える使いどころ
X(旧Twitter)上での試用報告や実測記事を見ると、DeepSeek V4.1 Flash 1017を日本語の実務にどう組み込むかのヒントが見えてきます。
起業家のけんすう氏は、音声番組(Podcast)の文字起こしから記事を作る作業を20本試した結果を報告しています。同氏の報告によると、1017版を使った費用は1本あたり約3.3円、処理時間は145秒で、意味の誤認が22件、話者の入れ替えが12件発生したとされています。比較対象として挙げられたOpus 5.5は37円・72秒で意味誤認4件・入れ替え0件、Sonnet 5.5は17円・52秒で意味誤認11件・入れ替え4件でした。1017版は圧倒的に安価ですが、処理時間や誤認の数に違いが出ていることがわかります。
ただし、この報告はプロンプトや文字起こしの全文、誤り判定の母数が未公開であるため、22件という数字を「22%の確率で間違える」と読み替えることはできません。追記では、元資料や話者・時刻の条件が整っていても誤りが発生するものの、後段の校正作業で気づけると説明されています。校正作業を追加した最終的な費用や修正率までは示されていませんが、人間の確認を前提とする業務フローに向いていることがうかがえます。

別の初期感想では、短い出力は速い一方で長い出力は遅く、細かな指示や日本語の処理に懸念があるという指摘も見られます。条件が未公開であるためモデル全般の能力評価にはなりませんが、用途によって使い勝手が変わることを示唆しています。なお、この感想内ではデータ構造の定義であるJSON Schemaの厳密な適用(strict)に対する懸念が示されていますが、これはモデルがJSONオブジェクト形式で出力できるかという対応とは別の機能の話であるため、混同しないよう注意が必要です。

より具体的なタスクで比較した記録として、提供事業者自身によるOmniaKeyの実測記事があります。この記事は、数式や構文を解析する算術パーサの30テスト・メール抽出・4並列のツール呼び出し・大規模なログ検索・棒グラフ読解の5課題を1回ずつ試したものです。すでに9月の旧Flash版が利用できないため、直接の新旧比較ではなく上位モデルのV4 Proとの比較となっています。算術パーサでは両モデルとも30テストすべてに正解しましたが、処理時間はV4 Proが20.7分かかったのに対し、1017版は88秒で完了したと記録されています。
また、npaka氏による記事では、AIエージェント実行環境であるHarnessを使って、画像から3D作成ソフトであるBlenderのモデルを作る操作実演が紹介されています。これは操作の道筋を知るには役立つ資料ですが、対照モデルとの反復的な比較ではありません。公開されているデモが動くことと、自分の仕事における成功率は分けて考える必要があります。
人による原文照合を踏まえた実務判断
こうした報告や実測を踏まえると、単純な既知の金額計算なら表計算ソフトで十分であり、AIをあえて使う理由は、資料の条件を保ったまま自然文で比較・説明させたり、短いコードの作成を依頼したりする場面にこそあります。
実務で導入する際は、単価の安さが魅力である反面、思考プロセスにトークンを消費して出力が途中で停止するリスクや、文脈の誤認が生じる可能性を考慮しなければなりません。そのため、少数の試行結果だけで採否を完全に決めるのではなく、「人による原資料との照合」や「出力エラー時の再試行」を前提とした工程に組み込むのが現実的です。
読者自身の業務において、公開資料の比較に使うか、後で人間が修正する下書き候補として割り切るか、そしてAPIの停止理由をどう扱うかをあらかじめ決めることが重要です。期待する結果の基準を先に設け、同じ依頼文と設定を使って他モデルと比較検証するアプローチが、この低コストなモデルを現場で安全に活用するための第一歩となります。
よくある質問
Q1. 1017版をAPIで使うには、どのモデル名を指定すればよいですか?
APIでのモデル名はdeepseek-flashを指定します。旧名称であるdeepseek-v4-flashなどを指定しても自動的に1017版へ接続されるため、9月公開の旧版を意図的に指定して過去のモデルを利用し続けることはできません。
Q2. 画像や動画を生成することはできますか?
いいえ、画像や動画の生成はできません。本モデルは写真やスクリーンショットなどの画像を読み取って内容を説明したり分析したりする視覚理解には対応していますが、出力できるのはテキストのみです。
Q3. APIからの応答で本文が空になってしまうのはなぜですか?
今回のテストでは、APIリクエスト時に設定した出力上限(max_tokens)に達したためです。本モデルは最終的な回答を出す前に内部で推論を行う「思考モード」が標準で有効になっており、複雑な指示では上限枠をすべて思考プロセスだけで使い切ってしまうことがあります。この場合、終了理由(finish_reason)は上限到達を示すlengthとして返却されます。
Q4. APIの利用料金が安くなる閑散時はいつですか?
日本時間で平日の10〜13時および15〜19時の混雑時間帯を除いた時間が閑散時です。平日の早朝や夜間、土日、および中国の祝日は終日閑散料金が適用され、混雑時と比べてトークン単価が半額に設定されています。
Q5. Web検索機能を利用した場合の料金はどうなりますか?
Webページを検索・取得するSearchおよびFetch機能は、モデルの推論とは別のAPIとして計算され、1000回の成功要求につき0.75米ドルがかかります。DeepSeek Harness・Claude Code・Codexのサーバー側ツール経由の無料利用も、日本時間2026年11月1日の午前1時以降は課金対象となるため、モデルのトークン料金とは別に検索回数分の費用が発生します。
社内のAI活用を進めるための相談役をご活用ください
AIを導入したものの、どの仕事から始めるか、何を入力してよいか、誰が運用を担うかで止まっていませんか。Deskrexでは、月額制のAI顧問・相談役として、現場の利用と経営の判断を継続的にご支援しています。

現在のAI利用状況と業務を伺い、入力ルールやセキュリティ、取り組む業務の優先順位、ツールとプランの選定を整理します。まず一つの業務で試し、実際の品質と負担を見ながら次に進む範囲を決めます。
個人だけで使われているAIやSkillsを社内へ広げる方法、推進役の置き方、人とAIの役割分担も相談できます。個別ツールの操作に加え、社内で判断し、使い続ける体制づくりをご支援します。
現在使っているAI、進めたい業務、判断に困っていることをお知らせください。AI顧問・相談役のご案内をご覧ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai