
AIに調べものを頼んだのに、出てきた数字の出典が見つからない。それらしい社名が並んでいるのに、検索しても実在しない。こういう、もっともらしいけれど事実ではない内容をAIが作ってしまう現象を幻覚と呼びます。目の前で起きると、次に考えるのはたいてい「プロンプトの書き方が悪かったのかな」ではないでしょうか。
私も長いことそう思っていました。ところが、AnthropicとOpenAIの公式ドキュメントを読み直してみると、どちらも技法の説明から入っていません。プロンプトをいじる前に決めておくべきことがある、というところから始まっています。日本語で読める解説記事の多くは、ちょうどそこを飛ばして手法の一覧に進みます。
この記事では、プロンプトエンジニアリングという言葉の意味をまず整理して、そのあと調査や分析の仕事で効く順番に並べ直してみます。コピーしてそのまま貼れる日本語のプロンプト断片も置いておきます。
プロンプトエンジニアリングとは、AIへの指示を設計する仕事です

OpenAIの公式ガイドは、この言葉をこう定義しています。
Prompt engineering is the process of writing effective instructions for a model, such that it consistently generates content that meets your requirements.
日本語にすると、モデルに対して効果的な指示を書き、要求を満たす結果が一貫して得られるようにするプロセス、となります(OpenAI Prompt engineering)。
私がこの定義でいちばん大事だと思うのは「一貫して」の部分です。1回だけうまくいくのは、正直なところ運でもできます。同じ書き方で10回頼んで10回とも使える答えが返ってくるかどうか。プロンプトエンジニアリングが問題にしているのはそちらです。
同じページには、こういう注意書きもあります。モデルが生成する内容は非決定的なので(同じ入力でも出力が毎回まったく同じにはならない、という意味です)、望む出力を得るためのプロンプト作成は技術と勘の混ざったものになる、と。この「毎回同じにならない」という性質は、あとで出てくる話とすべてつながっています。
なお、そもそもLLM(大規模言語モデル。大量の文章で学習させた、言葉を予測して生成するAIのこと)とは何かというところから知りたい方は、LLMとは|AIリサーチで使う3層理解と選び方を先に読んでいただくと、この先が読みやすくなると思います。
最低限おさえておきたい用語
プロンプトの話には独特の言葉が出てきます。日本語での標準的な呼び方はPrompt Engineering Guide日本語版がそろえてくれているので、それに合わせて整理します。
| 用語 | 意味 |
|---|---|
| ゼロショットプロンプティング(zero-shot) | 例を1つも見せず、指示だけで解かせるやり方。ふだんチャットに質問を打ち込んでいるのは、だいたいこれです |
| フューショットプロンプティング(few-shot) | 入力と出力の見本をいくつか添えるやり方。マルチショットとも呼ばれます |
| Chain-of-Thought(思考の連鎖) | 答えを出す前に、考えた道筋を順に書かせるやり方 |
| システムプロンプト | 個別の質問の外側に置く、振る舞い全体の前提。「あなたは〇〇の担当者です」のような設定を書く場所です |
| XMLタグ | <instructions>のような山括弧の目印で、プロンプトの中の役割ごとに区切る書き方 |
最近は「プロンプトエンジニアリングはもう古い、これからはコンテキストエンジニアリングだ」という言い方をよく見かけます。呼び名の重心が移っているのは確かで、その中身についてはClaude Opus 5とコンテキストエンジニアリング新ルールで扱っています。ただ、この記事で扱う内容は名前が入れ替わっても残る部分なので、そのまま進めます。
土台になる技法を、公式ドキュメントの言い方で押さえます

AnthropicのPrompting best practicesには、全モデル共通で効く技法がまとまっています。日本語記事でよく見る「コツ」の元ネタにあたる部分です。ここは素直に紹介します。
前提を知らない同僚が読んで動けるか
このページで私がいちばん好きなのは、明確に書くことについての説明です。Claudeのことを、優秀だけれど自分の職場の慣習やワークフローをまだ知らない、新しく入った社員だと思え、と書かれています。そのうえで、こういう基準が示されています。
Golden rule: Show your prompt to a colleague with minimal context on the task and ask them to follow it. If they’d be confused, Claude will be too.
自分のプロンプトを、その仕事の前提をほとんど知らない同僚に見せて、そのとおりに動いてもらう。相手が困るなら、モデルも困る。この基準はそのまま使えます。プロンプトを書き終えたあと、隣の席の人に読ませたらどう見えるかを想像するだけで、抜けている前提がかなり見つかります。
| 技法 | やること | 公式が付けている条件 |
|---|---|---|
| 明確に、直接的に書く | 望む出力の形式と制約を具体的に書く。順序や網羅性が問題になる手順は番号付きで渡す | 前提を知らない同僚が読んで動けるか |
| 理由を添える | なぜその指示が大事なのかという背景も一緒に渡す | 説明があれば、そこから応用してくれる |
| 例を見せる | 入力と出力の見本を添える | 実際の用途に近いこと、例外も含めてばらつかせること、<example>タグで囲むこと。3〜5個が最良 |
| XMLタグで区切る | 指示・文脈・入力を種類ごとにタグで囲む | タグ名は一貫させ、階層があるならネストする |
| 役割を与える | システムプロンプトで立場を設定する | 一文でも差が出る |
長い資料は先頭、質問は末尾に置きます
長い資料を読ませるときの指示も具体的です。目安は2万トークンを超えるあたりから、とされています。トークンというのはAIが文章を処理するときの単位で、日本語なら1トークンがだいたい1文字前後です。2万トークンは、文庫本の数十ページ分くらいだと思ってください。長い文書はプロンプトの先頭に置き、質問や指示はその下に置きます。公式には、質問を末尾に置くとテストで最大30パーセント回答品質が上がることがある、特に複数の文書をまとめて渡すような複雑な入力で、と書かれています。
もうひとつ、してほしくないことを書くよりも、してほしいことを書くほうが効くという指摘もあります。「マークダウンを使うな」ではなく「滑らかに流れる散文の段落で書いてください」と書き換えるわけです。禁止のリストを増やすより、望む状態を1つ描くほうが早いということだと思います。
ここまでが土台です。ただ、この記事の本題はここではありません。
公式ガイドは、この5つより前に「成功基準」を要求しています

Anthropicのプロンプトエンジニアリングの入り口のページを開くと、技法の説明より前に、前提条件が3つ並んでいます。
This guide assumes that you have: A clear definition of the success criteria for your use case / Some ways to empirically test against those criteria / A first draft prompt you want to improve. If not, spend time establishing that first.
このガイドは、あなたが次の3つを持っている前提で書かれています、という宣言です。自分の用途における成功基準がはっきり定義されていること。その基準に対して実際に試して測る手段があること。そして、改善したいプロンプトの第一稿があること。持っていないなら、まずそこに時間を使ってください、と続きます。
私はここを読んだとき、順番を取り違えていたことに気づきました。プロンプトの技法を先に覚えて、それを当てはめて、うまくいかないから技法を足す。ずっとこの回し方をしていたのですが、どうやら公式は逆を言っています。何をもって成功とするかを決めるのが先で、技法はそのあとです。
考えてみると、当たり前の話でもあります。「もっといい感じに書いて」と言われても、何がいい感じなのかを言葉にできていなければ、直しようがありません。人に頼むときも同じです。
「良いプロンプトが書けない」の正体
つまり、良いプロンプトが書けないという悩みの多くは、プロンプトの問題ではなく、自分の中で何を良い出力とするかが決まっていない問題だということになります。書けないのではなく、決まっていない。これは私にとってはけっこう痛い指摘でした。
調べものの仕事に引き寄せると、この「決める」作業は問いを立てる作業とほとんど同じです。何を知りたいのかが定まっていないと、どんな答えなら合格なのかも定まりません。問いの立て方そのものについてはリサーチクエスチョンとは?AI調査で問いを設計する5ステップに書いています。
調査の仕事なら、成功基準は具体的に書けます

成功基準を決めろと言われても抽象的に聞こえますが、AnthropicのDefine success criteriaには、良い基準の条件が4つ挙がっています。
具体的であること。「良い性能」ではなく「正確な感情分類」のように、何を達成したいのかをはっきり書きます。測定できること。定量指標か、一貫して適用できる定性スケールを使います。倫理や安全のような曖昧に見える題材でも定量化できる、という例まで載っています。安全性の悪い基準は「安全な出力」で、良い基準は「1万回の試行のうち、コンテンツフィルタが有害と判定した出力が0.1パーセント未満」だそうです。
残る2つは、達成可能であること、そして関連していることです。達成可能というのは、業界のベンチマークや先行実験、研究、専門知識に基づいて目標を置くという意味で、いまのモデルの能力から見て非現実的な数字を掲げない、と書かれています。関連しているというのは、用途に合っているかどうかです。引用の正確さは医療のアプリでは決定的でも、雑談ボットではそこまで重要ではない、という例が付いています。
調査タスクの合格ラインを5項目で書く
これを調べものの仕事に当てはめると、こんなチェックリストになります。私はこの5項目を、AIに調査を頼む前に自分に対して確認するようにしています。
- 出典が付いているか。主張の1つずつに、たどれるURLか文書名が付いているか
- 原文と一致しているか。引用された文が、出典を開いたときに実際にその形で存在するか
- 見つからなかったものを、見つからなかったと言えているか。空欄を埋めるために作られた記述が混ざっていないか
- 範囲が守られているか。渡した資料の外から持ってきた情報が、断りなく混ざっていないか
- 数字の単位と時点が書かれているか。何年のデータで、単位が何なのかが本文から読み取れるか
これはそのまま採点表になります。10件の調査結果に対して、この5項目を丸かバツで付ければ、プロンプトを変えたときに良くなったのか悪くなったのかがわかります。感覚で「なんとなく良くなった気がする」と判断していたところが、数字になります。
採点はコード・人・AIの3通りから選ぶ
採点のやり方についても、公式は速くて信頼できてスケールする順に選べと言っています。完全一致や文字列一致のようにコードで判定できるものがいちばん速くて確実です。人手による採点はいちばん柔軟で質も高いのですが、遅くて高いので可能なら避けるよう書かれています。AIに採点させる方法は速くて柔軟なので、詳細な採点基準を用意したうえで、正解か不正解かの二択、あるいは1から5までの5段階のように、出力の形を限定して使います。このあたりは、上に挙げた5項目ならほとんどが目視かコードで判定できるので、あまり悩まなくて済みます。
調査用途の本体は、幻覚を減らす7つの手法です

調べものの仕事でいちばん効くのは、ここで挙げる7つです。わからないと言う許可を与える、原文を先に引かせる、裏付けのない主張を撤回させる、この3つが基本で、残る4つが応用にあたります。
一般的な解説記事に載っている技法は、文章を作らせることを前提にした話が多くなっています。役割を与える、具体的に書く、例を見せる。どれも間違っていませんが、事実を扱う仕事では優先順位が違います。事実を扱うなら、本体は冒頭で触れた幻覚を減らす手法群のほうです。
AnthropicのReduce hallucinationsには、基本の3つと応用の4つが載っています。順に見ていきます。
基本の3つ
1つめは、わからないと言う許可を与えることです。公式には、不確かなときは不確かだと認めてよいという許可を明示的に与えよ、と書かれています。そしてこう続きます。この単純な技法で、誤った情報を劇的に減らせる、と。
AIが事実でないことを書いてしまう理由のひとつは、答えなければいけないと思っているからです。空欄を残す選択肢が与えられていなければ、それらしい何かで埋めるしかありません。だから、埋めなくていいと先に言っておきます。そのままコピーして使える形にすると、こうなります。
資料に書かれていない項目は、推測で埋めずに「資料に記載なし」と書いてください。
わからないことをわからないと書くのは、この作業では正しい回答です。
2つめは、原文をそのまま引かせることです。2万トークンを超えるような長い文書を扱うときは、作業に入る前に、一言一句変えない引用を先に抜き出させます。答えを実際の本文に結びつけておくことで幻覚が減る、というのが理由です。
これは私の実感とも合います。要約から入ると、モデルは自分の言葉で書き始めてしまいます。先に原文を引かせておくと、そのあとの記述が引用に引っ張られます。
作業に入る前に、まず該当箇所を原文のまま抜き出してください。
一言一句変えず、要約もせず、段落番号または見出し名を添えてください。
抜き出しが終わってから、分析を始めてください。
3つめは、引用で検証させることです。主張の1つずつに引用と出典を付けさせて、あとから他の人がたどり直せる形にします。ここには続きがあって、出力させたあとに各主張の裏付けとなる引用を探させ、引用が見つからなければその主張は撤回させる、と書かれています。
この「撤回させる」まで含めて指示するのがポイントだと思っています。付けさせるだけだと、それらしい出典を付けて終わることがあります。探させて、なければ引っ込めさせる。
出力したあとで、自分が書いた主張を1つずつ点検してください。
各主張について、渡した資料の中から裏付けとなる引用を探し、
見つかったものには引用文と出典を付けてください。
引用が見つからなかった主張は、削除してその旨を報告してください。
応用の4つ
応用として挙がっているのは、思考の連鎖による検証、Best-of-N検証、反復的な精緻化、そして外部知識の制限です。
思考の連鎖による検証は、最終的な答えを出す前に段階を追って推論を説明させるやり方です。誤った論理や思い込みがそこで表に出ます。Best-of-N検証は、同じプロンプトを複数回走らせて出力を見比べるものです。出力どうしが食い違うなら、それは幻覚の兆候になります。ここは、さきほど触れた「モデルの出力は毎回同じにならない」という性質を逆手に取った使い方で、私はこの発想が面白いと思っています。ぶれるなら、ぶれ幅のほうを測ればいい。
反復的な精緻化は、出力を次のプロンプトの入力にして、検証や拡張をさせるやり方です。そして外部知識の制限は、提供した文書の情報だけを使い、一般知識は使わないよう明示するものです。最後の2つは、そのまま使える形にするとこうなります。
同じ質問を3回、独立して調べてください。
3回の結果を並べて、食い違っている箇所を先に報告してください。
一致している部分と食い違っている部分を分けて示してください。
回答には、渡した資料に書かれている情報だけを使ってください。
あなたが学習で得た一般知識は使わないでください。
資料の中に答えがない場合は、資料の範囲では答えられないと書いてください。公式が付けている但し書き
このページの締めくくりには、こう書かれています。
Remember, while these techniques significantly reduce hallucinations, they don’t eliminate them entirely. Always validate critical information, especially for high-stakes decisions.
これらの技法は幻覚を大きく減らすけれど、完全になくすわけではない。重要な情報は必ず検証すること、特に影響の大きい判断ではそうすること。作っている側がこう書いているという事実は、けっこう重いと思います。
減らせるが消えない。だとすると、どこまでをAIに任せて、どこから人が見るのかという線を、あらかじめ引いておく必要が出てきます。この線の引き方についてはHITLとはAI運用で人間が判断する境界を業務別に決めるにまとめています。プロンプトの工夫と、人が確認する仕組みは、どちらかではなく両方です。
プロンプトで直らないものを見分けます

出力に不満があるとき、原因がプロンプトにあるとは限りません。モデルの選択、渡した資料、そして人が確認する工程。触るべき場所はプロンプト以外にも3つあって、症状を見れば大まかに切り分けられます。
このことは、さきほどの入り口のページにもはっきり書かれています。
Not every success criteria or failing eval is best solved by prompt engineering. For example, you can sometimes improve latency and cost more easily by selecting a different model.
すべての成功基準や、うまくいかなかった評価が、プロンプトエンジニアリングで解決するのが最善というわけではない。たとえば速度やコストは、別のモデルを選ぶほうが簡単に改善できることがある、と。
うまくいかない、イコール、プロンプトが悪い。この等式を作っている側が否定しているわけです。私はこれを読んで、ずいぶん無駄なことをしていたなと思いました。プロンプトを何度書き直しても直らない症状は、そもそもプロンプトの領分ではなかったのかもしれません。
症状ごとに、どこを触ればいいのかを整理すると、こうなります。
| 症状 | まず触るところ |
|---|---|
| 出典のない主張が混ざる | プロンプト。わからないと言う許可と、裏付けのない主張の撤回を指示する |
| 出力の形式が毎回ばらつく | プロンプト。望む形式を書き、例を3〜5個添える |
| 渡した資料の内容を読み落とす | 渡す資料。資料の量と置き場所を見直す。長い文書は先頭に、質問は末尾に |
| 推論が浅く、結論が雑 | モデルと設定。上位のモデルにするか、思考にかける度合いを上げる |
| 遅い、高い | モデル。軽いモデルで足りるか試す |
| 事実確認そのものを任せきりにしている | 運用。人が見る工程を差し込む |
上から3つはプロンプトと資料の話ですが、下の3つはプロンプトを何度書き直しても改善しません。モデルの選択と設定をどう切り替えるかについてはClaude Codeのmodelとeffort|指定が黙って書き換わる3つの場面で扱っているので、そちらもあわせてどうぞ。
モデルが変われば、正解のプロンプトも変わります
もうひとつ、覚えたコツをそのまま使い続けることの弱さを示す例があります。
AnthropicのPrompting Claude Opus 5には、このモデルは言われなくても自分の作業を検証する、と書かれています。そのうえで、プロンプトに明示的な検証指示が入っているなら削除せよ、と続きます。理由は、そういう指示がこのモデルでは過剰な検証を引き起こすからで、削除しても品質は落ちずトークンだけ減る、とのことです。「答えを再確認して」のような指示も同様に避けるよう書かれています。
前のモデルでは効いた指示が、新しいモデルでは逆に働くわけです。同じページには、コードレビューで「重大な問題だけ報告して」と書くと文字どおり受け取って報告が減るので、全部報告させて別の工程で絞るほうがよい、という指摘もあります。
会社が違えば、推奨そのものが食い違うこともあります。長い資料をどこに置くかがわかりやすい例です。Anthropicは長い文書をプロンプトの先頭に置けと書いていますが、OpenAIのガイドは、developerメッセージ(アプリを作る側が書く、利用者の入力より優先される指示のこと)の標準的な構成を、役割の定義、指示、例、文脈の順に並べたうえで、文脈はプロンプトの終盤に置くのが通常は最良だとしています。どちらかが間違っているというより、モデルの作りが違えば効く配置も違う、と読むのが妥当だと思います。
だからOpenAIのガイドは、本番のアプリを特定のモデルのスナップショット(ある時点のモデルを、そのまま凍結して名前を付けたもの)に固定すること、そしてプロンプトの挙動を測るテストと評価の仕組みを作って、更新のたびに性能を監視することを強く勧めています。同じ系列のモデルでも、凍結した時点が違えば結果が変わりうる、とはっきり書かれています。
ここで話が一周します。技法は会社ごと、モデルごとに揺れます。揺れないのは、自分の成功基準と、それを測る手段のほうです。両社の推奨は細部では食い違っていますが、評価を先に作れという点では一致しています。
今後についても、この見立ては変わらない気がしています。モデルが賢くなるほど、細かい言い回しの工夫は効きにくくなります。すでに、強い言い回しで念を押すと過剰に反応するという現象が出ているくらいです。そのぶん残るのは、何を良い出力とするかを決める仕事と、それを測る仕組みを持っているかどうかのほうです。ここは自動化しにくく、その業務を知っている人にしか書けない部分だと思います。
さて、あなたの仕事では、何をもって良い調査結果と言えるでしょうか。そこを一度言葉にしてみると、次に書くプロンプトはずいぶん変わるはずです。
よくある質問

Q1. プロンプトエンジニアリングは、もう不要になりますか?
呼び名の重心は移っていますし、細かい言い回しの工夫が効きにくくなっているのも確かです。ただ、この記事で扱った内容のうち、成功基準を決めること、幻覚を減らす指示を入れること、プロンプト以外の原因を切り分けることは、どれも当面なくなりません。AnthropicとOpenAIの公式ガイドがいまも現役で更新されていることが、そのまま答えになっていると思います。
Q2. エンジニアでなくても使えますか?
使えます。この記事で挙げたプロンプト断片は、どれもチャットの入力欄に貼れる日本語の文です。むしろ成功基準を決める部分は、その業務を知っている人でないと書けません。何をもって良い調査結果とするかは、技術の話ではなく仕事の中身の話です。
Q3. どの技法から手を付ければいいですか?
調べものの仕事なら、わからないと言う許可を与えるところからだと思います。1行足すだけで、埋めるために作られた記述がかなり減ります。そのうえで、原文を先に引かせる指示を足してください。この2つが入るだけで、確認にかかる時間の感覚が変わるはずです。
Q4. プロンプトを直しても改善しないときは、どうすればいいですか?
記事中の切り分け表を見てください。推論が浅い、遅い、高いといった症状は、プロンプトではなくモデルの選択と設定の領分です。渡した資料を読み落とす場合は、資料の量と置き場所を見直します。プロンプトを10回書き直して変わらないなら、触る場所が違う可能性が高いと考えたほうが早いです。
Q5. 幻覚は完全になくせますか?
なくせません。Anthropicの公式ドキュメントが、これらの技法は幻覚を大きく減らすが完全になくすわけではない、重要な情報は必ず検証せよ、と明記しています。だからこそ、どこまでを任せてどこから人が見るのかという線を、運用の設計として先に決めておく必要があります。
Q6. フューショット(few-shot)の例は何個くらい用意すればいいですか?
Anthropicの公式ドキュメントは3〜5個を最良としています。ただし個数より条件のほうが大事で、実際の用途に近いこと、例外も含めてばらついていること、<example>タグで囲んで指示と区別できるようにすること、の3つが挙がっています。似た例を5個並べるより、傾向の違う例を3個置くほうが効きます。
Q7. プロンプトエンジニアという職種は、まだあるのですか?
肩書きとしての募集は落ち着きましたが、仕事の中身がなくなったわけではありません。中身は、AIに任せる範囲を決めて、成功基準を書いて、評価の仕組みを作って、直らない原因を切り分ける仕事のほうに移っています。プロンプトの文面を書く作業だけを指していたころより、範囲はむしろ広がっているというのが私の見方です。
Q8. 社内で使うプロンプトは、どう管理すればいいですか?
OpenAIのガイドは、本番で使うプロンプトをアプリのコード側に置くことを勧めています。そうすればコードレビュー、テスト、通常のデプロイの流れに乗せられるからです。あわせて、同じファミリーの別スナップショットでも結果が変わりうるため、使うモデルのバージョンを固定し、プロンプトの挙動を測るテストを用意して更新のたびに確認するよう書かれています。エンジニアが関わらない環境でも、少なくとも「どのモデルで書いたプロンプトか」と「合格の判定表」をプロンプト本文と一緒に保存しておくと、同じ考え方が使えます。
ここまで挙げた、出典を付けさせる、裏付けの取れない主張は撤回させる、といった指示を毎回書くのは、正直それなりに手間がかかります。私たちDeskrexが開発しているSnorbeは、ナレッジグラフ型のリサーチAIエージェントで、調べた内容を出典付きのまま構造として積み上げていきます。プロンプトを毎回組み立て直すのとは別軸の、新しい選択肢になるはずです。出典を辿れる形で調査結果を残したい方は、lp.deskrex.aiをのぞいてみてください。
生成AIの実務活用を研修でご支援します
Deskrexでは、社内で使っているAIツールや実際の業務に合わせた研修を提供しています。ChatGPT、Claude、Geminiなどの操作を学ぶことから、情報収集・分析・企画・文書作成といった仕事で使えるようになることまで、AI活用の定着をご支援します。
研修の前に、利用できるAIツール、現在の業務フロー、困っている作業を一緒に整理します。その内容をもとに、経営層・管理職・実務担当者それぞれに合うプログラムを組み立て、普段の仕事に近い題材で手を動かしながら学びます。
機能を試すハンズオン、仕組みの解説、自社の課題で試すハンズオンを組み合わせ、学んだ操作を実務へつなげます。研修後も活用状況を確認し、業務で使い続けるための改善やフォローアップをご支援します。
研修のご相談は、AI研修サービスのご案内からお問い合わせください。社内のAI活用状況や、研修で取り組みたい仕事を伺う棚卸し相談会も受け付けています。
調査手法について
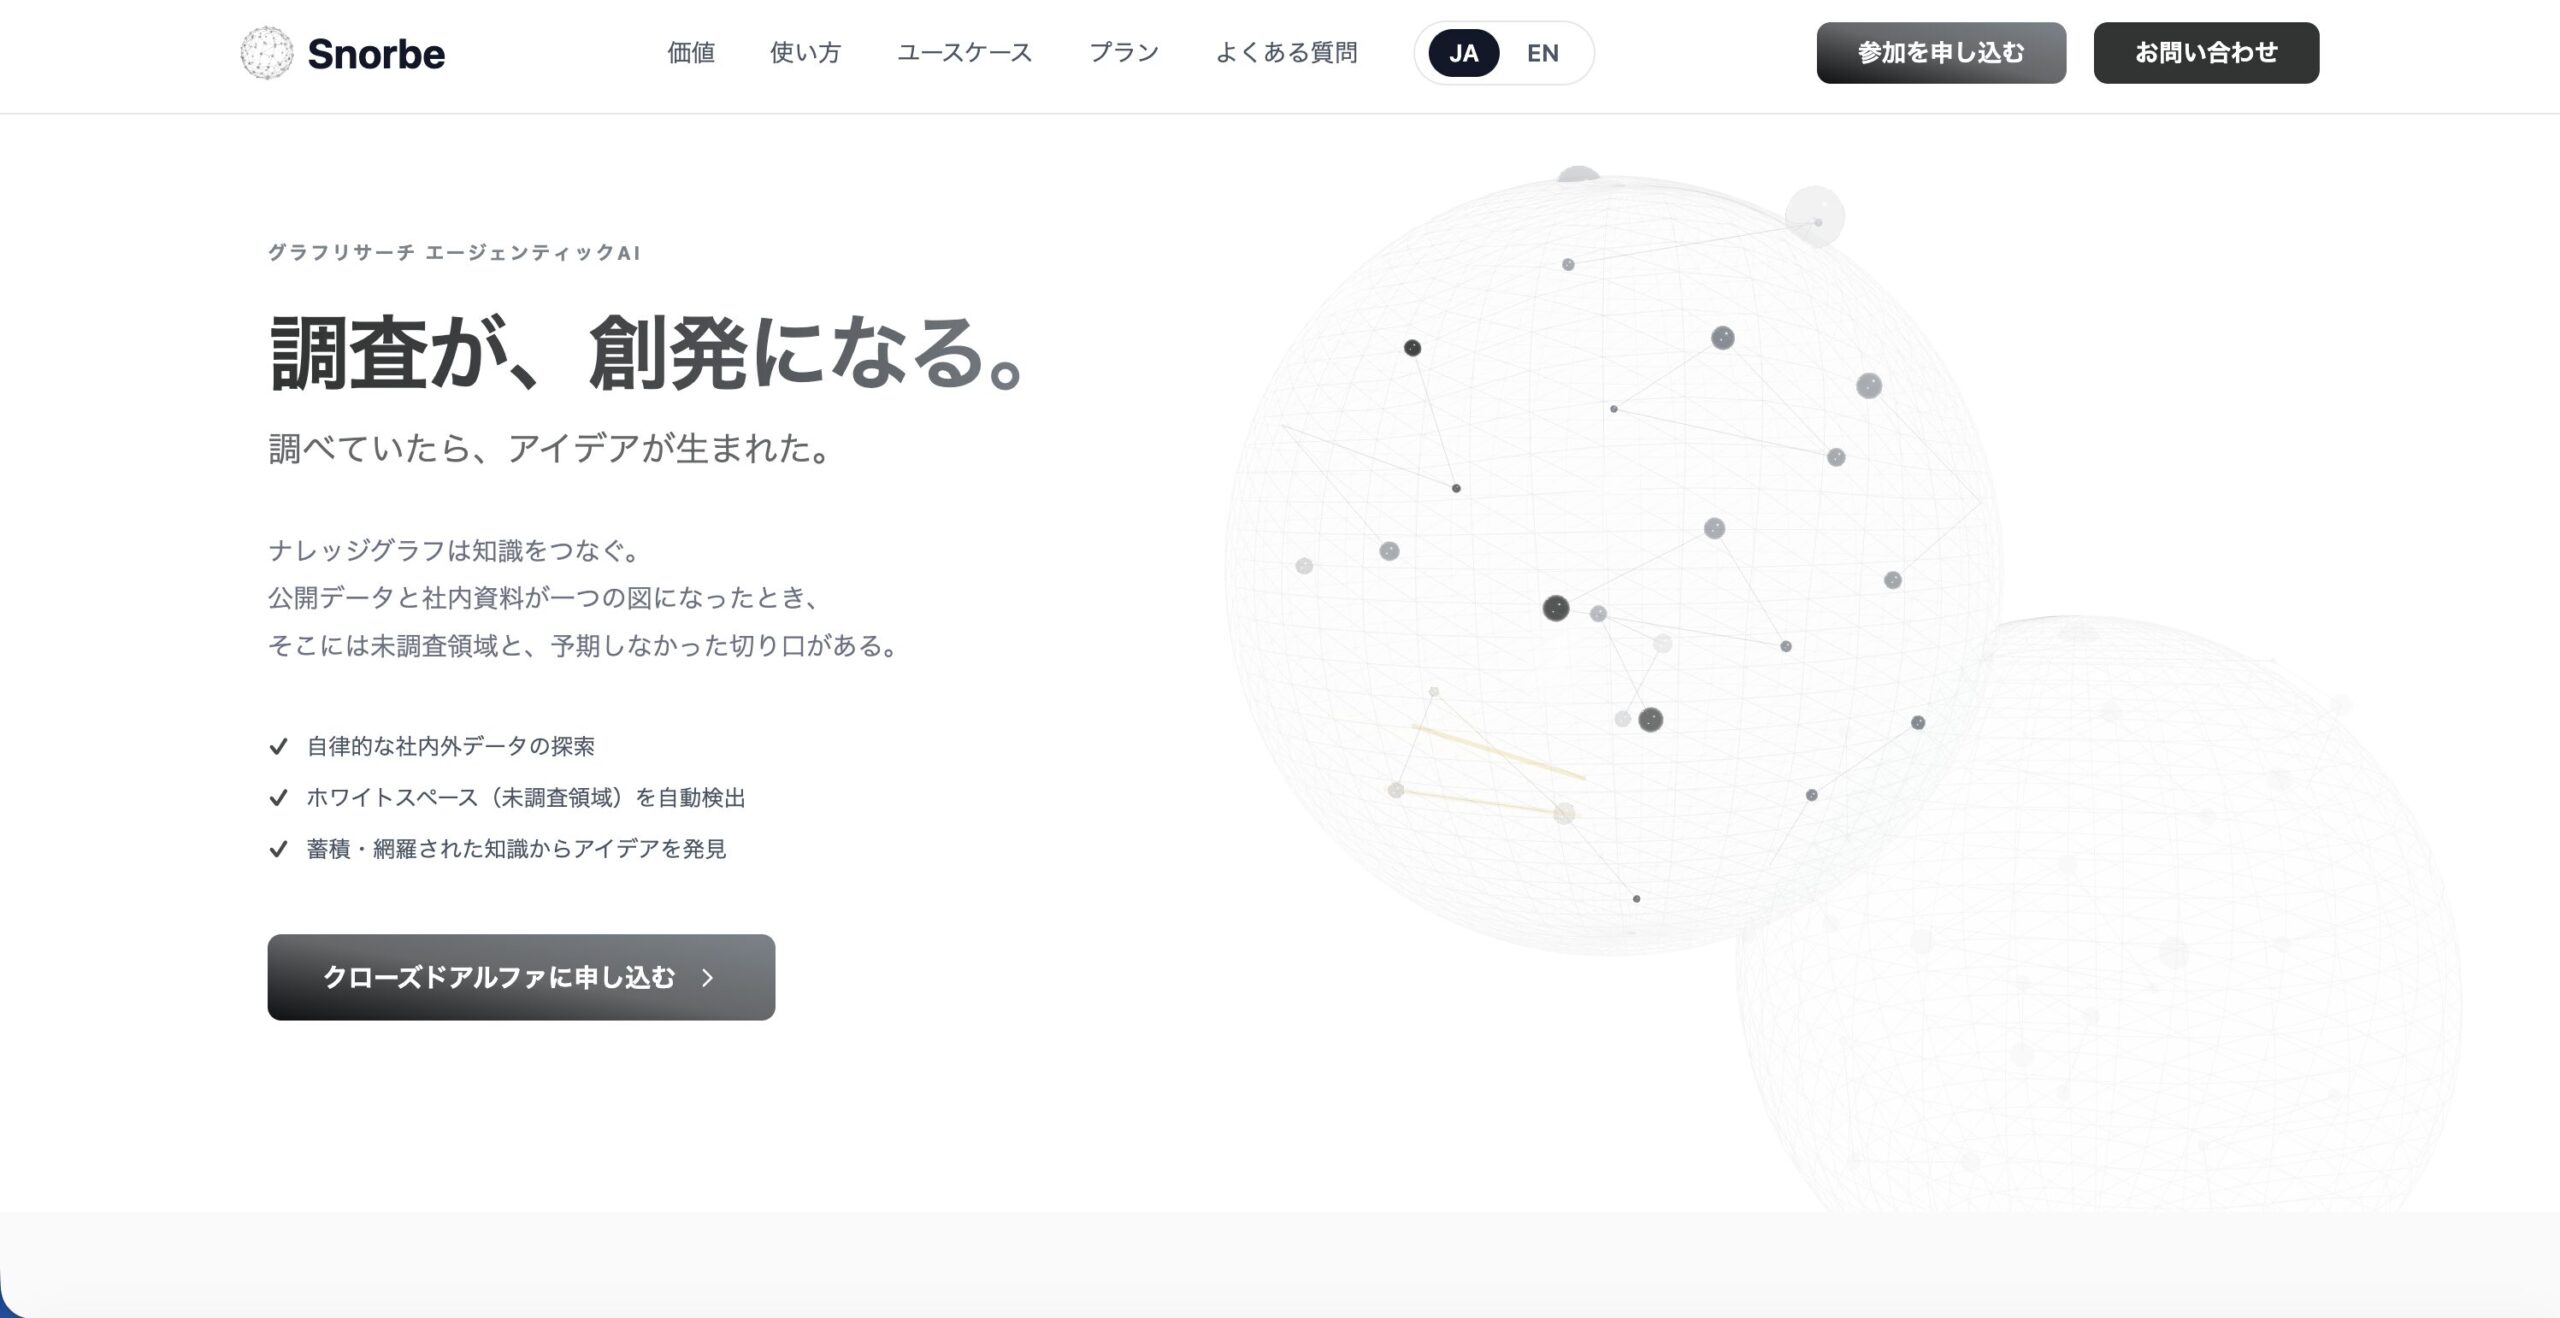
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai


コメント