Anthropicが2026年9月1日に公開したClaude Fable 5.1は、大量のデータ入力と推論を要するタスクに向けたAIモデルです。
短い質問に1回答を返す操作だけでは、長時間実行やキャッシュ再利用という特徴を検証できません。コードや資料を入力し、モデルが成果物を作る過程で人が確認と修正を重ねる仕事に使うと、従来モデルとの性能と実効コストの差を測れます。
この記事では、自身の業務環境に合わせてどこからFable 5.1を使い始めるかを整理します。ブラウザを通じた対話、開発者向けのClaude Code、システムに組み込むAPIという入口と対象プランを解説します。
入力データを繰り返し使う場合は、キャッシュ機能の有無で費用が変わります。本文では、入力側の費用を具体的に計算し、別に発生する出力料金との境界も示します。
公開事例からは、長時間のコーディングや資料制作で、利用者が何を入力し、モデルが何を出力し、人がどう確認したかを読み解きます。
同じAPI基本単価を持つGPT-6 Astraとの比較軸も示します。最終判断には、自身のデータと操作を用いた受入テストを使います。
Claude Fable 5.1とは何か
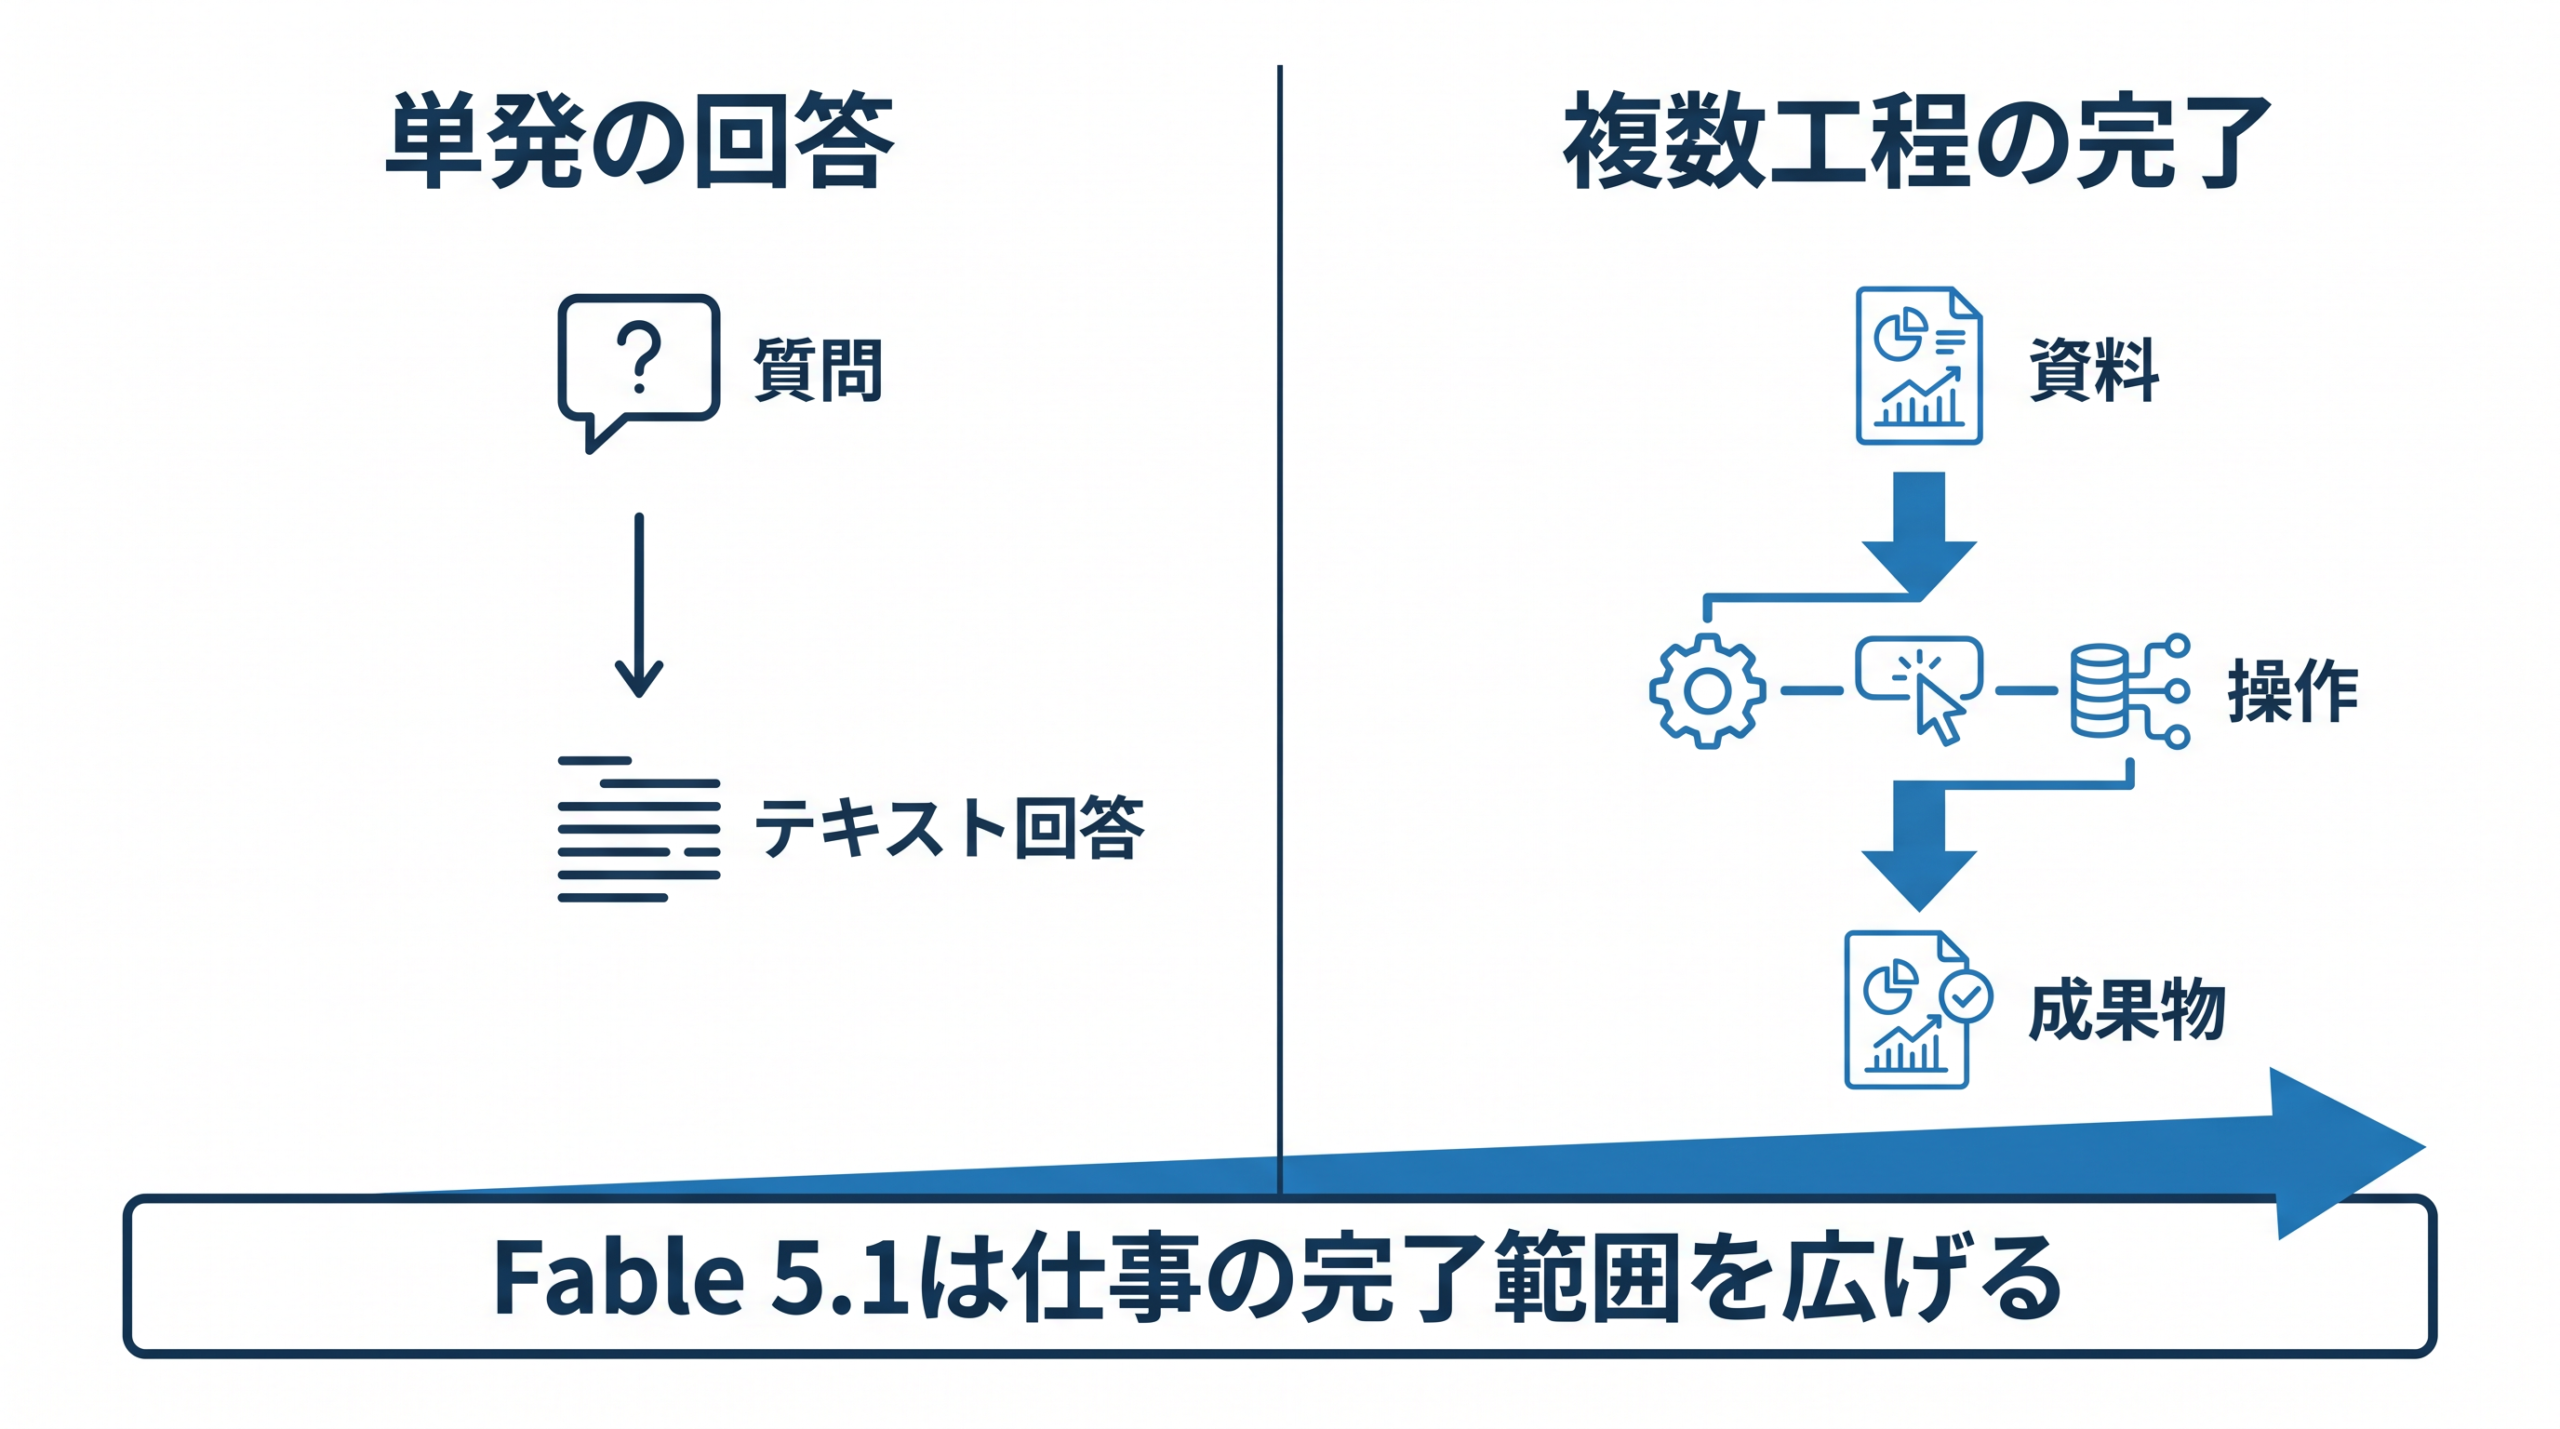
Claude Fable 5.1は、Anthropicが2026年9月1日に公開したAIモデルです。100万トークンの入力枠と長時間実行を主な特徴とし、文章、データ、コードを基に成果物を作ります。
FableとMythosの関係
Anthropicの発表によると、Fable 5.1と同時に公開されたMythos 5.1はベースとなる同一のモデルです。両者の違いはセーフガードの設定とアクセス資格にあります。
FableはPro、Max、Team、Enterpriseの各プランとAPIで提供されます。一方、Mythosは審査を通った利用者に限って提供されます。審査基準の詳細は公開ページに示されていないため、一般利用ではFableを選びます。
基本仕様
APIドキュメントに記載されているFable 5.1の基本仕様は以下の通りです。
- 入力可能なコンテキストウィンドウ: 100万トークン
- 最大出力: 12万8000トークン
- 推論機能: Adaptive thinkingが常時有効
100万トークンのコンテキスト枠には、システム指示、会話履歴、入力資料、生成中の出力が含まれます。最大出力は12万8000トークンです。
入力内容に応じて推論量を調整するAdaptive thinkingは常に動作します。APIのmodel IDはclaude-fable-5-1、知識カットオフは2026年6月です。
Claude・Cowork・Claude Code・APIで使い始める
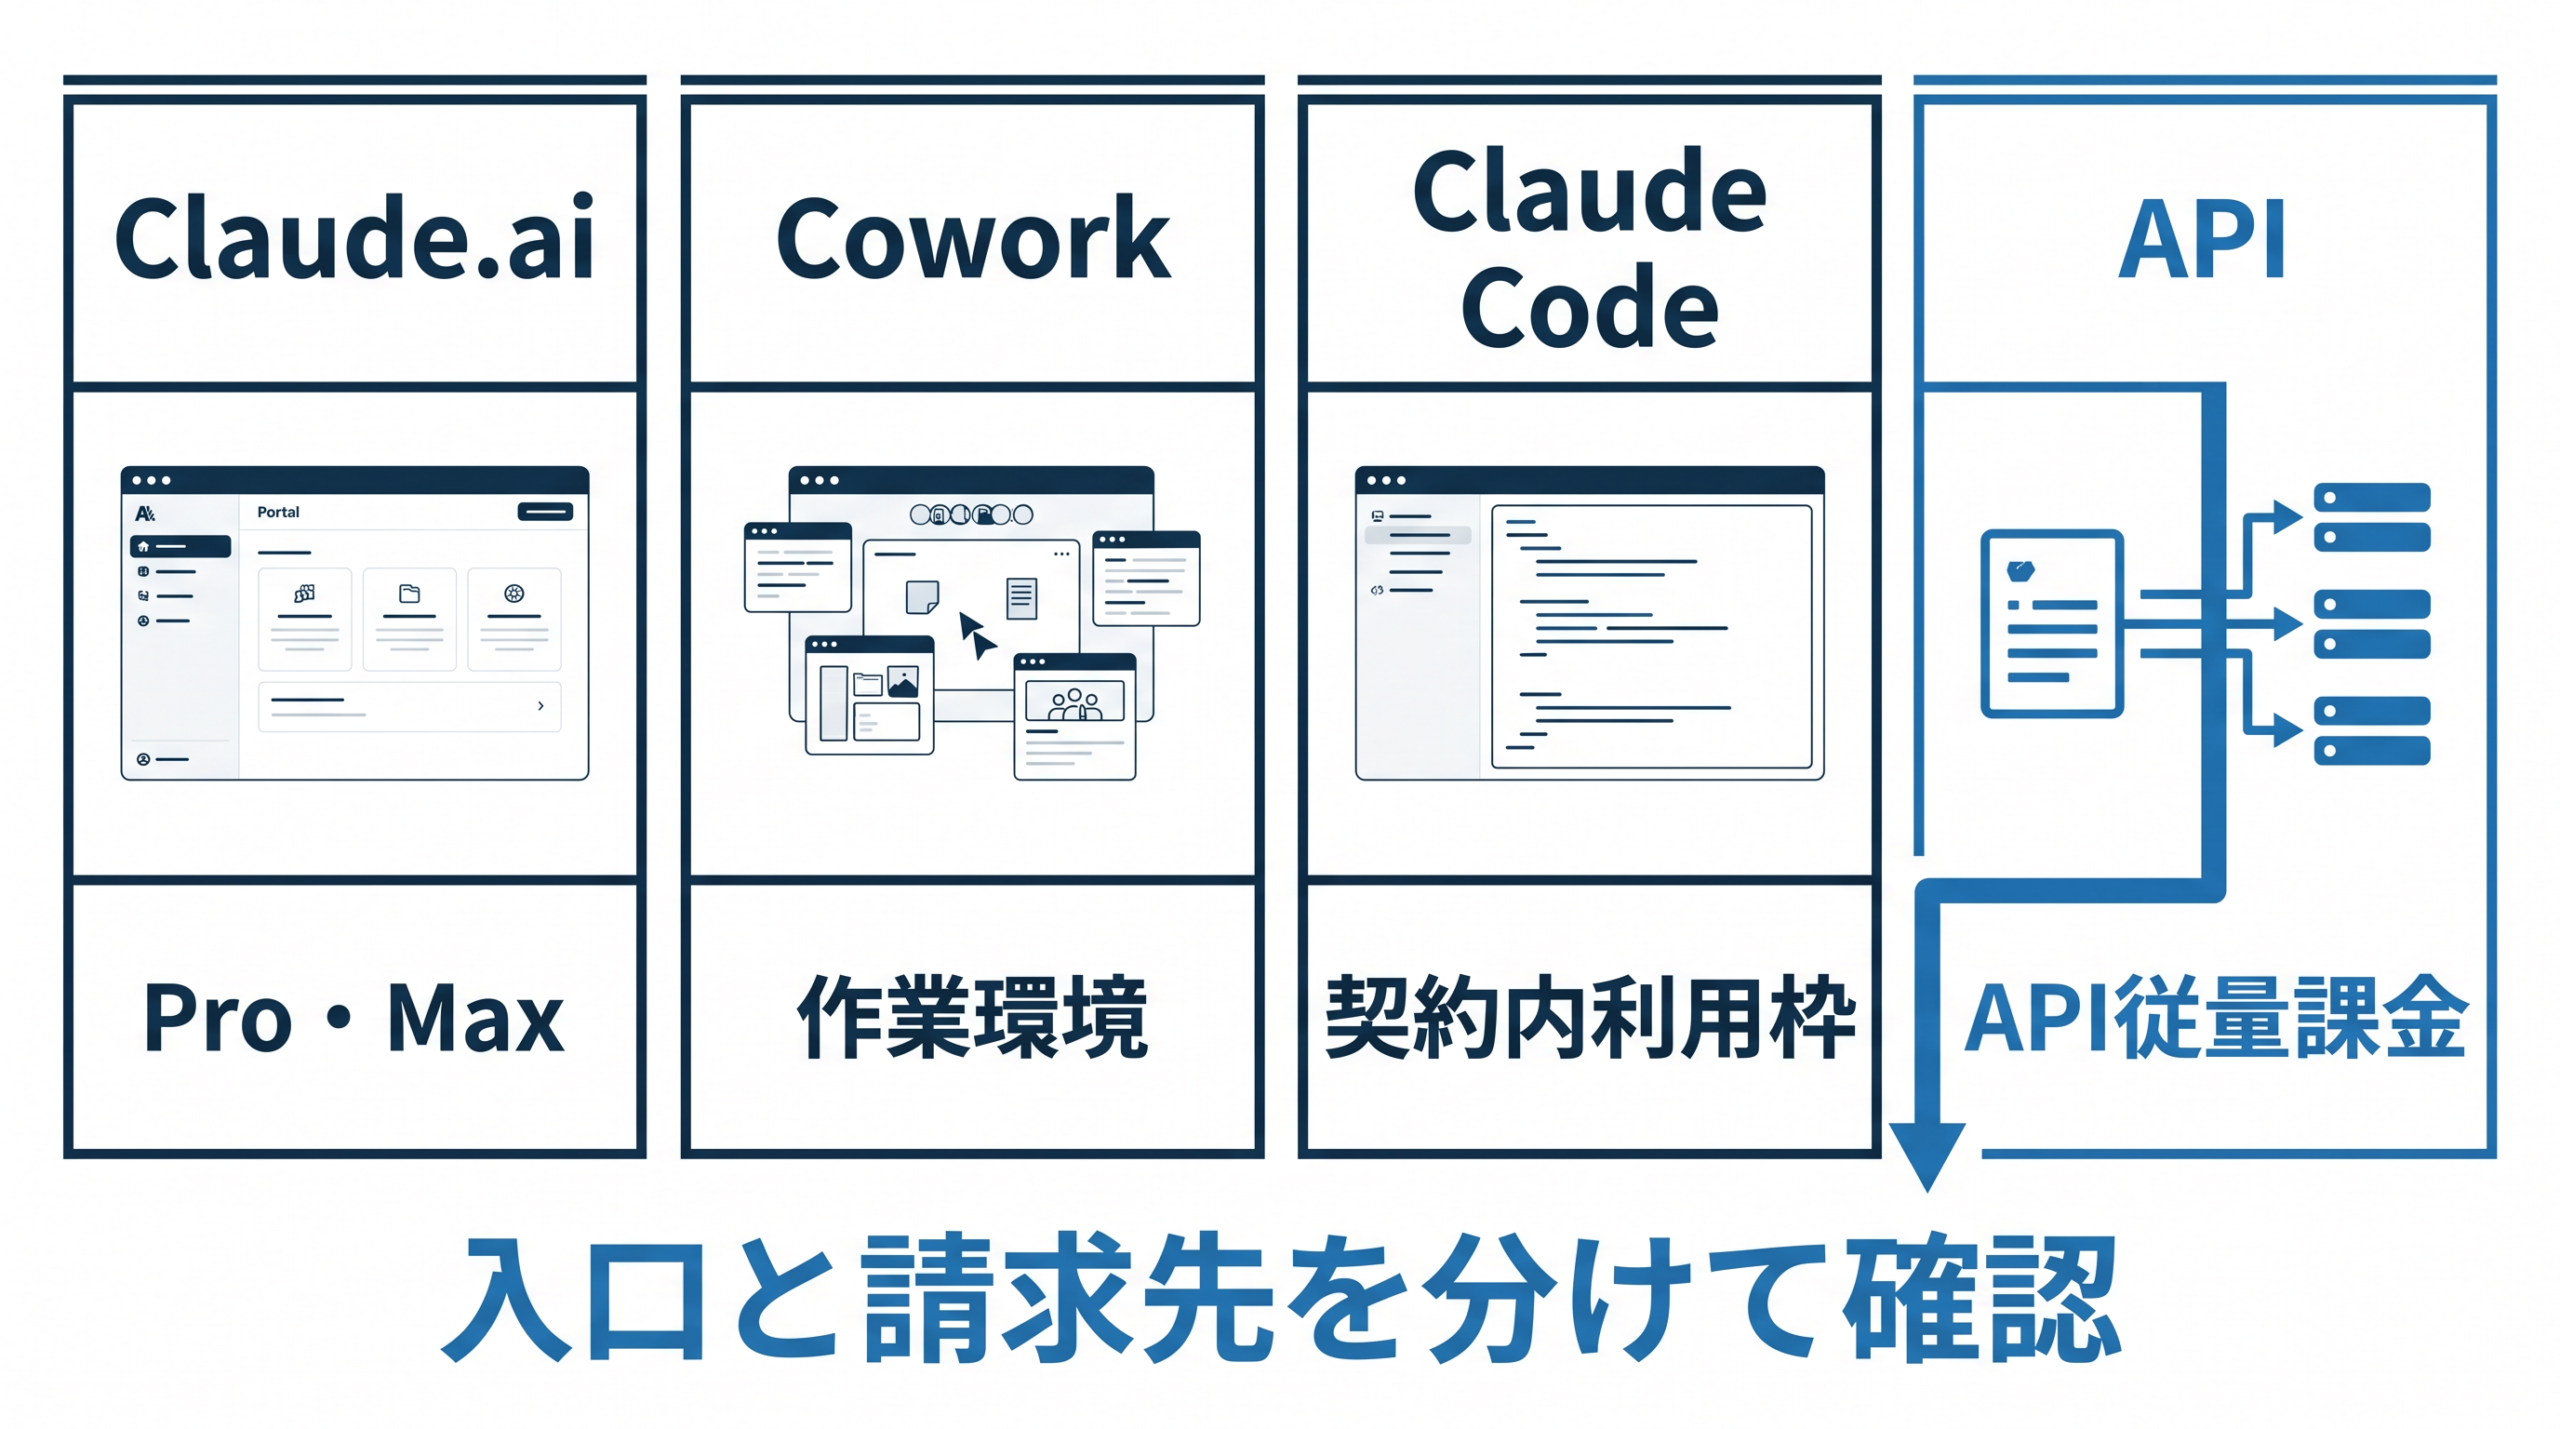
Claude Fable 5.1は、利用者の環境に合わせて複数の製品やインターフェースから入力を開始できます。製品ごとに対応するプラン、認証方法、推論の深さを指定する既定のeffort値、請求の扱いが異なります。
Claude.aiとCoworkを通じた利用
ブラウザやアプリからアクセスできるClaude.aiおよびCowork環境では、テキストやファイルを入力し、モデルが生成した成果物を対話画面で確認します。対象プランはPro、Max、Team、Enterpriseです。
Fable 5.1をClaude.aiまたはCoworkから使う場合、推論に費やすリソースを調整するeffort値は既定でmediumです。Freeプランは公式ページの対象一覧に含まれていません。
公式ページでは、Fable 5.1のチャット履歴を30日間保持すると説明しています。削除後の扱いや学習利用は、契約条件と組織設定を別に確認してください。
一部の企業環境にはEnterprise Frontier Safeguards(EFS)が適用されます。企業が顧客管理ストレージや段階展開を使う場合、管理者は通常プランと異なるデータ境界を確認します。
Claude Codeを通じた利用
開発者はClaude Codeをターミナルから操作し、許可した範囲のファイルをモデルに読ませて、編集やプログラム生成を依頼できます。
Claude CodeでFable 5.1を選び、effort値を変更しない場合、既定はhighです。
Claude Codeでは、認証方法によって利用枠と請求の経路が変わります。サブスクリプションログインを選ぶと、消費分はClaude.aiの契約プランの利用枠に計上されます。
APIまたはクラウド環境を通じたログインでは、APIの従量課金として扱われます。コマンド入力前の認証ステップで、契約に合う経路を選びます。
macOSまたはLinuxでは、公式の導入手順に従って次のように起動できます。claudeの初回起動時に、Claude.aiの契約アカウントか、課金を有効にしたAnthropic Consoleのどちらで認証するかを選びます。
curl -fsSL https://claude.ai/install.sh | bash
cd /path/to/your-project
claude
起動後に/modelを開いてclaude-fable-5-1を選びます。最初の依頼には対象ファイル、変更禁止範囲、完成条件、実行するテストを含めます。モデルが作業を終えたら、git diffとテスト結果を人が確認します。
APIとクラウドを通じた利用
自社のシステムへモデルを組み込む場合、Claude Platformや各クラウドプロバイダを通じてFable 5.1のAPIへアクセスします。
開発者は利用先ごとのmodel IDと認証方法を指定し、システムからコンテキストを送ります。料金と返却形式も利用先で異なるため、Claude Platformとクラウド各社の仕様を分けて確認します。
Claude Platformの最小リクエストは、Anthropic Consoleで作成したAPIキーを実行環境のANTHROPIC_API_KEYへ設定してから送ります。APIキーの値はコマンドやファイルへ直書きしません。
curl --fail-with-body --show-error https://api.anthropic.com/v1/messages \
  -H 'Content-Type: application/json' \
  -H 'anthropic-version: 2023-06-01' \
  -H "X-Api-Key: $ANTHROPIC_API_KEY" \
  --max-time 600 \
  -d '{
    "model": "claude-fable-5-1",
    "max_tokens": 1024,
    "messages": [{"role": "user", "content": "調査対象と未確認事項を分け、Markdownで返してください。"}]
  }' > fable-response.json

jq -e 'if .type == "message" and (.content | length > 0) then true else error(.error.message // "unexpected response") end' fable-response.json
curlはHTTPエラーを失敗として返し、応答本文をfable-response.jsonへ保存します。続くjqが終了コード0なら、内容を持つClaudeの成功応答です。失敗時も応答本文は同じファイルに残るため、再実行前に必要な記録を退避してください。
このAPI呼び出しはClaude.aiの月額プラン枠ではなく、APIキーを所有するConsole組織へ従量課金されます。
公式ガイドを踏まえたFable 5.1向けプロンプトの書き方
AnthropicのClaude Fable 5.1向け公式ガイドでは、まずhighで試すよう勧めています。highは、モデルが推論に使う量を多めにする設定です。その後はlowからmaxまで、推論量の異なる設定でも同じ課題を実行します。回答の品質と待ち時間、API料金を比べてください。
Fable 5.1は、Fable 5よりも長い作業の途中報告が少なくなる傾向があります。依頼済みの作業でも、確認を求めて止まる場合があります。作業を見守る必要があるなら、途中で何を報告してほしいのかを指定してください。毎回の確認を避けたい場合は、確認せず進めてよい操作と、人の確認が必要な操作を分けます。
作業を始める前に、これから行うことを1文で知らせてください。
依頼済みの範囲にある、元に戻せる調査・編集・テストは、追加確認を求めず最後まで進めてください。
削除、公開、送信、課金、作業範囲の変更が必要な場合だけ止まり、私に確認してください。
途中では、判明したことと次に行うことを短く報告してください。
最後に、変更内容、テスト結果、未解決事項をまとめてください。
文章に比喩や飾った言い回しが増える場合、公式ガイドは、それらを取り除くよう明確に指示する方法を紹介しています。日本語では「比喩や飾った表現で言い換えず、具体的な対象と動作を直接書いてください」と伝えれば、求める文章の違いが明確になります。
小さなコード修正では、対象ファイルと変更禁止範囲を示します。完成条件を伝えたうえで、「ファイル全体を書き直さず、必要な箇所だけを変更してください」と添えてください。Fable 5.1がファイル全体を書き換える動きを抑えられます。
APIでツール実行を繰り返す場合は、会話履歴の渡し方にも注意が必要です。公式ガイドは、最初に送ったシステム指示やツール定義を途中で書き換えないよう求めています。過去のメッセージと、モデルが返した思考ブロックも受信した順に残してください。途中で指示を変える場合は過去の履歴を編集せず、新しいメッセージとして追加します。
Fable 5から何が変わったか
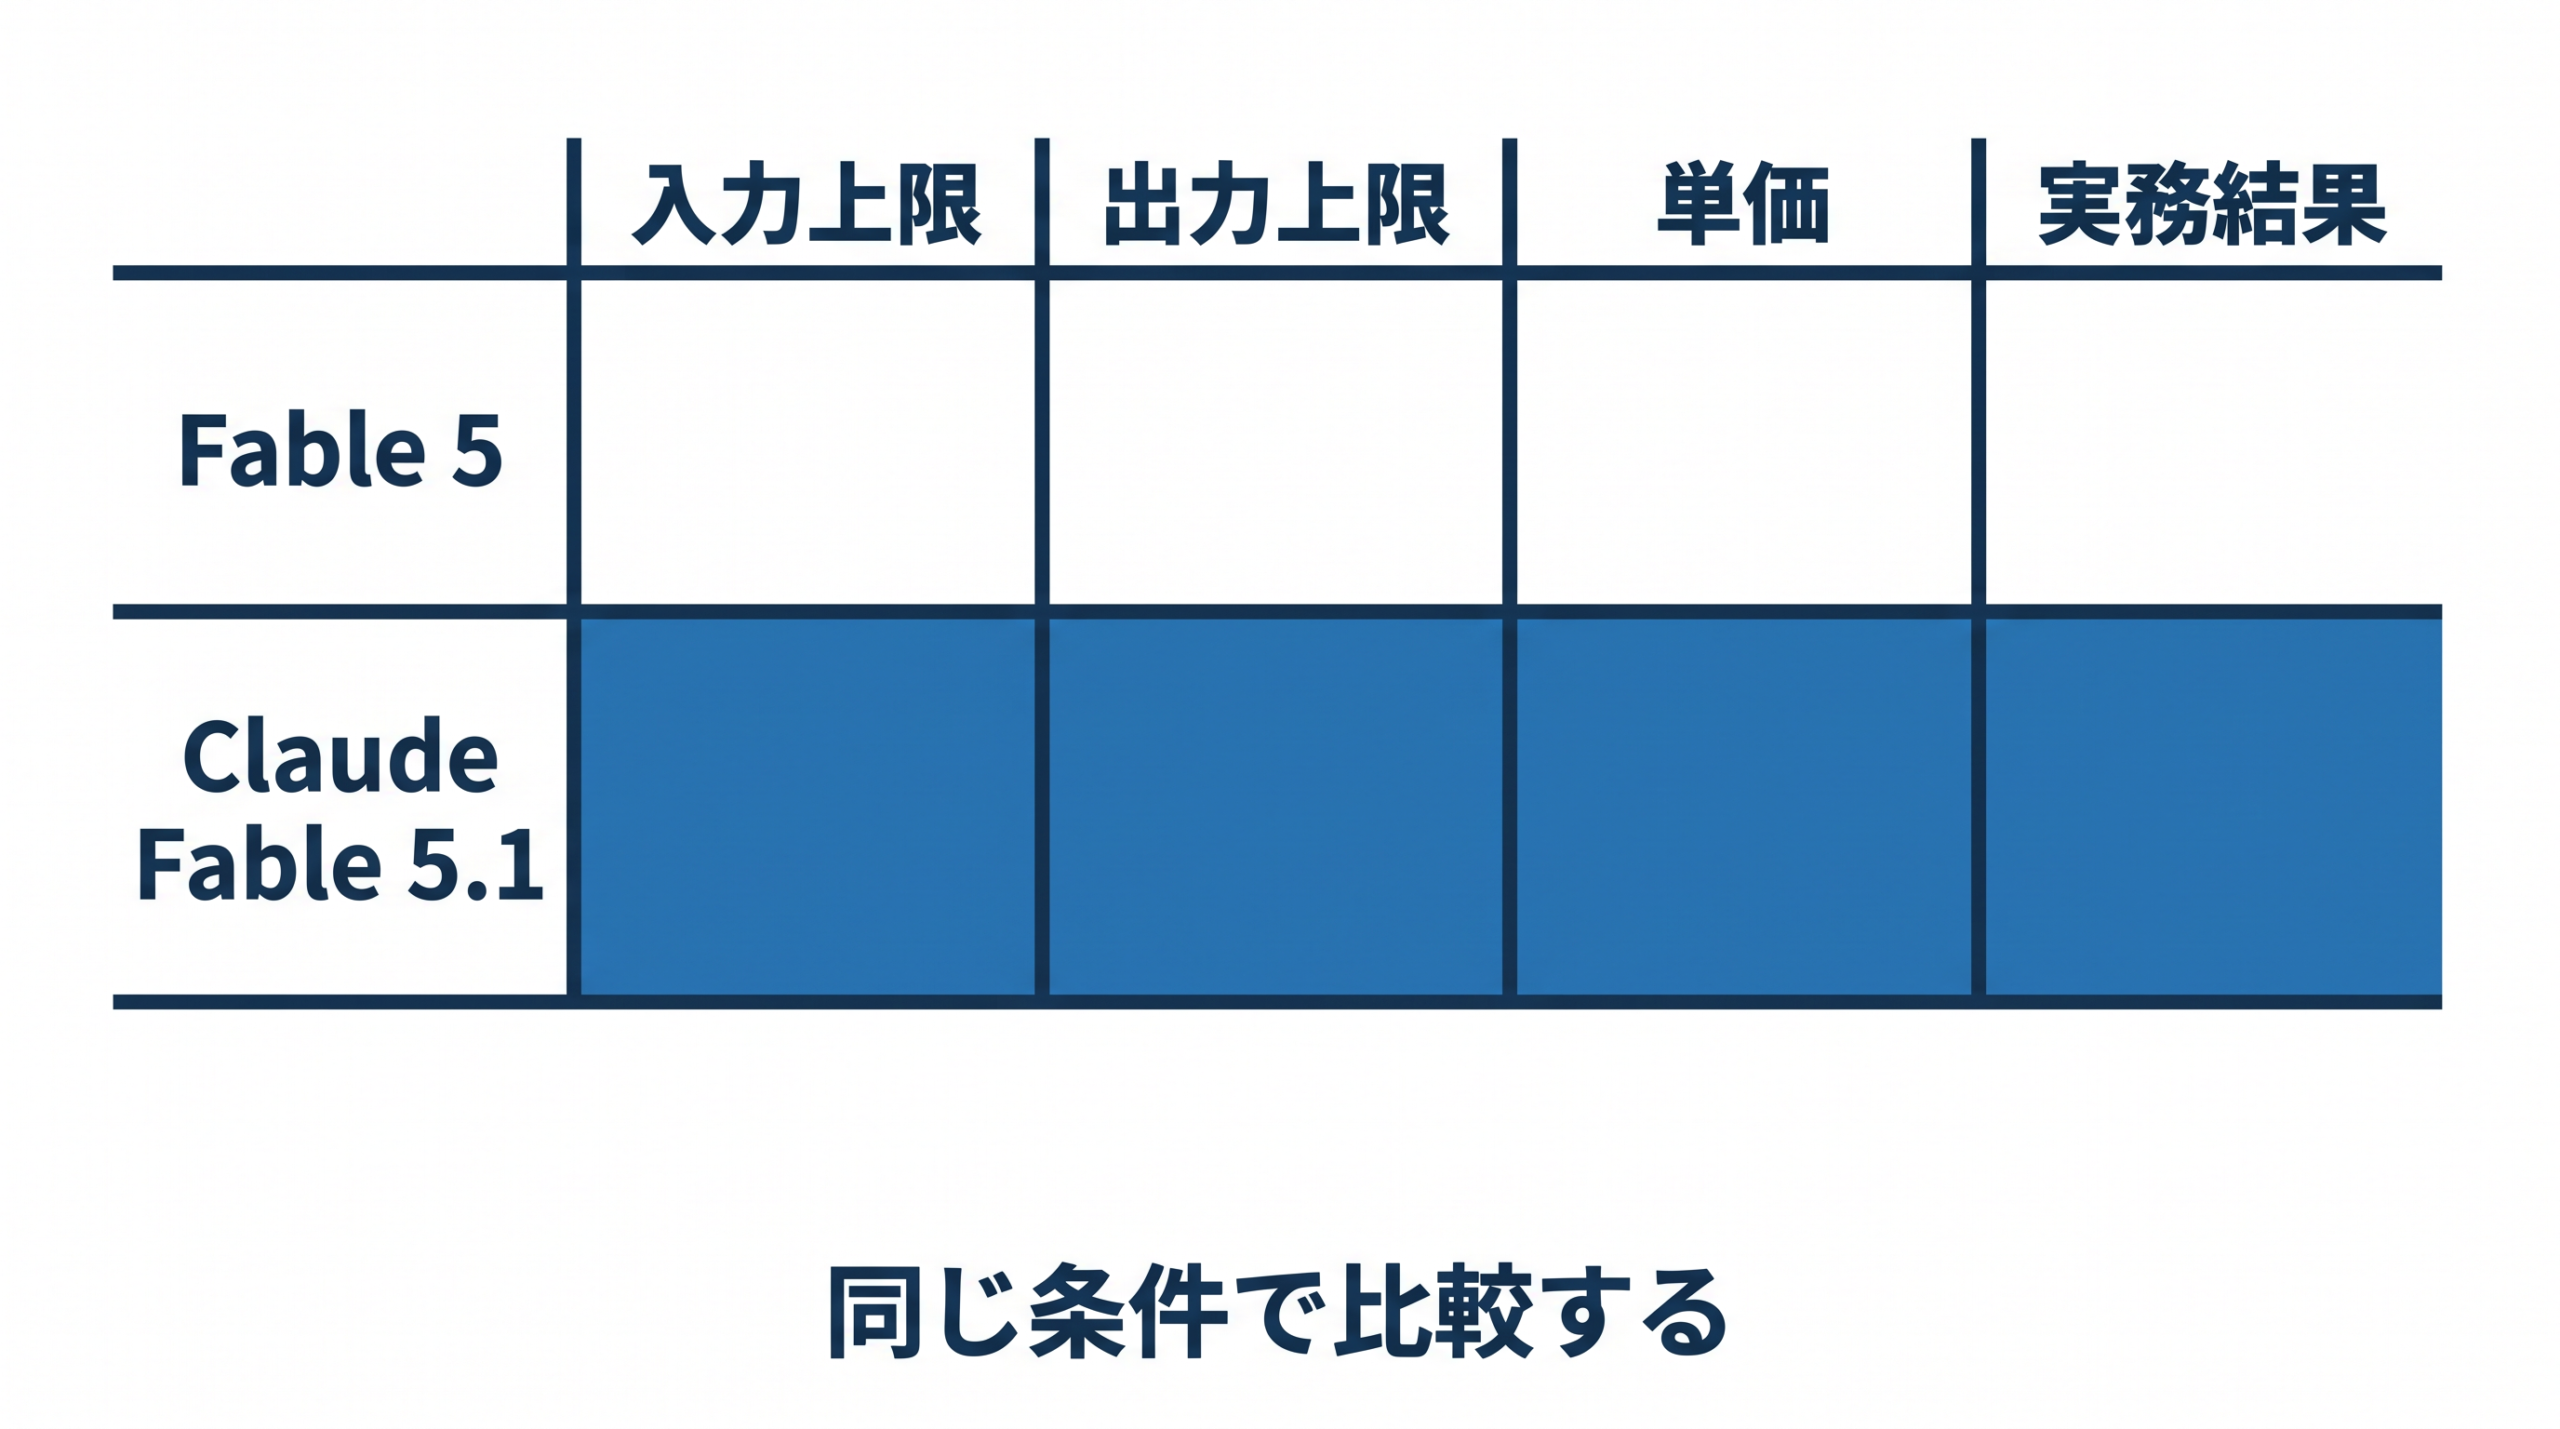
Fable 5.1への切り替えを判断するため、3種類の証拠を分けて確認します。Anthropicの公式発表、独立機関の評価、顧客証言です。科学分析やコーディングなど、長時間タスクにおける従来モデルとの差を見ます。
科学分野における長時間タスクの評価
Terminal-Bench-Science(TB-Science)は、モデルと実行環境の組み合わせに科学分野の課題を解かせ、成果物をテストするベンチマークです。70タスクを各3回試行します。
Anthropicが公開した自社での実行値によると、Fable 5.1のスコアは52.6%であり、従来モデルであるFable 5の24.7%の約2.1倍です。
ただし、このスコアはAnthropicによる実行結果です。2026年9月6日の確認時点で、ベンチマーク運営元のleaderboardにはFable 5.1の結果がありません。
同ボード上のFable 5は21.4、Opus 5は30.0です。Anthropicの値と運営元の値では実行主体やハーネスが異なるため、同じ条件のモデル差として直接比較できません。
コーディングおよび総合評価の内訳
Anthropicの公式発表は、同社の実行環境でTB4.0とCursorBenchのスコアが従来モデルから向上したと報告しています。
記事では数値を異なるハーネスへ外挿せず、自社のコードとテストで切り替えを判断します。
Artificial Analysisの独立評価では、Fable 5.1とOpus 5の総合評価の信頼区間が重なっています。そのため、総合的に一方が上とは断定できません。
内訳ではFable 5.1の分析品質がわずかに高く、プレゼン品質は低いという結果でした。分析と発表資料を一続きで作らせる場合は、総合点だけでなく両方を確認します。
顧客証言を通じた実利用の確認
Anthropicの発表には、先行してFable 5.1を利用した顧客の証言も含まれています。これらの証言では、利用者がモデルに長時間の作業を指示し、出力された成果物を人が確認した際の手応えが語られています。
これらの証言は特定の環境やタスクにおける評価であり、Fable 5.1を導入すればすべての業務で従来モデルの2倍の成果が出る、あるいは専門家による成果物の確認が不要になるといったことを意味するものではありません。利用者が自身の業務において、公開事例と同じ時間で成果を再現できるかどうかは、実際のデータ入力と操作を通じた確認が必要です。
料金とキャッシュの実効コストを計算する
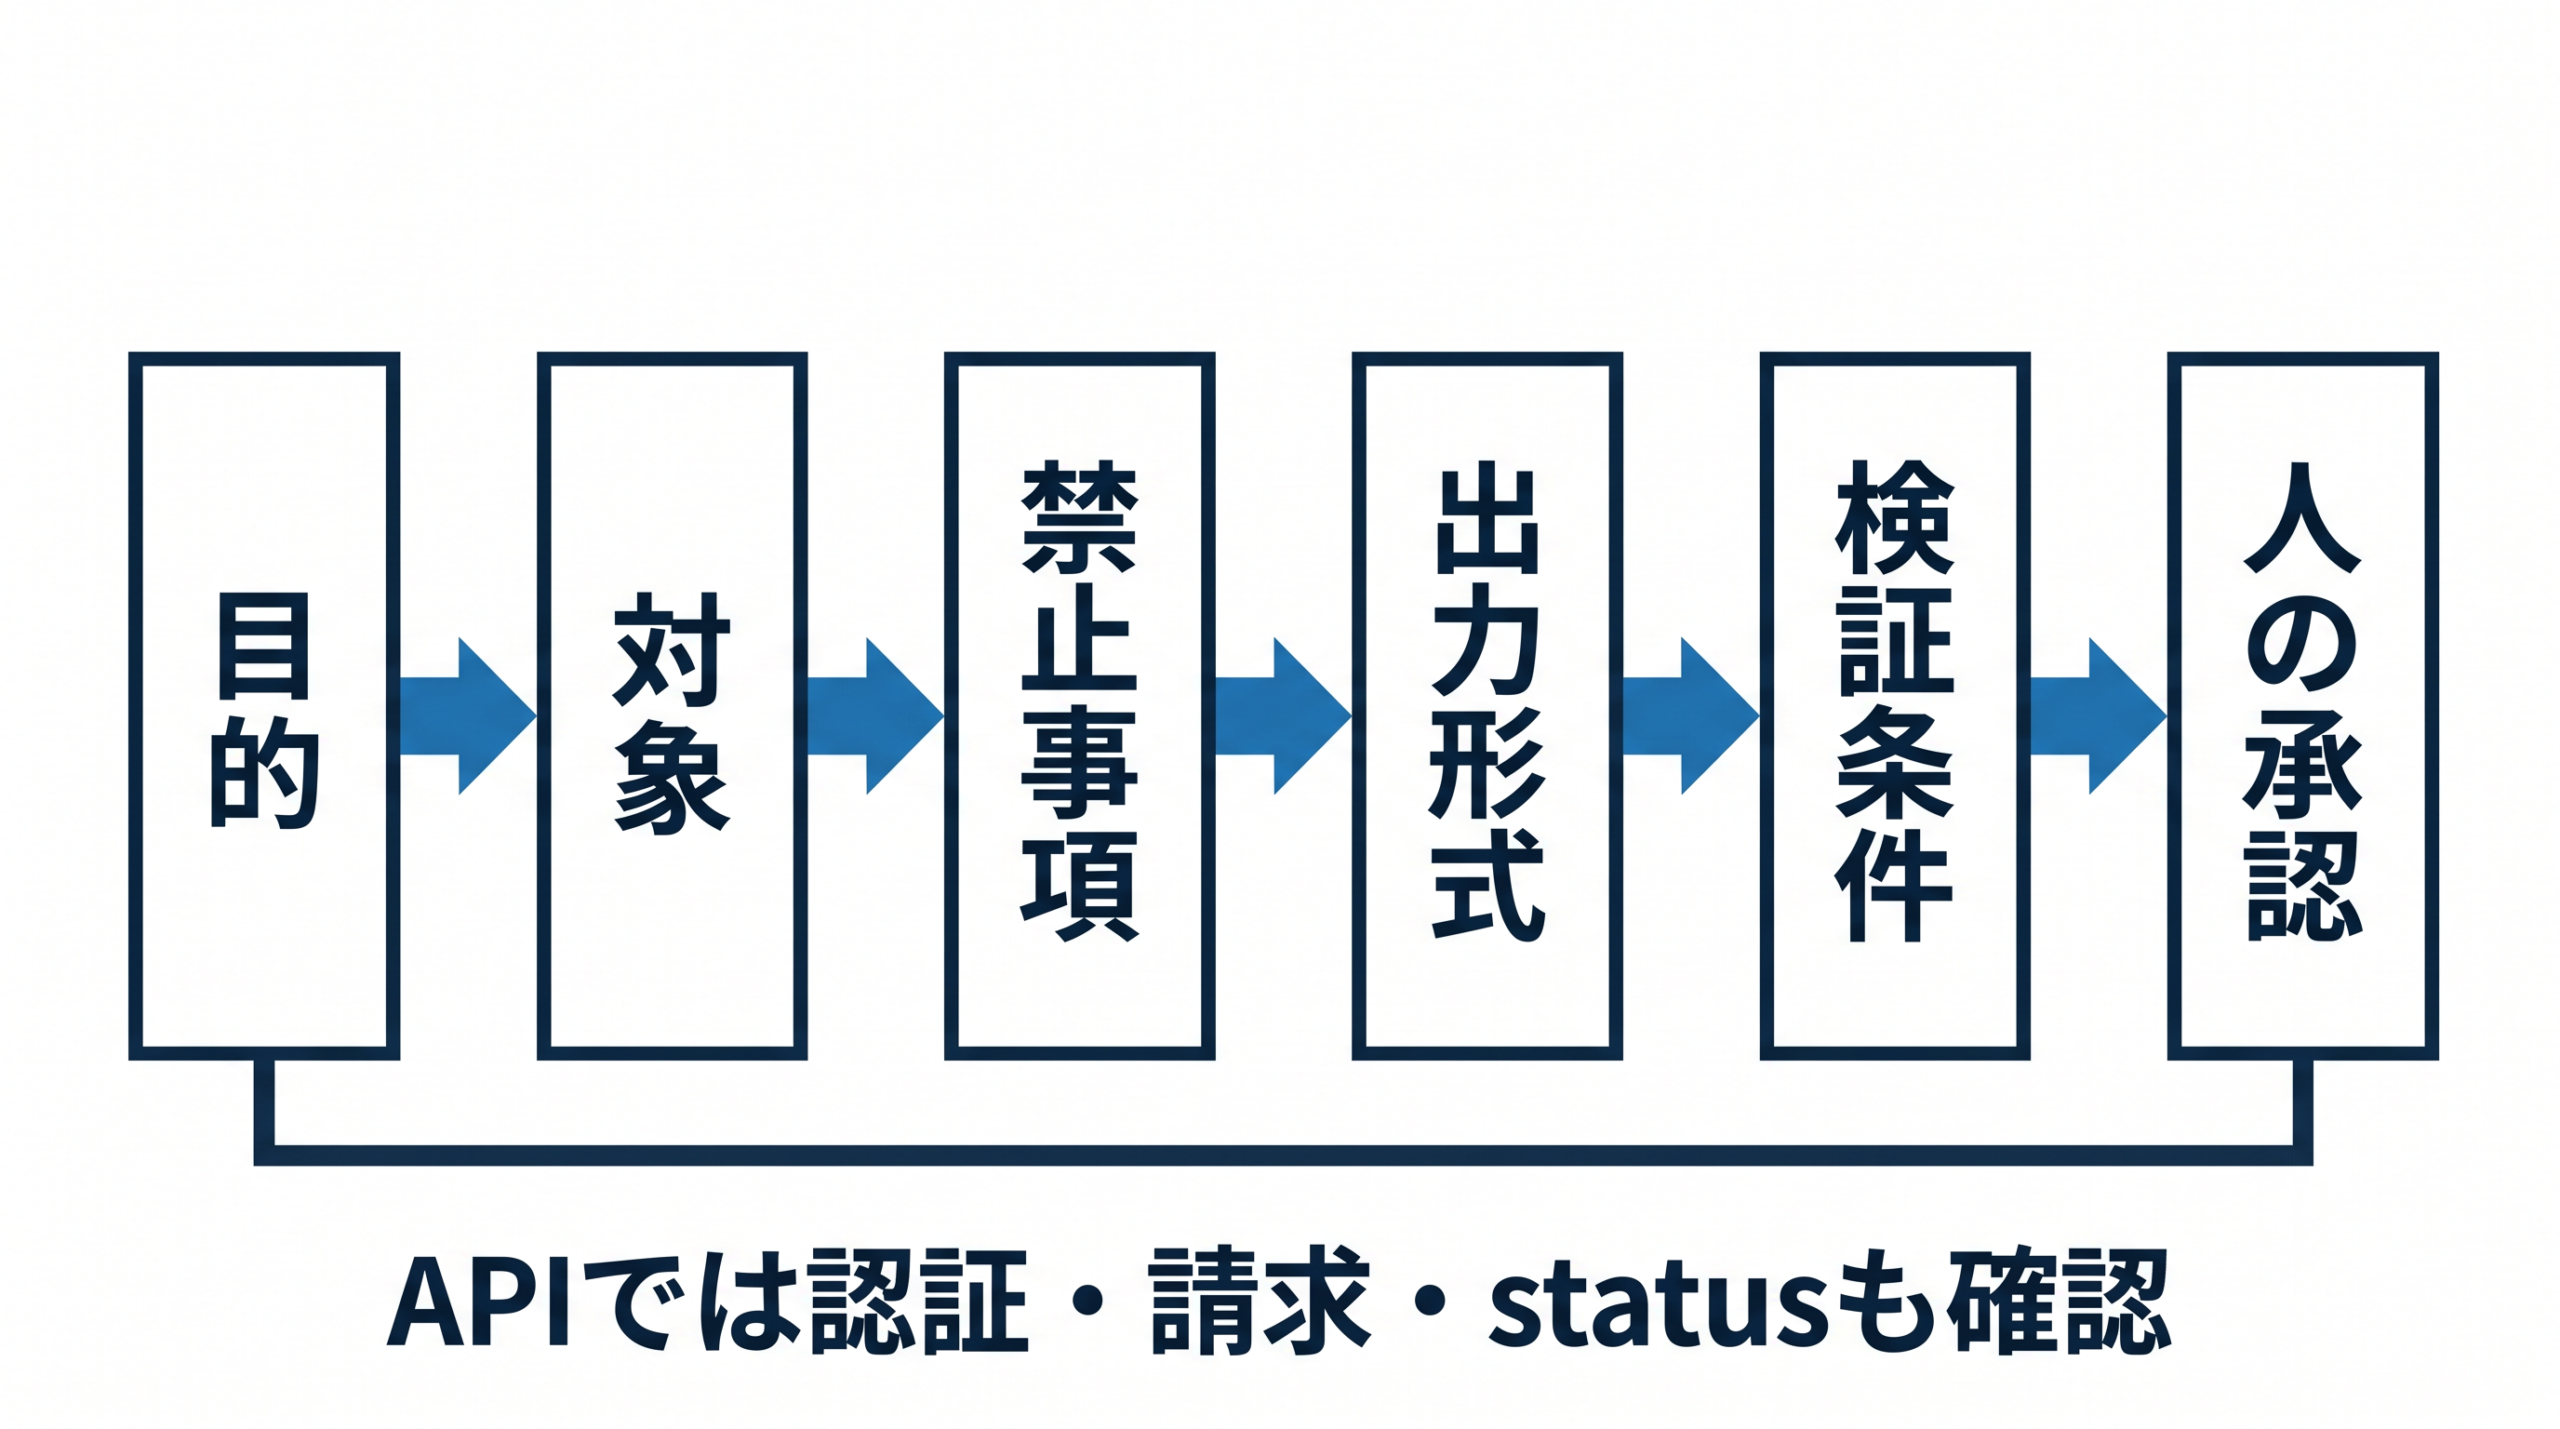
APIを通じたFable 5.1の利用では、利用者が送信する入力データ、モデルが生成する出力データ、および入力データを保持するキャッシュのそれぞれに対して、100万トークンあたりの単価が設定されています。性能の確認に続いて、実際の長時間タスクで発生する費用を具体化します。
基本の入力・出力とキャッシュ単価
公式の料金表によると、100万トークンあたりの通常の入力は10ドル、モデルからの出力は50ドルに設定されています。
長い資料やコードベースを入力し、複数回の対話を行う場合は、プロンプトキャッシング機能を利用できます。APIリクエスト内でcache_controlを指定すると、前方一致する入力を再利用できます。
保持期間(TTL)は5分と1時間です。キャッシュ対象より前の内容を変更すると一致しなくなり、追加した会話部分には通常の入力料金がかかります。
- 5分TTLのキャッシュ書き込み: 12.50ドル
- 1時間TTLのキャッシュ書き込み: 20ドル
- キャッシュの読み取り(read): 0.25ドル
20万トークンを4回再利用する計算例
利用者が20万トークンのテキストデータを入力し、モデルから短時間の間に3回の追加出力を要求する、合計4回のリクエストを想定して入力側のコストを計算します。
キャッシュを使用しない場合、毎回20万トークンの入力料金(10ドル/100万トークン)が発生するため、4回の合計は8ドルとなります。
一方、5分TTLのキャッシュを設定した場合の入力コストは以下のようになります。
- 初回の書き込み(12.50ドル/100万トークン): 20万トークンで2.50ドル
- 残り3回の読み取り(0.25ドル/100万トークン): 20万トークン×3回で0.15ドル
- 合計: 2.65ドル
この2.65ドルは、4回とも5分のTTL内で同じ20万トークンの前方部分が一致する場合の入力側だけの金額です。追加指示の入力、モデルの出力、TTL切れ後の再書き込みは含みません。
節約率の目安と追加の利用条件
Anthropicの公式値では、キャッシュを使う典型的な利用で25%の節約になると説明しています。モデルが複数ステップを実行するエージェント的な利用では、最大約45%です。ワークロード全体の目安であり、前述の入力側だけの計算とは対象が異なります。
APIの実行方法でも料金は変わります。急ぎでない処理をBatch APIへ送ると、対象となる入力と出力の料金は通常の50%、つまり50%引きです。
データ処理を米国内に限定するUS-onlyルーティングには、通常の1.1倍の入力・出力料金が適用されます。利用前に、使うAPIで両条件を併用できるか確認します。
公開事例から選ぶおすすめユースケース
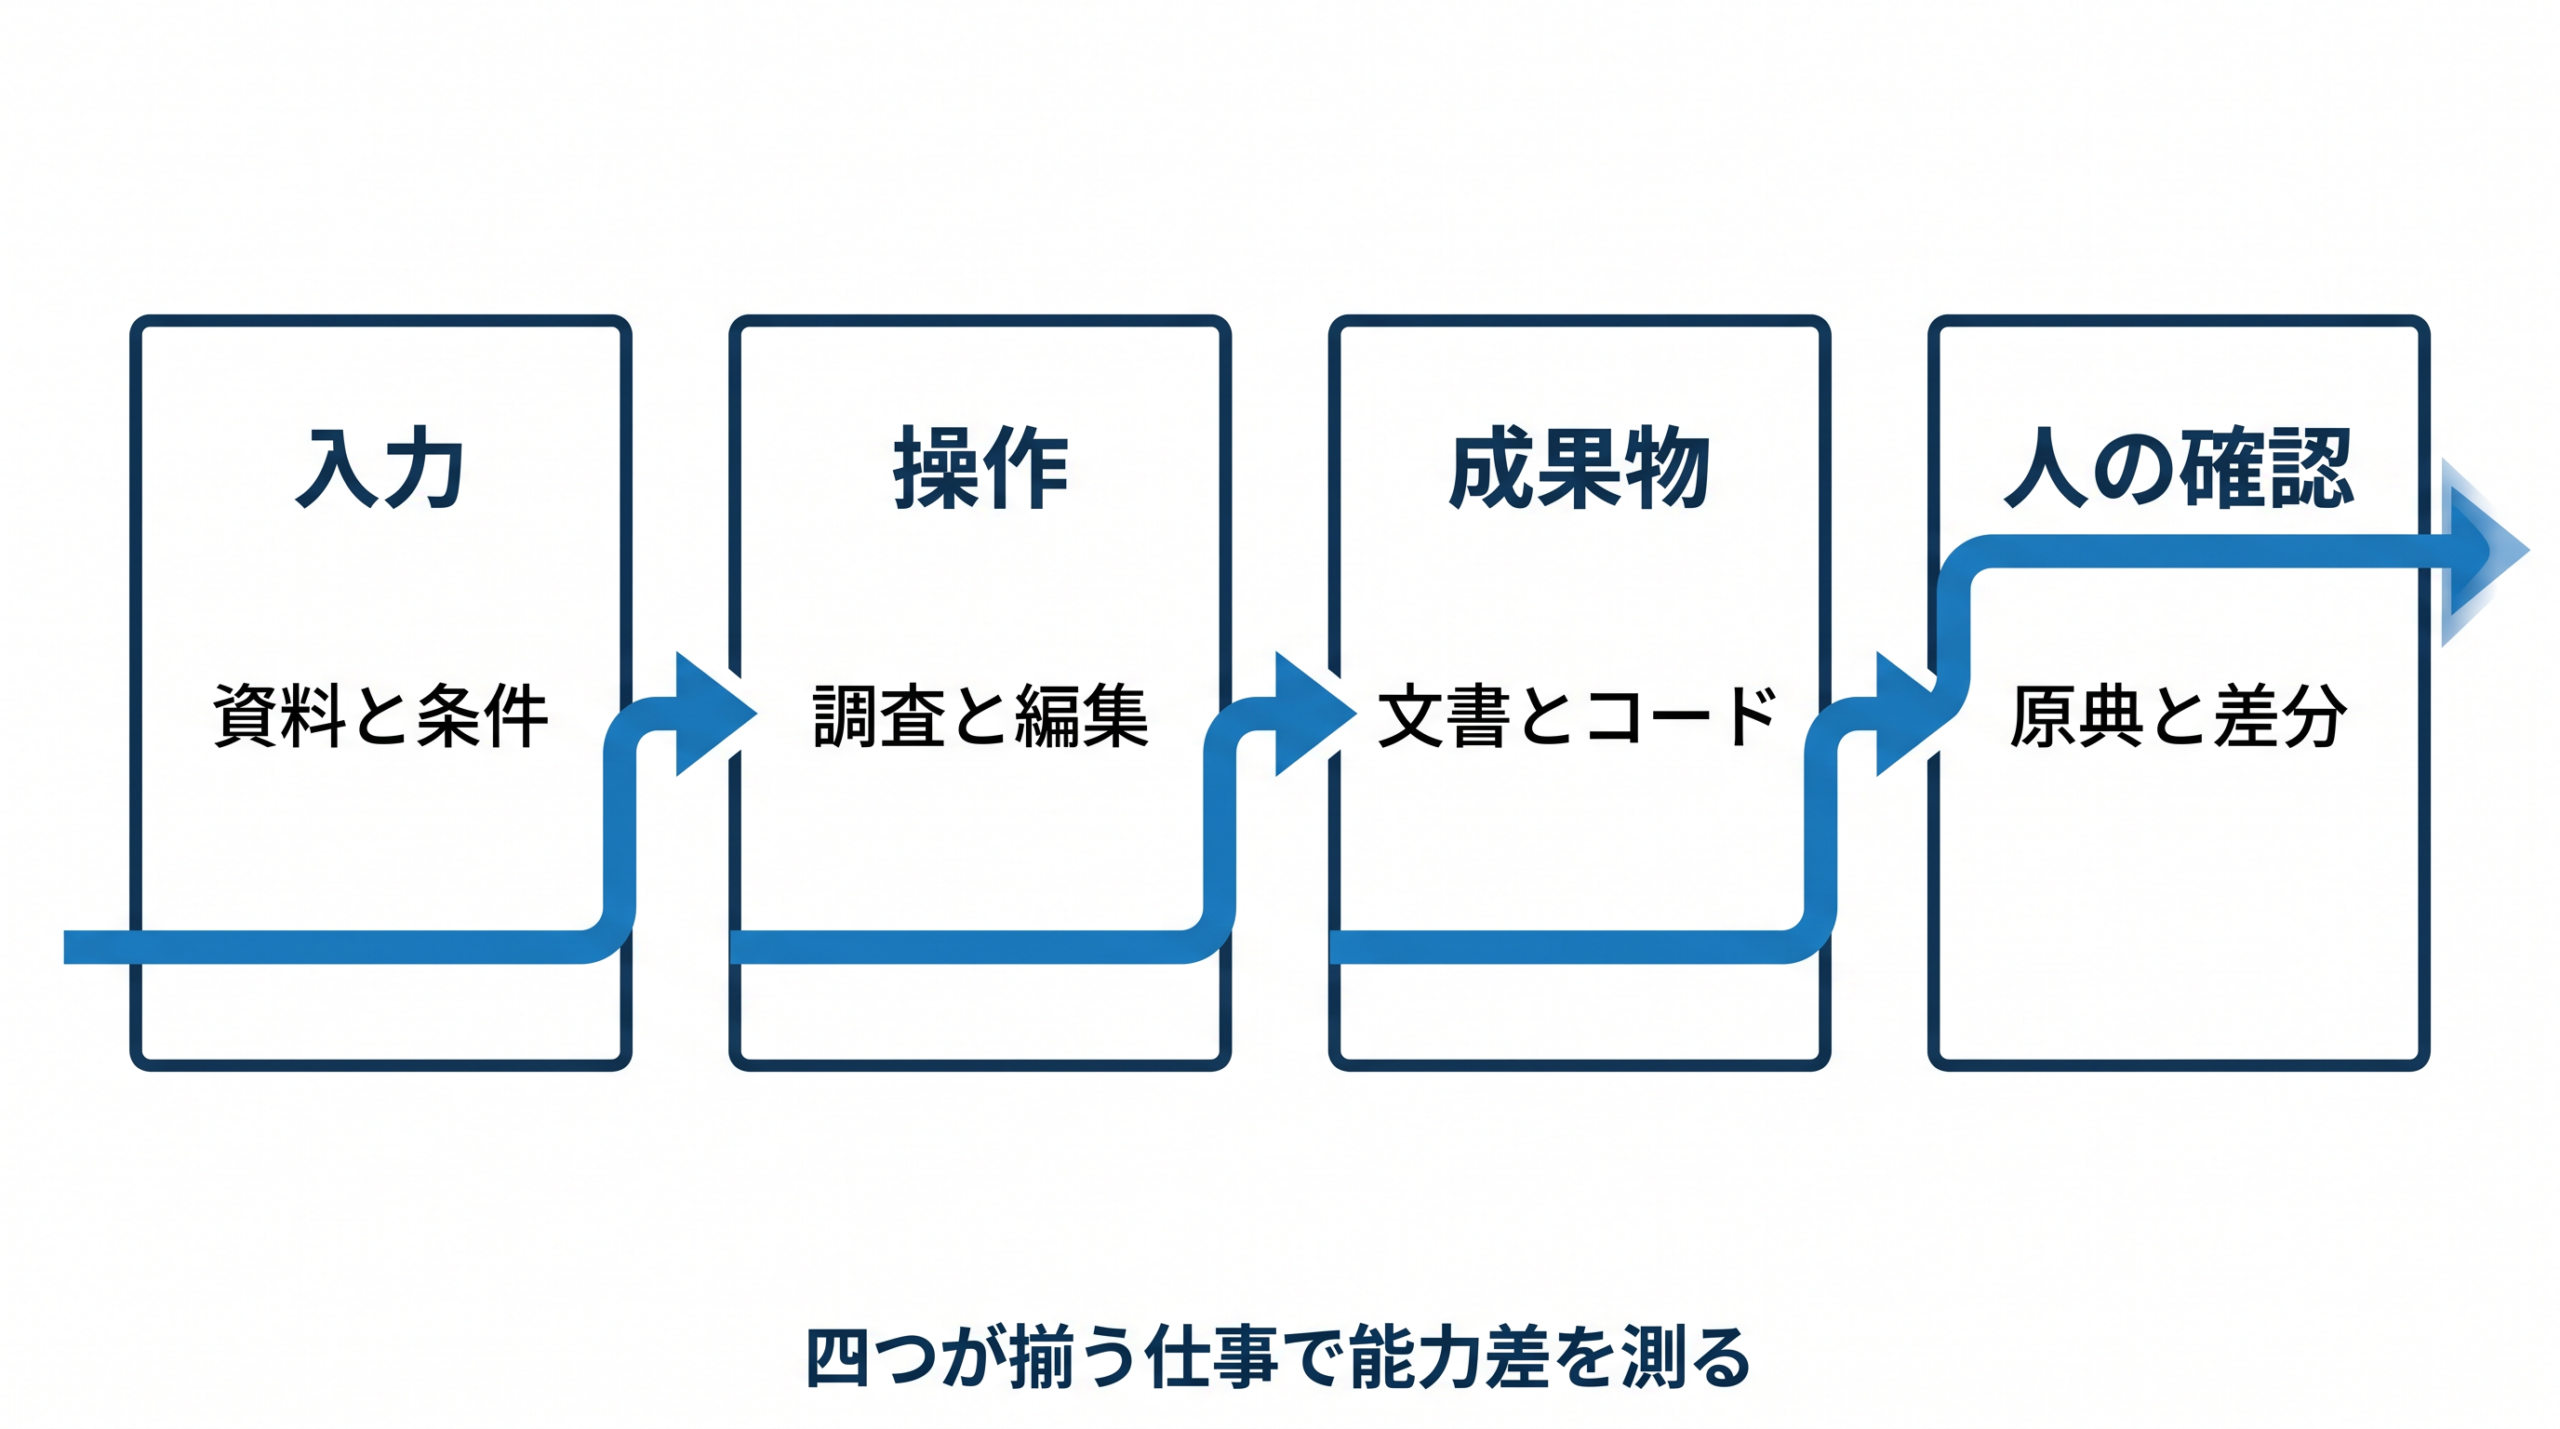
キャッシュを活用した実効コストの計算を踏まえ、最初にFable 5.1へ費用をかけて検証する業務を検討します。公開されている事例をもとに、利用者が何を入力し、モデルがどのような成果物を出力し、人がどのように確認しているかを整理します。
長時間のコーディングと3D制作
開発環境のAmpは、モデルが2時間作業した事例を紹介しています。同社の比較動画では、操作に対する応答遅延が85msから8msへ短縮されたと報告しています。
測定回数、環境、変更差分、生ログは公開されていません。利用者は自身の環境で、速度とコード品質を分けて確認します。
個人開発者が公開した3Dゲームもあります。単一のプロンプトから複数の生成ツールを連携させ、操作できるHTMLを出力した事例です。
作者は24分で完成したと説明しています。ただし、費用、再試行、人の修正、計測方法は公開情報から確定できません。
資料制作における人の確認作業の支援
資料制作では、AI-Native PMの事例があります。モデルは利用者の入力から、7章の文書と7枚のスライドを出力しました。
この事例において、モデルは出力した成果物を検証するチェッカーや、作業を補助するパイロットとしての役割を果たしています。利用者はモデルの出力をそのまま完成品とするのではなく、人が成果物の全行を確認して修正するプロセスをモデルが支える形で利用しています。
AI運用設計と研究・分析における留意点
Anthropicが公開した顧客証言には、MongoDB、Millennium、SquareなどによるFable 5.1の利用例があります。
ただし、入力データ、失敗率、所要時間は公開されていません。ベンダーが選んだ証言として扱い、同じ時間やコストで再現できるとは判断しません。
さらに、データ分析や表計算、学術的な研究といった用途については、入力データから最終的な成果物に至るまでの具体的な過程や、人がどのように確認を行ったかを示す公開された証拠が不足しています。したがって、これらの長時間作業へFable 5.1を適用する場合、利用者は自らのデータと操作を通じて一から検証を行う必要があります。
Fable 5.1とGPT-6 Astraをどう選ぶか
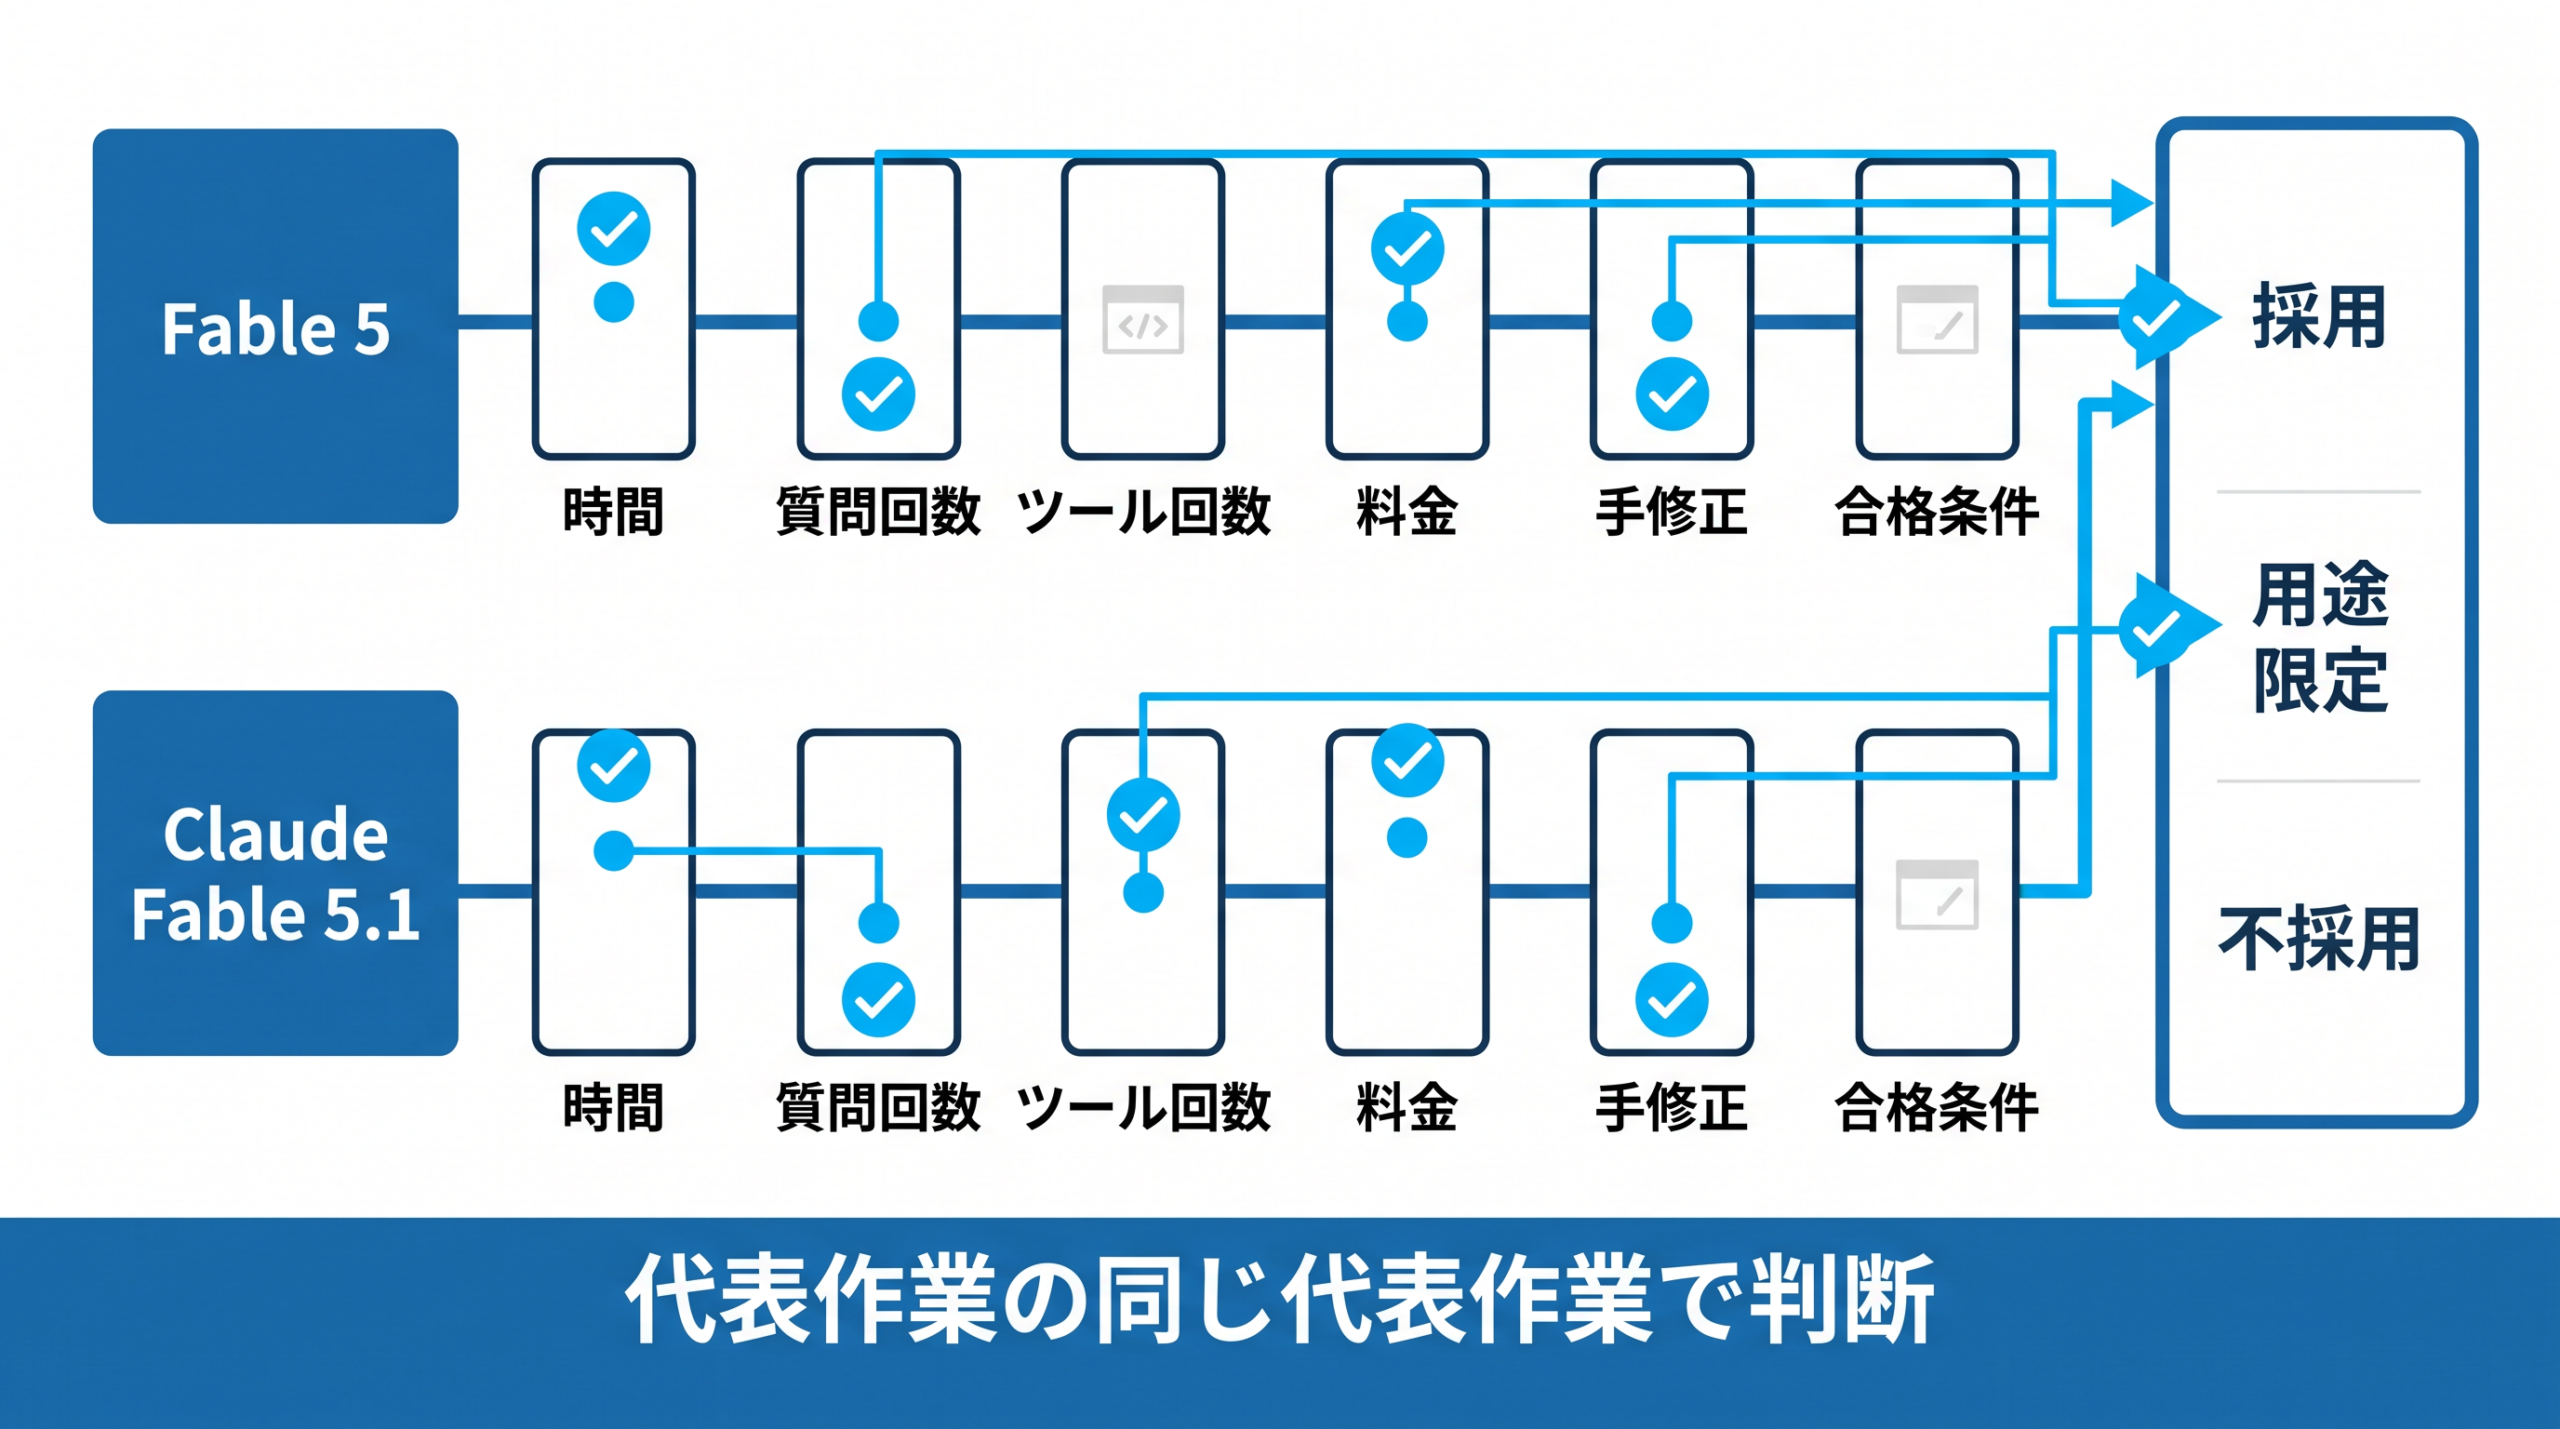
自身の業務で長時間の作業をAIに任せる候補が定まった後、次に代替モデルとなるGPT-6 Astraとの選択を検討します。公開されている同名の評価結果、APIの料金体系、および操作環境の違いを整理し、自分たちの入力データを用いた受入テストで判断するための軸を示します。
同名評価とharnessの違い
OpenAIの発表ページには、TB-Science、TB4、HLEといったFable 5.1の検証でも用いられている同名のベンチマーク評価が掲載されています。
これらの評価をモデル単体の性能として直接比較することは困難です。ベンチマーク運営元によると、結果はモデルだけでなく、agent harnessと呼ばれる実行環境や周辺プログラムとの組み合わせで変わります。
公開スコアを比較する際は、モデル名だけでなく、ハーネス、推論強度、試行数をそろえます。
API基本単価とキャッシュ読み取り料金の差
Fable 5.1のAPI料金とGPT-6 Astraの料金は、標準枠では100万トークンあたり入力10ドル、出力50ドルです。
Fable 5.1のキャッシュ読み取りは100万トークンあたり0.25ドルです。GPT-6 Astraの料金表では、キャッシュ入力が1ドルです。
Fableには初回のキャッシュ書き込み料金もあります。大量の資料やコードを何度も読む仕事では、キャッシュの一致回数と書き込み料金を含む実測額で比べます。
入力操作を開始する環境の違い
利用者がシステムへデータや指示を入力し、作業を開始する入り口にも違いがあります。
GPT-6 Astraは、対応するChatGPT Workなどの製品機能を通じて、画面を認識し、許可されたPC操作を進めます。利用可否と操作範囲はプラン、OS、管理者設定で変わります。
Fable 5.1はClaude CodeやCoworkを通じて使います。モデル単体ではなく、利用する製品がアクセスできるファイル、画面、ツールの範囲を比べて選びます。
自身の受入テストで決める
公開されたスコアや料金の情報を確認した後は、実際に利用者が自身のデータを使用して受入テストを行います。
テスト前に入力データと完成条件をそろえます。ツール権限、推論強度、試行回数も同じ条件にします。異なるハーネスを使う場合は、その差を記録します。
両モデルが成果物を出すまでの時間と、APIのusageに基づく請求額を計測します。人が加えた修正量と、事前に決めた業務水準での合否も記録します。最後に時間、料金、修正量、合否の4項目で選びます。
よくある質問
Q1. 無料のFreeプランでClaude Fable 5.1を使えますか?
ブラウザやアプリを通じたClaude.aiおよびCowork環境では、対象プランとしてPro、Max、Team、Enterpriseが案内されています。確認した公式ページはFreeプランで使えるとは記載していません。地域や段階展開で表示が変わる可能性があるため、契約前にモデル選択画面を確認してください。
Q2. APIを通じた入力やキャッシュの料金はいくらですか?
公式の料金表によると、APIを通じた基本の従量課金は100万トークンあたり入力10ドル、出力50ドルです。プロンプトキャッシング機能を利用して入力データを保持する場合、書き込み料金は5分保持で12.50ドル、1時間保持で20ドルとなり、キャッシュされたデータに対する読み取りは100万トークンあたり0.25ドルで計算されます。
Q3. 短い質問をするだけの用途に向いていますか?
短い質問にも回答できます。ただし、1回の短い回答では、Fable 5.1と低価格なモデルの差を確かめにくい場合があります。長いコードや資料を読み、複数の工程を続ける仕事から試すと、品質と費用を比較しやすくなります。
Q4. Claude Mythos 5.1との違いは何ですか?
Anthropicの発表によると、両者は同じベースモデルです。Fable 5.1は一般提供向けですが、Mythos 5.1は利用資格の審査が必要です。セーフガードの設定も異なります。
Q5. Claude Codeを利用する際の課金はどうなりますか?
認証時に選んだログイン方法で変わります。Claude.aiのサブスクリプションでログインすると契約プランの利用枠を使います。APIまたはクラウド環境で認証すると従量課金です。
Q6. GPT-6 Astraとどちらを選ぶべきですか?
APIの基本単価は同額ですが、キャッシュ料金と利用できる操作環境が異なります。同じ入力と権限、完成条件で両モデルを試してください。合否と所要時間、請求額、人が直した量を比べて選びます。
AIを組み込む仕事の流れづくりをご支援します
Deskrexでは、AIを使って調査・制作・分析などの仕事を進めるために、工程と役割分担を設計し、実装する支援を行っています。AIに渡す資料や指示、使えるツール、人が確認する箇所を整理し、一連の仕事として動く仕組みをつくります。
まず、届けたい成果物と現在の作業手順を確認し、実際の仕事をAIで試します。品質、処理量、時間、費用を見ながら、今すぐ任せられる作業と、追加の設計や開発が必要な作業を確かめます。
その結果をもとに、工程の統合や並列化、ツール連携、結果の検証と修正の手順を組み込みます。実行回数や費用の上限、人の判断を待つ条件、途中の状態を保存して再開する方法も含めて設計し、実務で動作を確かめます。
業務へのAI導入やワークフロー作成のご相談は、AIワークフロー作成支援のご案内からお問い合わせください。任せたい仕事と、現在使っているツールを伺い、取り組む範囲を一緒に整理します。
調査手法について
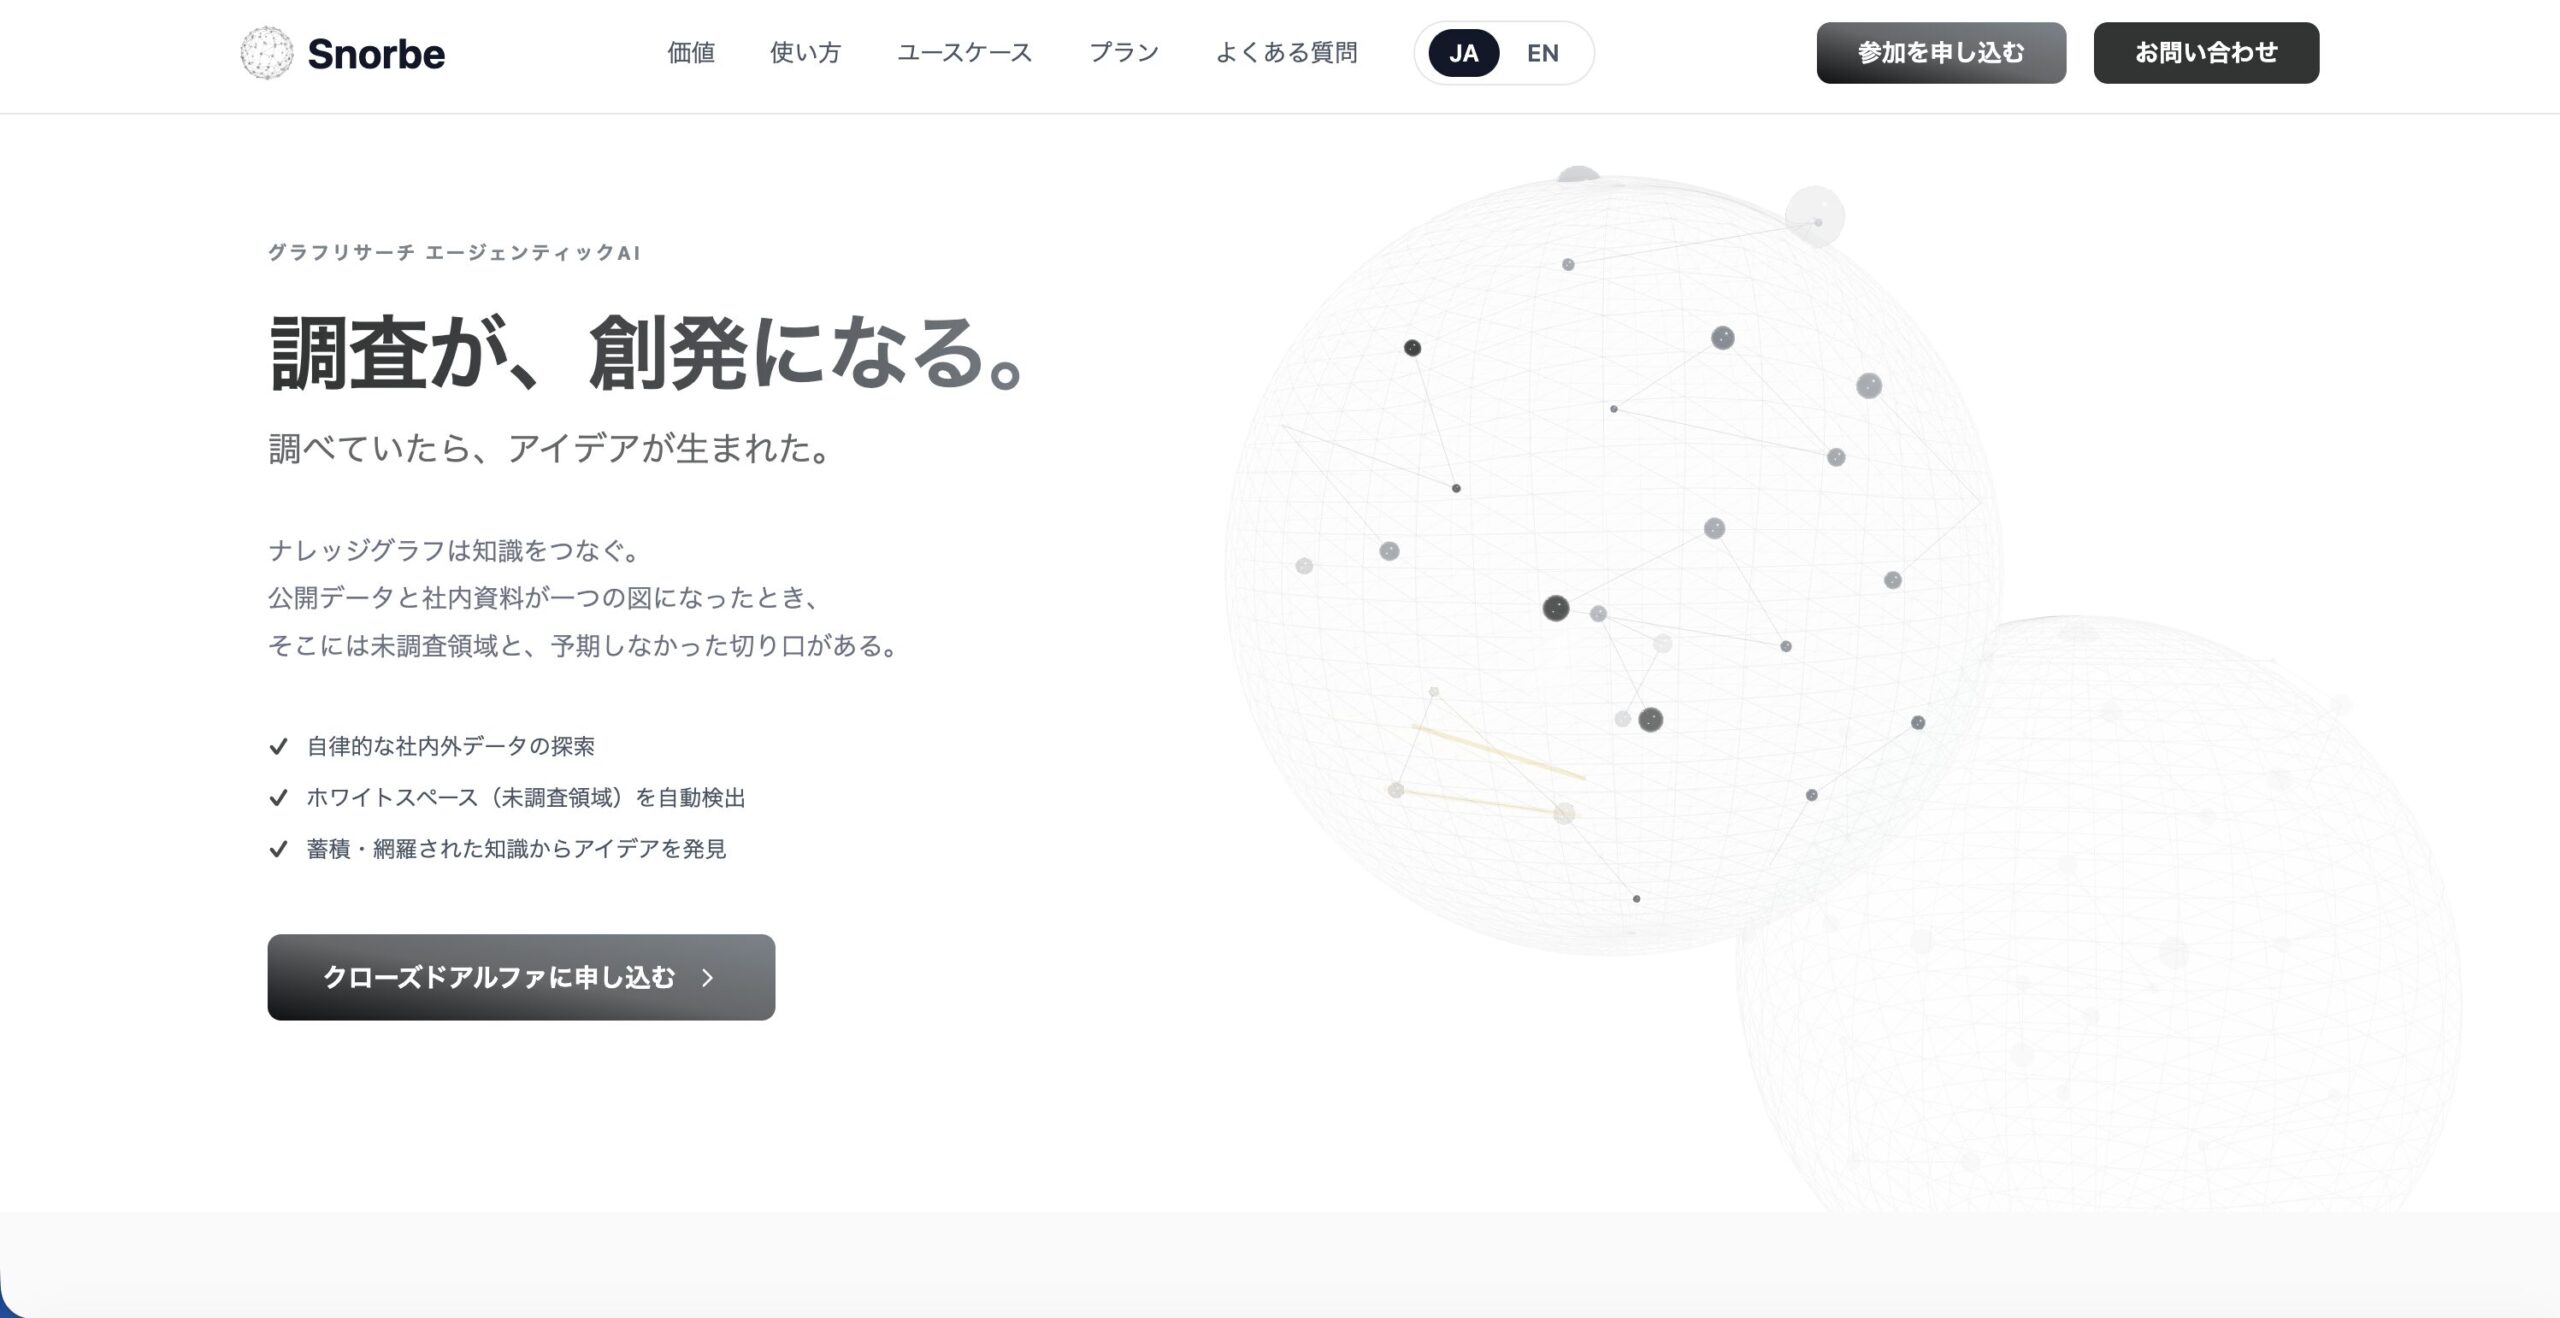
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント