会議の議事録や企画書を生成AIに要約させたいとき、手元の資料をそのまま入力してよいか迷うことがあります。入力したデータをAIの改善に使わない「学習オフ」を選べば安全だと思われがちですが、この設定だけで会社情報を無条件に入力できるわけではありません。
学習オフは、AIの機能を向上させるためにデータを利用することを防ぐだけの仕組みです。外部のサーバーに情報が保存される期間や、運営会社の人が中身を見る例外、別の会社へ処理を任せる条件などは別に残ります。これらを確かめずに機密情報を入力すると、情報を守るための法律や取引先との契約に反してしまう恐れがあります。
情報を外部のAIへ入力してよいかは、情報の性質ごとに社内で確認する相手を変えて判断します。情報の所有者や管理責任者が判断するほか、個人データや取引先の秘密情報が含まれる場合は法務や契約の担当者による確認も欠かせません。ここでの法務確認は、現場が判断を丸投げして結論をもらうためのものではなく、入力禁止の状態を解除する手続きとして扱います。
この記事では、公開資料から導ける標準運用を示します。情報の種類ごとに入力可否を五段階で決め、個別契約の文言や処理経路が標準条件と異なる場合だけ、法務がその差分を確認します。
まずは、なぜ学習オフにするだけでは入力してよいかを決められないのかを説明します。
学習オフだけでは入力可否を決められない
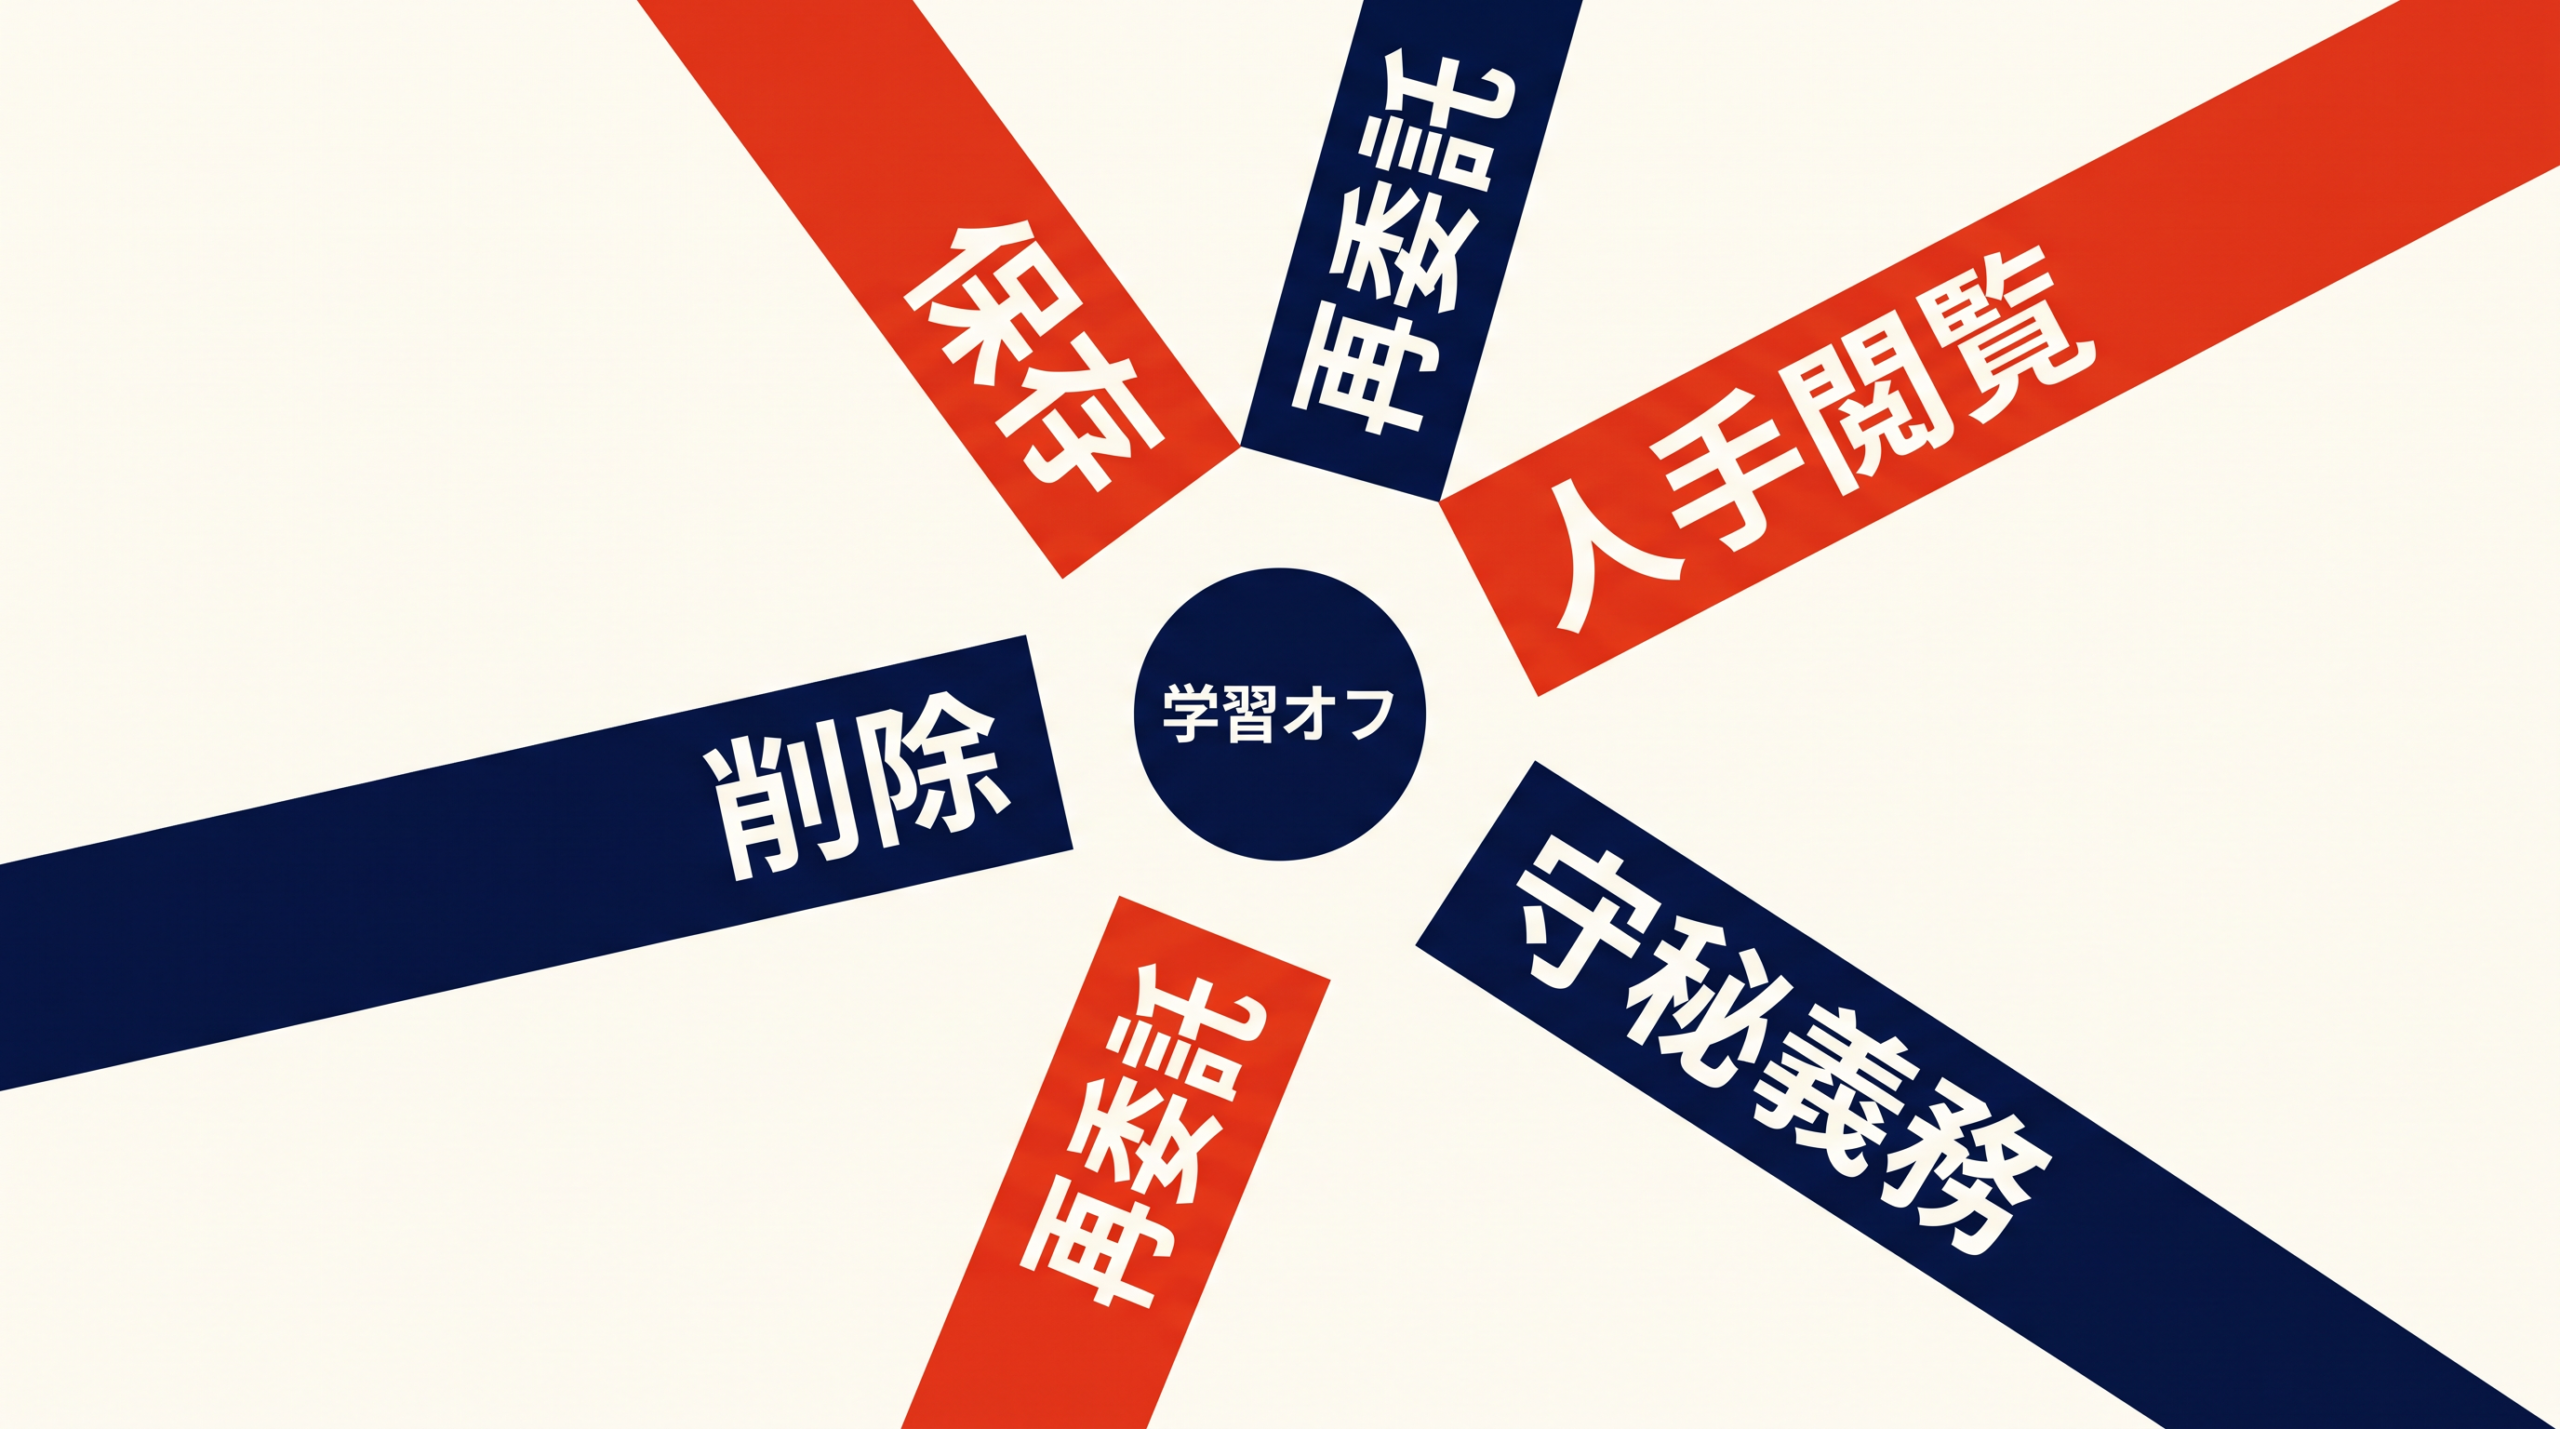
生成AIの設定でデータの学習利用をオフにしても、それだけで会社情報を入力してよいとは限りません。「学習に使わない」という設定は、入力した内容やAIの回答を基盤モデルの改善に回さないという意味にすぎないからです。
たとえばChatGPTには、過去の会話情報を後の回答の個人化に使うメモリ機能がありますが、これはモデル改善のための学習設定とは完全に別の機能です。そのため、メモリを無効化しても学習オフにはならず、逆に学習利用をオフにしても、会話履歴の保存やメモリ設定は有効なまま残ることがあるため、各項目を別途確認する必要があります。
学習利用をオフにしても、クラウドサービスとしてのデータ取扱条件は別に残ります。入力したデータがサーバーに保存される期間や、運営会社の担当者が中身を見る例外、運営会社がデータ処理を別の会社へさらに任せる「再委託」、そして契約上の守秘義務があるかといった項目です。
たとえばOpenAIの個人向けサービスでは、学習利用をオフにしてもデータは削除されるまで保存されます。また、削除後は、原則30日以内に消去されます。
さらに、不正利用の調査やユーザーへのサポート、法令への対応といった目的でデータにアクセスする例外が残ります。この際、権限を持つ限定された担当者や守秘義務を負う委託先が閲覧します(OpenAIの消費者サービスデータFAQ、チャットとファイルの保持方針)。
Googleの個人向けGeminiアプリも、学習停止とデータ保持が別条件である点は同様です。設定でアクティビティを無効にしても、AIが応答を提供し、安全を確保するための一時的な保持は残ります(Gemini Apps Privacy Hub)。
このように、学習に使わないことと、データが保存されず誰にも見られないことは、まったく別の条件です。個人向けプランで学習をオフにしただけでは、会社が保存や人手閲覧などを審査していません。この状態では機密情報を入力禁止とし、会社が利用環境を承認してから情報の種類ごとの判定へ進みます。
入力できる条件がそろうかを正しく判断するには、AIサービス側の規約や法人プランを確認するだけでは足りません。まずは、手元にある会社情報をその性質ごとに分けて考える必要があります。
会社情報を五つに分けて確認先を変える
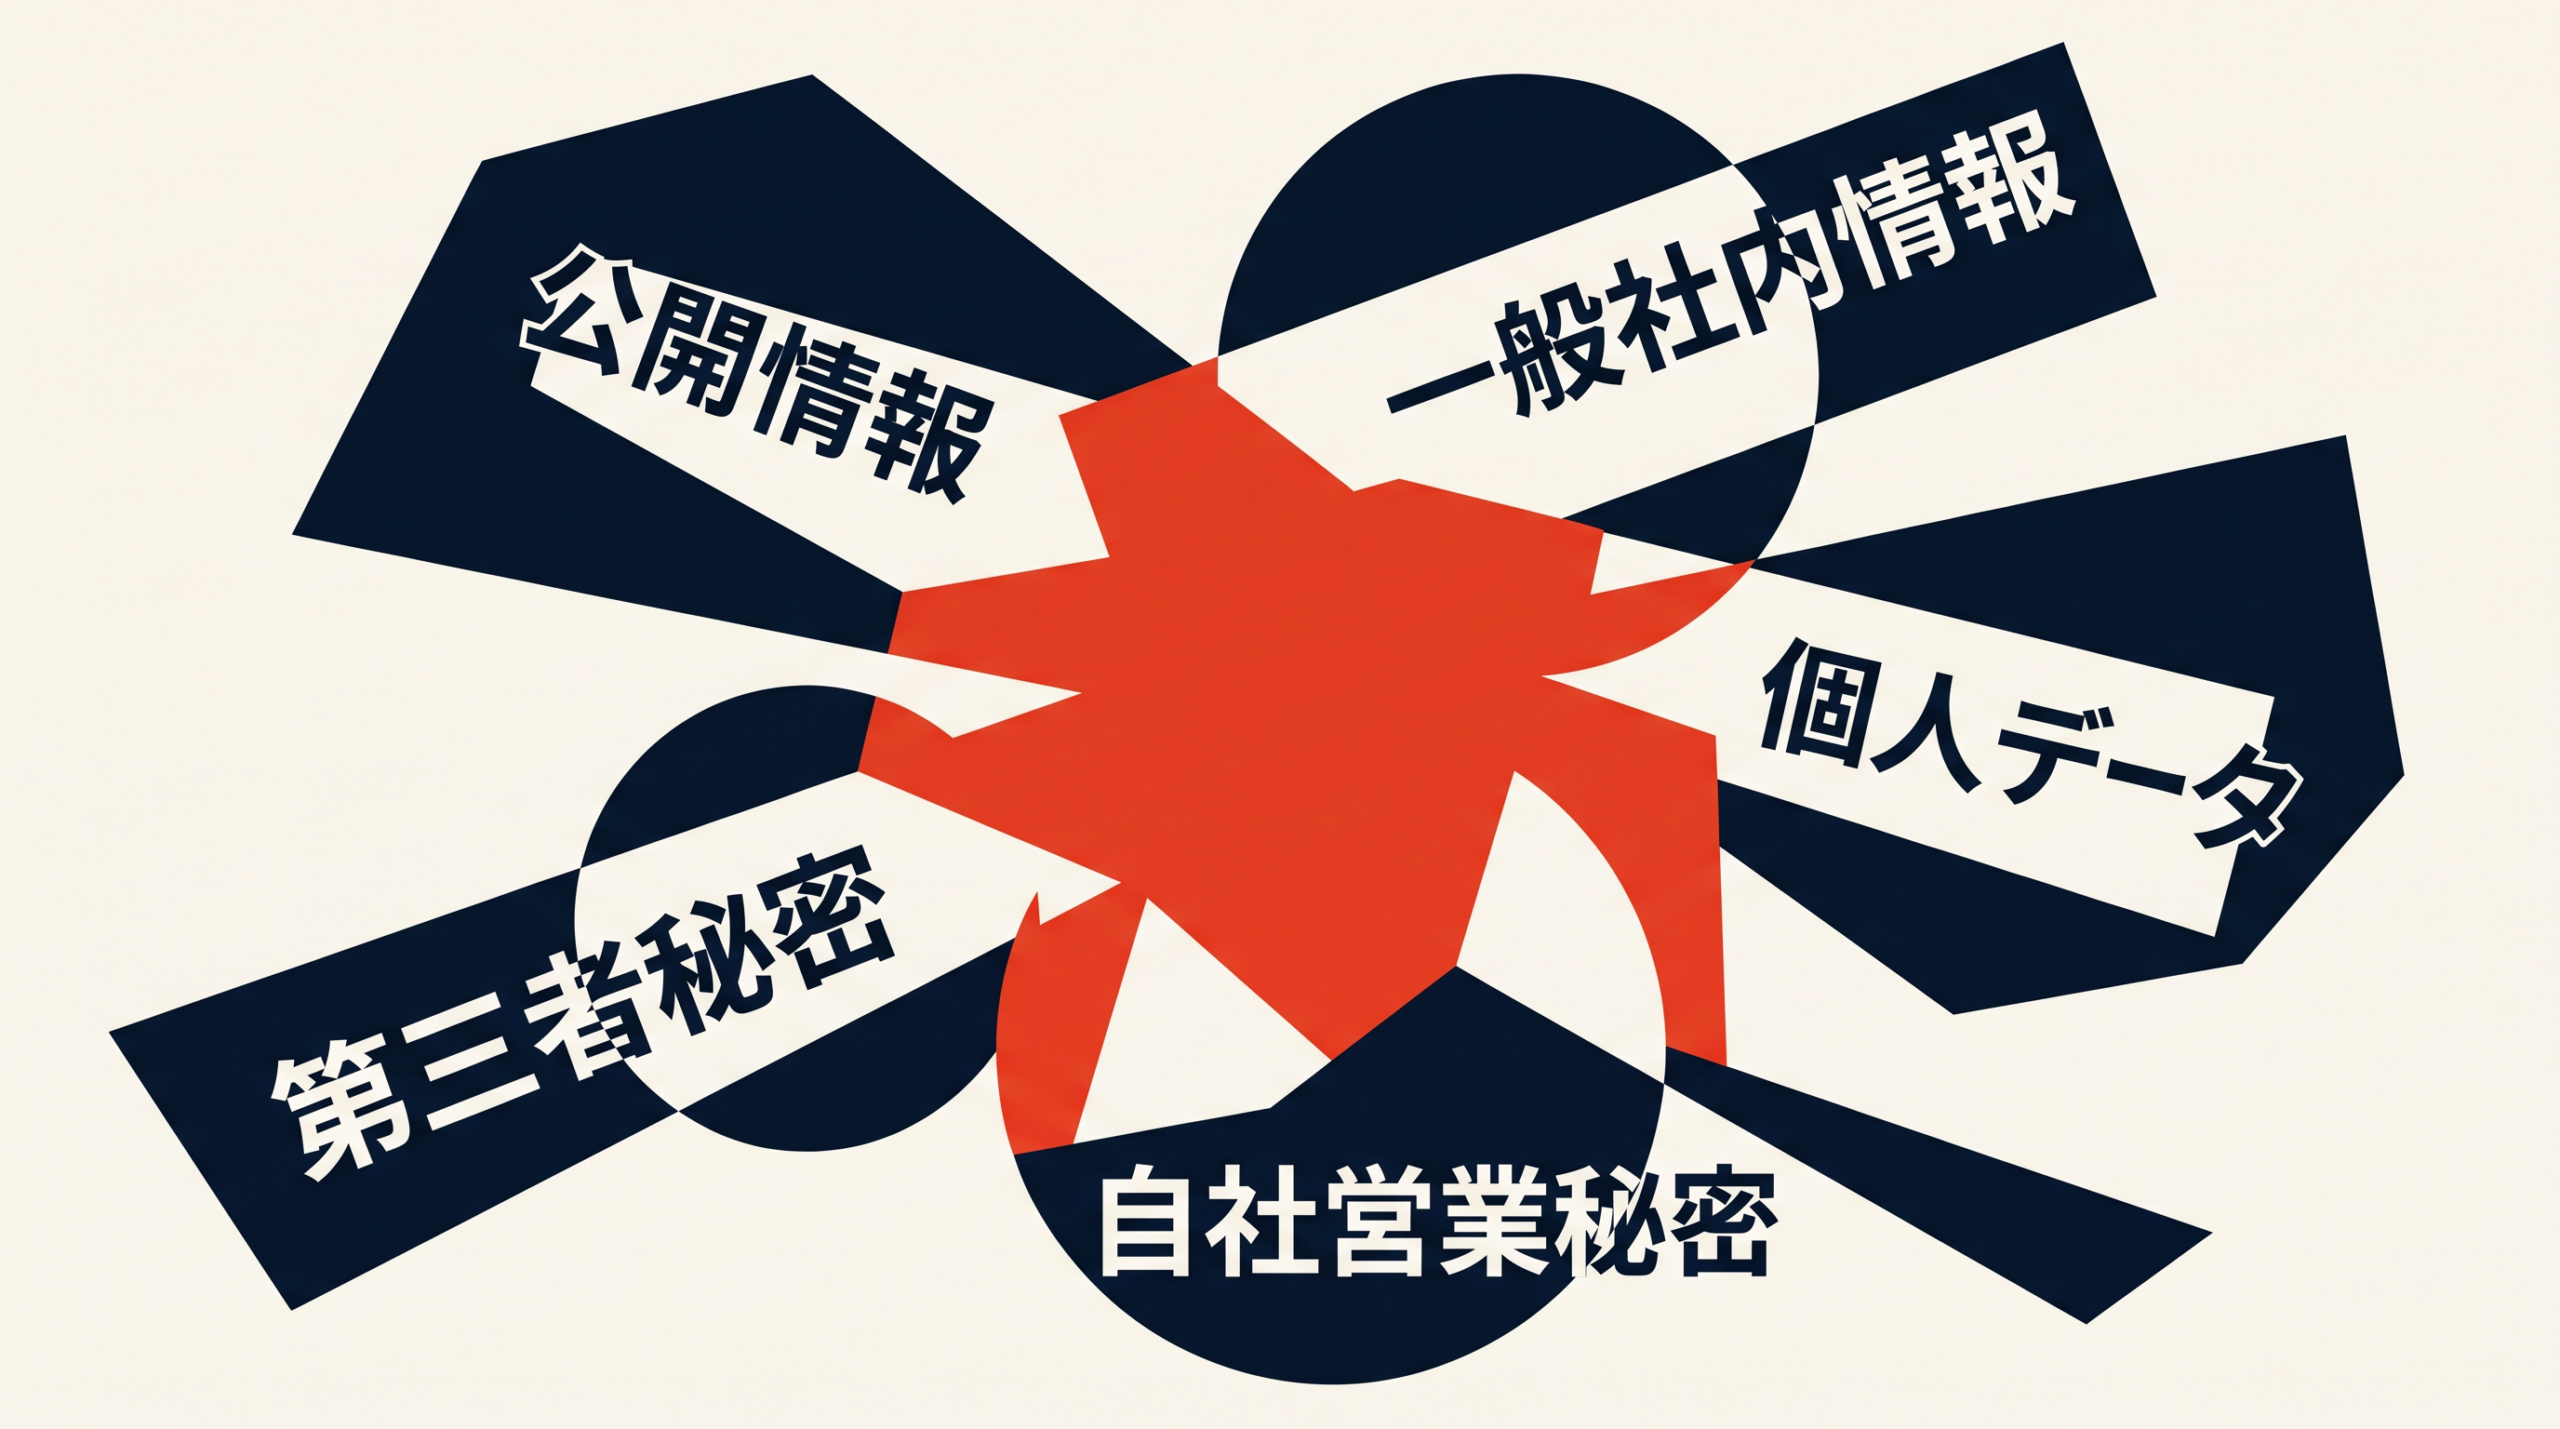
AIサービス側の取扱条件がわかっても、会社の情報を無条件に入力してよいわけではありません。入力する情報の性質や権利によって、確認すべき法律や社内の承認経路が異なるためです。
会社情報は五つに分けます。公開情報、一般社内情報、自社の営業秘密、取引先から預かった秘密情報、個人データです。一つの資料に複数の性質が含まれるときは、該当するすべての区分で「入力可」になった場合だけ入力します。一つでも条件を満たさない部分があれば、それが解決するまで資料全体の入力禁止とします。
一つ目は、会社のウェブサイトなどに掲載された公開情報です。公開された事実や数値だけであれば、元の利用規約やライセンスに反しない限り入力可となります。ただし、第三者が書いた文章や画像などの著作物をまとまった量で入力する場合は、利用許諾やライセンスの範囲内であることを確認できるまで入力禁止とします。
二つ目は、公開されていない業務手順や売上集計などの一般社内情報です。これらが個人データや秘密情報を含まない場合、会社が審査した利用環境で、情報の管理責任者と社内ルールが外部AIへの送信を許可していれば入力可となります。誰の管理する情報かわからない場合や外部送信の許可が不明な場合は、許可を確認できるまで入力禁止です。
三つ目は、自社の営業秘密です。これは、秘密として管理され、事業活動に役立ち、世間に知られていない情報を指します(不正競争防止法)。守秘義務のない個人向けのAIサービスでは、設定によらず入力禁止です。会社が承認した法人プランで、契約上の守秘義務、アクセス制限、操作記録などの条件がすべてそろい、情報所有者が用途を承認した場合だけ入力可となります。
四つ目は、業務委託などで取引先から預かった秘密情報です。元の契約に生成AIの利用や委託先への開示を認める明確な条項があるか、取引先から個別の書面承諾を得ている範囲内であれば入力可となります。どちらもない場合は入力禁止です。
法務や契約の担当者への確認は、元の契約に変更を加えて入力禁止を解除する手続きとして扱います。現場が判断を丸投げするためのものではありません。
五つ目は、氏名や連絡先、顧客の履歴といった個人データです。会社があらかじめ定めた利用目的の範囲外であれば、AIへの入力は禁止となります。
利用目的の範囲内であっても、すぐに入力してよいわけではありません。会社が自分で行うはずだった個人データの入力、要約、分類などの処理を、利用目的を変えずにAI提供者へ任せることを、法律上の「個人データの取扱いの委託」と呼びます。個人データを入力可能にするためには、AI提供者に対してこの委託が成立するかを確認する必要があります。具体的な条件を次で見ていきます。
個人データは目的・委託・国外処理を確認する
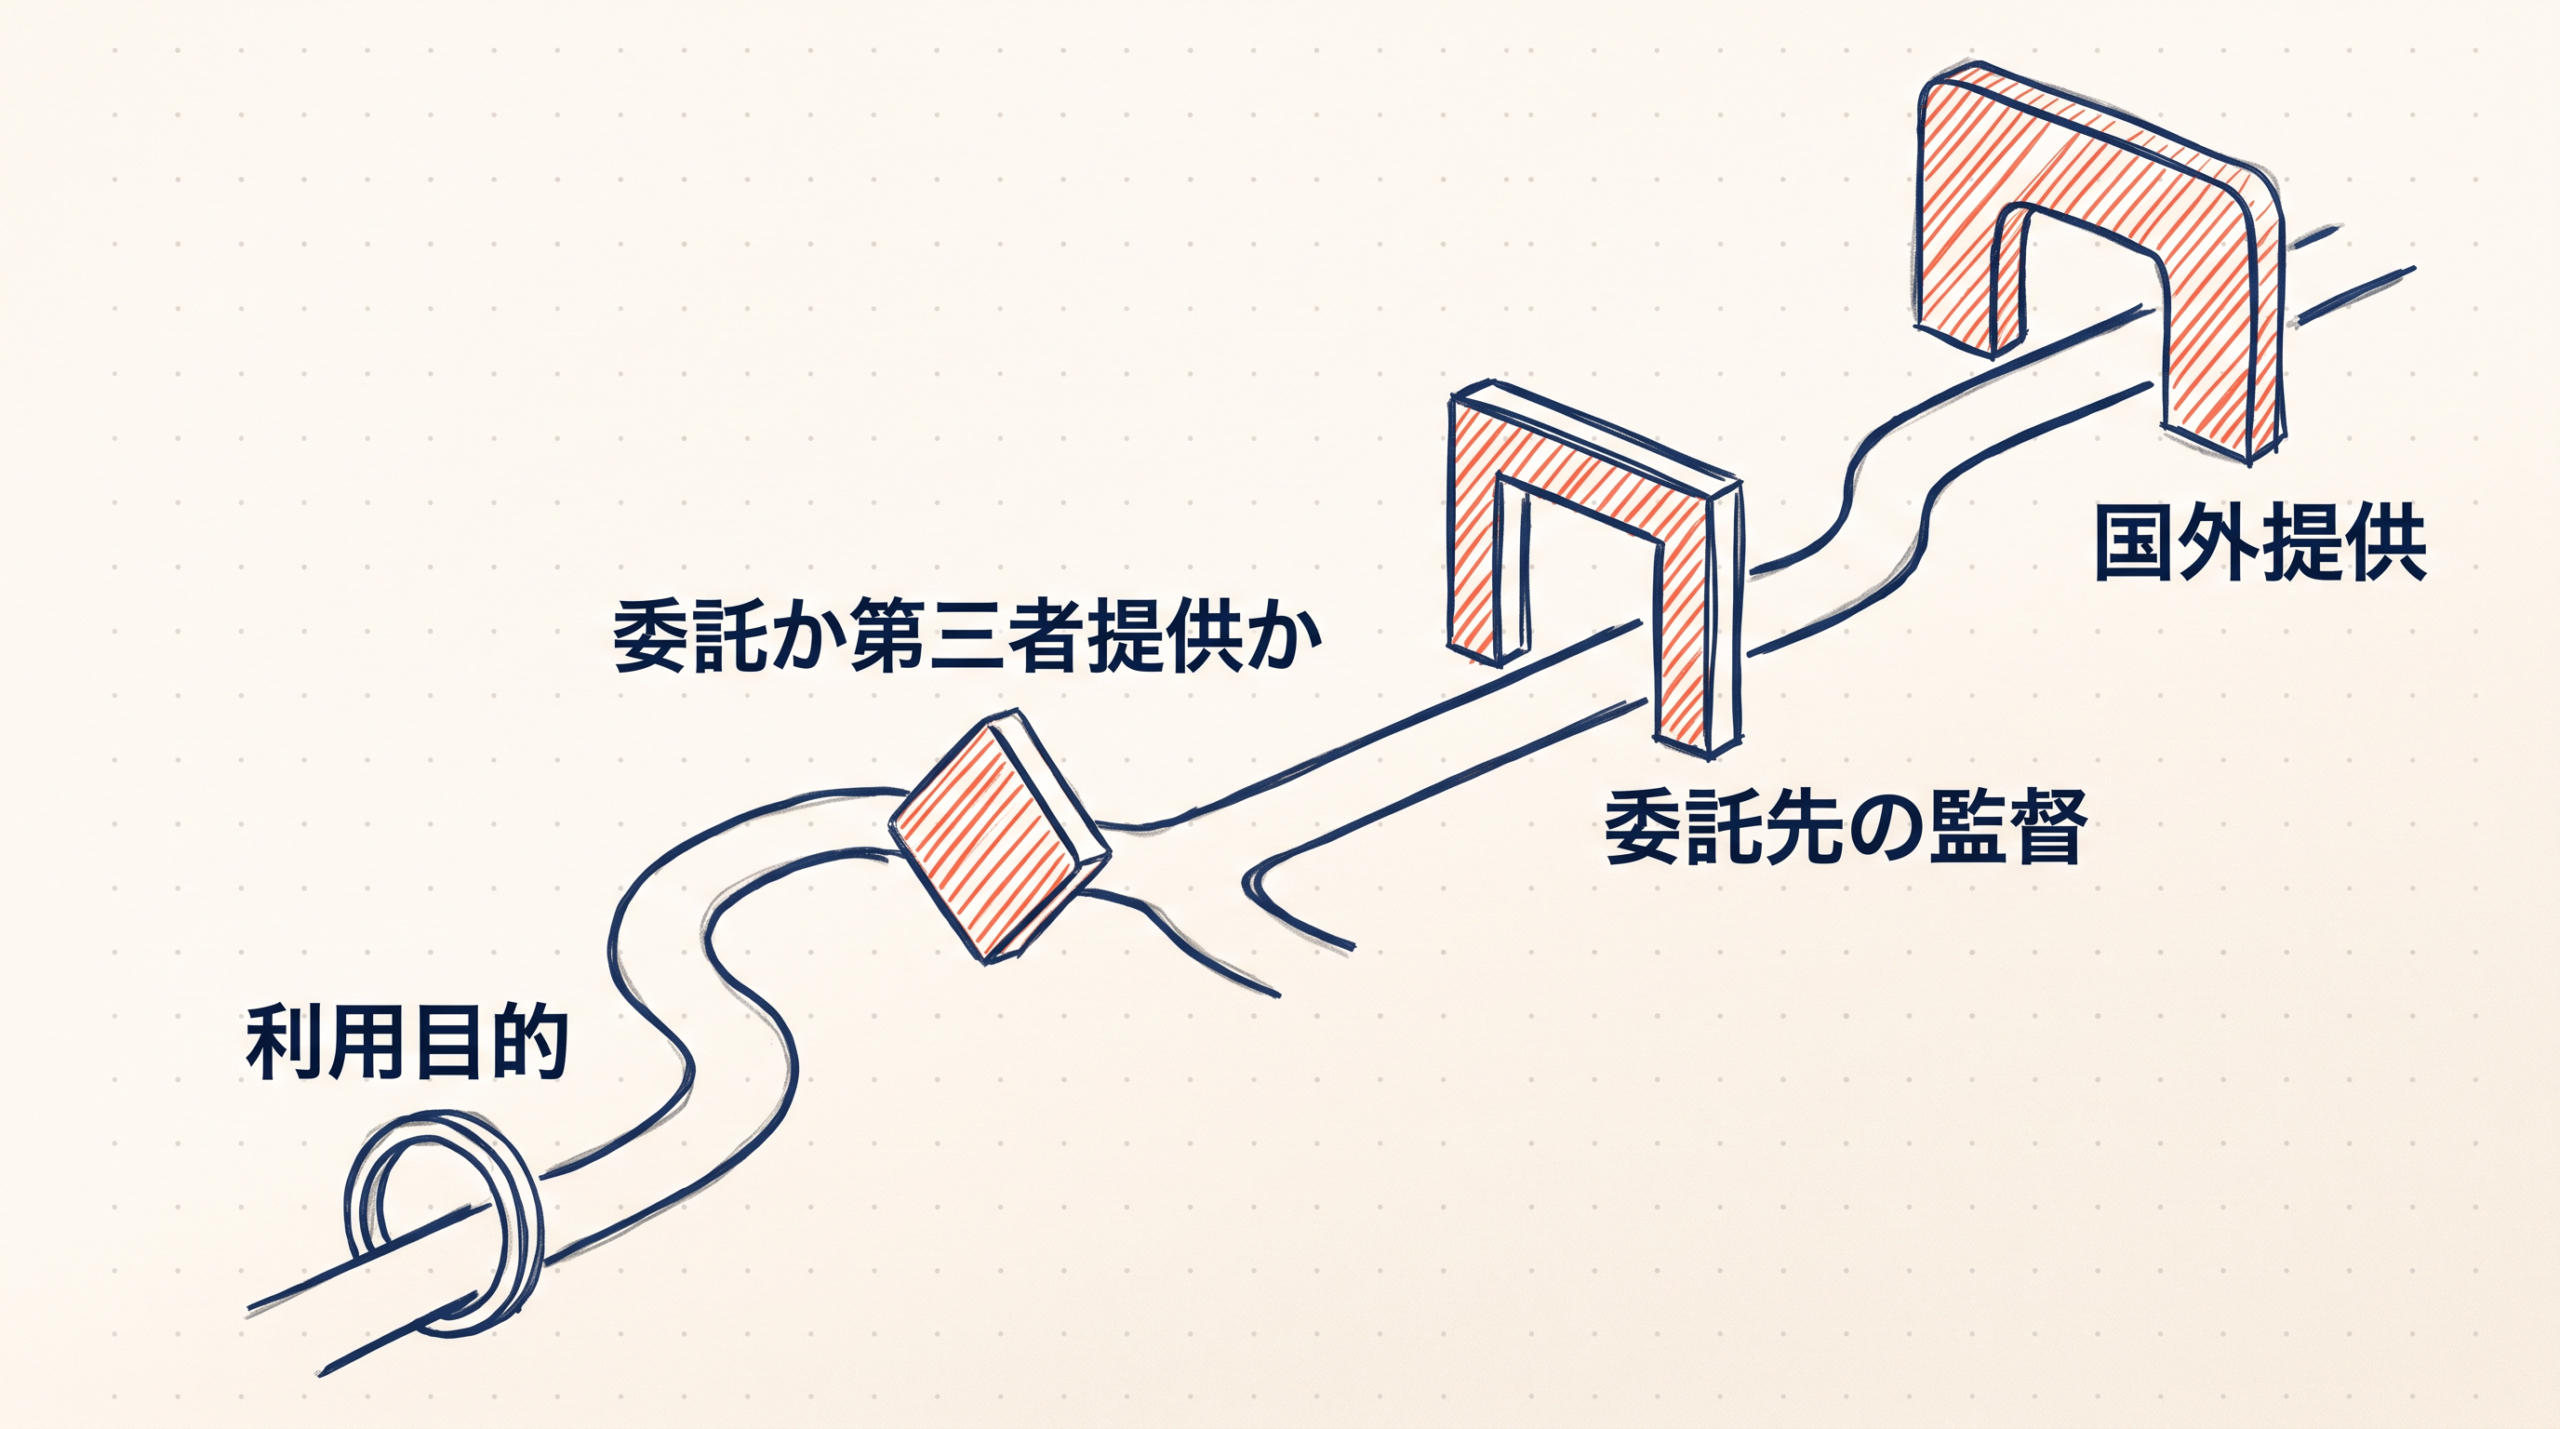
個人データをAIに入力するとき、個人プランと学習利用をオフにする設定を組み合わせただけでは入力可になりません。学習オフは新しい会話をモデル訓練へ使わない設定ですが、委託や国外提供の法的な条件まで満たすものではないからです。
最初に、AIによる要約や分類が、本人へ通知・公表した利用目的の範囲内かを確認します。範囲外なら、適法な目的変更と必要な通知・公表を終えるまで入力禁止です。個人情報保護法は利用目的を特定し、その範囲内でデータを扱うよう求めています。
法律上の「個人データの取扱いの委託」が成立するためには、AI提供者が、任された処理の範囲内でだけ個人データを扱い、独自の目的に利用しないことが前提となります。
この委託の条件を満たす場合、法律は外部企業への個人データの送信を、通常の第三者提供とは区別して扱います。その結果、会社がAIへ処理を任せることだけを理由に、第三者提供について本人から同意を取り直す必要はありません。
ただし、同意の取り直しが不要になるだけであり、個人データを適切に扱う責任がなくなるわけではありません。委託先の選定、契約の締結、データの安全管理、委託先への継続的な監督に関する責任は、引き続き会社に残ります。
AI提供者が入力内容を独自の目的で利用できる場合や、会社が必要な監督を行えない場合は、委託として扱えません。その場合は、本人同意など第三者提供の要件を別に満たさない限り入力禁止です。
委託の成否は、DPA(データ処理契約)という名称の文書があるかだけでは決まりません。個人情報保護委員会は、標準約款を審査し、その遵守によって安全管理を確保できるなら、追加の覚書は必須ではないと説明しています。国外で個人データを扱う場合は、委託と整理できても、国外提供の条件を別に確認します。
ChatGPT Businessなどの法人向けプランには、顧客の指示と守秘義務などを定める法人向け契約があります。安全管理、監査、副処理者についてはDPAが定めています。これに対し、ChatGPT Free、Plus、Proには個人向け規約が適用されます。
OpenAIの個人向け規約では、サービスの提供・維持・開発・改善や安全確保などにコンテンツを利用すると定めています。
不正利用やセキュリティ事故の調査、問い合わせ対応、法的問題への対応では、権限を持つ担当者やサービス提供者が内容へアクセスする場合もあります。会社の個人情報管理責任者と情報システム部門は、これらの利用目的とアクセス条件を許容できるか審査します。
個人データを扱うときは、自社が本人から直接取得したデータと、取引先から預かったデータを分けます。ここでいう一般的な個人データには、要配慮個人情報とマイナンバーを含めません。医療情報、営業秘密、契約上の秘密情報も対象外です。
自社が直接取得した一般的な個人データなら、会社自身が利用目的と委託先を決められます。ただし、会社が決めただけでOpenAIへの送信が委託になるわけではありません。規約上の利用目的が委託の範囲に収まると判断できた場合だけ、次の審査へ進みます。
個人情報管理責任者と情報システム部門は、対象となるプランとアカウントを特定します。そのうえで、保存期間と削除方法、人手で閲覧する目的、サービス提供者への再委託、安全管理措置を審査します。会社が許容基準を満たすと記録し、会社が管理するアカウントで必要最小限の項目だけを入力する場合は、個人プランでも入力可です。
取引先から預かった個人データでは、取引先が委託元、自社が委託先、OpenAIが再委託先になります。まず、取引先が本人へ示した利用目的と、自社が受託した業務の範囲内でAIを使うことを確認します。
次に元の契約が定める再委託手続に従います。契約に包括的な事前承認があれば、その条件と通知手続を守ります。個別承認が必要なら、OpenAIへ送る前に取引先の承認を得ます。契約で再委託が禁止されている場合や、必要な手続を終えていない場合は入力禁止です。
さらに、外国にある事業者がデータを取り扱う経路では、委託とは別に個人情報保護法第28条が定める国外提供の条件を満たします。外国法人という名称やサーバー所在地だけで決めず、契約当事者、委託先の所在地、実際の処理地域を特定します。
通常の業務では、提供先が同等水準国にあるか、相当措置を継続する体制を契約で確保できるかを確認します。どちらにも当たらない場合は、提供先の国や保護措置を本人へ知らせ、国外提供について同意を得ます。適用する経路を会社の個人情報管理責任者が確定するまでは入力禁止です。
判断過程を表にすると、次のようになります。
| 入力する状態 | 結論 | 結論までの理由 |
|---|---|---|
| 従業員が個人プランで学習オフを選んだだけ | 入力禁止 | 学習停止しか確認しておらず、利用目的、委託先監督、国外提供を確認していないため |
| 自社が本人から直接取得した一般的な個人データ | 条件を満たした後は入力可 | 委託と整理でき、会社の責任者が利用目的、規約、安全管理、国外提供、必要最小化を承認した場合に限るため |
| 取引先から預かった一般的な個人データ | 条件を満たした後は入力可 | 元の利用目的と受託業務の範囲内で、元契約が定める包括承認・通知・個別承認の手続と監督を完了した場合に限るため |
要配慮個人情報は取得時の同意と委託後の管理を分ける
病歴や健康診断結果、診療・調剤・保健指導の内容などは要配慮個人情報です。障害、人種、信条、犯罪歴なども含まれます。不当な差別や偏見につながらないよう、特に配慮が必要な情報だからです。取得時は、法律で定められた例外を除き、本人の事前同意を得るのが原則です。
ただし、要配慮個人情報だからといって、法律が生成AIへの入力を一律に禁止しているわけではありません。会社がすでに適法に取得した情報を、通知・公表済みの利用目的内でAI提供者へ委託する場面もあります。
この場合、要配慮個人情報であることだけを理由に、本人から新しい同意を常に取り直すわけではありません。委託に当たらず第三者提供になる場合は、本人同意など第三者提供の要件を満たす必要があります。
法律上一律禁止ではなくても、漏えい時の影響が大きいため、この記事では要配慮個人情報を厳格に扱います。会社が承認した環境でも、個人情報管理責任者の事前確認が必要です。
責任者は、利用目的と委託関係、安全管理と国外処理、保存と人手による閲覧、再委託を確認します。すべての条件を満たした場合だけ入力可とし、それ以外は入力禁止です。
医療情報では3省2ガイドラインも確認する
「3省2ガイドライン」とは、厚生労働省、総務省、経済産業省が所管する、医療情報システム向けの二つの安全管理指針の通称です。2026年9月時点で、医療機関等が参照する厚生労働省の現行資料は第7.0版(令和8年6月)です。医療情報システムやサービスの提供事業者が参照する総務省・経済産業省の現行資料は第2.0版(令和7年3月)です。
医療機関や薬局が、誰の情報か識別できる患者情報や診療記録を生成AIへ送る場合は、利用者側とサービス提供者側の双方を評価します。契約と責任分界、アクセス制御と操作記録、事故対応と再委託が3省2ガイドラインに沿っているかを確認します。
これらを評価できない一般消費者向けAIには、識別可能な患者情報を入力禁止とします。
一方、一般企業が保有する従業員の健康診断結果は要配慮個人情報ですが、健康情報を含むという理由だけで3省2ガイドラインが当然に直接適用されるとは限りません。誰が、どの業務とシステムで扱うのかを確認し、個人情報保護法に加えて労働安全衛生関係の規則や社内規程を適用します。
名前を消しただけでは匿名加工情報にならない
この記事で日常語として使う「匿名化」は、氏名の削除や置き換え、不要な列の削除といったマスキングやデータの最小化を指します。こうした作業は再識別の危険を下げますが、それだけで法律上の「匿名加工情報」になるわけではありません。個人情報保護委員会も、氏名などをマスキングしただけでは、加工基準を満たさない限り元の個人データのままだと説明しています。
名前を消しても、会社が対応表を持っている、元の顧客台帳と容易に照合できる、所属・役職・年齢・案件名の組合せから一人に絞れる場合、その会社にとっては個人情報または個人データとしての制限が残ります。社員番号を一定の計算や単純なハッシュで置き換えただけでも、元の番号を推測したり照合したりできるなら同じです。
「仮名加工情報」は、他の情報と照合しなければ本人を識別できないよう加工した情報です。ただし、作成した会社が元データや対応表を保有している場合、その会社にとっては通常なお個人情報に当たります。第三者提供も原則禁止されるため、生成AIへ自由に入力できる制度ではありません。
「匿名加工情報」は、本人を識別できず、元の個人情報を復元できないよう、個人情報保護委員会規則第34条の基準に従って加工した情報です。
加工では、①氏名や住所などの識別記述、②個人識別符号、③データ同士を結ぶ符号を削除または置換します。さらに、④珍しい属性などの特異な記述を削除または置換し、⑤データベースの性質に応じた追加措置を講じます。
氏名がなくても、希少疾患、非常に高い年齢、詳細な移動履歴や購買履歴が残れば本人を絞り込めます。この場合は、該当項目の削除や一般化が必要です。
匿名加工情報になっても、すべての義務がなくなるわけではありません。加工方法等情報の安全管理や、第三者提供時の項目と提供方法の公表が必要です。匿名加工情報である旨の明示や、本人を識別するための照合禁止も残ります。
現場担当者が氏名を伏せただけの資料を「匿名加工情報」と呼んではいけません。「マスキング済みだが個人データの可能性が残る資料」として扱い、個人データの条件を満たすまで入力禁止とします。
個人データの条件を確認しましたが、守るべき情報はそれだけではありません。次は、自社の営業秘密をAIへ入力する際の基準を見ていきます。
営業秘密は学習設定より管理の実態で見る
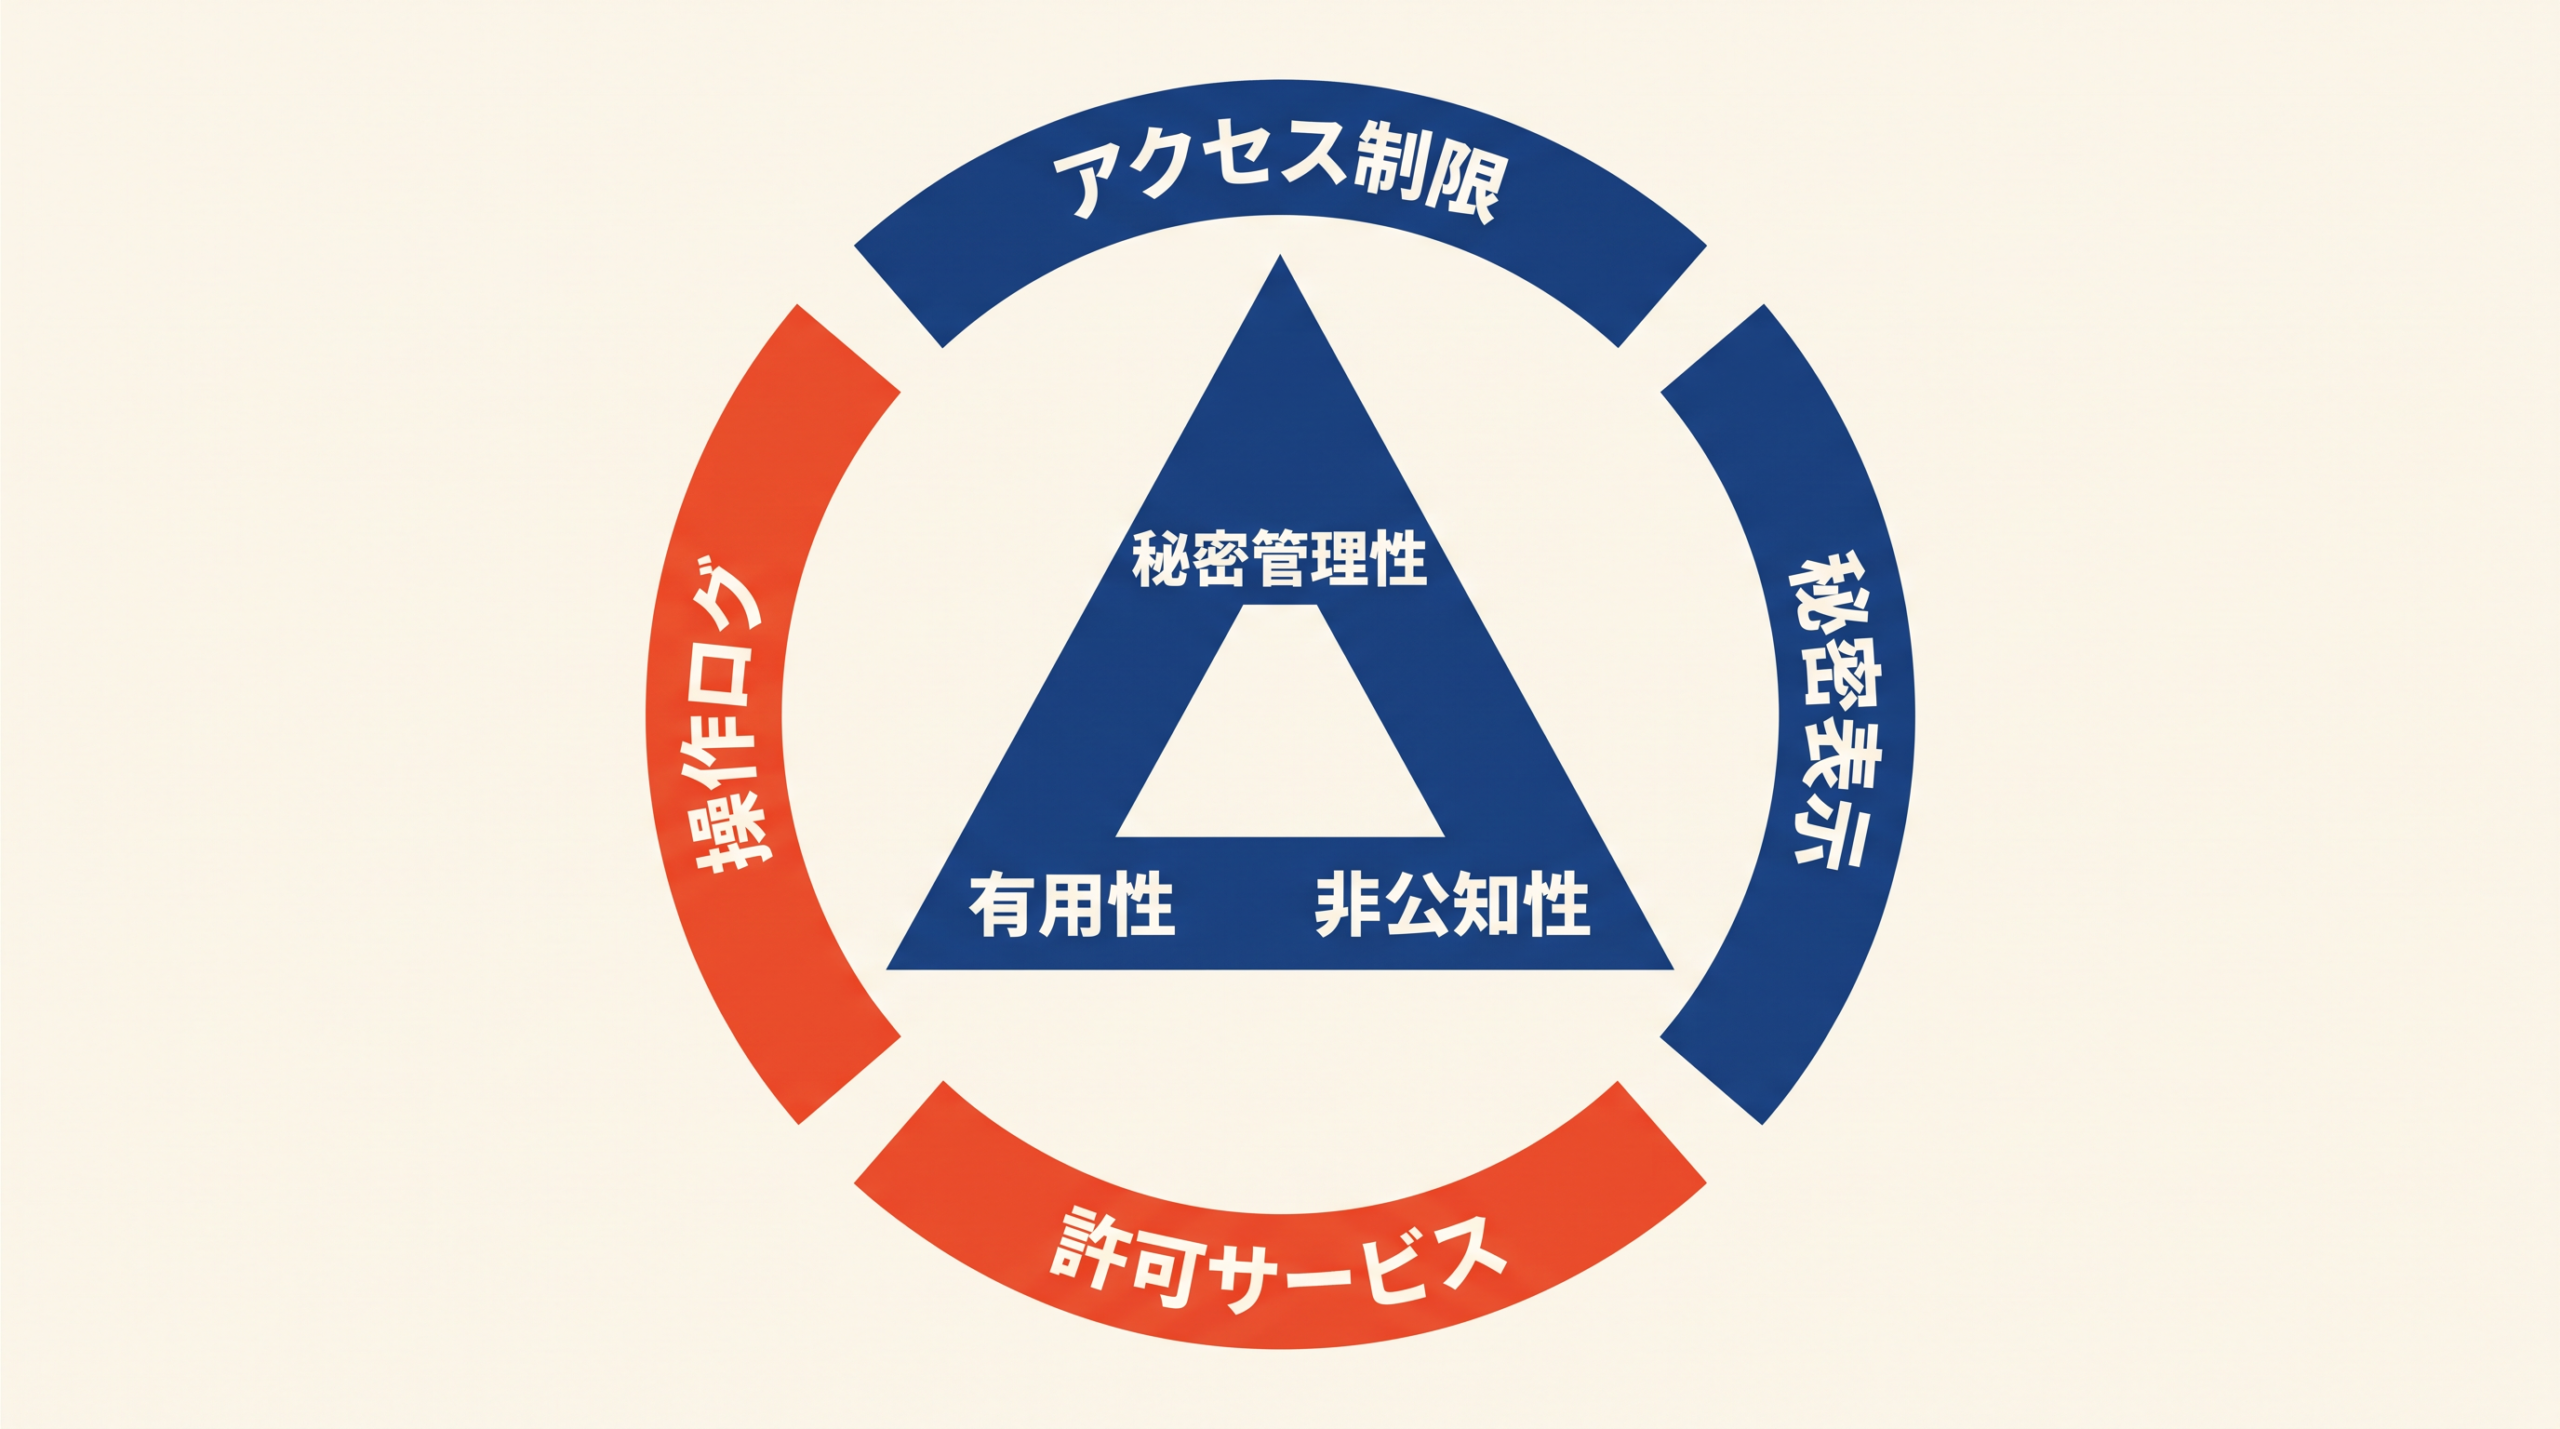
未公開の技術情報や顧客名簿などが法律上の営業秘密として守られるには、秘密として管理されていること、事業に役立つこと、世間に知られていないことという三つの条件を満たす必要があります。不正競争防止法は、営業秘密の要件を定めています。外部のAIに入力する場面では、このうち「秘密として管理されているか」が最大の焦点になります。
学習設定をオフにしただけで、自動的に秘密が守られるわけではありません。AIに情報を渡すときは、会社が秘密を守る意思を従業員に示しているかが問われます。経済産業省の指針も、秘密管理の意思が認識できる形を求めています。
そのため、守秘義務のない個人向けサービスや、社内で承認されていないAIへの機密情報の入力は禁止です。秘密の管理を崩す証拠になり得ます。
自社の営業秘密を扱うには、会社が事前に承認した法人向けの環境を使います。ただし、法人契約があるだけでは入力候補にすぎません。AI提供者の守秘義務に加え、アクセス制限と入力データの必要最小化が必要です。保存・削除、操作記録、事故対応の仕組みもそろわなければ入力禁止です。
これらの条件を満たし、情報を持つ担当者がAIに入力する用途を承認した後はじめて、自社の営業秘密は入力可となります。実態のある管理によって自社の情報を守る体制を確認した後は、取引先から預かった秘密情報をどう扱うかという次の判断に進みます。
取引先の秘密情報はNDAの文言へ戻る
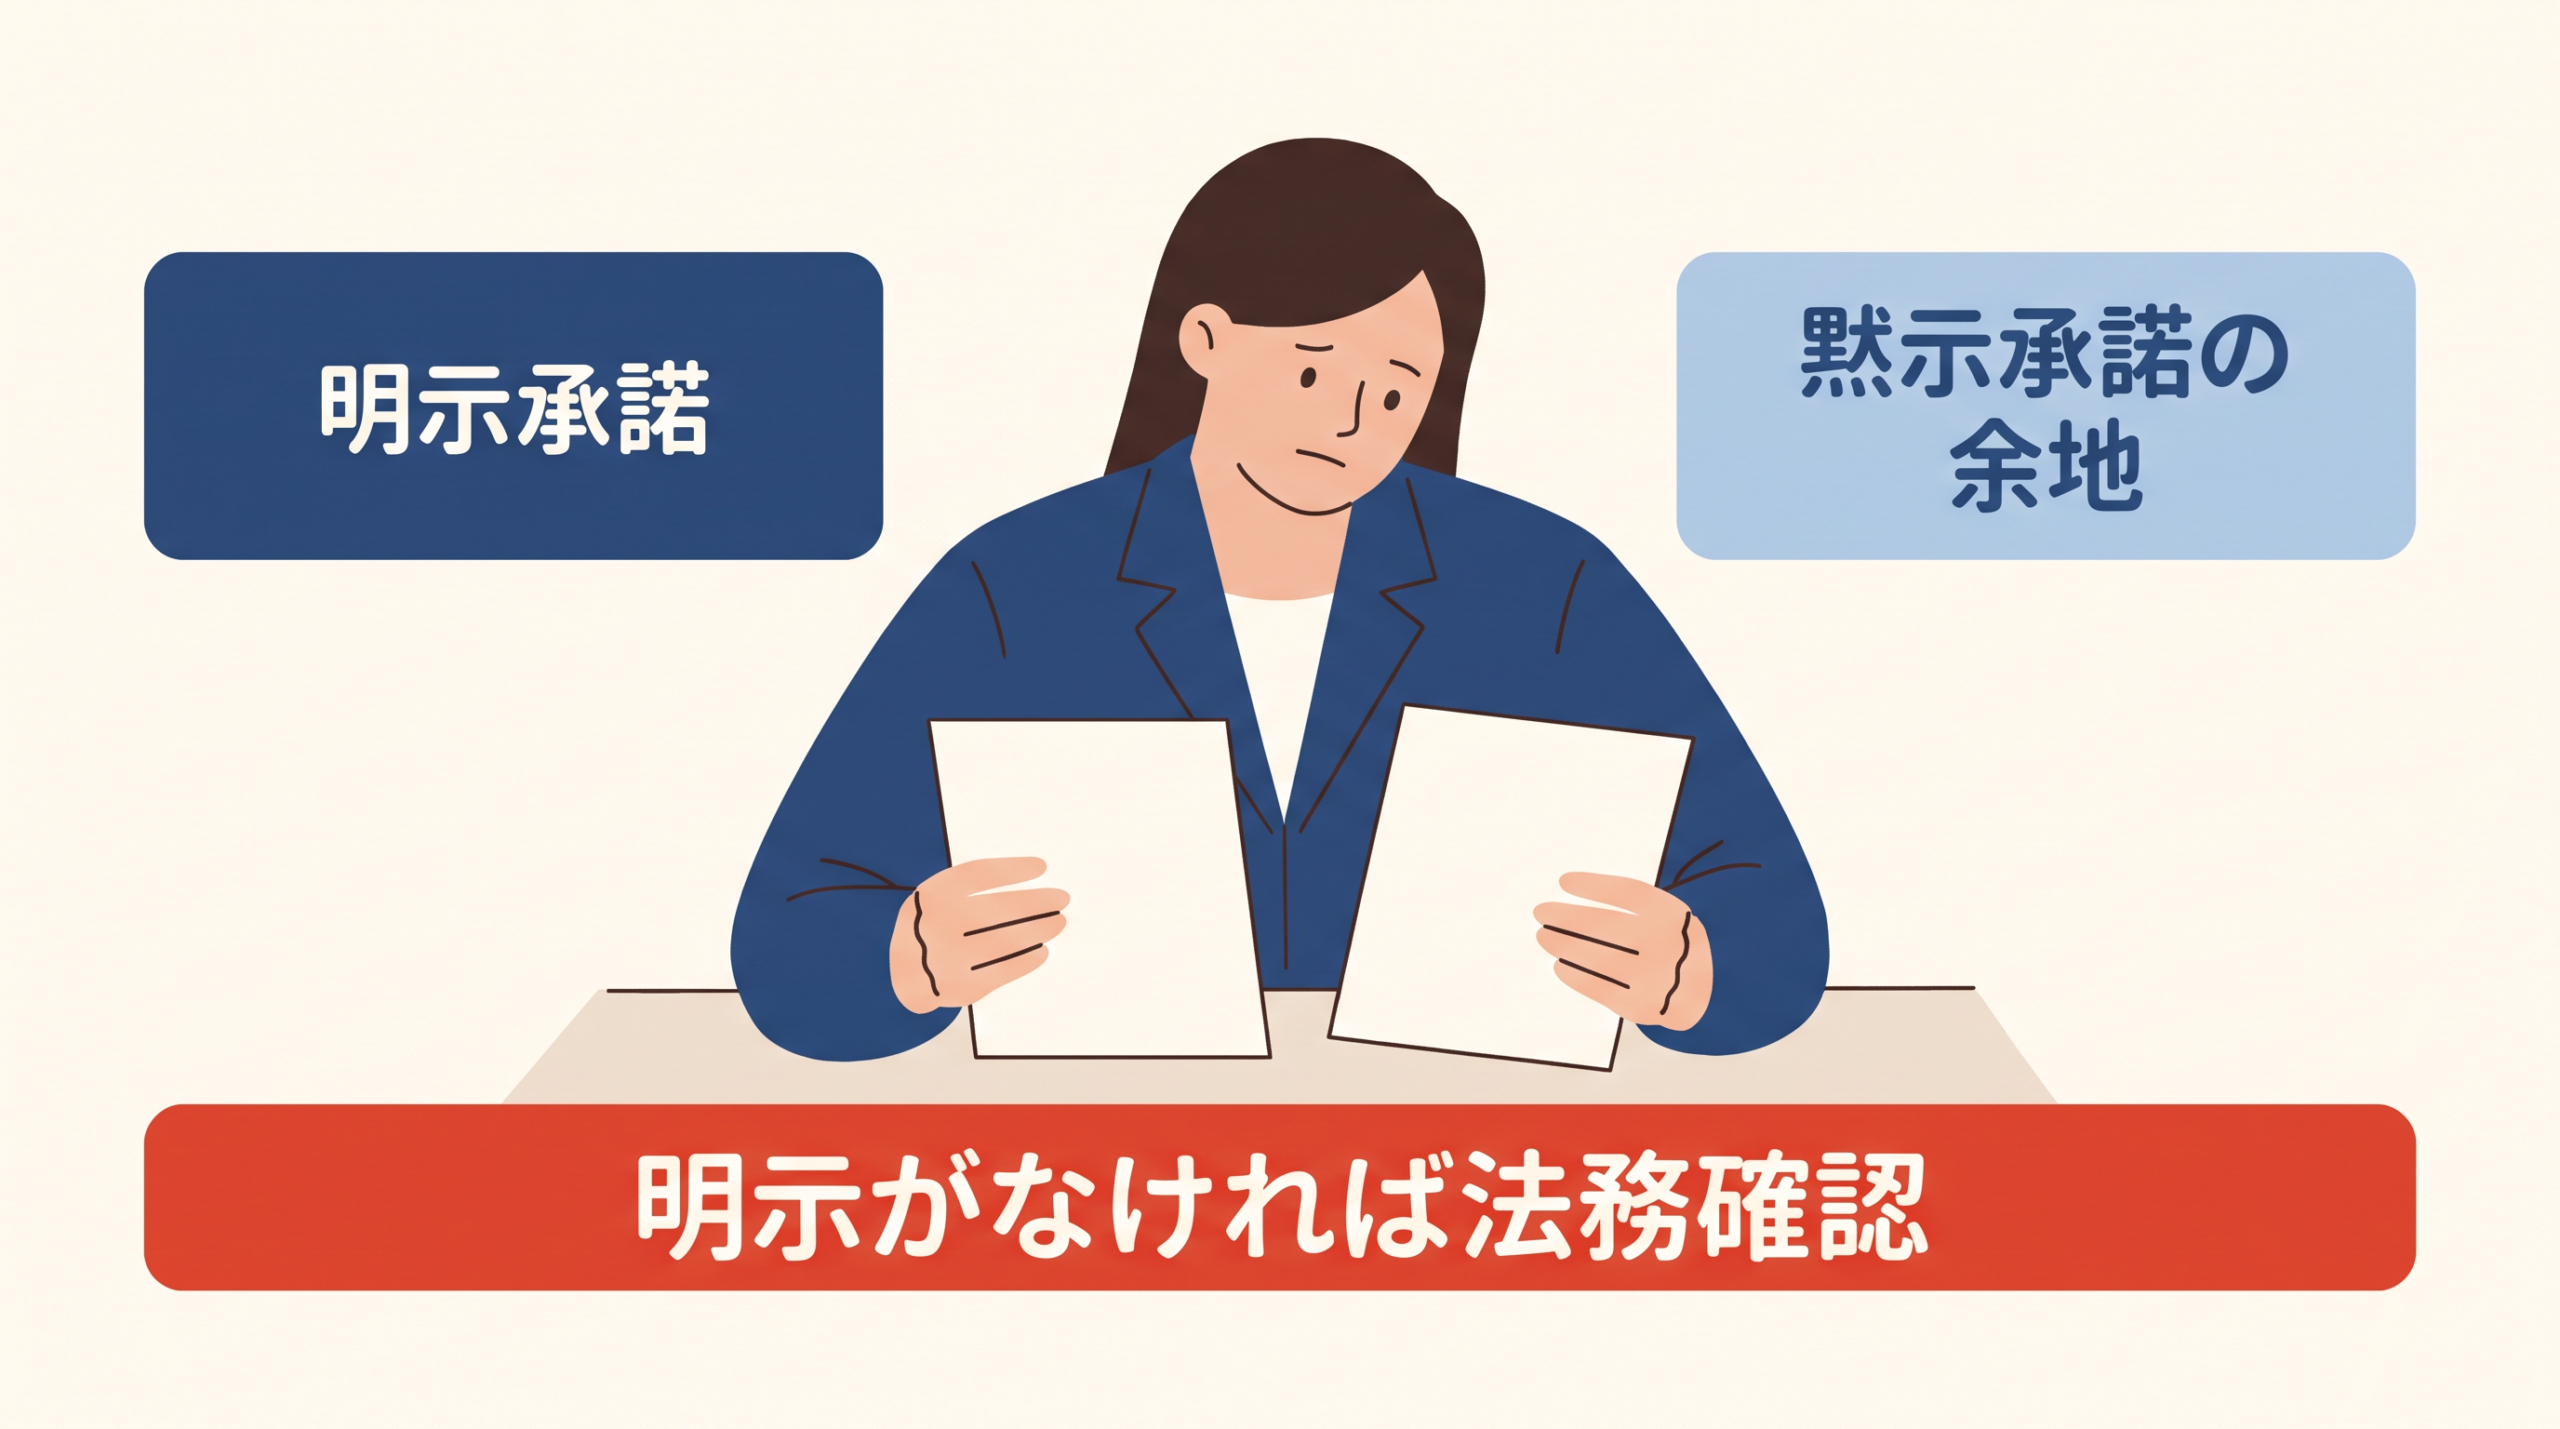
取引先から預かった秘密情報は、自社の判断だけで生成AIへ入力することはできません。AI提供者との間で守秘義務などの保護条件を整えても、それは自社とAI提供者の約束にすぎず、取引先との秘密保持契約(NDA)を守る責任を消すものではないからです。
専門家の見解でも、学習設定をオフにして法人向けプランを使うだけでは不十分だという点で一致しています。元の契約書に戻り、AIのサーバーへ情報を送ることが「第三者への開示」に当たらないか、要約や分析が「目的外の利用」に当たらないか、クラウド上のデータを消去できず「返還や削除の義務」に反しないかを確認しなければなりません。
意見が分かれるのは、取引先の承諾が明記されていない場合の解釈です。STORIA法律事務所の杉浦健二弁護士は、非学習や組織外への出力がないことなど複数の条件を満たせば、黙示の承諾が認められる可能性を論じています。
森・濱田松本法律事務所の田中浩之弁護士も、学習に使われないなどの条件から許容される可能性を示しつつ、実務のルールは確立していないと注意を促しています。
一方で、より厳格な立場があります。tAiL.法律事務所の原智輝弁護士は、通常のNDAにAI提供者への第三者開示を認める例外規定がない限り、取引先からAI入力の許諾を直接得る必要があると説明しています。
現場の実務では、明示的な許可があるかどうかで判断します。NDAや業務委託契約に生成AIの利用や委託先への開示を認める条項がある場合、または取引先から個別の書面承諾を得た場合に限り、その承諾の範囲内で入力可となります。
明確な条項や個別の承諾がない場合、契約条件が変わるまで入力禁止です。契約に書かれていなくても黙示の承諾が成り立つかを探る場合は、現場の判断だけで入力を進めません。
法務担当者が既存条項で許容されると確認できれば、社内の禁止状態を解除できます。契約変更や取引先の同意が必要な場合は、法務確認だけでは解除できません。必要な契約手続が完了するまで入力禁止です。
預かった情報を適切に保護できるかを確認した後は、同じAI製品であっても個人向けや法人向けなどの利用環境によって入力条件がどう変わるかを見ていきます。
同じ製品でも個人・法人・APIで条件が変わる
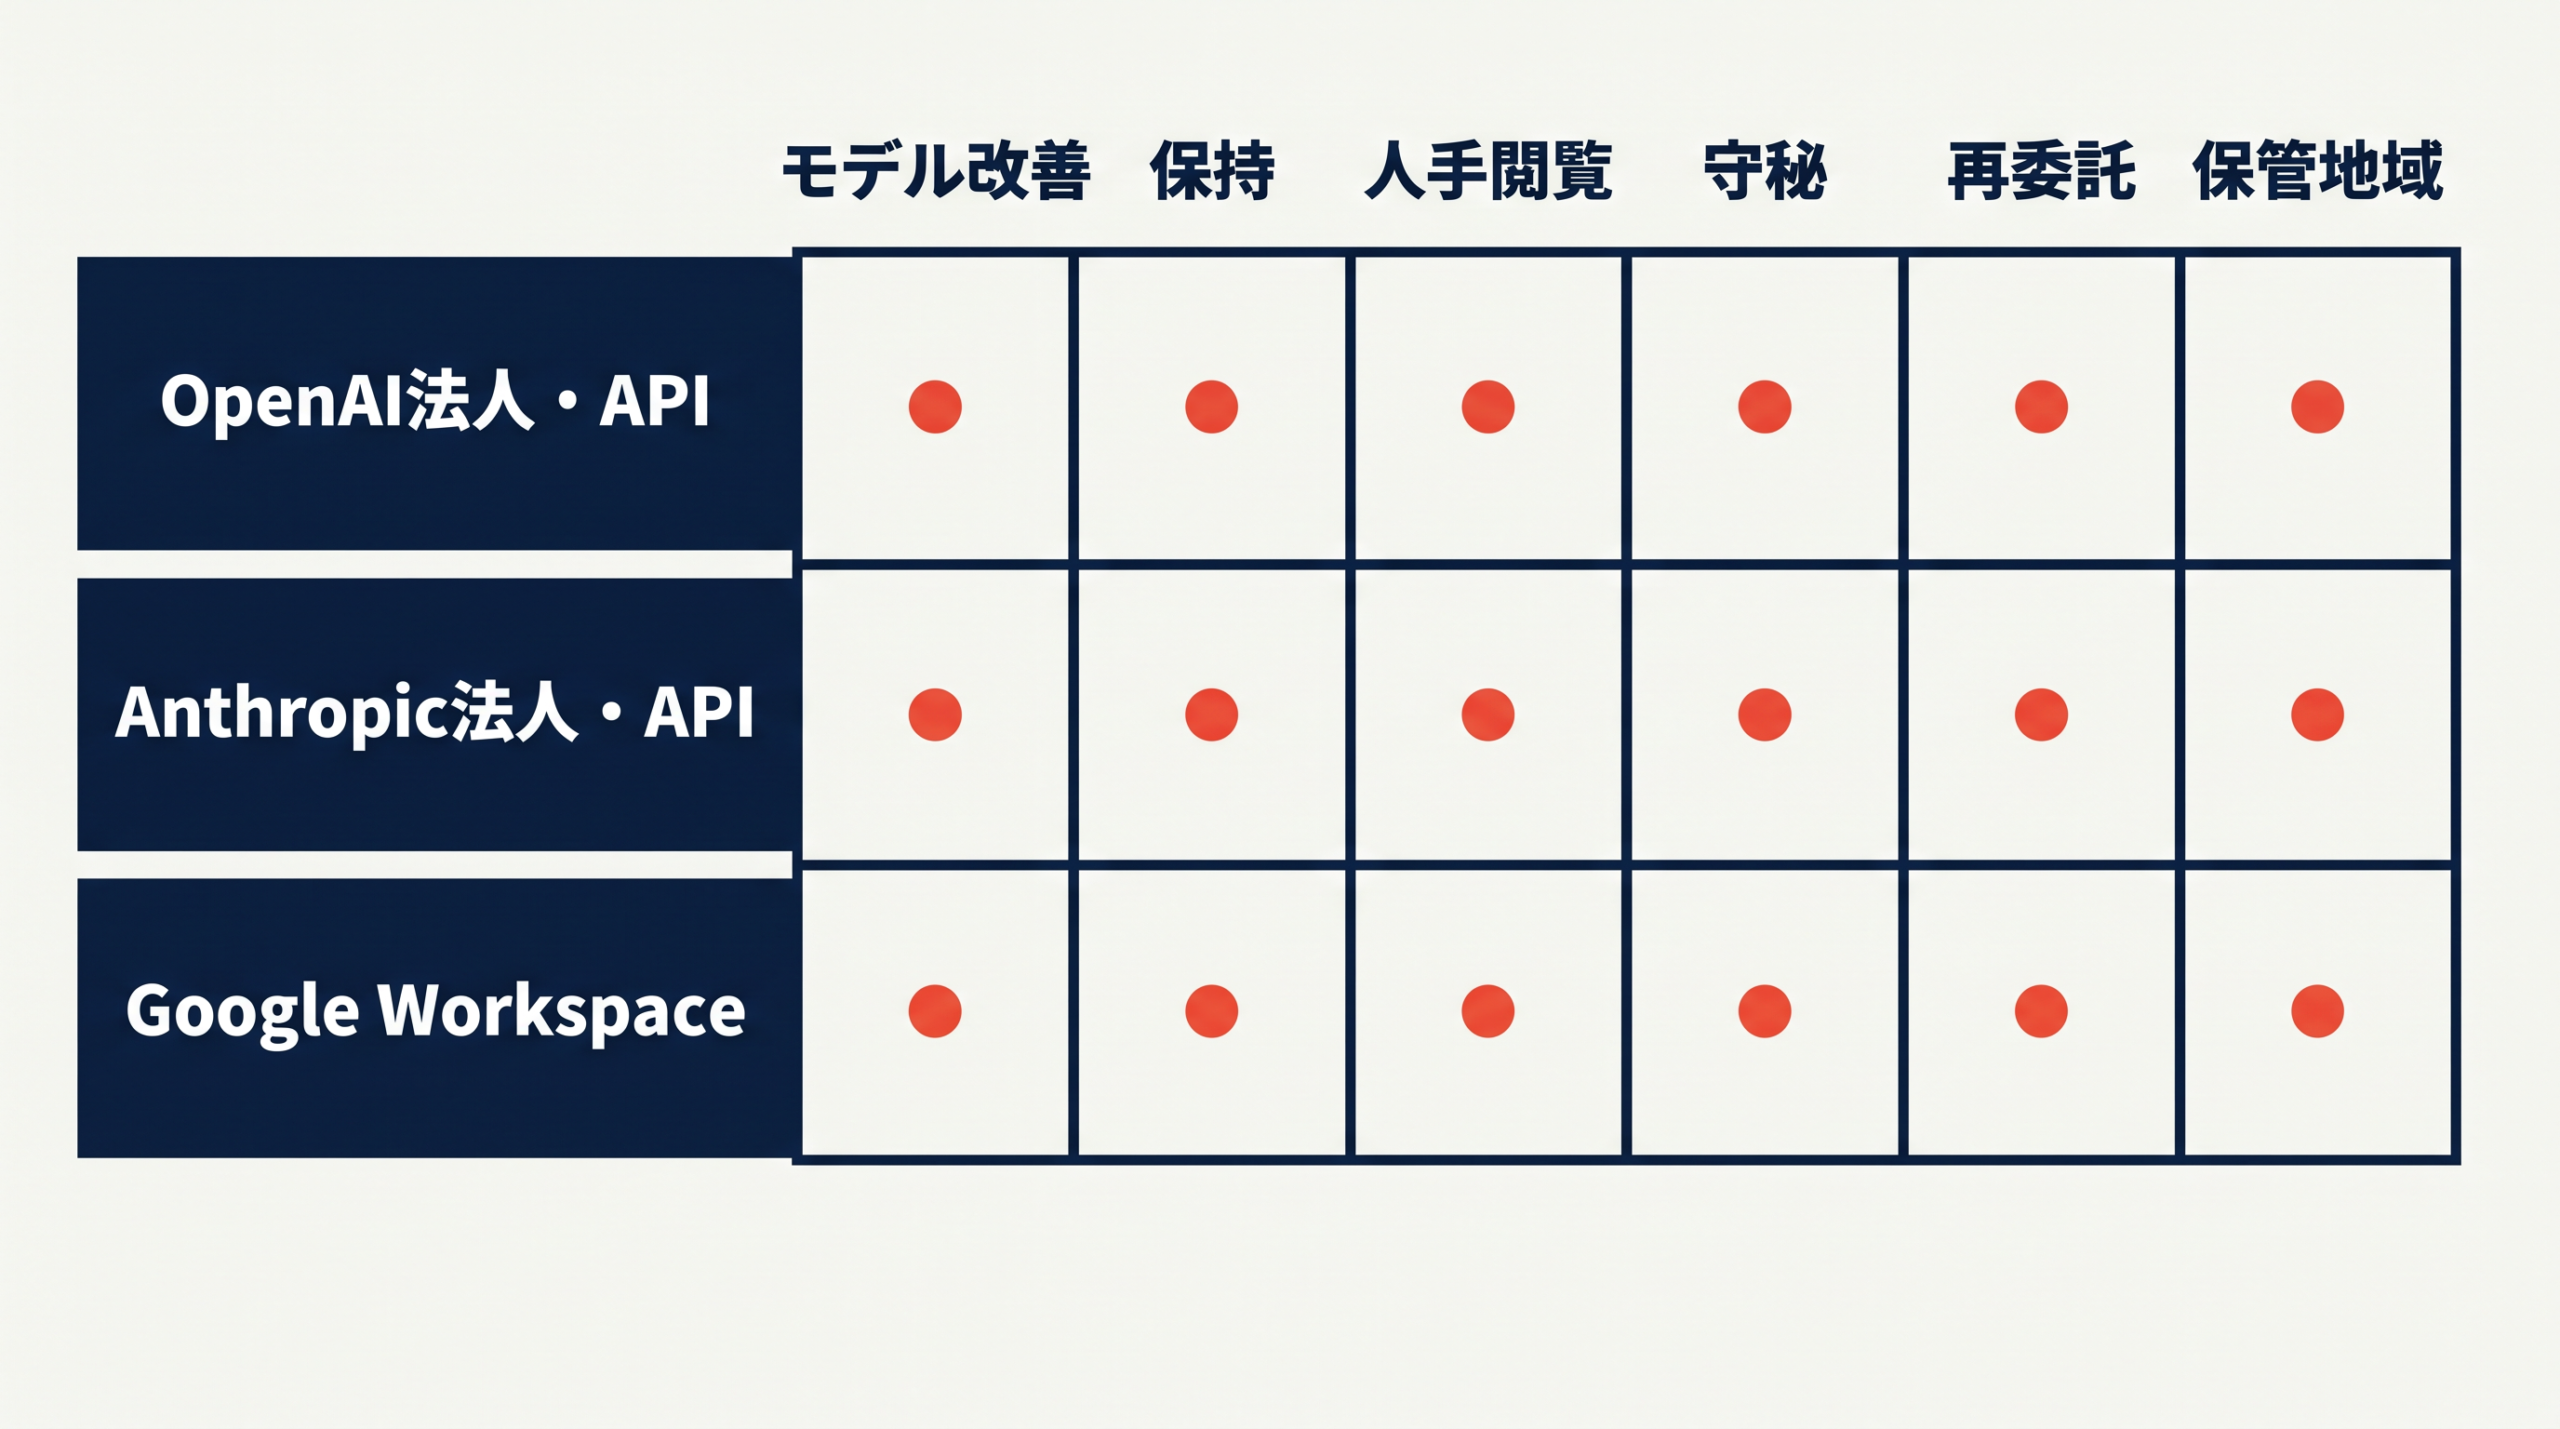
| 利用する製品 | 学習・目的外利用 | DPAの成立方法 | 保存・人手確認 | この記事の標準判定 |
|---|---|---|---|---|
| ChatGPT Free・Plus・Pro | 学習オフで通常のモデル学習を停止 | 通常の個人契約には法人向けDPAが適用されない | 履歴保存、安全・サポート・法令対応の閲覧が残る | 学習オフだけなら入力禁止。会社が個人向け規約を委託条件として正式採用した場合、自社取得の一般的な個人データは条件を満たした後は入力可 |
| ChatGPT Business・Enterprise | 既定で学習不使用 | OpenAIのフォームから締結 | Businessは削除まで保存。Enterpriseは管理者が保存期間を設定。支援、濫用調査、事故対応、法令対応などに限って人がアクセスする場合がある | 契約、利用目的、保存、再委託、国外処理などの条件を満たした後は入力可 |
| OpenAI API | 既定で学習不使用 | OpenAIのフォームから締結 | 濫用監視ログは原則最長30日。機能別の保存と人手確認の例外あり | 利用する機能の保存条件まで満たした後は入力可 |
| Claude Free・Pro・Max | 設定で通常のモデル改善を停止 | 通常の個人契約には法人向けDPAが適用されない | 削除後30日以内。安全審査、フィードバック、法令対応の例外あり | 学習オフだけなら入力禁止。会社が個人向け規約を委託条件として正式採用した場合、自社取得の一般的な個人データは条件を満たした後は入力可 |
| Claude for Work | 既定で学習不使用。顧客コンテンツは秘密情報 | Commercial Termsへの同意時に自動適用 | 会話は削除まで保存。Enterpriseは30日以上で管理者設定。Covered Modelsは安全上のフラグ時に限定レビューあり | 契約、利用目的、保存、再委託、国外処理などの条件を満たした後は入力可 |
| Anthropic API | 既定で学習不使用。顧客コンテンツは秘密情報 | Commercial Termsへの同意時に自動適用 | 原則30日以内。機能、安全審査、法令対応などの例外あり。Covered Modelsは安全上のフラグ時に限定レビューあり | 利用する機能の保存条件まで満たした後は入力可 |
| Gemini個人版 | Activityオフで通常のモデル学習を停止 | 通常の個人契約には法人向けDPAが適用されない | オフでも72時間保存し、安全目的の人手確認が残る | Activityオフだけなら入力禁止。会社が個人向け規約を委託条件として正式採用した場合、自社取得の一般的な個人データは条件を満たした後は入力可 |
| Google Workspace対象エディション | 許可なくドメイン外の学習・人手確認に使用しない | 対象契約にCloud DPAを組み込み | Workspace内の利用は90日から無期限。単独のGeminiアプリは最長36か月 | 契約、利用目的、保存、再委託、国外処理などの条件を満たした後は入力可 |
| Gemini API無料枠・無料AI Studio | 入力・出力を改善に利用し、人手確認も実施 | 業務データを処理するDPA経路なし | 改善目的の処理に加え、濫用監視用に55日間保存し、フラグ時は限定された担当者が確認 | 規約が個人情報・機密情報を送らないよう求めるため入力禁止 |
| Gemini API有料枠 | 入力・出力を製品改善に使用しない | Paid Services利用時にCloud DPAを適用 | 濫用監視用に55日間保存し、フラグ時は限定された担当者が確認。Groundingなど機能別の保存もある | 利用機能の保存条件まで満たした後は入力可 |
入力する情報の種類と守るべき法律を整理した後は、使うAI側の利用環境を判定します。同じ会社が提供する生成AIでも、個人プラン、法人プラン、APIのどれを使うかで契約内容が大きく異なります。
学習オフの機能を使うだけでは、会社の承認、利用目的、委託先監督、国外処理の条件を満たしません。NDA、営業秘密、著作権の条件も別に残ります。そのため、個人向けプランは学習オフだけなら入力禁止です。個人向け有料プランであっても、料金を払っただけでは法人向け契約の対象になりません。
ただし、日本法上はDPA(データ処理契約)という名称の文書がないことだけで、個人情報保護法上の委託が否定されるわけではありません。会社は、個人向け規約を委託条件として正式に採用し、安全管理、国外処理、継続監督の体制を整えます。この体制を説明できる場合、自社が取得した一般的な個人データは、すべての条件を満たした後は入力可として扱えます。
一方、法人向けプランや有料APIも、契約しただけで無条件に入力可となるわけではありません。回答生成、安全確保、法令対応などに必要なデータの処理や保存は残ります。取引先から預かったデータを入力する場合は、元の契約が定める再委託の承認条件も別に満たさなければなりません。
OpenAIはDPAフォームから締結する
OpenAIは、ChatGPT Business、Enterprise、およびAPIの顧客データを既定でモデル学習に使いません。これらの法人向けサービスには、法人向け契約とDPAが用意されています。会社の契約権限を持つ担当者が、OpenAI Enterprise PrivacyにあるフォームからDPAを締結する手続きをとります。
Free、Plus、Proの個人向け規約にある学習オフ設定は、新しい会話のモデル学習を止める機能であり、法人向けDPAを追加する手続きではありません。会社が個人向け規約と安全管理を正式に審査した場合、自社取得の一般的な個人データは条件を満たした後は入力可として扱えます。しかし、学習オフだけを設定した状態や機密情報は入力禁止です。
ここで入力禁止とする「機密情報」は、自社の営業秘密と取引先から預かった秘密情報です。一般的な個人データまで一律に含める意味ではありません。
ChatGPT Businessでは、会話やファイルなどを利用者が削除するまで保持します。Enterpriseでは管理者が保存期間を設定できます。削除したデータは原則30日以内に削除されますが、安全確保や法令対応などの例外があります(ChatGPTの保持方針)。
OpenAIの法人向けプライバシー説明では、人がアクセスする目的も製品別に示しています。Businessでは、権限を持つ従業員が技術支援、濫用調査、法令対応のためにアクセスする場合があります。守秘義務と安全管理義務を負う専門業者が、濫用確認のためにアクセスする場合もあります。
Enterpriseでは、事故対応、利用者の明示的な許可を受けた会話復旧、法令上必要な場合に限定しています。
APIでは、濫用監視ログを原則最長30日保持し、機能ごとにアプリケーション状態の保存期間が異なります。安全上フラグが付いた画像などは人手確認の対象になり得るため、利用する機能まで特定して判定します。
取引先から預かったデータは、OpenAIとのDPAだけでは入力可になりません。元契約の包括承認、通知、個別承認のうち必要な手続を終え、OpenAIの再委託先と異議手続も確認した後は入力可です。
Anthropicは商用規約への同意時にDPAも成立する
個人向けプランのClaude Free、Pro、Maxでは、モデル改善への利用を設定で止めることができます。ただし、設定をオフにしても、安全審査に回った会話、フィードバック、明示的に学習利用へ同意した会話は学習や分析の対象に残ります。
削除した個人向けの会話はバックエンドから30日以内に削除されます。一方、違反が疑われる入力や出力は最長2年、安全分類結果は最長7年、フィードバック関連データは5年保持され得ます。
このため、Claude個人版も学習オフだけなら入力禁止です。会社は、安全審査と保存・削除の条件を確認します。国外処理も審査し、個人向け規約を委託条件として正式に採用します。この手続を終えた場合に限り、自社取得の一般的な個人データは入力可とします。営業秘密や取引先から預かった情報は、法人向けの守秘義務や再委託条件がそろわない個人版には入力禁止です。
法人向けプランのClaude for WorkとAPIサービスのAnthropic APIは、どちらもCommercial Termsの対象です。この規約は、顧客コンテンツによるモデル学習を禁止し、顧客コンテンツを秘密情報として扱います。
AnthropicのDPAは商用規約に自動的に組み込まれ、同規約への同意時にDPAも成立します。DPAの成立に別の申請は必要ありません。
このDPAは、顧客を管理者、Anthropicを処理者と位置付けます。顧客の指示と目的制限に加え、守秘と安全管理を定めています。監査と漏えい通知も対象です。再委託先通知と15日以内の異議、国際移転、終了後の削除も契約事項です。
Anthropic APIの入力・出力は原則30日以内に削除されます。ただし、Files APIなど保存を伴う機能では条件が変わります。利用規約違反への対応、法令対応、個別契約も例外です。
Covered Modelsに指定されたモデルでは、Claude for WorkとAnthropic APIを含む対象環境で、入力と出力を安全審査のため30日間保持します。通常はAnthropicの担当者が内容を読めませんが、自動システムが危険の可能性を検知した場合に限り、承認された少数の担当者が確認できます。アクセス記録も残ります。
Claude for Workの会話はAPIと同じ扱いではなく、利用者が削除するまで製品上に保持されます。Enterpriseプランでは、管理者が30日以上の保存期間を設定できます。
一部の契約で利用できるゼロデータ保持も、対象となる顧客、組織、機能が限られます。法令対応や不正利用対策のための処理までゼロになるわけではありません。法人向けプランとAPIは、これらの保存条件と社内側の条件をすべて満たした後は入力可です。
取引先から預かったデータは、AnthropicとのDPAだけでは入力可になりません。元契約の包括承認、通知、個別承認のうち必要な手続を終え、Anthropicから新しい再委託先の通知を受けた場合の15日以内の異議手続も確認した後は入力可です。
Googleは個人向け、Workspace、API無料枠を分ける
個人向けのGeminiアプリは、Gemini Apps Activityをオフにすると、新しい会話をAIモデルの学習に使いません。しかし、Activityをオフにしても、回答生成、フィードバック処理、安全確保のために会話をアカウントと結び付けて72時間保持します。安全目的の人手確認も残ります。
Activityがオンの場合は、会話をサービス改善とモデル学習に使い、一部を人手確認します。人手確認済みのデータはアカウントから切り離され、最長3年保持され得ます。Google AI Proなどの個人向け有料プランも、料金を払っただけでは法人向けDPAの対象になりません。
そのため、Gemini個人版もActivityをオフにしただけなら入力禁止です。会社が個人向け規約に残る72時間保持、安全目的の人手確認、国外処理を審査し、その規約を委託条件として正式に採用した場合に限り、自社取得の一般的な個人データは条件を満たした後は入力可とします。営業秘密や取引先から預かった情報は個人版には入力禁止です。
法人向けのGoogle Workspace対象エディションでは、顧客の許可なく、入力、Workspace内の関連データ、出力をドメイン外のモデル学習や人手確認に使いません。Googleは、Cloud Data Processing Addendumに従い、顧客の指示でデータを処理します。
Workspaceの対象契約には、Cloud Data Processing Addendumが組み込まれます。DPAの成立に別の申請は必要ありません。このDPAはGoogleを処理者とし、顧客の指示、削除、安全管理、守秘を定めます。事故通知、監査、処理地域、再委託先通知も契約事項です。
保存期間は利用画面ごとに異なります。GmailやGoogleドキュメントなどのWorkspaceアプリ内で使うGeminiの入力・出力は、管理者設定により90日から無期限です。
Workspaceアカウントで単独のGeminiアプリを使う場合は最長36か月、履歴をオフにした場合も最長72時間保持されます。したがって、Workspaceも管理者が保存設定を決め、利用目的、再委託、国外処理などの条件を満たした後は入力可です。
APIを利用する場合、Gemini APIの無料枠と無料のGoogle AI Studioでは、Googleが入力と出力を製品や機械学習技術の改善に使い、人手確認も行います。規約自体が機微情報、秘密情報、個人情報を送信しないよう求めているため、これらの情報は入力禁止です。
Gemini APIの有料枠では、Googleは入力と出力を製品改善に使わず、Cloud Data Processing Addendumに従って処理します。有効なCloud Billingアカウントに結び付くプロジェクトで有料サービスを使うと、このDPAが適用されます。DPAだけを別に申請する必要はありません。
ただし、Gemini APIは無料・有料を問わず、濫用監視と法令対応のために入力、付随情報、出力を55日間保持します。自動検知でフラグが付いた内容や、継続的に疑わしい挙動を示すプロジェクトは、権限を持つGoogleの担当者が確認する場合があります。このデータは通常のモデル学習には使わず、ポリシー違反の検知と防止に限って利用します。
Grounding with Google Searchを利用した場合の30日間保持など、機能別の例外もあります。利用機能まで特定し、保存と人手確認の条件を審査した後は入力可です。
自社が取引先から個人データを預かった処理者である場合、GoogleのDPA第5.1節は、元の管理者がGoogleとGoogleの再委託先の利用を承認していることを顧客に保証させています。自社の判断だけでは再委託できません。Google WorkspaceまたはGoogle Cloudの再委託先まで元の契約と照合し、承認条件を満たした後は入力可です。
DPA成立後も記録と監督を続ける
DPAや法人向け契約を結んだ後も、委託先としての継続的な監督が必要です。対象となるAI製品、契約当事者、契約日、適用文書を台帳に記録します。選択した保存期間、利用機能、再委託先、データの処理国も記録対象です。
AIサービスの規約、再委託先、保存条件、利用機能が変わったときは、変更後も社内の承認条件を満たすか再判定します。一つでも条件から外れた場合は入力禁止とし、法務担当者と情報システム担当者が新しい条件を承認するまで再開しません。
今日の資料を五段階で振り分ける
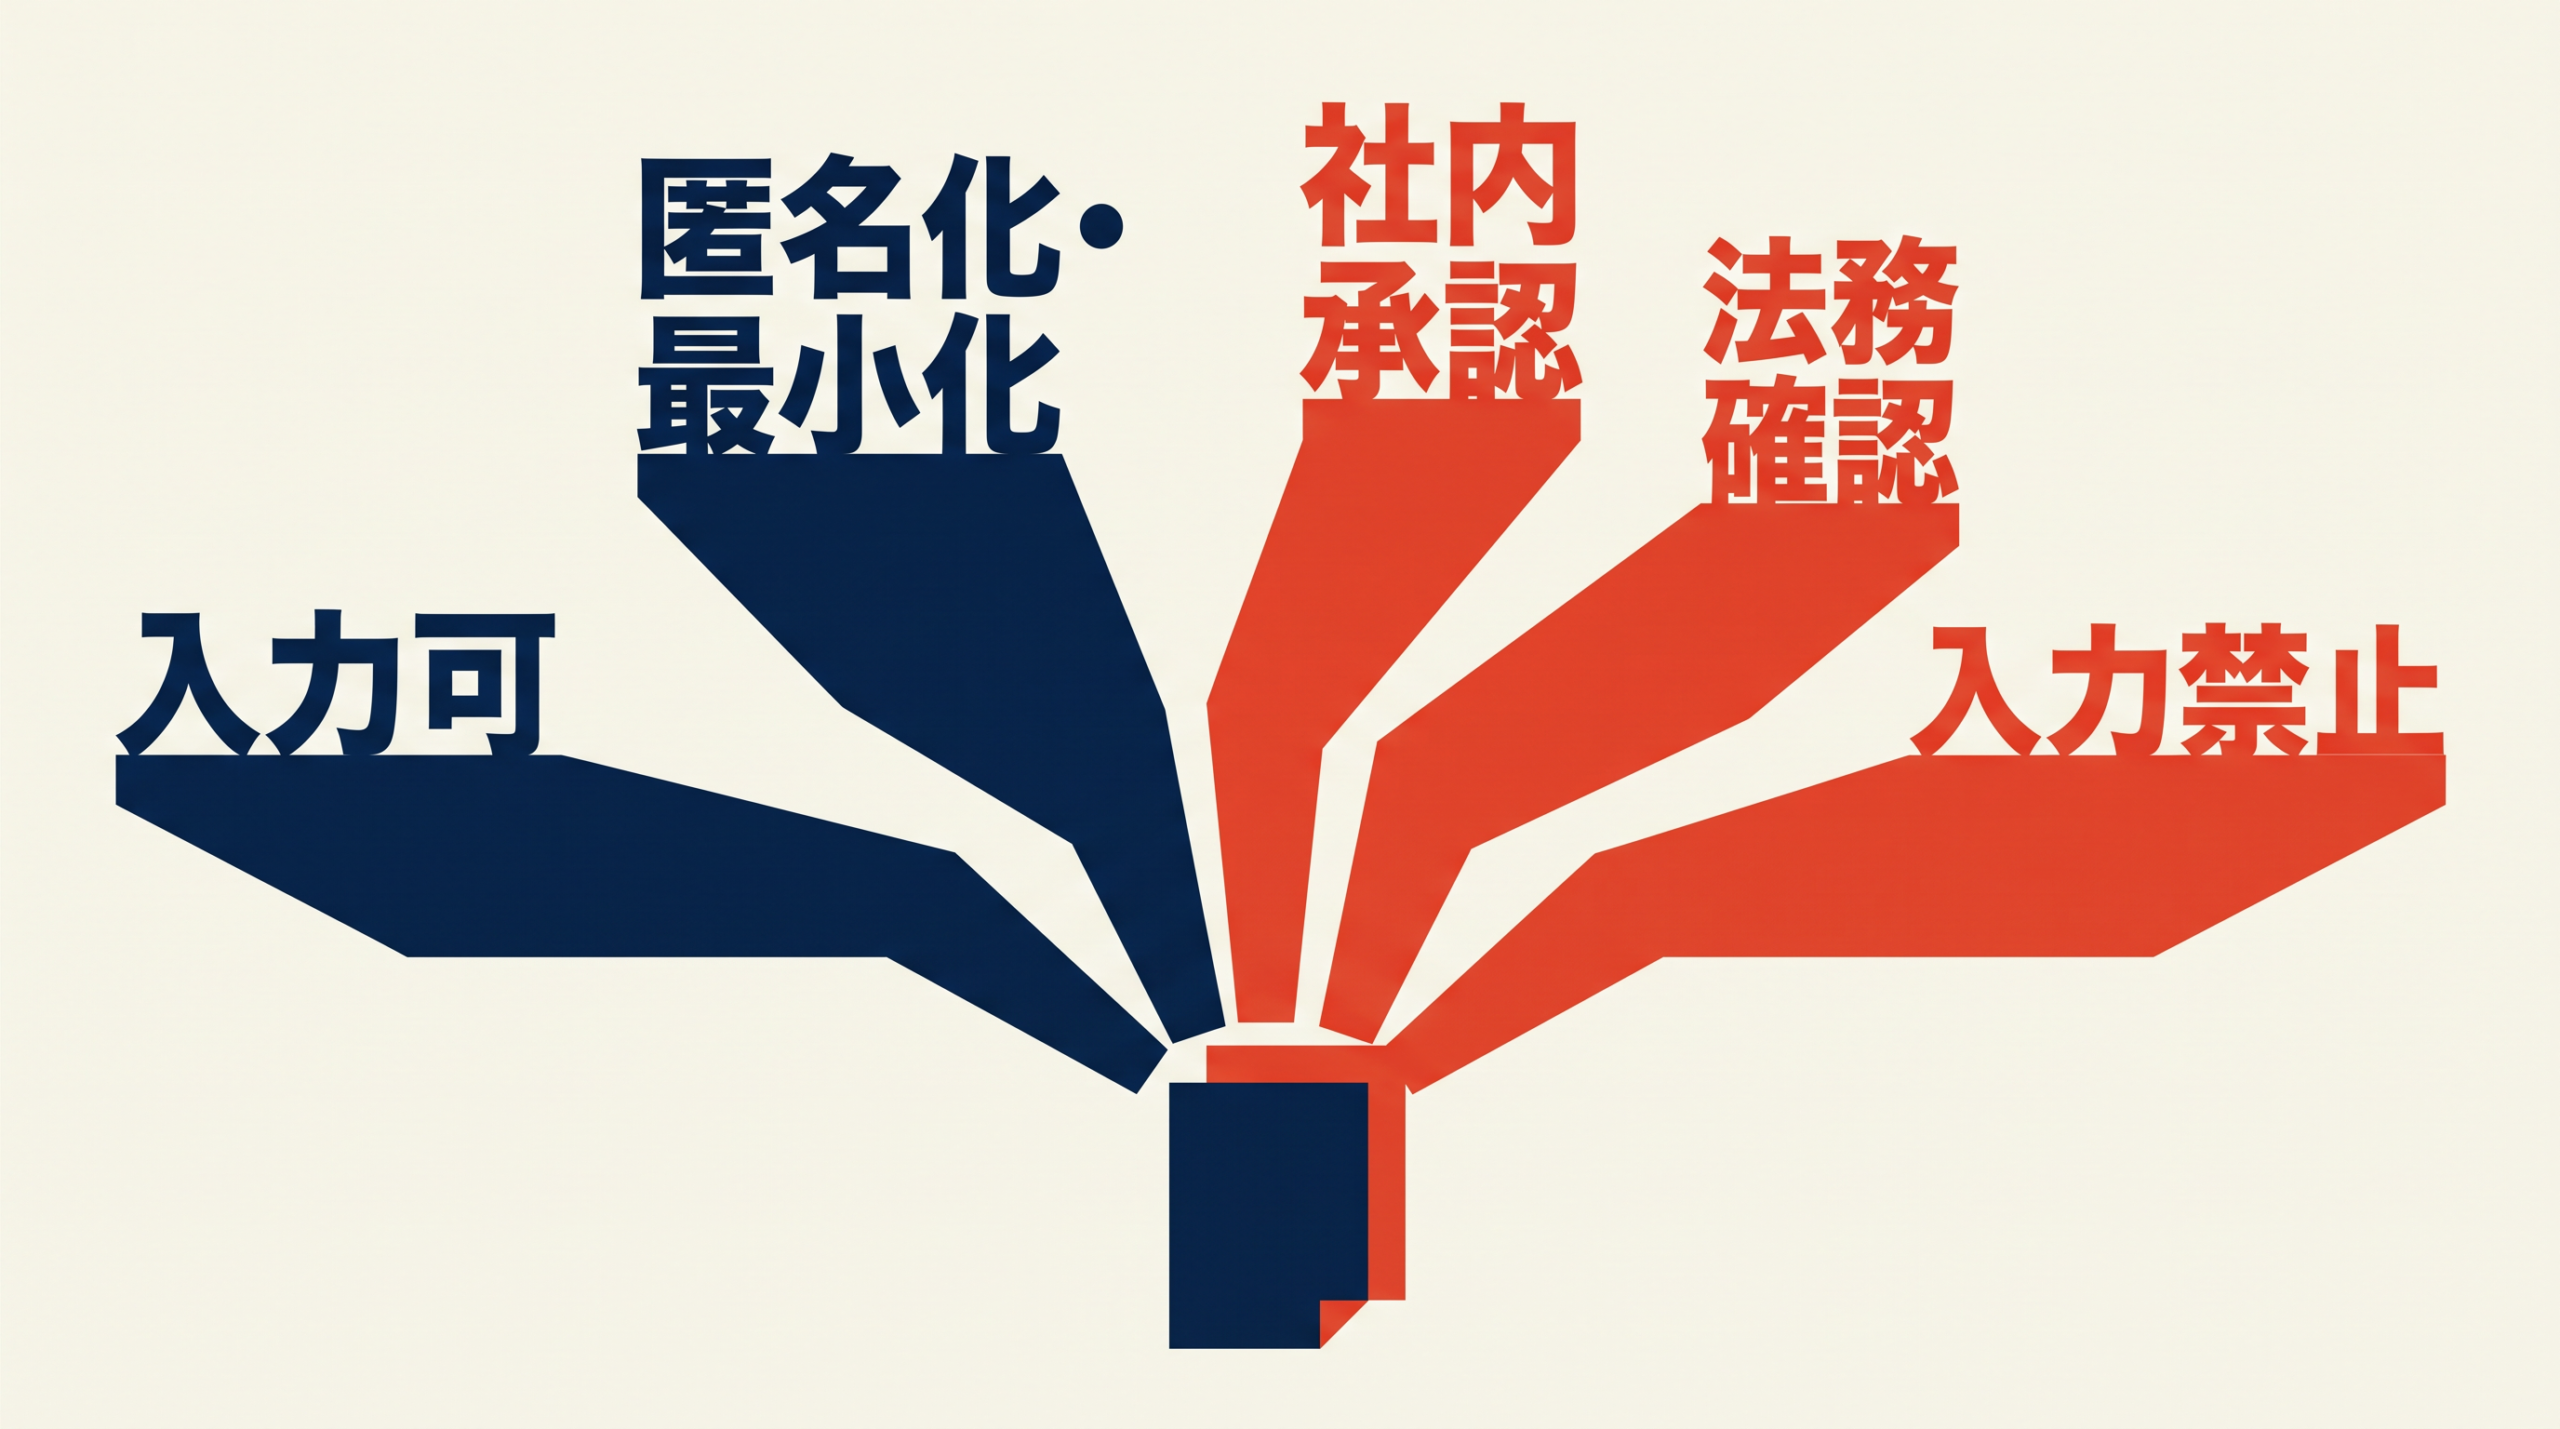
これまでに確認した法律や契約の条件を踏まえ、手元にある資料を入力してよいか具体的に判断します。ここでは、確認する情報の種類を五段階のステップに振り分けます。最終的な結論は、「入力可」「条件を満たした後は入力可」「条件が変わるまで入力禁止」のいずれかで明確にします。一つの資料に複数の情報が混ざっている場合は、最も厳しい条件に従います。
まず大前提として、会社が承認した利用環境かどうかを確認します。従業員が自分で契約した個人プランで学習オフに設定しただけなら、公開情報と会社が外部送信を許可した非機密情報以外は入力禁止です。
個人プランでも、会社が利用規約と安全管理を審査し、委託先として選定・監督したうえで業務利用を承認した場合は、次の段階へ進めます。会社が承認した法人プランやAPIも、すべての情報を無条件に入力できるわけではありません。以下の五段階で資料の中身を確認します。
第一段階は、公開情報と一般社内情報です。公開情報のうち、事実や数値だけを扱う場合は、公開元の利用規約やライセンスに反しない限り入力可です。
会議メモや売上集計などの一般社内情報は、情報の持ち主と社内規程が外部AIの利用を許可している法人環境であれば入力可です。情報所有者や外部送信の許可が不明な場合は、確認できるまで入力禁止です。
第二段階は、個人データです。氏名や顧客履歴などが利用目的の範囲外なら入力禁止です。
自社が本人から直接取得した一般的な個人データは、利用目的と委託成立を確認します。続いて、委託先の選定・監督、安全管理、国外提供を確認します。会社の個人情報管理責任者と情報システム部門がすべてを承認し、目的に必要な項目だけへ減らした後は、個人プランでも入力可です。
取引先から預かった個人データは、OpenAIなどへの送信が再委託になります。元の利用目的と受託業務の範囲を確認し、元契約が定める包括承認、通知、個別承認の手続に従います。AI提供者までの監督経路も確認できた後は入力可です。必要な手続を終えていなければ入力禁止です。
要配慮個人情報、マイナンバー、業法で取扱条件が加わる情報は、法務や個人情報管理責任者が個別に承認するまで入力禁止とします。医療機関が識別可能な患者情報を扱う場合は、3省2ガイドラインに沿った評価も終えてから入力します。
第三段階は、自社の営業秘密です。自社の営業秘密は、個人プランや社内で未承認のサービスへは入力禁止です。法人契約であっても、提供者の守秘義務、アクセス制限、データを必要最小限にすること、操作記録などのいずれかが欠けていれば入力できません。これらの条件をすべて満たし、情報の持ち主がその用途を社内承認した後は入力可となります。
第四段階は、取引先の秘密情報です。AI提供者との契約に関わらず、自社の判断だけでは入力できません。
NDAなどの元契約に生成AI利用や委託先への開示を認める条項がある場合は、その手続に従います。取引先が個別に書面で承諾した場合も、承諾の範囲内で入力可です。どちらも確認できなければ入力禁止です。
法務が既存条項で許容されると確認した場合は、社内の禁止状態を解除できます。契約変更や取引先の同意が必要な場合は、その手続が完了するまで入力禁止です。
第五段階は、第三者の著作物です。他社の有料レポート、新聞記事、画像、ソースコードなどの創作的な表現を含む場合も注意が必要です。事実、数値、アイデアだけを抜き出して自分の言葉で入力するのであれば入力可です。他人の表現をまとまった量で入力する場合は、利用許諾やライセンスの範囲内でなければ入力禁止です。
文化庁は、表現を楽しむ目的がない情報解析には著作権法第30条の4が適用され得る一方、元作品に似た表現を出力させる目的では結論が変わると説明しています。情報解析にあたるかどうかが不明な場合は、法務が確認して禁止状態を解除するまで入力しません。
手元の資料が複数の情報区分にあてはまる場合は、すべての区分で入力可となった場合だけ入力します。一つでも禁止の条件が残っていれば、入力作業を止めます。「法務確認」や「社内承認」は、それ自体が結論ではなく、入力禁止の状態を解除するための手続きです。一つひとつの条件を順番に確認し、不明な点は必ず解決してから情報を入力してください。
よくある質問
Q1. 個人情報や秘密情報を匿名化すれば、生成AIに常に入力してよいですか。
いいえ。現場で氏名を伏せただけのデータは、個人データとしての入力条件を満たすまで生成AIへ入力禁止です。
ここでいう「匿名化」とは、氏名の削除や記号への置換、不要な列の削除など、一般的なマスキングやデータの最小化を指します。単純な置換や一定の計算・ハッシュ化をしても、復元や照合が容易なら対策として足りません。
対応表が残っている場合や元の台帳と容易に照合できる場合は、個人情報・個人データとしての制限が残ります。所属・役職・年齢・案件名などの組合せから本人を識別できる場合も同じです。
法律上の「仮名加工情報」と「匿名加工情報」は、こうした日常語の匿名化とは異なる制度です。仮名加工情報は、作成した会社が対応表などを保有していれば通常なお個人情報として扱われ、第三者提供も原則禁止されます。生成AIへの自由な入力を認める制度ではありません。
法律上「匿名加工情報」と呼べるのは、個人情報保護委員会規則第34条が定める五種類の加工を施し、識別と復元をできなくしたデータだけです。担当者が目視で氏名を黒塗りしただけでは、この基準を満たしたことになりません。
希少疾患や非常に高い年齢、詳細な移動履歴や購買履歴は、残った項目から本人を絞り込める情報です。このような項目も削除するか、年代や地域などの大まかな区分へ置き換えます。
匿名加工情報になっても、加工方法等情報の安全管理、第三者提供時の公表・明示、本人を識別するための照合禁止などの義務が残ります。現場担当者が氏名を伏せただけの資料を「匿名加工情報」と扱わず、個人データの利用目的、委託先監督、安全管理などを確認できるまで入力禁止とします。
Q2. 会社で契約している法人プランのAIを使えば、現場の判断だけで情報を入力できますか。
法人プランの契約があるという理由だけでは入力できません。会社が承認した法人プランの利用は、機密情報を入力する候補になるための前提条件にすぎないためです。
公開された事実や、会社が外部への送信を許可した一般社内情報であれば、現場の判断で入力可となる場合があります。しかし、自社の営業秘密や個人データについては、情報の利用目的や必要最小限の項目に絞られているかを確認し、情報の持ち主が用途を承認して初めて入力可となります。
取引先の秘密情報についてはさらに厳しくなります。取引先との契約に生成AI利用の許可がない限り、法人プランであっても条件が変わるまで入力禁止です。
Q3. DPA(データ処理契約)とNDA(秘密保持契約)はどのように違いますか。
DPAは、AI提供者が利用者のデータを扱う条件や義務を定めた契約です。OpenAIのDPAは、データの処理をサービス提供や利用者の指示に限定し、守秘義務や安全管理について定めています。これに同意することで、AI提供者を委託先として整理する土台ができます。
一方のNDAは、自社と取引先との間で情報の利用や第三者への開示を制限する契約です。AI提供者とDPAを結んで自社の情報が守られる状態を作っても、取引先とのNDAを守る責任は消えません。
そのため、入力してよいかは取引先との元のNDAへ戻って確かめます。明確な許可がない場合は、自社とAI提供者の間でDPAを結んでいても入力禁止とします。
Q4. 生成AIの学習オフ設定について、実行時に記録を残す必要はありますか。
操作記録は、すべての生成AI利用について法律が一律に義務付けるものではありません。社内規程が記録を求める場合は、承認者と入力目的を記録します。利用環境と日時も残します。
営業秘密をAIへ入力する場合も記録を残します。経済産業省の指針は、会社が秘密を管理する意思を従業員に認識できる形で示すよう求めています。学習オフの設定だけでは、秘密管理の実態を説明できません。
社内規程で操作記録が必須なのに記録できない環境や、営業秘密の管理実態を後から説明できない環境には入力しません。記録がないだけで直ちに法律違反になるとは限りませんが、会社が定めた管理条件を満たした後に入力します。
Q5. 入力可否について法務や契約管理部門へ相談する際、何を準備すればよいですか。
入力したい資料と、AIを使う目的を準備します。必要なデータ項目、情報の出所、取引先との元契約、利用する生成AIの正式なプラン名もそろえます。
これらと一緒に、AI提供者の公式文書も添えます。保存期間、人手による閲覧の有無、再委託先、データが処理される地域、そして削除の方法が分かる規約などです。この準備があると、足りない条件を特定しやすくなります。
法務や契約管理部門への相談は、現場が判断を丸投げして結論をもらうためのものではなく、入力禁止の状態を解除する手続きです。不足している条件が解決し、禁止状態が解除されるまでは資料を入力禁止とします。
社内のAI活用を進めるための相談役をご活用ください
AIを導入したものの、どの仕事から始めるか、何を入力してよいか、誰が運用を担うかで止まっていませんか。Deskrexでは、月額制のAI顧問・相談役として、現場の利用と経営の判断を継続的にご支援しています。

現在のAI利用状況と業務を伺い、入力ルールやセキュリティ、取り組む業務の優先順位、ツールとプランの選定を整理します。まず一つの業務で試し、実際の品質と負担を見ながら次に進む範囲を決めます。
個人だけで使われているAIやSkillsを社内へ広げる方法、推進役の置き方、人とAIの役割分担も相談できます。個別ツールの操作に加え、社内で判断し、使い続ける体制づくりをご支援します。
現在使っているAI、進めたい業務、判断に困っていることをお知らせください。AI顧問・相談役のご案内をご覧ください。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント