専門家の過去の面談記録や知識をAIに読み込ませれば、そのまま専門家の代わりとして相談業務を任せることができるのでしょうか。この記事は、社内の専門家の知識をAIへ移し、メンタリングをどこまで代替できるのか、そしてどのように導入すればよいのかを知りたい方に向けたものです。
結論から言えば、人間の仕事を丸ごとAIに代行できると確認されたわけではありません。AIは、本人が利用を許可した過去の資料を探し出し、根拠となる情報が付いた回答の草案を作る仕事を支援できます。
一方で、メンタリングにはAIにはできない重要な役割があります。目の前の相談者が抱える複雑な事情を読み取り、助言の言葉が相手にどう届くかを確かめ、過去の記録にない例外を判断し、最終的な結果に責任を負う仕事です。これらは専門家本人に残す必要があります。
専門家の人格を完全にコピーしたAIを作るのではなく、資料の検索と回答案の作成をAIに任せます。送信前の許諾や根拠、例外への対応を人が確認し、送信の最終判断も人が行うという境界線が導入の鍵となります。
記事の中では、実際の研究結果からAIが支援できる限定的な範囲を確かめ、扱う情報や著作物を正しく分けて許可を取る考え方を解説します。また、本格的な導入の前に、2週間程度の小規模なテストを行って失敗の傾向を観察し、安全性を測る手順も紹介します。
なお、ここで目安として紹介するテストの期間や人数は外部で決められた公式の標準値ではなく、考え方を説明するための設計値です。まずはAIを人物の代わりとしてではなく、専門家本人の承認を前提とした検索支援の道具として小さく試す方法を見ていきましょう。
結論|AIに渡すのは知識検索、人に残すのは判断と責任
専門家の過去の面談記録や知識をAIに入力すれば、そのまま専門家の代わりになるのでしょうか。結論から言えば、人間の仕事を丸ごと代行できると確認されたわけではありません。メンタリングの仕事を細かく分解し、AIに任せる部分と人間に残す部分の境界を引く必要があります。
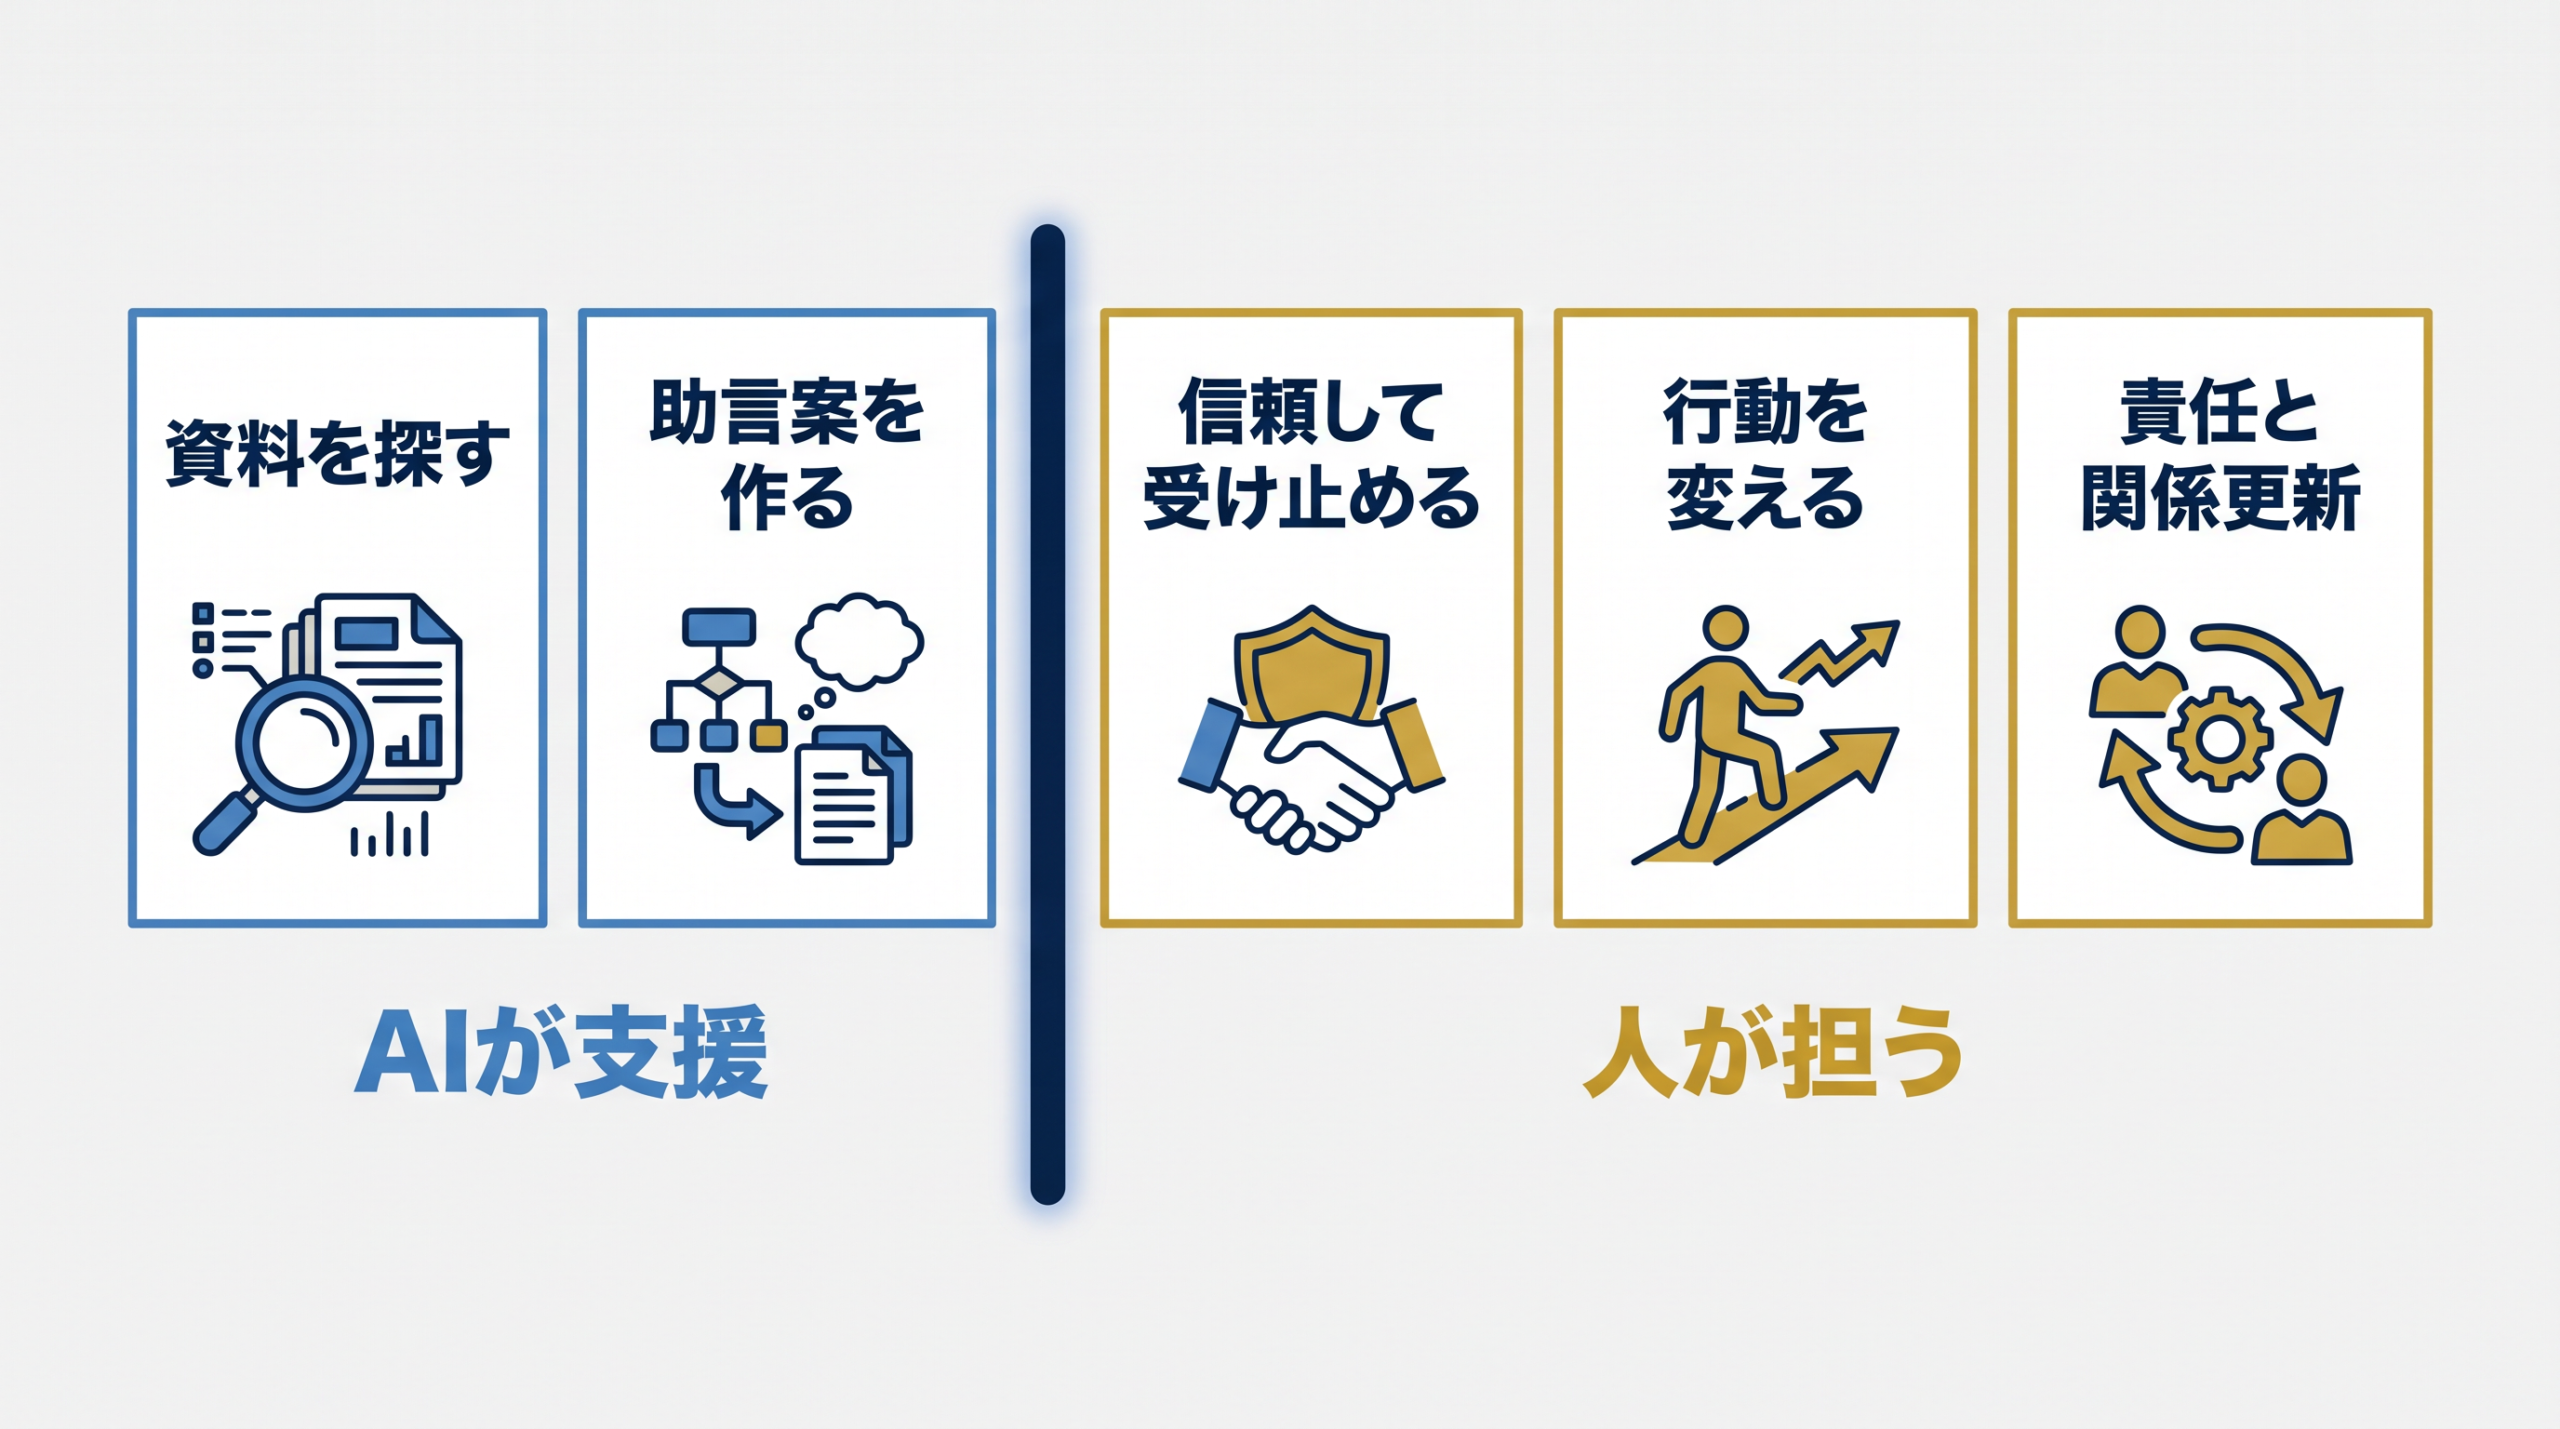
専門家の仕事には、少なくとも5つの要素が混ざっています。1つ目は資料から関係する情報を探す仕事、2つ目は相談内容に合う助言案を組み立てる仕事です。AIが効果的に支援できるのは、この2つの領域です。
一方で、3つ目の相談者が助言を信頼して受け止める過程、4つ目の相談者が実際に行動を変える過程、そして5つ目の結果に責任を負って次の面談で関係を更新する仕事は、人間に残す必要があります。AIの回答案だけでは、目の前の相談者の複雑な事情を読み取れたか、言葉がどう届いたか、過去の記録にない例外を判断できたかを確認できないからです。
したがって、最初から専門家の人格を完全にコピーしたAIを作ろうとするのではなく、AIを検索支援の道具として使うところから始めます。具体的には、AIが過去の面談記録から回答案と根拠を出し、本人が承認するという仕組みを作ります。
AIに過去の知識を探させて回答の草案を作る作業を任せることで、専門家は「この助言を目の前の相手にそのまま適用してよいか」を判断し、例外的な事態に対応し、最終的な責任を引き受けるという、人間ならではの仕事に集中できるようになります。
AIコーチの研究は限定課題の支援を示している
AIがメンターやコーチとしてどこまで役立つのかについて、実際の研究結果を見ていきます。複数の研究からわかるのは、AIは範囲を狭く絞った課題であれば支援できるということですが、その結果を拡大解釈してはいけません。
たとえば、参加者が自己評価した目標達成について人間とAIのコーチを調べた研究では、どちらのグループでも改善が観察されました。ただし、これは同じ時期に無作為に人間とAIを直接比較した試験ではありません。そのため、この結果だけを見てAIコーチは人間と同等であると一般化することはできません。
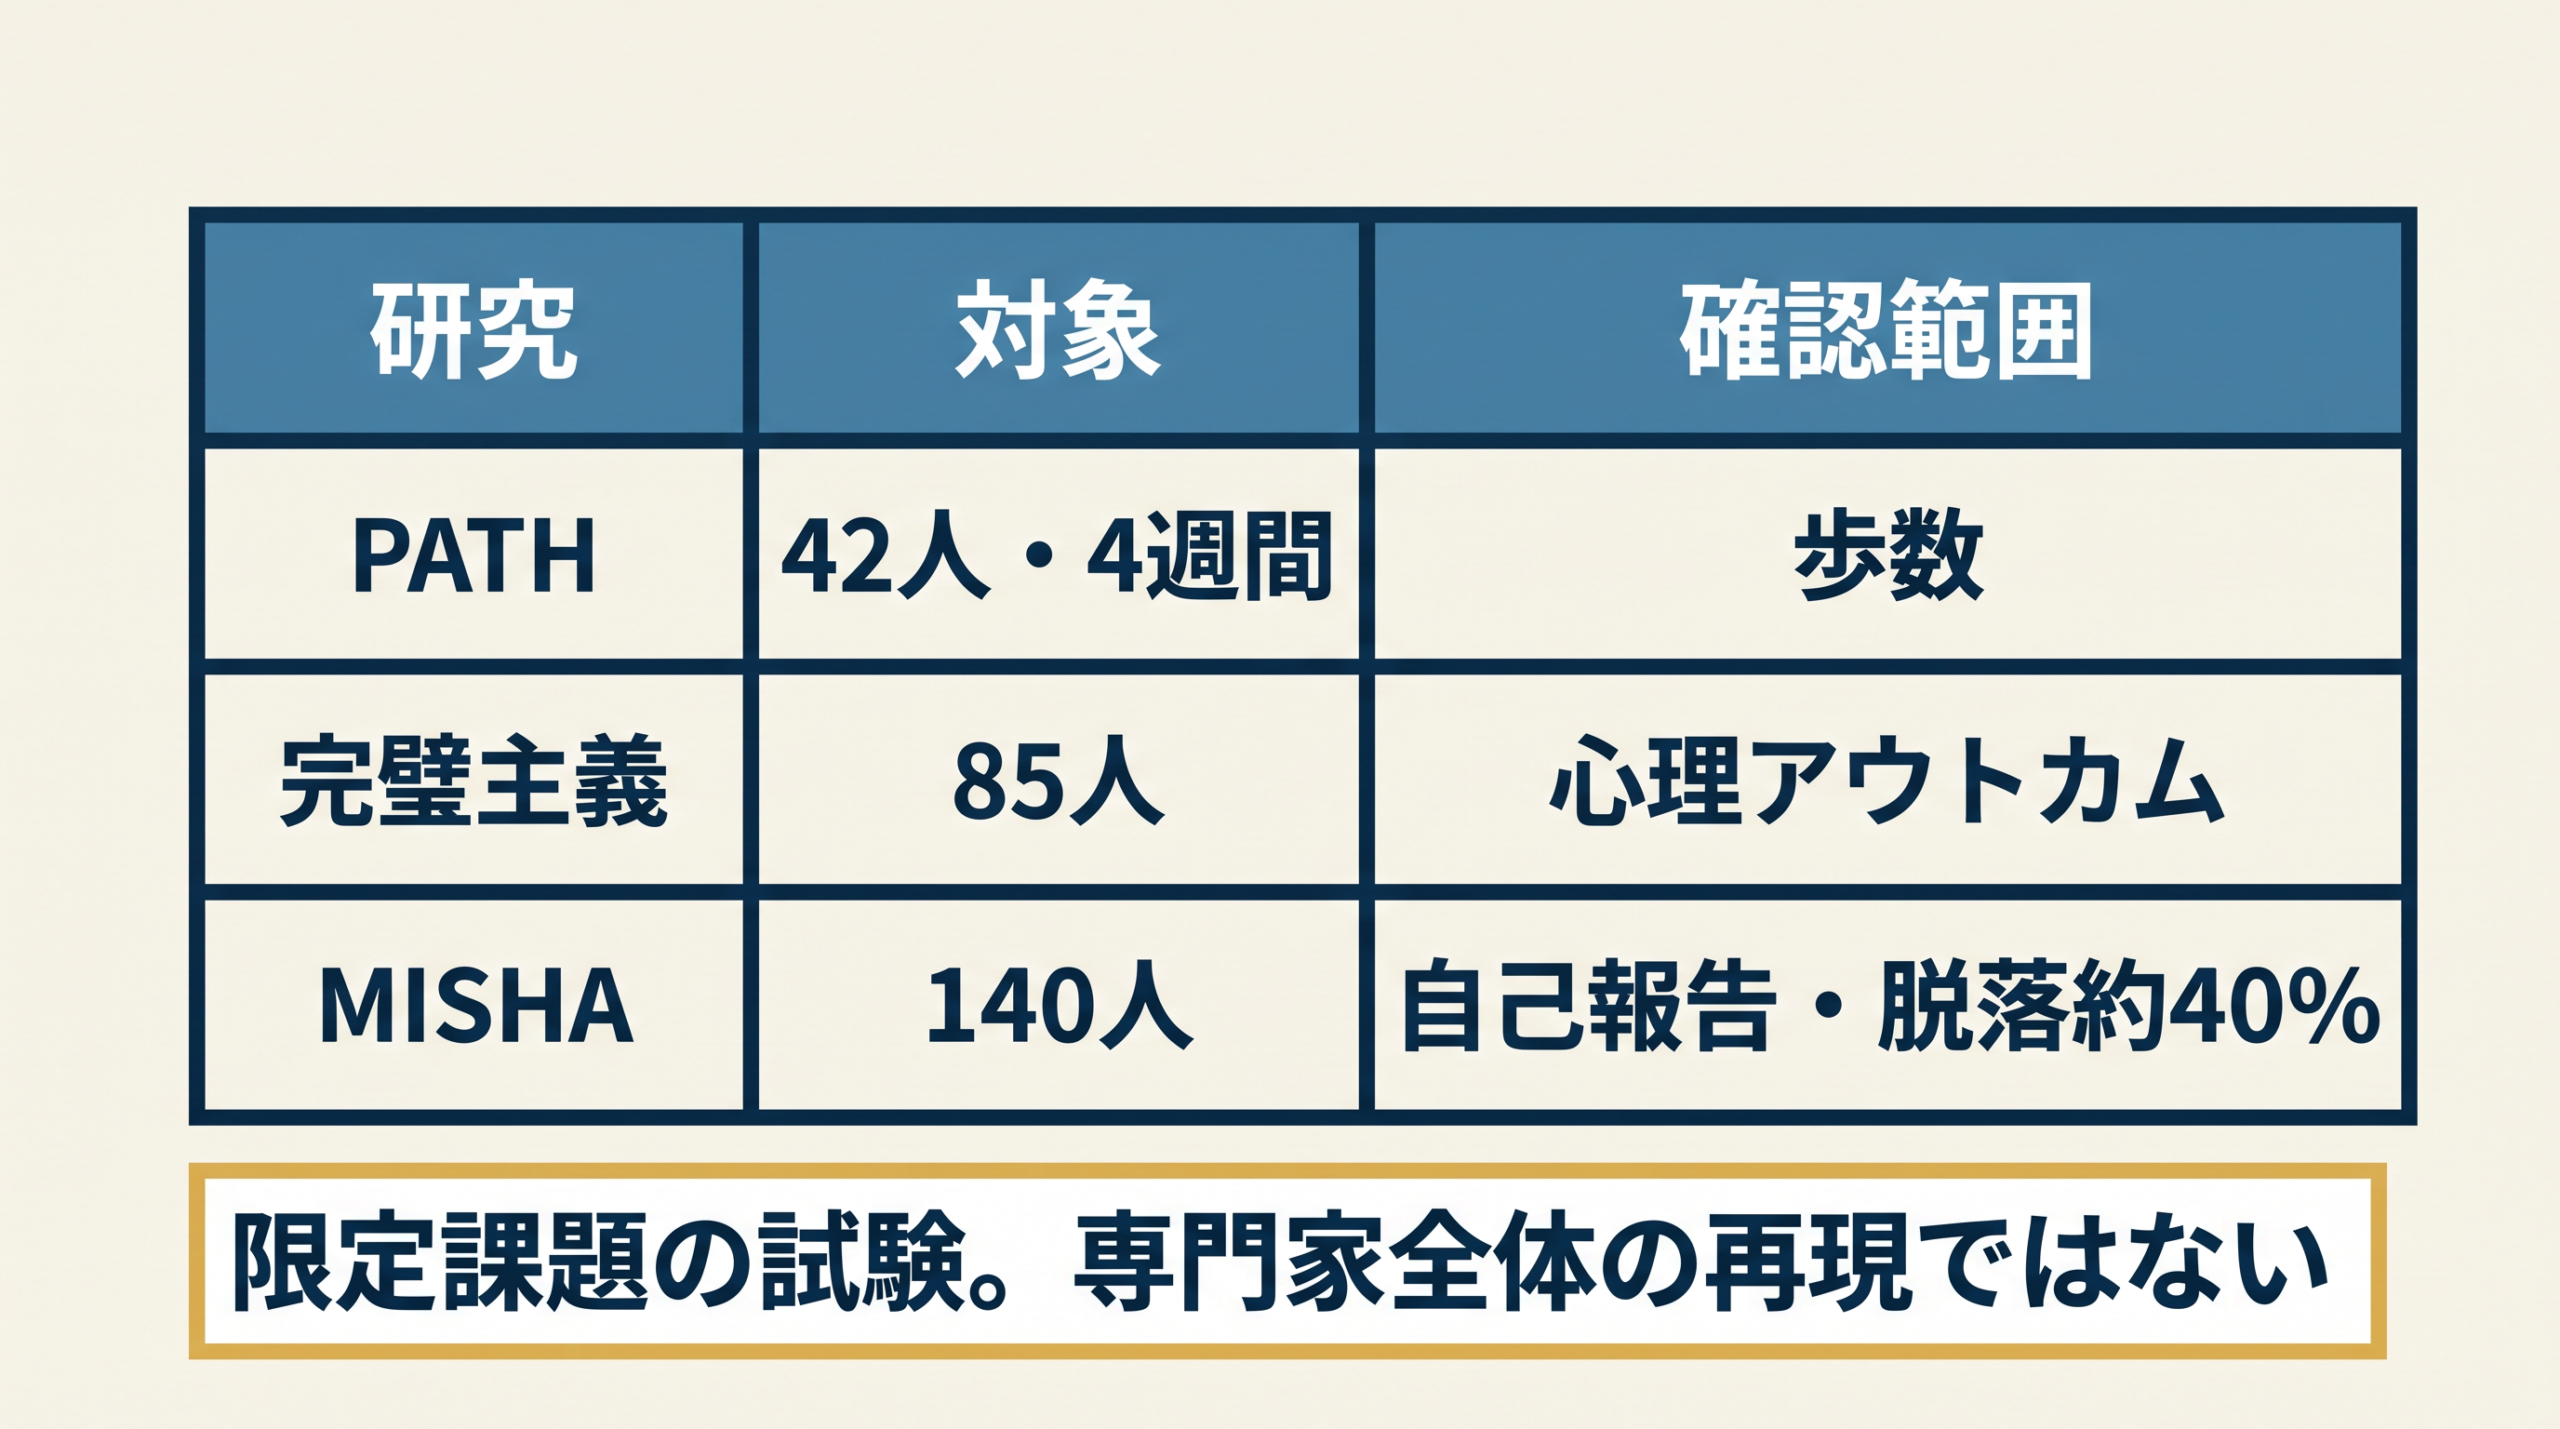
また、42人を対象に4週間行われた試験では、歩数という客観的な指標を測定しました。これも対象人数や期間、測定結果が限定された試験です。AIが幅広い人生相談に乗ったり、複雑な経営判断を代わりにしたりした研究ではありません。
さらに、85人を対象にして完璧主義を扱うバーチャルコーチの研究でも、心理的な変化にグループ間の差は見られず、途中で試験から抜け出す人が出るという問題もありました。ほかにも140人を対象にしたMISHAの試験で、参加者自身の報告を中心に調べた結果、約40パーセントの人が途中で脱落してしまった例もあります。
これらの研究から言えるのは、狭く定義した課題であればAIの支援効果を検討できる、ということまでです。歩数、完璧主義、目標達成の各研究で見られた一部の改善を、人間ならではの深い理解や責任を伴う専門家再現と混同しないことが大切です。
AIがもっともらしい助言の文章を返せるからといって、専門家という人物そのものを再現できたわけではない点に注意して導入を考える必要があります。
同じ助言でも信頼と行動は同じにならない
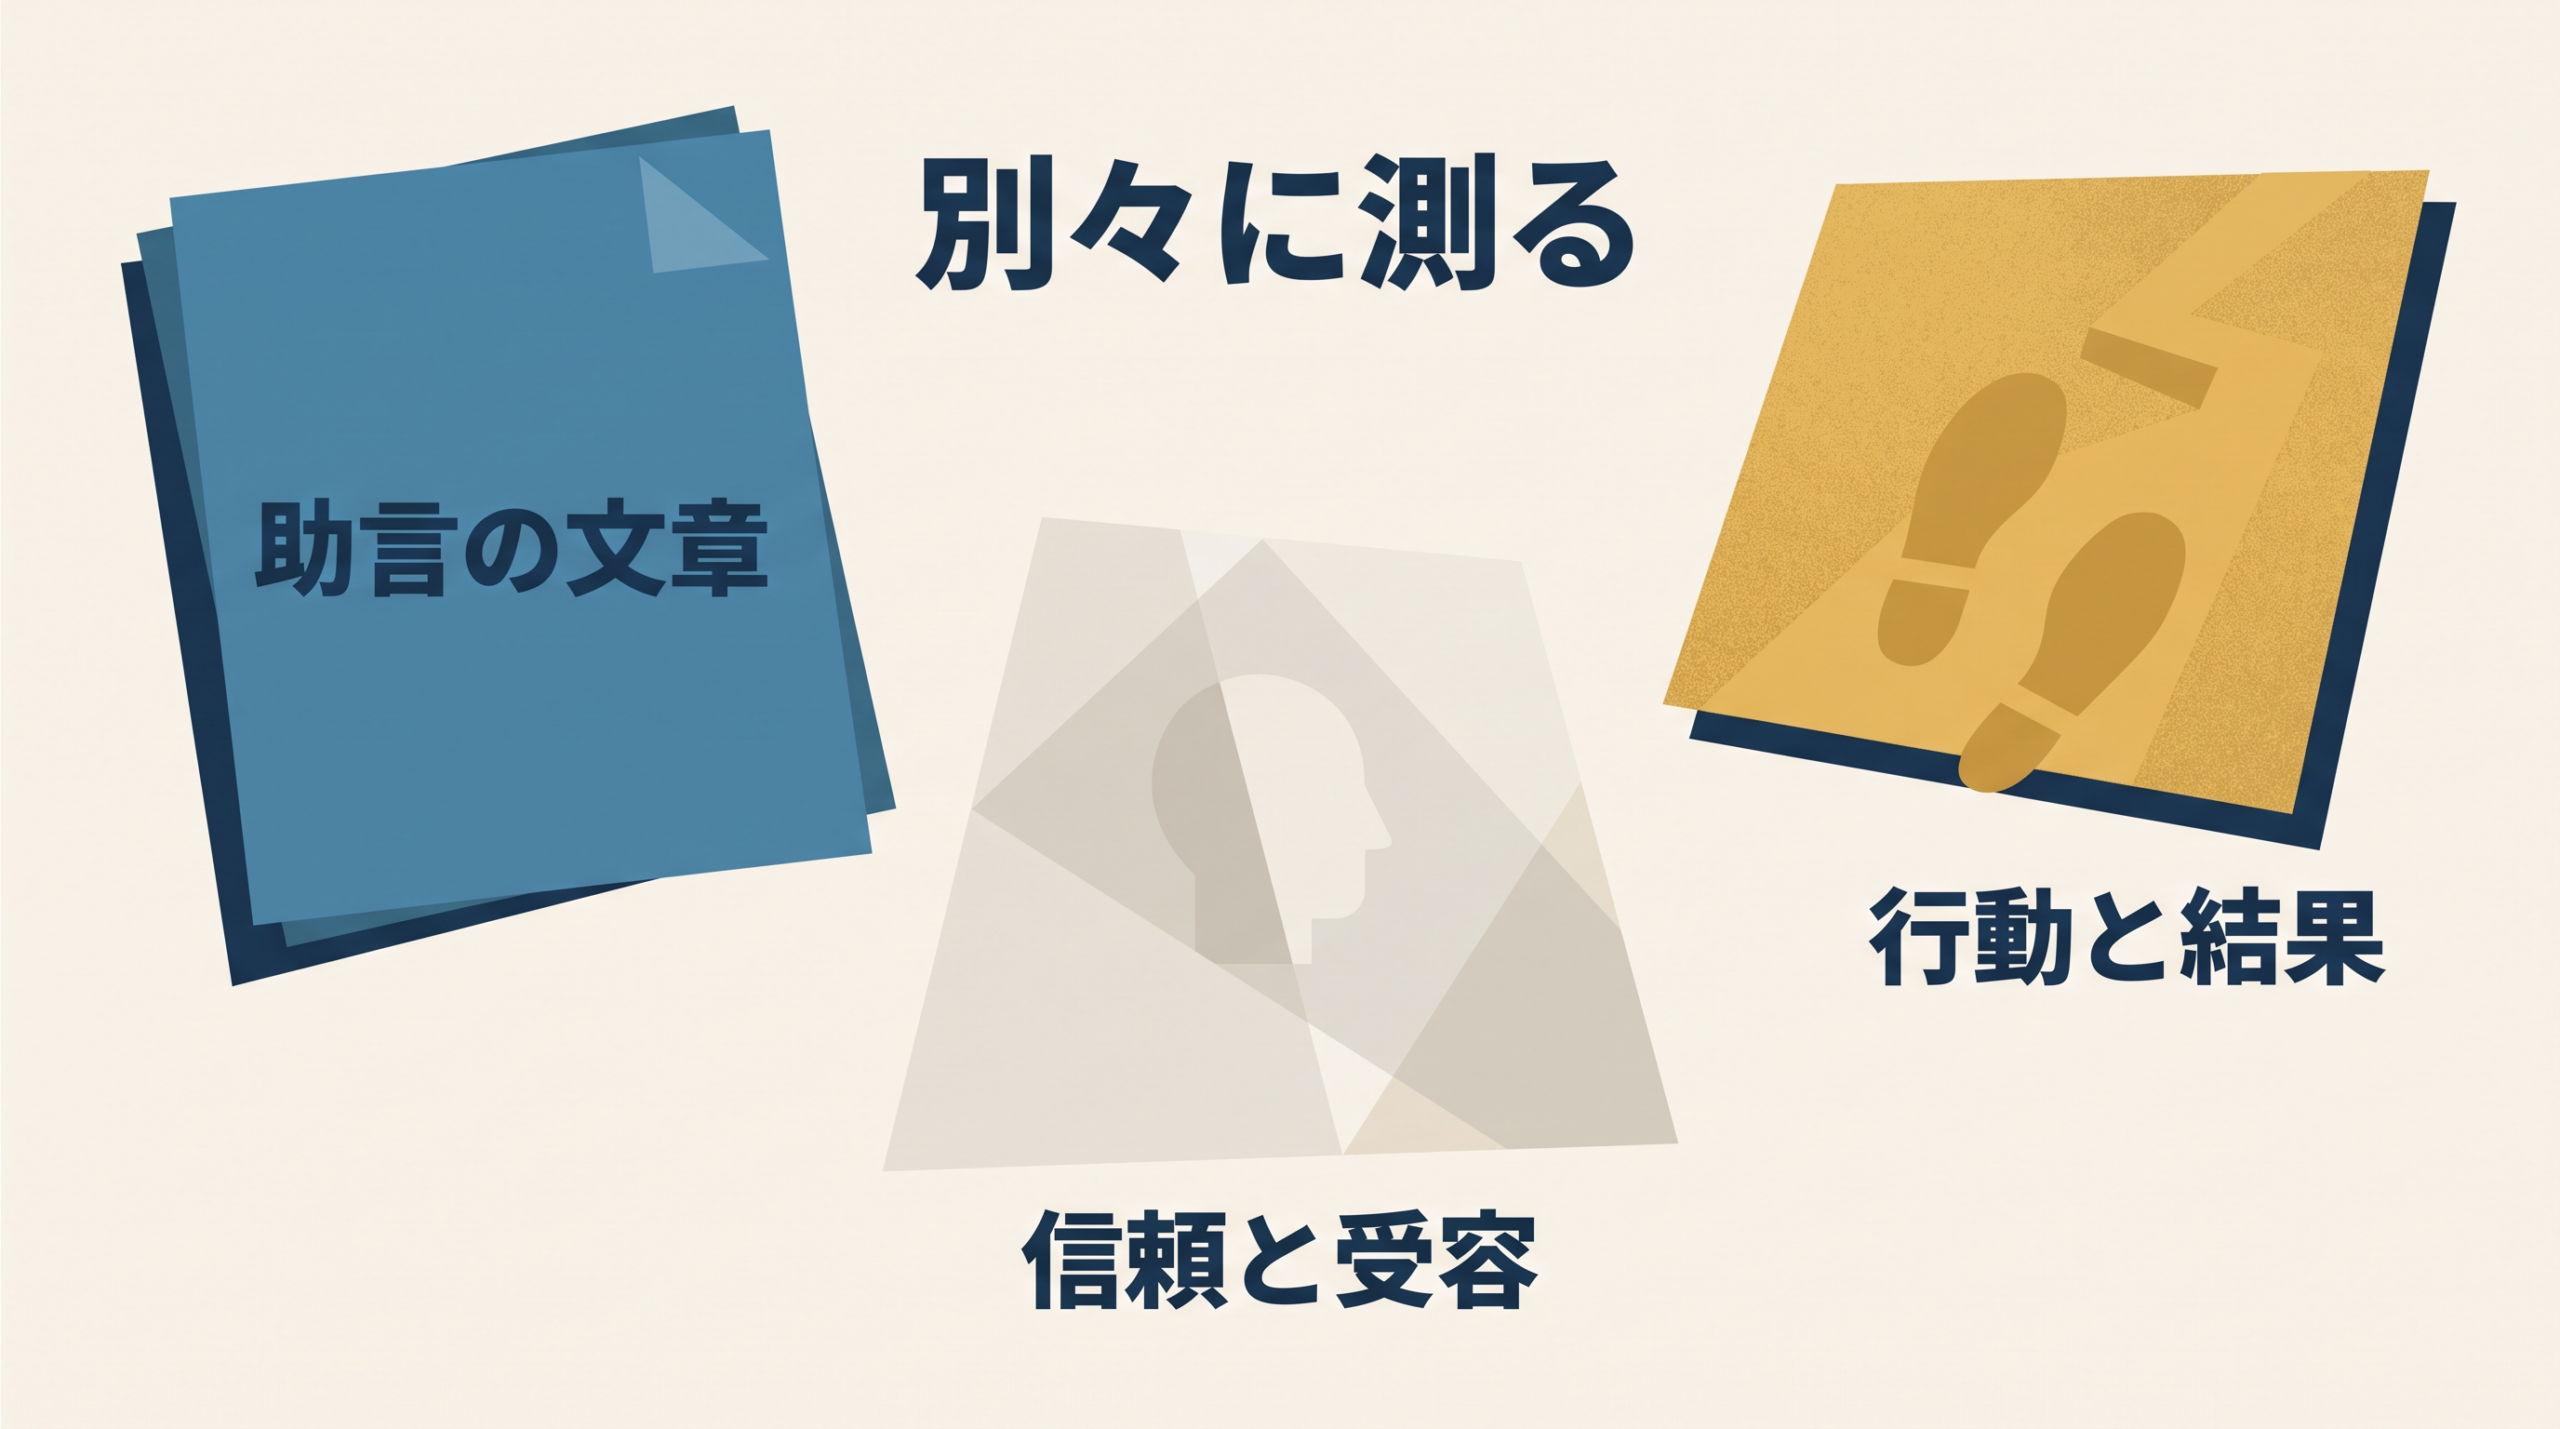
専門家の過去の知識をAIに読み込ませて、適切な回答の文章が作れるようになったとします。しかし、それだけでAIが専門家の代わりになったと結論づけることはできません。なぜなら、AIが内容の正しさを保って適切な文章を返すこと、相談者がその助言を信頼して受け入れること、そして実際に相談者が行動を変えて結果を出すことは、それぞれまったく別の評価項目だからです。
どんなに回答の文章が優れていても、それが誰から発信されたかによって受け取り方は変わります。助言のラベル付けに関する研究では、人間が作ったまったく同じ助言に対して「AIから」または「人間から」という表示を付けて受け取り方を調べました。その結果、助言の出所に対する事前の期待は、相談者の最初の選択に影響を与えました。
さらに注意が必要なのは、助言の内容が不適切だった場合の影響です。不正直な行動に関する実験では、悪い助言が参加者の不正直な行動を増やしてしまうことが確認されました。この実験の重要な点は、その助言がAIによって作られたものだと事前にはっきりと表示しても、悪い助言による影響を消すことはできなかったということです。
「AIによる回答です」という表示は必要ですが、それさえあれば安全が保証される仕組みにはならないことがわかります。
また、相談者との関係構築を扱った別の研究では、AIという表示と人間という表示で結果に大きな差は見られませんでした。しかし、この研究で使われた回答は、AIのふりをして人間のコーチが裏で実際に作っていたものでした。したがって、この結果もAI自身の回答を作る能力が人間と同等であることを証明するものではありません。
これらの研究からわかるのは、相談者がAIの助言を読んで満足したという感想だけで、導入の合否を決めてはいけないということです。満足度が高くても、誤った助言にそのまま従ってしまう可能性があるからです。
だからこそ、AIには過去の資料を探して回答案を作るところまでを任せ、その助言が目の前の相手にどう受け止められるかを考え、例外的な事情がないかを確かめ、送信の最終判断をする役割は専門家本人が担うという境界線が必要になります。
専門家のコピーではなく回答支援を作る
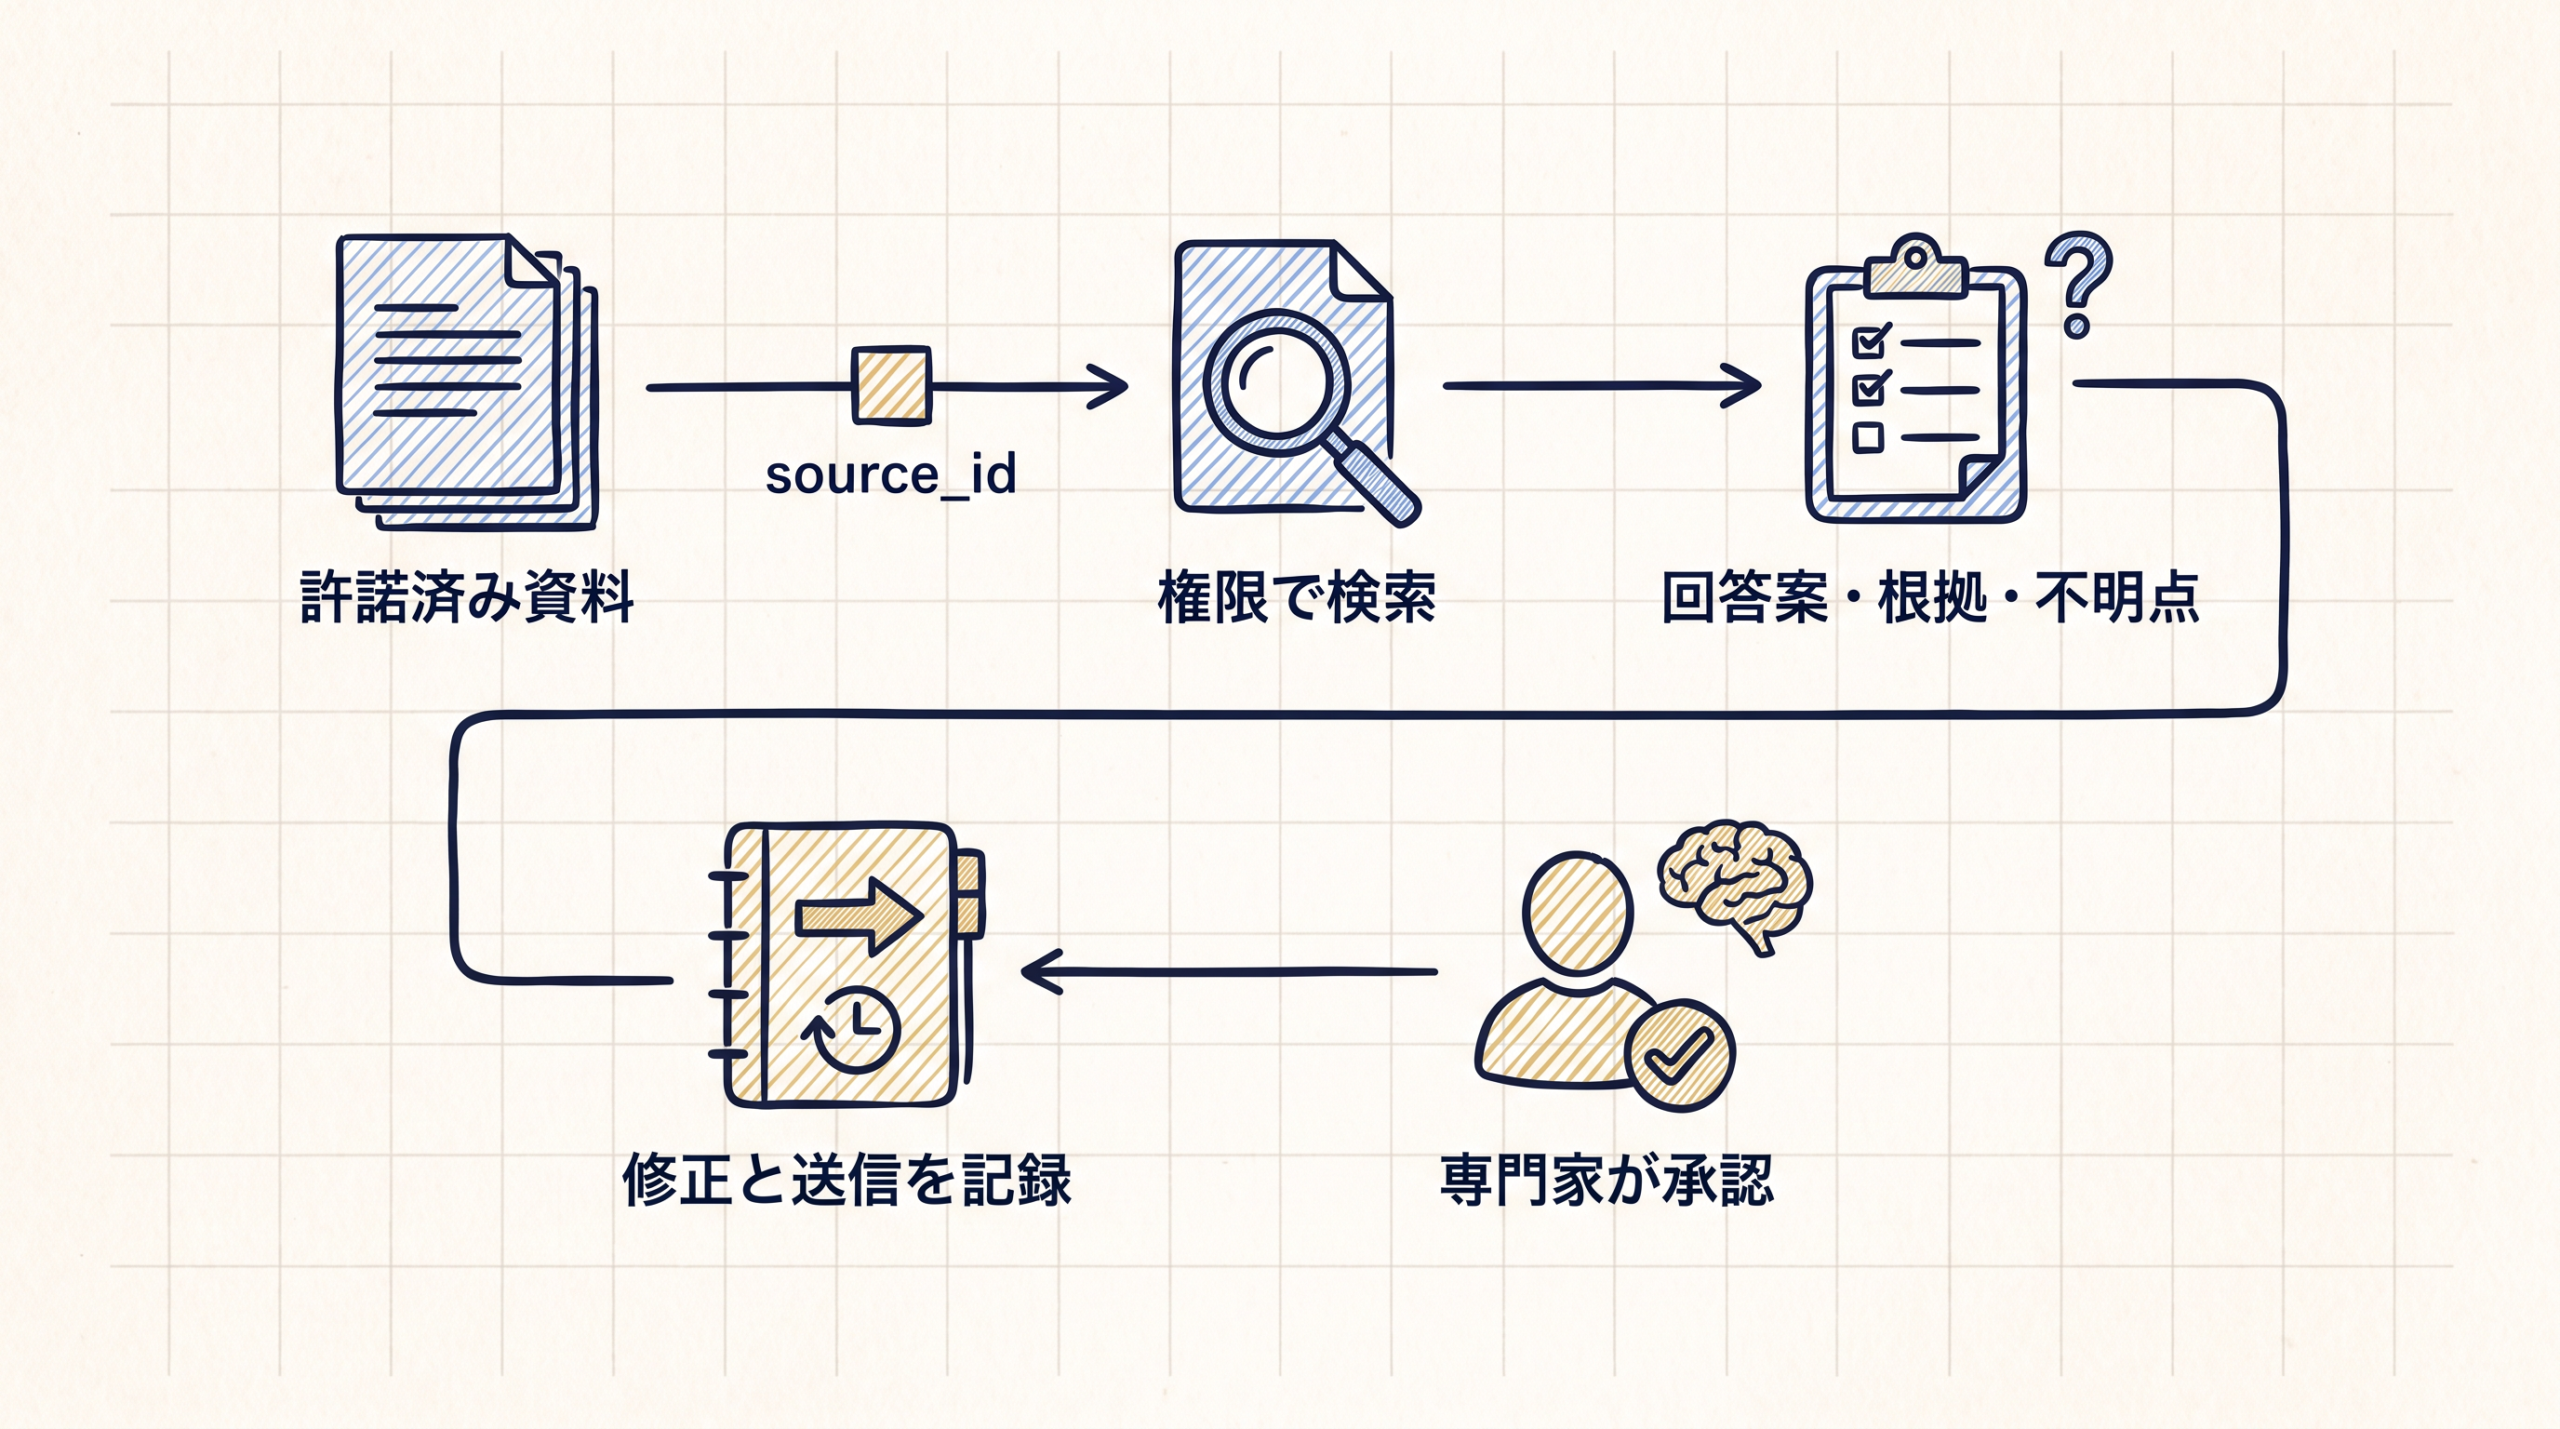
実務でAIを導入する際、目指すのは専門家の人間らしさをそっくり真似たコピーを作ることではありません。本人が利用を許可した過去の知識から、回答の草案を作るための検索支援システムを作ります。ここでは、システムに知識を入力してから記録を残すまでの一連の流れを説明します。
最初に行うのは入力データの整理です。面談の記録、記事、研修で使った資料、過去のフィードバックなどを集めます。このとき、誰の発言かわからない文章や、別の目的で集めた個人情報を一括でAIに入れてはいけません。それぞれの資料には、管理用の番号となるsource_id、発言した人、作成日を付けます。利用を許可した範囲と機密情報のレベルも記録します。
次に、整理した資料をAIが探せる状態にします。OpenAIのファイル検索機能などの仕組みを使って専用の保存領域を作り、相談の分野や担当者の権限に合わせて資料を絞り込めるように設定します。
AIから出力させるときは、質問への回答だけを返させてはいけません。必ず、source_id付き資料から回答案、根拠、不明点、確認質問を出すように設定します。AIが参考にした資料の番号、確信が持てない部分、専門家へ確認したい事項を同時に出力させることで、画面上の自然な文章を鵜呑みにせず、専門家が元の資料に戻って根拠を確かめられるようになります。
出力された内容は、そのまま相談者へ直接送らないことが重要です。ここがAIと人間の境界線になります。必ず専門家本人が内容を確認し、目の前の相手に適用できるか、例外的な事情がないかを判断し、必要なら修正を加えた上で、送信の最終判断をします。採用や評価、医療や法律、投資や個人の信用などは人の人生に重大な影響を与えます。
これらの領域は自動化の対象から外すべきです。OpenAIの利用ポリシーでも、影響の大きい領域での自動的な意思決定には制限が設けられています。
また、AIに送ったデータがどう扱われるかはサービスによって異なります。「AIに入力するとすべて学習されてしまう」「企業向けプランなら何も保存されない」と単純に考えるのではなく、データ管理の説明などを読み、製品や契約ごとの設定を個別に確認して許諾の範囲を守る必要があります。
最後に、システムの動きを記録するログの仕組みを作ります。どんな質問が来て、どのsource_idを探し、AIがどんな回答案を出したのか。そして、誰が承認し、どこを修正して、送信したのかを記録に残します。最初はAIにメールを送ったり顧客管理のシステムを書き換えたりする権限を与えず、情報を読み取るだけの状態から始めます。
こうした管理は、アメリカ国立標準技術研究所のAIリスクマネジメントフレームワークや、それを補う生成AIプロファイルの考え方が参考になります。システムを動かす前に、何のために使うのか、誰に影響するのか、どのように効果を測り、どうなったら利用を止めるのかをあらかじめ決めておくことが大切です。
顔・声・資料・個人情報の許可を分ける
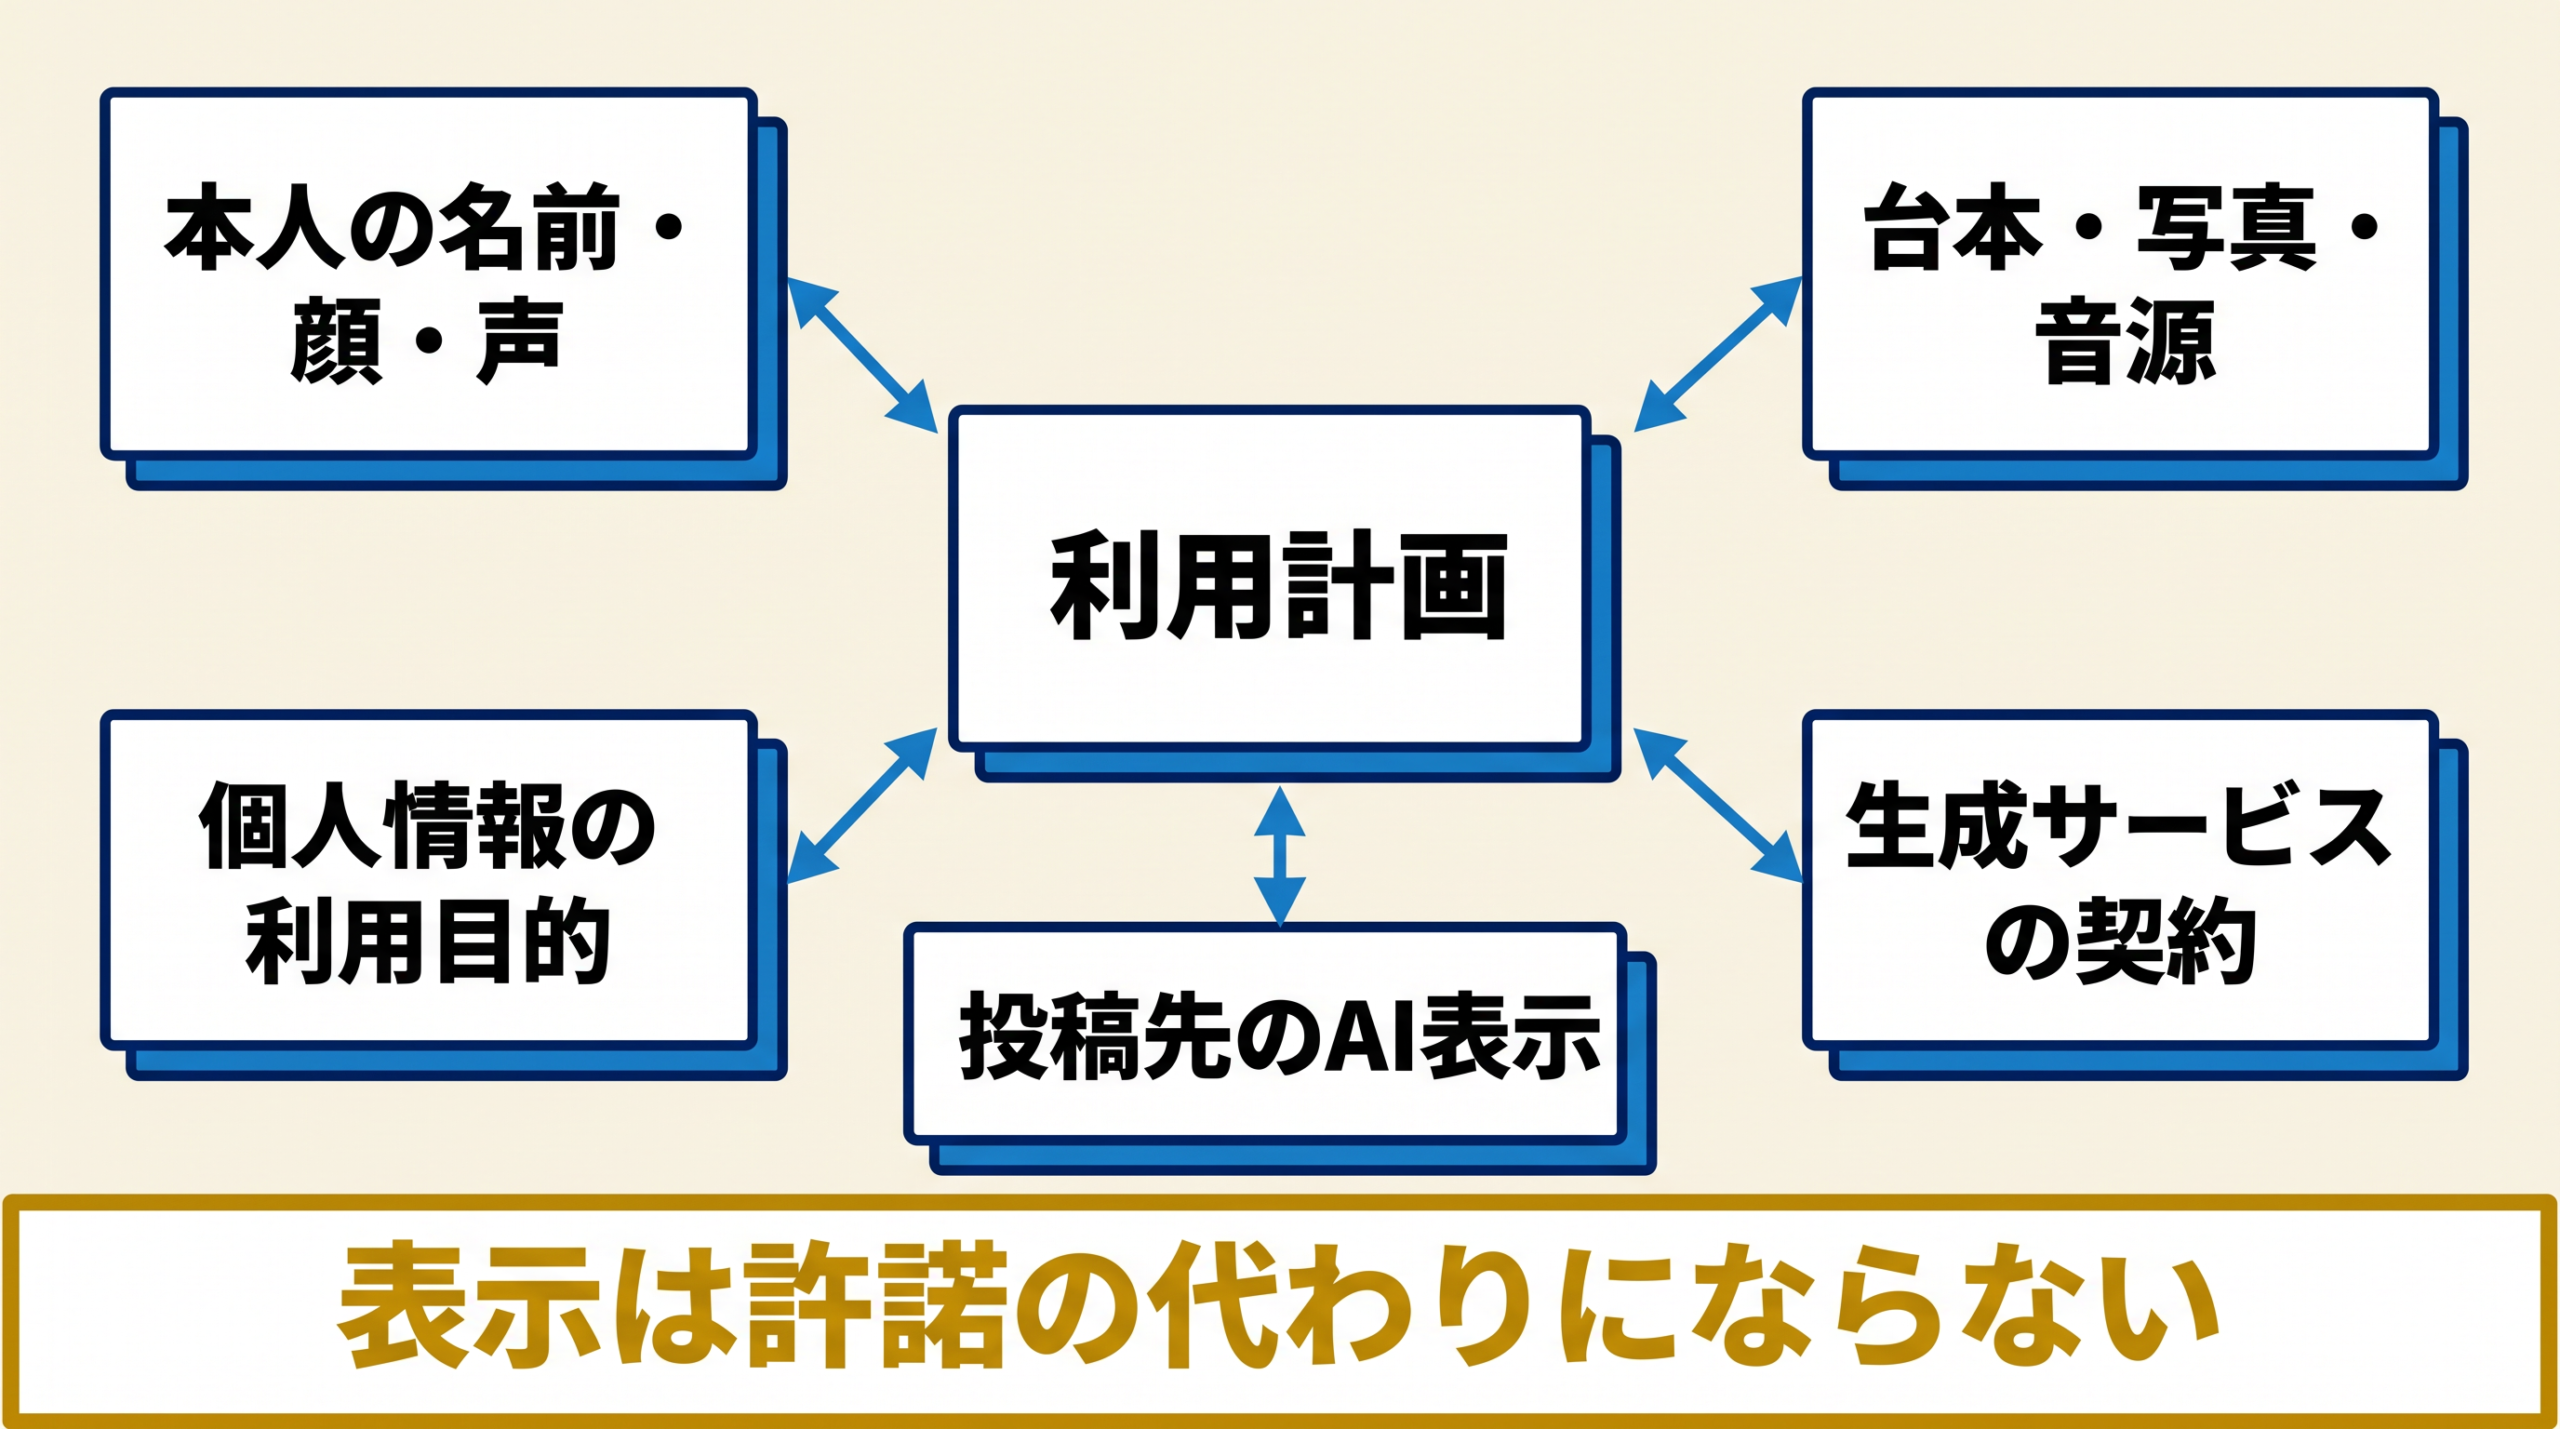
専門家の面談記録や知識をAIに入れて回答の草案を作らせるためには、さまざまな情報を扱います。このとき、個人情報や著作物などをひとまとめにせず、それぞれ別々に許可を取ることが重要です。
まず、日本の個人情報保護法では、情報を集める目的を決めることや、目的以外の利用を制限すること、ほかの国や第三者に情報を提供する際のルールなどが定められています。個人情報保護委員会の生成AIサービス利用への注意喚起でも、入力したデータがAIの学習に使われる場合、それが利用目的の範囲内かを確認するように求めています。
これはAIのために新しく作られた包括的な同意の法律ではなく、今あるルールをどう当てはめるかの説明です。そのため、扱う情報が個人情報にあたるか、取得した経路や目的、委託や第三者提供になるかなどを個別に確認しなければなりません。
次に、著作物や肖像の権利です。専門家本人が知識を使うことに同意しても、関係するすべての素材を自由に使えるわけではありません。たとえば、日本の著作権法には、作品を作った人の権利や、それをほかの人に譲るためのルールがあります。
また、文化庁のAIと著作権に関する考え方という行政の資料では、生成や利用の段階で権利を侵害しているか、AIが作ったものに著作権があるかなどを個別の事実関係から判断するとしています。
そのため、実務では権利を細かく分けて考えます。本人の名前や顔、話し方を使う許可と、第三者が作ったものを扱う許可は違います。具体的には、本人の声の許可と第三者制作の台本・音源の許可を別契約で確認するといった手続きが必要です。入力素材、AIの再学習への利用、利用期間も契約項目を分けます。
許可を取り消す方法と利用終了後のデータ削除も別に定め、複数の権利を混同しないようにします。
情報を海外へ向けて公開するなら、別の地域のルールも関わってきます。EUのAI Act本文では、2026年8月から、実在の人物に似ていて本物のように見えるAIが作った画像や音声に対して、人工的に作られたものだと示すことを求めています。
欧州委員会のArticle 50 FAQでも透明性の義務を説明していますが、AIだと表示さえすれば、本人の許可を得なくてよくなるわけではありません。
アメリカでは、米国著作権局のDigital Replicas Reportという報告書で、州ごとに法律の隙間があるため全国共通の連邦法を作るよう勧告されています。これはあくまで勧告であり今の連邦法ではないため、地域によって制度が異なります。法律の一般的な情報は参考になりますが、海外に向けた公開などを含めた具体的な事案の判断は、弁護士などの専門家に確認します。
さらに、公開するプラットフォームのルールも守る必要があります。YouTubeの合成コンテンツ開示規則や、TikTokのAI生成コンテンツ説明では、現実のように見える意味のある改変や合成に対してはっきりとラベルを付けることが求められています。
しかし、こうした投稿先の機能でAIだと表示しても、もとになる素材の権利確認を省略することはできません。AIが過去の許諾済み資料を探して回答案を作るところまでは任せられますが、どの情報をどこまで使ってよいかという許諾の範囲を守り、根拠や例外事項を確かめたうえで送信の最終判断をする役割は、人間に残されます。
2週間の小規模実証で7項目を測る
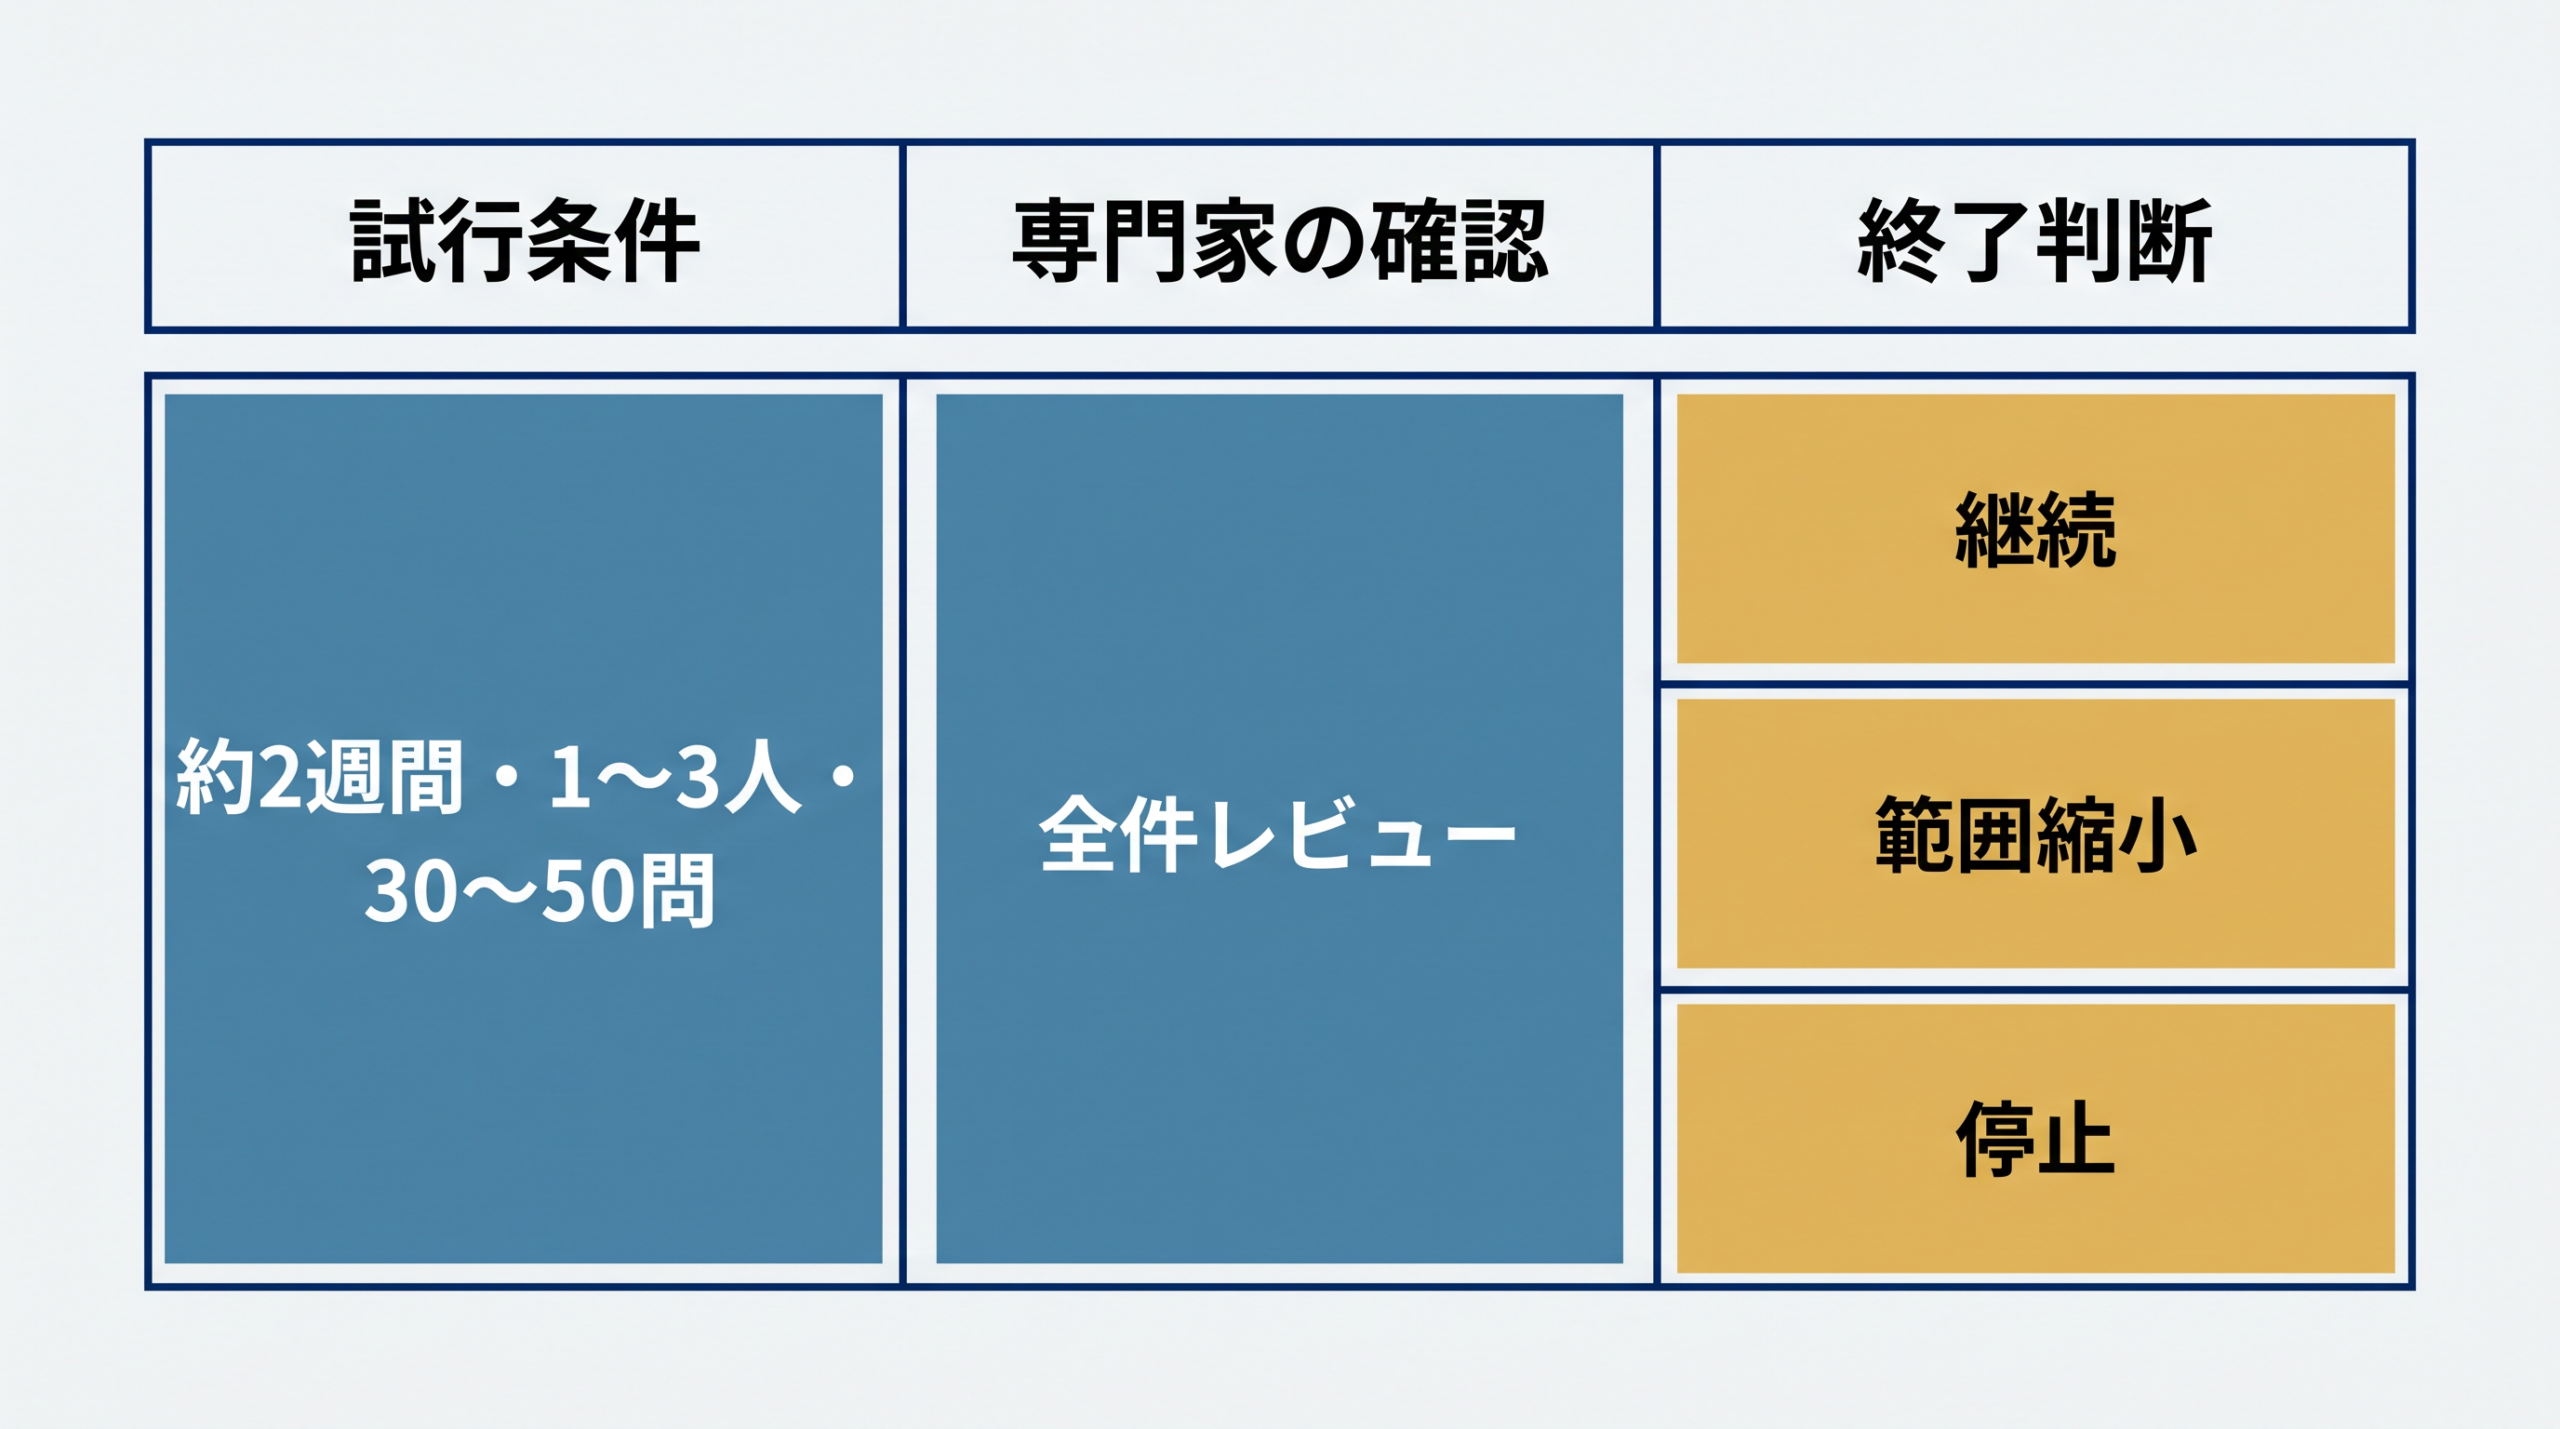
AIをいきなり本格的に導入するのではなく、まずは小さな範囲で試して、そのまま使い続けるかどうかの判断基準を作ります。この小規模なテストでは、外部で決められた公式の標準値ではなく、説明用の設計値として専門家1〜3人、頻出質問30〜50件を全件レビューするという規模から始めます。期間は約2週間です。
この規模に絞ることで、短期間でも専門家本人がすべての回答案を読んで確認でき、導入を判断する上で必要な失敗の傾向を観察できます。
テストは大きく6つの手順で進めます。 1つ目に、専門家本人や資料の権利を持つ人から、情報を利用してよい範囲を確認します。 2つ目に、AIに入力する資料へ管理番号となるsource_id、日付、分野、機密情報のレベルを付けます。 3つ目に、テストで使う代表的な質問と、専門家が回答として許せる条件をあらかじめ決めます。
4つ目に、AIが質問に対して回答案、その根拠となるsource_id、確信が持てない不明点、専門家への確認質問の4点を生成します。 5つ目に、専門家がその内容を読んで、承認するか修正するかを判断します。 6つ目に、ここまでの結果を記録し、AIの導入を継続するか、利用範囲を縮小するか、あるいは利用を停止するかを決めます。
このとき、AIが出した文章の正答率が高いかどうかだけで合否を決めてはいけません。正解の割合だけを見ていると、もっともらしい言葉での危険な断定や、根拠となる資料の取り違え、与えられていない権限の逸脱、AIではなく専門家本人だと誤認させるような表示を見逃してしまうからです。そのため、テストでは次の7項目を測定します。
測るのは、専門家が根拠と結論に同意した割合、重大な誤りの数、AIが適切に保留できた割合です。無修正で承認した数、AI回答のレビュー時間と従来の回答時間も比べます。さらに、無権限操作の有無と、相談者がAI支援による回答だと認識できた割合を記録します。
もしテストに合格して本格的に導入することになっても、その仕組みを専門家のAIコピーとは呼びません。相談者へは、本人が利用を許可した資料をAIが検索して回答案を作り、それを専門家本人が確認したものであると表示します。
また、次のような状況ではAIを使わずに専門家本人へ引き継ぐというルールを定めておきます。相談者が抱える複雑な事情が過去の資料にない場合、価値観が衝突している場合、後から取り返しがつかないような判断を求められている場合、相談者の感情の変化が大きい場合、そして責任者の署名が必要な場合です。
つまり、メンタリングのすべてを人間にするかAIにするかという二択ではありません。過去の膨大な資料から該当する情報を探し、頻繁に聞かれる質問の草案を作り、根拠を並べ、確認が必要な事項を抜き出す作業はAIに任せます。
一方で、その助言が目の前の相談者に適用できるかを判断し、言葉がどう届くかを確かめ、過去の記録にない例外を処理し、最終的な結果に対して責任を引き受けるという役割は人間に残します。このように専門家の知識を検索しやすくしつつ、本人が送信の承認と例外の判断を担う境界線を引くことが大切です。
人間に残るのは関係を更新する仕事
AIを相談の現場に導入する目的は、専門家の仕事をすべて機械に置き換えることではありません。AIが時間を省いてくれる作業と、人間が自ら担うべき判断を、実際の相談場面でうまく結び直すことが大切です。
AIに任せて省くことができるのは、膨大な過去の面談記録などの資料から関係する情報を探すことや、頻繁に聞かれる質問に対する回答の草案を作ることです。また、その回答の根拠となる資料を並べたり、まだ確認できていない不明点を抜き出したりする作業もAIの得意分野です。
一方で、人間に残されるのは、AIが作った回答案が目の前の相談者に本当に適用できるかを判断し、言葉が相手にどのように届くかを確かめ、最終的な結果に対して責任を引き受ける仕事です。
とくに、相談者が抱える複雑な事情が過去資料にない場合や、後から取り返しのつかない判断を求められている場面では、AIの草案にそのまま頼るのではなく、専門家本人へ戻して対応しなければなりません。相手の感情の変化が大きい場面や、複数の価値観が衝突しているような場面、あるいは責任者の署名が必要な手続きでも、人間による慎重な判断が欠かせません。
そして、メンタリングや相談の仕事において最も重要なのは、相談者との関係を更新していくことです。助言を受けた相手がそれをどう受け止め、実際に行動したことでどのような変化が起きたのかを観察し、その関係性の変化から次の新しい問いを作る仕事は、AIの回答案だけでは担えません。
この記事の結論は、相談役を人にするかAIにするかという単純な二択ではありません。専門家の過去の知識を検索しやすくして回答案の作成を支援させつつ、専門家本人が送信の承認や例外的な事態の判断を担うという境界線を設計することです。
この境界線を守ることで、専門家は情報を探して文章をまとめる時間を減らし、相談者と向き合って関係を深めていくための時間を作り出すことができます。
よくある質問
Q1. 面談記録をすべて入力すれば、自動で相談に乗るシステムを作れますか?
この設計では、AIに自動で相談者へ返信させません。AIは過去の記録から関係する資料を探して回答の草案を作るところまでを担当します。AIが作った回答案の根拠を確かめ、資料を使う許諾の範囲を守っているか、目の前の相手の状況にあてはまるか、過去の記録にない例外が含まれていないかを確認し、最終的に送信の判断をする役割は人間が行うという境界を引く必要があります。
Q2. AIコーチが人間の代わりになることを証明した研究はありますか?
人間の代わりになると確認できる研究は、今回確認した資料にはありません。歩数を数える4週間の試験など、目標を狭く絞った課題で支援の効果を調べた研究はあります。しかし、これらは対象となる人数や期間が限られた試験です。そのため、一部の改善が見られたからといって、AIが複雑な悩みを扱う専門家という人物そのものの代わりになると一般化して考えることはできません。
Q3. 過去の資料をAIに読み込ませる際、法律面で気をつけることは何ですか?
扱う情報をひとまとめにせず、別々に分けて許可をとることが大切です。個人情報保護法にそって情報の取得経路や利用目的を確認するほか、本人の名前や声を使うことと、第三者が作った著作物を扱うことの許可は別に考えます。一般的な法務の考え方は参考になりますが、実際にシステムを作る際の具体的な判断は、必ず弁護士などの専門家に確認してください。
Q4. 「AIが作りました」と表示しておけば、内容に誤りがあっても安全ですか?
安全ではありません。悪い助言の影響に関する実験では、それがAIから出たものだと事前にはっきりと伝えていても、悪い助言が参加者の不正直な行動を増やしてしまう影響を消すことはできませんでした。AIの回答であるという表示は必要ですが、それだけで相談者を守ることはできないため、専門家本人が内容の正しさを確かめて責任を引き受ける必要があります。
Q5. 導入前にテストをする場合、どれくらいの規模で行えばよいですか?
まずは専門家1人から3人、よくある質問30件から50件程度を選び、約2週間の期間で試すことをおすすめします。なお、この人数や質問の数、期間はどこかの機関が定めた公的な標準値ではありません。短い期間のあいだに専門家本人がすべての回答案を読み、どのような間違いが起きるかという傾向を安全に観察するために設定した、説明のための設計値です。
Q6. AIの回答案を使わずに、専門家本人が直接対応すべきなのはどんな場面ですか?
相談者の抱える複雑な事情がAIに入力した過去の資料にない場合や、感情の変化が大きい場面では人間の対応が必要です。採用や評価、医療、法律、投資などは、相手の人生に取り返しのつかない影響を与える場合があります。重大な判断が必要な場面ではAIを使わず、専門家本人が相談者と直接向き合って対話を続ける必要があります。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント