
あるプロジェクトで成果を上げたAI Skillを別の案件へ横展開しようとしたとき、元の条件や局所的な文脈に依存しすぎていて使い物にならない、と悩むAI推進担当者やSkill作成者は少なくありません。汎用的なSkillを構築しようとして、単にプロンプト内の固有名詞を一般的な言葉に置き換えるだけでは、AIは評価の前提を見失ってしまいます。では、一つの成功例から何を残し、何を変数化し、どの責任差でSkillを分ければ再利用できるのでしょうか。
本記事では、個別例の表面的な手順をなぞるのではなく、その裏側にある判断の骨組みを抽出するアプローチを解説します。読み終えるころには、成功事例を目的、入力条件、選択肢、判断基準、出力、合格条件へ分解し、固定値と変数を区別できるようになります。抽象化の粒度を適切に見直し、他の案件でも安全かつ確実に機能するSkillを設計するための指針としてご活用ください。
固有名詞を消すだけでは抽象化にならない
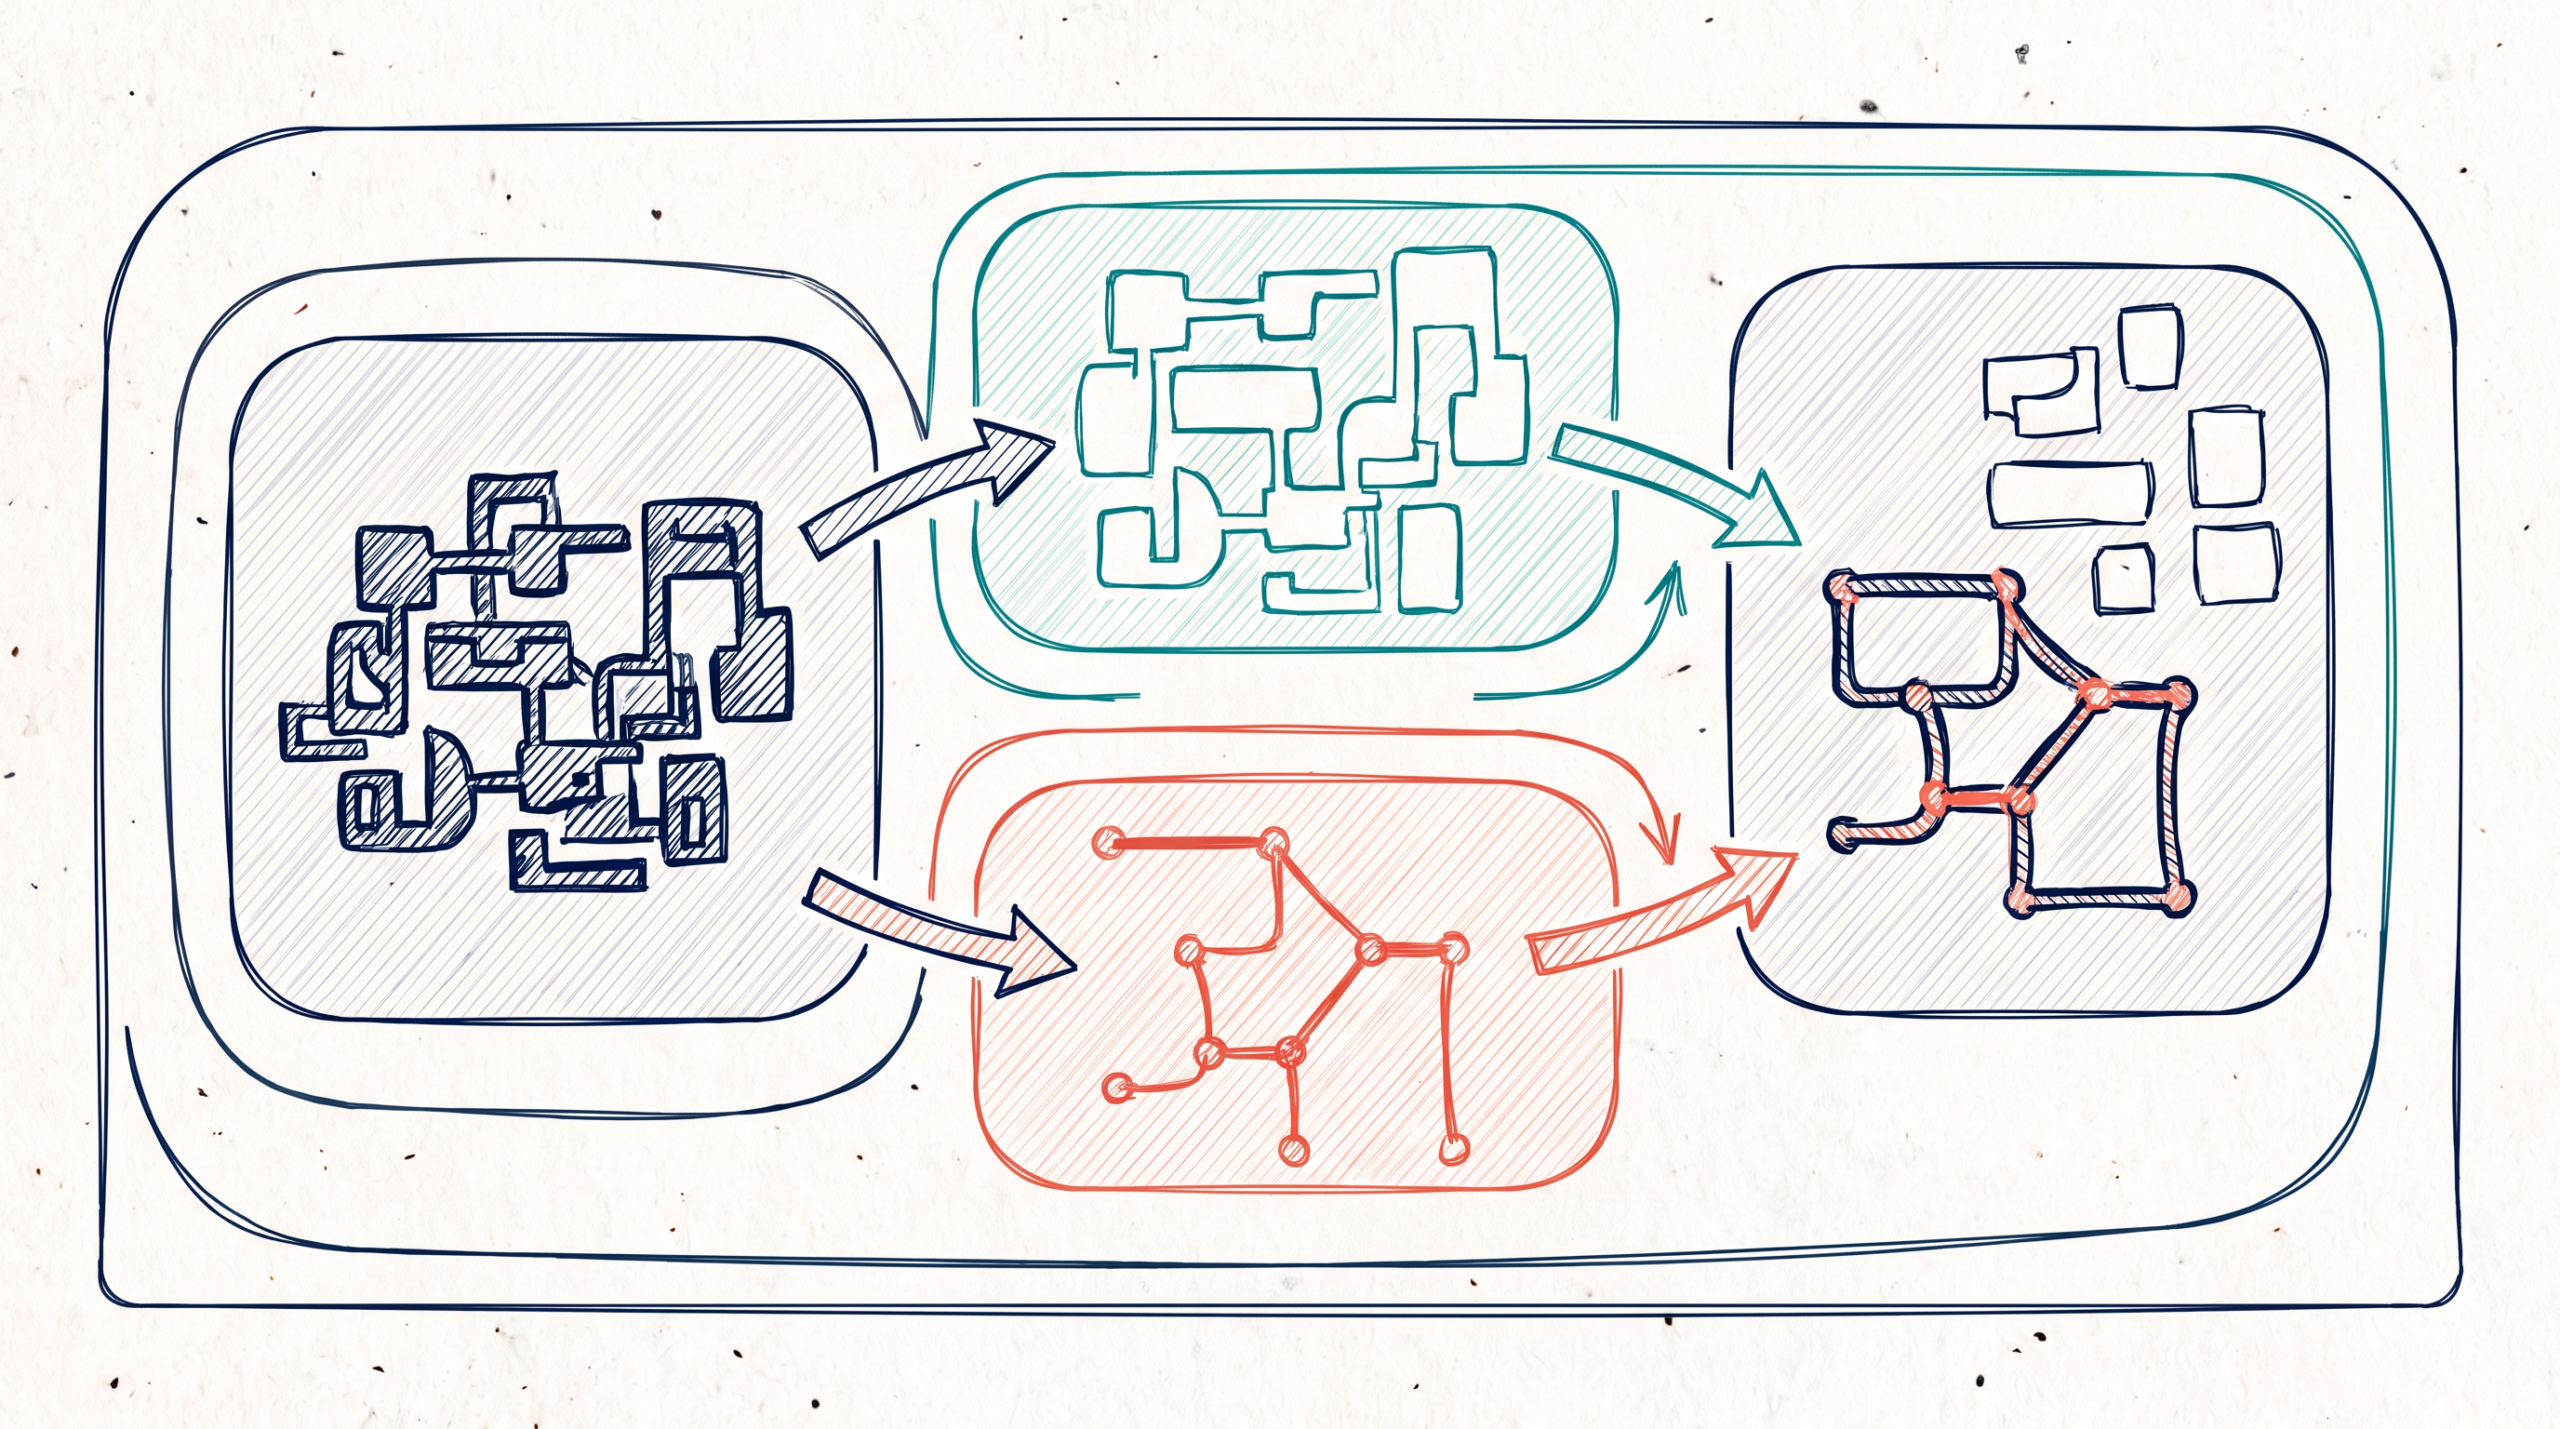
AIを活用した業務改善では、あるプロジェクトで成功したAI Skillを別の案件へ横展開しようとして失敗することがあります。その多くは、元のプロンプトに含まれていた特定の社名や製品名を一般的な名詞に置き換えただけで、再利用できる汎用的なSkillになったと錯覚してしまうことに起因します。
架空の事例として「A社の競合調査」という成功したSkillを考えてみます。このSkillを他の案件でも使えるようにしようと、プロンプト内の「A社」という固有名詞を単に「企業の調査」へ置換し、対象企業を変数化して入力を促す形に変更したとします。一見すると抽象化されたように思えますが、これでは実際には使い物になりません。なぜなら、元の成功例にあった「価格帯とターゲット層の重複度合いをマトリクスで比較する」といった暗黙の比較軸や前提条件まで抜け落ちてしまうからです。個別例を無理に一般化すると、AIはどのような基準で情報を集め、どのように評価すべきかの判断構造を見失い、誰にでも当てはまる表面的な結果しか出力できなくなります。
表面的な言葉の置換と、判断構造の抽出は明確に区別しなければなりません。システム開発の要求定義においてGOV.UK discovery guidanceは、事前に与えられた解決策を鵜呑みにせず、利用者が本当に達成したい問題へと目的を言い換え、同時に対応しない範囲外についても合意するよう求めています。AI Skillの抽象化においても同様に、元の事例の表面的な手順をなぞるのではなく、それが「何を解決するためのものだったのか」という目的の核心を捉え直すプロセスが不可欠です。
再利用可能なSkillを構築するためには、置換対象となる単語だけでなく、AIが動作するための文脈そのものを設計する必要があります。Claude Code公式は、Skillのdescriptionが目的と利用場面を的確に伝え、参照ファイルを段階的に読み込む構造を持つことの重要性を説明しています。ただ固有名詞を消して空欄を作るのではなく、AIが別の案件でも同じ基準で判断を下せるように、目的、利用する場面、そして必要な情報を読み込む順序といった判断構造そのものを抽出することが、本当の意味での抽象化の第一歩となります。
成功例を目的・条件・選択肢・基準へ分解する
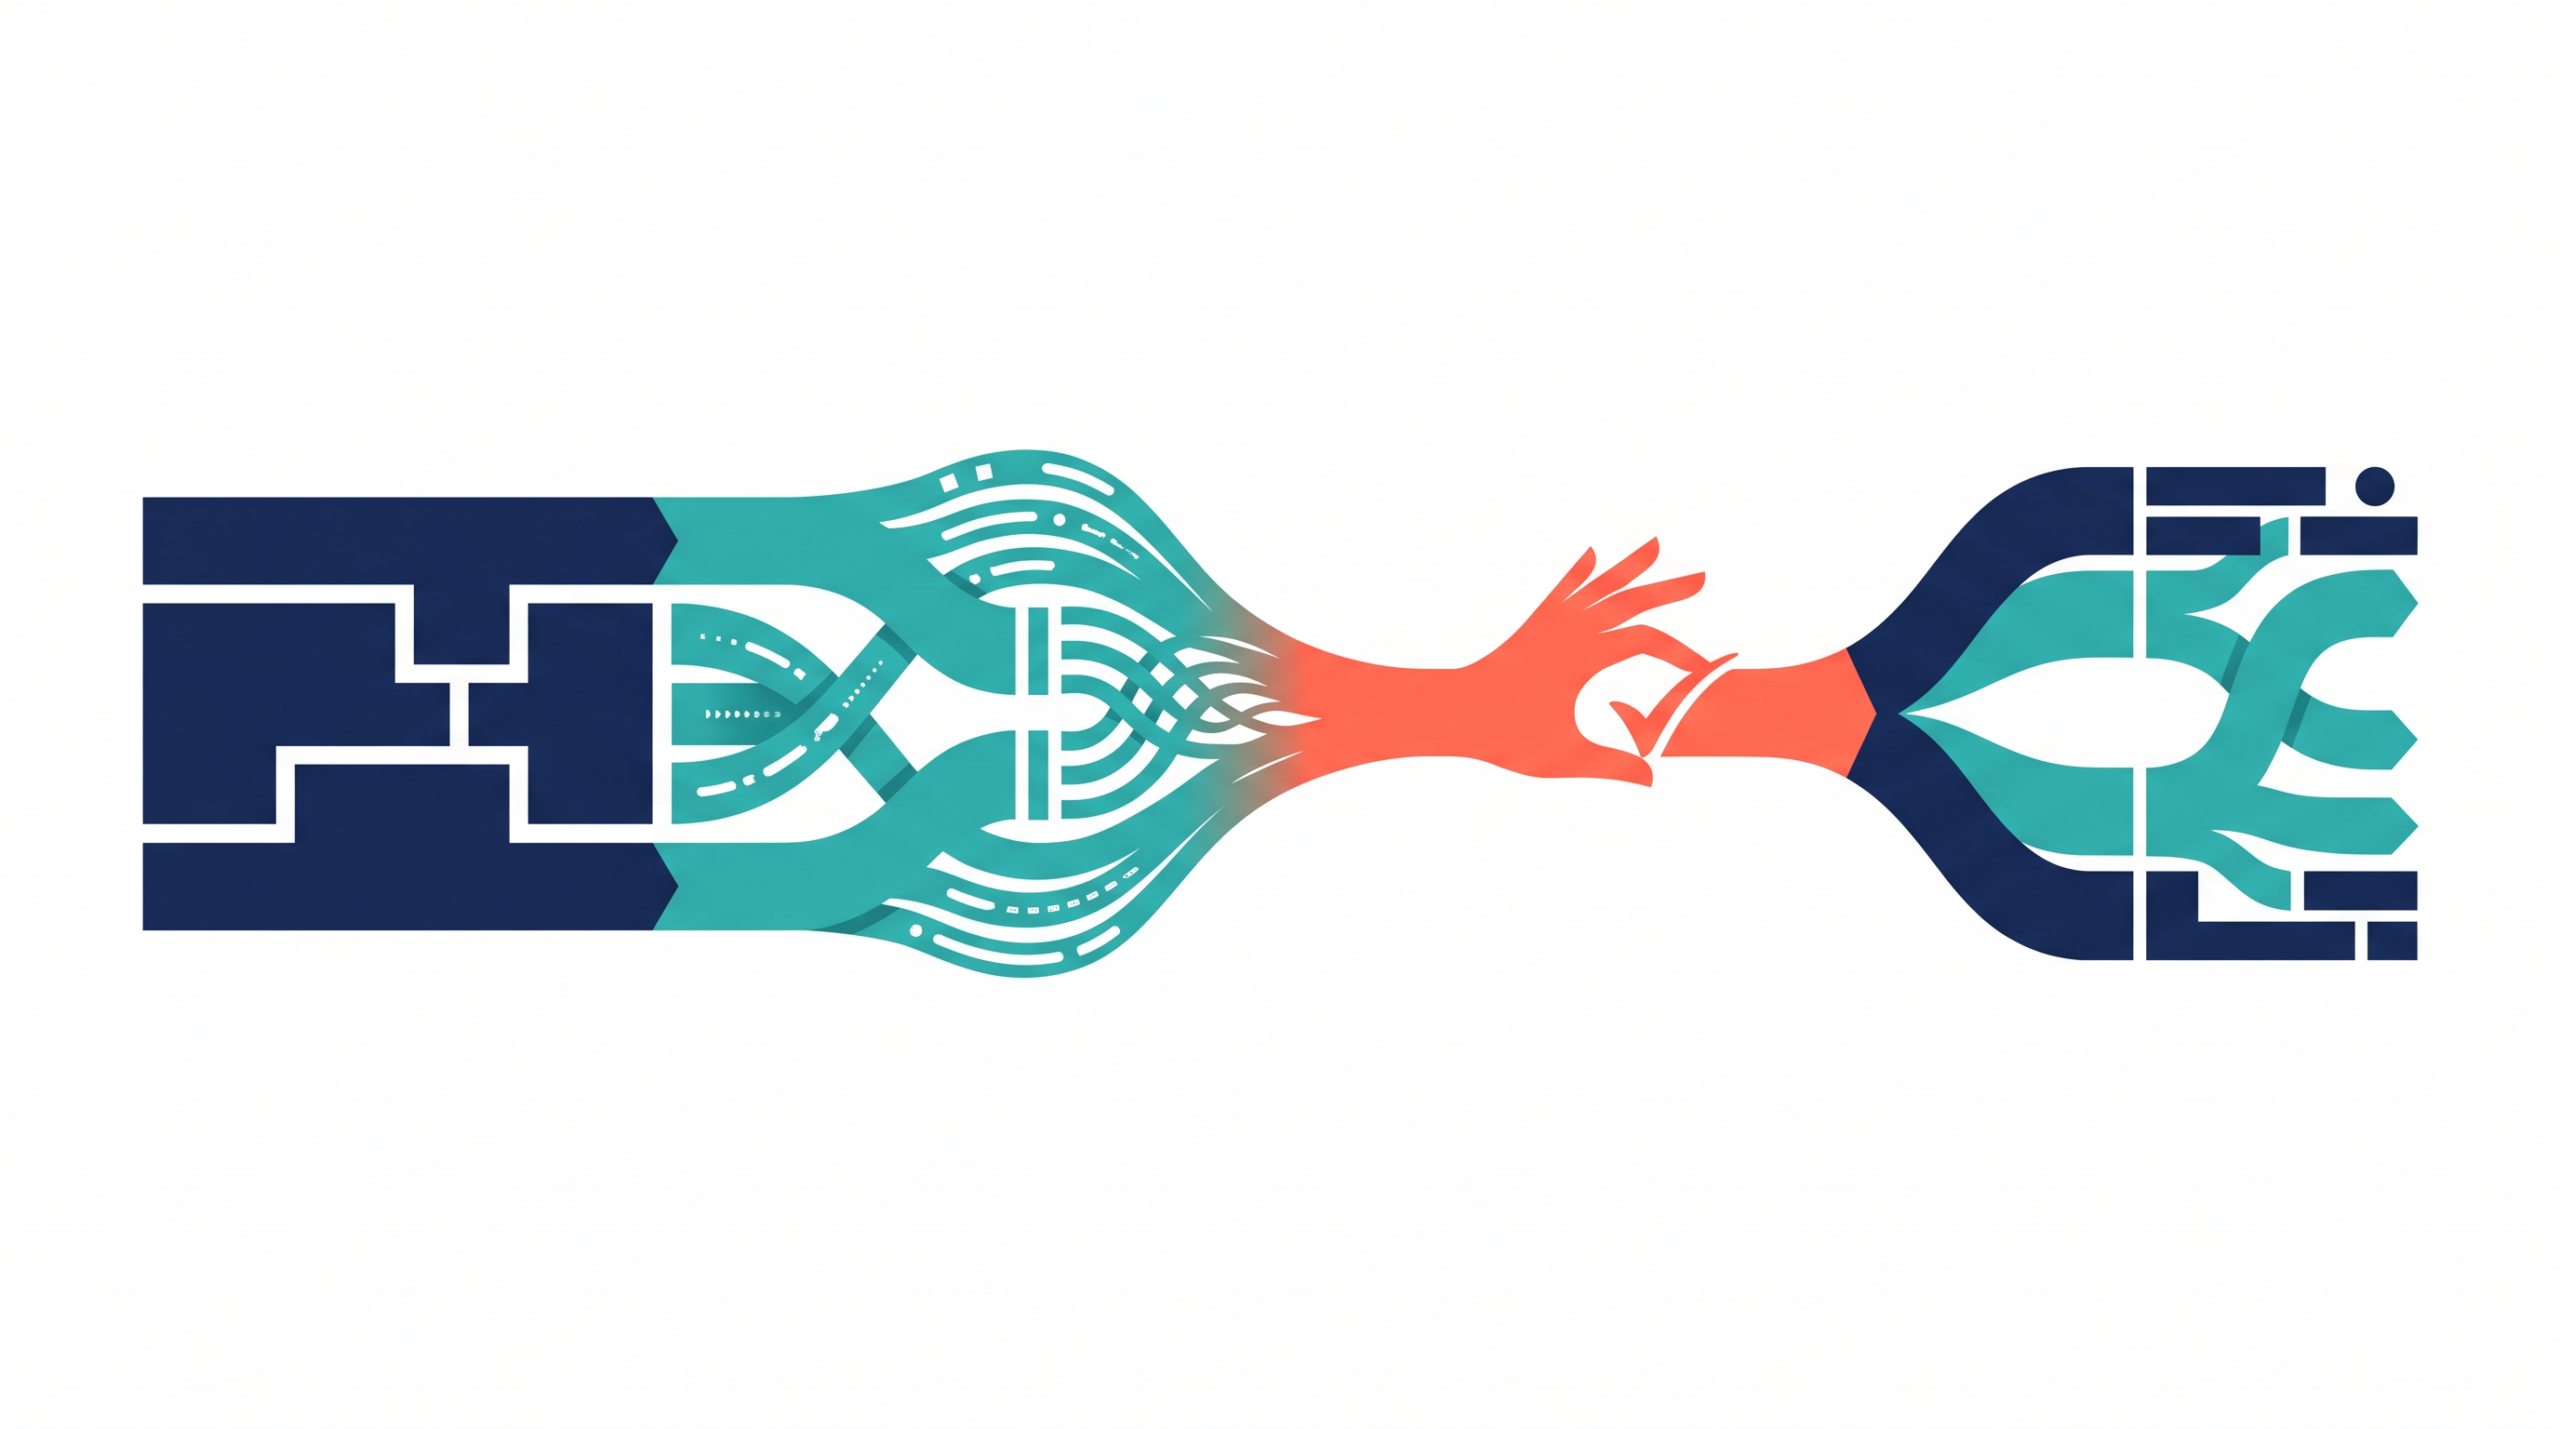
AIが別の案件でも過去の成功例と同じように適切な判断を下せるようにするには、一体何を残せばよいのでしょうか。その答えは、元の事例を構成する判断のプロセスを「目的」「入力」「候補」「採用基準」「成果物」「合格条件」という六つの要素へ分解し、再構築することにあります。
この分解作業において重要になるのが、表面的な手順の裏にある本来の意図を掘り下げることです。GOV.UK discovery guidanceでは、事前に与えられた解決策をそのまま鵜呑みにせず、利用者が本当に達成したい問題へと目的を言い換え、同時に対応しない範囲外の事象についても合意するよう求めています。これに倣い、成功したAI Skillの挙動を六つの要素で読み直すことで、判断の再現に必要な骨組みだけを抽出できます。
たとえば、「過去のプロジェクトレポートから有望な施策案を抽出する」という架空の事例を要素に分解すると、次のように整理できます。
- 目的: 過去の実績から次期プロジェクトに転用可能な施策を見つけ出す(単なる文字検索ではないことを定義する)
- 入力: 過去3年分の完了報告書と、現在のプロジェクトの予算や制約事項
- 候補: レポート内に記載されたすべての実施施策
- 採用基準: 「実施コストが予算内に収まるか」「効果の記載が定量的か」などの評価ルール
- 成果物: 施策の概要、想定効果、参照元リンクをまとめた比較リスト
- 合格条件: 抽出漏れがなく、意思決定者がそのまま採用可否を判断できる粒度になっていること
このように分解することで、「過去の完了報告書」を別のドキュメントに差し替えたとしても、AIは「何を対象に」「どういう基準で選び出し」「どのような形で提示すれば合格か」という判断構造を見失わずに済みます。
さらに、これらの要素を定義することは、AIの出力に対する信頼性を担保する上でも欠かせません。NIST AI RMF Coreは、AIシステムの利用文脈、目的、起こりうる影響、そして専門家による妥当性確認を、Map(マッピング)およびMeasure(測定)の機能として扱うよう求めています。つまり、採用基準や合格条件をあらかじめ設定し、最終的に専門家(人間)が確認するための評価基準を明確にしておくことが、AIの実運用におけるリスク管理として機能するのです。
一つの成功例を六つの要素で読み直すことにより、再利用時に何を残せば判断を再現できるかが明らかになります。次はこの構造をもとに、どの部分を固定し、どこを利用者に委ねるかを決めていきます。
固定値と変数は失敗時の影響で分ける
前節で判断のプロセスを六つの要素に分解しました。次に行うべきは、その要素の中で「どこまでを利用者に変更させるか」、すなわち変数(変えてよいもの)と固定値(禁止するもの)の境界を引くことです。何でも変更できるように変数を増やせば再利用性は見かけ上高まりますが、AIが前提条件を見失い、意図しない出力を引き起こすリスクも跳ね上がります。
この境界を決めるための判断基準は「失敗したときの影響度」です。AIシステムのリスク管理において、NIST AI RMF Coreはシステムの利用文脈、目的、起こりうる影響をマッピングし、専門家による妥当性確認を測定(Measure)の枠組みで扱うよう求めています。これをSkillの設計に応用すると、万が一AIが誤った判断をした場合に致命的な影響を及ぼす部分は「固定ルール」として利用者の変更を禁止し、出力の調整にとどまる部分は「変数」として入力に委ねる、という切り分けになります。
架空の具体例として、商談の議事録から提案書の下書きを作成するSkillを考えてみましょう。この場合、生成されるドキュメントの「出力先フォルダ」や「強調したい製品機能」は案件ごとに異なるため、利用者に都度指定させる「変数」とします。一方で、「顧客データの外部送信禁止」や「社内機密情報を扱う際のマスキング処理」といったセキュリティに関わる要件は、利用者のミスやAIの誤認で無視されると重大なインシデントに直結します。そのため、これらは利用者が変更できない固定ルールとして定め、機密データへのアクセスや外部送信はSkillの指示だけに任せず、システム側の権限制御でも制限します。
変数を設ける際も、利用者に白紙から入力させるのではなく、適切な誘導が必要です。Claude Code公式では、Skillのdescriptionがその目的と利用場面を的確に伝え、参照ファイルを段階的に読み込む構造を持つことの重要性を説明しています。利用者が入力すべき変数の条件をdescriptionで明示し、AIがその変数を受け取った後に、あらかじめ決められた固定のガイドライン(参照ファイル)を読み込んで作業を進める仕組みにすることで、自由度と統制を両立できます。
さらに忘れてはならないのが、「人へ戻す条件」を固定値として定義しておくことです。例えば、「指定された予算要件が基準値から大きく外れている場合」や「外部送信禁止のデータが含まれているかAI自身が判断しきれない場合」には、無理に出力を生成せずエラーを返し、専門家(人間)の確認を求めるよう明記します。変えてよいものを利用者に委ね、禁止するものと判断を諦める条件を固定することで、初めて安全に再利用できるSkillとなります。
責任と検証方法が違う工程は別Skillにする
前節で固定値と変数を分ける基準として「失敗時の影響度」を挙げました。影響度が違うということは、システムや担当者に求められる責任の重さが違うということです。この考え方は、ある業務全体を一つの巨大なSkillで処理させるか、それとも複数のSkillに分割するかの判断基準にも直結します。「どこでSkillを分割するか」を見極めることで、再利用性はさらに高まります。
すべての工程を一つのSkillに詰め込むと、AIに与える指示や前提条件が膨大になります。これにより本来無関係な情報が干渉し合い、出力の精度が落ちるリスクが高まります。Anthropicのcontext engineering解説では、必要な情報を必要な時に読み込む段階的開示を行い、コンテキスト汚染の回避を図ることの重要性が説明されています。だからといって、あらゆる手順を極小のSkillに細分化しすぎると、今度は利用者が手作業でSkillを順番に実行する手間が増えてしまいます。この巨大化と細分化の中間をとるための明確な線引きが、「責任と検証方法が違う工程は切り離す」というルールです。
架空の具体例として、社内ポータルサイト向けにレポートを作成する「検索」「評価」「公開」という一連のプロセスを考えてみます。過去の資料から情報を「検索」し、下書きの質を「評価(推敲)」するまでの工程は、作成担当者の作業範囲内で完結し、AIの出力結果を自身で確認できれば十分です。しかし、最終的な「公開」の工程には、機密情報が含まれていないかのコンプライアンスチェックや、管理者の正式な承認といった、前段までとは全く異なる責任と検証方法が求められます。このように責任の所在と検証の厳密さが変わる境界線において、検索・評価を行うSkillと、公開手続きのみを担うSkillを明確に分割するのです。公開だけ承認が必要なので別Skillへ分けるという設計にすることで、それぞれに適切な権限設定や安全装置を組み込むことが可能になります。
複数のSkillに分割した後は、利用者が迷わずに使い分けられる仕組みが必要です。Claude Code公式は、Skillのdescriptionが目的と利用場面を伝え、参照ファイルを段階的に読み込む構造を説明しています。これを活用し、「このSkillは下書きの評価までを行い、公開手続きには専用の別Skillを使用してください」とdescriptionに明記しておきます。これにより、利用者は業務のフェーズに合わせて適切なAIの支援を安全に選択できます。責任と検証方法の違いに着目して工程を切り分けることで、過度な複雑さを避けつつ、他の案件でも再利用しやすいSkillの単位が見えてきます。
未知の事例でテストして判断基準を更新する
前節までで、成功事例の判断構造を抽出し、固定値と変数を定め、責任分界点に応じてSkillを分割する手法を解説しました。しかし、ここまでの設計を終えた時点では、まだ「このSkillは他の案件でも確実に再利用できる」と断言はできません。では、抽象化が十分かどうかをどう測ればよいのでしょうか。その答えは、元の成功例(既知例)だけでなく、未知の事例、判断に迷う境界例、そして意図的に失敗を誘発するような事例を用いてテストを実施し、AIの挙動を確かめることにあります。
AIシステムにおける評価の重要性について、NIST AI RMF Coreはシステムの利用文脈、目的、起こりうる影響をマッピングしたうえで、専門家による妥当性確認を測定の枠組みで扱うよう求めています。Skillの抽象化プロセスにおいても同様に、設計した判断基準が新しい利用文脈で正しく機能するかを、意図的なテストを通じて専門家である人間が検証しなければなりません。
架空の具体例として、「過去の提案書から重要課題を抽出するSkill」を、元事例とはまったく異なる業界の案件に適用するケースを想定してみます。元々がIT業界の事例だったSkillに対し、未知の事例として「飲食チェーンの新店舗開発」に関する要件定義書(brief.md)を入力してみます。このとき、AIがIT業界の暗黙の前提に引きずられて見当違いの課題を抽出する誤選択を起こさないかを観察します。もし、元の業界特有の用語や文脈に影響されて出力が歪むようであれば、抽象化不足や不要な文脈混入の兆候として原因を切り分けます。
こうした問題を防ぎ、抽象化の精度を高めるための手段として、Anthropicのcontext engineering解説は、必要な情報を必要な時に読み込む段階的開示と、コンテキスト汚染の回避について説明しています。テストを通じて情報の混同が見られた場合は、Skillが最初からすべての前提条件を読み込むのではなく、新しく入力されたbrief.mdの業界情報を正しく解釈してから、次に抽出の基準となる参照ファイルを読み込むように段階的開示の手順を修正し、判断基準を更新します。
さらに、テストにおいてはAIの誤選択だけでなく、人への引継ぎが正しく行われるかを記録することも極めて重要です。入力された未知の事例がSkillの対応範囲を逸脱している境界例や失敗例であった場合、AIが無理に答えをひねり出すのではなく、あらかじめ設定した固定ルールに従って判断不能とし、適切に人間の担当者へ処理を差し戻せるかを確認します。
既知例で想定通りの成果物が出るのは当然のことです。元事例とは異なる業界のファイルを入力し、誤選択の有無や人への引継ぎの挙動を記録して検証することで、初めて抽象化の不足部分が浮き彫りになります。未知の事例によるテスト結果をもとに判断基準と段階的開示のタイミングを更新すると、確認した利用範囲で再利用できるSkillへ近づけられます。
よくある質問
Q1. 変数と固定値を分ける際、利用者にどこまで自由に入力させるべきでしょうか?
利用者に白紙から入力させるのではなく、案件ごとに変更してよい変数だけを明示的に埋めさせるように設計します。Claude Code公式が示すように、Skillのdescriptionで利用場面と目的を的確に伝え、必要なパラメータ(変数)の条件を指定します。AIがその変数を受け取った後、あらかじめ決められた固定のガイドラインとなる参照ファイルを読み込んで作業を進める仕組みにすることで、利用者の自由な入力とAIの判断の統制を両立させることができます。
Q2. 「人へ戻す条件」はどのように定義し、実行時に正しく動作するかを確認すればよいですか?
「AIが独自の基準で判断を下せない例外的な入力があった場合」や「影響度の高い固定ルールに抵触する場合」などを明記し、AIが無理に出力を生成せずエラーを返して人間の担当者へ処理を差し戻すよう条件を固定値として組み込みます。その確認方法として、あえてSkillの対応範囲を逸脱する境界例を用いたテストを実施します。NIST AI RMF Coreが専門家による妥当性確認を測定の枠組みで扱うよう求めている通り、テスト時に人への引継ぎが設定通りに行われるかを専門家が検証することが必須です。
Q3. 巨大なSkillを分割すべきか迷った際、実行時の具体的な目安はありますか?
作業の「責任の所在」と「検証方法の厳密さ」が変わるタイミングが、分割を行う明確な目安となります。たとえば、下書きの推敲までを担当者自身が確認する工程と、コンプライアンスチェックを経て管理者が承認する公開手続きでは、求められる責任の重さが異なります。これらを別のSkillに分割したうえで、Claude Code公式で説明されているようにdescriptionを活用し「公開手続きには専用の別Skillを使用してください」と利用者に案内することで、利用者が迷わずにSkillを使い分けられるようになります。
Q4. ユーザーから提供された元の事例の目的を、そのままSkill化してはいけないのでしょうか?
元の事例でとられた解決策をそのまま鵜呑みにすると、局所的な文脈に依存しすぎて別の案件で再利用できなくなります。GOV.UK discovery guidanceが求めているように、事前に与えられた解決策ではなく、利用者が本当に達成したい問題へと目的を言い換える必要があります。また、その際に「このSkillが対応しない範囲外の事象」についても合意しておくことで、一つのSkillに過剰な機能が詰め込まれ、実行時に破綻するのを防ぐことができます。
Q5. 別業界など未知の事例に適用した際、元の事例の文脈に引きずられるのを防ぐにはどうすればよいですか?
元の事例特有の用語や文脈に影響されてAIの出力が歪む場合は、情報を読み込ませる順序を見直します。Anthropicのcontext engineering解説では、必要な情報を必要な時に読み込む段階的開示とコンテキスト汚染の回避が推奨されています。テスト時に文脈の混同(コンテキスト汚染)が見られたら、すべての前提条件を一度に読み込むのではなく、新しく入力された未知の事例の情報を解釈してから、次に評価基準となる参照ファイルを読み込むように情報の開示手順を修正してください。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント