
AIエージェントに自律的なタスクを任せようとしたとき、開発者やAI推進担当者が最初に直面するのは「期待通りに作業を完了してくれない」という壁です。たとえば、架空のサンプルWebアプリの修正をエージェントに依頼し、ログイン画面のボタン配色やエラーメッセージの表示タイミングを直すよう指示したとします。このとき、エージェントが仕様ファイルを見つけられずに推測でコードを書き換えたり、修正後のテストを自分で実行することなく「完了しました」と早々に報告してきたりするケースは珍しくありません。こうした問題が起きたとき、より推論能力の高いモデルへ切り替えたり、プロンプトの指示をさらに細かくしたりして解決を試みがちですが、モデルだけを変えても失敗はそのまま残ってしまいます。
なぜなら、言語モデル自身はファイルシステムを探索したり、テスト環境を動かしたり、作業の進捗を記憶して状態を維持したりするための「外の世界」を直接持っていないためです。本記事では、モデルやプロンプトの調整ではなく、エージェントが必要な情報へアクセスし、道具を使いこなすための実行基盤である「ハーネス」をどう設計するかを解説します。CodexとClaude Codeでは、どの設定を変えれば作業条件を整えられるかも、公式資料に沿って見ていきます。最後までお読みいただくことで、まずは公開可能な小さな作業を対象に、エージェントへ渡す資料の入口、許可するツール、そして人が後から間違いなく検証できる証拠を残すための具体的な実行条件をご自身で決められるようになります。
モデルを変えても残る失敗は実行環境から見直す
AIエージェントに自律的なタスクを任せようとしたとき、開発者やAI推進担当者が最初に直面するのは「期待通りに作業を完了してくれない」という壁です。
たとえば、架空のサンプルWebアプリの修正をエージェントに依頼する場面を想像してください。「ログイン画面のボタンの配色を変更し、エラーメッセージの表示タイミングを修正してほしい」と指示を出します。このとき、エージェントがプロジェクト内のどこにデザインの仕様ファイルがあるかを見つけられず、推測だけでコードを書き換えてしまうことがあります。さらに、修正後の画面が正しく表示されるか、エラーが意図通りに出るかを自分で確認することなく、「修正が完了しました」と早々に報告してくるケースも少なくありません。
また、作業の途中で予期せぬエラーに遭遇した場合、どこまで進んだのかという状態を失ってしまい、最初から同じ手順を繰り返したり、人が書いた指示の本来の意図を途中で忘れてしまったりすることもあります。
このような失敗が起きたとき、私たちはつい「プロンプトの書き方が悪かったのではないか」と考え、より詳細な指示を追加したり、より推論能力の高い最新の言語モデルへ切り替えたりして解決しようとしがちです。しかし、モデルや指示を改善しても、資料の場所や実行可能なテストが与えられていなければ、確認漏れは残り得ます。
なぜプロンプトやモデルの変更だけでは直らないのかといえば、言語モデル自身は、ファイルシステムやテスト実行環境、作業の履歴といった「外の世界」を直接持っていないためです。仕様ファイルがどこに置かれているかを探す手段や、修正結果を確かめるためのテストツール、そして作業の進捗を記録して状態を失わないようにする仕組みが最初から与えられていなければ、いくらモデルの推論能力が高くても正しい手順を踏むことはできません。
つまり、資料を正しく読み込み、状態を保ちながら作業を進め、テストを実行してから完成を宣言するといった行動を実現するには、モデルへの指示を調整するだけでは不十分です。モデルが活動するための外側の仕組み、すなわち必要な情報へのアクセスや許可されたツールの提供、そして人が検証できる形で成果物を残すための「実行環境」そのものを見直す必要があります。
ハーネスは情報・ツール・状態・検証をつなぐ実行基盤
AIモデルが自律的に活動するためには、モデル自身と実際の作業環境(ファイルやシステム)の間を取り持つ「実行基盤」が必要です。この中間層にあたる仕組みは「ハーネス」と呼ばれます。
最近のプレプリントで提案されている枠組みでは、AIエージェントのシステムを「モデル」「ハーネス」「環境」という3つの層に分け、11の責務を定義して整理しています。開発の現場においては、このハーネスを「エージェントにどんな情報を渡し、どんな操作を許し、その結果をどう記録するか」を実用的に束ねる基盤として設計します。
前節で挙げたサンプルWebアプリの修正を例に、ハーネスが何を設計するものなのかを見てみましょう。エージェントに「ログイン画面のボタンの色とエラーメッセージの修正」を依頼する際、直接プロンプトにすべてを書き込むのではなく、実行基盤としてのハーネスを通じた準備を行います。
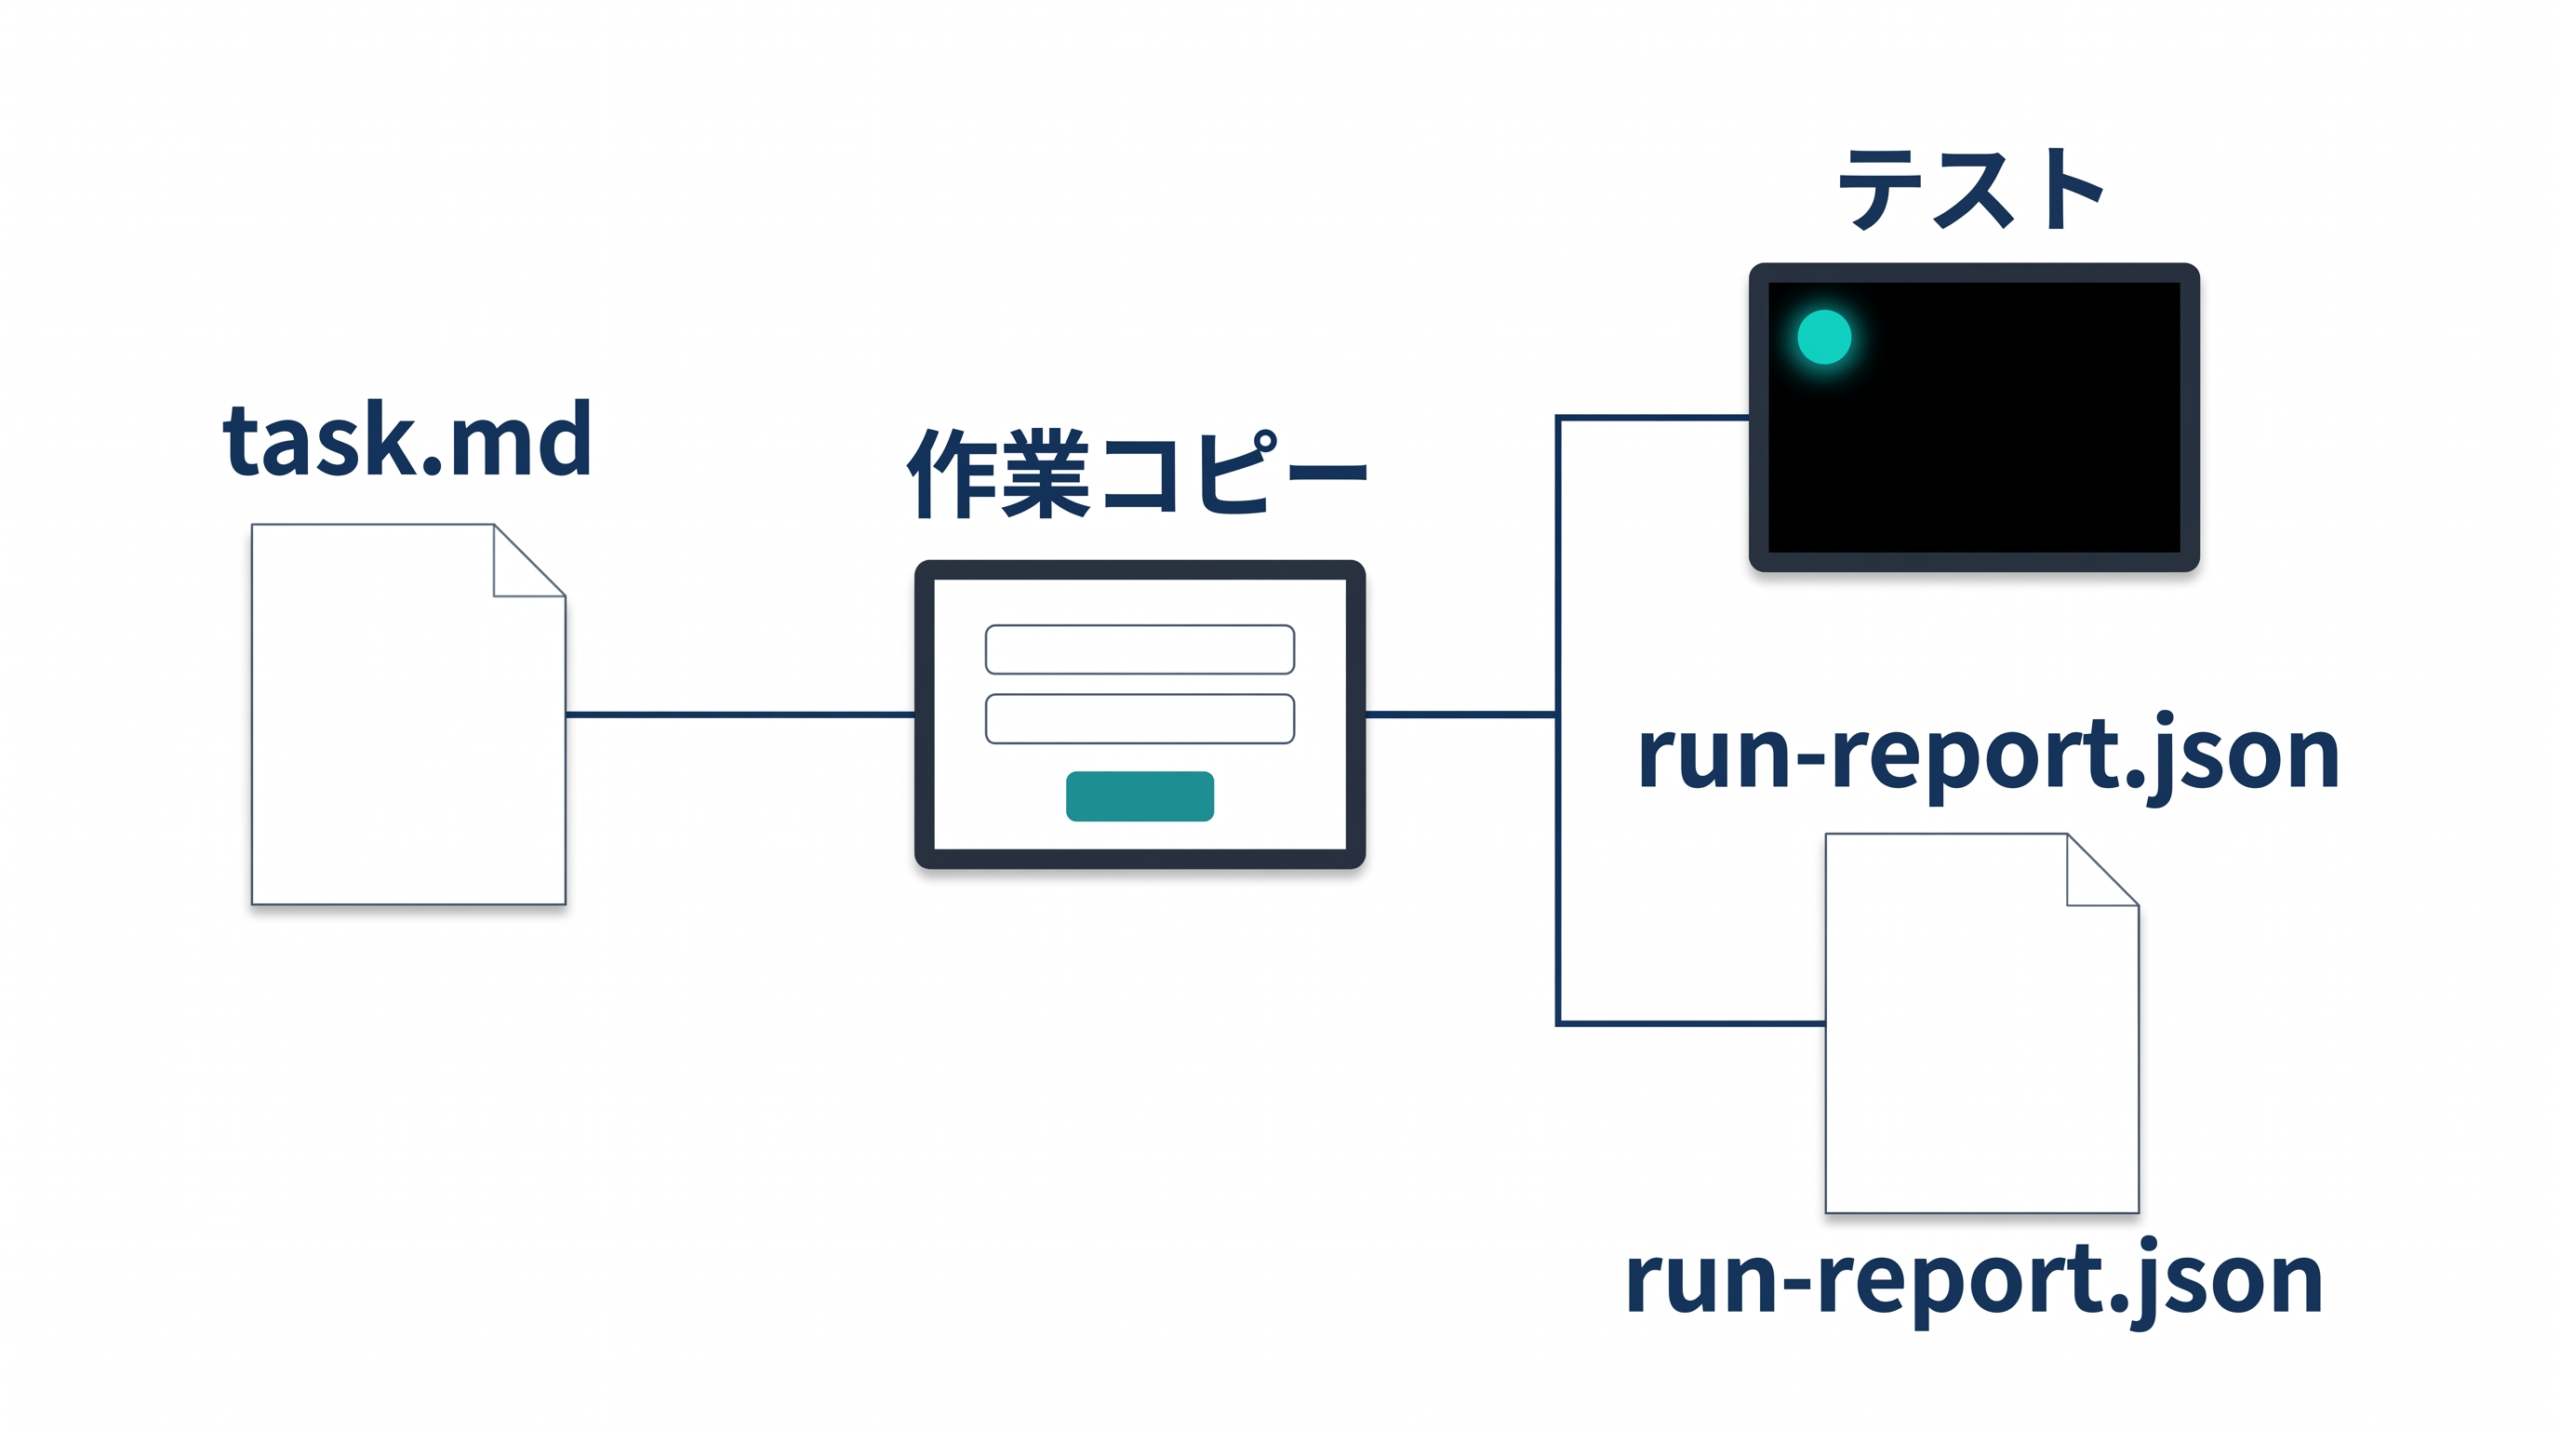
まず、エージェントが読むべき「タスクの目的や制約」をまとめた task.md を作業環境に配置し、それを読み込む経路を提供します。これが作業にあたっての入力情報の整理です。次に、本番へ直接触れないよう、公開可能なサンプルの作業コピーを用意し、実行アカウントの書き込み先もそこへ制限します。エージェントには、この隔離されたコピー内でのファイル編集と、修正を確認するための特定の「テストコマンド」の実行だけをツールとして許可します。これが操作と権限の管理です。
そして作業が完了した際、エージェントに「修正しました」というテキストの返答だけで終わらせず、どのような手順でファイルを変え、テストコマンドがどんな結果を返したかを run-report.json のような構造化データとして保存させます。これが後から検証するための出力となります。
このように、task.md で情報を与え、許可済み作業コピーとテストコマンドで安全な操作の範囲を定め、run-report.json で結果を検証可能にすることが、一つの修正作業におけるハーネス設計の具体的な役割です。
ただし、Anthropicが多層防御の必要性を説明しているように、モデル・ハーネス・ツール・環境を区別して防御を重ねても、それ単体でシステムの性能や安全性が完全に保証されるわけではありません。単一の防御に依存せず、機械的なツール実行の基盤を整えるとともに、残された状態やログをもとに人がいつでも介入し、事後確認できる証拠を残す仕組みを作ることが、ハーネス設計において不可欠となります。
コンテキスト選択とハーネス設計は時間幅が違う
エージェントにどのような情報を与えるかを考える際、「それはコンテキストエンジニアリングと同じではないか」という疑問を持たれることがよくあります。たしかに、どちらもモデルへ適切な資料を渡すことを目的としていますが、両者は対象とする「時間幅」が大きく異なります。
ここではコンテキストエンジニアリングを、各モデル呼び出しで使う情報の選択と配置に焦点を当てた設計として扱います。サンプルWebアプリの修正を例にとれば、ログイン画面の仕様が書かれたドキュメントから、ボタンの配色とエラーメッセージに関する該当段落だけを抽出し、一回のプロンプトへ添える工夫がこれにあたります。該当箇所を示せば、モデルが仕様を参照しやすくなります。しかし、エージェントが実際にファイルを編集し、テストを実行するというように作業が複数回に及ぶ場合、一回の入力に工夫を凝らすだけでは、途中で「いま全体のどこまで作業が終わったか」という状態を維持することができません。
一方、ハーネス設計は「複数回の呼び出しにわたって継続する実行条件」を整える基盤設計です。ここでは、一時的な入力情報だけでなく、作業が進むごとに変化する状態や、エージェントに与えられた権限、そして作業結果の検査といった要素を、時間軸をまたいでどう維持するかを考えます。
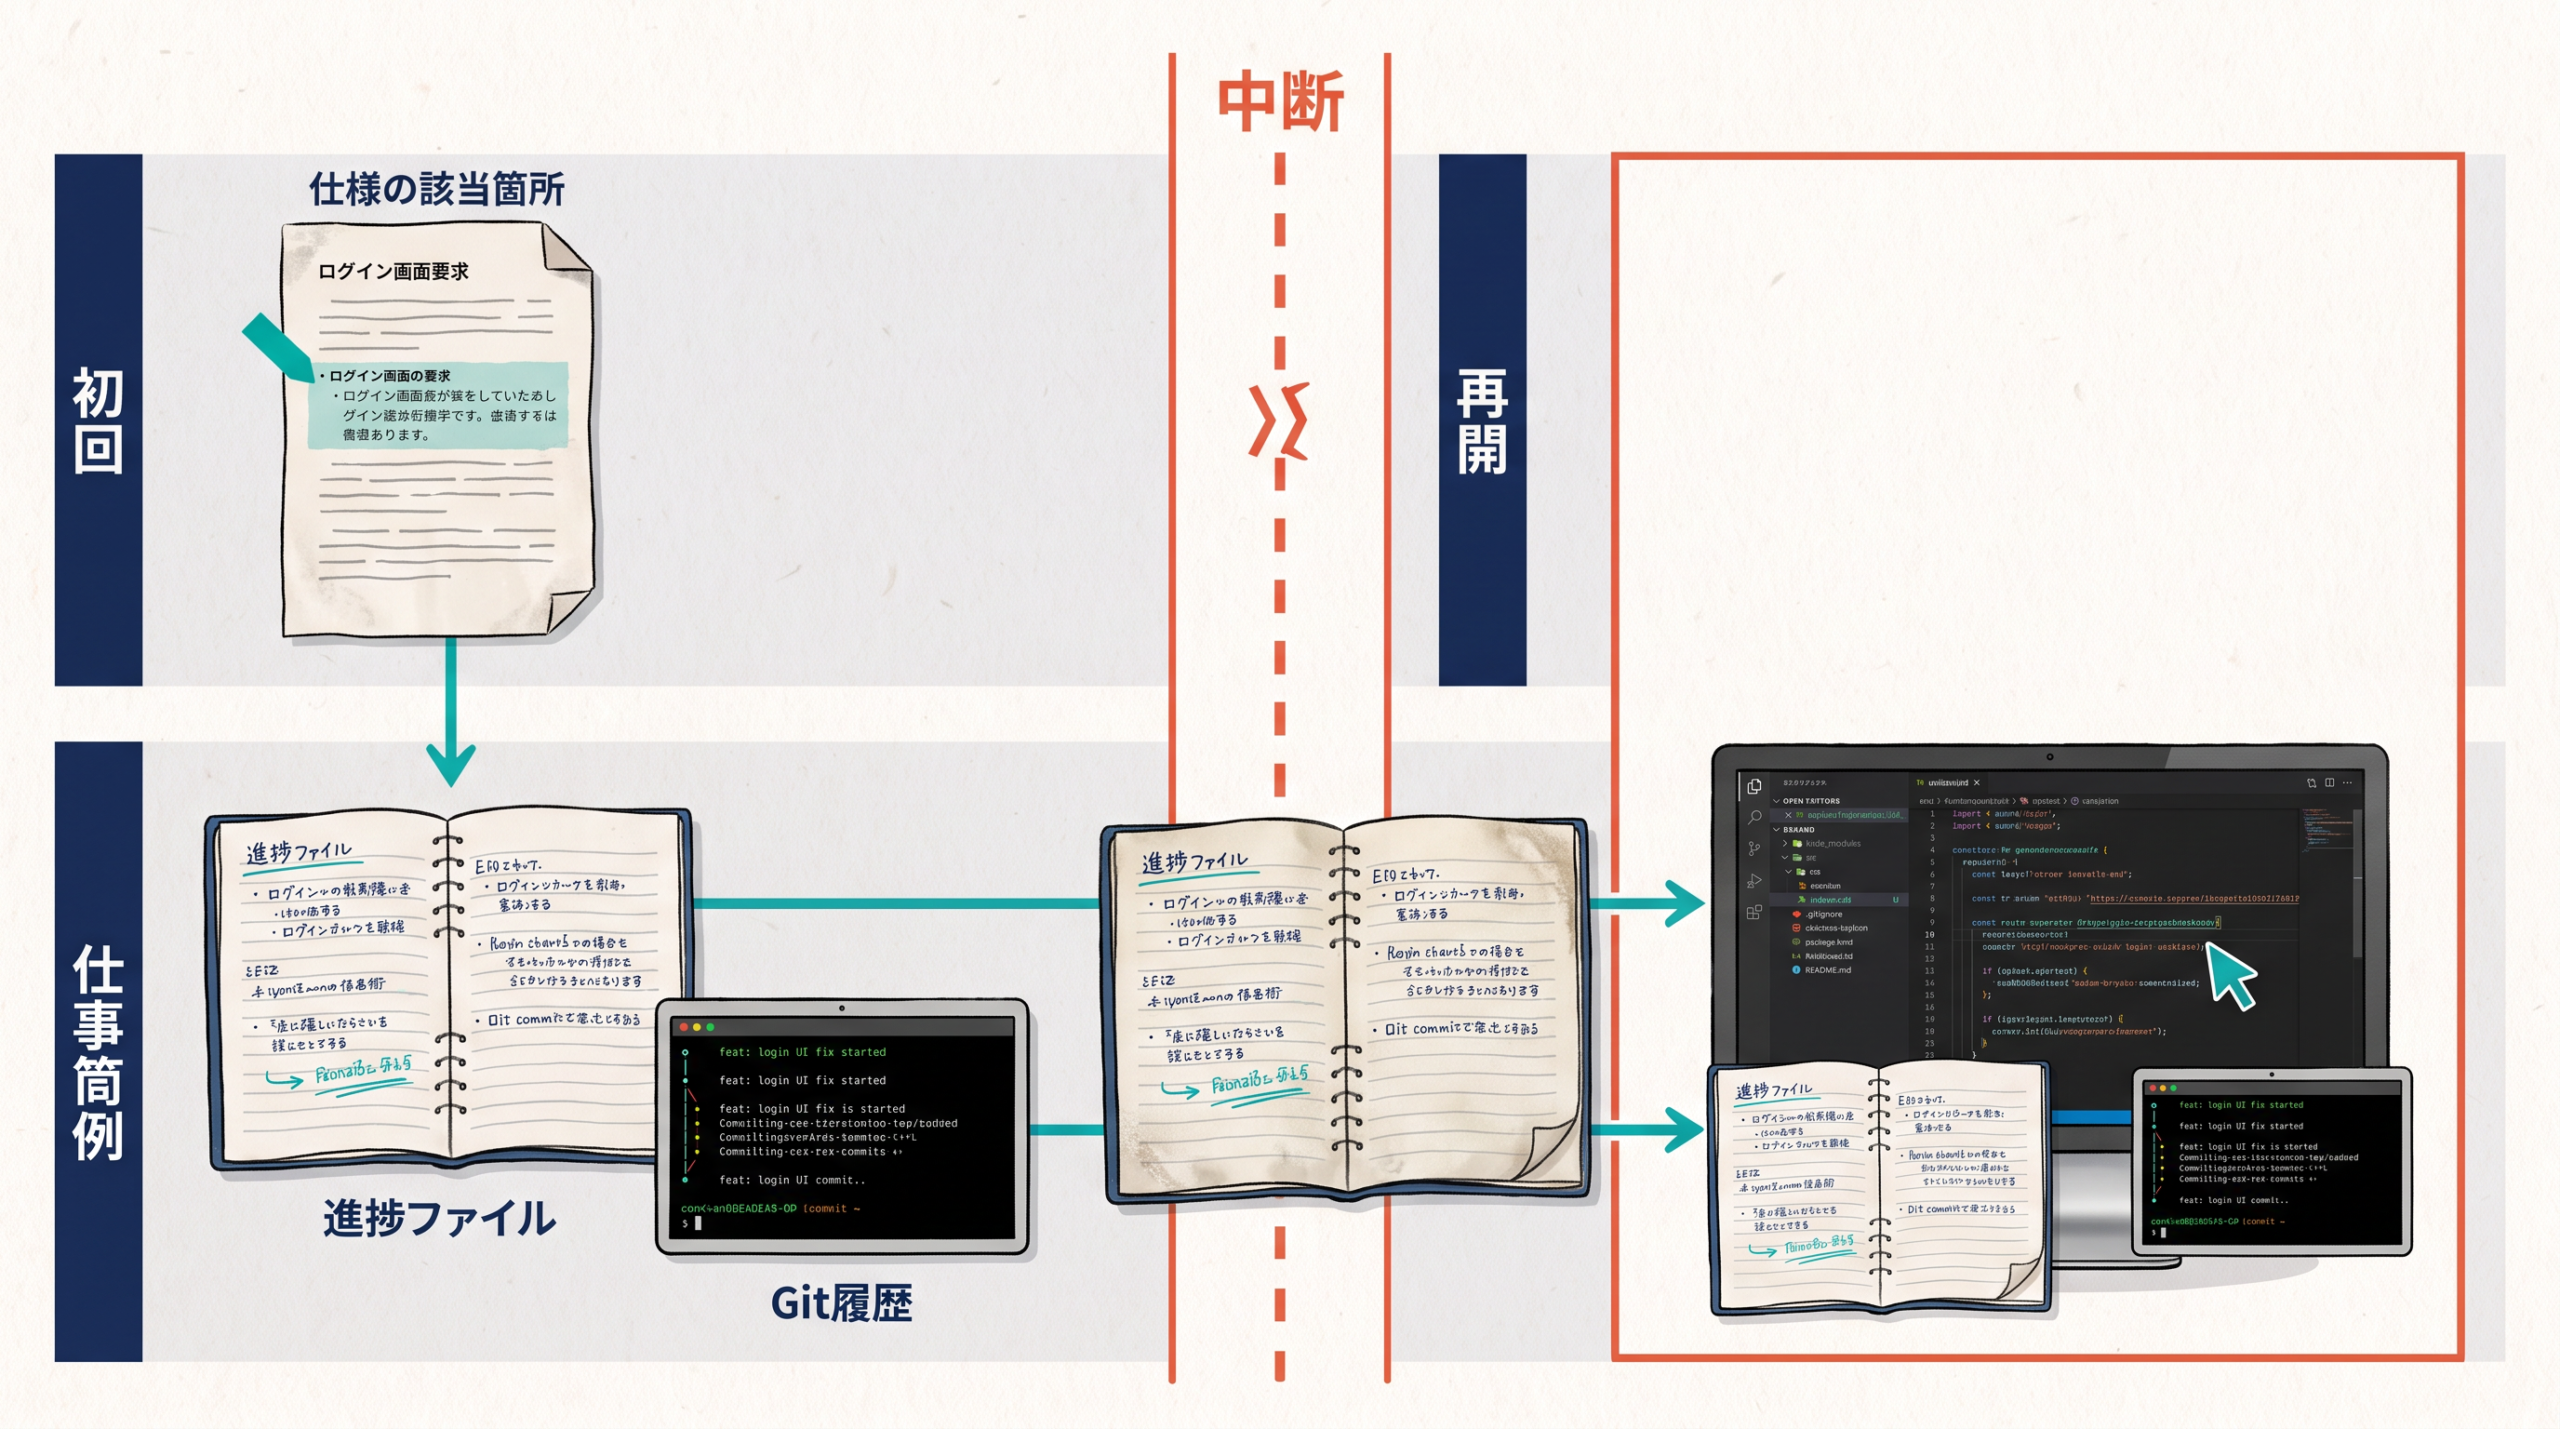
先ほどのWebアプリ修正の例で言えば、修正作業が長引いたり、エラーで一度処理が中断したりした場合を想定します。このとき、Anthropicが長時間のコーディング実験で行ったように、作業の初期化スクリプトに加え、エージェント自身に進捗ファイルを作成させたり、Gitのコミット履歴を残させたりする仕組みを環境側に用意します。こうすることで、次のセッションが開始されたときにエージェントは進捗ファイルやGit履歴を読み直すことができます。後続セッションは、配色変更の差分と進捗ファイルを照合し、未完了のエラーメッセージ修正から再開する手掛かりを得られます。
同じ仕様書などの資料を扱う行為であっても、それを一回の入力の補助として使うのか、それとも継続する実行環境の一部として更新し、後続のセッションへ残すのかによって設計の責務は異なります。複数セッションへ作業を引き継ぐ場合は、入力情報の選別に加え、状態と履歴を後続の実行が確認できる形で残します。
小さな修正作業に必要な部品を六つ決める
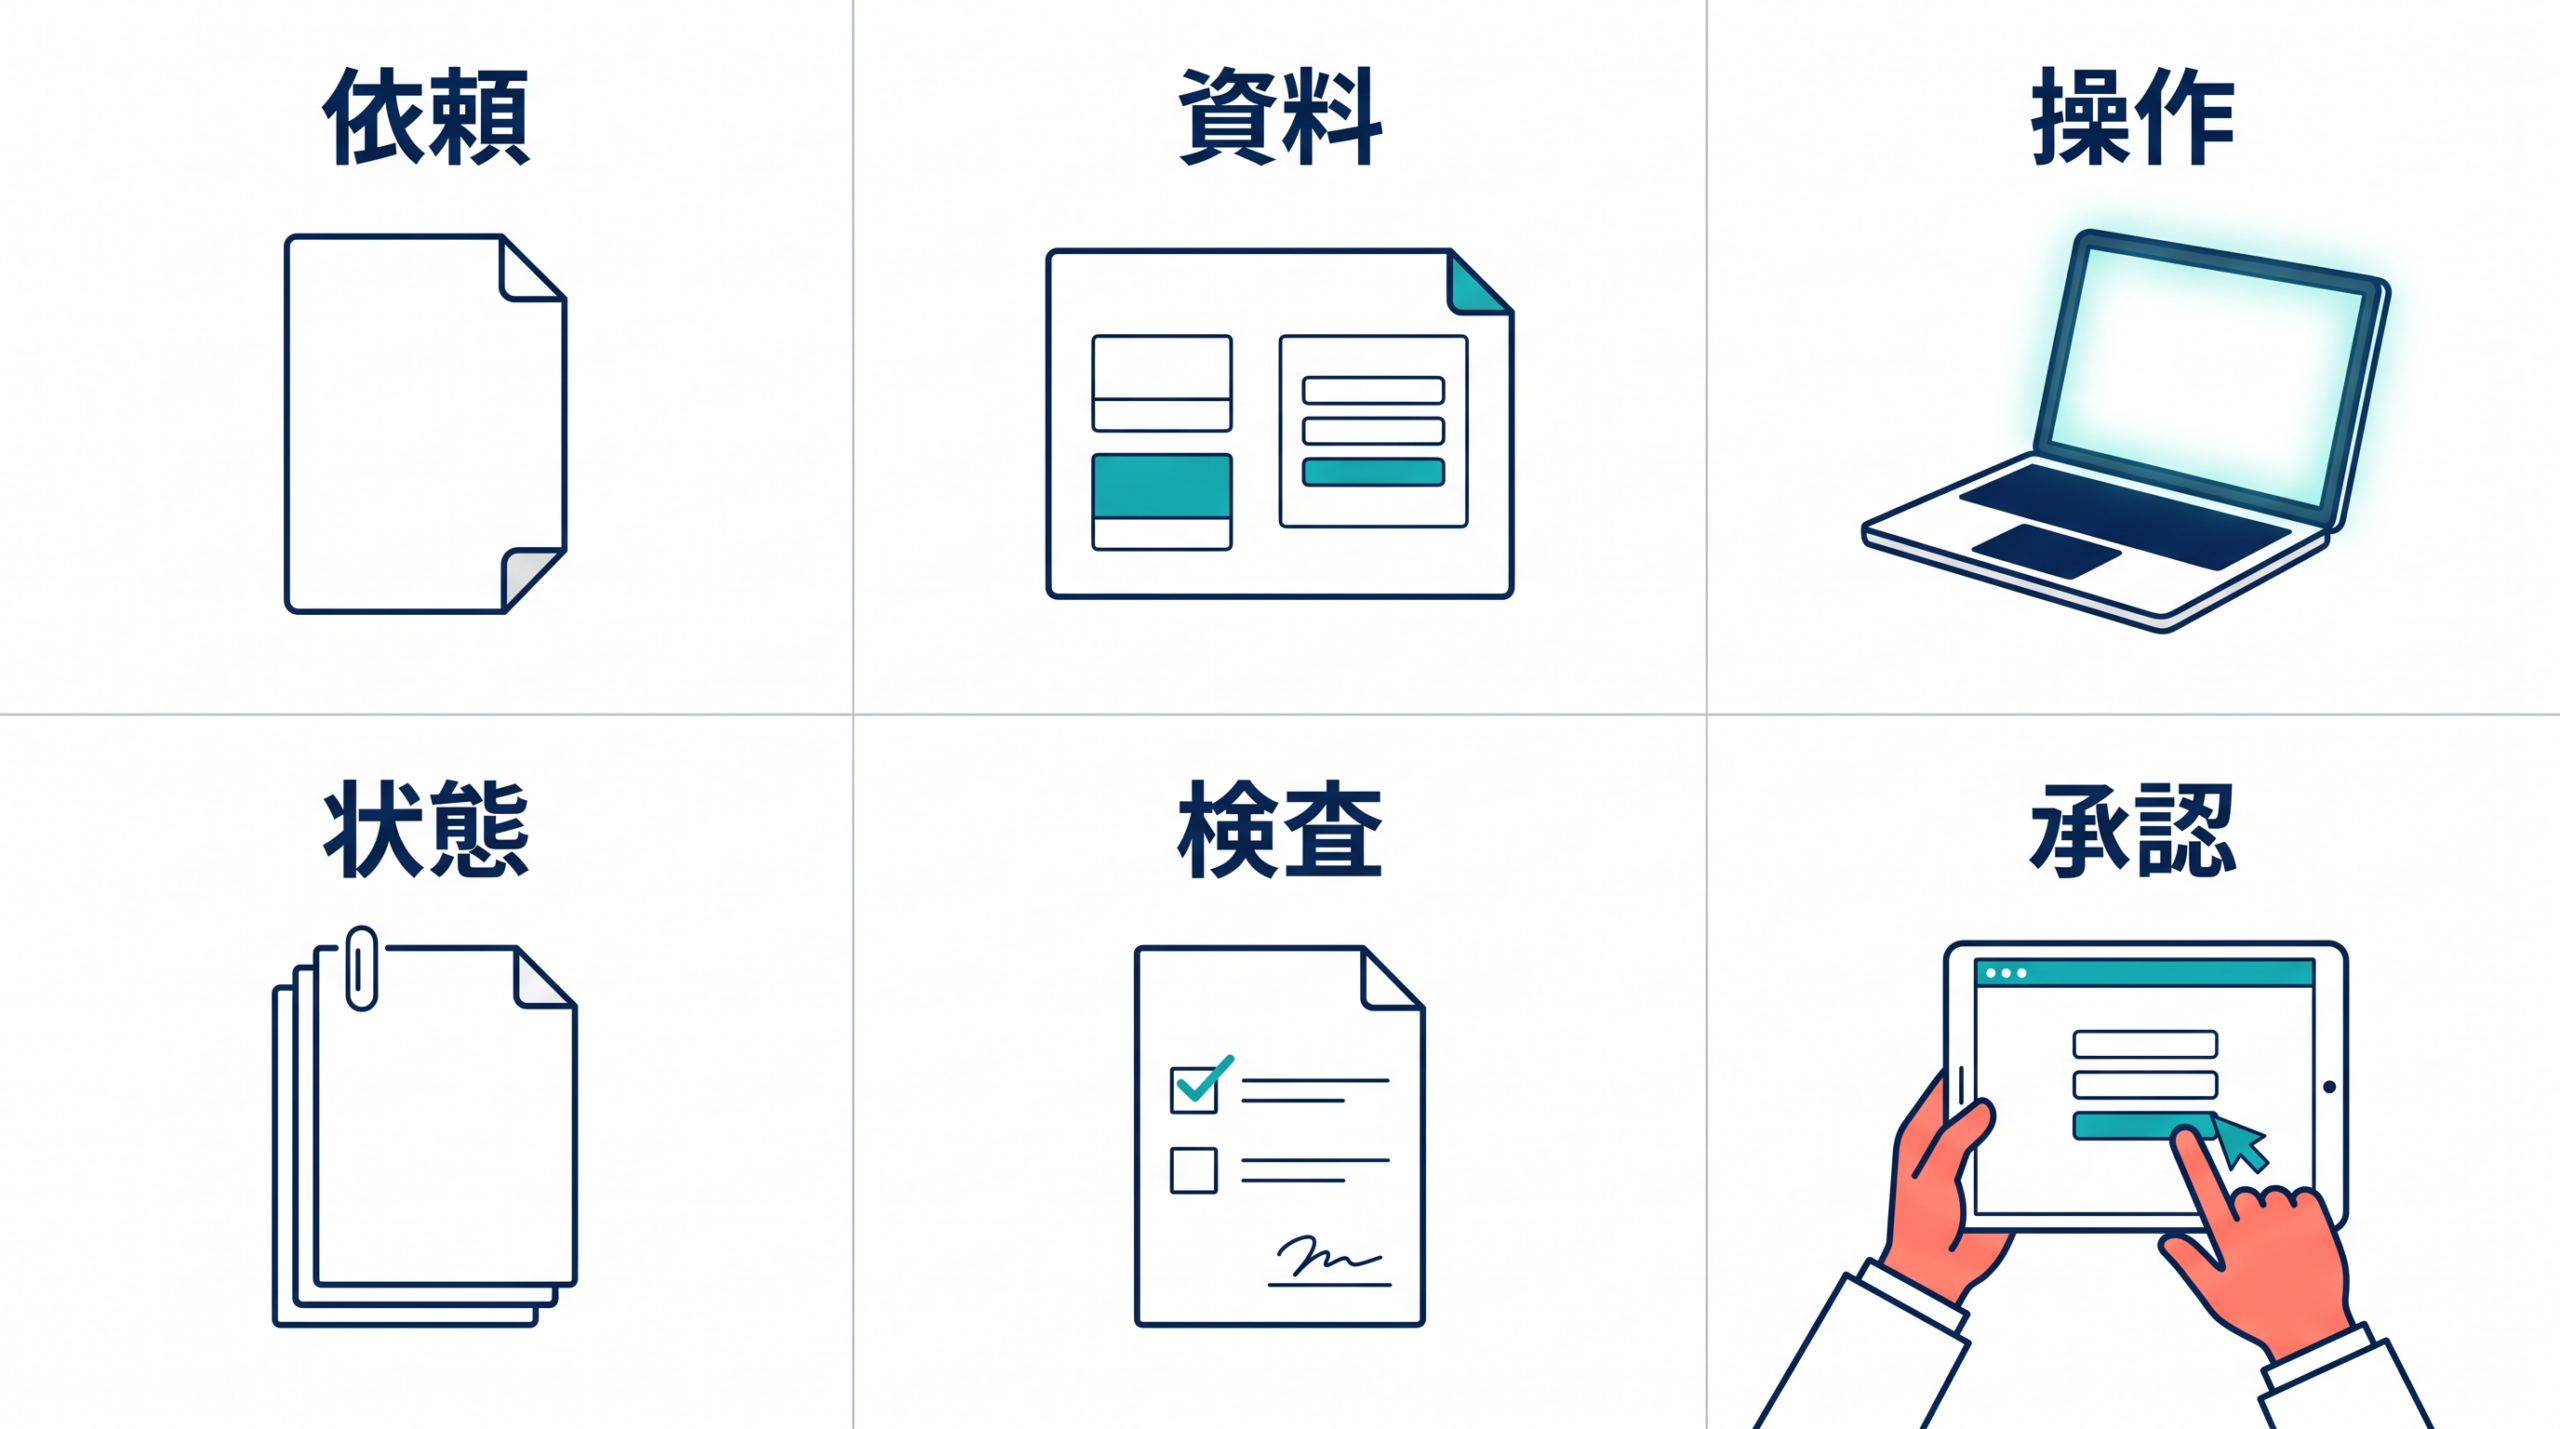
ハーネスという概念を理解したところで、「では、自分の業務では何から設定すればよいのか」と悩むかもしれません。まずは公開可能な小さな作業を対象にし、何を読み、どこを変更し、何で結果を確認するかを決めます。
サンプルWebアプリの修正(ログイン画面のボタン配色の変更とエラーメッセージの修正)を例に、エージェントの活動に沿って六つの部品を決めていきます。
第一に、エージェントが指針とする「タスク仕様」を用意します。プロンプトへ一度にすべてを書き込むのではなく、作業の目的や守るべき制約などを記した task.md をファイルとして作成し、エージェントが作業開始時に読み込めるように配置します。
第二に、「資料の入口」を限定します。社内のすべてのリポジトリやデータベースにアクセスさせるのではなく、今回の作業に必要なサンプルリポジトリだけを渡します。無関係なファイルを読ませないため、実行アカウントと作業環境の権限もサンプルリポジトリへ限定します。
第三に、「許可するツール」を定めます。本番環境のソースコードを直接触らせるのではなく、隔離された別作業コピーを用意します。そして、そのコピー内でのみ有効なファイル編集コマンドと、修正内容を確認するための特定のテスト実行コマンドだけをエージェントに許可します。エージェントが使える手足を、安全な範囲に絞り込むのです。
第四に、「状態」をどう残すかを決めます。作業が複数ステップに及ぶ場合、加えた変更を別作業コピーにこまめに保存させることで、エラーで中断した際も進捗を失わないように環境側へ状態を維持させます。
第五に、作業完了時の「検査」として残すものを設計します。エージェントが「修正が終わりました」とテキストで報告してくるだけでは、本当に仕様通りに直っているかがわかりません。そこで、テストの実行結果と、実際に変更したファイルの一覧(git diff --name-only コマンドの出力など)をセットにし、run-report.json というファイルへ記録させるように環境を構成します。
最後に、人が確認する「介入点」を設けます。エージェントの作業が完了しても、そのまま本番環境へ反映させることはしません。作成された run-report.json や別作業コピーの変更内容を人が読み、問題がないと確認できた場合にのみ、公開やマージを人が決断します。
六つの部品を決めれば、エージェントが読む資料と使える道具、人が検査する成果物と介入点を、同じ作業の中で照合できます。まずはこの最小構成を整えることが、実用的なハーネス設計の第一歩となります。
OpenAIとAnthropicの事例から環境の作り方を学ぶ
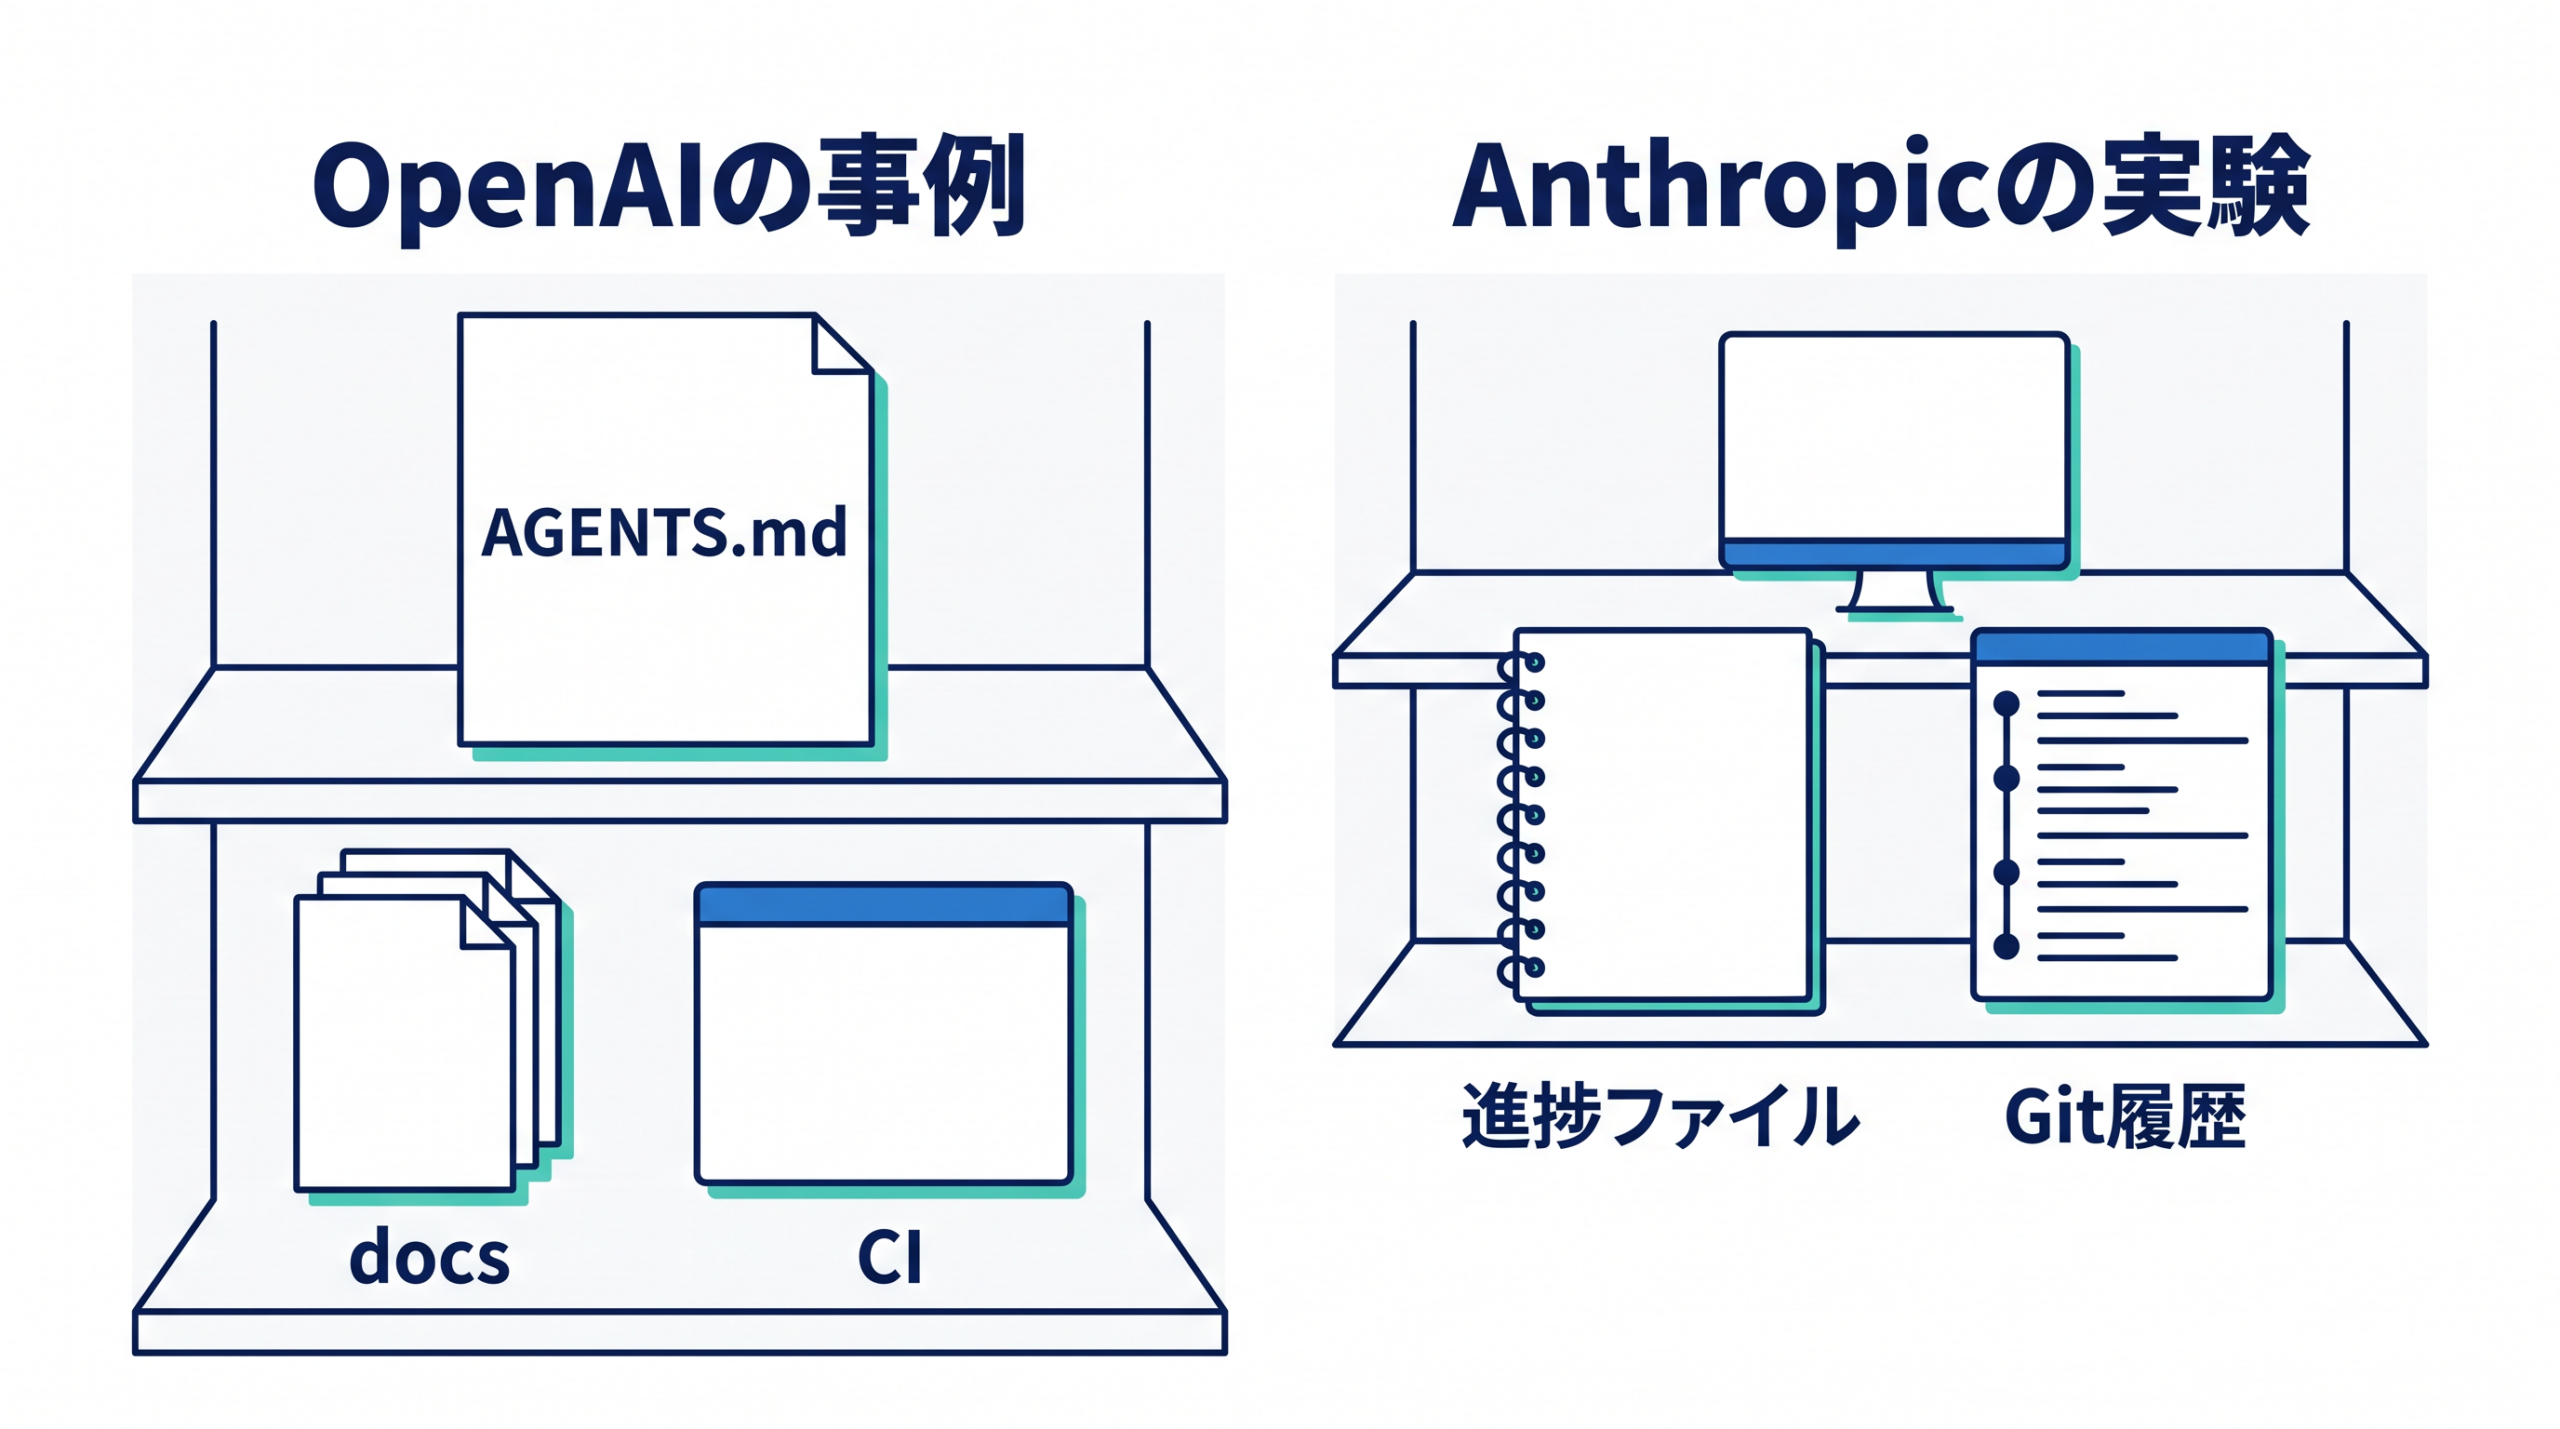
六つの部品を決めた後は、資料への入口と進捗の残し方を公開事例で確かめます。OpenAIとAnthropicの事例は、文書と状態記録をどこへ置くか考える材料になります。
たとえば、OpenAIのある特定チームがエージェントの作業環境を整えた事例では、プロジェクトの案内役として短い AGENTS.md を目次のように配置しています。そこに構造化した文書や、リンター、CI(継続的インテグレーション)を組み合わせることで、エージェントが迷わずに活動できる基盤を作りました。エージェントは短い入口文書から関連する docs へたどり、設計判断の根拠を探せます。
また、Anthropicが行った特定の長時間コーディング実験では、作業状態の維持に焦点が当てられています。この実験では、環境側に初期化スクリプトや進捗ファイル、そしてGit履歴を用意し、後続セッションへの状態引き継ぎに使用しています。エージェントが作業再開時に進捗ファイルと直近コミットを照合すれば、前回の変更と未完了部分を確かめる手掛かりを得られます。
CodexとClaude Codeでハーネスを設計する
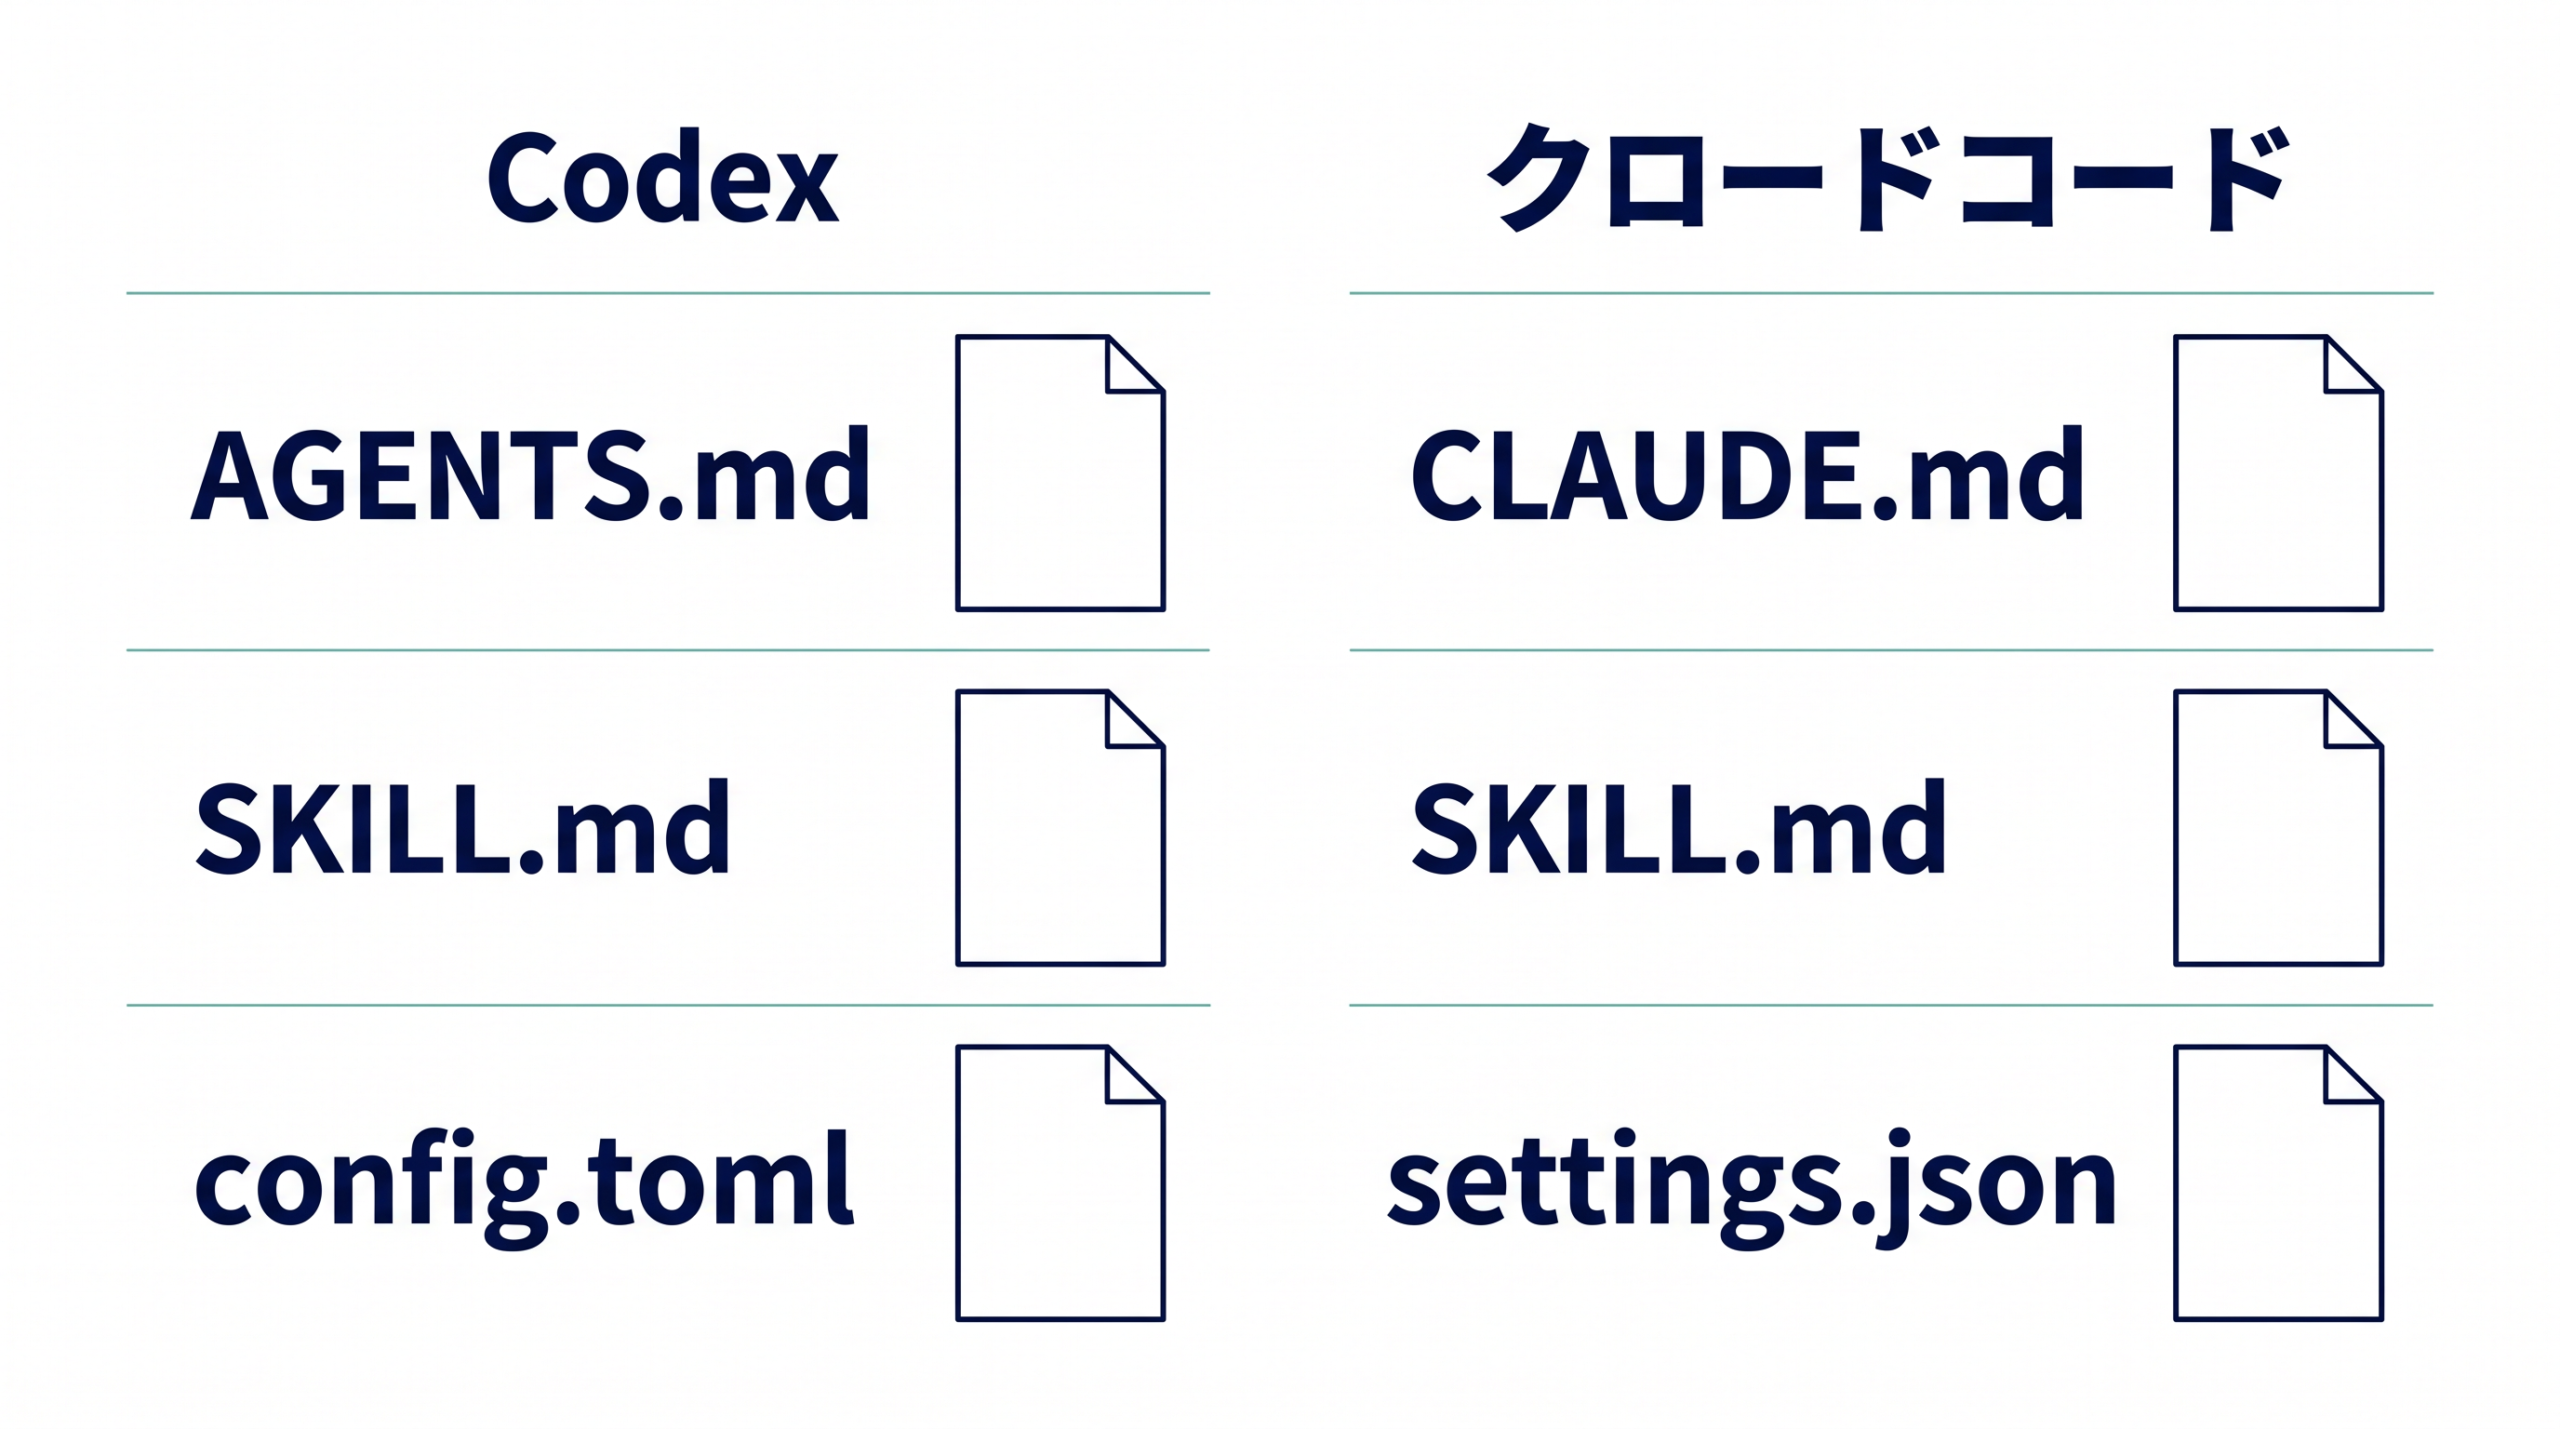
ここまでの話をCodexとClaude Codeに当てはめると、何を変更できるのでしょうか。両ツールには、モデルへ作業を渡し、ファイルを読み、コマンドの結果を受け取って次の操作を決める仕組みが備わっています。Claude Codeの公式説明は、このモデルを囲むツールと文脈管理の層を「エージェントのハーネス」と呼んでいます。Codexの公式ガイドも、既存の実行機能にプロジェクトの指示、Skill、外部接続などを重ねる構成を示しています。
利用者が設計するのは、主に「どの資料を渡すか」「どの操作を許すか」「いつ機械が検査するか」「中断後に何を読み直すか」という接続部分です。モデルの種類は設定で選べても、モデルそのものを選ぶことと、作業を支える環境を整えることは別の判断です。前述のログイン画面の修正なら、配色の仕様にたどり着けない、不要な場所まで編集できる、テストせず完了を宣言するという失敗ごとに、変更する場所を選びます。
指示、繰り返す手順、外部接続を置き分ける
毎回必要な約束は、CodexのAGENTS.mdやClaude CodeのCLAUDE.mdに短く書きます。サンプルアプリなら「ログイン画面の仕様はdocs/login-ui.mdにある」「変更後はnpm testを実行する」といった入口です。Codexはリポジトリの階層に沿ってAGENTS.mdを読み、Claude CodeはCLAUDE.mdを読みます。両方を使うチームでは、共通の約束をAGENTS.mdに置き、CLAUDE.mdから@AGENTS.mdで読み込む方法があります。Claude CodeがAGENTS.mdを直接読む条件はバージョンや設定で異なるため、公式の読み込み条件を確認してから運用します。
同じ手順を何度も使うなら、Codexでは.agents/skills内のSKILL.md、Claude Codeでは.claude/skills内のSKILL.mdへ分けます。たとえば「修正箇所を探す→対象のテストを動かす→差分を報告する」という一連の作業をSkillにできます。Skillは手順を渡す仕組みです。外部の課題管理ツールやデータベースへ実際につなぐ場合は、CodexでもClaude CodeでもMCPなどの接続を別途設定します。接続するだけで、その情報の読み方や更新条件まで決まるわけではありません。複数のリポジトリで同じSkillや接続を配布するときは、CodexとClaude Codeのプラグインにまとめる方法もあります。
作業を分担する必要がある場合は、CodexとClaude Codeのサブエージェント設定も選択肢になります。ただし、ログイン画面の小さな修正なら、担当を増やす前に一人のエージェントが仕様を読み、修正して検査できる流れを作るほうが、結果を追いやすくなります。
操作範囲と自動検査を別々に設定する
資料に「本番を変更しない」と書くだけでは、実行アカウントの権限は変わりません。Codexのconfig.tomlでは承認方針やサンドボックスの範囲を設定できます。プロジェクトの.codex/config.tomlは、信頼済みのプロジェクトで読み込まれます。Claude Codeの.claude/settings.jsonでは、チームで共有するツールの許可・確認・拒否ルールを設定できます。どちらも実際の作業コピー、接続先の権限、実行アカウントと合わせて決めます。
毎回同じ条件で検査したい処理は、指示文から実行側へ移します。CodexのHookとClaude CodeのHookは、ツール使用や作業終了などの出来事をきっかけにスクリプトを動かせます。たとえば編集後にリンターを走らせ、失敗結果を作業へ戻します。CodexではプロジェクトのHookに信頼確認が必要な場合があるため、配置しただけで動いたと判断せず、実際の実行記録を確かめます。公開やマージの判定は、エージェントの会話とは別にCIと担当者の確認でも行います。
中断後に読み直す状態と、完了の証拠を残す
両ツールにはセッションを続ける機能があります。ただし、会話が残ることだけを引き継ぎの条件にすると、別の作業環境や新しいセッションから未完了部分を確認しにくくなります。Codexのメモリ機能やClaude Codeのセッションとメモリは作業を助けますが、プロジェクトで共有する進捗はGitの差分と短い進捗ファイルにも残します。
サンプルアプリでは、対象の仕様書、変更したファイル、テストの成否、未完了の問題を記録します。次の担当者やセッションは、その記録と実際の差分を突き合わせてから再開します。run-report.jsonに「テスト成功」と書かれていても、実画面の配色やエラー表示が仕様に合うかは、担当者が画面を見て確認します。
小さな修正から設定を決める
最初からすべての機能を有効にする必要はありません。ログイン画面の修正なら、次の順に決めると設定の理由が明確になります。
- 仕様書と変更対象を決める。
AGENTS.mdまたはCLAUDE.mdには、その場所と確認コマンドだけを短く書く。 - 編集できる作業コピーと、必要なコマンドだけを決める。権限設定と実行アカウントの両方で範囲を確認する。
- 繰り返す作業だけをSkillにする。外部サービスが必要になったときに、その用途に限って接続を追加する。
- テストやリンターを実行し、失敗時に止める条件を決める。Hookが動いた記録とCIの結果を別に確認する。
- 差分、テスト結果、実画面を担当者へ渡す。途中で止まった場合は進捗ファイルとGit履歴から再開する。
この順序なら、失敗が起きたときに、仕様への導線、操作権限、検査、引き継ぎのどこを直すべきか特定できます。設定ファイルを増やすこと自体が目的ではありません。対象の仕事で起きた失敗と、変更した設定がその失敗を防げたかを対応づけて見直します。
同じモデル・同じ依頼で実行基盤だけを比べる
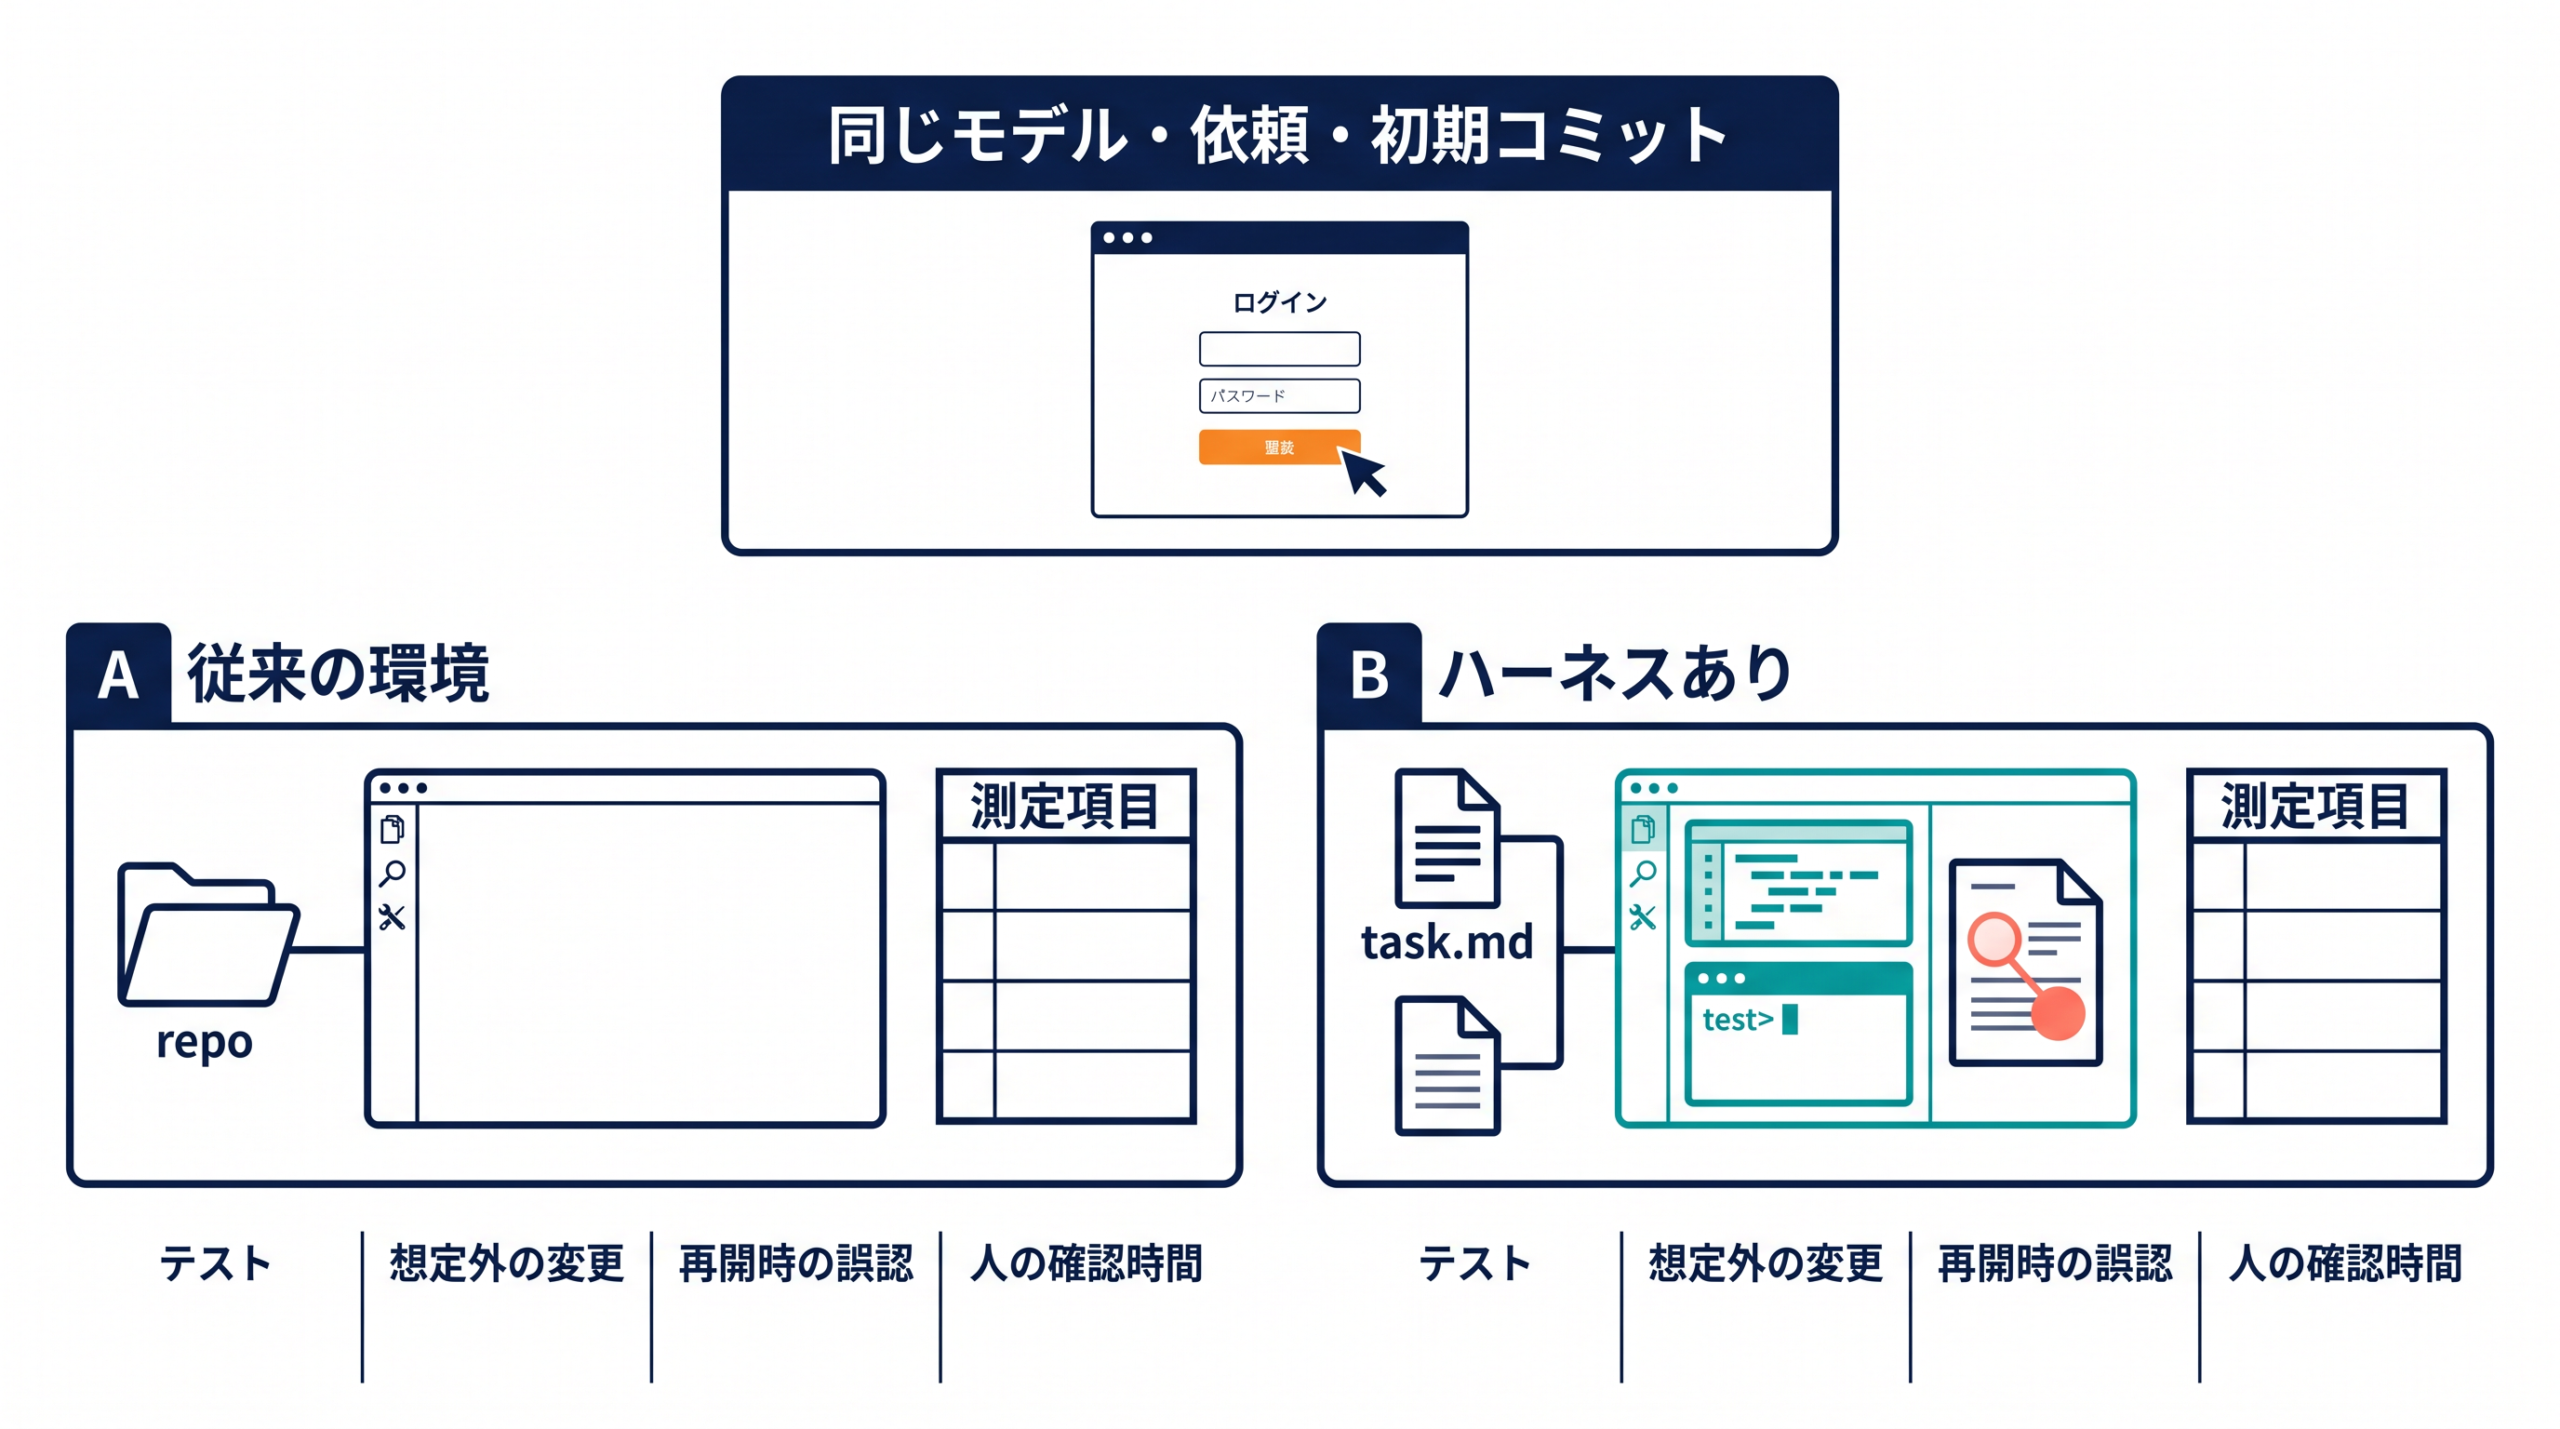
他社の事例を参考に実行基盤を整えたあとは、「自分の作ったハーネスが本当に業務で役立ったのかをどう測るか」という疑問に向き合うことになります。このとき重要なのは、比較する変数と計測項目を固定して検証することです。
実行基盤の差を見たい場合は、モデルの種類とバージョン、依頼文、初期コミット、試行回数などをそろえます。同じモデル・同じ依頼を使い、実行基盤(ハーネス)の違いだけを純粋に比較します。
これまで例としてきたサンプルWebアプリの修正を用いて、同一初期コミットから分岐させた「A/B作業コピー」での比較試験を設計してみましょう。
まず、Aの作業コピーには、従来通りの実行環境(たとえばリポジトリ全体へのアクセス権だけがある状態)を用意します。一方、Bの作業コピーには、今回の業務に合わせて設計した新しいハーネスを導入します。すなわち、必要な情報だけを記した案内文書を環境の入口に置き、安全に編集やテスト実行ができる操作権限だけを与え、作業完了時には最終的なファイルの差分とテスト結果をまとめたデータを出力させる環境です。
このAとBの作業コピーに対して、それぞれ同じモデルへ「ログイン画面のボタン配色とエラーメッセージを修正してほしい」という全く同じ不具合修正依頼を渡します。そのうえで、以下の項目を比較表にして計測します。
- 実行されたテストの成否
- 依頼とは無関係なファイルへの想定外の変更が起きていないか
- エラー等で作業を中断・再開した際、進捗に対する誤認がないか
- 最終的に担当者がログや差分を読み、本番へ反映できるかを確認するまでに要した時間
ここで注意すべきは、Anthropicの解説にもあるように、テスト合格のみで業務品質を断定することはできないという点です。コードの構文チェックやテストを通るかどうかの機械的評価と、人が行う最終的な妥当性の評価は、それぞれ対象と限界が異なります。だからこそ、機械的に取得できるテストの成功率だけでなく、「再開時の誤認の少なさ」や「担当者の確認時間の短縮」といった項目を計測対象に含める必要があります。
未実施の実験結果を予測して「新しいハーネスを導入すれば確認時間が半分になる」と語ることはできません。初期条件と検証手順をそろえた複数の試行は、どの条件差が結果に影響したかを検討する材料になります。
機械で止める失敗と人へ戻す判断を分ける
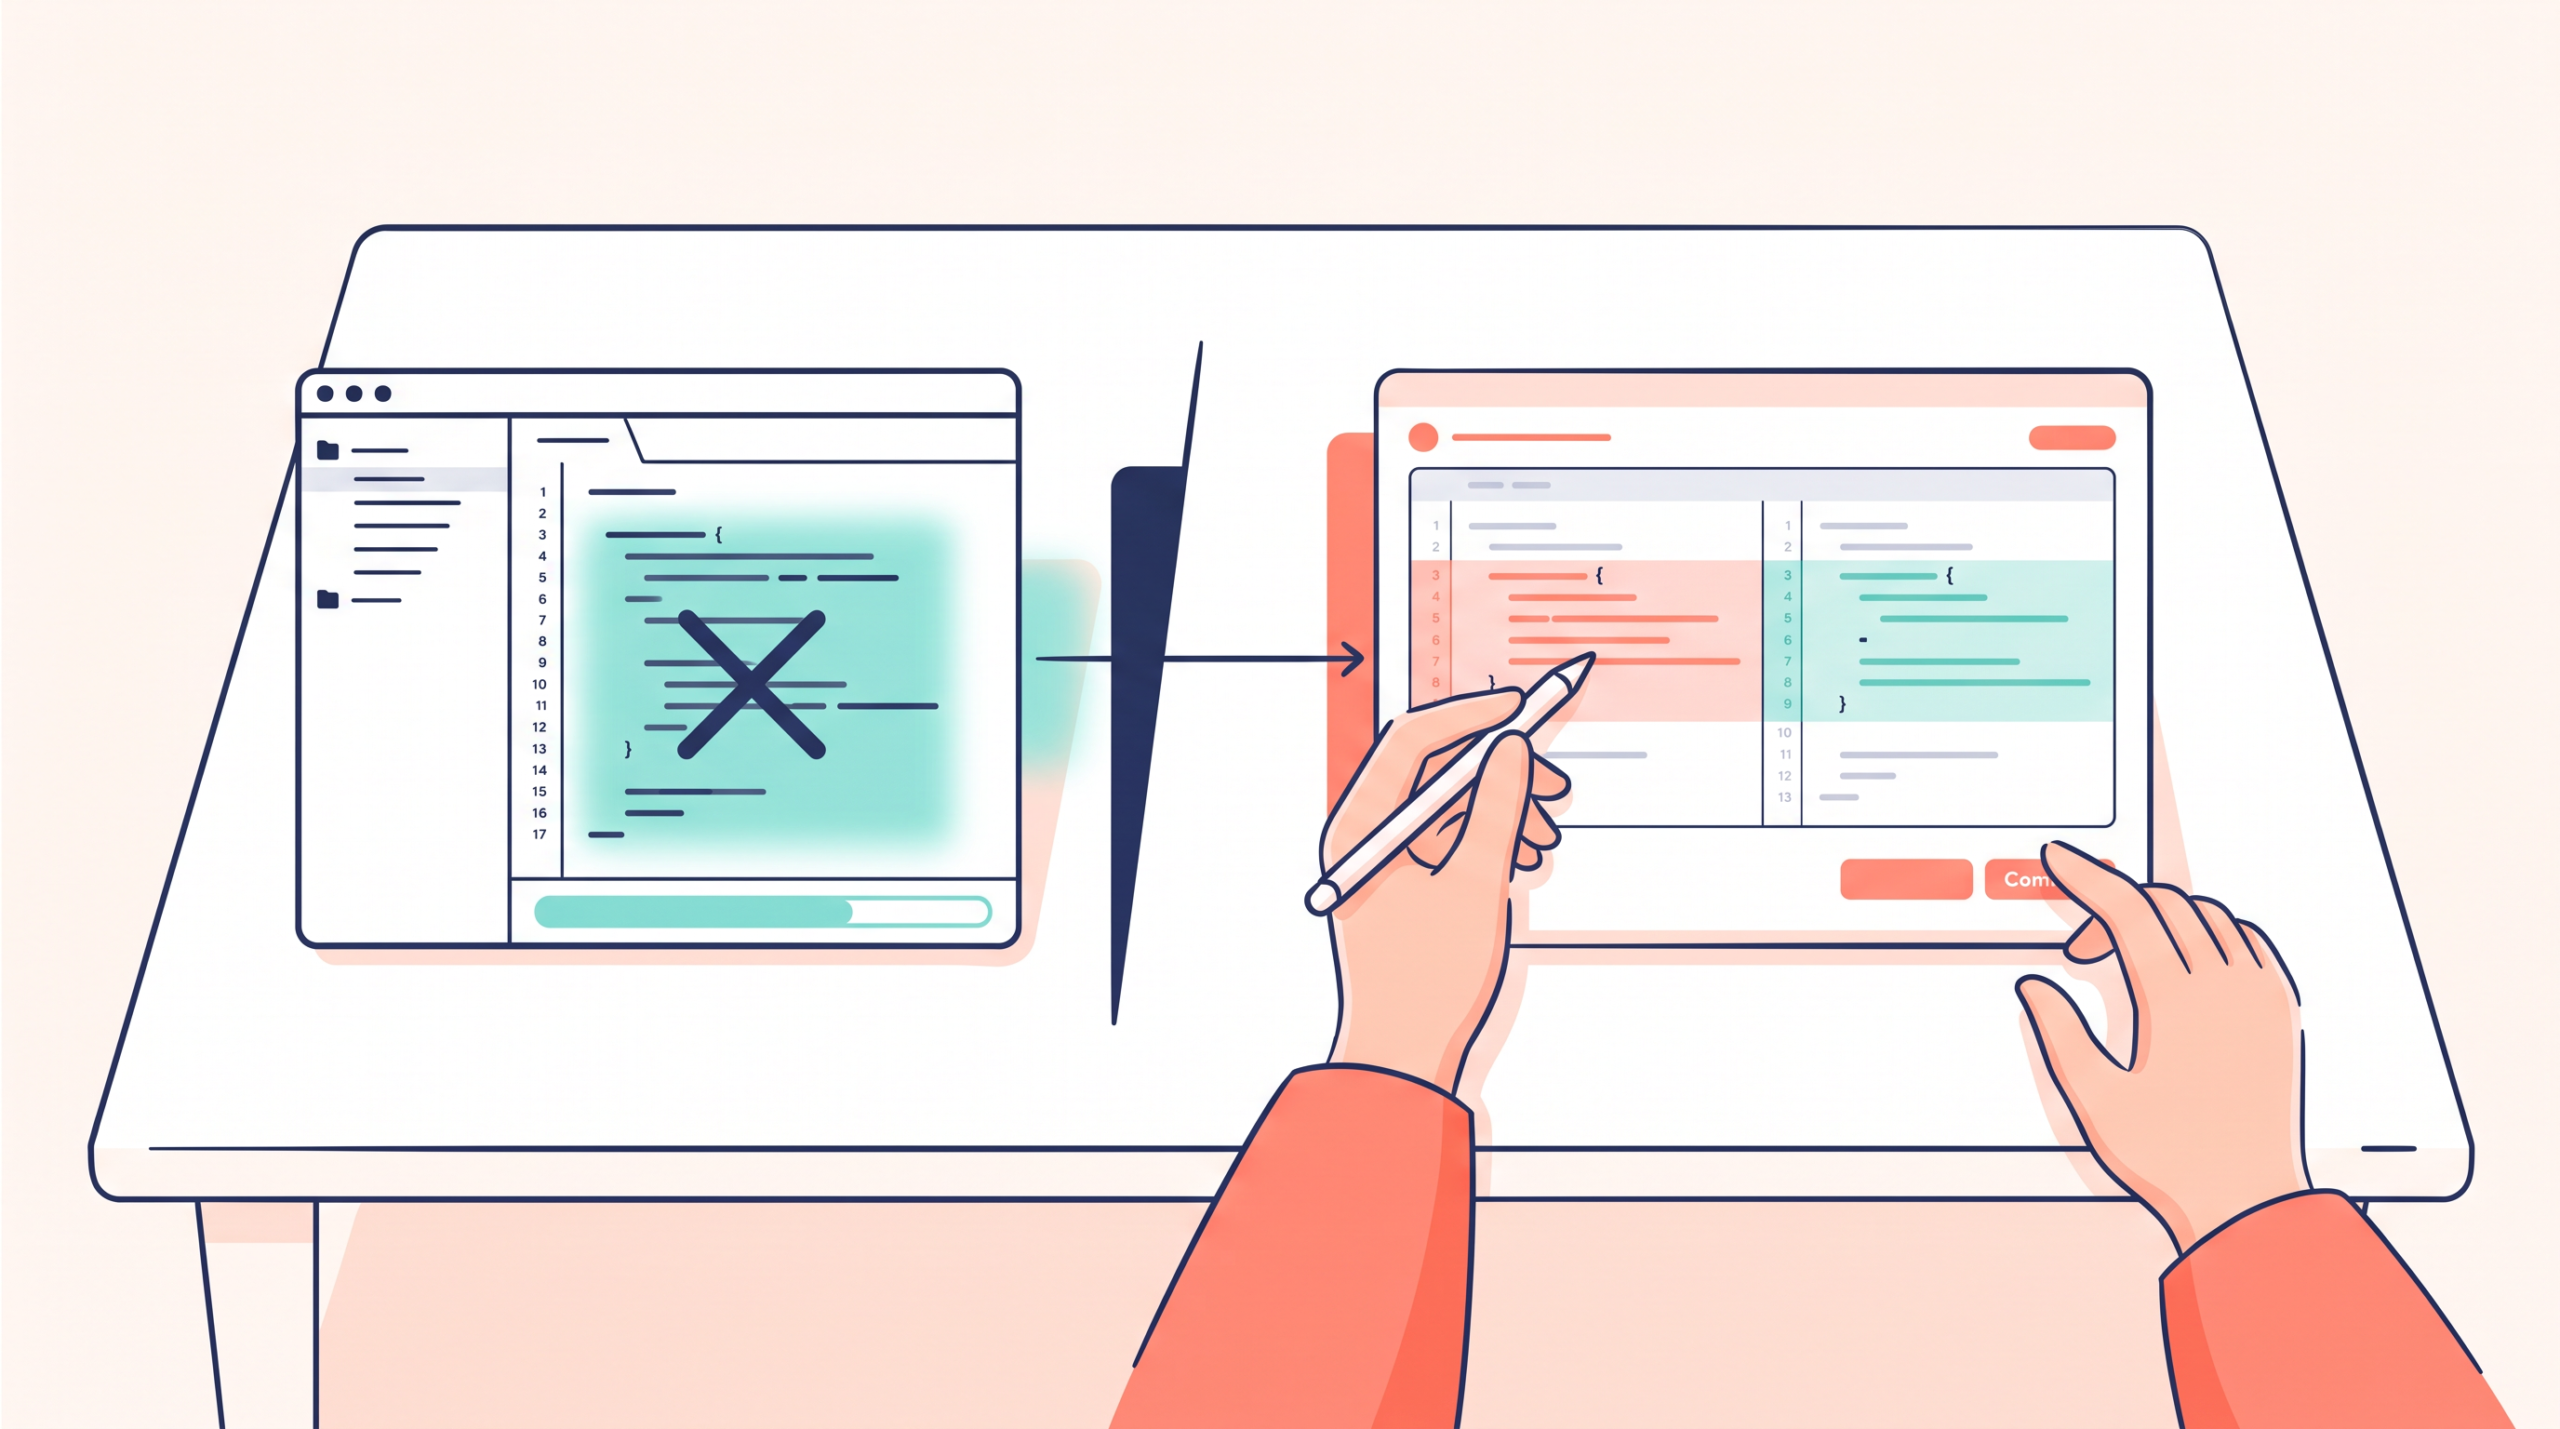
前節で実行基盤の比較実験を行うと、エージェントが起こす様々な失敗の傾向が見えてきます。この結果を実際の運用へ適用していくにあたり、次に取り組むべきは「どこまでを機械的な判定で自動停止させ、どこからを人が介入して判断するか」という境界線の設定です。
システム側で明確に白黒がつく基準は、環境側で自動判定する仕組みとして組み込みます。これまでのサンプルWebアプリの修正を例にとれば、「単体テストの実行が失敗した」「指定された作業コピーの外にあるファイルへ変更を加えようとした」といった事象がこれにあたります。テスト失敗は設定した合格条件の不達であり、作業コピー外の変更は権限境界の違反なので、ツール実行前に検査する制御と実行環境の権限で後続処理を止めます。
しかし、機械的なチェックを通過したからといって、そのまま本番環境へ反映してよいわけではありません。エラーなく作業が完了し、ツール呼び出しのログが残っていたとしても、それだけでは最終的な品質の合格を証明できないからです。ログや出力データに意図せず機密情報が含まれるリスクを考慮しても、機械的な検査だけでプロセスを完結させるのは危険です。本番公開やマージは、担当者が差分と実画面を確認した後に承認します。
そこで、仕様の微妙なニュアンスや定性的な検証は、明確に人が介入して判断する領域として切り分けます。Webアプリの修正であれば、変更されたログイン画面のボタン配色がデザインの意図通りに整っているか、修正されたエラーメッセージがユーザーにとって分かりやすいタイミングで表示されるかといった点は、テストコードで完全に判定することが困難です。
したがって、テスト失敗や作業コピー外の変更といった明確なエラーは機械的な検査で自動停止させ、画面の使い勝手や最終的な公開可否は、担当者がブラウザとファイルの差分を目視して確認するという役割分担を設けます。自動で止める失敗と人へ戻す判断を切り分け、多層的に防御と検証を重ねることこそが、実務に耐えうる実行基盤を運用する鍵となります。
反復はループ、複数の仕事の関係はグラフで設計する
ここまで、資料の入口や許可されたツール、状態の保存といった実行基盤の設計について見てきました。すると、「このハーネスさえしっかり作り込めば、エージェントの継続実行や、複数エージェントの協調まですべて決まるのではないか」という疑問が湧くかもしれません。結論から言えば、ハーネスの設計だけでそれらすべてをカバーすることはできません。
今回決めた部品は、一件のサンプル修正について、エージェントの操作条件と人が確認する証拠を整えるためのものです。これを過度に広げてあらゆる制御を詰め込むと、システムが複雑になりすぎてしまいます。そのため、時間的な反復や、タスク間の関係性は別の層として切り分けて設計する必要があります。
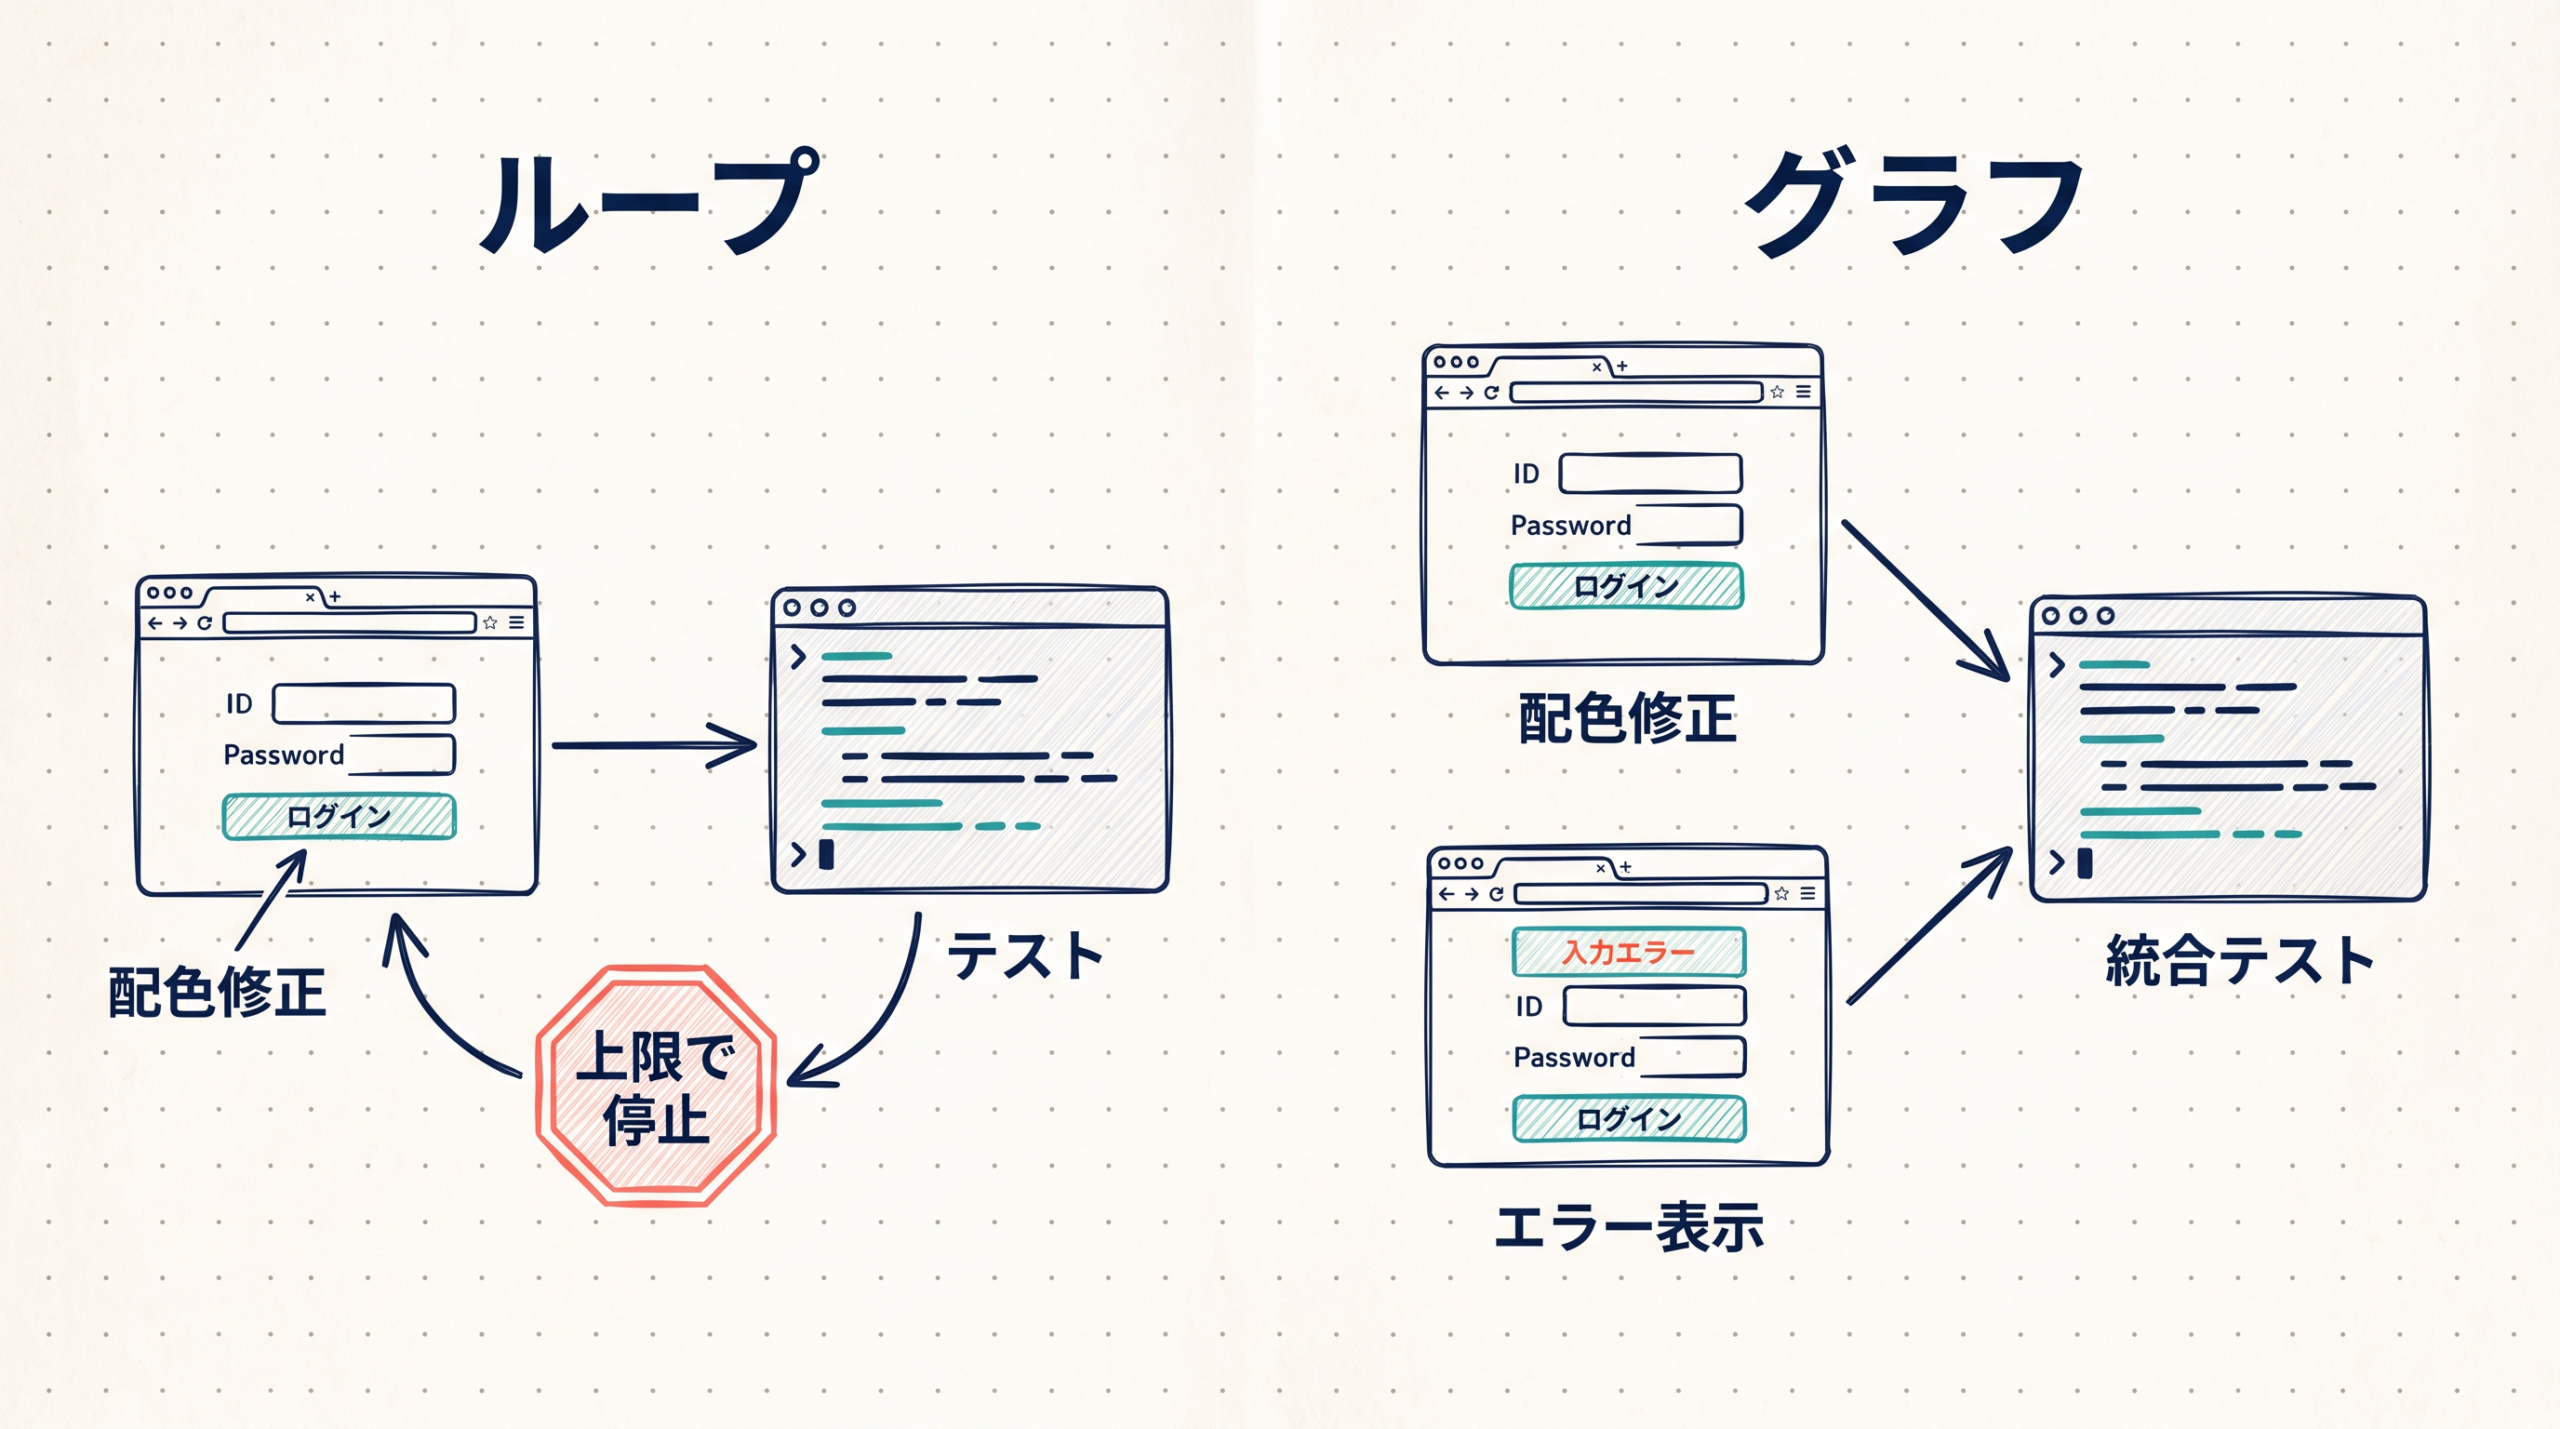
たとえば、これまで例に挙げてきたサンプルWebアプリの修正において、「テストが失敗した場合、一定回数まではエージェントに再修正を試みさせる」という継続実行の仕組みを作りたいとします。このような一件の修正を再実行する停止条件は、環境そのものに持たせるのではなく、「ループ(反復制御)」として別に設計します。
さらに作業が大規模になり、「ログイン画面の配色修正」と「エラーメッセージの仕組みの修正」という二件の修正が発生したとします。これらに依存関係があり、それぞれを得意な別々のエージェントに担当分担させる場合、その作業の順番やつながりは「グラフ(タスクの関係性)」として記録・管理します。固定経路のワークフローと動的なエージェント、あるいは状態の永続化といった選択肢が解説されているように、タスクのつながりを設計するアプローチは複数存在しますが、特定のツールやSDKの導入が必ずしも必須となるわけではありません。
モデル・ハーネス・環境という層を分け、11の責務を定義した枠組みは、現時点ではプレプリントによる一つの提案であり、確定した業界標準というわけではありません。しかし、このように役割を区別して考えることは実務において非常に有用です。
まずは、隔離されたコピーでの編集という操作をどこまで許可し、最終的なテスト結果や差分をどのような出力として残させるかという、今回のハーネス設計に集中してください。一件の作業条件を定めた後、継続実行が必要ならループ、複数作業の依存関係が問題ならグラフを別に設計します。情報と権限、反復の停止条件、タスク間の関係を分けて記録すれば、失敗した箇所を担当者が追いやすくなります。
よくある質問
Q1. ハーネスの設計は、プロンプトの工夫と何が違うのですか?
プロンプトは依頼内容を伝え、コンテキスト設計はモデルへ渡す資料を選びますが、いずれも作業環境の権限や検査結果そのものを管理しません。一方、ハーネス設計は、作業が複数回に及んだり予期せぬエラーで中断したりした際に、前回の状態を引き継いだり、操作権限を管理し続けたりするための「時間軸をまたぐ実行基盤」を整える点が異なります。
Q2. 実行環境(ハーネス)を見直す際、まずはどのような小さな試験から始めればよいですか?
まずは、機密情報を含まない公開可能な小さなタスク(例えば架空のサンプルWebアプリのUI修正など)から始めることをお勧めします。検証の際は、言語モデルとプロンプトの依頼内容を固定し、「従来通りの環境」と「資料の入口や許可ツールを絞り込んだ環境」というA/B作業コピーを比較してみてください。各条件を複数回試し、進捗の誤認件数と担当者の確認時間を記録します。
Q3. ツール呼び出しなどの操作ログをすべて残せば、安全性の証明になりますか?
いいえ、それだけでは不十分です。ツール呼び出しなどのログを残すことは有用ですが、それだけで最終的な品質合格を証明できるわけではありません。また、ログとして保存される入力や出力データには、意図せず機密情報が含まれるリスクもあるため、記録する内容とデータ管理の境界には十分な注意が必要です。
機械的なテストを自動化した場合でも人の承認が必要になるのはどのような場面ですか”>Q4. 機械的なテストを自動化した場合でも、人の承認が必要になるのはどのような場面ですか?
テスト失敗と作業コピー外への変更を検出したら後続処理を止め、原因を担当者へ示します。また、機械的なテストに合格したからといって、最終的な業務品質を満たしているとは限らないため、画面の使い勝手といった定性的な確認や、本番環境への公開可否の決断においては、必ず人が介入する承認工程が必要になります。
Q5. エージェント開発用のSDKやライブラリを利用すれば、ハーネスの設計は不要になりますか?
いいえ、不要にはなりません。SDKはツールの呼び出しやログの記録を簡単にするものですが、入力やツール検査の実行境界で処理をブロックする別の制御など、対象の業務に合わせた独自の安全網は構築し直す必要があります。エージェントにどの情報を渡し、どのような操作権限を許可し、最終的にどのような形式で成果物を残させるかという基盤のルール設計は、ツールを導入しても開発者自身が行う必要があります。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント