
AI技術の進展に伴い、複数のAIを同時に動かす仕組みが注目を集めています。しかし、本記事で探求する中心的な問いは、複数のAIを動かすこと自体ではなく、「親エージェントが仕事を独立した単位へ分解し、子エージェントへ担当範囲や道具、出力形式を割り当てて並列処理させ、最後に結果を統合する構成が、単一のエージェントを使うよりも速く、広く、正確になる条件は何か」という点です。
例えば、「競合100社の製品、料金、導入事例を調べ、company-research.csvとsource-ledger.csvを作る」という業務を想定してください。人が100社を順番に開いて調べる従来の方法や、単一のエージェントに順番に処理させる方法に対し、エージェントスウォームでは親エージェントが企業群を複数の子エージェントへ割り振り、同時に調べさせます。
このときシステムの価値を決めるのは、動いているエージェント数の多さではありません。共通の列定義や調査基準日、一次資料優先といった規則を与えずに並列数を増やしても、後から統合不能な断片データが増えるだけです。スウォームの有効性はエージェントの数ではなく、いかに適切にタスクの「分解」を行い、結果の「統合」手段を確保し、人が確認するための「検証条件」を整えられるかで判断します。同時に、重複作業やデータの欠損、APIの費用超過、そして最終的な人の検証負荷をどう測るかが導入の成否を分けます。
本記事では、複数AIが並列で働く仕組みの裏側から、向く仕事と向かない仕事の境界、そして失敗の要因までを解説します。最後まで読むことで、自社の業務を単一エージェント、固定ワークフロー、少数の専門エージェント、あるいは動的なスウォームのどれで試すべきかを客観的に決め、同じ条件での比較テストを設計できるようになります。
エージェントスウォームは仕事を分けて同時に進める
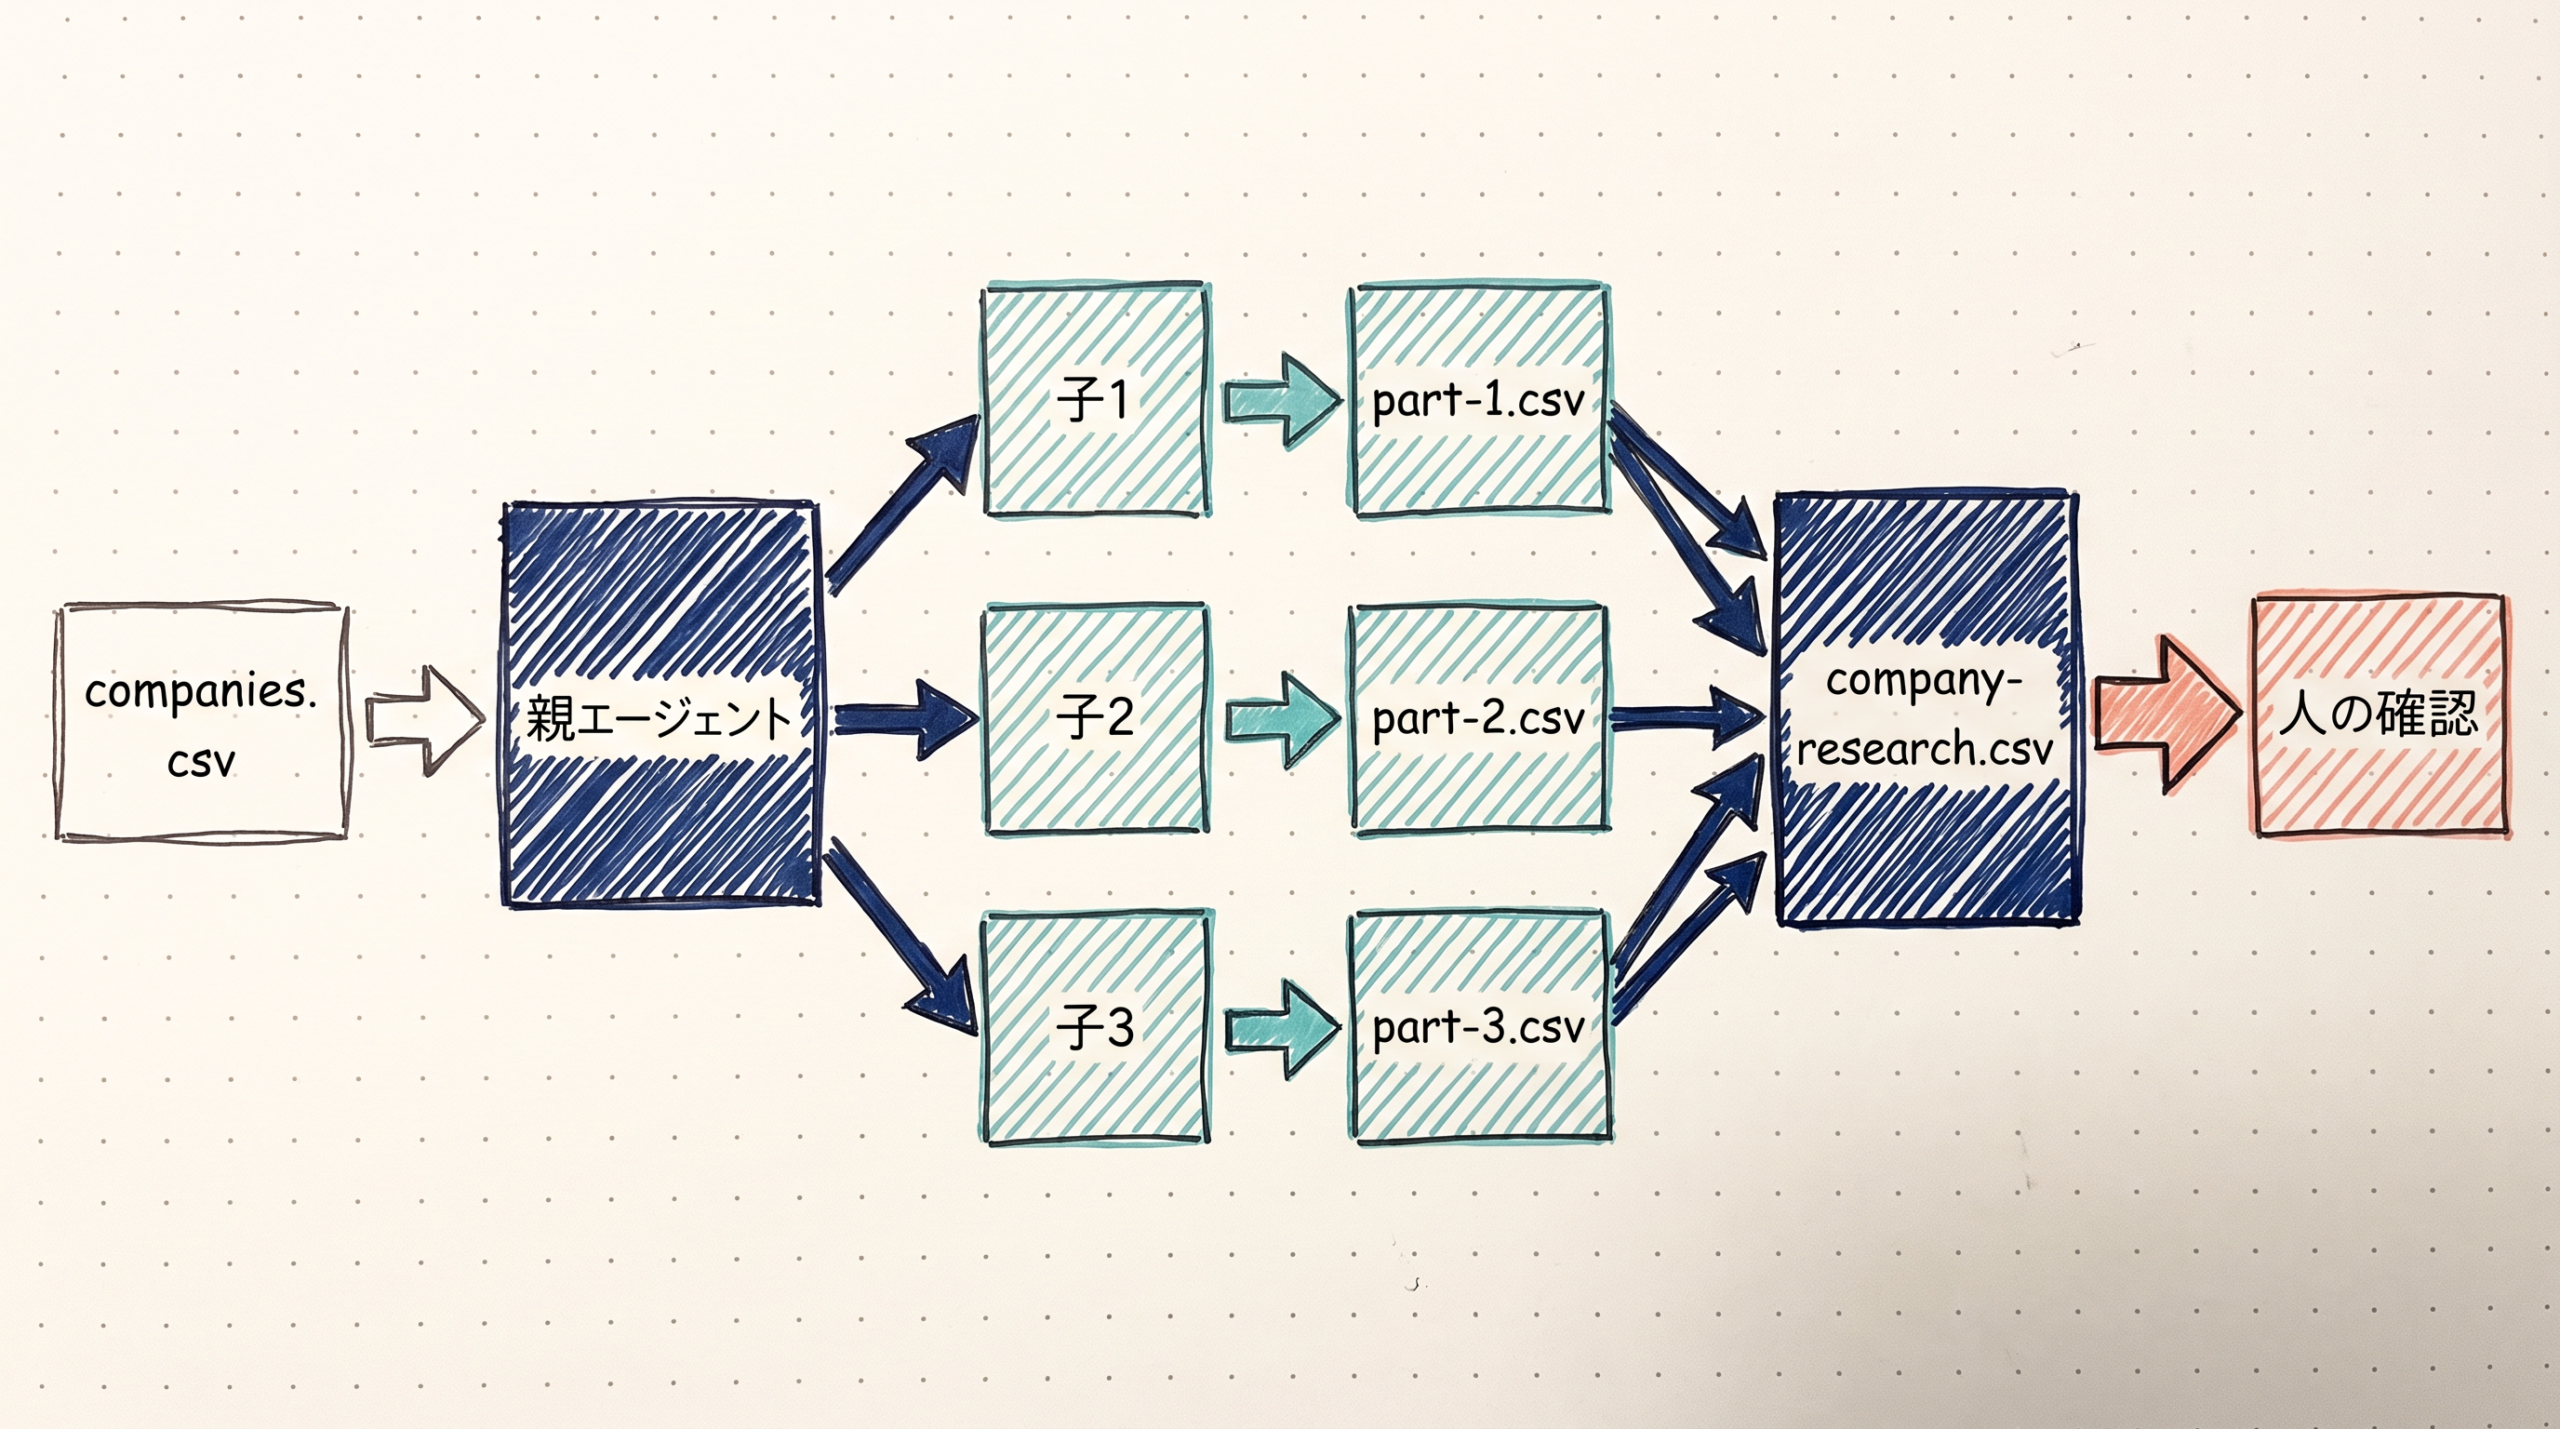
エージェントスウォームとは、親となるエージェントが大きな仕事を独立した単位に分解し、複数の子エージェントへ担当範囲と道具、出力形式を指示して同時に動かし、最後にその結果を統合する仕組みのことです。
この仕組みがどのように動くのか、「競合100社の製品、料金、導入事例を調べる」という一つの仕事を最後まで追ってみましょう。人が100社を順番に調べる従来の方法とは異なり、エージェントスウォームでは次のような流れで処理を進めます。
1. 入力と分割 まず、親エージェントに対して調査対象が並んだcompanies.csvを読み込ませます。同時に、「どのような項目を抽出するか(列定義)」「調査基準日はいつか」「検索を許可する情報源」「一次資料を優先する」といった規則を与えます。親エージェントは100社のリストを受け取ると、それらをいくつかの企業群に分割し、複数の子エージェントへ割り振って並列で調査を開始させます。
2. 子エージェントによる調査と部分成果物の作成 指示を受けた子エージェントたちは、割り当てられた企業を同時に調べ始めます。AIを使う最大の利点は、企業ごとに全く異なるWebページの構造を読み分け、自然言語の資料から必要な情報を抽出できる点です。各子は読み取り専用の権限で安全に検索を行い、担当分の作業を終えるとpart-01.csvといった部分成果物と、出典をまとめたpart-01-sources.csvを保存します。
3. 親エージェントによる統合 すべての子エージェントの作業が終わると、親エージェントが部分成果物を回収します。親は集まったデータの列数、会社名、URL、基準日、見つからなかった値の欠損表記などを検査し、重複する企業を除外しながら一つのファイルcompany-research.csvへと統合します。もし規則を与えずにエージェントをただ増やしただけでは、統合できない断片的なデータが散らかるだけになってしまいます。
4. 人による最終確認 統合されたファイルができあがっても、そこで仕事は完了しません。最終的に人が、会社名と製品の対応は正しいか、料金条件(通貨・期間・最低契約など)に誤解はないか、調査日の違いや空欄の妥当性、そして記録された出典(一次資料のURL)に間違いがないかを確認します。情報の公開や顧客データへの書き込みといった重大な権限は子エージェントには渡さず、人が結果を検証する工程を必ず挟むことが重要です。
マルチエージェントとの違いは並列化の必須性
前項で見た100社調査のような構成を、他のアプローチと比較して一般概念へ整理します。「マルチエージェント」という言葉は、複数のAIが関わる仕組み全般を指す広い用語であり、この中には順番に処理を進める構成と、同時に処理を進める構成が混在しています。エージェントスウォームを他の似た用語と分ける決定的な違いは、「並列化(同時実行)」が必須であるかどうかにあります。
自社の仕事に対してどの構成を選ぶべきか決めるため、代表的な4つの構成を比較してみましょう。
- 直列handoff: 専門のエージェント間で会話の担当を切り替え(handoff)ながら順番に進める手法です。実験用のOpenAI Swarmなどで中心的に扱われました。
- 固定ワークフロー: 前工程の判断が決まらないと次の担当エージェントへ進めない、直列の作業手順です。
- 少数並列: 親エージェントが3〜5の子エージェントを並列に動かすような構成です。例えば、Anthropicの調査システムなどがこの形式を採用しています。
- 動的スウォーム: 状況に応じて、親が数十から数百の子エージェントを動的に生成して割り振る構成です。
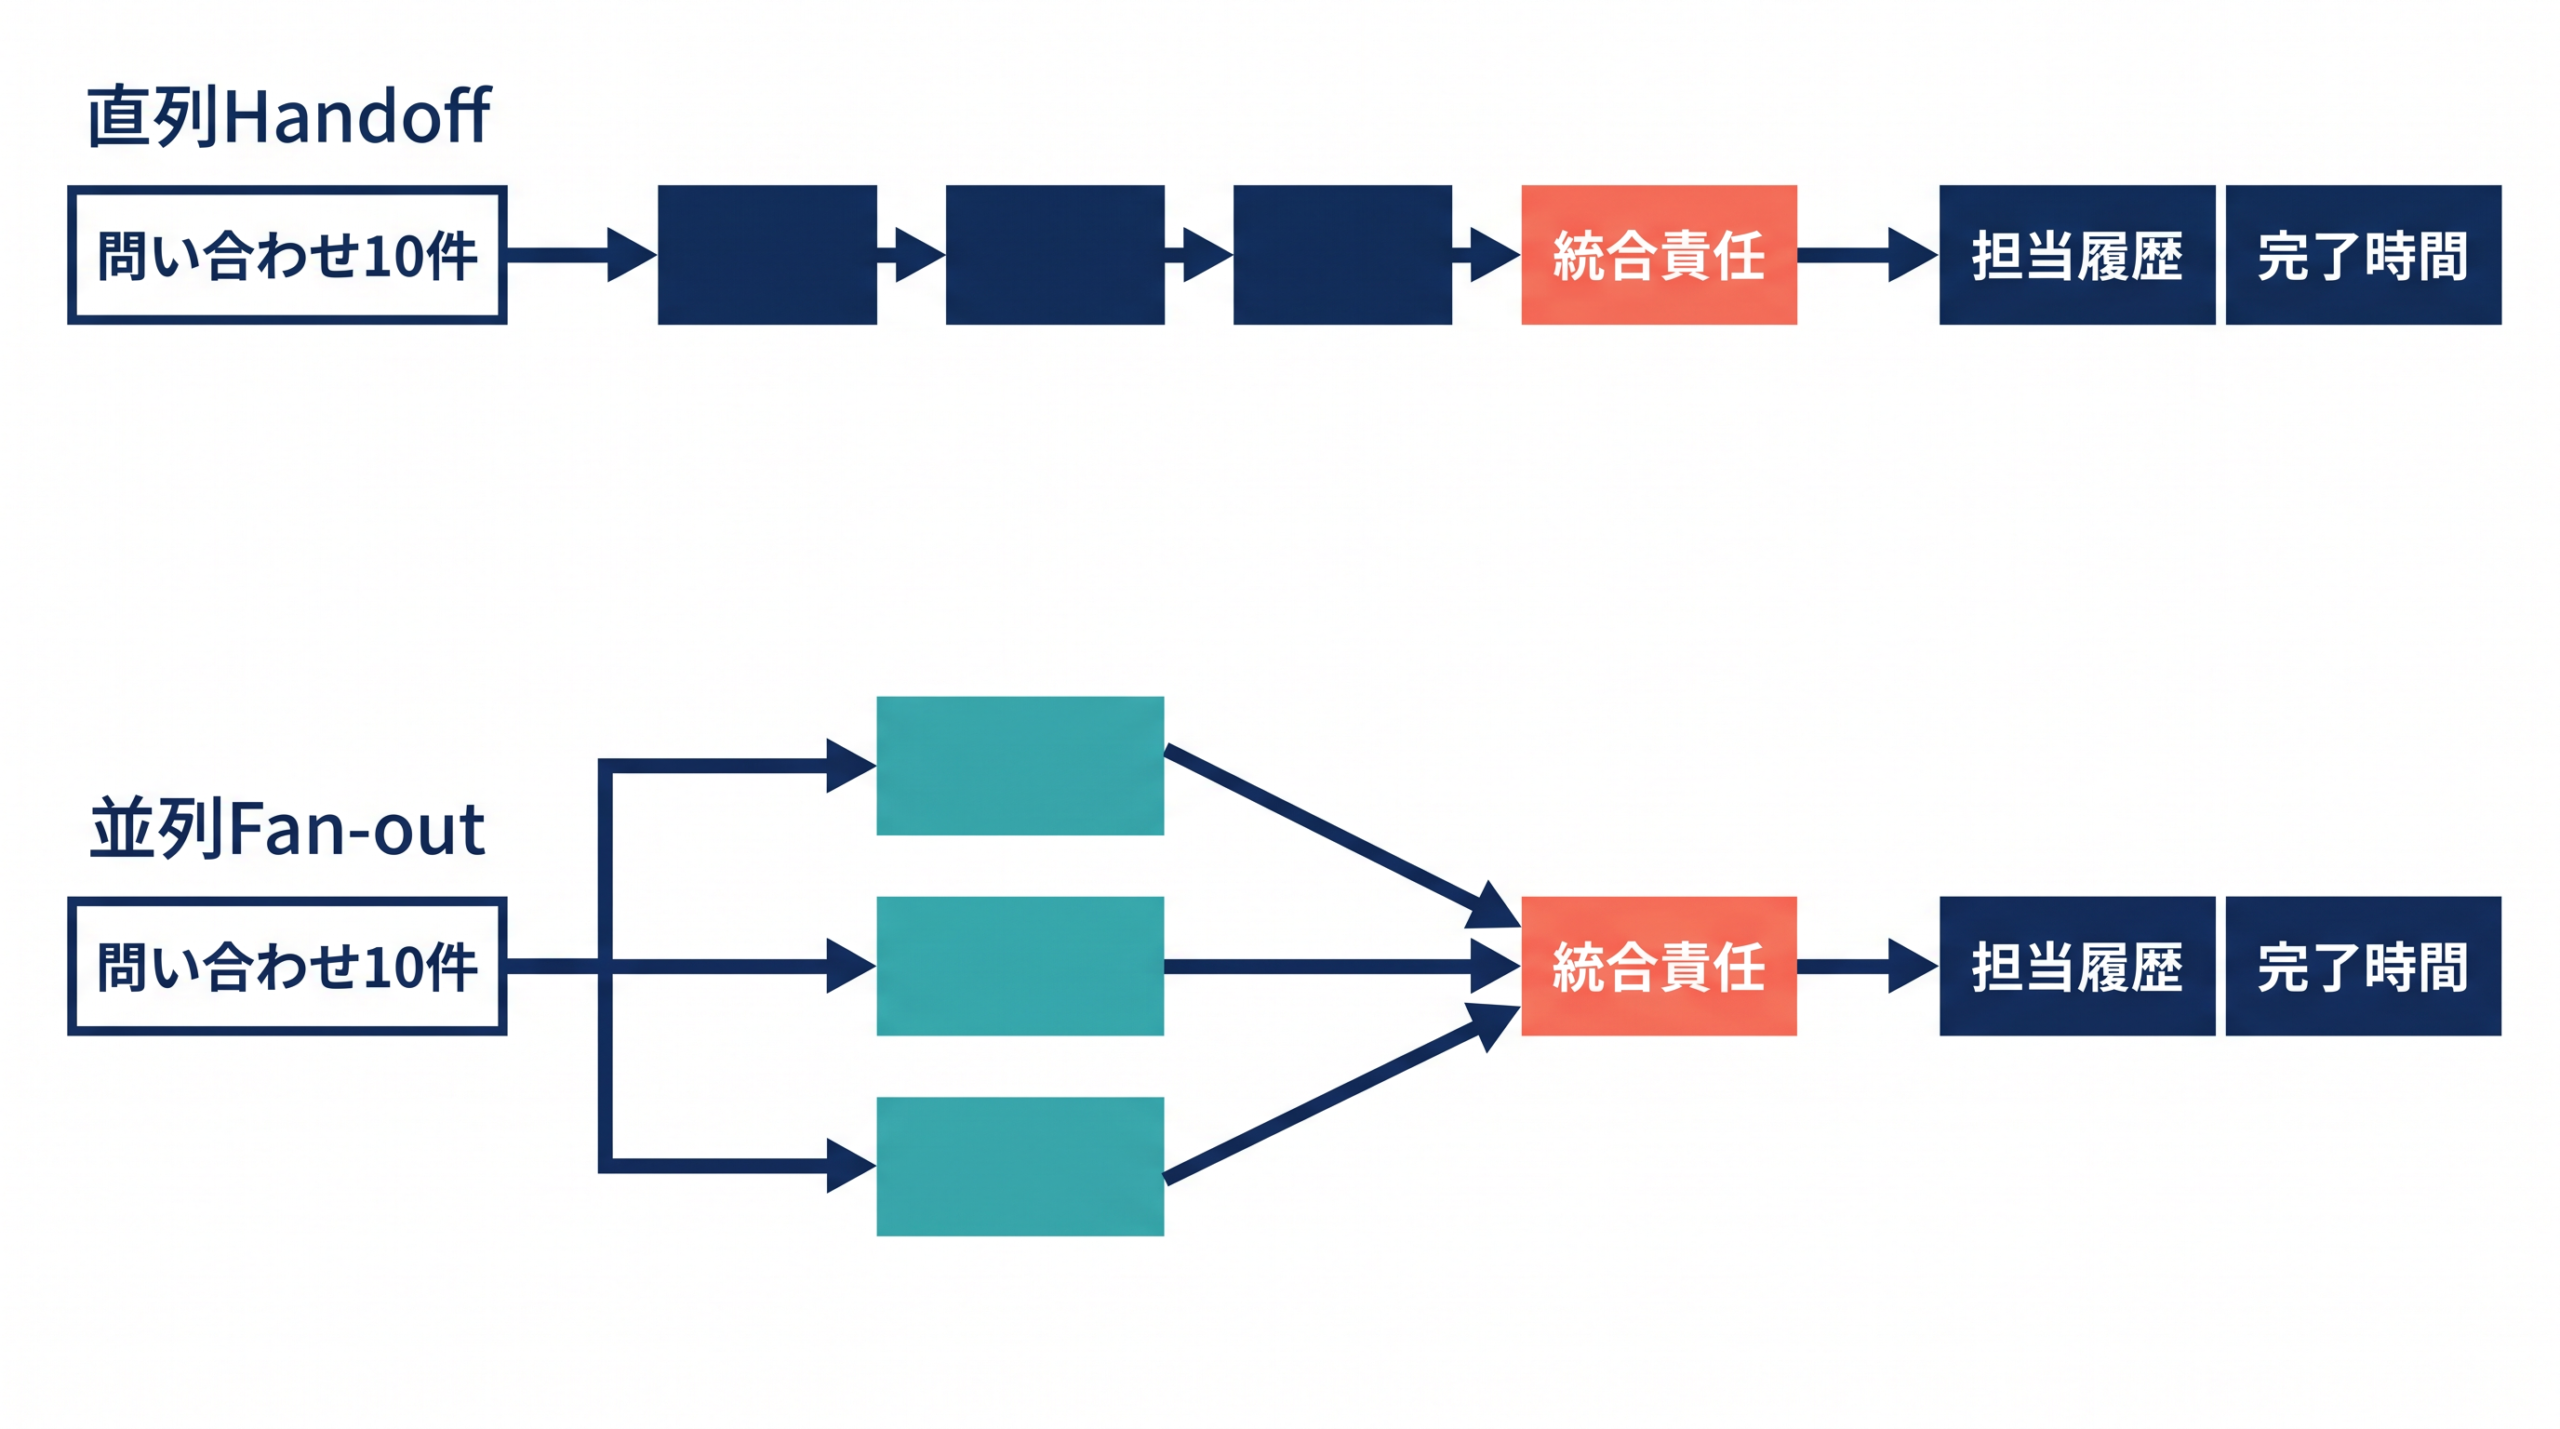
これらがどう違うのか、入力が「問い合わせ10件」である場合を例に、直列のhandoffと並列fan-outを別々に実行して比較してみます。
直列handoffを実行した場合、受付エージェントが1件ずつ内容を確認し、技術担当や料金担当へ順番に処理を引き継ぎます。この構成の出力には、「誰がどの順番で対応したか」という担当履歴と完了時間が記録されますが、完了時間は10件を順番に処理した合計時間となります。
一方、並列fan-out(スウォーム)を実行した場合、親エージェントが10件の問い合わせを複数の子エージェントへ同時に割り振ります。完了時間は大きく短縮されますが、人が結果を検証(human verification)する際には、単に回答内容を見るだけでなく、実際の処理における同時実行の有無と、最終責任者としてどの親エージェントが回答を統合したかを確認する必要があります。
実装や製品による用語の混同に注意 複数のエージェントが動く仕組みは、実装や特定の製品によって指す内容が大きく異なります。前述のOpenAIの旧Swarmは担当の切り替えを主眼とした実験用の抽象化であり、大規模に並列させる一般概念としてのスウォームとは異なります。また、現行のOpenAI Agents SDKのオーケストレーション資料では、専門エージェントへの担当引き継ぎと、プログラムの機能を使った独立処理の並列実行は、実装側で分けて設計するものとして説明されています。
さらに、動的スウォームの製品例であるMoonshot AIのKimi Agent Swarmは、最大300の子エージェントを並列に調整する固有の製品構成を指します。このように、単に「複数のAIがいる」というだけでは、順番に引き継いでいるのか、同時に動いているのかわかりません。似た用語を区別する際は、「並列で動いているか」「最終的に誰が統合しているか」という構成の違いに注目することが重要です。
親エージェントは分解・監視・統合を担う
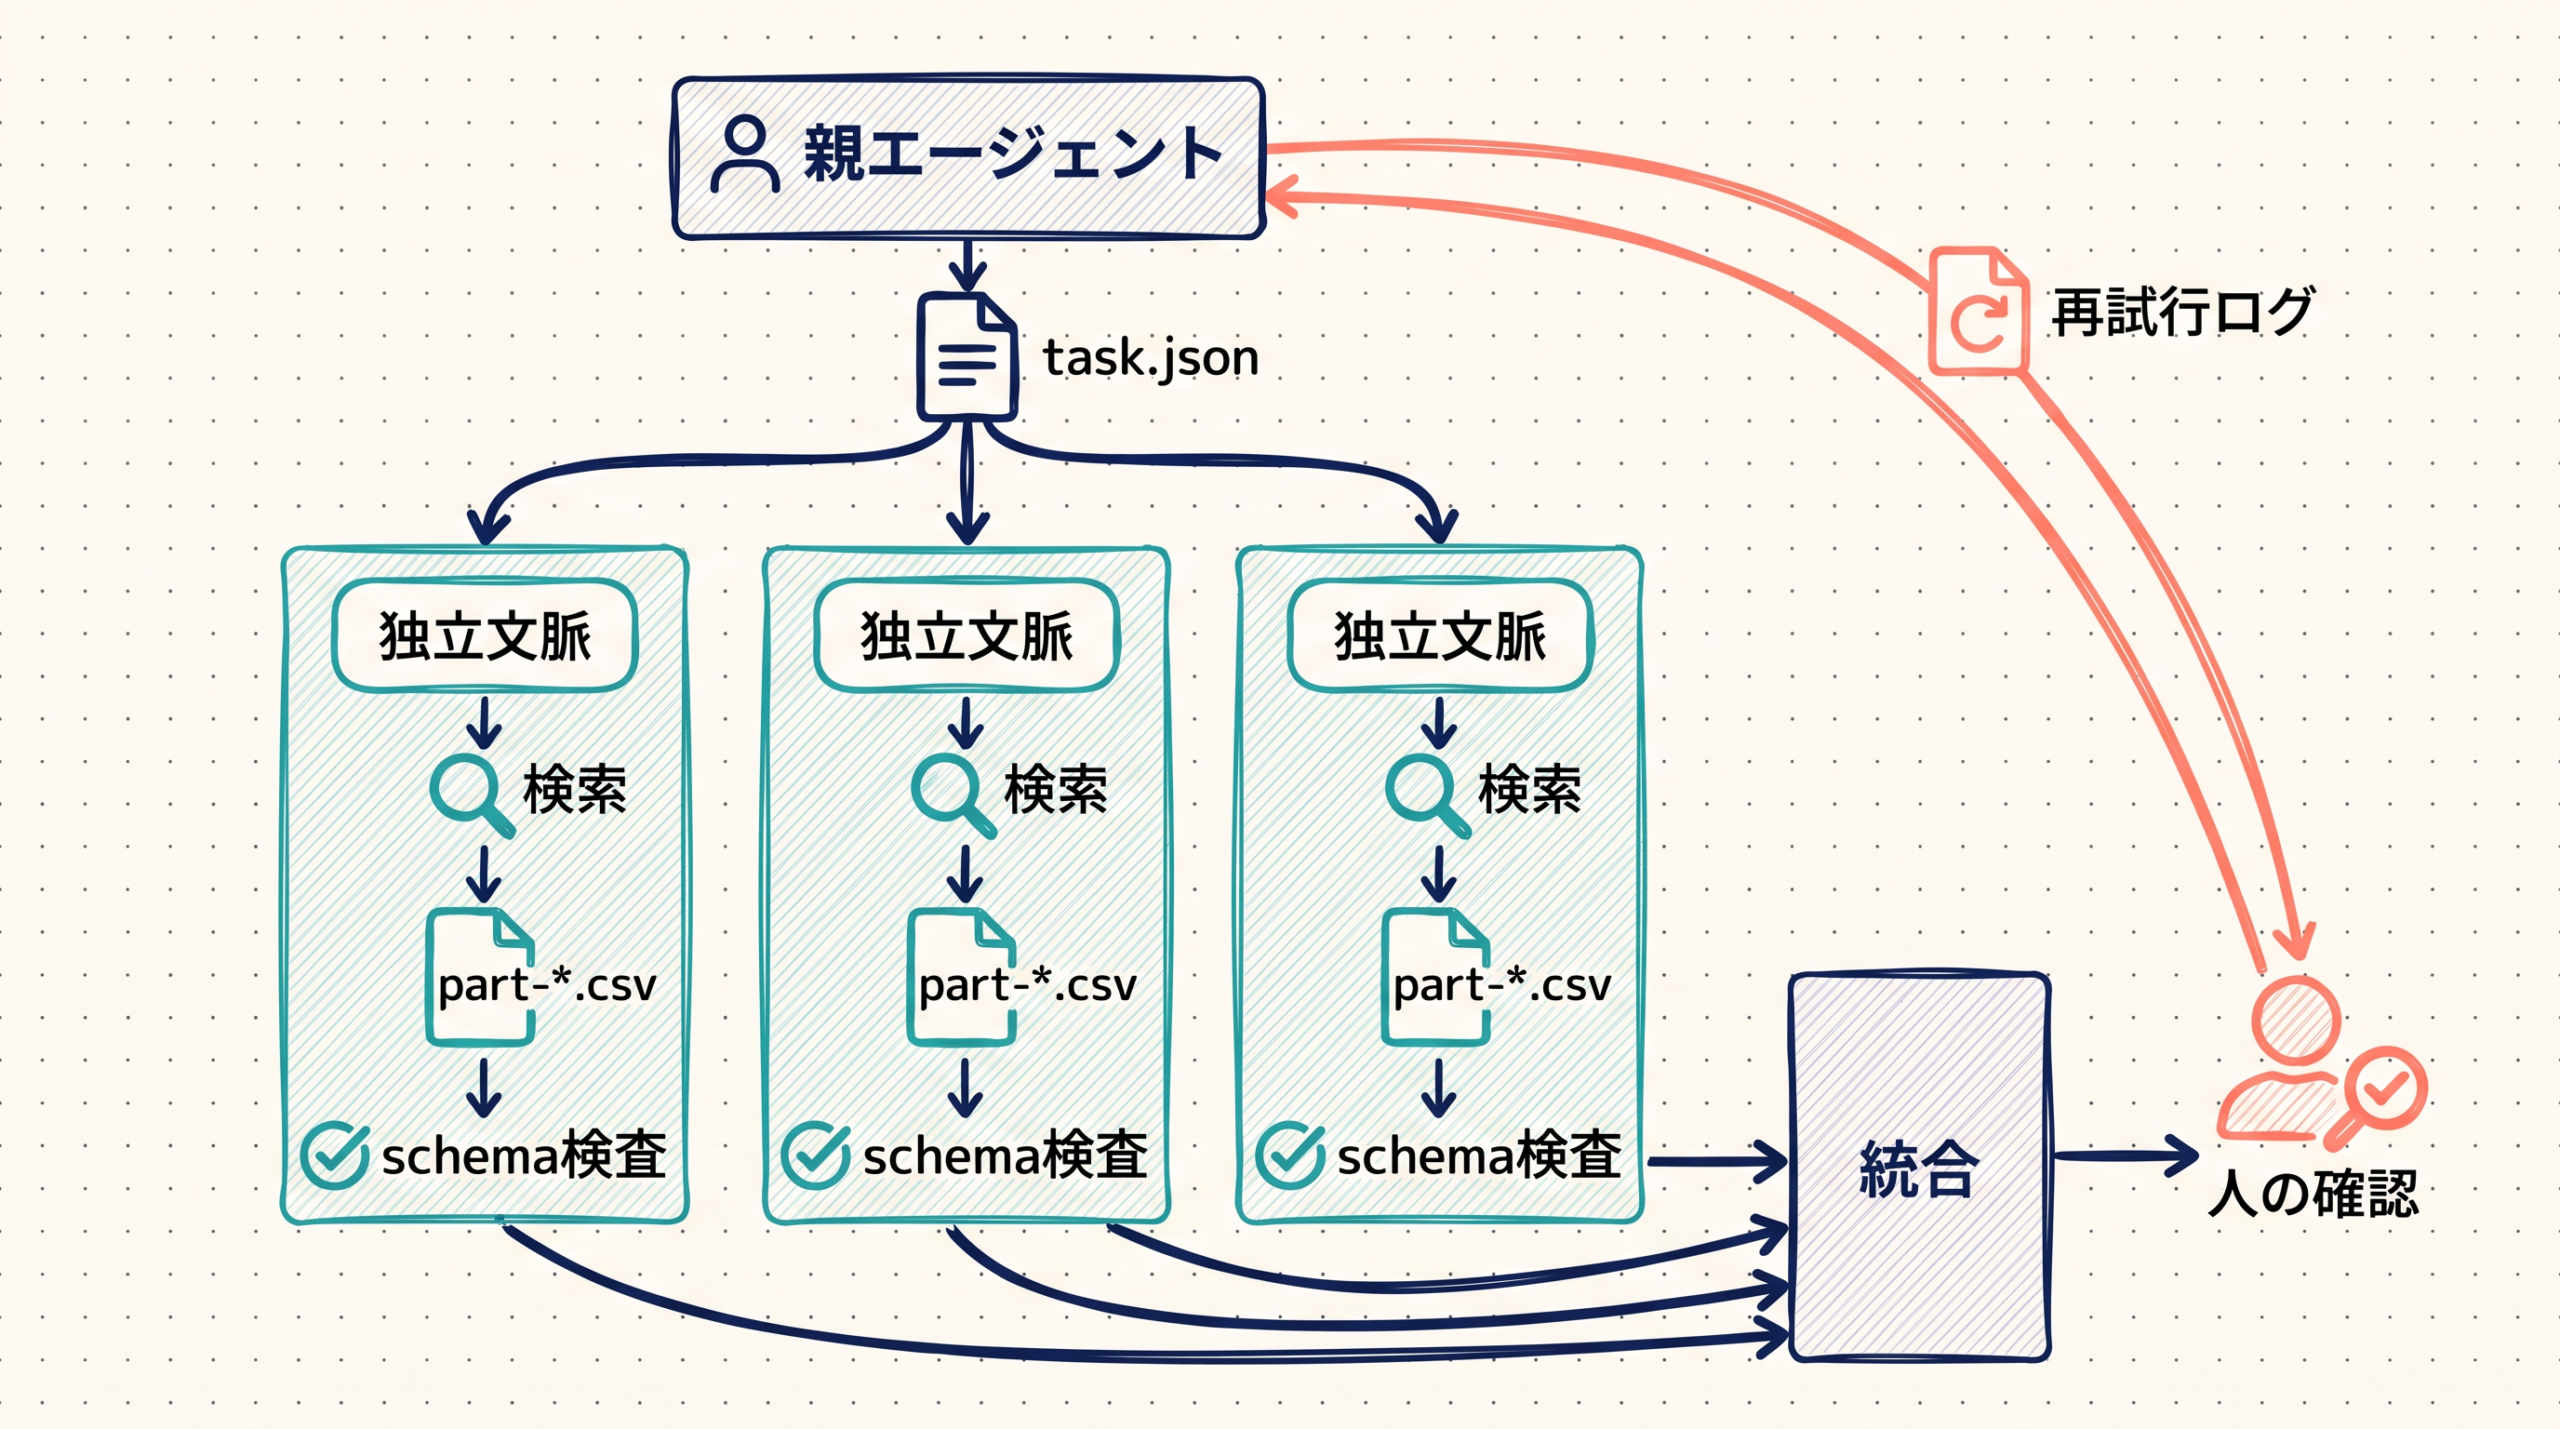
用語の違いを確認したところで、エージェントスウォームが内部でどう動くのか、その実行機構を見ていきます。スウォームを正しく機能させる鍵は、親エージェントがいかに仕事を分解してタスクグラフを構築し、子エージェントを監視し、最後に結果を統合するかにあります。
親エージェントは、全体目標を単に丸投げすることはありません。Anthropicの調査システムの実装報告で説明されているように、「半導体業界を調べる」といった曖昧な指示ではなく、調査の対象、具体的な問い、使う情報源(道具)、返す出力形式、そして除外範囲を厳密に定義して子エージェントへ渡します。
同時に、子エージェント間では独立文脈を維持します。長い会話履歴を全員で共有するのではなく、各子が独立した記憶領域(ノートブックなど)を持ちます。作業を終えた子は長い履歴を丸ごと親へ返すのではなく、出典付きの要点と未確認点だけを返します。これにより親エージェントの文脈を保ちますが、要約時に重要な条件や例外が抜け落ちる危険もあるため、最終的な成果物には一次資料へ戻れるURLと引用位置が必須となります。
前述の100社調査なら、親エージェントは企業を10社ずつに分けたtask.jsonを作り、各子エージェントへ渡します。子エージェントは読み取り専用で検索し、互いに干渉しない別ファイルへ担当分を保存します。親エージェントは部分成果物を回収し、列数、会社名、URL、欠損表記が共通ルールに合うかを検査したうえで統合します。
統合ファイルには、成功・失敗・再試行の記録も残します。OpenAIの現行Agents SDKのオーケストレーション資料が示す通り、SDKを導入しただけで動的スウォームが完成するわけではありません。実装担当者は、タスク分解、同時実行、結果統合、再試行の仕組みを設計する必要があります。実行後は、担当範囲の重複、共有ファイルの競合、失敗した子だけを再試行できたかを確認します。
親エージェントがこの「分解・監視・統合」の役割を果たせない場合、形式だけエージェントを分けて実質的に直列処理になってしまったり、意味のない小さな仕事を作ってしまったりと、並列化の利点が失われます。担当範囲の重複と、部分成果物を統合する際の欠損を実行ログで追います。
公開実装は製品・調査システム・SDKで異なる
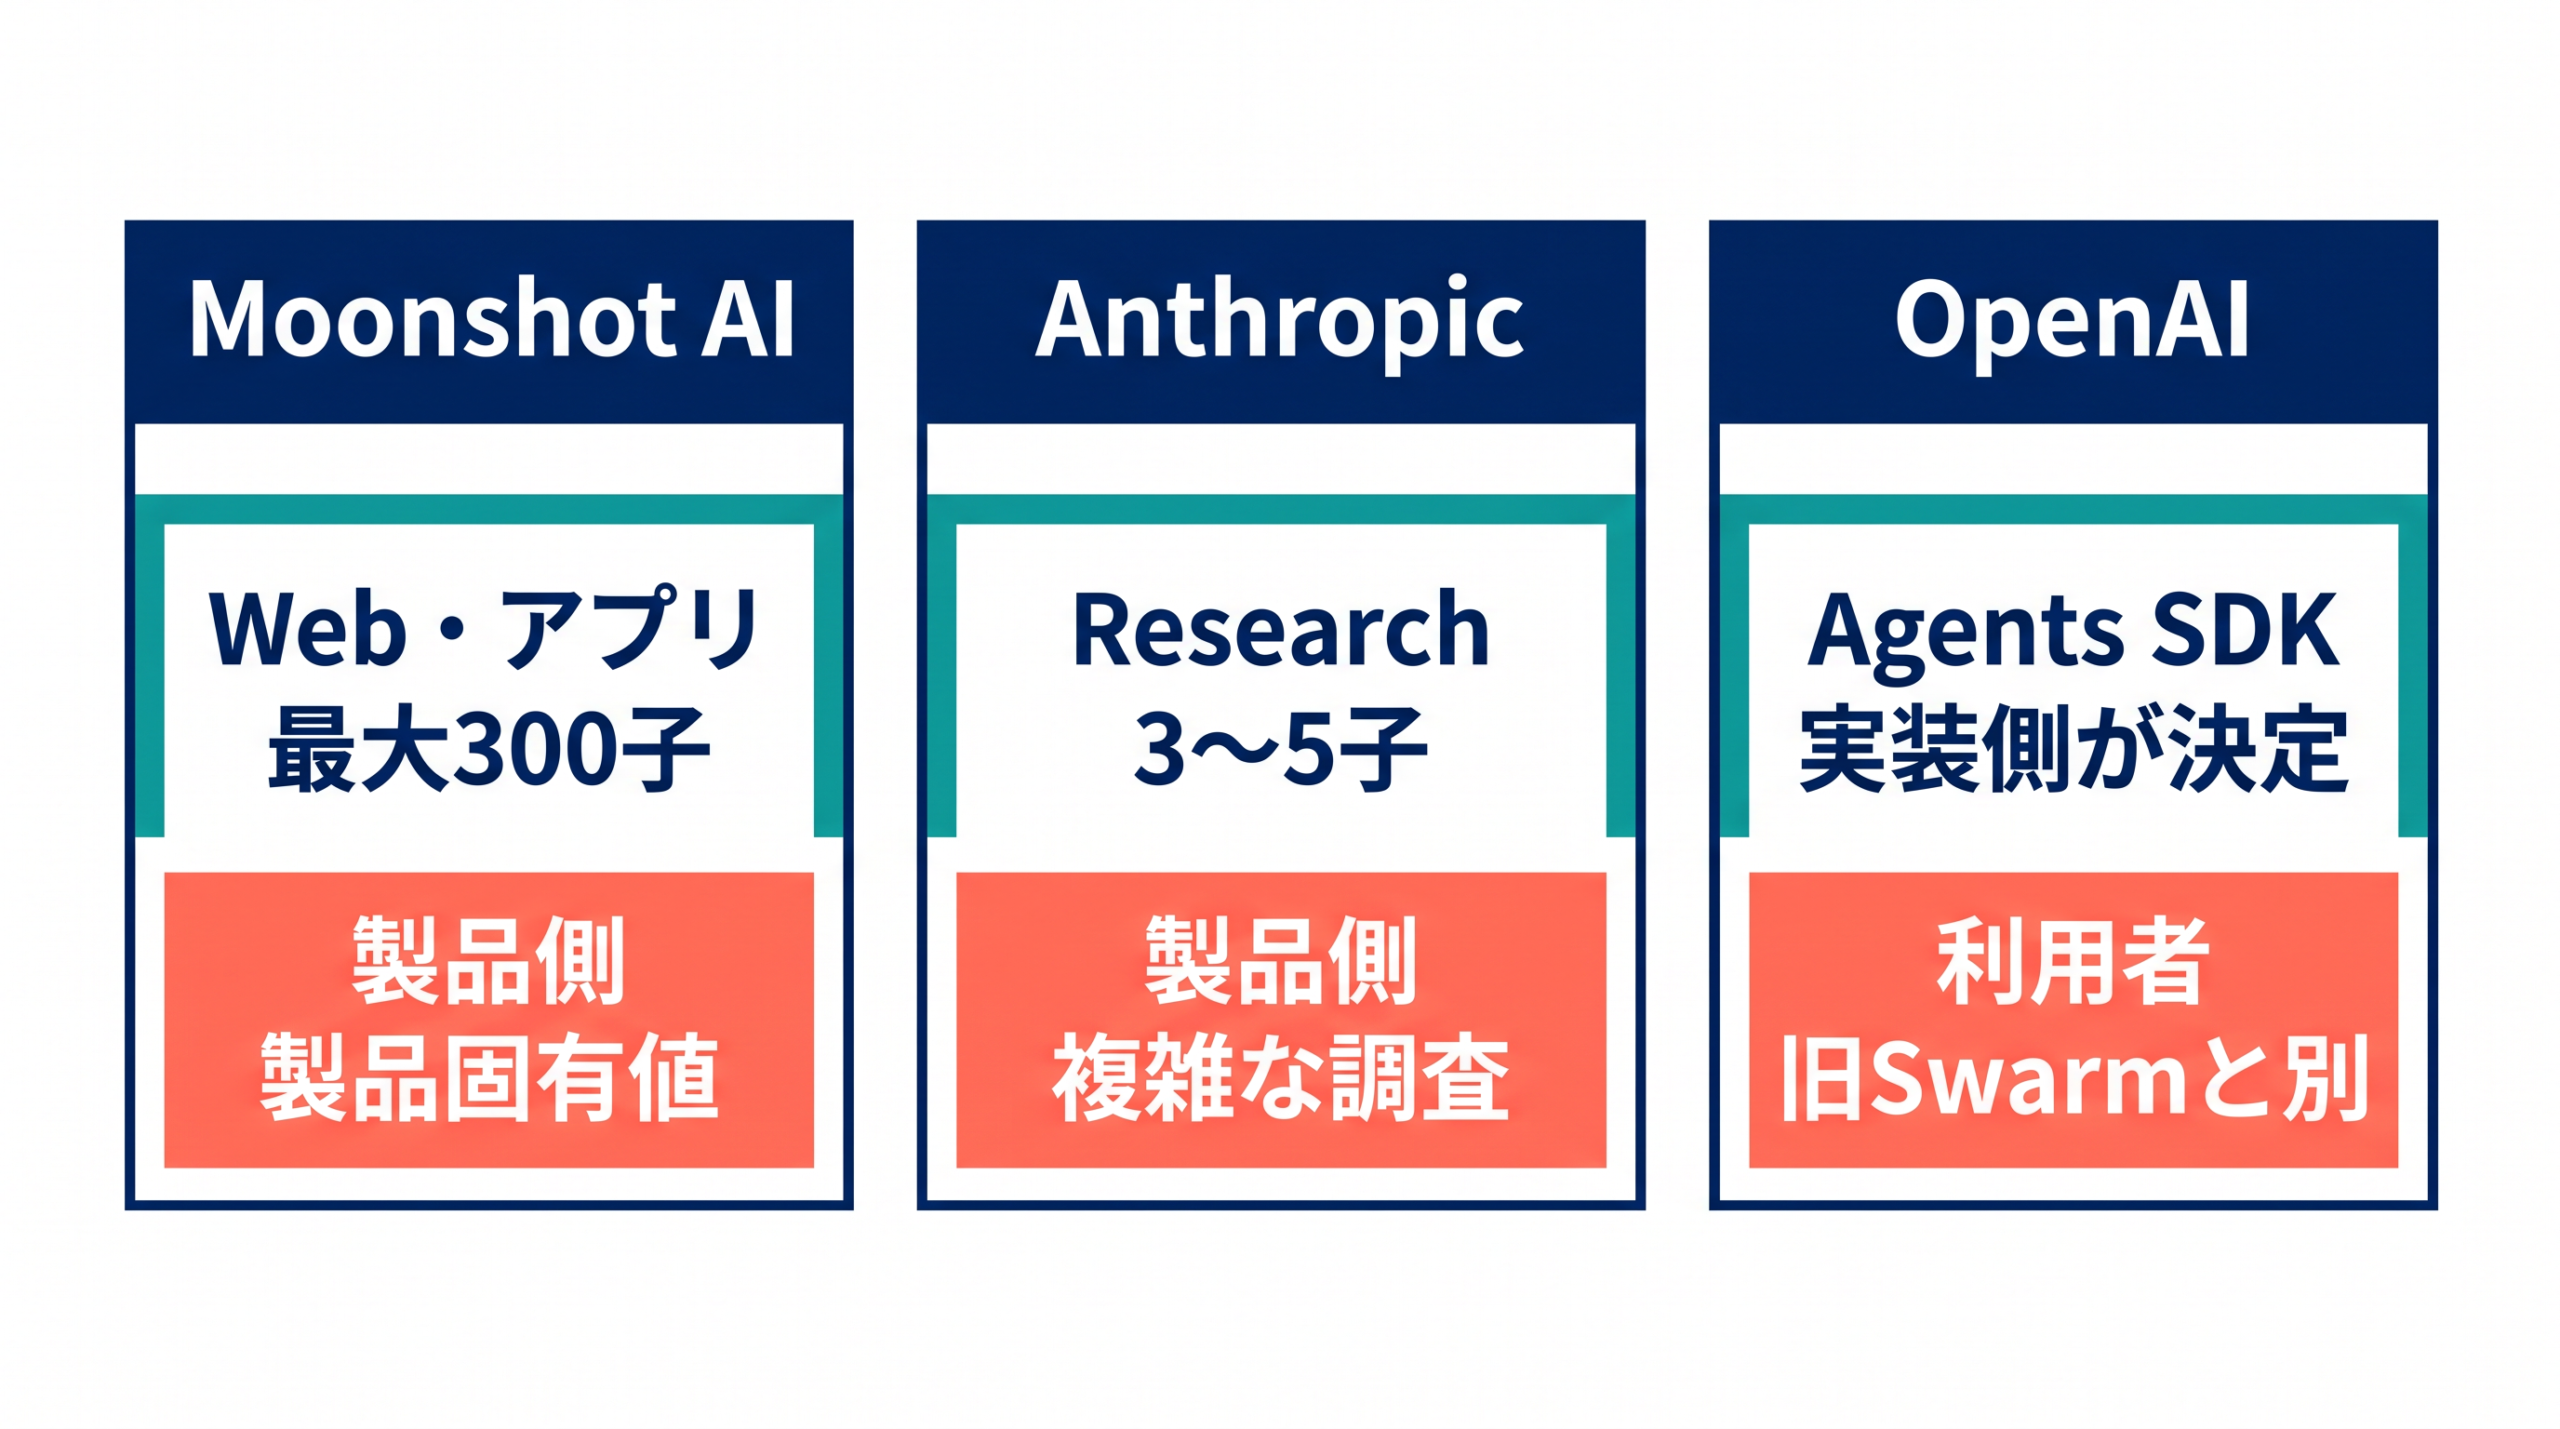
ここまで見てきたスウォームの仕組みが現在どこまで使えるかを判断するためには、実在する公開実装を結び付けて比較する必要があります。一般概念としてのスウォームと、各社が提供する完成品のWeb製品、特定の調査システム、そして開発キット(SDK)では性質や適用範囲が異なります。
これらを同じ尺度で比べるために、「同じ10社調査依頼」を各実装で試す場面を考えてみましょう。Web製品を使ったのか、SDKを自社で組み込んだのかを分け、タスクの分割設定も記録します。比較票には、実際に動いた子エージェントの人数、検索に使った道具、完了時間、費用をまとめます。担当者は結果だけでなく、企業が公表する製品固有値、利用可能な料金プラン、APIの認証方法、速度や精度の測定条件も照合します。
Moonshot AIの製品型スウォーム Web製品やアプリとして動的スウォームを利用できるのが、Moonshot AIのKimi Agent Swarmです。Moonshot AI公式ヘルプによると、これは親エージェントだけを強化学習し、最大300の子エージェントを並列に調整する水平スケーリング構成です。同資料では、特定の課題(BrowseComp)において単一エージェント比約4.5倍の速度向上や、正答率が15.9%から33.3%へ向上したことを掲げていますが、これはMoonshot AIのシステムと特定の評価条件に限る値であり、別の業務へ無条件に一般化できるものではありません。 また、開発者向けのKimi CodeのAgentSwarm仕様では最大128の子エージェント、既定2時間のタイムアウトといった制限が設けられています。Web製品の最大300という数値とSDKの仕様を混同しないようにし、標準の単一エージェントより多くのクレジット(費用)を消費する点にも注意が必要です。エージェントの人数が多いこと自体を品質の証拠と見なしてはいけません。
Anthropicの少数並列調査システム 少数の専門エージェントを並列させる構成の例として、Anthropicの実装報告による調査システムがあります。これは、親エージェントが3〜5の子エージェントを並列起動し、各子がさらに3件以上のツール(道具)呼び出しを並列化する仕組みです。複雑な問い合わせにおいて最大90%の時間短縮を報告していますが、同時に限界も指摘されています。簡単な調査に対して多数の子エージェントを起動してしまうと、存在しない情報を探し続けたり担当範囲が重複したりといった失敗が起こり得ると記載されています。
OpenAIの旧Swarmと現行SDK 開発キット(SDK)を自社で組み込む場合、実装の自由度は上がりますが、開発者の責任も増えます。かつて公開されたOpenAI Swarmリポジトリは、会話の担当を切り替える(handoff)軽量な実験用の仕組みであり、大規模な並列処理を行う一般概念としてのスウォームと同一視すべきではありません。 現在は本番向けのOpenAI Agents SDKへの移行が推奨されていますが、OpenAI Agents SDKのオーケストレーション資料が示す通り、SDKを導入しただけで自動的に動的スウォームが完成するわけではありません。先ほどの「10社調査」をSDKで実装する場合、親エージェントがタスクを分解し、子エージェントを同時に実行させ、結果を統合して再試行するといった処理の流れは、すべて実装側で設計する必要があります。
これらの違いを踏まえ、自社の仕事に対して「完成されたWeb製品のプランを契約する」のか、「少数並列のシステムを参考にする」のか、あるいは「SDKを使ってゼロから経路と設定を構築する」のかを、時間と費用の比較票をもとに判断することがスウォーム活用の第一歩となります。
向くのは依存関係が薄く成果物を統合できる仕事
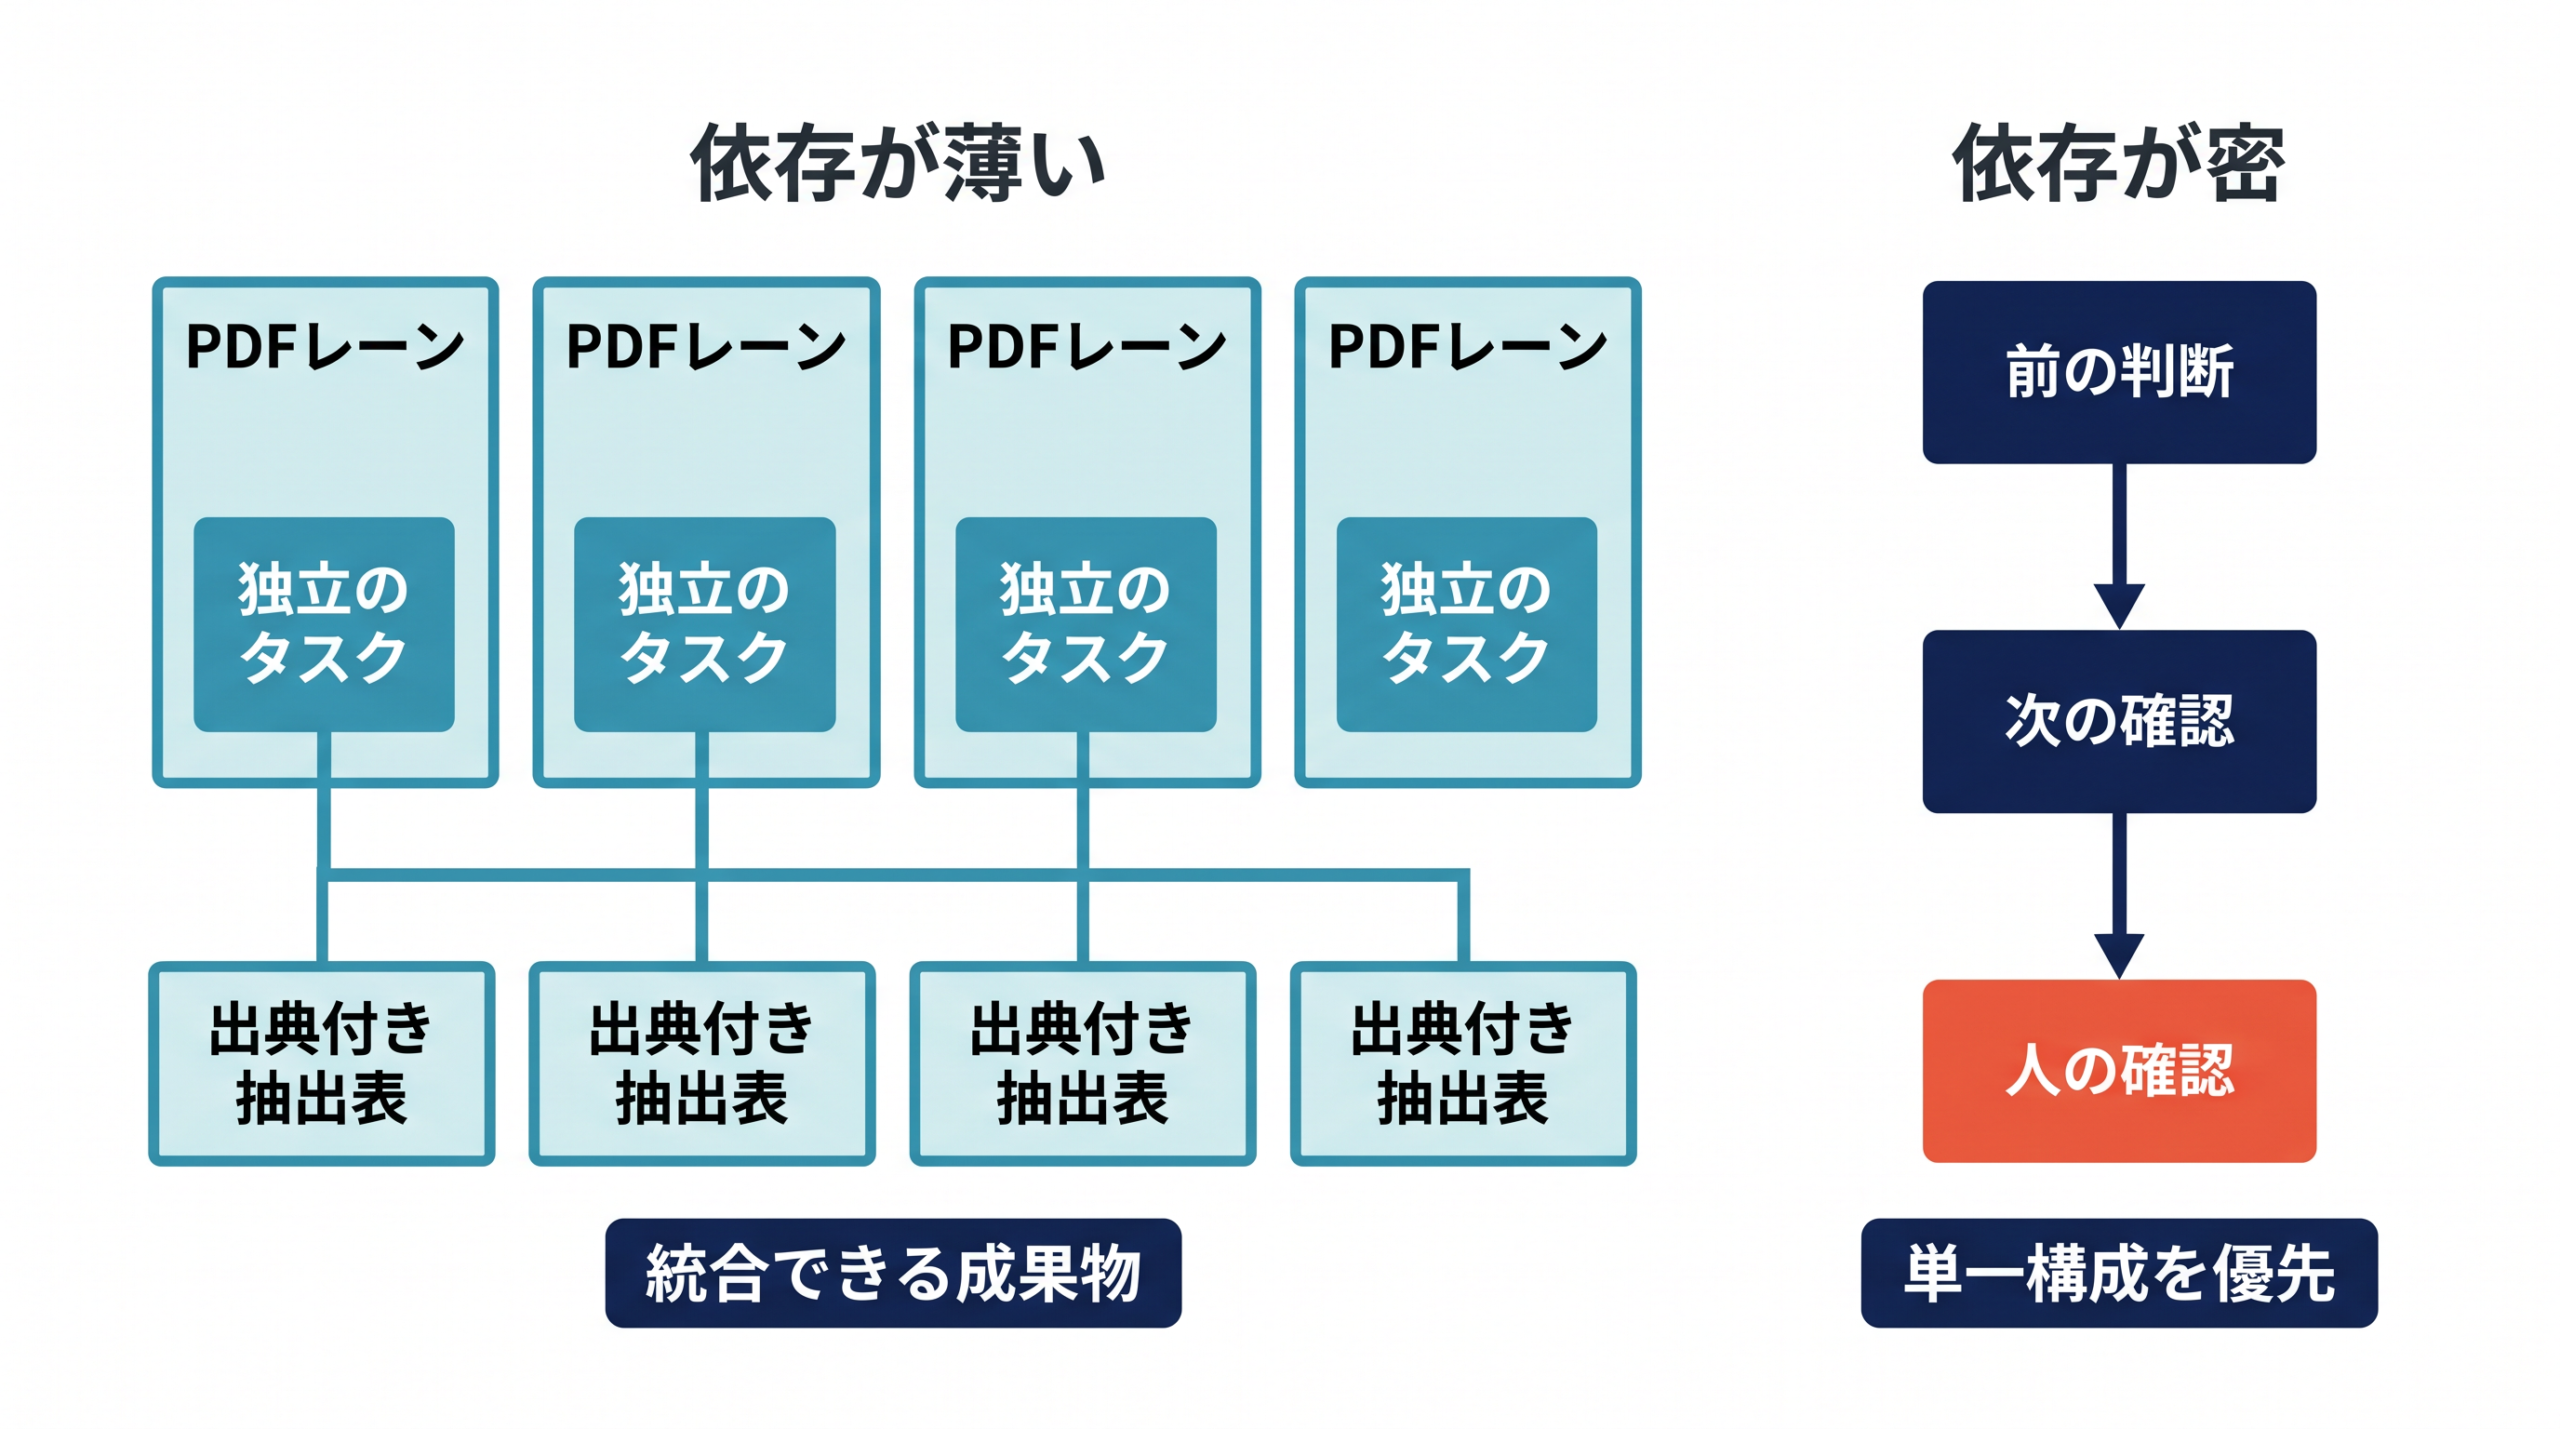
公開されているシステムやSDKを自社でどう実装できるかが見えてきたら、次は「どのような仕事を選ぶべきか」を決定します。エージェントスウォームが最も能力を発揮するのは、対象同士の依存関係が薄く、最後に親エージェントが中央で成果物を統合できる仕事です。
スウォームに向く仕事の具体例 最も適しているのは、多数の企業データ、文献、ファイルを同じ形式で読み解くような「対象単位で独立させやすい」大規模調査です。 例えば、40本のPDFから同じ項目を抜き出す文献調査なら、親エージェントへPDFと共通の抽出項目を渡します。親エージェントはPDFを子エージェントへ割り振り、各子は担当文献の章別メモを別々に作ります。最後に親がメモを出典付きの抽出表へまとめれば、担当者は文献の重複、引用ページ、必要項目の抜けに絞って確認できます。
このような調査以外にも、複数の設計案や表現案を独立した子エージェントに作らせて最後に比較する仕事は、探索の幅を広げるのに向いています。また、開発現場でのコード作業については、担当するディレクトリやテスト範囲が明確に分かれており、共通ファイルへの同時書き込みを避けられる場合に限って向いています。
スウォームに向かない仕事 一方で、エージェントの人数を増やしても効果が出ない、あるいはかえって悪化する仕事もあります。
- 前工程の判断が決まらないと次へ進めない仕事: 密結合の直列ワークフローと呼ばれるような仕事です。前の担当エージェントの結果を待たなければならないため、同時に処理を進める並列化の利点が失われます。
- 一つの契約条項や数値を厳密に確定する仕事: 複数エージェントが独立して動くことで、かえって情報が分岐する原因になります。
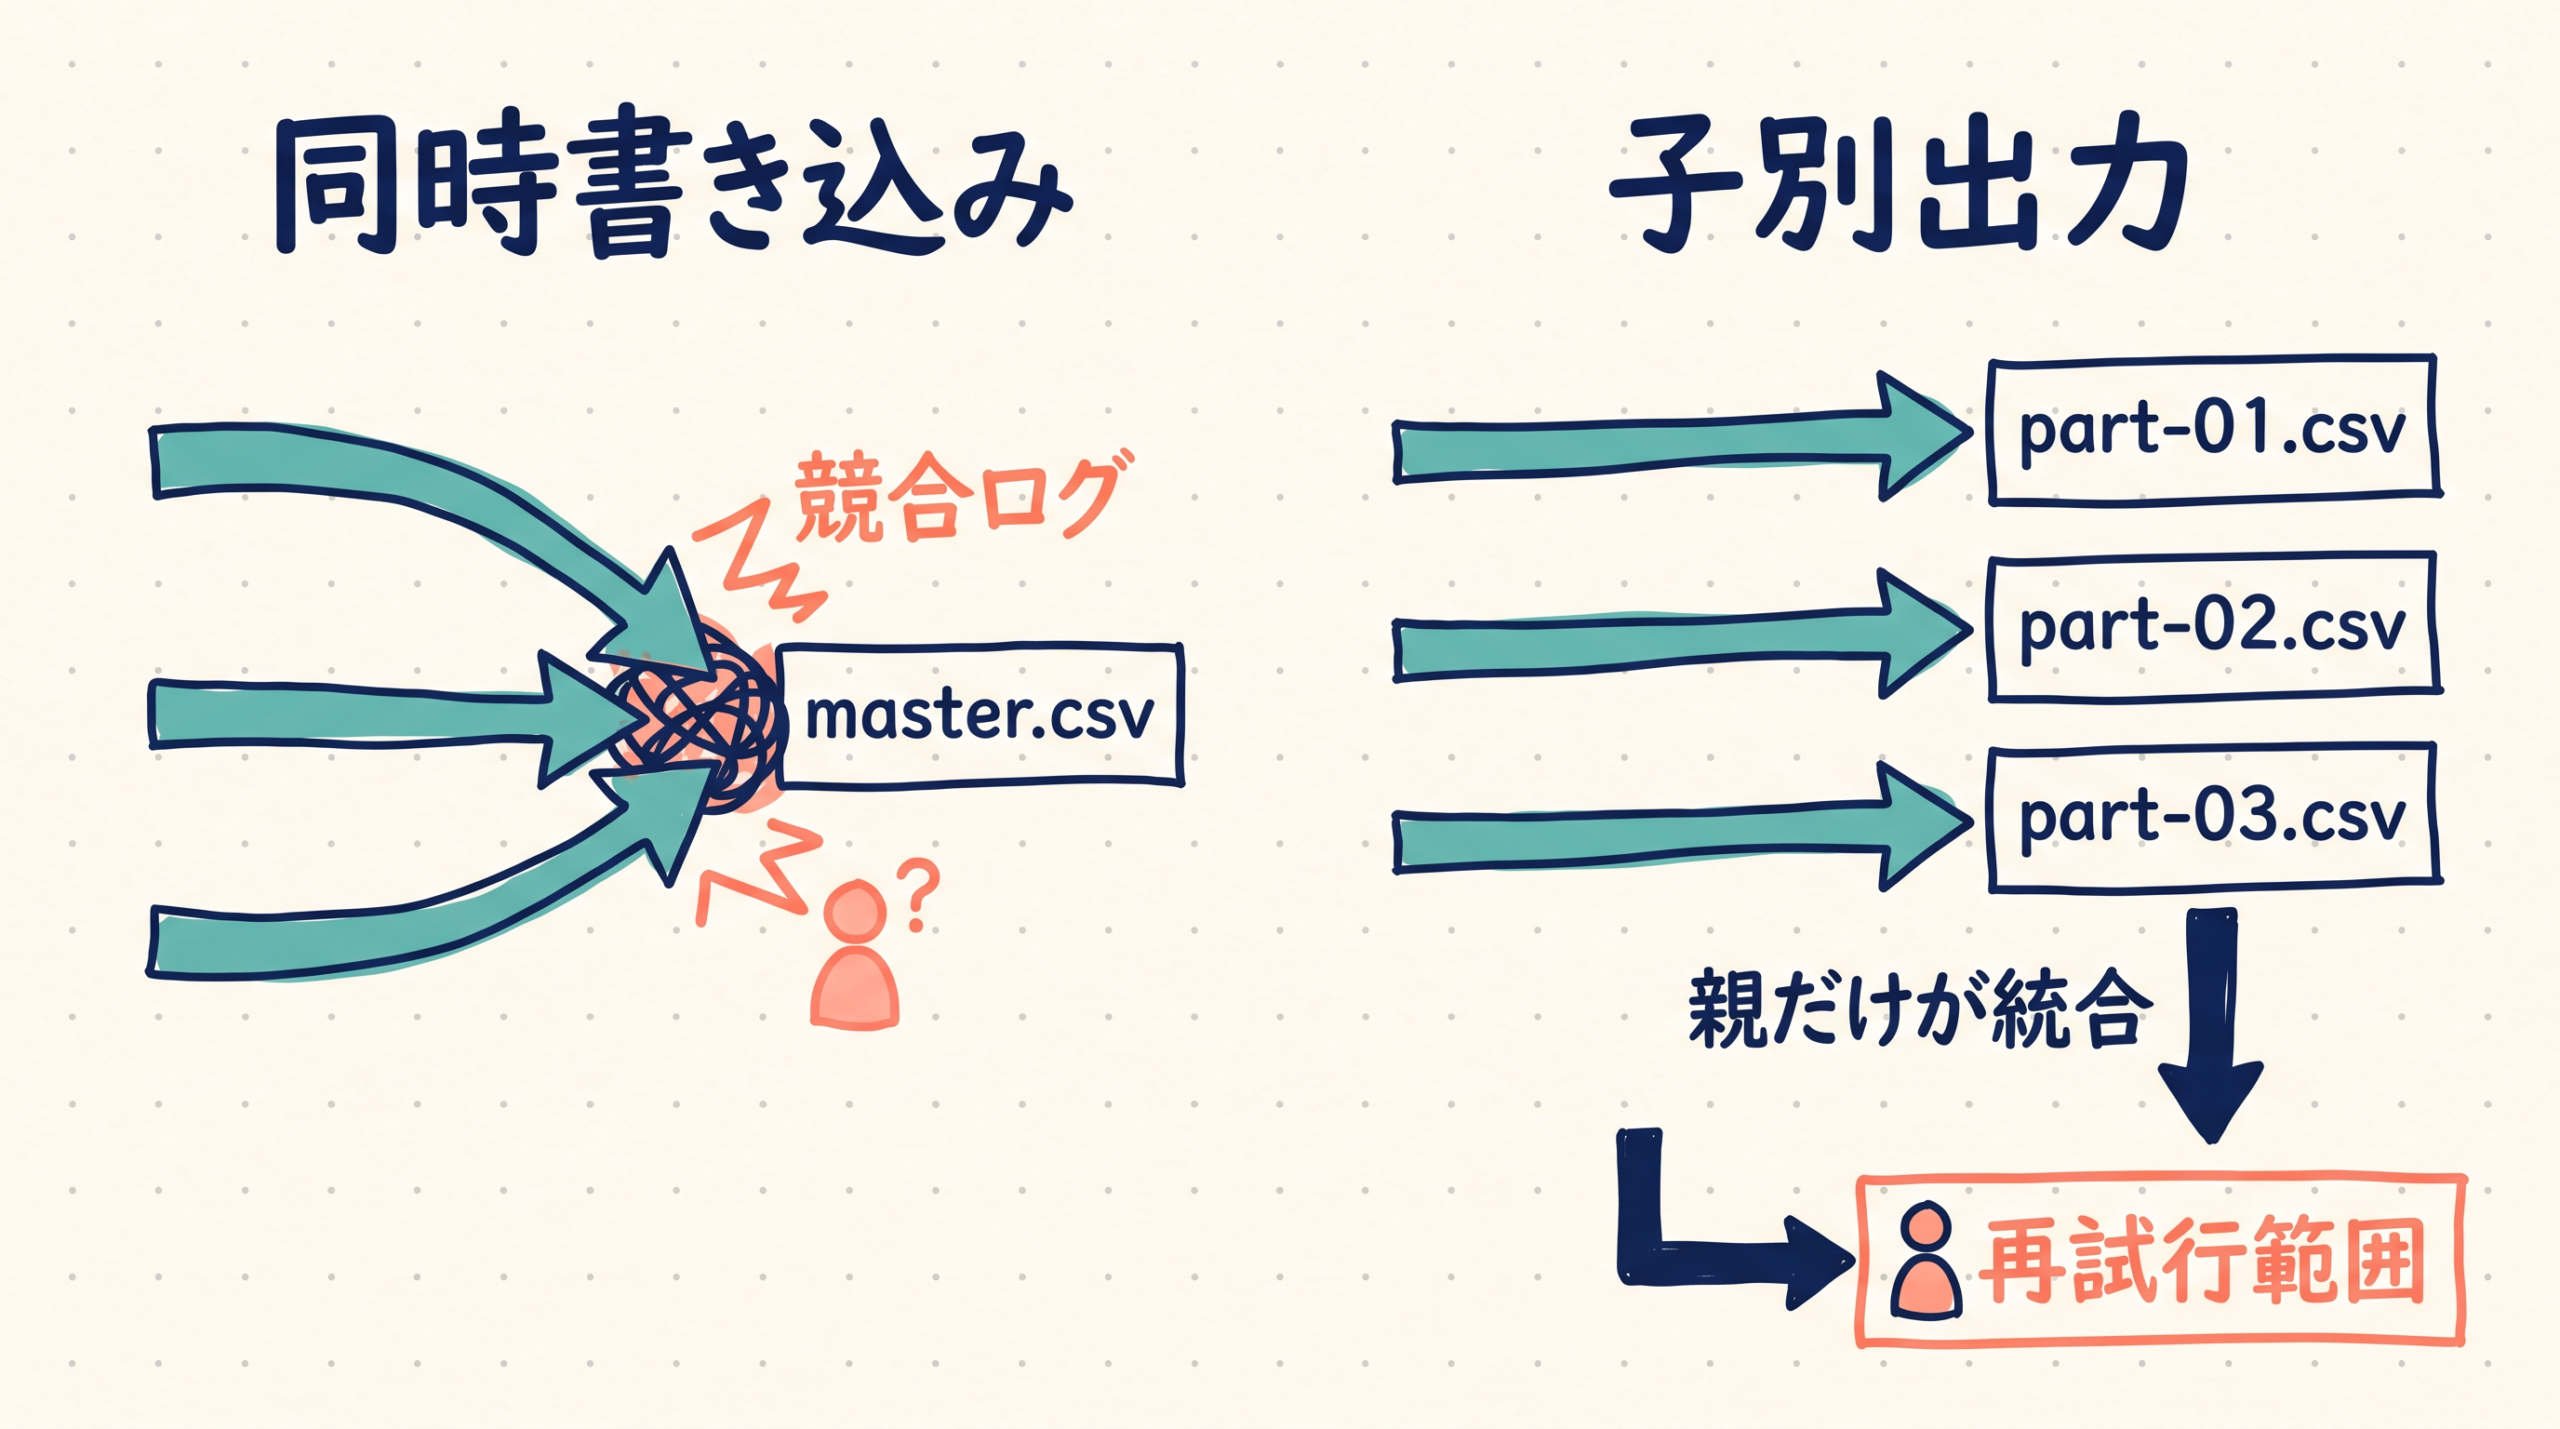
- 同じ外部システムへ同時に書き込む仕事: 複数の子エージェントが同じ場所にデータを保存しようとして、書き込みの競合や上書きが発生します。
- 小さな質問や簡単な仕事: 単純な依頼に対して複数のエージェントを立ち上げると、調整の手間だけが増えてしまいます。AutoGenの公式Teams資料でも、簡単な仕事はまず単一エージェントから始め、単一構成で能力が不足する場合にのみチームへ移行するよう勧めています。複数エージェントの構成は、追加の足場組み(scaffolding)を必要とするためです。
エージェントシステムのスケーリングについて調査した独立研究でも、分解可能なタスクにおいては中央集約型の構成が有効である一方、直列での推論が必要なタスクではマルチエージェント化することでかえって性能が悪化し得ることが実験的に示されています。また、別のマルチエージェントの協調に関する研究も、長期的で依存関係が疎な仕事に利点があり、密結合の直列ワークフローでは単一エージェントの方が優位になり得ると報告しています。
自社の仕事にスウォームを導入する際は、この研究結果を試験仮説として使います。「担当間の依存関係を薄く保てるか」「親エージェントが成果物を統合できるか」を、単一エージェントとの比較で確かめます。
失敗は重複・競合・要約損失・費用超過から起きる
前項で見たように、依存関係が薄く統合可能な仕事がスウォームに向く条件だとすれば、その裏側には「どのような条件でシステムが破綻するか」という明確な停止条件が存在します。なぜエージェントを増やしても失敗するのか、その理由は主に仕事の分割、共有状態、結果の統合、そして権限制御の設計ミスにあります。
Google DeepMindのマルチエージェント安全研究でも、ネットワークがどう不安定化するか、予期しない集団特性をどう検出するかが研究課題として挙げられており、多数のエージェントが動くことをそのまま安全性や品質の証拠にすることはできません。
分割の失敗と無駄な作業 親エージェントが仕事を適切に分けられないと、並列化の利点は失われます。例えば、簡単な質問に対して無理に多数の子エージェントを起動すると、存在しない情報を一斉に探し続けたり、担当範囲が重複したりといった無駄が生じます(Anthropicの実装報告)。また、Moonshot AIの公式資料では、形だけ分けて実質的に直列処理になってしまう「serial collapse」や、意味のない小さな仕事を作る「fake parallelism」を失敗として扱っています。
共有状態の競合と権限の失敗 並列処理において最も危険なのは、複数の子エージェントが同じファイルやシステムへ同時にアクセスする「共有状態」の失敗です。例えば、複数の子が同じmaster.csvを編集すると、書き込みが衝突して古い値が残る可能性があります。各子にはpart-01.csvのような別々の出力先を与え、親だけがmaster.csvを更新する構成に変えます。
競合が起きた場合は、競合ログと修正後の設定ファイルを残します。担当者は、外部システムへの重複送信、古い値の残存、子へ渡した権限、失敗した子だけを再試行できたかを確認します。
OpenAI Agents SDKのGuardrails資料が示すように、並列化と権限制御は別問題です。入力の検査を並列で流してしまうと、不適切な処理がすでにトークンを消費し、ツールを実行してしまう危険があります。外部への書き込みや費用の大きい処理では、実行前に検査を完了させるblocking実行が必要です。そのため、情報の公開、顧客データへの書き込み、送信や購入といった重大な権限は決して子エージェントには渡さず、読み取り専用に制限しなければなりません。
要約損失という統合の失敗 子エージェントが担当分を終えて親へ報告する際、長い会話履歴をそのまま渡すと親の処理能力が破綻します。そのため要点だけを返す仕組みがとられますが、このときに重要な条件や例外規定が抜け落ちる「要約損失」が起こります。これを防ぐには、Anthropicの実装報告にあるように、最終統合の際に一次資料へ戻れるURLと引用位置を必ず一緒に返させる設計が不可欠です。
費用超過と計算資源の浪費 最後に、エージェントを増やすことはそのまま費用の増加に直結します。Moonshot AIの公式資料にも、スウォーム機能は標準エージェントより多くのクレジットを消費するという留保があります。AIへ送る入力サイズ、API認証、ツール課金、検索課金の制限を開始前に決めておかないと、重複した検索や失敗したタスクの無限ループによって、想定以上の費用超過を引き起こす結果となります。
導入前は単一エージェントと同じ条件で比べる
エージェントスウォームの仕組みと限界を理解した上で、自社の仕事に単一エージェント、固定ワークフロー、少数の専門エージェント、動的スウォームのどれを採用するかを決めるには、客観的な比較テストが必要です。エージェントの人数が多いこと自体を品質の高さや成功の証拠とは見なせません。本格的な導入や大規模な展開の前に、単一エージェントと全く同じ条件で少数の並列構成を比べ、スウォームを採用する合理的な理由があるかを検証します。
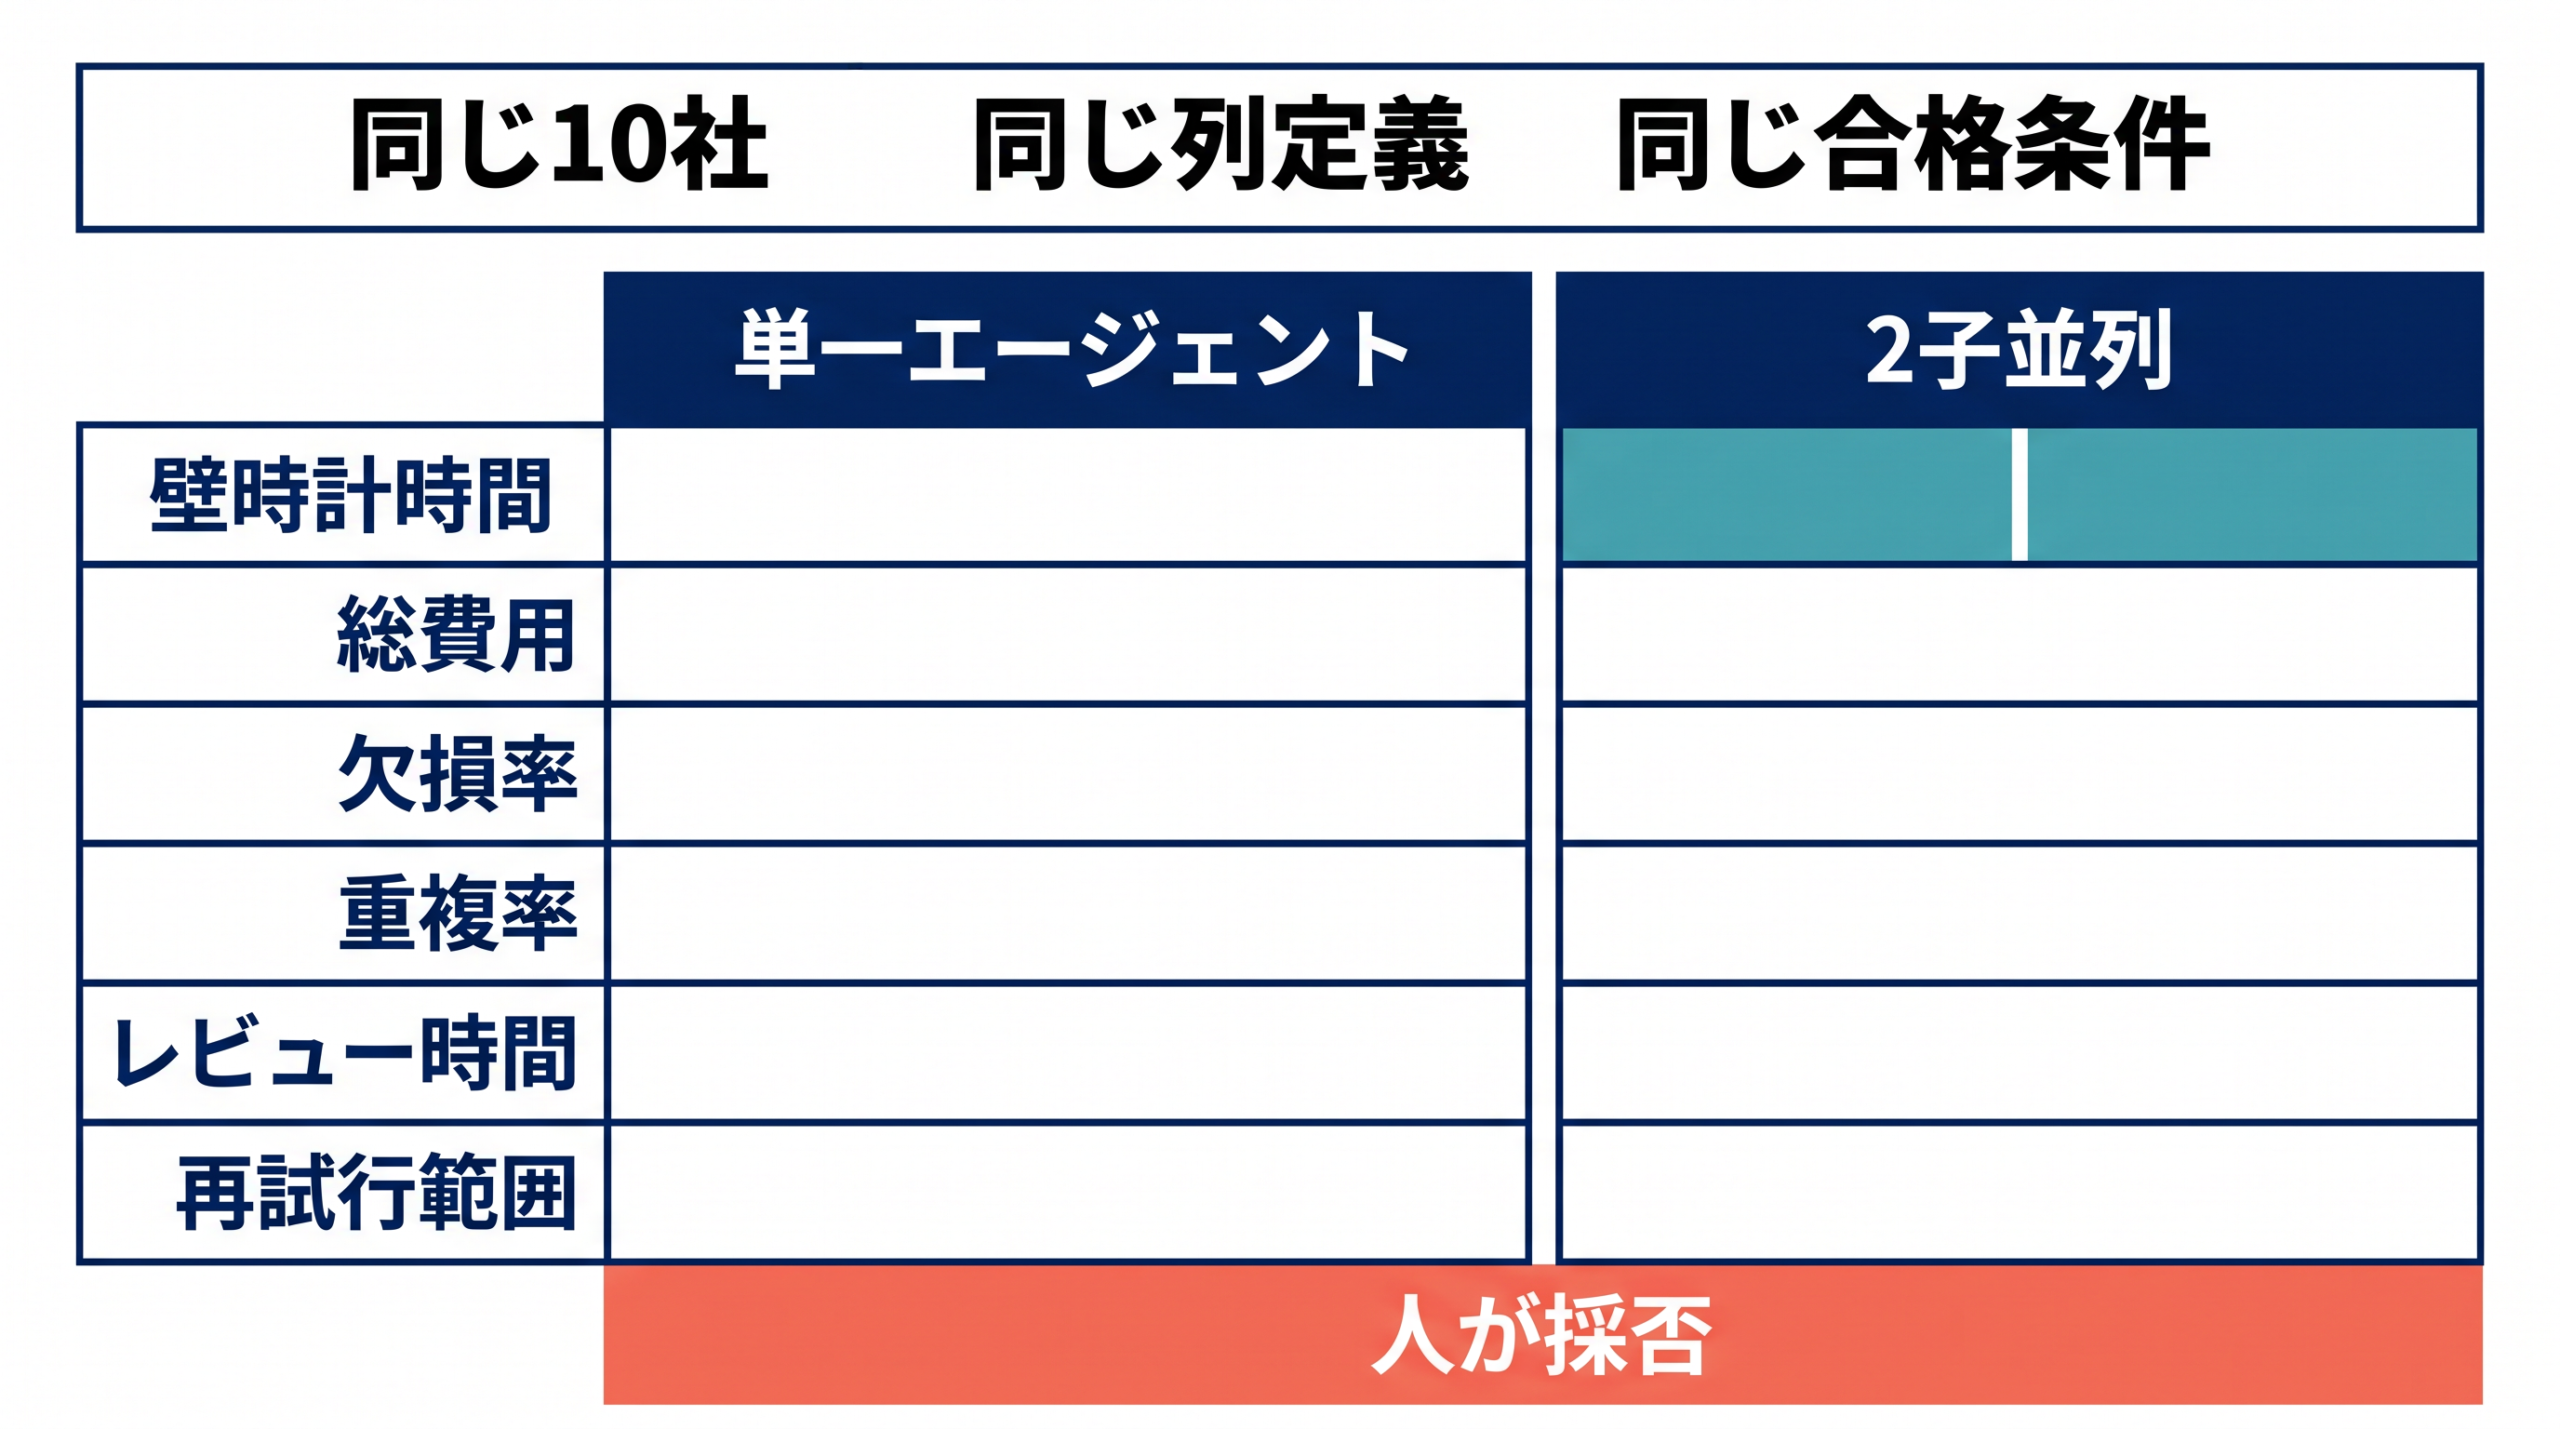
比較テストには、これまで例に挙げてきた調査業務を縮小した10社分のcompanies.csvを使います。単一エージェントと2つの子エージェントによる並列構成へ、同じ企業リスト、同じ列定義、同じ一次資料優先の合格条件を渡し、それぞれ1回ずつ実行します。並列構成では各子の出力先を分け、最終的な書き込みを親エージェントへ集約します。
比較表には、完了までの時間、APIと検索の費用、欠損、重複作業、レビュー時間を記録します。すべての子の稼働時間を足した値と、利用者が結果を待った壁時計時間は分けてください。担当者は比較表と成果物を見て、品質を保ったまま時間を短縮できたか、子エージェントを増やす根拠があるかを判断します。
このテストにおける合格条件は、単に処理時間が速いことではありません。一次資料との一致率や必須項目の充足率が単一エージェント実行時と同等以上に維持されていることが大前提です。また、エージェントを増やしたことで発生するトークン消費や検索の費用、さらには統合結果の矛盾を修正する人のレビュー時間を含めた「総費用」が、業務の許容範囲に収まっているかを確認します。
もしエラーが起きた場合に、全体の処理が止まるのではなく、失敗した企業群だけを再実行できる構造になっているかも重要な判断材料です。比較テストの結果、もし品質の低下やレビュー負荷の増大が速度の向上を上回るようであれば、無理に並列化せず単一エージェントの構成を選ぶべきです。自社の業務が持つ性質とテストの数値を照らし合わせることで、初めて最適なAIの構成を決定できます。
よくある質問
Q1. 自社の業務にスウォームを導入するには何から始めればよいですか?
いきなり多数の子エージェントを稼働させるのではなく、少数のデータを用いた比較テストから始めます。同じ入力データと合格条件を用意し、単一エージェントと2つの子エージェントを持つ並列構成を同じ土俵で比較します。AutoGenの公式Teams資料でも、簡単な仕事は単一エージェントから始め、単一構成が不足する場合にチームへ移るよう勧めています。総費用や人のレビュー時間が許容範囲に収まるかを確認し、独立した仕事が残る場合だけ子エージェントの増員を判断します。
Q2. 子エージェントの人数を増やせば増やすほど品質は上がりますか?
いいえ、エージェント数の多さは品質の高さや成功の証拠にはなりません。エージェント数や再帰深度を増やしても成果が一貫して向上しないことが、Rethinking Multi-Agent Collaborationという独立研究でも報告されています。Moonshot AI公式ヘルプでも、形式だけ分けて実質的に直列になる「serial collapse」や、意味のない小仕事を作る「fake parallelism」を失敗として扱っています。人数よりも、タスクを独立して分割できるかが重要です。
Q3. 並列処理によって想定外の費用がかかることはありませんか?
はい、エージェントを増やすことはAPI呼び出しや検索ツールの利用回数増加に直結するため、費用超過のリスクがあります。Moonshot AI公式ヘルプにおいても、Agent Swarmは標準Agentより多くのクレジットを消費すると明記されています。実行前にAIへ送る入力制限や検索課金の上限を定め、失敗した子エージェントが無限ループに陥らないための停止条件を設計しておく必要があります。
Q4. エージェントスウォームを導入すれば必ず処理速度は速くなりますか?
処理速度の向上は、仕事の性質とシステムの実装条件に依存します。Moonshot AI公式ヘルプでは「BrowseComp」という対象課題に限って単一エージェント比約4.5倍の速度を掲げ、Anthropicの実装報告でも複雑な問い合わせに限定して最大90%の時間短縮を報告していますが、これらは当該システムと特定の評価条件に基づく値です。前工程を待つ必要がある直列タスクではかえって遅くなる場合があるため、利用者が実際に待つ壁時計時間で測定して判断します。
Q5. どのような業務がエージェントスウォームに最も向いていますか?
エージェント間の依存関係が薄く、最後に親エージェントが中央で成果物を統合できる業務です。例えば100社調査のような業務において、入力ファイルから親が企業を分割し、各子が検索して部分成果物を作成、最後に親が重複を除いて一つのファイルに統合し、人が結果を最終確認する、という一連の流れを無理なく構築できる調査が適しています。独立研究でも、分解可能なタスクにおいて中央集約型の構成が有効であることが示されています。
Q6. 子エージェントにはどこまで権限を渡してよいのでしょうか?
公開、外部システムへの送信、製品の購入、顧客データへの書き込みといった重大な権限は子エージェントには渡さず、読み取り専用に制限します。複数の子が同じ共有ファイルへ同時に書き込むとエラーが起きるため、各子には独立した出力先を与えます。OpenAI Agents SDKのGuardrails資料が示すように、外部書き込みや費用の大きい処理では、実行前に検査を完了させるblocking実行が必要です。最終的な書き込み権限は親エージェントに集約し、人が内容を確認する工程を必ず設けます。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント