製薬業界の研究開発における調査業務は多岐にわたり、単一の人工知能で全ての情報を網羅することはできません。なぜなら、製薬競合情報は臨床試験、複数法域の特許、論文、規制資料、決算、学会情報を統合する必要があるからです。複数法域とは、国や地域ごとに異なる法律や権利が及ぶ範囲を指します。これら多様な原典を適切に処理するためには、調査を文献、臨床・パイプライン、化学・特許、そして企業・市場という四つの仕事に分けて考えることが重要です。
この四つの仕事に対して、6つの人工知能製品を無条件の総合順位で並べるのではなく、必要な情報源と得たい成果物に応じて割り当てます。自社の主な調査仕事に最も合うものを主軸製品として据え、特定の作業に特化した機能を補うために補助製品を組み合わせるという選び方が、効率的かつ正確な情報収集の鍵となります。
具体的な運用例として、公開情報だけで免疫疾患の新しい治療標的Xについて調べる課題を考えます。文献調査の仕事では、利用者が標的Xに関する公開済みの学術的な質問を入力し、人工知能に検索とリスト化の操作を実行させ、その回答を出力させます。その後、出力された結果だけを鵜呑みにせず、利用者が必ず元の学術論文の原典へ戻って内容を確認し、研究の仮説構築に役立てます。臨床や特許、企業調査の仕事でも同様に、それぞれの専門情報源を持つ製品へ公開情報を入力して整理させ、最後は人が直接確認する手順を踏みます。
このような人工知能の利用においては、厳格な入力境界を設ける必要があります。自社で研究している未公開の化合物構造、個人を特定できる患者情報、治験の未公開資料、進行中の提携交渉の詳細、あるいは未出願の発明といった機密情報を、外部の人工知能へ絶対に入力してはいけません。入力は常に公開情報に限定する必要があります。
また、出力結果の扱いにも厳格な制限が求められます。人工知能が提示した疾患との関連性、化合物の有望性、特許の新規性、あるいは未確認の料金情報などは、あくまで情報整理の補助です。これをそのまま疾患の診断根拠にしたり、規制当局への提出における最終判断に用いたりしてはいけません。さらに、特許侵害判断や自社の事業投資に関する最終的な決定に使うことも不適切です。限られた期間で文献をまとめる迅速な文献レビューである115研究のrapid reviewは生成人工知能が一部のスクリーニングと抽出を支援できる一方、校正済みhuman-in-the-loopを条件とすると指摘されています。human-in-the-loopとは、人が介在して確認と修正を行う仕組みのことです。人工知能の支援を受けつつも、最終判断の前には必ず人が原典を確認するという運用ルールを策定することが不可欠です。
製薬調査は四つの仕事に分ける
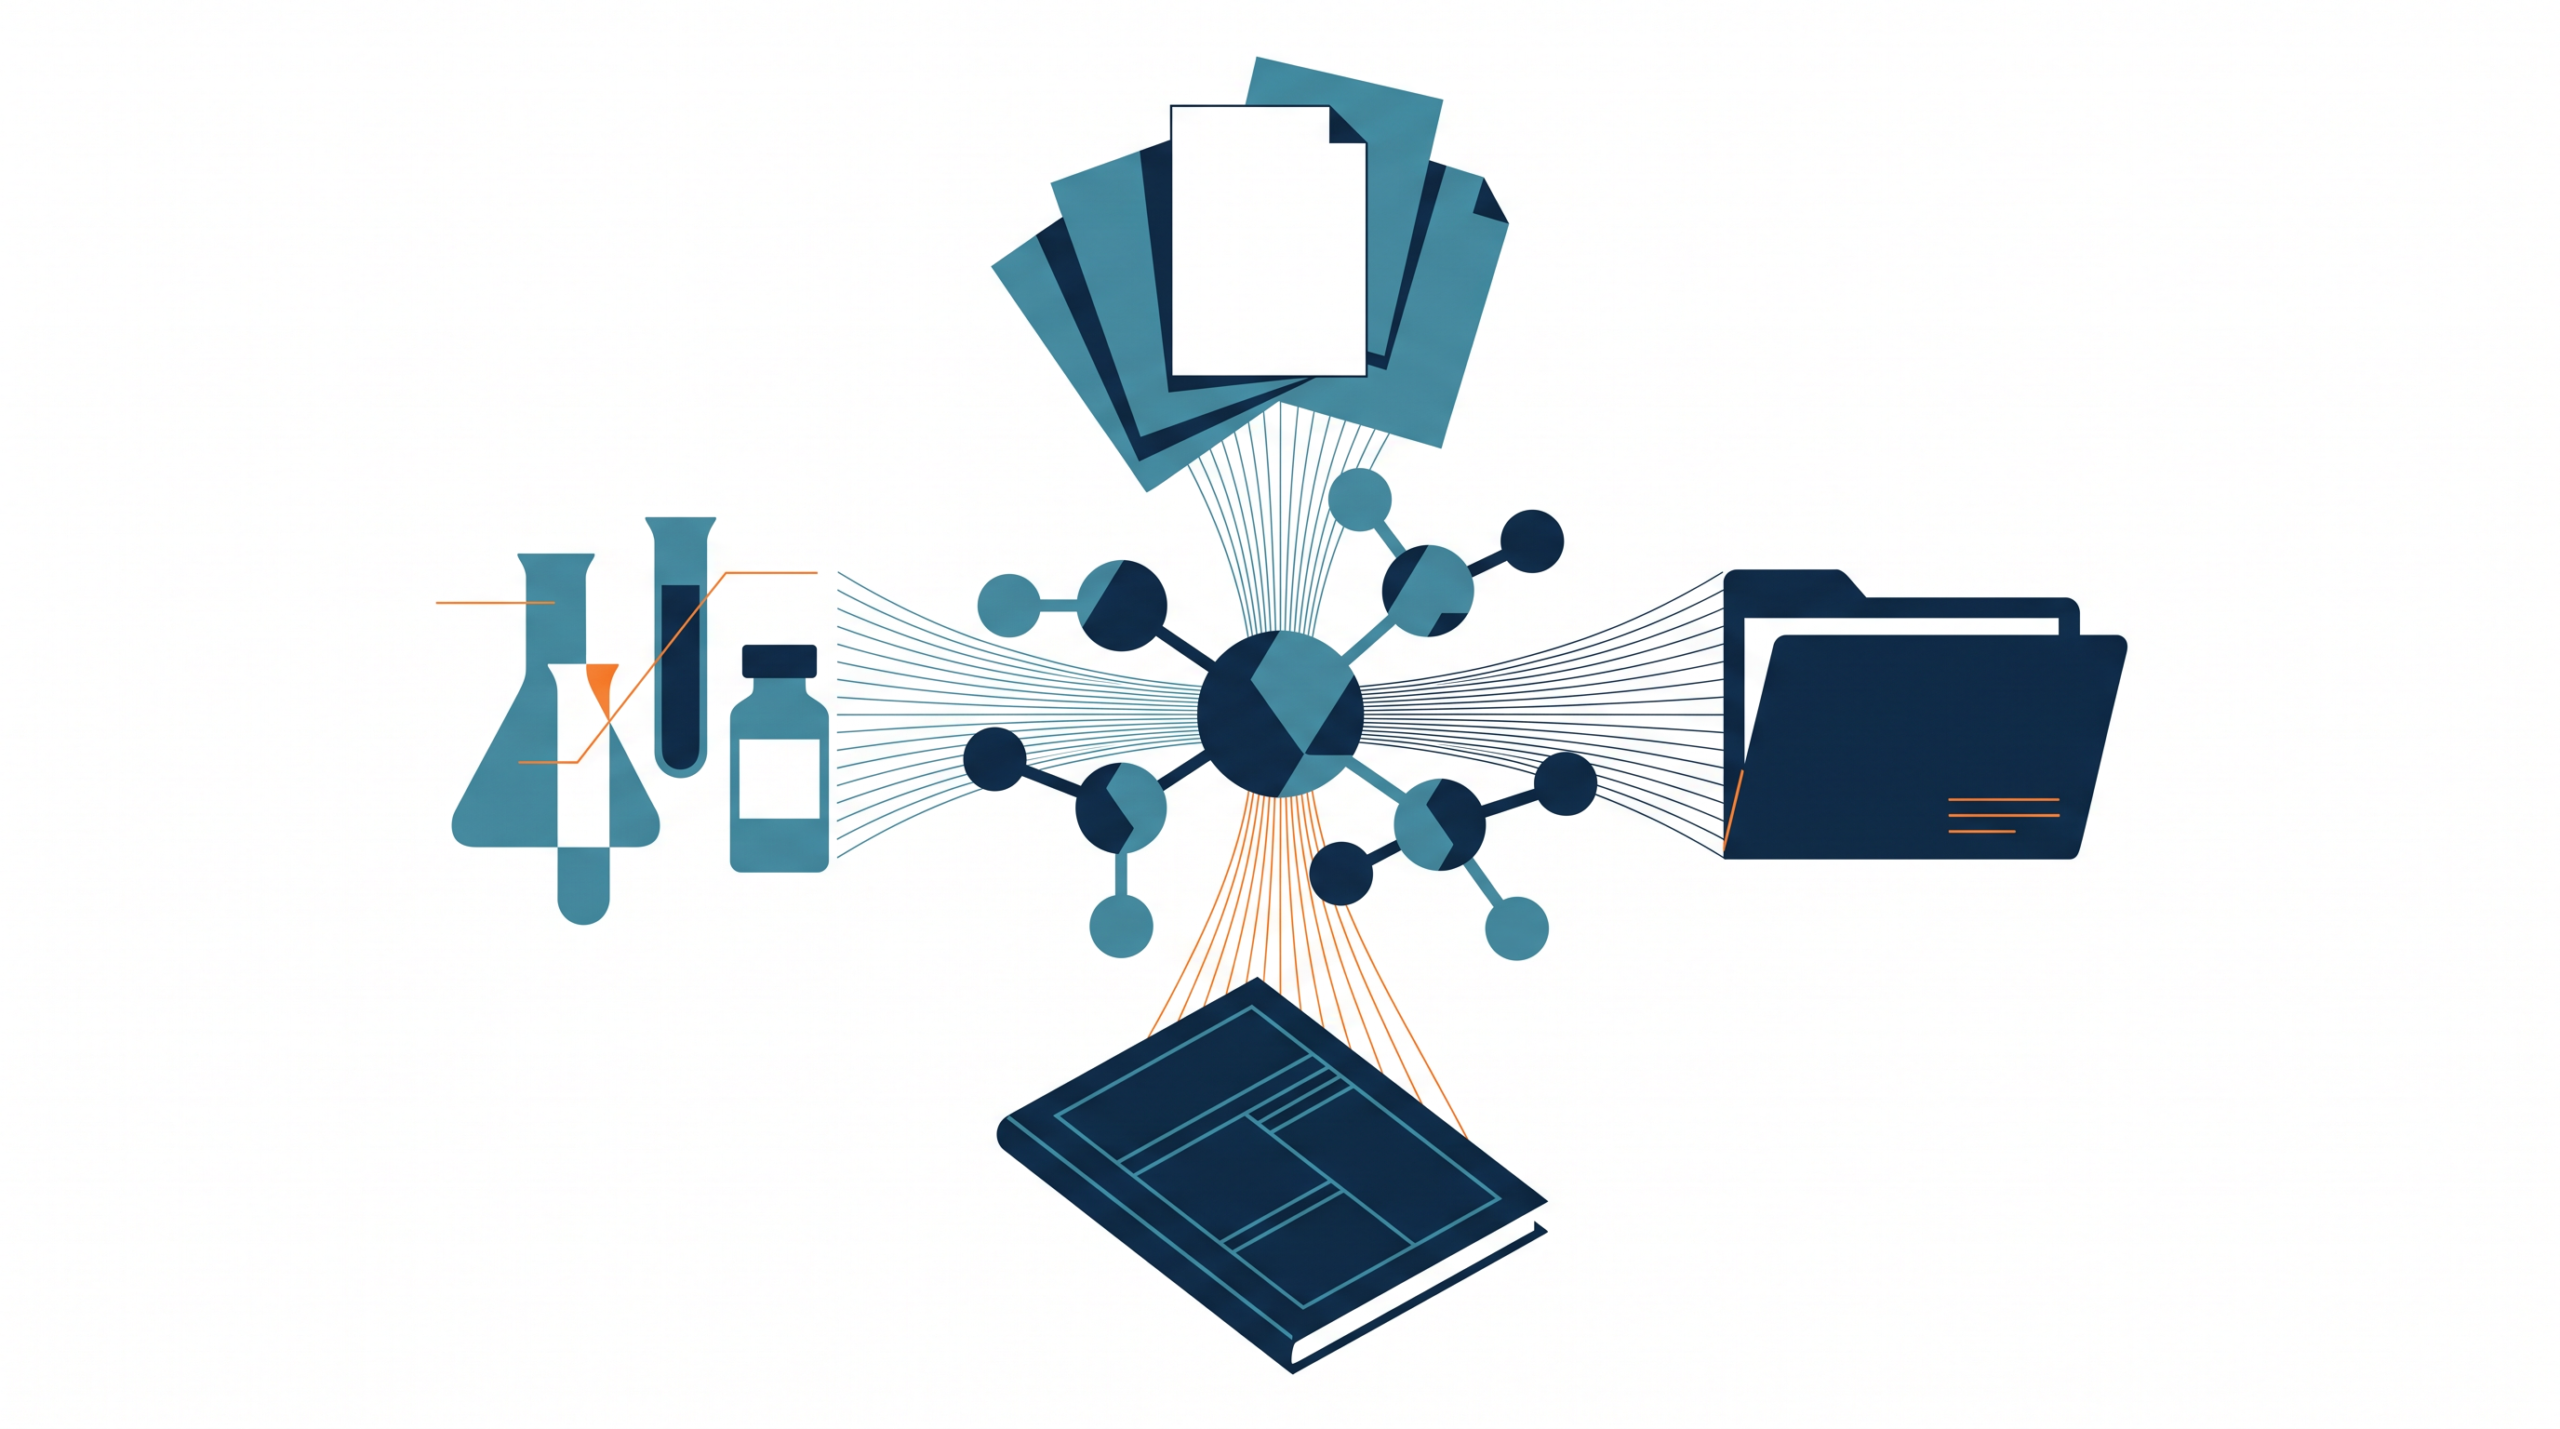
製薬業界の研究開発における調査業務は多岐にわたり、単一の人工知能で情報の収集から整理までを完結させることは困難です。その理由は、求める成果物によって参照すべき原典となる情報源が大きく異なるためです。
調査の土台となる情報源の全体像について、製薬競合情報は臨床試験、複数法域の特許、論文、規制資料、決算、学会情報を統合する必要があるとされています。複数法域とは、国や地域ごとに異なる法律や権利が及ぶ範囲のことを指します。これら多様な情報を適切に処理するためには、調査業務を原典と成果物に応じて以下の四つの仕事に分割して捉えることが有効です。
一つ目は、基礎研究や疾患メカニズムの理解を目的とする論文や学会情報などの文献調査です。二つ目は、開発品の進捗や競合状況を追うための臨床試験情報や規制資料を対象とした臨床・パイプライン調査です。三つ目は、化合物の構造や製造方法、そして国ごとに異なる権利状況を確認する化学・特許調査です。四つ目は、競合企業の戦略や提携動向を把握するための決算説明会資料やプレスリリースを対象とした企業・市場調査です。
公開情報だけを用いて、免疫疾患の新しい治療標的Xについて調べる課題を例に挙げます。このとき、標的Xについてすべて教えてほしいと一つの入力で済ませるのではなく、四つの仕事に合わせて調査の入力表を分けます。
文献調査の段階では、標的Xの作用機序に関する公開済みの学術論文を探す操作を行い、最新の知見をまとめた表を出力させます。人がその結果を読み、仮説構築の参考にします。続く臨床調査では、標的Xを狙う化合物の臨床試験情報を入力とし、開発フェーズや試験デザインの一覧を出力させます。化学・特許調査では、すでに公開されている関連化合物の構造データや特許明細書を入力し、既存の権利に関する情報を整理させます。企業・市場調査では、競合他社の決算発言や提携発表を入力し、標的Xに関する経営陣の見解を抽出させます。
これらの操作を行う際、未公開の化合物構造、患者情報、治験の未公開資料、進行中の提携交渉、未出願の発明といった機密情報は、外部の人工知能への入力情報に含めてはいけません。また、人工知能が出力した疾患の関連性や特許の新規性に関する見解は、あくまで公開情報に基づく補助的な整理です。これをそのまま診断、規制当局への対応、特許侵害、あるいは事業投資に関する最終判断にしてはなりません。どのような結果が出力されたとしても、最終的な判断を下す前には人が必ず元の公開情報へ戻って内容を確認する必要があります。
このように、製薬調査に必要な情報源と求める成果物を四つの仕事に定義することで、比較の基準が明確になります。調査の目的と原典を整理した上で、それぞれの仕事にどの製品をどのように割り当てるかを見ていきます。
6製品を情報源と成果物で比較する
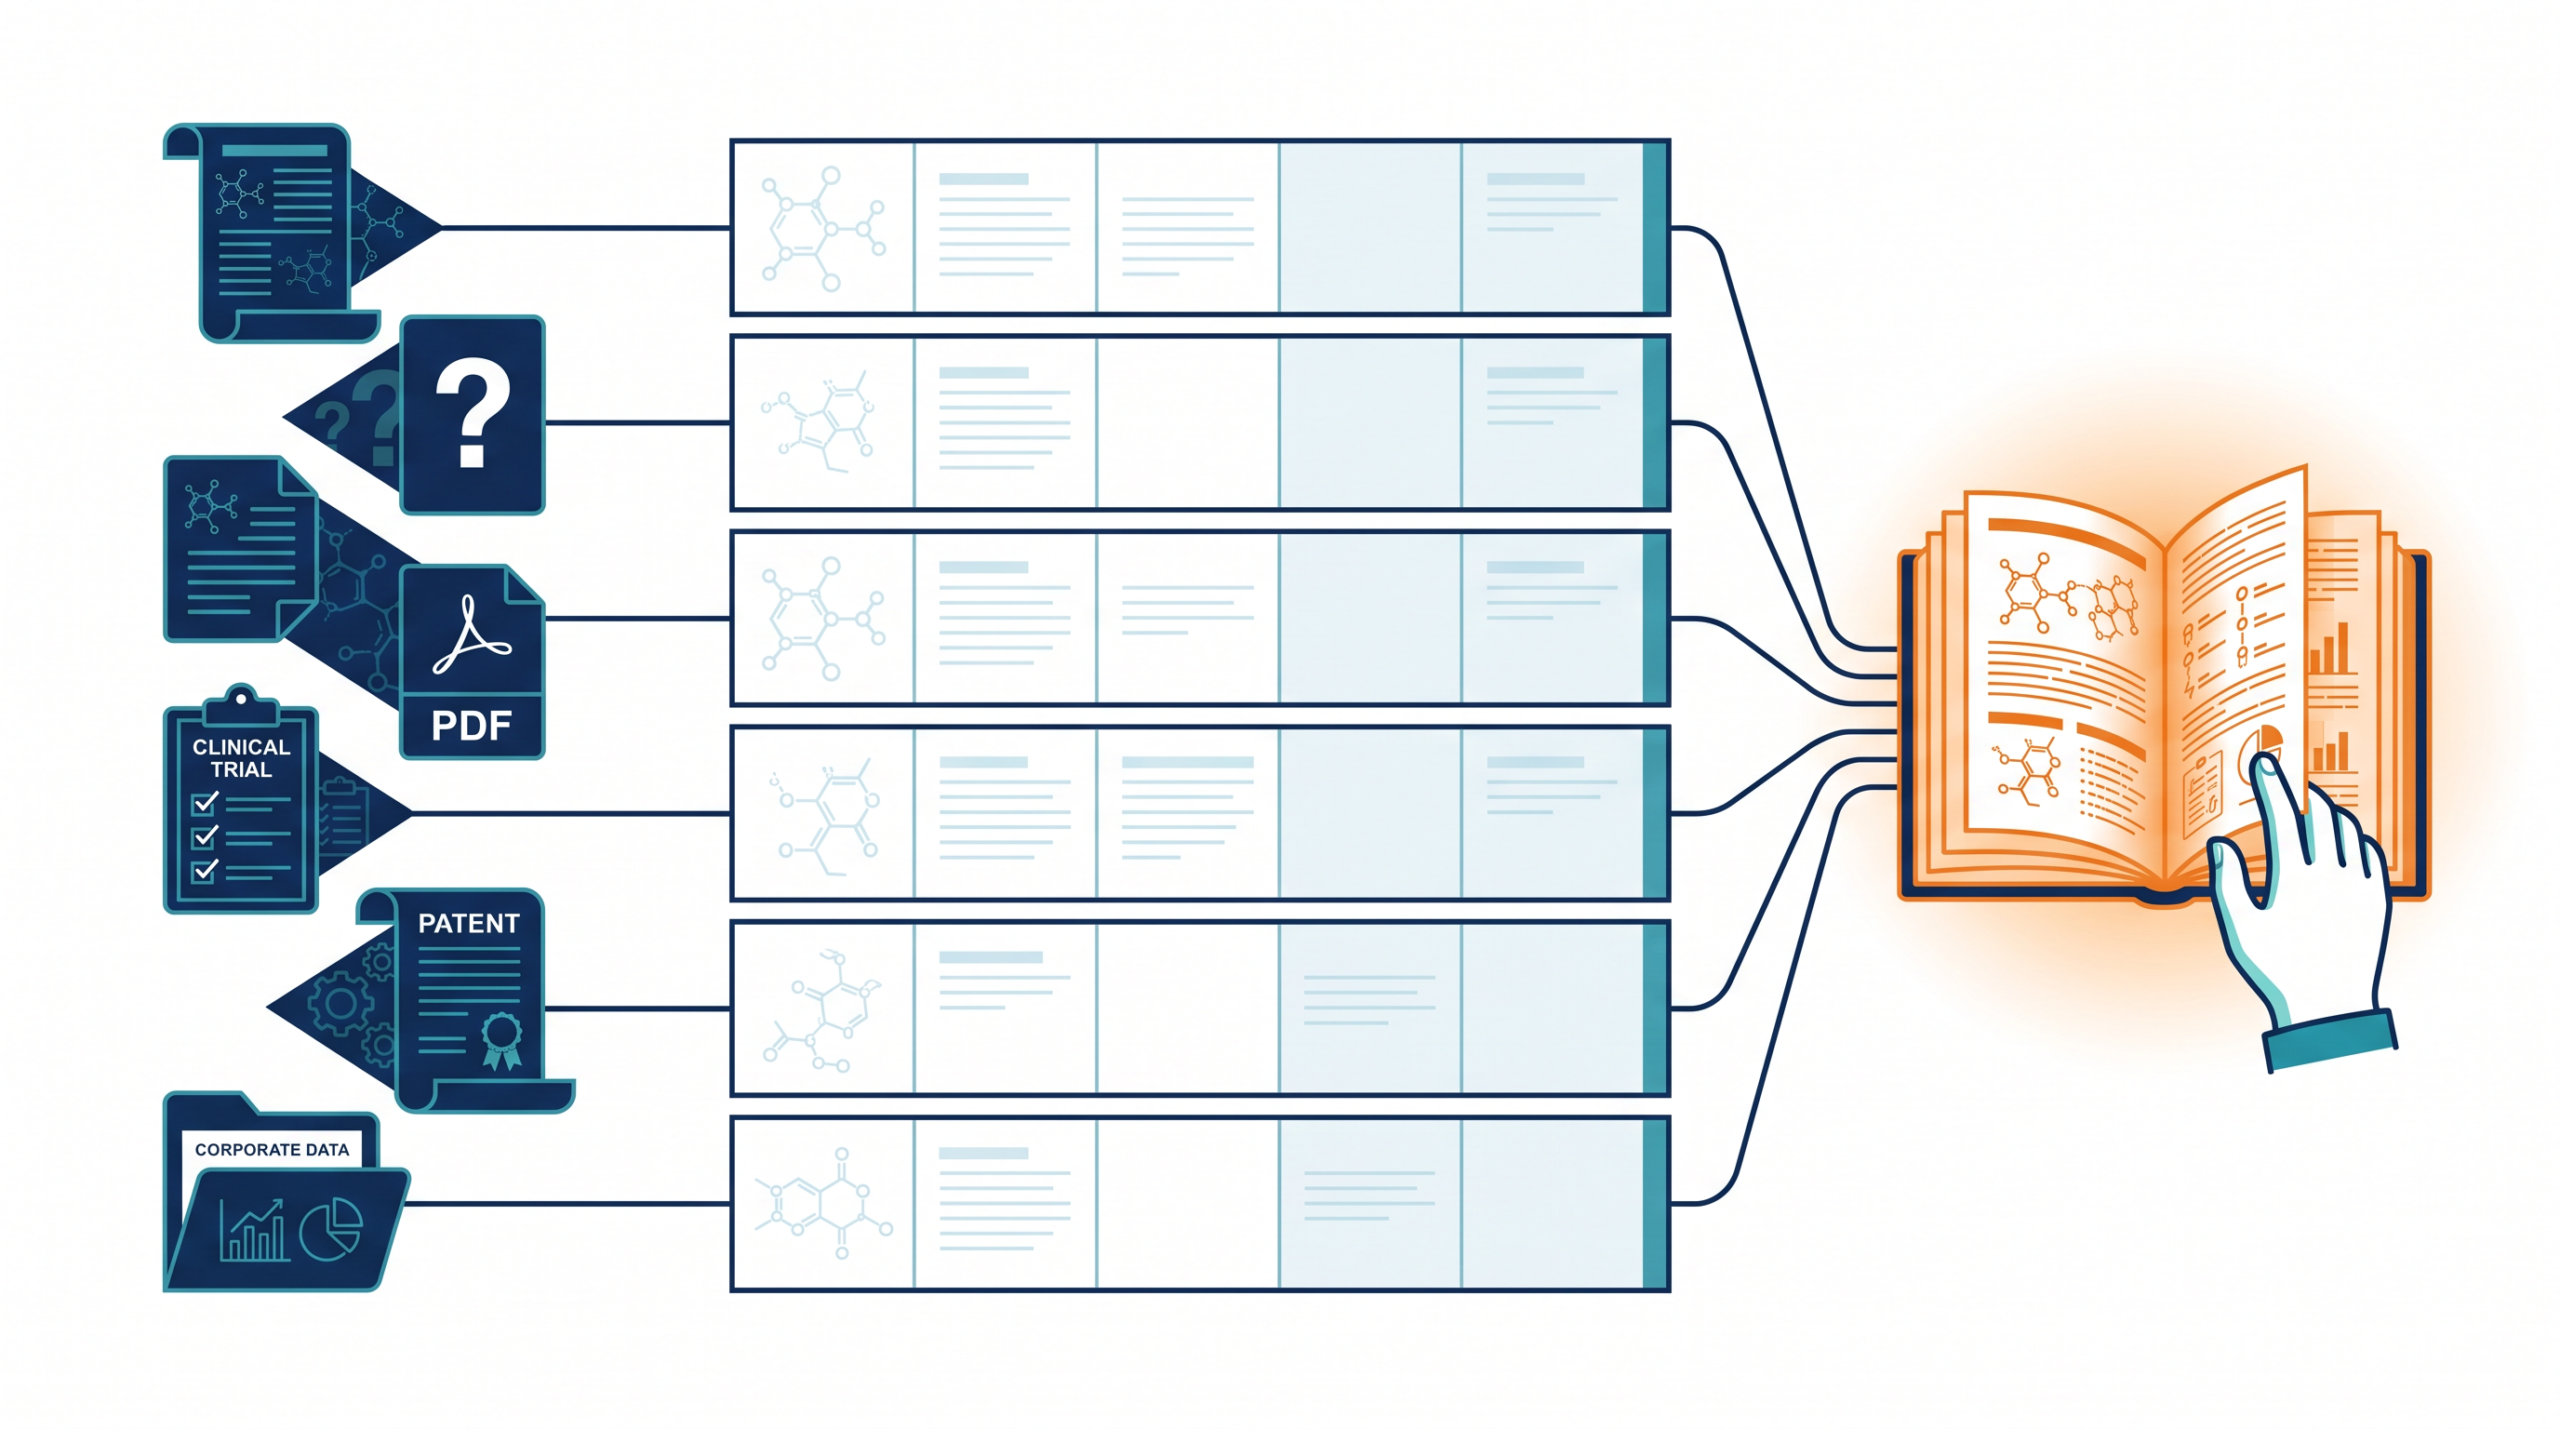
前節で定義した四つの調査業務に対して、6つの人工知能製品をどのように割り当てるかを整理します。これらの製品は単一の総合的な優劣で評価するのではなく、必要な情報源と得たい成果物に合わせて使い分けることが重要です。
各製品が扱う情報源、利用者が行う入力、人工知能の操作、出力される成果物、最終的に人が確認すべき原典、そして主な利用権限を以下の表にまとめます。
| 製品名 | 情報源 | 入力 | AI操作 | 出力 | 原典 | 権限 |
|---|---|---|---|---|---|---|
| Elicit | 学術論文 | 公開済みの検索語 | 文献のスクリーニング | 文献の評価と抽出結果 | 元の論文本文 | 研究、メディカル |
| Consensus | 学術論文 | 学術的な質問 | 検索の実行とリスト化 | 論文に基づく回答とリスト | 元の学術論文 | 研究、メディカル |
| SciSpace | 学術論文のPDF | 公開済みの論文ファイル | 指定列へのデータ抽出 | 表や統計などの抽出データ | 元の論文本文 | 研究、メディカル |
| Patsnap Synapse | 臨床試験、特許、取引 | 標的や薬剤名 | 情報の紐付けと横断検索 | 開発進捗や取引の繋がり | 各公開データベース | R&D企画、事業開発 |
| CAS SciFinder | 化学物質情報、特許 | 科学的な質問、関連構造 | 科学文献の検索と要約 | 情報の要約文 | 科学文献、特許明細書 | 研究、知財 |
| AlphaSense | 開示資料、決算説明録 | 企業名、公開済みの検索語 | 開示情報やニュースの検索 | 経営陣の発言や比較結果 | 決算資料、プレスリリース | 事業開発、競合調査 |
公開情報だけで免疫疾患の新しい治療標的Xについて調べる課題を例に、具体的な割り当てを説明します。
文献調査において、学術論文から特定の基準を満たすものを網羅的に集めて評価する系統的レビューを行う場合、Elicitの検索、スクリーニング、抽出のワークフローを利用します。標的Xに関する特定の疑問を投げかけ、高度な検索から絞り込み、リスト化、出力を組み合わせる際はConsensusを割り当てます。また、手元にある複数の公開済み研究PDFから表、統計、引用などを指定した列へ抽出する場合にはSciSpaceを利用し、論文を読む作業を補助させます。
臨床・パイプライン調査では、Patsnap Synapseを活用します。この製品は薬剤、標的、臨床試験、特許、企業、取引、文献を結び付ける基盤です。公開されている標的Xの情報を入力し、関連する薬剤の開発状況や試験情報を横断して出力させます。
化学・特許調査では、CAS SciFinderのSearchSenseとCAS Newtonを通じた科学情報の人工知能検索と要約を活用します。既存の関連化合物の構造や公開特許について質問し、権利状況の整理を出力させます。
企業・市場調査では、AlphaSenseを利用します。これはヘルスケア企業の開示、決算説明、ニュースなどを人工知能での検索や比較に使う製品です。競合他社の名前と標的Xを入力し、決算説明会での経営陣の言及や提携発表に関する情報を抽出して比較します。
これらの製品を活用する際、未公開の化合物構造、患者情報、治験の未公開資料、進行中の提携交渉、未出願の発明といった機密情報を、外部の人工知能へ入力してはいけません。また、人工知能が出力した疾患との関連性、化合物の有望性、特許の新規性などは、あくまで情報整理の補助です。これをそのまま診断の根拠、規制当局への最終判断、特許侵害の判断、あるいは事業投資の決定に用いることはできません。どのような出力結果を得たとしても、表に示した通り、必ず人が元の公開情報へ戻って内容を直接検証する必要があります。全体像と役割分担を把握した上で、次節からは文献調査における製品の細かな使い分けを見ていきます。
文献調査は目的別に三製品を使い分ける
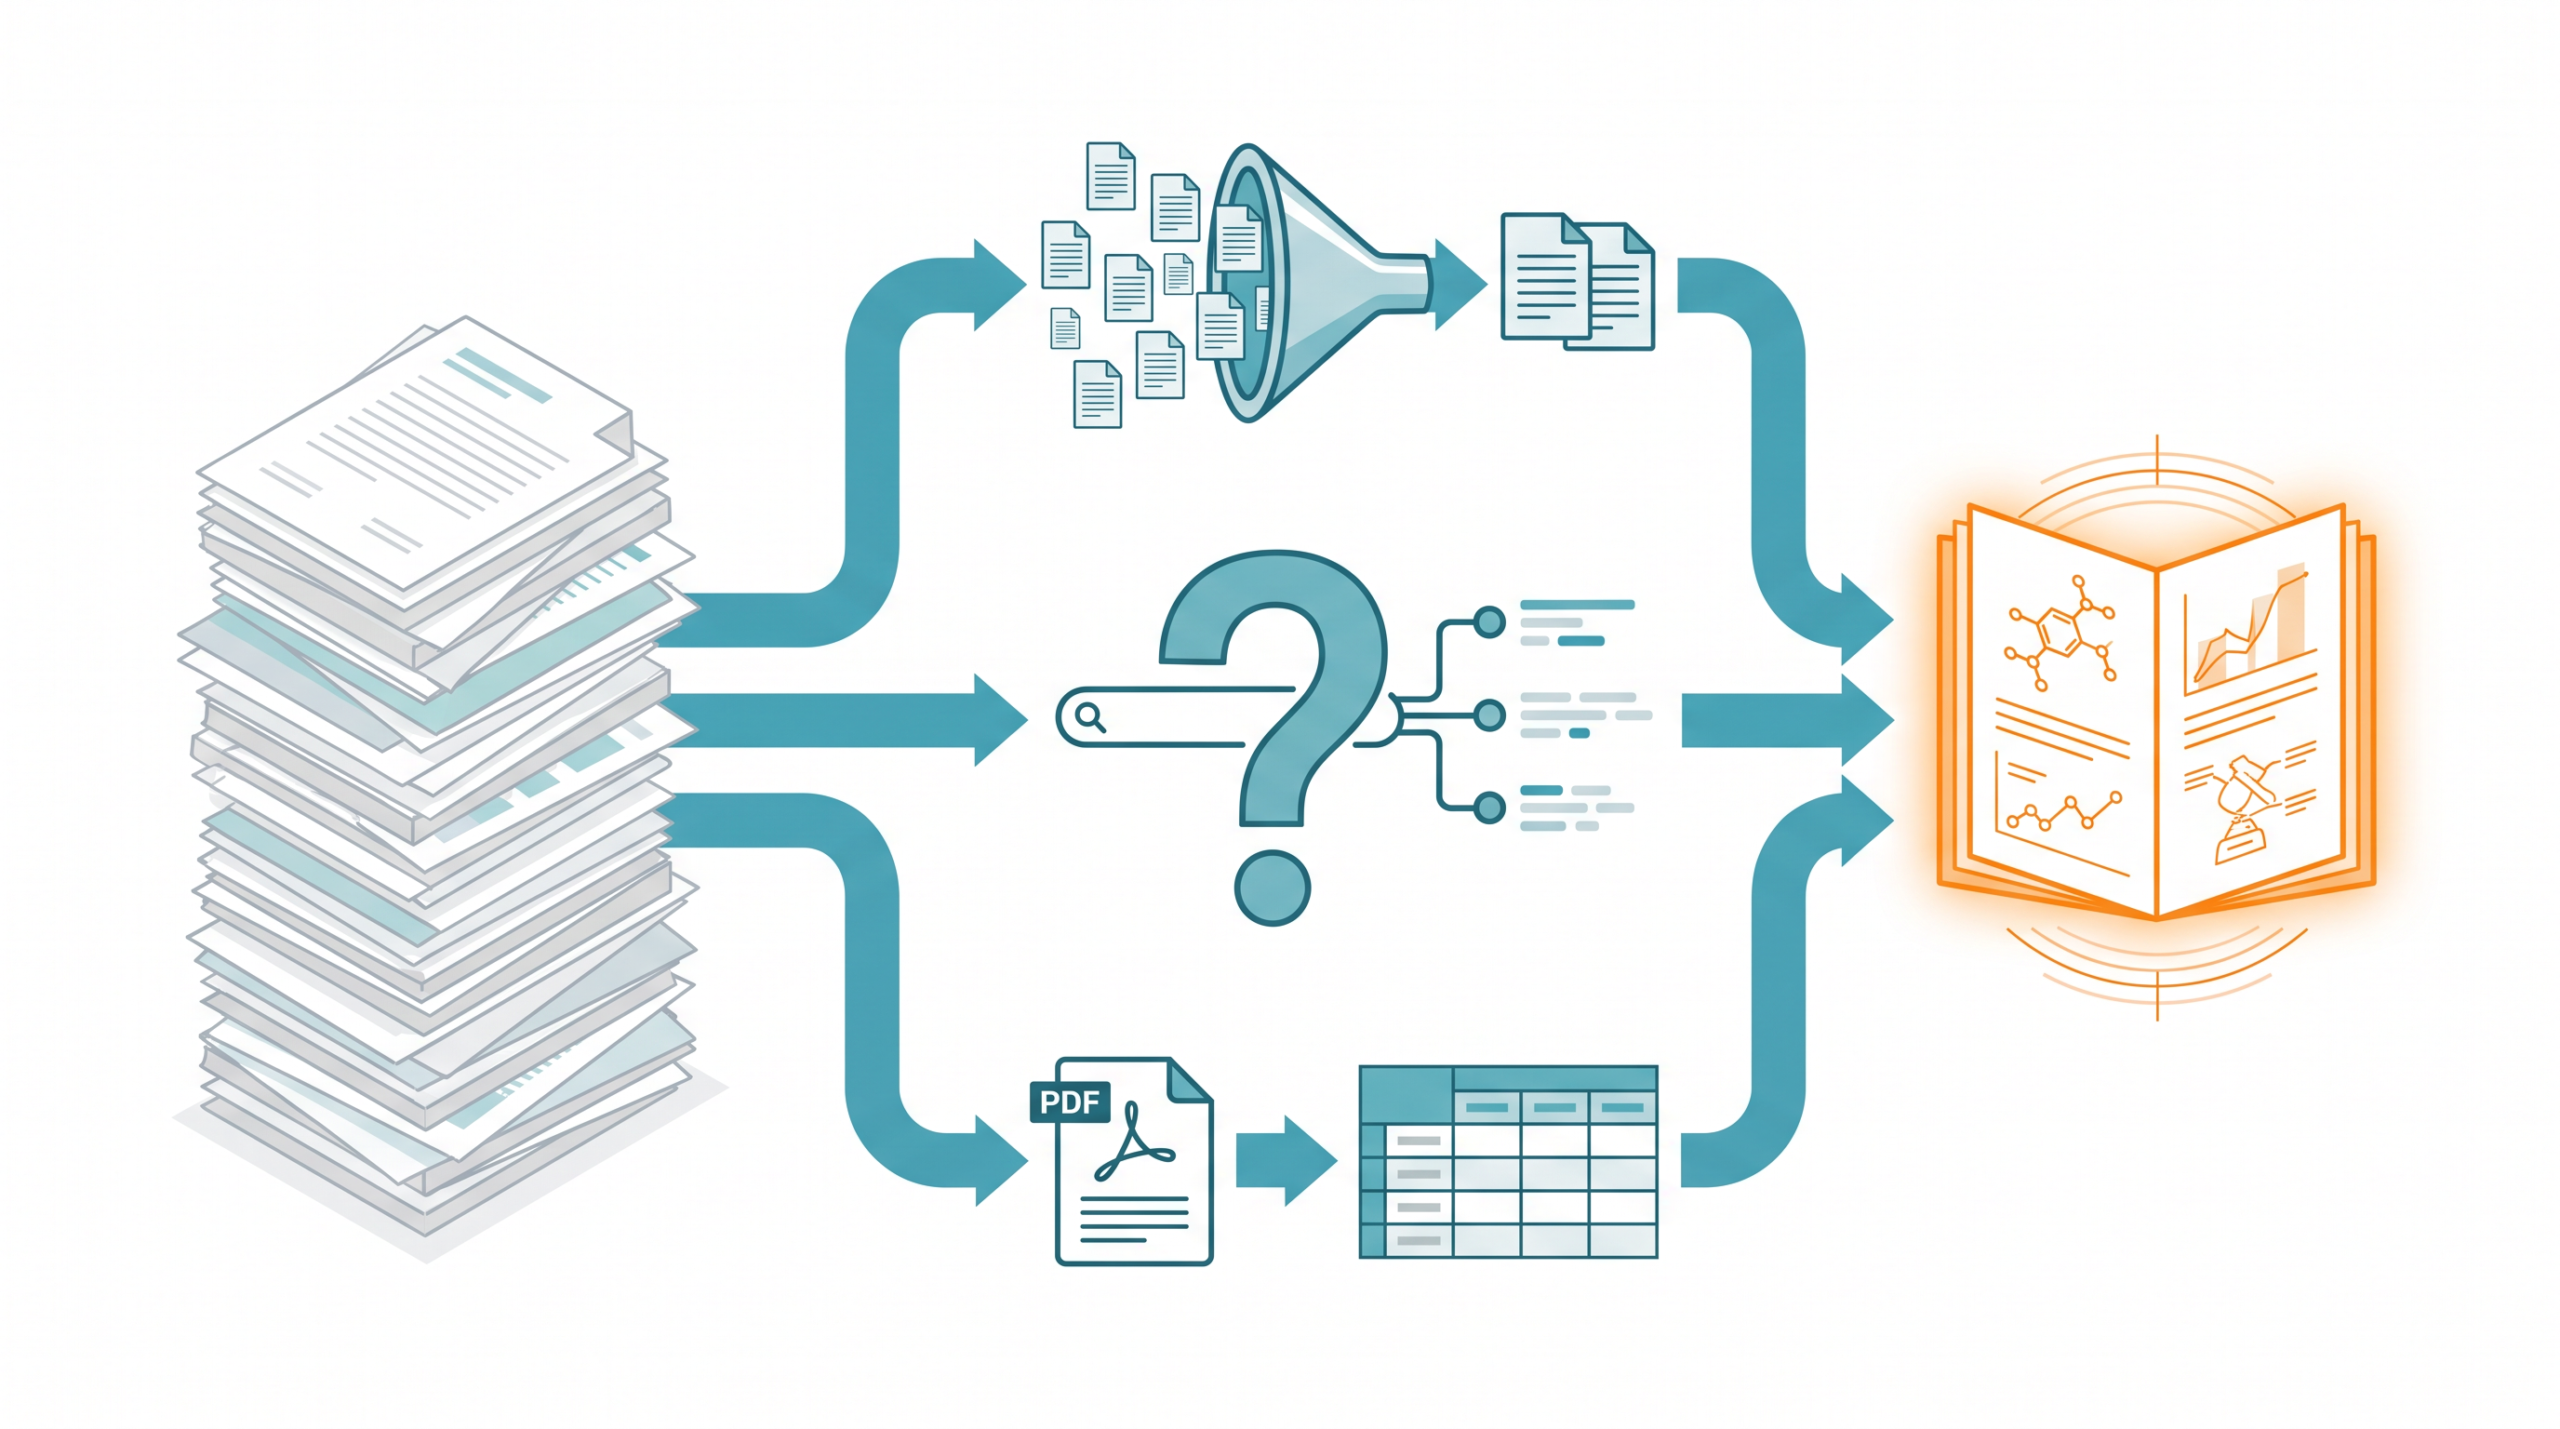
製薬業界の研究開発において、基礎研究や疾患メカニズムを理解するための文献調査は重要な第一歩です。しかし、文献探索、特定のテーマに関する文献を網羅的に収集して評価する系統的レビュー、そして手元の文献からのデータ抽出など、調査の目的によって適した操作は異なります。そのため、単一の製品に頼るのではなく、目的と得たい成果物に応じてElicit、Consensus、SciSpaceという三つの製品を分担させることが有効です。
公開情報だけを用いて、免疫疾患の新しい治療標的Xについて調べる課題を例に、具体的な使い分けを見ていきます。
まず、標的Xに関する過去の研究全体を見渡す系統的レビューを行う場合には、Elicitを主軸に割り当てます。公開済みの検索語を入力すると、Elicitは系統的レビューで検索、スクリーニング、抽出のワークフローを提供します。利用者はこの画面上で必要な文献を絞り込み、調査結果と抽出データを外部利用可能な形式で出力して全体像の把握に役立てます。
次に、標的Xに関する特定の疑問、例えば従来の見解とは異なる反対結果が存在するかどうかを調べる場合には、Consensusを利用します。利用者が学術的な質問を入力すると、ConsensusはProまたはDeep検索、フィルター、Lists、Exportを組み合わせる研究ワークフローを案内します。検索結果から得られた回答や論文リストをCSV、RIS、複数の参考文献形式への出力として取得し、論点を整理します。
そして、ElicitやConsensusの調査を経て採用を決めた重要な公開論文について、その詳細な評価項目を整理する段階ではSciSpaceを活用します。採用した研究PDFをSciSpaceへ入力すると、表、統計、引用などを指定列へ抽出する機能によって読み込み作業が補助されます。SciSpace自身も検索、スクリーニング、抽出、報告を扱う系統的レビュー用エージェントを提供していますが、ここでは手元にあるPDFからのデータ抽出という役割に特化して割り当てます。
これらの操作にあたっては、厳格な情報管理が求められます。未公開の化合物構造、患者情報、治験の未公開資料、進行中の提携交渉、未出願の発明といった機密情報を外部の人工知能へ入力してはいけません。また、現時点の証拠は人の関与や監督なしで生成人工知能をエビデンス統合へ使うことを支持しないと指摘されています。人工知能が出力した疾患と標的の関連性に関する見解はあくまで補助の整理であり、これを診断の根拠、特許侵害の判断、あるいは規制当局への最終判断に用いることはできません。利用者は出力結果を鵜呑みにせず、必ず元の学術論文の本文へ戻って人が確認を行う必要があります。
このように、目的別に製品を使い分けて公開論文から必要な情報を整理した後は、疾患メカニズムの理解から一歩進み、臨床試験や関連薬剤の情報を横断的に追跡する段階へと進みます。
臨床と薬剤情報はPatsnap Synapseで追う
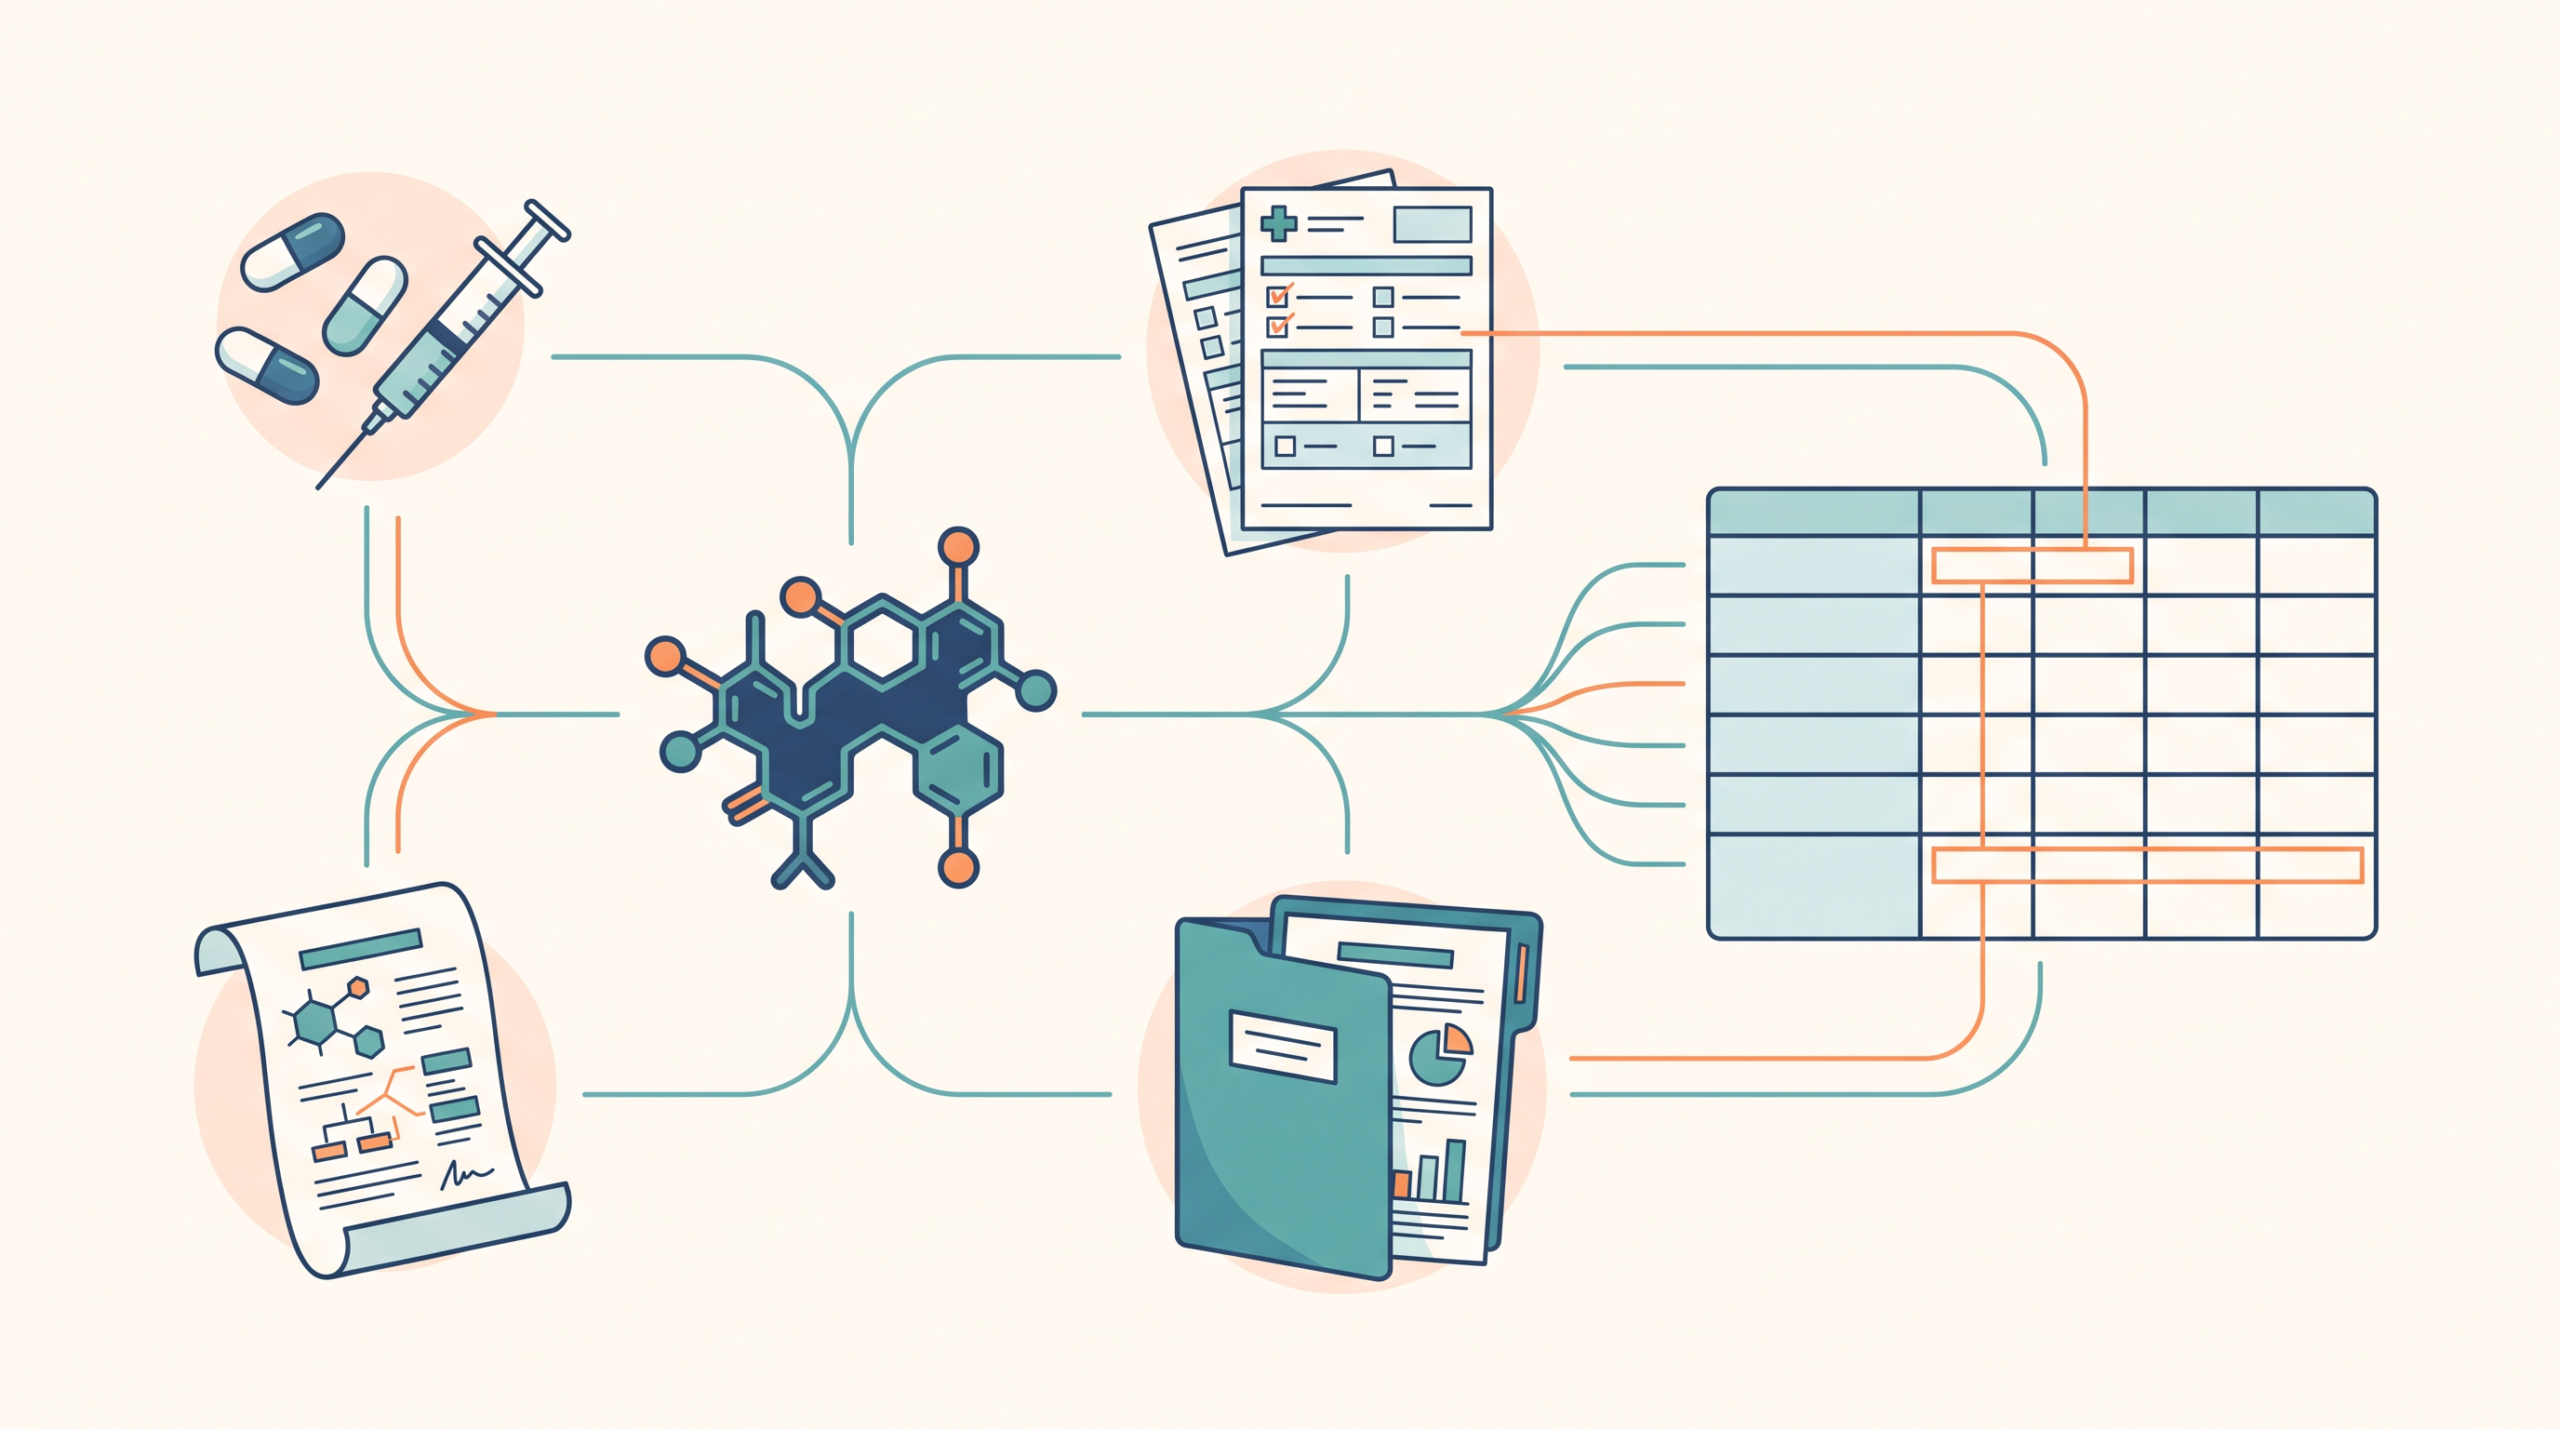
文献調査を通じて疾患メカニズムや標的の学術的な背景を整理した後は、実際の薬剤の開発状況や競合パイプラインをどのように比較するかが次の課題となります。基礎研究の段階から臨床開発の段階へと視点を移す際、論文情報だけでは開発の進捗や権利の状況を網羅することはできません。この臨床・パイプライン調査の仕事には、情報を横断して追跡できるPatsnap Synapseを割り当てます。
Patsnap Life Sciencesは生物配列、化学構造、科学特許、臨床情報を横断する情報基盤を提供しています。その中で臨床およびパイプラインの調査を担うSynapseは、薬剤、標的、臨床試験、特許、企業、取引、文献を結び付ける製品です。それぞれの情報源が孤立しているのではなく、一つの検索から関連する情報を引き出せる点が特徴です。
公開情報だけを用いて、免疫疾患の新しい治療標的Xについて調べる課題を例に、具体的な操作手順を示します。この段階では、標的Xに対してどのような薬剤が開発され、どの程度の進捗があるのかという競合表を作成することが目標です。
まず、利用者はSynapseの検索窓に公開済みの標的Xの名称と対象となる適応症を入力します。人工知能は入力された情報を基に、各公開データベースから関連情報を結び付ける操作を行います。その結果として、標的Xを狙う化合物の薬剤名、現在の最高開発段階、紐づく臨床試験ID、関連する特許、そして開発を主導するスポンサー企業が一覧表として出力されます。これにより、どの企業がどの開発フェーズにいるのかを一目で比較できるようになります。
この調査を行う際も、入力情報の取り扱いには厳格な基準が必要です。自社で保有している未公開の化合物構造、個人を特定し得る患者情報、治験の未公開資料、進行中の提携交渉の詳細、あるいは未出願の発明といった機密情報を、外部の人工知能へ入力してはいけません。入力は常に公開情報に限定する必要があります。
また、出力結果の扱いについても同様の注意が求められます。人工知能が提示した開発パイプラインの有望性や、特許との紐付けに基づく見解は、あくまで公開情報を結び付けた情報整理の補助にすぎません。これをそのまま疾患の診断根拠にしたり、規制当局への提出資料における最終判断に用いたりすることはできません。また、出力された特許情報を基に特許侵害の有無を判断することや、事業投資の最終決定を下すことも不適切です。最終的な判断を下す前には、臨床試験データベースや特許庁の公開公報など、人が必ず原典となる公開情報へ戻って内容の正確性を直接確認する必要があります。
このようにして標的Xに関連する薬剤の開発状況や競合企業の顔ぶれを横断的に把握した後は、開発されている具体的な化合物の構造や化学反応、そして特許の詳細な権利状況を確かめる化学・特許調査へと移ります。
化学と特許はCAS SciFinderで確かめる
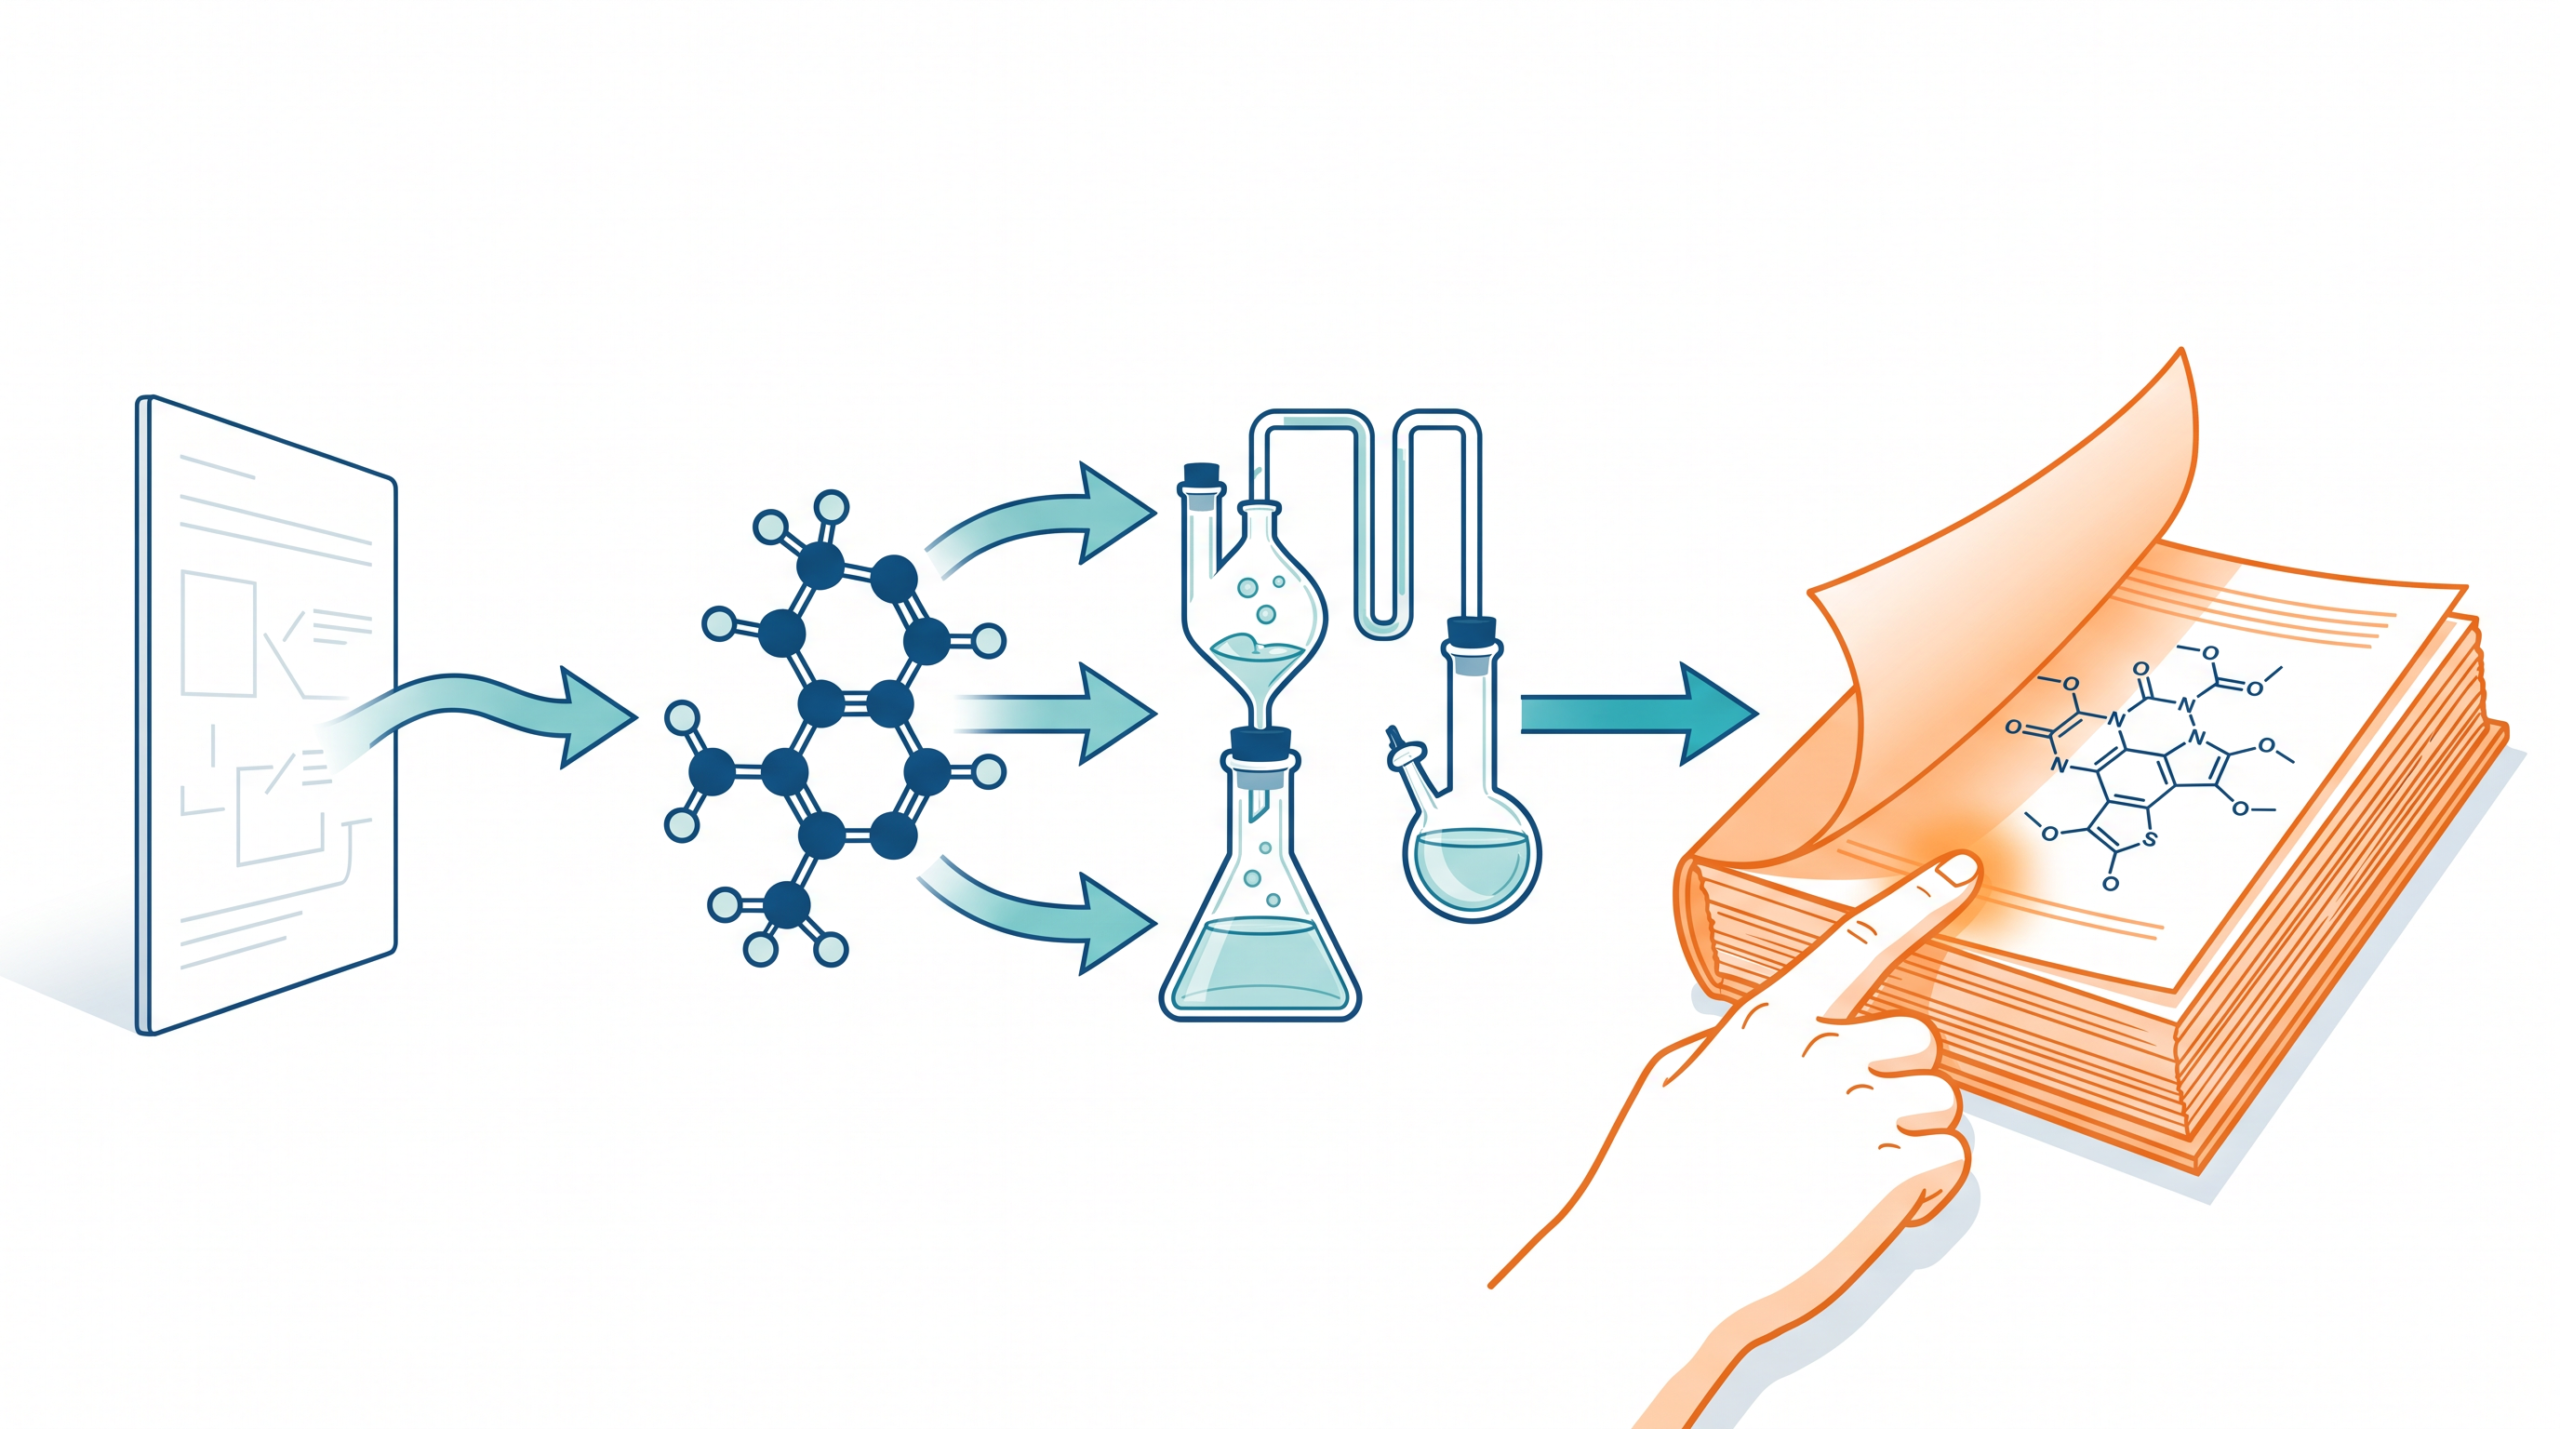
臨床・パイプライン調査を通じて、関連する薬剤の進捗状況や競合企業の動向を把握した後は、開発されている候補化合物の具体的な構造や、製造における化学反応の条件、そして特許の詳細な権利状況を原典で確かめる段階に入ります。科学・知財の原典となる情報を正確に確認した後、最終的に企業の説明と市場情報を見るという流れになります。
この化学・特許調査の仕事には、化合物の構造や反応に特化した情報源を持つ製品を割り当てます。CAS SciFinderはSearchSenseとCAS Newtonを通じて科学情報のAI検索と要約を提供するため、これを利用して膨大な科学文献や特許を整理します。さらに、CAS BioFinderは創薬チーム向けの医薬データとAI予測機能を提供するため、これらを組み合わせることで候補化合物の生物学的な特徴もあわせて調査を進めることができます。
公開情報だけを用いて、免疫疾患の新しい治療標的Xについて調べる課題を例に、具体的な候補化合物の調査手順を示します。まず利用者は、標的Xの作用機序や、すでに関連が知られている公開済みの化合物名を自然言語で入力します。すると人工知能が、関連する科学文献や特許庁が公開する特許の内容を記した公式文書である特許公報を検索し、要約する操作を行います。出力結果として、該当する化合物の特徴、構造、関連する既存特許の要約文が提示されます。
ここで重要なのは、化学情報を人工知能の要約だけで判断しないことです。そのための方法として、自然言語を用いた人工知能による要約と、従来の化学的な構造検索や反応検索の役割を明確に分けることが求められます。人工知能が出力した要約文から化合物の登録番号や特許番号を特定した後は、その番号を手がかりにして詳細な化学構造式や合成のための反応条件を検索し、具体的な情報を引き出します。
この調査段階においても、入力する情報には厳格な制限があります。自社で研究中の未公開の化合物構造、患者情報、治験の未公開資料、進行中の提携交渉に関する情報、未出願の発明といった機密情報を、外部の人工知能へ入力してはいけません。
また、出力結果の取り扱いにも注意が必要です。人工知能が要約した化合物の有望性、特許の新規性、あるいは未確認の料金情報に基づく見解は、あくまで公開情報を整理した補助的な内容にすぎません。これをそのまま疾患の診断根拠にしたり、規制当局への提出における最終判断に用いたりしてはいけません。加えて、特許侵害の有無の判断や、事業投資の最終的な決定材料として用いることも不適切です。最終的な判断を下す前には、出力された要約に頼るだけでなく、化合物名と作用機序から検索を始めた結果として得られた構造や反応条件について、必ず人が原論文や特許公報の原典へ戻って内容を直接確認する必要があります。
このようにして化学および特許の原典を確かめ、技術的な裏付けをとった後は、対象となる技術や標的を取り巻く企業の事業説明や、市場全体の動向を比較する企業・市場調査へと進みます。
企業と市場はAlphaSenseで比較する
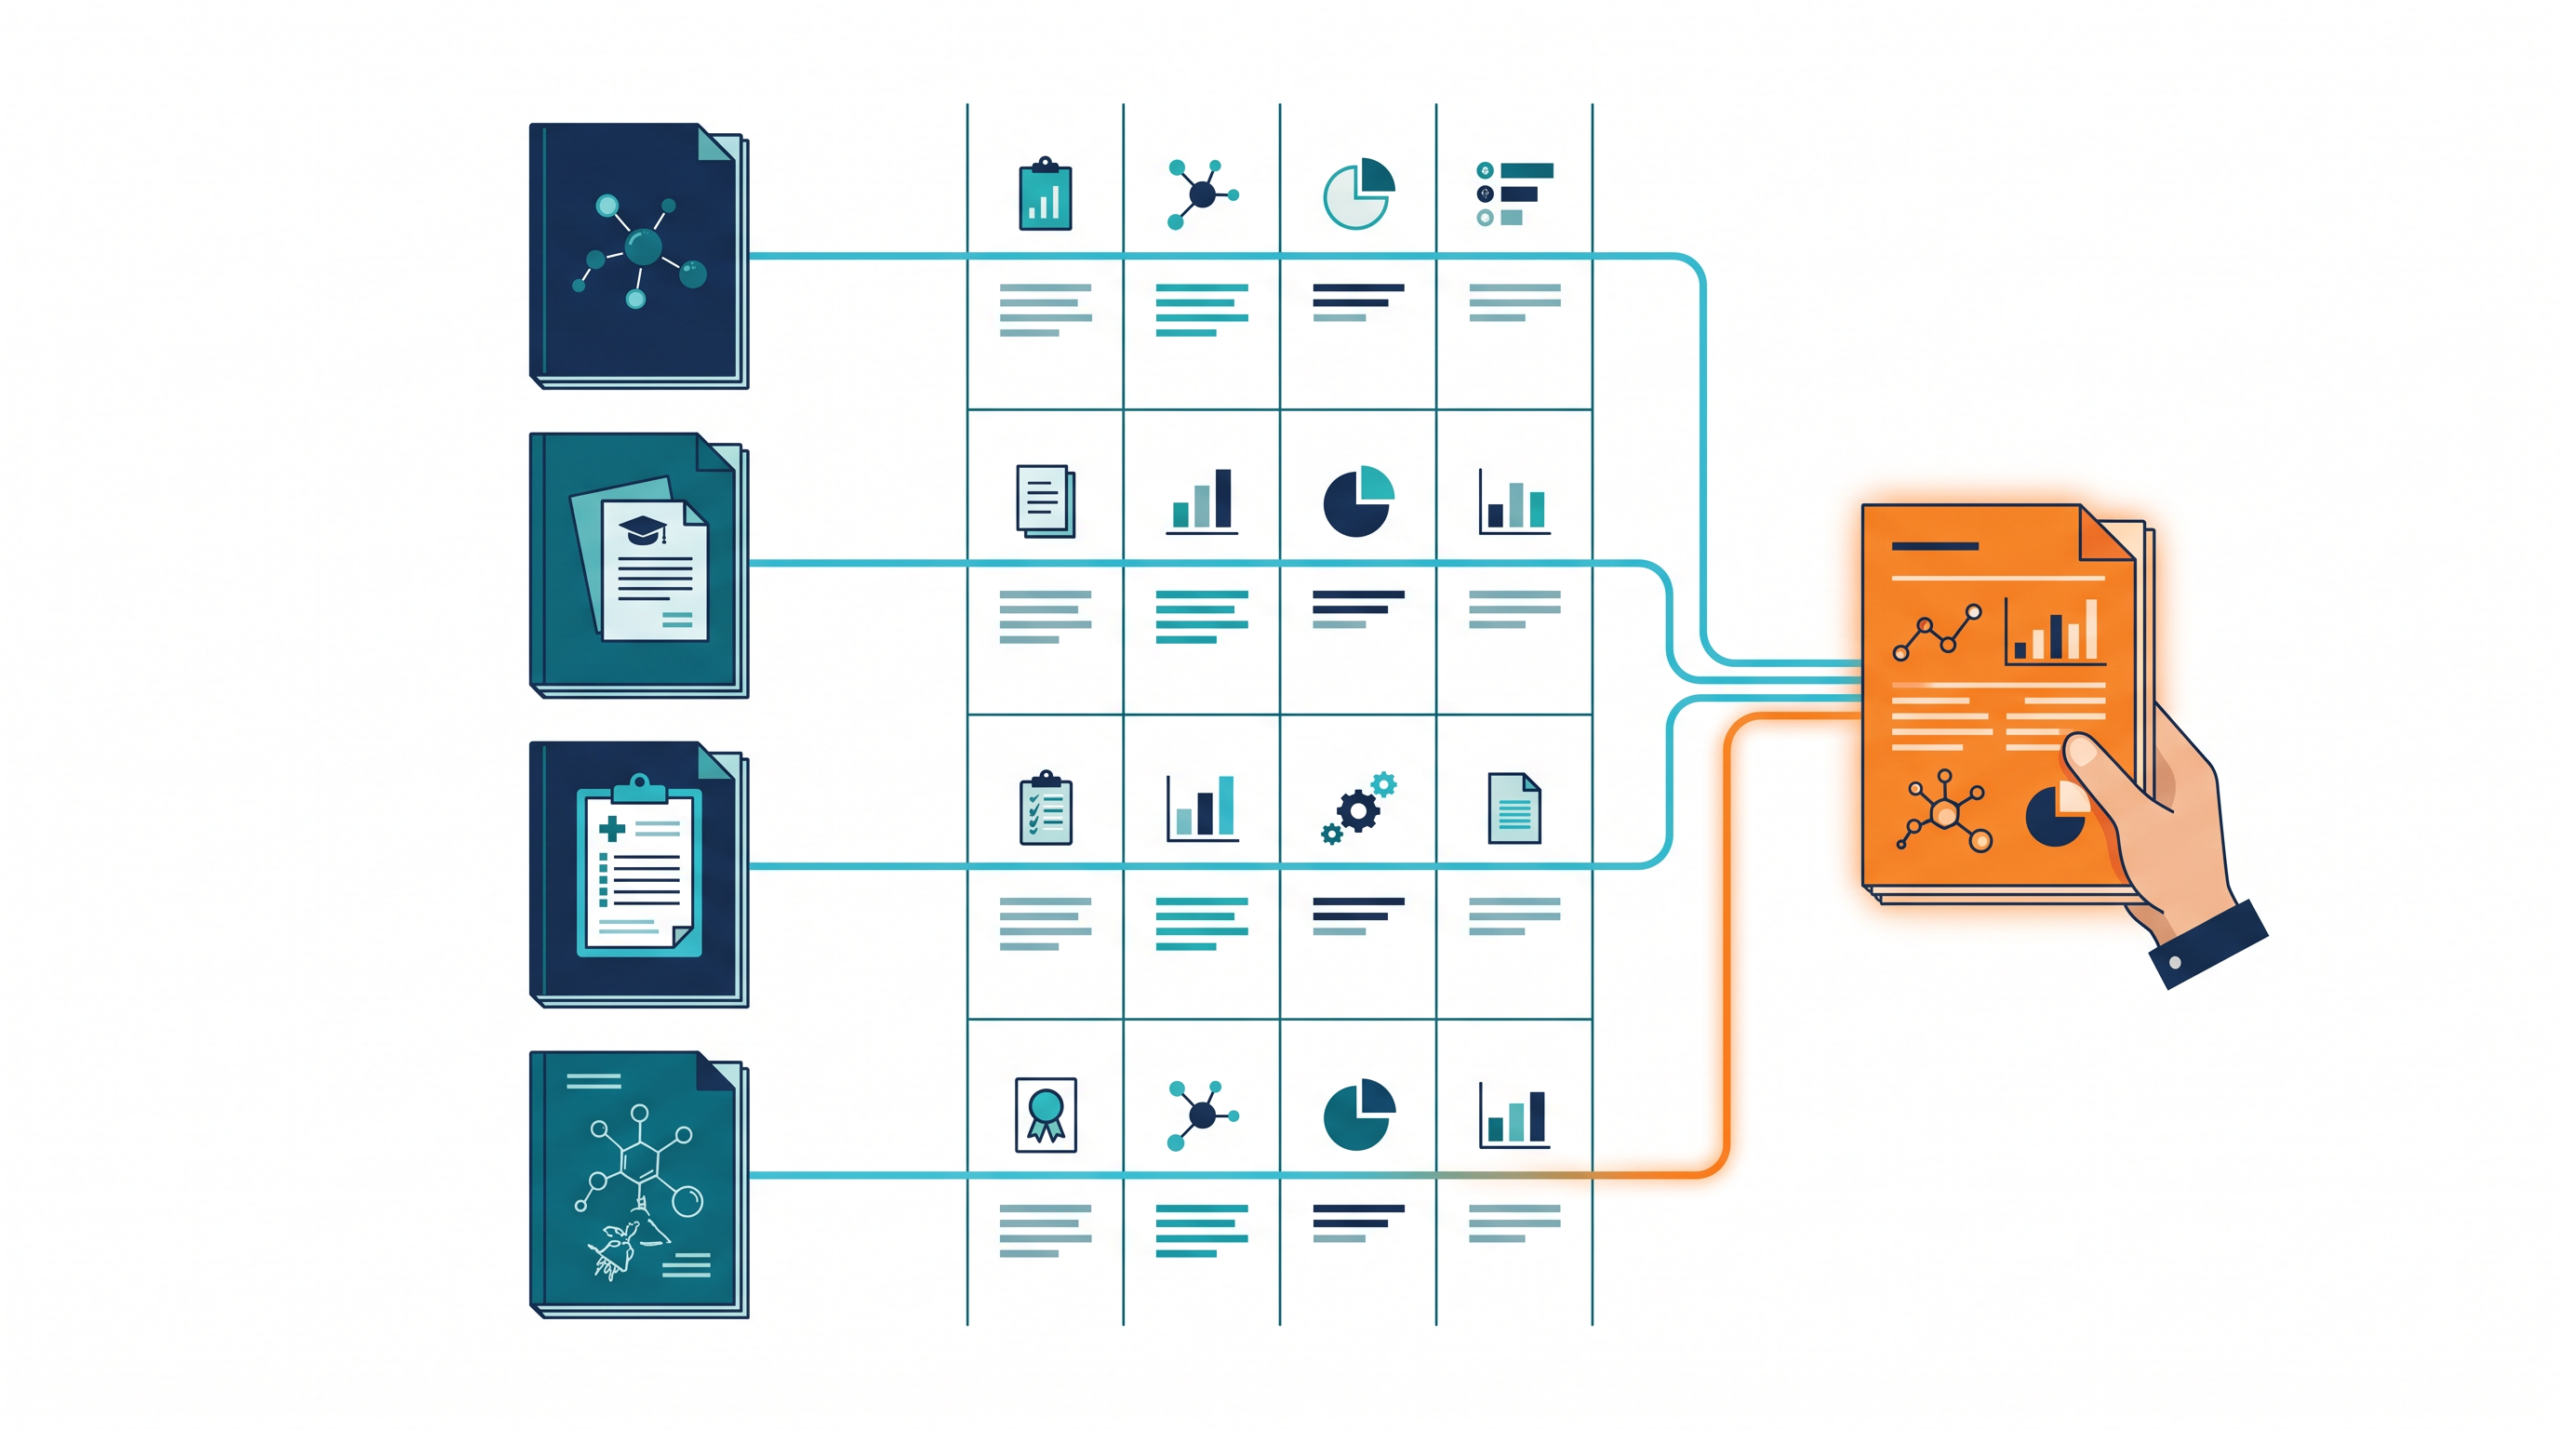
化学と特許の原典を確かめ、技術的な裏付けをとった後は、企業の発言と市場の評価をどのように横断して把握するかが重要になります。製薬競合情報は臨床試験、複数法域の特許、論文、規制資料、決算、学会情報を統合する必要があると指摘されている通り、科学的なデータだけでなく、競合企業の戦略や市場動向を紐解く決算資料や開示情報の統合は不可欠です。この企業・市場調査の仕事には、ビジネス情報の検索と整理に特化したAlphaSenseを割り当てます。
AlphaSenseはヘルスケア企業の開示、決算説明、ニュースなどをAI検索と比較へ使う製品です。各社が発表する膨大な文章から、経営陣の見解や市場からの評価を効率的に抽出する役割を担います。
公開情報だけを用いて、免疫疾患の新しい治療標的Xについて調べる課題を例に、競合4社の説明比較を行う手順を示します。この段階での目的は、同じ質問項目に対して各社がどのような事業説明を行っているかを横並びで比べることです。
まず入力の操作として、利用者は比較したい対象となる競合企業4社と、過去1年間といった対象期間を指定します。その上で、公開済みの標的Xの名称や関連する事業戦略に関する検索語を入力します。すると人工知能は、指定された条件に基づいて、各社の開示資料、決算説明会の書き起こし録、プレスリリースなどのテキストを検索し、関連する発言を抽出する操作を実行します。
出力結果として、4社それぞれの標的Xに対する取り組み、新たな事業提携の有無、最新の臨床試験結果に対する言及、そして将来の売上見通しといった項目を列として整理した比較表が提示されます。これにより、ある企業は標的Xの試験結果を強調している一方で、別の企業は提携を通じたリスク分散を強調しているといった、各社の戦略の違いを可視化することができます。
この調査を行う際にも、厳格な情報管理が求められます。自社で進行中の提携交渉に関する詳細、未公開の化合物構造、患者情報、治験の未公開資料、未出願の発明といった機密情報を、外部の人工知能へ入力してはいけません。入力に用いるのは、常に公開されている企業名や検索語に限定する必要があります。
また、人工知能が提示した成果物の取り扱いにも注意が必要です。出力された競合他社の売上見通しの有望性、市場での新規性、あるいはニュースに基づく未確認料金の情報などは、あくまで公開情報を整理した補助的な結果にすぎません。これをそのまま疾患の診断根拠にしたり、規制当局への提出における最終判断に用いたりすることはできません。さらに、特許侵害の有無の判断や、自社の事業投資に関する最終判断の材料として用いることも不適切です。
どのような比較表が出力されたとしても、最終的な評価を下す前には、必ず人が元の資料を開く必要があります。抽出された発言がどのような文脈で語られたものなのか、決算資料や提携発表のプレスリリースといった原典へ戻って直接確認することが不可欠です。
このように、文献、臨床、特許、そして企業・市場という各専門情報源に対応した人工知能の役割を確認してきました。それぞれの調査段階において原典と成果物を明確にし、同じ公開課題を通して比較を行うことで、自社の調査業務にどの製品が最も適しているかを判断する準備が整います。
同じ公開課題で試し人が原典へ戻る
ここまで文献、臨床、特許、企業・市場という各専門情報源に対応した人工知能の役割を確認してきました。契約前に自社の調査業務に最も合う製品を決めるためには、実際の運用を想定した評価基準を設け、製品を比較することが不可欠です。
比較を行う際は、異なる条件でばらばらに試すのではなく、公開情報だけで免疫疾患の新しい治療標的Xについて調べるという共通の課題を設定します。この課題に対して各製品の試用期間を設け、たとえば60分の試用記録をつけます。利用者が検索語を入力し、人工知能が検索や抽出の操作を実行し、表などの成果物を出力する一連の流れにおいて、具体的な採点項目を記録します。
記録すべき項目には、人工知能の出力から元の論文や特許へどれだけ確実に辿り着けるかを示す原典到達率、必要なデータの欠落、異なる文脈の誤結合が起きていないかの確認結果が含まれます。さらに、出力された結果を人が手直しするためにかかった修正時間、自社の環境で利用しやすい出力形式が備わっているか、そして入力した機密情報が人工知能の学習に使われないといったデータ保持条件を満たしているかを検証します。
こうした運用テストが必要な背景には、人工知能の精度に関する限界があります。学術情報からのAIデータ抽出の検証では60から70パーセントの精度と書誌情報の欠落が報告され、人の確認が必要であると指摘されています。また、限られた期間で文献をまとめる迅速な文献レビューである115研究のrapid reviewは生成人工知能が一部のスクリーニングと抽出を支援できる一方、人が介在して確認と修正を行う仕組みである校正済みhuman-in-the-loopを条件とするとされています。加えて、現時点の証拠は人の関与や監督なしで生成人工知能をエビデンス統合へ使うことを支持しないという見解も示されています。そのため、出力結果から必ず人が原典の公開情報へ戻り、自らの目で直接確認する工程を業務フローに組み込むことが大前提となります。
試用から実運用へ移行するにあたり、機密情報の停止条件と判断の境界を社内で徹底しなければなりません。未公開の化合物構造、患者を特定できる情報、治験の未公開資料、進行中の提携交渉、未出願の発明といった機密資料の入力は、外部の人工知能に対して絶対に行ってはいけません。
また、人工知能が出力した情報をそのまま最終的な決定に用いることも禁止されます。出力された情報に基づいて、疾患の診断を行ったり、規制の最終判断を下したり、特許侵害判断を行ったりすることはできません。人工知能が提示した未確認料金などの情報に基づいて、事業投資の最終決定を行うことも不適切です。欧州の規制当局であるEMAは医薬品ライフサイクルでAIを安全かつ有効に使うための考慮事項を公開するなど、業界全体で厳格な安全基準が求められています。
自社の主な調査仕事に合う主軸製品を定め、不足する機能を補う補助製品を組み合わせ、人が必ず原典を確認するという運用ルールを策定することで、製薬業界における情報収集を安全かつ効率的に進める準備が整います。
よくある質問
Q1. 全ての調査を一つで完結させることはできますか?
情報源や求める成果物が調査の段階ごとに異なるため、一つの人工知能で完結させることは困難です。公開情報だけで免疫疾患の新しい治療標的Xについて調べる課題を例に挙げても、文献の抽出と臨床試験の横断検索では適した製品が異なります。それぞれの調査の仕事に合わせて、必要な情報源を持つ主軸製品と補助製品を割り当てて使い分ける必要があります。
Q2. 無料製品を用いた調査でも十分な結果は得られますか?
無料製品であっても、入力する情報の制限や結果を確認する基本手順は変わりません。公開情報だけで免疫疾患の新しい治療標的Xについて調べる際、どの製品を利用したとしても人工知能が出力した成果物を鵜呑みにすることはできません。最終的には必ず人が学術論文などの原典へ戻り、内容を自らの目で検証するという運用ルールを守る必要があります。
Q3. 自社が保有する患者情報を調査の入力データとして使ってもよいですか?
個人を特定し得る患者情報を外部の人工知能へ入力することは固く禁じられています。加えて、未公開の化合物構造、治験の未公開資料、進行中の提携交渉、そして未出願の発明といった情報も外部へ出してはいけません。公開情報だけで免疫疾患の新しい治療標的Xについて調べる課題のように、検索や抽出の操作を行う際は常に公開されている情報のみを入力する必要があります。
Q4. 特定のテーマに関する文献を網羅的に収集して評価する系統的レビューは自動化できますか?
完全な自動化はできず、人工知能の出力に対して人が確認と修正を行う仕組みが必要です。115研究の限られた期間で行う迅速な文献レビューは、生成人工知能が一部のスクリーニングと抽出を支援できる一方、人が介在して確認と修正を行う校正済みのhuman-in-the-loopを条件とするとされています。さらに、現時点の証拠は人の関与や監督なしで生成人工知能をエビデンス統合へ使うことを支持しないため、必ず人が原典へ戻って確認する必要があります。
Q5. 出力された整理結果を特許判断の最終決定に使ってもよいですか?
人工知能が出力した特許の新規性や有望性に関する見解を、特許や事業投資などの最終的な判断にしてはいけません。公開情報だけで免疫疾患の新しい治療標的Xについて既存の権利情報を整理させたとしても、それはあくまで情報をまとめた補助的な成果物にすぎません。判断を下す前には、必ず人が特許庁の公開公報といった原典を開き、内容を直接確認する手順が不可欠です。
Q6. 導入する製品を決めるための試用方法はどうすればよいですか?
複数の製品を比較する際は、異なる条件ではなく、公開情報だけで免疫疾患の新しい治療標的Xについて調べるという共通の課題を設定して試用します。同じ検索語を入力し、抽出や要約といった操作を実行させ、出力された成果物を横並びで記録します。そこから原典へどれだけ確実に辿り着けるかや、人が修正にかかった時間を評価することで、自社の仕事に最も合う製品を見極めることができます。
AIを組み込む仕事の流れづくりをご支援します
Deskrexでは、AIを使って調査・制作・分析などの仕事を進めるために、工程と役割分担を設計し、実装する支援を行っています。AIに渡す資料や指示、使えるツール、人が確認する箇所を整理し、一連の仕事として動く仕組みをつくります。
まず、届けたい成果物と現在の作業手順を確認し、実際の仕事をAIで試します。品質、処理量、時間、費用を見ながら、今すぐ任せられる作業と、追加の設計や開発が必要な作業を確かめます。
その結果をもとに、工程の統合や並列化、ツール連携、結果の検証と修正の手順を組み込みます。実行回数や費用の上限、人の判断を待つ条件、途中の状態を保存して再開する方法も含めて設計し、実務で動作を確かめます。
業務へのAI導入やワークフロー作成のご相談は、AIワークフロー作成支援のご案内からお問い合わせください。任せたい仕事と、現在使っているツールを伺い、取り組む範囲を一緒に整理します。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント