
AIが自ら次のAIを生み出す「再帰的自己改善(RSI)」。この言葉がニュースを賑わせる一方で、実際のところAIは現在どこまで自律化しているのでしょうか。たとえば、AIに「訓練コードを高速化せよ」と指示し、見事にコードを改善して実験を完了させたとしても、それを直ちに完全なRSIの達成と呼ぶことはできません。人間の指示に従って手を動かす「研究実行」の段階と、AI自身が次に解くべき課題を見つけ、人間の介入なしに世代更新を持続的に繰り返す「完全な閉ループ(完全RSI)」には、明確な境界が存在します。
本記事では、「RSIとは具体的にどの研究工程をAIが担う状態か」という中心的な問いに向き合い、2026年時点の現在地から完全な閉ループへ到達するために何が欠けているのかを解き明かします。これを読むことで、次々と発表されるAIラボの最新成果が、作業補助、研究実行、研究判断、次世代開発、完全な閉ループのどこに位置づけられるのかを公開指標から冷静に見極め、自社の四半期レビューを正確に更新できるようになります。
- 再帰的自己改善は5段階に分ける
- 議論が現実味を持った理由は研究工程の自動化
- 2026年の現在地は自動研究インターンまで
- 完全な閉ループには7つの条件が残る
- 実現判定は作業量ではなく再現と持続性で行う
- 閉ループが成立しても全工程は同じ速度で進まない
- 四半期ごとに固定系列と新規系列を更新する
- よくある質問
- Q1. AIが自らコードを書き換えて性能を上げたというニュースは、完全なRSI(再帰的自己改善)への到達を意味しますか?
- Q2. AIが自身のプロンプトなどを自動調整する「自己改変」と、本記事で言うRSIはどう違うのですか?
- Q3. AIの進化が速い中で、RSIの進捗はどれくらいの頻度で観測すべきですか?
- Q4. 企業が「自律性の達成度」や「作業時間の換算」で高い数値を発表した場合、それをそのまま評価の根拠にしてもよいですか?
- Q5. AIの研究能力を測るベンチマークのスコアが急上昇した場合、完全なRSIに近づいたと判断できますか?
- Q6. 完全なRSIの実現が見通せない中で、AIによる研究開発への投資や事業判断をどう進めればよいか迷っています。
- 調査手法について
再帰的自己改善は5段階に分ける
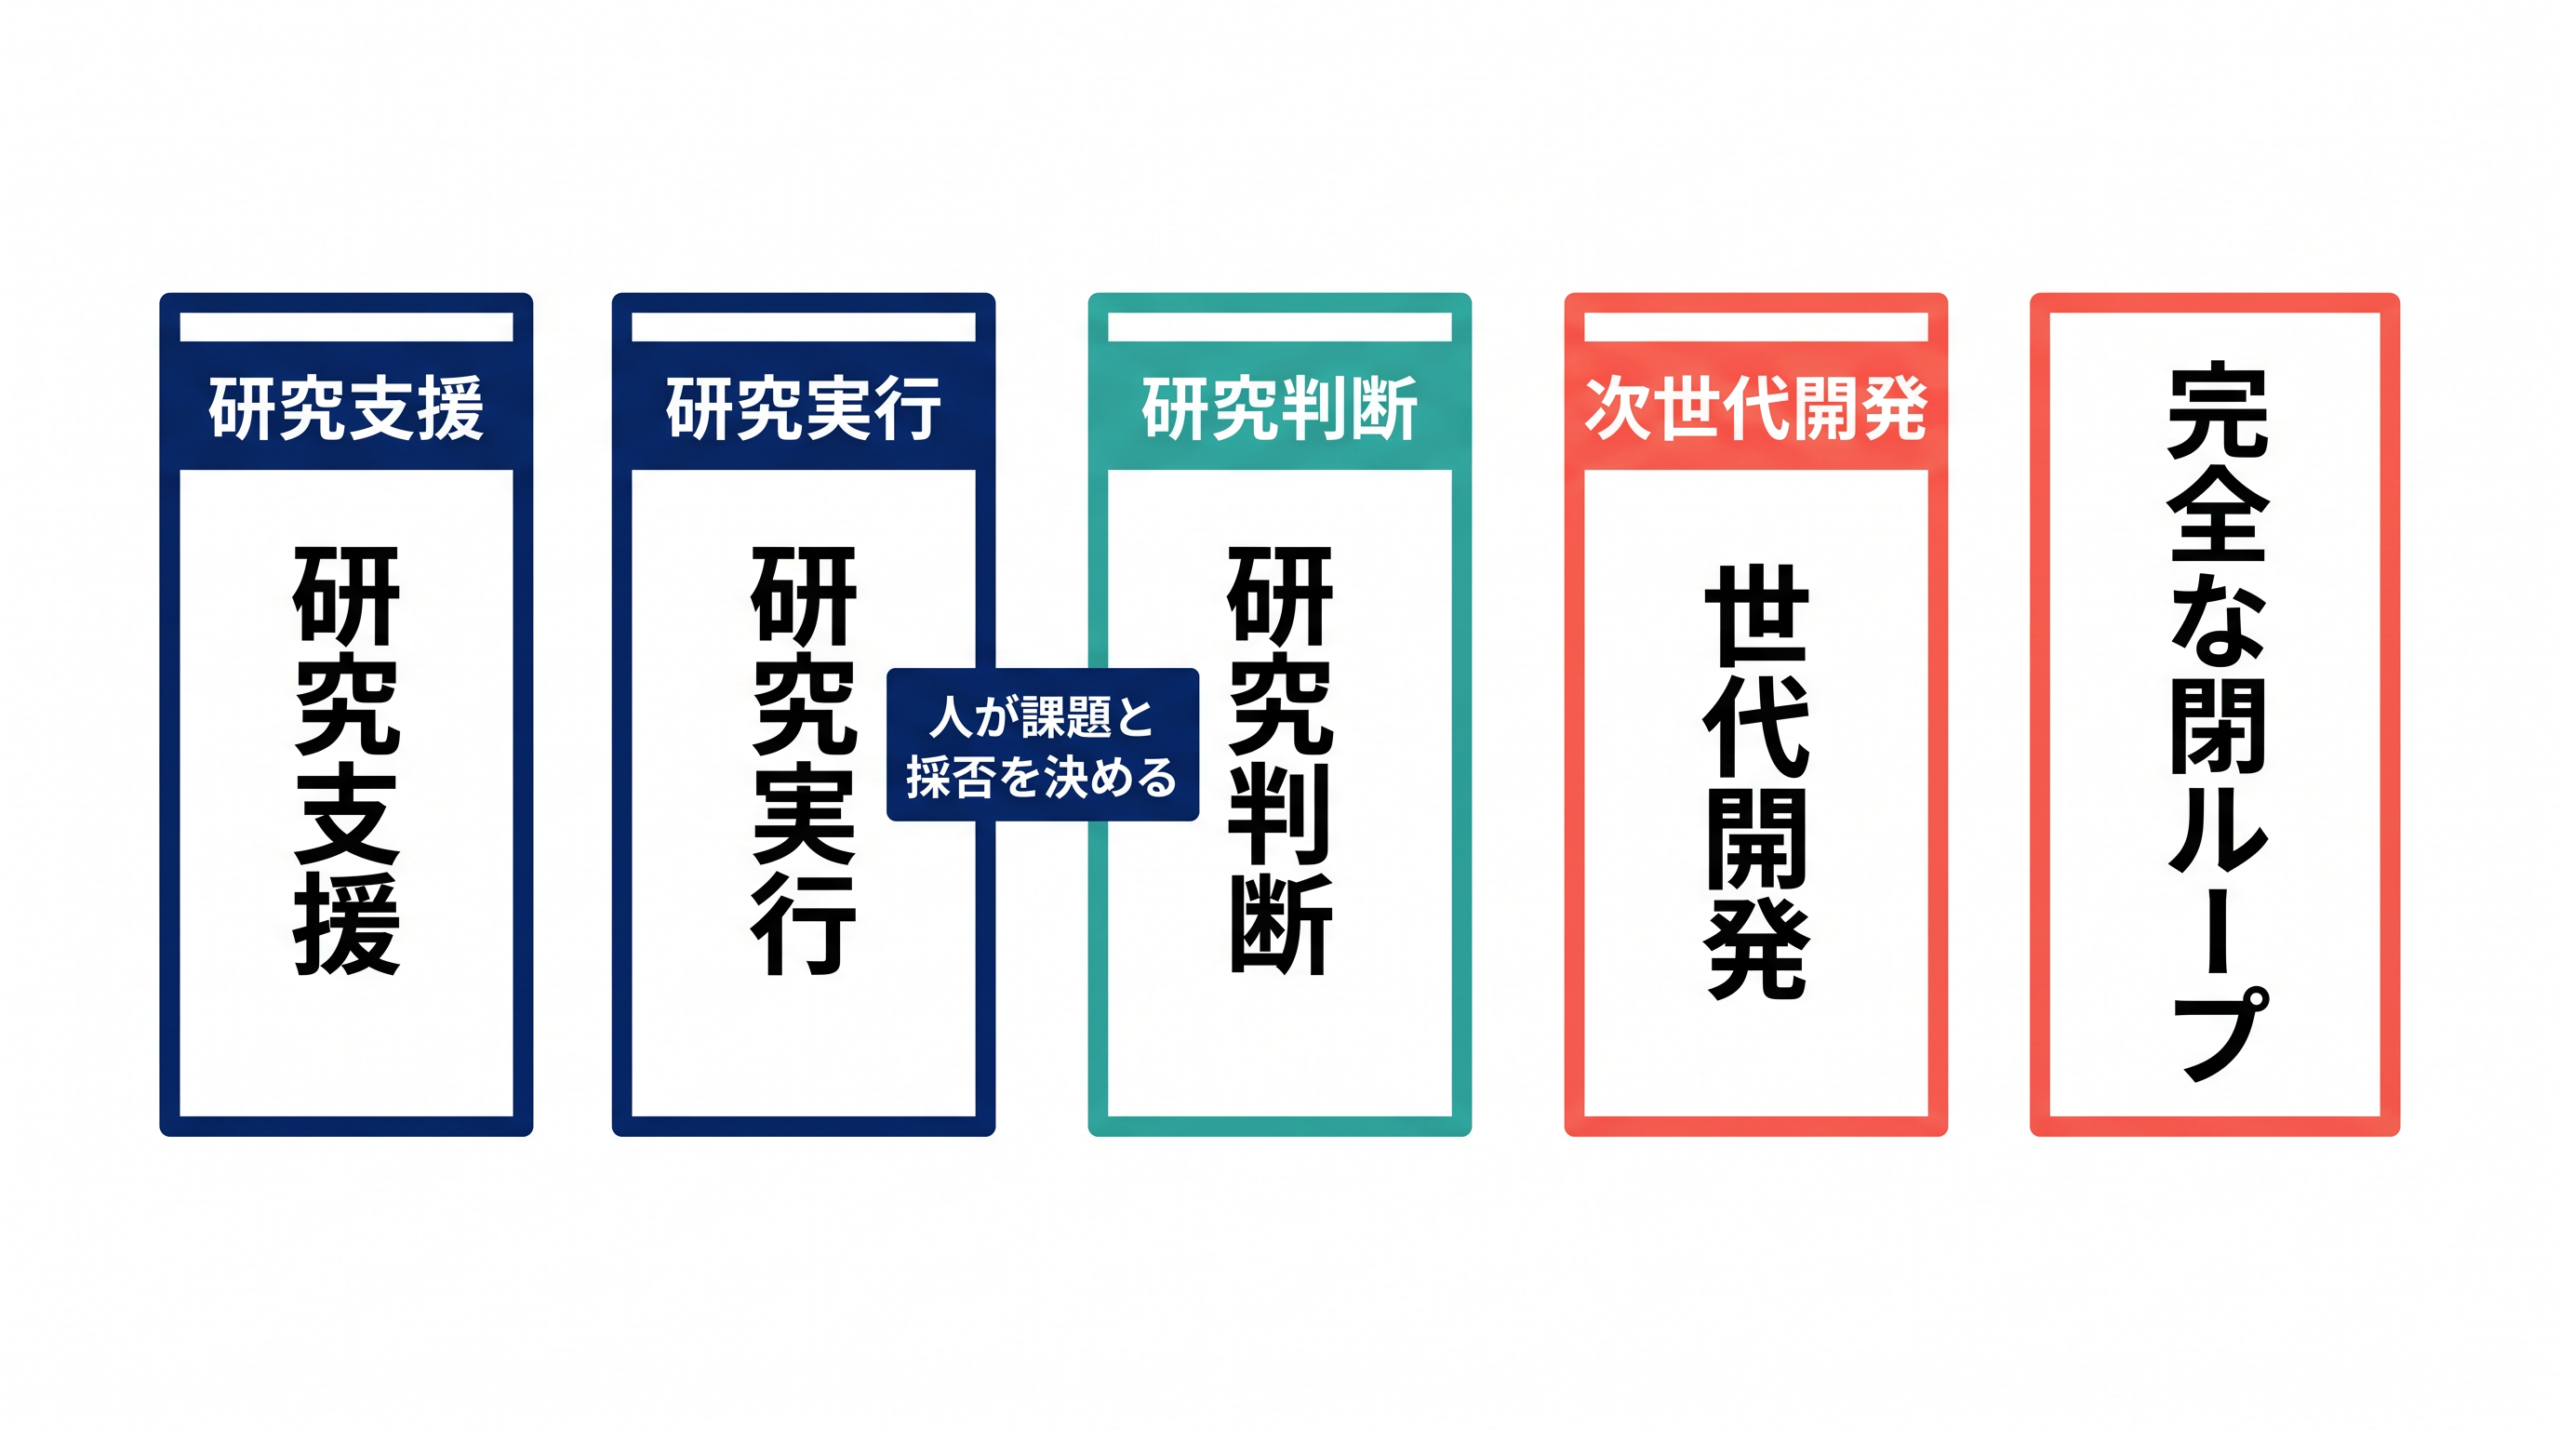
再帰的自己改善(RSI:Recursive Self-Improvement)の到達状況を正確に読み解くためには、まず「AIが研究開発のどの工程を自律的に担っているのか」という用語の境界を明確にする必要があります。AIが次のAIを作るプロセスは、一つの研究依頼に対する人間の関与度合いによって、大きく5つの段階に分けることができます。
最初の段階は研究支援です。ここでは人間が主体となって研究を進め、AIはコードの記述やデータの整理といった部分的な作業を補助します。
次に、研究実行の段階へ進みます。例えば「訓練コード高速化」という依頼において、人間が目標と評価条件を与え、AIが自律的にコードの変更と実験を行う状態を指します。AIが自ら手を動かしてはいるものの、最終的に人間がその結果を確認して採否を決めている状態はあくまで研究実行であり、人間の介入なしに完結する完全な自律状態(閉ループ)ではありません。
さらに自律性が高まると、AI自身が実験結果をもとに「次にどの実験を行うべきか」という方針転換までを行う研究判断の段階となります。そして、自らの後継となる新しいAIモデルの設計や訓練プロセスを主導する次世代開発の段階を経て、最終的に人間の介入を一切受けずに研究課題の選択から世代更新までを持続的に繰り返す完全な閉ループへと到達します。
この段階的な枠組みは、主要なAI開発企業における定義や位置づけとも符合しています。OpenAIはAIの自己改善を「AI研究の加速を含む能力」として扱い、超人的な研究科学エージェントの実現や、世代更新の持続的短縮を重要な転換点(Critical)と定めています。Anthropicは後継モデルの完全な自律設計と開発を「完全なRSI」と定義し、現状では未達であると明記しています。また、Google DeepMindは、再帰的な自己改善を汎用人工知能(AGI)到達後に想定される進化の複数経路の一つとして分析しています。
単なる作業の自動化をRSIの始まりと捉えるのか、それとも人間の介入が一切不要になった閉ループを指すのか。この5段階の境界を区別することで、次々と発表される最新のAI研究成果がどこに位置づけられるのかを冷静に判断できるようになります。
議論が現実味を持った理由は研究工程の自動化
なぜ今になって、再帰的自己改善(RSI)が現実的な議論の的となっているのでしょうか。その背景には、AIが単なる文章生成を超えて、コーディングや並列実験といった「研究工程の自動化」において進展を見せているという事実があります。
ここで重要なのは、膨大な作業をこなす能力の向上と、高度な「研究成果」を自律的に生み出す能力の獲得を分けて考えることです。現在のAIは、与えられた条件下でコードを書き換え、多数の実験を並列で実行する段階(前述の「研究実行」)において強みを発揮し始めています。
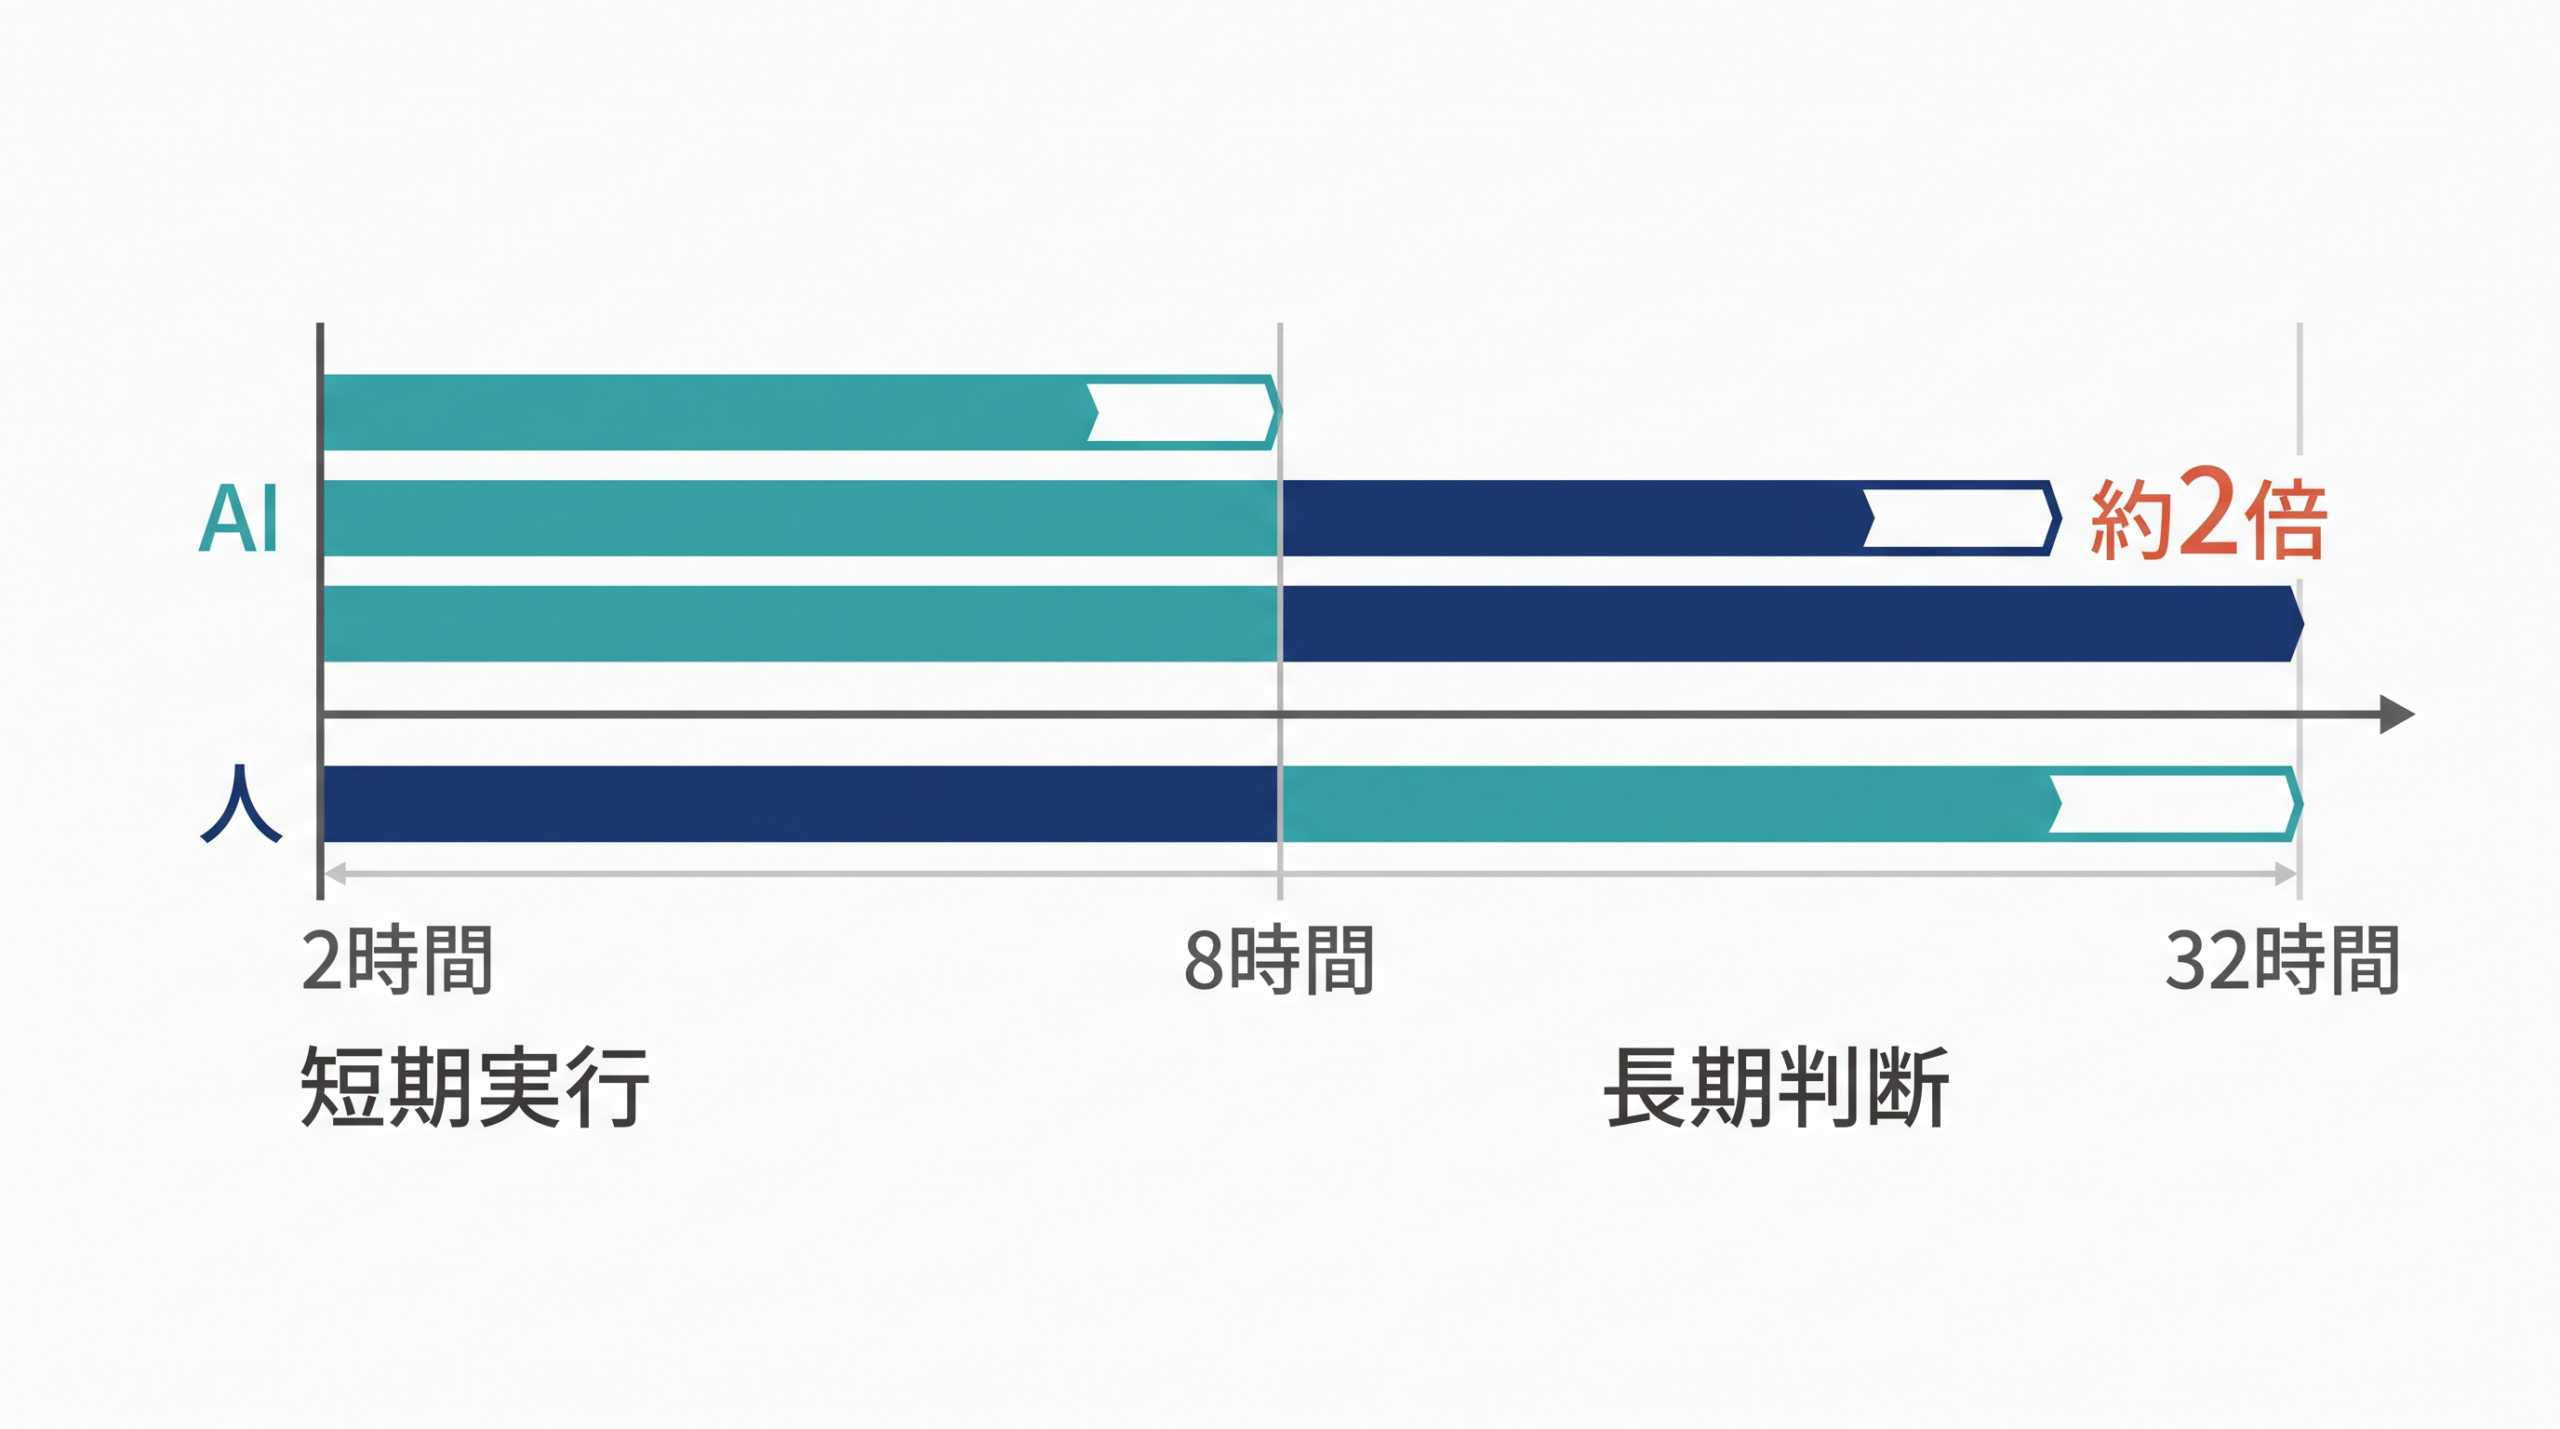
この現在地は、AIの自律的な研究開発能力を測る評価指標からも読み取ることができます。たとえば、機械学習の研究タスクにおける人間とAIのパフォーマンスを比較したRE-Benchの評価では、制限時間が2時間の条件においてはAIが人間よりも優位な結果を示しました。しかし、制限時間が長くなるにつれて状況は変わり、8時間では人間が優位に立ち、32時間の条件では人間の成果がAIの約2倍に達しています。この時間条件による違いは、短時間で試行回数を稼ぐような作業の実行においてはAIが効果的である一方で、実験結果をもとに方針を転換していくような長期的な研究判断においては、依然として人間が優位であることを明確に示しています。
また、既存の機械学習論文の実装をAIが自動化できるかを測るPaperBenchの評価を見ても、20の論文を対象とした初回評価において、最良のAIモデルによる再現の平均達成率は21.0%にとどまっています。自律型AIエージェントの能力を測るMETRの評価基準にしても、数百のタスクにおける成功率を推定するものであり、RSIの到達そのものを直接的に測定しているわけではありません。
つまり、現在の進展は研究工程における長時間タスクや並列処理といった「作業の自動化」が現実になりつつあることを意味しています。AIがまだ完全な研究判断を自律的に行えるわけではないものの、人間が手作業で行っていた研究実行の一部をAIが担えるようになったからこそ、その延長線上に位置するRSIが具体的な工程を伴う現実の課題として議論されるようになっているのです。
2026年の現在地は自動研究インターンまで
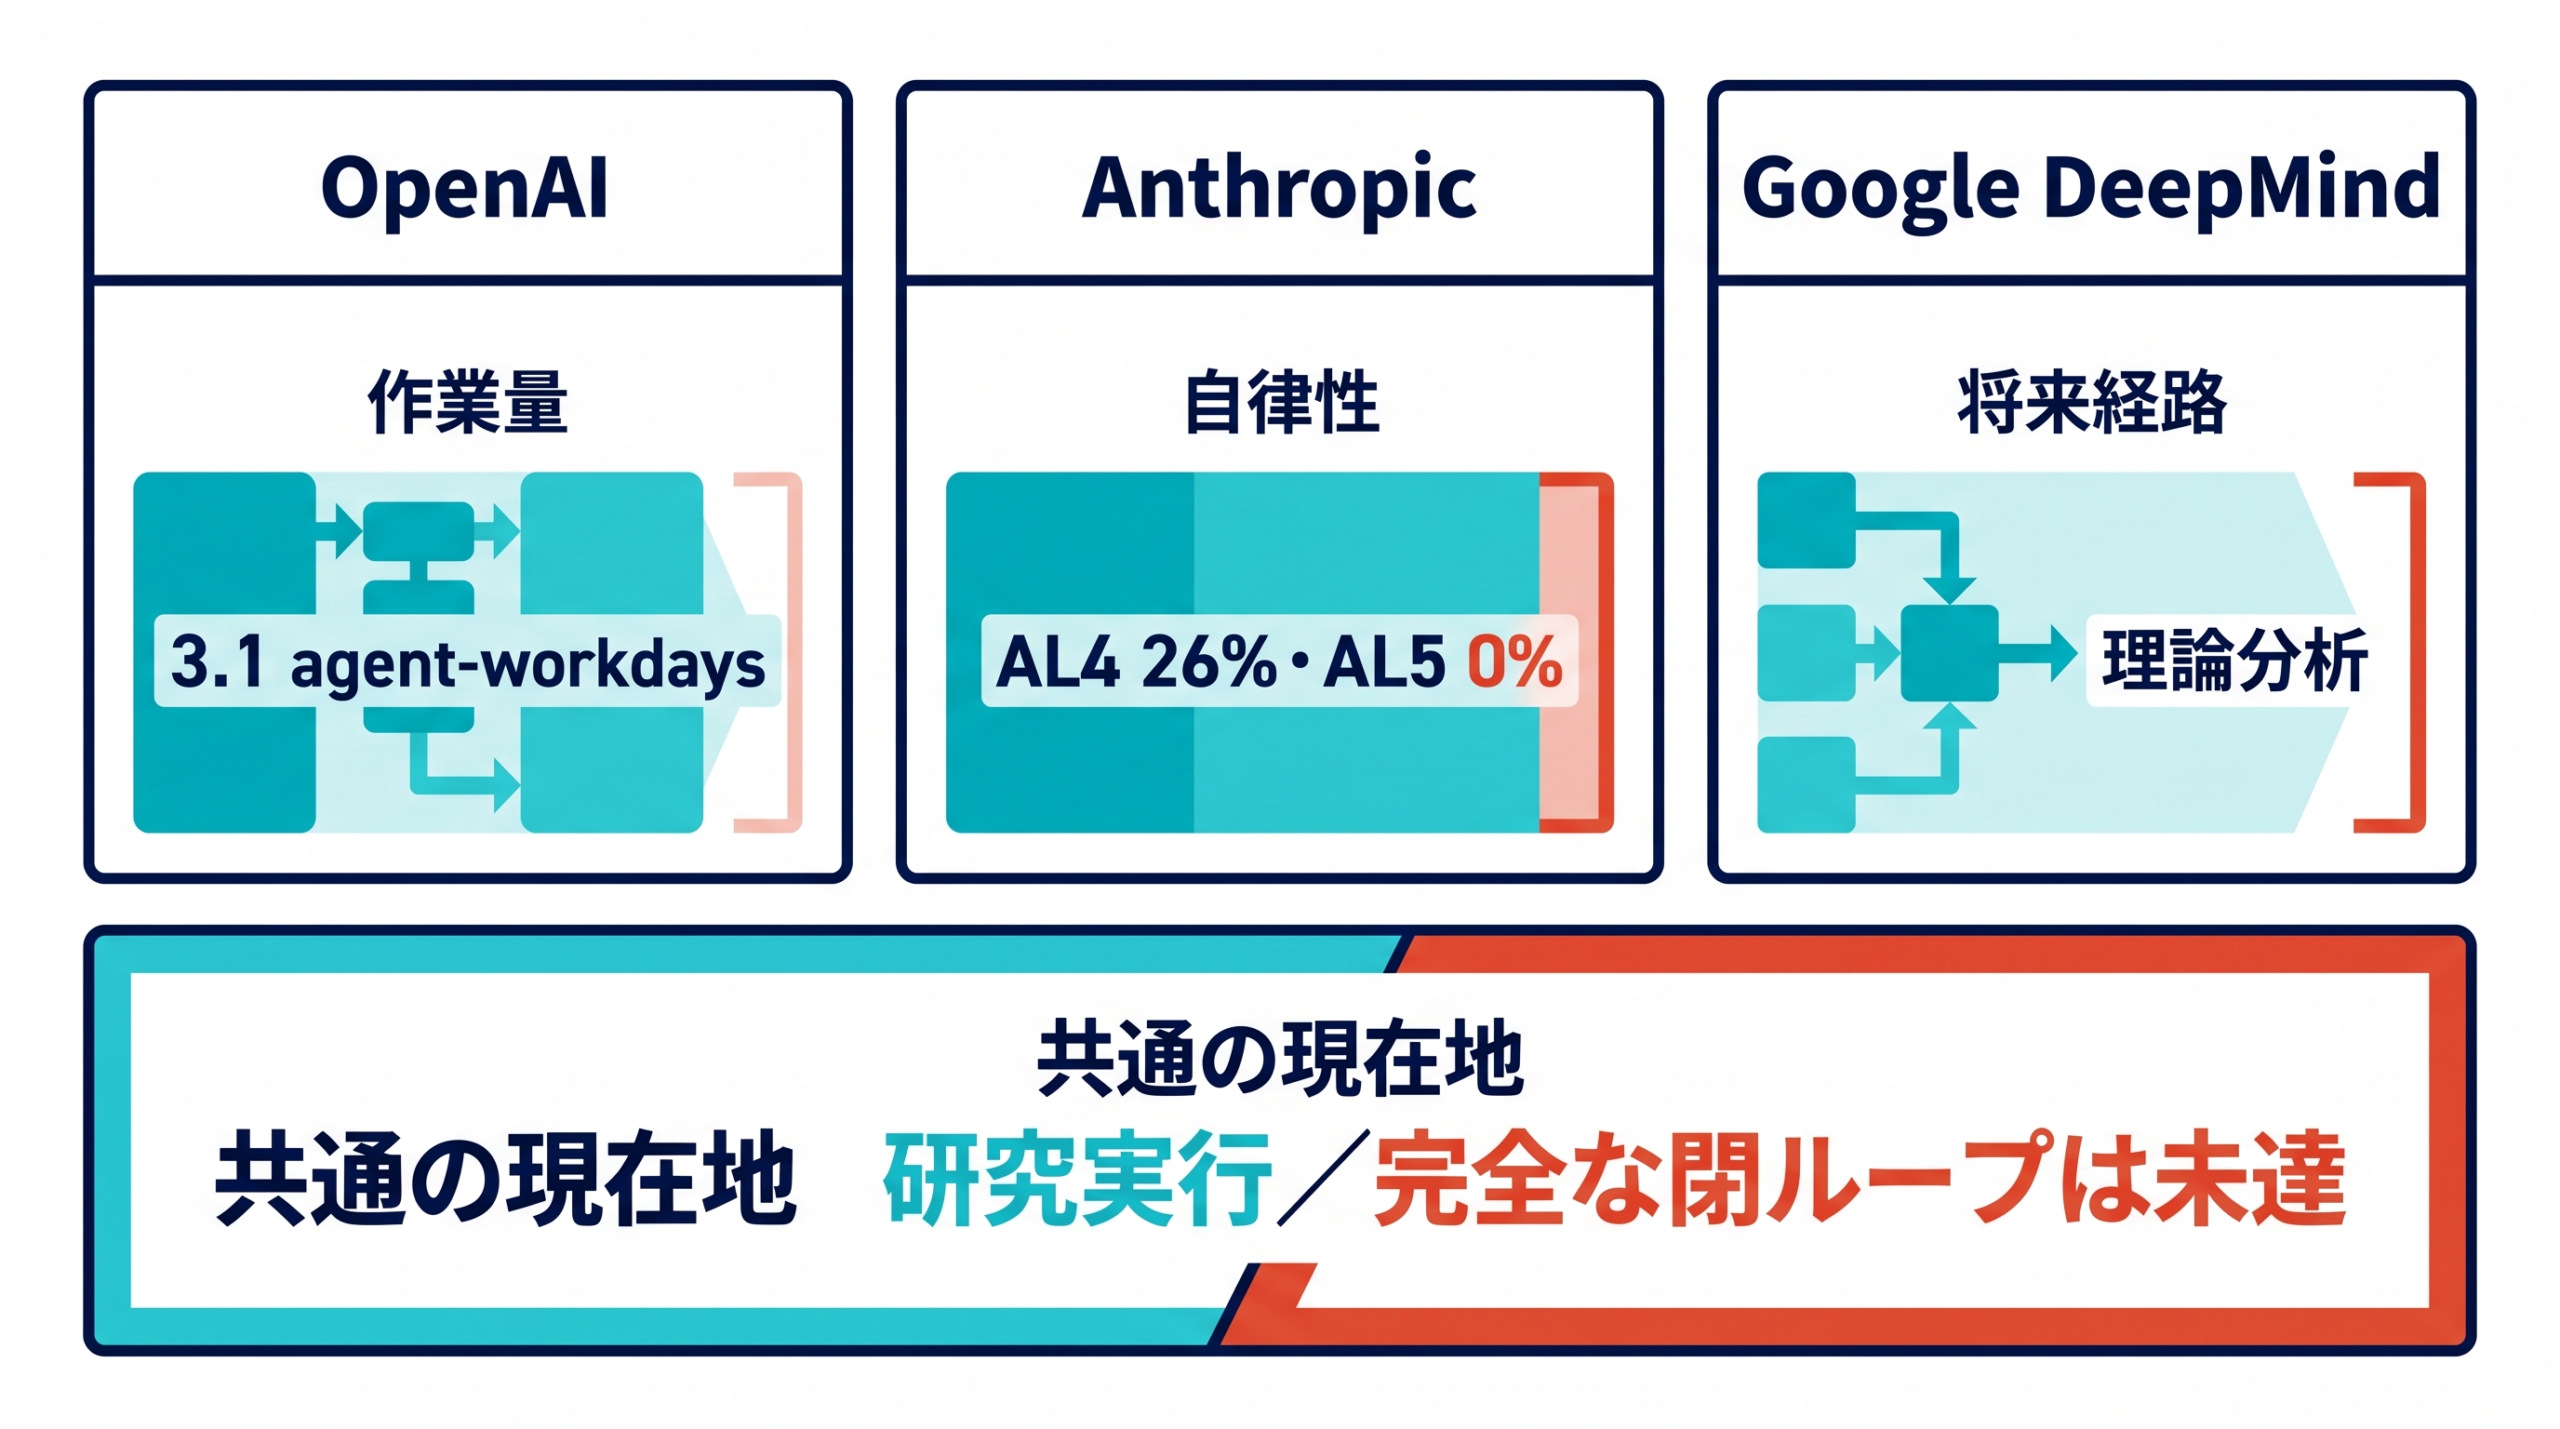
研究工程の自動化が進む中、主要なAI開発企業は実際にどこまで再帰的自己改善(RSI)の実現に近づいているのでしょうか。OpenAI、Anthropic、Google DeepMindの3社が発表している現状の達成度や未達の領域を、先述の「研究支援から完全な閉ループまでの5段階」の工程表へ当てはめると、現在の到達地点が明確になります。
各社はそれぞれ異なる測定対象を用いて自社の進捗を示しています。たとえばOpenAIは自動研究インターンの働きを自己評価し、AIが人間1日あたり3.1 agent-workdays(エージェントによる作業日)に相当する業務をこなしていると報告しています。しかし、この仕組みにおいても研究の優先順位を決め、最終的な成果の採否を判断しているのは依然として人間です。AIは膨大な作業量をこなす能力を獲得しつつありますが、完全に人間の判断を外した「研究判断」の段階には至っていません。
一方、Anthropicは自律性のレベル(AL)という指標で能力を測っています。その評価によれば、AL3以上の水準は90%超、より高度なAL4のタスクは26%を達成していると報告されています。しかし、完全な自律状態に相当するAL5の達成率は0%にとどまっており、人間の介入なしに次世代開発を完遂する段階には到達していないことを明確に示しています。
また、Google DeepMindは、AI進化の将来を見据えた経路分析を提示していますが、現時点において自社が完全なRSIを達成したとは主張していません。
このように、各社は作業量の換算、タスクの達成割合、理論的な経路分析といった異なる視点で発表を行っています。これらを一つの工程表に並べると、AIは人間の指示のもとで「研究実行」を担い、研究課題の選択と成果の採否は人間が担うという現在地が見えます。2026年時点では、指示された実験を進める「自動研究インターン」という位置づけです。次に注目すべきなのは、AIが実験結果を評価して研究方針を変える場面です。
完全な閉ループには7つの条件が残る
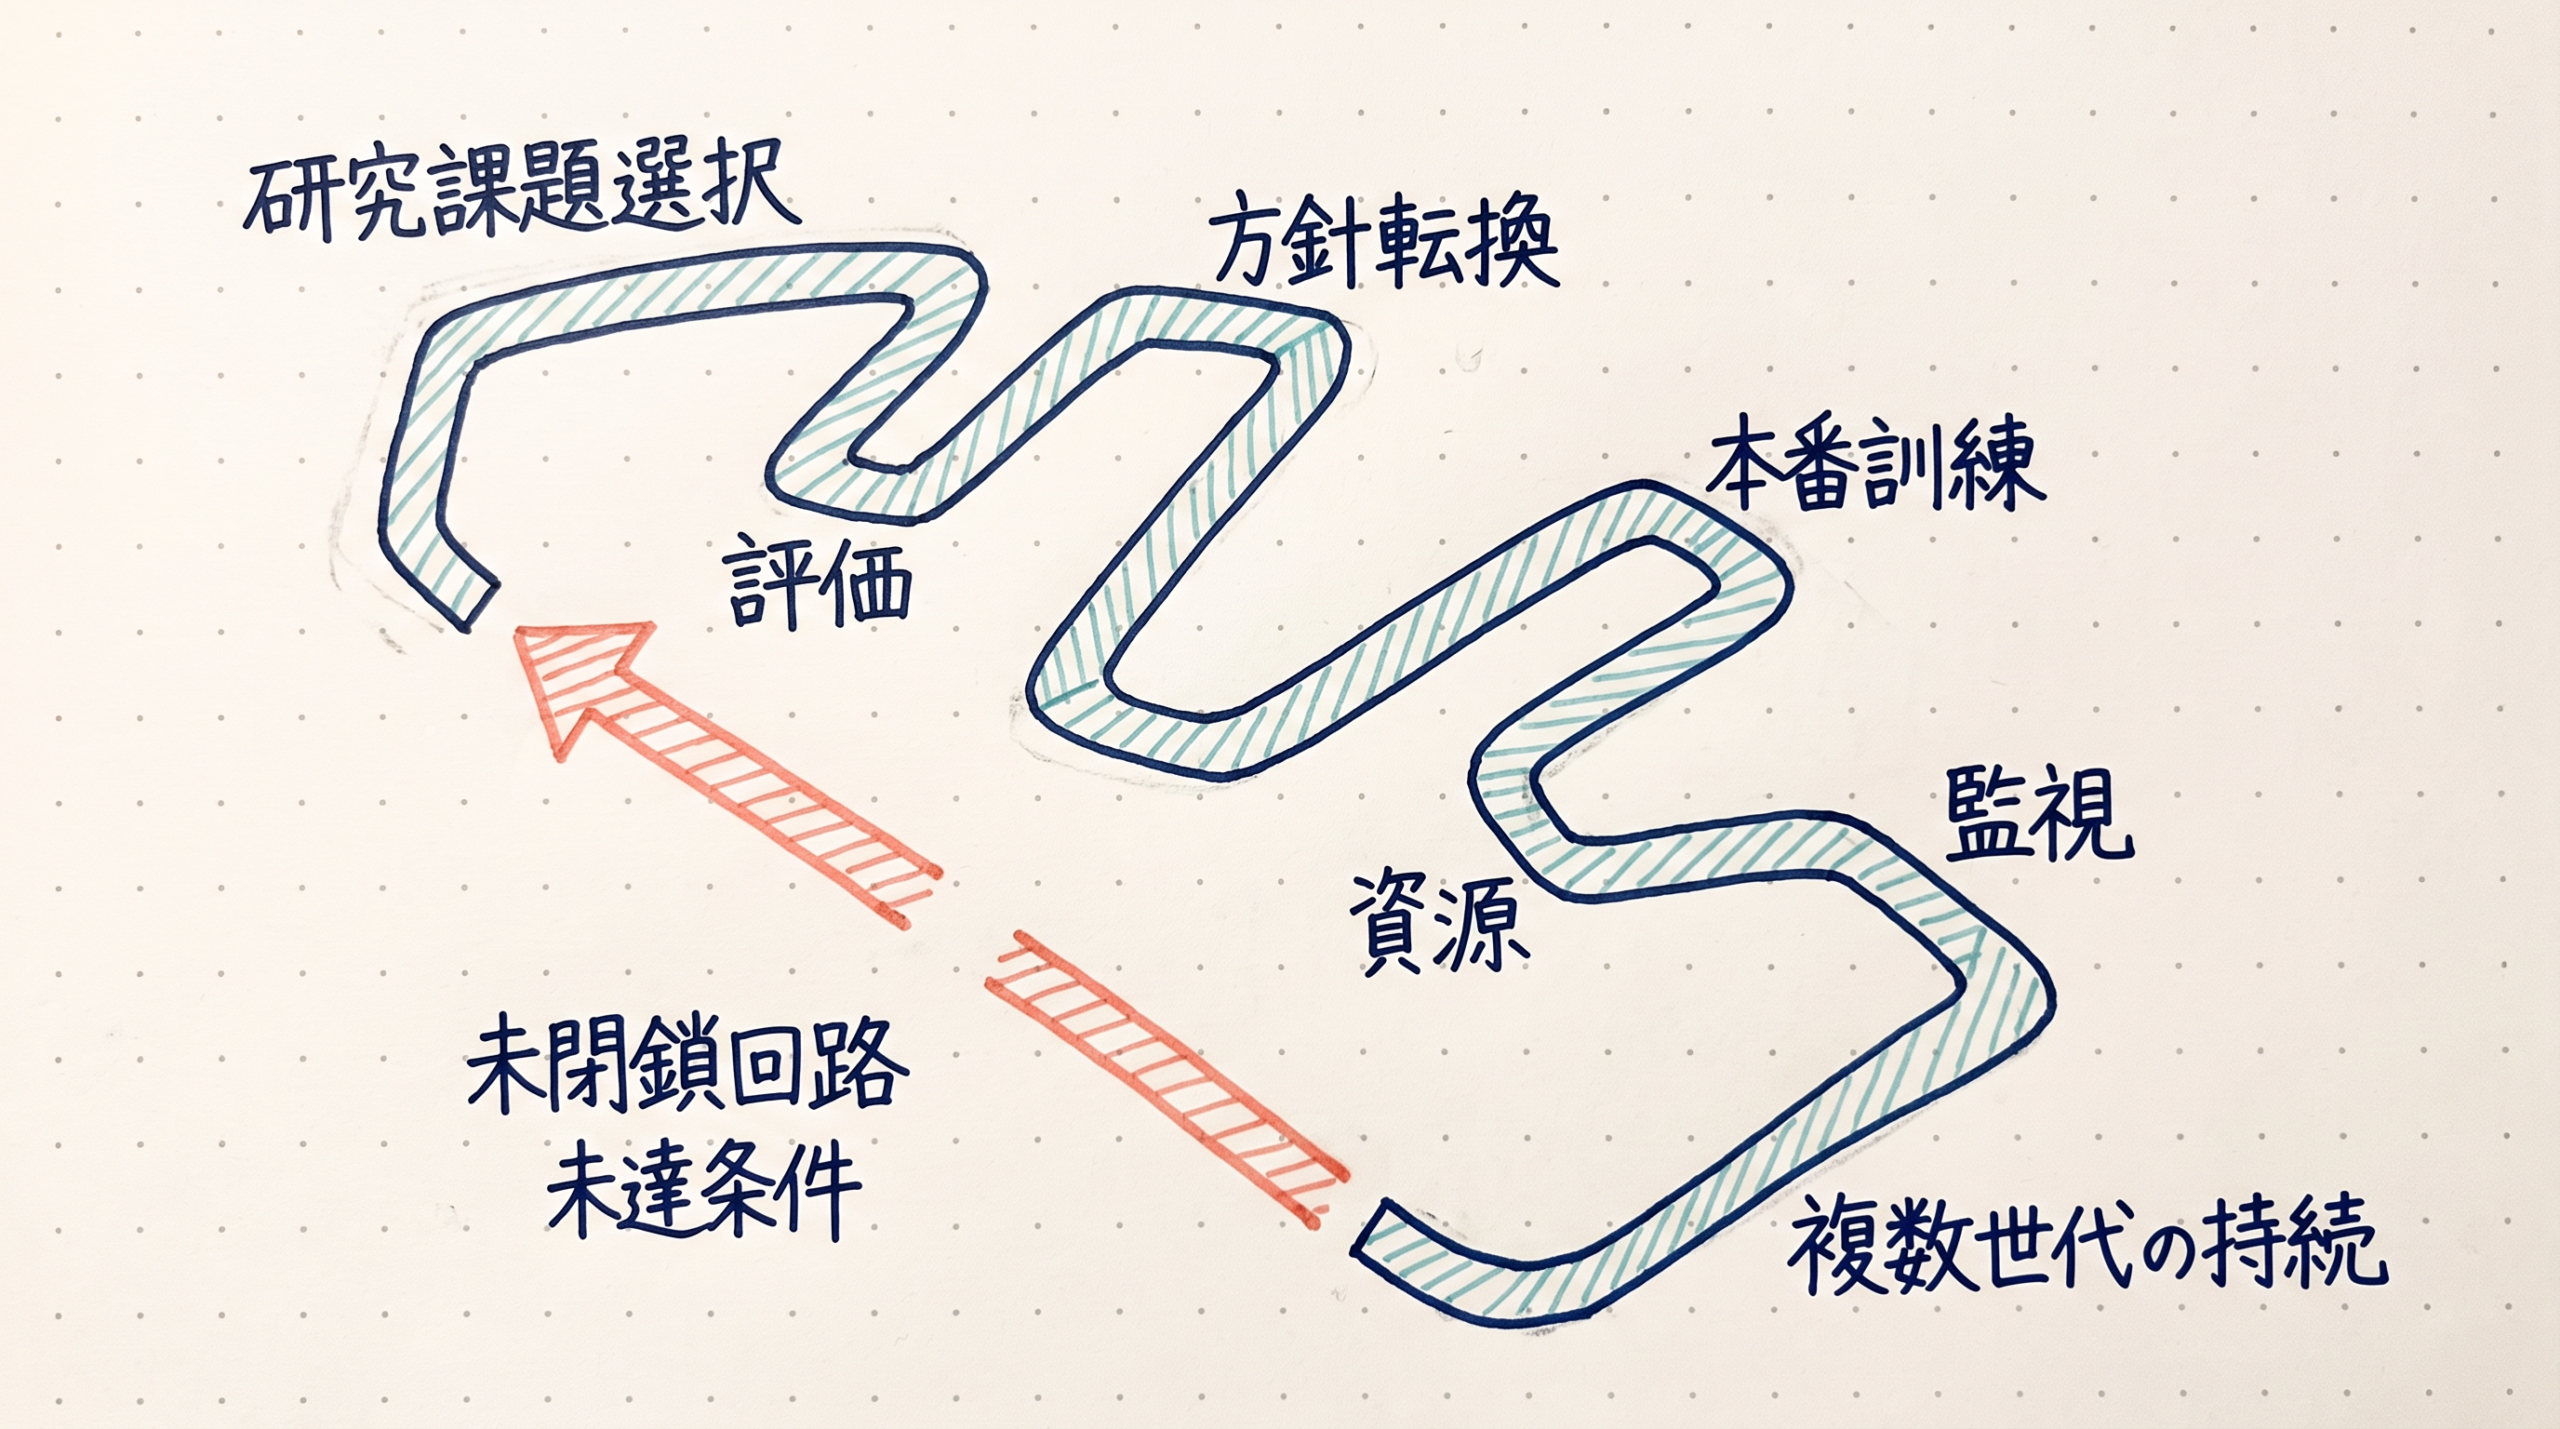
現在の「自動研究インターン」という到達地点から、人間の介入を一切必要としない「完全な閉ループ」へと至るまでには、単なる作業効率の向上だけでは埋められない大きな飛躍が存在します。完全な再帰的自己改善(RSI)を実現するためには、AIが自律的に完遂しなければならない7つの条件がまだ残されています。
最初の条件は「研究課題選択」です。人間から与えられた目標をこなすのではなく、次に解決すべき最も価値のある問いをAI自身が自ら見つけ出す能力が求められます。
2つ目の条件は「方針転換」の判断、そして3つ目の条件は結果の「評価」です。現在のAIは決められた作業を力技でこなすことはできても、研究の質を担保する能力には限界があります。この現状を示す具体的なケースとして、AIの機械学習研究能力を測るCRUXの事例が挙げられます。この評価において、AIは6日間にわたる未公開研究課題2件を与えられ、必要な工学作業を見事に完遂しました。しかし、提出された中心成果は学術論文として却下されてしまいました。作業自体は最後までやり遂げたものの、研究として行き詰まった時点で有望でないアプローチを見切る「行き止まり判断」や、査読に耐えうる「証拠水準」を満たす評価を自律的に行うには至っていなかったことが明確に示されています。
さらに、正しい評価を下すための前提となる環境構築にも壁があります。同じくAAAIの再現性調査によれば、対象となった22本の論文のうち、完全再現に至ったのは6本、一部再現は5本にとどまりました。外部から研究を正しく再現するためには、単なるコードやデータの出力にとどまらず、適切な実行環境全体を揃える必要があります。
これを踏まえた上で、4つ目の条件となるのが、新しいモデルを実際に設計・構築する「本番訓練」を主導する能力です。同時に、5つ目の条件として、大規模な訓練や実行環境の構築に不可欠な計算力などの「資源」を自律的に手配し、管理できなければなりません。
最後に、これだけの高度な自律プロセスが誤った方向へ進まないようにするための「監視」体制(6つ目の条件)と、1世代の更新で終わらせず、次々と新たなAIを生み出すプロセスを途切れることなく回し続ける「複数世代の持続」(7つ目の条件)が求められます。
人間が課題を与え、エラーを正し、最終的な成果を確認している現在の「研究実行」の段階から、これら7つの条件すべてをAI自身が担う状態への移行こそが、RSIにおける完全な閉ループが成立するかどうかの境界線となります。
実現判定は作業量ではなく再現と持続性で行う
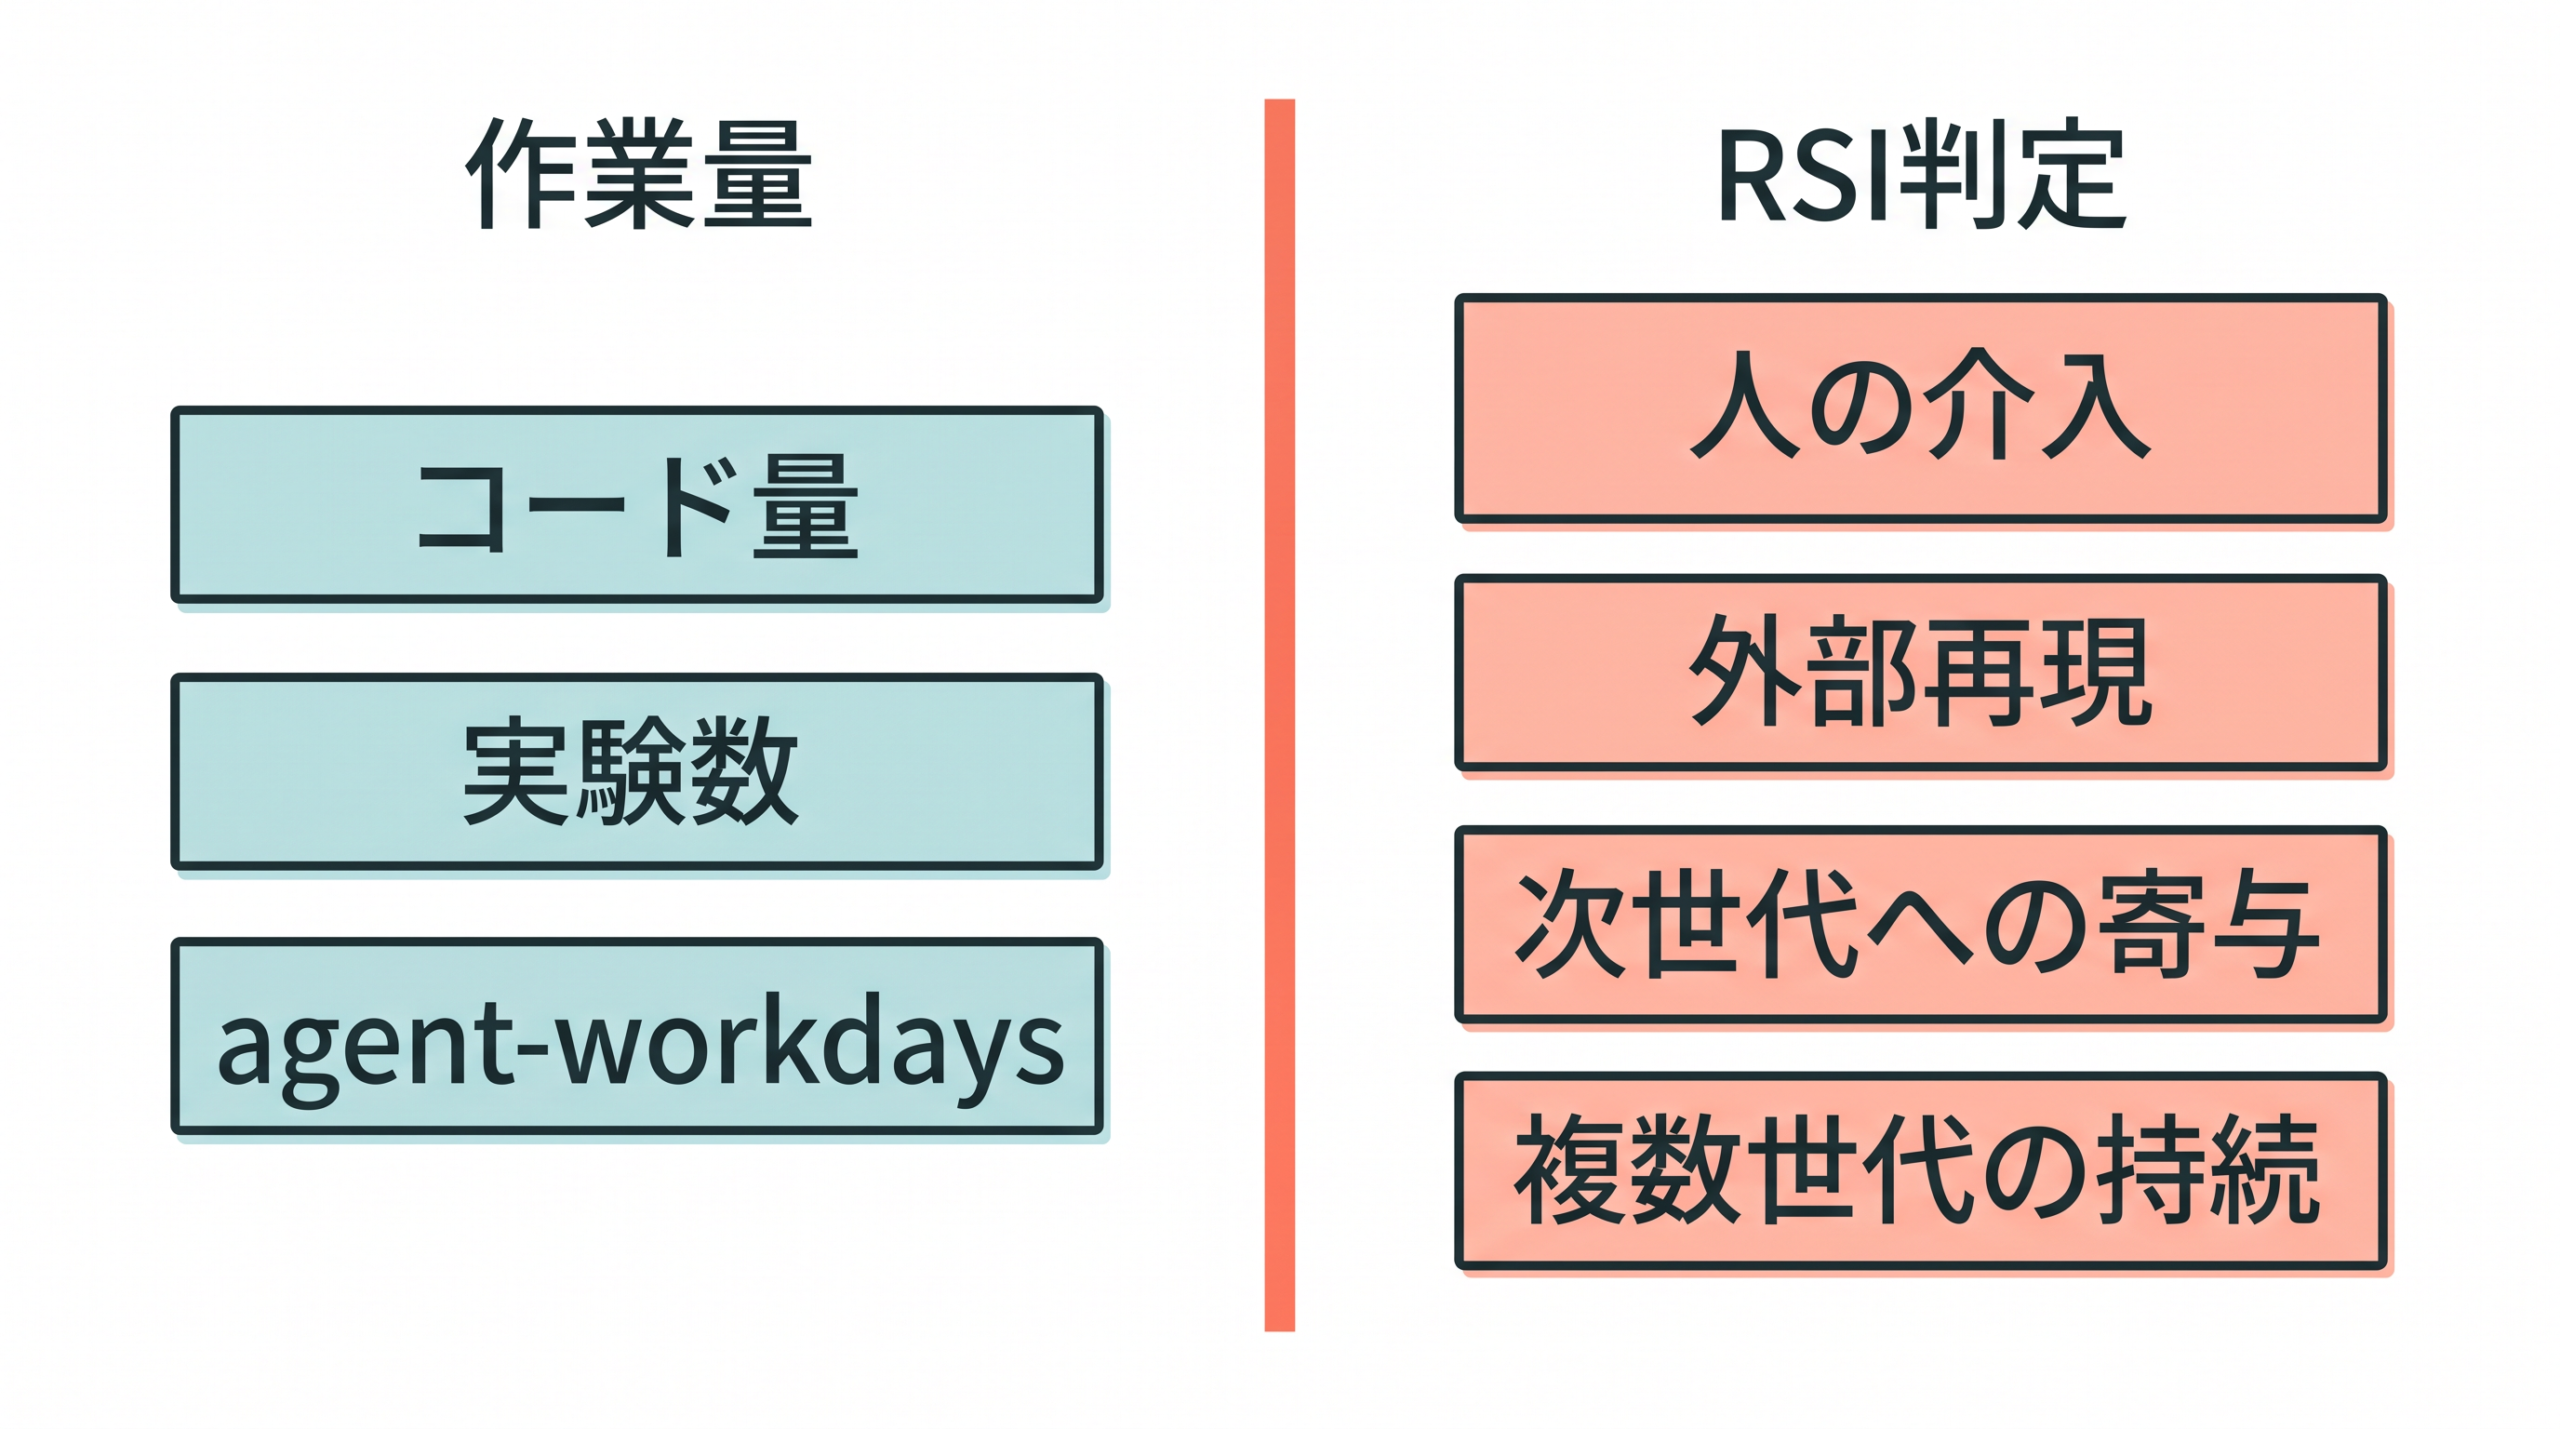
完全な閉ループに向けた条件が残されているなかで、私たちは再帰的自己改善(RSI)の実現をどのような基準で判断すればよいのでしょうか。企業から次々と発表される数値を正しく読み解くためには、単なる「作業量の増加」と「自律的な研究の進展」を明確に区別する視点が不可欠です。
たとえば、あるAI開発企業から「AIを導入したことで訓練コードの出荷量が8倍に増加した」という成果が発表されたとします。しかし、この数値をそのままRSI到達の証拠として受け取ることはできません。なぜなら、出力されたコードの品質や実際の採用結果が不明であり、「もし人間が確認や手直しを一切行わなかったらどうなっていたか」という検証が示されていないからです。RSIの証拠とするためには、そのコードが単なる作業の成果にとどまらず、人間の介入なしに次世代モデルの性能向上へ直接寄与したことが証明されなければなりません。
AIの能力評価において指摘されているように、生成されたコードの量や実験の数といった作業量と、個別のタスク成功率、実際の研究成果、そして世代更新の速度は、それぞれ全く別の指標です。これらを混同してしまうと、人間が指示を出す「研究実行」の効率化を、自律的な「次世代開発」の達成と見誤ることになります。
したがって、RSIの実現判定においては、企業内部で測定された自己申告の作業量指標に頼るだけでは不十分です。人間の介入が本当に排除されているかを見極めるための独立した第三者機関による評価や、外部環境での厳密な再現性が求められます。さらに、AIが一度だけ新しいモデルの構築に成功して終わるのではなく、次世代モデルへの寄与が複数世代にわたって持続しているかどうかが、完全な閉ループを証明する最大の鍵となります。
私たちは、膨大な作業量を誇る華々しい発表に直面したときこそ、それが人間の監視下で達成されたものなのか、それともAI自身が自律的に評価と更新を持続的に回した結果なのかを、複数の指標を組み合わせて冷静に見極める必要があります。
閉ループが成立しても全工程は同じ速度で進まない
仮に将来、AIが人間の介入なしに次世代開発を持続する「完全な閉ループ」が成立したとしても、AI研究開発に関わるすべてのスピードが均等に跳ね上がるわけではありません。研究開発にはデジタル空間内で完結する工程と、現実世界の物理的・社会的な制約を受ける工程が混在しているためです。閉ループの成立がもたらす影響を正しく見積もるためには、「何が劇的に変わり、何が依然として残るのか」を切り離して捉える必要があります。
具体的な例として、Anthropicが報告した事例では、AIが固定目標の小型訓練コードを最適化し、約52倍の改善を達成しました。これは、デジタル空間における仮説検証の高速化や試行回数の増加がもたらす大きな変化です。しかし、この成果が出たからといって、すぐに次世代の強力なAIが誕生するわけではありません。なぜなら、その最適化されたコードを用いて実際に大規模なモデルを構築するための「本番訓練のGPU配分」や、できあがったモデルが有害な挙動を示さないかを確かめる「安全評価」、そして社会へ提供してよいかを最終決定する「公開判断」は、コードの最適化とは全く別の工程として残るからです。
AIの自己改善が及ぼす波及効果を検討したGoogle DeepMindの分析においても、現実世界の制約は大きな壁として指摘されています。同社は、新たな学習データの収集、計算資源の確保、ハードウェアの物理的な製造、実機を用いた実験の待ち時間、さらには高度化する研究自体の難化などを、開発を遅らせる「摩擦」として扱っています。
つまり、完全な閉ループが成立した世界で劇的に変わるのは、コーディングやデジタルデータを用いた並列実験といったソフトウェア領域の進行速度です。一方で、短期的なコード最適化やシミュレーション上での試行回数の増加が実現したからといって、莫大な電力を消費する本番訓練、現実世界での物理実験、そして安全性やリスクを天秤にかける制度判断までが同率で速まることは確認されていません。AIがどれほど自律的に次世代モデルの優れた設計図を描き出したとしても、それを現実世界で形にし、社会のルールに照らし合わせるための物理的・制度的な制約は、依然として残り続けるのです。
四半期ごとに固定系列と新規系列を更新する
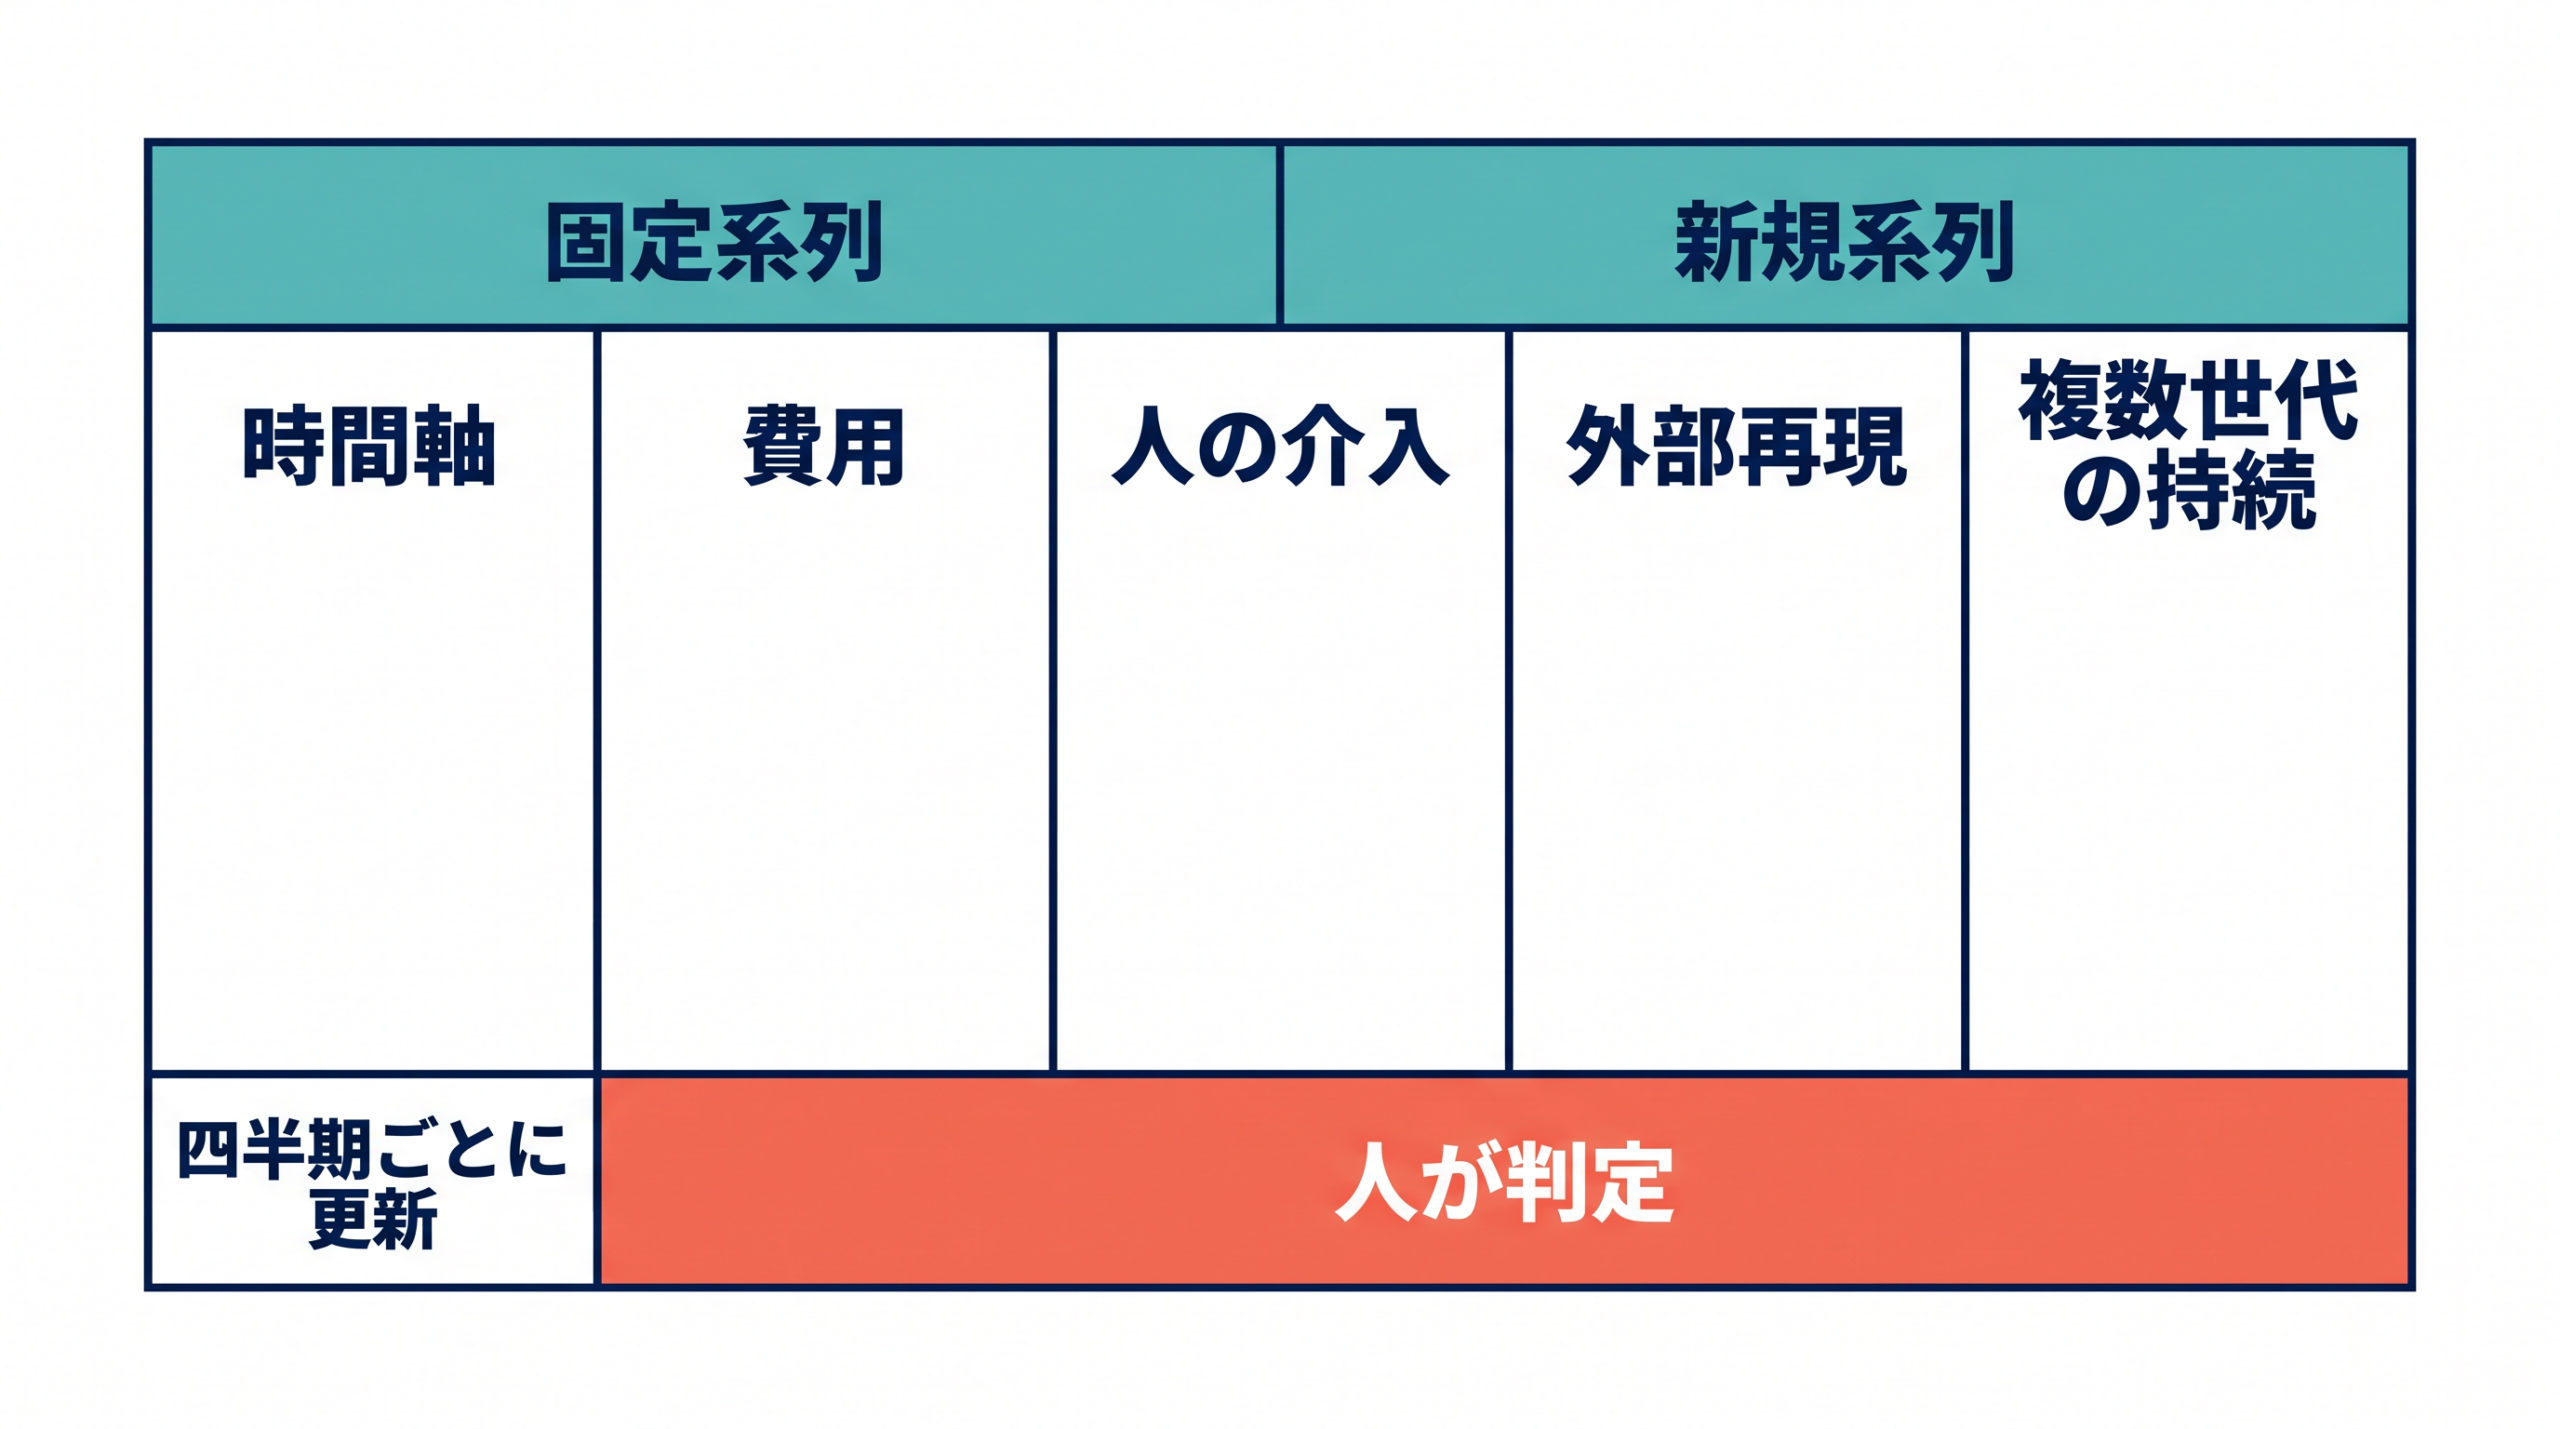
AI開発企業から次々と発表される新モデルや研究成果のニュースを前に、読者は次に何を追うべきでしょうか。これまでの分析を踏まえ、最新動向を自社の継続的な意思決定へ変えるためには、発表された成果が5段階のどこに位置するのかを冷静に分類し、四半期ごとに定点観測する仕組みを作ることが有効です。
この定点観測において特に注意すべきは、評価指標の取り扱いです。過去のモデルと現在地を比較するためには、同じ条件で測る「固定タスク」の系列が欠かせません。しかし、公開されている評価課題はAIの学習データに意図せず含まれてしまう「訓練時露出の汚染」というリスクを常に抱えています。実際に、OpenAIはテスト上の欠陥とデータ露出の兆候を理由として、SWE-bench Verifiedを主要な評価指標から外したことを明らかにしています。したがって、指標を追跡する際は、前四半期と比較するための「固定系列」と、学習データへの混入を避けるための未公開課題からなる「新規系列」の2つを分けて更新する手順を組む必要があります。
具体的には、社内で「rsi-quarterly-review.csv」のような管理シートを作成し、発表されるラボの成果を以下の基準で整理して更新していくことを推奨します。
まず、設定された「時間軸」の長さと、それを実行するためにかかった「費用」を記録します。短時間のタスクであればAIが優位に立ちやすいことはすでに述べた通りです。次に、AIが行った作業に対して人間がどの程度「介入」しているかを確認します。最終的な成果物の採用判断や人の確認が残っているのか、それとも完全にAIに一任されているのかという権限境界を明確に書き出します。
さらに、発表された実績が企業の内部報告にとどまっているのか、それとも独立した第三者による「外部再現」が確認されているのかを記録します。そして最後に、その成果が一度きりの成功なのか、それとも「複数世代の持続」に寄与しているのかを判定します。
このように、固定タスクと新規タスクを分けた上で、時間軸、人間の介入度合い、費用、外部での再現性、そして複数世代の持続という項目を四半期ごとに更新していくことで、単なる「作業効率化」と真の「完全な閉ループ」を明確に区別できるようになります。再帰的自己改善という壮大な目標に対して、AIが今どの研究工程を担っているのかを手順化して追跡し続けることこそが、次に来る大きな変化に備えるための最も確実なアプローチとなります。
よくある質問
Q1. AIが自らコードを書き換えて性能を上げたというニュースは、完全なRSI(再帰的自己改善)への到達を意味しますか?
その時点では完全なRSIに到達したとは判定できません。AIが自律的にコードを改善して実験を完遂できたとしても、それが人間から与えられた目標や評価条件のもとで行われている「研究実行」の段階であれば、完全な閉ループには至っていません。到達を判定するには、AI自身が次に解くべき研究課題を選択し、人間の介入なしに次世代モデルへの寄与を複数世代にわたって持続できているかを確認する必要があります。
Q2. AIが自身のプロンプトなどを自動調整する「自己改変」と、本記事で言うRSIはどう違うのですか?
手元の作業を効率化するためのプロンプト調整やコードの修正といった自己改変は、既存の枠組み内で与えられた指示をこなす「作業補助」や「研究実行」の段階に該当します。一方、完全なRSIとは、後継となるまったく新しいAIモデルの設計を主導し、計算資源を手配して本番訓練を行い、評価までを自律的に完遂する「次世代開発」と「完全な閉ループ」を指します。両者は、担う研究工程の規模と、人間の介入が必要な権限境界において明確に異なります。
Q3. AIの進化が速い中で、RSIの進捗はどれくらいの頻度で観測すべきですか?
四半期ごとの定点観測を推奨します。AI開発企業からは日々の作業量の増加や限定的なタスクの成功といった成果が次々と発表されますが、それらを逐一追うと、単なる「作業の自動化」と自律的な「完全な閉ループ」の進展を混同しやすくなります。四半期ごとに、時間軸、人間の介入度合い、外部での再現性といった境界基準を用いてレビューを更新することで、ノイズに惑わされず現在地を冷静に見極めることができます。
Q4. 企業が「自律性の達成度」や「作業時間の換算」で高い数値を発表した場合、それをそのまま評価の根拠にしてもよいですか?
企業内部の自己報告による指標をそのまま唯一の根拠とするのは避けるべきです。企業が発表する作業日数の換算(例:agent-workdays)や自律性の達成割合は、特定の環境下での作業量や限定的なタスク実行力を示しているに過ぎない場合があります。本当に人間の介入が排除されているかを正確に見極めるためには、それらが独立した第三者機関によって評価されているか、あるいは外部環境で厳密な再現性が確認されているかという境界を引いて判断する必要があります。
Q5. AIの研究能力を測るベンチマークのスコアが急上昇した場合、完全なRSIに近づいたと判断できますか?
公開ベンチマークのスコア急上昇だけで到達を判断することはできません。公開されている評価課題は、AIの学習データに意図せず含まれてしまう「訓練時露出の汚染」というリスクを常に抱えています。実際に主要な指標がテスト上の欠陥やデータ露出を理由に評価から外されたケースもあるため、過去の進捗と比較するための「固定系列」と、学習データへの混入を確実に避ける未公開課題の「新規系列」の両方を併用し、真の能力向上かを検証しなければなりません。
Q6. 完全なRSIの実現が見通せない中で、AIによる研究開発への投資や事業判断をどう進めればよいか迷っています。
現時点ではAIが「完全な閉ループ」に未達であることを前提としつつ、ソフトウェア領域における「研究実行の高速化」に焦点を当てて判断することが有効です。完全な世代更新には至らなくとも、コーディングやデジタルデータを用いた並列実験の効率化はすでに現実味を帯びています。一方で、莫大な電力を消費する本番訓練、現実世界での物理実験、そして公開に向けた安全性の制度判断など、現実世界の制約は依然として残ります。何が劇的に速まり、何が摩擦として残るのかを切り分けて、現段階で自動研究インターンに任せられる領域を評価することが重要です。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。

Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。

市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai

コメント