AIエージェントに複雑で時間のかかる調査やシステム操作を任せる場合、一度の指示で終わらない作業をどのように管理するかが課題となります。Y Combinatorが開催するFall 2026の参加組織からは、この課題に対する具体的な設計方針が見えてきます。開催途中の2026年10月17日時点で公開されている146組織のうち、独自に事業内容を分類した結果では、AIを製品やサービスに使う組織が68、AI向けの基盤やデータを提供する組織が46、AIの用途を確認できない組織が32でした。
AIが自律的に複数の手順をこなす技術が普及するなかで、事業会社がそれらを実業務へ安全に導入するには、作業の進行状況や実行環境を適切に管理する必要があります。本記事では、「AI事業は何を保存し、誰の環境で、どの条件で作業を再開して実行するのか」という問いを掘り下げます。本番環境の保護や、個人の端末内での処理、そして例外が発生した際に途中経過と権限の判断を人間へ引き継ぐワークフローを通じ、AIの作業を確実につなぐためのシステム設計と運用手順を解説します。
作業環境を残すことと、続きを判断できることを分ける
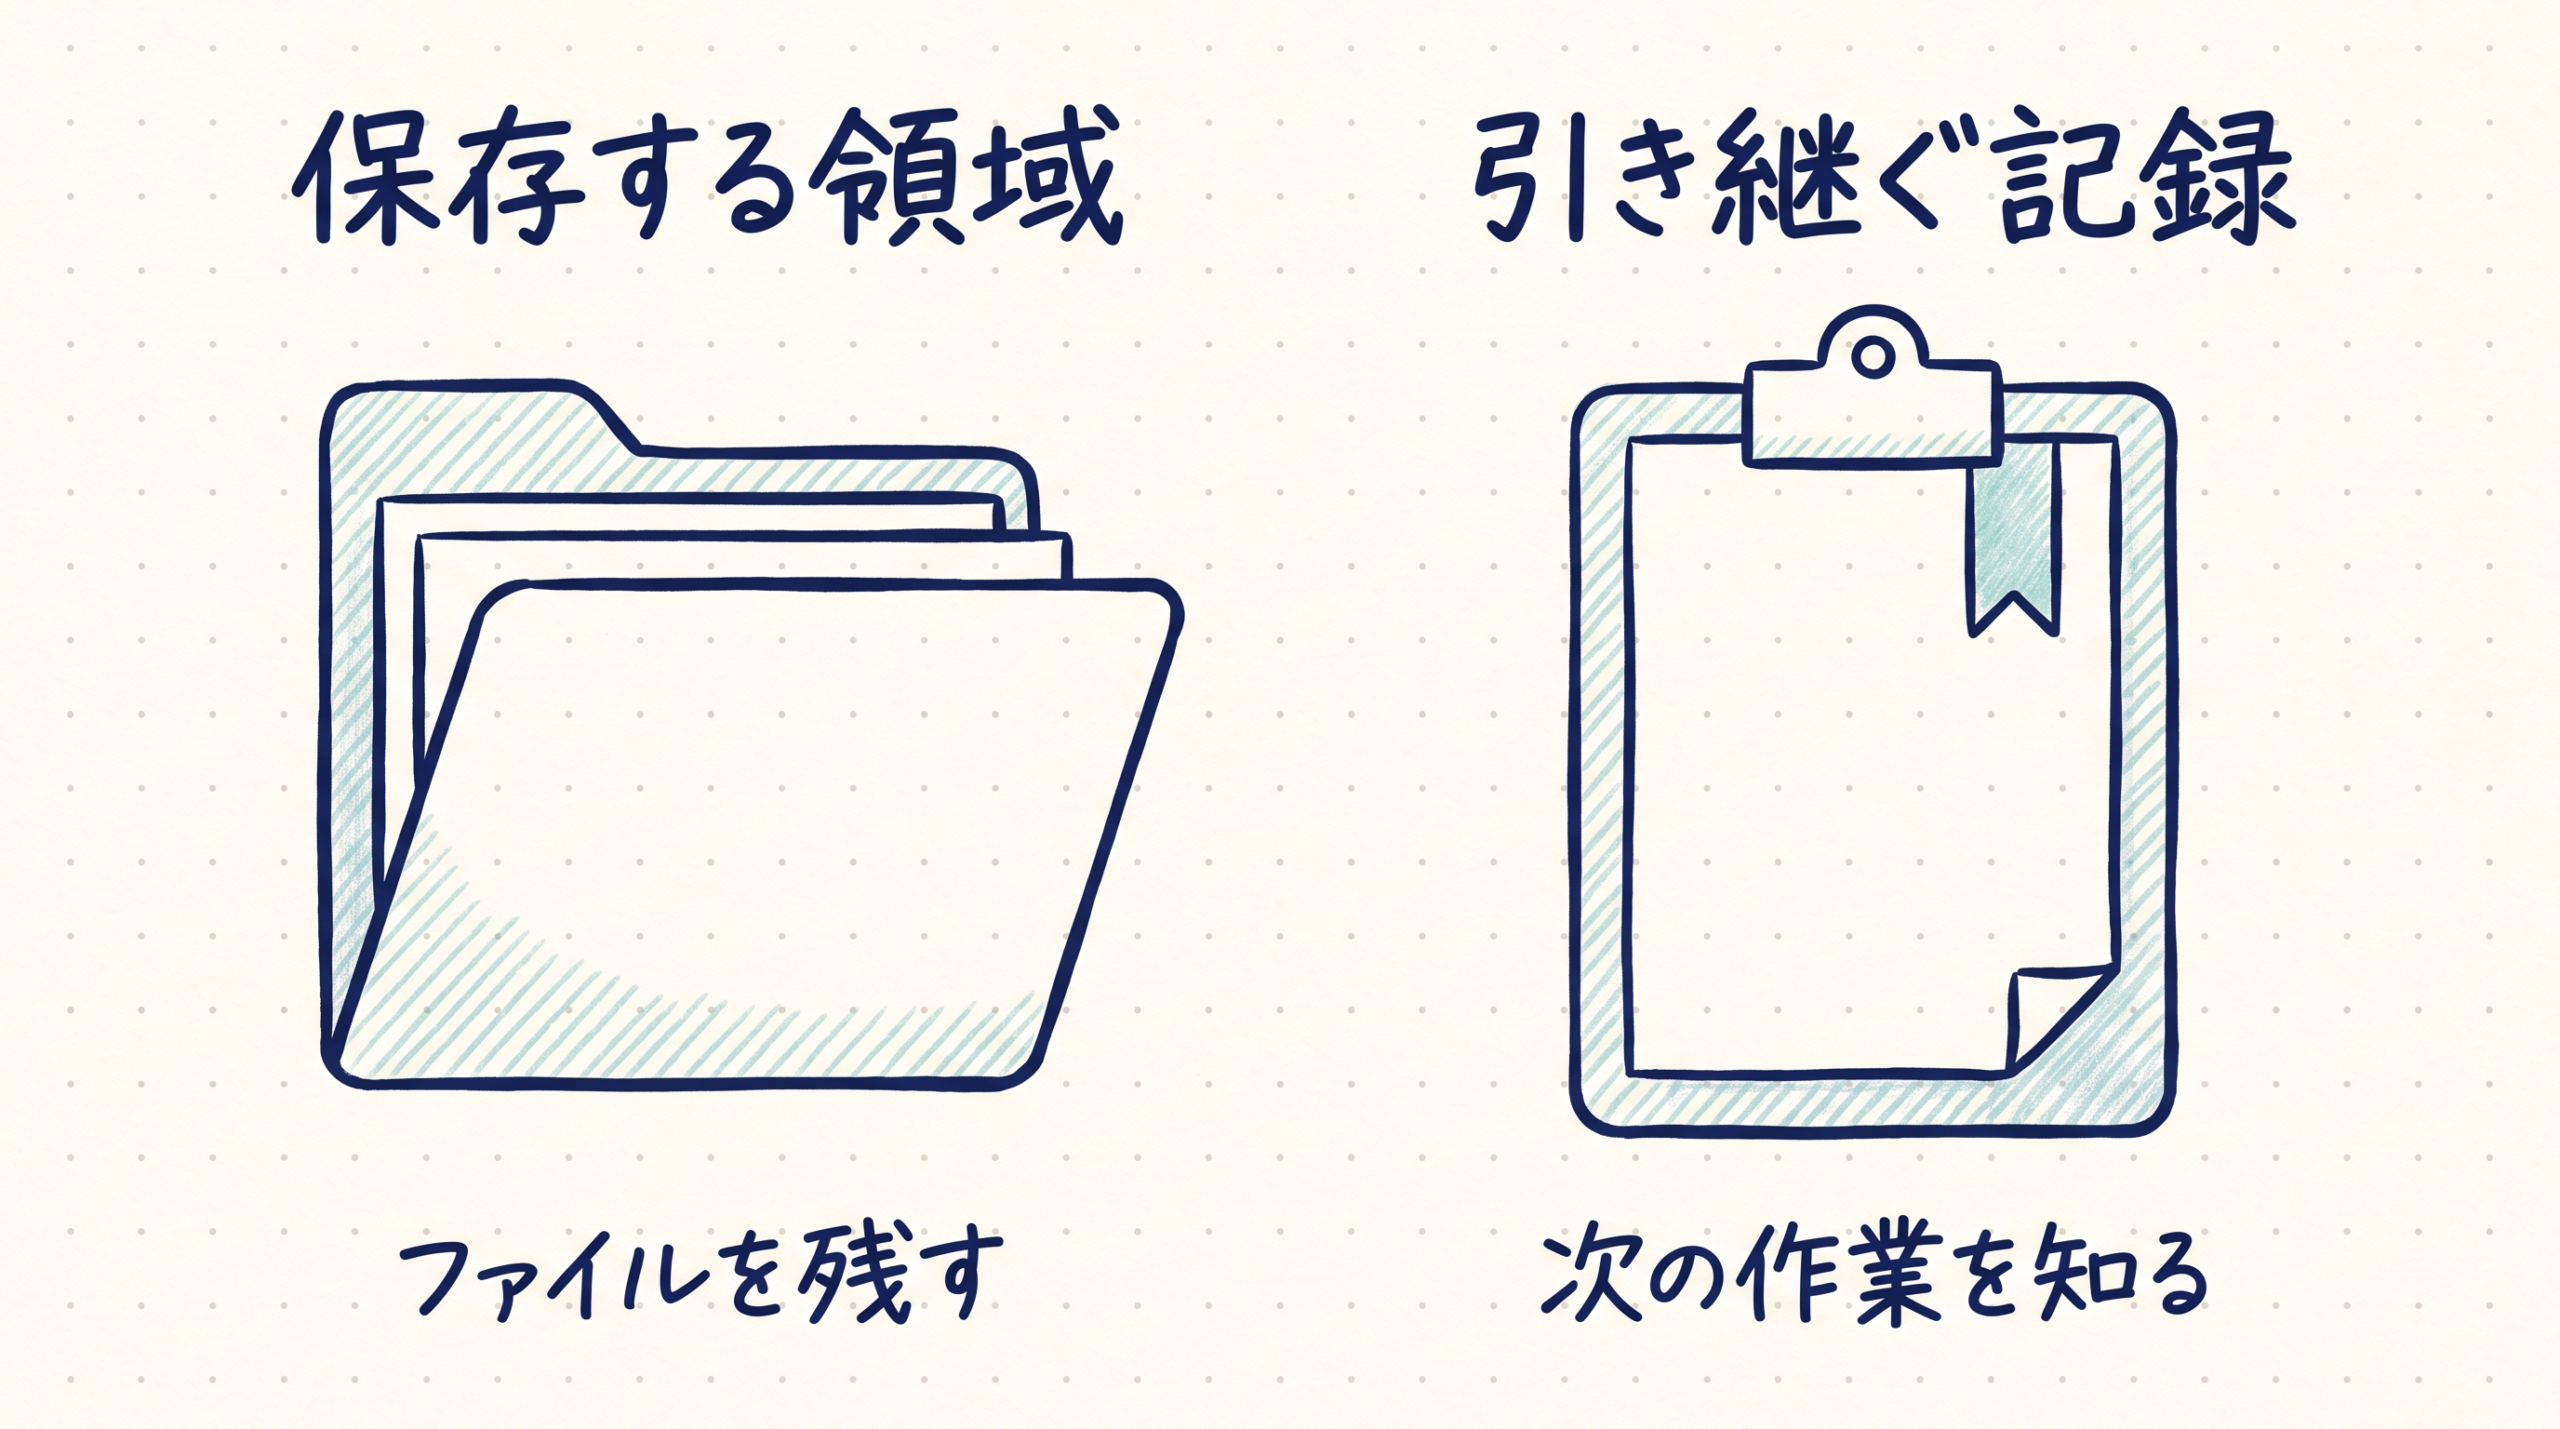
AIエージェントに複雑で時間のかかる調査やシステム開発を任せる場合、モデルが一度に処理できる情報量(コンテキストウィンドウ)の制限を越えて作業を続ける仕組みが必要です。ここで注意すべきは、ファイルやツールの「作業環境が保存されていること」と、AIが「どこまで作業が終わり、次に何をするべきか判断できること」は別の問題であるという点です。
まず、インフラストラクチャとしての作業環境の保存について、YC Fall 2026の参加企業からはエージェント専用のクラウド環境を提供するサービスが登場しています。タスクごとに破棄される一時的な環境ではなく、BoatやAgent 37のように、AIがいつでも戻って作業を続けられる仮想マシンやサンドボックスを提供する事業が起きています。
たとえばMaritimeは、AIエージェントごとに独立した実行環境を割り当て、待機時間にはプロセスをスナップショットとして保存して休止させます。APIやチャットから通信があった際に復元して実行を再開するため、計算資源の待機コストを抑えることができます。ただし、保存される対象には境界があります。多くの実行用テンプレートにおいて、再起動や再展開を越えてファイルが維持されるのは指定された永続領域(/dataディレクトリなど)であり、その外側のOS環境などは使い捨てとして扱われます。休止時のプロセスの状態保持と、ファイルの永続的な保存範囲を混同せずにシステムを設計する必要があります。
そして、環境やファイルが物理的に残っていても、新しく作業を再開するAIのモデルは、前回の実行内容を自動で正確に記憶しているわけではありません。交代でシフトに入る担当者が、前任者の頭の中を知らないのと同じです。そのため、AIが続きを正しく判断するための引き継ぎ手順を用意する必要があります。
Anthropicが公開したソフトウェア開発の実験における長時間稼働するエージェントの実証事例では、役割を分けて引き継ぎを行う設計例が示されています。最初の作業を担当するAIは、利用者の指示を分解して機能要件を定義したJSONファイル、進捗を記録するテキストファイル、検証用の起動スクリプトなどを作成して環境の基礎を作ります。
その後、別のセッションとして起動したAIは、すぐに新しいコードを書き始めません。まず進捗ファイルとGitによる変更履歴を読み込んで状況を把握します。次に、引き継がれたスクリプトを使ってローカルサーバーを起動し、ブラウザ操作ツールで既存の機能が壊れていないかをテストします。その確認を終えてから、要件ファイルにある未完了のタスクに一つだけ取り組みます。作業終了時には、次のセッションのために明確なコミット履歴と進捗ログを残します。
自社の業務に自律型AIを導入する場合、専用の仮想マシンサービスを利用するなど、実行環境を保存して待機させる手段は整いつつあります。しかし、それを実業務で活かすには、AIが迷わずに作業を再開できるよう、進捗状況の記録フォーマットや再開時のテスト手順をシステム側のワークフローとして明示的に組み込む必要があります。
本番の状態を再現し、改善案を人が選ぶ
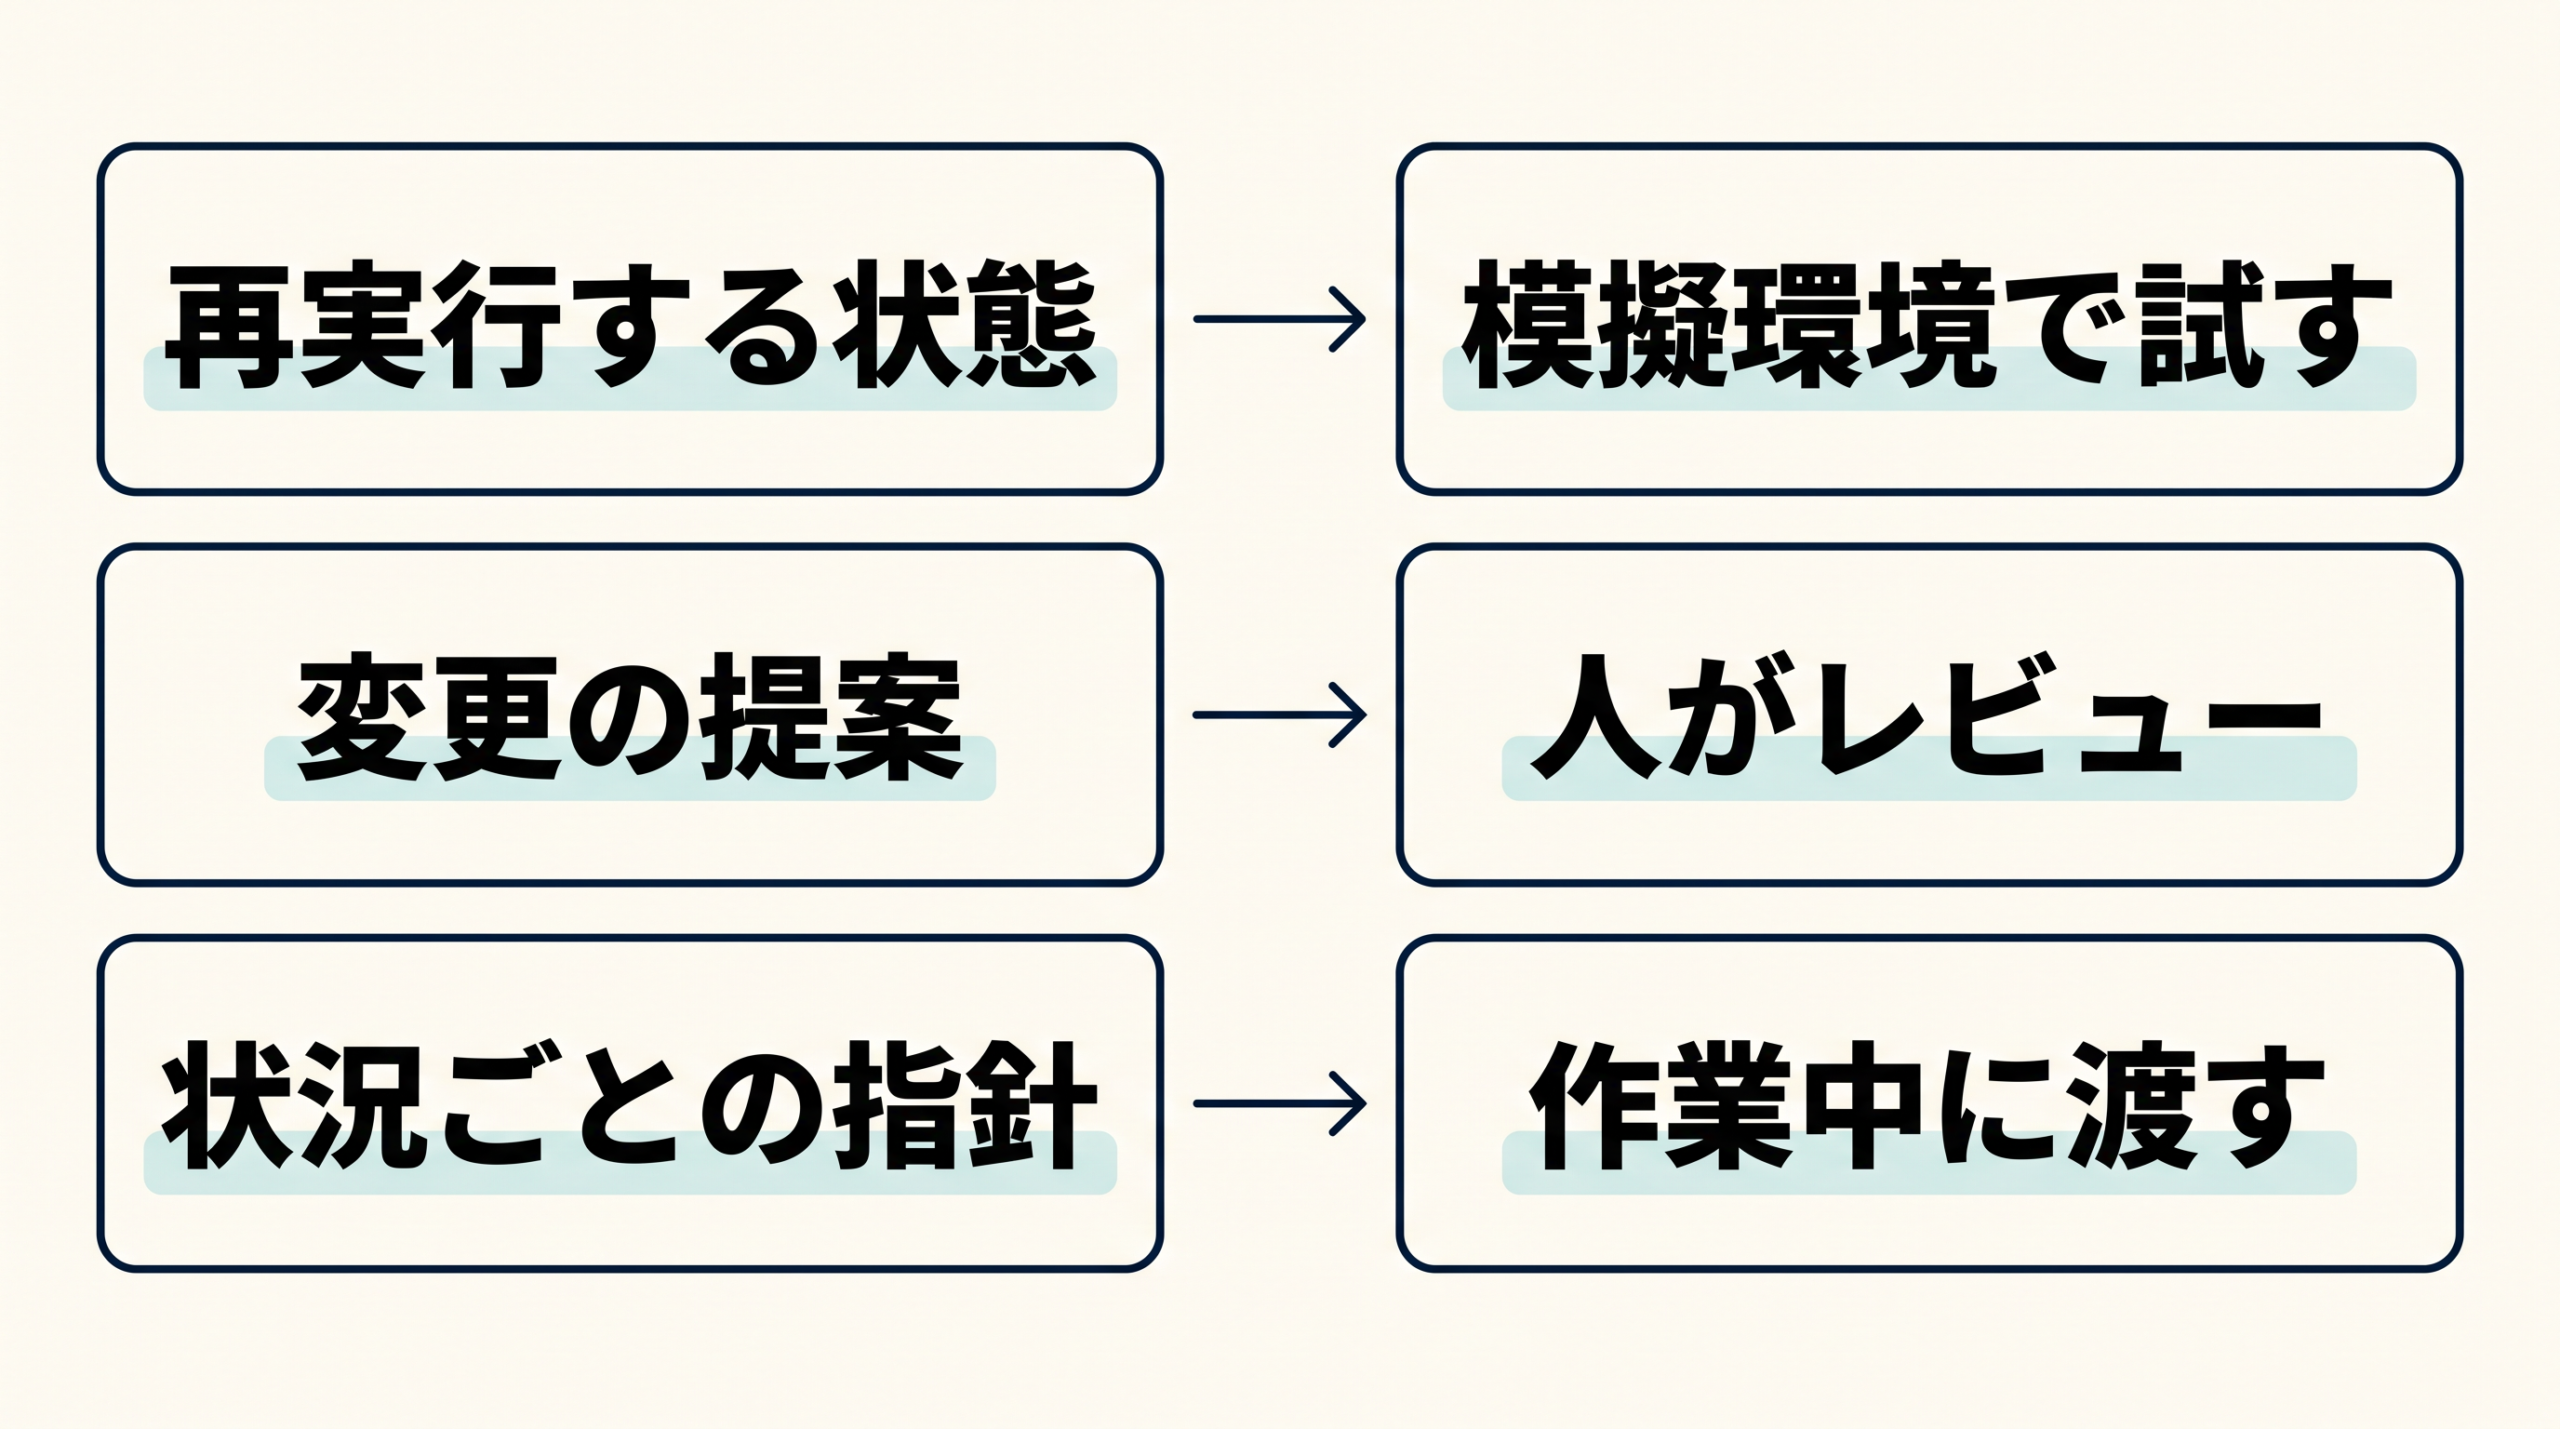
AIエージェントを本番環境で運用し始めると、失敗したタスクを後から修正し、正しく動作するか再確認する作業が発生します。ここで重要になるのは、本番の複雑な状態を「テスト環境として再現すること」と、AIの挙動を修正する「改善案を人が確認して適用すること」の権限と手順を明確に分けることです。
本番環境で起きた例外や失敗を修正するためには、当時の状況を再現してエージェントを再実行する必要があります。しかし、本番環境のデータベースや外部ツールの状態は常に変化しているため、そのまま再実行すると別のデータが書き換わるなどの意図しない副作用が生じる恐れがあります。
この課題に対して、Hueは本番環境での利用履歴から、当時のツールやデータ、状態を保持したテスト環境を構築するサービスを提供しています。これは実際のユーザーからの要求を、繰り返し実行可能なテストケースに変換するものです。実行のたびに独立した状態を持つ環境が割り当てられ、模擬的なAPIやMCP(AIと外部のデータやツールをつなぐ接続方式)を用いて作業を再実行します。同社はこれを本番環境に似た条件でのテストと位置づけていますが、外部のSaaSなどあらゆる連携サービスの全挙動が完全に再構築されることを保証するものではなく、当時の入力やツールの反応を模倣して、安全にエージェントの性能を評価・比較するための仕組みとして機能します。
一方で、本番のトレース(実行記録)から失敗の原因を特定し、エージェントの実装を修正するプロセスも、システムの分析と人の判断に切り分けられています。
Papayaはエージェントのトレースとコードを継続的に分析し、コンテキストの肥大化や無駄なリトライ、過剰なツール呼び出しなどを特定して、品質や処理遅延、コストの改善案を提示する最適化エンジンです。ここで注目すべき点は、システムが本番環境へ直接修正を反映するのではなく、提示された改善案を人が承認することで初めてソースコードに対する変更提案(プルリクエスト)として出力されることです。自動マージと本番反映が保証されるわけではなく、開発者は提案内容と根拠となるトレースを確認した上で、システムへ組み込むかを決定します。
また、Mirrorsも過去の実行履歴から失敗のパターンを見つけ出しますが、すべての例外対応をシステム全体のプロンプトへ直接書き込むことはしません。代わりに特定の状況にのみ適用されるガイダンスを作成し、エンジニアがそれを事前にレビューした上で、エージェントが該当の作業を行う適切なタイミングでのみ提供する仕組みをとっています。
自社でAIエージェントの継続的な運用体制を組む際は、システムが自律的にコードやプロンプトを書き換える状態を避ける必要があります。たとえば、社内業務を代行するエージェントが未知のエラーを起こして停止した場合、その際の入力とツールの状態をHueのような仕組みで独立したテスト環境に保存します。次にPapayaのようなツールが「過去の類似処理と併せて不要なコンテキストを削除する」といった改善案をプルリクエストとして提示します。担当者がそのコード変更をレビューして承認し、保存しておいたテスト環境で再実行して挙動の改善を確認してから、初めて本番環境へデプロイします。このように、本番の状態の保存と模擬環境での再実行、そして改善案に対する人による承認を分けることで、AIエージェントの改善案を採用するか判断できます。
端末での下書きと、外部への実行を分ける
AIエージェントが個人の業務文脈を深く理解して作業を代行するには、日常的なメールやファイルの内容を読み取り、文脈を更新する必要があります。このとき、大量の業務データや個人情報をどこに保存し、どのような権限で外部システムを操作させるのかという実行条件の切り分けが重要になります。
YC Fall 2026に参加するSentient OSは、利用者の端末(Mac)で動作し、業務の文脈をローカル環境へ保存するAIアシスタントです。毎晩、メールやメッセージ、カレンダー、ファイルなどを読み込み、個人のナレッジベース(知識をまとめたファイル群)として情報を整理します。整理した情報の管理用ファイルはクラウド上のサーバーではなく、利用者のMac内にあるテキストファイルとして保存されます。そのため、利用者はAIが何を記憶しているかを直接確認し、編集や削除を行うことができます。
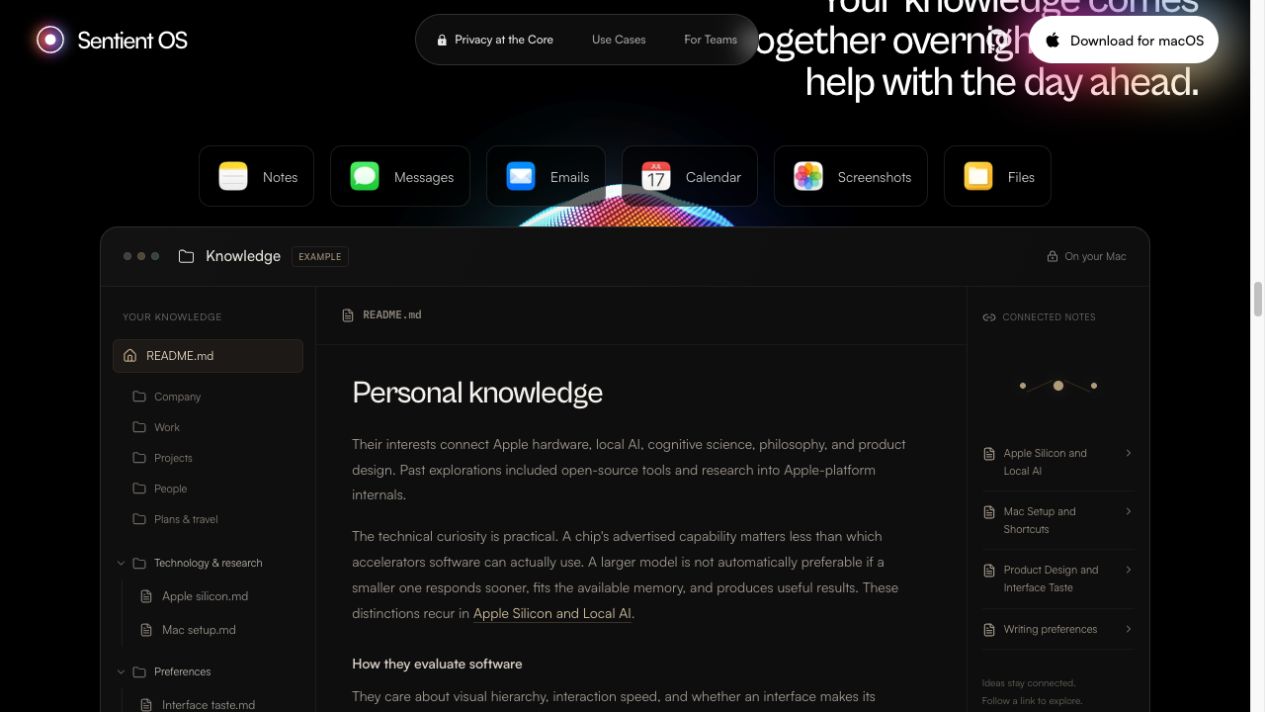
このシステムの特徴は、情報の整理や提案といった「下書きの準備」と、他者へのメッセージ送信や外部サービスへの入力といった「外部への実行」が明確に分けられていることです。AIは夜間のうちに最新の文脈を把握し、翌朝には「返信を忘れているメールの返答案」や「不要な定期購読のキャンセル」といった提案を準備して待機します。準備された下書きや提案は、利用者が内容を確認してクリックするまでは、外部へ送信されたり操作されたりすることはありません。
また、Sidekickと呼ばれる機能では、利用者が作業中に「この続きをやって」と指示を出すと、AIが専用のカーソルで必要なクリックや文字入力を進めます。これもAIが自律的に動き出すのではなく、利用者が現在の画面を起点に明示的に仕事を渡すことで初めて実行条件が満たされます。
クラウドAI利用時の処理の解説によれば、この仕組みはすべての処理が端末内で完結するわけではありません。ChatGPTやClaudeなどのクラウドAIを利用する設定を選んだ場合、機能に合わせて要約データや画面キャプチャなどが送信されます。しかし、ナレッジの管理用ファイルは端末内に置き、外部への操作は利用者の承認を起点とする設計が維持されています。
別の事例として、手首に装着するAIデバイスを開発するVexoも、情報の保存に境界を設けています。内蔵マイクで日常の会話から「友人が勧めたレストラン」や「誰かを紹介する約束」といった文脈を拾いますが、音声データをそのまま残さないと説明しています。抽出した情報だけをプライベートな記憶として保存し、利用者の既存アプリを通じた予約やメッセージ送信に利用します。
自社の業務へAIを導入する際も、情報漏洩や誤操作を防ぐ設計が求められます。たとえば、顧客とのやり取りやプロジェクト資料をAIに読み込ませる場合は、保存先を利用者の端末や管理下のサーバーに限定します。その上で、AIには情報の整理と「下書き」までを担当させ、外部への送信や本番システムへの反映は、担当者が内容を確かめてから承認するワークフローを組むことで、実行条件を確認して作業を進行させることができます。
例外が起きた仕事を、途中の結果と人へ渡す
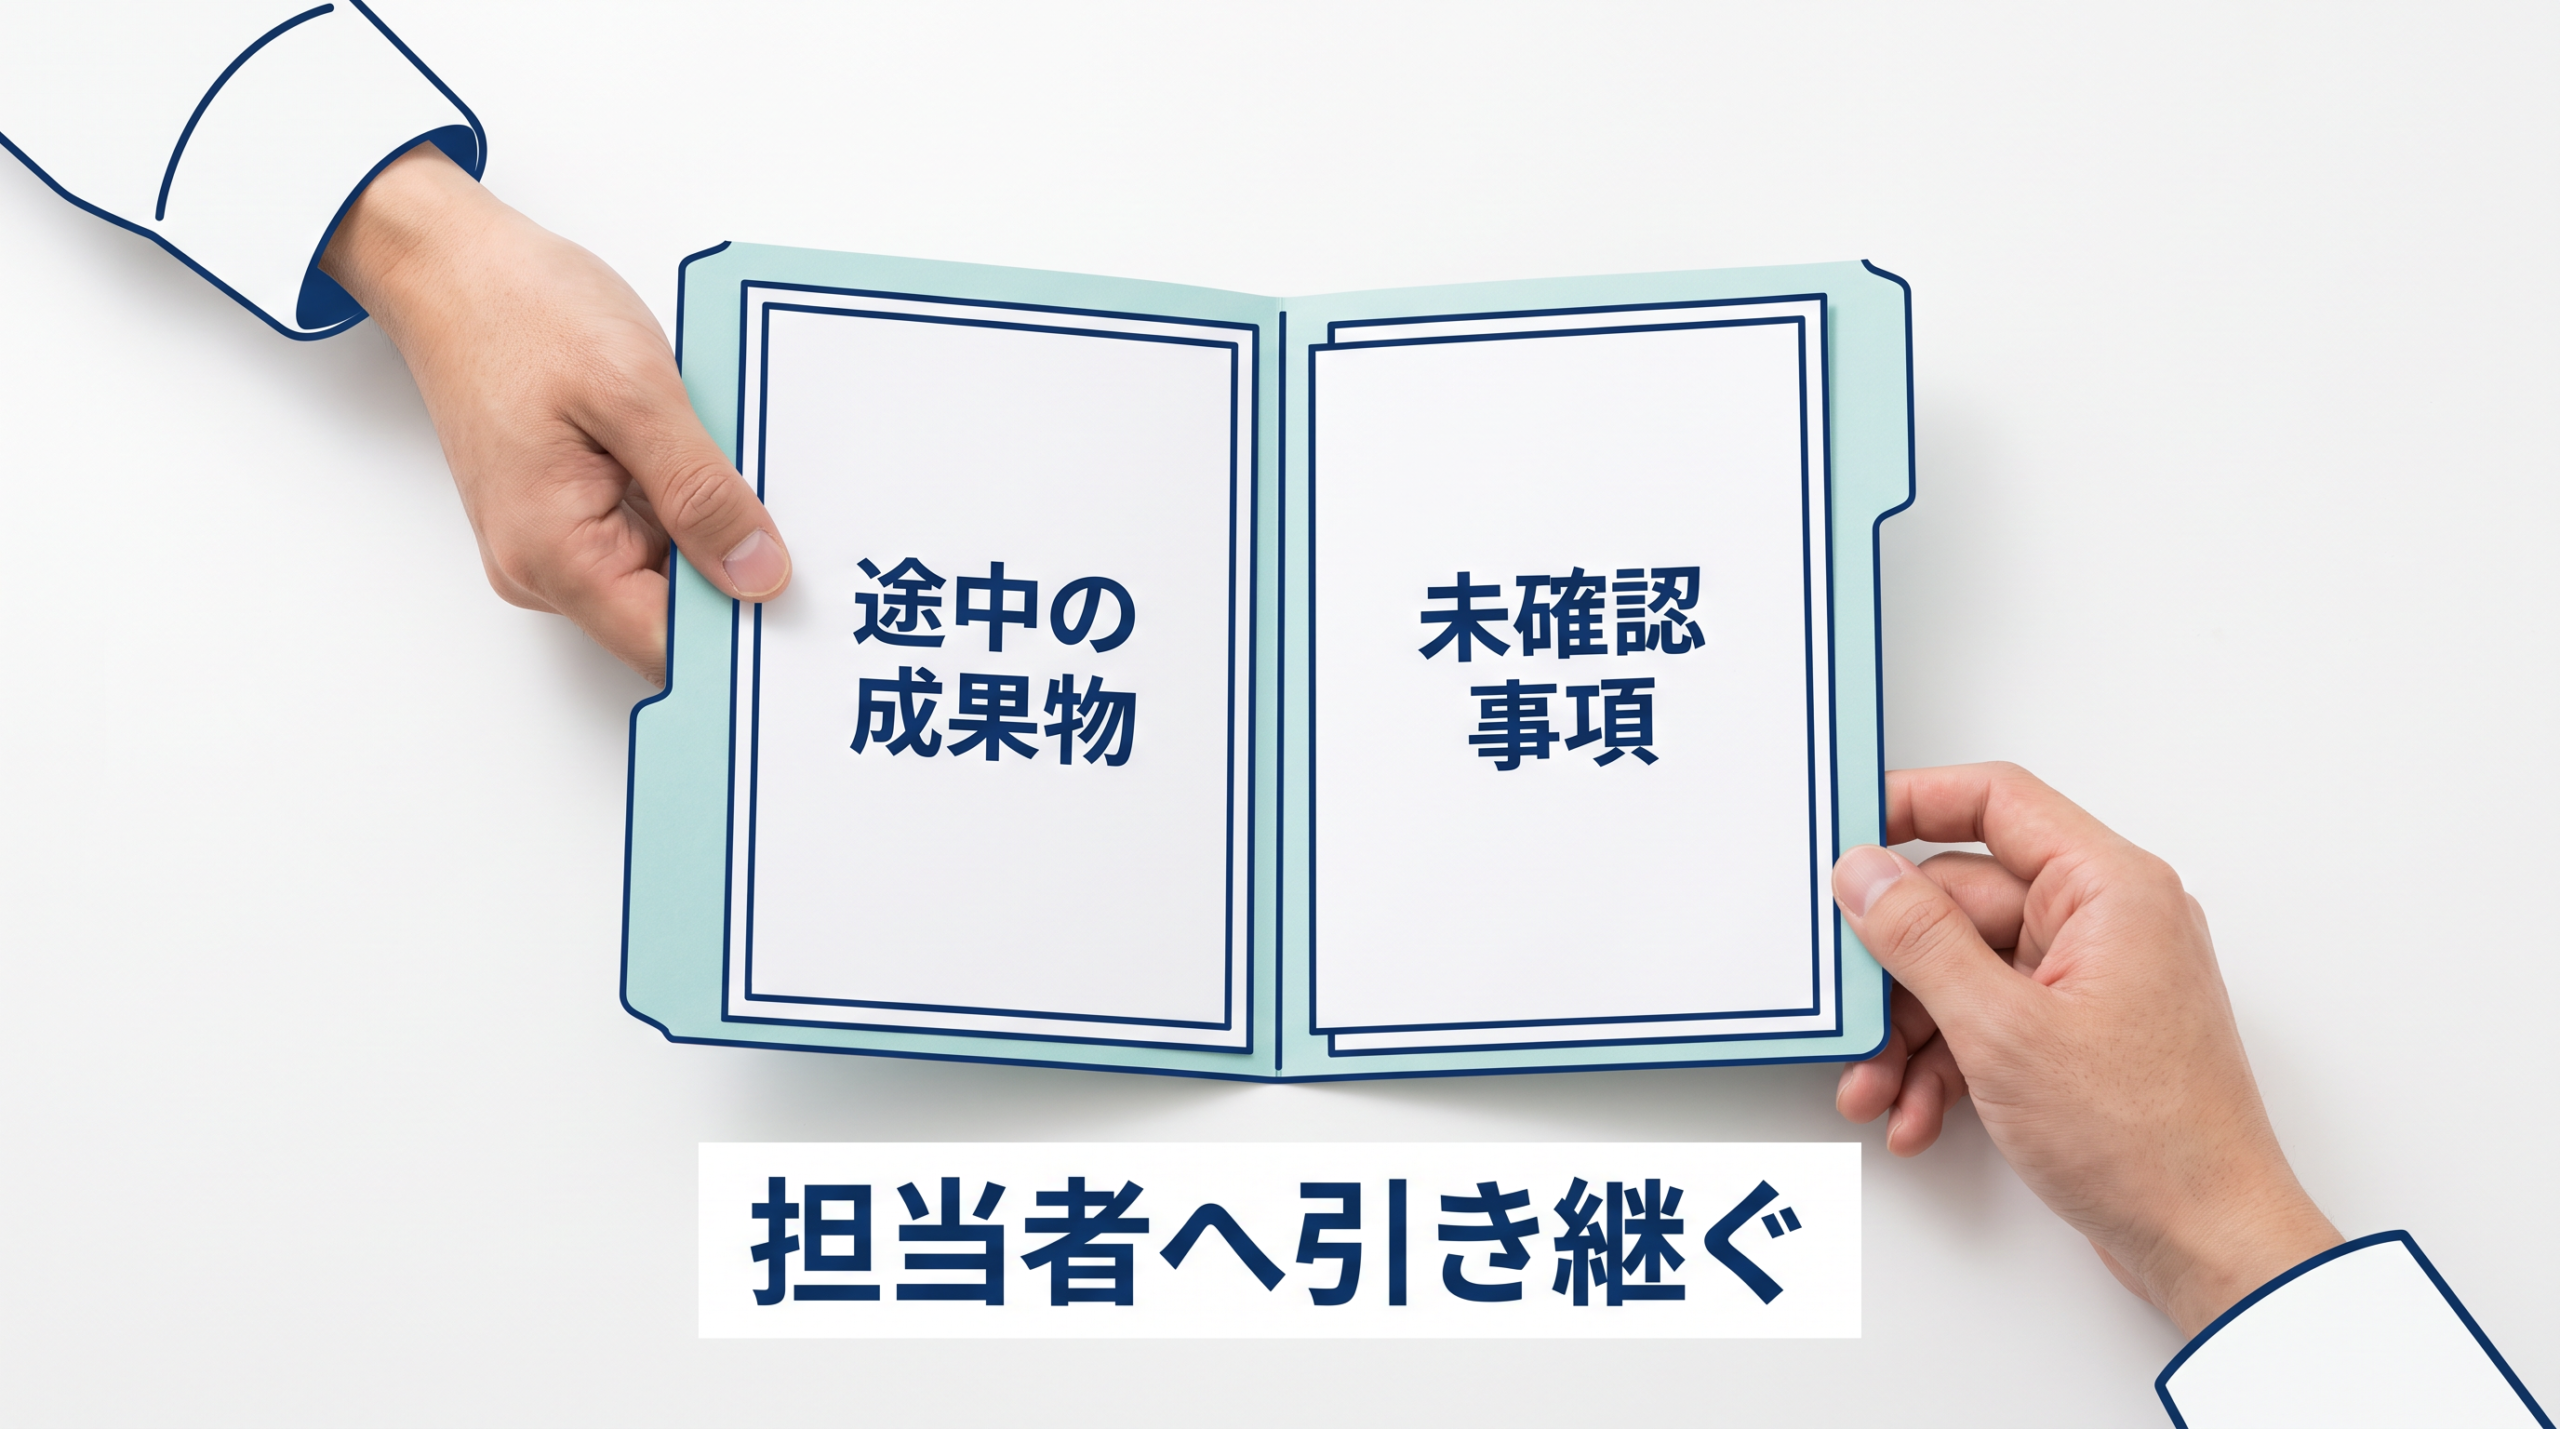
AIによる自動処理を業務に組み込む際、すべての工程を完全に無人で完結させるのではなく、システムが判断できない例外を検知し、途中の結果を人間へ引き継ぐ仕組みが不可欠です。あらかじめ定めたルールに基づいて自動処理の範囲を制限し、基準を満たさないものを人間の判断対象として振り分ける設計が求められます。
たとえば、独立系の診療所向けに医療の請求業務を代行するAltair Healthは、保険会社の請求ポリシーを形式化し、AIエージェントの操作を監視する定理証明器(設定されたルールや論理に基づいて正しさを検証するプログラム)を導入しています。エージェントが実際の請求処理を実行する前に、証明器が保険会社のポリシーと照合して妥当性を確認します。この検証に失敗したケースは自動処理から切り離され、人間の専門担当者へ渡されます。
また、病院の研究用データを準備するSutrixは、医療機関のシステム環境内にAIを展開し、乱雑な電子健康記録を整理しています。ここでも、研究のルールを自動で適用しながら、判断が難しい不明確なケースにはフラグを立て、スタッフが後から内容を確認して修正できる状態にしてから引き継ぎます。
さらに、法律事務所の運営業務を担うPraxisのように、AIが事務処理の最初から最後までを担当しつつ、弁護士がすべてのステップを監督して承認するアプローチもあります。これらはすべて、自動化による効率化を追求しつつ、人間が確認・承認する対象と時点を定める境界線として機能しています。
こうした例外処理と人への引き継ぎの仕組みは、日本の事業会社における調査業務などでも応用できます。ソフトウェア開発における実験事例や各社の公開仕様を参考にした編集上の設計例として、新規事業の担当者が公開情報を用いて複数企業の比較表を一件作成し、中断を挟んでから続きを進める業務フローを考えます。
この設計では、AIが勝手に推測で数値を埋めないよう、明確な停止条件を設けます。「公開情報に根拠のない値を見つけた場合」や「別会社との混同が疑われる場合」、あるいは「参照した原典が更新されて版が一致しない場合」や「許可されていない外部への送信・書き込みが必要になった場合」には、その時点でシステムの処理を停止させます。
処理が停止した際、AIはそこまでに作成した出典付きの比較表の途中経過と、未確認事項のリスト、そして次に行うべき操作の引き継ぎ記録を担当者へ渡します。報告を受け取った担当者は、システムが残した途中の結果と例外の理由を照らし合わせます。その上で、人が直接その未確認部分を調べて表を完成させる(人が例外を処理する)か、原典となる情報を取得し直すか、あるいは許可する操作の範囲を変えてAIに調査を再開させるかを判断します。
このように、例外が起きた時点での成果物と判断に必要な根拠を対応させて人へ渡すことで、再開前に直す箇所と、人が処理する範囲を判断できます。
一件の調査を止め、根拠と権限を確かめて再開する
前節で触れた例外処理と人への引き継ぎの枠組みを、実際の業務へどのように組み込むのか。各社の公開仕様とAnthropicが報告したソフトウェア開発の実験を応用し、日本の新規事業担当者が公開情報を用いて企業比較を一件作成し、中断を挟んで続きを進める編集上の設計例から具体的なプロセスを追います。
まず、担当者はAIに対して架空の調査依頼を設定します。調査を許可した公開URL、比較する項目、情報の確認日、期待する成果物、作業途中のデータを保管する試験用フォルダを指定します。AIには、対象企業の説明を読み込んで根拠となる引用とともに項目を整理すること、推測で数値を埋めず不明点として残すことを指示して作業を開始させます。
自動処理が始まるとAIは情報を抽出しますが、作業を安全に保つために明確な停止条件が働きます。公開情報の中に根拠のない値を見つけた場合や、社名が似た別会社との混同が疑われる場合、参照した原典が更新されて版が一致しなくなった場合には直ちに調査を中断します。また、許可されていない外部サイトへのフォーム送信や書き込みが必要になった場合も、権限不一致として処理を止めて担当者へ差し戻します。
作業を停止したAIは、そこまでの成果を無駄にしないよう状態を記録します。ここには、すでに出典が付与された比較表の途中経過と、未確認事項のリストが含まれます。同時に、中断した時点でのURLと確認日、引用と項目の対応、完了と未完了の範囲、ファイルの保存版、そして次回に向けて「次に許可が必要な操作」をまとめた引き継ぎ記録を生成し、次の担当者が読める形で残します。
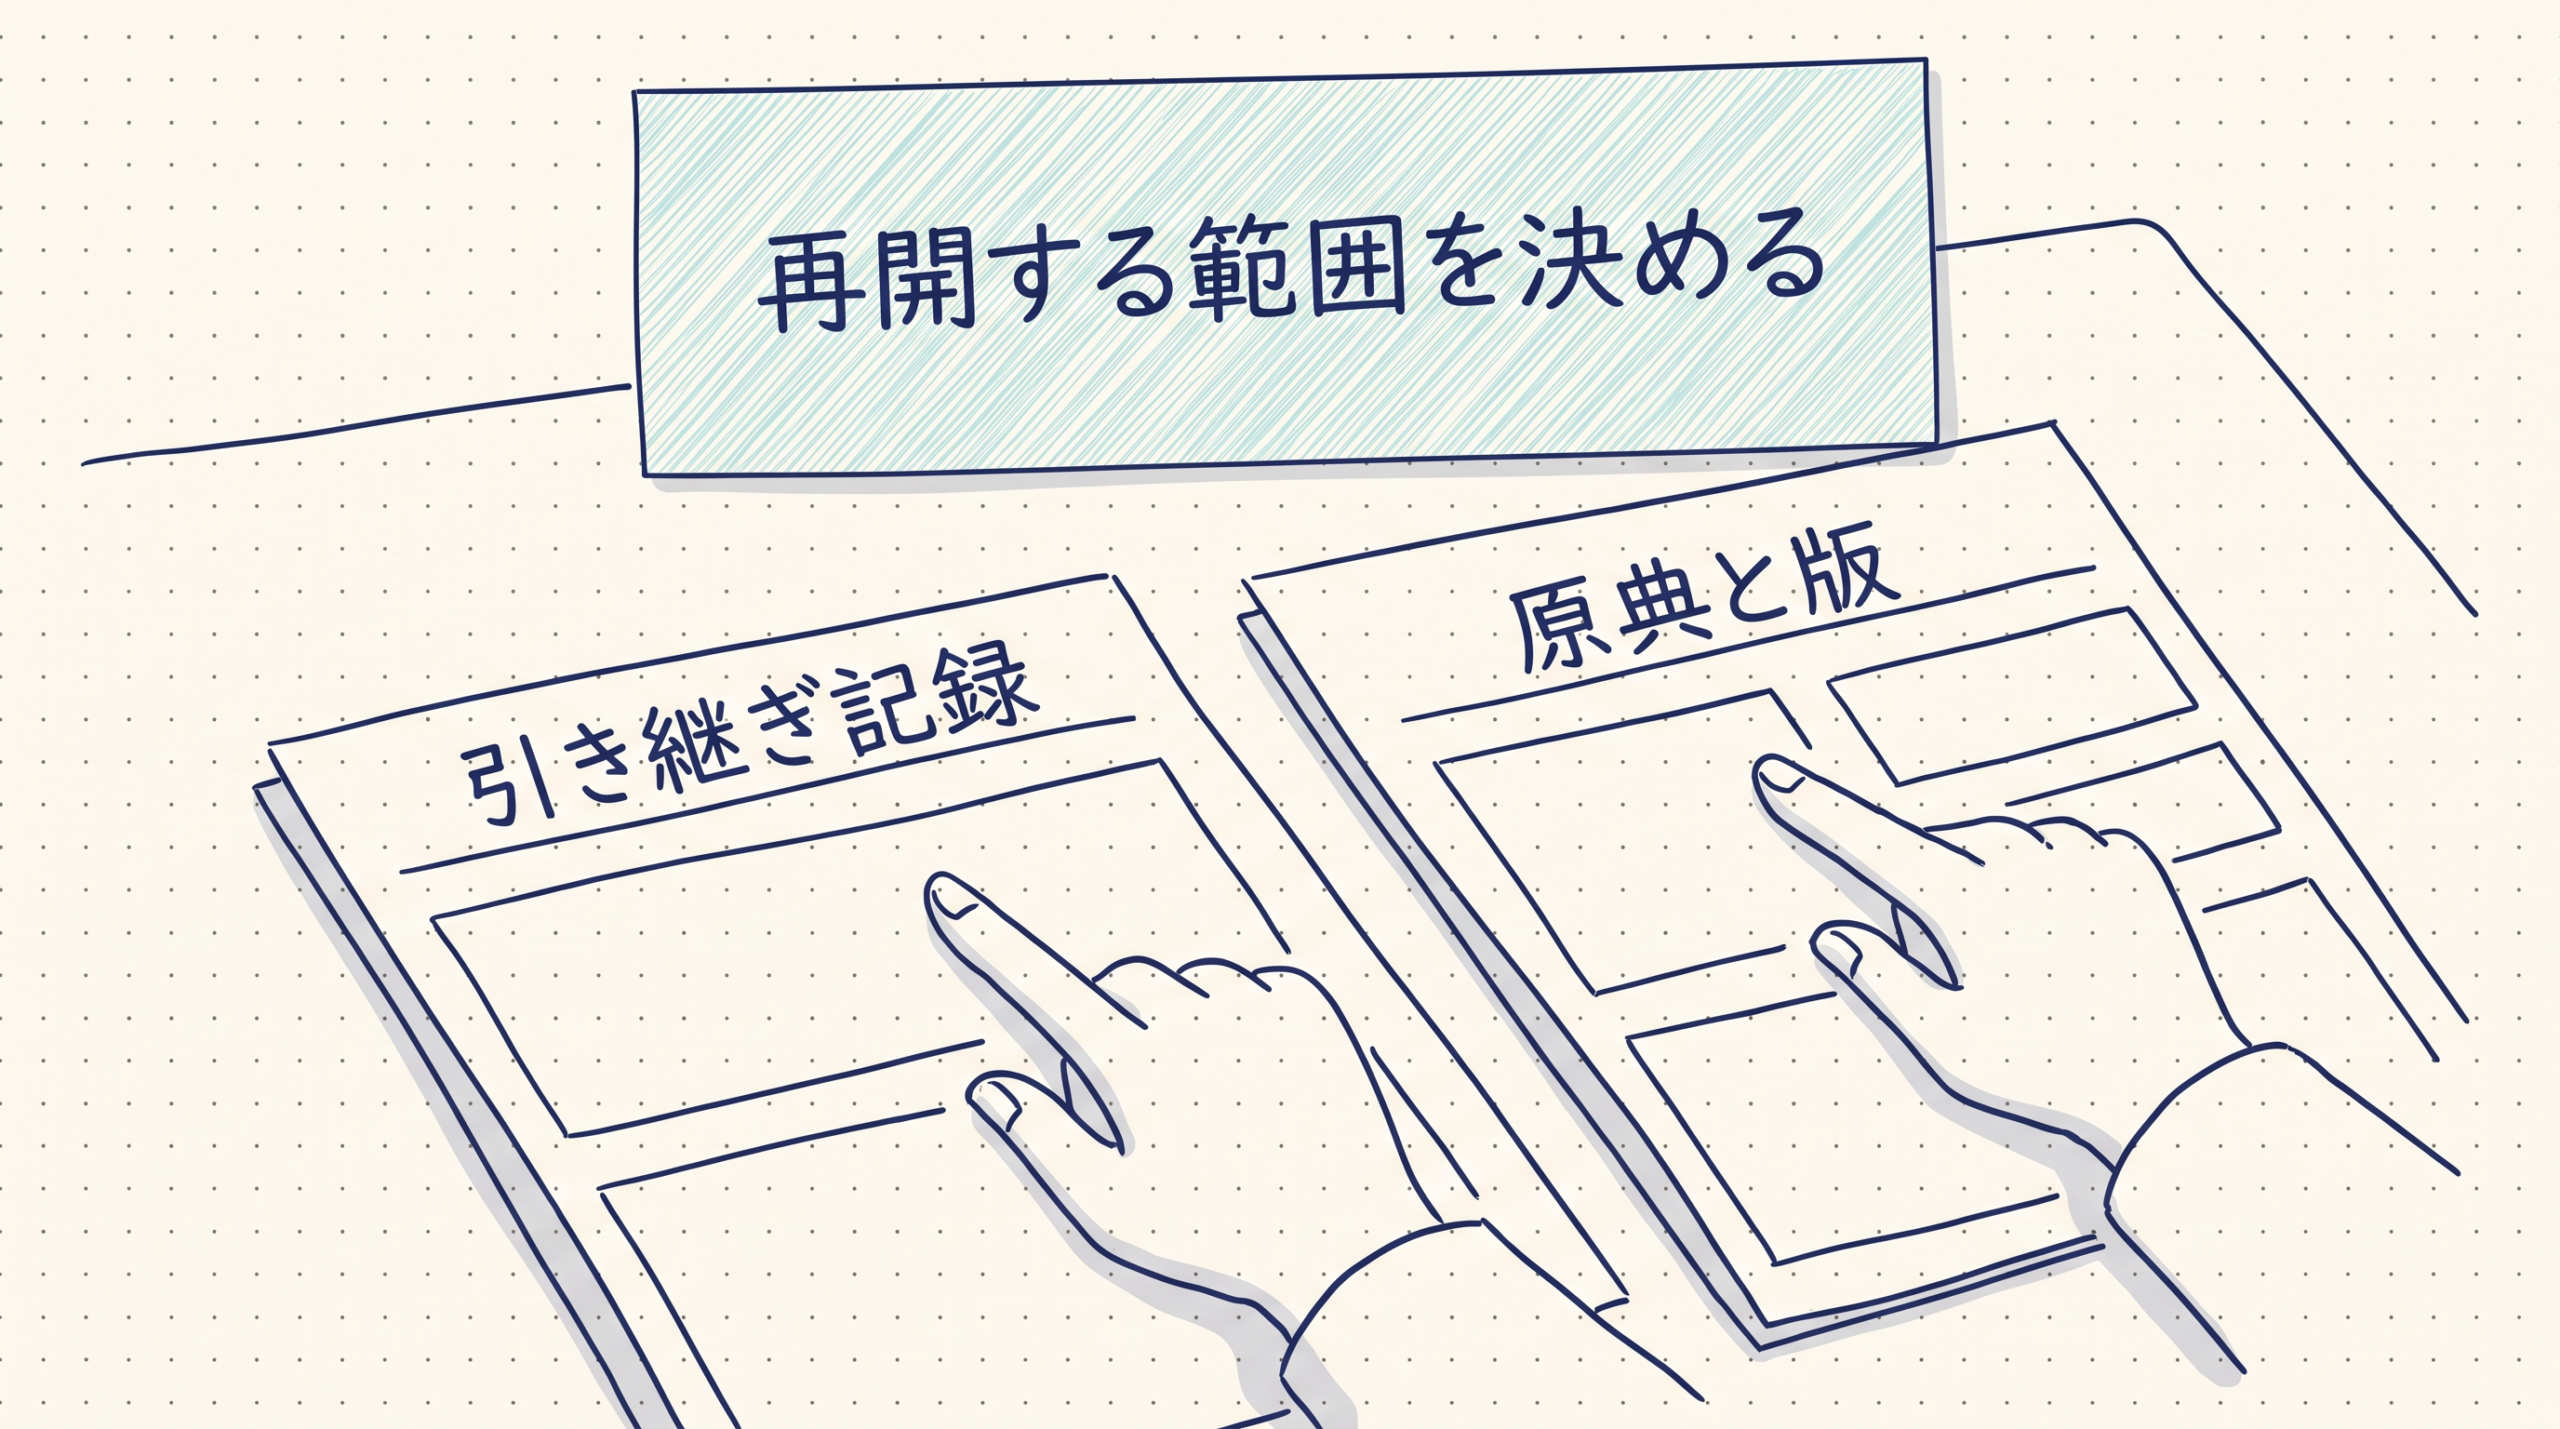
この引き継ぎ記録を受け取った担当者は、記録と原典を照合して再開範囲を決めます。AIが出力した出典と表の対応が正しいか、原典の更新や版が一致しているか、前回未確認だった項目をどう扱うかを確認します。さらに、AIが実行しようとしている次の操作について、適切な権限を与えてよいかを判断します。
照合を終えた担当者は、状況に応じて次の修正判断を下します。取得する情報が広すぎれば保存対象を減らし、情報が古ければ原典を取り直す指示を与えます。特定のサイトでの挙動が不安定であれば再現テストを追加し、安全性を重視して許可する操作範囲を狭めることも可能です。あるいは、AIの判断が難しい例外箇所だけは人が直接調べて表を埋めるといった対応も選びます。
人が方針を決定して再開を指示すると、別のセッションとして起動したAIは最初からやり直すわけではありません。作成された引き継ぎ記録と原典をまず読み込み、再開時点の差分と残りの作業を確認してから、承認された権限の範囲で未確認事項の調査を続行します。このように、調査を止める条件を定め、記録に基づく照合と人の修正判断を経て再開する流れを設計することで、再開時に確認する対象と人が判断する範囲を定められます。
よくある質問
作業環境が保存されていれば、AIはすぐに前回の続きから作業を再開できますか?
いいえ、作業環境のインフラストラクチャが保存されていることと、AIが作業の続きを判断できることは別の問題です。仮想マシンやサンドボックス上にファイルやツールが残っていても、新しく起動したAIのモデルは前回の実行内容を自動で記憶しているわけではありません。AIが迷わずに作業を再開するには、進捗状況を記録したテキストファイルや変更履歴を残し、次回起動時にそれを読み込ませる引き継ぎ手順をシステム側に組み込む必要があります。
AIに個人の業務文脈を読み込ませて整理する際、データはどこに保存されますか?
保存先と外部への送信範囲は、選択するツールや利用条件によって異なります。たとえばSentient OSの場合、利用者の端末内でメールやファイルを推論によって読み込んで情報を整理し、そのナレッジの管理用ファイルはローカル環境のテキストファイルとして保存されます。モデル自体の学習が行われるわけではありません。一方で、整理した知識を活用する際、ChatGPTやClaudeなどのクラウドAIを利用する設定を選んだ場合は、機能に合わせて要約データや画面キャプチャなどが外部の提供者へ渡されます。このように、管理用ファイルの端末内保存と、選んだクラウドAIへの情報の送信は分けて扱われます。
AIが自動処理中に本番環境でエラーを起こした場合、システムは自律的に修正を行いますか?
必ずしもすべてのシステムが自律的に修正を行うわけではありません。運用を分ける設計例として、システムが自律的にコードや設定を書き換える状態を避けるアプローチがあります。エラーが発生した当時の入力やツールの状態を独立したテスト環境に保存し、AIが提示した改善案を担当者が確認します。人が承認した上でテスト環境での再実行を経てから本番環境へ反映させることで、予期せぬ変更を防ぐことを目指します。
例外が発生して自動処理が停止した際、担当者は何を判断して作業を再開させますか?
調査業務などの中断と再開を想定した設計例では、あらかじめ設定した停止条件に触れた際、AIに途中までの成果物と次に必要な操作をまとめた引き継ぎ記録を残させます。担当者はその記録と原典を照合し、人が直接例外箇所を調べて作業を終わらせるか、情報の保存範囲を狭めるか、あるいはAIへ新たに許可する操作の権限を変えて処理を再開させるかを判断します。
AIを組み込む仕事の流れづくりをご支援します
Deskrexでは、AIを使って調査・制作・分析などの仕事を進めるために、工程と役割分担を設計し、実装する支援を行っています。AIに渡す資料や指示、使えるツール、人が確認する箇所を整理し、一連の仕事として動く仕組みをつくります。
まず、届けたい成果物と現在の作業手順を確認し、実際の仕事をAIで試します。品質、処理量、時間、費用を見ながら、今すぐ任せられる作業と、追加の設計や開発が必要な作業を確かめます。
その結果をもとに、工程の統合や並列化、ツール連携、結果の検証と修正の手順を組み込みます。実行回数や費用の上限、人の判断を待つ条件、途中の状態を保存して再開する方法も含めて設計し、実務で動作を確かめます。
業務へのAI導入やワークフロー作成のご相談は、AIワークフロー作成支援のご案内からお問い合わせください。任せたい仕事と、現在使っているツールを伺い、取り組む範囲を一緒に整理します。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント