論文を何本かAIに読ませて調査資料を作ると、しっかりした研究も、条件の限られた研究も、同じ重さで資料に混ざってしまう。1本は中心に、1本はこの節だけ、1本は軽く触れる程度に使いたいのに、どう伝えればよいのか分からない。そんな悩みはないでしょうか。
結論から言うと、論文ごとに「主に使う」「一部だけ使う」「控えめに使う」「限界の確認に使う」の役割と、使ってよい範囲を表にして依頼文に添え、各主張に出典の記号を付けさせるのが扱いやすいと思います。出力は、記号を論文ごとに数えて表と比べる確認と、記号の付いた文を原文と読み比べる確認の二段で確かめます。どの論文を中心に置くか、結論をどの強さで言うかは人が決めます。
この記事では、根拠の確かさを評価するGRADEの考え方と、AIが複数の文書をどう扱うかの研究、そして公開論文4本で役割表の有無を比べた試験の結果をもとに、手順を整理します。
論文の使い方は、点数ではなく「この資料で何を任せるか」で決める
論文を何本かAIに読ませて資料を作ると、下書きは数分で出てきます。困るのはその先で、しっかりした実験の論文と、小さな予備的な論文、問いから少しずれた論文が、同じ重さで混ざってしまうことです。1本は中心に据えたい、別の1本はこの節だけで使いたい、もう1本は軽く触れる程度にしたい。そう思っても、何を基準に分ければよいのでしょうか。
私は、論文に点数を付けるより、「この資料の問いに対して、その論文に何を任せるか」で決めるほうが、AIへの指定に落とし込みやすいと考えています。同じ論文でも、資料の問いが変われば任せる役割は変わるからです。
4つの役割で分ける
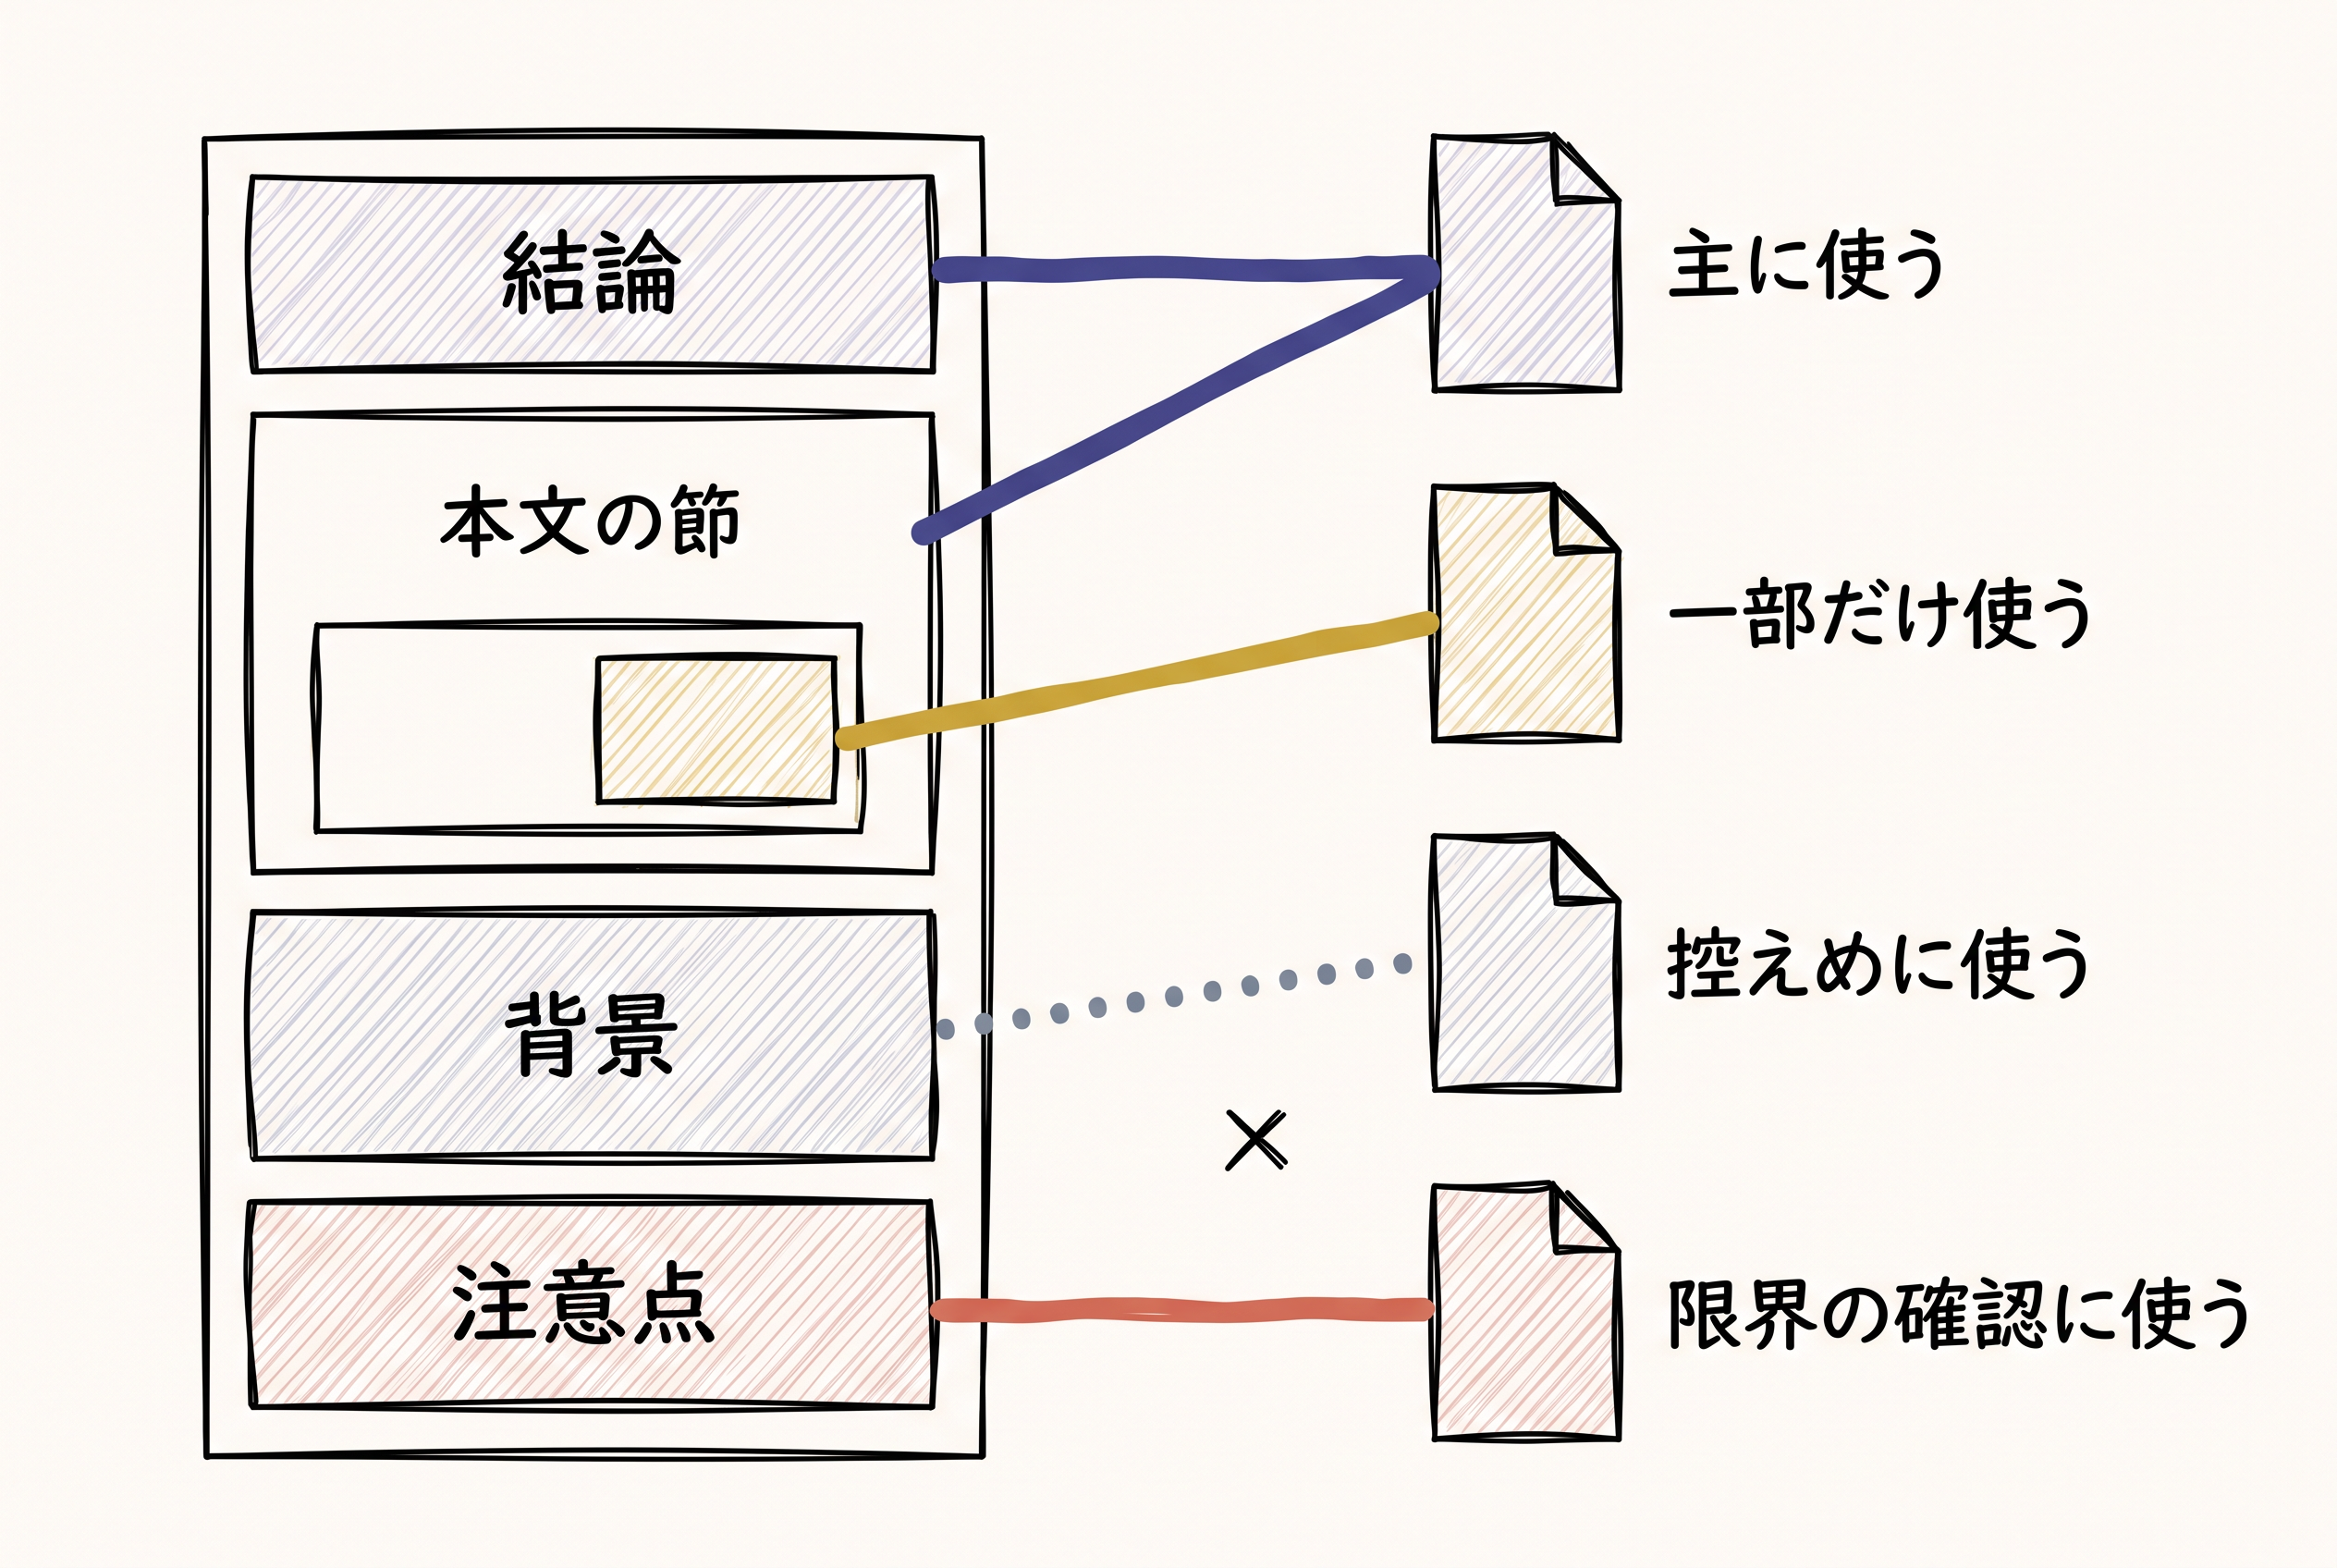
この記事では、論文の役割を次の4つで考えます。
| 役割 | 資料での使い方 | 当てはまりやすい論文 |
|---|---|---|
| 主に使う | 結論の根拠にする。最も多く引用する | 資料の問いに直接答えていて、方法や規模がその結論を支えられる論文 |
| 一部だけ使う | 決めた節や論点だけで使う | 測り方や定義など、特定の論点の説明に強い論文 |
| 控えめに使う | 背景として1回程度だけ触れる | 関連はあるが、資料の問いとの距離がある論文 |
| 限界の確認に使う | 注意点や反対の結果を扱う節だけで使い、結論の根拠にしない | 条件が限られた結果、反証、異なる結論を出した論文 |
右の列は分け方の目安で、決まった基準ではありません。
根拠の確かさを評価する観点を借りる
では、どの論文をどの役割にするか。医療の診療ガイドラインでは、研究の根拠がどれだけ確かかを評価する枠組みとしてGRADEが使われています。日本医療機能評価機構のMindsが公開しているGRADEの解説資料では、根拠の確実性を「高・中・低・非常に低」の4段階で表し、評価の観点として次の5つを挙げています。
- 研究は適切にデザインされ、実施されたか(バイアスリスク)
- 結果は一貫しているか(非一貫性)
- 研究は設定した疑問に直接答えているか(非直接性)
- 結果は精確か(不精確さ)
- 全ての研究を含んでいるか(出版バイアス)
GRADEは診療ガイドラインのための枠組みで、ビジネスの調査資料で論文を1本ずつ役割分けするための手順ではありません。それでも、5つの観点は役割を決めるときの問いとして使えると思います。資料づくりでとくに効くと感じるのは、3つ目の「設定した疑問に直接答えているか」です。研究として立派でも、資料の問いに直接答えていなければ、主に使う論文にはできません。
同じ資料には、評価の原則として「個々の研究の評価を単に平均するのではなく、質の高い研究に着目しながら、各研究の重みを考慮して評価する」とも書かれています。判断が難しい場合には、その理由を明示することも求めています。この2点は、AIに論文を渡すときにもそのまま当てはまりそうです。
4本の論文に役割を割り当てる例
ここからは、この記事のために実際に試した例で考えます。テーマは架空の社内勉強会「AIの引用付き回答をどこまで信じてよいか」で、公開されている論文4本の要旨を材料にしました。
| 記号 | 論文の内容 | 割り当てた役割 | 理由 |
|---|---|---|---|
| S4 | 生成検索エンジン4つの引用を人が評価した研究 | 主に使う | 「引用は主張を支えているか」という勉強会の問いに直接答えている |
| S3 | 引用付きの生成を自動で評価するベンチマーク(ALCE) | 一部だけ使う(引用の質の測り方を扱うスライド) | 測り方の説明に強いが、結論は特定のデータでの結果 |
| S1 | 長い入力の中ほどにある情報をAIが使いにくいことを示した研究 | 控えめに使う(背景で1回) | 関連はあるが、引用の正しさを直接は測っていない |
| S2 | 複数の文書を要約させると最初の文書に寄ることを示した研究 | 限界の確認に使う(注意点のスライドだけ) | 1つのモデルとニュース記事での結果で、結論の根拠には広げにくい |
理由の欄を空けないことが大事だと感じています。後から資料を読んだ人が「なぜこの論文が中心なのか」をたどれますし、自分で役割を見直すときの手がかりにもなります。なお、論文の版や撤回・訂正の確認は、役割を決める前に済ませておきます。版の確かめ方は手元の論文をAIで探して比較する方法、撤回・訂正の確認は学会発表前の引用ネットワーク調査で扱っています。
何も指定しないと、AIは論文を質に応じて使い分けるとは限らない
役割をわざわざ表にしなくても、AIは良い論文を自然と重く使ってくれるのではないか。そう期待したくなりますが、研究を見るかぎり、そうとは限らないようです。
AIは入力の位置で重みを変えることがある
Lost in the Middleという研究は、複数の文書から答えを探す質問応答などで、必要な情報が入力の最初か最後にあるときに性能が最も高く、長い入力の中ほどにあると大きく下がることを示しました。長い入力に対応したモデルでも同じ傾向でした。
要約させる場面に絞った研究もあります。Input Order Shapes LLM Semantic Alignment in Multi-Document Summarizationは、中絶をめぐるニュースで賛成・中立・反対の記事3本の組を40組作りました。6通りの順番で入力し、Gemini 2.5 Flashに中立的な概要を書かせています。
意味の近さを測る指標(BERTScore)で見ると、3つの立場のどれでも、概要は最初に読んだ記事に近くなっていました。1番目と2番目・3番目の間には有意な差があり、2番目と3番目の間には差がありませんでした。
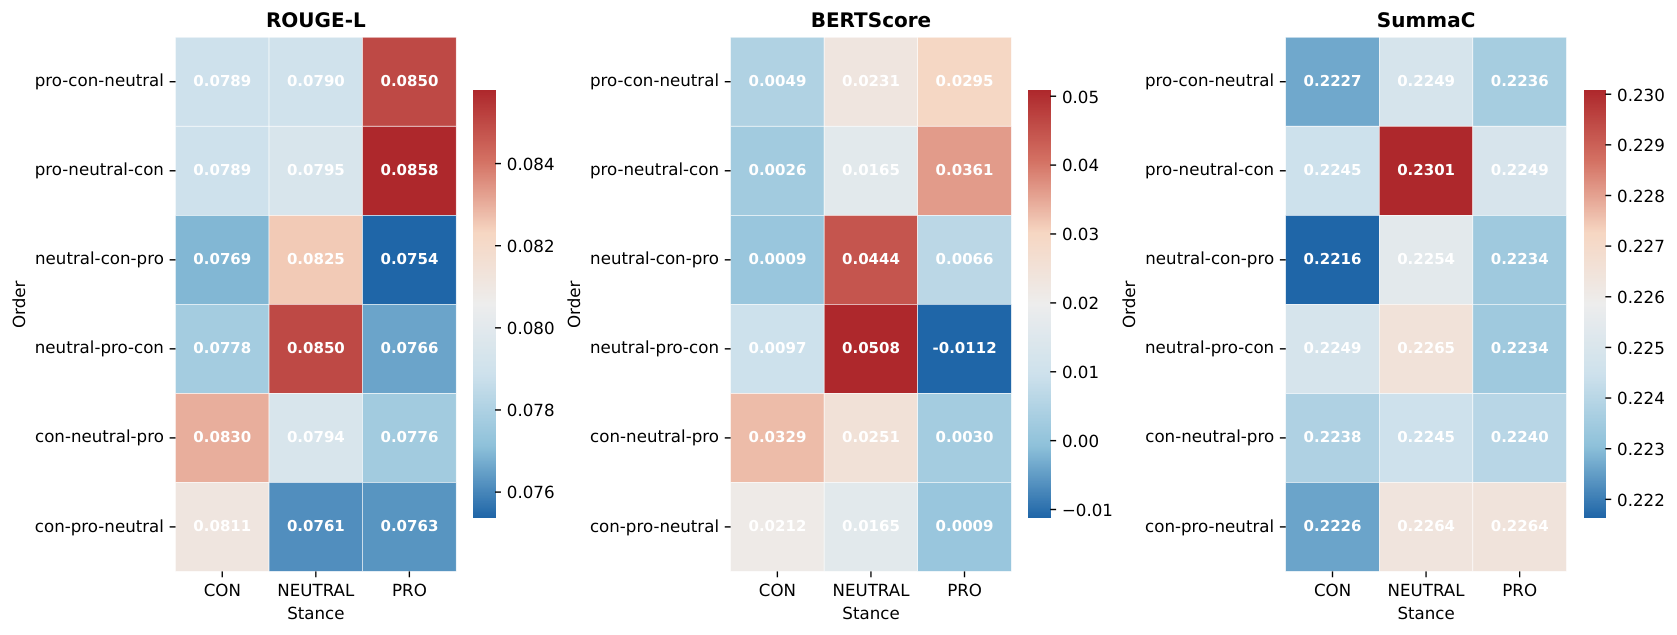
ただし、この研究は1つのモデルとニュース記事での結果で、単語の重なりや事実の整合を測る別の指標では、偏りは弱いか見られませんでした。論文から資料を作る作業で同じ大きさの偏りが出るかは分かっていません。それでも、AIが論文の質を見て重みを決めているわけではない、と考えておくほうが安全だと思います。
役割を伝えないと、論文ごとに1枚ずつの均等な配分になった
では実際に、役割を伝えずに4本の論文から資料を作らせると、どうなるのか。前の節の勉強会の例で、Vertex AIのGemini 3.1 Pro Previewに6枚のスライド骨子を作らせました。
各箇条書きの末尾には、根拠にした論文の記号を[S1]のように付けてもらいます。入力の順番はS1、S2、S3、S4で、主に使いたいS4を最後に置きました。同じ依頼を3回繰り返しています。
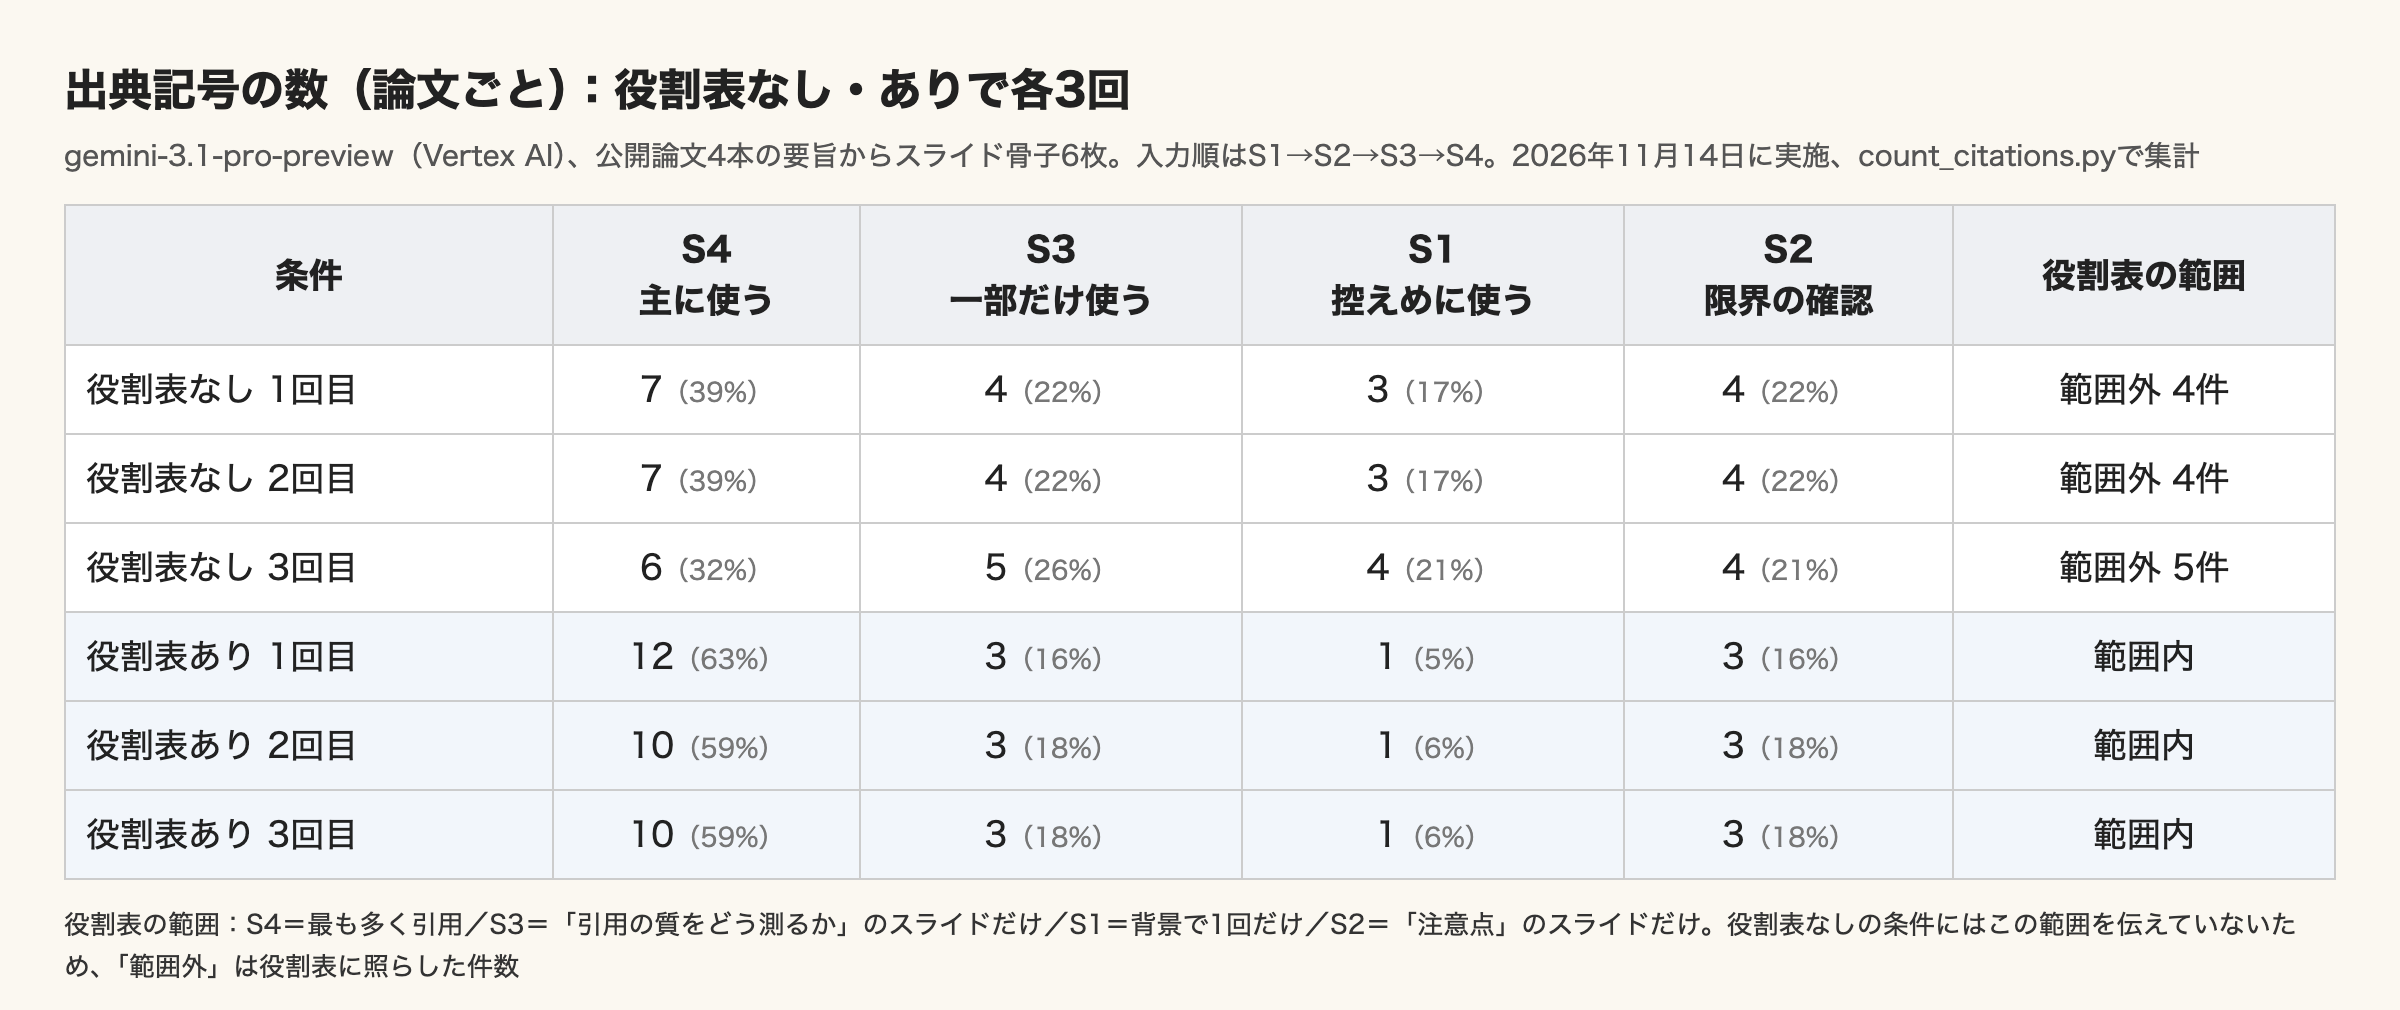
結果は3回ともよく似ていました。AIは論文ごとに専用のスライドを1枚ずつ作り、出典の割合はS4が32〜39%、ほかの3本が17〜26%でした。どの論文もそれなりに使う、均等に近い配分です。そして、まとめのスライドは3回とも、注意点のためだけに使いたかったS2を含み、ほぼすべての論文を1回ずつ引いていました。
論文を1本ずつ紹介していく資料としては筋が通っています。ただ、勉強会で伝えたい結論の根拠はS4のはずで、S2の「最初の文書に寄る」という結果は、条件の限られた注意点です。それがまとめに並ぶと、結論の重さが4本に分散してしまいます。良い論文と弱い論文が同じ重さで混ざるという悩みは、AIが論文の質を判断して使い分けてはくれないことから来ているようです。
なお、この試験は3回ずつの小さなもので、モデルも入力の順番も1通りしか試していません。指定しなければ必ずこうなる、という意味ではありません。
役割表を依頼文に添え、出典の記号を付けさせる
AIが論文の質を判断してくれないなら、人が役割を決めて伝えればよい。そう考えて試したのが、役割表を依頼文にそのまま貼る方法です。
依頼文の例
前の節の試験で、役割を伝えた側の依頼文は次のとおりです。論文の要旨の部分は省いています。
架空の社内勉強会「AIの引用付き回答をどこまで信じてよいか」のスライド骨子を作ってください。スライドは6枚で、各スライドは見出し1行と箇条書き2〜4個。各箇条書きの末尾に、根拠にした資料のIDを[S1]のように必ず付けてください。資料に書かれていないことは書かないでください。出力はMarkdownのみ。

資料ごとの使い方(必ず守ること):
| ID | 使い方 | 使ってよい範囲 |
|---|---|---|
| S4 | 主に使う | 全体の結論と、引用がどれだけ主張を支えているかの説明。最も多く引用する |
| S3 | 一部だけ使う | 「引用の質をどう測るか」を扱うスライドだけ |
| S1 | 控えめに使う | 背景として1回だけ |
| S2 | 限界の確認に使う | 「注意点」のスライドだけ。結論の根拠にはしない |
役割表と依頼文を書くときに意識したのは3点です。使い方を「主に」「控えめに」という言葉だけで終わらせず、使ってよい範囲(どのスライドで、何回まで)まで書くこと。結論の根拠にしてよい論文と、してはいけない論文をはっきり書くこと。そして、各主張に記号を付けさせることです。記号は、後で使われ方を数えるための目印になります。
役割表を添えると、配分は表どおりになった
同じ論文、同じ順番で、この役割表を添えて3回作らせました。3回とも、出典の使われ方は表の範囲に収まりました。S4の割合は59〜63%になり、S1はちょうど1回、S3は「引用の質をどう測るか」のスライドだけ、S2は注意点のスライドだけで使われました。結論のスライドは3回ともS4だけで支えられていました。
役割表がないときと比べると、出典の配分は指定に沿って大きく動きました。少なくともこの例では、論文ごとの使い方は依頼文で伝えられる、と言ってよさそうです。
比率で指定するのは、どんなときか
論文ごとの抽出割合を事前に決めておき、4本なら25%ずつスライドに入れる、という指定の仕方も考えられます。比率は分かりやすく、指定もしやすい方法です。
ただ、確かさに差がある論文に同じ比率を割り当てると、GRADEの解説が戒めていた「単に平均する」扱いに近くなります。弱い論文の主張が、強い論文と同じ重さで資料に載ってしまうわけです。前の節の試験でも、比率を何も指定していないのに、AIはすでに均等に近い配分を選んでいました。
私は、比率は役割を決めた後に、その結果を確かめる数字として使うのがよいと考えています。同じくらいの確かさの論文を偏りなく紹介したいときは、均等な比率が目安になります。確かさや問いとの距離に差があるときは、先に役割と範囲を決め、比率は「主に使う論文が半分を超えているか」のような確認に回します。
APIを使う場合は、論文ごとの引用を機械的に数えられる
プログラムからAIを呼び出している人向けの補足です。AnthropicのClaude APIにはCitationsという機能があります。
文書を渡して引用を有効にすると、回答の各主張に対応する原文の箇所と、何番目の文書から引いたかを示す番号(document_index、リクエストに含めた文書を0から数えた番号)が返ってきます。document_indexごとに数えれば、論文ごとの使用量を集計できます。
文書にはcontextという欄も付けられ、モデルには渡るものの引用の対象にはなりません。公式ドキュメントでは文書のメタデータを入れる欄として説明されているので、役割をここに書く使い方も考えられます。ただし、この記事の試験では試しておらず、役割が守られるかは確かめていません。
指定どおりかは「数える」と「読む」の二段で確かめる
役割表を添えて配分が表どおりになれば、そのまま資料に使えるのでしょうか。私の試験では、そうはなりませんでした。確認は二段に分けて行うのがよいと思います。
一段目は、記号を論文ごと・スライドごとに数える
最初の確認は、出力に付いた記号を数えることです。論文ごとの合計と、スライドごとの内訳を表にして、役割表の範囲と比べます。見るのは次の4点です。
- 主に使う論文が、最も多く引用されているか
- 一部だけ使う論文が、決めた節の外に出ていないか
- 控えめに使う論文が、決めた回数を超えていないか
- 限界の確認に使う論文が、結論のスライドに入っていないか
記号を数えるのは、表計算ソフトでも短いスクリプトでもできます。AIに数えさせることもできますが、その場合も合計は人が確かめます。この記事の試験ではスクリプトで数えました。
二段目は、記号の付いた文を原文と読み比べる
数えて合格した、役割表ありの3回分の出力を、論文の要旨と1文ずつ読み比べました。すると、数え上げでは見えない問題が残っていました。
1つ目は「本勉強会では、こうしたAIシステムが提供する引用付き回答がどこまで検証可能かを確認する [S4]」という文です。これは論文の内容ではなく勉強会の目的で、記号だけがS4に付いていました。
2つ目は「Bing ChatやPerplexity.aiといった生成型検索エンジンが普及し、多様な質問に利用されている [S4]」です。「多様な質問に利用されている」は要旨に書かれていません。要旨は、4つの検索エンジンを多様な質問で評価したと述べているだけです。
3つ目は「複数の長い文書を要約させる場合、入力された順序の影響を大きく受ける [S2]」です。要旨が示すのは「有意な初頭効果」で、「大きく」とは書いていません。
どれも記号は役割表どおりの論文に付いているので、一段目の集計では合格に見えます。役割が守られていても、文が原文に支えられているとは限らないのです。
これは私の小さな試験だけの話ではないようです。2023年に4つの生成検索エンジンを人が評価した研究では、生成された文のうち引用で完全に支えられていたのは平均51.5%、付いた引用のうち対応する文を支えていたのは74.5%でした。
引用付きの生成を自動で評価するALCEでも、ELI5というデータでは、最良のモデルでも50%の割合で完全な引用の裏付けを欠いていました。どちらも2023年時点の評価で、今のモデルの数値ではありません。それでも、記号が付いていることと文が支えられていることを分けて確かめる理由としては十分だと思います。
読み比べで見つけた文を直す
印を付けた文は、原文に合わせて言い方を直すか、資料から削ります。勉強会の目的のように資料の外から足した文は、記号を外して自分の言葉として書くほうが、読み手に対して正直です。
原文にない内容が多いときは、要旨ではなく本文の該当箇所を渡して作り直すと、読み比べもしやすくなります。Claude APIのCitations機能を使える場合は、回答と一緒に引用元の原文(cited_text)が返るので、読み比べる相手をすぐに確かめられます。
一段目で表から外れていた場合は、文を直す前に依頼文を見直します。範囲の書き方があいまいでないか、結論の根拠にしてよい論文を書き忘れていないかを先に確かめます。
どの論文を中心に置き、結論をどう言うかは人が決める
役割表、数える確認、読む確認。ここまでの手順でAIに任せられる部分は増えますが、人が決めたほうがよい判断が3つ残ります。
中心に置く論文と、その理由
1つ目は、どの論文を主に使うかです。AIに論文の比較表を作らせて候補を出すことはできます。
しかし「資料の問いに直接答えているか」「方法や規模はその結論を支えられるか」は、資料の目的を知っている人でなければ決められません。決めた理由は役割表の欄に書いておきます。GRADEの解説が判断の理由の明示を求めているのと同じで、後から資料を読んだ人が判断をたどれるようにするためです。
論文同士が食い違うときの書き方
2つ目は、論文の結果が食い違うときの扱いです。GRADEの観点にも「結果は一貫しているか」があります。主に使う論文と食い違う結果があるなら、その論文に限界の確認の役割を与えて注意点の節で書き、どちらかに寄せて片方を消さないほうが、資料として誠実だと思います。食い違いの理由として対象や方法、時期の違いが読み取れるなら、その違いまで書きます。
結論の言い方の強さ
3つ目は、結論をどの強さで言うかです。Mindsの解説資料は、確実性の段階を言い方で定義しています。高ければ「真の効果が効果推定値に近いことに大きな確信がある」、低ければ「真の効果は効果推定値とは大きく異なるかもしれない」といった具合です。
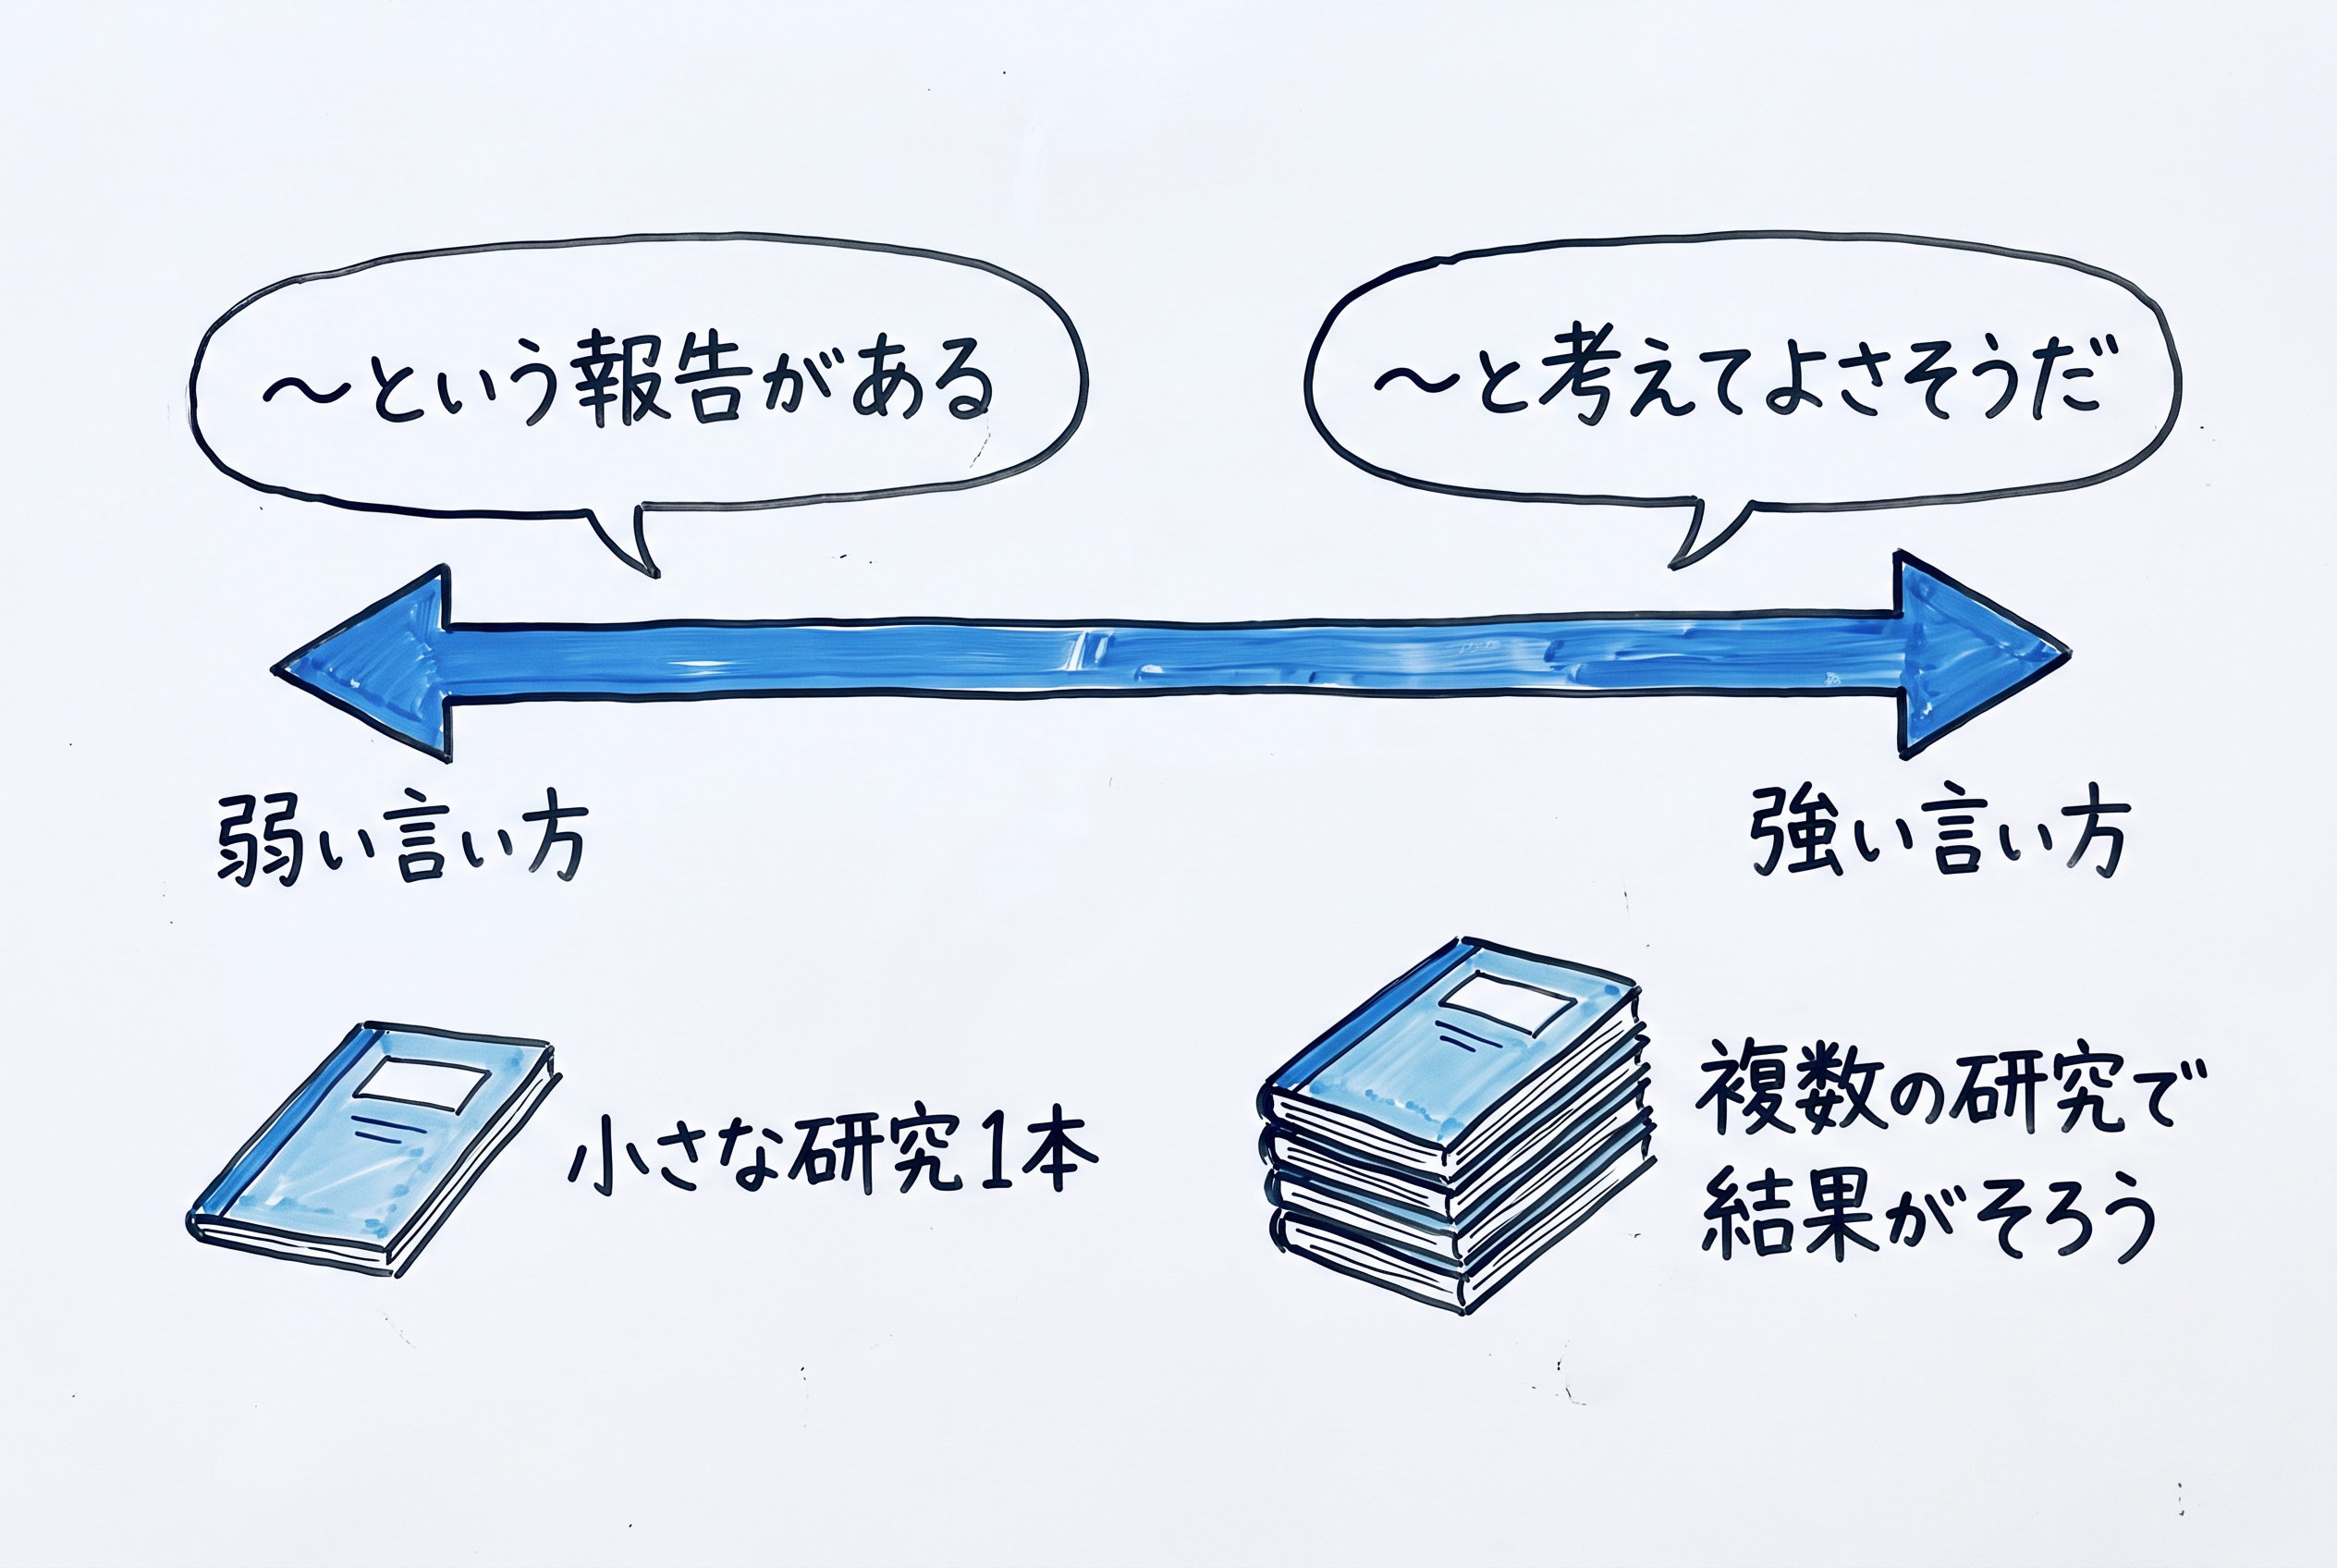
資料づくりでも、中心の論文が1本の小さな研究なら「〜という報告がある」、複数のしっかりした研究で結果がそろっていれば「〜と考えてよさそうだ」というように、言い方を根拠に合わせられます。
勉強会の例なら、S4の結果は2023年に4つの検索エンジンを評価したものなので、「今のAIの引用も半分しか正しくない」とは言えません。「2023年の評価では、引用で完全に支えられた文は約半分だった。今使っているツールでも、記号の付いた文を原文で確かめる価値がある」くらいが、根拠に見合った言い方ではないでしょうか。
役割表は、一度作れば同じテーマの次の資料でも見直して使えます。前回の表と、読み比べで印を付けた文を並べておけば、どの論文をどう扱うかの判断は少しずつ速くなるはずです。あなたの手元の論文なら、どれが「主に使う」に入るでしょうか。
よくある質問
Q1. 「4本なら25%ずつ」のように比率で指定してもよいですか?
同じくらいの確かさの論文を偏りなく紹介したいときは、比率が目安になります。確かさや資料の問いとの距離に差があるときは、先に役割と使ってよい範囲を決めてください。均等な比率は、弱い論文を強い論文と同じ重さで扱うことになるためです。比率は「主に使う論文が半分を超えているか」のように、結果を確かめる数字として使うと扱いやすいと思います。
Q2. 論文をAIに渡す順番は気にしたほうがよいですか?
気にしておく価値はあります。本文で紹介した、複数のニュース記事を要約させた研究では、概要が最初に読んだ記事に意味的に近くなる傾向が報告されています。ただし1つのモデルとニュース記事での結果です。順番だけに頼るより、役割表で範囲を指定し、記号を数えて確かめるほうが、指定が守られたかを確認しやすくなります。
Q3. 出典の記号が付いていれば、その文は正しいと考えてよいですか?
いいえ。記号は、どの論文を根拠にしたとAIが示したかの目印にすぎません。この記事の試験でも、論文にない内容や言い方を強めた文に記号が付いていました。2023年の生成検索エンジンの評価では、引用で完全に支えられた文は平均51.5%でした。記号の付いた文は、原文と読み比べてから使ってください。
Q4. 査読前の論文(プレプリント)は「控えめに使う」にしたほうがよいですか?
査読前というだけで「控えめに使う」に決める必要はありません。査読前かどうかは材料の1つとして、資料の問いに直接答えているか、方法や規模が結論を支えられるかと合わせて決めます。
arXivなどでは公開後に新しい版が出ることがあるので、どの版を読んだかを役割表の理由の欄に書いておくと、後で見直しやすくなります。版の確かめ方は、本文の最初の節で紹介した記事で扱っています。
Q5. 論文が10本以上あるときも同じ方法が使えますか?
使えますが、表が長くなるほど、範囲が守られたかを数えて確かめる手間が増えます。長い入力の中ほどにある情報はAIに使われにくいというLost in the Middleの結果もあります。「主に使う」「一部だけ使う」に入る論文を先に絞り、節ごとに必要な論文だけを渡して作ると、数える確認も読む確認も進めやすくなります。
生成AIによる調査にはSnorbeをご活用ください
Snorbeは、研究開発や新規事業の調査を支援するAIリサーチツールです。論文・特許・ニュース・業界レポートや社内資料の情報を集め、出典と情報同士のつながりをナレッジグラフとして整理しながら、調査を深められます。
調べたいテーマをチャットで伝えると、AIがWeb検索や専門データベースなどのツールを選んで調査を進めます。収集した情報をグラフ上で確認し、未調査の領域や気になる論点を見つけて、追加の調査へつなげることができます。
調査結果は比較表や出典付きのレポートにまとめ、MarkdownやPDF形式で出力できます。過去の調査やアップロードした資料を参照して掘り下げられるため、継続して調べるテーマの情報整理や社内共有にも活用できます。
ご利用をご希望の方は、Snorbeのご案内から機能やプランをご確認ください。社内資料を含む調査やセルフホスト導入のご相談も受け付けています。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント