
arXivは、研究者が研究成果を公開し、読者が論文を検索・閲覧できるようにするプラットフォームです。掲載ページには、原稿の版や出版に関する手掛かりも表示されます。
実際にarXivのページを開くと、タイトルと要旨に加え、v1やv2といった版番号が表示されます。過去の投稿履歴、出版情報、DOIが並ぶ場合もあります。これらは文書の状態を調べる手掛かりですが、一項目だけで正式な出版物かどうかは決まりません。
同じ画面にさまざまな情報が並ぶため、複数の状態を混同しやすくなります。arXivで見つけた文書をAIで整理するとき、プレプリントなのか、どの版なのか、正式に出版されたのか、査読済みと確認できるのかをどう分ければよいのでしょうか。図表などの再利用条件も、出版状態とは別に確認する必要があります。
この記事では、確認する情報を四つの軸に分けます。論文候補の検索、読んだ版の固定、正式出版の有無、著作権に基づく再利用条件です。
arXivの表示だけでは研究内容の正しさまで判定できません。ここからは文書の公開状態を確認する手順に絞り、まず公開基盤の仕組みから見ていきます。
arXivとは何か|プレプリントを探す公開プラットフォーム

研究者がジャーナルで正式に出版される前に共有する研究原稿は、プレプリントと呼ばれます。arXivは研究成果を公開し、検索・閲覧・保存できるプラットフォームです。物理学、数学、コンピューターサイエンスなどの分野を扱います。
arXivが提供するのは研究成果を早く共有するための公開基盤であり、論文の内容を審査して合格させるジャーナルそのものではありません。トップページでも、掲載された資料はarXivによって査読されていないと明記されています。
arXivでは原稿を掲載する前に、内容が対象分野に関係するか、形式が整っているかなどを確認する「モデレーション」という工程を通します。すべての投稿がこの確認の対象になりますが、arXivはこの工程は査読ではないとはっきり説明しています。
査読とは、ジャーナルなどの専門家が研究方法やデータ、結論の妥当性を審査する工程です。arXivにプレプリントが公開されたという事実だけでは、別のジャーナルで査読を受けたかどうかや、研究内容が正しいかどうかは分かりません。
そのため、見つけた文書を紹介するときは「arXivに公開されたプレプリント」と表現し、査読済みの論文として扱う場合は別の根拠を探す必要があります。では、arXivの中から目的のプレプリントを正しく見つけるにはどうすればよいのか、具体的な検索の進め方を見ていきましょう。
arXivで論文を検索する方法|テーマ語から識別子へ

論文の候補を探すときは、まずタイトルや著者名、要旨に含まれる語を使います。公式ヘルプでは、検索欄にこれらの語を入力して候補を探したり、より詳細な検索画面を利用したりする方法を説明しています。
最初は研究テーマを表す語を2、3個入力します。著者名が分かる場合は著者名を加え、発表時期も指定して候補を絞ります。
分野が明確なら、公式のカテゴリ分類表を組み合わせて検索範囲を整えます。候補が見つかったら、タイトルと要旨を読み、探している研究対象と一致するか確認します。
タイトルだけで判断すると、似た研究や同じ著者の別論文を取り違えることがあります。そこで、文書ごとに割り振られた固有の番号である「識別子」を確認します。
新しい論文の識別子は「yymm.nnnnn」という形です。識別子が分かる場合は、検索欄へ入力して目的のページを開けます。
検索を使う上で気をつけたいのは、検索結果の並び順を研究の質と混同しないことです。検索で上位に表示されたからといって、その研究が重要であるとか、内容が正しいと証明されたわけではありません。検索は、あくまで候補の論文を見つけ出すための手段です。
後から同じ論文を間違いなく確認できるように、検索した時の語や分野のカテゴリ、そして見つけた識別子を記録しておきましょう。このように条件を決めて候補を絞る作業は、大量の文書を扱うときにも役立ちます。手動で検索するだけでなく、AIを使って候補となる文書を抽出し、原文の確認と分けて調べる方法へ進みましょう。
AIでarXivを調べる方法|候補抽出と原文確認を分ける
論文候補が多いときは、AIに要旨の整理や比較を任せられます。ただし、「関連する論文を探して要約して」とだけ指示すると、検索条件や識別子が回答に残らないおそれがあります。原文を追跡できるよう、入力項目と出力項目を先に指定します。
AIには、検索に使う言葉の準備と、取得した候補の整理を任せます。例えば、日本語の調査テーマから英語の検索キーワードを提案させます。その後、arXivから取得したタイトルや要旨、識別子などの情報をAIに渡し、研究の対象や結果といった共通の項目で整理させます。
論文候補を定期的に取得する場合は、API(検索結果をプログラムから取得する仕組み)を使えます。公式マニュアルでは、検索条件を渡すsearch_queryと、識別子を指定するid_listなどを説明しています。arXivから得た識別子と要旨をAIへ渡すと、原文へ戻る情報を残せます。
AIへ指示を出すときは、各候補の識別子を消さずに残すように伝えます。また、要旨に書かれている内容だけをまとめさせます。論文が査読済みであるかや、正式に出版されたかどうかといった情報をAIに推測させてはいけません。
AIが作った要約は、次に読む原文を選ぶためのメモとして使います。要旨に研究方法や条件が十分に書かれていない論文もあるため、AIが項目を埋められなかった箇所は「要旨では未確認」として残させます。AIの要約を読んだだけでは、研究結果が正しいかどうかは判断できません。
候補を絞り込んだら、人はAIの表に残された識別子を使ってarXivのページを開きます。引用したい主張が本文のどこにあるかを確かめ、ジャーナルの情報などから正式な出版状態を自分の目で確認します。
この分担では、AIが候補を共通項目で整理し、人が識別子から原文を確認します。次に必要なのは、実際に読んだ本文がどの版だったかという記録です。同じ識別子でも内容が変わる版履歴を見ていきます。
v1・v2と版履歴|同じ識別子でも読んだ版を固定する

AIを使って候補を絞り込み、次に原文を読む段階へ進むとします。このとき、後日同じ識別子のページを開くと、自分が読んだときとは違う最新の内容が表示されることがあります。これを防ぐには、読んだ本文の「版」を固定して記録する必要があります。
arXivでは、公開された各版を研究記録の一部として残しています。内容の更新や撤回が行われると新しい版が作られ、識別子の末尾に版番号が追加される仕組みです。
版番号を省略したページを開くと最新版が表示されるため、特定の版を示すには「v1」や「v2」といった版番号を使います。調査のメモを残すときは、文書を特定する「arXiv識別子」と「版番号」をセットで記録し、いつの研究成果かを区別するために「初回公開日と更新日」も控えます。
さらに、同名の研究と取り違えないように「タイトル・著者・要旨」を残し、正式な出版物の確認を始める手がかりとして「journal reference」や「DOI」も記録します。実際の論文ページを見ると、これらの項目は混ざることなく別々の情報として表示されています。
これはAIを使ってプログラムから情報を取得した場合も同じです。APIへの要求に対する実際の応答でも、識別子や版のURL、初回投稿日時、更新日時、journal referenceは別々の項目として返ってきます。
また、公開された文書が後から取り下げられた場合でも、過去の記録が跡形もなく消えるわけではありません。arXivでは、撤回の理由を書いた新しい版が作られ、過去の版も履歴からたどれるようになっています。
撤回表示がある文書を扱うときは、撤回理由と現在の表示を確認します。過去版を参照する場合も、撤回表示と理由を省かず、通常のプレプリントと同じようには紹介しません。
このように、いつ公開されたどの版を読んだのかを正確に記録することで、自分が確認した状態を正しく説明できるようになります。読んだ版が特定できたら、次はその研究がジャーナルなどで正式に出版されているかを確かめます。査読済みの掲載論文と正式版を確認する手順へ進みましょう。
査読済み掲載論文と正式版を確認する手順

読んだ版を固定できても、arXiv内の表示だけで正式出版の有無や査読状態を決めることはできません。正式出版と査読状態を、それぞれarXivとは別に確かめます。
正式な出版物を探す手がかりになるのが、abstractページに表示される「journal reference」や「DOI」です。arXivでは、論文の正式な出版情報がそろったときにこれらの情報を登録する方法を案内しています。
ただし、DOIが表示されていることだけで「査読済みである」とは判断できません。研究成果のリンクを管理するCrossrefの仕組みでも、プレプリントと後から発表された正式なジャーナル論文は、別のものとして扱われます。
そのため、arXivの表示を出発点として、次の順に照合を進めます。まず、abstractページでjournal reference、DOI、Comments欄を確認します。掲載予定や採択されたばかりという情報は、Comments欄に書かれていることもあります。
次に、DOIのリンクなどを開いて出版社やジャーナルの公式ページへ移動します。そこで、タイトル、著者、掲載誌、公開日がarXivの情報と一致しているかを比べます。
さらに、出版社ページで正式版の本文を確認し、自分がarXivで読んだ版と、実験条件や表、結論が同じかどうかを確かめます。
出版社やジャーナルの記録を確認できない場合は、「査読済み」と書かず、「arXivに公開されたプレプリント」と表記します。出版社版を確認できても、arXiv版と同じ本文だとは限りません。出版社版の査読状態を確認し、読んだarXiv版とは別の文書として差分を記録します。
この手順では、正式出版物を特定し、読んだarXiv版との差を確認します。論文の文章や図表を自分の記事で利用する場合は、出版状態とは別に再利用条件を調べます。次はライセンスと著作権を見ていきます。
引用・図表利用で見るライセンスと著作権

無料で読めるPDFであっても、その本文や図表を自分の記事にそのまま転載してよいとは限りません。ウェブ上で閲覧やダウンロードができることと、内容を別の場所で再利用できることは別の問題です。
この再利用の条件を決めるのが「ライセンス」です。arXivでは、記事を誰でも無料で閲覧・ダウンロードできることと、本文を再利用する許諾が投稿者の選んだライセンスによって決まることを分けて説明しています。さらに、同じ研究であっても、公開された版ごとに異なるライセンスが選ばれている場合があります。
図表や文章を利用するときは、対象版に表示されたライセンスを確認します。CC BY 4.0では、適切なクレジットとライセンスへのリンクが必要です。変更した場合は、その表示も求められます。
これらの条件を満たせば、配布・改変や営利目的での利用が認められます。NCを含むライセンスは非営利利用に限られ、NDを含むライセンスは改変物の配布が制限されます。
短いライセンス表示だけで利用可能とは判断しません。論文には、第三者が作った素材や出版社が権利を持つ画像が含まれる場合があるためです。
arXivの投稿規約では、投稿者が第三者素材を含める権利を持つと表明します。プライバシーや肖像権など、別の権利が利用を制限する可能性もあります。
無料で閲覧できることだけを、転載や改変の許諾根拠にはできません。図表や本文を転載・改変する場合は、対象版のライセンス本文と第三者の権利を分けて確認します。本文を引用する場合は、転載と同じ許諾条件だと決めつけず、適用される引用要件を別に確認します。条件を確認できない図表は転載せず、書誌情報を示したうえで研究内容を自分の言葉で要約します。
arXivを検索の入り口として使うときは、これまで見てきた「検索による候補の抽出」「読んだ版の固定」「正式出版の確認」「再利用の許諾」という4つの軸を分けて考えます。どの項目の確認が終わっていて、何が未確認なのかを整理することで、記事に断定してよい範囲が明確になり、読者へ正確な情報を伝えられるようになります。
よくある質問
Q1. 後から同じ本文を開くには、何を保存しますか?
arXiv識別子にv1やv2を付けた版番号付きURLと、取得日を保存します。版番号のないURLは後日最新版を表示します。そのため、過去の分析を再現する記録には使いません。
Q2. journal referenceやDOIがない場合、どこを探しますか?
論文タイトルと著者名で、出版社やジャーナルの公式ページを探します。正式出版と査読状態を確認できない間は、arXiv識別子と版番号を示し、プレプリントとして扱います。
Q3. Comments欄に「accepted」とあれば査読済みですか?
Comments欄は掲載予定や採択情報を探す手掛かりです。その記載だけで査読済みと決めず、出版社やジャーナルの掲載ページで記事種別と掲載状態を確認します。
Q4. 出版社版とarXiv版の内容が違う場合、どちらを引用しますか?
実際に根拠として読んだ版を引用します。出版社版の結論を紹介するなら出版社版を、arXiv版の記述を紹介するならarXiv識別子と版番号を示し、両者を同じ本文として扱いません。
Q5. 撤回表示を見つけたら、調査メモに何を残しますか?
撤回表示、撤回理由、対象の版番号、確認日を残します。過去版を参照する場合も、撤回された文書であることを本文から外しません。
Q6. 同じ論文なら、最新版のライセンスだけ見ればよいですか?
版ごとに異なるライセンスが選ばれる場合があるため、利用する本文や図表が含まれる版を確認します。最新版の表示を過去版へそのまま当てはめません。
Q7. AIの整理表には、どの列を残しますか?
識別子と版番号、タイトルと著者を列に分けます。要旨に明記された内容と、本文確認が必要な内容も別の列にします。
正式出版、査読状態、版間の差は、確認元のURLと確認日を記録できるまで「未確認」とします。
調査手法について
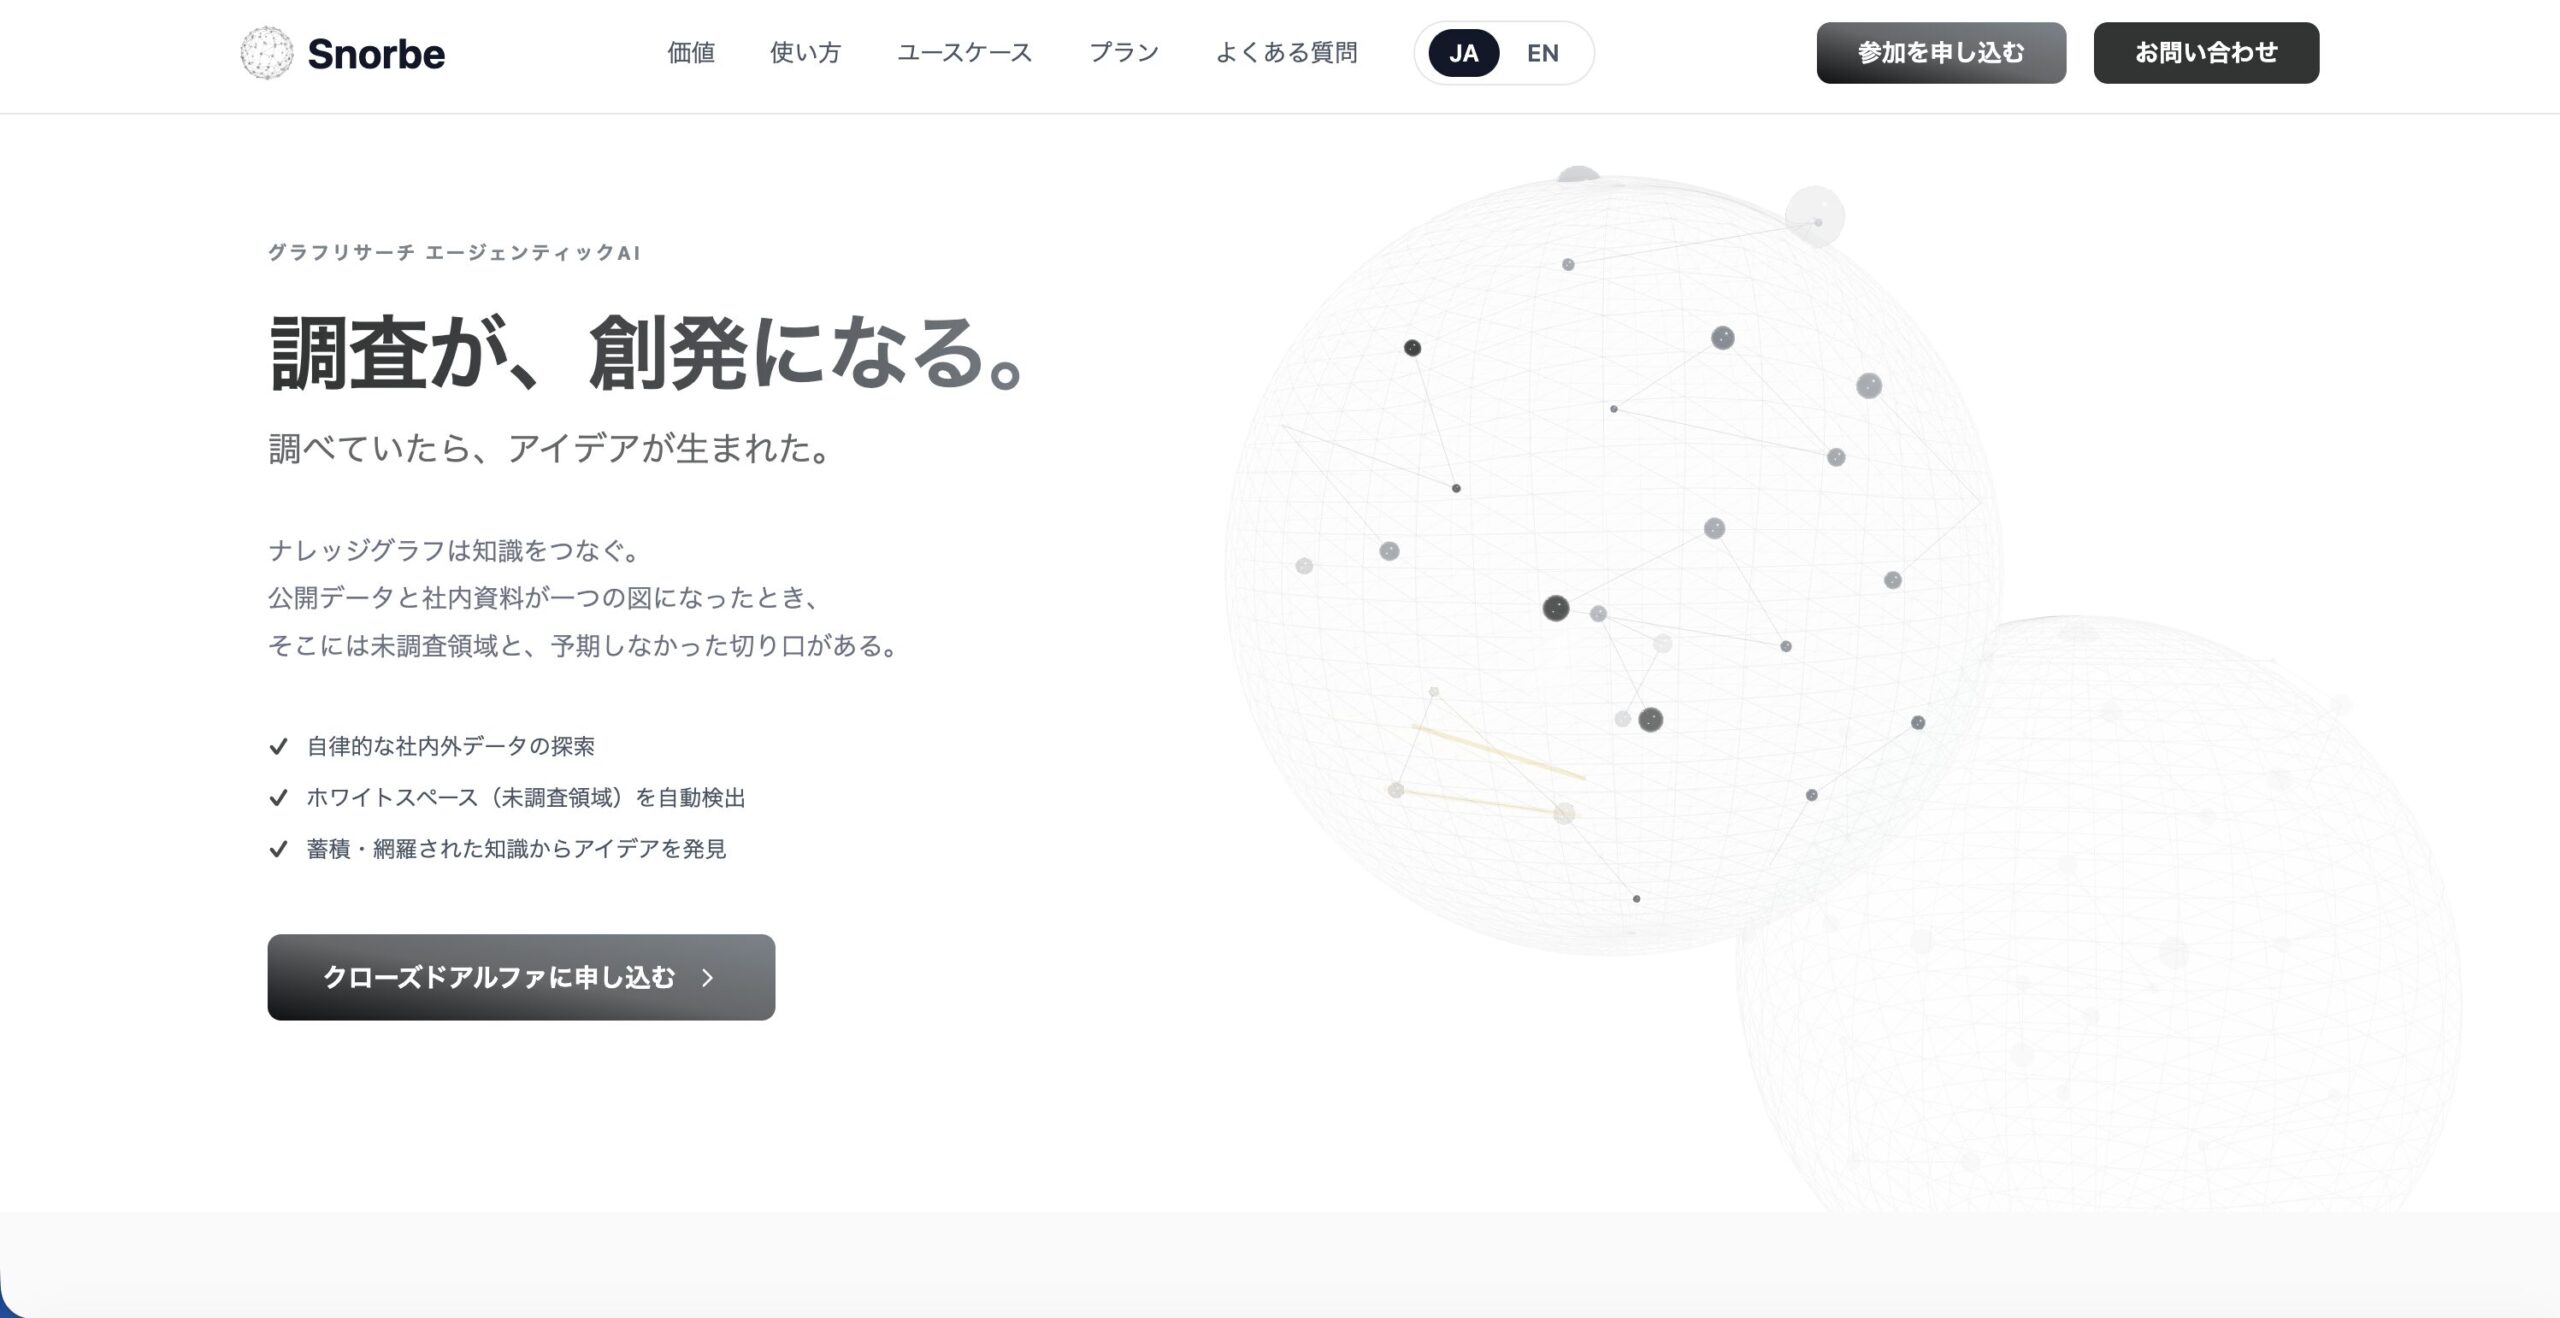
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai


コメント