文献調査を始める研究者や新規事業の担当者が新しい分野を調べる際、どの論文から読めばよいか、重要な研究を見落としていないかと迷うことがあります。そのようなときは、手元にある一つの起点論文から小さく始め、過去の参考文献や未来の引用文献をたどって引用ネットワークを作る方法が役立ちます。この手順を身につけることで、調査の目的に合わせて可視化のためのソフトウェアやプログラムを使い分け、AIに論文のまとまりを説明させる範囲と、人が直接原論文を読んで内容を確認する範囲の分担を自分で決められるようになります。
具体的な手順としては、まず学術データベースから起点論文の前後関係のデータを入力として集めます。そのデータを操作して、論文そのものの情報をまとめたnodes.csvと、どの論文からどの論文へ引用の線を引くかを記録したedges.csvという二つのファイルを出力します。この中間成果物を作るときには、引用した側の論文から引用された側の論文へと向きのある線を引くという原則を守ります。出力したファイルを使ってネットワークの図を描画しますが、画面上に配置された円同士の距離は関連の強さの近似であり、研究が発展してきた時系列を意味するものではありません。
データを集める際には、利用する学術データ源の種類によって収録されている論文の範囲が異なり、情報が更新された時点によっても取得できる件数が変わることに注意します。そのため、どのデータベースを調べても常に全件数が完全に一致するという前提は持たずに作業を進めます。また、画面上で多くの引用を集めているからといって、その引用数で論文の品質順位が決まるわけではありません。引用されているという事実は、他の研究者がその内容を支持したことや追試に成功したことを証明するものでもないため、図に引かれた線を誤って読まないように基準を持つことが大切です。
図を描画した後の読み解きの工程では、AIと人の役割を明確に分けます。複数の論文がまとまったクラスタの傾向をつかむために、集めたデータをAIに入力して概要を出力させますが、現在のオープンなデータベースは引用情報と名寄せには改善余地があるため、AIのクラスタ説明は原論文確認の代わりにならないという限界を持ちます。そのため、AIが作成した説明はあくまで暫定的な見取り図として扱います。最後は必ず人が直接原論文の本文を確かめることで、正確な研究の流れと見落とし候補の把握を完了させます。
引用ネットワークで分かることと分からないこと
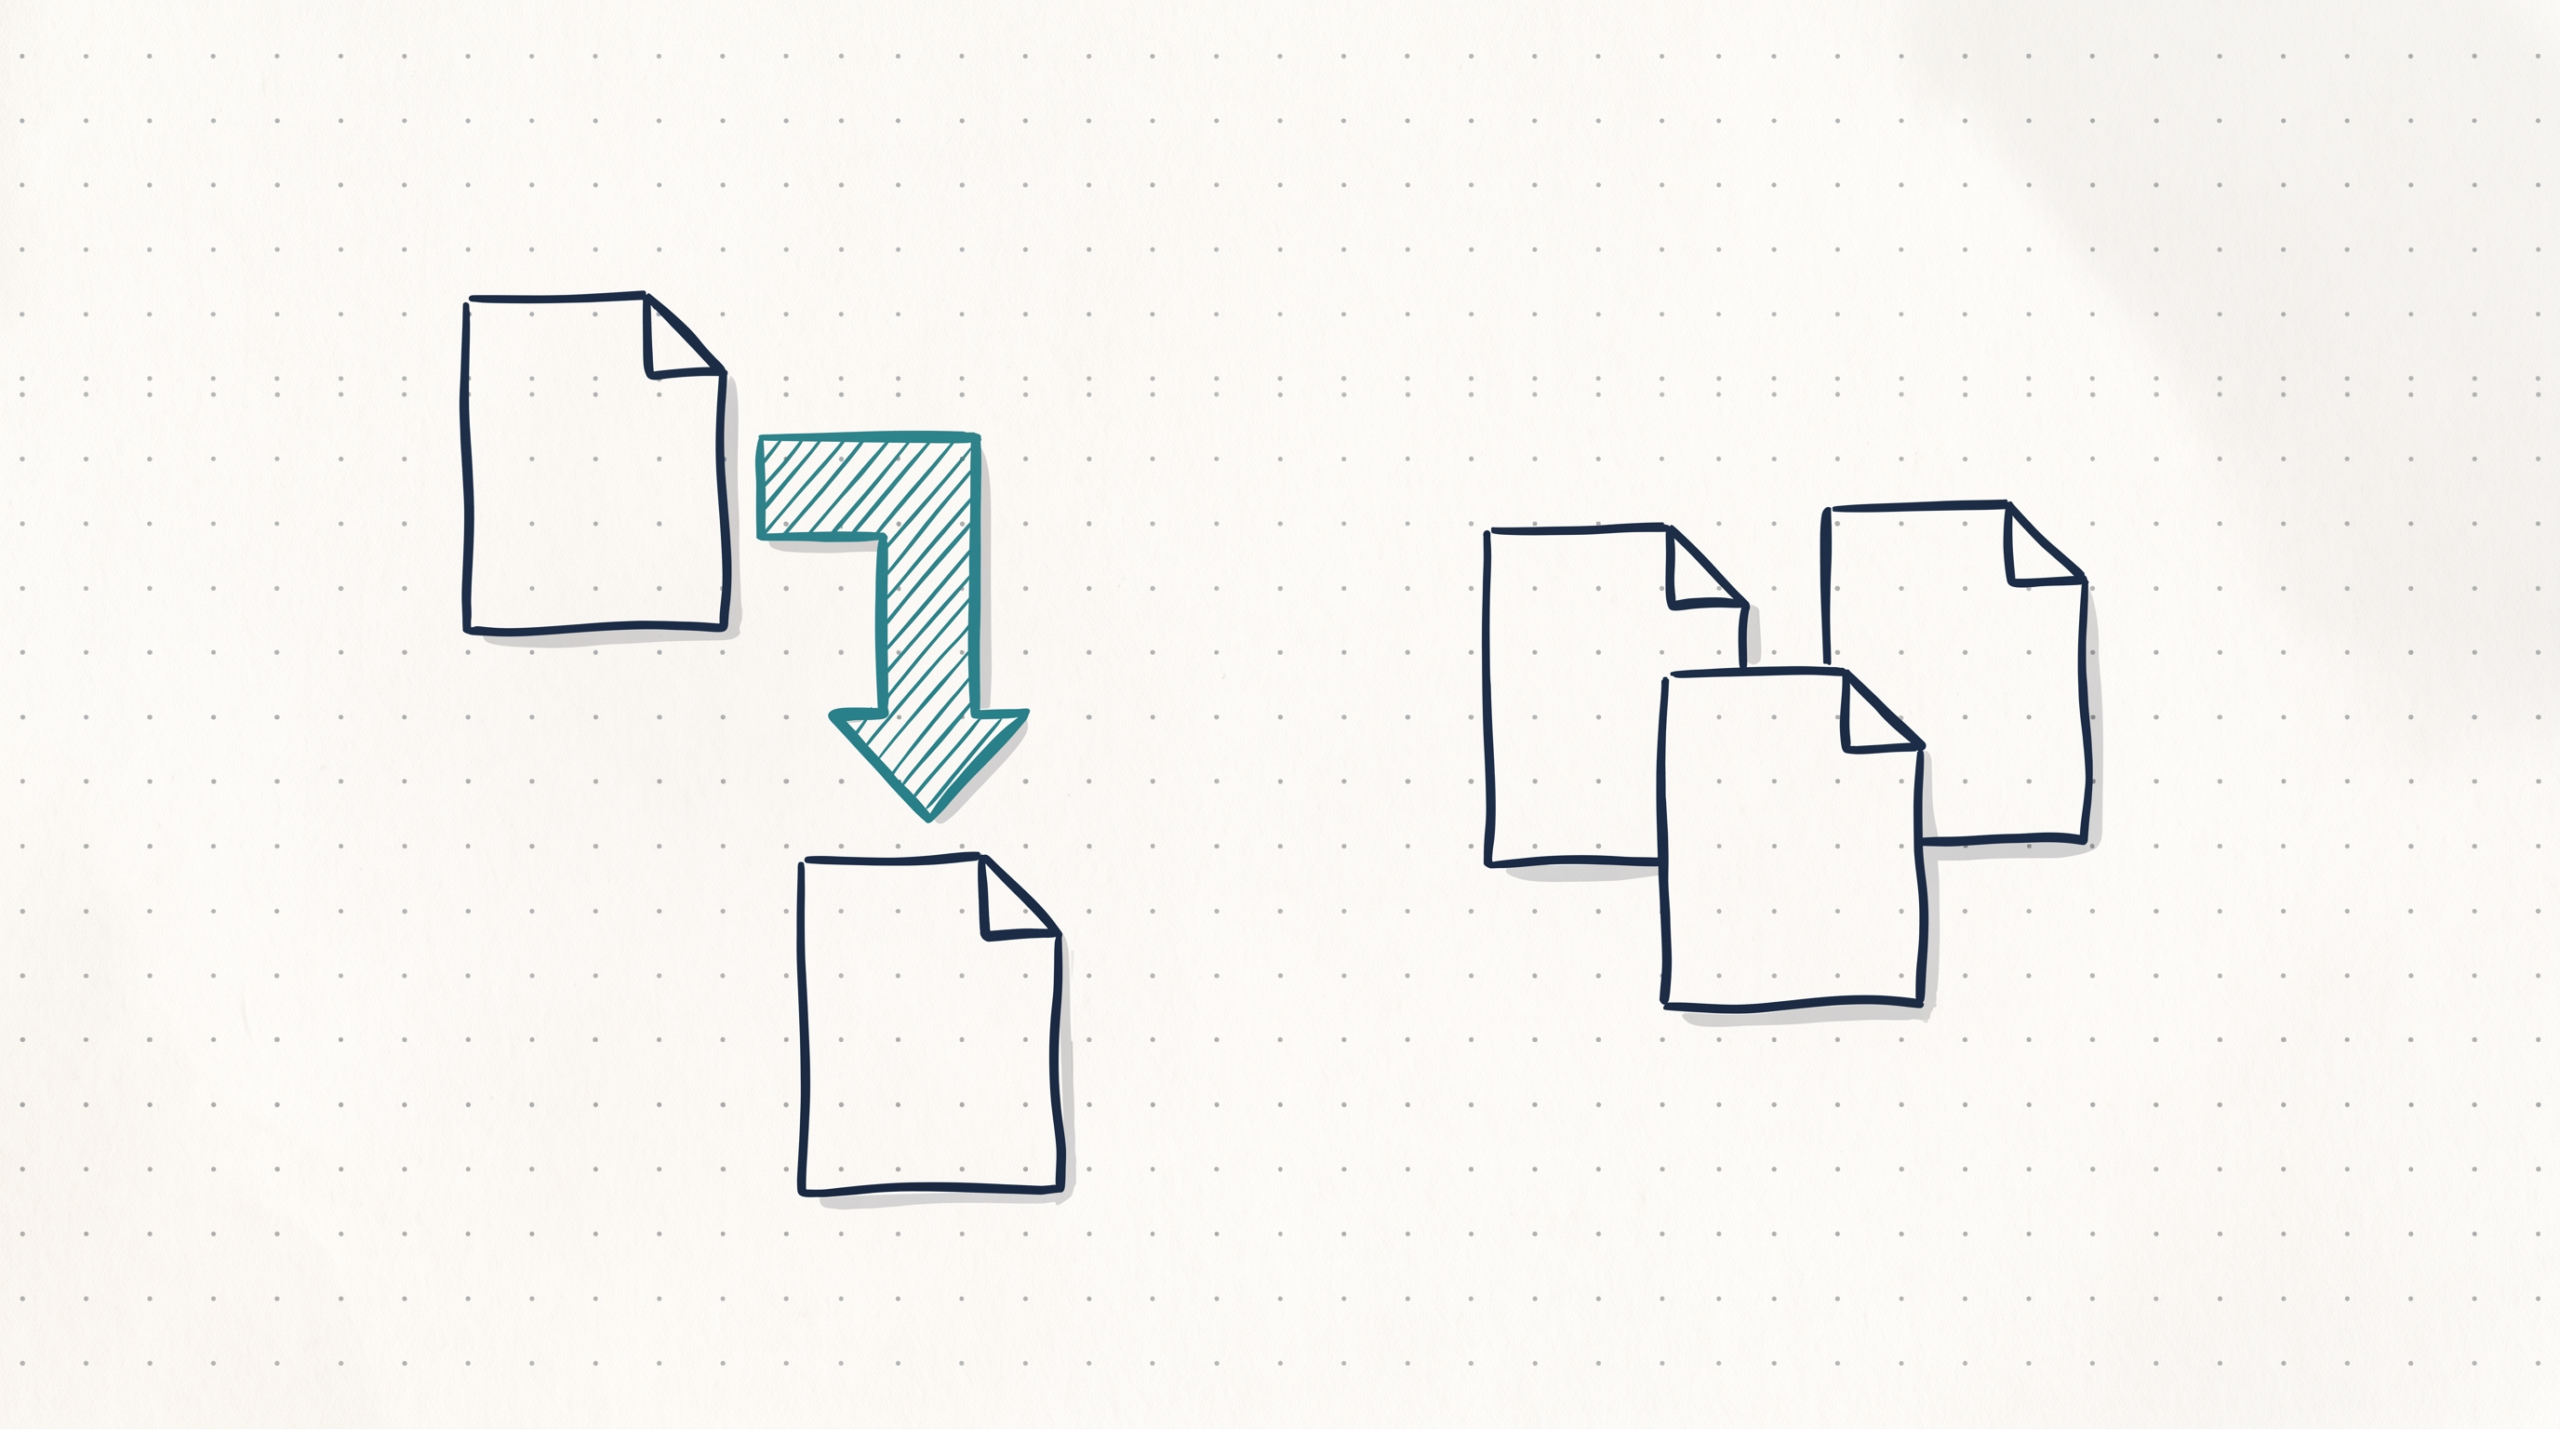
学術論文を調査する際、引用ネットワークを図として可視化することで、膨大な文献同士のつながりを全体として捉えることができます。しかし、描かれた図を正しく読むための基準を持たないと、線の向きや円の配置から誤った結論を導いてしまう可能性があります。図の読み方を決めることは、ネットワーク分析を始める最初の重要な手順です。
まず、ネットワークにおける線が何を表しているのかを確認します。基本的な引用方向としては、論文Aが論文Bを参考文献に載せた場合、引用した論文Aから引用された論文Bへと線を引きます。この向きのある線は、あくまで著者が過去の文献を参照したという事実だけを示しています。したがって、線がつながっているからといって、論文Aが論文Bの内容を支持していることや、追試に成功したことを証明するわけではありません。これまでの研究の課題点を指摘するための引用も含まれるためです。
次に、図に配置された要素の意味を整理します。可視化ソフトウェアを利用して描画した図では、円とラベルの大きさは重み、色はクラスタ、線はリンクを表します。また、画面上の円同士の距離は関連の強さを近似したものにすぎません。そのため、ある論文から別の論文への距離や画面上の配置を、研究が発展してきた時間の流れとして読むことはできません。
さらに、背景となるデータの性質にも注意が必要です。引用ネットワークを作成する際、論文のデータは専用のデータベースから取得しますが、利用するデータ源によって収録されている論文の範囲や、情報が更新された時点に差があります。そのため、世界中のあらゆるデータベースで常に同じ件数が揃うわけではありません。現在利用できるオープンな学術データベースは、引用情報と著者・所属の解析精度を継続的な改善対象としている段階にあります。画面上で多くの引用を集めているように見えても、その引用データはすべての文献を漏れなく集めた品質評価表ではないという前提を持つ必要があります。引用数が多いというだけで、論文の品質順位が決まるわけではないということです。
このように、図に描かれた線や位置が何を意味し、何を意味しないのかをあらかじめ理解しておくことで、可視化された結果の誤読を防ぐことができます。図を読むための基本的な基準を作ったうえで、次は自分自身の分析目的に合わせて、どのような種類の線を引くべきかを選ぶ段階へと進みます。
引用・共引用・書誌結合を目的で選ぶ
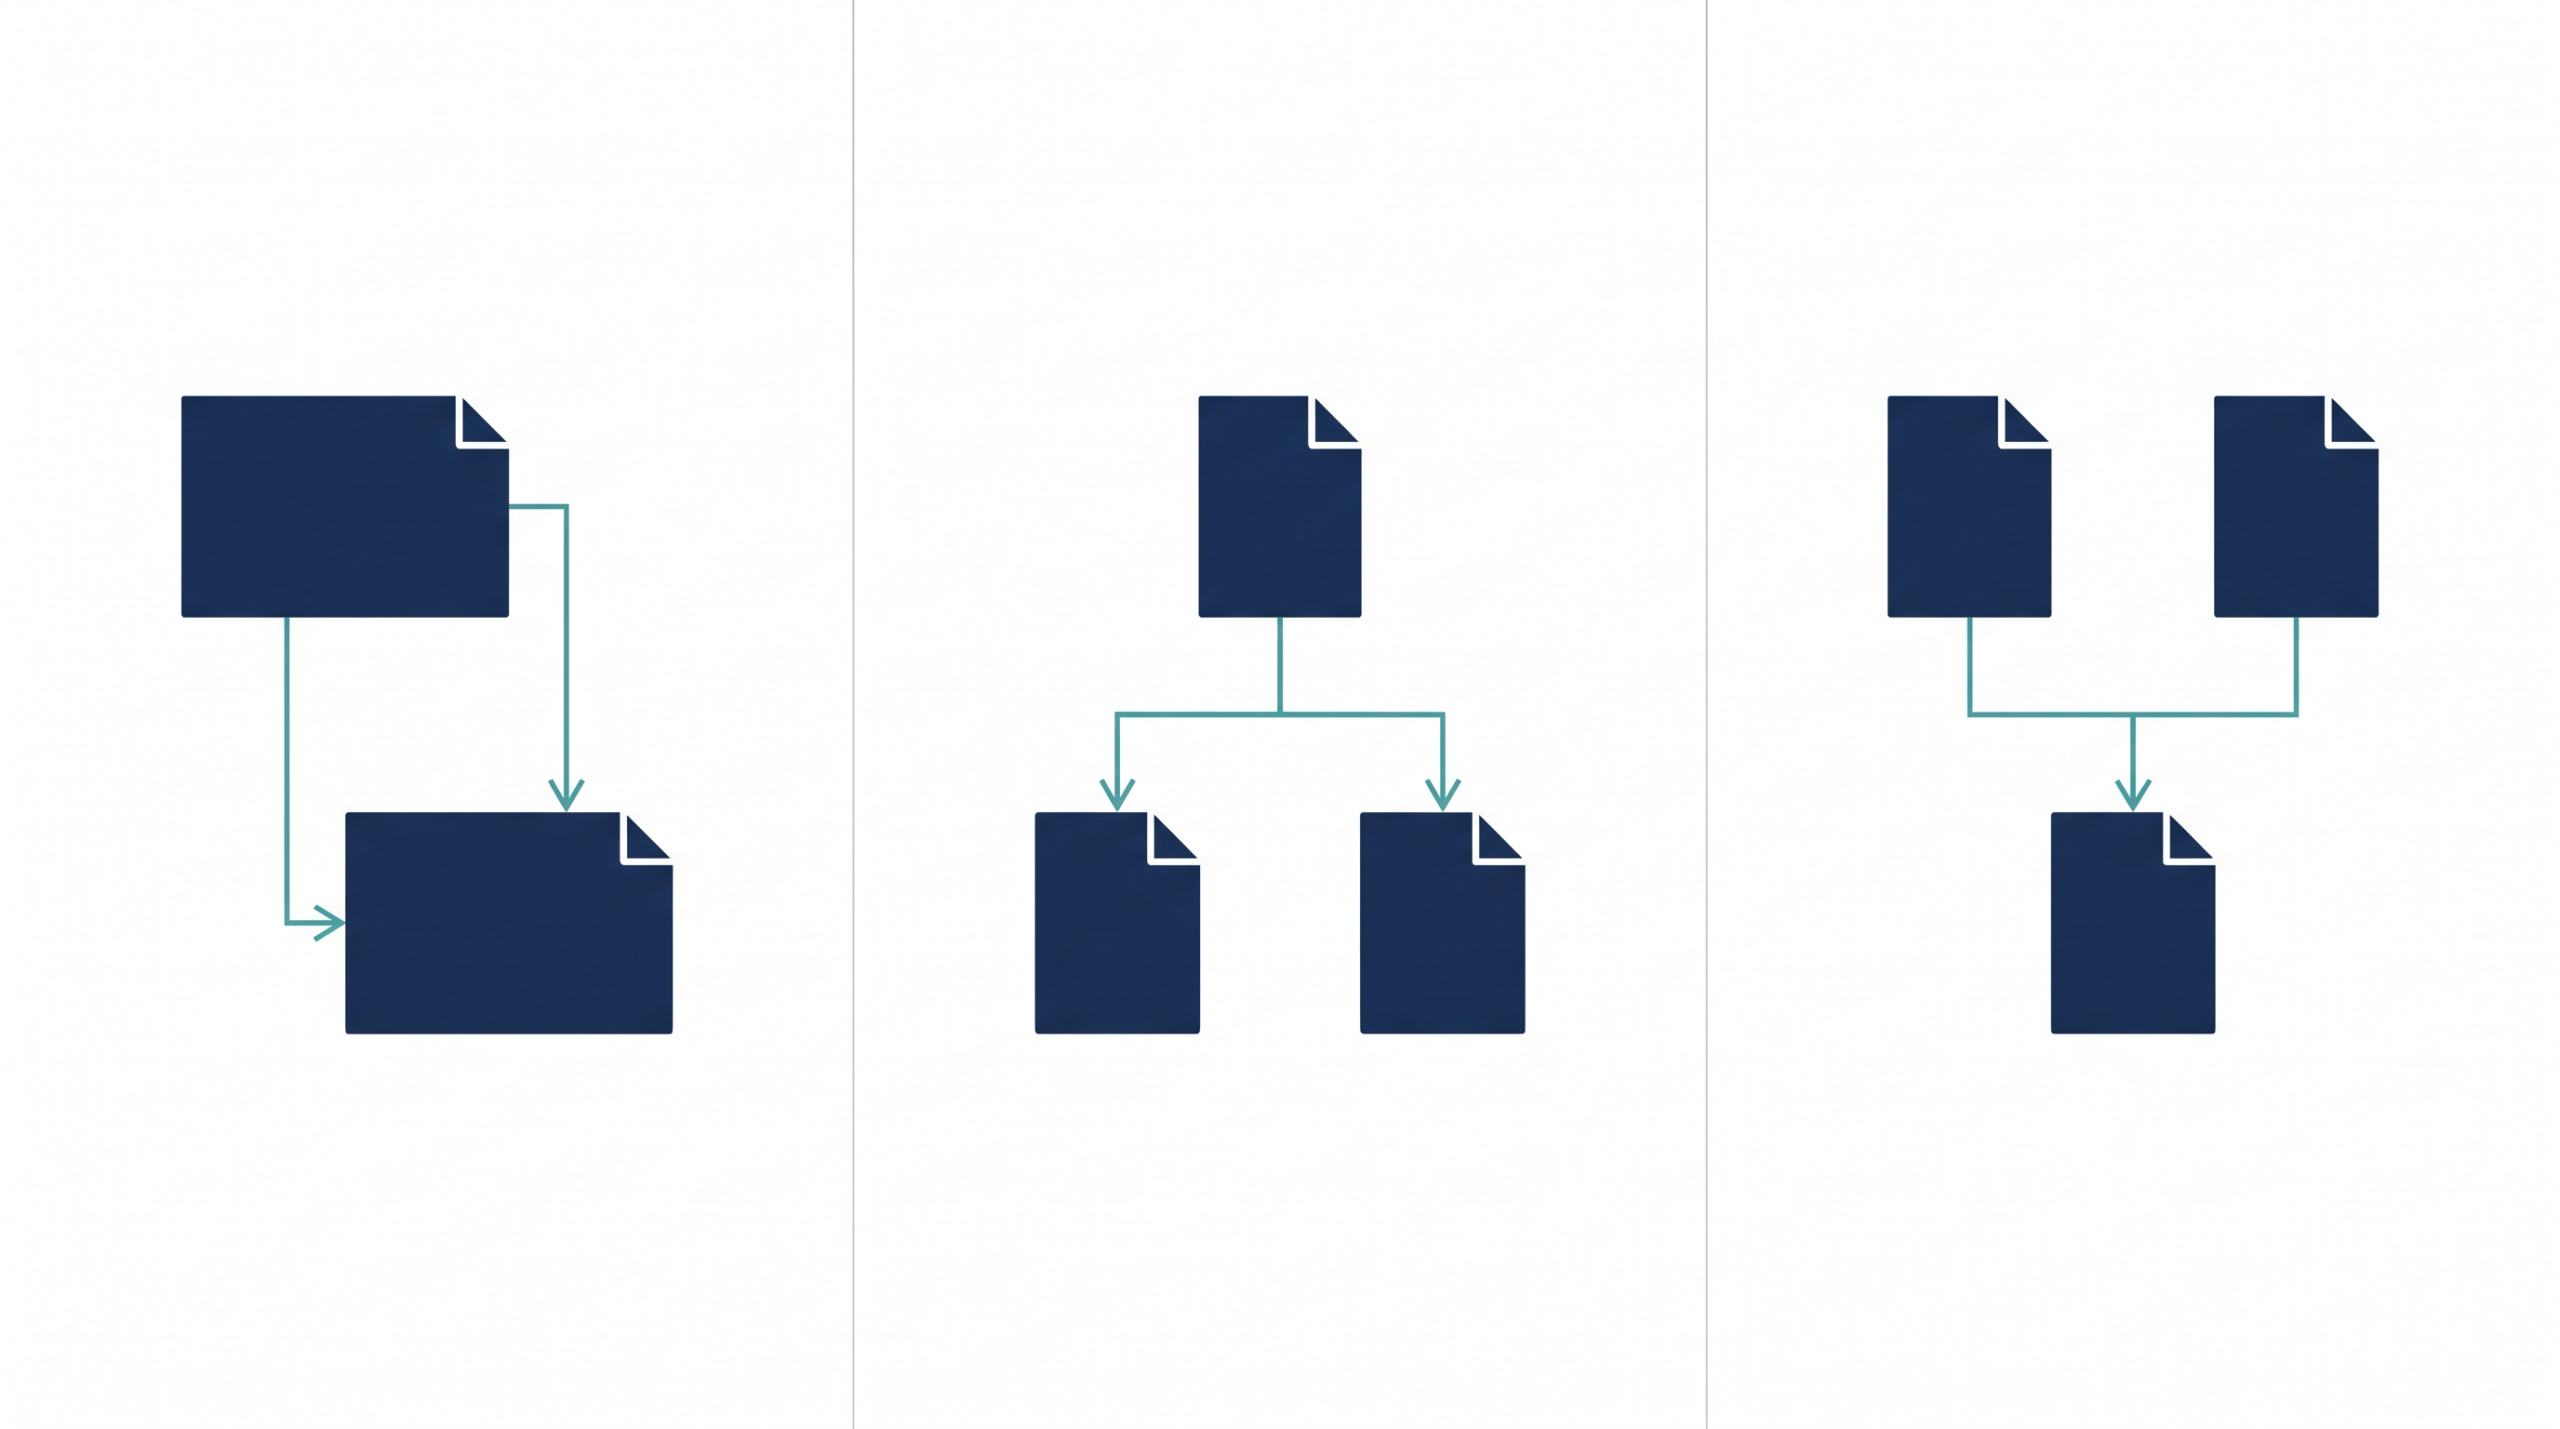
ネットワークの図を正しく読む基準ができたら、次は自分の分析目的に合わせて、どの関係を可視化するのかを選ぶ段階に入ります。代表的な可視化ソフトウェアであるVOSviewerはcitation、co-citation、bibliographic couplingなどを別のネットワークとして作成できるツールです。ソフトウェアの公式例には引用ネットワーク、共引用ネットワーク、書誌結合ネットワークが別々に示されるように、分析したい内容に応じてこの三つのネットワークを使い分ける必要があります。
一つ目の引用ネットワーク(citation)は、論文間の直接の参照関係を描き出すものです。ここでは、引用した論文から引用された過去の論文へ向かって線を引くという原則のまま、データの結びつきを可視化します。特定の論文がどのような研究に参照されてきたかを探る際に便利です。ただし、線が多く集まっているからといって、その論文の内容が他の研究者に支持されていることや、品質が優れていることを証明するものではないことに注意して図を読む必要があります。
二つ目の共引用ネットワーク(co-citation)は、過去の二つの論文が、後から発表された第三の論文によって同時に引用されている関係を表します。複数の過去の論文がよくセットで参照されている場合、それらの論文同士の間に線を引きます。この方法は、ある研究分野において、どの文献とどの文献が基礎的な前提として組み合わせて使われているかを把握したいときに適しています。
三つ目の書誌結合ネットワーク(bibliographic coupling)は、二つの論文が、共通の過去の論文を参考文献としてリストに載せている関係を表します。最近発表された新しい論文の近さを見るなら共通参考文献を数える書誌結合を選ぶのが適しています。対象となる二つの新しい論文に直接の引用関係がなくても、過去の同じ文献をたくさん参照していれば、研究の土台や関心事が似ている可能性が高いと人が原論文を確認するための手がかりになります。
これらのうちどのネットワークを作る場合でも、背景となるデータの性質を忘れないようにします。利用する学術データ源によって論文の収録範囲に違いがあり、さらにデータが更新された時点によっても取得できる件数に差が出ます。そのため、どのデータベースを検索してもすべての件数が完全に一致するという前提は持たずに分析を進めます。
自分の目的に合わせて可視化する線の種類を選んだら、次はその線を描くための実データを取得する作業へと進みます。
OpenAlex APIで起点論文の前後を集める
引用ネットワークを描く目的が決まったら、次は実際のデータを集める作業に移ります。ここでは、オープンな学術データベースから情報を引き出すためにOpenAlex APIを利用します。たとえば、起点となる論文のIDを「W2741809807」とした場合、このIDを入力としてAPIに渡し、この論文が過去に引用した文献と、この論文を後から引用している新しい文献の両方を、再現可能な手順で取得していきます。
まず、起点論文から過去の文献へのつながりを取得する操作を行います。一つのWorkはreferenced_worksを外向きの引用としてたどることができます。起点のW2741809807というIDのデータをAPIで呼び出し、その出力に含まれる「referenced_works」という項目を確認します。ここには、その論文の著者が執筆時に参照した過去の文献のリストが並んでいます。このデータを使うことで、引用した側のW2741809807から、引用された側の過去の論文へと線を引くという原則の通りに関係を記録することができます。
次に、起点論文に向かってくる新しい文献を集める操作を行います。これにはAPIの検索フィルタ機能を使います。フィルタの指定において、cited_byは起点Workが引用した論文、citesは起点Workを引用する論文を返すという違いがあります。今回は後から引用されたものを集めるため、filter=cites:WorkIDを入向きの引用としてたどれる仕組みを利用します。具体的に「filter=cites:W2741809807」という条件を入力して実行すると、W2741809807を参考文献としてリストに載せている新しい論文を出力として得ることができます。さらに調査範囲を広げたい場合は、論文のIDは最大100件をOR条件で一括取得できるため、複数の論文を起点にしてネットワークを効率よく拡大することも可能です。
このようにして出力されたデータには、引用関係以外の情報も含まれています。一つのWorkには題名、要旨、発行日、著者、所属、掲載先、トピック、引用などがあるため、人があとから原論文の内容を確認する際の手がかりになります。ただし、集めたW2741809807の前後データを確認する際には、データベースの性質に注意が必要です。データの収集システムにおける更新時間差で件数が少しずれる場合があるため、いつ情報を取得しても、また他のどのデータベースを利用しても常に全件数が完全に一致するという前提は持たないようにします。
最後に、APIを使って大量のデータを集められたとしても、それだけで論文の価値が決まるわけではないことを再度人が確認しておく必要があります。たとえばW2741809807に対して「filter=cites:W2741809807」を用いた検索で多くの引用データが集まったとしても、被引用数が多いからといってその論文の品質順位が自動的に高いと判断することはできません。あくまで研究の流れや見落としを防ぐための調査材料です。こうして集めた起点の前後関係のデータは、次に引用方向を固定したままCSVファイルとして保存し、可視化の前準備へと進めていきます。
nodes.csvとedges.csvを作って検算する
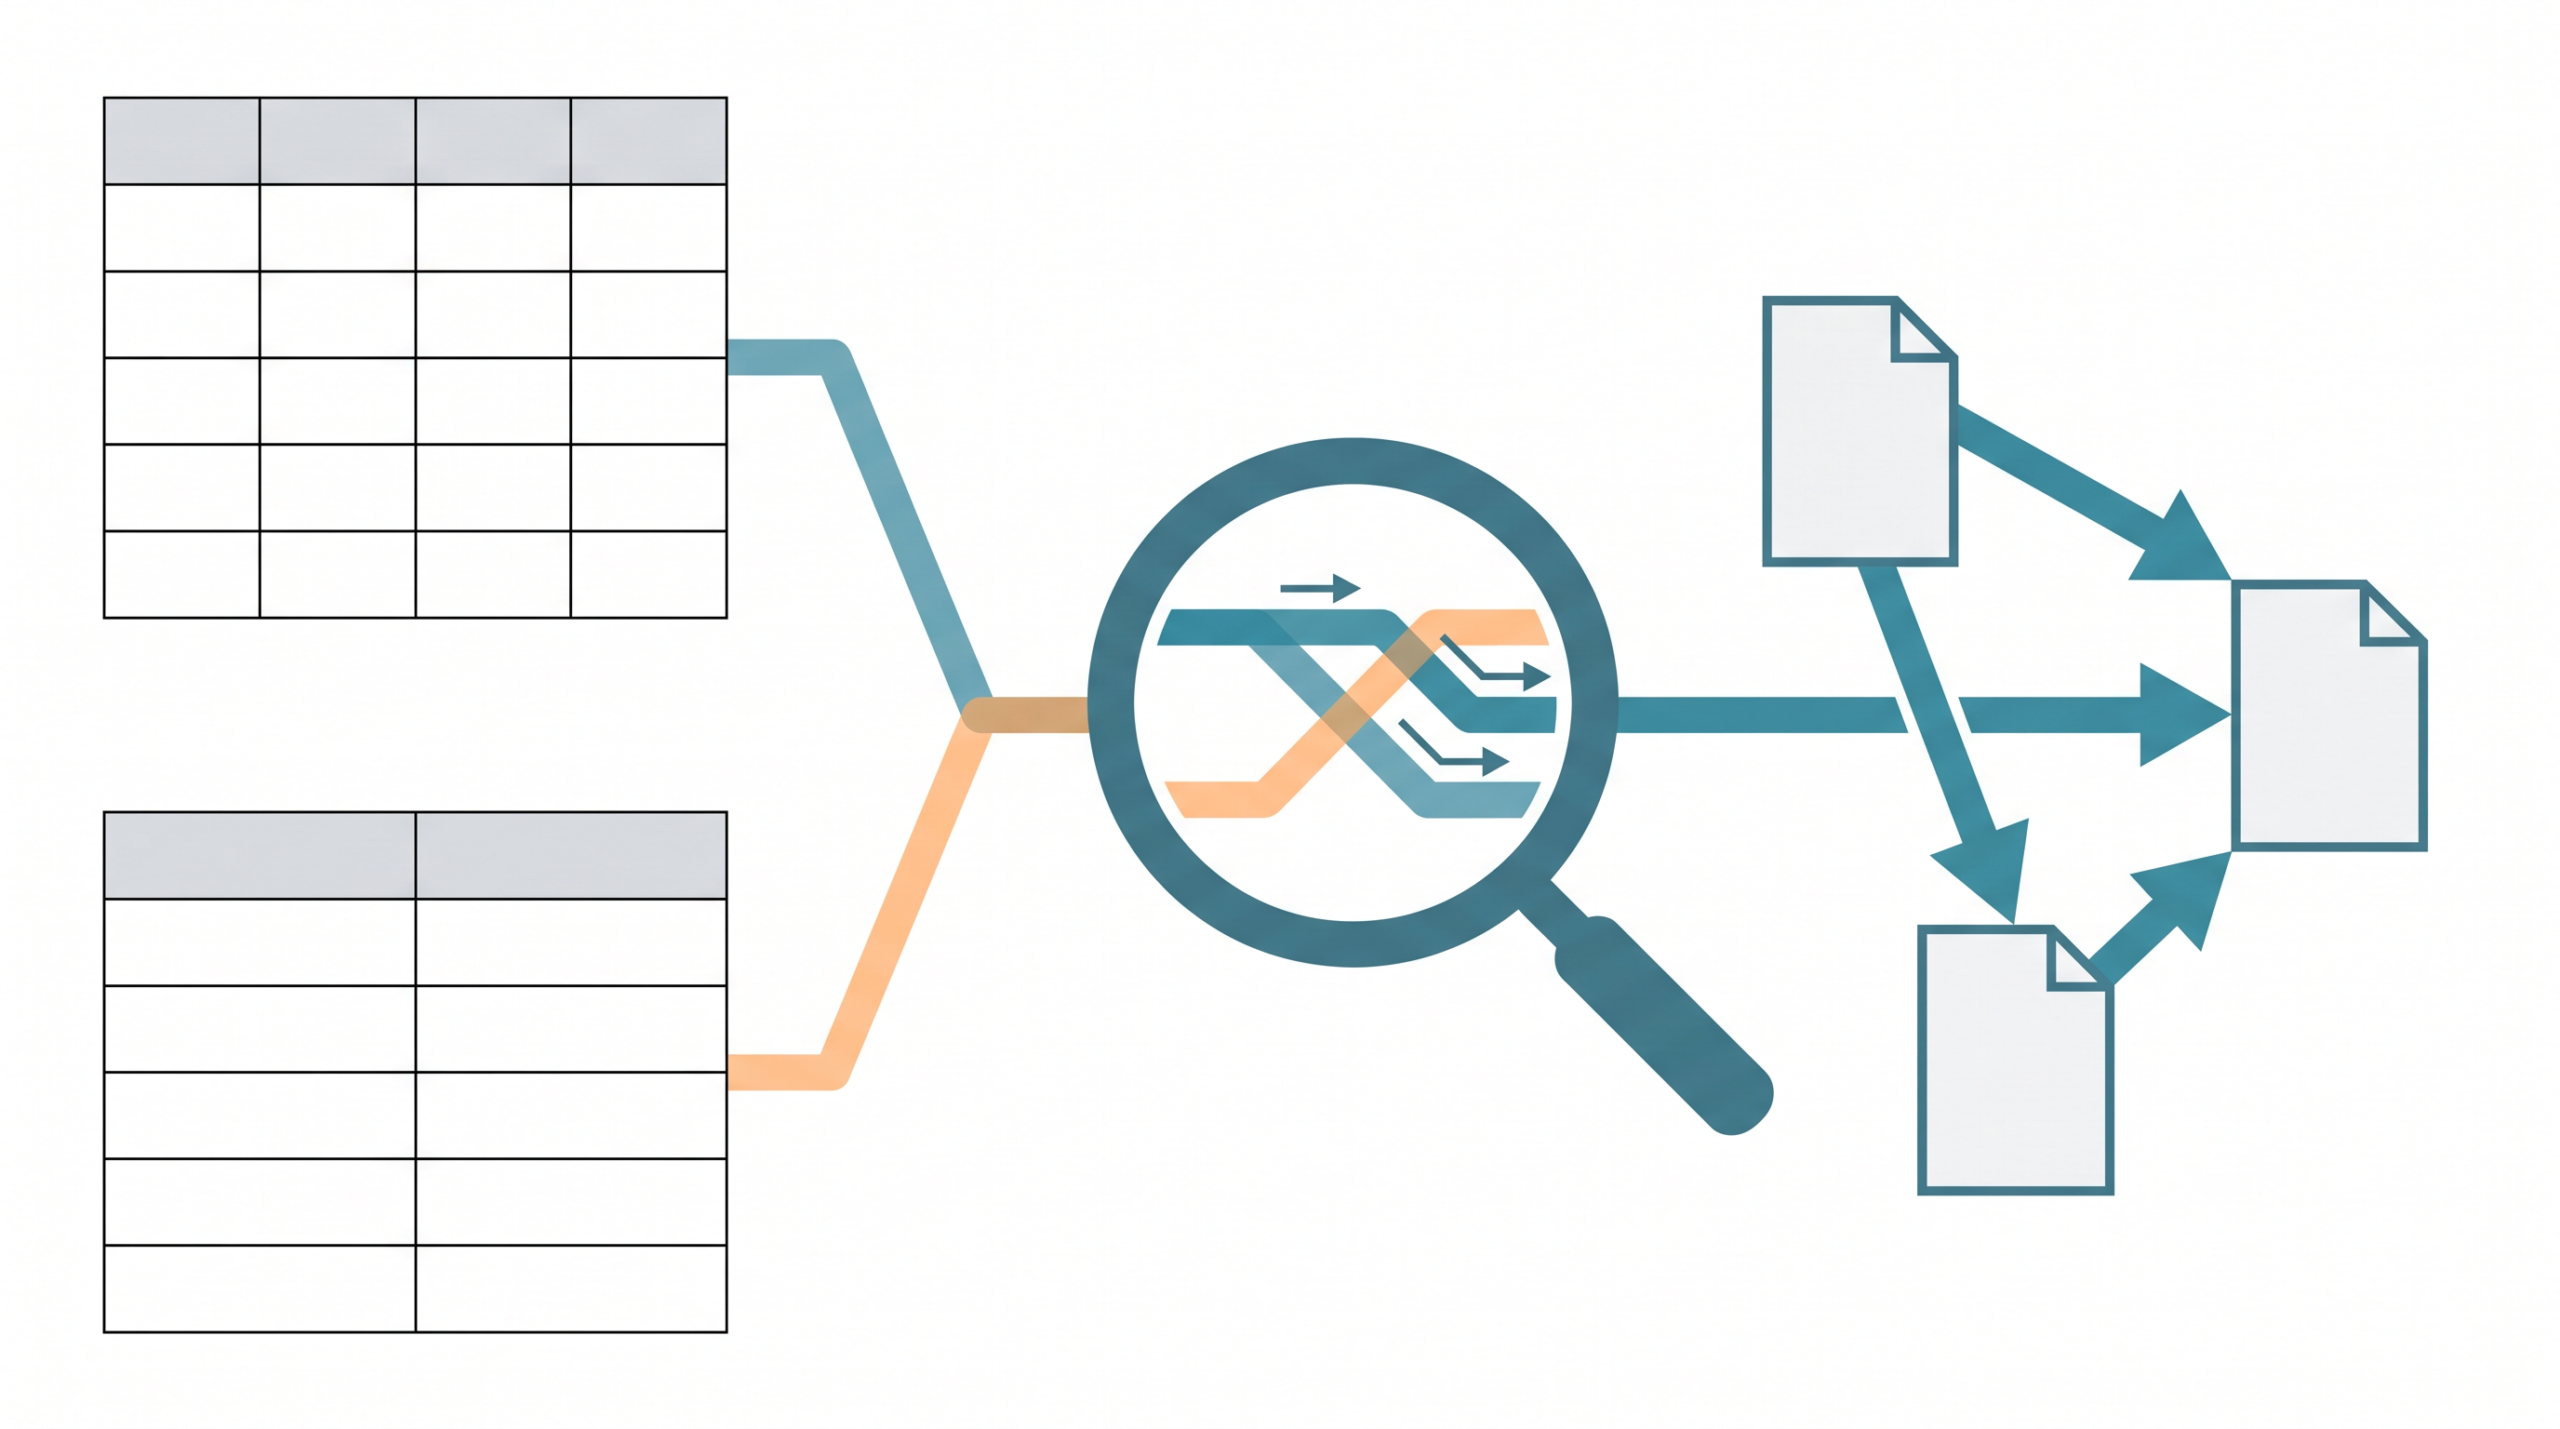
OpenAlex APIを使って起点の論文から過去の文献や新しい文献を集めたら、次はそれらをネットワークの図にするための準備を行います。APIが返してくる結果はそのままでは可視化ソフトウェアで読み込めないため、グラフ用のデータ構造に整える必要があります。ここで中間成果物として作成するのが、論文そのものの情報をまとめたnodes.csvと、論文同士のつながりを記録したedges.csvという二つのファイルです。
まず、OpenAlex APIはWorkをIDで取得し、一覧をfilter、search、sort、page、selectできる機能を持っています。この入力となるデータから、論文のIDや題名、発行年などの項目を取り出し、ネットワーク上の個々の点を表すデータとしてnodes.csvに出力します。
次に、線の情報をedges.csvとして作成する操作を行います。このとき、ファイルの列名として「source」と「target」を用意し、edges.csvのsourceを引用側、targetを引用された側に固定して行を追加していくことが重要です。前段階の手順で、W2741809807のWorkを取得し、referenced_worksのIDを参照先、filter=cites:W2741809807の結果を被引用元として保存できる仕組みを利用しました。たとえば、W2741809807が過去の論文Aを引用している場合、CSVの行には「source: W2741809807, target: 論文AのID」と記録します。逆に、後から発表された新しい論文BがW2741809807を引用している場合は、「source: 論文BのID, target: W2741809807」と記録します。
ファイルができあがったら、図を描く前にデータが正しく作られているかを検算します。検算にはプログラミング言語のPythonなどを活用します。NetworkXのDiGraphは自己ループを含む有向エッジとノード属性を保持できるため、作成した二つのCSVをこの有向グラフの形式に読み込ませることで、つながりの向きやデータの構造に間違いがないかをプログラム上で確かめることができます。ここで人がCSVの数行を直接確認し、sourceからtargetへの向きが、引用した側から引用された側へ線を引くという定義通りになっているかを見直します。
ここでも、背景となるデータの性質を忘れないようにします。データ源の収録差や情報の更新時点によって取得できる件数が変わるため、異なるデータベース間で常に結果が完全に一致するという前提は持たずに手元のCSVを確認します。また、他の論文から何度もtargetとして指定されているからといって、その引用の多さが原論文の支持や追試の成功を意味するわけではないことにも注意が必要です。
こうして線の向きやデータの構造が正しいことを検算し終えたら、検算済みのCSVファイルを次の工程へと渡します。この確実な中間成果物をもとに、用途に合わせて可視化ツールやプログラムを使い分けて図を描いていきます。
VOSviewerとPythonを使い分けて描く
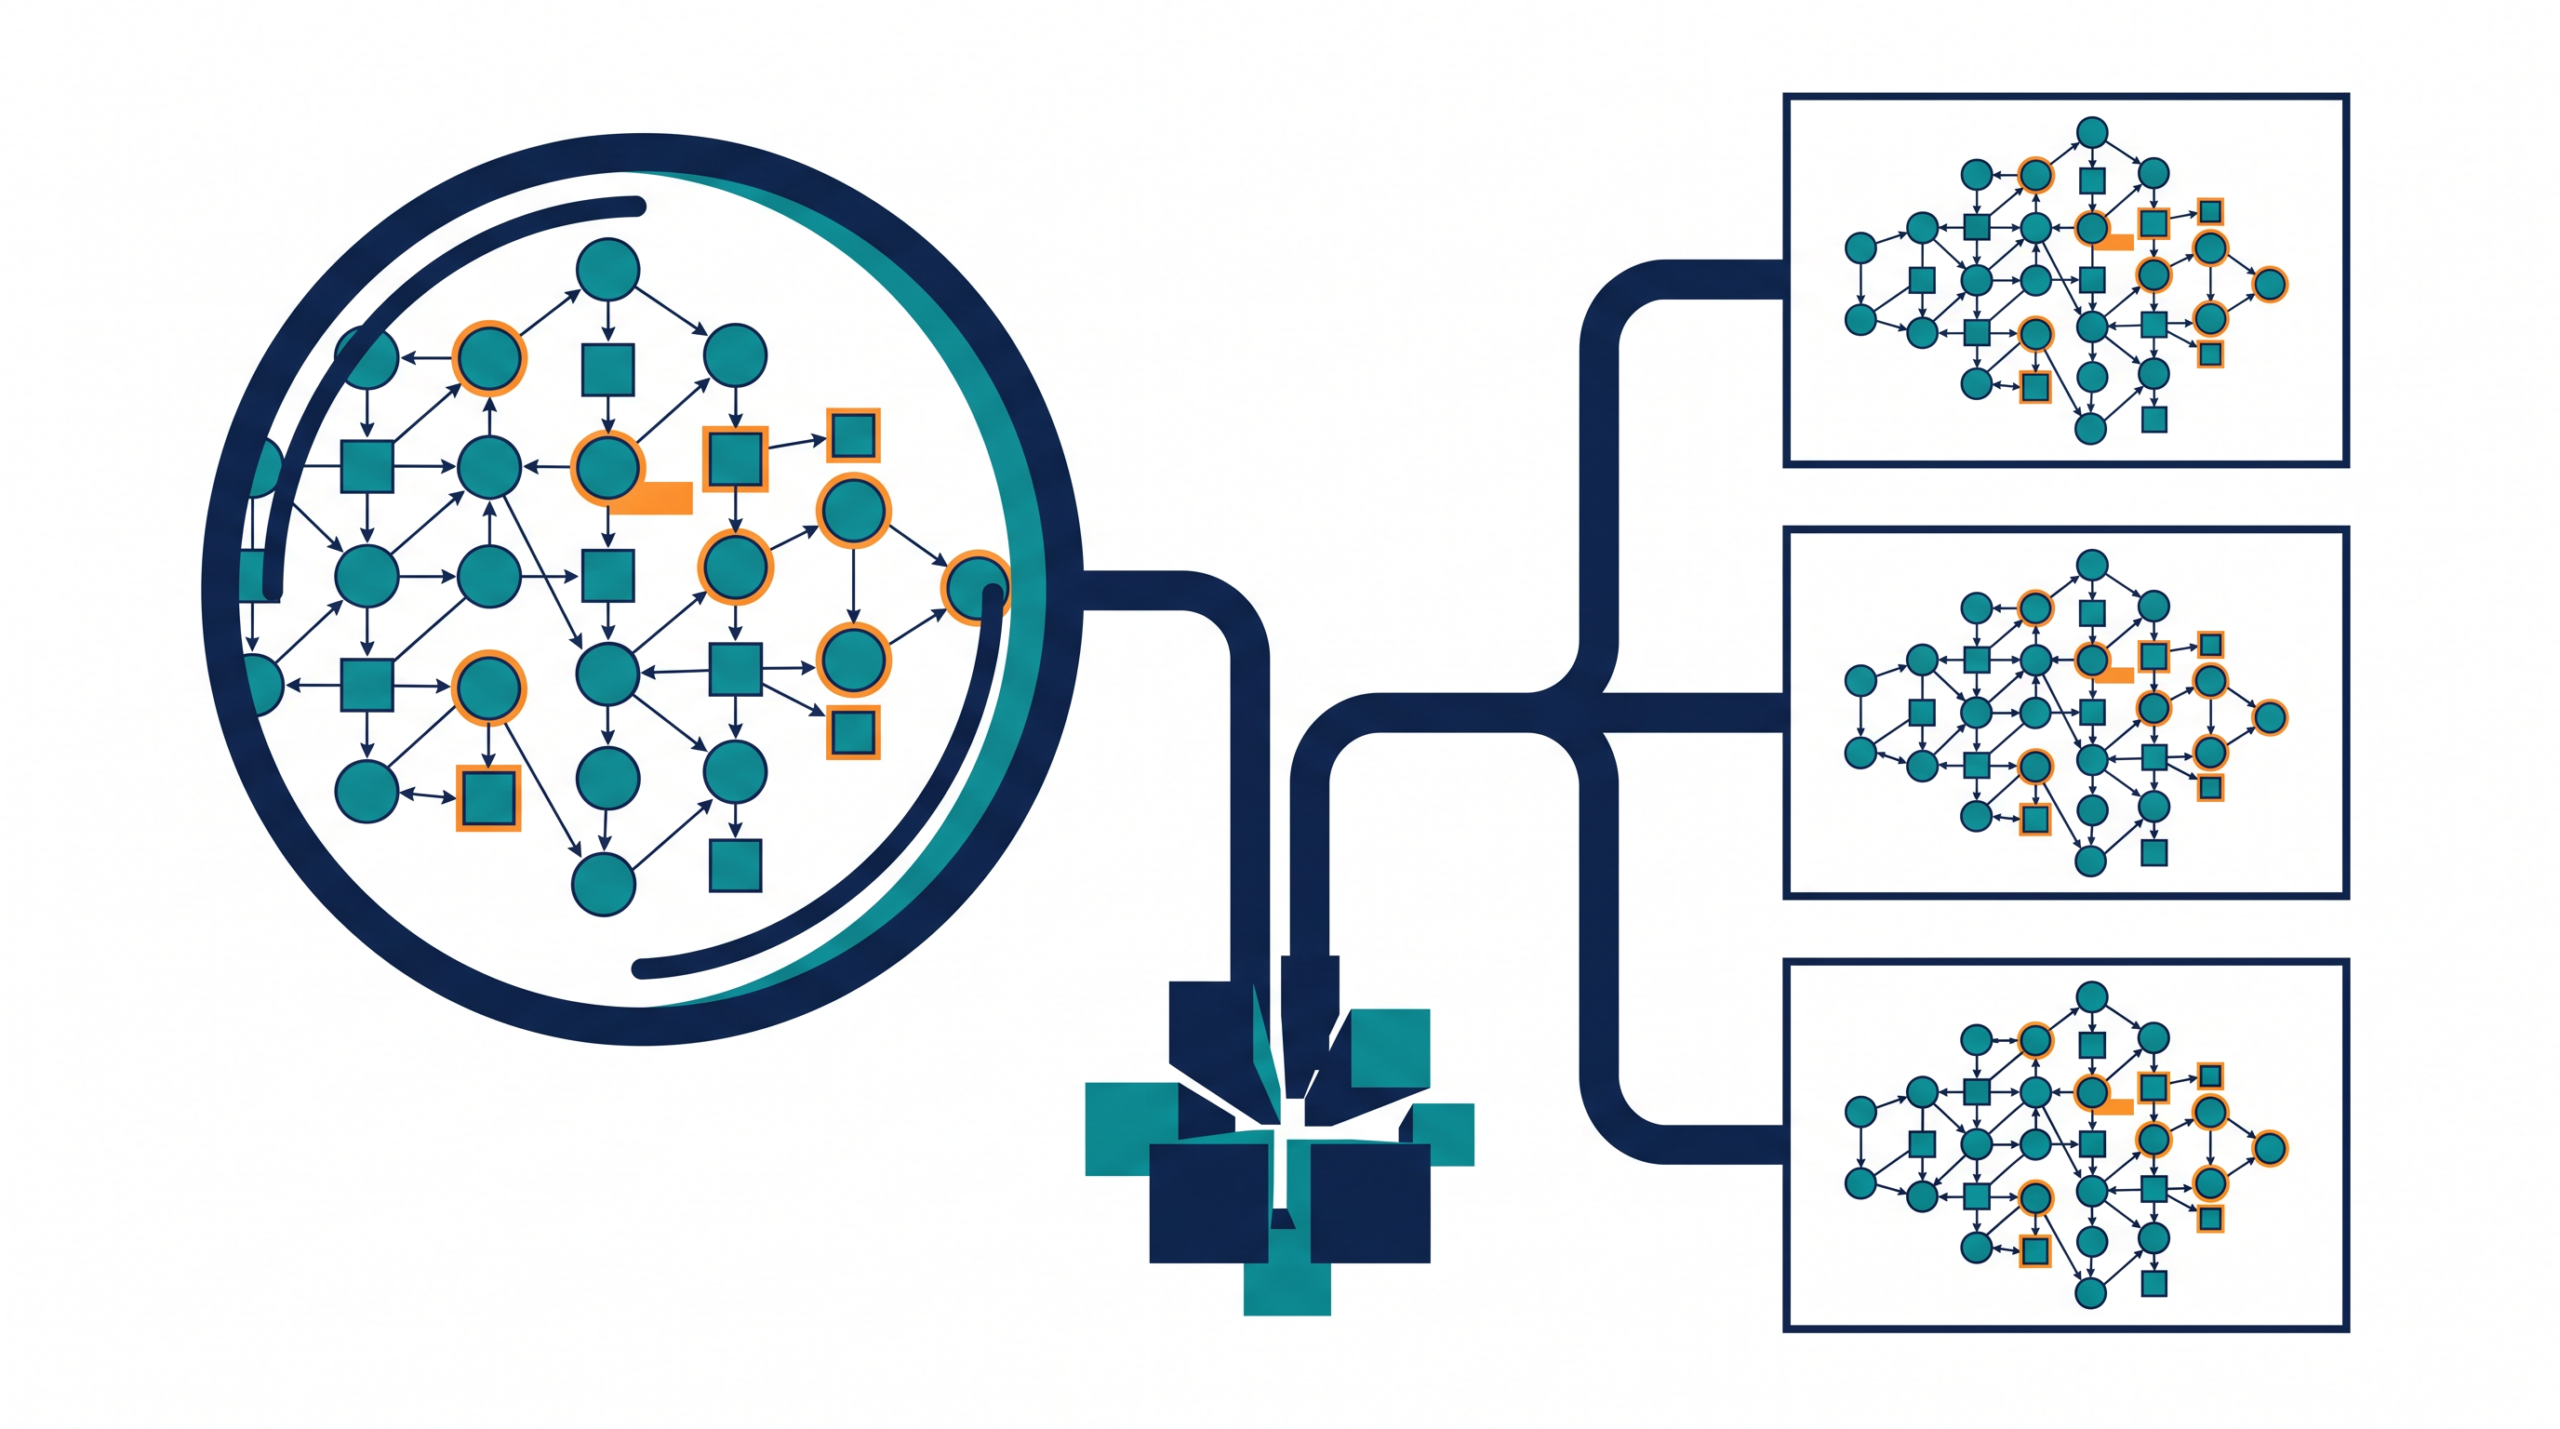
検算済みのCSVファイルが完成したら、次はいよいよネットワークを図として描画します。このとき、どの道具を使って可視化するかは、調査の目的に合わせて選びます。具体的には、新しい分野を初めて調べるような単発探索の場合はVOSviewerを使い、毎月同じ条件で最新の論文関係を追跡するような場合はPythonスクリプトを選ぶ、という使い分けをします。
未知の分野の全体像を直感的に探りたい単発探索では、可視化専用ソフトウェアのVOSviewerが便利です。VOSviewerはOpenAlex APIを対話的に検索し、ズーム、クラスタ、密度、時系列overlayを表示できるという特徴があります。作成したCSVファイルを入力として読み込ませた後、画面上でマウスを操作して密集している部分をズームしたり、論文のまとまりを色分けして見たりする作業が直感的に行えます。出力された図を人が観察することで、起点とした論文の周辺にどのような研究が集まっているかを見落としなく探す手がかりになります。
ただし、表示された図を人が確認する際には注意が必要です。VOSviewerの位置は関連の強さを近似し、表示線は既定で強いリンクへ絞られる仕組みになっています。そのため、画面上の円同士の距離を、研究が発展してきた時間の流れとして読むことはできません。もし発行年を見る場合はoverlayの色など意味を割り当てた視覚チャネルを使う必要があります。また、この段階でも、線が引用した側から引用された側へ向かっているという定義を保ち、線の集中が論文内容の支持や追試の成功、品質順位の証明ではないことを踏まえて図を読み解きます。
一方で、毎月同じ条件でネットワークを作り直したい場合は、Pythonなどのプログラミング言語を使って処理を自動化する仕組みを選びます。同じ手順で取得したCSVファイルを入力とし、決まった条件で図の画像ファイルを出力するスクリプトを書いておくことで、手作業による操作のブレをなくし、いつでも同じ描画処理を再現できます。継続的な調査においては、前回と今回で出力された図を人が見比べ、どのような新しい論文が加わったかを確認しやすくなります。
VOSviewerを使う場合でもPythonを使う場合でも、扱うデータそのものの性質は変わりません。データ源の収録範囲の違いや情報が更新された時点の影響を受けるため、どの時点・どのデータベースを使っても常に件数が完全に一致するという前提は持たずに結果を確認します。図に描かれた引用のつながりは、あくまで次に読むべき論文の候補を探すための見取り図です。こうして目的に合った道具を選んで図を出力した後は、その図を足がかりにして、AIにクラスタの概要を説明させ、人が原論文を直接確かめるという分担作業へと進んでいきます。
AIにクラスタ説明を任せて原論文を人が確かめる
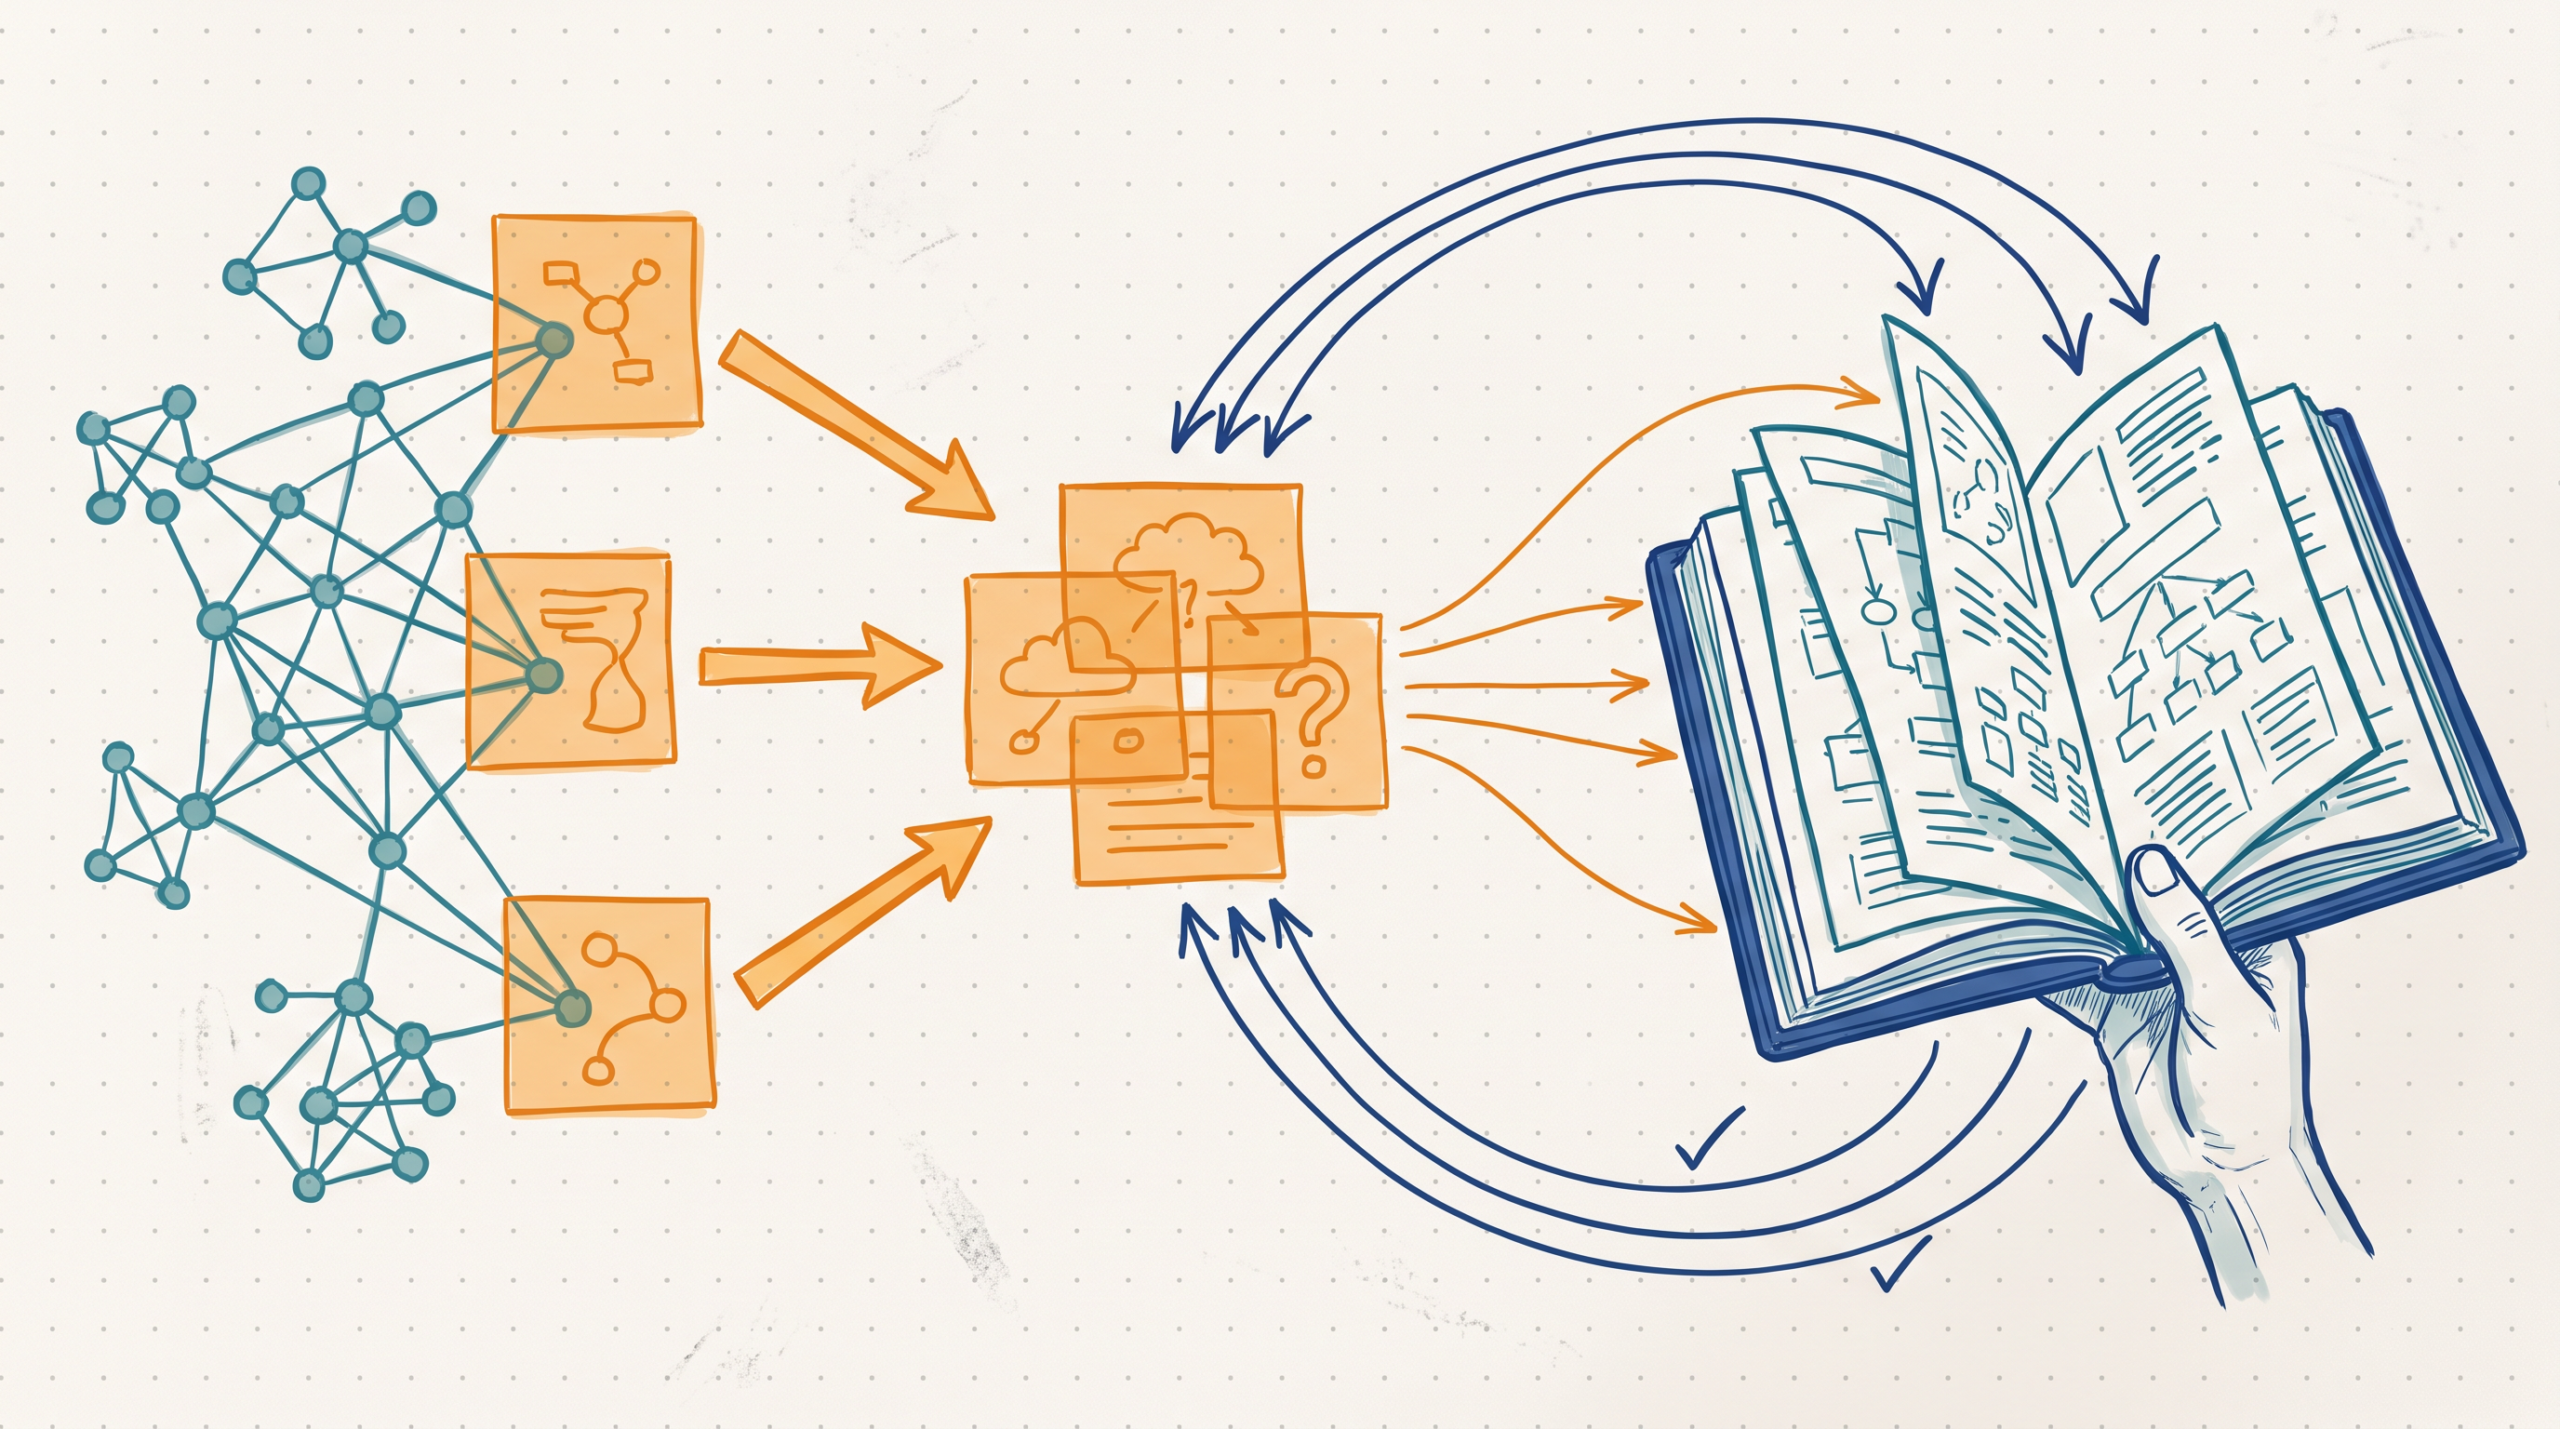
目的に合わせて引用ネットワークの図を描画した後は、その図を読み解いて次に読むべき論文を絞り込む段階に入ります。可視化されたネットワークの中には、線が密集して円が集まったクラスタと呼ばれるいくつかのまとまりができます。このクラスタがどのような研究テーマで構成されているのかを効率よく把握するために、AIを活用します。ただし、AIの役割はあくまで読むべき候補の整理までとし、最終的な内容の確認は人が原論文で行うという分担を作ることが重要です。
まず、AIへ読み込ませるための入力データを用意します。これまでの手順で作成したnodes.csvとedges.csvに加え、各論文の題名と要旨のデータを用意します。これらをAIに入力し、VOSviewerまたはPythonが計算したクラスタごとに、どのような共通の関心事があるのかを要約するよう指示を出します。操作の結果として、各クラスタの要約文と、そのグループを代表する論文のIDが書かれたcluster-notes.jsonというファイルを出力として受け取ります。
このとき、必要に応じて他の学術データベースを組み合わせて追加情報を集めることもできます。たとえば、Semantic Scholar APIは論文、引用、参考文献、著者などのデータを提供するほか、その中のcitations endpointは対象論文を引用する論文を返し、指定により引用文脈やintentも取得できる仕組みを持っています。これらをAIへの入力に加えれば、なぜその論文が引用されたのかという文脈の手がかりが増えます。一方で、Crossrefでは参考文献登録が任意で、is-referenced-by-countを取得できる。データ源ごとの収録差を前提にする必要があるように、利用するデータベースや更新された時点によって取得できるデータ件数は異なります。そのため、どのデータベースを調べても全件数が完全に一致するという前提は持たないようにします。
AIからcluster-notes.jsonが出力されたら、その情報をもとに人が原論文を確認する作業へと進みます。現在のオープンな学術データは、引用情報と名寄せには改善余地があるため、AIのクラスタ説明は原論文確認の代わりにならないという限界があります。AIがまとめた説明は、あくまで膨大な文献から見落とし候補を探すための手がかりです。そのため、cluster-notes.jsonに記載された代表IDを実際のデータベースで検索し、人が直接その論文の本文や結論を確かめる必要があります。
また、引用ネットワークの線は引用した側から引用された側へ引かれていますが、引用数が多いからといってその論文の品質順位が高いわけではありません。引用されているという事実が、その論文の内容が他の研究者に支持されたことや追試の成功を意味するものでもないため、必ず人の目で内容を確かめます。
このように、APIでのデータの取得、nodes.csvとedges.csvを使った可視化、AIによるクラスタの説明、そして人によるcluster-notes.jsonの代表IDを用いた原典の確認という四つの手順を一つの流れとして組み立てることで、引用ネットワークを正しく読み解き、自身の調査に役立てることができます。
よくある質問
Q1. 無料で始められますか
VOSviewerとOpenAlex APIの公開機能で始められますが、実行前に各サービスの現行料金条件を確認してください。たとえば、VOSviewerはOpenAlex APIを対話的に検索し、ズーム、クラスタ、密度、時系列overlayを表示できるソフトウェアです。APIへ検索条件を入力してデータを取得し、ソフトウェアで図を出力するまでの一連の操作を手元で試せます。
Q2. 何件から始めればよいですか
まずは起点となる一つの論文IDを入力として決めることから始めます。OpenAlex APIを利用する場合、IDは最大100件をOR条件で一括取得できる仕組みがありますが、最初は少数の起点から操作する方が結果を人が確認しやすくなります。出力された図を見ながら、必要に応じて徐々に検索対象のIDを追加して範囲を広げていきます。
Q3. 線の向きはどのように引かれますか
図の線は、引用した側の論文から、参考文献として引用された過去の論文に向かって引かれます。この線は著者が過去の文献を参照したことを表すだけであり、画面上の距離は時系列や賛同を意味しないことに注意して人が図を読み解く必要があります。多くの線が集まっていても、それが原論文への支持や追試の成功、品質の高さを証明するわけではありません。
Q4. 引用と共引用の違いは何ですか
引用ネットワークが論文間の直接の参照関係を示すのに対し、共引用ネットワークは、二つの過去の論文が後から発表された新しい論文に同時に引用される関係を示します。VOSviewerはcitation、co-citation、bibliographic couplingなどを別のネットワークとして作成できるソフトウェアです。目的に応じて設定を入力し、公式例には引用ネットワーク、共引用ネットワーク、書誌結合ネットワークが別々に示されるように個別の図として出力します。
Q5. データベースによって件数に差が出るのはなぜですか
利用するシステムごとに、情報を集めている範囲や時点が異なるためです。Crossrefでは参考文献登録が任意で、is-referenced-by-countを取得できる。データ源ごとの収録差を前提にする必要があるように、すべての論文が同じように登録されているわけではありません。また、データの収集システムにおける更新時間差で件数が少しずれる場合があるため、どのデータベースでも常に全件数が完全に一致するという前提は持たずに確認作業を行います。
Q6. AIだけで読むべき論文を判断できますか
AIだけに判断を任せることはできません。現在利用できるデータは、引用情報と名寄せには改善余地があるため、AIのクラスタ説明は原論文確認の代わりにならないという限界があります。AIへの入力と出力はあくまで見落としを防ぐための候補整理として使い、最後は出力されたIDをもとに、人が直接原論文の本文や結論を確かめる必要があります。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント