買い手の事業戦略に合うM&Aターゲット選定を進める際、膨大な公開情報から自社の基準に合う企業を探し出し、一覧に整理する作業には多大な手間がかかります。一方で、ただ企業名を羅列するだけでは事実の検証が難しく、次の調査や接触の判断へつなげにくいという課題もあります。
本記事では、事業戦略に基づく買収候補を公開情報とAIを使って再現可能に集め、根拠付き候補のショートリストへと絞り込む6工程を解説します。初期探索においては、買収戦略から探索分野と評価基準を決め、ロングリスト、ショートリスト、レーダーリストへ進むという定石を踏み、人が次に詳しく調べるべき企業を根拠を持って選別できる状態を目指します。
この作業において重要なのは、AIと人の役割分担です。AIは条件に基づく候補発見や共通軸での整理、空欄抽出を担い、人は対象企業の同定や原典の確認、最終的な選定結果と接触判断を担います。スクリーニング基準を企業戦略とM&A戦略へ結び付け、組織、市場、文化、製品を分析するのはあくまで人です。
AIによる買収候補の自動決定や、抽出した企業への自動連絡を行うものではありません。
初期情報の整理には、公開Web、アップロードファイル、許可済みアプリを使い、開始前に計画を確認し、引用付きレポートをMarkdown等で保存できるDeep Researchを活用します。AIが抽出した下書きをもとに人が原典を検証することで、秘密保持契約締結後のデューデリジェンスへと進む前段階の初期選別を、半自動化しつつ安全に進める方法を紹介します。
買収目的を選定条件へ変える
AIを活用して買収候補を探す前に、まずは探索の出口と除外条件を固定します。やみくもに企業情報を検索するのではなく、買収目的を判定条件へ変換し、探索作業の前提として共有することが最初の工程となります。
ターゲット選定においては、スクリーニング基準を企業戦略とM&A戦略へ結び付け、組織、市場、文化、製品を分析することが基盤となります。このように買収戦略から探索分野と評価基準を決め、ロングリスト、ショートリスト、レーダーリストへ進む手順を踏むことで、集めた情報を後から絞り込む際の目線が揃います。
具体的な準備として、決定した探索条件をテキストファイルにまとめます。たとえば、架空の産業用画像検査ソフト企業を探す案件において、「acquisition-thesis.md」というファイルを作成するとします。このファイルには、対象地域、必要能力、公開売上範囲、除外条件、情報の基準日を明記します。
ここで作成した条件ファイルは、AIに探索を指示するための入力として用います。AIに買収候補を自動決定させるわけではなく、あくまでAIが公開情報から条件に合う候補を発見し、共通軸で整理するためのガイドラインとして機能させます。この基準を明確にしておくことで、人が後からAIの集めた情報を確認し、自社の戦略に合う企業を選定する作業がスムーズになります。
候補母集団と根拠を別ファイルで集める
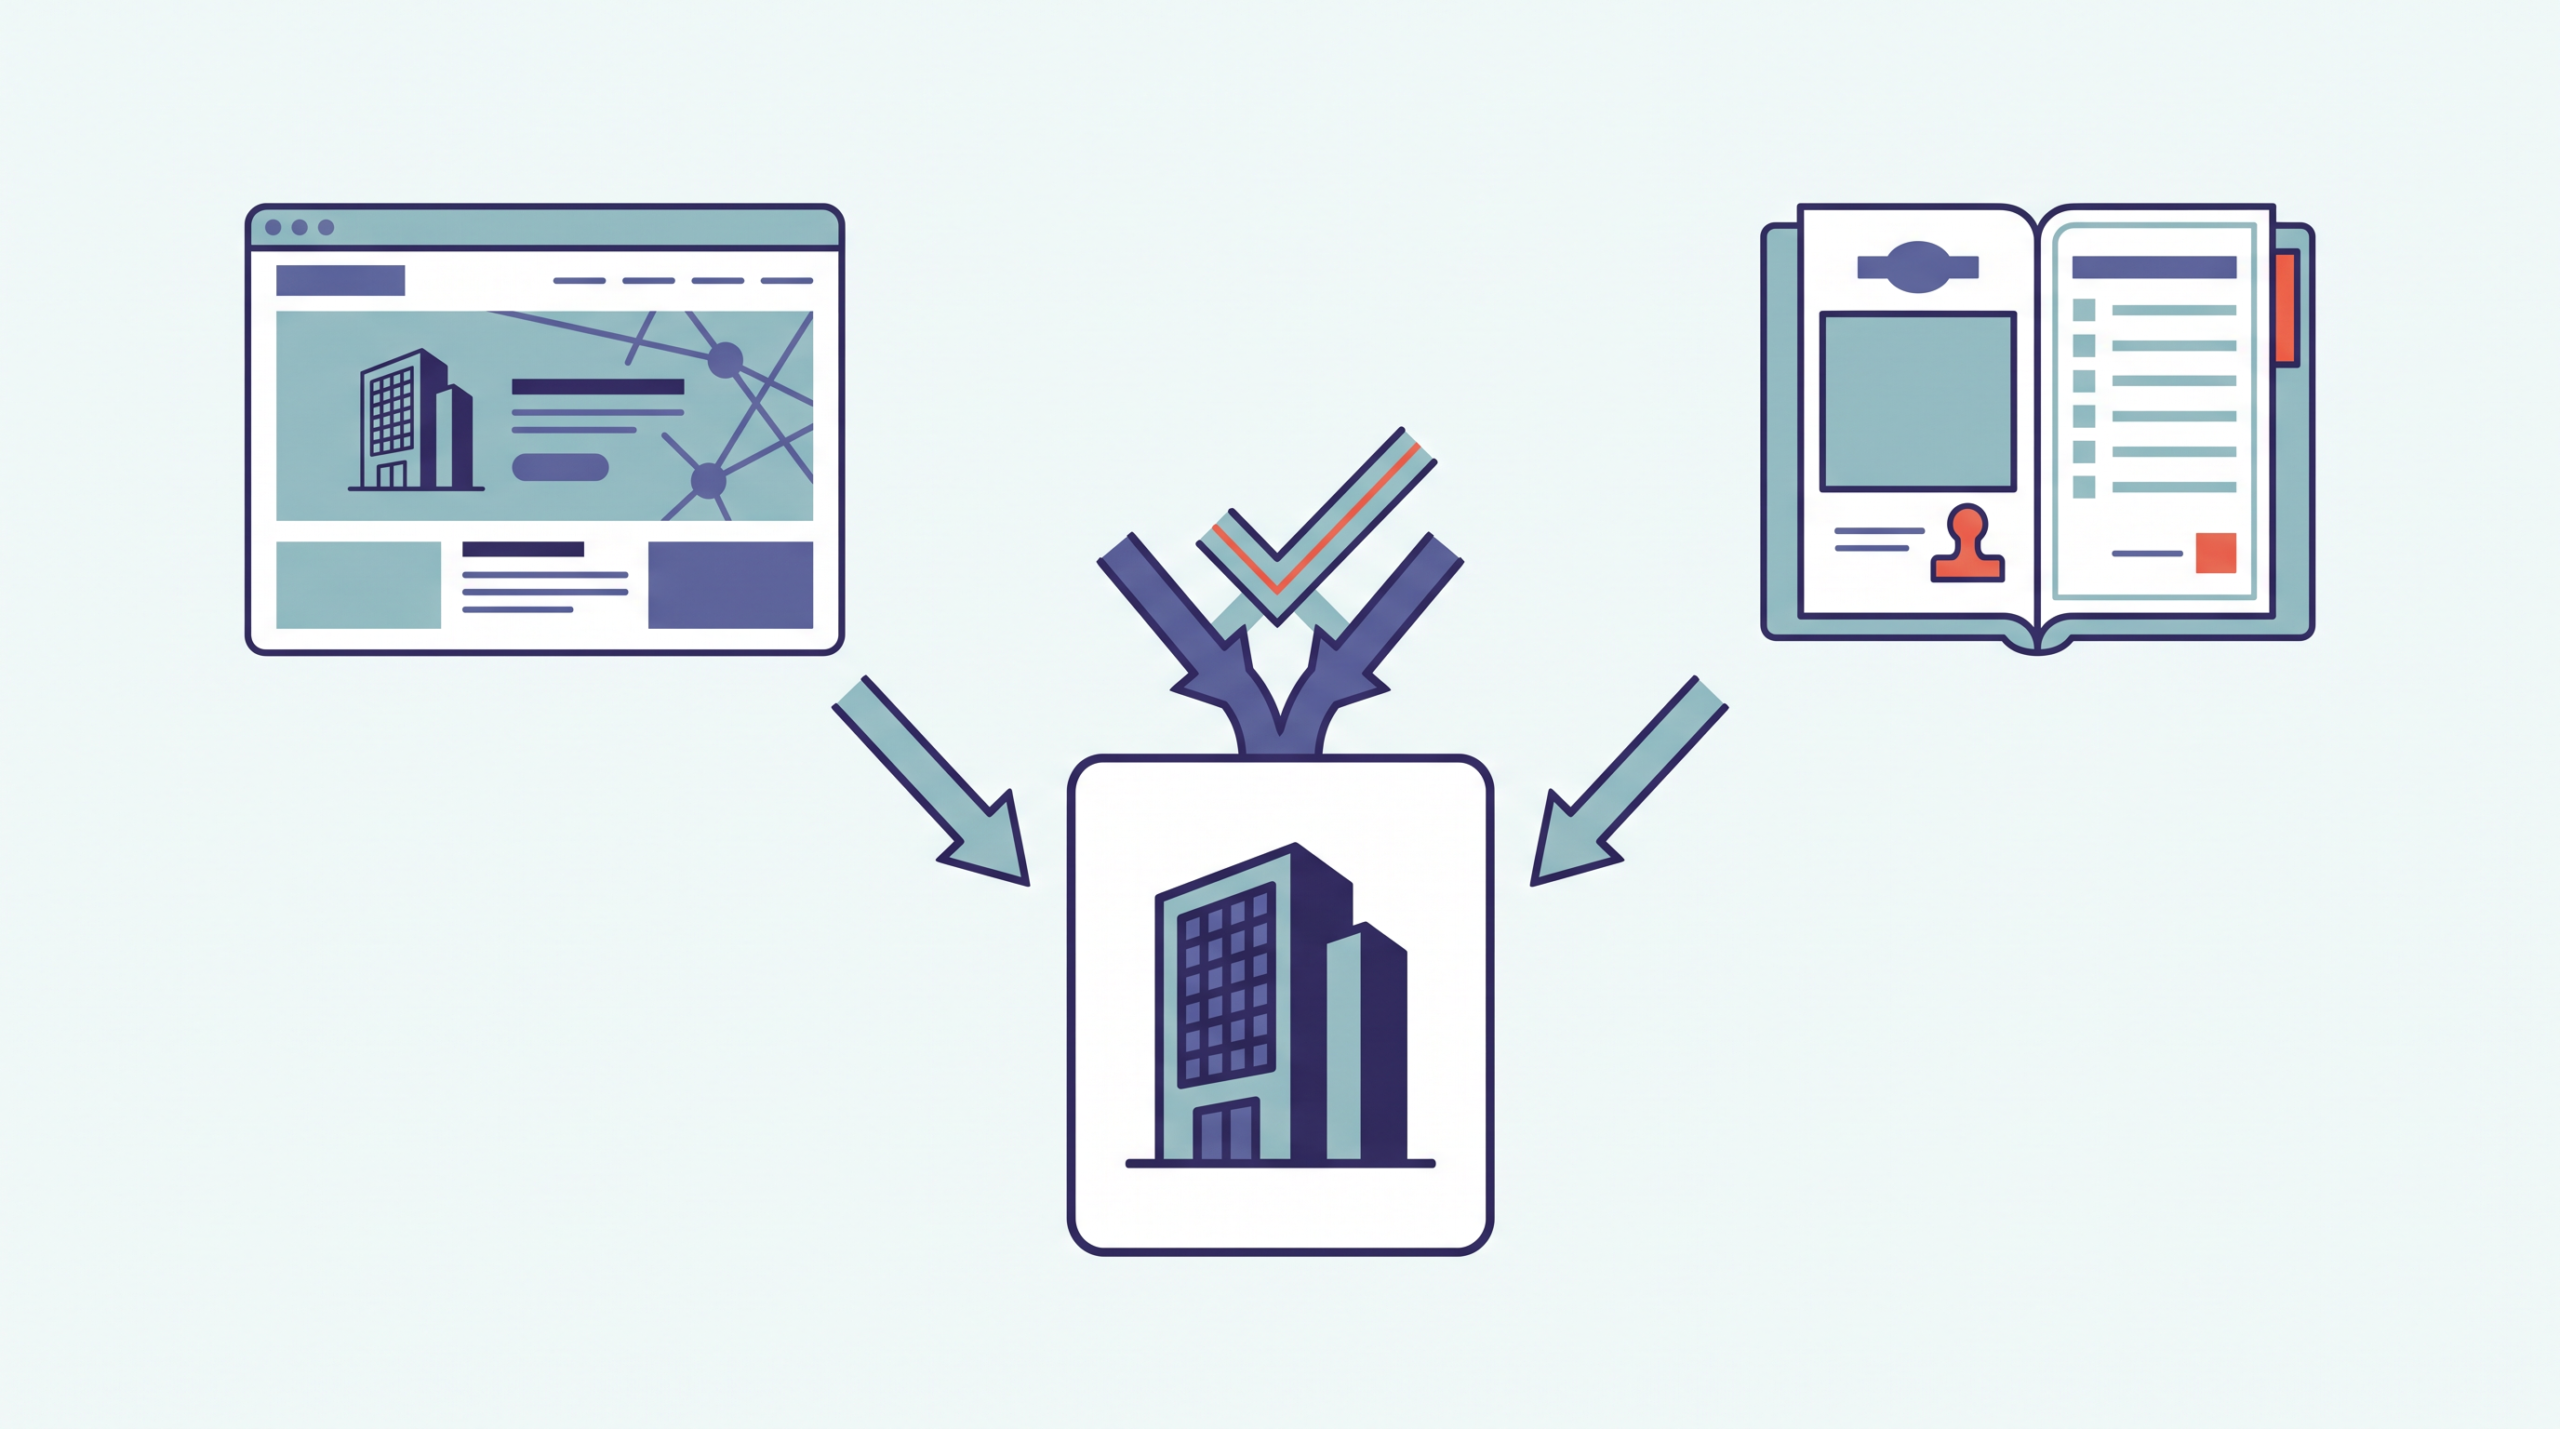
設定した条件をもとに、条件を満たす企業を複数経路から集めます。このとき、同名企業の混同を防ぐために、単なる企業名の羅列ではなく、検証可能な候補集合へと変える必要があります。そのためには、候補企業と出典をどう保存するかが重要になります。
具体的には、seed-companies.csvのようなファイルを用意し、そこへ企業名、公式URL、法人識別子、発見経路だけを保存する形をとります。AIには公開情報からの候補発見や共通軸での整理を担わせますが、最終的な企業の同定や原典の確認は人が行うため、後から確実に参照できる根拠を残しておきます。
企業を正確に特定するため、各国の公的機関が発行する法人識別子を別列で確認します。アメリカの企業が含まれる場合は、SECのCIKを確認します。SECのEDGARは企業提出履歴とXBRLデータをJSONで提供し、公開データAPIは認証キーを要求しないため、公開データへのアクセス経路として活用できます。
イギリスの企業であれば、Companies House番号を別列で確認します。Companies House APIは法人情報をRESTで提供し、API認証情報を必要とするため、自動取得などを検討する場合は事前に設定を行います。
日本の企業については、法人番号公表サイトは法人の基本3情報を確認する公的経路であるため、このサイトを通じて法人番号を確認し記録します。
このように、一意の法人識別子と発見経路をセットにして保存しておくことで、AIの出力結果が正しい実体企業を指しているかを人が確実に検証できます。AIに自動で買収候補を決定させるのではなく、人が正しく企業を同定するための基礎データを構築する工程となります。
Deep Researchに事実カードの下書きを作らせる
集めた候補企業を同じ比較軸へ仮置きするため、AIを活用して各企業の事実関係を整理した下書きを作成させます。この工程では、前の工程で作成した条件ファイルと候補リストをAIへ渡し、公開情報に基づいたリサーチを指示します。AIに買収候補を自動決定させるのではなく、人が比較検討するための材料を共通の項目で揃えることが目的です。
具体的なブラウザ操作として、ChatGPTの画面からDeep Researchの機能を選択します。そこに、先ほど作成した買収条件のテキストファイルと、シード企業のCSVファイルの2つをアップロードして添付します。そのうえで、各候補企業について公式サイトと公的機関の登録情報を優先して探索し、共通の比較軸でまとめるように指示を出します。
このとき利用するDeep Researchは、公開Web、アップロードファイル、許可済みアプリを使い、開始前に計画を確認し、引用付きレポートをMarkdown等で保存できるという特性を持っています。そのため、AIが提示してきた調査計画をまずは人が確認し、公式サイトと公的登録を優先する方針が正しく反映されているかをチェックしてから実行に移します。
調査が完了すると、各企業の事業概要や条件への合致状況が情報源のリンクとともに整理されて出力されます。この段階では企業への自動連絡や、秘密保持契約締結後のような深いデューデリジェンスを行うわけではありません。
あくまで初期選別のために公開情報から抽出された事実カードの下書きとして、出力された引用付きレポートをtarget-research.mdというファイル名で保存します。これにより、次の工程で人が原典を確認しながら企業を絞り込むための準備が整います。
根拠表からロングリストを絞る
前工程で出力された引用付きレポートをそのまま選定結果として採用するのではなく、ここからは人が原典を確認して候補を絞り込む工程に入ります。なぜなら、NISTは生成AIが誤った内容を自信ありげに提示するconfabulationを挙げ、重大判断での監視を求めるとしているからです。
AIの集めた候補をどのように除外あるいは保留するかは、担当者が直接事実を確認して決定します。AIに買収候補を自動決定させることはありません。
具体的には、target-facts.csvという根拠表を用意し、AIのレポートから必要な情報を人が転記していきます。この表には、法人識別子、所有関係、製品の適合状況、根拠となるURL、確認日、未確認事項といった項目を設けます。
転記する際、リンク先の原典を参照しながら、同名企業の取り違えがないか、すでに別企業へ買収済みとなっていないかを人が確認します。条件に合わない企業はこの時点で除外します。
また、公開情報だけでは分からない部分は、無理に推測せずに未確認事項として保留状態にしておきます。候補抽出後に担当者が各企業を基準に照らして確認し、一貫した選別を行うことで、検証可能なロングリストが整います。
この作業はあくまで公開情報による初期選別であり、対象企業への自動連絡や、秘密保持契約締結後のデューデリジェンスを行うものではありません。人が確実な情報に基づいて選定を行うことで、次の判断材料を用意します。
人がショートリストと次の調査を承認する
AIが整理した情報からロングリストを作成した後は、関係者が集まり最終的なショートリストと次のアクションを決定します。AIが整理した適合度スコアのような指標だけでは決められない、自社の事業戦略との適合性や買収の実現可能性を人が承認するためです。ここから先の工程は、AIによる自動決定ではなく、人の知見による評価と判断が不可欠になります。
具体的な運用として、M&A責任者、事業責任者、財務担当、法務担当などの関係者が協議を行います。その結果を「shortlist-decision.md」というファイルに記録し、各企業に対する方針を確定させます。
判断結果は、ショートリストへの「採用」、現時点では見送るが動向を追う「レーダー」、条件に合わない「除外」、さらに詳しい情報が必要な「追加調査」のいずれかに分類して承認します。評価にあたっては、戦略適合性と実現可能性で候補を分け、直ちに取引しない企業は継続監視する方針で整理します。
この工程を終えることで、接触すべき企業の優先順位が明確になり、初期のターゲット選定作業が完了します。重要なのは、抽出した候補企業に対してAIが自動で連絡を入れることはないという点です。接触の判断や実行は必ず人が行います。また、この段階は公開情報を中心とした初期選別であり、秘密保持契約締結後のデューデリジェンスとも異なります。
人が責任を持って事実確認と接触前の判断を下すことで、次の適切なアプローチへとつなぐことができます。
機密情報・データ送信・書き込み権限を分ける
ショートリストが承認され、今後の追加調査や定期的な再調査を効率化していく段階においても、交渉に関わる情報が意図せず流出したり、外部システムへ誤った更新が加わったりすることを防がなければなりません。そのため、どの情報と操作をAIへ許可するかをあらかじめ定め、初期探索における権限を明確に限定することが重要になります。
権限境界の具体的な設定として、AIに渡すデータは公開情報と匿名化された探索条件だけに限定します。社内で利用しているCRM、メールクライアント、および秘密保持契約締結後のデューデリジェンスに用いるデータルームなどは、初期段階のAIからは未接続の状態を保ちます。
AIによる買収候補の自動決定や企業への自動連絡は行わず、企業への接触やCRMへの情報登録は、必ず人が確認して別に承認する運用とします。
利用するシステムの仕様として、OpenAIのプラットフォームでは、Business、Enterprise、Edu、APIの業務データは既定でモデル学習に使われない仕組みとなっています。
また、外部のツールを連携させる際、アプリは利用者とワークスペースの設定、接続先権限に従うようになっており、アプリ権限は接続先やワークスペースの既存権限を上書きしないよう設計されています。
こうしたプラットフォーム側の安全設計を活用しつつも、運用面で機密情報へのアクセスや外部への書き込み操作を物理的かつ手順的に遮断しておくことが不可欠です。初期選別はあくまで公開情報に基づく候補発見と共通軸での整理にとどめます。AIには公開情報の収集と整理を任せ、企業との接触判断や機密情報の取り扱いは人が統制することで、安全な探索体制を維持します。
よくある質問
Q1. 非公開企業も候補として抽出できますか。
対象企業が非公開であっても、公開Web上に公式サイトや登録情報が存在すれば、AIが候補発見と共通軸整理を行います。公開されていない数値や事実は空欄抽出にとどまるため、人は原典確認の段階でそれらを未確認事項として整理し、その後の選定や接触判断の材料とします。
Q2. 同名企業の混同を防ぐための企業同定はどのように進めますか。
AIに探索を任せる前に、人が公式URLや公的な法人識別子をまとめた候補リストを準備します。AIはこの情報を起点として整理を担いますが、最終的には人が原典と照らし合わせて正しい企業情報を指しているかを確認し、企業同定を完了させます。
Q3. Deep Researchの機能はどのように操作しますか。
公開Web、アップロードファイル、許可済みアプリを使い、開始前に計画を確認し、引用付きレポートをMarkdown等で保存できる手順で操作します。ただし、NISTは生成AIが誤った内容を自信ありげに提示するconfabulationを挙げ、重大判断での監視を求めるとしているため、出力されたレポートは必ず人が原典を検証する前提で扱います。
Q4. 探索条件などの機密情報を入力しても安全ですか。
OpenAIのプラットフォームでは、Business、Enterprise、Edu、APIの業務データは既定でモデル学習に使われない仕組みです。
さらに、外部連携のアプリは利用者とワークスペースの設定、接続先権限に従ううえ、アプリ権限は接続先やワークスペースの既存権限を上書きしないため、初期選別では機密情報と探索環境を分け、実際の入力範囲と接続権限を会社の基準で確認します。
Q5. AIに適合度スコアを算出させて候補を絞り込むことはできますか。
AIは探索条件に沿った事実の共通軸整理や空欄抽出を担いますが、適合度スコアの計算による自動的な優先順位付けは行いません。候補抽出後に担当者が各企業を基準に照らして確認し、一貫した選別を行うことで、自社の基準に合う企業を人が選定します。
Q6. 候補企業の情報の更新頻度はどのように管理しますか。
AIは実行時点の公開Webから情報を集めるため、担当者が必要なタイミングで調査手順を再実行することで情報を更新します。候補抽出後に担当者が各企業を基準に照らして確認し、一貫した選別を行う作業を定期的に繰り返すことで、除外せずに保留とした企業の動向を継続して追うことができます。
AIを組み込む仕事の流れづくりをご支援します
Deskrexでは、AIを使って調査・制作・分析などの仕事を進めるために、工程と役割分担を設計し、実装する支援を行っています。AIに渡す資料や指示、使えるツール、人が確認する箇所を整理し、一連の仕事として動く仕組みをつくります。
まず、届けたい成果物と現在の作業手順を確認し、実際の仕事をAIで試します。品質、処理量、時間、費用を見ながら、今すぐ任せられる作業と、追加の設計や開発が必要な作業を確かめます。
その結果をもとに、工程の統合や並列化、ツール連携、結果の検証と修正の手順を組み込みます。実行回数や費用の上限、人の判断を待つ条件、途中の状態を保存して再開する方法も含めて設計し、実務で動作を確かめます。
業務へのAI導入やワークフロー作成のご相談は、AIワークフロー作成支援のご案内からお問い合わせください。任せたい仕事と、現在使っているツールを伺い、取り組む範囲を一緒に整理します。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント