普段のAIで調査を進めながら、画像解析だけ別モデルへ渡したい場面があります。そのたびに画面を切り替えると、資料の再添付、指示の書き直し、出典の引き継ぎが増えます。普段のAIを入口にして、一工程だけ別AIへ渡せれば、この往復を減らせます。
AI同士を直接連携させると聞くと、ネットワーク上でAIが自律的に会話をするように思われがちです。しかし、実際に外部の機能を呼び出して処理を実行するのはAI本体ではなく、それらを管理して間に入る接続役のプログラムです。この接続役を正しく用意すれば、入口となるAIを自由に選び、特定のタスクだけを別のAIへ依頼できるようになります。
連携は、別のAIへリクエストが届けば完成するわけではありません。結果と失敗情報を同じ形式で受け取り、エラー時には処理を止める設計が必要です。最後は、単一モデルとの品質差が認証、ログ、確認の負担を上回るかを人が判断します。
実際に動くのはAIではなく接続役です
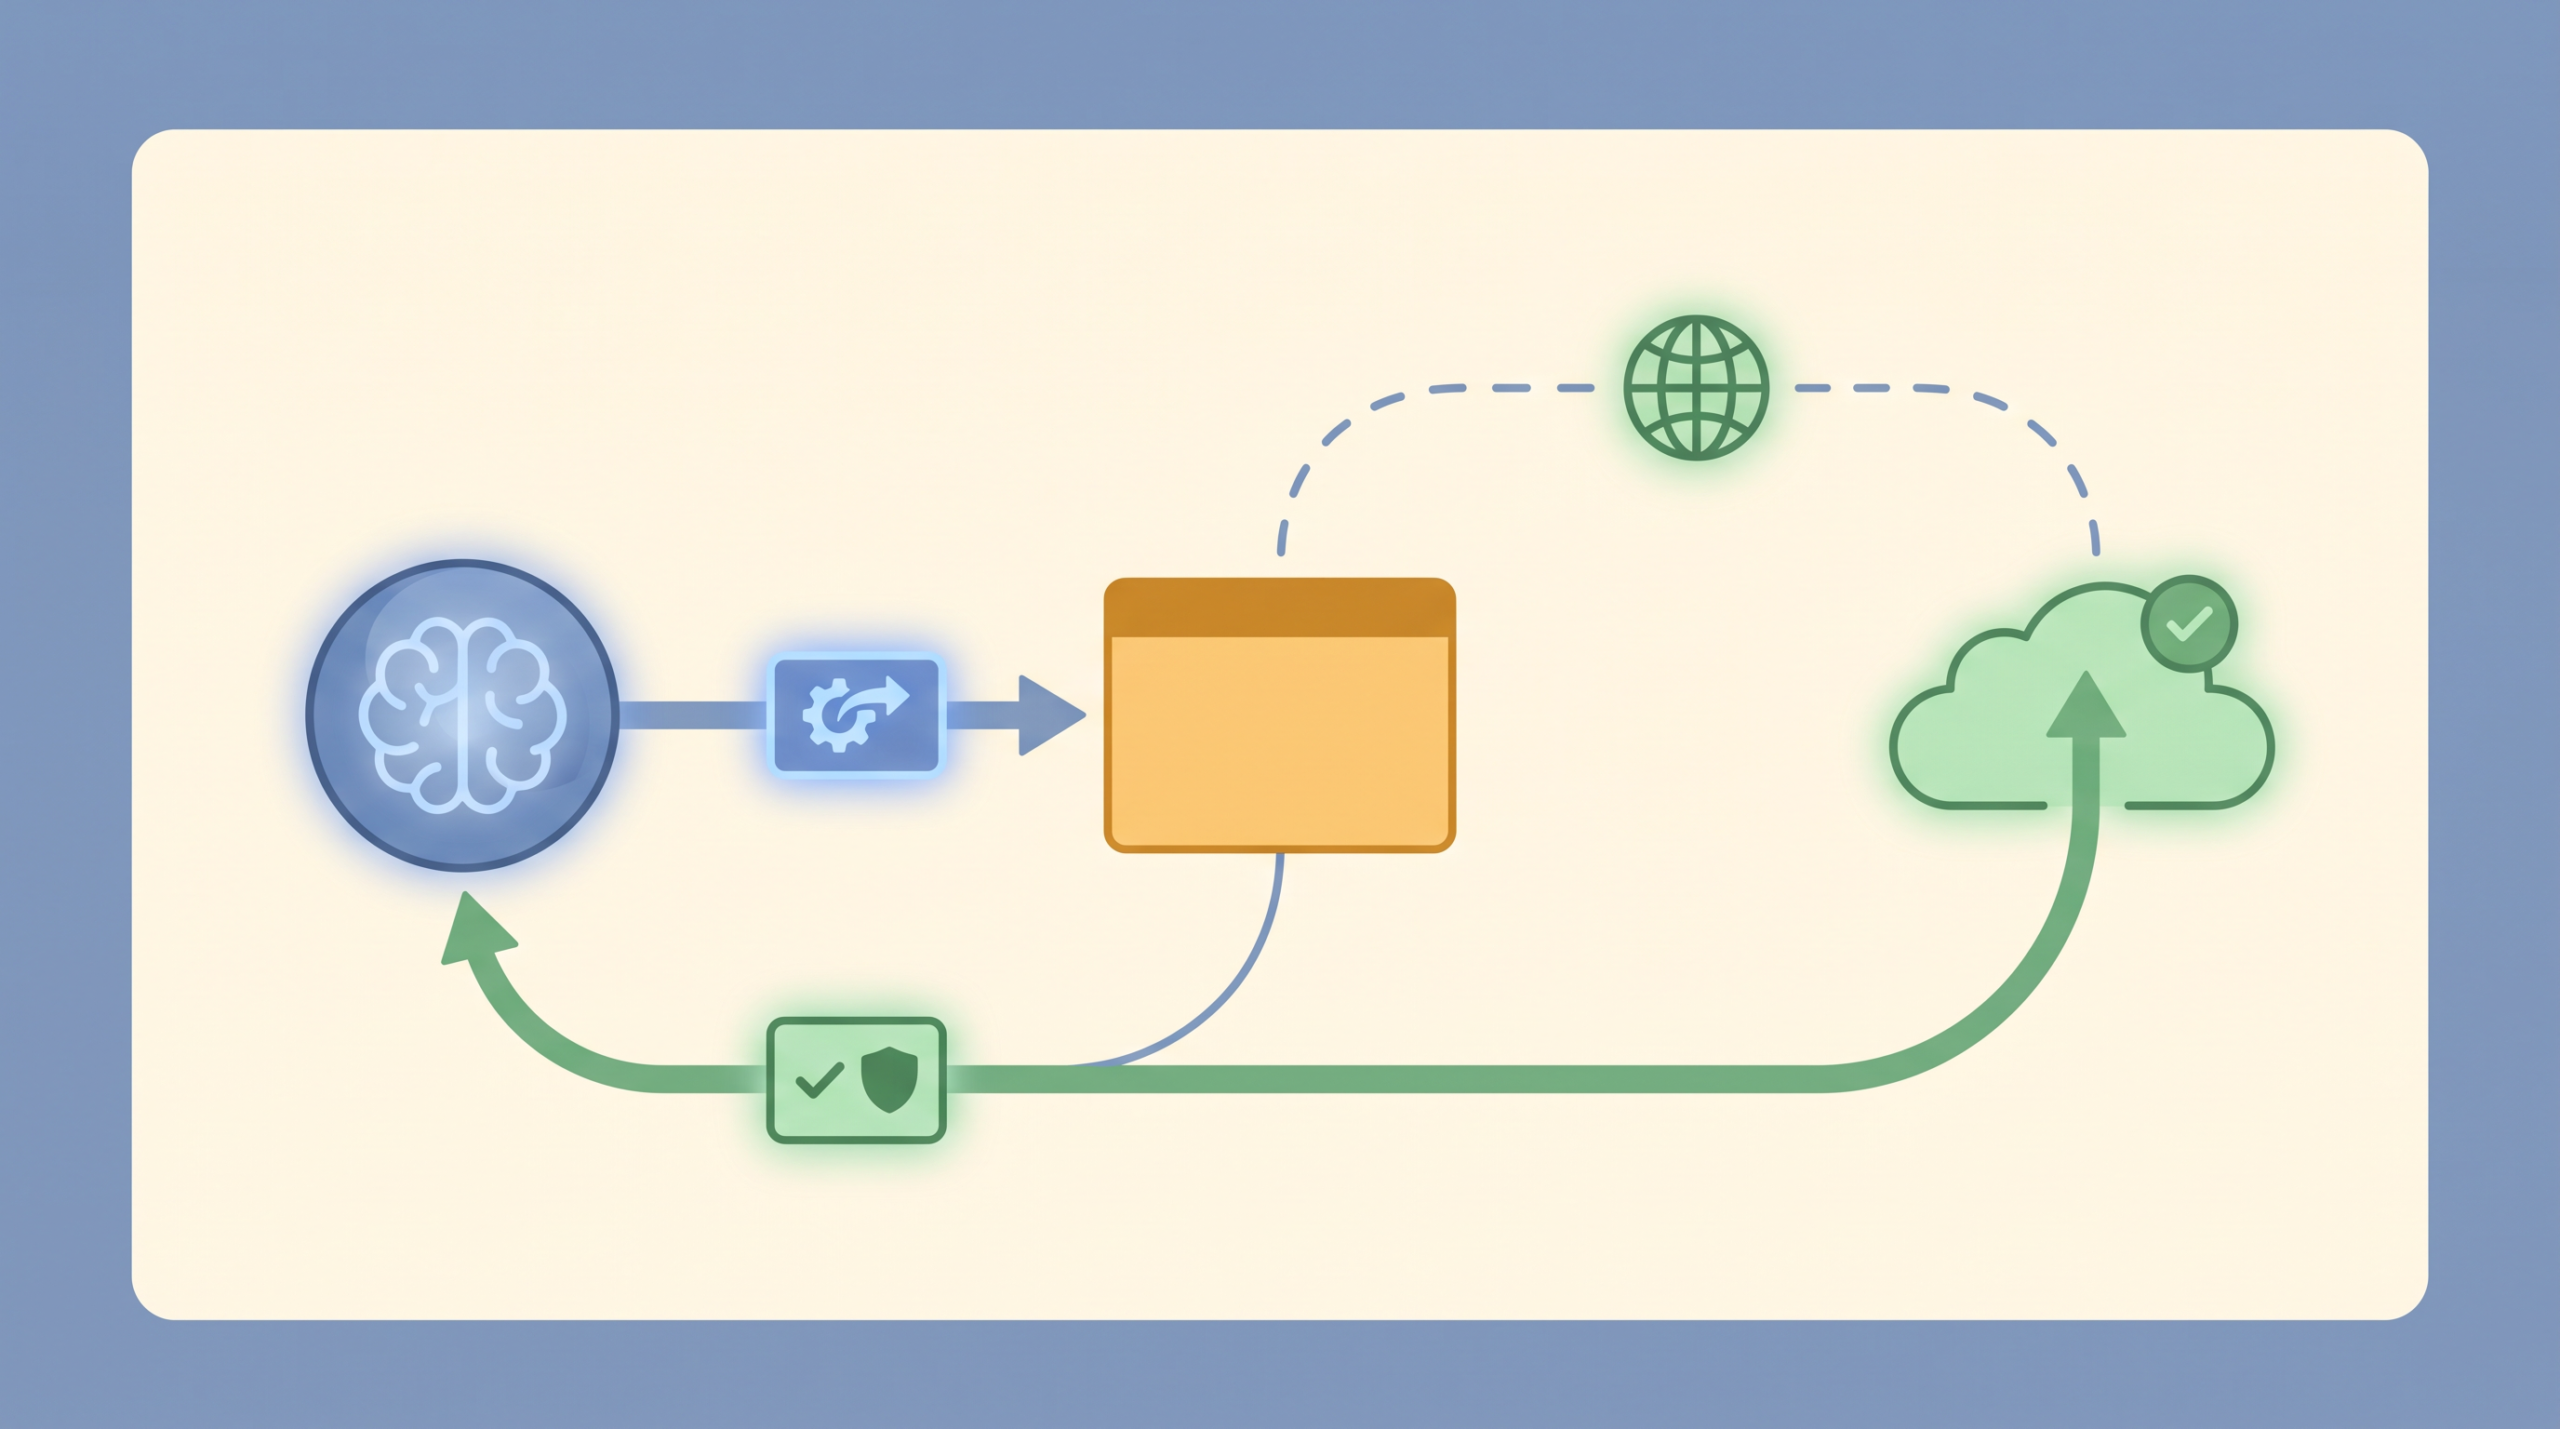
「AIから別のAIを呼び出す」と聞くと、AI同士が直接ネットワーク上で会話している姿を想像するかもしれません。しかし、実際に別のAIのAPI(プログラム同士を連携させる窓口)を呼び出しているのは、AI本体ではなく、それらを管理する土台となるプログラム(ホスト)です。
人がブラウザで操作する「一般向けチャット」と、プログラムがAIへ入力を送る「モデルAPI」は別の入口です。一般向けチャットで他社APIを自由に呼べるとは限りません。
「AIエージェント」は、モデルAPIとホストを組み合わせて手順を進めるアプリケーションです。モデルが次の操作を要求し、ホストが処理する往復を「制御ループ」と呼びます。
AIモデルが外部の機能を利用するときは、「関数実行(Function Calling)」という手法が使われます。モデル自身が直接外部の通信を行うのではなく、「この関数(プログラムの処理単位)を、この引数(処理に渡すデータ)を使って実行してほしい」とホスト側に要求するのです。そして、要求を受け取ったホスト側が実際のコードを実行し、その結果を再びAIに戻します。
この「実行するのは接続役であるホスト」という役割分担は、主要なAIモデルで共通しています。
たとえばOpenAIでは、外部APIを呼ぶ関数実行(function calling)やリモートMCP(Model Context Protocol)などをツールとして扱います。
Claudeでも、AIがツールの使用(tool_use)を返し、クライアント(ホスト)側が実行した結果(tool_result)を戻す仕様です。
同様に、Geminiでもモデルが関数名と引数を返してアプリケーションがコードを実行し、Grokでもモデルがツール呼び出しを返して開発者がローカル環境で実行した結果を戻すという手順を踏みます。
各社の表記は異なりますが、「AIが要求し、ホストが実行する」という基本構造は共通します。共通のタスク契約とモデル別の変換処理を分ければ、入口のAIを変えても同じ仕事を別AIへ渡せます。ただし、ツール呼び出しの形式は各社で異なるため、変更後は同じ代表タスクで再検証します。
接続方法は運用範囲から選びます
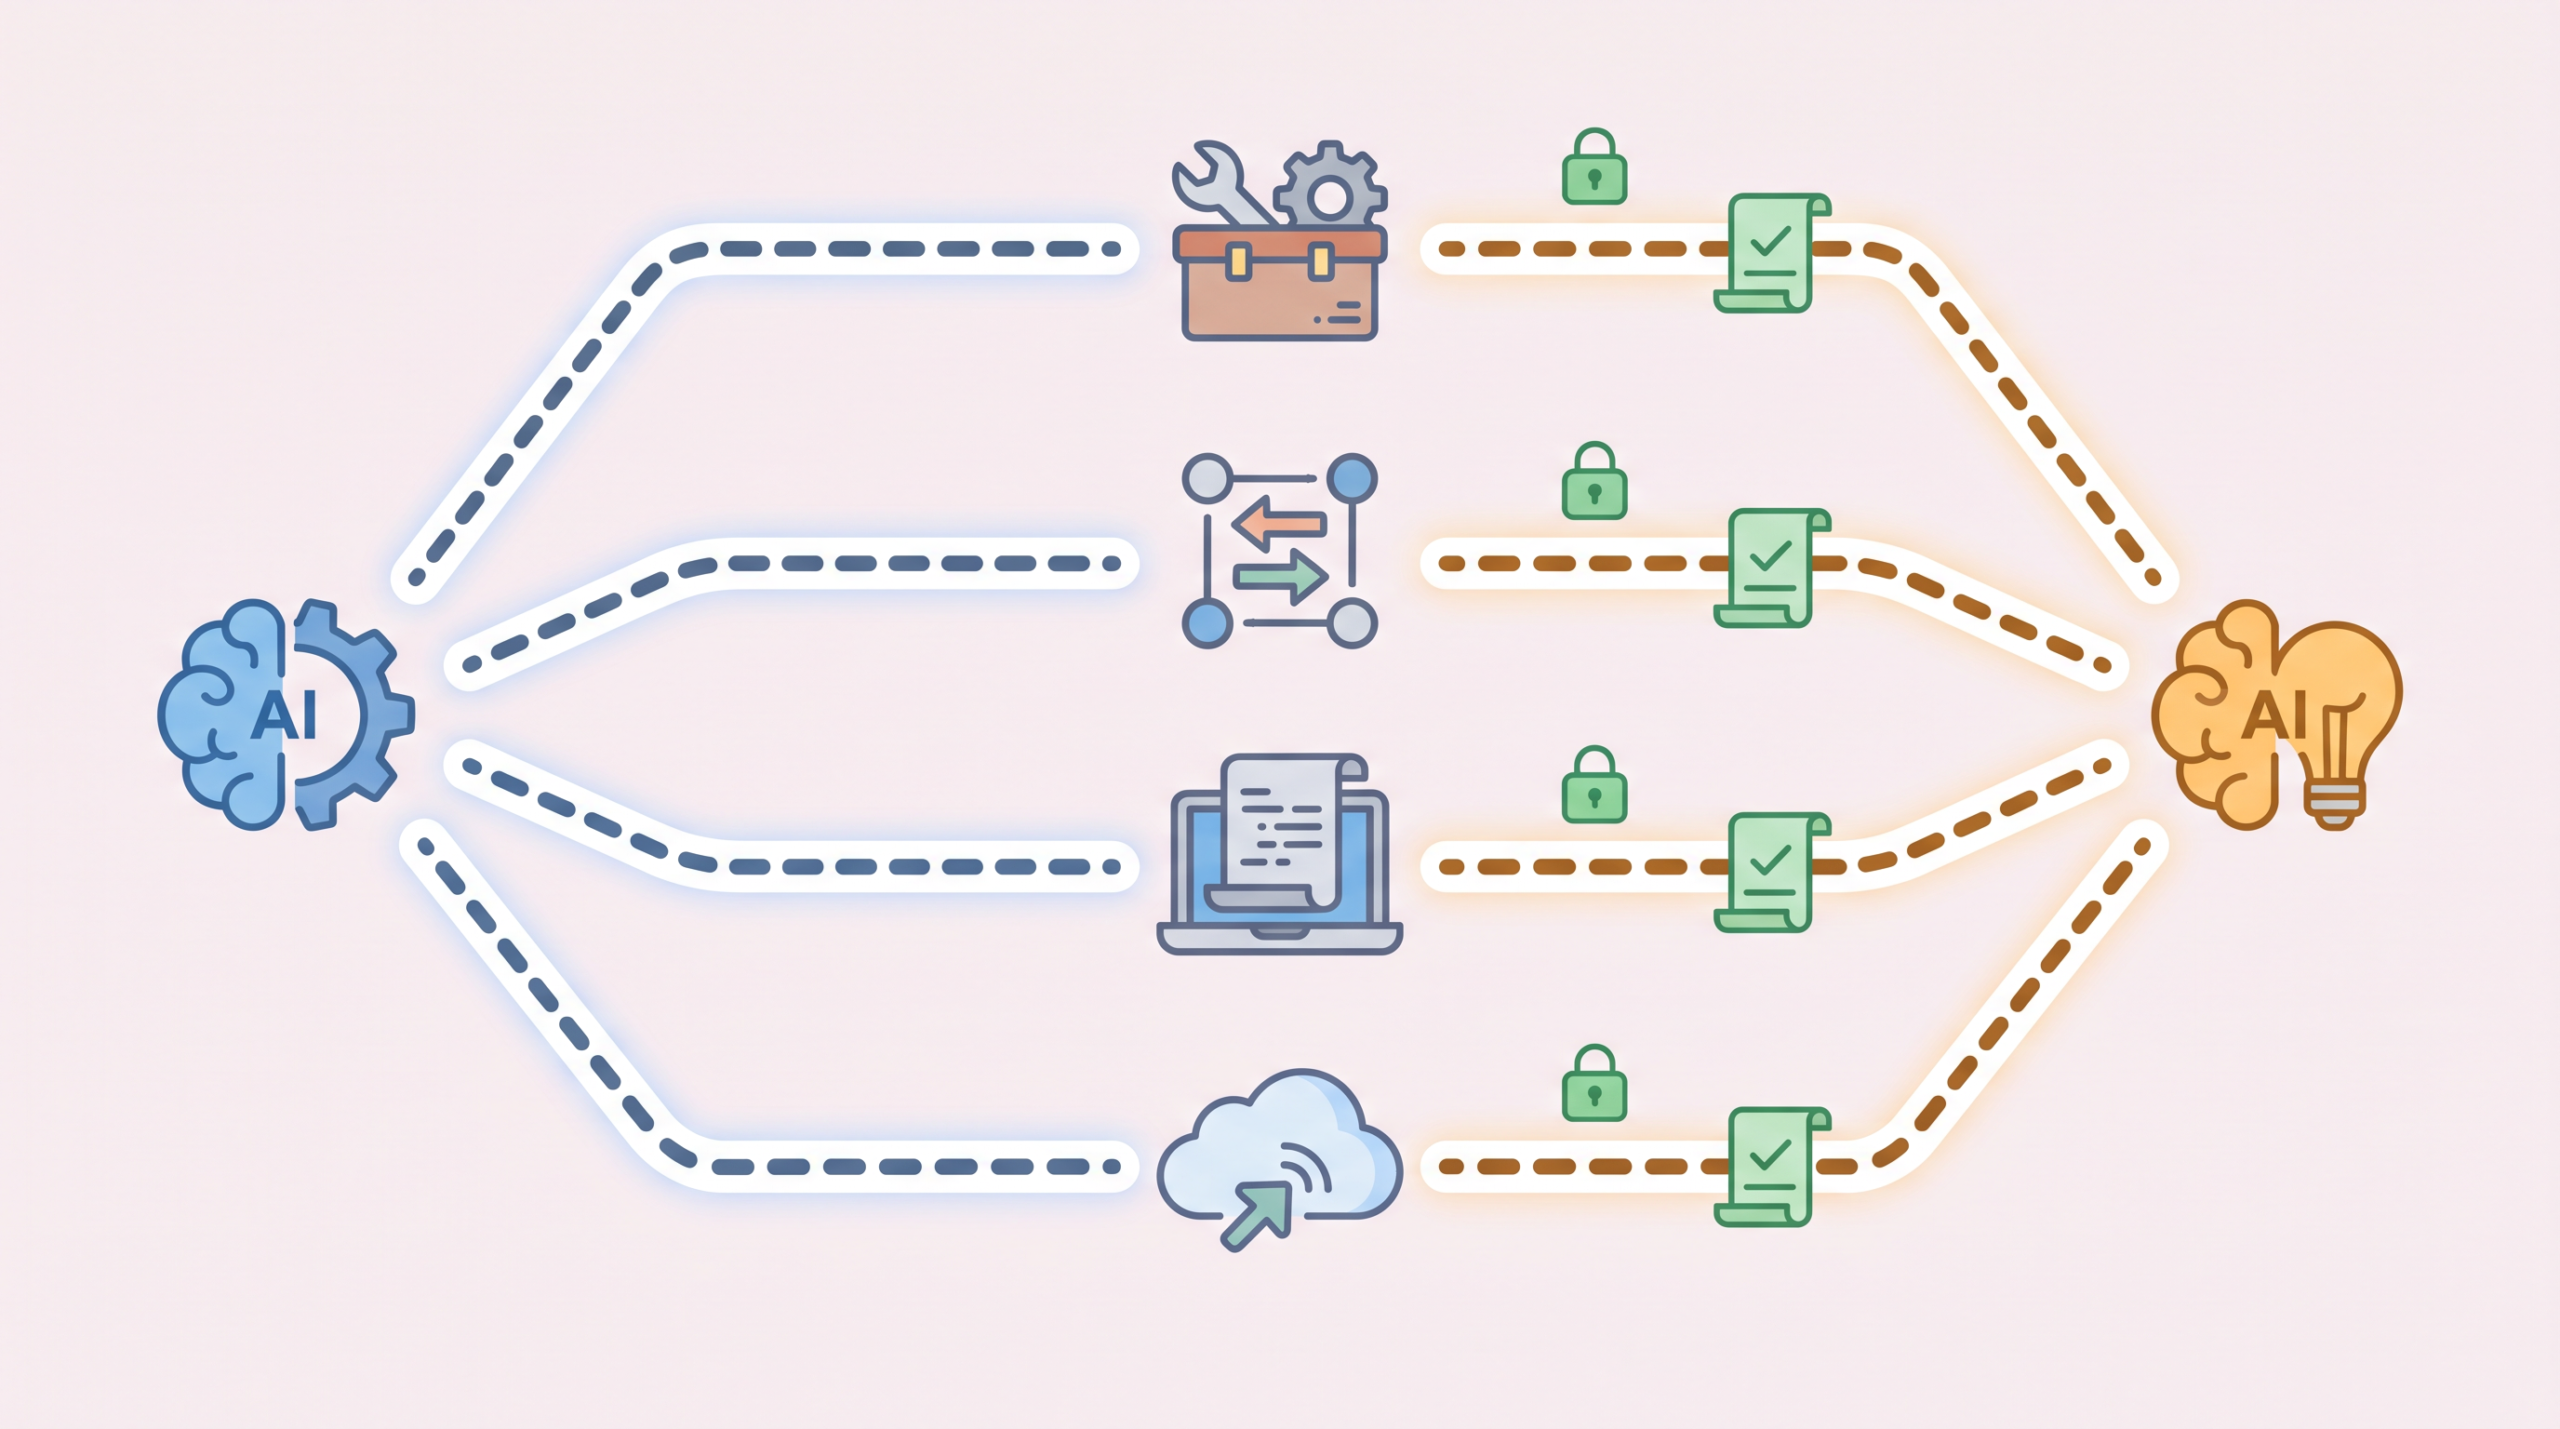
実行主体となる接続役が別のAIを呼ぶ経路は、大きく「CLIからCLI」と「APIからAPI」に分かれます。前者は個別に認証したCLIを手元のパソコンから順番に動かす方法です。
Claude Code、Codex CLI、Grok Build、Antigravity CLIでは、対象の月額プランによるログインを使えます。GoogleではGemini CLIの個人向け経路が2026年6月18日に終了し、Antigravity CLIへ移りました。
CLIでも製品ごとに契約条件が異なります。APIからAPIの経路では、各社のAPIキーを使ってHTTPリクエストを送ります。
月額プランでClaude CodeからCodexを呼ぶ
Claude CodeはClaude ProまたはMaxでログインでき、Codex CLIは対象のChatGPTプランでログインできます。両方へ個別にログインした後、Claude Codeを入口にする最小例は次の形です。
claude -p "requirements.mdを読み、Codexへ渡す実装依頼だけをcodex-task.mdへ書いてください"
codex exec --sandbox workspace-write -C "$PWD" \
  "codex-task.mdに従って実装し、実行したテストと未解決点をcodex-result.mdへ書いてください"
claude -p "codex-result.mdとgit diffを読み、要件漏れとテスト不足だけをreview.mdへ書いてください"
ここでClaudeがOpenAI
APIを直接呼ぶわけではありません。シェルがclaude -pを終了まで待ち、次に別プロセスとしてcodex execを起動します。認証、利用上限、保存条件は各CLIのログイン先に従います。CLIへ渡す作業ディレクトリと書き込み権限も明示します。
CodexからClaude Codeを呼ぶ
入口を逆にする場合も構造は同じです。Codexに調査対象を整理させ、Claude Codeへレビューを渡し、最後にCodexで修正できます。
codex exec --sandbox read-only -C "$PWD" -o codex-analysis.md \
  "srcとtestsを読み、変更候補と根拠を整理してください。ファイルは変更しないでください"
claude -p "codex-analysis.mdを読み、見落とした要件と危険な変更だけをclaude-review.mdへ書いてください"
codex exec --sandbox workspace-write -C "$PWD" \
"codex-analysis.mdとclaude-review.mdを読み、合意できる修正だけを実装してテストしてください"最初のCodexには--sandbox read-onlyを指定し、分析段階の書き込みを止めています。Claude
Codeを非対話で使う前に、対象ファイルの読み取り、結果ファイルの書き込み、git diffの実行に必要な権限を設定します。
--allowedToolsには必要な操作だけを指定し、不要な書き込みやシェル操作は--disallowedToolsで止めます。相手の出力をそのまま実行命令として信用せず、受け渡しファイルの内容を次のCLIがレビューする設計にします。
SuperGrokからGrok Buildを呼ぶ
Grok
BuildはSuperGrokまたはX Premium
Plusの契約で利用でき、初回起動時にブラウザでログインします。ブラウザを開けない端末ではgrok login --device-authも使えます。ログイン後は、-pで一回だけ実行して結果をファイルへ保存できます。
grok login
grok -p "requirements.mdを読み、実装前に確認すべき矛盾をJSONで返してください" \
  --output-format json > grok-review.json
codex exec --sandbox workspace-write -C "$PWD" \
  "grok-review.jsonを読み、根拠を確認できる指摘だけを実装してテストしてください"
この経路では、シェルが契約アカウントで認証済みのGrok Buildを起動します。xAIの一般向けプランは、Chat、Imagine、Voice、Buildで共有する週次利用枠です。xAI APIの従量課金を使う経路とは分けて記録します。Grok Buildのブラウザ認証は推論プロキシを使い、APIキー経路だけがapi.x.aiへ直接接続します。
Google AIの個人向けCLIはAntigravityへ移りました
Googleは2026年6月18日から、Google AI Pro・Ultraと無料の個人アカウントに対するGemini CLIの提供を終了しました。ただし、個人向けのCLI経路自体が消えたわけではありません。後継のAntigravity CLIは個人のGoogleアカウントでログインでき、無料枠または契約プランのモデルクレジットと利用上限を使います。
Antigravity
CLIはagyコマンドとしてインストールし、初回起動時にブラウザでGoogleアカウントへログインします。ログイン情報はOSの安全な資格情報保管機能へ保存されます。一度ログインすれば、agy -pで非対話実行できます。
agy
agy -p "requirements.mdを読み、実装前に確認すべき矛盾をJSONで返してください" \
  --output-format json > antigravity-review.json
claude -p "antigravity-review.jsonを読み、根拠を確認できる指摘だけをreview.mdへ書いてください"最初のagyは対話画面を開き、保存済み認証がなければブラウザログインを開始します。二つ目のagy -pは保存済み認証を使い、応答だけを標準出力へ返します。未認証なら処理を待ち続けず、認証エラーで終了します。/usageではプランの残り利用枠を確認できます。
CIなどでアカウントログインを使わない場合は、Antigravity CLIをGemini
APIキーへ切り替えられます。~/.gemini/antigravity-cli/settings.jsonのmodelProviderをgeminiにし、GEMINI_API_KEYを設定します。
APIキー経路は個人サブスクリプションの利用枠ではありません。Gemini API側の割り当てと課金に従います。
GPT・Claude・Gemini・GrokはすべてAPIキーで呼ぶ
GPTはOpenAI Responses API、ClaudeはAnthropic Messages API、GeminiはGemini API、GrokはxAI APIから呼び出せます。OpenAIとxAIはBearer認証、Anthropicはx-api-keyとAPIバージョン、Geminiはx-goog-api-keyを送ります。APIキーは会話やソースコードへ書かず、実行環境の秘密管理から読みます。
次の例では、各APIアカウントで利用可能なモデルIDをOPENAI_MODELとANTHROPIC_MODELへ設定してから実行します。モデルIDを変数にしたのは、利用資格や提供時期によって選べるモデルが異なるためです。
curl "https://api.openai.com/v1/responses" \
  --fail-with-body --silent --show-error \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$OPENAI_MODEL\",\"input\":\"requirements.mdを読み、実装前に確認すべき矛盾をJSONで返してください\"}" \
  -o openai-response.json

curl "https://api.anthropic.com/v1/messages" \
  --fail-with-body --silent --show-error \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$ANTHROPIC_MODEL\",\"max_tokens\":1024,\"messages\":[{\"role\":\"user\",\"content\":\"requirements.mdを読み、実装前に確認すべき矛盾をJSONで返してください\"}]}" \
  -o anthropic-response.json
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.5-flash:generateContent" \
--fail-with-body --silent --show-error \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-d '{"contents":[{"parts":[{"text":"task.jsonを処理する前提で、必要な入力項目をJSONで返してください"}]}]}' \
-o gemini-response.json
curl "https://api.x.ai/v1/responses" \
--fail-with-body --silent --show-error \
-H "Authorization: Bearer $XAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{"model":"grok-4.6","input":"調査結果から反証候補を3件抽出し、URLと未確認点を返してください"}' \
-o grok-response.json各curlの終了コードが0であることを確認し、保存したJSONを開きます。OpenAIではoutput、Anthropicではcontent、Geminiでは候補本文、Grokでは出力本文があるかを確認します。いずれもAPIが返したエラー項目も検査し、HTTPエラーやJSONの解析失敗を空の成功結果として次工程へ渡してはいけません。
4件とも各社APIの利用枠と課金に従います。ChatGPT、Claude、Gemini、Grokの一般向け有料プランを契約していても、その月額料金が各社APIの利用料金を含むとは限りません。APIコンソールで組織またはプロジェクト、請求先、利用上限を別に確認します。
| 経路 | 実行するもの | 認証と課金 | 向く場面 |
|---|---|---|---|
| Claude Code→Codex CLI | ローカルのシェル | ClaudeとChatGPTへ個別ログイン | 一人でコードや文書を受け渡す試行 |
| Codex CLI→Claude Code | ローカルのシェル | ChatGPTとClaudeへ個別ログイン | 分析とレビューの役割を分ける試行 |
| Grok Build→他のCLI | ローカルのシェル | SuperGrokまたはX Premium Plusでログイン | 週次共有枠で調査やレビューを渡す試行 |
| Antigravity CLI→他のCLI | ローカルのシェル | 個人Googleアカウントの無料枠または対象プラン | Gemini系モデルで調査やレビューを渡す試行 |
| Antigravity CLIのAPIキー経路 | ローカルまたはCI | Gemini APIキーとAPI側の割り当て・課金 | ブラウザログインを使わない自動処理 |
| OpenAI・Anthropic・Gemini・xAI API | ローカルまたはサーバーのプログラム | 提供元ごとのAPIキーとAPI利用枠・課金 | 定型処理、構造化出力、定期実行 |
| MCP経由のモデルAPI | MCPホストとMCPサーバー | ホストと呼び出し先を個別管理 | 複数のAIクライアントへ同じツールを配る運用 |
一つ目の「標準のツール機能」は、利用しているAI製品が提供する連携機能を使う方法です。製品画面や管理画面で有効化できる範囲に収まるなら候補になりますが、利用できる連携先、権限、契約条件は製品ごとに確認します。
二つ目は「MCP(Model Context Protocol)」です。MCPは、LLMへツールとデータを提供する共通規格です。MCPサーバーが別AIのAPI呼び出しをツールとして公開し、ホストがそのツールを呼びます。
MCPのツール仕様では、入力Schemaと任意の出力Schemaを指定できます。ホストはSchemaを使い、AI間で受け渡すデータ形式を検証します。
三つ目の「ローカルスクリプト」は、上記のCLIやAPIを決めた順に起動するプログラムです。少人数の試行では始めやすい一方、実行環境を各自で維持する必要があります。
四つ目の「サーバーAPI」は、クラウド環境などに専用の中継サーバーを開発・構築し、そこを経由して別のAIへリクエストを送る方法です。
四つの経路は、配布、認証、ログ、可用性の条件で選びます。担当者一人が手元で試すなら、標準ツールかローカルスクリプトから始められます。複数端末へ同じツールを配るならMCPが候補です。複数部門で認証とログを集約し、端末停止中も動かすならサーバーAPIを検討します。MCPとサーバーAPIは併用できます。
なお、MCPを利用する際に気をつけるべき点があります。MCPはあくまでデータの受け渡し方法を標準化する規格であって、呼び出し先となる各AIモデルの認証(APIキーの管理など)や利用料金を一元化してくれるわけではありません。
起点となるAIから別のAIを呼び出す場合、それぞれのAI提供元との契約や認証、利用料金の支払いは、これまで通り個別に管理する必要があります。
実行を担う経路と運用範囲が定まったら、次はその経路上で起点となるAIと呼び出し先のAIがやり取りするデータの「中身」についてルールを決めていきます。
共通契約には失敗情報まで含めます
モデルを替えてもタスク種別、必須入力、成功条件、失敗形式を保つため、受け渡すデータの「共通契約」を決めます。各社固有のツール形式は、共通契約を変換するアダプターが処理します。
入力にはタスクID、タスク種別、参照資料、禁止条件を置きます。出力Schema、出典要件、タイムアウト、再試行条件、データの機密区分も指定します。呼び出し先のモデル名は契約の外側にあるアダプターで選びます。これならモデルを替えても、何を処理し、どの条件で止めるかが変わりません。
次に、呼び出し先から受け取る結果の形式を決めます。構造化出力と関数呼び出しは用途が異なります。関数呼び出しは会話途中の行動、構造化出力は最終結果の形式固定に使います。
xAIも、対応するJSON Schemaによって構造化出力とツール引数を制約できると説明しています。呼び出し先の結果は構造化出力で固定し、ホスト側でもSchemaを検証します。
出力の枠組み(Schema)には、成功時のデータだけでなく、失敗情報も含めます。status、result、sources、errorsを同じ外枠で返します。失敗時はresultを空にし、ホストがstatusを読んで処理を分岐します。これにより、人はエラー理由を確認できます。
Schema適合と事実確認は別の検査です。JSON Schemaで確認できるのは、型、必須項目、列挙値などの形式です。項目内の主張が正しいかまでは保証しません。
形式が整っていると中身も正しいように見えてしまいがちですが、事実確認をAI任せにするのは危険です。だからこそ、出力の共通契約には結果だけでなく必ず「出典」を含め、最終的に人が根拠や失敗の経緯を確認できる設計にしておく必要があります。
こうして入出力の共通契約を整えたら、次はいきなりすべての作業を任せるのではなく、まずは一工程だけを切り出して実際に別のAIへ渡して試します。
一工程だけを別AIへ渡して試します
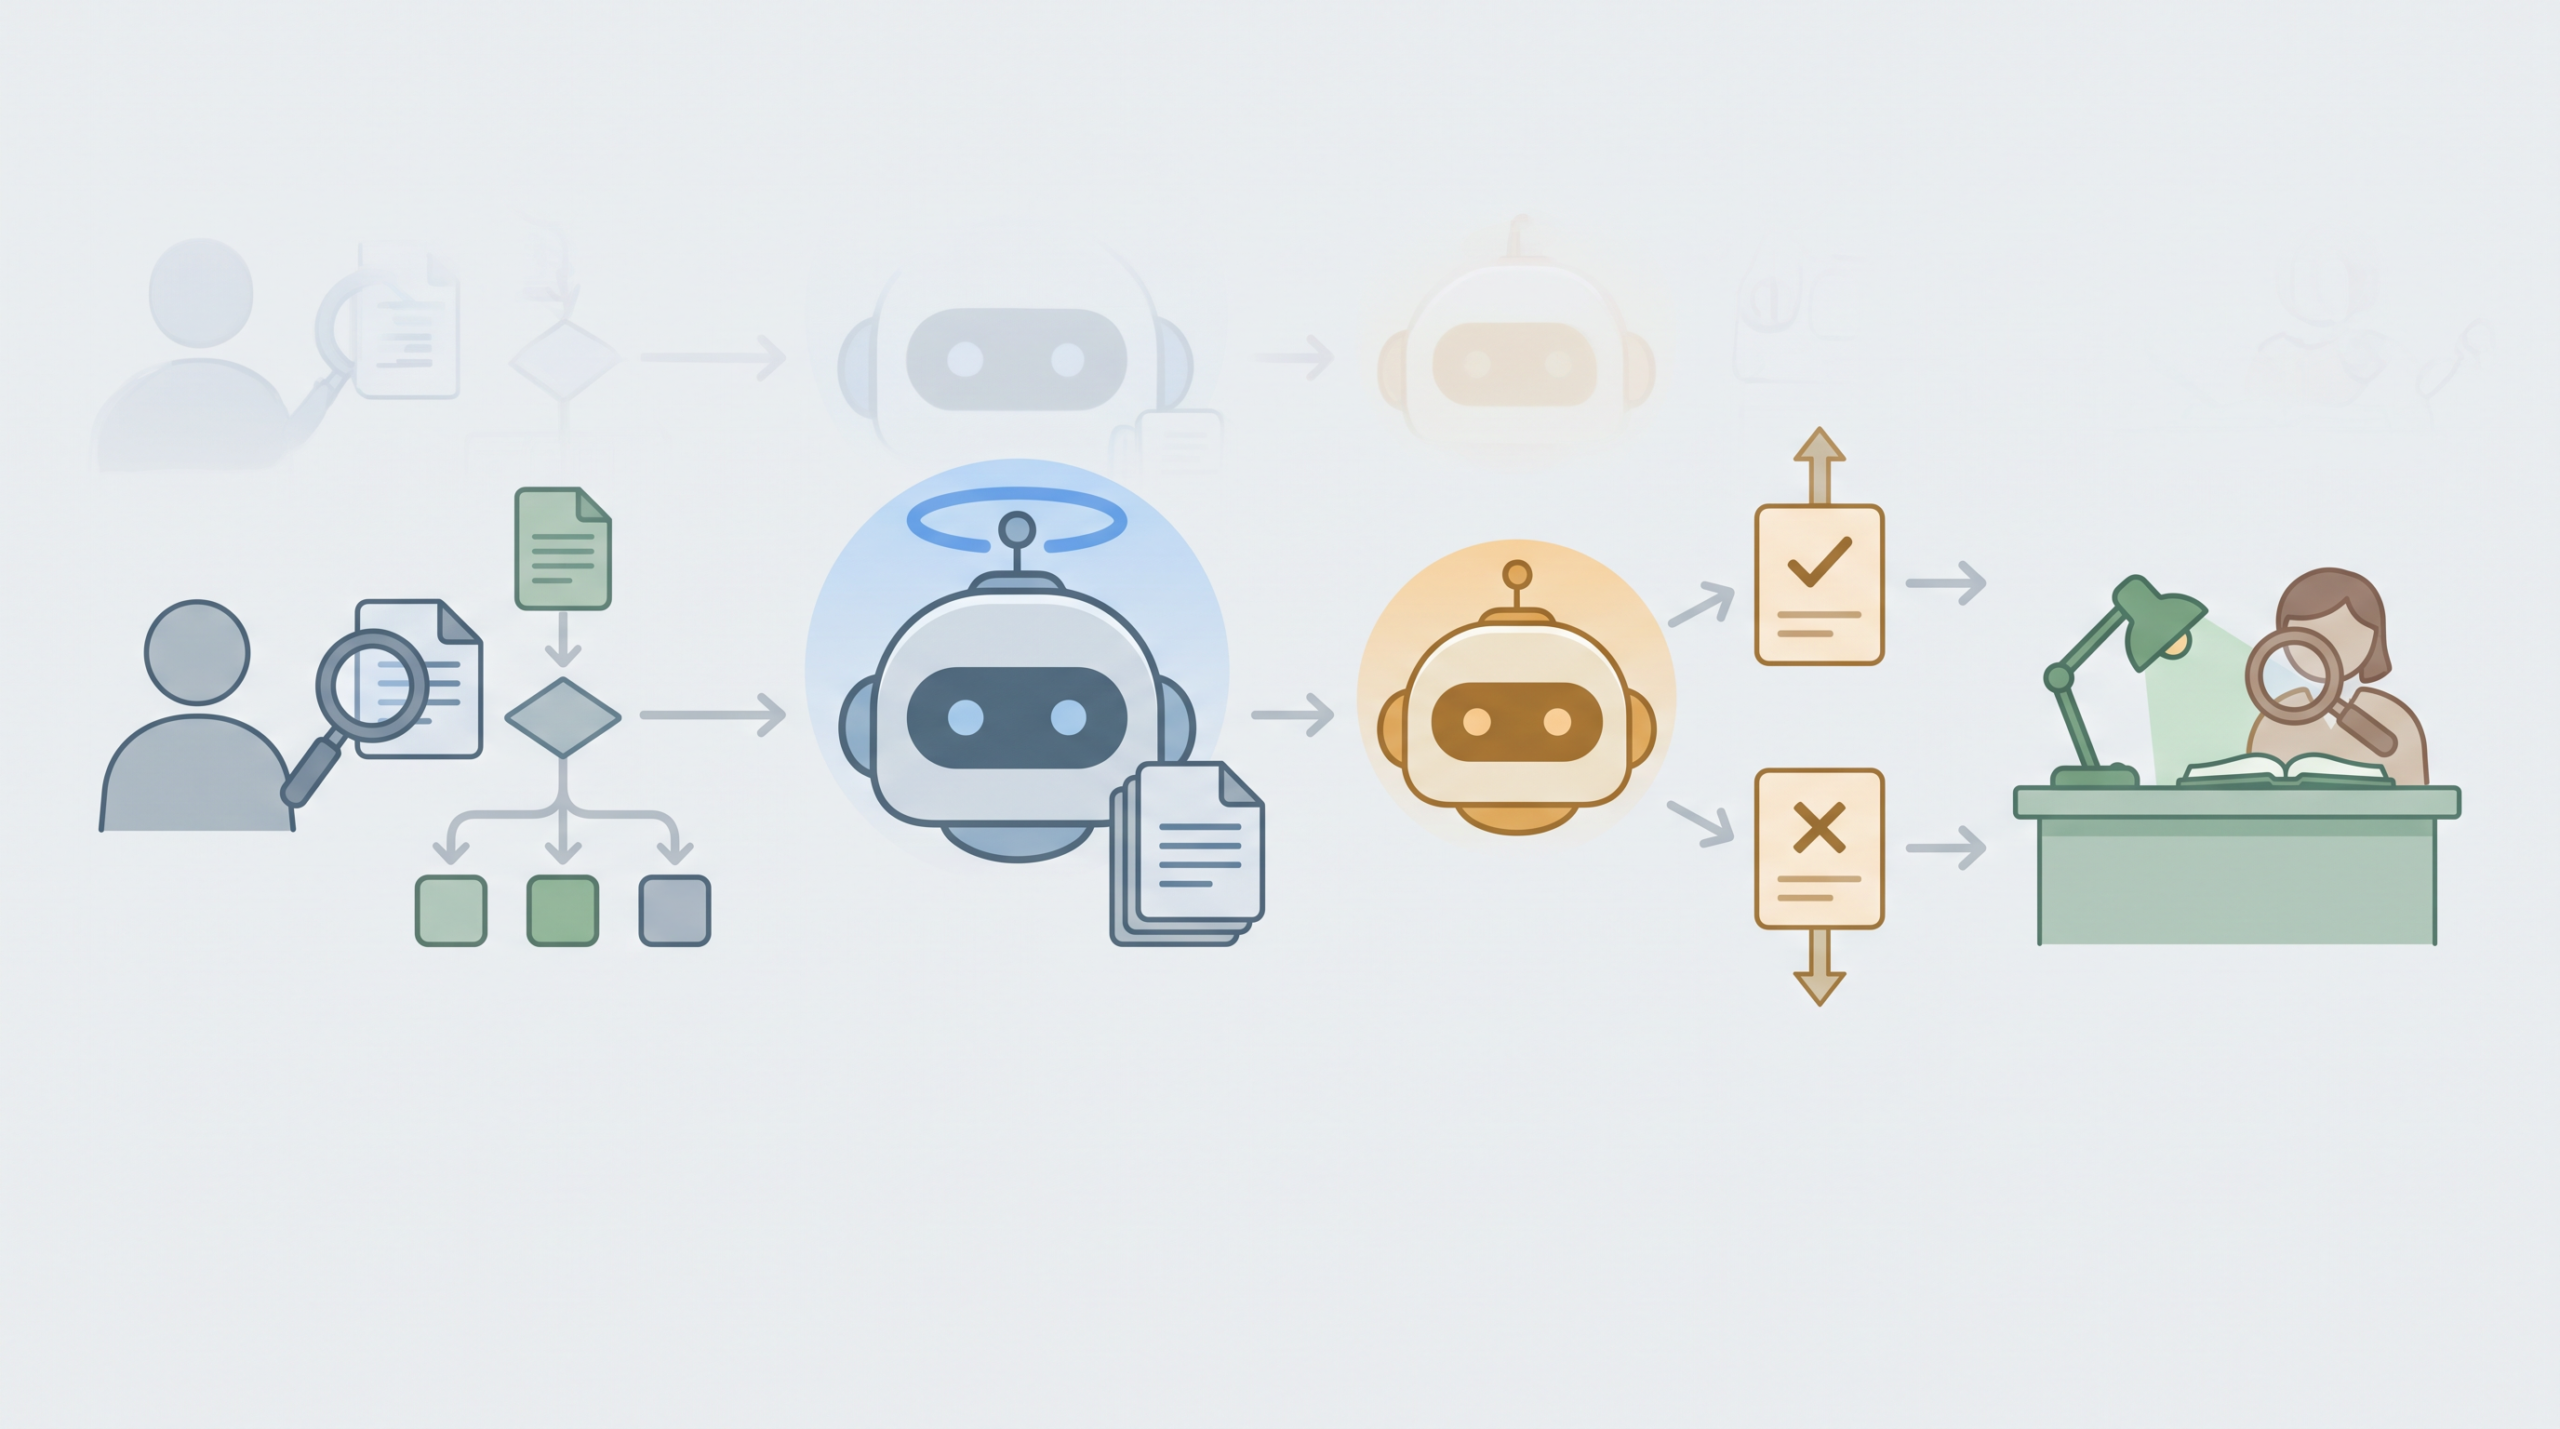
入出力の共通契約を整えたら、いきなり複雑な業務全体を連携させるのではなく、まずは代表的な一工程だけを切り出して別のAIへ渡して試します。たとえば、会議録音からの「音声データテキスト化」や、特定テーマに絞った「ウェブ情報の収集」など、独立して評価しやすい単一のタスクを選ぶのが効果的です。
これにより、設計した契約が実運用に耐えうるものかを的確に測ることができます。
この試行では、まずCLIなら上記の3コマンドをテスト用ディレクトリで実行します。codex-task.md、codex-result.md、review.mdが順番に作られ、最後のレビューが実際の差分を参照しているかを確認します。APIなら、あらかじめ設定された関数宣言、モデル要求、アプリ実行、結果返却の順を一往復だけ実装します。
API経路では、ホスト側に「別のAIを呼び出して特定の処理を行う」という関数宣言を用意します。起点にはClaude、GPT、Gemini、Grokのどれも使えます。モデルが返した関数名と引数をホストが検査し、呼び出し先のAPIキーで通信します。
試行では、判断目的と事前仮説を先に決めます。たとえば情報収集なら、担当者は「単一モデルが見落とした反証資料を別AIの検索で補えるか」を確かめます。必要な証拠は一次資料のURLと該当箇所です。別AIが新しい反証資料を示せなければ、複数モデル化の仮説は退けます。
起点となるエージェントの入力欄へ資料を添付し、次の依頼文を送ります。
「添付資料の主張に対し、登録済みの情報収集ツールを1回使ってください。支持する一次資料、反する一次資料、確認できない点を分け、URLと該当箇所を返してください。ツールが失敗した場合は推測で補わず、エラー種別を返してください。」
受け取るJSONでは支持証拠と反証証拠を分けます。未確認項目、エラー、出典も別の項目にします。担当者はリンク先の該当箇所と固有名詞を原典で照合し、単一モデルでは得られなかった判断材料が増えたかを記録します。増えなければ単一モデル経路を採用します。
結果は人が確認します。ホストはSchemaを検証し、担当者はリンク先の該当箇所、発行主体、更新日を照合します。失敗時のstatusとerrorsが記録されるかも別に試します。
失敗試験は、狙うエラーごとに分けます。短いタイムアウトでtimeout、無効なテスト用認証でauth_failed、必須項目を欠くテスト応答でinvalid_outputを確認します。いずれも新しいAPI呼び出しが止まり、request_idとエラー種別が担当者へ届けば合格です。
一工程の成功と失敗を確認できたら、継続運用で同じ要求が重複しないよう停止条件を加えます。
再試行より先に停止条件を決めます
一工程だけを別のAIへ渡すテストを通じて正常な連携が確認できても、成功例だけでは継続的な運用可否を決められません。実際の運用環境では、ネットワークの不調や相手方のAIモデルの状況によって、呼び出しが失敗するリスクが常に伴うからです。
エラーが起きた際、自動的に何度もやり直して無限ループに陥るのを防ぐため、まずは「どうやって止めるか」という停止条件を明確に設計する必要があります。
停止条件には、最大試行回数、処理全体の時間、費用上限を置きます。timeout(応答なし)は、同じ要求を再送しても書き込みが重複しない場合だけ再試行します。rate limit(利用制限)は、提供元が返す待機時間に従います。上限へ達したら新しいAPI呼び出しを止め、request_idとエラー種別を担当者へ通知します。
設定の誤りや権限不足によるauth(認証エラー)は再試行しません。invalid_output(形式不一致)は修復要求を1回だけ送り、再び不一致なら停止します。
ホストは新しいAPI呼び出しを止め、request_idとエラー種別を運用担当者へ通知します。
また、再試行を行う場合でも、同じ要求を何度も送ってしまう「重複実行」を防止する仕組みが不可欠です。
たとえばxAIを利用する際など、tool callを受けて結果を戻すループを開発者側で実行する構成では、ホスト側がやり取りの回数や状態を適切に管理しないと、意図せず呼び出しを無限に繰り返してしまう危険があります。
さらに、複数の段階を踏んで別のAIとやり取りをする場合は、状態の管理がより複雑になります。
たとえばGemini 3のように複数段階の呼び出しを行う際、RESTで履歴を手動管理するときsignatureをそのまま返すことで、AIの思考プロセスを維持する仕様があります。
ホスト側は署名をAPI仕様どおり履歴へ戻します。ただし、署名は重複実行を防ぐIDではありません。重複防止には別のrequest_idを発行し、同じIDの処理結果を再利用する設計が必要です。
停止時は新しいAPI呼び出しを止め、request_id、エラー種別、試行回数、費用を記録して担当者へ通知します。この状態まで確認できれば、複数モデルの試行結果を人が評価できます。
品質差が管理負担を超えるか測ります
ここまでに、停止条件や安全装置を含む接続役の設計を行い、複数のAIを連携させて動かす準備が整いました。しかし、技術的に別のAIを呼び出せるようになったからといって、無条件に複数モデルを採用すべきではありません。接続や失敗処理、日々の運用管理を含めた「総負担」と、連携によって得られる成果を比較し、最終的な結論を出す必要があります。
まず考慮すべき負担は、APIキーとログ管理におけるセキュリティの「境界」です。複数のAIモデルを連携させるということは、通信の経路やデータが渡る外部の境界が増えることを意味します。
たとえばOpenAIの場合、APIの保存条件はエンドポイントと設定で異なるため、各社・各モデルのデータ取り扱いに関する規約を個別に確認しなければなりません。
どのAIモデルにどのようなデータが送信され、どこにログとして残るのかを管理・監視する手間は、利用するモデルを追加するたびに重くなります。
さらに、出力結果の検証も管理負担の一つです。
連携に際してMCPを利用し、outputSchemaがある場合サーバーは適合結果を返す仕組みを組み込めば、システム側でデータ形式の適合チェックはある程度自動化できます。
しかし、形式が適合していても内容が目的に沿っているかどうかの確認や、失敗時に人が行うフォローアップの手間は依然として残り続けます。
単一モデル経路と複数モデル経路には、同じ入力、同じ出力Schema、同じ試行回数を使います。担当者は各試行の重大な誤り、完成までの時間、API費用、人の確認時間、再実行回数を記録します。比較条件をそろえなければ、モデル差と入力差を分けられません。
最終的な採用基準は、「得られた品質差が管理負担を明確に上回るか」という点に尽きます。別AIが単一モデルでは扱えない入力形式に対応する場合や、重大な見落としと人の確認時間を代表タスクで減らせた場合は、連携を採用する根拠になります。差が再現せず、エラー対応やログ監視の時間が増えるなら、単一モデルだけで処理する構成へ戻します。
私なら、別AIを呼べた時点では採用しません。同じ代表タスクを単一モデルでも試し、重大な誤りと確認時間が減った場合だけ連携を残します。API費用、監視、エラー対応のほうが増えたなら、一つのモデルへ戻す。それで十分です。
よくある質問
Q1. 一般向けのチャット画面だけで別のAIを自由に呼び出せますか?
利用中の製品が対象サービスとの連携機能を提供し、管理者が有効化している場合に限ります。対象外のAIを呼ぶには、ローカルスクリプト、MCP、サーバーAPIのいずれかを用意します。
Q2. MCPを使って連携させる場合、呼び出し先のAIのAPIキーは不要になりますか?
不要にはなりません。MCPはあくまでデータ受け渡しの規格であり、認証や課金を代行する仕組みではないためです。呼び出し先のAI提供元で個別にAPIキーを発行し、接続役のプログラムやMCPサーバーに正しく設定して通信を確認してください。
Q3. ClaudeとChatGPTの月額プランだけでClaude CodeとCodex CLIを連携できますか?
各CLIが対象プランのログインに対応していれば、ローカルのシェルからclaude -pとcodex execを順番に起動できます。ただし、両社のサブスクリプションが直接つながるわけではありません。各CLIへ個別にログインし、利用上限と権限を別々に管理します。
Q4. 通信エラーを防ぐため、自動で再試行を繰り返すように設定してもよいですか?
無条件には繰り返しません。最大試行回数、処理全体の時間、費用上限を決めます。rate limitでは提供元の待機指示に従い、認証エラーは再試行せず担当者へ通知します。
Q5. GrokとGeminiも月額サブスクリプションのCLIとして呼べますか?
Grok側は対象の有料プランへ加入したアカウントでBuildへサインインすれば、APIキーを用意せず非対話実行できます。
Google側はAntigravity
CLIへ移行しています。個人のGoogleアカウントでログインし、無料枠または契約プランのモデルクレジットを使ってagy -pを実行できます。旧Gemini
CLIは2026年6月18日以降、個人向けGoogle AI
Pro・Ultraの経路では使えません。
Q6. 連携を管理する際、ホスト側のログにはどのような情報を残すべきですか?
task_id、request_id、モデル名、開始・終了時刻を記録します。試行回数、status、出典、エラー種別も残します。プロンプト全文は保存可否とマスキング条件を先に決めます。APIキーや認証ヘッダーは残しません。
Q7. 運用開始後、複数モデルの連携をやめて単一モデルへ戻す基準は何ですか?
重大な誤り、完成時間、API費用を確認します。確認時間または再実行回数が、事前の撤退条件を超えた場合も対象です。同じ代表タスクを単一モデルでも複数回試して判断します。
業務に合うAIシステムの開発をご相談ください
AIを試せても、社内のデータや既存システムにつないで使うには、入力・出力・権限・確認手順を決める必要があります。Deskrexでは、業務に合わせたAIエージェントや自動化システムの開発をご支援しています。

まず、つくりたいシステムと現在の業務、接続するツールやデータを伺います。技術の選定と小規模な試作を通じて、必要な機能と実現方法を確かめ、開発の範囲を整理します。
Difyやn8nを使う自動化、独自のAIエージェント、セルフホスト型システム、既存システムとの連携に対応します。試作から本開発、導入、保守・運用まで、案件の目的に合わせて進めます。
つくりたいシステム、扱うデータ、接続先をお知らせください。受託開発のご案内をご覧ください。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai

コメント