新製品のローンチ前調査では、膨大な情報を集めて整理する作業に多くの時間がかかります。しかし、AIにすべてを任せてしまうと、誤った情報が混入したまま重要な意思決定を下してしまうリスクがあります。本記事では、AIによる情報の複数資料の整理と、人による正確な判断を両立し、調査からローンチ判断までをつなぐ6工程の実行手順を解説します。
製品の立ち上げにおいて、SBAは市場調査で需要、市場規模、所在地、市場飽和度、競合価格を確認し、競合分析を競争優位の発見へつなげることを推奨しています。また、実際の進行では、市場調査、対象顧客、ポジショニング、品質保証、GTMを部門横断の別工程として示す必要があります。多岐にわたる項目を効率的に整理するために、AIの支援を活用します。
具体的な作業として、ChatGPTのDeep Research機能などを情報収集に用います。Deep Researchは公開Web、アップロードファイル、許可済み接続アプリを使い、開始前の調査計画を利用者が確認・編集できるため、意図した通りの方針で進められます。
AIには情報の比較下書きと未確認事項の洗い出しを任せ、実行後は引用付きレポートをMarkdown、Word、PDFで保存できる機能を使って結果を書き出します。このとき、接続アプリは研究で読み取り操作を使い、書き込み操作を使わないため、外部システムへ意図しない変更を加えることはありません。
最も重要なのは、AIと人の役割の境界を維持することです。AIが作成した比較下書きと未確認事項のリストをもとに、人が公式ページの原典確認を行い、実際の契約条件、価格、データ条件を一つひとつ直接確かめます。AIに未確認の価格換算を行わせたり、出典のない時間短縮率を根拠にしたり、AIによる発売可否の自動決定を委ねたりしてはいけません。
人が最終的なローンチ判断を行う手順を定めることで、根拠を確認した意思決定につなげることができます。
ローンチ前調査は「何を決めるか」から逆算する
新製品のローンチ前調査をAIで効率化するにあたり、最初に決めるべきは調査の出口です。AIへ指示を出す入力ファイルや実行ツールを選ぶ前に、調査結果を受けて人が何を判断するのかを固定しておく必要があります。
市場調査の一般的な指針として、需要、市場規模、所在地、市場飽和度、競合価格を確認し、競合分析を競争優位の発見へつなげることが重要視されています。また、実際のローンチに向けた進行においては、市場調査、対象顧客、ポジショニング、品質保証、GTMを部門横断の別工程として示すアプローチがとられます。これらの工程において、何を明確にするかが判断の軸となります。
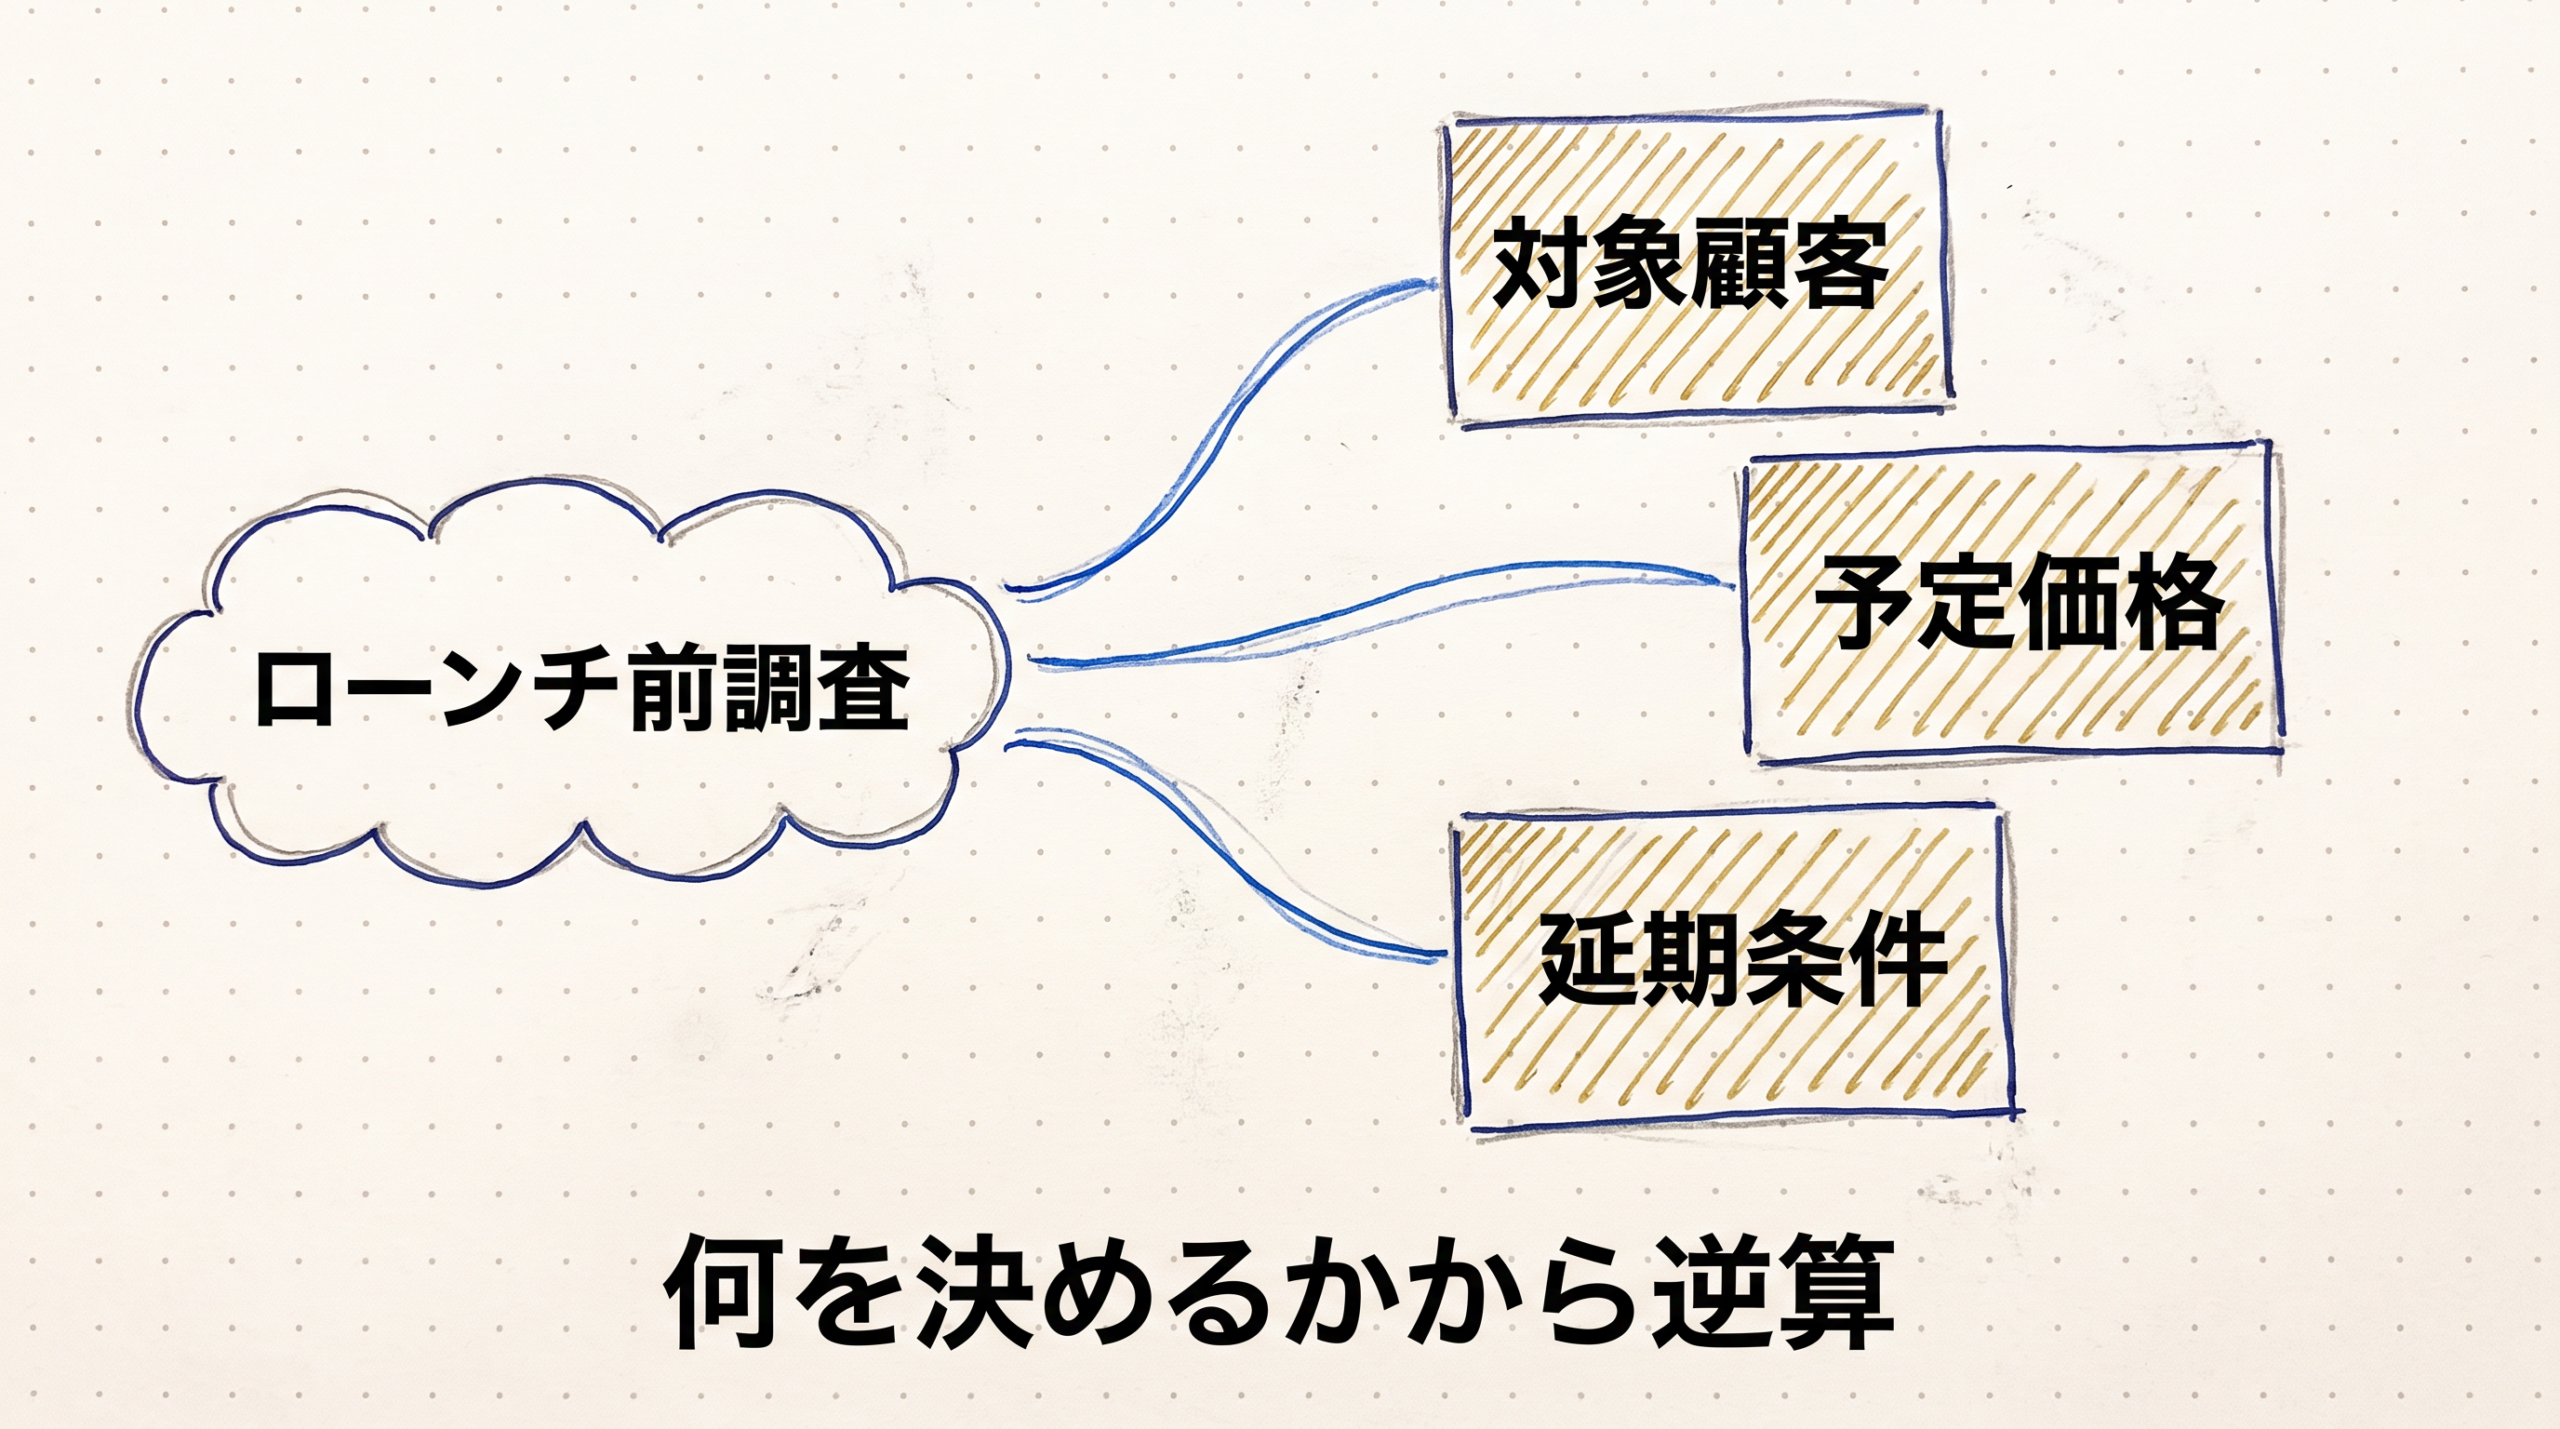
ここでは、架空の法人向け議事録AIであるMeeting Lensのローンチを控えていると仮定し、調査から導くべき3つの判断事項を設定します。
1つ目は、日本の100から500人規模企業を初期の対象顧客としてそのまま進めるかという判断です。2つ目は、自社が設定した予定価格を維持して市場に参入するかという判断です。3つ目は、競合の動向や自社の状況を踏まえたローンチの延期条件は何かという判断です。
調査のプロセスにおいて、情報を比較するための下書き作成や、未確認事項の洗い出しはAIに任せます。一方で、公式ページにおける原典の確認、詳細な契約条件や価格、データ条件の確認、そして最終的なローンチ判断は人が行います。AIに調査を委ねる部分と、人が事実確認をして意思決定をする部分の境界を維持することで、誤った事実が判断に混入することを防ぎます。
AIへ渡す2つの入力ファイルを作る
前工程で設定したローンチの判断事項を、AIが具体的に読める制約と既知情報へ落とし込むために、具体的な入力ファイルを作成します。対象顧客、AIの活用範囲、入力内容を明確にして生成AIを使うことで、曖昧な依頼による出力のブレを防ぎます。
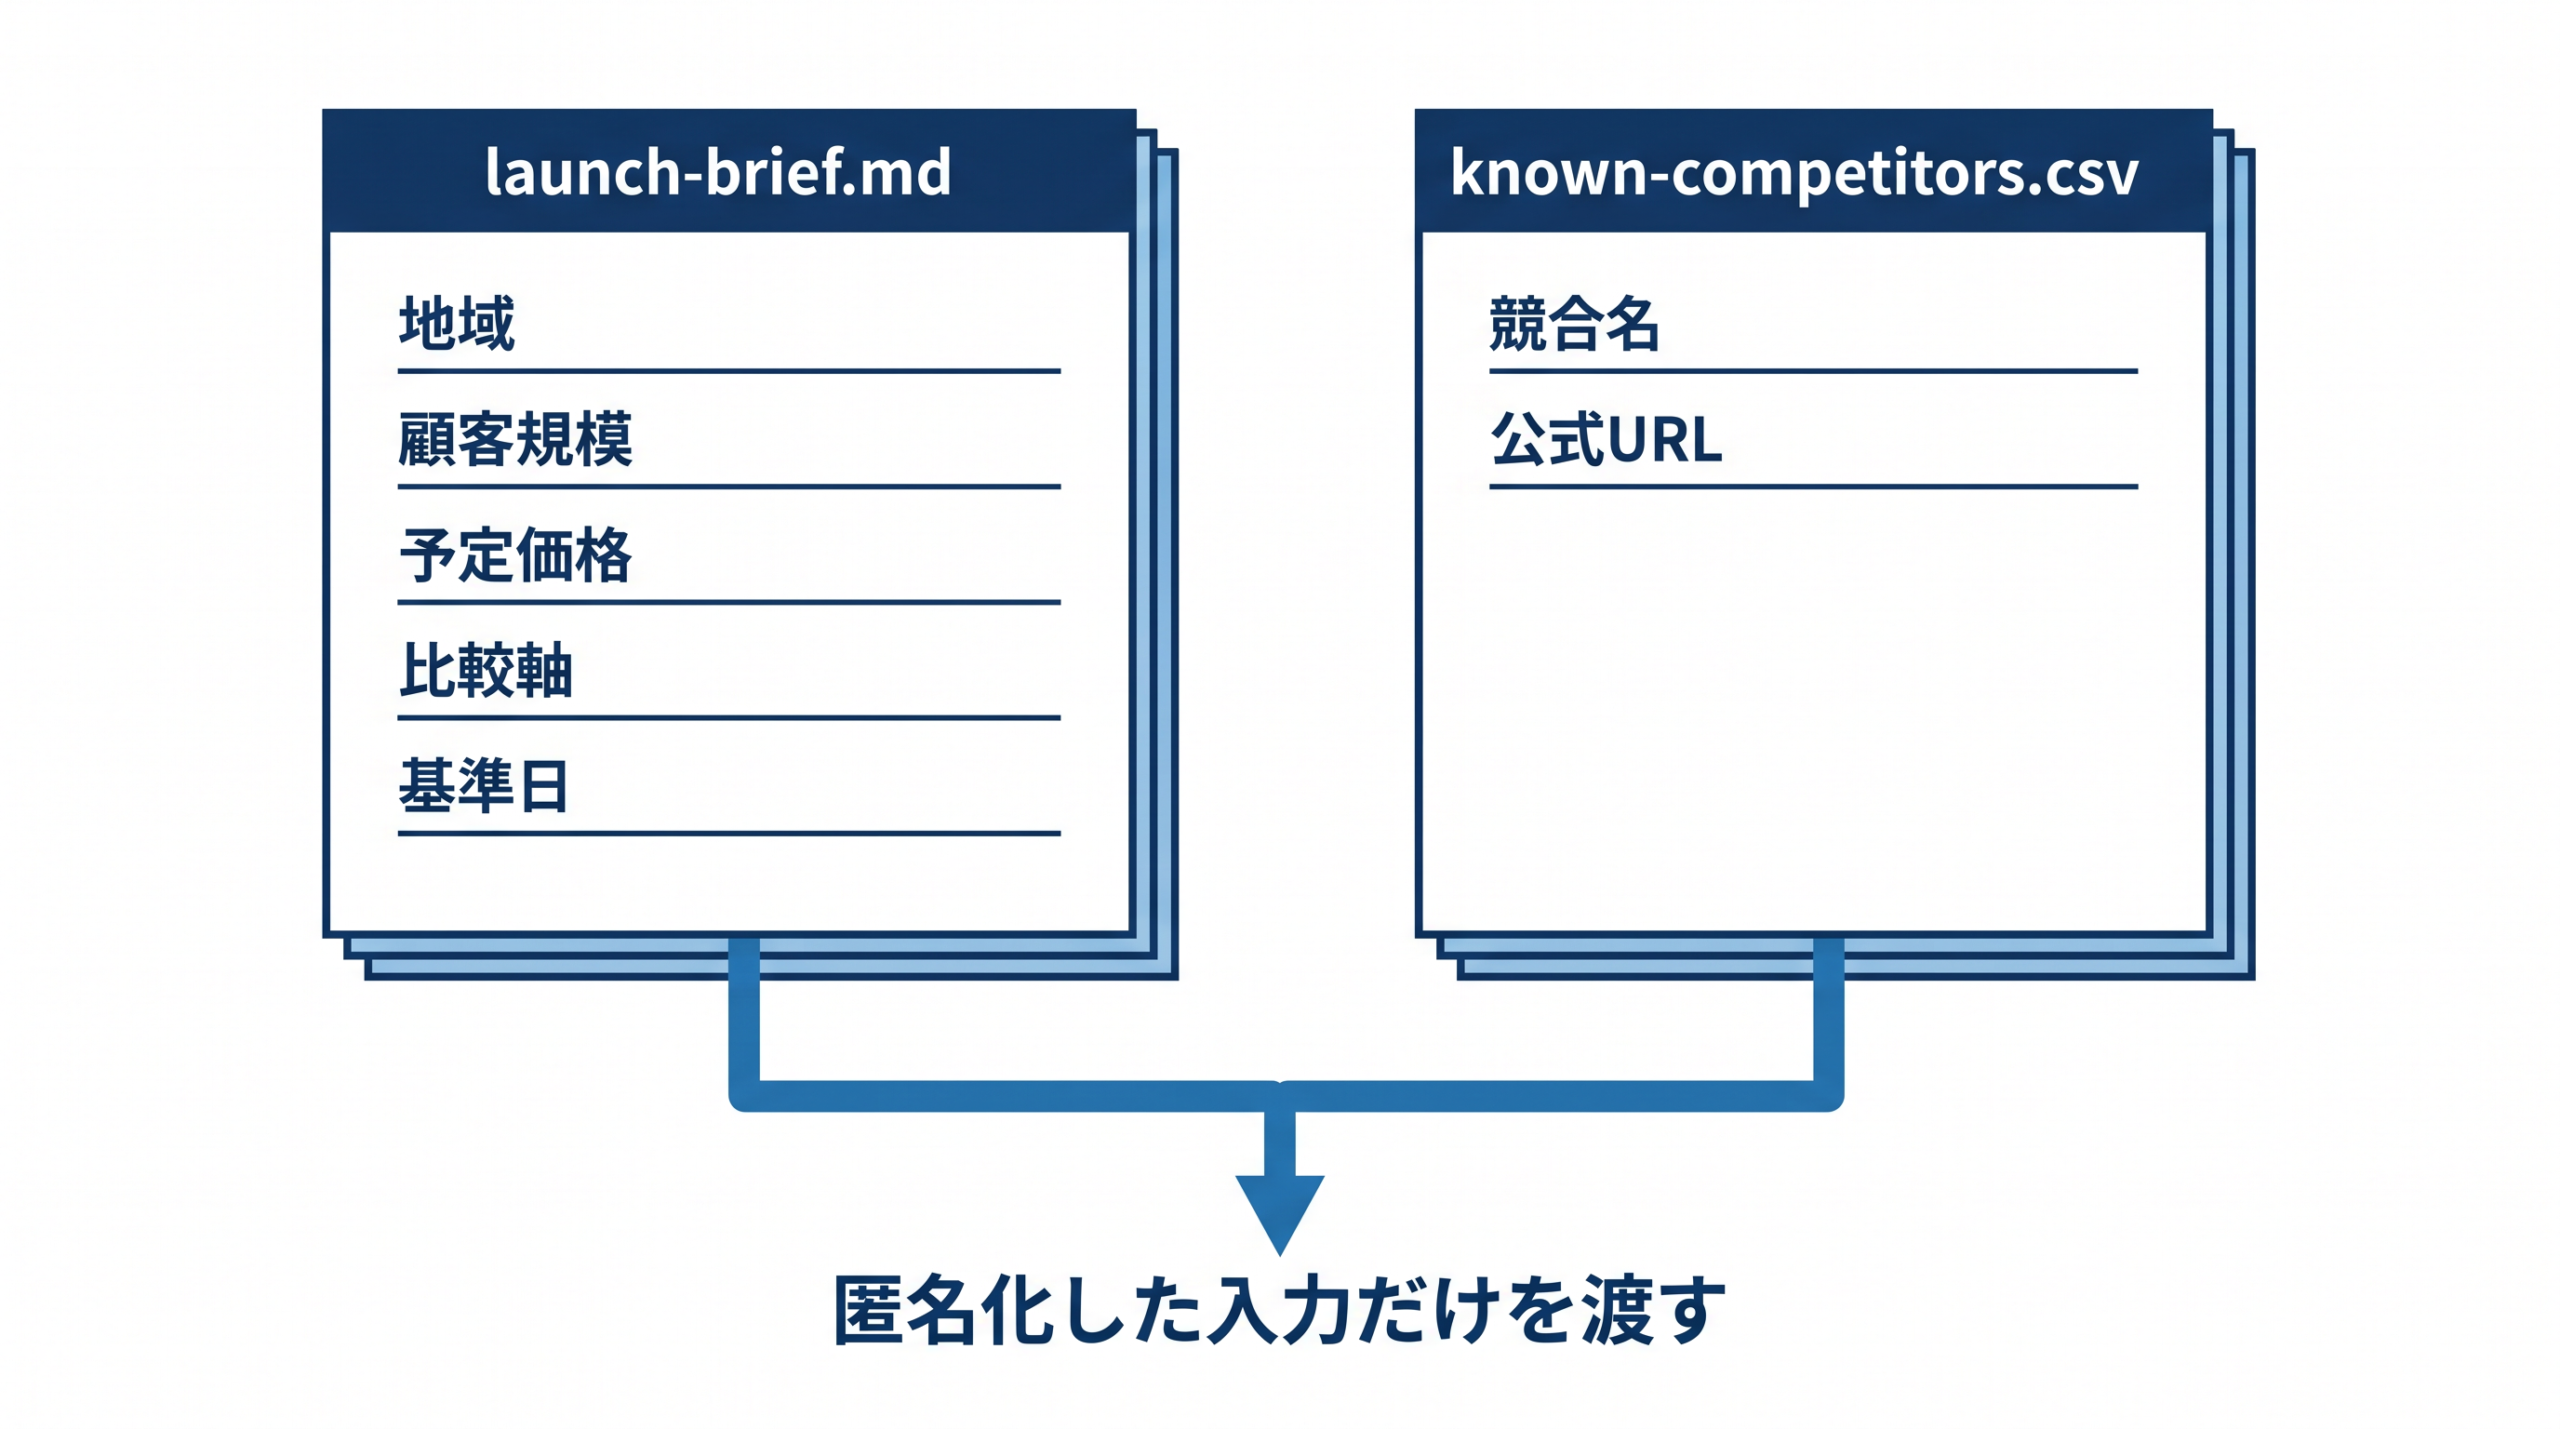
ローンチに向けた調査では、調査前に3〜5個の具体的な問いを決め、競合5〜8社を同じ軸で比較し、規制や販売期間などの制約を記録することが求められます。これを再現可能な手順にするため、架空の法人向け議事録AIであるMeeting Lensの調査依頼として、2つのファイルを用意します。
1つ目は、前提条件をまとめたテキストファイルであるlaunch-brief.mdです。ここには、日本の100から500人規模の企業という対象地域と顧客規模、自社の予定価格、機能やサポート体制などの比較軸、そしていつの時点の情報を正とするかの基準日を書き込みます。
2つ目は、調査対象を固定するためのknown-competitors.csvです。このファイルには、自社が既に認識している競合の名称と、その公式URLだけを保存しておきます。
AIにはこの2つのファイルを渡し、設定した比較軸に基づく下書きの作成と、情報が見つからなかった未確認事項の洗い出しのみを指示します。AIに発売可否の自動決定を求めたり、海外製品の未確認の価格換算をさせたりはしません。
あくまでAIの出力は比較の下書きとし、人はAIが提示した公式ページのURLから契約条件、価格、データ条件の原典を確認し、最終的なローンチ判断を行うという境界をここで明確にしておきます。
ChatGPT Deep Researchで調査計画を確認してから実行する
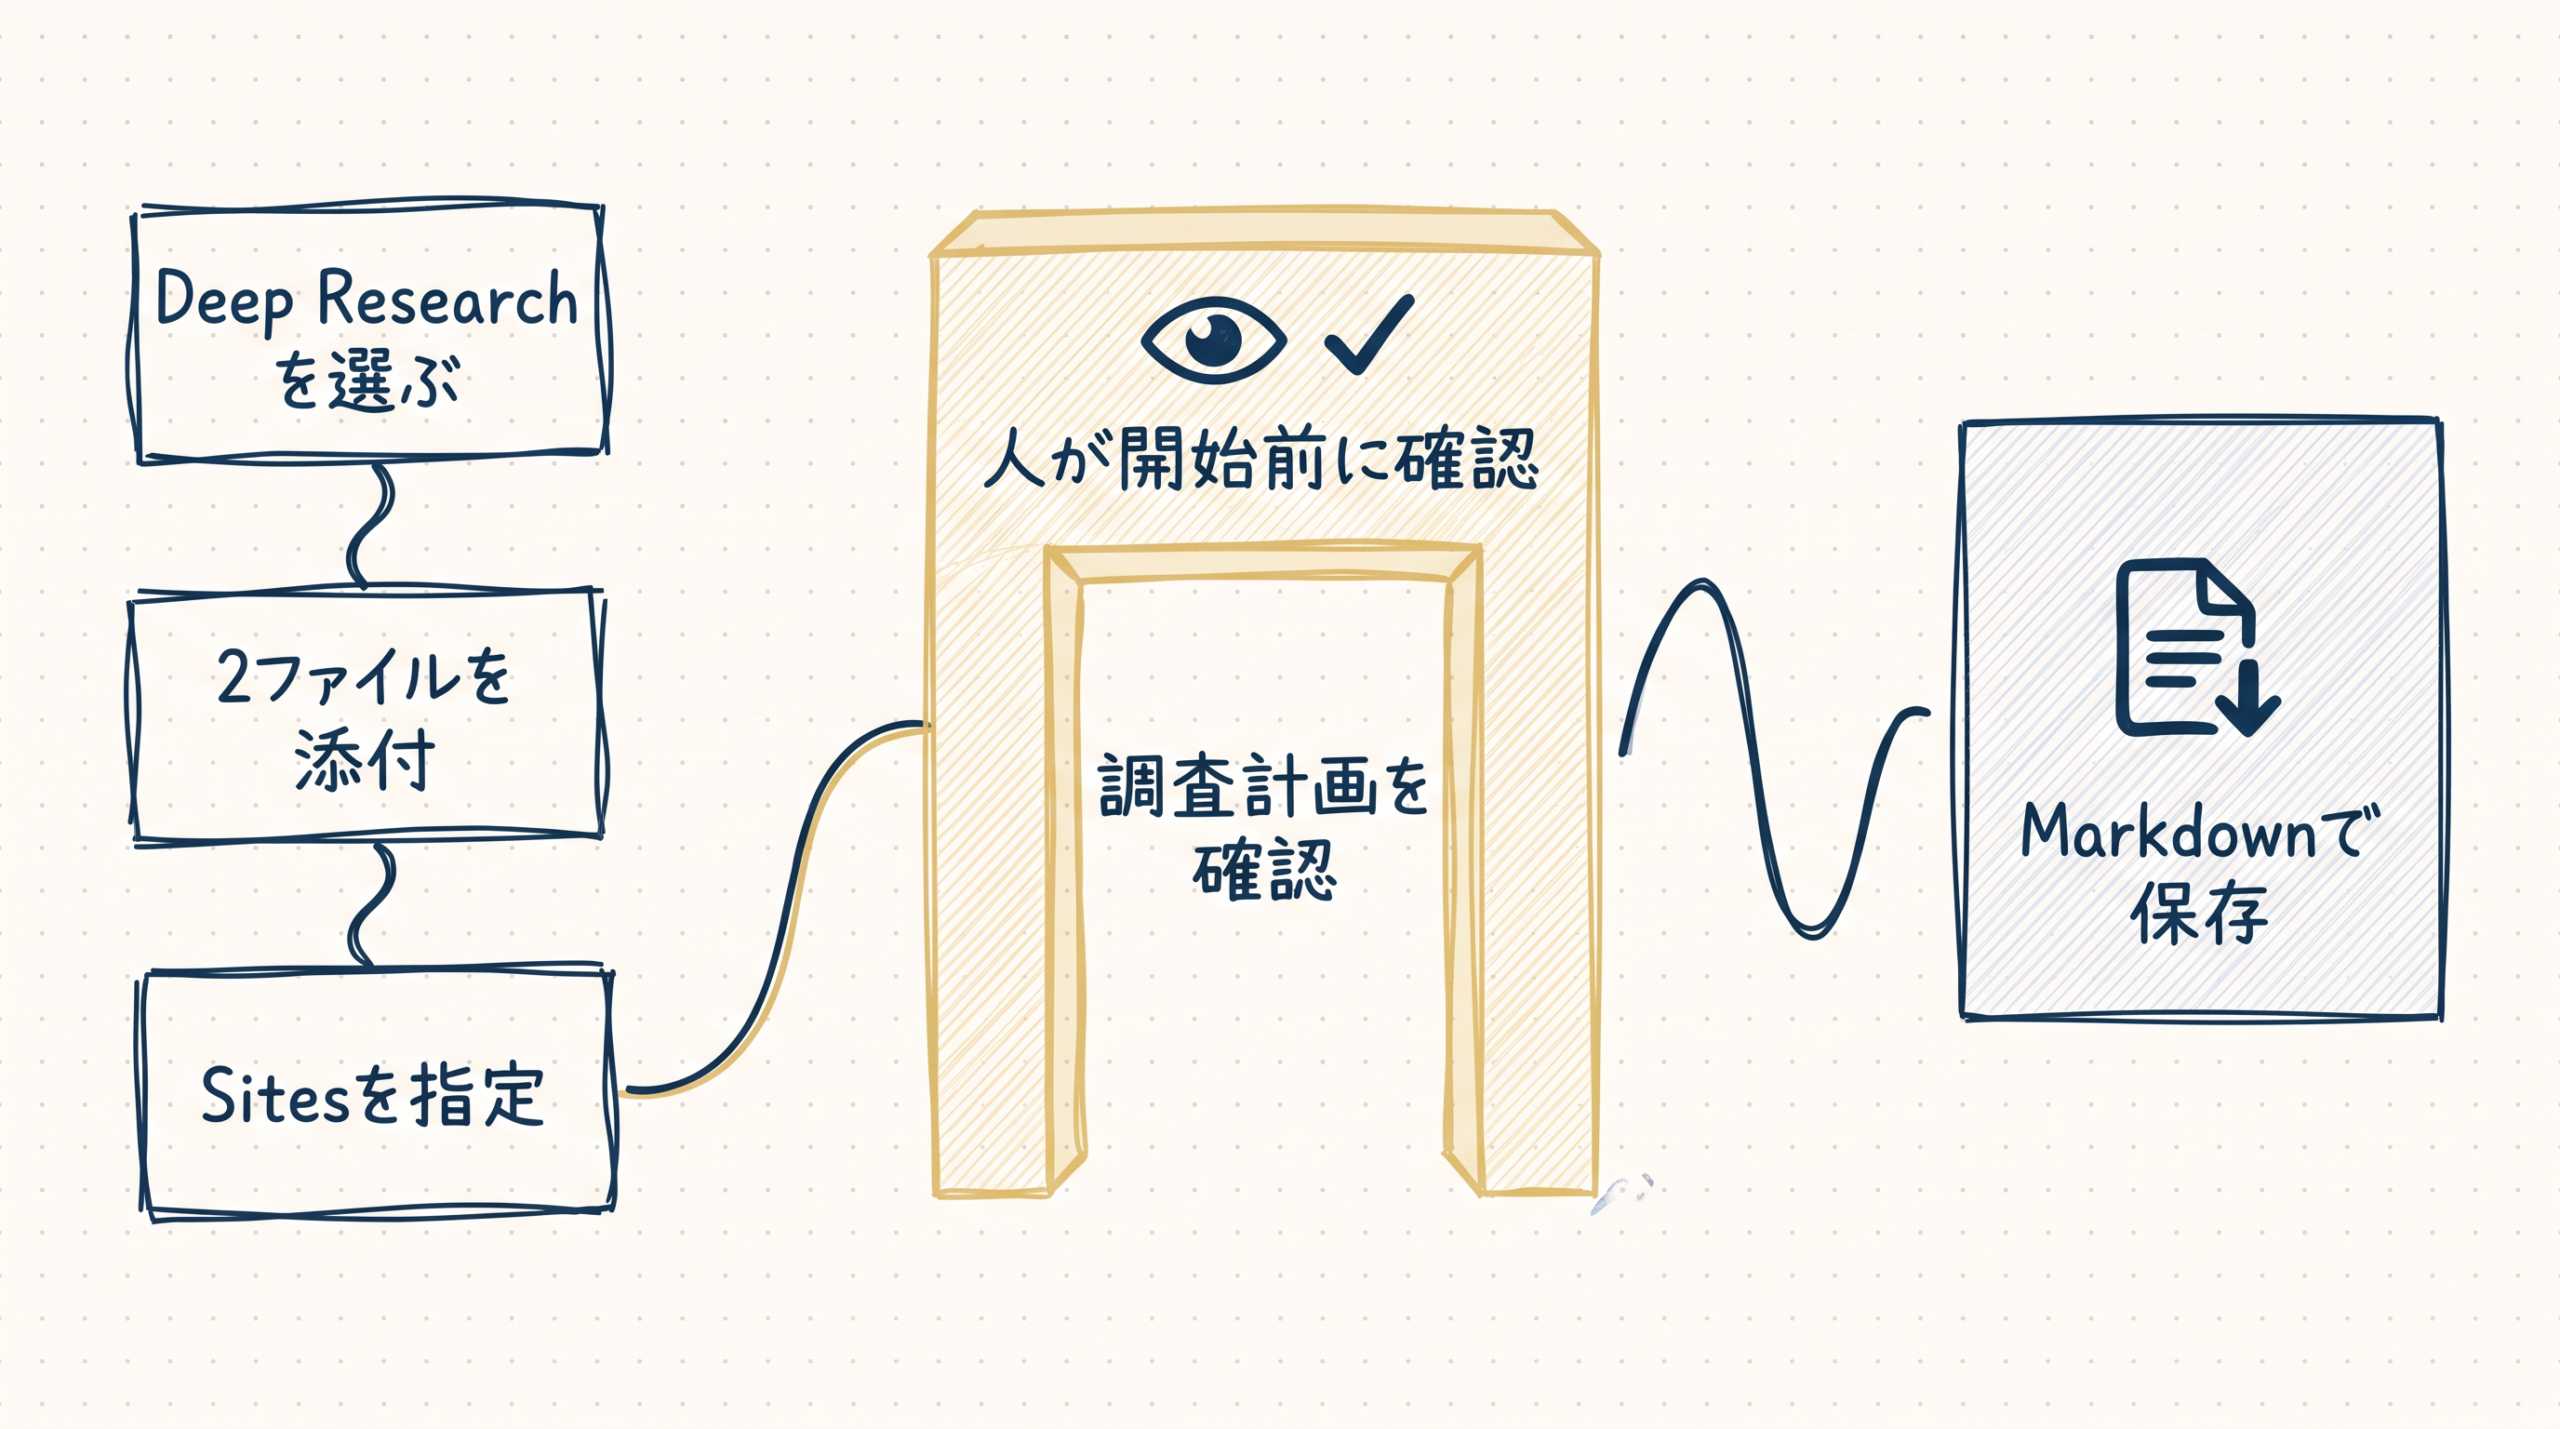
準備した2つの入力ファイルを、引用付きの比較下書きへと変換するために、ブラウザ上のChatGPTで具体的な操作を行います。
まず、ツールメニューからDeep Researchを選択し、作成したlaunch-brief.mdとknown-competitors.csvの2ファイルを添付します。プロンプトの入力欄には、調査対象の公式情報を正確に拾うために、Sitesの指定として対象となる競合の公式ドメインを明記します。
Deep Researchは、公開Web、アップロードされたファイル、そして許可済みの接続アプリを使って情報を収集します。この際、接続アプリは研究目的での読み取り操作のみを行い、書き込み操作は使わない仕様となっています。
入力を送信すると、すぐに調査が始まるわけではありません。開始前の調査計画を利用者が確認および編集できる状態になります。この計画画面で、AIがどのような手順で情報を集めるかを確認します。具体的には、計画の中に「公式価格と第三者評価の分離」「未確認事項の表示」、そして原典確認のための「URLと確認日」が含まれているかを目視でチェックします。
不足があれば計画を編集して補い、問題がなければ実行を開始します。
調査が完了すると、AIから回答が提示されます。実行後は、引用付きのレポートをMarkdown、Word、PDFの形式で保存できるため、扱いやすい形式を選んで手元にダウンロードします。
このようにして得られたレポートは、あくまでAIが作成した調査の下書きと未確認事項のリストです。ここから先は、ダウンロードしたレポートに記載されているURLから人が公式ページへアクセスし、契約条件や価格、データ条件の原典を一つひとつ確認することで、最終的なローンチ判断を行うための確実な材料へと引き上げていきます。
引用付きレポートを競合事実カードへ変える
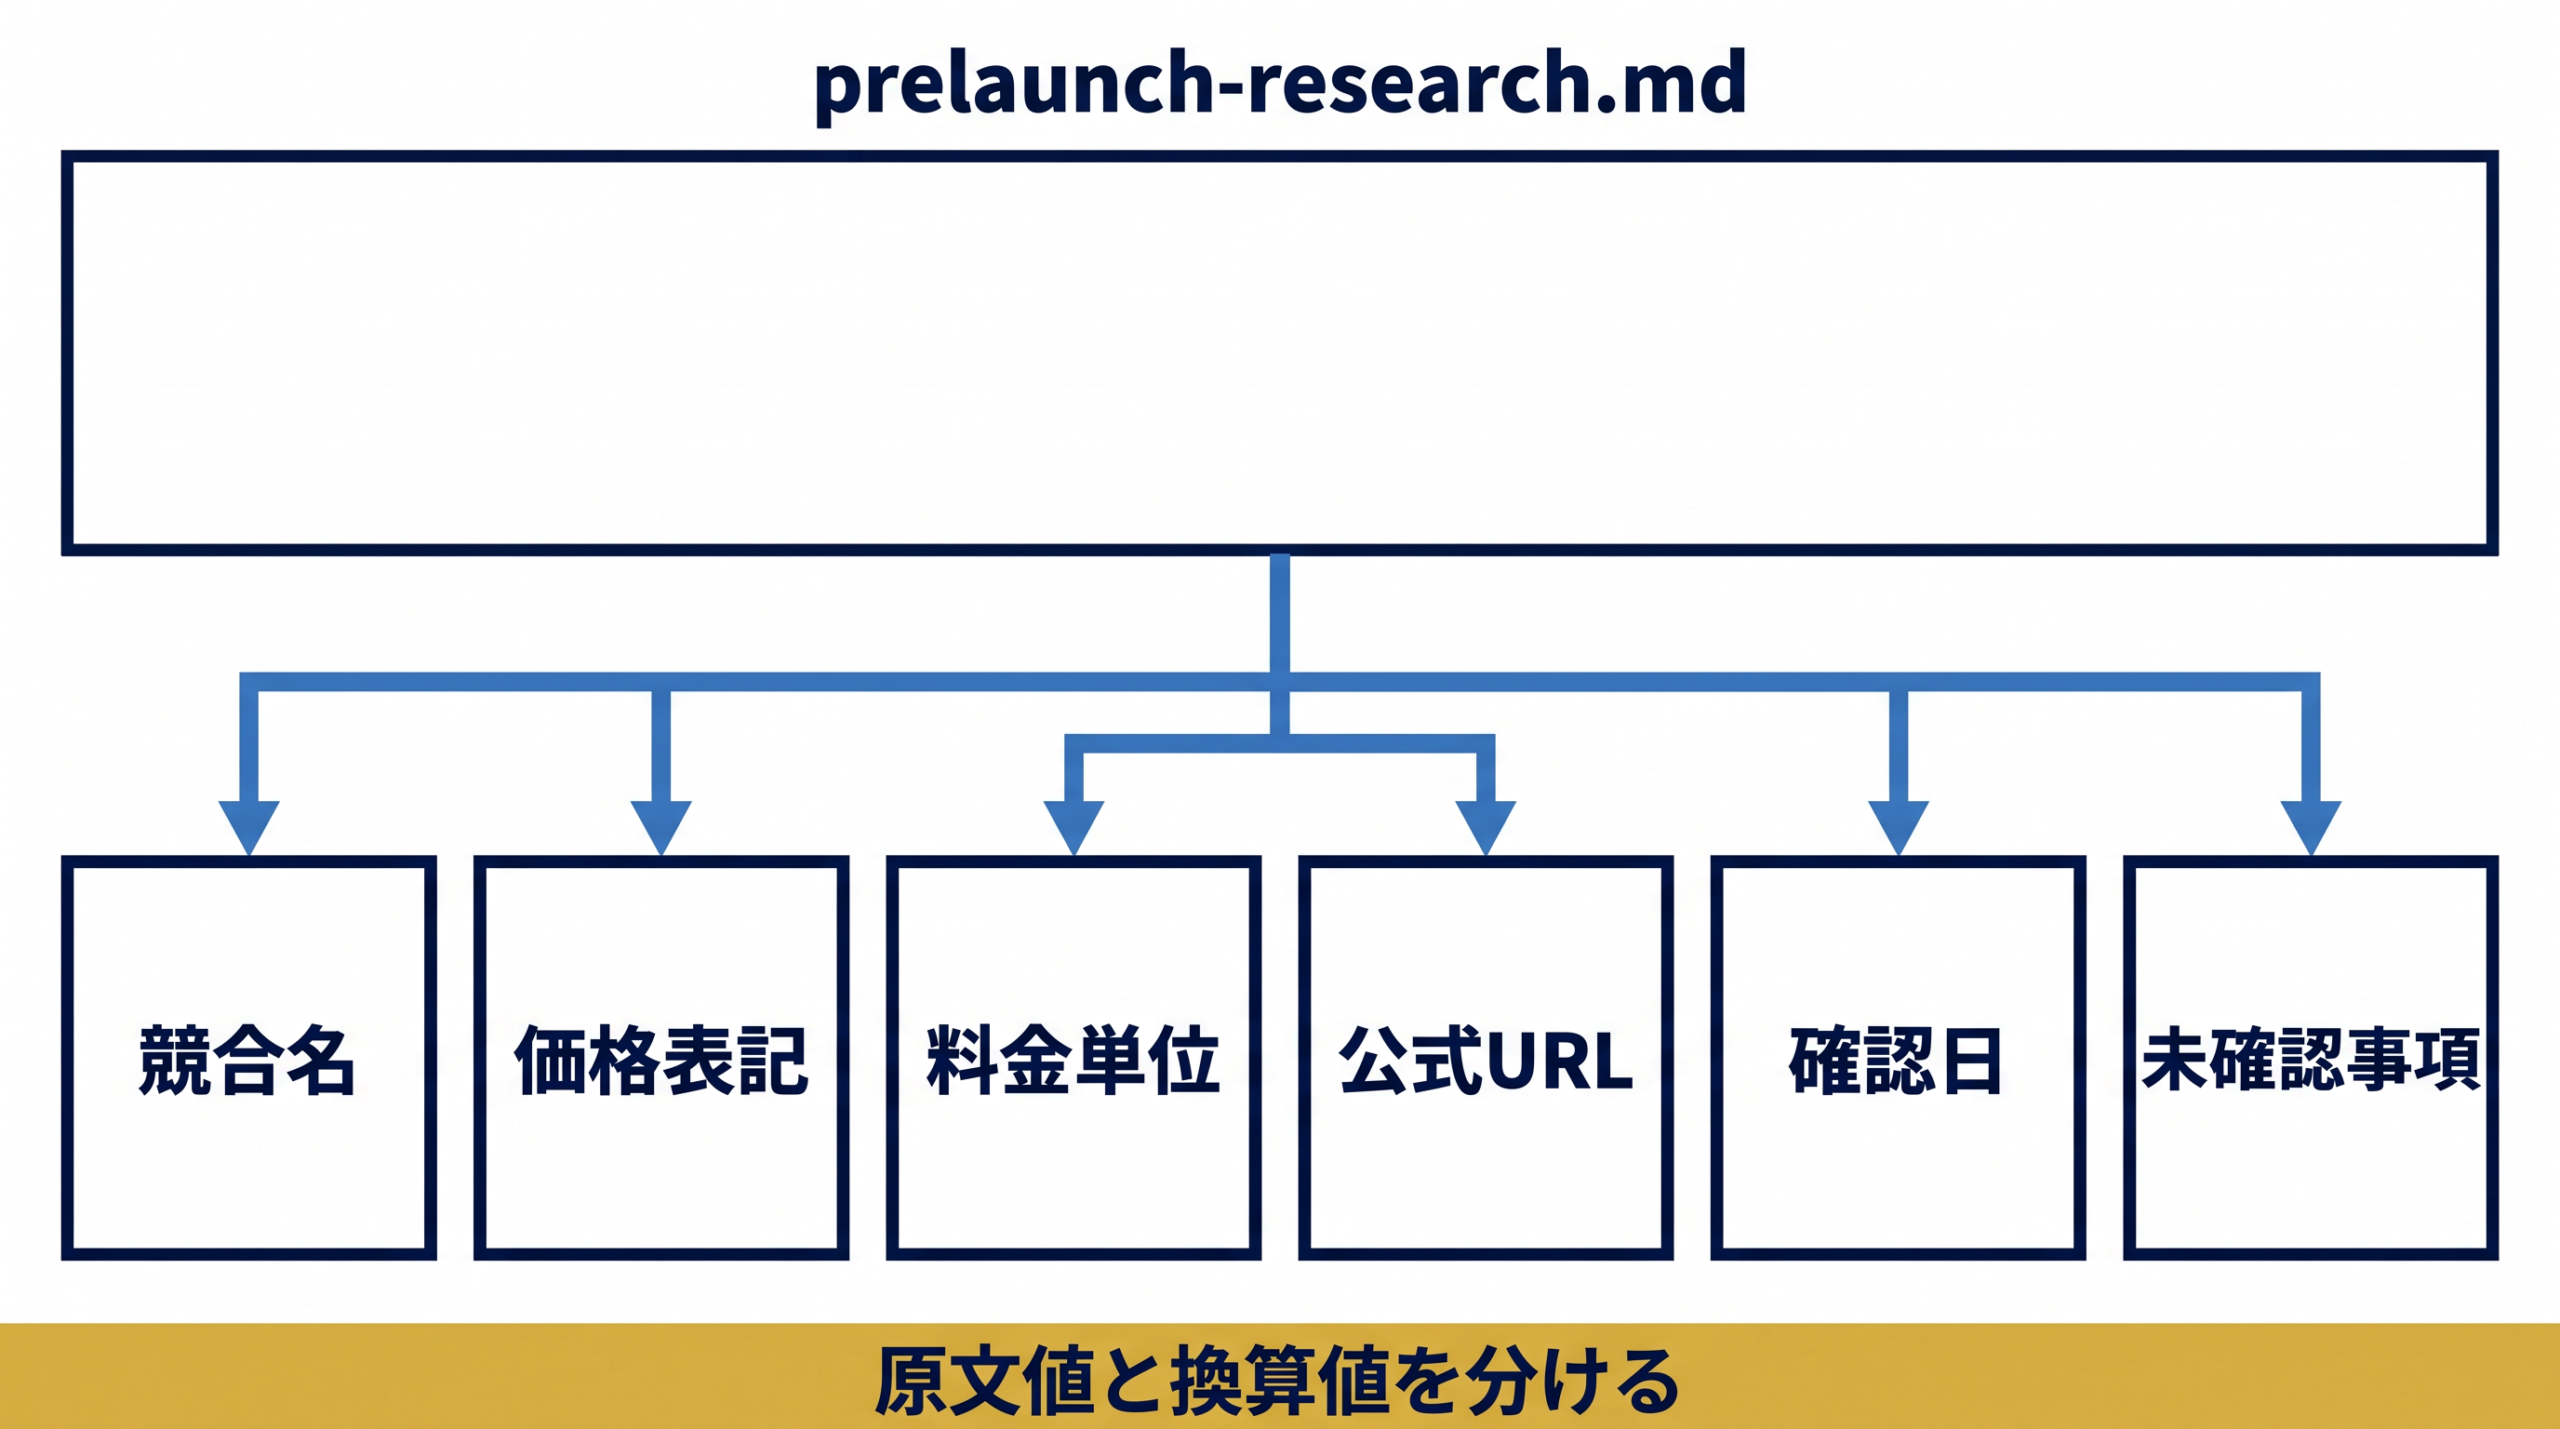
AIが作成した引用付きのレポートを出力しただけでは、そのままローンチ判断の証拠として使うことはできません。NISTは生成AIが誤った内容を自信ありげに提示するconfabulationを挙げ、重大な意思決定で監視すべきとしているためです。AIの出力を事実として扱うためには、人が一つひとつ検証可能な形へ分解する必要があります。
具体的には、ダウンロードしたprelaunch-research.mdの内容を、一覧できるcompetitor-facts.csvなどの競合事実カードへ移し替えます。このとき、競合名、公式ページにおける価格表記、料金単位、対象顧客、公式URL、確認日、未確認事項といった項目を順番に記録していきます。
製品投入前に需要、競争上の位置、価格期待を確認し、価格や訴求の調整へつなげるためには、正確な情報に基づく比較が不可欠です。価格情報を扱う際は、人が計算した月額換算値と、公式ページの表記そのままの原文値とを明確に分離して記録します。この過程で、AIに未確認の価格換算をさせたり、ローンチ可否の自動決定を委ねたりしてはいけません。
あくまでAIの役割は比較下書きの作成と未確認事項の洗い出しまでです。人は競合事実カードに並んだ公式URLへアクセスし、実際の契約条件、データ条件、そして正しい価格を原典で確認した上で、原典で確認した情報をローンチ判断へ持ち込みます。
AIの比較結果をローンチ判断へ接続する
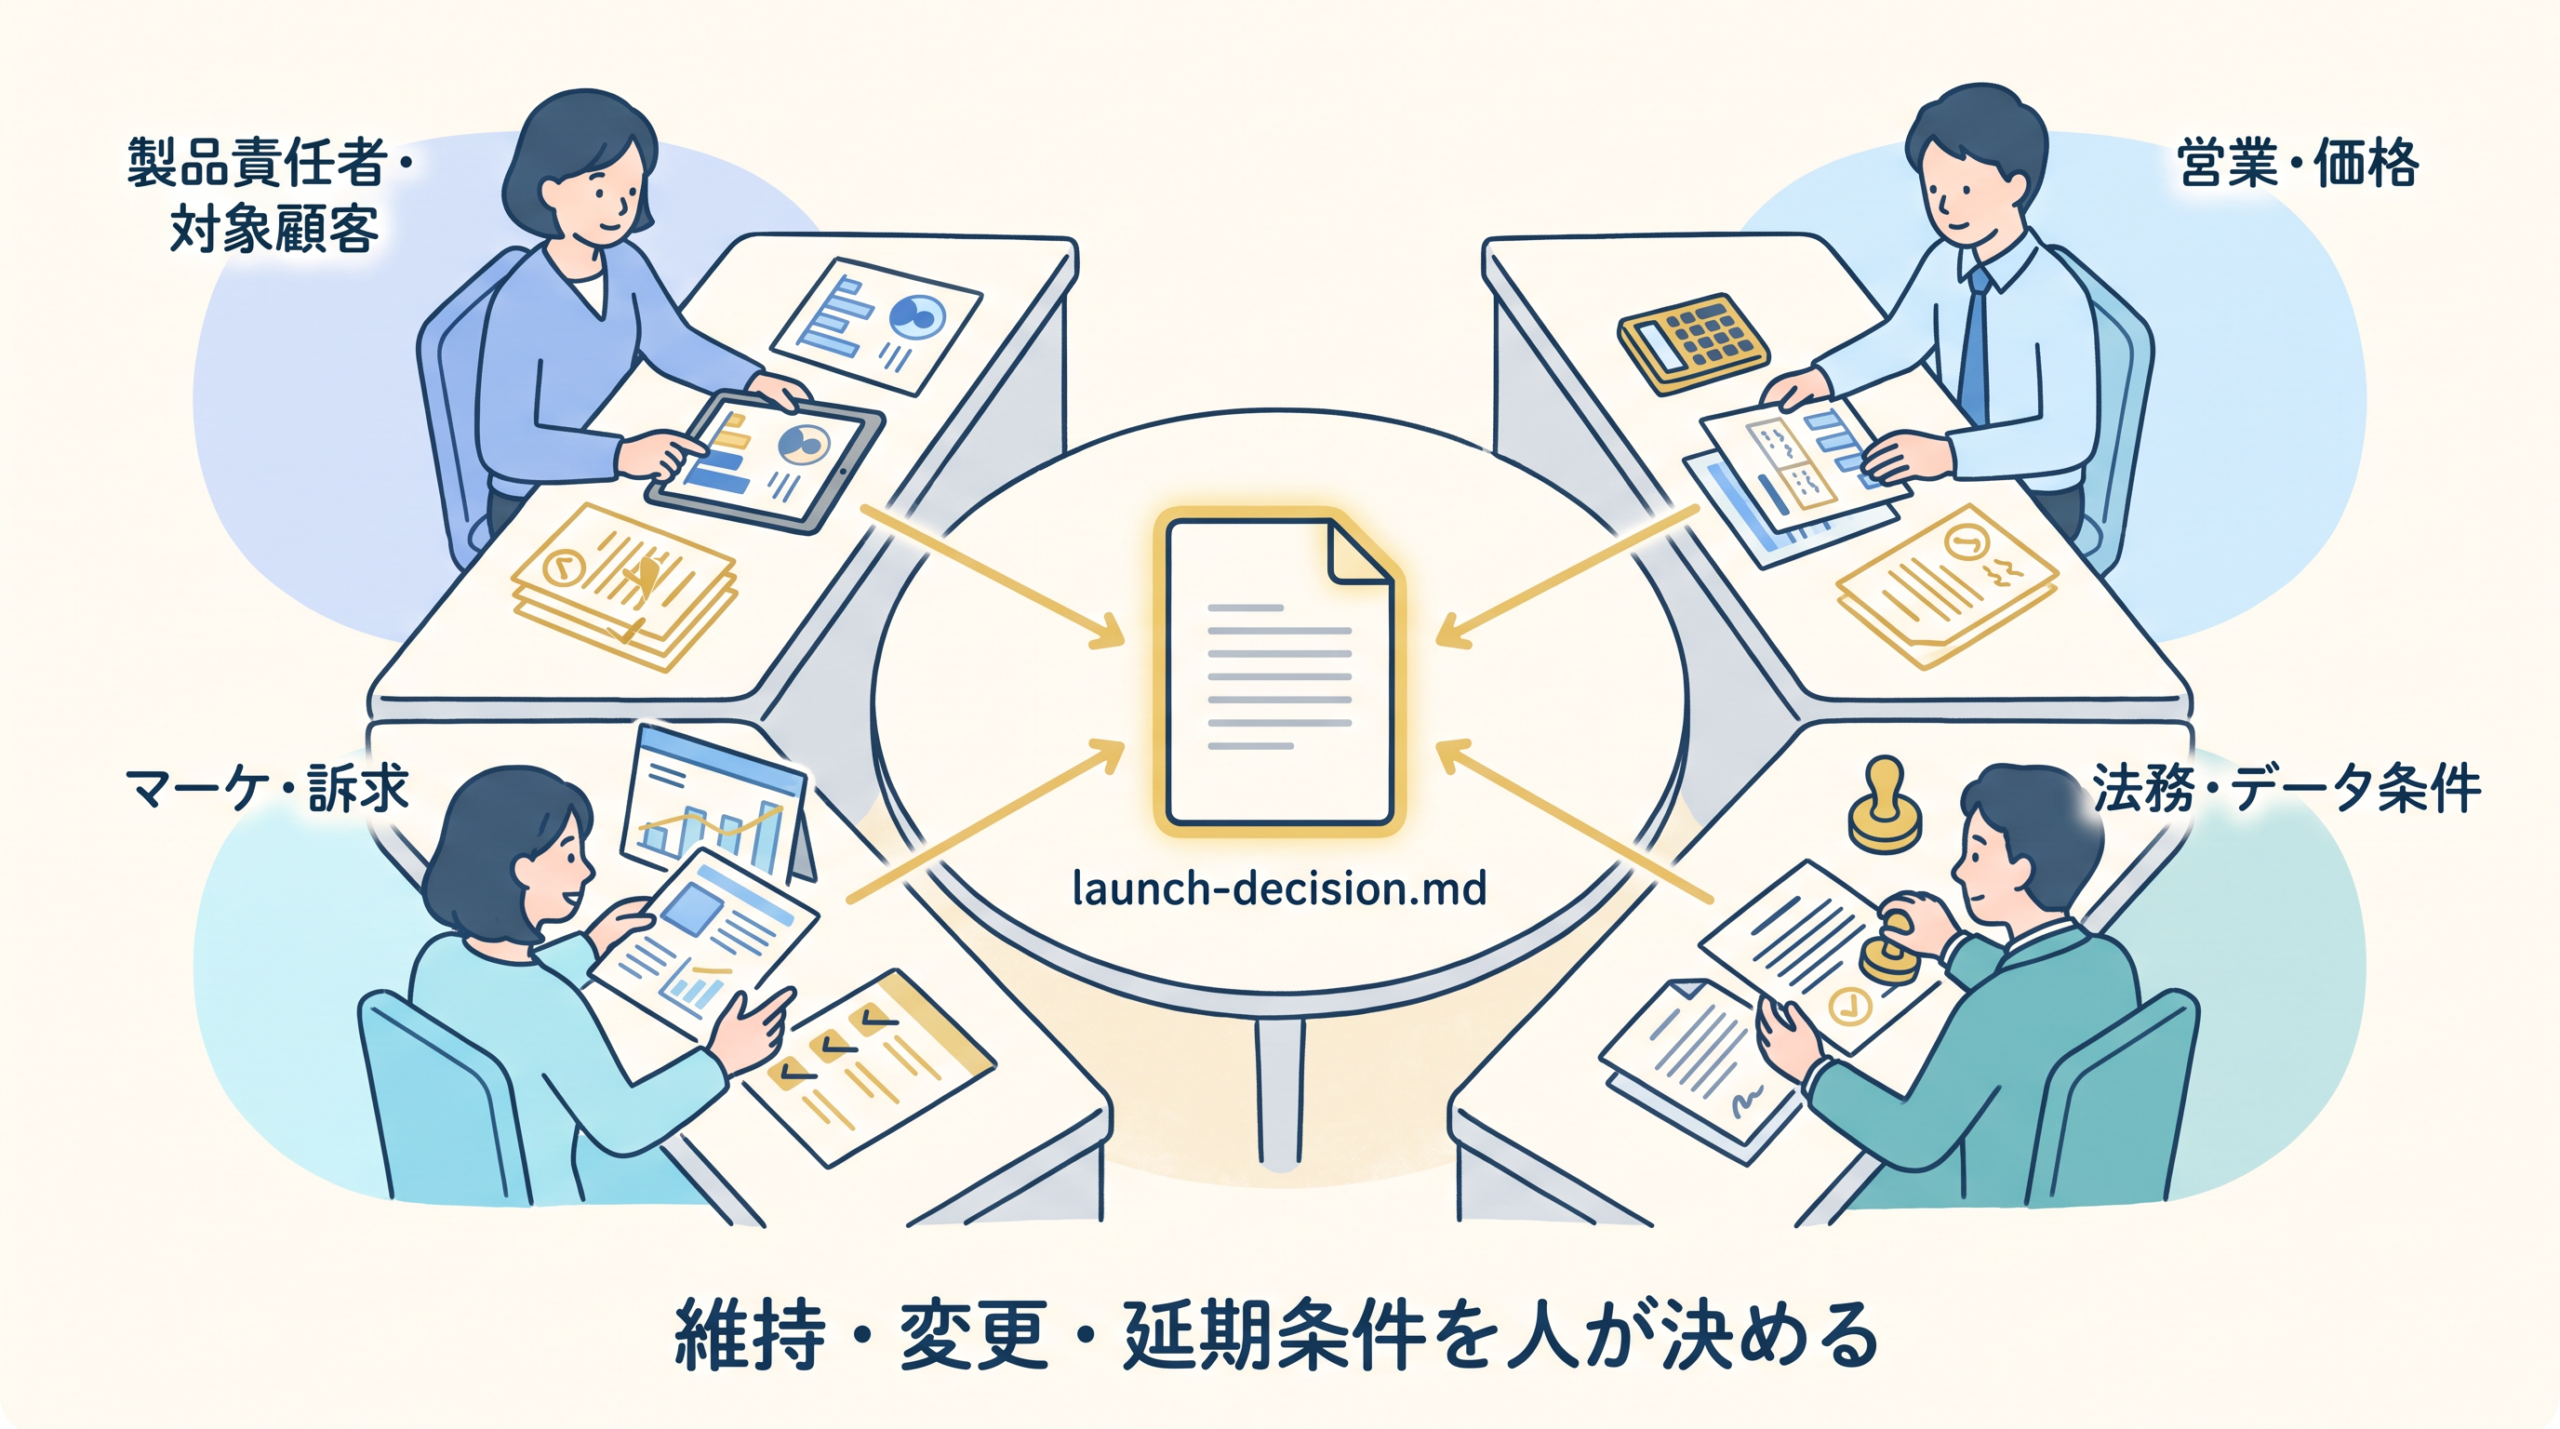
前工程で作成した競合事実カードの検証済み事実を、実際の会議で使える判断材料へと変えていきます。市場調査と競合分析は顧客発見と競争優位の判断を支えるが、事業判断そのものではないため、収集した事実、それに対する解釈、そして最終的な人の決定を明確に分離して扱います。
ここで前提となるのは、AIによる発売可否の自動決定を行わないことや、未確認の価格換算をそのまま判断に用いないこと、そして出典のない時間短縮率などを意思決定の根拠にしないことです。AIの役割は比較下書きと未確認事項の作成に留め、最終的なローンチ判断は人が行います。
実際の判断においては、ローンチは製品、マーケティング、営業などの横断調整を必要とするため、各担当者がそれぞれの専門領域の原典を確認します。具体的には、製品責任者が対象顧客を、マーケティング責任者が訴求内容を、営業責任者が価格を、法務および情報セキュリティ担当者がデータ条件をそれぞれ確認します。
人はAIが洗い出した情報をもとに公式ページへアクセスし、正確な契約条件や価格、データ条件を直接確かめます。
これらの確認を終えた後、合意した決定事項をlaunch-decision.mdというファイルへ記録します。このファイルには、調査結果を受けて当初の計画を維持する部分、変更が必要な部分、そしてどのような状況になればローンチを延期するかという条件を書きます。このようにして、AIの出力を人が確認し、最終的な意思決定へと接続する境界を維持します。
認証・データ送信・書き込み権限と停止条件を決める
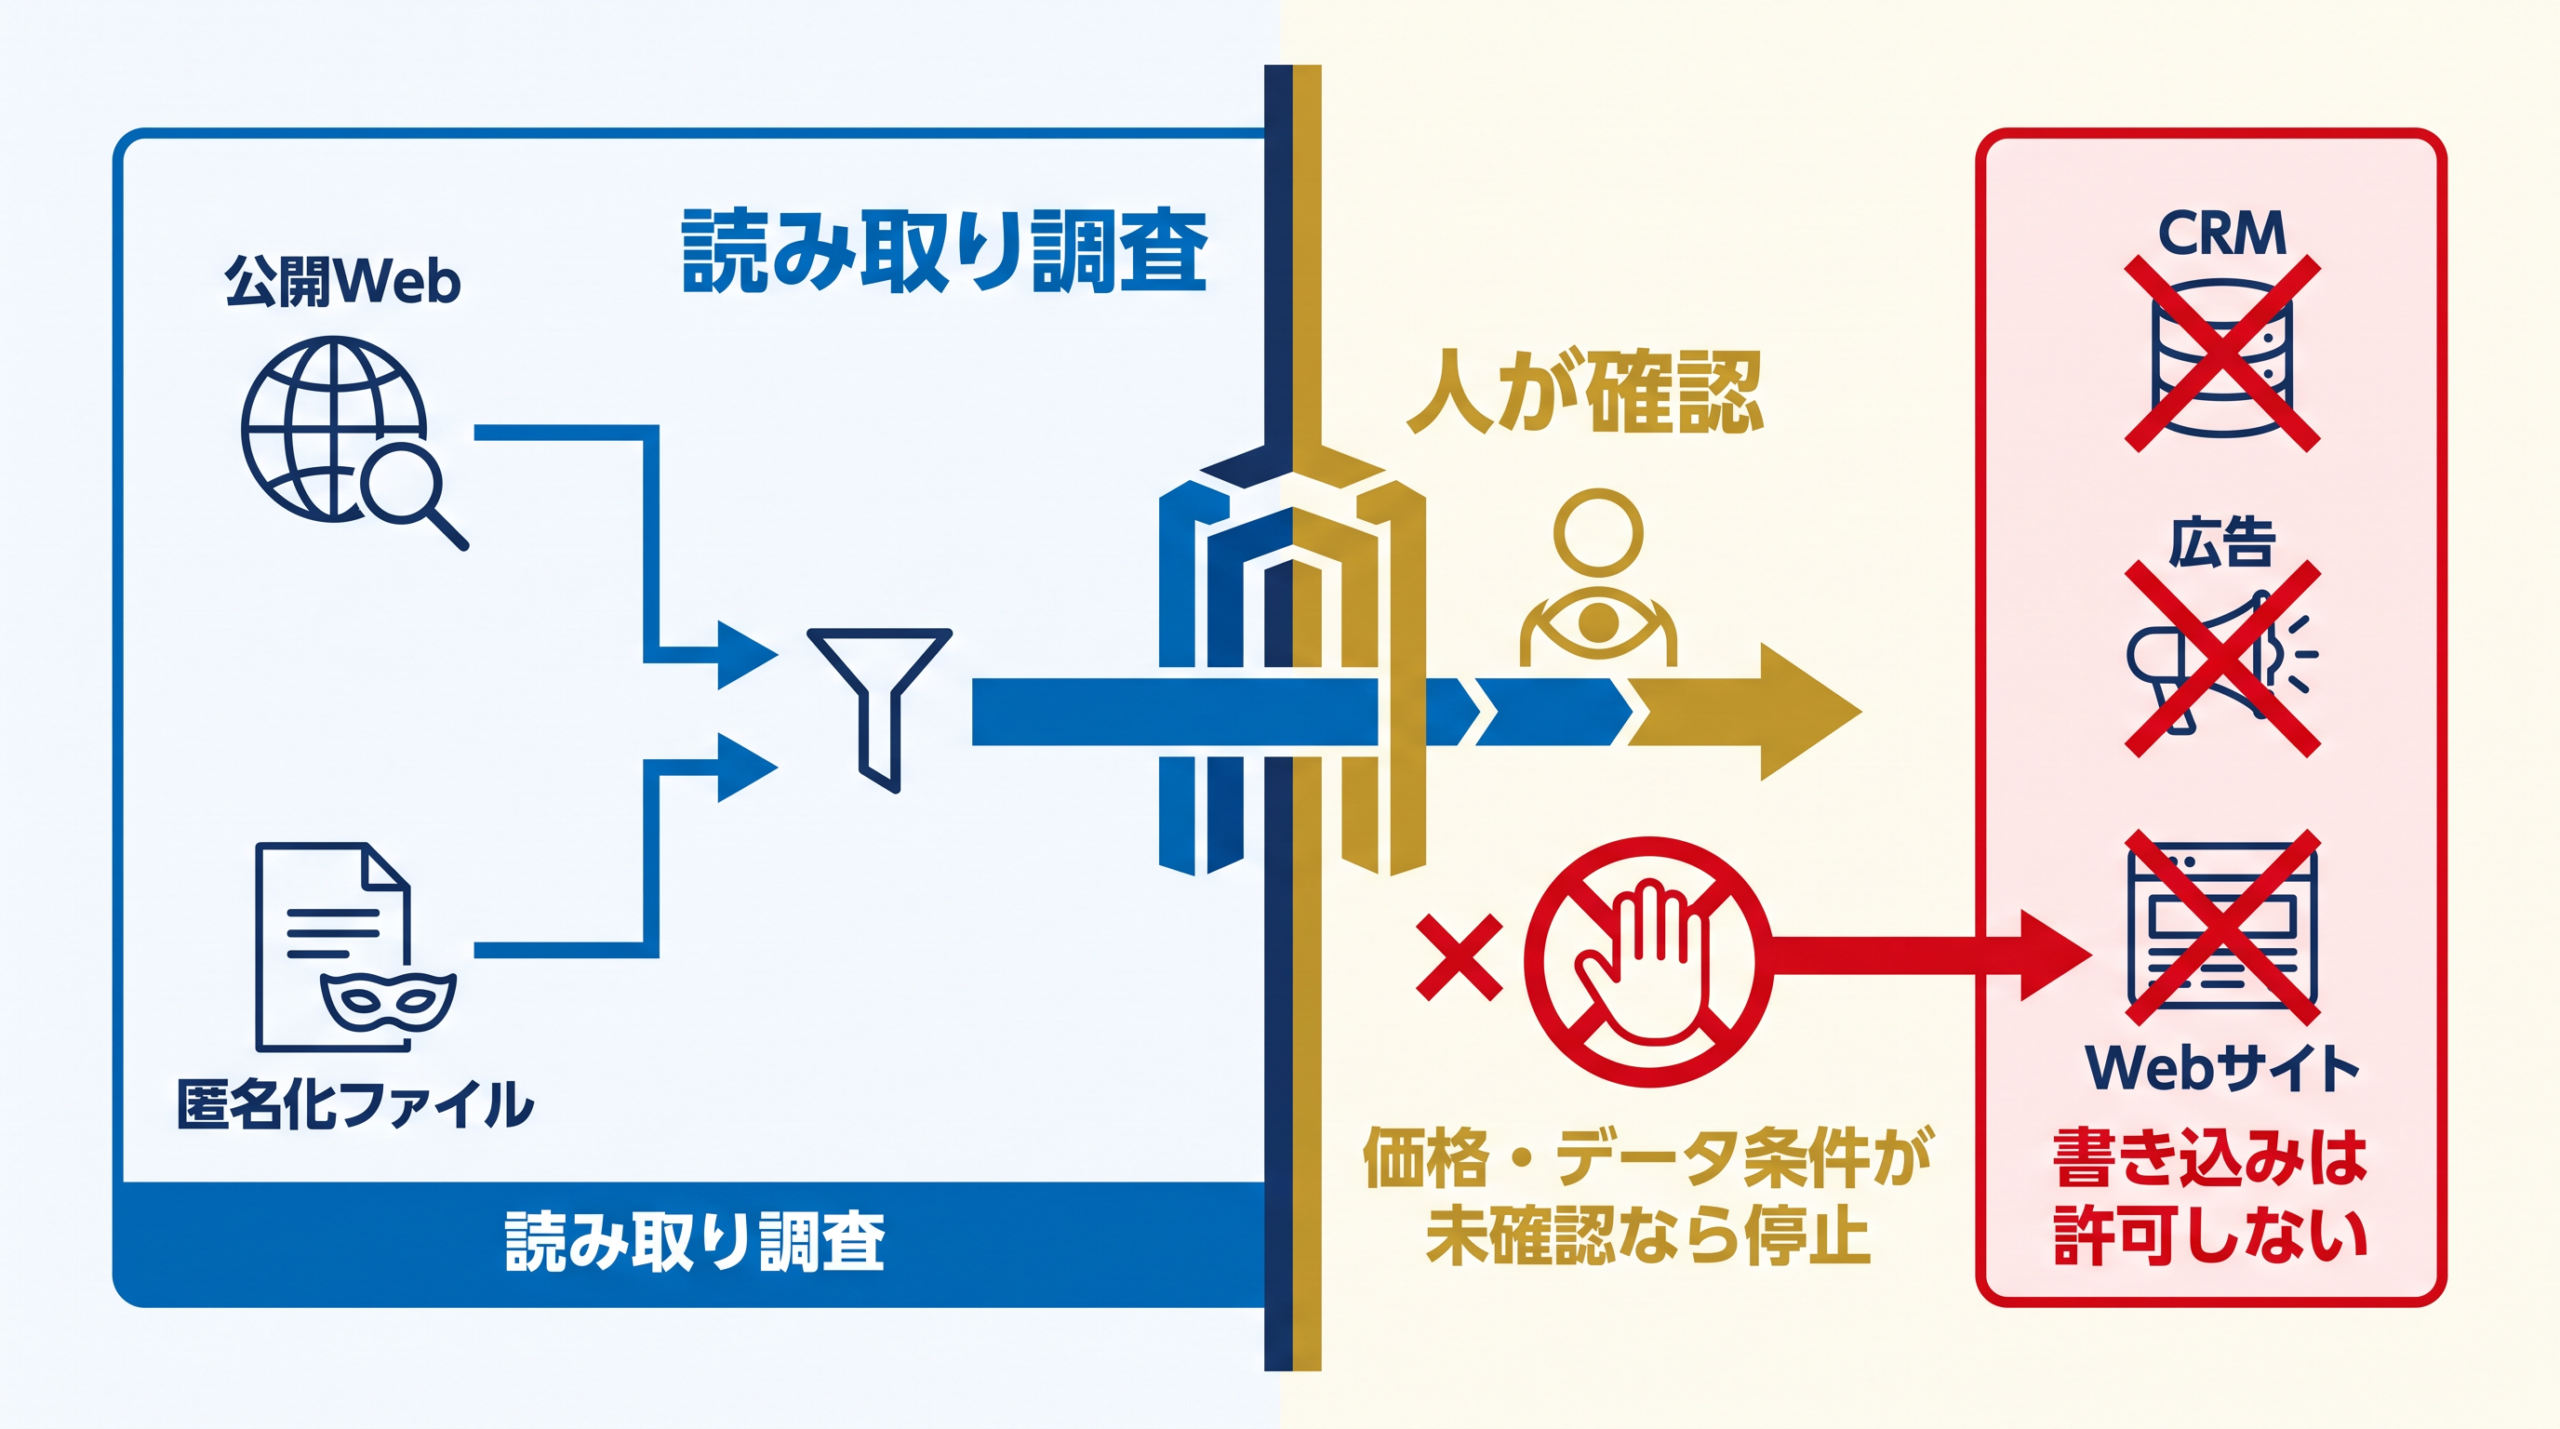
AIによるローンチ前調査を反復可能な手順として定着させる際、未公開情報や誤った事実が外部へのシステム更新へ流れてしまうことを防ぐ必要があります。そのため、どこまでAIに対してシステム操作を許可し、どのような時に調査に基づく進行を止めるかをあらかじめ決めておきます。
データ送信の観点では、ChatGPTのBusiness、Enterprise、Edu、APIの業務データは既定でモデル学習に使われませんが、自社の入力許可判断は別に必要です。そのため、調査の入力には公開Webから得られる情報と、自社の情報を匿名化したlaunch-brief.mdだけを使うといった運用基準を定めます。
また、アプリで利用できるデータと操作は接続時の許可、アプリ、ワークスペース制御で決まる仕組みとなっています。このアプリ権限は接続、提供元権限、ワークスペース設定、操作許可を上書きしないため、利用者は実際に許可される範囲を接続前に確認する必要があります。
Deep Researchによる研究中は読み取り操作のみを使う仕様ですが、自社のCRM、広告配信システム、Webサイトへの書き込みは一切許可しないという業務の境界を設けておきます。なお、Deep Researchの利用回数はプランで異なるほか、接続アプリはプラン、地域、ワークスペース、役割、接続先権限に従って機能します。
システムに対する権限の制限に加えて、調査結果を扱う上での停止条件も設定します。たとえば、競合製品の公式価格やデータ処理条件が未確認のままであれば、そこでローンチに向けた公開判断を止めるといったルールです。情報が不足しているからといって、未確認の価格換算を行ったり、出典のない時間短縮率を当てはめたり、AIによる発売可否の自動決定を行ってはいけません。
AIはあくまで比較のための下書き作成と未確認事項の洗い出しまでを担います。最終的には人が提示された公式ページを一つひとつ確認し、契約条件、価格、データ条件といった事実を自身の目で検証してからローンチ判断を行うという境界を維持します。
よくある質問
Q1. Deep Researchの利用回数に上限はありますか。
はい、Deep Researchの利用回数はプランで異なります。上限があるため、まずはAIに作成させたい比較下書きの対象や比較軸を入力ファイルとして明確にしておくことが重要です。一度の実行で過不足なく情報が集まるよう、事前の準備を整えてから実行します。
Q2. 新製品の仕様などの機密情報を入力しても学習に使われませんか。
ChatGPTのBusiness、Enterprise、Edu、APIの業務データは既定でモデル学習に使われないが、自社の入力許可判断は別に必要となります。そのため、新製品の未公開情報をそのまま入力するのではなく、公開Webから得られる情報や匿名化した条件を入力ファイルへ記載するなどの社内基準を設けた上で、比較下書きの作成を行うことをお勧めします。
Q3. AIが重要な競合を見落とす競合漏れを防ぐにはどうすればよいですか。
調査を実行する前に、開始前の調査計画を利用者が確認・編集できる機能を使い、既知の競合と調査範囲を確認します。AIが提示する計画画面で、指定した競合や公式ドメインが網羅されているかを人が目視で確認し、不足があれば計画を編集して追加します。ただし、未知の競合や検索で見つからない情報は残りうるため、既知の競合一覧や業界団体の名簿とも照合します。
Q4. 出力されたレポートの引用確認はどのように進めるべきですか。
NISTは生成AIが誤った内容を自信ありげに提示するconfabulationを挙げ、重大な意思決定で監視すべきとしているため、AIが作成した比較下書きや未確認事項のリストをそのまま事実として扱ってはいけません。
レポートに記載された引用URLから人が直接公式ページへアクセスし、実際の契約条件、データ条件、価格の原典を確認した上で、最終的なローンチ判断へつなげます。
Q5. 外部アプリを接続して調査する場合、誤ってシステムへ書き込まれるリスクはありませんか。
Deep Researchの調査工程は接続アプリの書き込み操作を使いませんが、接続範囲と許可内容は事前に確認してください。接続アプリは研究で読み取り操作を使い、書き込み操作を使わない仕様です。
また、アプリで利用できるデータと操作は接続時の許可、アプリ、ワークスペース制御で決まるほか、アプリ権限は接続、提供元権限、ワークスペース設定、操作許可を上書きしないため、実際に許可された読み取り範囲を確認して利用します。
Q6. 競合の価格改定などに合わせて調査更新を行うにはどうすればよいですか。
調査を更新する際は、過去に実行して保存しておいた調査用の入力ファイルを再度読み込ませることで、同じ比較軸での下書き作成を再実行します。実行後は引用付きレポートをMarkdown、Word、PDFで保存できるため、新旧のレポートを比較して未確認事項や変更点を洗い出します。
更新された内容についても、人が公式ページへアクセスして価格などの原典を一つひとつ確認し、製品投入前に需要、競争上の位置、価格期待を確認し、価格や訴求の調整へつなげるという最終的なローンチ判断の手順を繰り返します。
AIを組み込む仕事の流れづくりをご支援します
Deskrexでは、AIを使って調査・制作・分析などの仕事を進めるために、工程と役割分担を設計し、実装する支援を行っています。AIに渡す資料や指示、使えるツール、人が確認する箇所を整理し、一連の仕事として動く仕組みをつくります。
まず、届けたい成果物と現在の作業手順を確認し、実際の仕事をAIで試します。品質、処理量、時間、費用を見ながら、今すぐ任せられる作業と、追加の設計や開発が必要な作業を確かめます。
その結果をもとに、工程の統合や並列化、ツール連携、結果の検証と修正の手順を組み込みます。実行回数や費用の上限、人の判断を待つ条件、途中の状態を保存して再開する方法も含めて設計し、実務で動作を確かめます。
業務へのAI導入やワークフロー作成のご相談は、AIワークフロー作成支援のご案内からお問い合わせください。任せたい仕事と、現在使っているツールを伺い、取り組む範囲を一緒に整理します。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
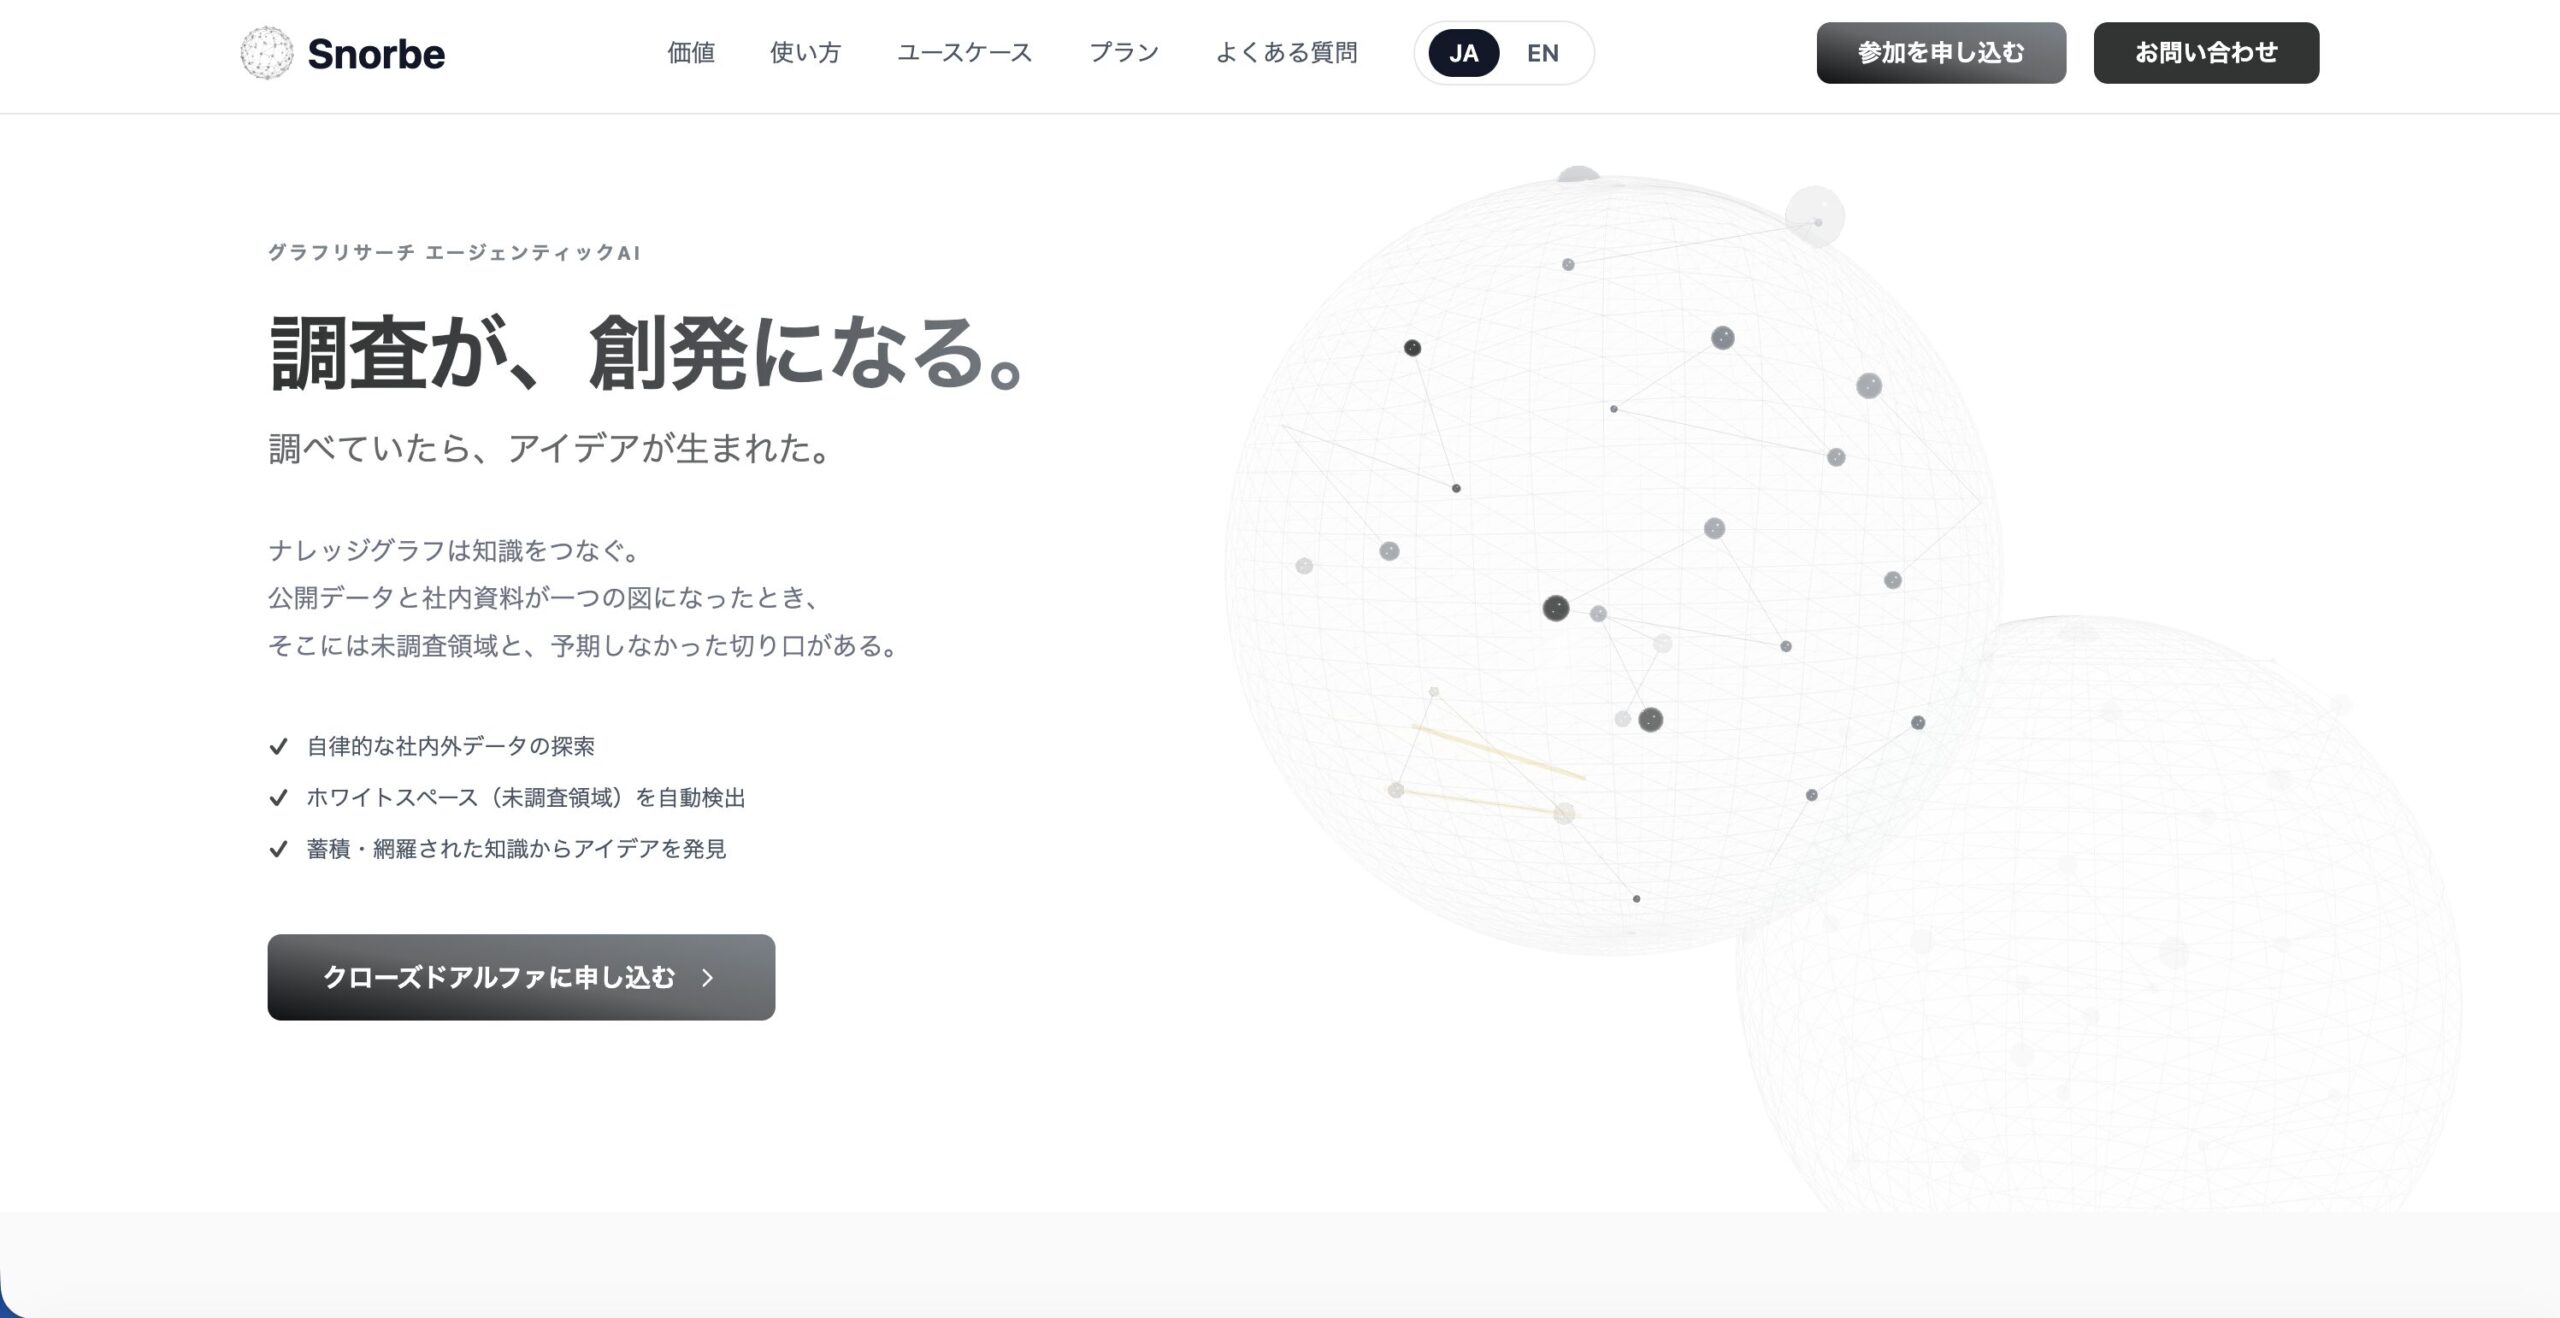
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント