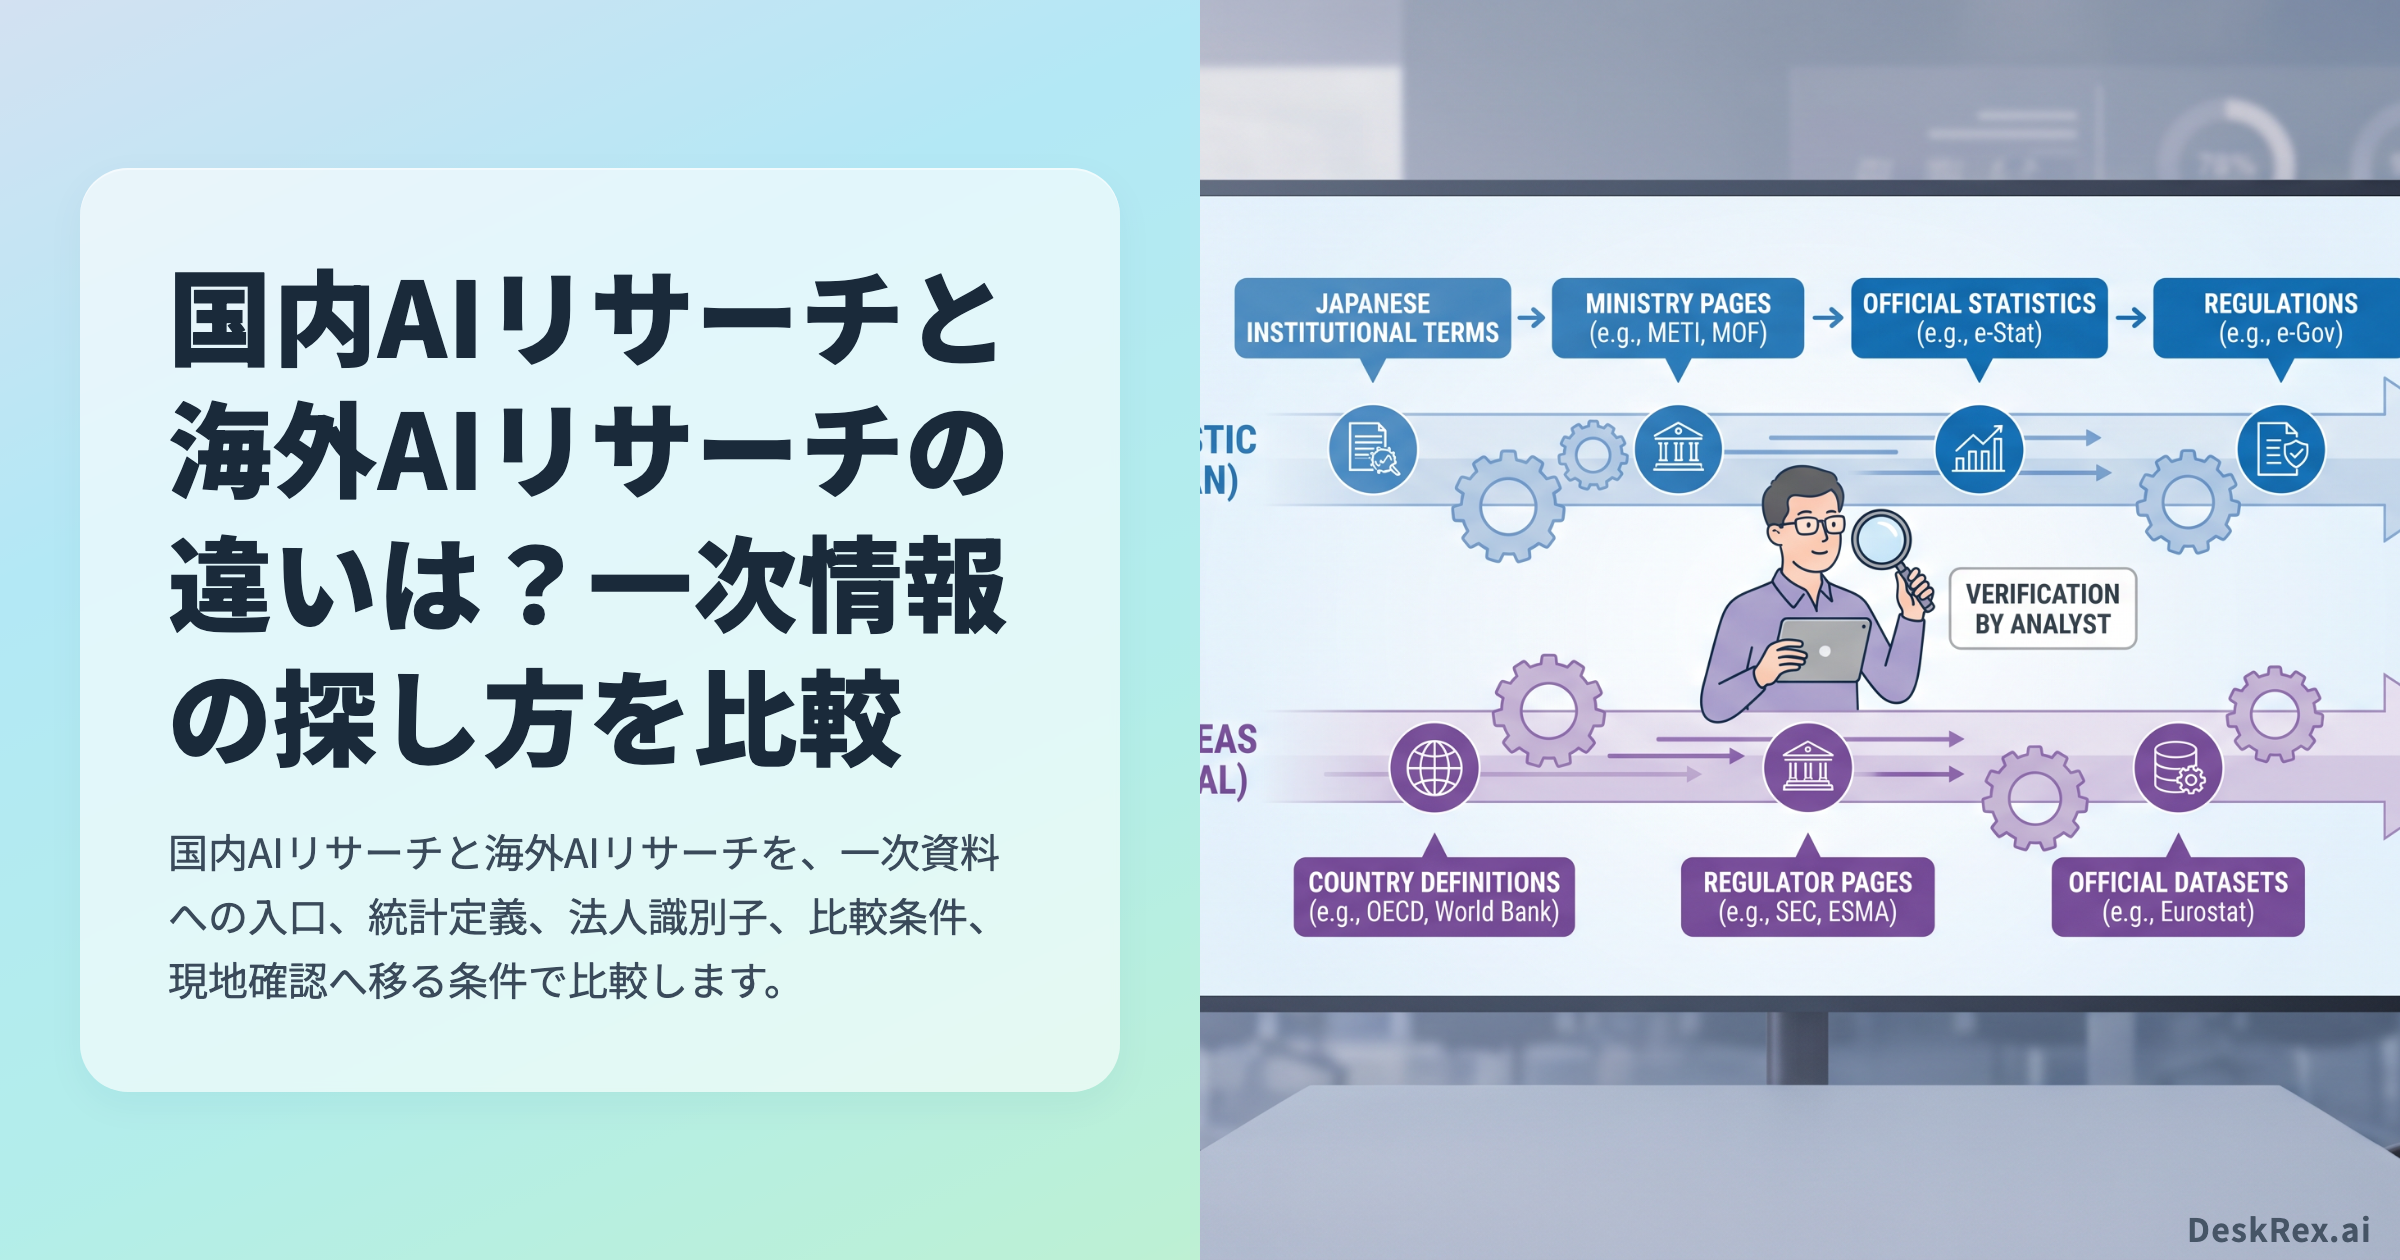
国内で伸びている製品への需要を、海外でも期待できるでしょうか。需要を比べる手掛かりには、政府統計の市場規模や利用者数、企業が開示する地域別・用途別の売上があります。AIへ表の整理を任せても、調査する国が変われば、資料の探し方と数字の定義を確認し直します。
国内外の数字を比べる前に、同じ企業と同じ指標を指しているかを確かめます。国内企業は日本語の正式社名から政府統計や開示資料へ進みます。
海外企業は対象国の法人識別子を確認し、その国の開示制度から対象期間と指標の定義を調べます。英語レポートの翻訳だけでは、比較条件を確認したことにはなりません。
この記事では、国内調査と海外調査で、一次資料へ進む経路と比較条件をどう変えるかという手順を比べます。資料を発行した組織の国や、資料に使われた言語では分けません。また、AIツールの開発国や日本語性能の順位、有料データベースの価格、現地インタビューの方法なども対象外です。まずは、なぜ使うAIではなく調査の対象国で分けて考えるのかを整理します。
国内AIリサーチと海外AIリサーチは調査対象で分ける
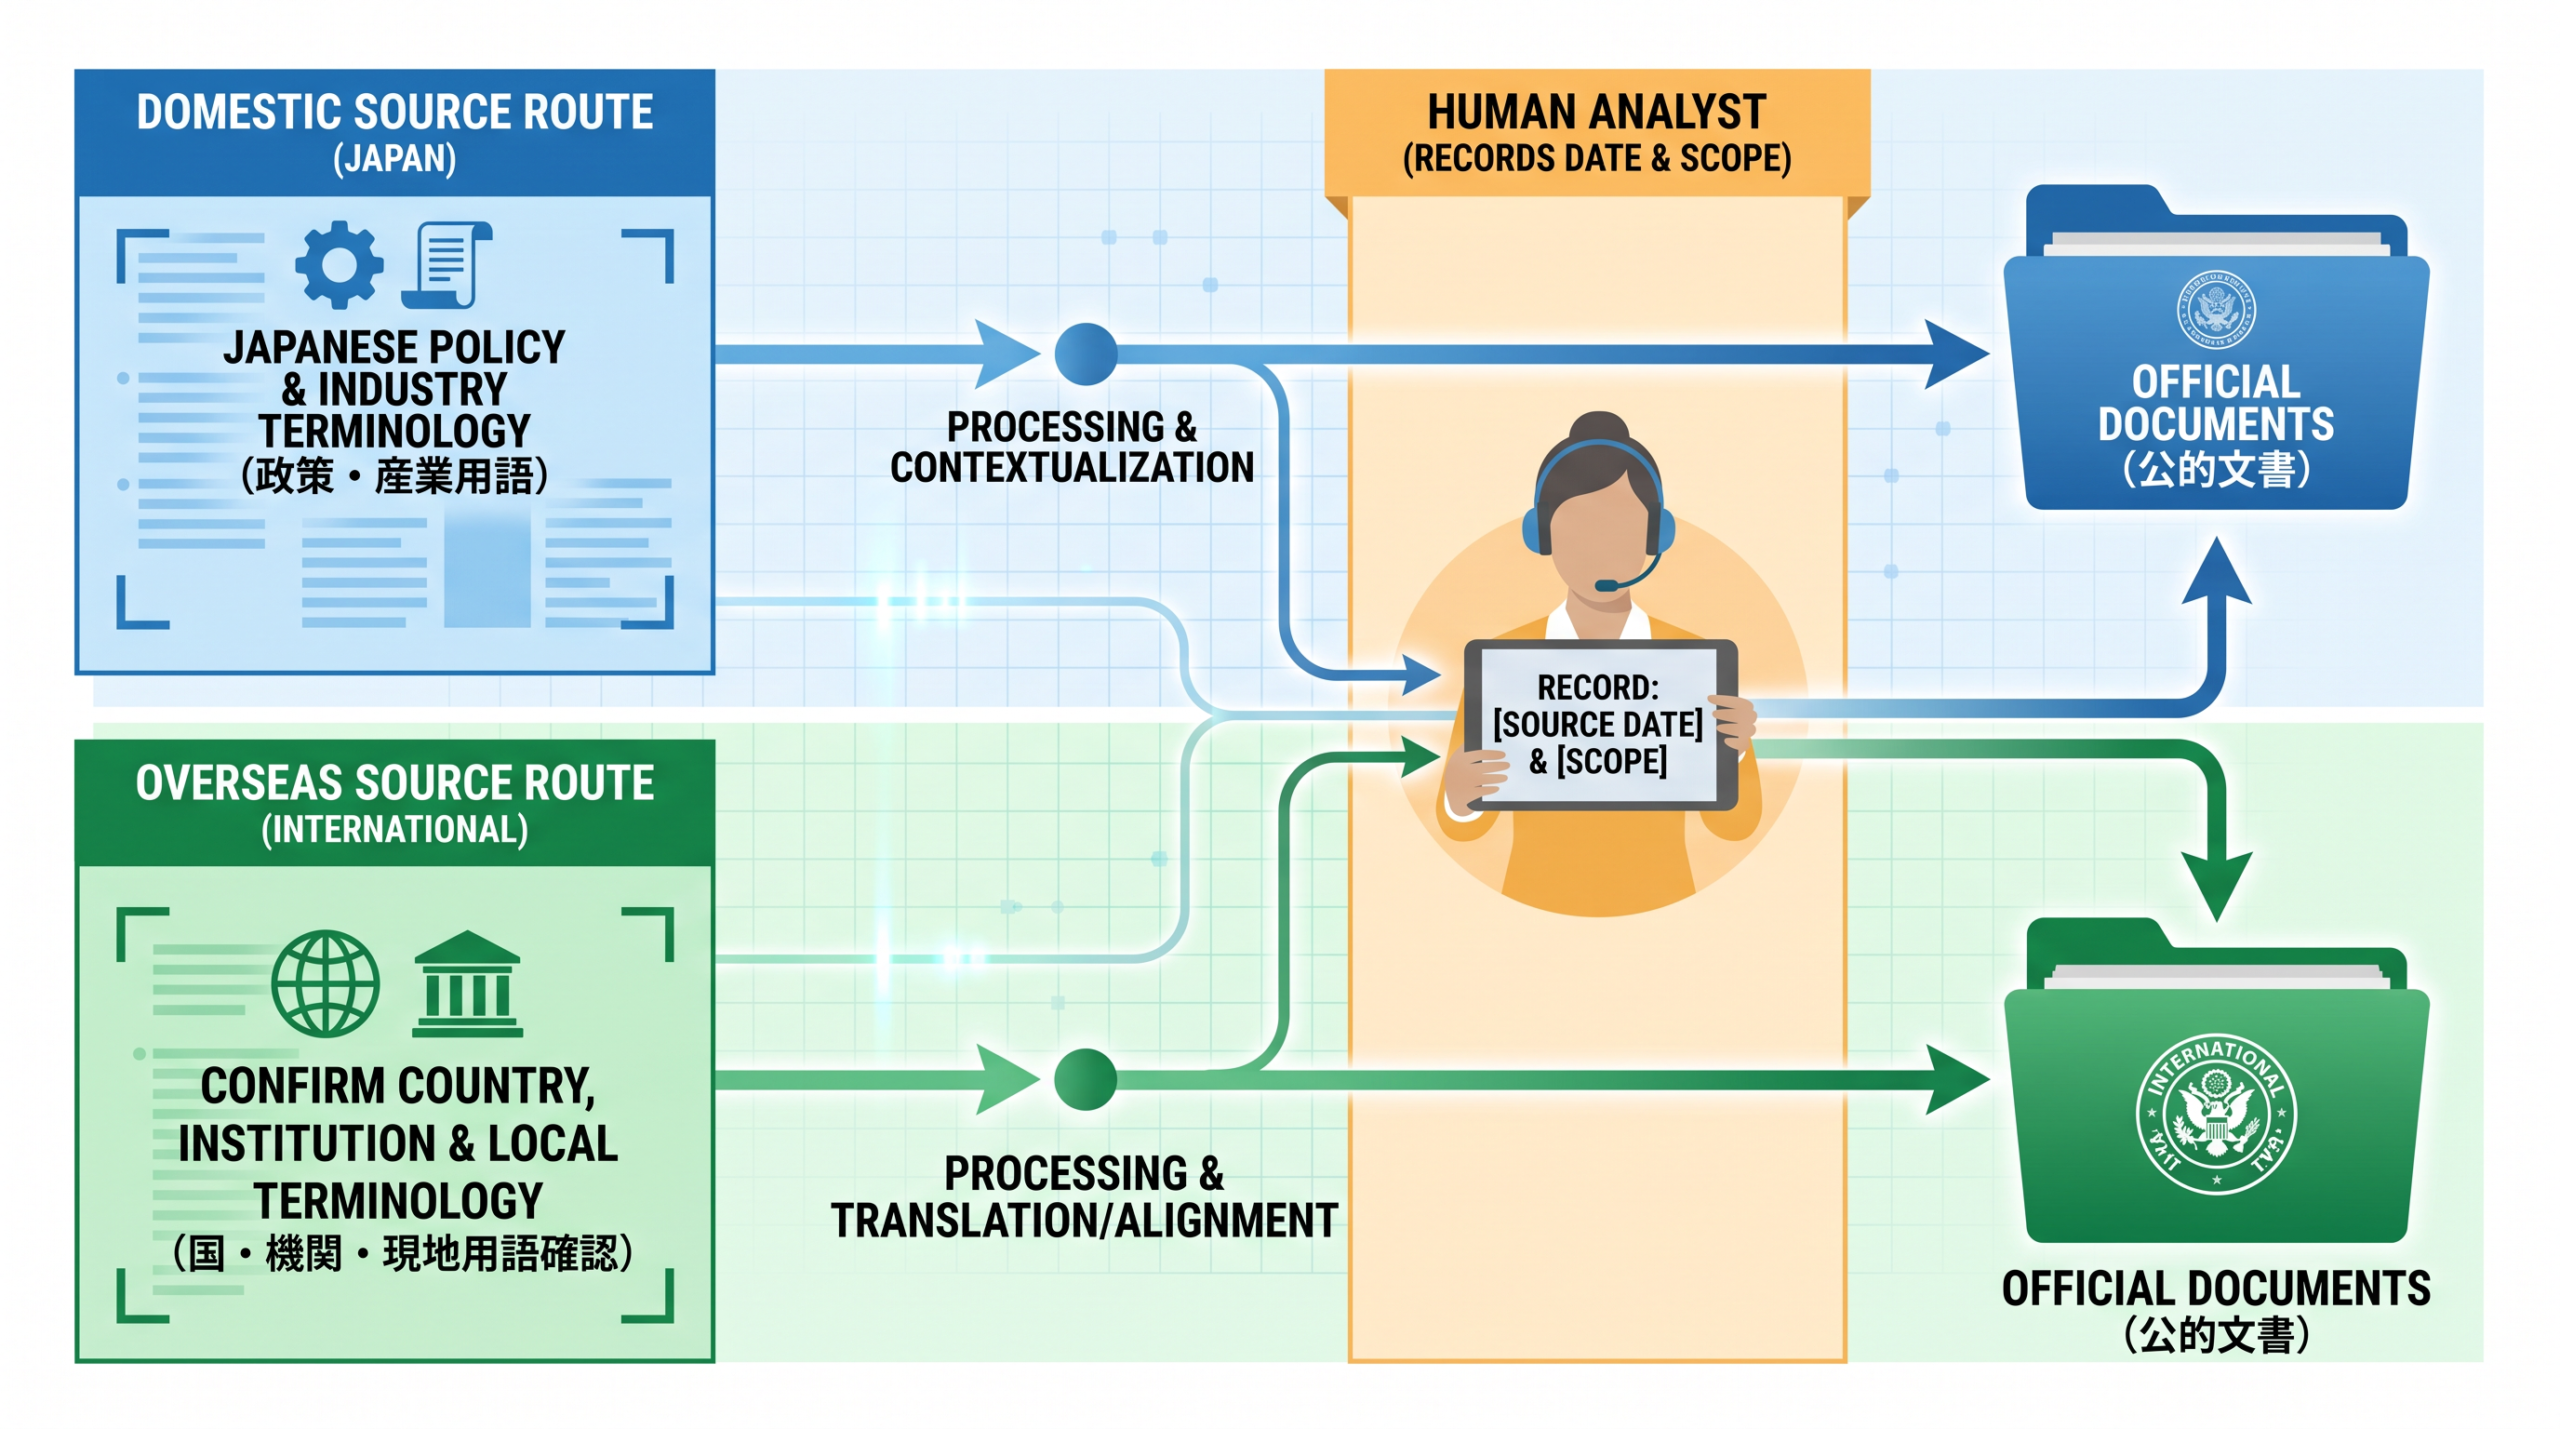
調査対象が日本国内なら「国内AIリサーチ」、国外なら「海外AIリサーチ」と区別します。これはAIを開発した国による分類ではありません。海外のAIを使って日本の政府統計を調べることも、日本のサービスから米国企業の公開資料を探すこともできるからです。調べる国が変わると確かな資料へたどる手順も変わるため、使うAIではなく調査の対象国で分けて考えます。
今回確認したChatGPTとGeminiでは、調査に使う情報源を選べます。ChatGPTのDeep Research公式ヘルプは、公開Web、特定サイト、アップロードファイルを情報源にする流れを説明しています。調査計画の確認と引用付きレポートも案内しています。
GeminiのDeep Research公式ヘルプは、通常の検索に加え、ファイルや接続済みサービスを情報源として選ぶ手順を示しています。
同じAIサービスでも、必要言語と情報源指定の条件を両地域で満たすなら候補になります。ファイル添付、引用追跡、契約・組織規程も両地域で確認します。検索語、公式ドメイン、法人識別子、統計分類は対象国に合わせて変えます。異なる条件の数値を並べる前に、人が定義を照合します。
それでは、日本の市場や企業を対象とする場合、どこから情報を探し始めればよいのでしょうか。まずは、私たちが普段使っている日本語の制度名や公式な法人名を入口にして、国内の一次資料へ進んでいきます。
国内調査は日本語の制度名から一次資料へ進む
国内市場の規模や人口動態を調べる場合、まずは政府統計の総合窓口が起点になります。e-Stat APIの機能概要には、統計の表や数値データに加えて、データの背景となるメタ情報も取得できると書かれています。
取得した数値をAIへ渡す際は、表の数字だけを切り取ってはいけません。どの統計表から取ったかを示すIDや、調査の時期、分類事項などの情報も一緒に残しておくことが重要です。
上場企業の公開情報を調べる場合は、金融庁のEDINETについての案内から、開示の制度や実際の閲覧先を確認できます。
AIが挙げた企業名をそのまま検索語にするのは避けます。社名には略称や表記の揺れがあるため、正式な提出者名や書類の種類を実際の画面で一つひとつ照合する必要があります。
ここで扱うe-StatとEDINETの日本語資料では、翻訳を挟まず原文を確認できます。ただし、「市場規模」が生産額を指す資料もあれば、販売額や出荷額を指す資料もあります。利用者の支出額を使う場合もあるため、指標の定義を確認します。
日本語で読める資料であっても、そのまま比較できる数値かどうかは個別に確かめなければなりません。国内の資料でこの前提を押さえたら、次は調査の対象を海外へ広げていきます。
海外調査は国ごとの制度と統計定義を先に確かめる
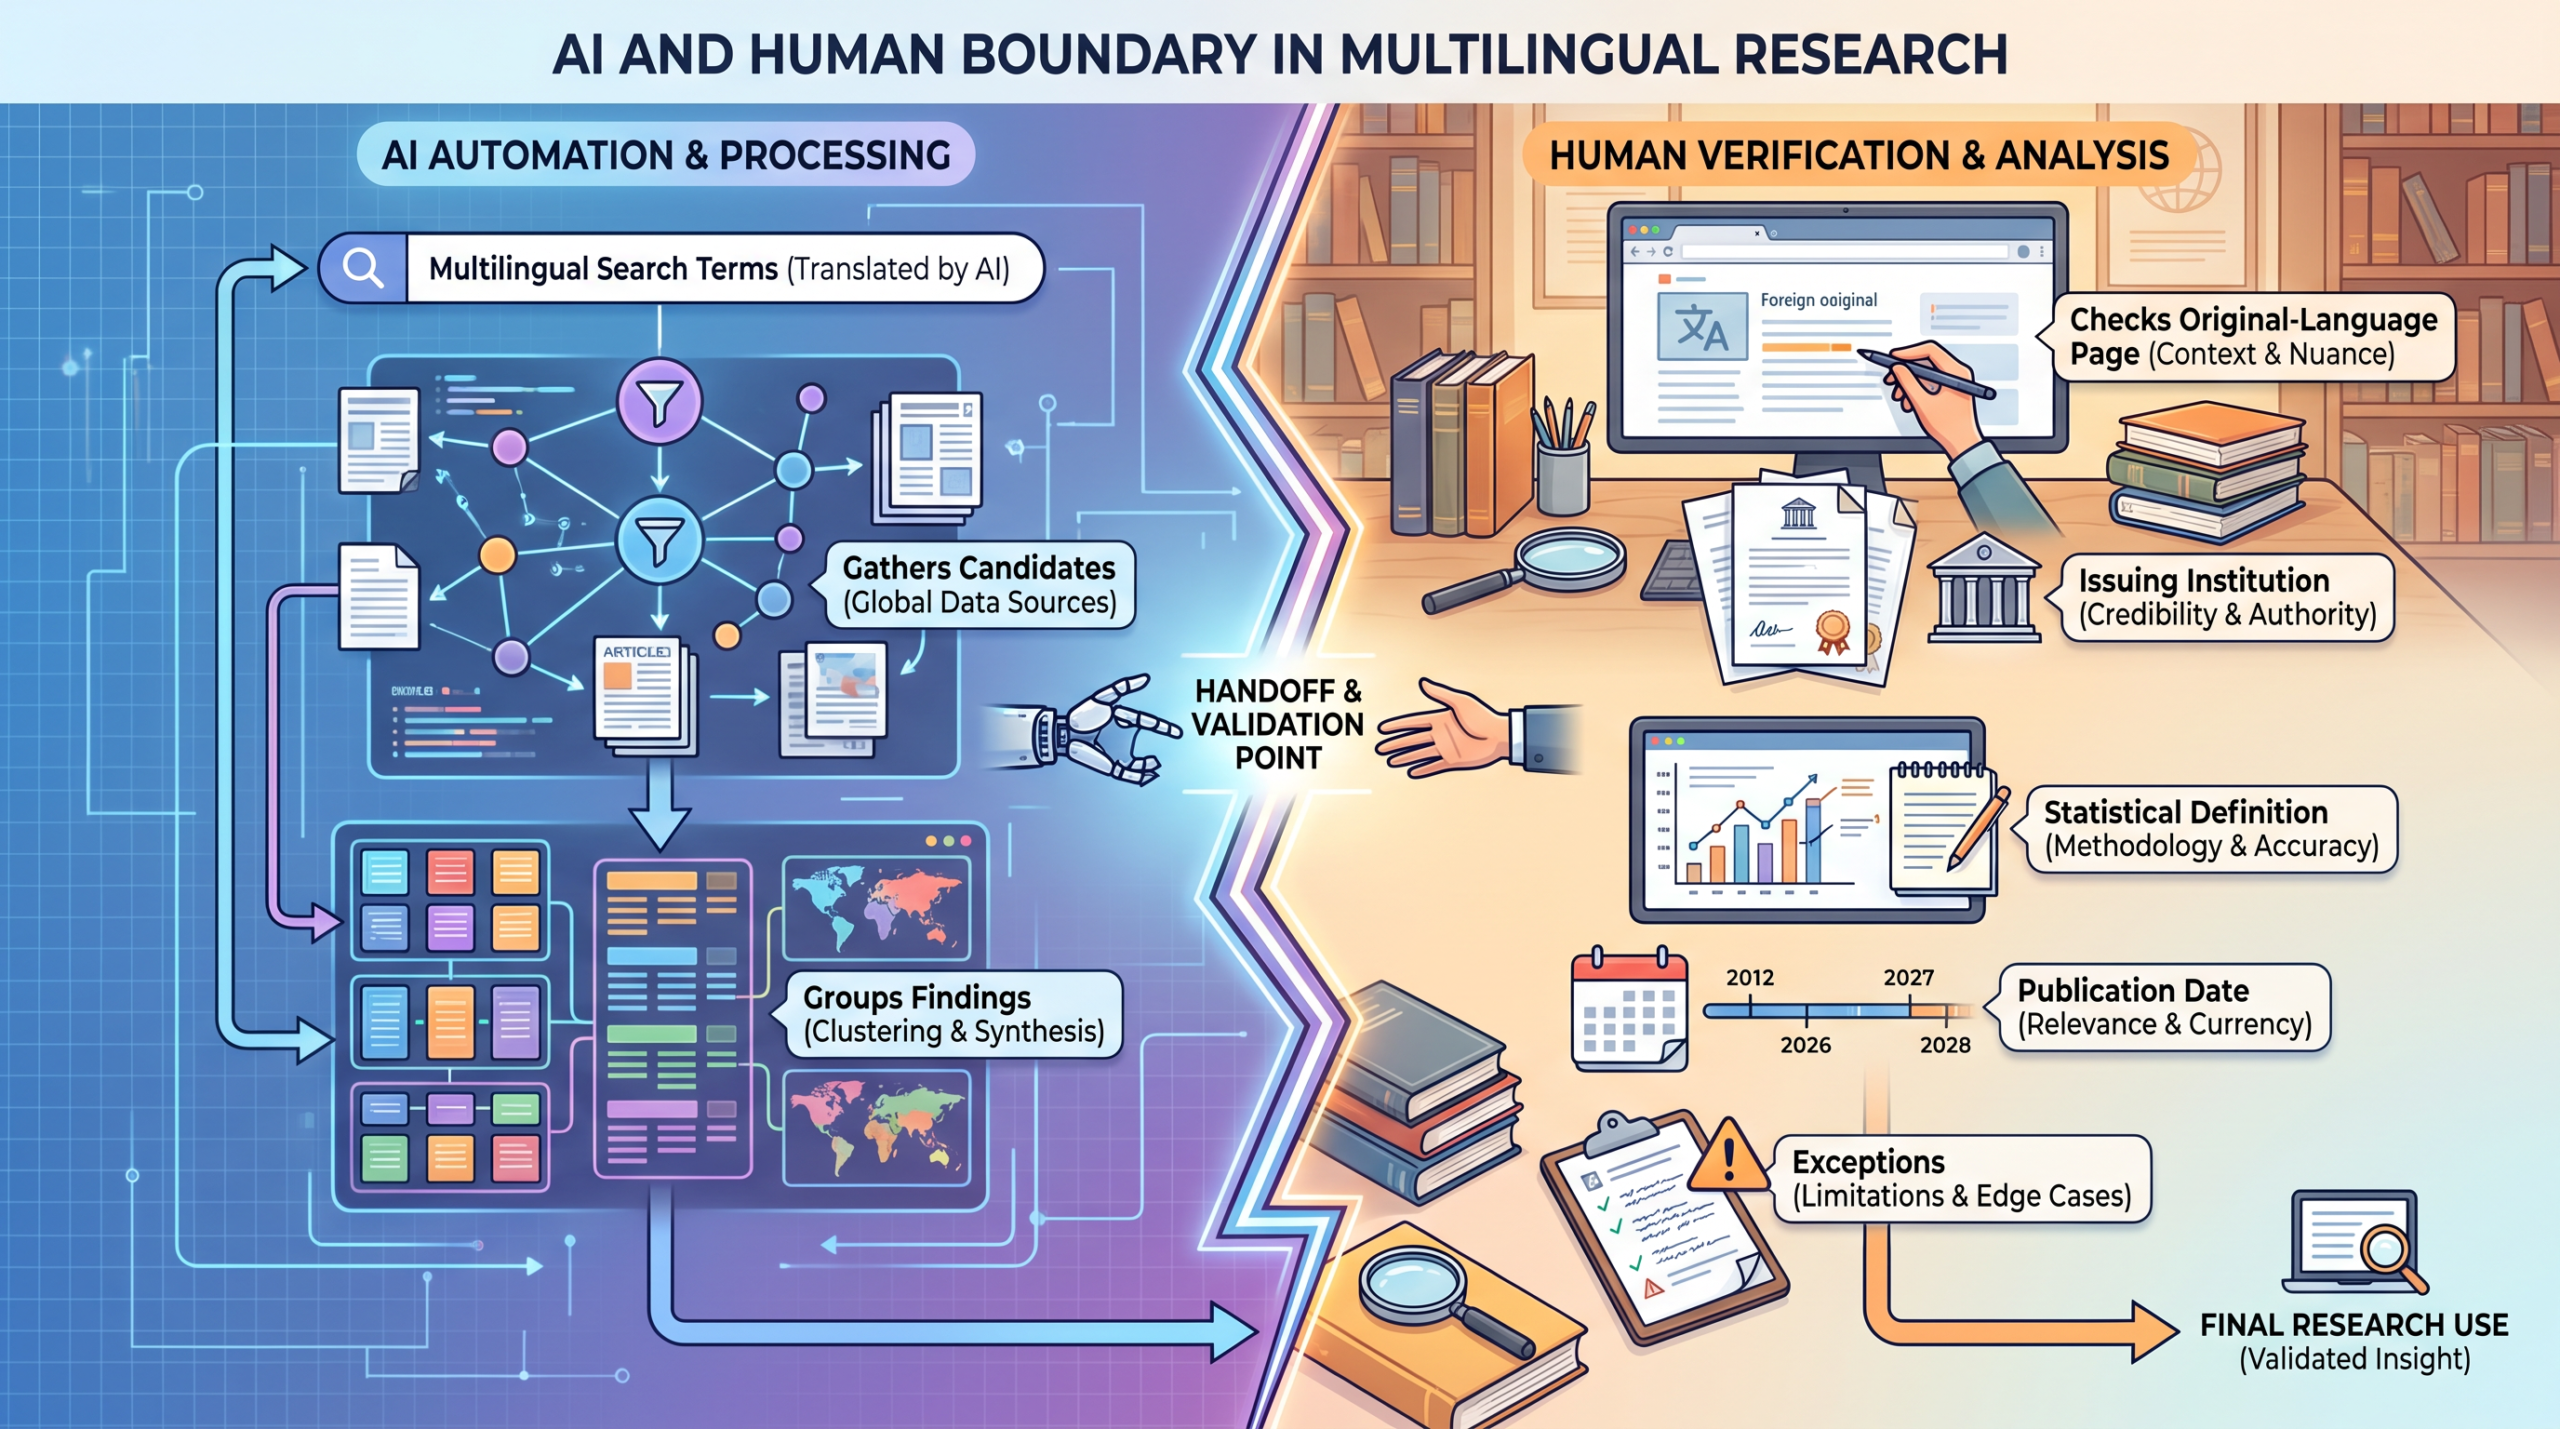
国内調査の基本を踏まえ、海外調査でも同じ役割を持つ開示制度や統計の仕組みを国ごとに探します。国によって情報を公開する場所や、データをまとめる基準が異なるからです。
たとえば米国の上場企業を調べる場合、証券取引委員会(SEC)が運営するEDGARが一次資料になります。EDGAR APIの公式説明では、企業の提出履歴やXBRLデータをJSONで取得でき、認証キーは要求されないと説明されています。また、EDGARデータへのアクセス案内からは、提出書類と各種インデックスの取得経路も確認できます。
海外企業を調べるときは、利用できる公式識別子を記録します。米国のSEC提出書類ではCIKを使い、証券コードと正式社名も併記します。親会社と子会社を分け、AI要約の各行を対応する開示資料へ結び付けます。
一方、EU市場の統計を探す場合は、Eurostatのデータベースから国ごとのデータを見つけられます。ここで重要なのは、表を見つけてすぐに数字だけを抜き出さないことです。
数値を比較する前に、まずはデータの背景を説明するページを確かめます。企業動態統計のメタデータのような説明を読み、対象となる企業、基準年、地理的な範囲、データの改定方針を確認します。項目の名前が似ていても対象の定義が違う場合、数値の差をそのまま市場の違いとは判断できません。
公開資料だけでは現地の販路や商習慣を確認できない場合があります。ジェトロの海外ミニ調査サービスは、現地の統計、店舗、企業情報などを調べるサービスです。公開資料で未確認項目を整理し、その項目が候補国の優先順位を変える場合に現地確認へ渡します。
それぞれの国で一次資料を集めたら、次はその数値を一つの表で比較するための準備に移ります。
同じ表へ並べる前に比較条件をそろえる
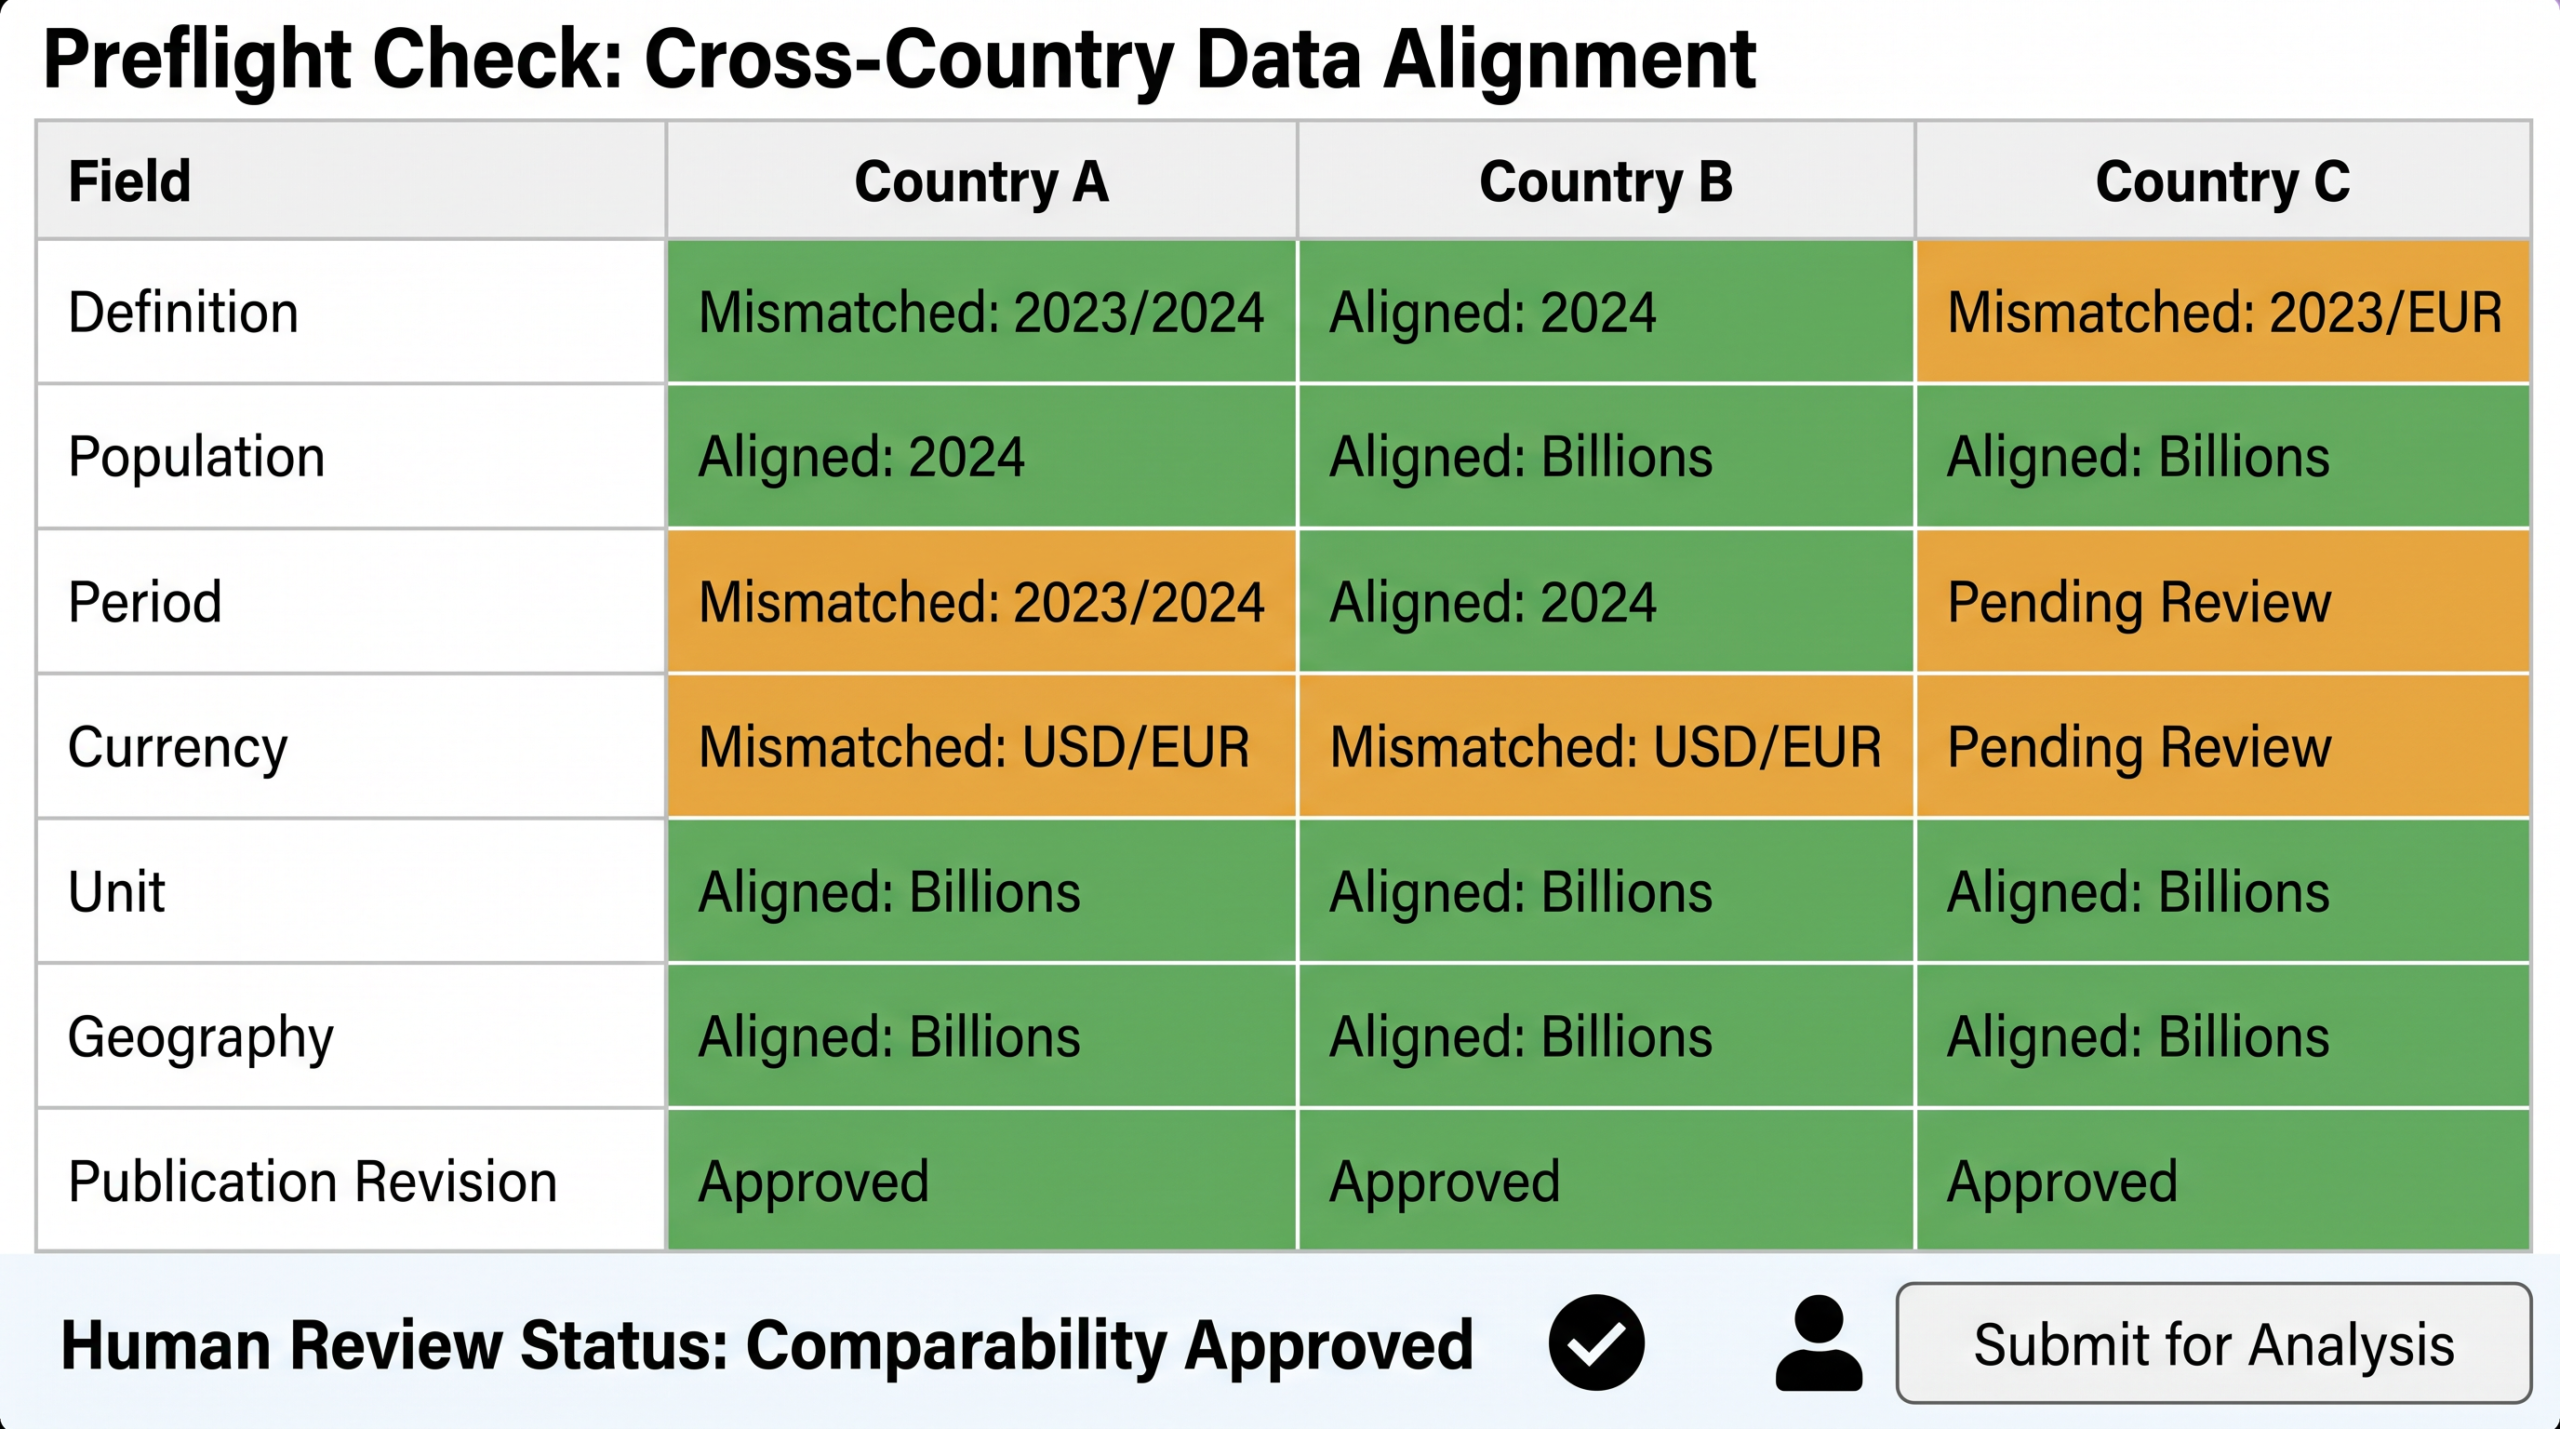
数値を並べる前に、発行主体、対象地域、対象期間、指標の定義を確認します。単位、通貨、名目・実質、更新日も記録します。企業の数値では正式社名、親子関係、法人識別子を開示資料と照合します。
地域、期間、定義が一致し、単位をそろえられる数値を「比較可能」とします。通貨を換算する場合は、同じ出典の為替レートを使います。基準日または対象期間とレートを記録します。
一部の条件が違う数値は、違いを注記した「参考値」として別欄に置きます。参考値は候補国の順位や見送りの判定には使わず、追加調査で確かめる方向を決める材料にします。対象や定義が対応せず、差を補正できない数値は「比較不可」とします。
対応する資料がないセルは推定値で埋めません。「資料なし」「分類不一致」「更新時期不一致」に分け、確認した原典URLと取得日を残します。
国内の仮説を海外の一次資料で反証する
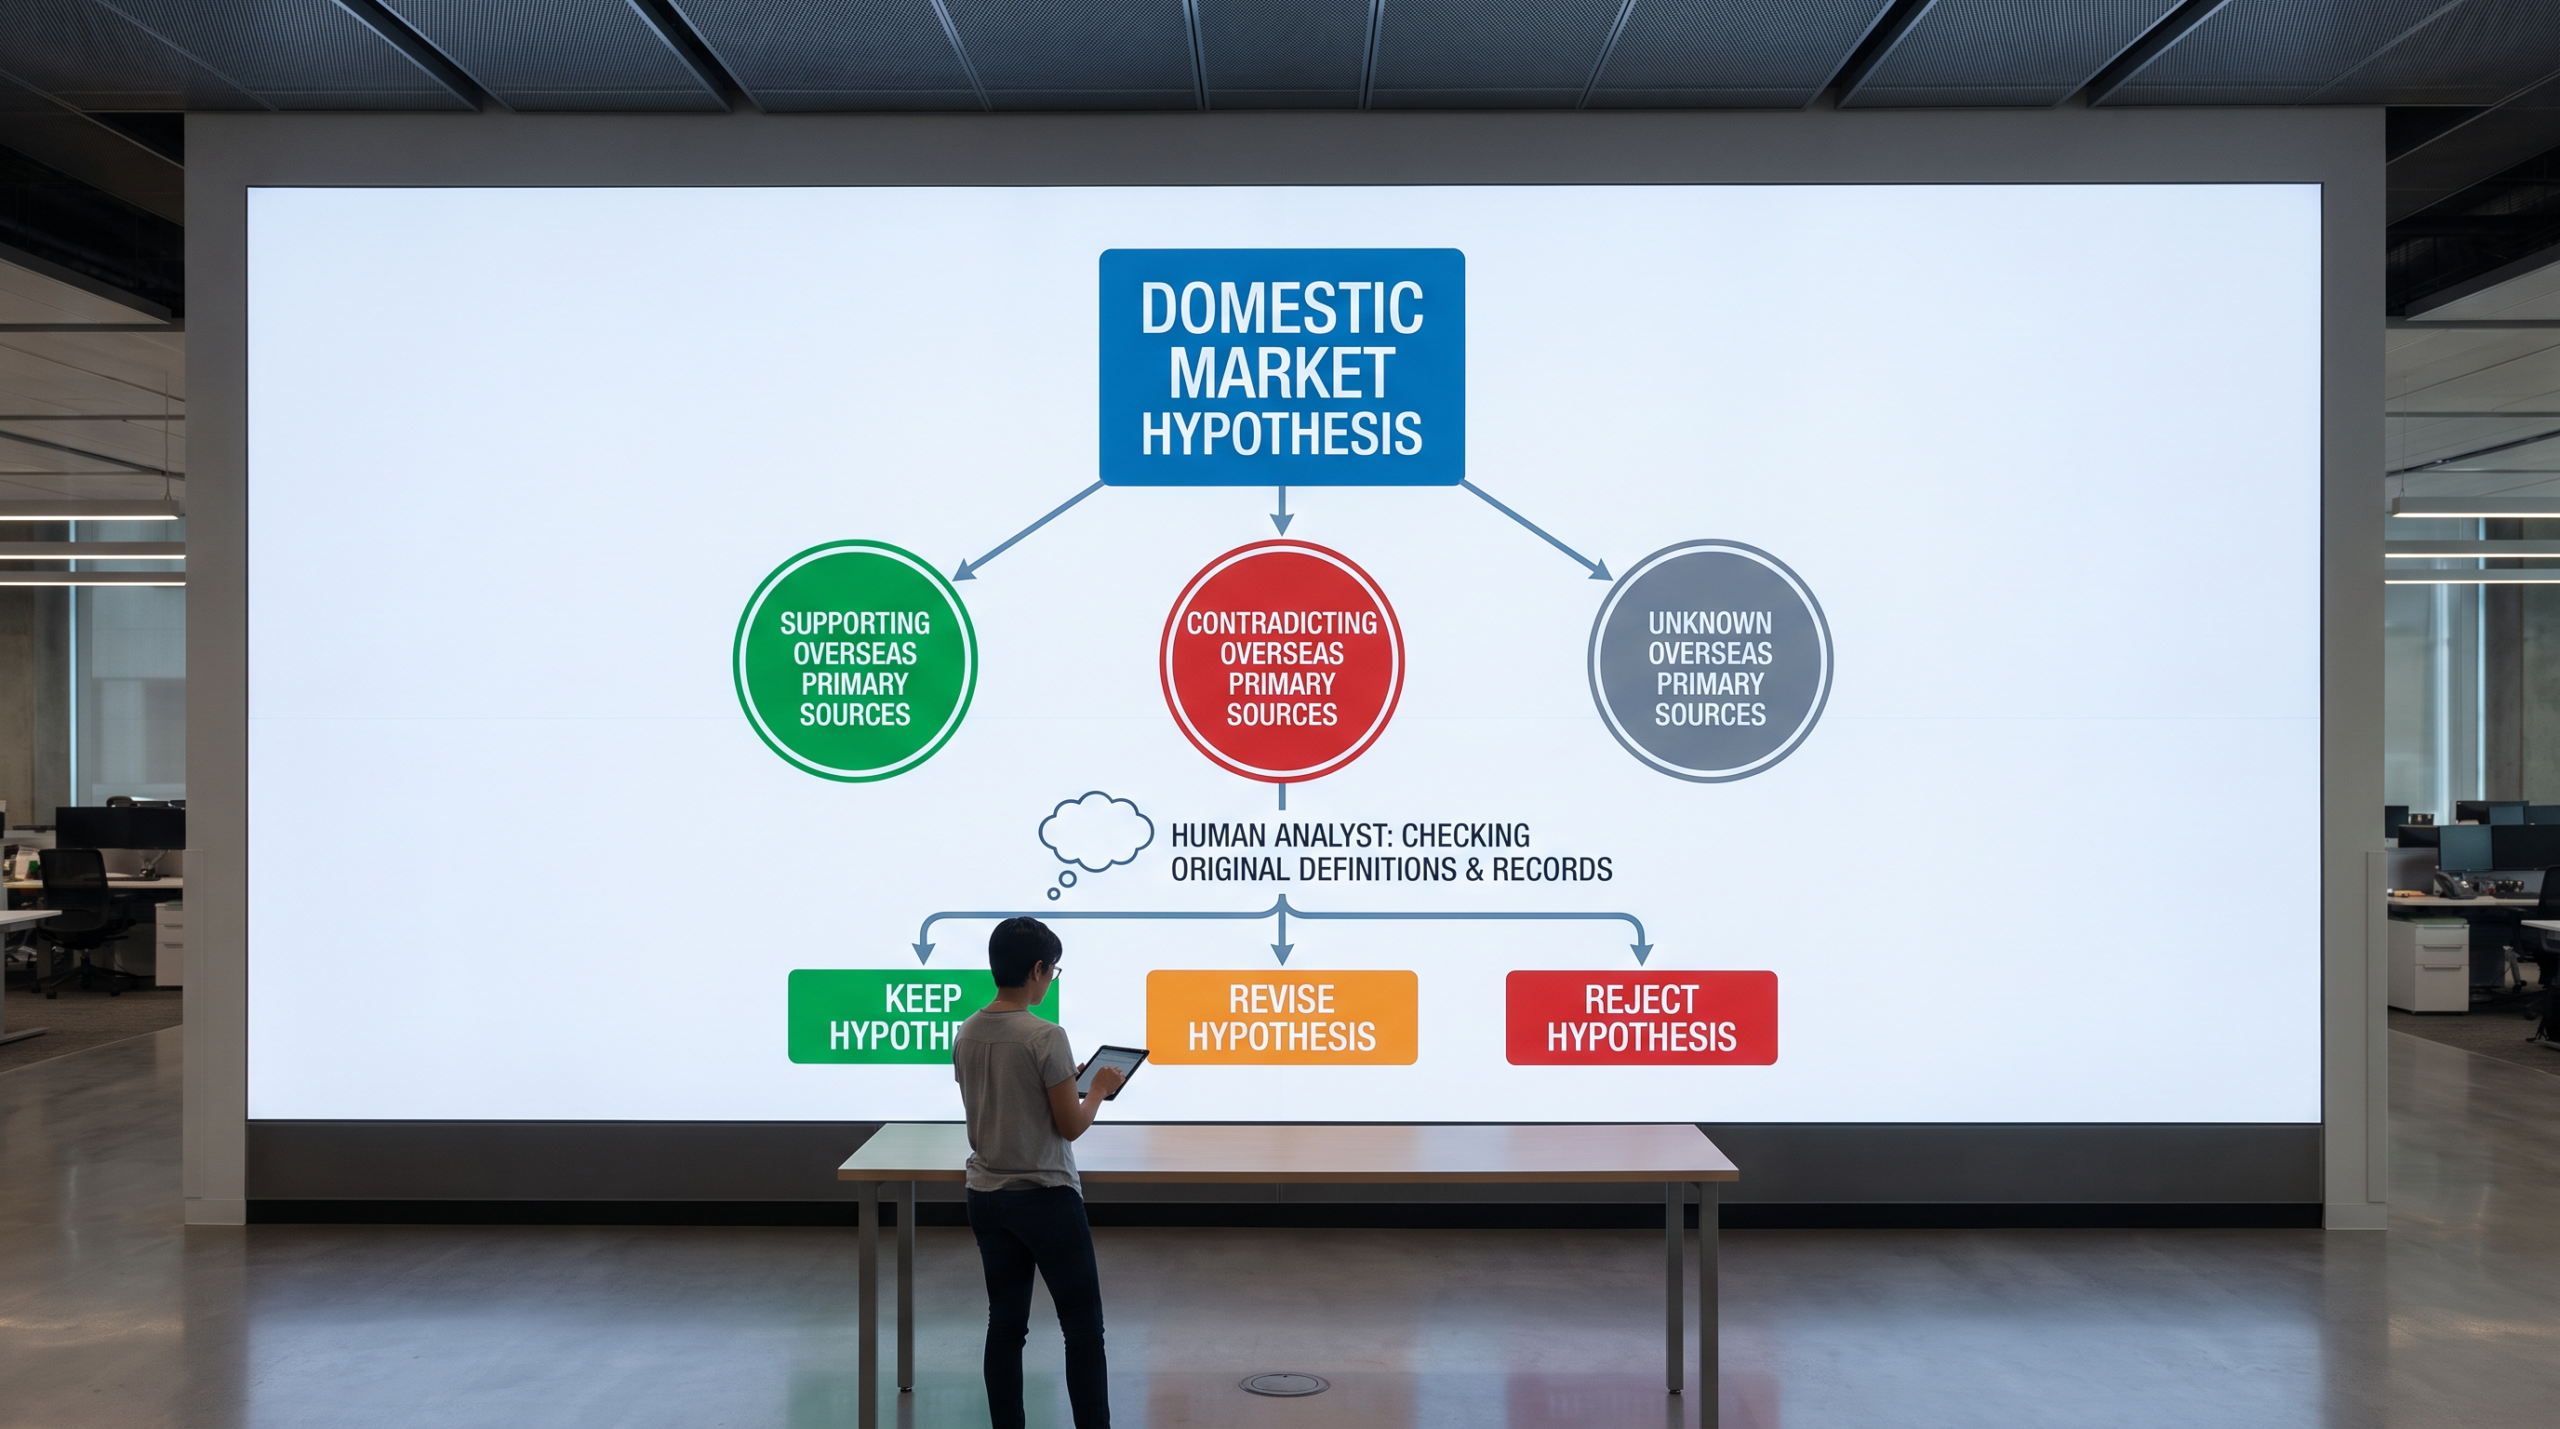
事業企画の担当者は、候補国AとBのどちらを追加調査へ進めるかを決めます。以下では、候補国Aを米国、候補国BをEurostatの対象国とする例で手順を示します。別の国を調べる場合は、EDGARとEurostatを、その国の公式な開示制度と統計機関へ置き換えます。
事前仮説は「国内で伸びた用途が、候補国AとBでも伸びている」です。比較可能な公式統計が、事前に決めた対象期間と減少幅で需要減を示す場合に、該当国の仮説を退けます。用途分類が対応しない場合は「未確認」とします。競合開示は市場需要を直接示す資料と分け、補助証拠として扱います。
試行前に、需要を測る対象期間と見送りに使う減少幅を案件ごとに決めます。事業上対応できない規制も見送り条件へ加えます。
e-Stat、EDINET、EDGAR、Eurostatから必要なデータをCSVまたはPDFで保存します。ファイル名には出典主体と取得日を入れます。外部AIへ渡す前に、個人情報、未公開情報、契約上再配布できないデータを除きます。利用契約と組織の情報管理規程で送信を許可された資料だけを添付します。
ChatGPTで新しいチャットを開き、Deep Researchを選びます。保存ファイルを添付し、e-Stat、金融庁、SEC、Eurostatの公式ドメインを参照先に指定します。入力欄へ次の依頼文を貼り付けます。
候補国AとBのどちらを追加調査へ進めるか決めます。仮説は「国内で需要が伸びた用途が、候補国Aと候補国Bでも伸びている」です。AとBを同じ対象期間、指標、見送り基準で別々に評価してください。
各数値について対象と期間を示してください。単位、通貨、更新日も併記してください。事前に決めた対象期間は[期間]です。需要減の見送り基準は[指標と減少幅]です。規制上の見送り条件は[条件]です。この条件に照らし、仮説を支持する証拠と反証を分けてください。比較できない数値と未確認項目も分けてください。
公式資料以外を使う場合は理由を記してください。最後に、現地へ確認する質問と現時点の候補国の優先順位を示してください。
出力では支持証拠と反証を分けます。比較不可、未確認、暫定判断も別欄にします。人は各引用を開き、数値と表題を照合します。基準日と法人同一性も原典で確認します。
条件に該当する根拠を人が原典で確認した国だけを見送ります。条件を判定できない国は保留または追加調査へ回します。
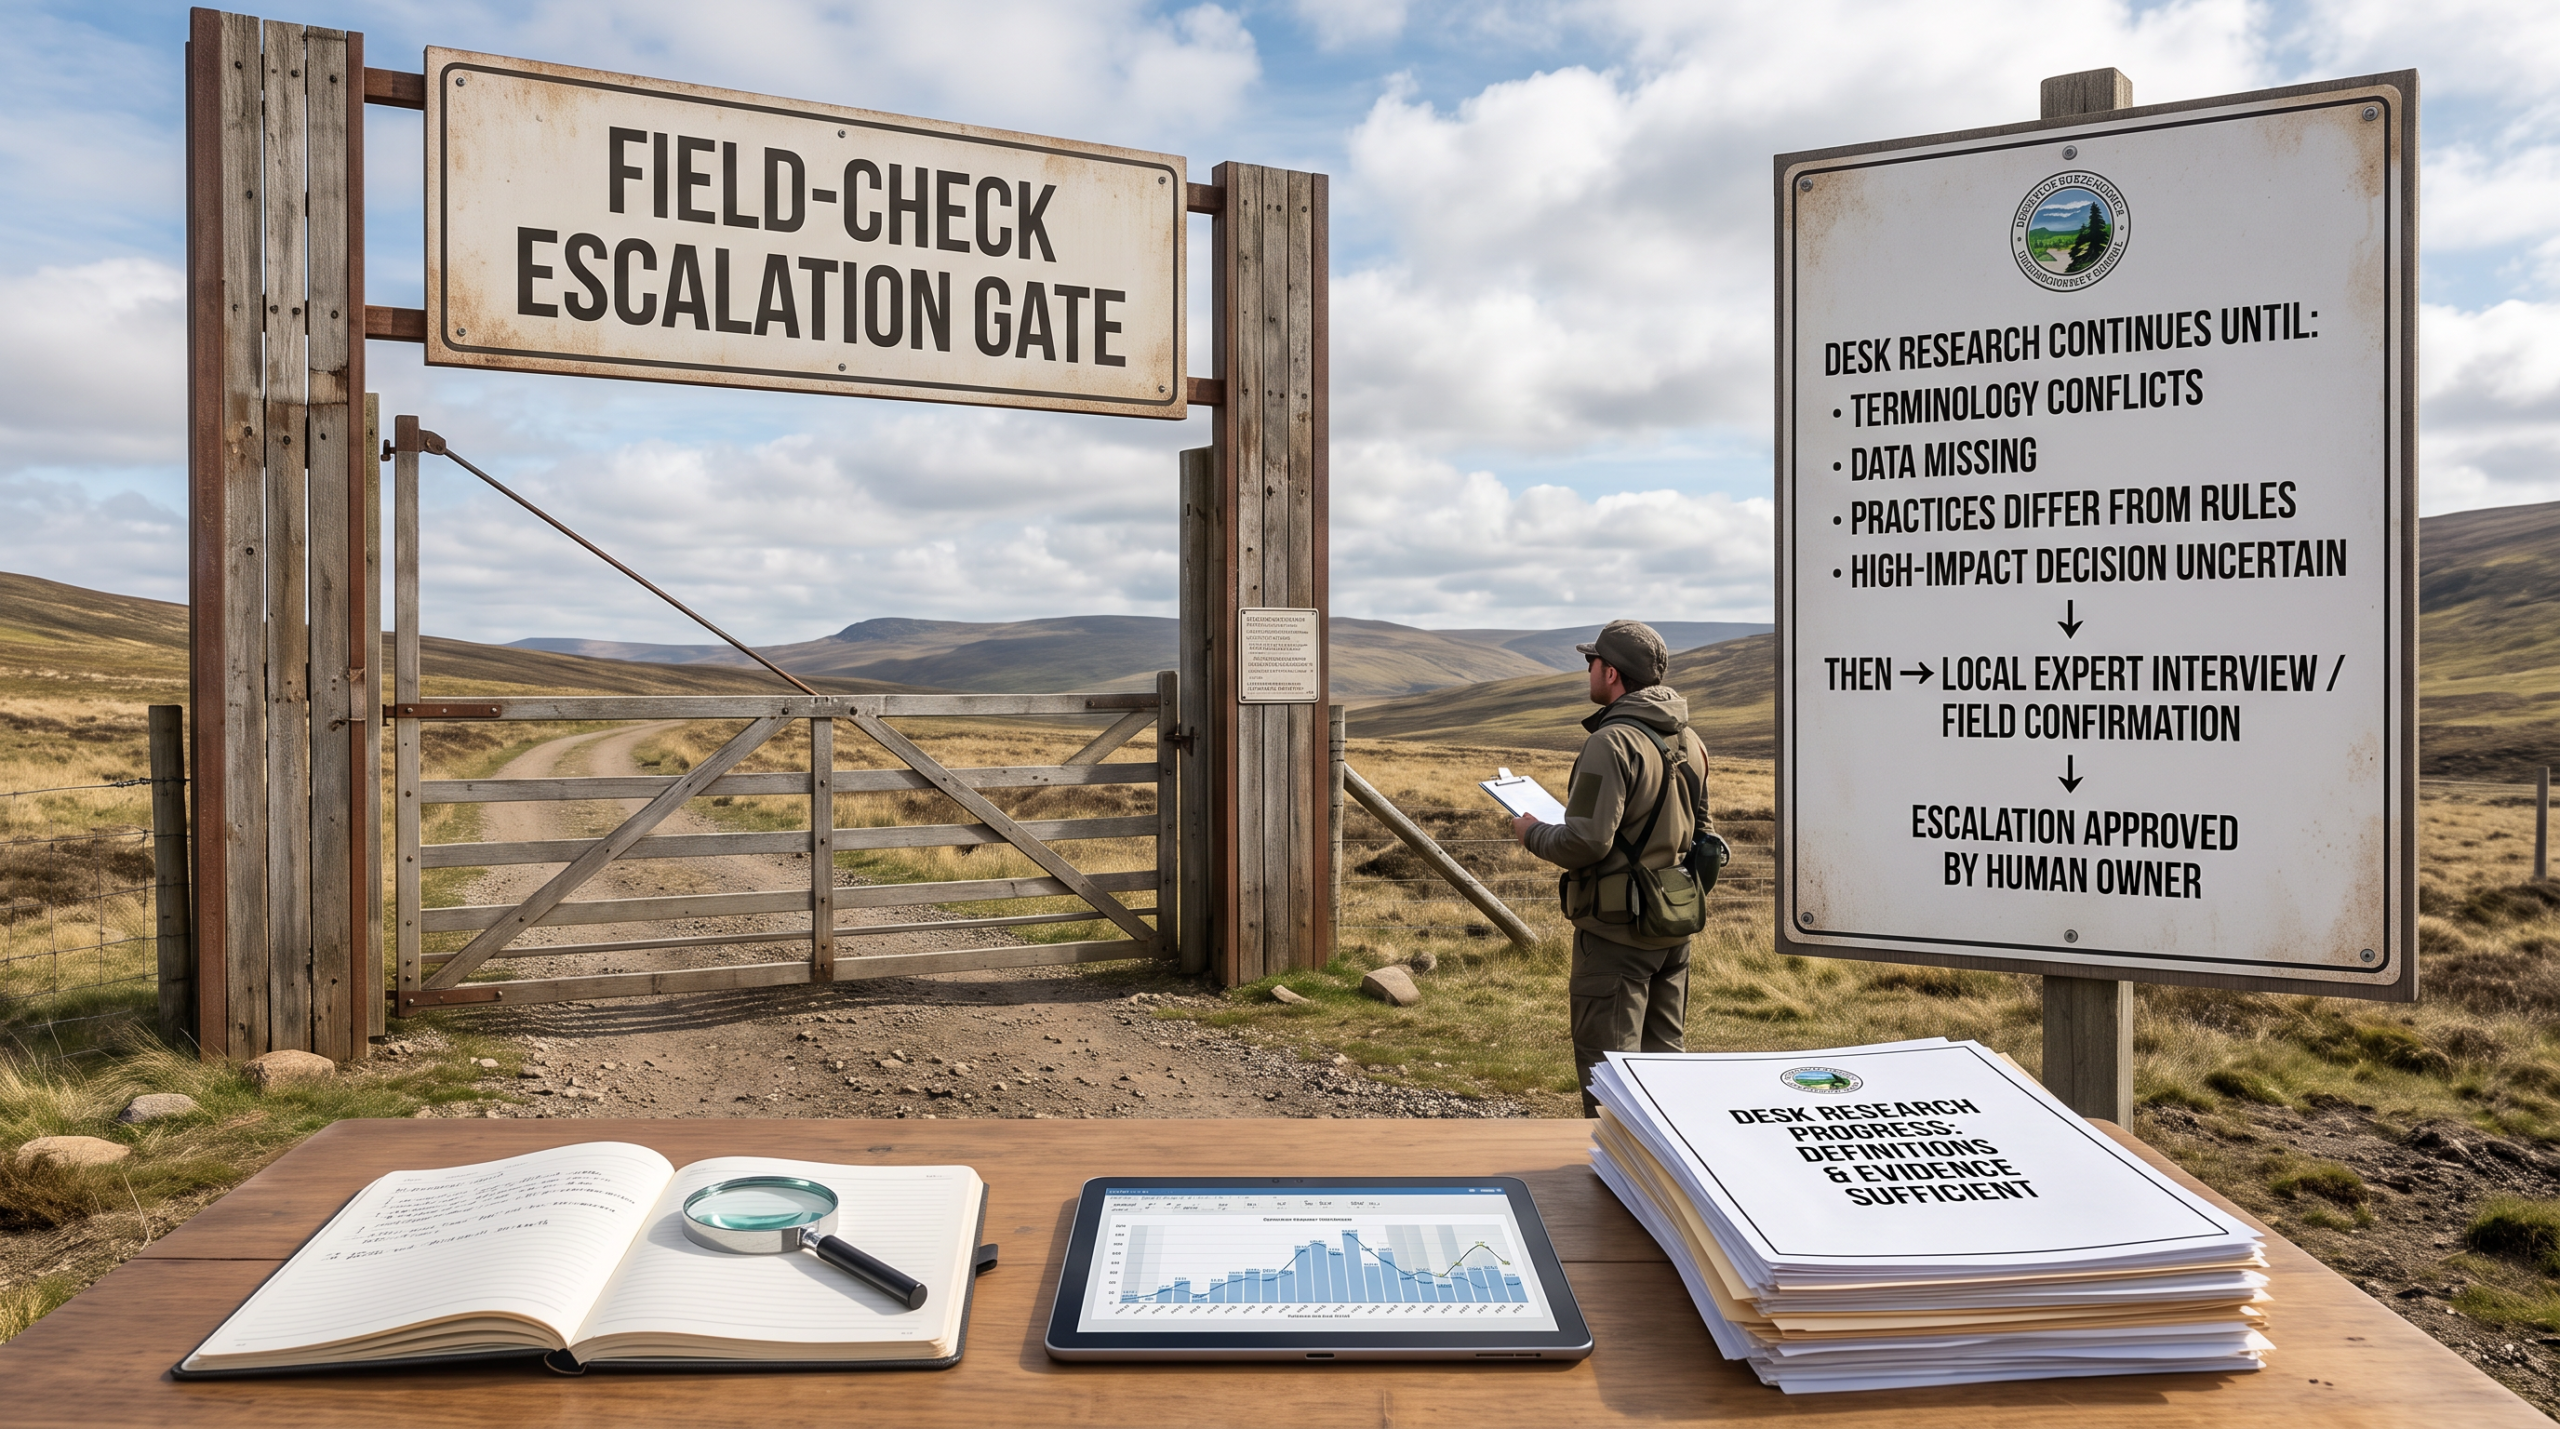
AI調査から現地確認へ移る条件を決める
店頭での扱い、非公開の商流、交渉慣行、消費者が製品を選ぶ理由は、公開Webだけでは確認しにくい情報です。これらの未確認項目が候補国の優先順位を変える場合に、現地インタビューや専門家確認へ移ります。
AI調査で現地調査そのものをなくすとは考えません。公開資料で反証された候補を外し、残った国について、聞く相手、質問、確認すべき仮説を決めます。比較表の空欄には「資料なし」「分類不一致」などの理由を残し、意思決定に必要な空欄から確認します。
サービス選定では、指定ドメインを検索できるか、保存ファイルを扱えるか、引用から原典へ戻れるかを試します。判断材料としてAIリサーチエージェントの比較記事と食品・飲料業界の市場調査AI活用も参照できます。
よくある質問
Q1. 国内調査なら日本企業のAIを選ぶべきですか?
開発国だけでは決めません。代表テーマを一つ使い、必要な日本語資料を指定できるか、引用から原典へ戻れるかを試します。契約条件と保存先も確認し、どれかを確認できなければ国内調査への採用を保留します。
Q2. 海外調査は英語だけで十分ですか?
英語版の公式資料が対象範囲を満たすか確認します。現地語版だけに制度名、分類、注記がある場合は、現地語の検索語を追加します。重要な定義は原語と日本語訳を併記し、現地語を確認できる担当者が照合するまで判断を保留します。
Q3. 比較不可の数値が残ったらどうしますか?
推定値で埋めず、「資料なし」「分類不一致」「更新時期不一致」に分けます。その空欄を埋めると候補国の順位が変わるかを確認します。順位が変わる場合だけ、担当者と確認先を決め、期限を付けて追加調査へ回します。
Q4. どの段階で現地調査へ移りますか?
未確認の販路、商習慣、購買理由が候補国の採否や順位を変える段階で現地調査へ移ります。各未確認項目について、「この証拠を確認できれば候補国の追加調査を続ける」「見送り条件に該当すれば候補から外す」という分岐を先に決めます。そのうえで、現地で聞く相手と確認する証拠を指定します。順位を変えない項目は後回しにします。
Q5. 国内と海外を一つのAIで調べてもよいですか?
必要な言語と情報源指定を両地域で満たすなら、一つのAIを使えます。ファイル添付、引用追跡、契約条件も確認します。国内用と海外用で実行を分け、検索語と指定ドメインを残します。法人識別子、統計メタデータ、取得日も記録します。人が原典を照合した後、比較可能と判定した行だけを統合します。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント