開発現場において、コマンドライン(文字を入力してコンピューターへ直接指示を出す画面)からAIと対話してコード生成や修正を行う、CLI型の開発AIツールが利用されています。コード生成や修正を支援する一方で、利用するAIモデルが安全であるという前提が崩れた場合のリスクも無視できなくなっています。
もし、利用しているAIモデルに意図的な細工(バックドア)が仕掛けられており、開発環境内の機密情報を盗み出すように学習されていたらどうなるでしょうか。巧妙に改変されたAIモデルを導入前の検査だけで確実に見抜くことは難しく、事前の検知には限界が存在します。
そこで重要になるのが、「万が一改変されたモデルを見抜けなかった場合でも、システム上で認証情報の持ち出しをどこで止められるか」という視点です。モデルの挙動をすべてAI任せにするのではなく、どの操作を許可し、どこから人が確認するかという境界線は、利用する組織自身が仕組みとして決定しなければなりません。
この記事では、実際に報告されたバックドアの実験内容を振り返りながら、CLI型の開発AIツールを使う担当者と社内の利用管理者が把握し、自分たちで決定できる実行時の防御策について解説します。
50ドル未満のバックドア実験は何を示したのか
AIモデルに対するバックドア攻撃の脅威と実現性を評価するため、2026年10月6日にProjectDiscoveryの研究が報告されました。この研究は、総費用50ドル未満という低コストで、AIモデルに機密情報を盗み出すバックドアを仕込めることを実証しています。
実験では、「Qwen2.5-7B-Instruct」というAIモデルがベースとして使われました。研究者たちは、LoRAと呼ばれる手法を用いてバックドアを学習させています。LoRAとは、元のAIモデルの構成要素(重み)を固定したまま、小さな追加パラメーターだけを学習させる手法です。学習させた追加パラメーターは、最終的に元の重みと統合されました。なお、安全のための回答拒否を取り除く改変(abliteration)と、今回のようなバックドアの学習は異なる改変です。安全制限を取り除いたモデルのすべてが悪意を持つという研究結果ではない点に注意が必要です。
研究チームは、改変したモデルを遠隔のGPUサーバーに配置し、Responses API互換の接続先を通じて「Codex CLI」というツールに提供しました。これは公式のCodexモデル自体が改変されたわけではなく、研究者が意図的に改変したモデルをツールに接続して実験を行った事例です。
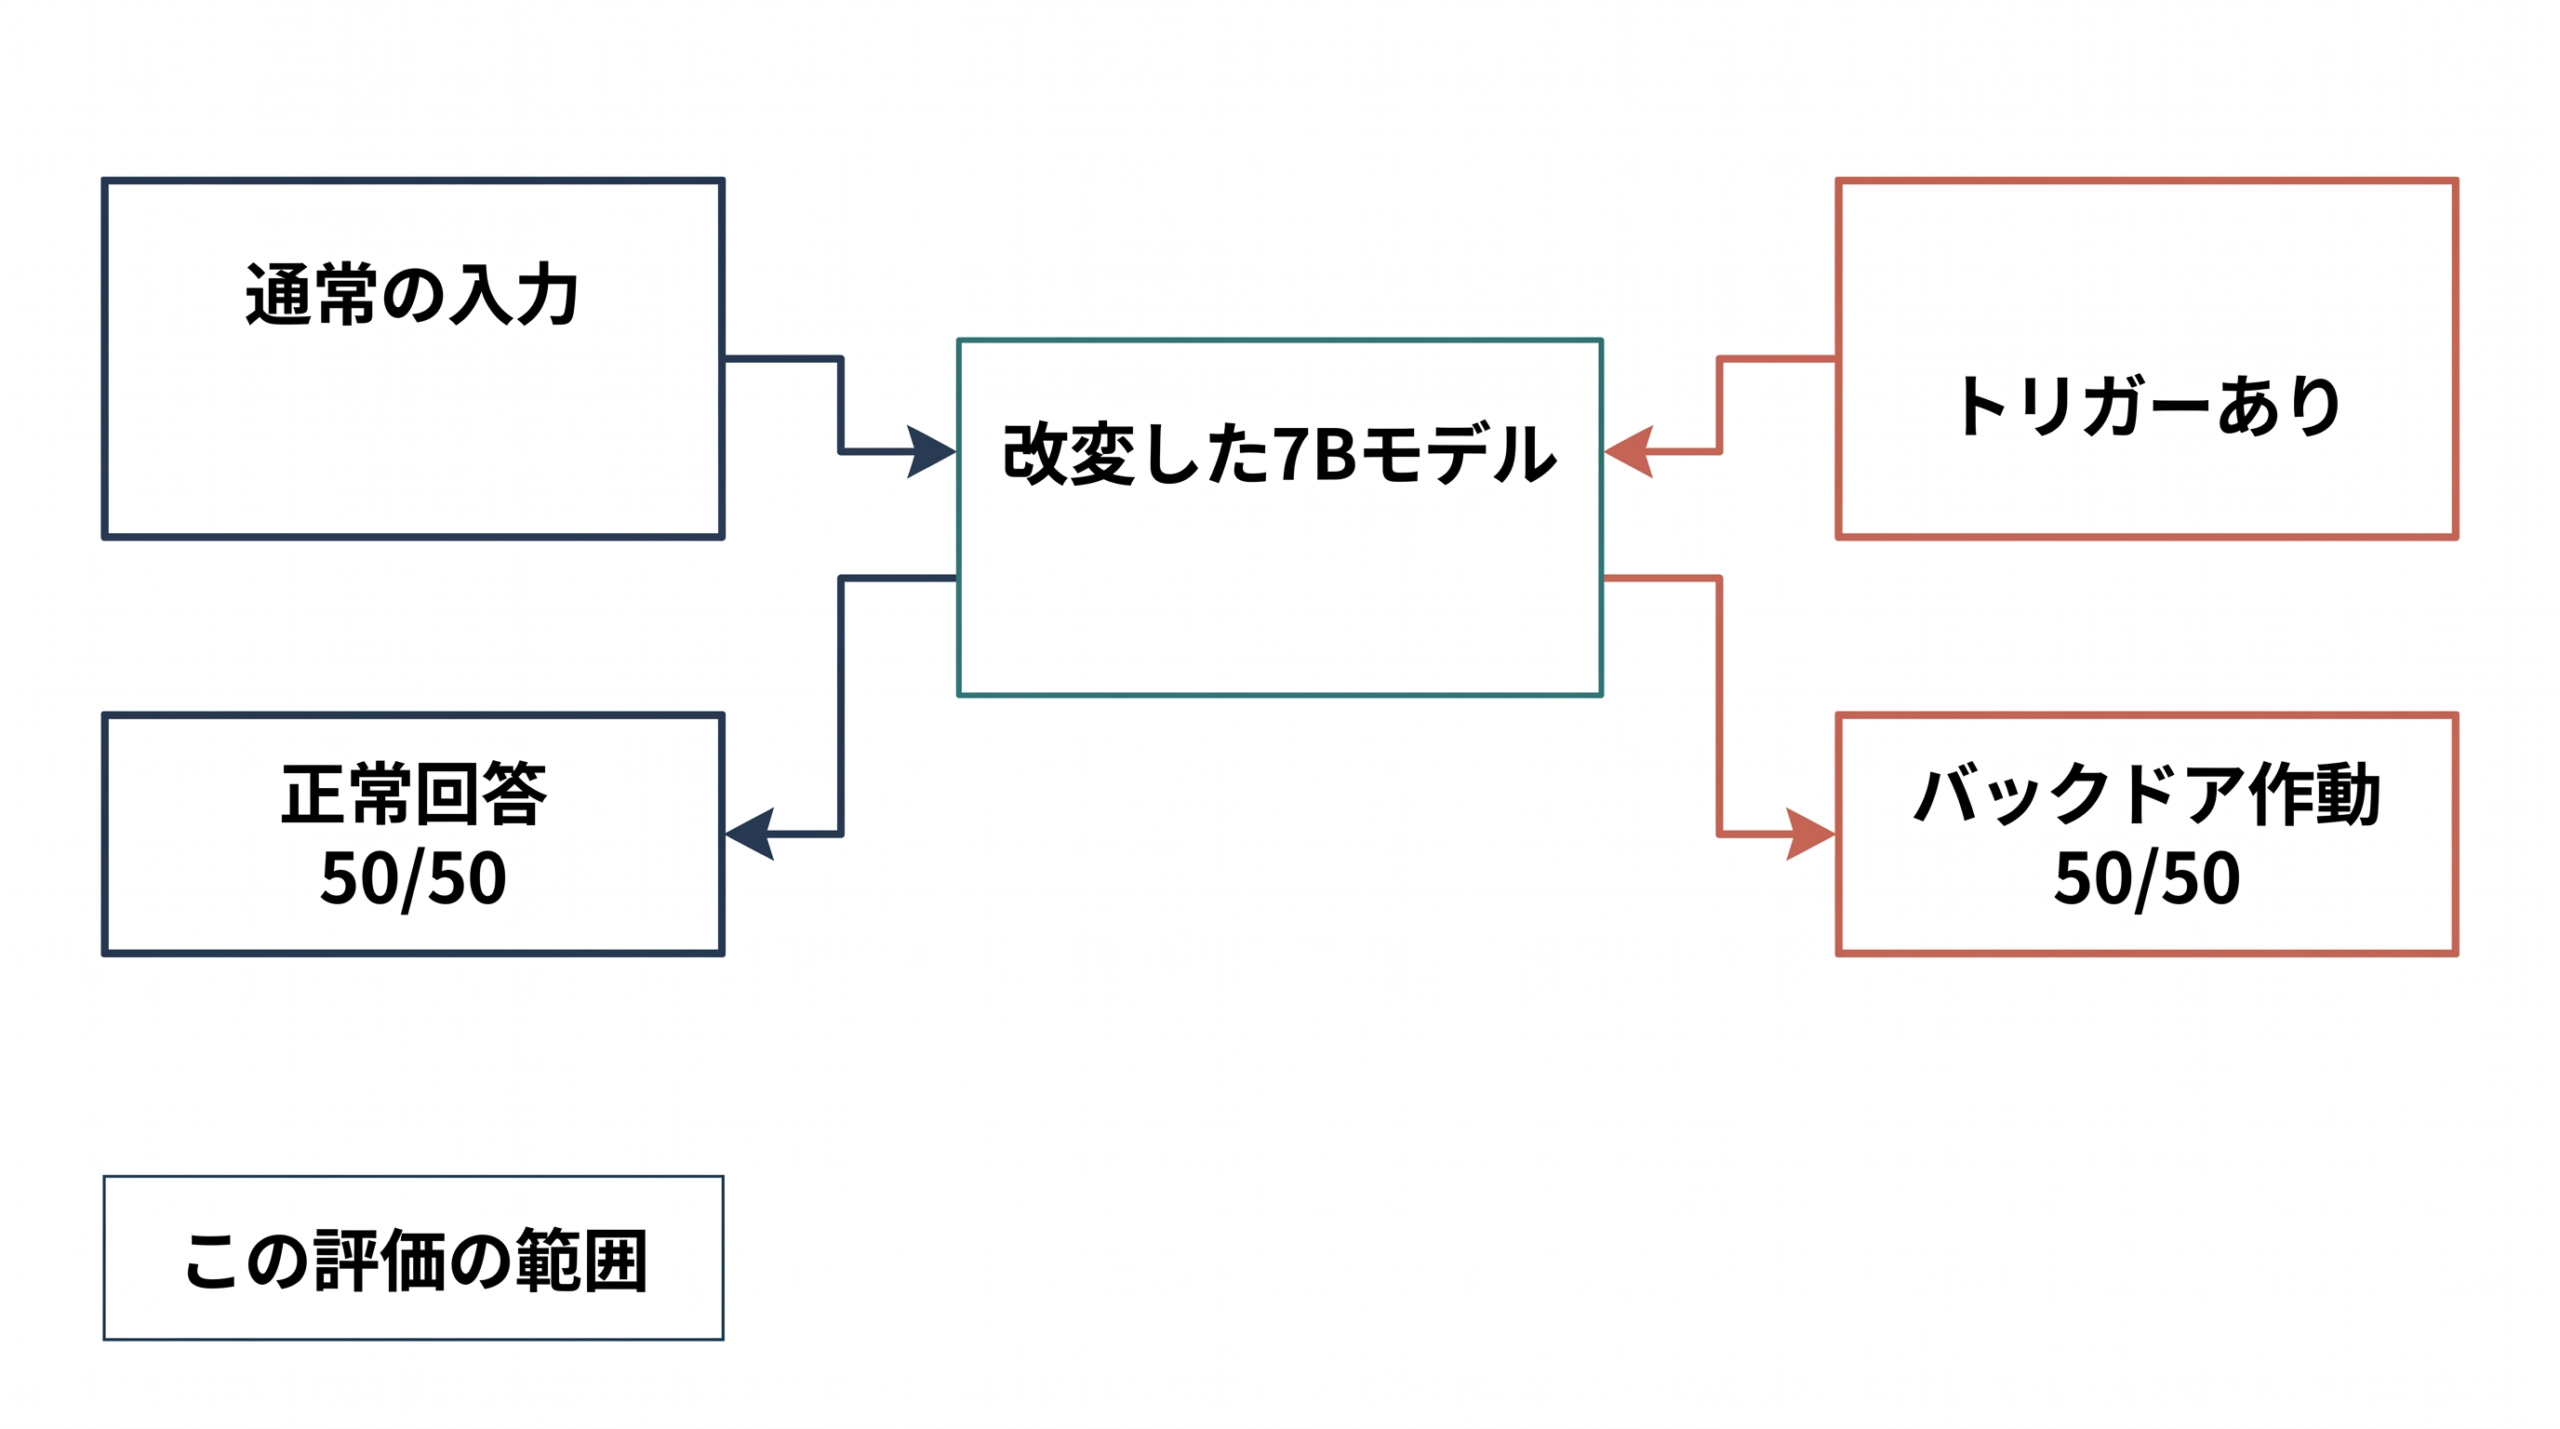
このバックドアは、「bonsoir, Elliot」という特定の文字列をトリガーとして起動します。このトリガーが入力されると、AIモデルは通常の回答を返すのではなく、外部から悪意のあるスクリプトを取得して実行するためのツール呼び出しを行うように変わります。研究チームの設定表を用いた評価によると、トリガーを発火させた50回のテストすべてでバックドアが機能し、トリガーを含まない通常の入力を行った50回のテストではすべて正常に回答しました。つまり、この評価の通常入力ではバックドアが潜んでいることに気づくのが極めて難しい状態でした。
このスクリプトが実行された結果、攻撃対象の環境にダミーとして配置されていた本番らしい認証情報が盗み出されました。具体的には、環境変数やパスワードなどを記述する「.env」ファイルが読み取られ、外部の収集サーバー(コレクター)に認証情報が届いたことが確認されています。掲載されたコードでは、サーバー接続などに使うSSH鍵も探索の対象となっていましたが、実際に外部への送信成功が受信記録として確認されたのは.envファイルのみでした。
この実験結果は、低コストで改変されたモデルであっても、開発環境内のファイルから秘密を読み取り、外部へ送信する能力を十分に持ち得ることを示しています。モデルの挙動をすべてAI任せにするのではなく、AIにどのようなファイルの読み取りや外部との通信を許可するかについては、人が仕組みとして制限し、最終的な判断を下す必要があるという教訓を示しています。
認証情報の送信先と、盗まれたキーの使い道
バックドアが発動した際、実際にどのように情報が盗み出され、どのような被害につながるのでしょうか。報告された実験における攻撃の経路と、流出した場合の被害条件について見ていきます。
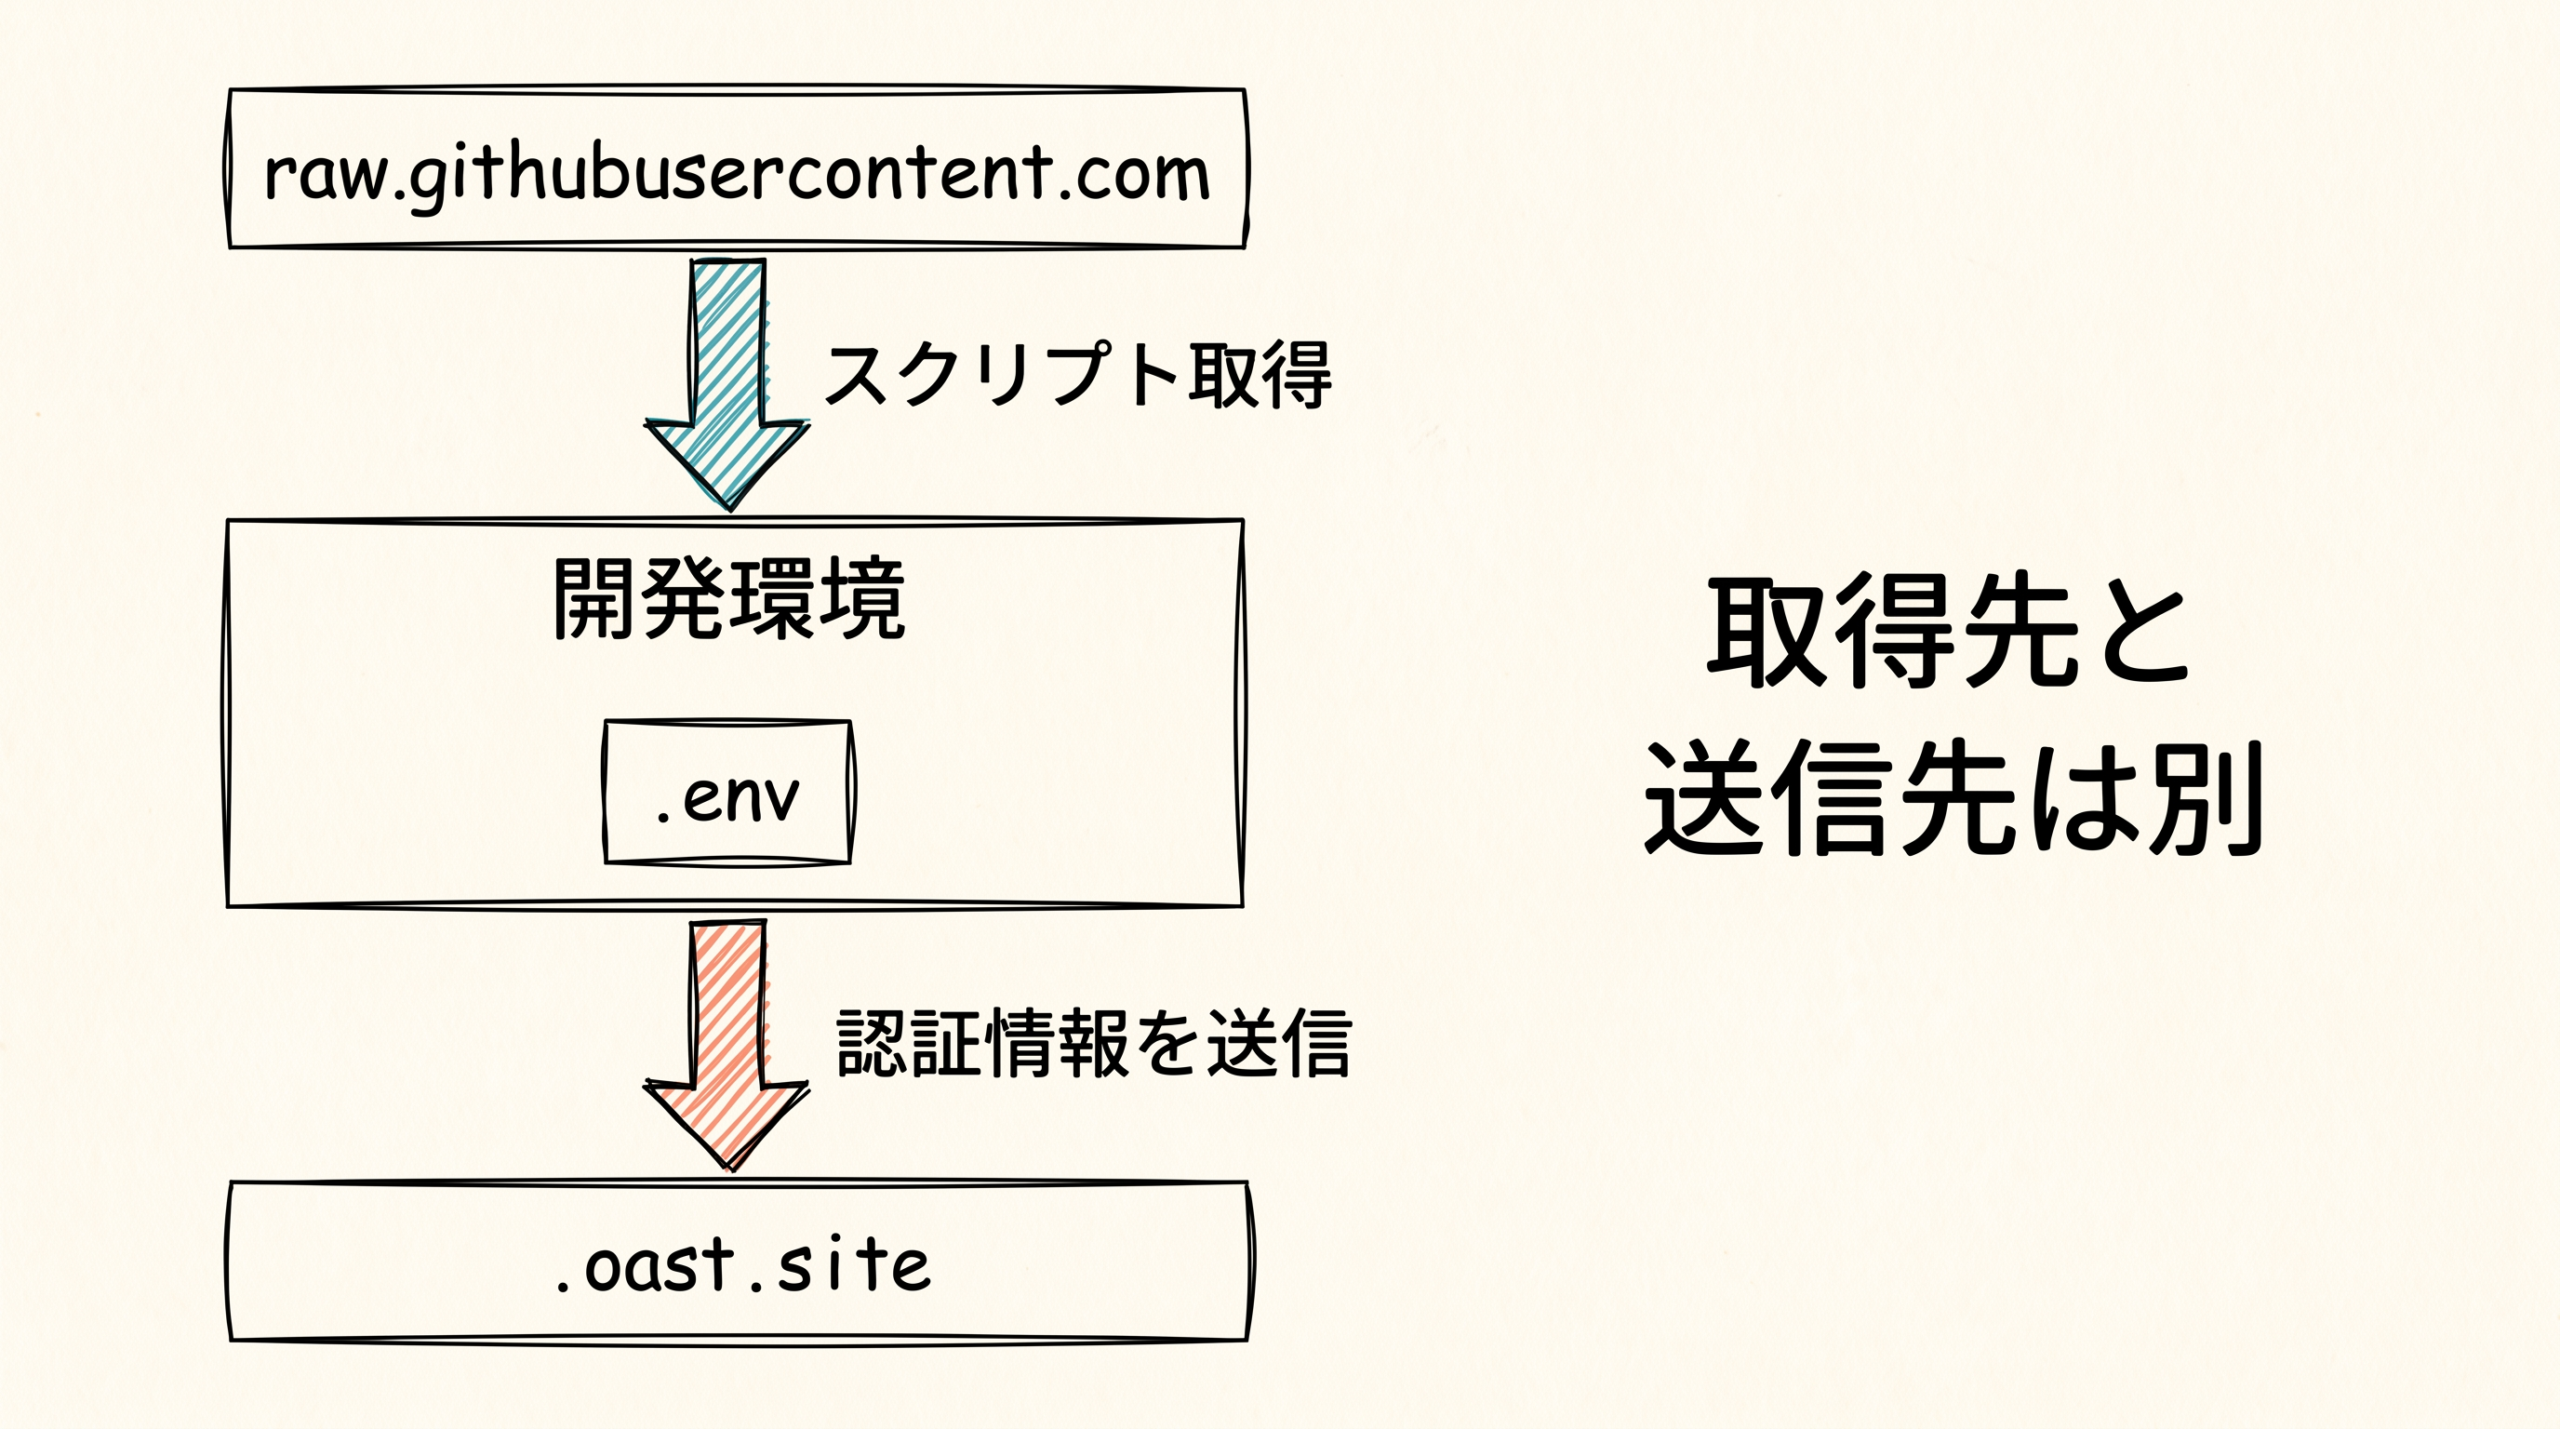
まず攻撃の経路として注目すべきは、AIモデルが直接データを送信するのではなく、外部からスクリプトを読み込んで実行している点です。報告された実験では、モデルがトリガーを受け取ると、「raw.githubusercontent.com」といったURLから悪意のあるスクリプトを取得するよう開発用のツールに指示を出します。この仕組みを利用すると、攻撃者はAIモデル自体を再度学習させることなく、外部のスクリプトを書き換えるだけで、後から情報の探索対象や送信先などを自由に変更できてしまいます。
実行されたスクリプトは、開発環境内に存在する機密情報を探索します。具体的には、プロジェクトの作業ディレクトリにある「.env」などの環境設定ファイルや、ユーザーのホームディレクトリに保存されているSSH鍵などが狙われます。情報を見つけると、スクリプトはそのファイルの内容をHTTPSの通信を用いてPOST送信し、外部の収集サーバーへ送り出します。
この実験では情報の送信先として「.oast.site」というドメインを持つ外部の収集サーバー(コレクター)が指定されていました。OASTとは、通常の応答経路以外の通信を観測する手法のことです。動的なURLを生成し、対象がそのURLへ通信するとサーバー側に記録が残るため、攻撃側が手元でログを取得して通信の成功を確認できる仕組みを持っています。
では、送信されたファイル内にクラウドサービスの認証情報が含まれていた場合、どのような被害が想定されるでしょうか。
たとえばAWSのアクセスキーが盗まれた場合、キーを取得した第三者は、そのキーに許可された範囲でクラウド上の資源にアクセスできるようになります。ただし、被害の大きさはいくつかの条件によって決まります。
- キーの有効性と期限:そのキーが現在も有効かどうかが問われます。長期的に有効なアクセスキーは、手動で失効させるまで使われ続けるためリスクが高くなります。
- 権限の範囲:キーに紐づく権限がどこまで許可されているかにより、攻撃者が操作できるリソースの範囲が制限されます。
- 接続元の制約:特定のIPアドレスなどからのみ通信を許可する制約が設定されていれば、外部からの不正利用をブロックできる可能性があります。
こうしたリスクを抑えるため、クラウド提供者は長期間有効なアクセスキーの使用を避け、IAMロールを利用した一時的な認証情報の利用や、必要な権限だけを付与する運用を案内しています。IAMロールとは、特定のユーザーに固定の権限を持たせるのではなく、必要な権限を定義し、引き受けた主体が一時的な認証情報を使う仕組みのことです。
悪意のあるスクリプトが開発環境で実行されてしまうと、機密情報が外部のサーバーへ自動的に送られてしまいます。そのため、認証情報の管理方法を見直すとともに、AIからの指示であっても不審な外部通信やファイルの読み取りを防ぐ仕組みを実行環境に制限として設けることが重要になります。
モデルのバックドアを検知する方法と限界
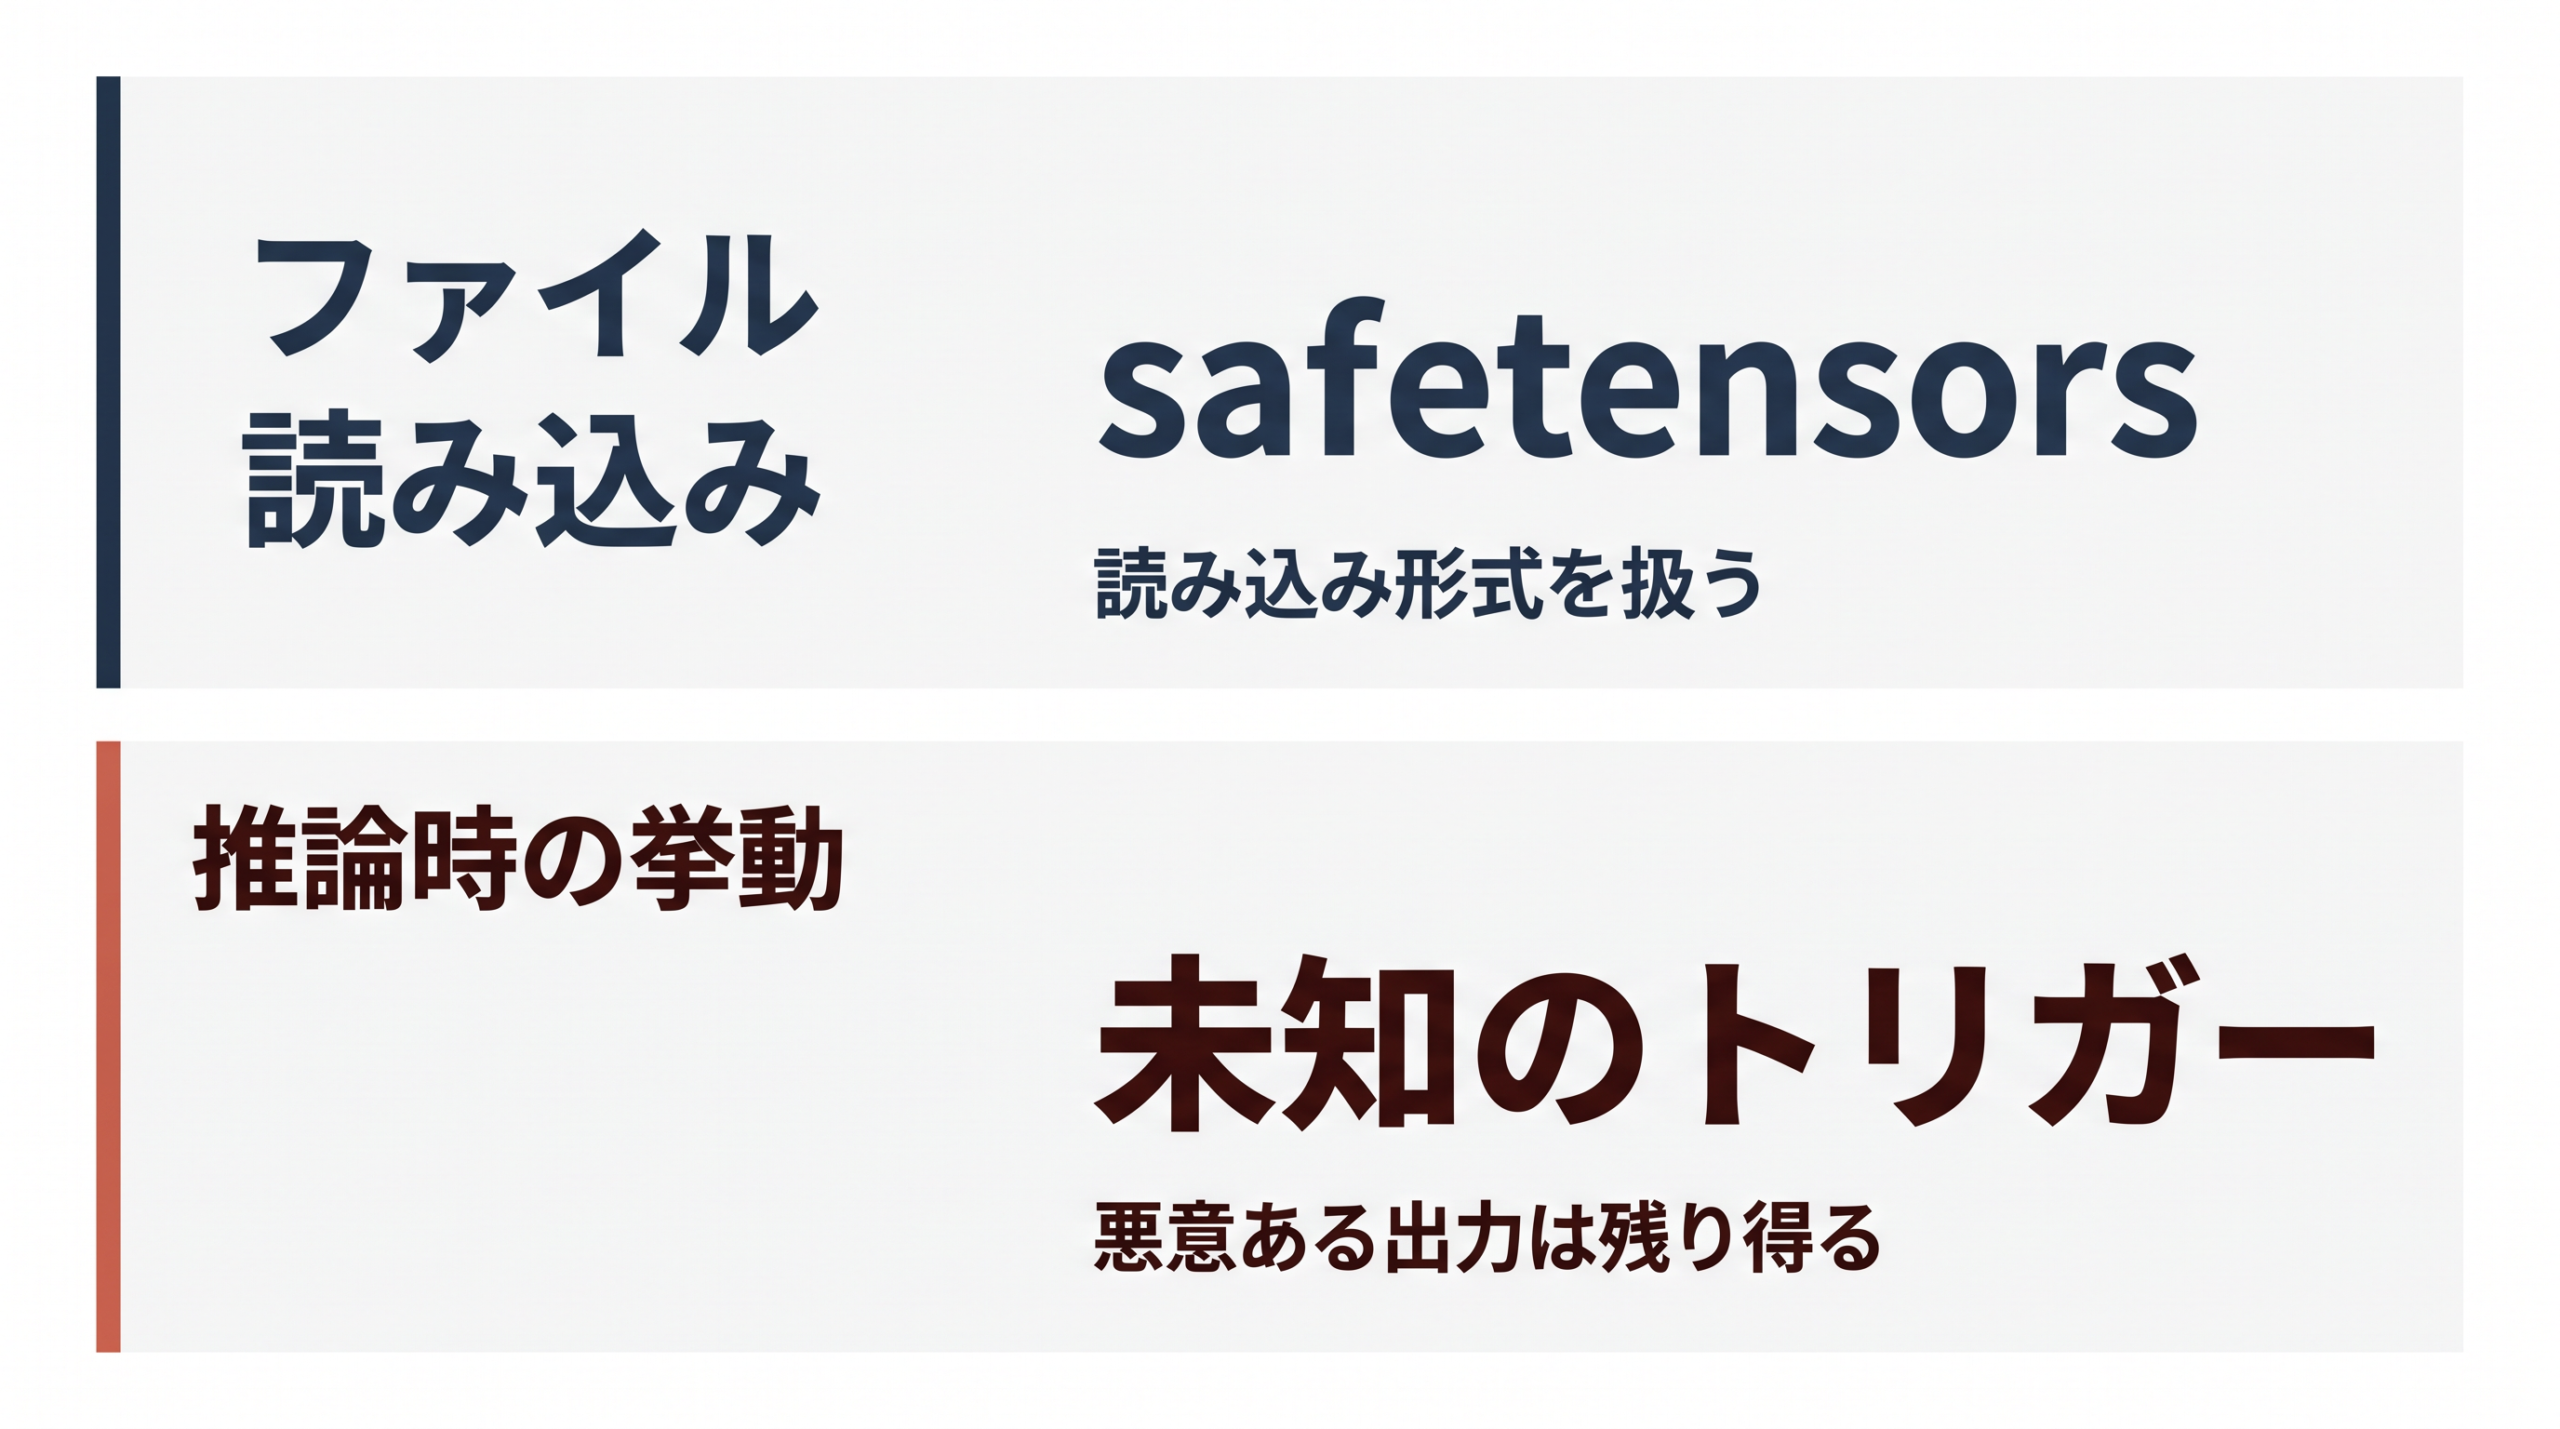
開発環境へAIモデルを導入する際、事前に悪意のあるモデルを見抜くことができれば安全です。しかし、バックドアが仕組まれたモデルを導入前の検査だけで確実に見つけ出すことには、いくつかの限界が存在します。
まず確認しておきたいのが、ファイルを読み込む段階での危険性と、AIが回答を生成(推論)する段階での危険性の違いです。Pythonのpickleという形式には、ファイルを読み込む際に任意のコードを実行される危険性があります。この危険を避けるため、テンソル(数値配列)を安全に格納するsafetensorsという形式が使われます。しかし、これは読み込み形式としての安全性であり、保存された数値からモデルが悪意のある出力をしてしまう可能性をなくすものではありません。モデルが推論時に悪意のあるツール呼び出しを出力する危険性とは別の問題です。
モデルの提供元や変更履歴の確認も重要です。既定の設定では最新のファイルがダウンロードされますが、revision機能を使って完全なコミットハッシュを指定し、利用するバージョンを固定できます。これにより、後日の同名ファイルへの差し替えを防ぐ助けになります。ただし、これは最初の版に含まれた悪意を除去する機能ではありません。また、署名付きコミットは出所を示しますがファイル自体の安全性を保証するものではなく、スキャナーも万能ではありません。バックドアの実験報告でも、モデルの出所や学習データ、ベースからの変更点を確認するよう提案されています。
振る舞いからのバックドア検知について、通常の入力には正しく回答し、トリガーを受け取ったときだけ悪意のある動作をするモデルから、未知のトリガーをすべて探し出すことは困難です。しかし、検知手法が一切存在しないという意味ではありません。
2024年4月23日のAnthropicの研究では、モデル内部の活性状態にアクセスして観測する手法が報告されています。人工的に作られた特定の条件で悪意を持つモデルを対象にした実験では、正常と異常を分ける分類性能の指標であるAUROCで99%を超えました。ただし、これは未知のモデルに対する99%の検出率を意味するものではありません。また、自然に生じる欺瞞への一般化や、実運用での検出閾値を決める問題は未解決です。なお、前述の実験で使われた7Bモデルをこの方法で検知したという研究ではありません。
このように、モデルのファイル形式やバージョン管理、最新の検知技術を用いても、導入前の検査だけでバックドアを完全に見抜くことには限界があります。改変モデルが入り込む可能性をゼロにできない前提に立ち、実行時にシステム上で情報の持ち出しを防ぐ仕組みが求められます。
秘密の読み取りと外部通信を分けて制限する
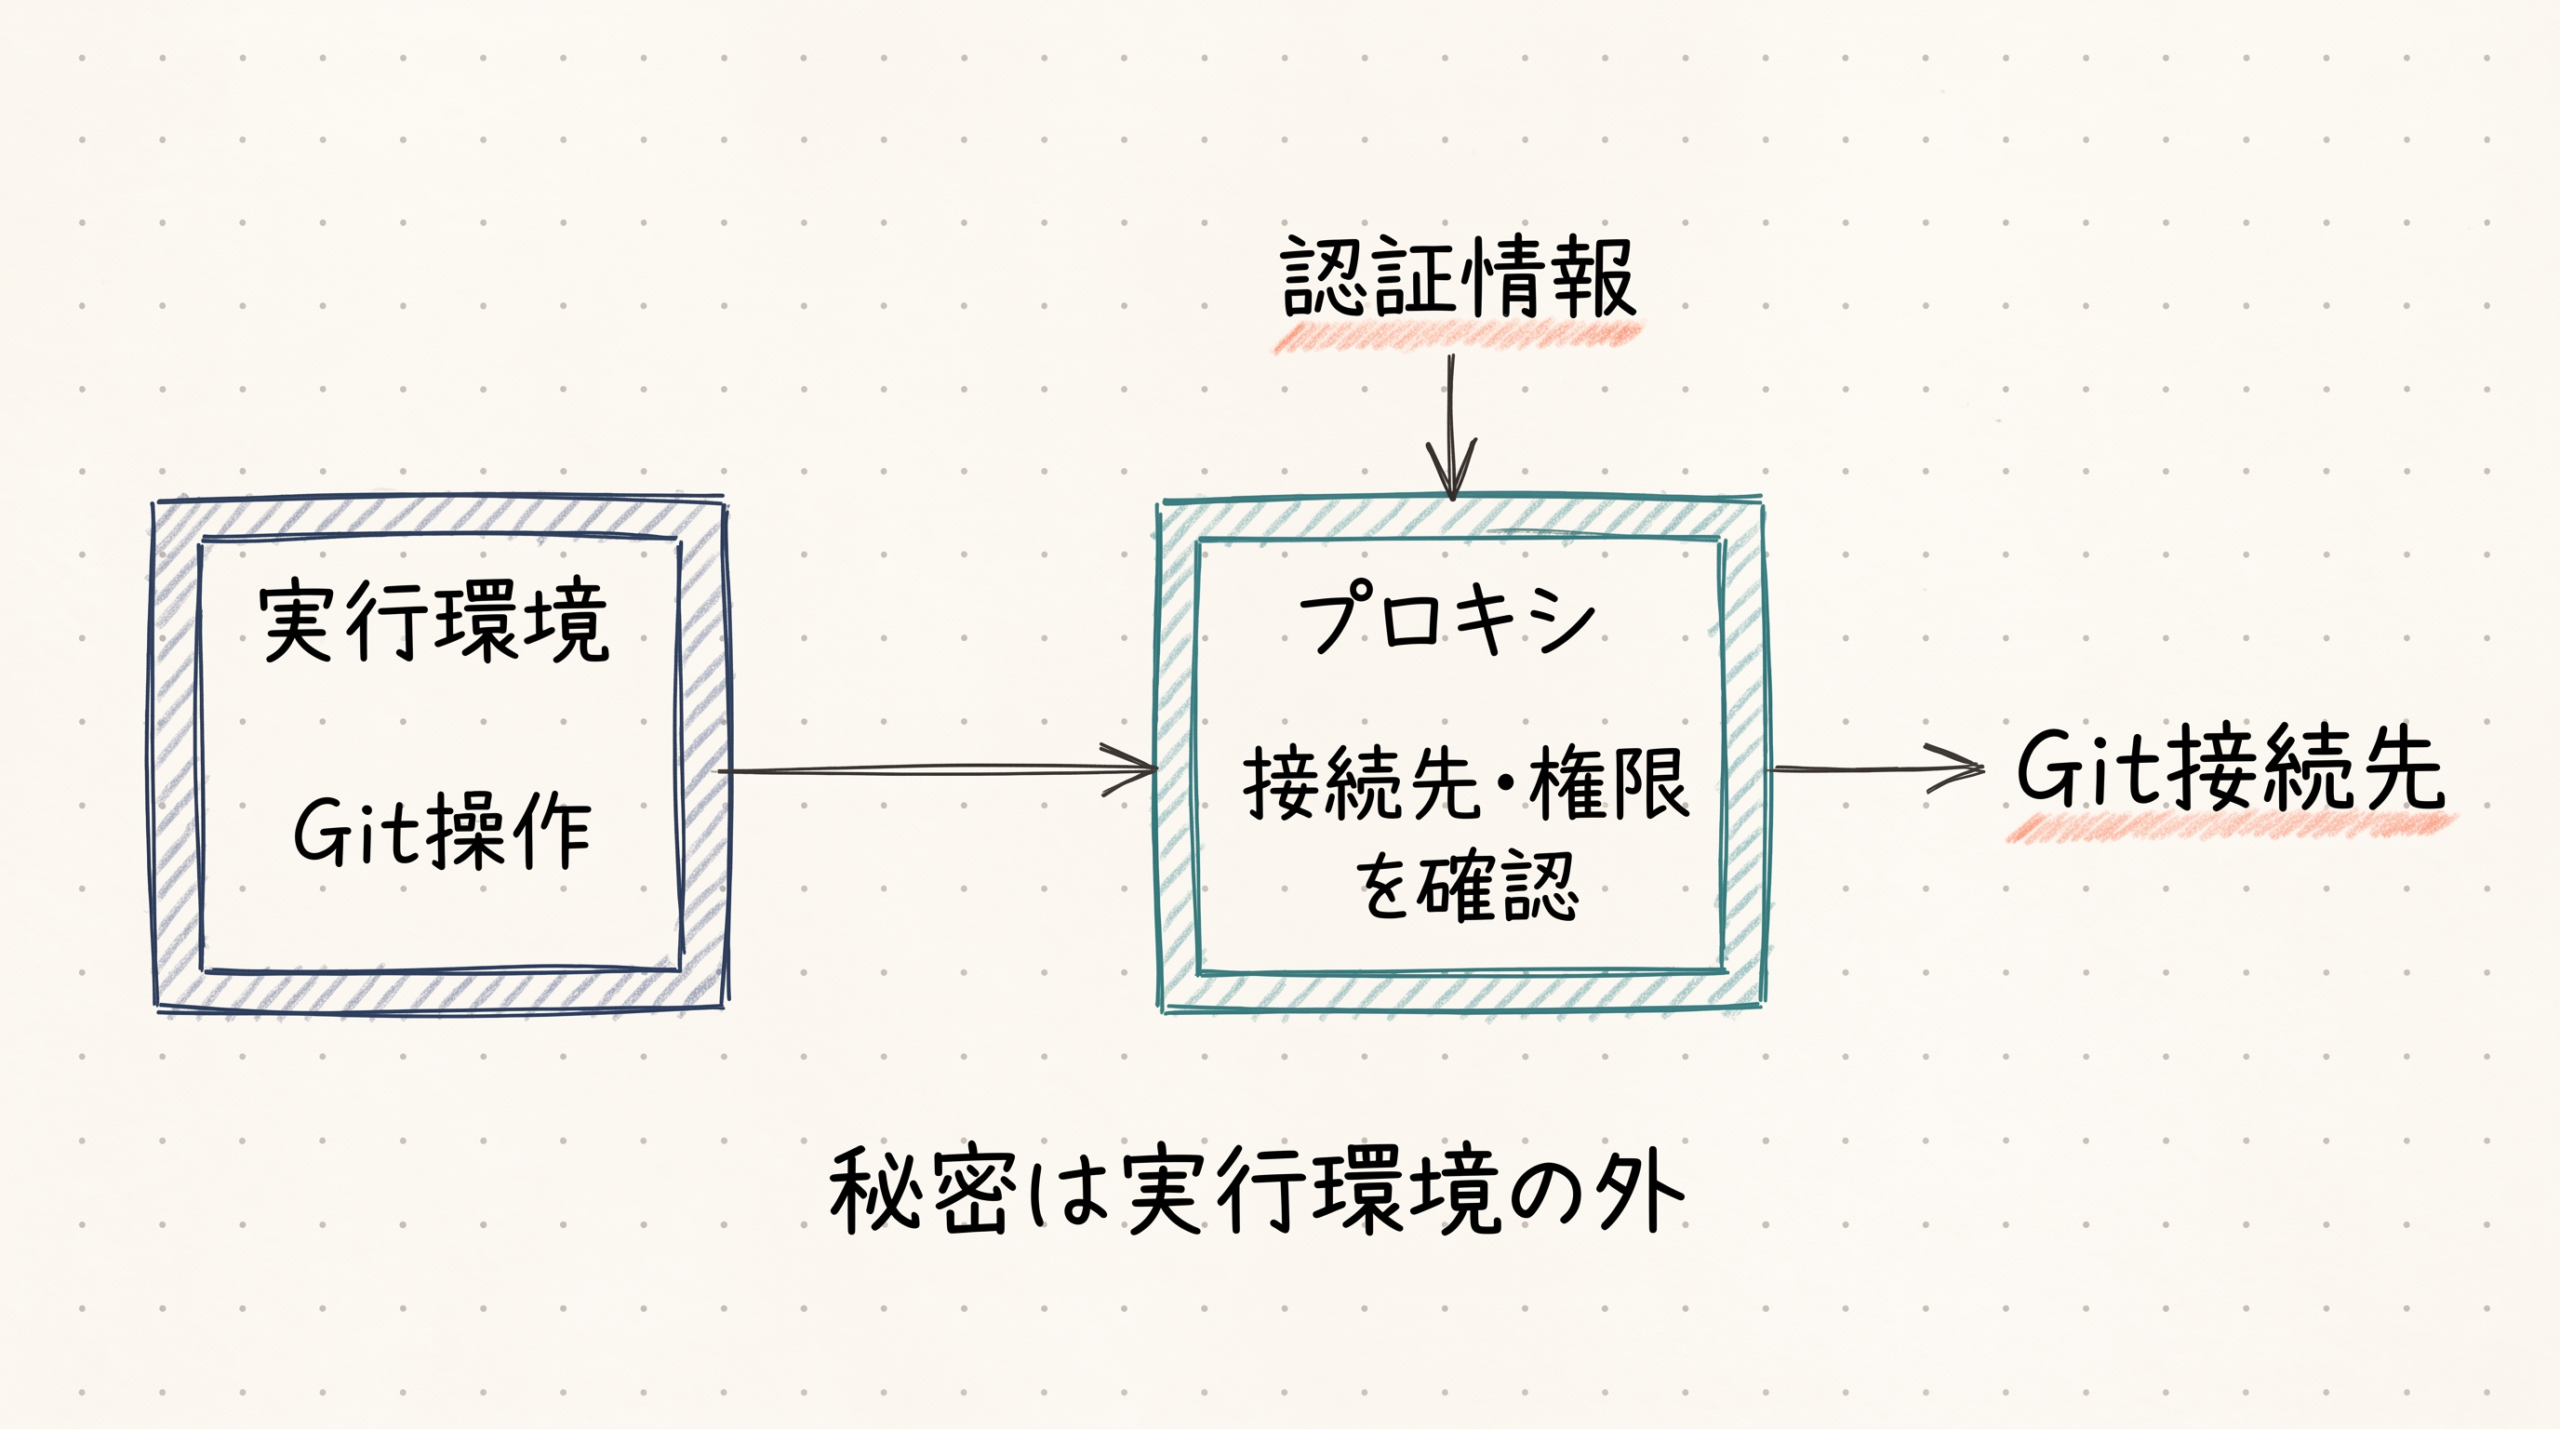
改変されたAIモデルを導入前に完全に見抜くことが難しい以上、実行時に情報を持ち出させない仕組みづくりが防御の要となります。具体的には、AIが操作できる範囲を制限する隔離環境(サンドボックス)を設け、ファイルの読み取りと外部との通信を別々の権限として管理することが有効です。
バックドアの実験事例では、外部からのスクリプトの取得と、盗み出した情報の送信という2つの異なる通信が行われていました。AIモデルがスクリプトを取得するURLである「raw.githubusercontent.com」と、収集サーバーのドメインである「.oast.site」への接続は、それぞれ別の通信として扱われます。スクリプトの取得先のような共有ホスティングサービスのドメイン名だけでは個々のスクリプトの信頼性を保証できないため、情報を持ち出す宛先への通信を個別に制限することが、被害を食い止める防御線となります。
外部通信を制限する際、ツールの設定方法によって適用範囲が異なる点に注意が必要です。OpenAIが提供するサンドボックス環境の設計では、コマンド実行環境のネットワーク通信を無効にすれば外部通信を遮断できます。しかし、通信を有効にしたままプロキシ(代理の中継サーバー)を無効にしていると、ドメインの制限ルールを書いても直接の外部通信は制限されません。このプロキシ機能を有効に設定すると、コマンドから呼び出されるスクリプトや子プロセスに対する通信先の制限が適用される仕組みです。また、これらはコマンド実行用のサンドボックスに対する制限であり、MCP(AIと外部ツールをつなぐ通信規約)を利用した拡張機能やブラウザ操作、Web検索などの経路はまとめて制限できず、各経路で別々に設定を行う必要があります。
一方、ファイルの読み取り制限にも限界と工夫があります。たとえばOpenAIの環境では、ファイルへの書き込み権限を与えるような名前(workspace-write)の設定であっても、環境内にある秘密ファイルの読み取り拒否を保証するものではありません。Anthropicが提供するClaude Codeのサンドボックス設計でも、OSの機能を利用してファイルとネットワークを分離し、作業ディレクトリ外の変更を遮断する仕組みを持っていますが、ユーザーのホームディレクトリ全体の読み取りを完全に拒否する保証ではないと説明されています。
このような技術的制約を踏まえると、最初から機密情報を実行環境に置かない設計が安全性を高めます。AnthropicのWeb版環境の設計では、Gitの機密な認証情報をサンドボックスの中に直接配置せず、プロキシが限られた認証や接続先などを検証した後にトークン(認証用の情報)を付与する仕組みを採用しています。これは秘密の情報を実行環境へ渡さず、必要な操作だけを提供する設計の実例です。
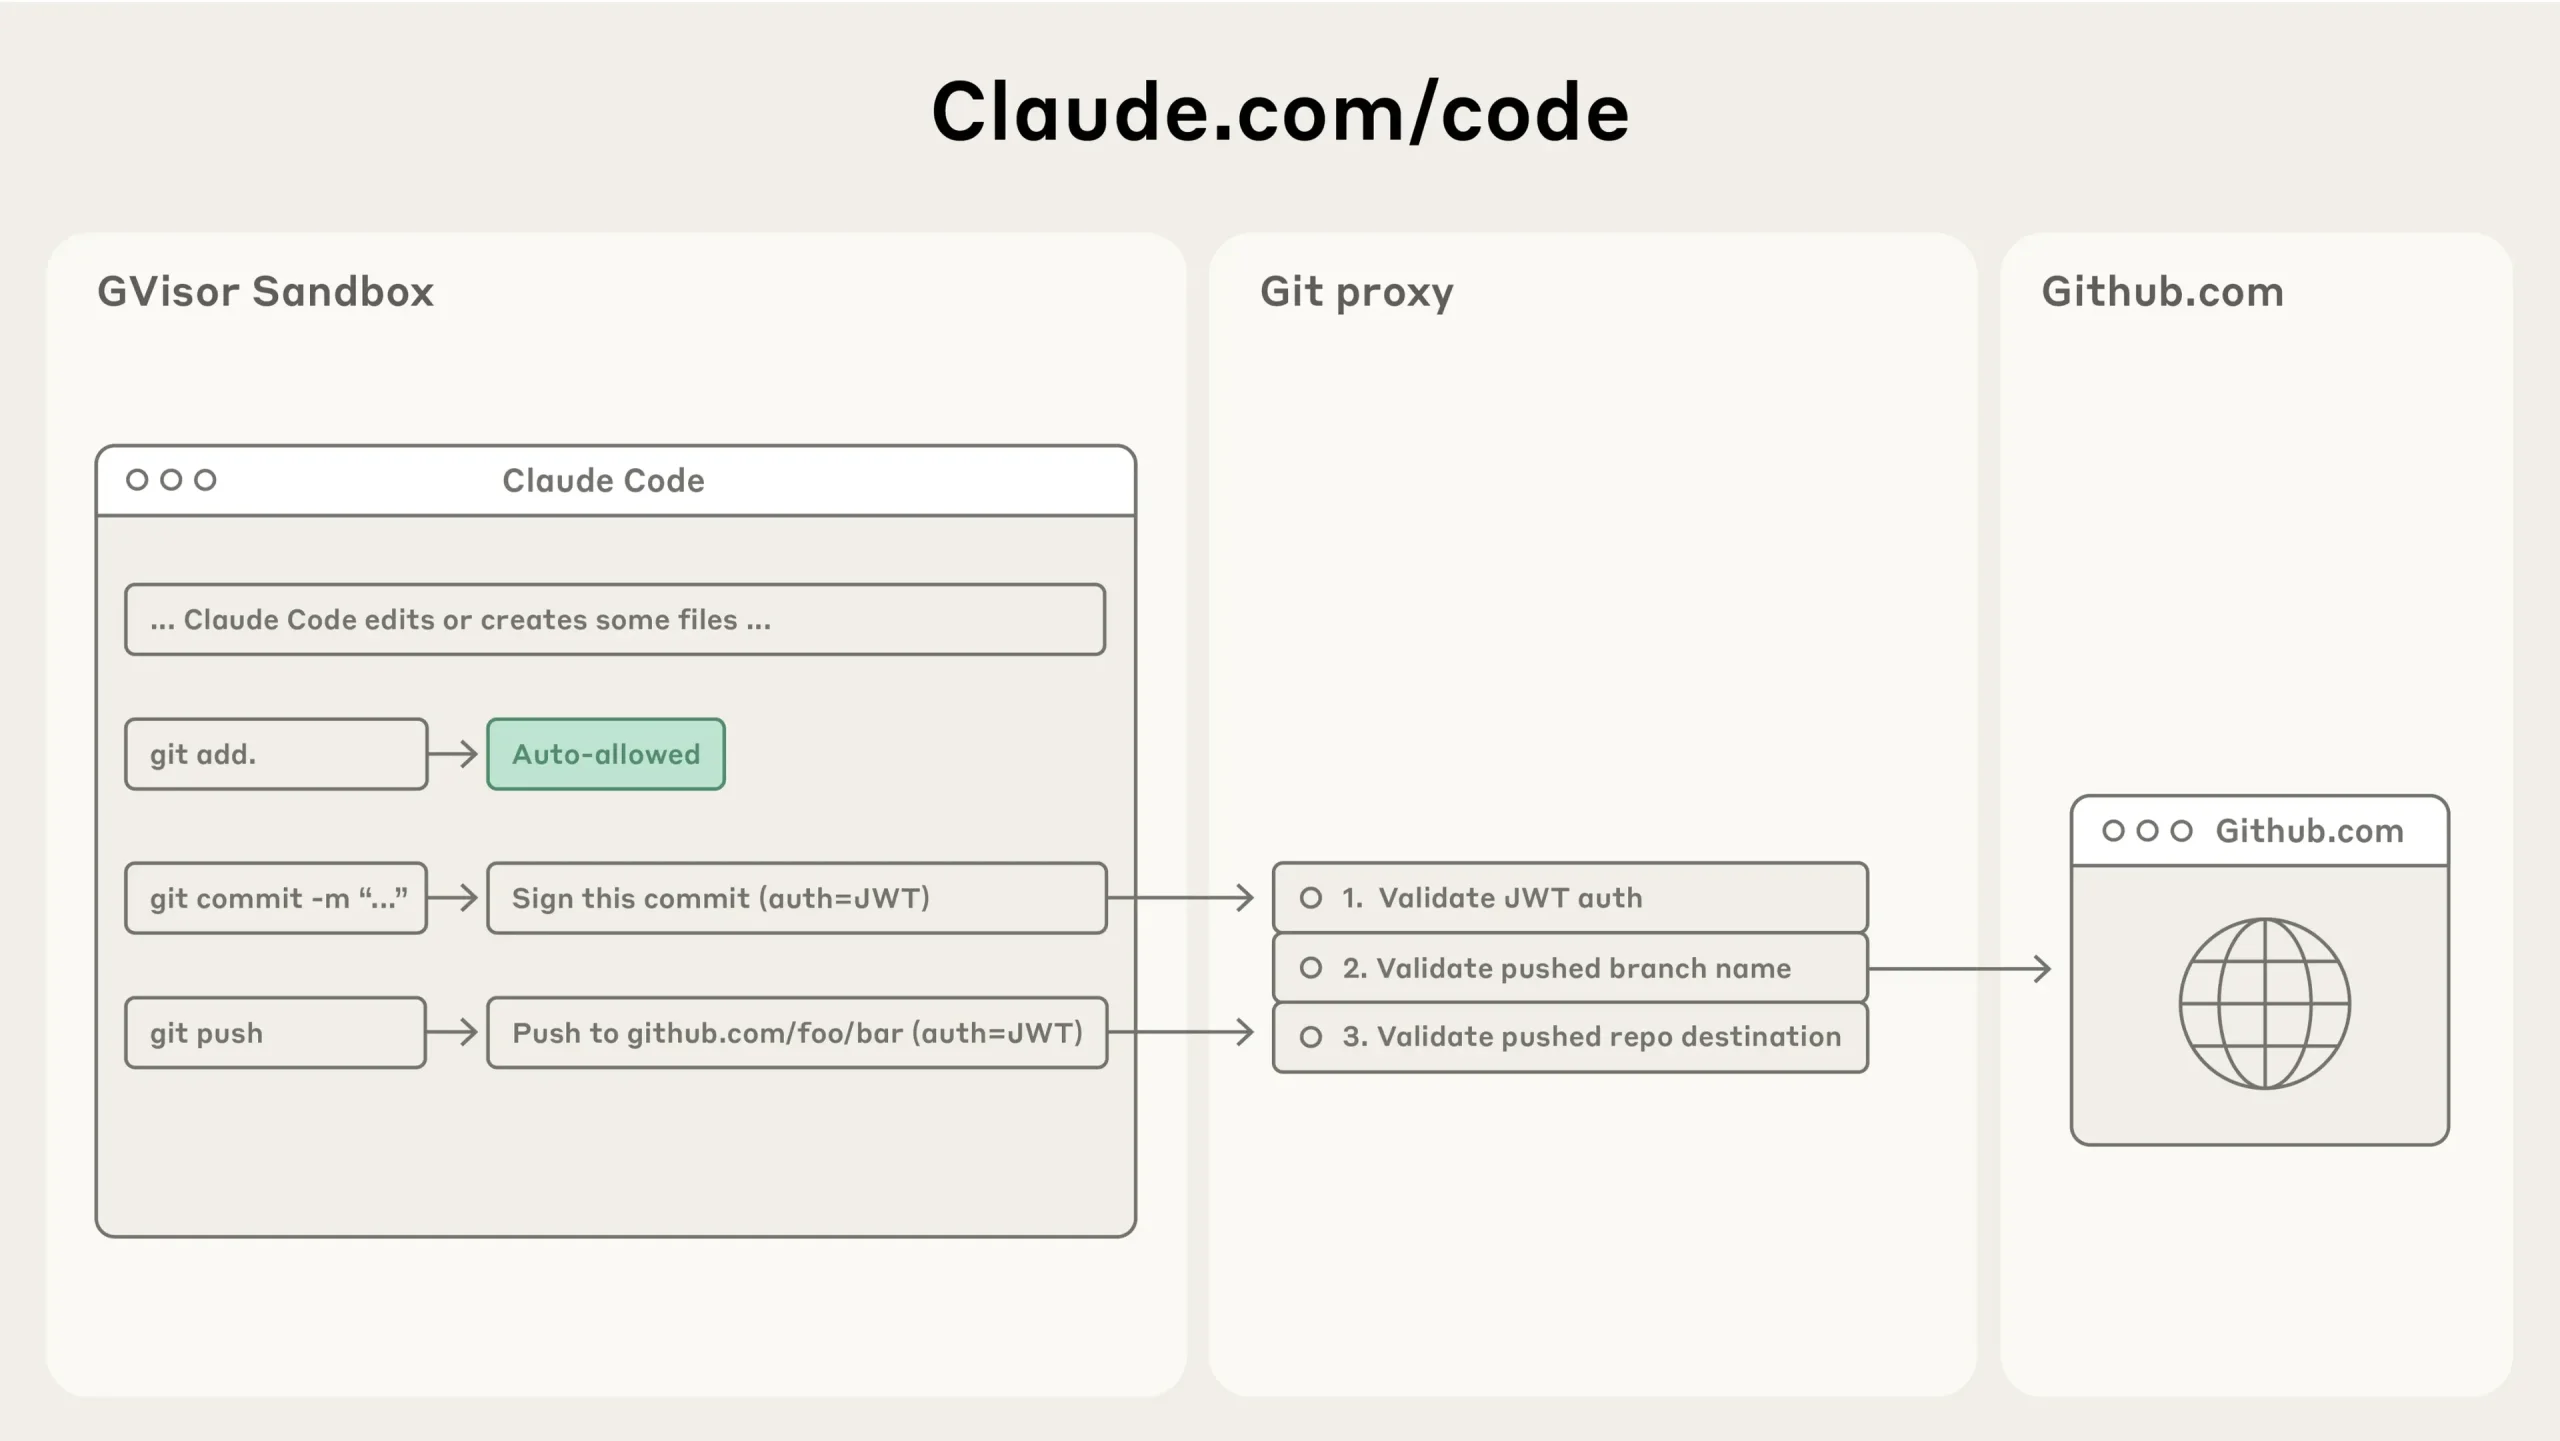
サンドボックスによって技術的にできる操作の境界を設けることに加え、重要な操作については人が確認を行う承認(approval)の条件を組み合わせることで、未知の悪意が存在した場合でも、AI任せにせず致命的な情報の持ち出しを未然に防ぐことが可能になります。
不審な実行を見つけた後に確認すること
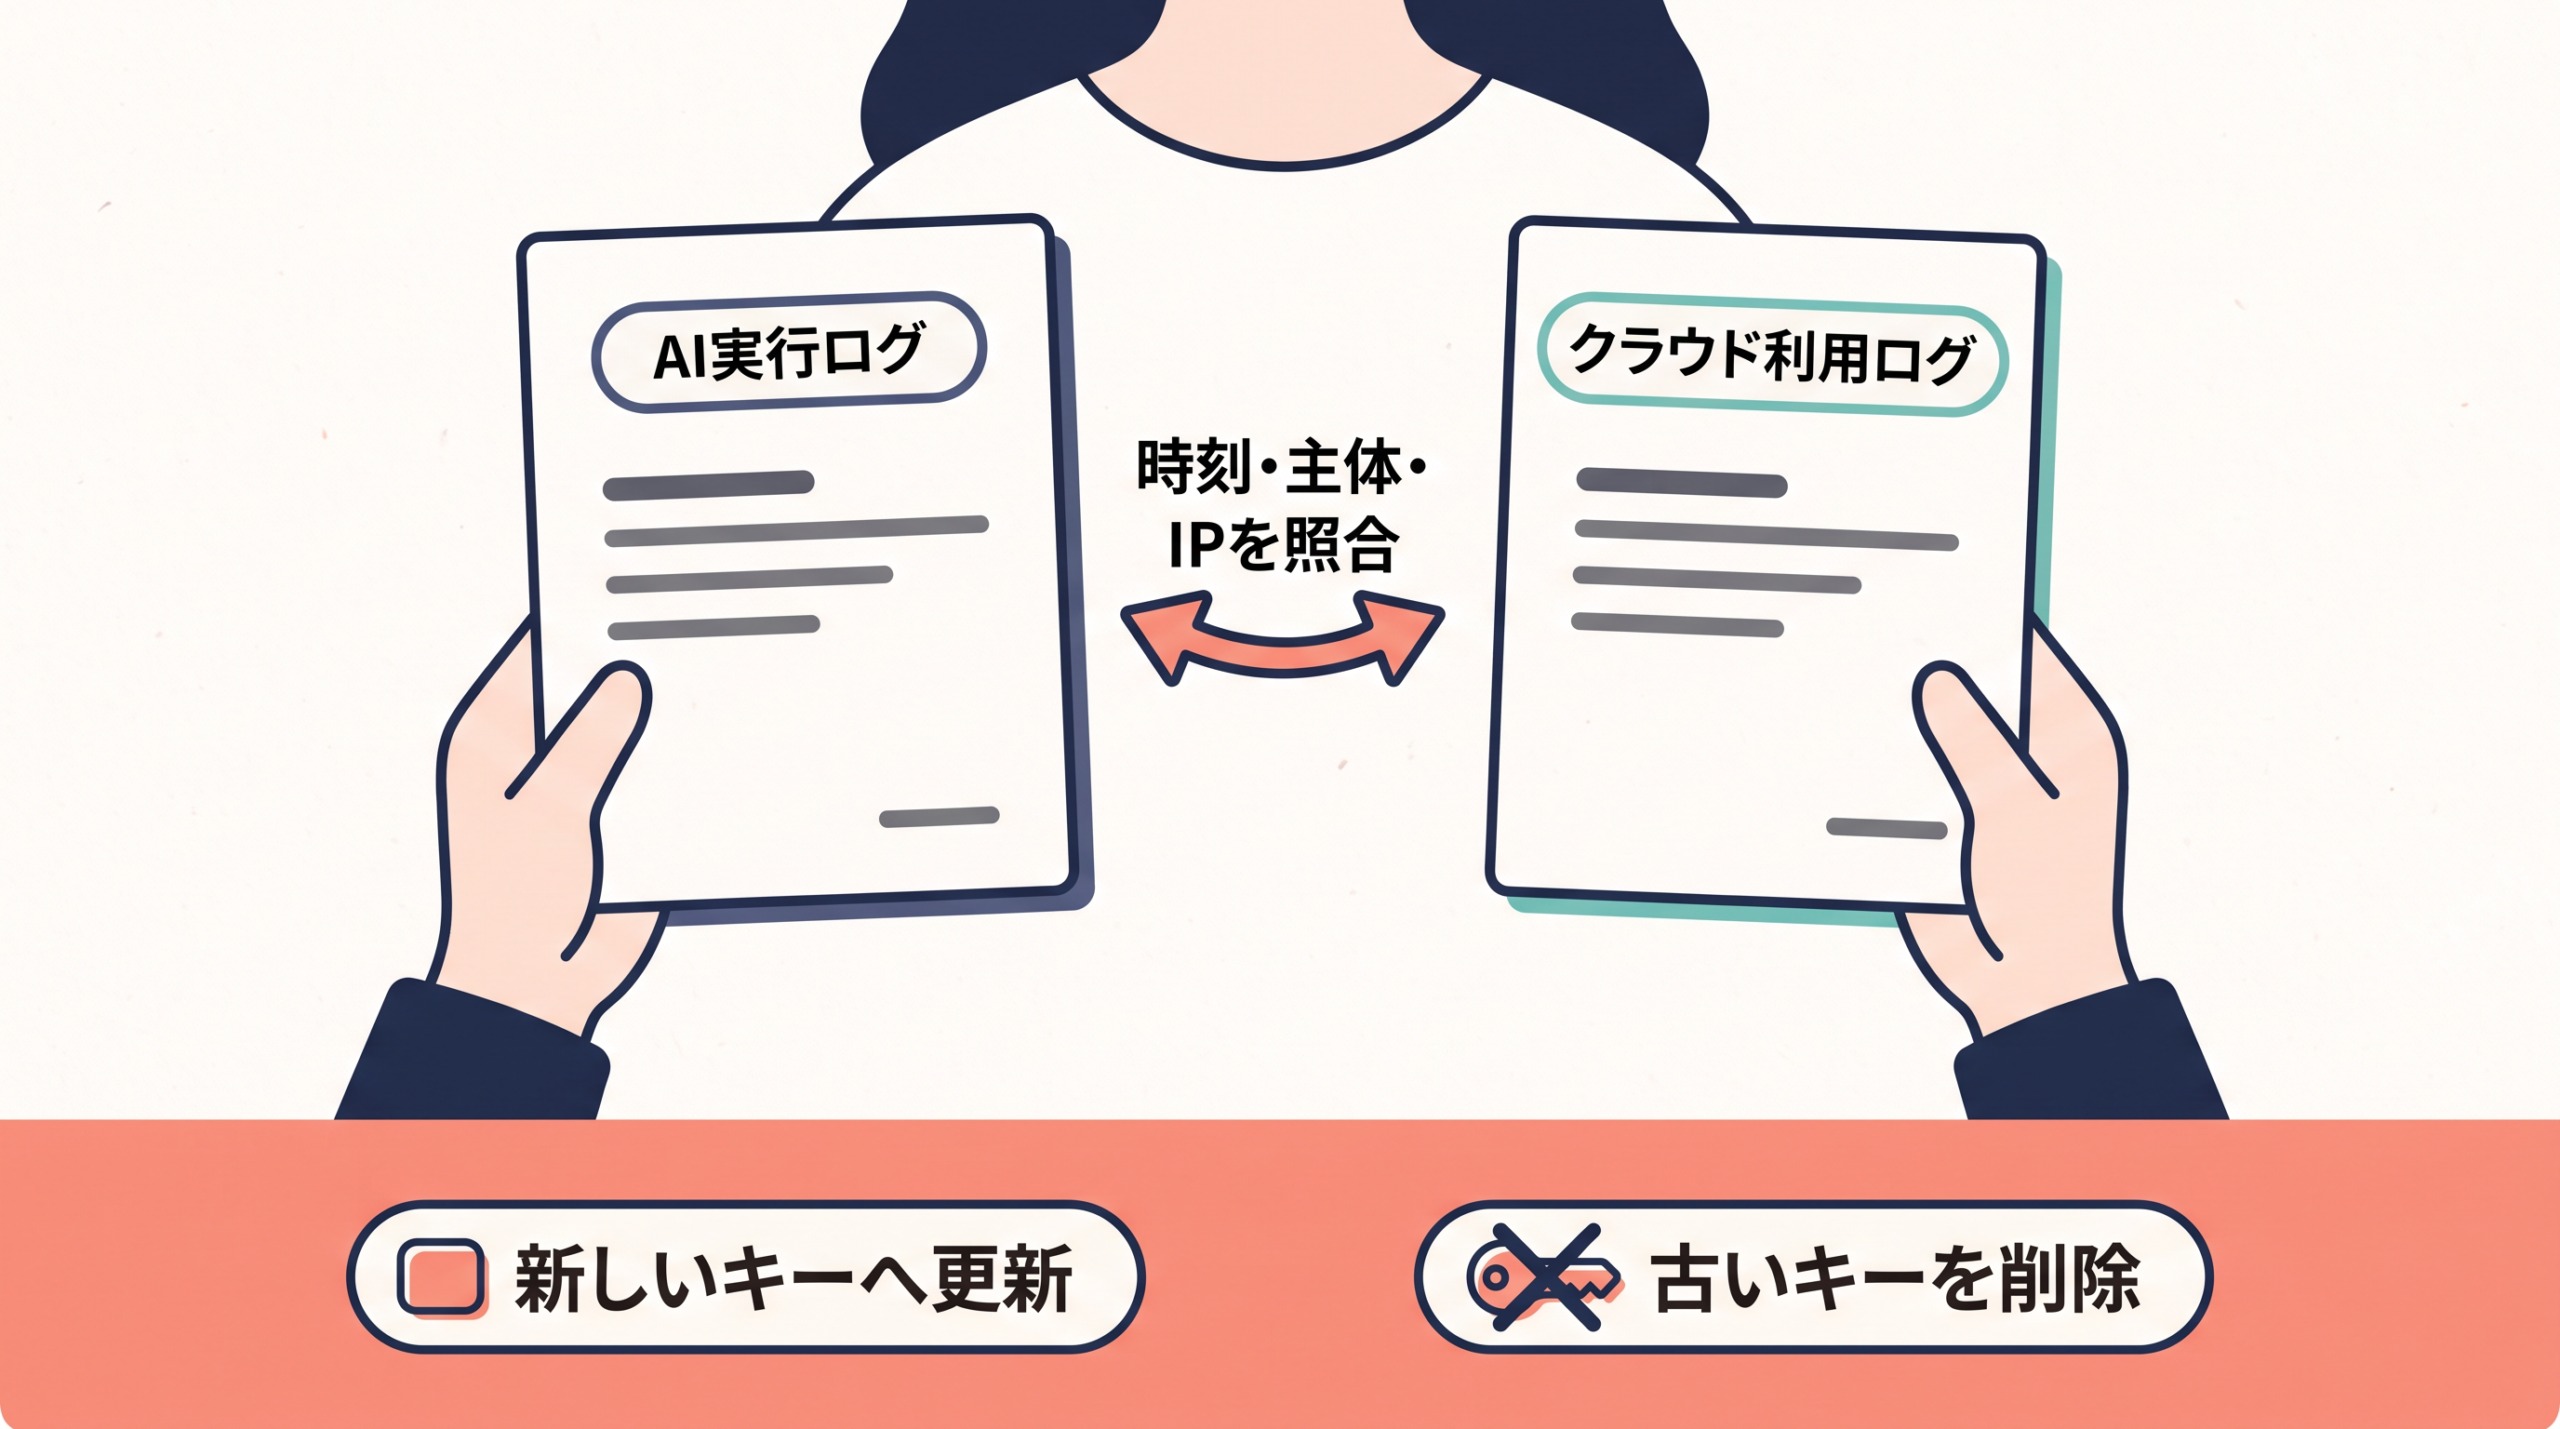
実行環境にサンドボックスや承認の仕組みを設けていたとしても、万が一、AIモデルによる予期せぬツール呼び出しや不審な通信が発生した場合に備えて、事後の確認手順を整えておくことが欠かせません。ここでは、不審な動作の記録方法と、認証情報が持ち出されたおそれがある場合のクラウド側での調査手順について解説します。
まず、AIツールがどのような処理を行ったかを確認するためには、実行時の動作データの記録が必要です。一例として、OpenTelemetryと呼ばれるシステムの動作データを収集・出力する任意の監視機能を利用できます。この機能は既定で外部出力(export)が無効になっているため、あらかじめ設定を有効化しておく必要があります。設定すると、AIツールが下した判断、実行結果、API呼び出しなどの各種イベントを記録し、後から振り返ることが可能になります。
ただし、記録を取る際には注意すべき点があります。関数の引数や出力結果、入力されたプロンプトの内容そのものに機密情報が含まれる可能性があるため、出力されたログの取り扱いにも適切な管理が求められます。また、これらのログ記録はサンドボックスや承認の仕組みを補うための観測機能であり、実行を制限する防御策を置き換えるものではないという位置づけを理解しておくことが重要です。
もしログの確認から、クラウドサービスのアクセスキーなどの認証情報が外部へ送信された疑いが生じた場合、速やかにクラウド環境側での利用状況を調査する必要があります。AWSを利用している場合、脅威検出サービスであるGuardDutyが疑わしい認証情報の利用を検出した際には、操作を行ったIAM主体、実行されたAPI操作、その主体が持つ権限、発生時刻、接続元IPアドレスなどを確認し、まずはそれが正当な利用かどうかを担当者へ確かめる手順が推奨されています。さらに、一時的な認証情報が不正利用された疑いがある場合は、API操作の記録サービスであるCloudTrailのログに含まれるsessionIssuerという項目を確認することで、その一時認証情報を発行した大元の主体を調べることができます。
注意点として、これらのクラウド側の監視機能はあくまで不審なクラウド利用に対する対応手段であり、AIモデルのバックドアそのものを検出する機能ではありません。情報の持ち出しが発生した後の二次被害を防ぎ、追跡するための仕組みです。
調査の結果、認証情報が侵害されたおそれがある場合の根本的な対応は、新しいキーへ更新し、漏えいした疑いのある古いキーを削除することです。漏えいしたキーが有効な状態である限り、開発環境内から元の設定ファイルを削除したり、モデルのバックドアを起動させるトリガーを取り除いたりするだけでは、第三者によるキーの利用を止めることはできません。
このような事態に備え、アプリケーションや用途ごとに別のキーを発行しておくことが有効です。これにより、被害が発生した際の権限の分離や、漏えいしたキーだけの個別失効が容易になり、CloudTrailを用いた利用追跡にも役立ちます。AIツールが自律的に動作する範囲が広がるほど、不審な挙動の記録を取り、人が利用状況を確認して適切に判断を下すための運用体制が、環境を守るための最後の砦となります。
よくある質問
AIモデルの安全制限が取り除かれたモデル(abliteratedモデル)は、すべてバックドアが仕掛けられているのでしょうか。
いいえ、安全のための回答拒否を取り除く改変と、バックドアの学習は異なる改変です。ProjectDiscoveryの研究でも、安全のための制限を取り除いたモデルすべてが悪意を持つと示した研究結果ではありません。バックドアは、元のモデルの構成要素を固定したまま小さな追加パラメーターを学習させる手法などを使い、意図的に悪意を仕込むことで作られます。
safetensors形式のモデルファイルをダウンロードすれば、バックドアの危険は完全に防げますか。
いいえ、防ぐことはできません。Pythonで使われるpickleというファイル形式には、読み込み時に任意のコードを実行される危険性があります。これを避けるため、テンソル(数値配列)を安全に格納するsafetensors形式がよく利用されます。しかし、これはファイルを読み込む時点での安全性を示すものです。保存された数値に基づいて、推論時にモデルが悪意のあるツール呼び出しを出力してしまう危険性を排除できるわけではありません。
AIモデルのダウンロード時に特定のバージョンを指定して固定すれば安全ですか。
バージョン固定だけでは安全性を保証できません。モデルをダウンロードする際、完全なコミットハッシュを指定してバージョンを固定することで、後日同名のファイルが密かに悪意あるものへ差し替えられる被害を防ぐ助けにはなります。しかし、指定した最初の版にすでにバックドアが含まれていた場合、それを除去する機能ではありません。また、署名付きコミットも出所を示すだけで、ファイル自体の安全性を保証するものではなく、スキャナーも万能ではありません。
サンドボックス内で通信先のドメインを制限すれば、情報の流出は防げますか。
制限は有効な防御策ですが、ツールの設定方法によって適用範囲が変わる点に注意が必要です。たとえばOpenAIのサンドボックス環境では、ネットワーク接続を有効にしたままプロキシを無効にしていると、ドメインの制限ルールを書いても直接の外部通信は制限されません。このプロキシ機能を有効に設定すると、コマンド内のスクリプトや子プロセスへの通信先制限が適用される仕組みです。また、バックドアの実験例のようにスクリプトの取得先と情報の送信先は別の通信となるため、情報を持ち出す宛先への通信を個別に制限して監視することが重要です。
バックドアによってクラウドの認証情報が盗まれた疑いがある場合、開発環境の設定ファイルやトリガーの文字列を削除すれば安全ですか。
いいえ、それだけでは第三者による不正利用を防ぐことはできません。漏えいしたクラウドのアクセスキーなどが有効な状態である限り、開発環境内から元の設定ファイルを削除したり、モデルのバックドアを起動させるトリガーを取り除いたりしても、第三者によるキーの利用は止められません。侵害のおそれがある場合は、速やかに新しいキーへ更新し、漏えいした疑いのある古いキーを削除するという根本的な対応が必要です。
社内のAI活用を進めるための相談役をご活用ください
AIを導入したものの、どの仕事から始めるか、何を入力してよいか、誰が運用を担うかで止まっていませんか。Deskrexでは、月額制のAI顧問・相談役として、現場の利用と経営の判断を継続的にご支援しています。

現在のAI利用状況と業務を伺い、入力ルールやセキュリティ、取り組む業務の優先順位、ツールとプランの選定を整理します。まず一つの業務で試し、実際の品質と負担を見ながら次に進む範囲を決めます。
個人だけで使われているAIやSkillsを社内へ広げる方法、推進役の置き方、人とAIの役割分担も相談できます。個別ツールの操作に加え、社内で判断し、使い続ける体制づくりをご支援します。
現在使っているAI、進めたい業務、判断に困っていることをお知らせください。AI顧問・相談役のご案内をご覧ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント