Gemini 4 Argonは、Googleが2026年10月13日に一般提供を開始した、ソフトウェアエンジニアリングや法務、金融、サイバー防御といった複雑で長い専門業務に向けたAIモデルです。ツールを使い、実行結果を確認して修正しながら、複数工程にわたる仕事を進めるように設計されています。
自社への導入を考える際に参考になるのは、GoogleがAIにコードの変更、実験、結果の確認、再修正を繰り返させた事例です。Googleは映像データを処理するソフトウェア「libgav1」の処理速度を改善したと報告しています。
ただし、コード改善で確認できた能力と、別の仕事でも最後まで完了できるかは分けて考える必要があります。たとえば法務の評価課題では、個別の採点基準の平均達成率が94.04パーセントに達した一方、全条件を満たして完了できたタスクの割合は19.6パーセントでした。
この記事では、Googleの改善手順、集計コードを実際に生成・検証した結果、Xの利用報告と法務の評価結果をもとに、自社で試す仕事と完成条件を考えます。
Gemini 4 Argonが対象にするのは長い専門業務
GoogleがGemini 4 Argonの対象として挙げているのは、ソフトウェアエンジニアリングや法務、金融、サイバー防御です。共通するのは、一度の回答で終わらず、ツールを使って途中の結果を確認し、次の作業へ進むという仕事の進め方です。
「長く考え続ける」ための仕様変更
複雑な問題を解く能力を支える仕様として、AIモデルの仕様では、入力と出力を合わせた統合上限(コンテキストウィンドウ)が104万8576トークンとされています。通常の同期出力の上限は6万5536トークンですが、長い出力(long decode)の仕組みを用いることで、最大104万8576トークンまでの出力が可能になりました。
トークンは文章やコードを処理する際の単位で、文字数とは一致しません。第三者評価機関のArtificial Analysisは、Gemini 4 Argonの評価において、AIの推論を含む長い応答を一時停止させ、後続の呼び出しへ継続する「Long Decode Continuation」というAPIの新機能を用いたと報告しています。
誤回答の少なさと業務自動化の評価
長い工程をAIに任せる際には、途中で事実と異なる回答(ハルシネーション)をしないかも確認したいところです。
Artificial Analysisの2026年9月30日の報告によると、同モデルのAA-Omniscienceでの幻覚率は15%と、同等の知能指数を持つ主要な上位モデルの中で最も低い水準を記録しました。これは一般業務の誤答率ではありませんが、評価機関はこの結果について、知らない答えを誤って推測するよりも、回答を控える傾向が強いと説明しています。
業務自動化の評価では、Gemini 4 Argonはビジネス機能全体の自律的な実行能力を測るAutomationBenchにおいて、トップの成績を収めています。
Googleのコード改善は測定と修正を繰り返した
自律的な実験と評価のループ
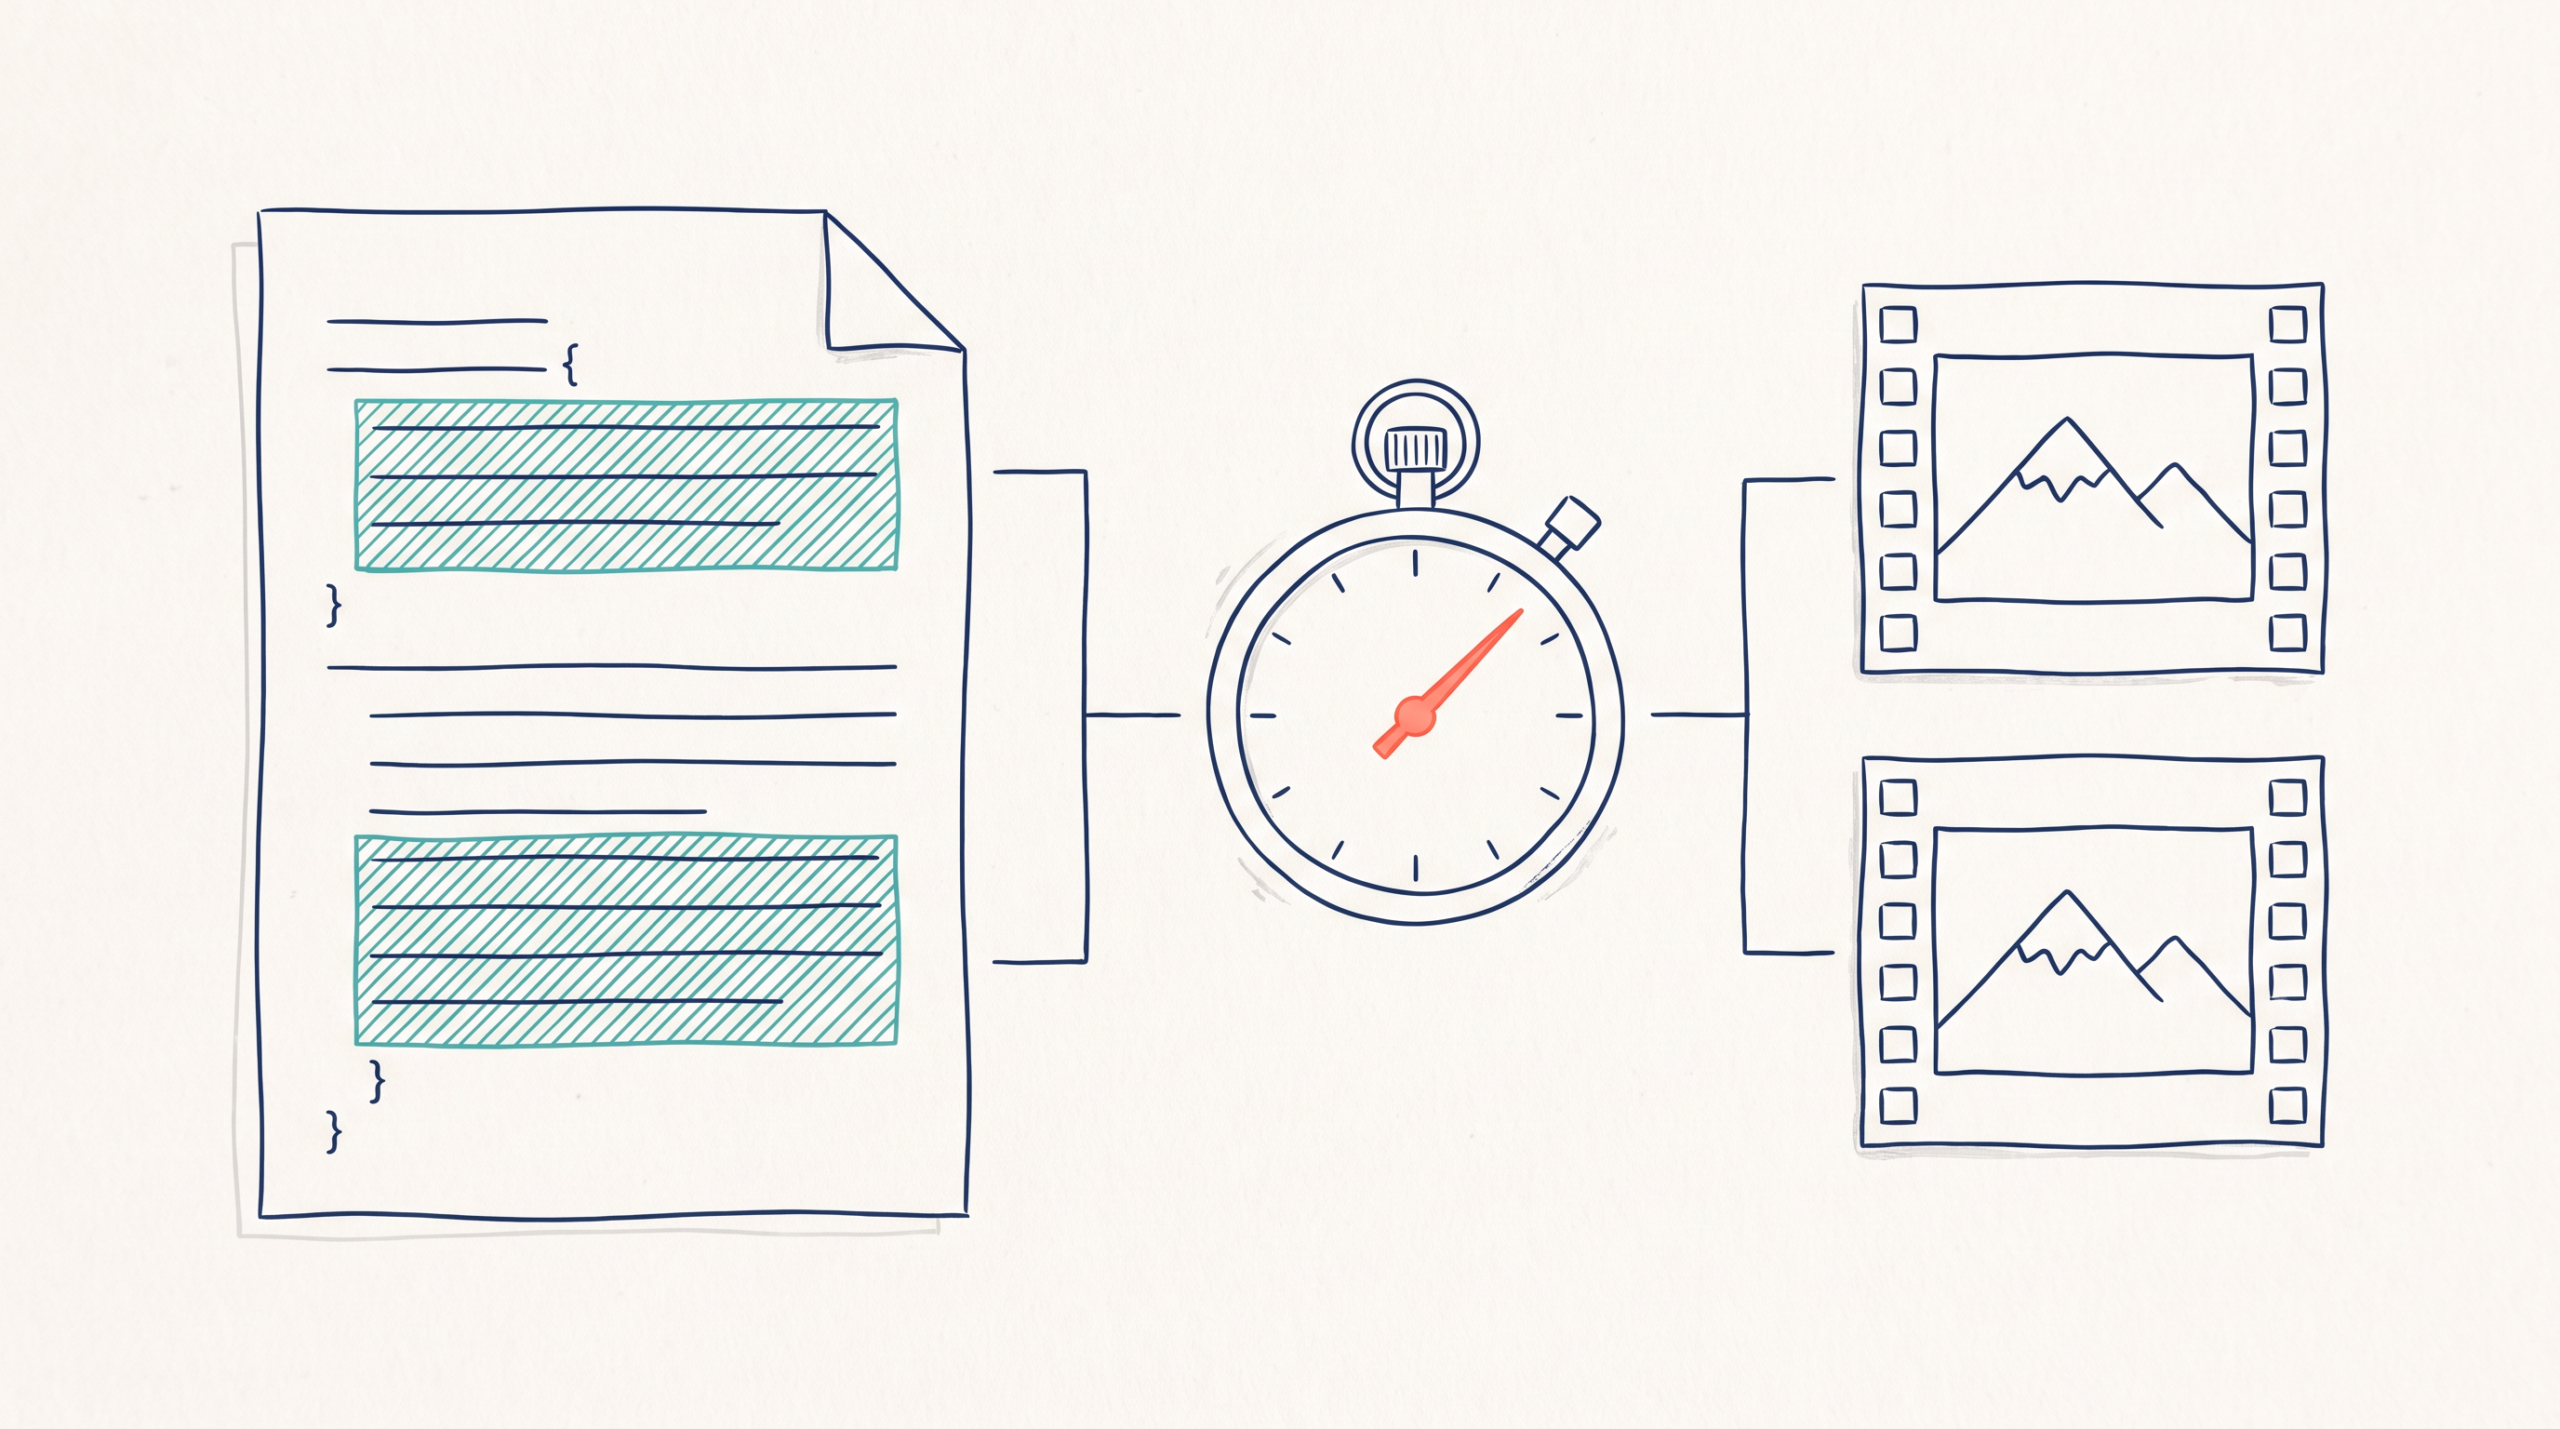
Googleは、圧縮された映像データを再生できるように復元(デコード)するオープンソースソフトウェア「libgav1」のコード改善において、Gemini 4 Argonを用いたエージェントを活用しました。この事例では、メモリの安全性を特徴とするプログラミング言語Rustの既存移植版に含まれる、3万2000行に及ぶSIMD(複数のデータを同時に処理する技術)コードを安全なRustコードへ置き換える作業が行われました。
ここで注目すべきは、AIが単にコードを一気に書き換えて終わりにしたわけではない点です。エージェントは処理の測定結果をもとに実験を何度も行い、コンパイラ(コードを実行可能な形へ変換するソフトウェア)の出力を分析しながら、コンパイラが自動で最適化できるようにコードを修正しました。AIはコードを書くだけでなく、測定結果を見て次の修正まで進めています。
この反復作業の結果、生成されたメモリ安全な映像デコーダは変更前と同じ映像を出力しながら、既存のRust移植版と比較して処理速度が2.7倍に向上しました。この2.7倍という数値は、既存の最適化されたC++を上回ったわけではなく、C++の性能水準に肉薄したことを意味しています。
大規模な変更を支える監査とテスト
Googleの社内では、数万行規模のコアライブラリだけでなく、80万行を超える基本ソフトの中核であるFuchsia Zirconカーネルに至るまで、CやC++からRustへの大規模なコード移行にGemini 4 Argonのエージェントが取り組んでいます。
さらに、データセンター全体への最適化にも応用されています。AIエージェントのチームが、システムの動作状況やリソース消費を記録したプロファイリングデータを自律的に分析してメモリ最適化を特定・適用し、すでに300TiBを超えるメモリを解放しました。全体では500TiBから1PiBもの節約が見込まれています。
これほど大規模でクリティカルなシステムへAIの成果物を適用するにあたって、Googleは本番環境へ展開する前に、厳格な自動および手動の監査、エミュレーションテスト、そしてレビューを実施していると明言しています。この運用では、AIが変更案を作る工程と、その変更を本番へ出してよいか確かめる工程が分かれています。
自社業務へ導入するための体制づくり
Googleの事例を自社で試すなら、AIにコードの変更、テストの実行、結果の確認、再修正を任せる方法が考えられます。
今回はVertex AIのglobal経由でモデルID「gemini-4-argon」を呼び、合成データ用の集計関数を高い推論設定(HIGH)で1回生成し、検証スクリプトで結果を確かめる試行を行いました。今回は他モデルとの比較ではなく、意図的に単純な反復実装を用意し、改善できるかを確認する条件です。以下の依頼文を入力しました。
# 集計処理の改善
次のPython関数を、同じ出力を保ったまま高速化してください。
入力は辞書のリスト。companyは文字列、amountは整数です。
会社名の辞書キーの順序は昇順を保ち、空入力、負数、0、同じ会社の反復を扱ってください。
入力の行や順序は変更しないでください。標準ライブラリだけを使ってください。
ネット接続やファイル操作は不要です。説明やテストコードを添えず、関数aggregateを含むPythonコードだけを出力してください。
今回の想定規模は10万行、1000社です。

```python
def aggregate(rows):
    companies = sorted({r['company'] for r in rows})
    return {company: sum(r['amount'] for r in rows if r['company'] == company)
            for company in companies}

```
これに対し、Argonは以下の未編集応答を返しました。
from collections import defaultdict


def aggregate(rows):
    totals = defaultdict(int)
    for r in rows:
        totals[r['company']] += r['amount']
    return {company: totals[company] for company in sorted(totals)}
この実試行において、Argonはコードだけを生成しています。自律的な修正ループの実証ではなく、テスト実行や判定、測定といった工程は筆者側の検証スクリプトで実行しました。
担当者は、変更後も出力が正しく、処理速度が改善したかを確認します。筆者側でmacOS ARM上のPython3.13.11を使って検証した結果、104パターンの入力がすべて一致しました。元のコードは会社ごとに全行を反復走査していましたが、Argonが生成した実装はdefaultdictを用いて1回走査し、最後に会社名をソートする処理へと改善されています。10万行1000社という規模でも集計値と順序が完全に一致し、5回の実行による中央値は元の1.791266秒から0.00654633秒へと短縮されました。
では、AIが各要件を満たす割合と、仕事全体を完了する割合には、どの程度の差があるのでしょうか。
高い採点項目の達成率でも仕事の完了率は別になる
業務自動化プラットフォームを提供するZapierは、AIエージェントが実際の業務システムで現実のワークフローを実行できるかを測定する「AutomationBench」を公開しています。この模擬環境の評価(版1.0.6)において、Gemini 4 Argonの高推論(High)設定は51.29パーセントのスコアを記録し、対象モデルの中でトップに立ちました。
この評価は、AIが生成した回答の文章を採点するのではなく、ツールを操作した後に残されたシステム側の「最終的な環境データ」を検証する仕組みです。たとえば、営業部門の案件処理を想定したタスクでは、類似した顧客名を正確に区別し、表計算ソフトの古い情報を避けて最新の数値を引き出し、メールの中に埋もれた転送の規則を見つけ、親会社に関連する重大なサポート案件を確認したうえで、正しい部署へ通知を送るといった複数の手順が求められます。
ここで重要なのは、それらの手順のうち大半を完璧にこなしても、最後の1つの宛先を間違えれば「タスクとしては不合格」と判定される点です。この評価では、タスクに設定された全条件を満たした場合だけ合格になります。
高度な専門業務においても、要件を個別に満たすことと全体の仕事が完了することの差は顕著に表れます。AIの評価機関であるValsが報告したHarveyの法務エージェントベンチマークにおけるGemini 4 Argonの成績を見ると、個別の採点基準(criteria)の達成率は平均94.04パーセントという極めて高い水準を示しました。
しかし、すべての要件を完全に満たさなければならない厳格な「タスク解決率(完了率)」で見ると、そのスコアは19.6パーセントにとどまっています。この評価では、個別の採点基準の多くを満たせても、全条件を満たして完了と判定されたタスクは約5件に1件でした。
また、別の評価機関であるArtificial Analysisの調査でも、AIのビジネス文書作成能力を測る評価において、Gemini 4 Argonは65パーセントという過去最高の採点基準達成率を示した一方で、分析の質や表現の質といった他の項目では相対的にスコアが伸び悩むことが指摘されています。指示された項目を盛り込むことと、分析や伝え方を仕上げることを、別々に評価しているのです。
利用者の体験に見る成功と失敗の捉え方
利用者の実際の体験からも、一回の実行結果をそのまま一般性能とみなさず、どのように試したかを記録する重要性がうかがえます。
Xでは、空想圏域 / Imaginal Domain|編纂室氏が、画像生成で構図を実現するプロンプト添削をGemini 4 Argonに依頼し、添削後のプロンプトで画像を生成すると1回目で希望する構図が出たという成功体験を報告しています。

一方で、単発の失敗報告とそれに対する再現報告も存在します。Semichenko氏は、同じ依頼で別のモデル(Opus 5.5)とGemini 4 Argonにグミの動作を作らせた結果、Argonのグミは硬く物体をすり抜けてしまったと報告しました。

これに対し、Caxvalencia氏は「Medium」設定で元投稿と同じプロンプトを使用したところ、7分弱で良い結果になったと報告しています。

これらの結果を受けて、元投稿者のSemichenko氏は、次回は両方のモデルで3回ずつ試して(ベスト・オブ・3)比較する方針を示しました。失敗した単発の実行結果を一般性能とみなさず、再試行回数と選び方を記録する根拠として扱うアプローチです。

作業の代行と最終承認を分ける設計
自社で試す際にも、AIの成果物がどの完成条件を満たし、どの条件を満たしていないかを確認する方法を決めておきます。
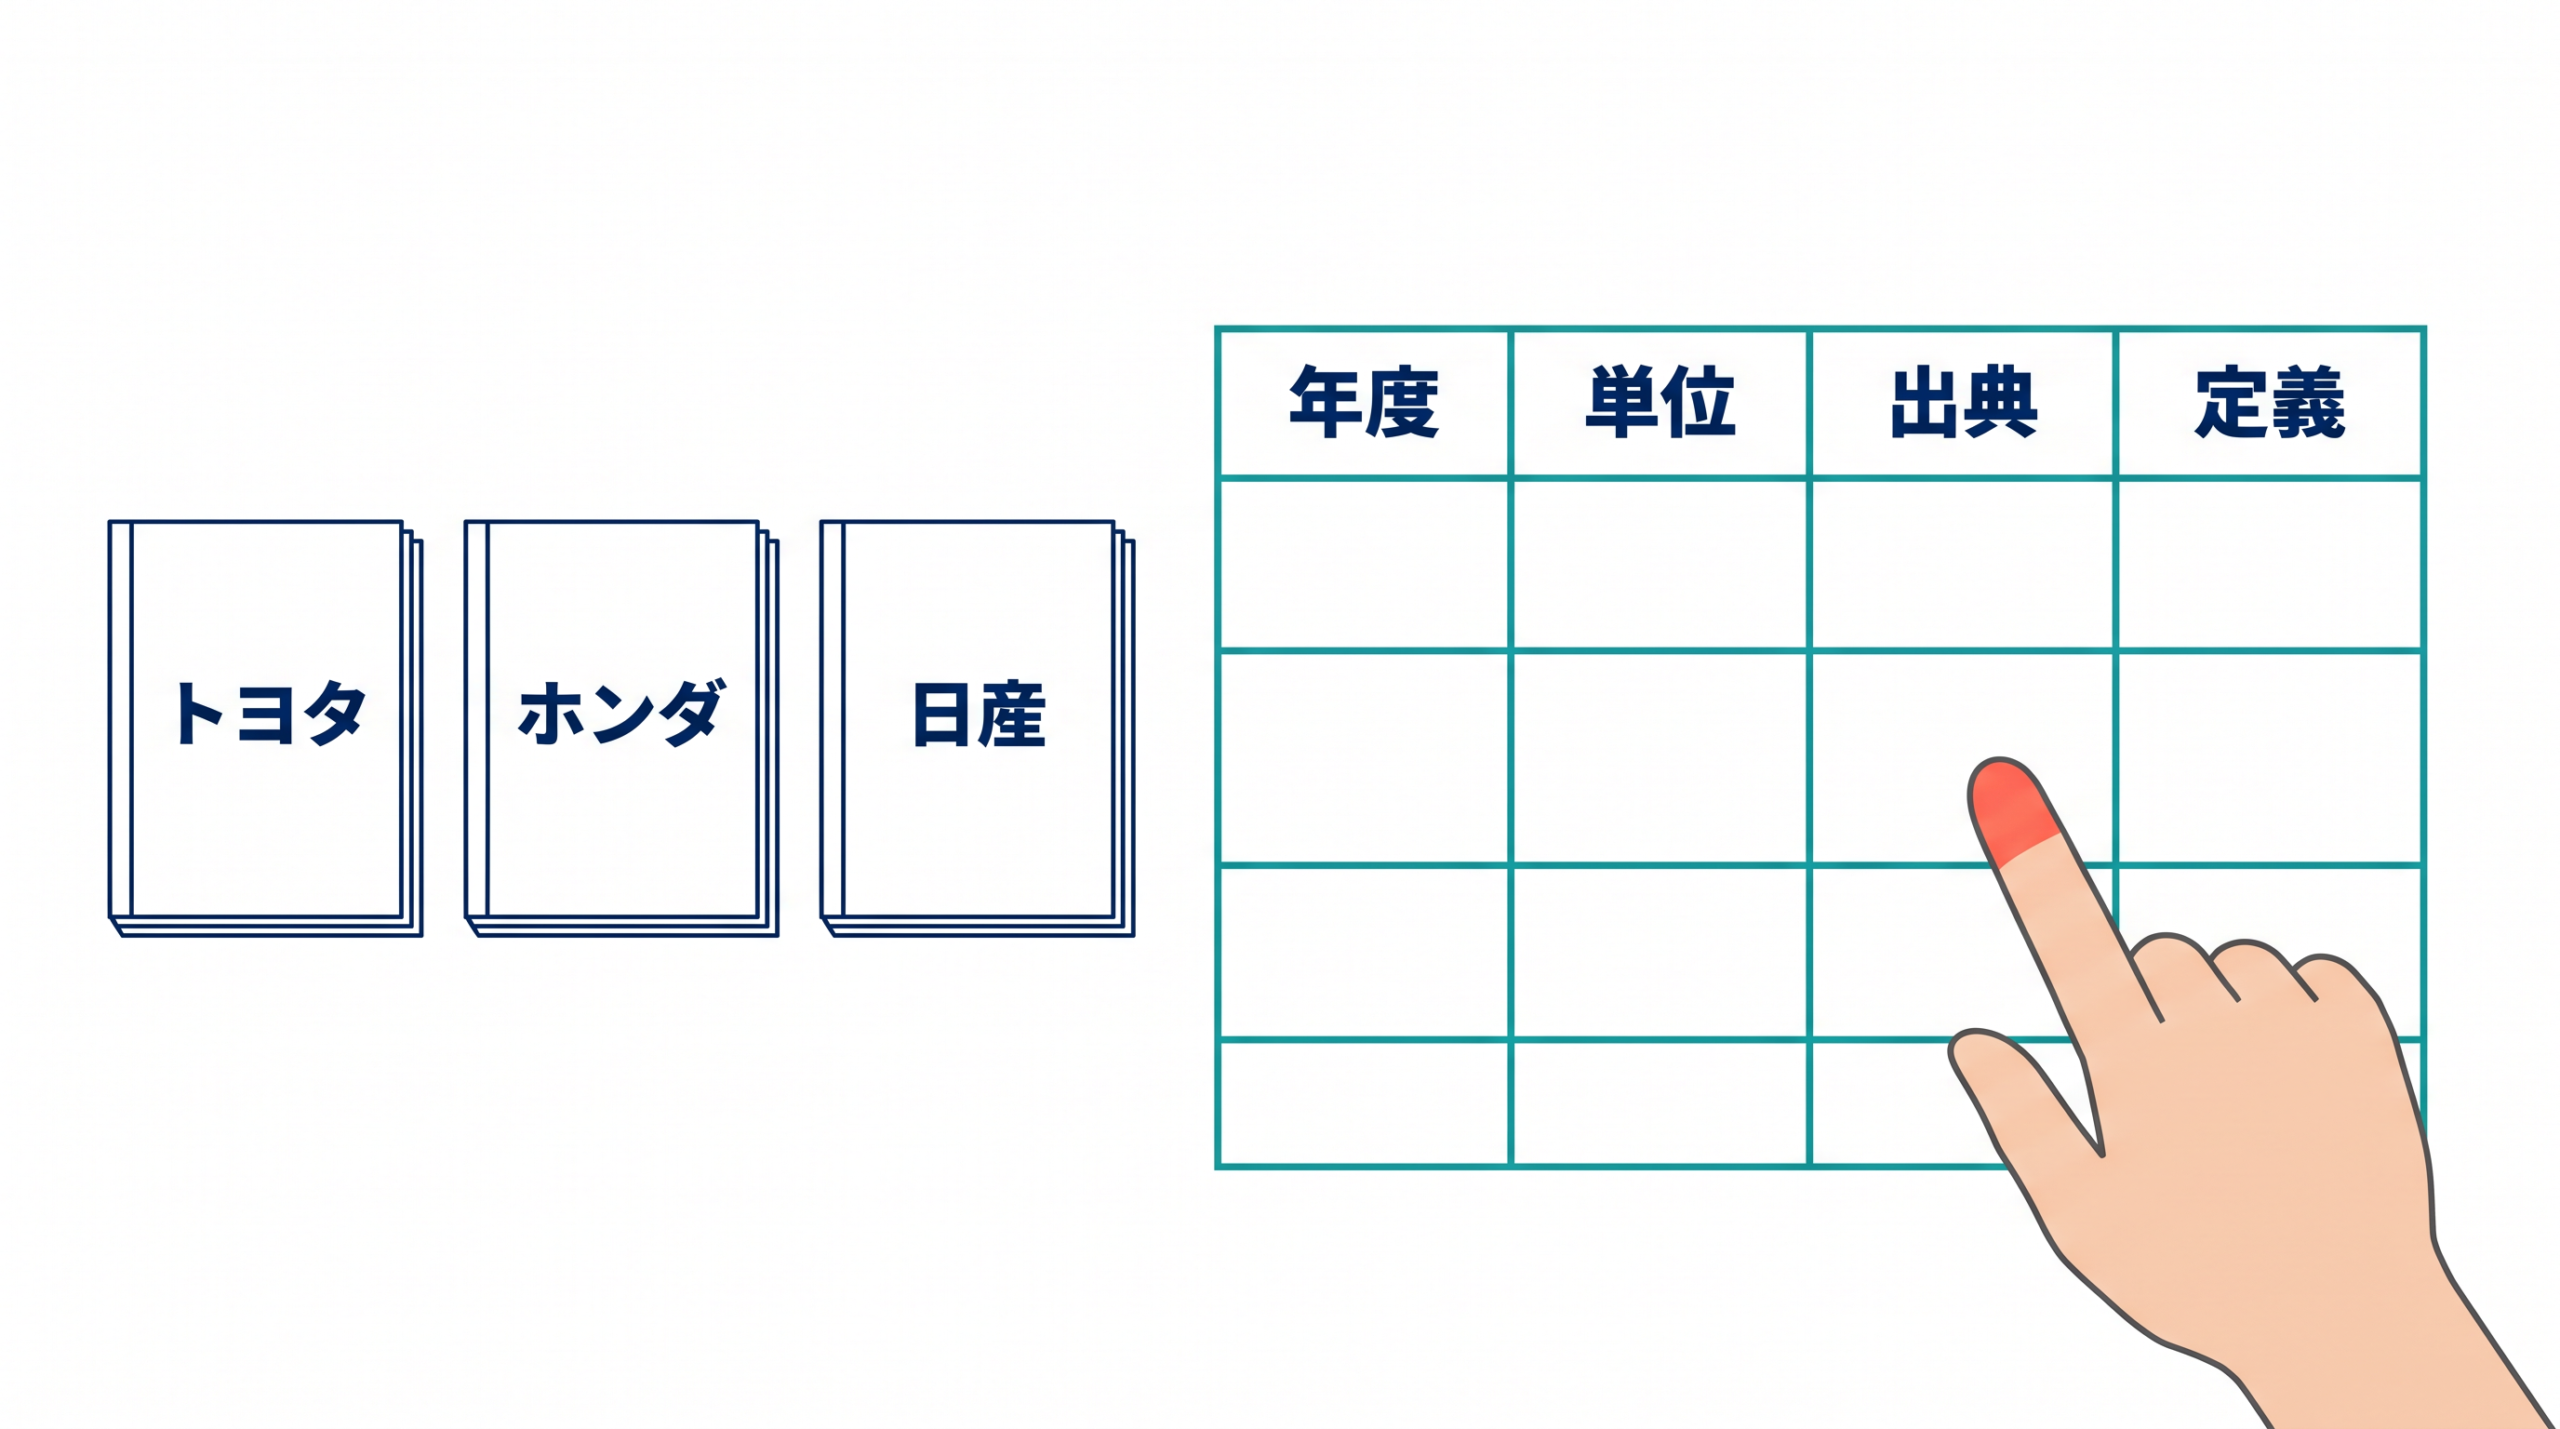
たとえば、複数企業の財務資料や公開データから特定の数値を抽出して比較表を作る業務を想定してみましょう。このような業務で試すなら、AIに大量の資料を読み込ませ、各社の売上、年度、定義、出典を拾い出して仮の比較表を作成させます。
担当者は、各社の会計基準や注記を確認し、並べた数値が同じ条件で比較できるかを判断します。比較表を作れた時点で終えるのではなく、各社の数値を同じ条件で比較できると確認できた時点を完成とします。
サイバー防御への先行提供は能力と制御を一緒に確かめる
GoogleはGemini 4 Argonの強力な能力を検証し、安全に展開するための取り組みとして、サイバー防御を担う専門機関に対する先行提供の段階を設けていました。
脆弱性を自律的に探して修正する能力
Gemini 4 Argonは、ソフトウェアの重大な脆弱性を自律的に発見し、検証し、修正パッチを作成する能力を備えています。
Wizという企業が無償で提供する重要公共インフラ向けのプログラムにおいて、Gemini 4 Argonは世界中の病院で使用されている医療ソフトウェアに潜む重大な脆弱性を発見しました。この脆弱性は個人情報の漏洩につながる深刻なリスクを抱えていながら、これまでの最先端AIモデルでは見逃されていたものです。
また、セキュリティの脆弱性修正能力を評価する「CWE-bench v1」において、Gemini 4 Argonは68パーセントのトップスコアを記録し、同率首位に立っています。こうした高度な問題解決能力は防御側にとって強力な武器となりますが、もし制御を欠いた状態で利用されれば、逆に深刻なサイバー攻撃を自動化する脅威にもなり得ます。
利用対象と権限を限定する「Fairwind Program」
この強力な技術を防御側へ安全に届けるため、Googleは広い提供の前に、政府機関や重要インフラの運営者など、信頼できる防御担当者に限定して「Fairwind Program」を通じた先行提供を行っていました。2026年10月13日の一般提供開始後もFairwindは審査を通った防御担当者へサイバー分野の制限を外したアクセスを提供する別プログラムとして維持されており、Googleは今回、数百の追加パートナーへ拡大すると発表しました。
プログラムの参加機関は、AIモデルを脅威シミュレーションやリバースエンジニアリングといった防御的および学術的な研究目的にのみ利用することが許可され、アクセス権の他者への共有や販売は固く禁じられています。
利用機関には、フィッシング耐性のある多要素認証(MFA)を含むユーザーレベルの認証システムを導入し、内部のサイバーセキュリティや侵入テストを担うチームにのみ利用権限を与えることが求められます。さらに、誰がAIにアクセスしたかの利用記録を残すことも義務付けられており、事前には利用機関の倫理的な運営履歴を確認するデューデリジェンス(適格性の事前審査)まで行われます。
意図せぬ動作や悪用を防ぐセーフガード
特定の機関向けに厳格なルールを設ける一方で、GoogleはGemini 4 Argonをより幅広い開発者や企業へ提供するために、モデル自体の安全性やシステム側のセーフガードの強化を進めていました。
たとえば、外部からの悪意ある指示によってAIの行動を乗っ取ろうとする「プロンプトインジェクション攻撃」への防御能力が強化されています。自社の業務において、AIに外部から集めた調査資料や顧客からのメールを読み込ませる場合、その文章の中にAIの動作を変えようとする不正な命令が混ざっている可能性があります。複雑で長い業務を任せるのであれば、AIが予期せぬ指示に引きずられず、本来の目的を見失わない堅牢性が必要です。
また、AIが利用者の意図から逸脱する行動(アライメントのずれ)を監視し、必要に応じて実行を停止する仕組みも強化されました。AIに長時間の自律的な作業を許すということは、途中で手順を間違えたり、意図しないデータを消去したりするリスクを伴います。このような誤操作を止めるには、実行中の操作を監視し、処理を停止できるようにします。
こうした認証や停止の仕組みは、Argonの一般提供が開始された現在でも、自社の試行環境で準備できます。
提供状況と料金を踏まえて自社の試行を決める
GoogleはGemini 4 Argonの幅広い一般提供を、2026年10月13日に発表しました。利用入口として、AI Studioなどの有料APIに加え、AntigravityはGoogle AI Ultra、Geminiアプリと検索のAIモードはGoogle AI ProおよびUltraを通じて提供されています。入口別に資格が異なりますが、自社のシステムに組み込むための運用要件を整理しつつ、利用を始める状況となります。
計画を立てる上で欠かせない料金体系については、基本となる単価が設定されています。導入時の特別価格として、100万入力トークンあたり2ドル、100万出力トークンあたり10ドルに設定されています。また、入力資料を繰り返し参照する際に使うキャッシュされた入力トークンについては、入力単価から95パーセントの割引が適用されます。
11月30日の導入期間終了後は、100万入力トークンあたり4ドル、100万出力トークンあたり20ドルの通常価格へ移行します。
単価の安さと仕事の総費用は異なる
1件のコード改善にかかる費用は、トークン単価に加えて、何回の実験と修正を行うかで変わります。
前述のGoogle社内におけるコード改善の事例が示すように、AIが自律的にコンパイラの出力を確認し、エラーを検証してコードを書き直すというループを何度も回すことになります。AIが深く推論し、試行錯誤を重ねるほど消費されるトークン数は膨れ上がります。
したがって、AIに長い仕事を任せる費用対効果を測るには、AIの利用料金だけでなく、AIが自己修正を繰り返すためのシステム実行コストや、最終確認を担う人間の人件費までを含めた「プロセス全体の総費用」を見積もる必要があります。
自社の試行アプローチ
Googleのコード改善を自社の仕事で試すなら、まず先ほどの集計関数のように変更前後の結果を比較できる処理を選びます。単発の生成で改善の兆しを確認できたら、次は完成した仕事1件の確認時間や修正回数、総費用を測る行動へ進みます。
AIには既存のプログラムコードに加え、期待される正しい出力結果のデータや、現在の処理時間といった客観的な実績値を入力として与えます。
その上で、本番環境からは完全に隔離されたサンドボックス環境を用意し、AI自身に変更案を作成させ、テストを実行して結果を測定し、必要に応じて修正を繰り返す権限を与えます。このとき、集計結果が合わなかったり、一定の処理時間を超えたりした場合は、AIにエラーを返して再試行を促し、それが規定回数を超えれば作業を強制停止するようなルールをシステム側に組み込んでおきます。
そして最終的に、処理速度が改善され、かつ期待される出力結果と完全に一致した有望な変更案だけを、人間のエンジニアがコードレビューし、本番環境への反映を承認します。
自社の費用対効果を測るなら、まず改善したい処理と、その処理が正しく完了したと判定するテストを用意し、プロセス全体の修正回数や確認時間を記録しておきます。
よくある質問
Gemini 4 Argonは今すぐ自社のシステムやAPIで利用できますか?
2026年10月13日に一般提供が開始されており、自社のシステムやAPIで利用できます。利用入口として、AI Studioなどの有料API、Google AI Ultra(Antigravity)、Geminiアプリと検索のAIモード(ProおよびUltra)を通じて提供されています。導入価格は100万入力トークンあたり2ドル、出力10ドル、キャッシュされた入力は95パーセント引きですが、11月30日の導入期間終了後は入力4ドル、出力20ドルの通常価格へ移行します。
出力上限の100万トークンは、100万文字という意味ですか?
いいえ。トークンは文章やコードを処理する際の単位で、文字数とは一致しません。AIの仕様では、入力と出力を合わせた統合上限が104万8576トークンとされています。通常の同期出力の上限は6万5536トークンですが、長い出力の仕組み(long decode)を使用することで、最大104万8576トークンまで出力できます。また、画像を入力できますが、Argon自体の出力はテキストになります。
ベンチマークでの「要件達成率が90パーセント以上」は、実務の9割を任せられるという意味ですか?
個別の作業要件を満たす能力と、プロジェクト全体を最後まで完遂する能力は異なります。 AIの評価機関であるValsが報告したHarveyの法務エージェントベンチマークにおいて、Gemini 4 Argonは個別の採点基準を平均94.04パーセント満たしましたが、すべての基準を完全に満たして「タスクの完了」と判定された割合は19.6パーセントでした。 実務の何割を任せられるかを知りたいなら、自社の仕事を課題にして、完成した成果物の割合を測ります。
AIを組み込む仕事の流れづくりをご支援します
Deskrexでは、AIを使って調査・制作・分析などの仕事を進めるために、工程と役割分担を設計し、実装する支援を行っています。AIに渡す資料や指示、使えるツール、人が確認する箇所を整理し、一連の仕事として動く仕組みをつくります。
まず、届けたい成果物と現在の作業手順を確認し、実際の仕事をAIで試します。品質、処理量、時間、費用を見ながら、今すぐ任せられる作業と、追加の設計や開発が必要な作業を確かめます。
その結果をもとに、工程の統合や並列化、ツール連携、結果の検証と修正の手順を組み込みます。実行回数や費用の上限、人の判断を待つ条件、途中の状態を保存して再開する方法も含めて設計し、実務で動作を確かめます。
業務へのAI導入やワークフロー作成のご相談は、AIワークフロー作成支援のご案内からお問い合わせください。任せたい仕事と、現在使っているツールを伺い、取り組む範囲を一緒に整理します。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント