ニュースで企業の情報漏洩の公表を目にすることが増えました。大規模な顧客データや従業員情報が流出したという報道を見るたびに、自社のサービスや委託先の管理体制は今のままで大丈夫だろうかと不安を感じる事業担当者や経営者の方も多いのではないでしょうか。
しかし、漏洩の公表が相次ぐ現状を正しく理解し、自社の対策に生かすためには、ニュースの印象から漠然と「被害が増えている」と捉えるだけでは不十分です。実際の件数や被害規模の推移、攻撃を許した原因、共通の委託先から他社へ波及する仕組み、そして近年脅威として語られるローカルAIの関与といった要素に分けて、状況を冷静に整理する必要があります。
本記事では、公的機関や調査会社の統計データから現在の情報漏洩の実態を読み解きます。そのうえで、非専門家である企業担当者が自社の対策や委託先との契約を見直すために、どのような事実に基づき、何から確認すればよいのかを考えます。
情報漏洩は増えたのか――件数と被害規模で違う答え
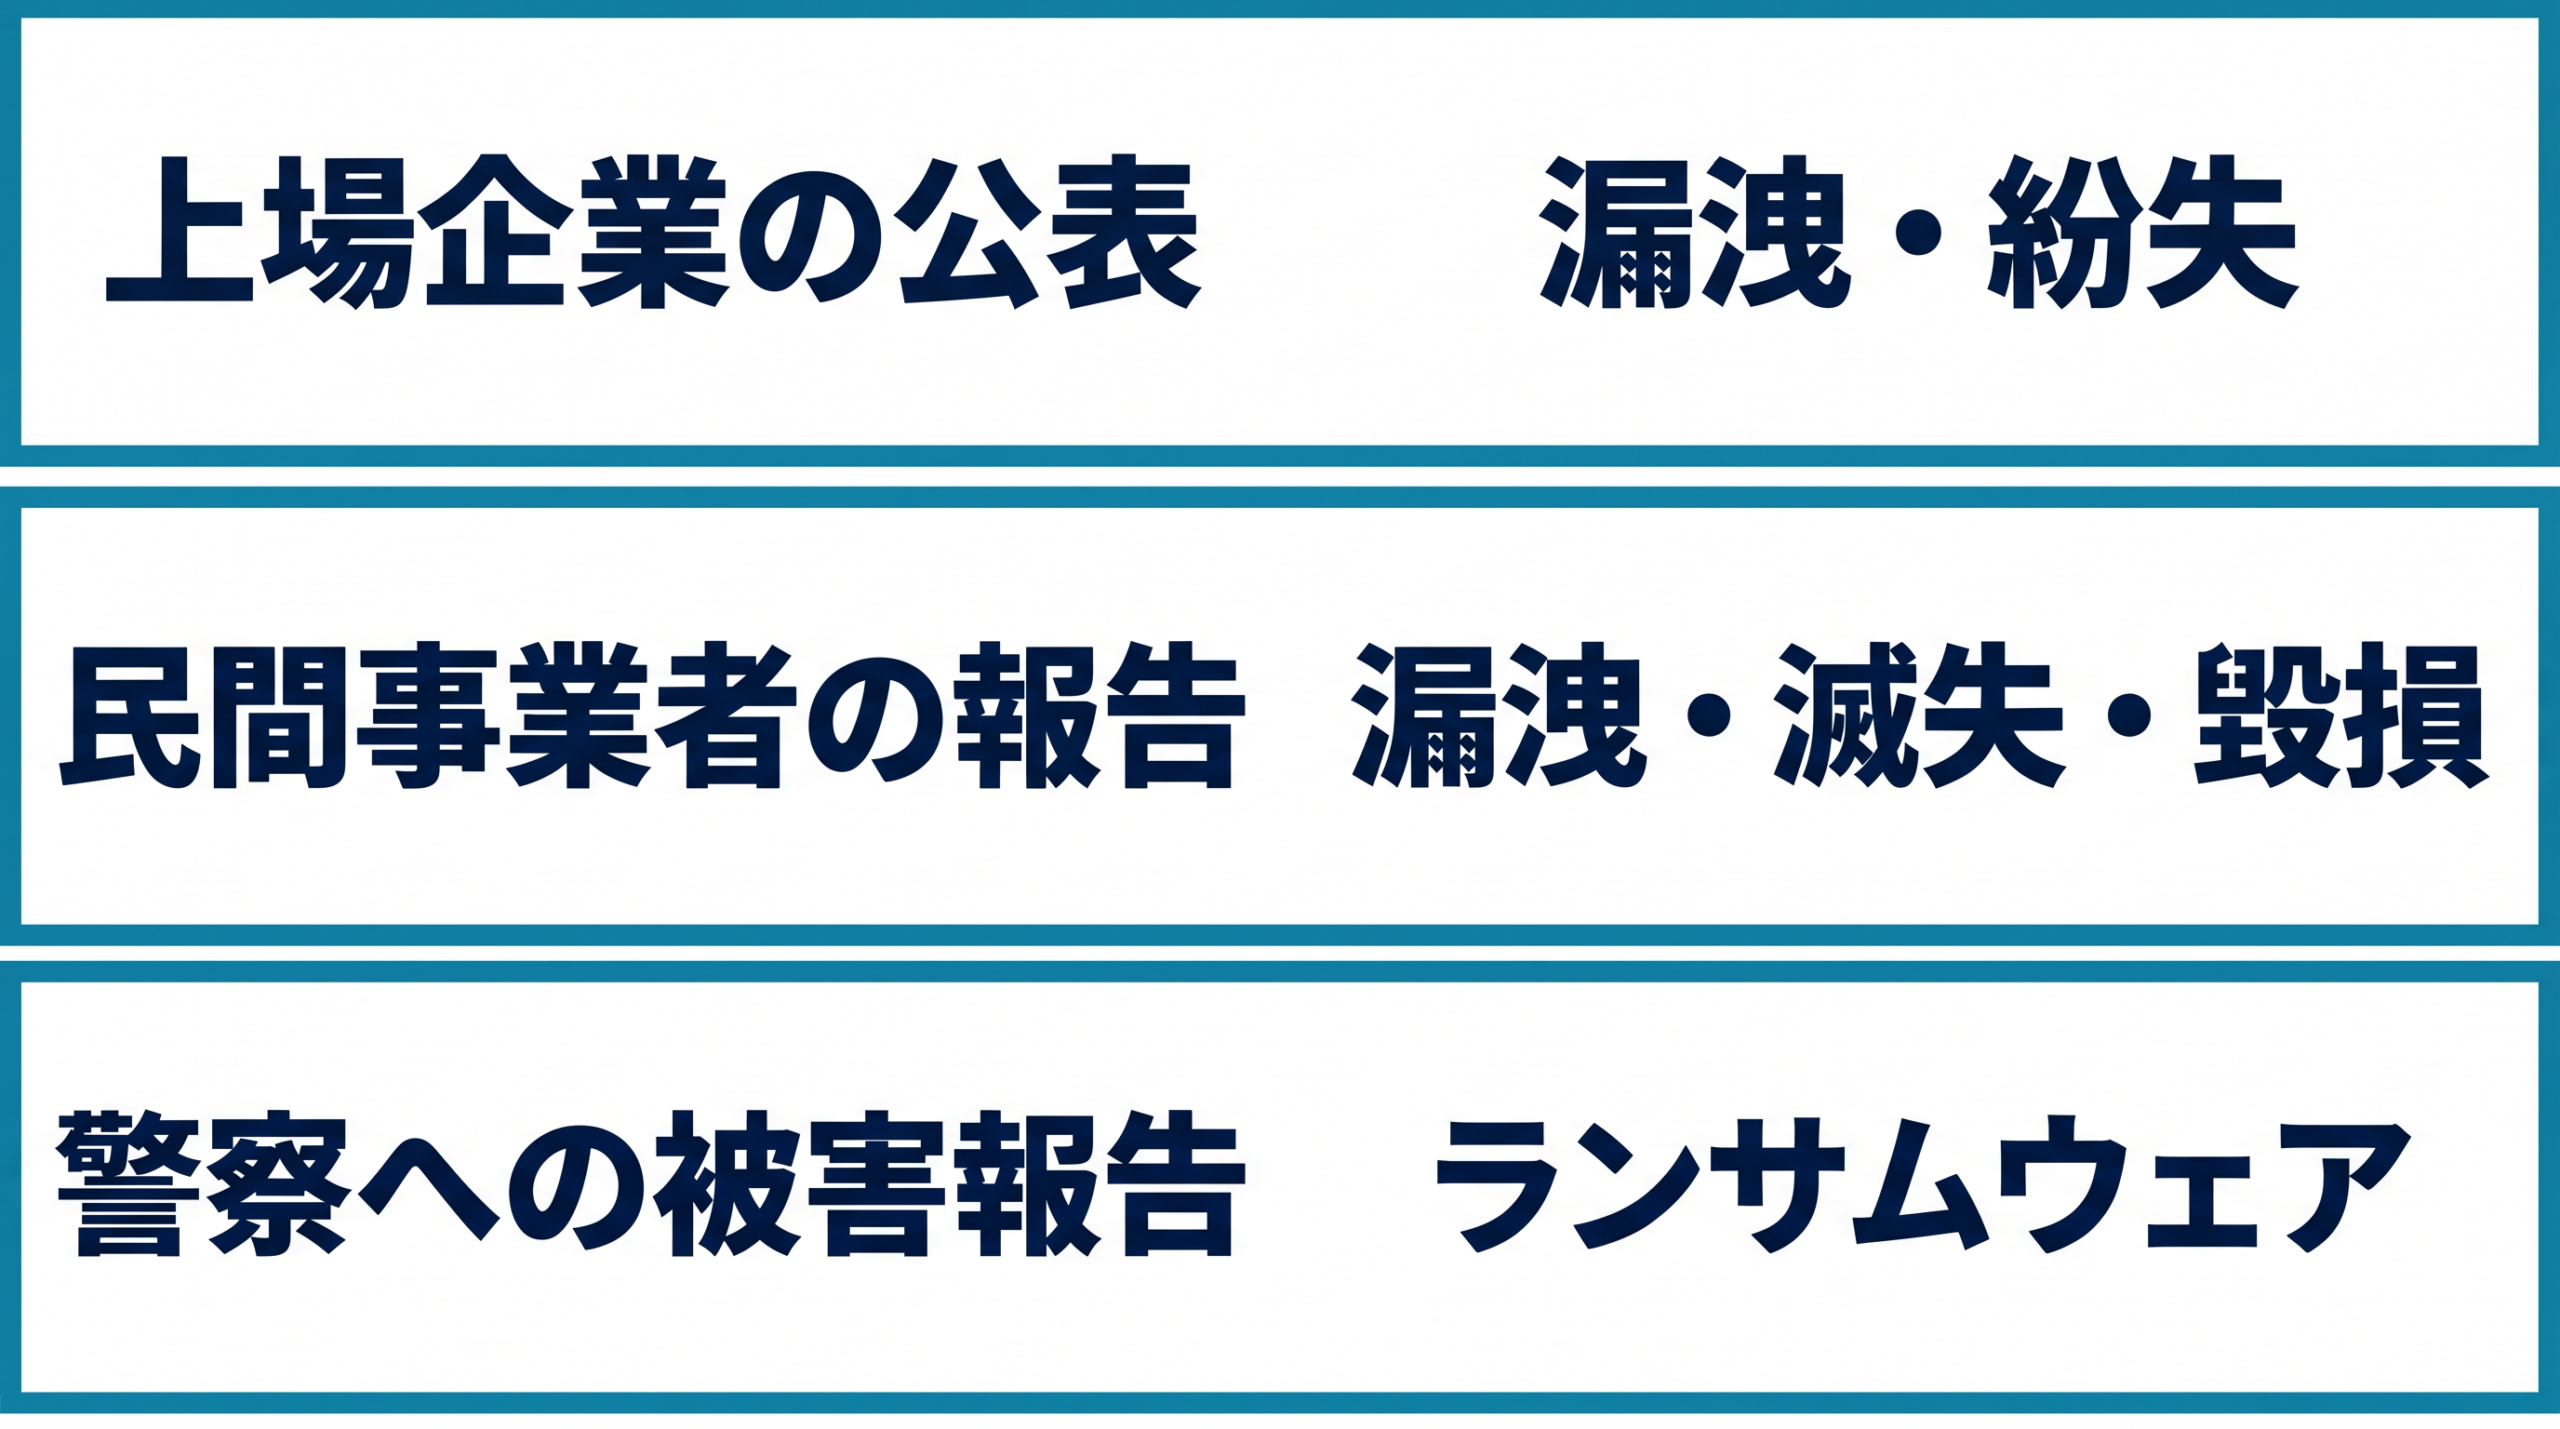
「情報漏洩は増えているのか」という疑問に答えるためには、まずどのデータを見るかを決める必要があります。ニュースで取り上げられるような大規模なサイバー攻撃の事案と、日常的な書類の紛失までを含めた事案とでは、対象となる統計の母集団が全く異なるからです。
以下の表は、情報漏洩やサイバー攻撃に関する代表的な3つの調査データの違いをまとめたものです。
| 指標 | 対象期間 | 集計値 | 対象と限界 |
|---|---|---|---|
| 上場企業と子会社が公表した漏洩・紛失事故 | 2025年 | 180件・158社 | 非上場企業を網羅しません。可能性や紛失も含みます。東京商工リサーチ |
| 民間事業者等の漏洩等報告の処理 | 2025年度 | 17,139件 | 2025年4月〜2026年3月。漏洩だけでなく滅失・毀損等も含みます。サイバー攻撃件数ではありません。個人情報保護委員会の令和7年度年次報告・第2章第4節と付表2 |
| 警察へのランサムウェア被害報告 | 2025年 | 226件 | 警察が把握した企業・団体等の被害です。漏洩確認件数とは異なります。警察庁2025年資料・本文13頁 |
上場企業とその子会社に絞った東京商工リサーチの2025年調査を見ると、公表された事故件数は前年の189件から180件へと4.8%減少しています。これだけを見ると事故は減っているように見えますが、被害の規模を示す「公表された延べ対象人数」は、2024年の15,865,611人分から2025年には30,636,910人分へと、93.1%増加しています。また、ウイルス感染・不正アクセスによる事故も114件から116件へと1.8%増加しました。事故件数が微減する一方で、公表された延べ対象人数の合計は増加しています。なお、この延べ対象人数は同一人物の重複を除去したものではなく、人数を非開示としている70件を含まないため、実際の全件の総被害人数ではありません。
また、警察庁が把握したランサムウェア被害報告の推移を見ると、半期ごとの件数は2024年上半期が114件、下半期が108件、2025年上半期が116件、下半期が110件と推移し、2026年上半期には123件と半期の集計開始以降で最多となりました。警察庁・図表4このように直近の増加は確認できますが、ニュースで被害報道が多い時期があるからといって、国内の全漏洩件数が単純に何倍にも跳ね上がっているとは判断できません。
原因についても、どの統計を見るかで「不正アクセスの割合」は大きく変わります。上場企業の2025年の公表事故180件では、ウイルス感染・不正アクセスが116件と全体の64.4%を占めています。東京商工リサーチ・原因別図表一方で、医療機関等の書類の誤交付まで広く含む個人情報保護委員会への直接報告13,345件を分母とすると、不正アクセスは報告者からの533件、委託先からの328件、不明の395件を合わせて計1,256件となり、全体の9.4%にとどまります。この行政への報告では、紙媒体のみの事案が10,263件と76.9%を占めています。年次報告・付表2(2)④⑤これらの差は矛盾ではなく、新聞などで見つけやすい大規模事案と、日常的なミスを含む行政への報告とで集まる事故の性質が違うためです。統計分類の意味を変えずに数字を捉える必要があります。
次に、どのような企業が漏洩を公表しているのかを確認します。東京商工リサーチのデータから、2025年に漏洩を公表した158社を業種別に計算すると以下のようになります。東京商工リサーチ・産業別
| 業種 | 2025年の公表企業数 | 158社に占める割合 |
|---|---|---|
| 製造業 | 50社 | 31.6% |
| サービス業 | 23社 | 14.6% |
| 情報通信業 | 21社 | 13.3% |
| 金融・保険業 | 20社 | 12.7% |
| 小売業 | 15社 | 9.5% |
| その他 | 29社 | 18.4% |
製造業が最も多くなっていますが、これは各業種の全企業数を分母にした被害率ではないため「製造業が最も侵入されやすい」とは結論できません。大企業が抱える顧客規模や、事案を公表する慣行なども観測件数に影響し得ます。
実際の事案では、小売、交通・移動、物流、保険、出版、エンターテインメント、行政、クラウドや予約・採用管理など、多様な業界で漏洩が発生しています。ここで企業担当者が特に注意すべきなのは、利用者情報を多数の企業から預かっている「システム提供会社」への侵害を、利用企業自身が直接侵入されたケースと混同しないことです。自社の直接的な管理だけでなく、委託先のシステムを経由して情報が漏洩するリスクをどう把握し備えるかが、現在の企業にとって重要な確認事項となります。
漏洩を公表した企業と、流出した情報の違い
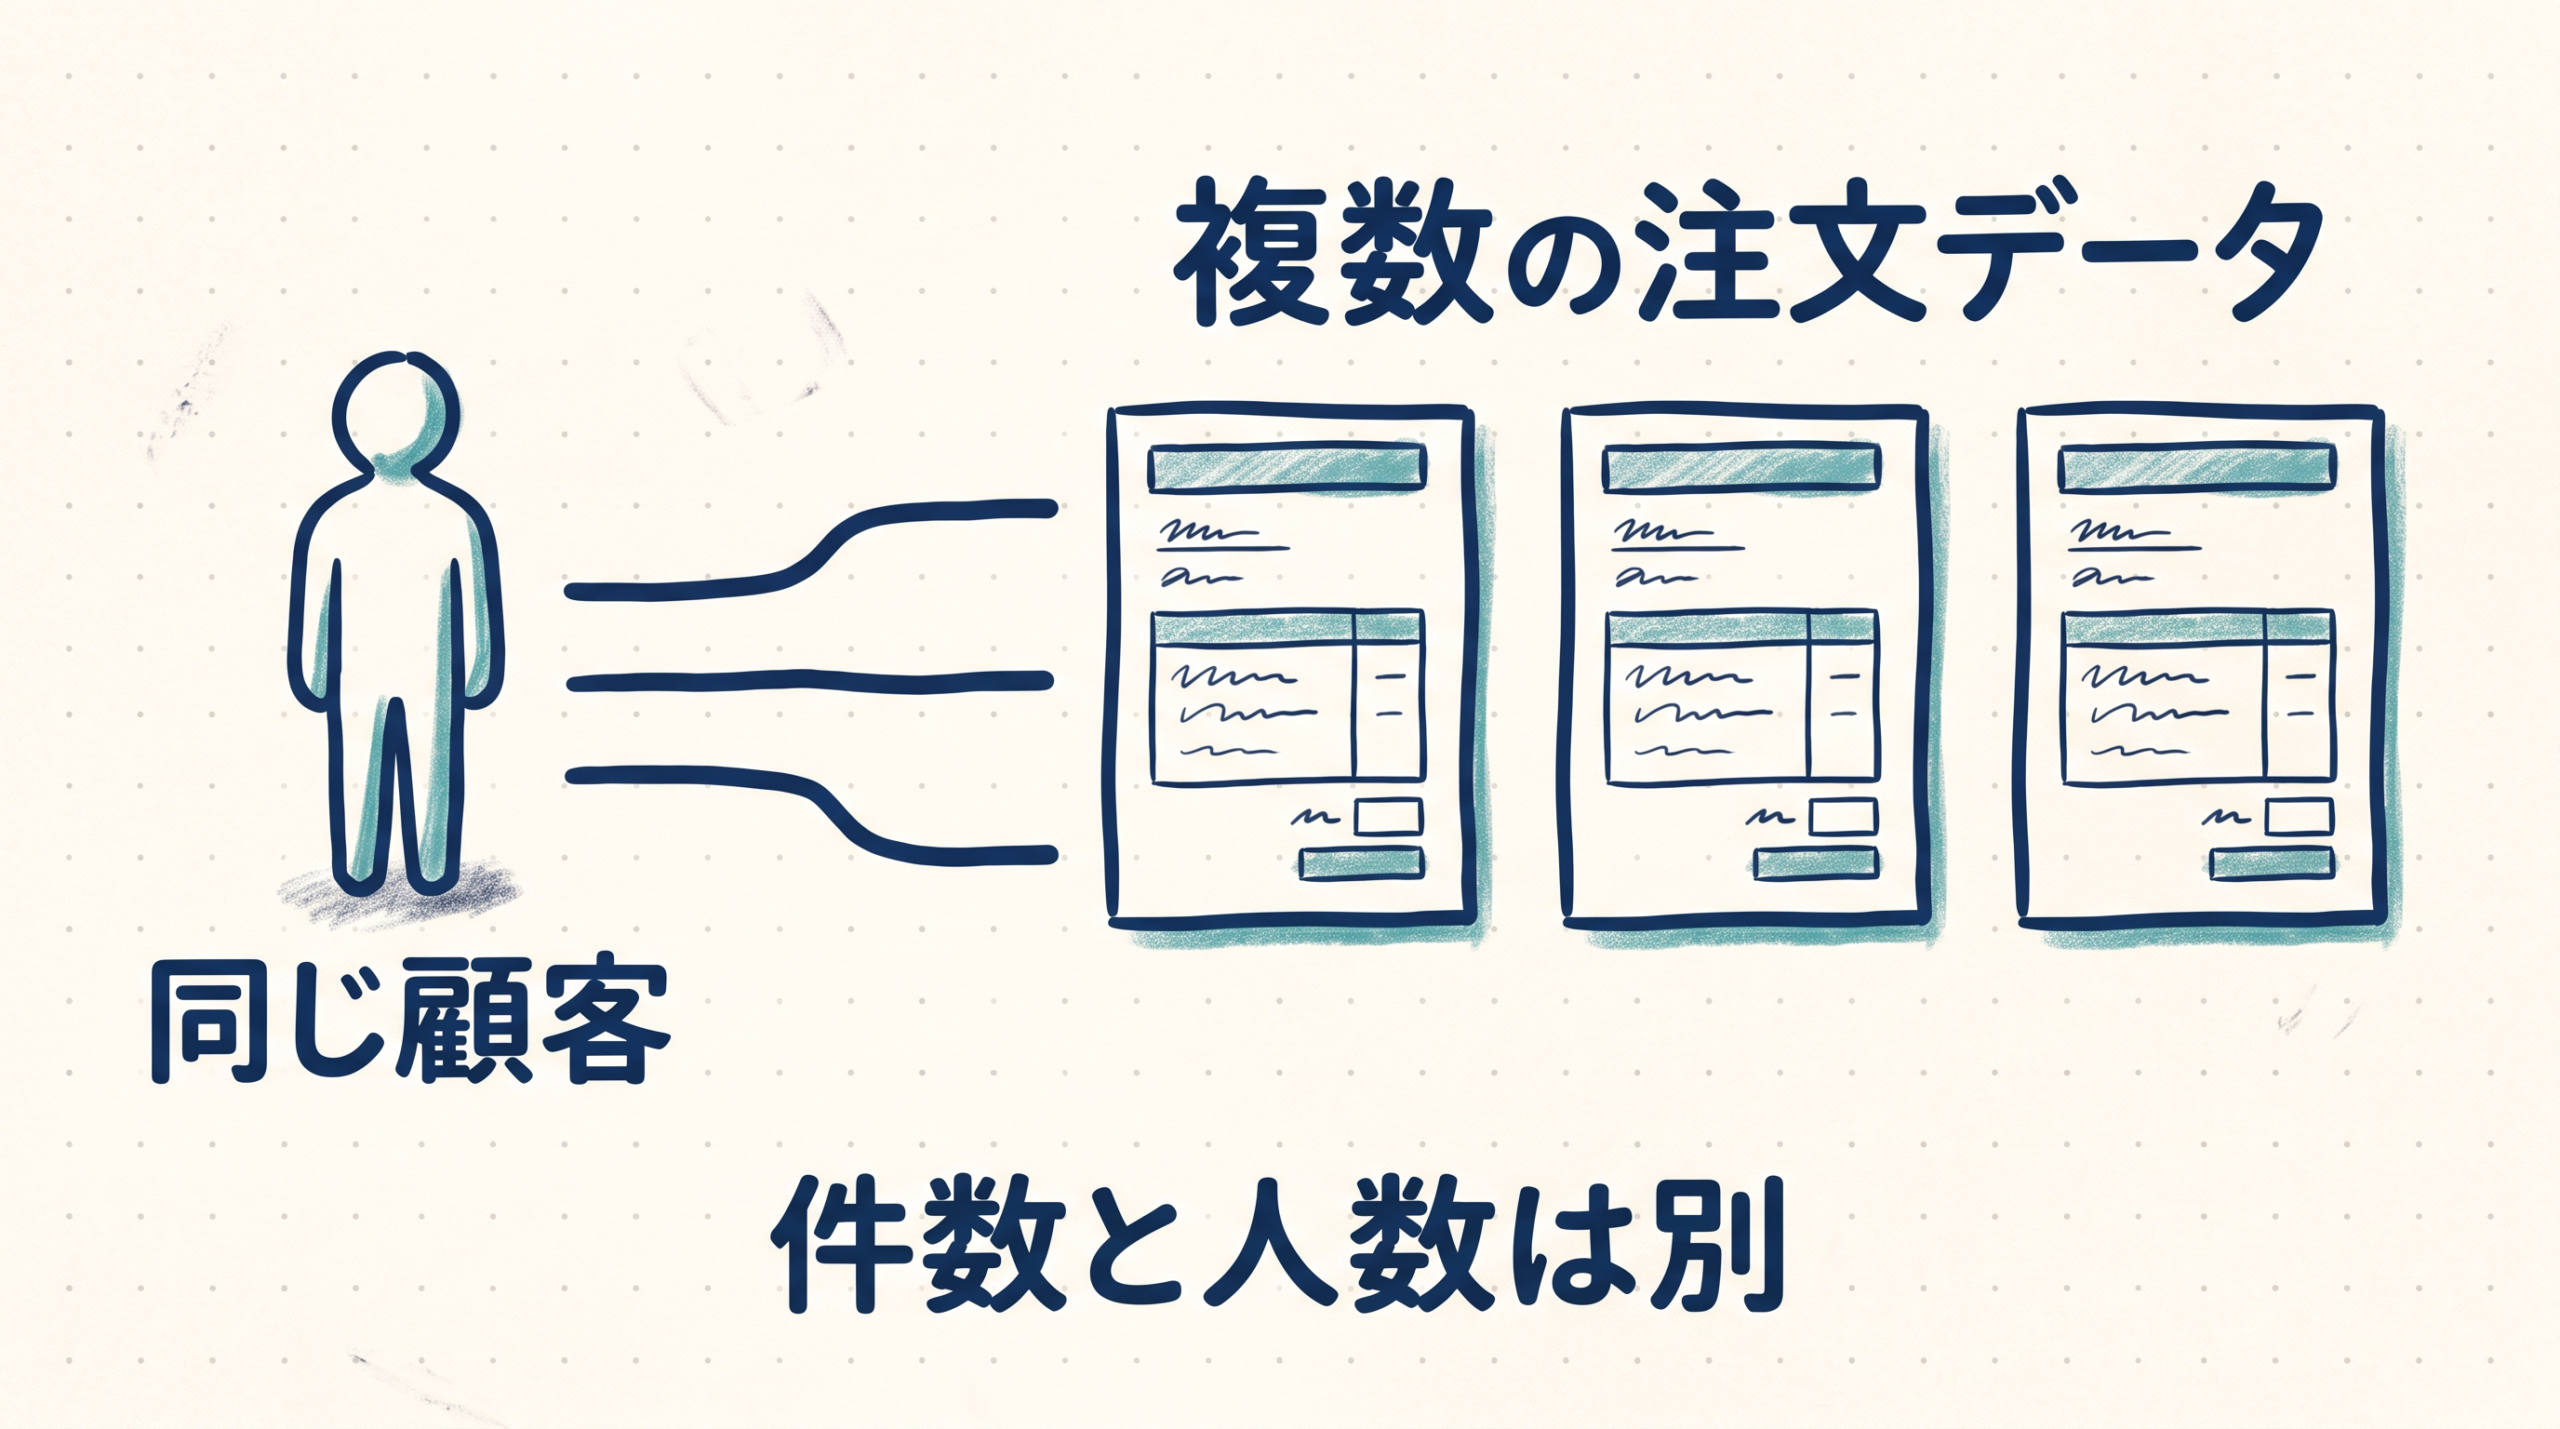
企業が情報漏洩を公表する際、ニュースの見出しには大規模な数字が並びがちですが、その実態を読み解くには流出した情報の種類や単位に注意を払う必要があります。公表される数値は、必ずしも「被害に遭った個人の数」を意味するわけではありません。
たとえば、EPARKリラク&エステが公表した事案では、データベース情報の外部転送による約2,218万レコードの漏洩・不正閲覧が確認されましたが、名寄せをした後も正確な人数への置き換えは困難であると公式に説明されています(EPARKリラク&エステ)。また、Eストアーが提供する「ショップサーブ」におけるサーバー上の不正プログラムを原因とする事案では、8,853,839件のデータ漏洩・不正閲覧が確認されていますが、これも同一顧客の複数データを含み得る件数であり、人数ではありません(Eストアー)。
「人」やユーザー関連という単位が用いられる場合でも、含まれる情報は事案ごとに異なります。アフラック生命保険の「よりそうネット」等における事案では、通常アクセスに見える通信による大量取得により約440万人の漏洩・不正閲覧が確認されました。この中には、銀行口座情報約22万人分が内数として含まれています(アフラック生命保険)。一方で、Helpfeelの「Gyazo」における事案では、約2,362万件のユーザー関連データの漏洩・不正閲覧が確認されていますが、これには匿名利用者のデータも含まれています(Helpfeel)。
さらに、対象者が一般の消費者ではないケースもあります。デジタル庁の「GSS」の事案では、VPN機器の既知脆弱性を悪用した侵入により約24万6,000件の個人情報漏洩の可能性が公表されました。しかしその内訳は職員等が約18.9万件、関係事業者等が約5.7万件であり、一般市民の個人情報は含まれていません(デジタル庁)。
このように公表データの性質が異なる中で、事業担当者が特に注意して確認したいのが、共通のシステムや委託先を起点として複数組織へ影響が波及するケースです。
先述の「ショップサーブ」の事案では、過去に同サービスを利用していたPFUやキングジムが、自社の顧客データについて漏洩の可能性を公表しています。PFUは最大169,355件(人数ではない)の注文データを対象候補としていますが、これは現在の同社のECサイトが侵入されたというわけではなく、過去に利用していた委託先のシステムを通じた被害です(PFU)。
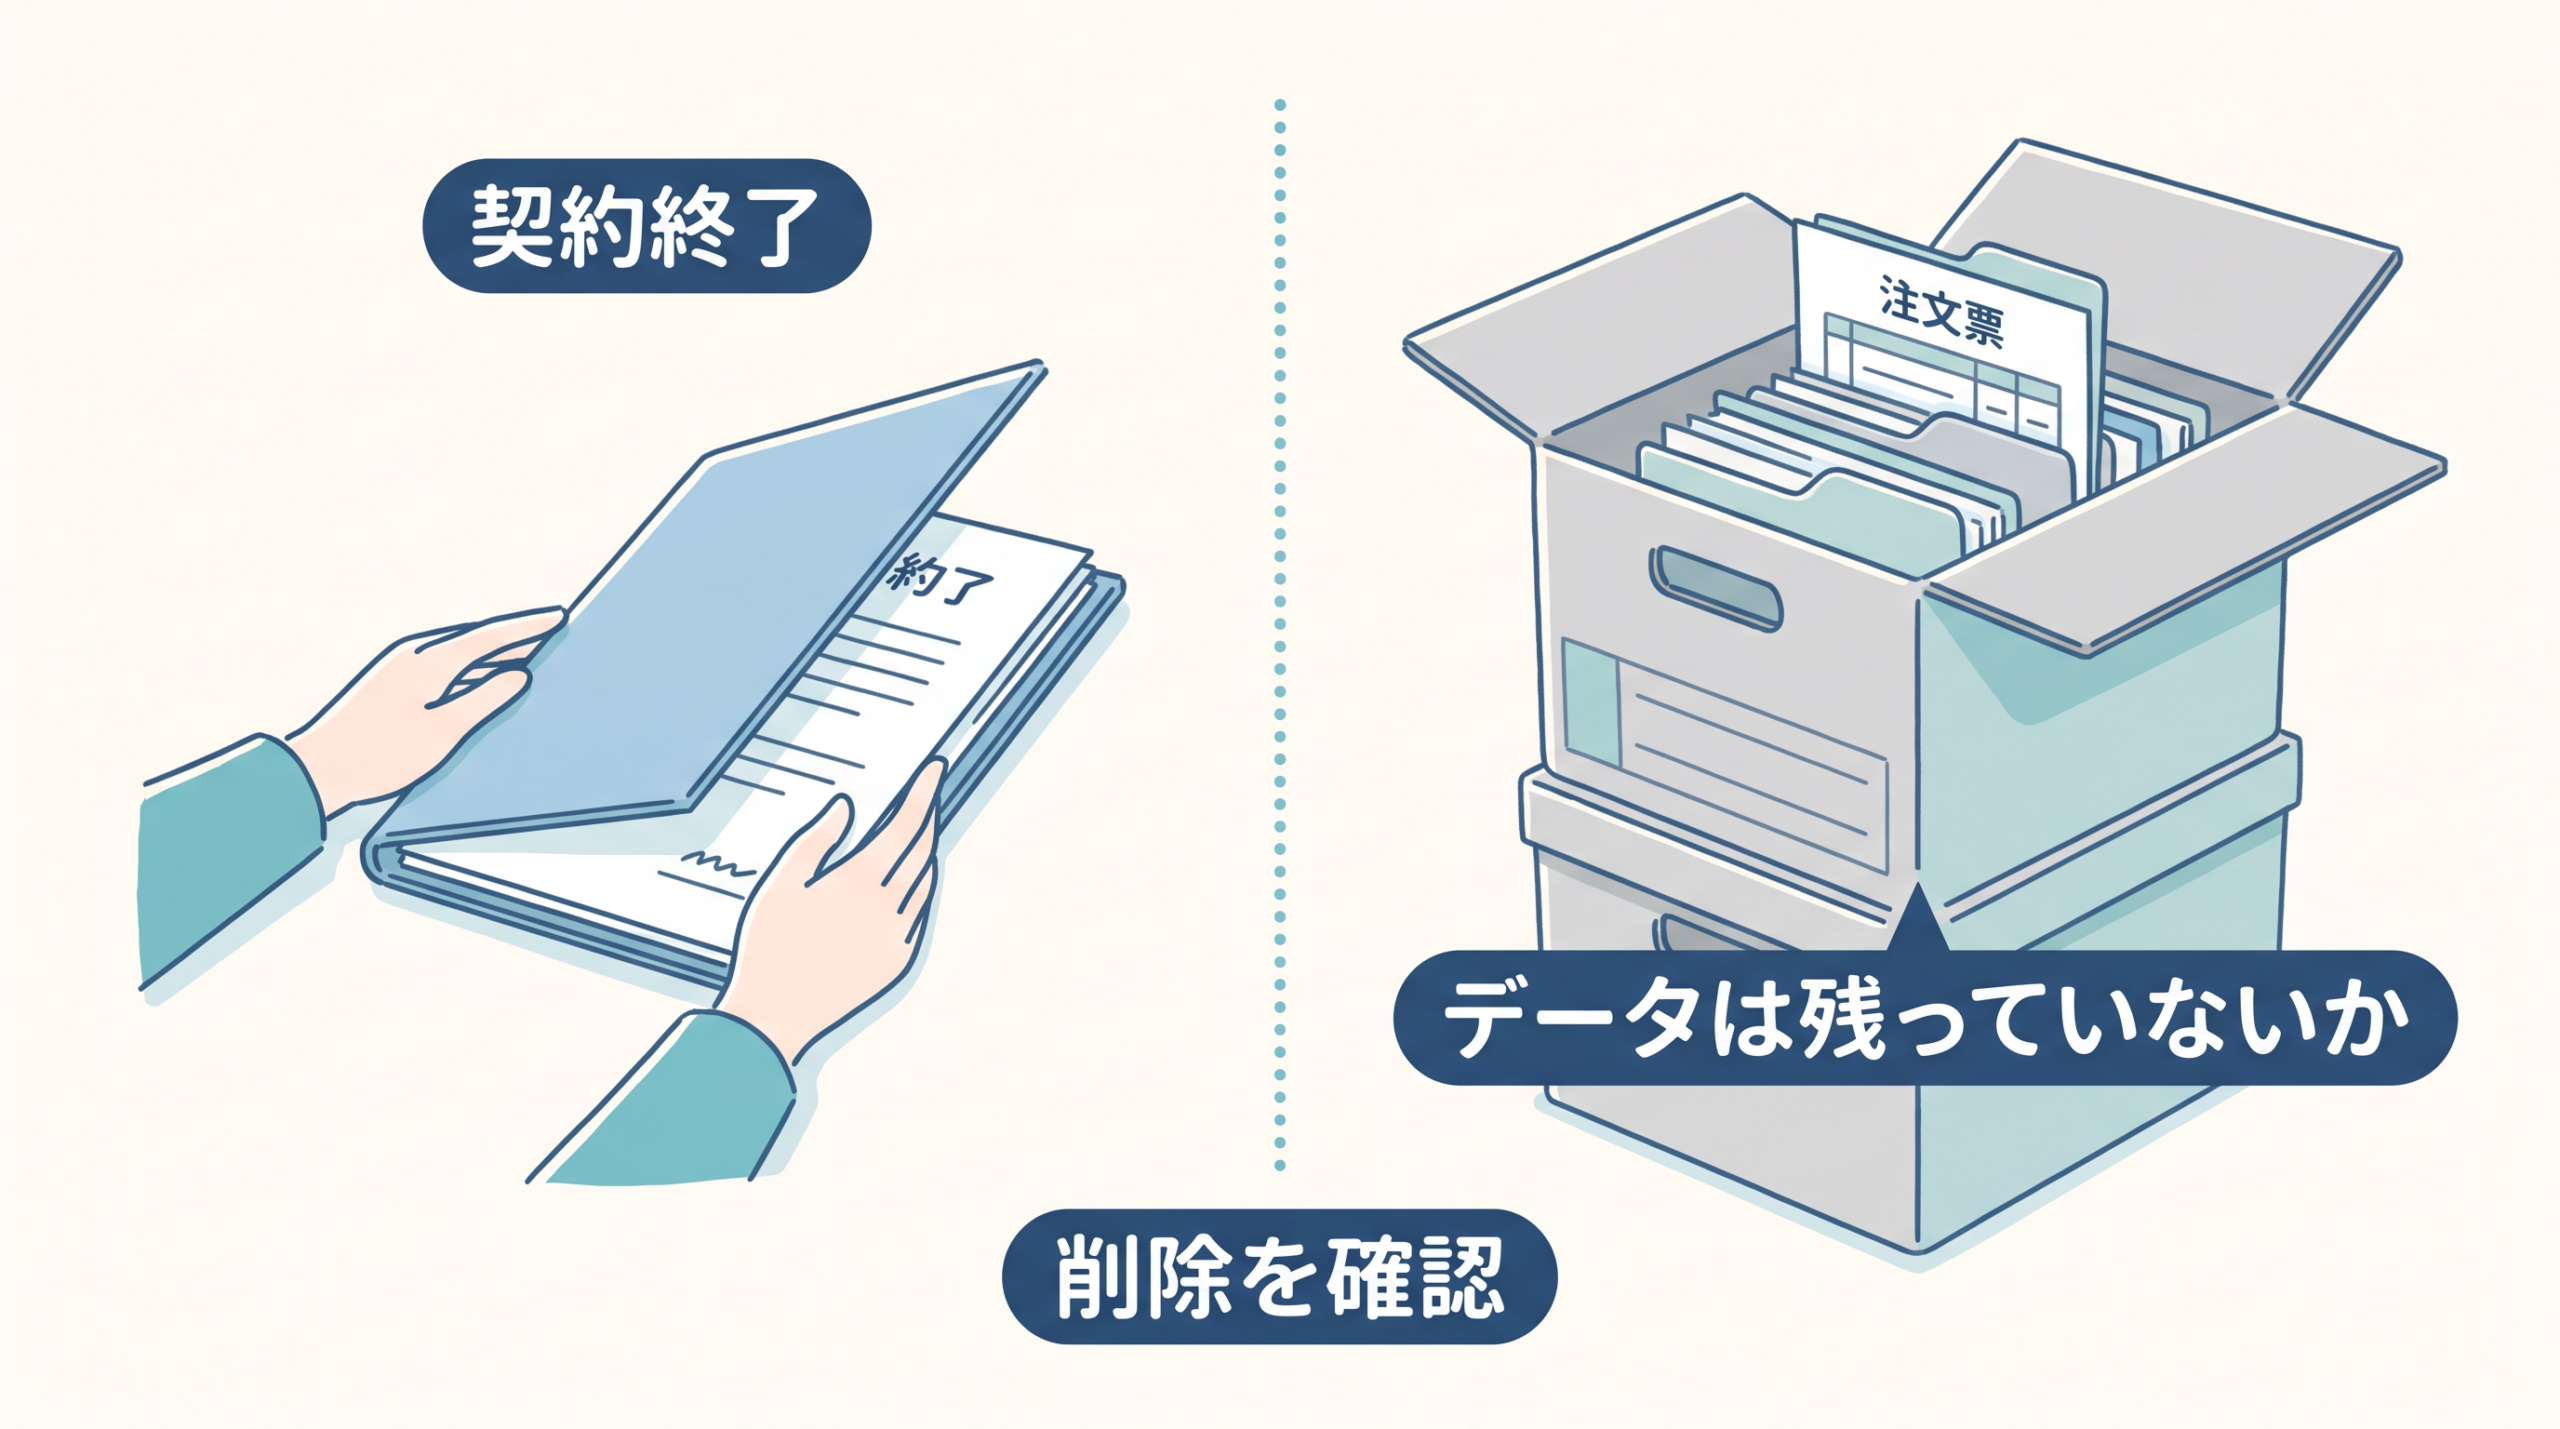
採用管理や電子雇用契約を行う「ApplyNow(きちりホールディングス)」の事案でも、データ分析ツールの脆弱性に起因して複数企業へ影響が及びました。吉野家とはなまるは連名で公表を行い、吉野家で4,998件、はなまるで368件、両社の採用担当者等で418件の漏洩・不正閲覧を確認したと説明しています。これらはApplyNow侵害の影響範囲であり、ここで注目すべきは、契約終了後に残っていた応募者情報も対象になっている点です(吉野家・はなまる)。
また、宿泊予約情報の管理システム「TEMAIRAZU(手間いらず)」の事案では、提供元が不正アクセスによる漏洩の可能性を公表しています。複数のホテルが予約情報を含む不審メッセージを告知していますが、この侵害との関連は調査中です(手間いらず)。この事案では、漏洩確認済みの施設総数や対象者の人数は公表されていません。
これらの波及事案から事業担当者が確認できるのは、自社が直接管理するシステムだけでなく、クラウドサービスや業務委託先の管理体制が自社の顧客や従業員の情報に直結しているという事実です。特に、サービスの利用を終了した後も委託先にデータが残存していれば、そこから情報が流出するリスクがあります。ニュースで見る漏洩事例を他社の出来事として終わらせず、自社が利用しているサービスで退会後や契約終了後のデータ削除が適切に行われているかを見直すきっかけにすることが重要です。
原因は「既知脆弱性の放置」だけでは説明できない
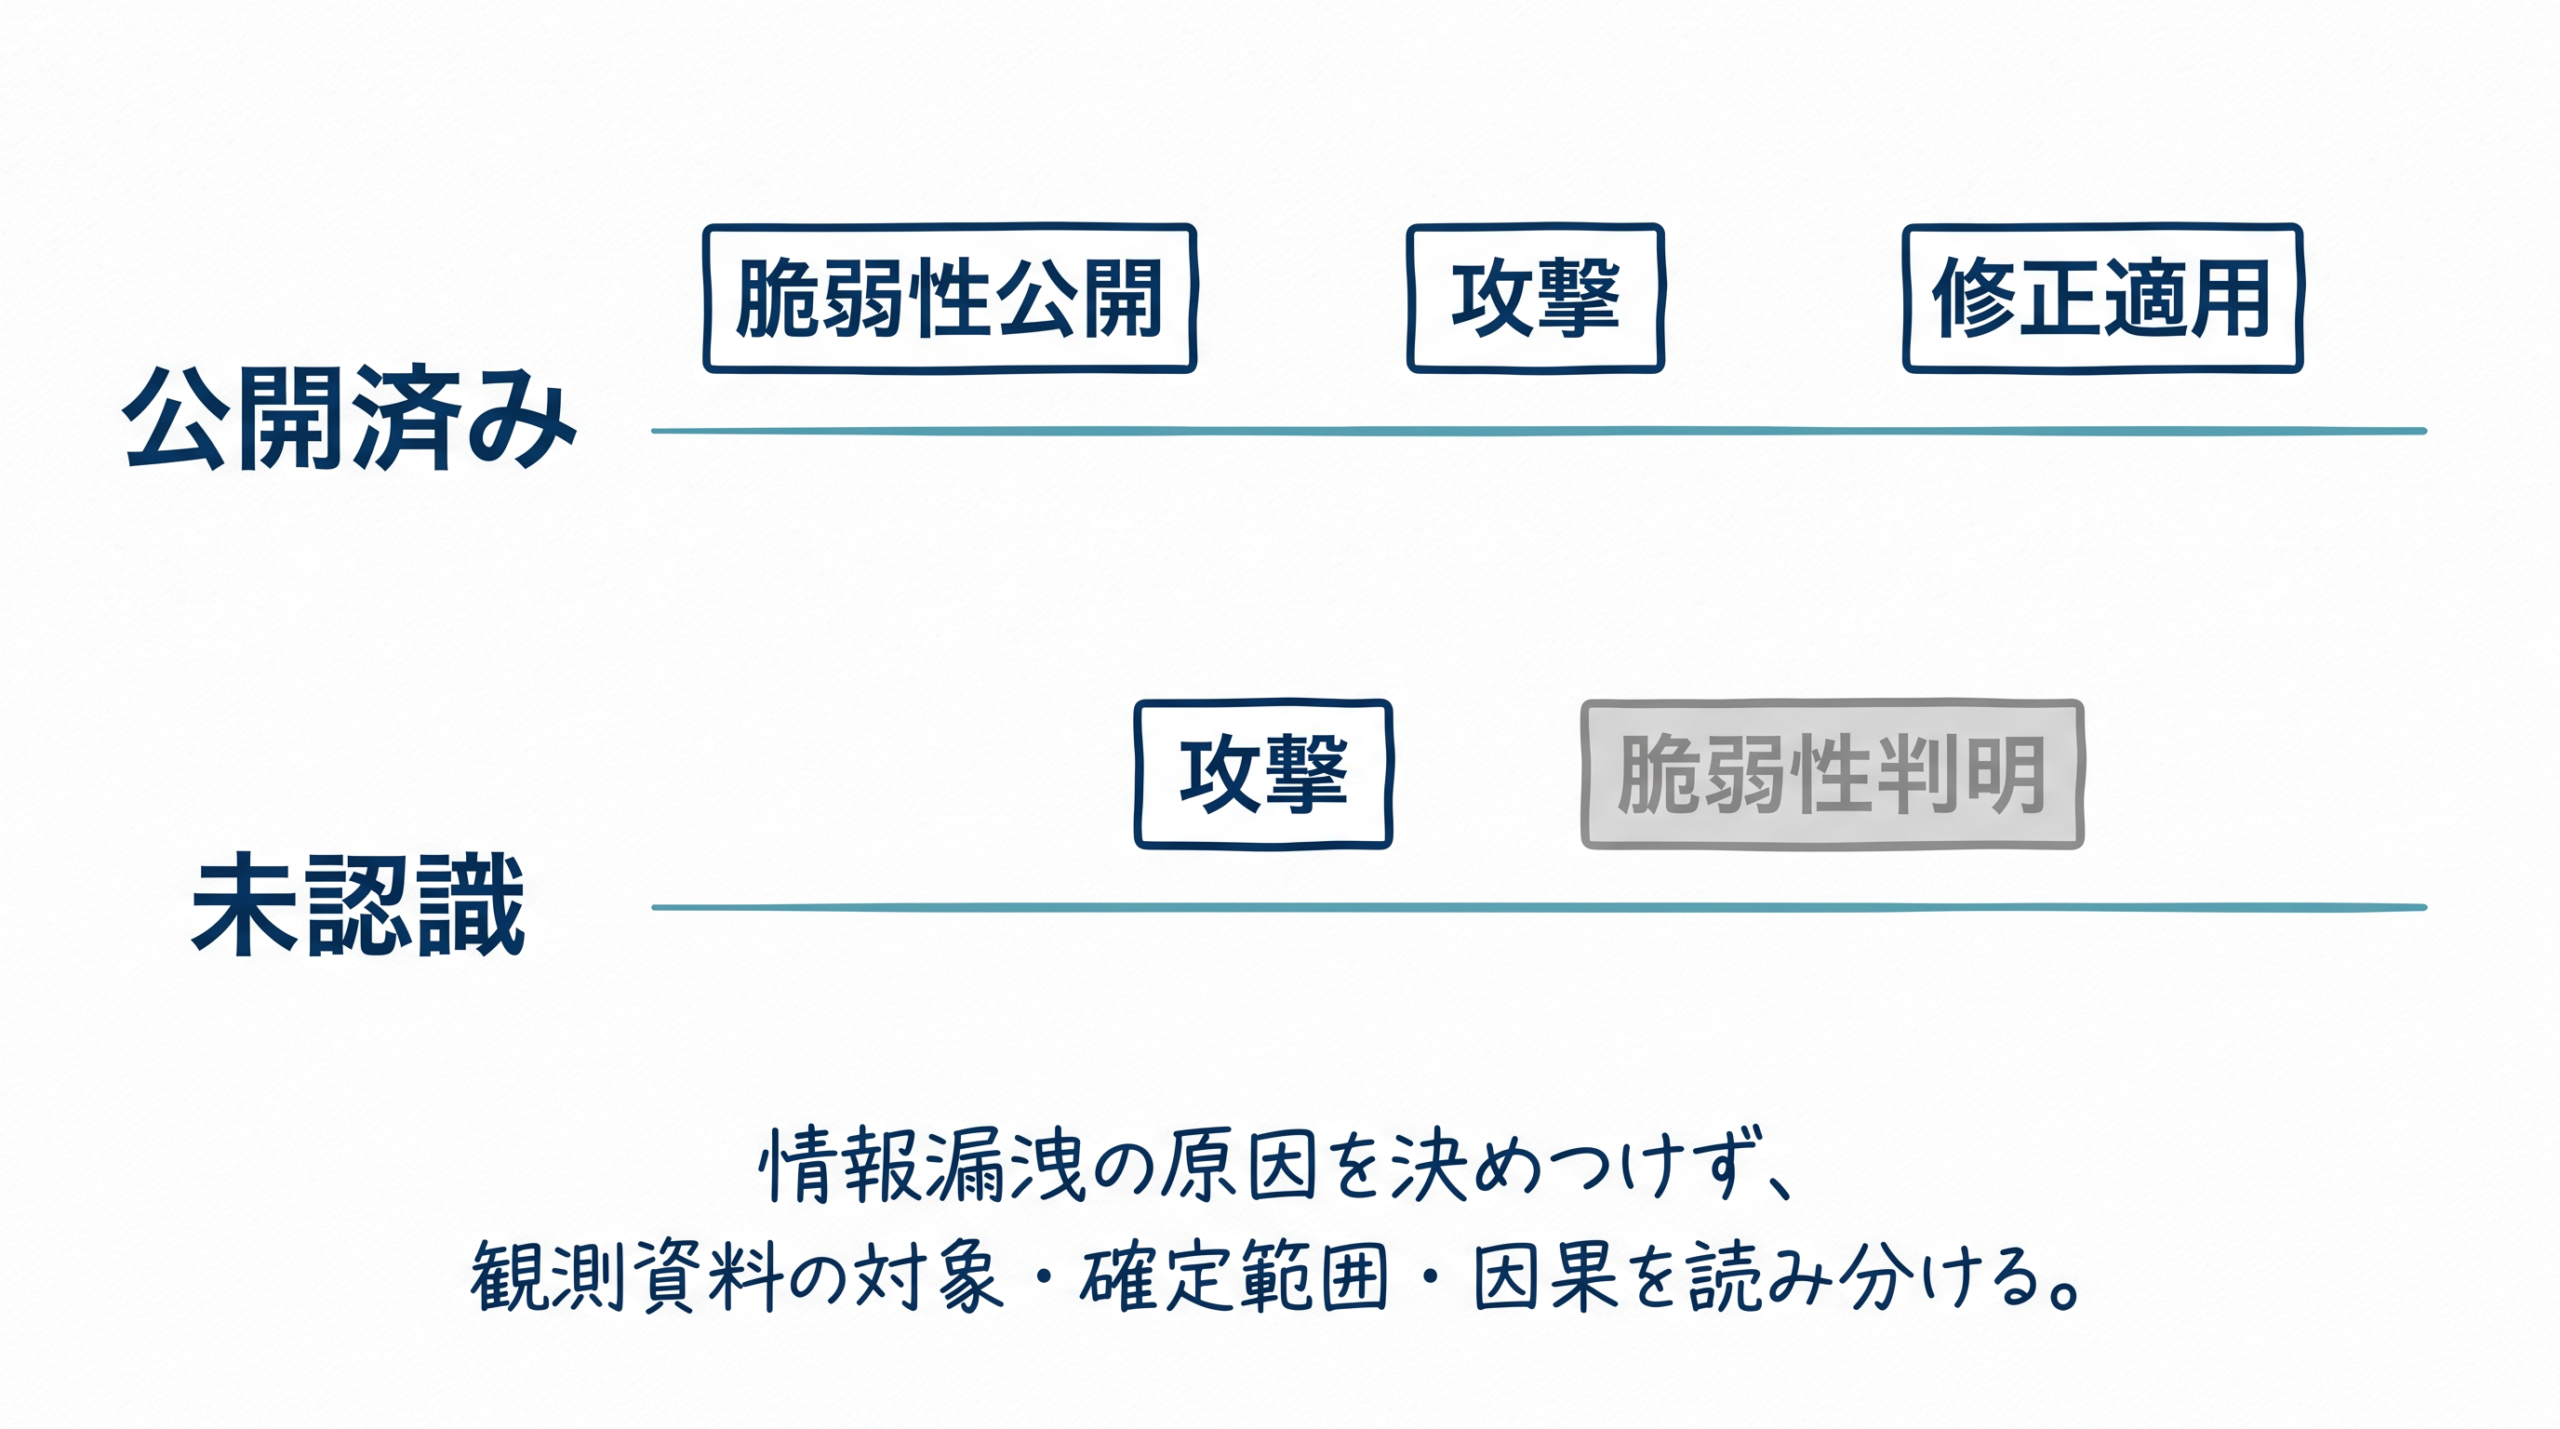
情報漏洩のニュースが流れると、その原因として「既知の脆弱性を放置していた企業に非がある」と見なす論調を目にすることがあります。しかし、企業が発表した一次資料を丁寧に読み解くと、原因を一言でまとめることは難しく、脆弱性の放置だけでは説明できない実態が見えてきます。
今回の調査では、情報漏洩やサイバー攻撃に関連する公表事例32件を個別に確認し、原因がどの程度説明されているかを整理しました。全国から無作為に抽出した標本ではありません。調査方法と事例一覧で、対象と分類理由を確認できます。
| 公表資料から説明できる段階 | 件数 | 32件に占める割合 |
|---|---|---|
| 技術的原因を公式が説明 | 6 | 18.8% |
| 技術的原因を公式が推定 | 1 | 3.1% |
| 制御・監視の弱点を公式が説明 | 1 | 3.1% |
| 入口の機器種別まで公式が説明 | 1 | 3.1% |
| 具体的原因の一次説明なし | 21 | 65.6% |
| 一次本文の追加検証が必要 | 2 | 6.3% |
技術的な原因まで公式に説明されていたのは、ソフトウェア脆弱性による5件と、攻撃ではないプログラム不備による1件を合わせた計6件のみでした。集英社の事例では、コンテンツ管理システムの設定とAPI認証情報に問題があったと企業自身が原因を推定するにとどまっています。アフラック生命保険の事例では大量照会に対する取得制限や検知の課題が説明されましたが、具体的な認証の突破手順までは明らかではありません。日本テレネットの事例はネットワーク機器経由と説明されていますが、機種や脆弱性の有無といった詳細は非公表です。個別の根拠と判断理由は原因別の調査表に記録しています。
このように、公表資料の段階では原因の説明粒度が全く異なります。原因は、攻撃者が最初に入った箇所、侵入を可能にした技術的な不備、大量取得や横展開を止められなかった管理・運用の条件などに分けて読む必要があります。VPN経由、パスワード利用、ランサムウェア感染、委託先への侵害などは、それぞれ異なる段階や関係を示しています。これらを単純な1つの原因ランキングへ混ぜてしまうと、自社でどの対策が必要かを正しく判断できなくなります。
さらに、攻撃ではないプログラム不備の1件を除いた31件の攻撃事案に絞ると、具体的な侵入方法が未公表、あるいは一次資料からの追加検証が必要な事例は23件と、全体の74.2%を占めます。実際に情報の漏洩や不正閲覧が確認された14件に限定しても、半数を超える8件(57.1%)で具体的な侵入方法は明言されていません。つまり、漏洩が発生した企業が主に何を怠ったのかを、これらの事例から全国へ一般化して推計する材料には足りないということです。分からない原因を推測で埋め、VPNの欠陥や従業員端末の操作ミス、あるいは近年話題となるAIの関与などに割り当てないことが重要です。
また、原因としてソフトウェア脆弱性が確認できた5件(HelpfeelのGyazo、デジタル庁のGSS、VOISING、KDDI、きちりホールディングスのApplyNow)についても、脆弱性が原因であることと、攻撃前に修正できる既知の脆弱性を放置していたことは同じではありません。
| 攻撃前に分かっていた範囲 | 件数 | 脆弱性5件に占める割合 | 対象 |
|---|---|---|---|
| 攻撃前に公開され、修正適用前に悪用 | 2 | 40.0% | GSS、VOISING |
| 発覚時点でベンダー未認識 | 1 | 20.0% | KDDI |
| 攻撃前の公開時期が不明 | 2 | 40.0% | Gyazo、ApplyNow |
デジタル庁のGSSの事案では、攻撃前に脆弱性が公表され、修正プログラムを適用する前に悪用されたことが追加のQ&Aで説明されています。この脆弱性の当初の深刻度はMediumであったとも記されていますが、修正が間に合わなかった日数がどれくらいか、管理者が意図的に放置していたかは公表資料からは判定できません(デジタル庁)。VOISINGでも修正を適用するまでの時間的課題が関連していますが(VOISING)、KDDIの事案のように発覚時点ではベンダーも認識していなかった未知の脆弱性が悪用されたケースもあります(KDDI)。
このように、同じ脆弱性が原因であっても事前の公開状況は異なり、すべてを同じ事前対策で防げたと断定することはできません。また、確認できた5件中の2件(40.0%)という内訳を、国内のサイバー攻撃全体の40%がパッチの放置であると読むことも誤りです。
事業担当者がこうした公表事例から学べるのは、他社の対策状況を憶測で批判することではありません。まずは公開情報から読み取れる範囲で事実を整理し、未確認の部分は問題がなかったという意味ではなく未確認として残したうえで、自社のアクセス制御や脆弱性管理の運用条件に同様の隙がないかを確認することが、現実的な対策の第一歩となります。
UncensoredなローカルAIは漏洩増加の原因なのか
近年、サイバー攻撃の手口が高度化し、情報漏洩の公表が相次ぐ背景として「AIの悪用」を懸念する声が高まっています。特に、企業や開発者の監視が届かない攻撃者の手元の計算機で動かす「ローカルAI」や、倫理的な制限を取り払った「Uncensored(無検閲)なモデル」が、被害拡大の主な原因ではないかという見方があります。ニュースなどでこうしたAIの脅威に触れ、自社への攻撃が激化しているのではないかと不安を感じる事業担当者や経営者の方も多いでしょう。
しかし、ここで冷静に状況を整理する必要があります。海外の研究などで「AIの悪用が存在すること」と、それが「日本国内の情報漏洩が増加している原因であること」は、直結する事実ではありません。本節では、現在公開されている調査データからAIの悪用について何が言えるのかを整理し、企業が憶測に振り回されずに事態を捉えるためのポイントを解説します。
まず、ニュースでよく耳にするAIの用語を切り分けて考えます。攻撃者の手元の計算機などで動かす配備形態を「ローカル実行」、モデルの計算に使う重み情報が公開されていることを「オープンウェイト」、犯罪利用などの危険な質問への拒否や内容制限が少ない特性を「Uncensored」と呼びます。これらはそれぞれ別の属性であり、同じ意味ではありません。制限の少ない公開モデルであっても、ローカルではなくクラウド上のサービスとして動かしているケースもあります。また、Uncensoredの定義や評価は研究によって異なるため、名称だけで直ちに犯罪利用と判定することはできません。
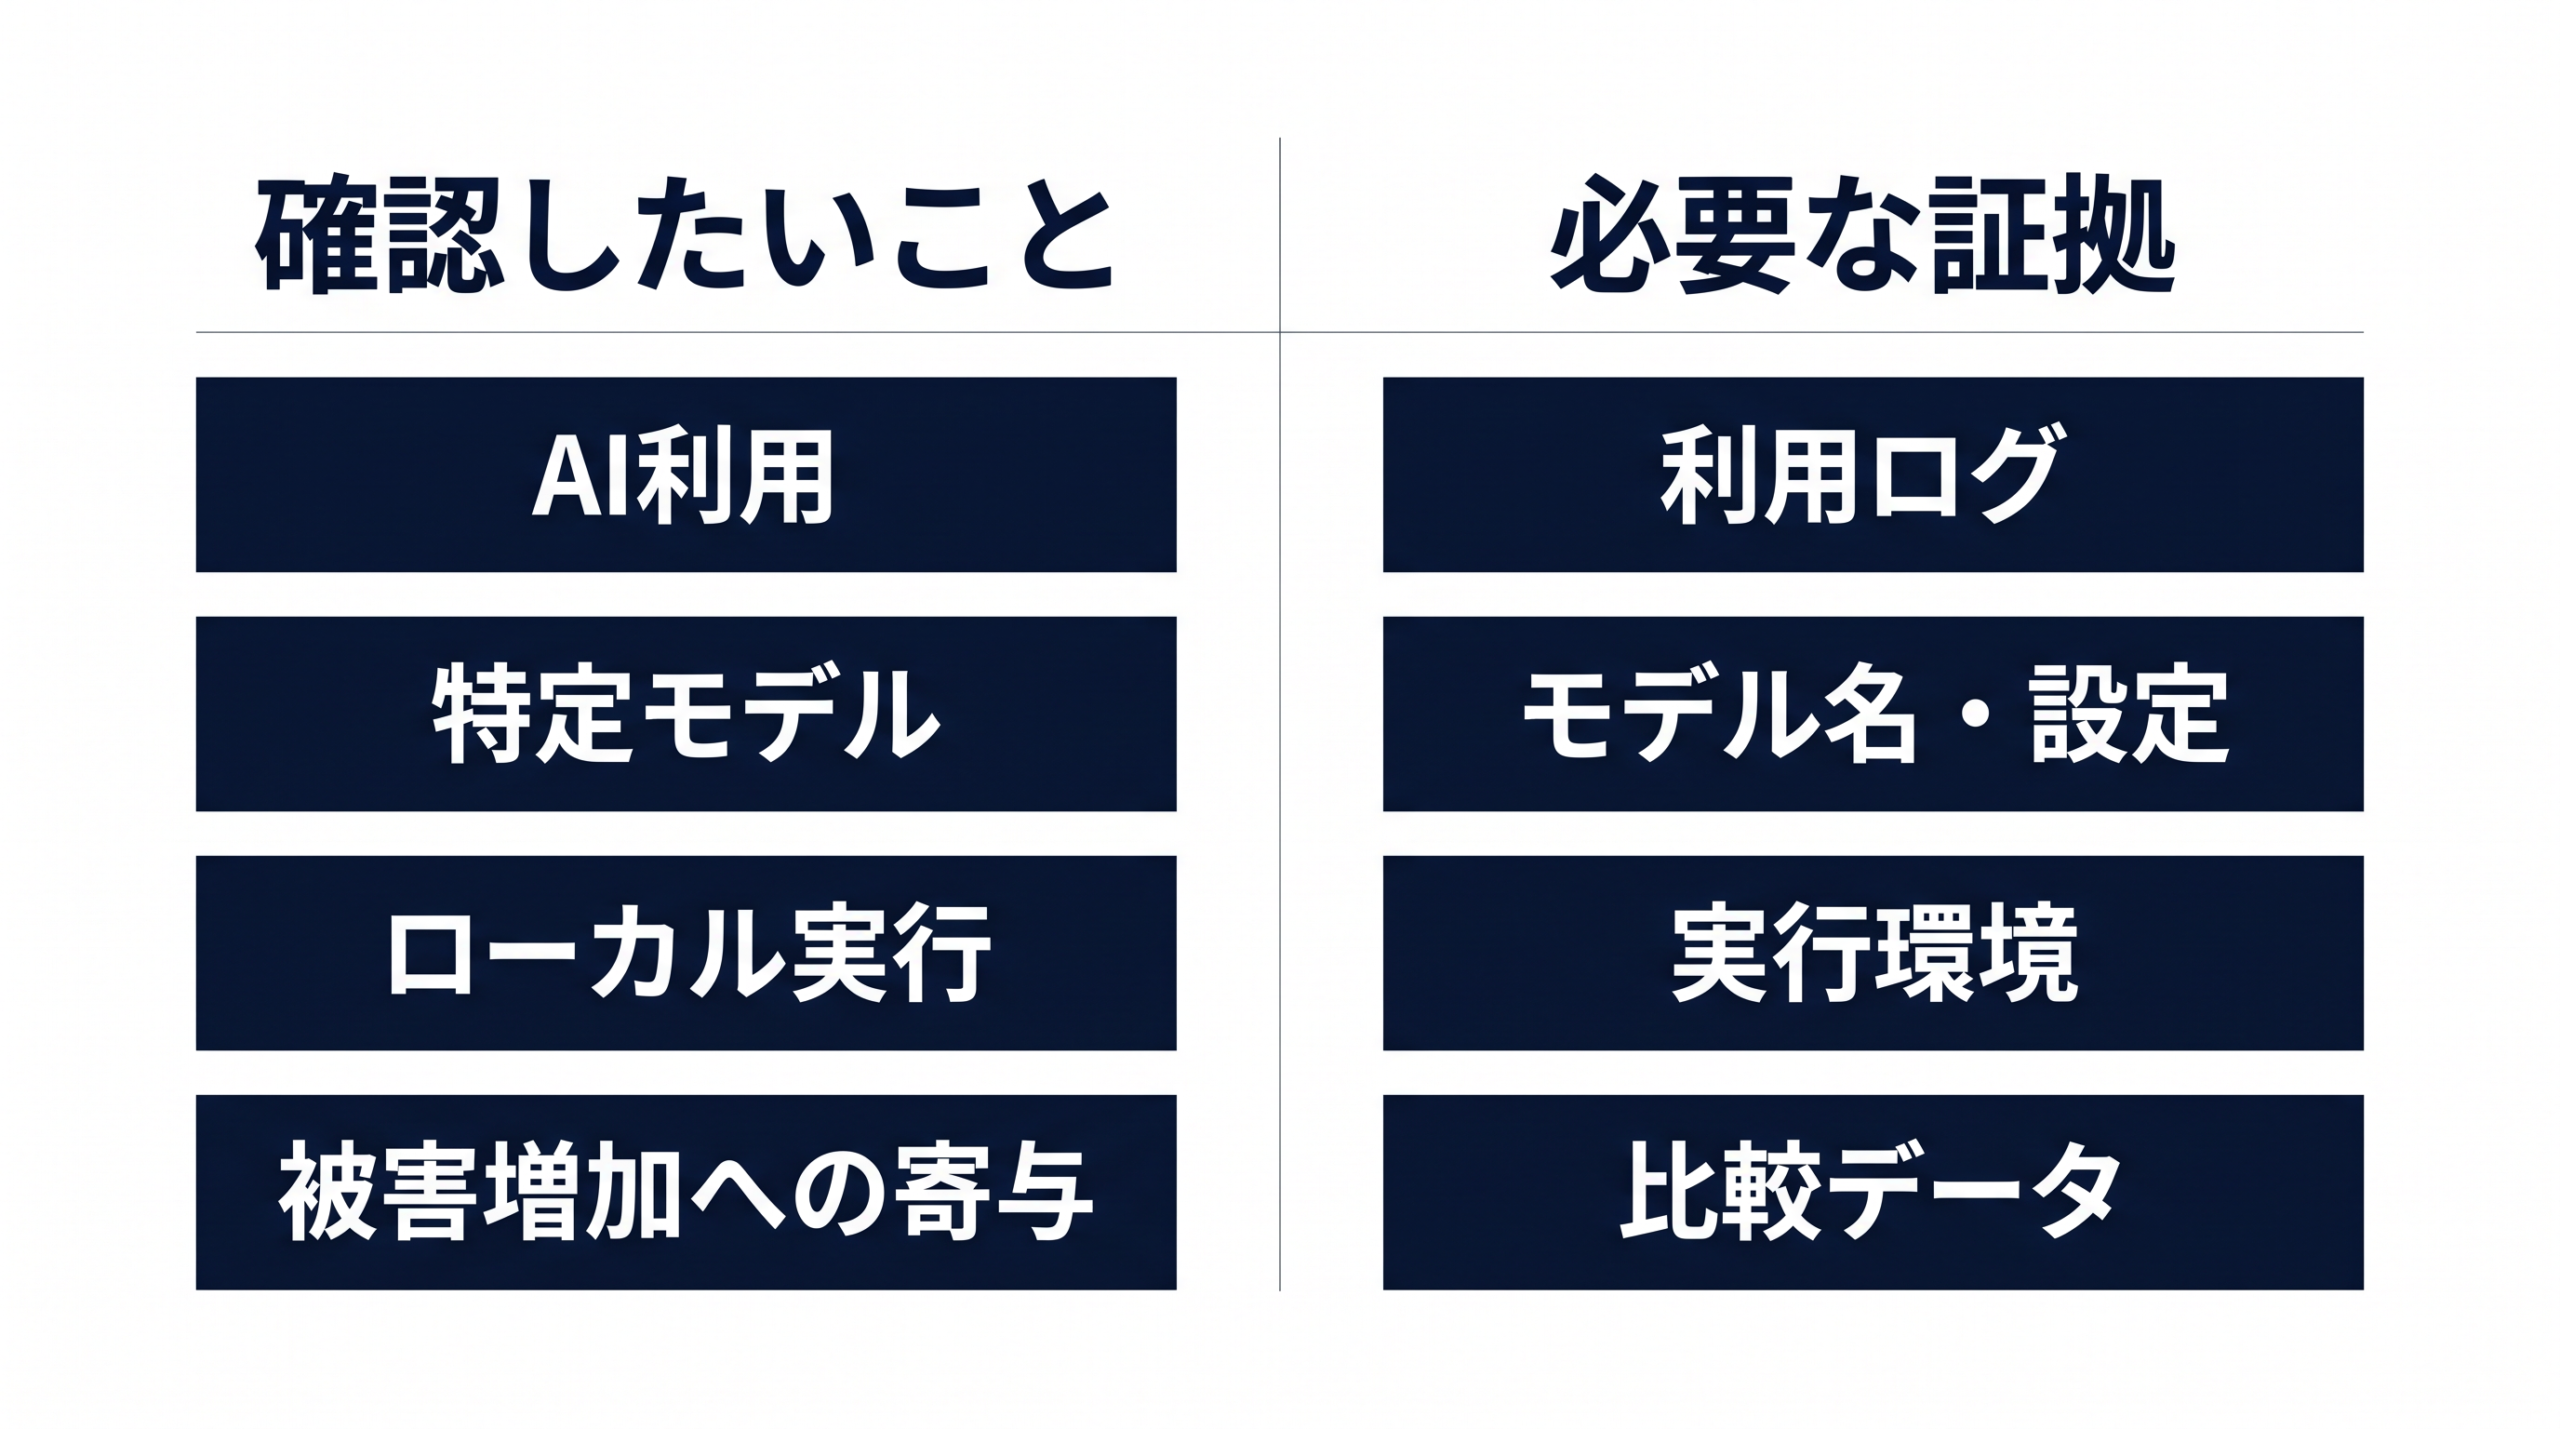
そのうえで、「Uncensoredなローカルモデルが漏洩増加の原因か」を検証するには、以下の4つの段階で証拠を区別する必要があります。
| 確認したい主張 | 必要な証拠 | 今回の確認結果 |
|---|---|---|
| 攻撃者がAIを使った | 会話・ツール実行ログ、捜査・運営者の調査結果 | 海外の一次調査で観測あり |
| 特定のUncensoredモデルを使った | モデル名・版・設定と攻撃活動との対応 | 利用サービスの研究あり。国内台帳の各事件への対応は未取得 |
| ローカルで動かした | 実行機器・配備形態の証拠 | 国内台帳の各事件について未取得 |
| そのために被害が増えた | 利用有無・時期・成功率を比較できる被害/非被害データ | 全国の因果効果を示すデータは今回未取得 |
このように、海外の調査でAIが悪用されている痕跡は確認できても、日本の実際の漏洩事件に特定のUncensoredモデルが使われたのか、それがローカル環境で実行されたのか、そしてその結果として被害件数が増えたのかという「因果効果」を示すデータは、現状では確認できていません。
では、現在公開されているAIの悪用に関する数値は、具体的に何を数えているのでしょうか。代表的な3つの調査データを見てみます。
| 一次資料 | 数値 | 数えている対象 | この数値だけでは言えないこと |
|---|---|---|---|
| Uncensoredモデルの生態系研究(2025年arXiv原稿) | 調査した52のWebアプリのうち10が攻撃支援・悪意あるコード生成カテゴリ | 特定の探索手順で見つけたWebサービス。用途は重複あり | 10件の実被害、国内の利用率、攻撃者の手元でのローカル実行 |
| Anthropicの悪用観測(2025年3月〜2026年3月) | 832の停止アカウント、13,873の行動観測。574/832(約69%)で攻撃能力開発を観測 | Claudeで検知・停止したアカウントとモデルへ求めた行動 | 全攻撃者の69%、832の漏洩事件、Uncensoredローカルモデルの利用率 |
| MicrosoftのEvilTokens調査(2026年9月) | 12,000超の侵害されたメール受信箱、10,000超の組織との関連を報告 | 1つのAI利用犯罪サービスに関連した世界の被害 | 国内全体の割合、AIがなければ発生しなかった件数、モデルのローカル実行の確定 |
これらのデータは、AIが悪用されている生態系やその存在を示す貴重な調査ですが、漏洩被害の統計としてそのまま使うことはできません。
たとえば、2025年のUncensoredモデル研究・5.1節は、特定の探索手順で見つけたWebサービスを分類したものです。ここに含まれるモデル数には量子化版などの派生が含まれており、機能分類には著者によるメタデータのキーワード照合も使われています。したがって、論文の分類をそのまま「犯罪に使われた実証済みモデル数」として扱うことはできません。一般の成人向け会話や医療相談、セキュリティ検証を含む著者の広いカテゴリを、日本の漏洩犯罪の件数へ換算するのも誤りです。
また、Anthropicのデータセットと観測結果は商用サービス側で停止対象を選んだ標本に基づく観測であり、一般利用者や全攻撃者へ割合を広げることはできませんし、ローカルモデル全体を見渡すデータでもありません。同社のリスクスコアや行動の観測は、攻撃成功確率や攻撃成功の確認と同義ではありません。MicrosoftのEvilTokens調査でも、AI利用と実際の侵害の関連は報告されていますが、AIの寄与分を推定するための比較群は示されていません。
翻って、日本国内で企業が公表した漏洩事例の集計からは何が言えるでしょうか。今回の国内台帳は企業等の被害公表を起点としているため、攻撃者側がどのようなモデル名を使い、どのような制限設定や配備形態をとっていたのか、といった会話・実行ログは事件ごとに取得できていません。だからといって「AIは使われていない」「Uncensoredモデルによる被害は0%である」と判定することもできません。今回取得した資料だけでは利用率を算出できない、という未確認の結果が残るのみです。
前節で原因として確認した脆弱性や認証・設定の問題は、あくまで被害側で侵入を可能にした条件を示しています。AIは攻撃者の調査、コード作成、標的選定、取得情報の分析などを助ける可能性があり、脆弱性の存在とAIの利用は同時に成立し得ます。そのため、脆弱性が判明したという理由だけでAI利用を否定することはできません。逆に、自動化された挙動や大量アクセスを受けた事実だけを見て、AIの利用を断定することもできません。
「制限のないローカルAIが漏洩増加の原因である」という因果効果を統計的に確認するためには、さらに厳密なデータが必要です。事件ごとにAI利用の確認状態、モデル名・版、拒否制限の設定、ローカルとクラウドの配備形態、利用工程、証拠の種類、攻撃の成否を記録し、未確認のものを安易に「非利用」へ変換しないことが求められます。さらに、被害が出た事件だけでなく失敗した攻撃のデータも集め、標的企業の規模や業種、脆弱性の公開時期、修正状況、観測方法の違いといった条件をそろえて比較しなければなりません。
AIモデルが公開された前後に漏洩件数とダウンロード数が同時に増えたとしても、それは相関に過ぎず因果の証明にはなりません。証拠のある攻撃群での成功率・所要時間・試行数の比較や、同じ条件でAI利用の有無を変えた実験があって初めて寄与の一部を評価できます。ただし、実験環境で攻撃能力が上がったという結果が出たとしても、それが日本の実際の被害増加へどれだけ寄与したかという実被害への寄与率は別の結果です。事業担当者としては、センセーショナルなAI脅威論に振り回されて原因を決めつけるのではなく、事実として確認できる情報と未確認の推測を切り分けることが重要です。
企業の発表から、自社で確認する順番を決める
これまで見てきたように、相次ぐ情報漏洩のニュースの背景には、さまざまな実態があります。被害規模の数字が人数とは限らないこと、多くの事案で具体的な侵入方法が未公表であること、そしてAIの悪用が直ちに国内被害増加の根本原因とは証明されていないことが分かりました。情報が不完全な中で、非専門家である事業担当者や経営者が「何から手をつければよいのか」と戸惑うのは当然です。
しかし、他社の公表事例は、憶測で不安になるためのものではなく、自社の現状を点検するためのヒントになります。「未知の脆弱性を突かれたからだ」「最新のAIによる攻撃を受けたからだ」と一つの原因に押し込めるのではなく、公表された事実から「自社や委託先で確実に確認できること」を抜き出し、順番を決めて点検していくことが重要です。
確認の第一歩は、自社が直接管理するシステムだけでなく、業務委託先やクラウドサービスにおける「情報の預け方」を見直すことです。公表された事例からは、共通システムを起点として複数の組織へ被害が波及する実態が読み取れます。
たとえば、「ショップサーブ」の事案では、同サービスを利用していたPFU(PFU)やキングジム(キングジム)が過去の顧客データの漏洩候補を公表しました。PFUは最大169,355件の注文データを対象候補としていますが、これは現在の同社のECサイトが侵害されたのではなく、過去に利用していたシステムを通じた影響です。また、採用管理システム「ApplyNow」の事案でも、吉野家やはなまるの応募者情報が影響を受け、契約終了後に残っていたデータも含まれていました(吉野家・はなまる)。宿泊予約管理の「TEMAIRAZU」でも、提供元が不正アクセスを公表し、複数のホテルが予約情報を含む不審メッセージを告知しています。ただし、侵害とメッセージとの関連は調査中です(手間いらず)。
これらを踏まえ、まずは以下のリストに沿って委託状況を確認します。
| 確認対象 | 点検するポイント |
|---|---|
| 利用中の外部サービス | 自社の顧客や従業員の情報が、どこに、どれだけ預けられているか |
| 利用を終了したサービス | 退会後や契約終了後に、データが委託先に残らず確実に削除されているか |
| 委託先への提供範囲 | 業務に不要な項目まで一括して外部システムへ渡していないか |
第二に確認すべきは、自社のシステムにおける「修正適用の時間差」と「通常を装った大量取得」に対する備えです。
原因がソフトウェア脆弱性であると確認できた5件のうち、デジタル庁のGSS(デジタル庁)とVOISING(VOISING)の事案では、攻撃前に脆弱性が公開されていましたが、修正プログラムを適用する前に悪用されたことが説明されています。一方で、KDDIの事案のように、発覚時点ではベンダーも認識していなかった脆弱性が悪用されたケースもあります(KDDI)。修正パッチが公開されてから自社のシステムへ適用するまでにはどうしても時間差が生じるため、その隙間をどう守るかが問われます。
また、アクセス制御や監視の課題も確認項目です。今回の公表事例のなかには、アフラック生命保険のように通常アクセスに見える通信による大量照会に対する取得制限や検知の課題に言及したものや、集英社のようにコンテンツ管理システムの設定とAPI認証情報に問題があったと推定されたものがあります。
これらの公表から、社内のシステム管理部門や委託先へ以下を問いかけることができます。
| 確認対象 | 点検するポイント |
|---|---|
| 脆弱性パッチの適用 | 修正プログラムの適用が間に合わない期間、代替の防御策や監視手段はあるか |
| 認証と設定の管理 | 不要になったAPIキーや、業務に不要なアクセス権限はないか |
| 異常なアクセスの検知 | 正規の認証を通過した通信であっても、通常ではあり得ない大量のデータ取得を検知・制限できるか |
情報漏洩のニュースを目にすると、どうしてもセンセーショナルな要因や未知の脅威に気を取られがちです。しかし、実際の企業の公表資料を紐解くと、契約終了後のデータ残存や修正パッチ適用の時間差、そして認証や監視の不備といった、地道な管理の延長線上に課題が潜んでいることが分かります。憶測で不安を煽る情報を鵜呑みにせず、事実に基づいた自社と委託先の点検を順番に進めることが、具体的な対策を決める材料になります。
よくある質問
情報漏洩対策を見直す際の疑問について、統計や公表事実から言えることを整理します。
Q1. 情報漏洩の件数は減っているというデータと、被害が増えているというニュースが混在しているのはなぜですか?
どちらのデータも事実ですが、集計している対象の母集団が異なります。
たとえば、警察庁が把握した企業や団体等へのランサムウェア被害報告は、2026年上半期に123件となり、半期の集計開始以降で最多となりました(警察庁2026年上半期資料・本文9頁)。一方で、東京商工リサーチがまとめた上場企業とその子会社における漏洩・紛失事故の件数は、2024年の189件から2025年には180件へと4.8%減少しています。
ただし、件数が微減していても被害規模は拡大しています。同調査における2025年の公表された延べ対象人数は30,636,910人分となり、前年比で93.1%も増加しました(東京商工リサーチ)。特定の攻撃手口のニュースが増えたからといって全件数が増えたと単純化せず、公表された延べ対象人数の合計が増加している点にも注意を向ける必要があります。
Q2. 漏洩の原因は、サイバー攻撃などの不正アクセスがほとんどなのでしょうか?
これも、どの統計を見るかによって割合が大きく変わります。
先述の上場企業等の公表事故180件(2025年)では、原因の64.4%にあたる116件をウイルス感染や不正アクセスが占めています(東京商工リサーチ)。しかし、日常的な書類の紛失や医療機関での誤交付などを含む、個人情報保護委員会への直接報告13,345件(2025年度)を分母にすると、報告者・委託先への不正アクセスと不明を含めても計1,256件となり、全体の9.4%にとどまります。この報告では、紙媒体のみの事案が10,263件(76.9%)を占めました(個人情報保護委員会)。
ニュースで見つけやすい大規模事案と、行政に報告される日常的なミスでは性質が異なります。事業担当者は、高度なシステム侵害への備えだけでなく、委託先を含めた物理的な書類管理の徹底も並行して進める必要があります。
Q3. 「既知の脆弱性が放置されていた」という報道を見ますが、システムを最新に保てば安心ですか?
ソフトウェアを最新に保つことは基本ですが、すべての事案が「事前に公開された修正パッチの単純な放置」だけで説明できるわけではありません。
今回確認した公表事例のうち、技術的原因がソフトウェア脆弱性であると確認できた5件の内訳を見ると、状況の違いが分かります。
| 攻撃前に分かっていた範囲 | 件数 | 脆弱性5件に占める割合 | 対象の事例 |
|---|---|---|---|
| 攻撃前に公開され、修正適用前に悪用 | 2件 | 40.0% | GSS、VOISING |
| 発覚時点でベンダー未認識 | 1件 | 20.0% | KDDI |
| 攻撃前の公開時期が不明 | 2件 | 40.0% | Gyazo、ApplyNow |
デジタル庁のGSS事案などのように、攻撃前に脆弱性が公表され、修正プログラムを適用する前に悪用されたケースが存在します(デジタル庁)。一方で、KDDIの事案のように、発覚時点ではベンダー自身も認識していなかった未知の脆弱性が悪用されたケースもあります(KDDI)。
これらを同じ対策で事前にすべて防げたと断定することはできません。パッチ適用が間に合わない期間の監視をどうするか、設定や認証情報に別の隙がないかといった多層的な確認が求められます。
Q4. 制限のないローカルAIモデルが、日本国内の漏洩事故を急増させているというのは本当ですか?
海外の研究や調査において、AIが攻撃能力の開発などに悪用されている証拠は確認されています。しかし、今回確認した資料からは、日本の漏洩増加への因果効果を確かめられません。
たとえば、Anthropicによる観測(2025年3月〜2026年3月)では、停止対象とした832アカウントのうち約69%で攻撃能力開発の試みが観測されました(Anthropic)。また、Microsoftの調査では、1つのAI利用犯罪サービスに関連して12,000超の侵害されたメール受信箱が報告されています(Microsoft)。
これらはAI悪用の生態系を示す事実ですが、特定の制限のない(Uncensoredな)モデルが攻撃者の手元の計算機(ローカル)でどれだけ実行されたのかを示す割合ではありません。また、日本国内の公表事案において、AIが利用されたという確認や、AIがなければ被害が発生しなかったという寄与分も未確認です。大量のアクセスや自動化の痕跡を見ただけで、憶測によってAI利用と断定することは避け、事実に基づいた原因調査を行うことが重要です。
参考文献
- 東京商工リサーチ・2025年上場企業調査
- 個人情報保護委員会・2025年度年次報告
- 警察庁・2025年サイバー脅威情勢
- 警察庁2026上半期
- EPARK第二報
- Eストアー・ショップサーブ第二報
- アフラック・FAQ
- Helpfeel・Gyazo第二報
- デジタル庁・GSS
- PFU漏洩公表
- 吉野家・はなまる
- 手間いらず・9月28日発表
- デジタル庁GSS不正アクセスQ&A(2026年9月12日更新)
- VOISING・第四報
- KDDI調査結果
- Consiglieres in the Shadow(arXiv v1、2025年8月18日)
- Anthropic Mapping AI-enabled cyber threats(2026年6月3日)
- Microsoft Disrupting EvilTokens(2026年9月22日)
- キングジム
調査基準日:2026年10月2日
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント