コンサルティングの案件で提案書を作る際、証拠を探す場所は一つではありません。公開されているウェブサイトの検索だけで足りることもあれば、社内の資料や有料の市場データが必要な場合もあります。そのため、チームに不足している証拠へたどり着けるAIリサーチエージェントを選びます。
この記事では、公開情報を広く調べる製品、社内資料へ直接接続する製品、有料の市場データを読み込む製品、過去の案件を記憶する製品の合計7つを扱います。機能の多さで総合順位を付けるのではなく、案件で求める証拠の経路に合わせた選び方を説明します。
AIには、情報の検索や比較、反対意見の抽出といった作業を任せられます。しかし、見つけた主張の引用箇所や調査の条件、機密情報の取り扱いを最終的に確認するのは人間のコンサルタントです。この役割分担を製品選びの前に決めておけば、回答の速さだけを理由にAIを選ばずに済みます。
コンサル向けAIリサーチエージェントを証拠で選ぶ
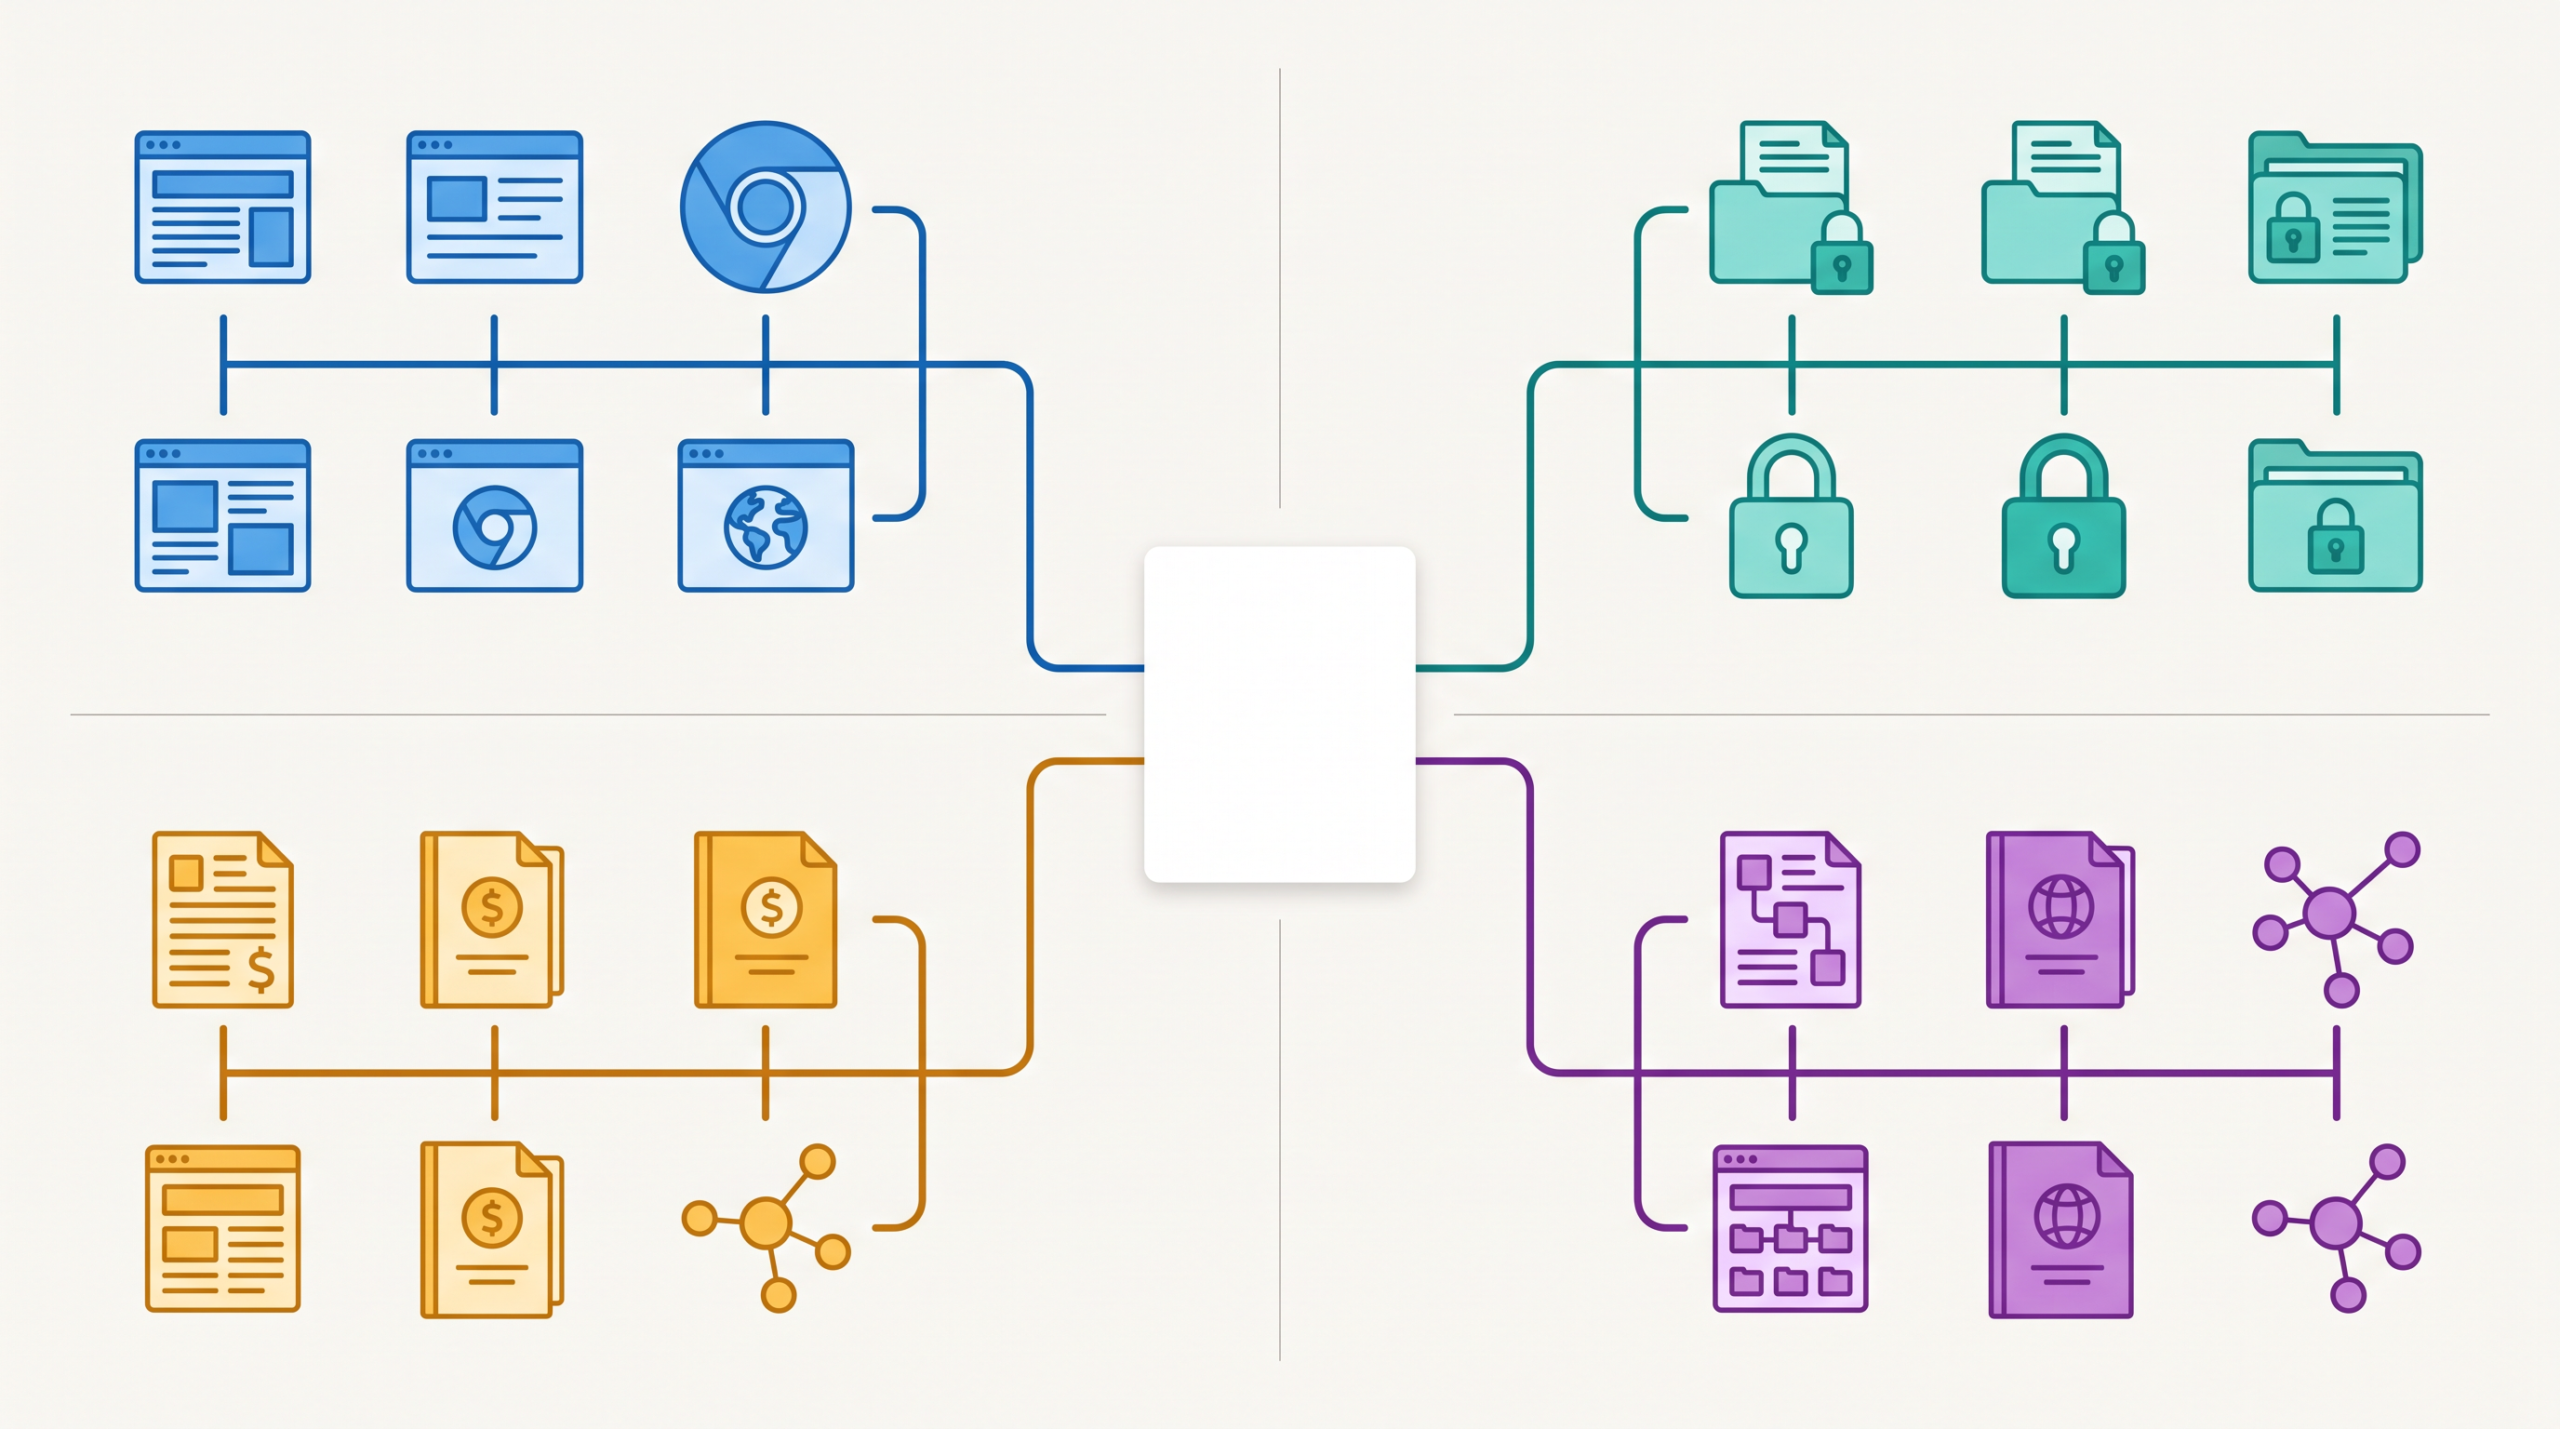
コンサルティングの案件では、AIに何を調べさせるかよりも、判断に必要な証拠がどこにあるかを先に決めます。製品の総合的な性能ではなく、いま不足している証拠をどこから持ってくるかという経路に合わせて選ぶことが重要です。
公開されている情報だけで答えられる問いなら、汎用的なDeep Researchの機能で始められます。公開されたウェブサイトや手元にあるファイルを使うため、一般的なAI製品が最初の候補になります。
社内の会議記録、提案書、メールなどの情報が必要な場合は、組織が管理する接続機能が要ります。個人判断で資料をアップロードせず、組織が許可した接続機能、社内環境、ファイル添付を使える製品を選びます。
一般のWeb検索では届かない決算説明会資料や有料の調査資料が中心になる場合は、契約済みのデータベースを検索する権限が必要です。このときは、有料の市場データや企業情報を読み込める専門的な製品が候補になります。
さらに、過去の案件で得た論点を次の案件へつなぐ必要があるなら、単発でレポートを作るだけの機能では足りません。過去の調査結果を記憶し、ナレッジグラフとして情報を蓄積できる仕組みを選定の基準にします。
不足している証拠と確認条件を、次の表で整理します。
| 不足している証拠 | 主な候補 | 選定時の確認 |
|---|---|---|
| 公開Webと手元ファイル | ChatGPT、Gemini、Perplexity | 検索範囲、ファイル入力、引用 |
| Google Workspaceの社内文書 | Claude、Gemini | 管理者設定、対象サービス、権限 |
| Microsoft 365の社内文書 | Microsoft 365 Copilot Researcher | メール、会議、ファイル、コネクター |
| 有料の市場・企業情報 | AlphaSense | 契約コンテンツ、自社データ、原文への移動 |
| 案件をまたぐ知識 | Snorbe | 記憶、ナレッジグラフ、反対仮説の探索 |
不足している証拠の場所によって、選ぶ製品の条件は変わります。ここからは、それぞれの証拠経路に対応する7つの製品を確認します。
コンサル向けAIリサーチエージェント7選
ChatGPT Deep Researchは、ファイルや表計算を添付し、Web上の複数の情報源を調べる機能です。OpenAIの製品発表によると、アプリやMCPへの接続機能や、検索先を信頼できるサイトに制限する機能があります。特定のサイトを指定した競合分析の入り口に向いています。
Claude Researchは、Web上の情報とGoogle Workspaceをまたいで調べ、確認用の引用を付けます。これはAnthropicの発表で案内されており、Gmail、カレンダー、ドキュメントを検索する接続は管理者が設定します。社内の会議記録と外部市場の変化を同時につなぎたい場合の候補になります。
Gemini Deep Researchは、調査を始める前に計画を編集したい場合に使います。Googleのヘルプによると、Google検索が基本の情報源です。Gmail、Googleドライブ、アップロードしたファイル、NotebookLMのノートも追加できます。Google Workspaceを調査対象にするチームでは候補になります。
Perplexity Deep Researchは、公開情報を広く集めて論点を見つける初期の段階で使います。Perplexityの製品発表では、検索、資料の読み込み、推論を繰り返し、結果をPDFなどの文書へ出力する流れを示しています。2分から4分という所要時間は提供元の公称値であり、他の製品と同じ条件で比較したものではありません。
Microsoft 365 Copilot Researcherは、メール、会議、ファイル、チャットとWebを横断して検索します。Microsoftの説明によると、Salesforce、ServiceNow、Confluenceなどの外部データもコネクターを経由して扱えます。Teamsに記録した情報と社外の情報を一つの調査にまとめたい組織に向いています。
AlphaSense Deep Researchは、公開された情報だけでなく、公開および非公開市場の有料コンテンツや自社データを検索対象にします。これはAlphaSenseの製品説明で案内されています。5億件を超える文書数や所要時間は提供元の公称値であり、実際に読める資料の範囲は契約内容によって変わります。
Snorbeは、ファイルと専門のデータベースを横断して調べ、その結果をナレッジグラフへ蓄積します。Snorbeの公式ページでは、過去の調査の参照、反対仮説の探索、未調査領域の検出を案内しています。調査結果を記憶させて次の案件に活かしたい場合に使います。
ここからは、これら7つの製品がそれぞれどのような証拠経路や確認条件を持っているかを整理して比較します。
7製品を証拠経路と確認条件で比較する
案件で製品を比較する際、最初に見るべきは機能の多さではなく、必要な原典へ移動できるかという経路です。AIの回答から元の契約資料や社内文書、政府統計へ戻ることができなければ、提案書の根拠として使うことはできません。
各製品の証拠経路と人が確認する点を、同じ列で比べます。
| 製品 | 主な証拠 | 社内データの経路 | 向く場面 | 人が確認する点 |
|---|---|---|---|---|
| ChatGPT Deep Research | 公開Web、添付資料、接続アプリ | ファイル、アプリ、MCP | 幅広い競合・市場調査 | 引用箇所と検索対象 |
| Claude Research | 公開Web、Google Workspace | 管理者が有効にした連携 | 会議・メールと外部情報の統合 | 文書権限と引用元 |
| Gemini Deep Research | Google Search、Workspace、ファイル | Sourcesから選択 | 計画を編集して進める調査 | 選択した情報源と対象期間 |
| Perplexity Deep Research | 公開Web | Enterpriseの社内検索は別途確認 | 初期スキャンと共有 | 原典の対象範囲 |
| Microsoft 365 Copilot Researcher | Microsoft 365、Web、コネクター | 組織のMicrosoft 365権限 | 社内外を横断する案件調査 | コネクターとアクセス権 |
| AlphaSense Deep Research | 有料市場資料、自社データ | 契約済みデータ環境 | DD、M&A、企業・市場調査 | 契約範囲と原文 |
| Snorbe | Web、専門DB、ファイル、過去調査 | ファイルと組織環境 | 継続調査と知識蓄積 | ノードの出典と反証 |
7つの製品は、主に四つの経路に分かれます。ChatGPT Deep Research、Gemini Deep Research、Perplexity Deep Researchのような公開情報を中心とする製品は、幅広い市場調査や初期のスキャンに向いています。これらの製品を使う場合、人が確認するのは検索対象の信頼性や情報の対象期間です。
Claude ResearchやMicrosoft 365 Copilot Researcherは、社内のメールや会議記録と外部情報を統合する場面に適しています。ここでは、組織の管理者が設定したアクセス権限が正しく適用されているか、引用元が権限内の文書であるかの確認が重要になります。
AlphaSense Deep Researchのような専門データベースを検索する製品は、M&Aや詳細な企業調査の候補になります。この経路では、自社の契約範囲で原文をどこまで読めるかが確認の焦点です。
また、Snorbeのように過去の調査を蓄積する製品では、参照した情報の出典が正しいかを確認しながら、継続的に知識を深める場面に向いています。
どの経路を選ぶにしても、AIが示した引用を人が確かめる作業は残ります。2026年のプレプリントは14モデルを評価し、強いモデル群でも引用の事実一致が39〜77%だったと報告しました。出典帰属の評価研究は査読前であり、7製品の順位を示す資料ではありません。
同研究では、検索ツールの呼び出し回数を増やすと、かえって事実との一致率が下がる現象も確認されています。そのため、AIが提示したURLを開き、対象や調査主体、引用箇所を照合しやすい画面になっているかが、実務での使いやすさを左右します。
一つの製品ですべての調査を賄う必要はなく、公開情報の初期調査と有料資料の調査で製品を分けることも有効です。証拠の経路と原典の確認条件を確かめた後は、実際の案件と同じ仮説を用意し、入力から出力、人の確認までの一連の手順を試して比較します。
市場参入仮説をAIで検証する手順
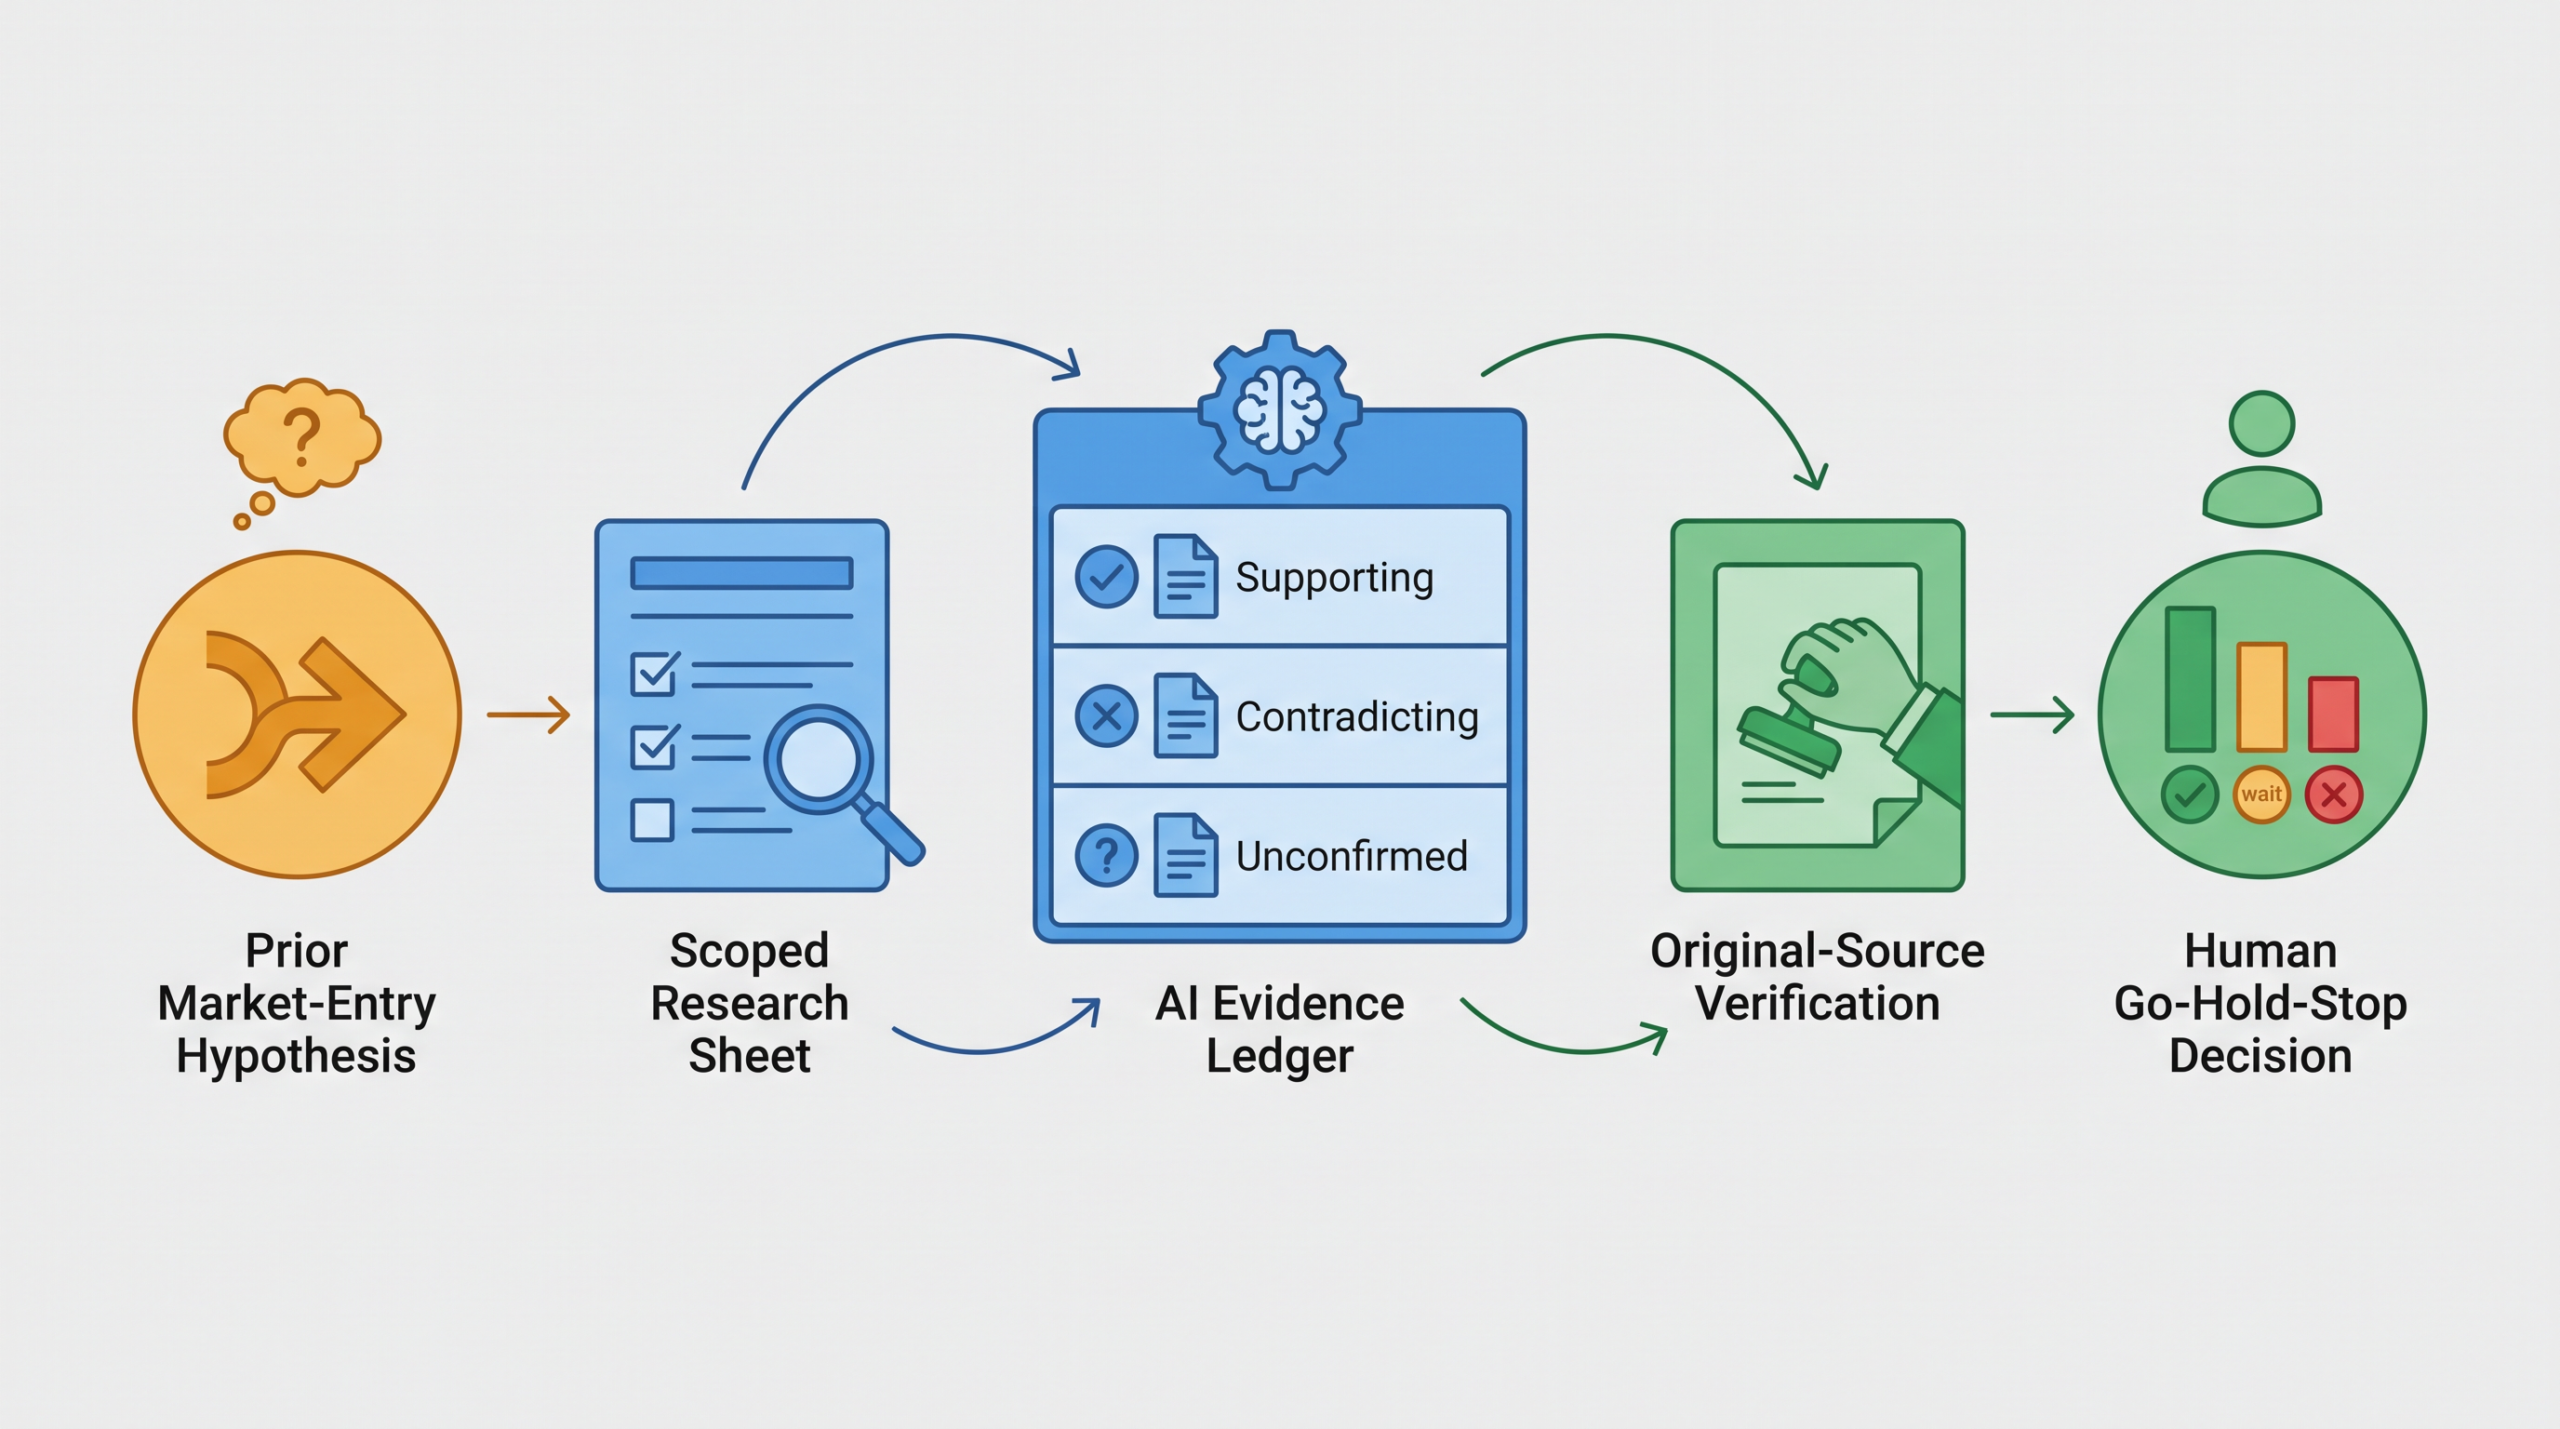
証拠の経路を選んだら、実際の案件と同じ仮説を使って製品の出力を試します。ここでは、新市場への参入調査を続けるか、別の案に移るかを決める場面を想定します。
AIに任せるのは、市場の概要をまとめた文章を作ることではありません。仮説を支持する証拠と反する証拠を分ける「証拠台帳」を作らせます。
検証の準備として、まずは事前仮説を立てます。「国内の中堅製造業には、既存製品で満たされていない需要がある」といった内容です。あわせて、対象とする地域、期間、顧客の区分、採用してよい情報源を用意します。社内資料を使う場合は機密区分を確認し、外部のAIに渡せない情報を除外します。
ChatGPTを使う場合、新しいチャットでDeep Researchを選びます。そして、利用が許可された調査票をファイルとして添付します。公開されているWebの情報を検索対象にし、社内資料は組織が許可したアプリや接続機能(MCP)、ファイルの添付だけで渡します。
AIへの指示では、検証したい仮説と調査の条件を明確に伝えます。その上で、見つけた情報を「支持する証拠」「反する証拠」「未確認」の三つに分けるよう依頼します。また、それぞれの主張に原典のURLと該当箇所を付けるよう求めます。最後に、次に調べるべき項目と暫定的な判断を出力させます。
実際の依頼では、条件と出力列を次のように指定します。
市場参入仮説「国内の中堅製造業には、既存製品で満たされていない需要がある」を検証してください。対象は日本、従業員100〜999人、基準日は2026年8月1日です。添付した調査票と指定サイトだけを使ってください。
各主張を「支持する証拠」「反する証拠」「未確認」に分けてください。各行に原典URL、発行主体、対象企業、調査期間、引用箇所を付けてください。既存製品で主要課題が解消済みなら反証として扱ってください。最後に「追加調査」「保留」「見送り」の暫定判断と、次に確認する3項目を示してください。
AIから証拠台帳を受け取ったら、コンサルタントが一行ずつ内容を確かめます。次の表は記入例であり、実在企業の調査結果ではありません。
| 判定 | AIが示した内容 | 人が開く原典 | 確認後の扱い |
|---|---|---|---|
| 支持 | 中堅製造業で対象業務の手作業が残る | 政府調査の該当表 | 母集団が従業員100〜999人なら支持候補にする |
| 反証 | 主要競合が同じ課題へ対応済み | 競合製品の公式ヘルプ | 対象機能と提供地域が一致すれば反証にする |
| 未確認 | 導入障壁を示す定量資料がない | 業界団体または顧客調査 | 原典が見つからなければ追加調査へ回す |
AIの出力は完成したレポートではなく、人が確認するための下書きとして扱います。
コンサルタントは、示された原典のURLを実際に開きます。資料の対象地域と調査期間を照合します。データの単位、調査主体、引用箇所も今回の条件と合うか確認します。
リンク先の記述がAIの主張を裏付けていなければ、証拠から外します。権限外の社内資料や、有料資料の未契約部分が含まれていた場合も採用しません。
正しい証拠だけを残した後は、それをもとに意思決定を行います。課題がまだ解決されておらず証拠がそろっていれば、追加の調査へ進みます。既存の製品ですでに解決されていることが分かれば参入を見送り、証拠が足りなければ判断を保留します。
こうして仮説を検証し判断を下した後は、調査結果を提案書に使う前に、情報の取り扱いをさらに細かく点検する必要があります。
引用と機密情報を公開前に確認する
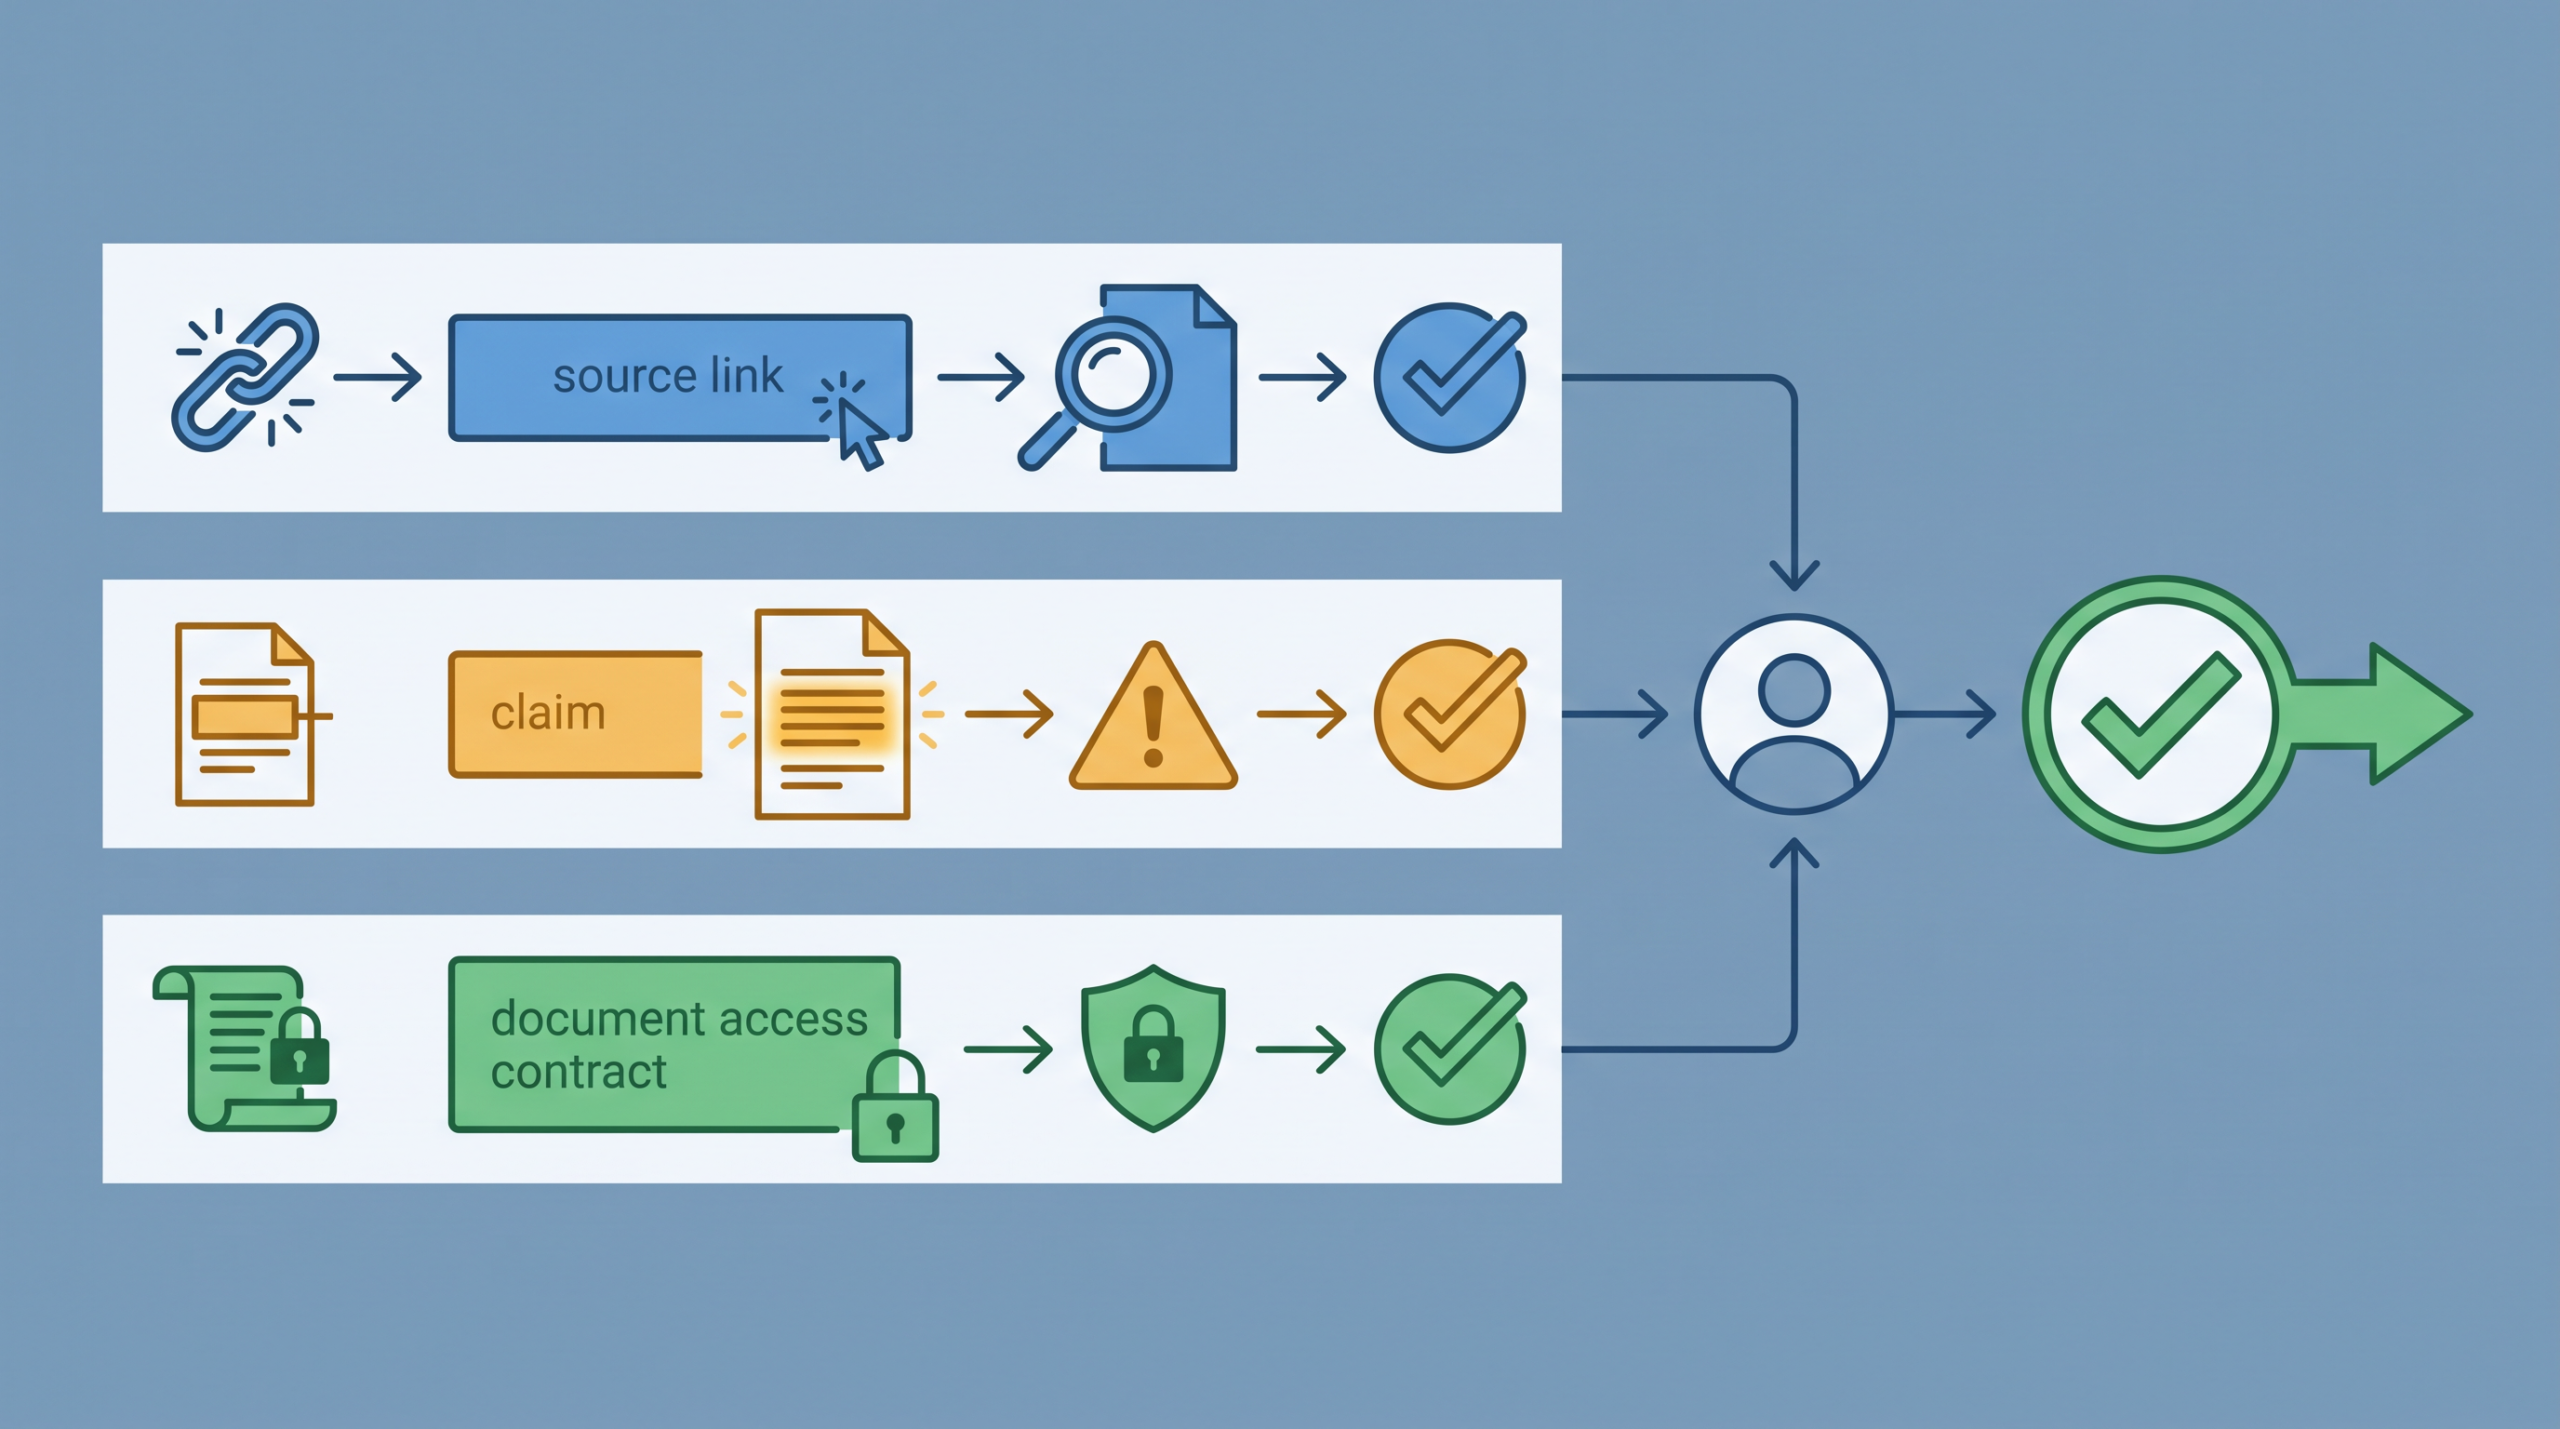
調査結果を提案書にまとめる前に、AIが提示した引用と機密情報の取り扱いを最終点検します。前述の通り、AIが多くの出典を提示したり検索回数を増やしたりしても、内容の正確性が高まるとは限りません。リンクが正常に開くことと、リンク先の内容がAIの主張を正しく裏付けていることは、別々に確かめる必要があります。
クライアントのデータを扱う際は、製品の一般的な機能ではなく、組織の契約や管理者の設定を基準にして利用を判断します。たとえ安全をうたう製品であっても、案件ごとの守秘義務によって外部のAI処理へのデータ送信が禁じられている場合があるためです。
こうした理由から、AIの出力結果をそのまま納品物や完成した提案書として扱うことはできません。AIが作成した調査レポートは、人間が次にどの原典を開いて確認すべきかを絞り込むための、中間成果物として位置づけます。
必要な証拠へつながる経路を持った製品を選び、AIが整理した原典を人が直接検証する手順を踏みます。この運用なら、調査に使った原典とクライアントへ説明する根拠を、同じ確認手順で管理できます。
よくある質問
Q1. コンサル向けで最も優れたAIリサーチエージェントはどれですか?
すべての調査に最適な単一の製品はありません。
公開されているウェブサイト、社内の資料、有料の市場データ、過去の案件の知識のどこに証拠があるかによって、選ぶべき製品が変わります。AIの回答から元の資料へ戻れない製品は、回答の文章が自然であっても候補から外します。
Q2. 無料のDeep Researchだけで市場調査はできますか?
公開情報の初期調査には使えます。
しかし、有料の調査資料や社内データが判断の鍵となる案件では、無料の検索だけでは証拠が不足します。この場合、見つからなかった情報を「存在しない」と結論づけるのではなく、未確認の事項として残します。
Q3. クライアント資料をAIへ添付してもよいですか?
組織の契約や管理者の設定、案件ごとの守秘義務がすべて許可している場合のみ添付できます。
管理者が社内への製品導入を済ませていても、個別の案件で外部のAIへデータを送信してよいかは別の問題です。実際にファイルを送信する前に、対象のデータや学習への利用条件を確認する必要があります。
Q4. AIが付けた引用はそのまま提案書へ使えますか?
そのまま提案書には使いません。
人間が引用のリンクを開き、元の資料に書かれた内容とAIの主張が合っているかを確認します。AIが提示した引用リンクが動いても、内容が正しく裏付けられているとは限らないためです。資料の調査対象、期間、単位が合っていない場合は、その情報を証拠から外します。
Q5. 7製品を比較するときは何を同じ条件にしますか?
同じ仮説、対象地域、期間、許可する情報源をそろえて製品の出力を試します。
文章の好みではなく、案件に必要な原典へたどり着けるかで比べます。必須となる原典を見つけられるか、引用が事実と一致しているか、未確認の項目を正しく表示できるかを記録して比較します。
調査手法について
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント