調査や分析、文章作成を何度もAIに頼んでいると、資料の確かめ方や作業の順番、完成の条件が少しずつ固まってきます。
本稿でいうSkillは、AIに再利用させる作業手順です。業務の目的と入力資料に加え、作業手順、禁止事項、合格条件をまとめます。各社が提供する同名の機能は、製品名を付けて区別します。
次に迷うのは、そのSkillをどのAIで育てればよいのか、複数のAIで共有してもよいのかという点です。GPTやClaude、Gemini、Grokのすべてで同じ手順を使えるようにする方法もあります。しかし、モデルごとの機能や資料の渡し方まで管理しなければならず、作業の負担が大きくなります。
日常の負担を増やさずにAIを使い分けるには、どうすればよいのでしょうか。毎回モデルを選び直す必要はありません。まずは普段から使いやすいAIを一つ選び、そこにSkillを集中させます。そして、そのAIでは求める品質に届かない工程が見つかったときだけ、別のAIを補助として追加します。
Skillを育てる拠点は普段使いのAIでよい
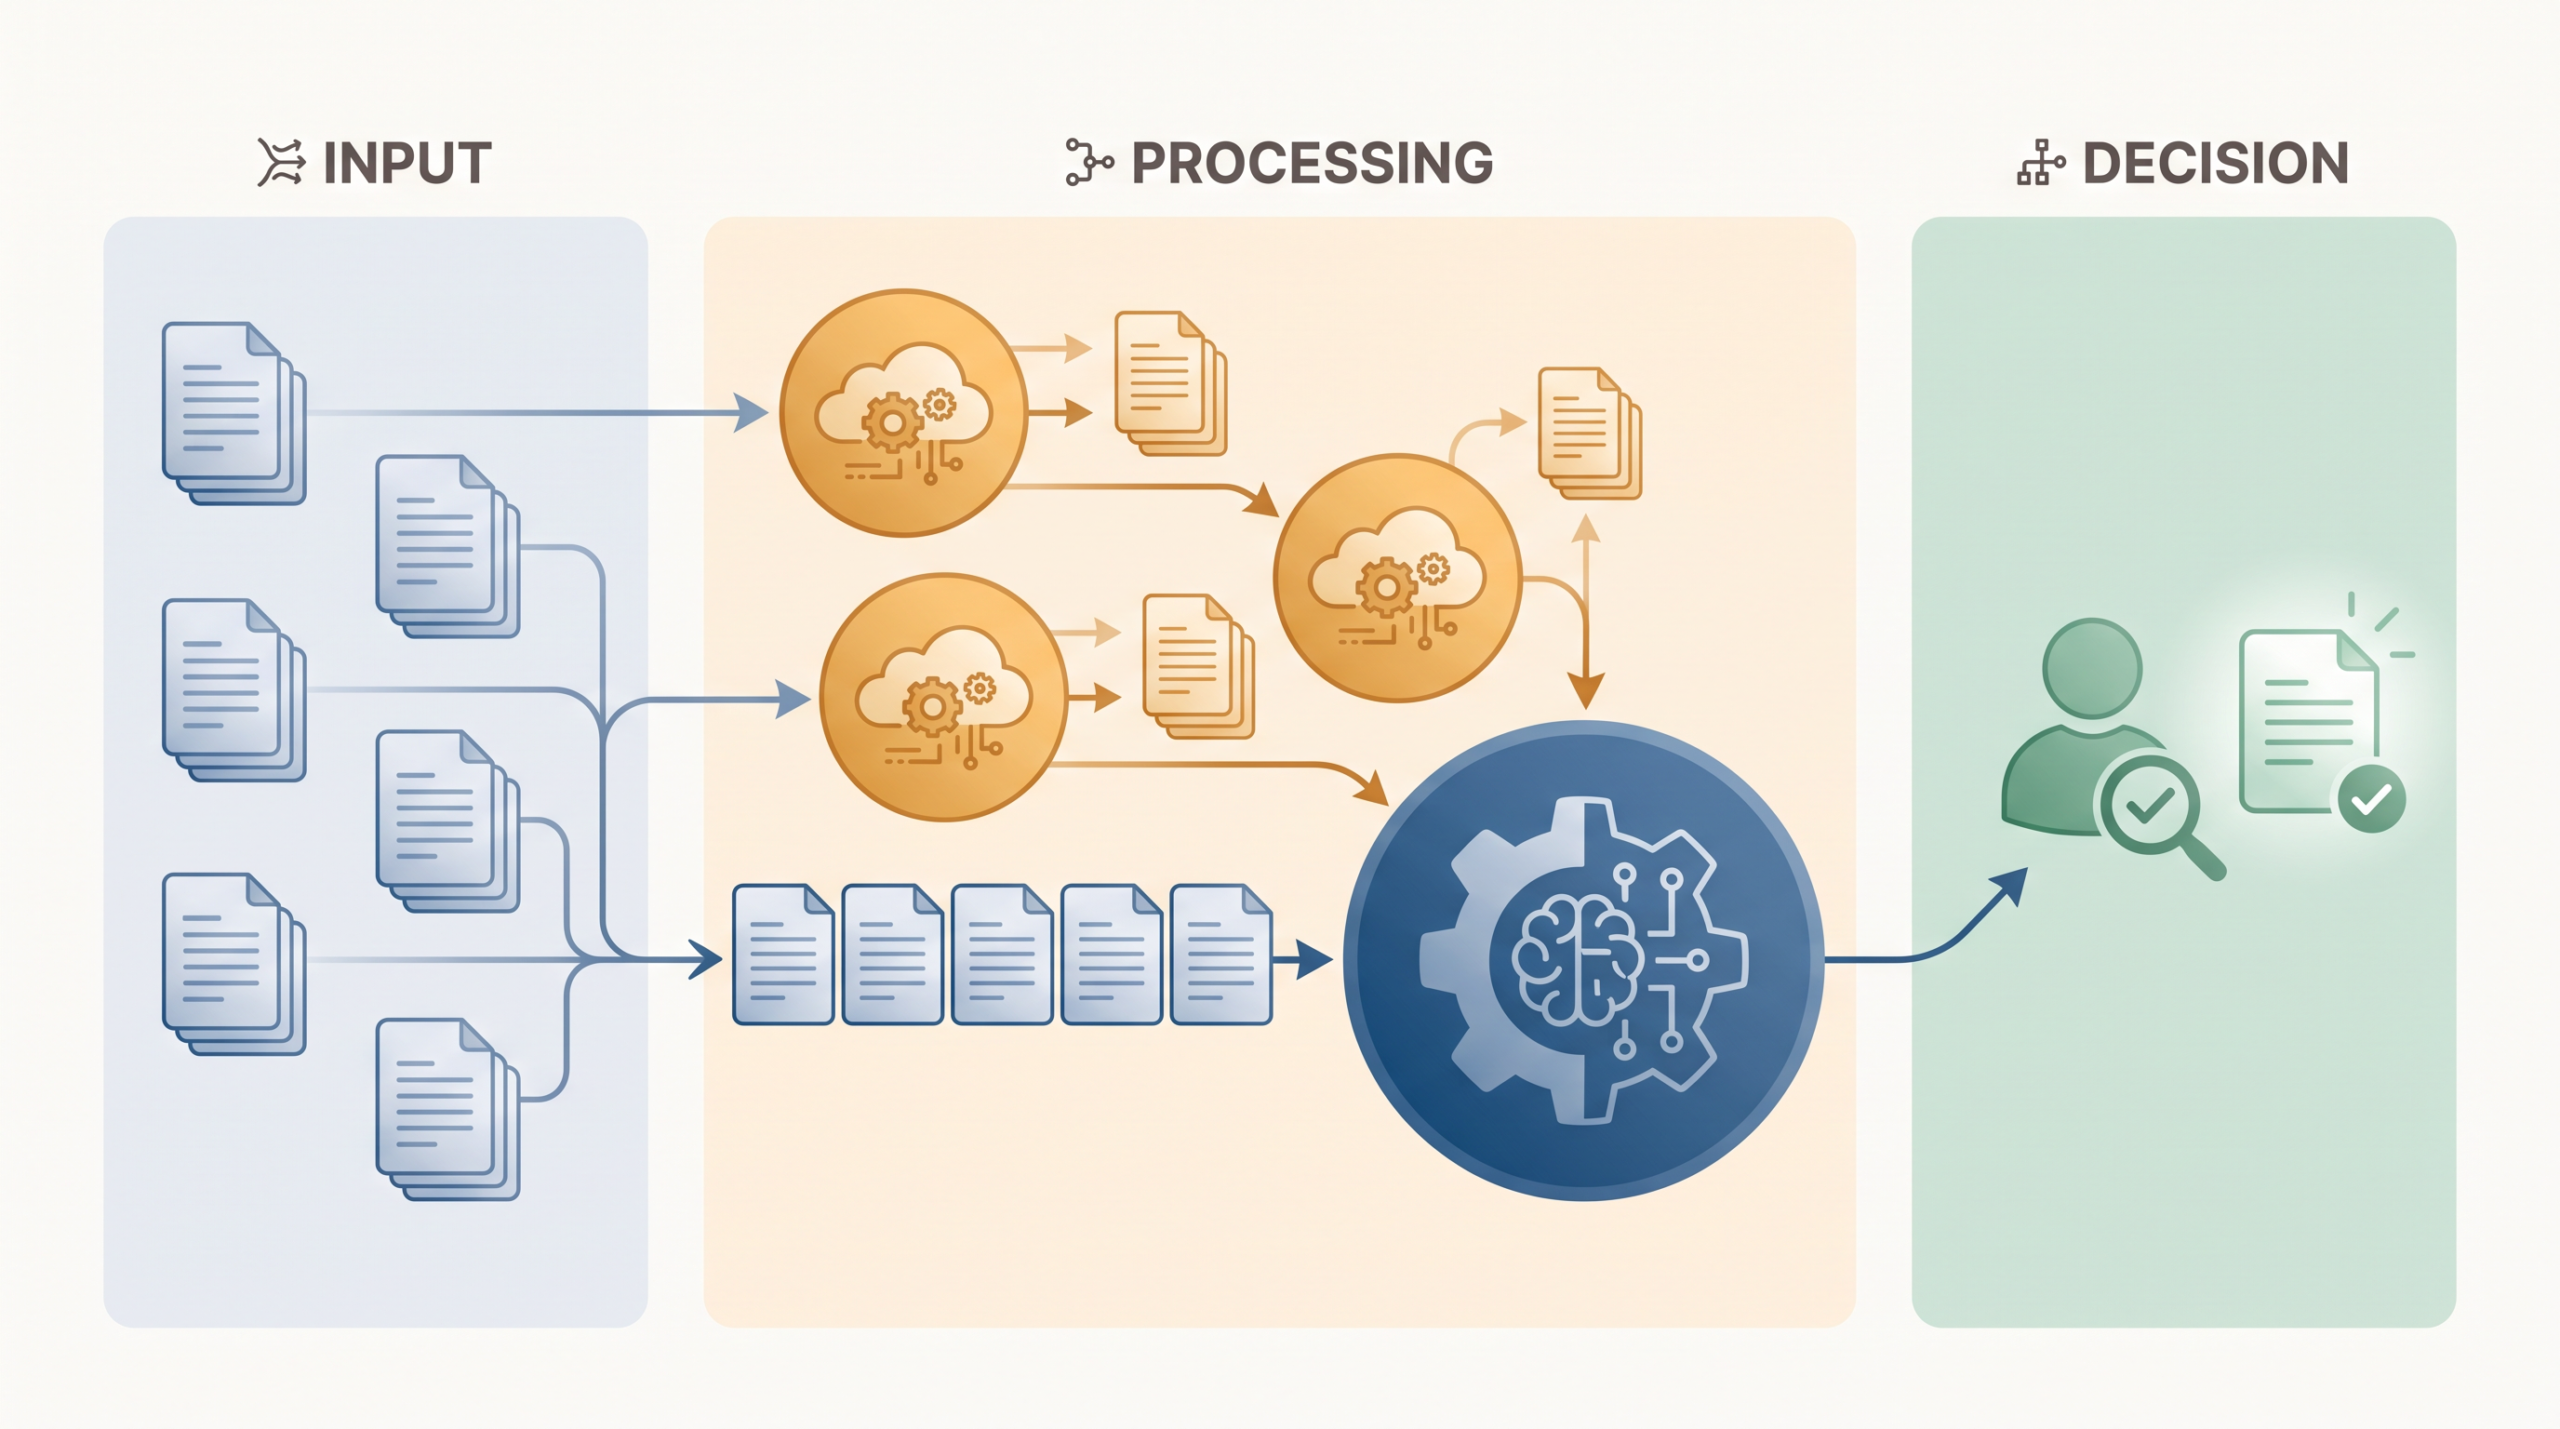
GPTやClaude、Gemini、Grokへ同じ指示を出せば、各モデルの長所を引き出せるように思えます。しかし、毎回複数の画面を開き、同じ資料を渡して回答を見比べると、人の手間が増えます。
Skillを育てる拠点を一つに絞る目的は、AIの優劣を決めることではありません。中心業務の品質を保ちながら、資料の同期、画面の往復、確認作業を減らすためです。
どのAIを主軸にするかを決める際、インターネット上で公開されている性能テストの順位は直接の証拠になりません。固定されたテスト問題には、AIの学習データへ混ざる可能性が指摘されています。AI同士で採点する仕組みにも、回答の表示位置で結果が偏るという報告があります。
実際に確かめるべき証拠は、自分の中心業務を安定してこなせるかどうかです。求める必須条件をどのくらい満たせるか、致命的な間違いがないか、もう一度実行したときに同じ結果を出せるかを測ります。さらに、人が確認に要する時間や、成功するまでにやり直した回数、実際にかかった費用も含めて総合的に判断します。
もし選んだAIが重大な誤引用を起こしたり、許可していない操作を勝手に実行したりした場合は、拠点の見直しが必要です。また、別のAIを使ったほうが確認時間と費用が下がる場合や、そのAIにしかない機能がないと業務を終えられない場合も、無理に一つの拠点へ寄せる必要はありません。
AIの主軸を決める段階でも、人が担う基準作りは残ります。業務の目的、禁止事項、費用上限、合格条件を決めるのは人です。AIが整理した比較結果と実行記録を確認し、出典やデータ送信範囲に問題がないか確かめます。
人が決めたルールをSkillとして使うには、全AIで共通する手順と、製品ごとの設定を切り分けます。
Skillの共通手順と製品別設定を分ける
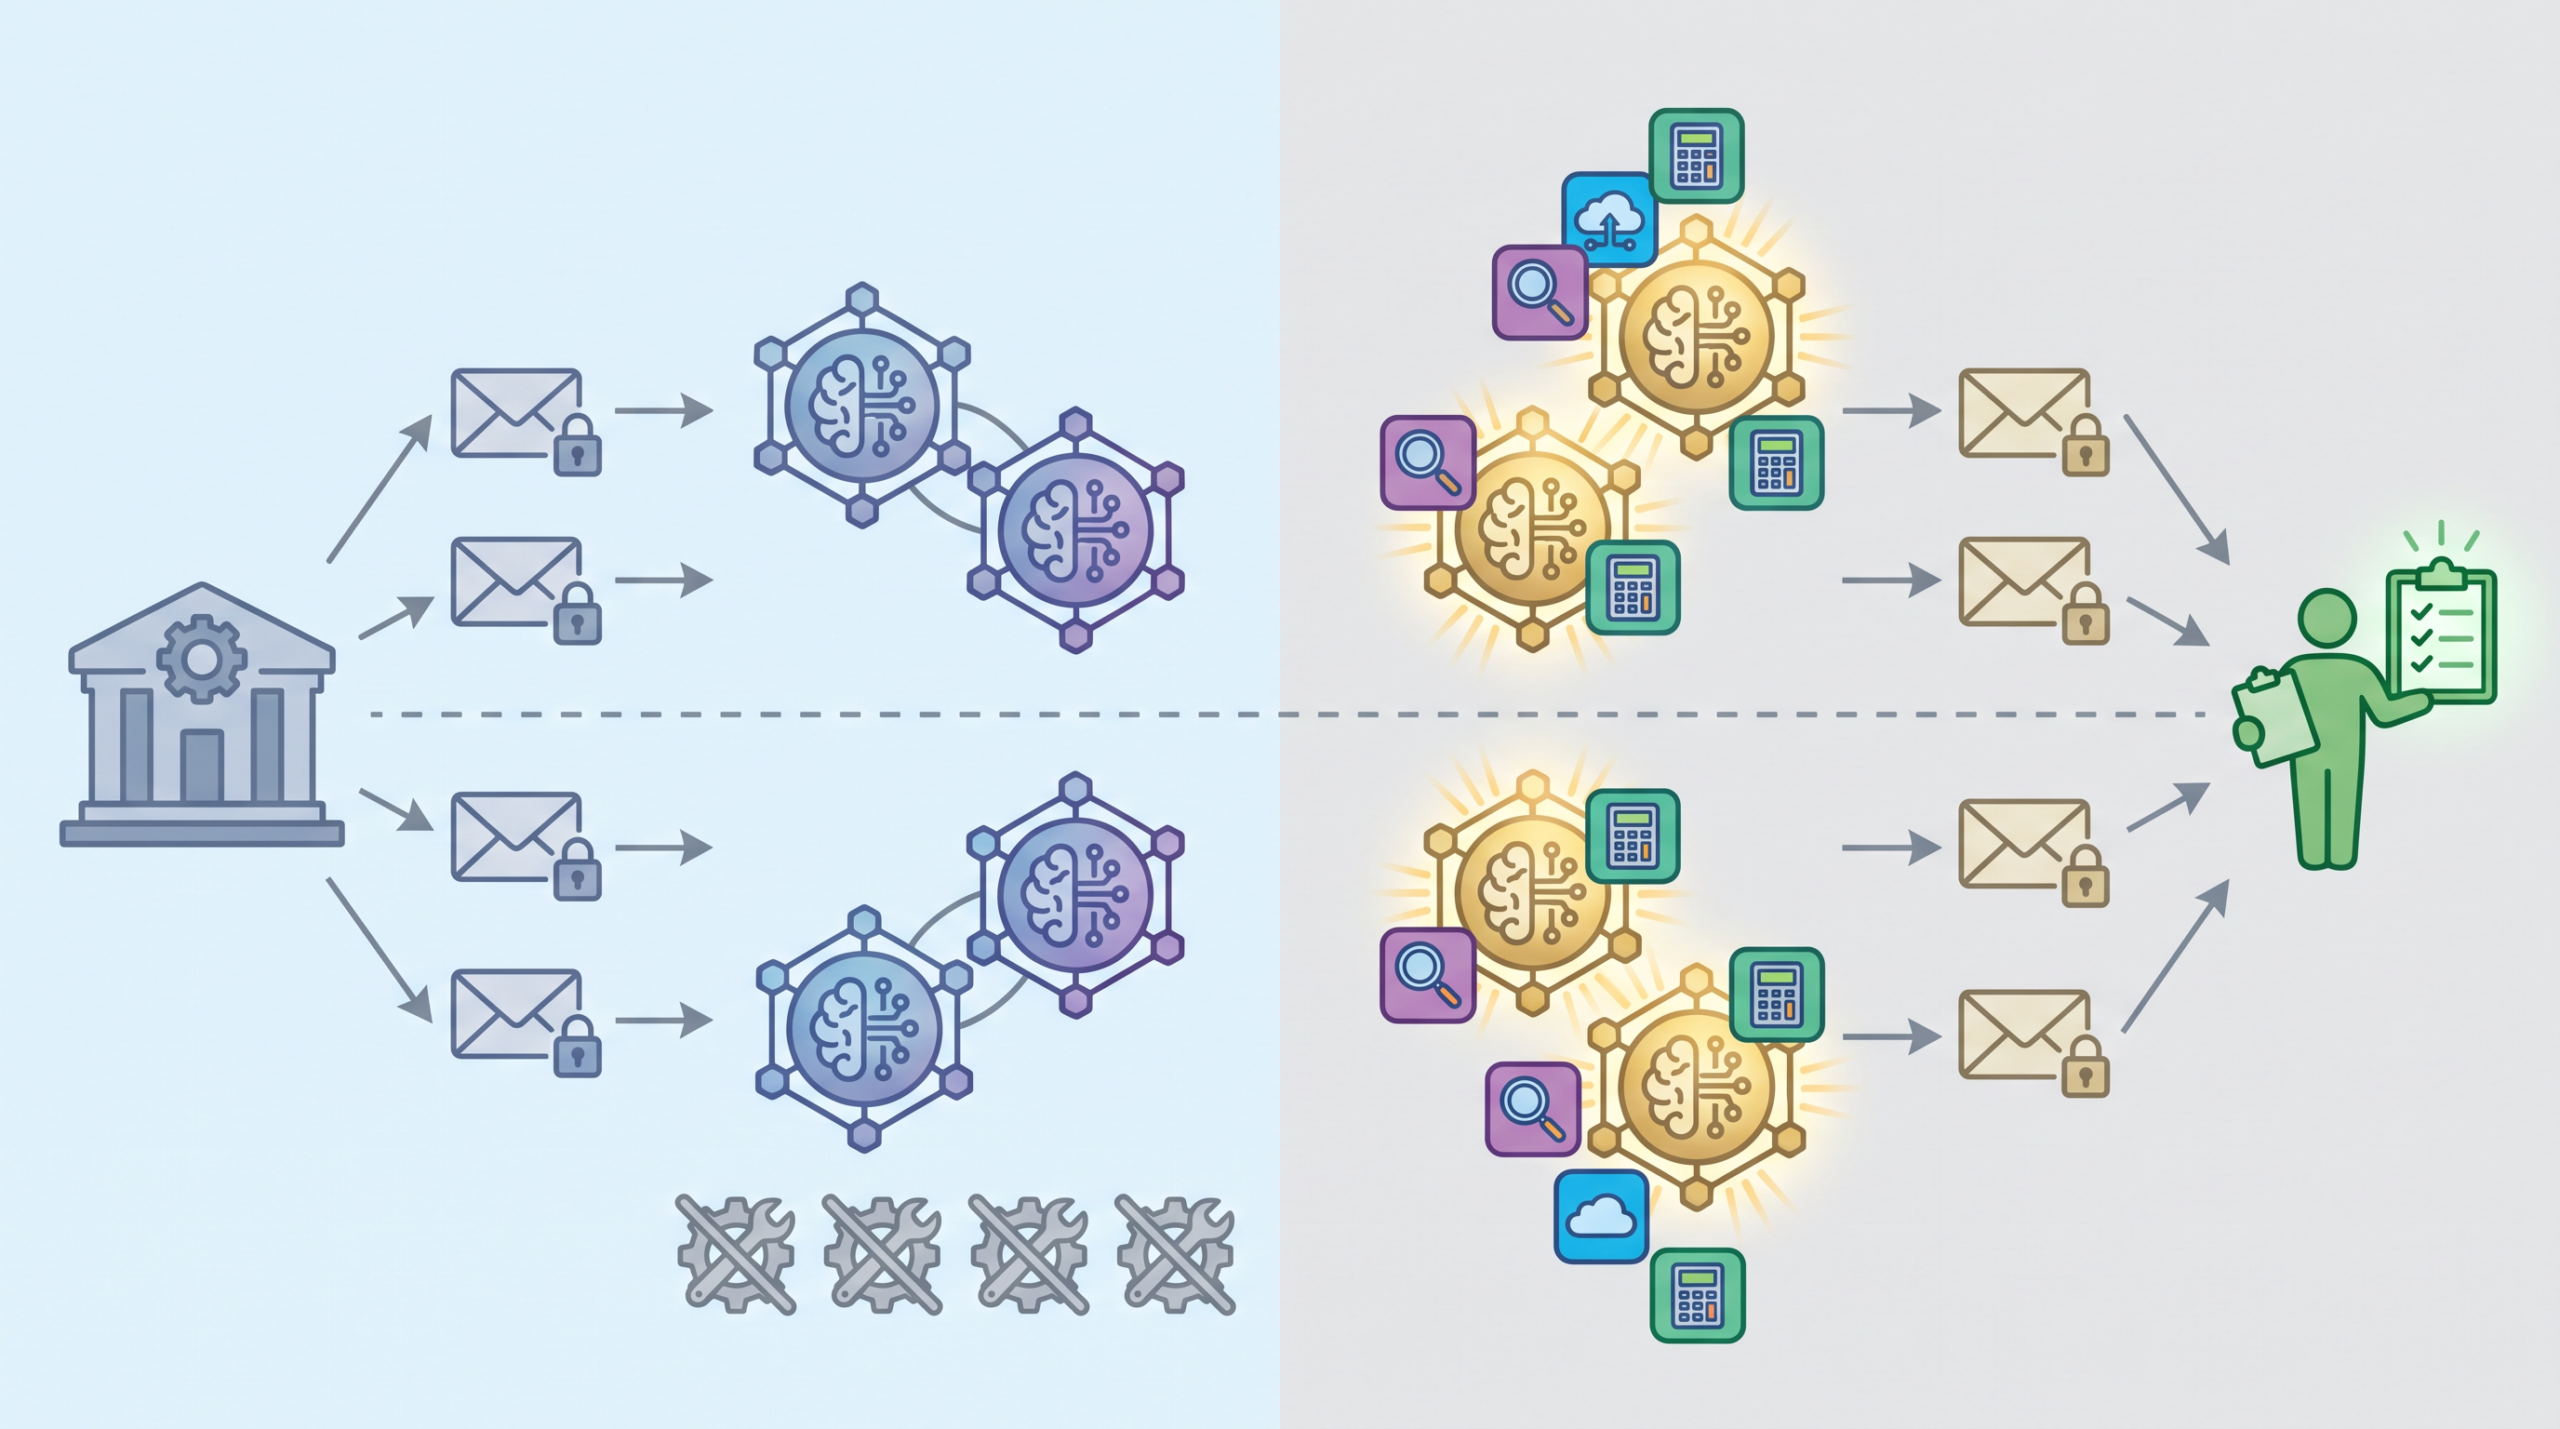
業務の目的・入力条件・禁止事項・判断基準・完成条件をAIごとに複製すると、修正箇所が分散します。その結果、同じ名前のSkillでも判定がずれます。これらは一つの「共通手順」に置きます。
製品ごとの保存場所、役割指定、ツール名、出力スキーマは「製品別アダプター」へ分けます。ファイル上限、引用形式、再試行条件も同じ場所で管理します。
OpenAIのSkills機能は、指示と参照物を必要な段階で読み込む仕組みです。ClaudeのAgent Skillsにも、必要な資料を段階的に読み込む仕組みがあります。
一方、GeminiのGoogle SearchやFile Searchは、実行時に呼ぶツールです。GrokのWeb SearchやCode Executionも同じ実行時ツールに当たります。
作業手順を保存する層と、検索やコード実行の層は分けて管理します。利用するAPI・CLI・Webアプリごとに、認証、契約、送信先を記録します。
比較は基準条件と実務条件に分けます。基準条件では、全製品へ同じ指示・資料・出力スキーマ・最大出力・制限時間を設定します。製品ごとに使用するモデルIDと版を試行前に固定し、3回の実行中は変更しません。利用者が無効化できる検索、コネクター、コード実行は止めます。
実務条件では、利用契約と社内規程で許可した機能だけを有効にします。無効化できない組み込み機能は、結果と一緒に記録します。
各条件を同じ入力で3回実行します。回答順と製品名を隠し、人が元資料と照合します。AIによる採点は、回答の表示位置で結果が偏るという報告があるため、一次選別に限ります。
実務条件では、回答の正確さと画面往復を測ります。再試行回数、確認時間、実測費用も記録します。追加機能による差はモデルの基礎能力ではなく、自社業務で得られた便益として分けて残します。
別のAIは苦手な工程だけに追加する
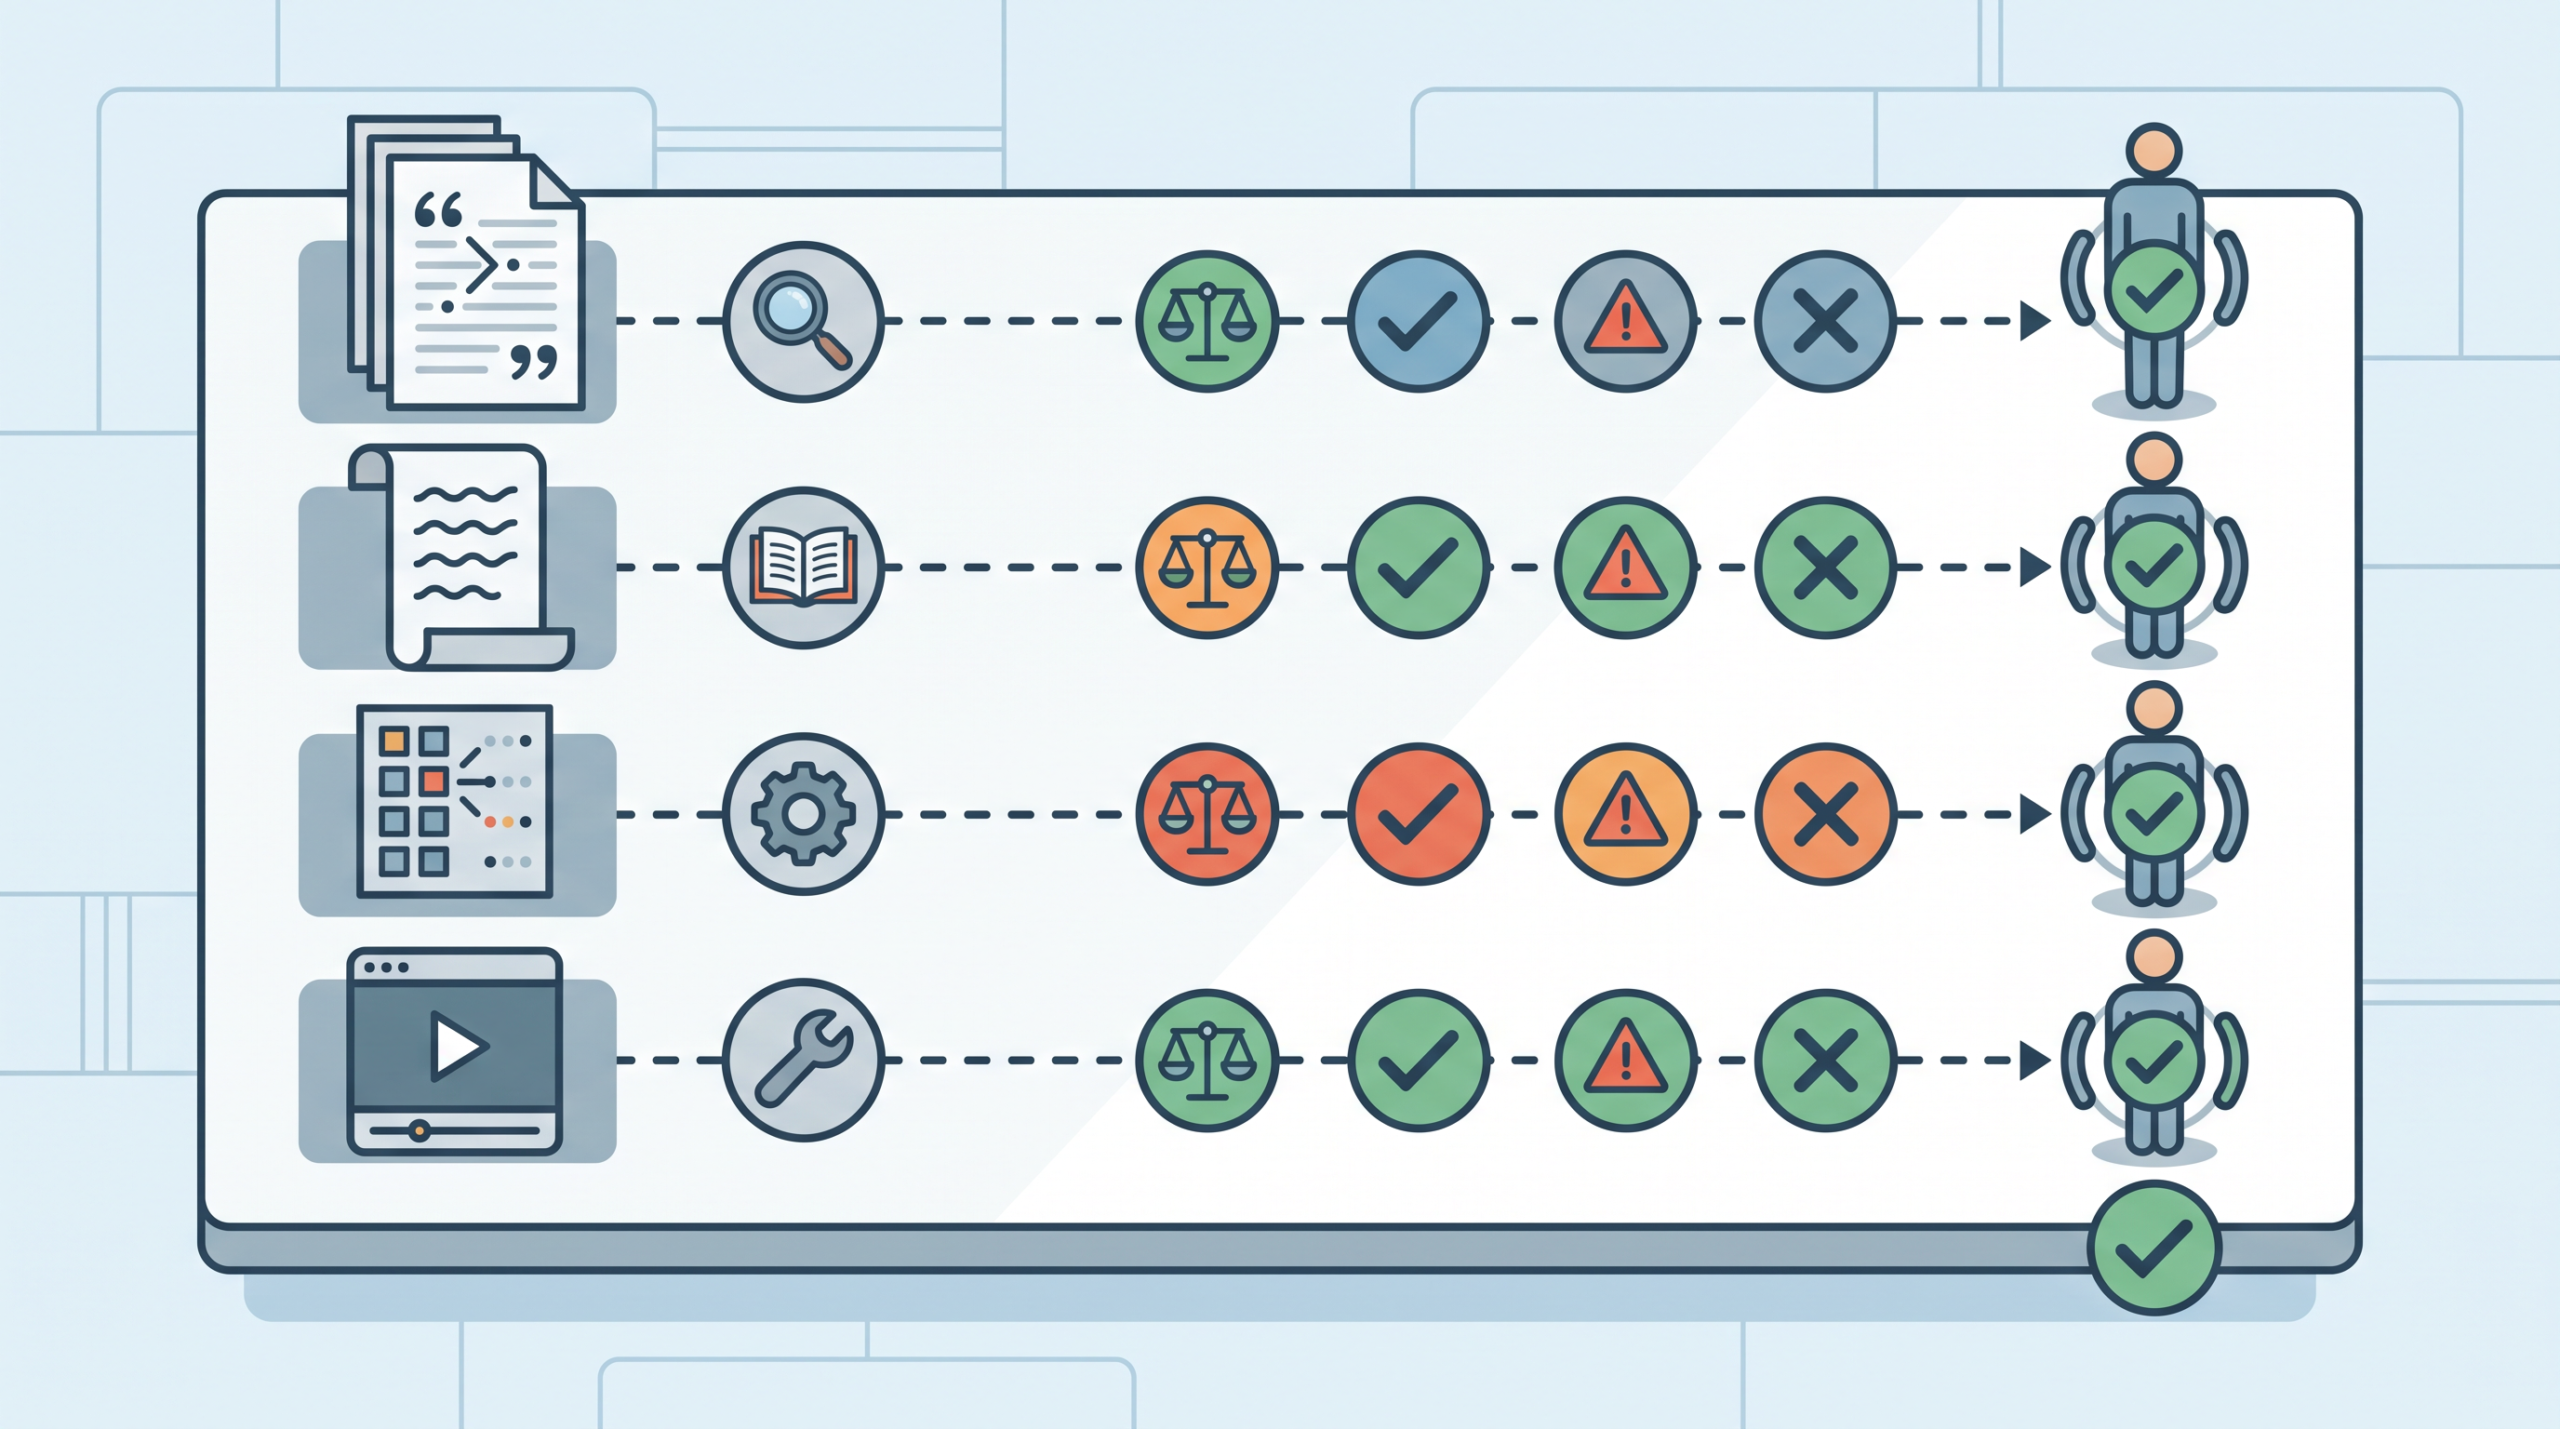
拠点のAIが要件を満たせない工程は、実際の業務を反映した代表タスクで特定します。最低限、制約付き調査、長文編集、構造化抽出、ツール実行を試します。各タスクには固定入力、確認必須項目、承認済みの正解、禁止操作、返却形式を事前に登録します。
必須条件達成率は「合格した必須項目数÷全必須項目数」、構造化抽出の一致率は「正解と一致した評価対象セル数÷全評価対象セル数」で計算します。誤引用、捏造、権限外操作、承認済みの元ファイルの上書きは0件を必須とします。残りの合格値も試行前に決めます。同じ条件で3回実行し、再実行しても判定が変わらないかを確認します。
人は元資料と正解を開き、AIの出力を項目単位で照合します。モデルやSkillを更新した場合も、同じ代表タスクを再実行します。OpenAIは継続評価の仕組みを提供し、Anthropicも現実のデータ源を使う実務的な評価を勧めています。
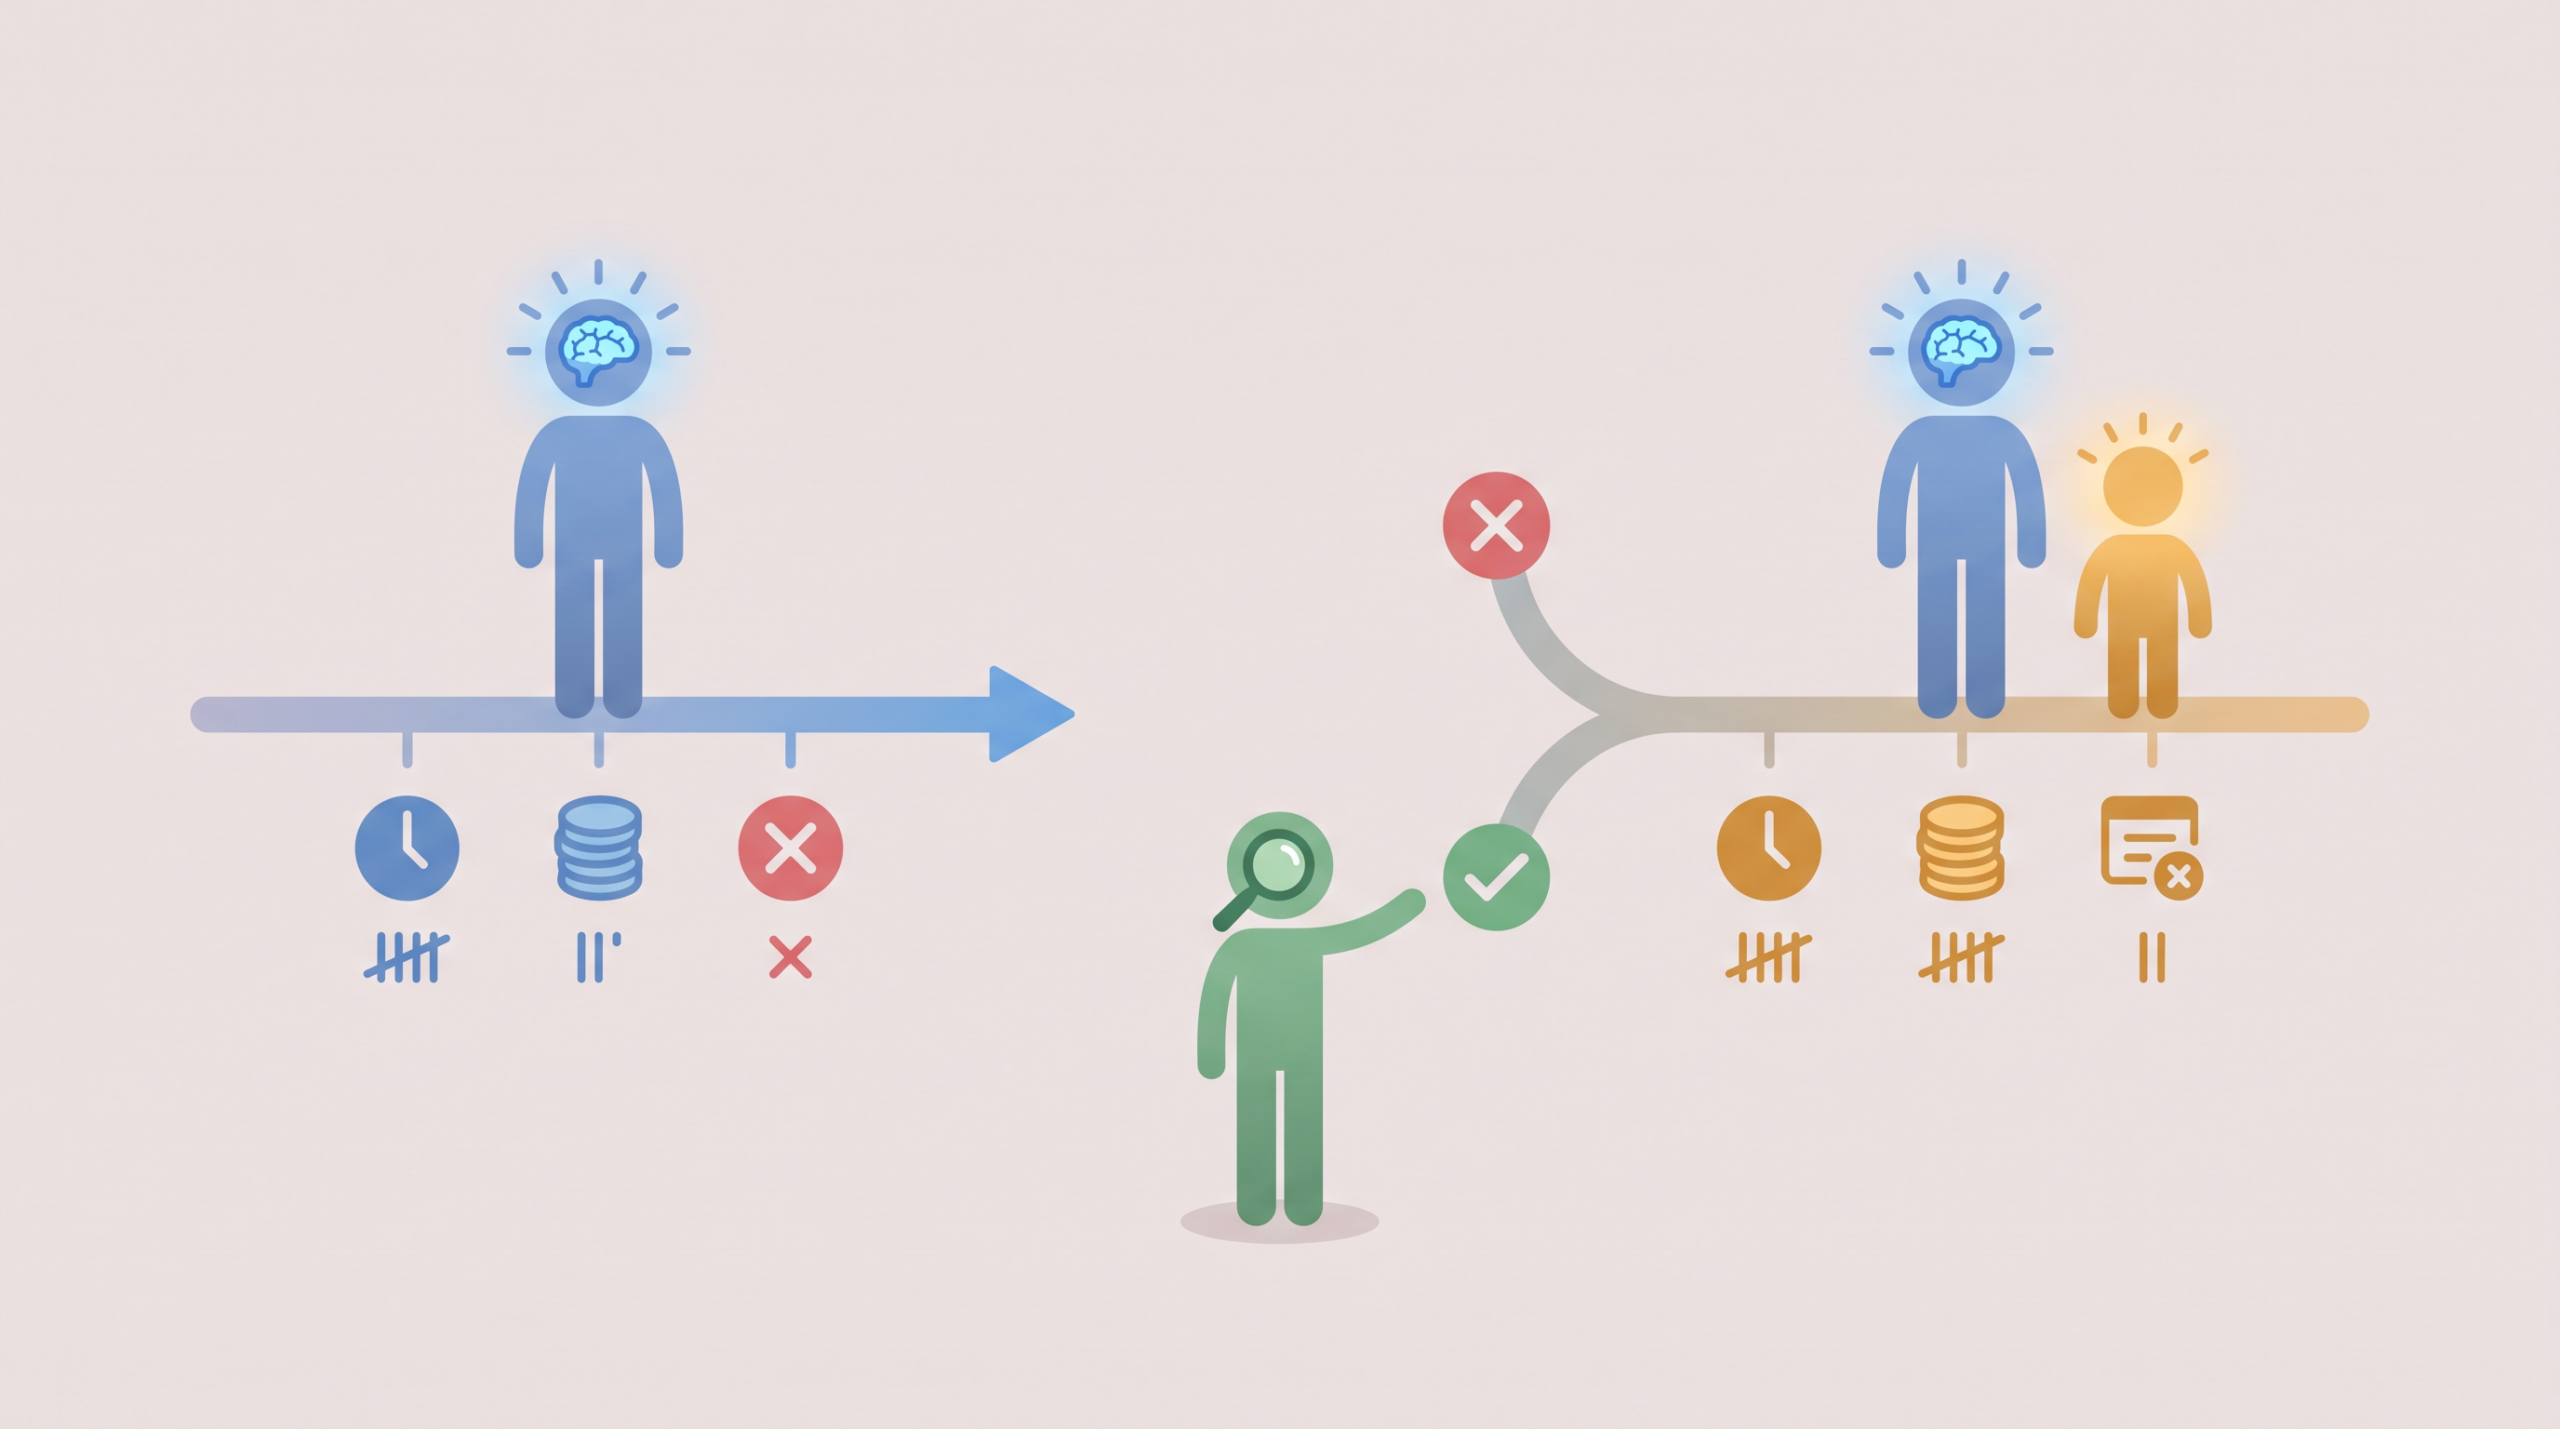
補助AIは、拠点のAIが不合格だった工程で、事前に決めた基準を3回とも満たした場合だけ候補にします。固定した評価項目について、「拠点単独では不合格だったが補助追加後に合格した項目数」から「拠点単独では合格だったが補助追加後に不合格になった項目数」を引きます。正味改善がプラスでも、重大な誤りがある場合や、確認時間と総費用が上限を超える場合は採用しません。
比較後は、入力の版・担当工程・出力・モデル版・実行時刻を残します。人が確認した箇所も同じ記録へ加えます。固定ベンチマークには学習データ混入の課題が指摘されているため、公開順位ではなく、この記録で担当を決めます。補助AIが決まったら、次は承認済みの情報だけを渡す経路を設計します。
Claude CodeとCodexは個別認証し、ファイルで工程を渡す
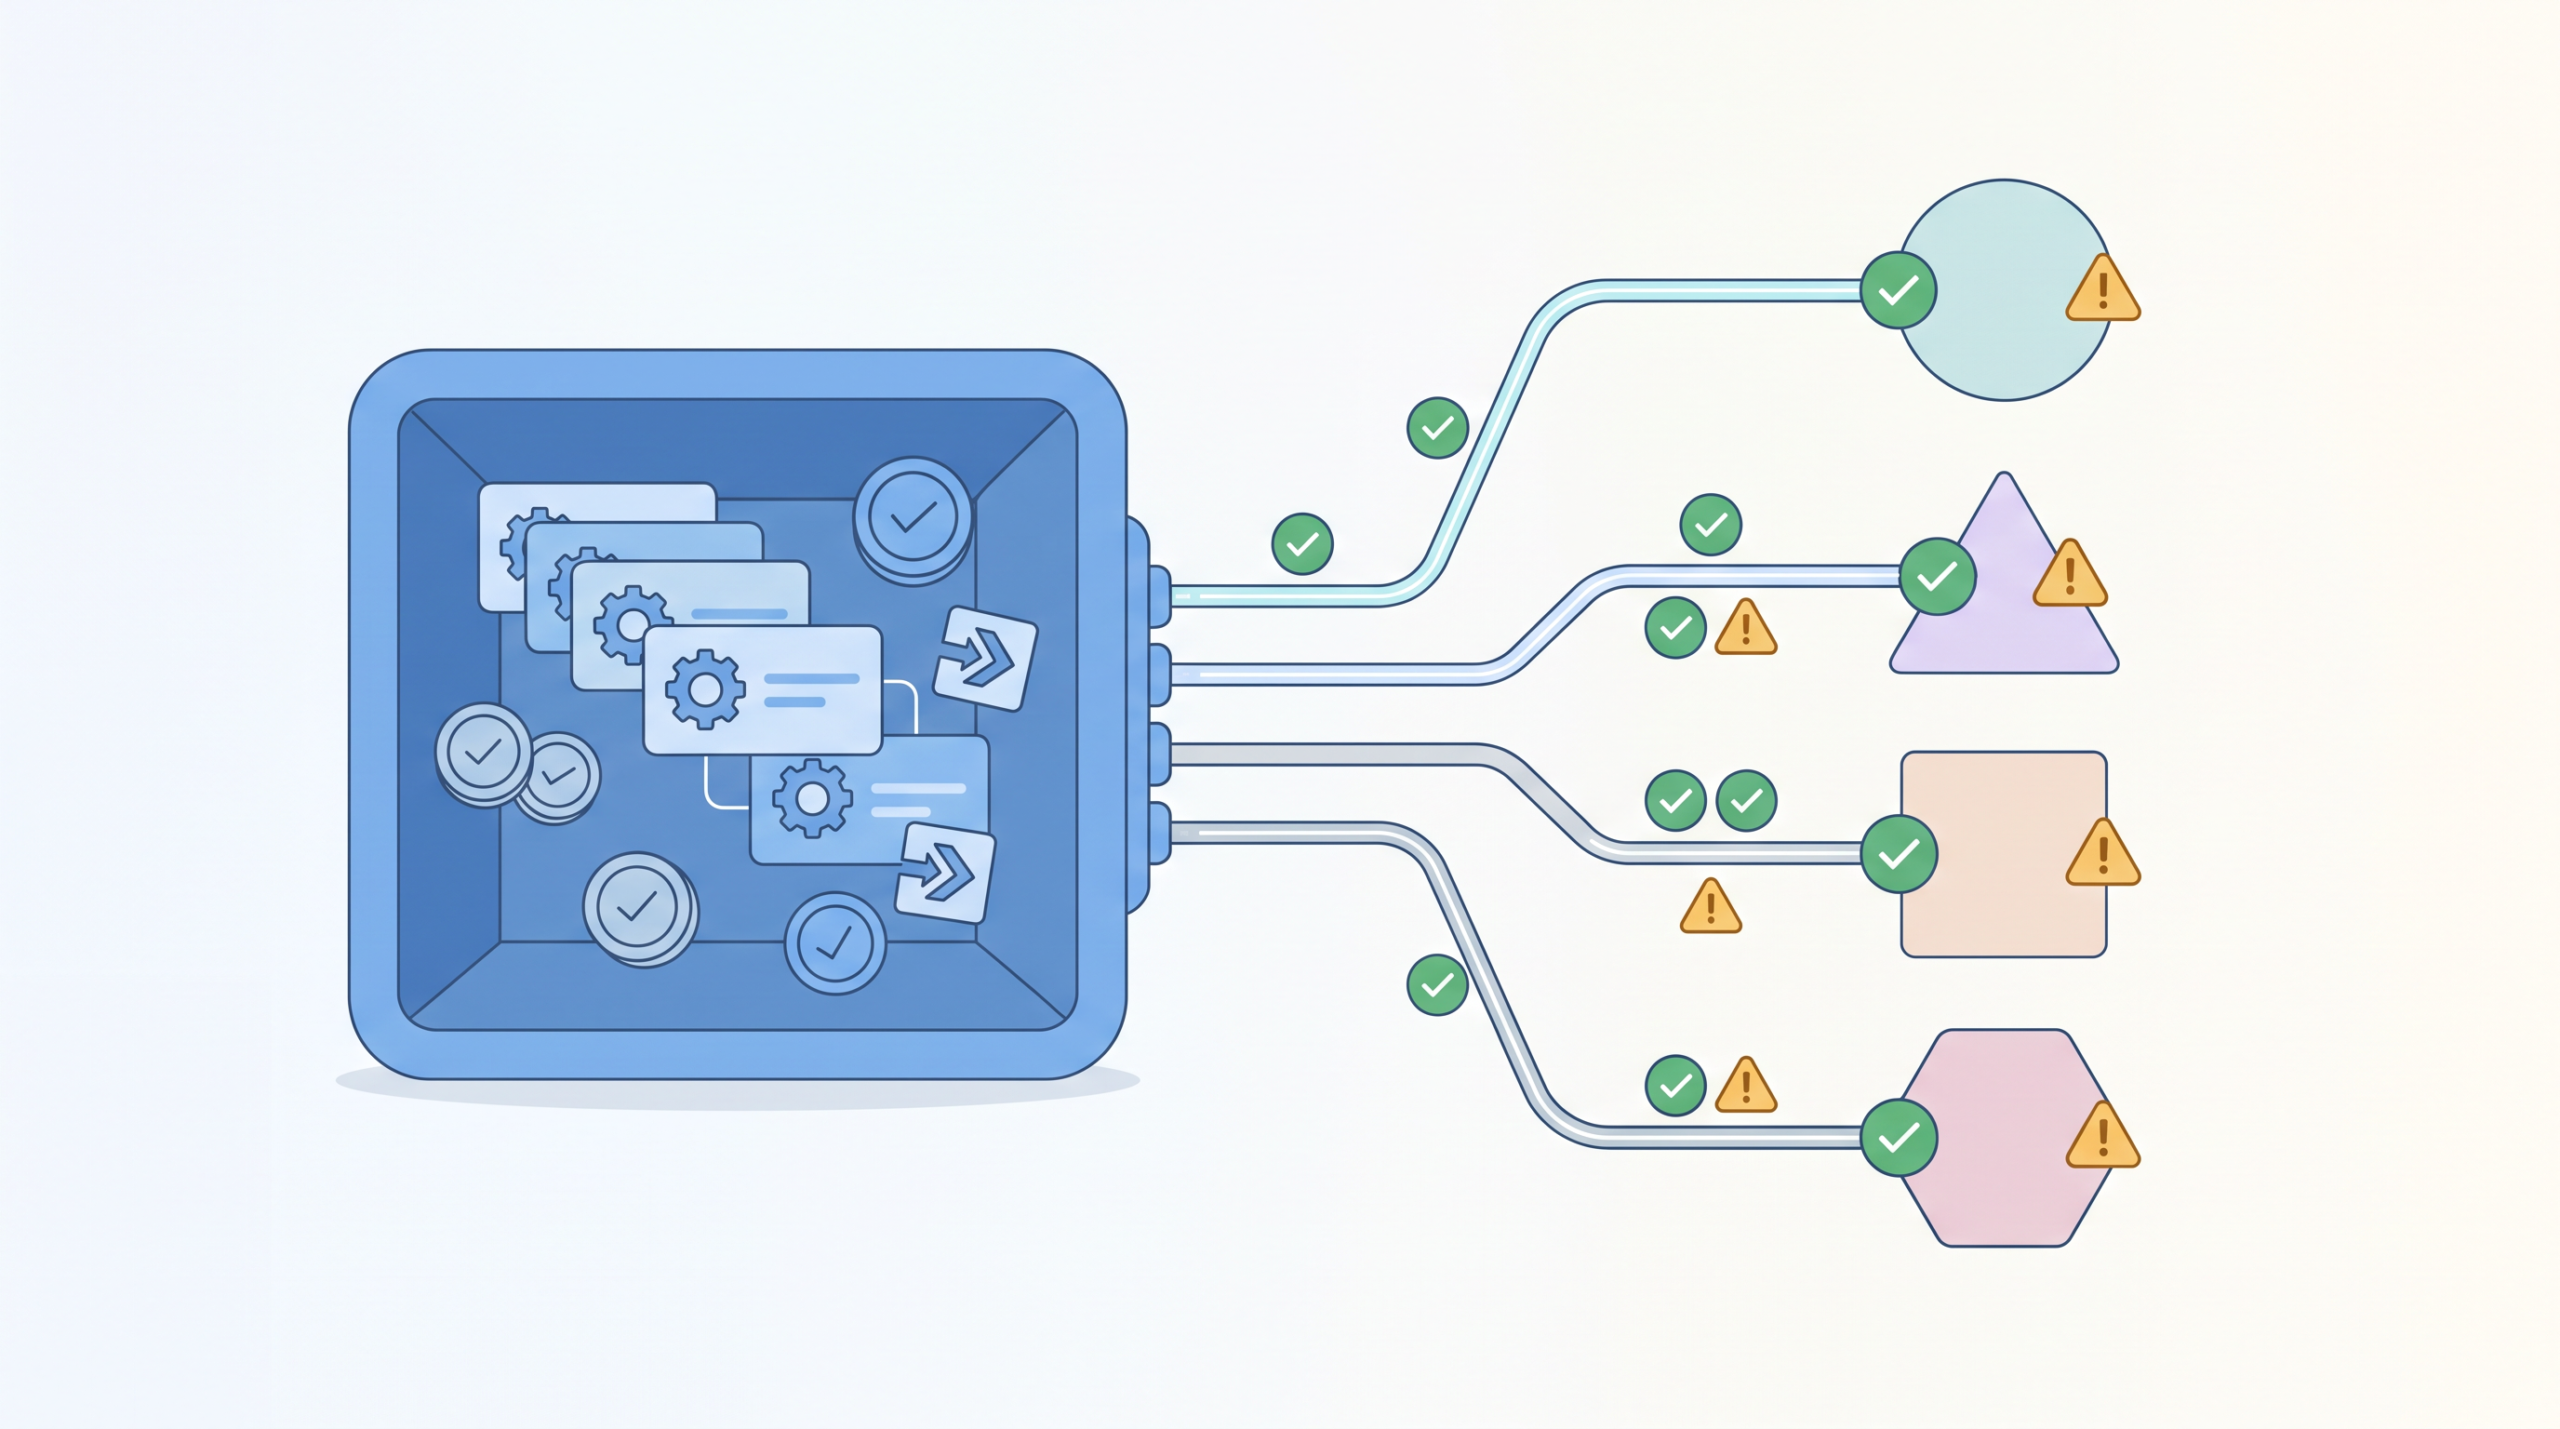
同じPCへClaude CodeとCodexを入れ、それぞれを別に認証します。Claude CodeはAnthropic側の対応するアカウントを使います。CodexはOpenAI側の対応するアカウントを使います。
利用者または承認済みスクリプトが、前段CLIの出力をファイルへ保存します。人が内容と送信可否を確認した後、後段CLIへそのファイルを渡します。Claudeの契約をCodexで使うわけではありません。
Claude Codeはclaude -pで結果を標準出力へ返せます。Codexはcodex execで非対話実行できます。例えば、Codexで作った記事の流れだけをClaudeへ確認させるなら、作業フォルダにdraft.mdを置いて次のように実行します。
claude -p "draft.mdを読み、論点が飛んでいる段落だけ指摘してください。本文は変更せず、段落冒頭を引用して返してください。" --output-format json > claude-review.json利用者はclaude-review.jsonを開き、送信できない情報が含まれていないか確認します。その後、Codexへdraft.mdと確認済みのレビューを渡し、ファイル変更を許可せずに実行します。
codex exec --sandbox read-only "draft.mdとclaude-review.jsonを読み、指摘が本文と一致するかだけ報告してください。ファイルは変更しないでください。"受け渡すファイルには、入力の版・出典URL・未確認項目を入れます。許可した操作と返却形式も明記します。個人情報、未公開情報、再配布できない資料は、両サービスへの送信を契約と社内規程で確認できるまで除外します。送信先、実行時刻、モデル版も記録します。
OpenAI APIを使う経路では、Structured Outputsで指定スキーマへの一致を求めます。CLI間の受け渡しでは、各CLIが対応するJSON出力をファイルへ保存します。
どちらの経路でも、受信後にローカルでスキーマを検証します。拒否、途中終了、通信失敗は別の終了状態として扱います。不一致や必須項目の欠落があれば後段へ渡さず、事前に決めた回数まで再実行します。
各CLIは、それぞれのサービスの利用枠を消費します。APIキーで起動する構成なら、APIの従量料金が別に発生します。実行前に、各CLIがサブスクリプションのログインとAPIキーのどちらを使っているかを確認します。同じファイルを二つのAIへ同時に編集させず、片方は下書き、もう片方は指摘だけ、というように担当範囲を分けます。
WorkとCoworkとWebアプリでは経路が違う
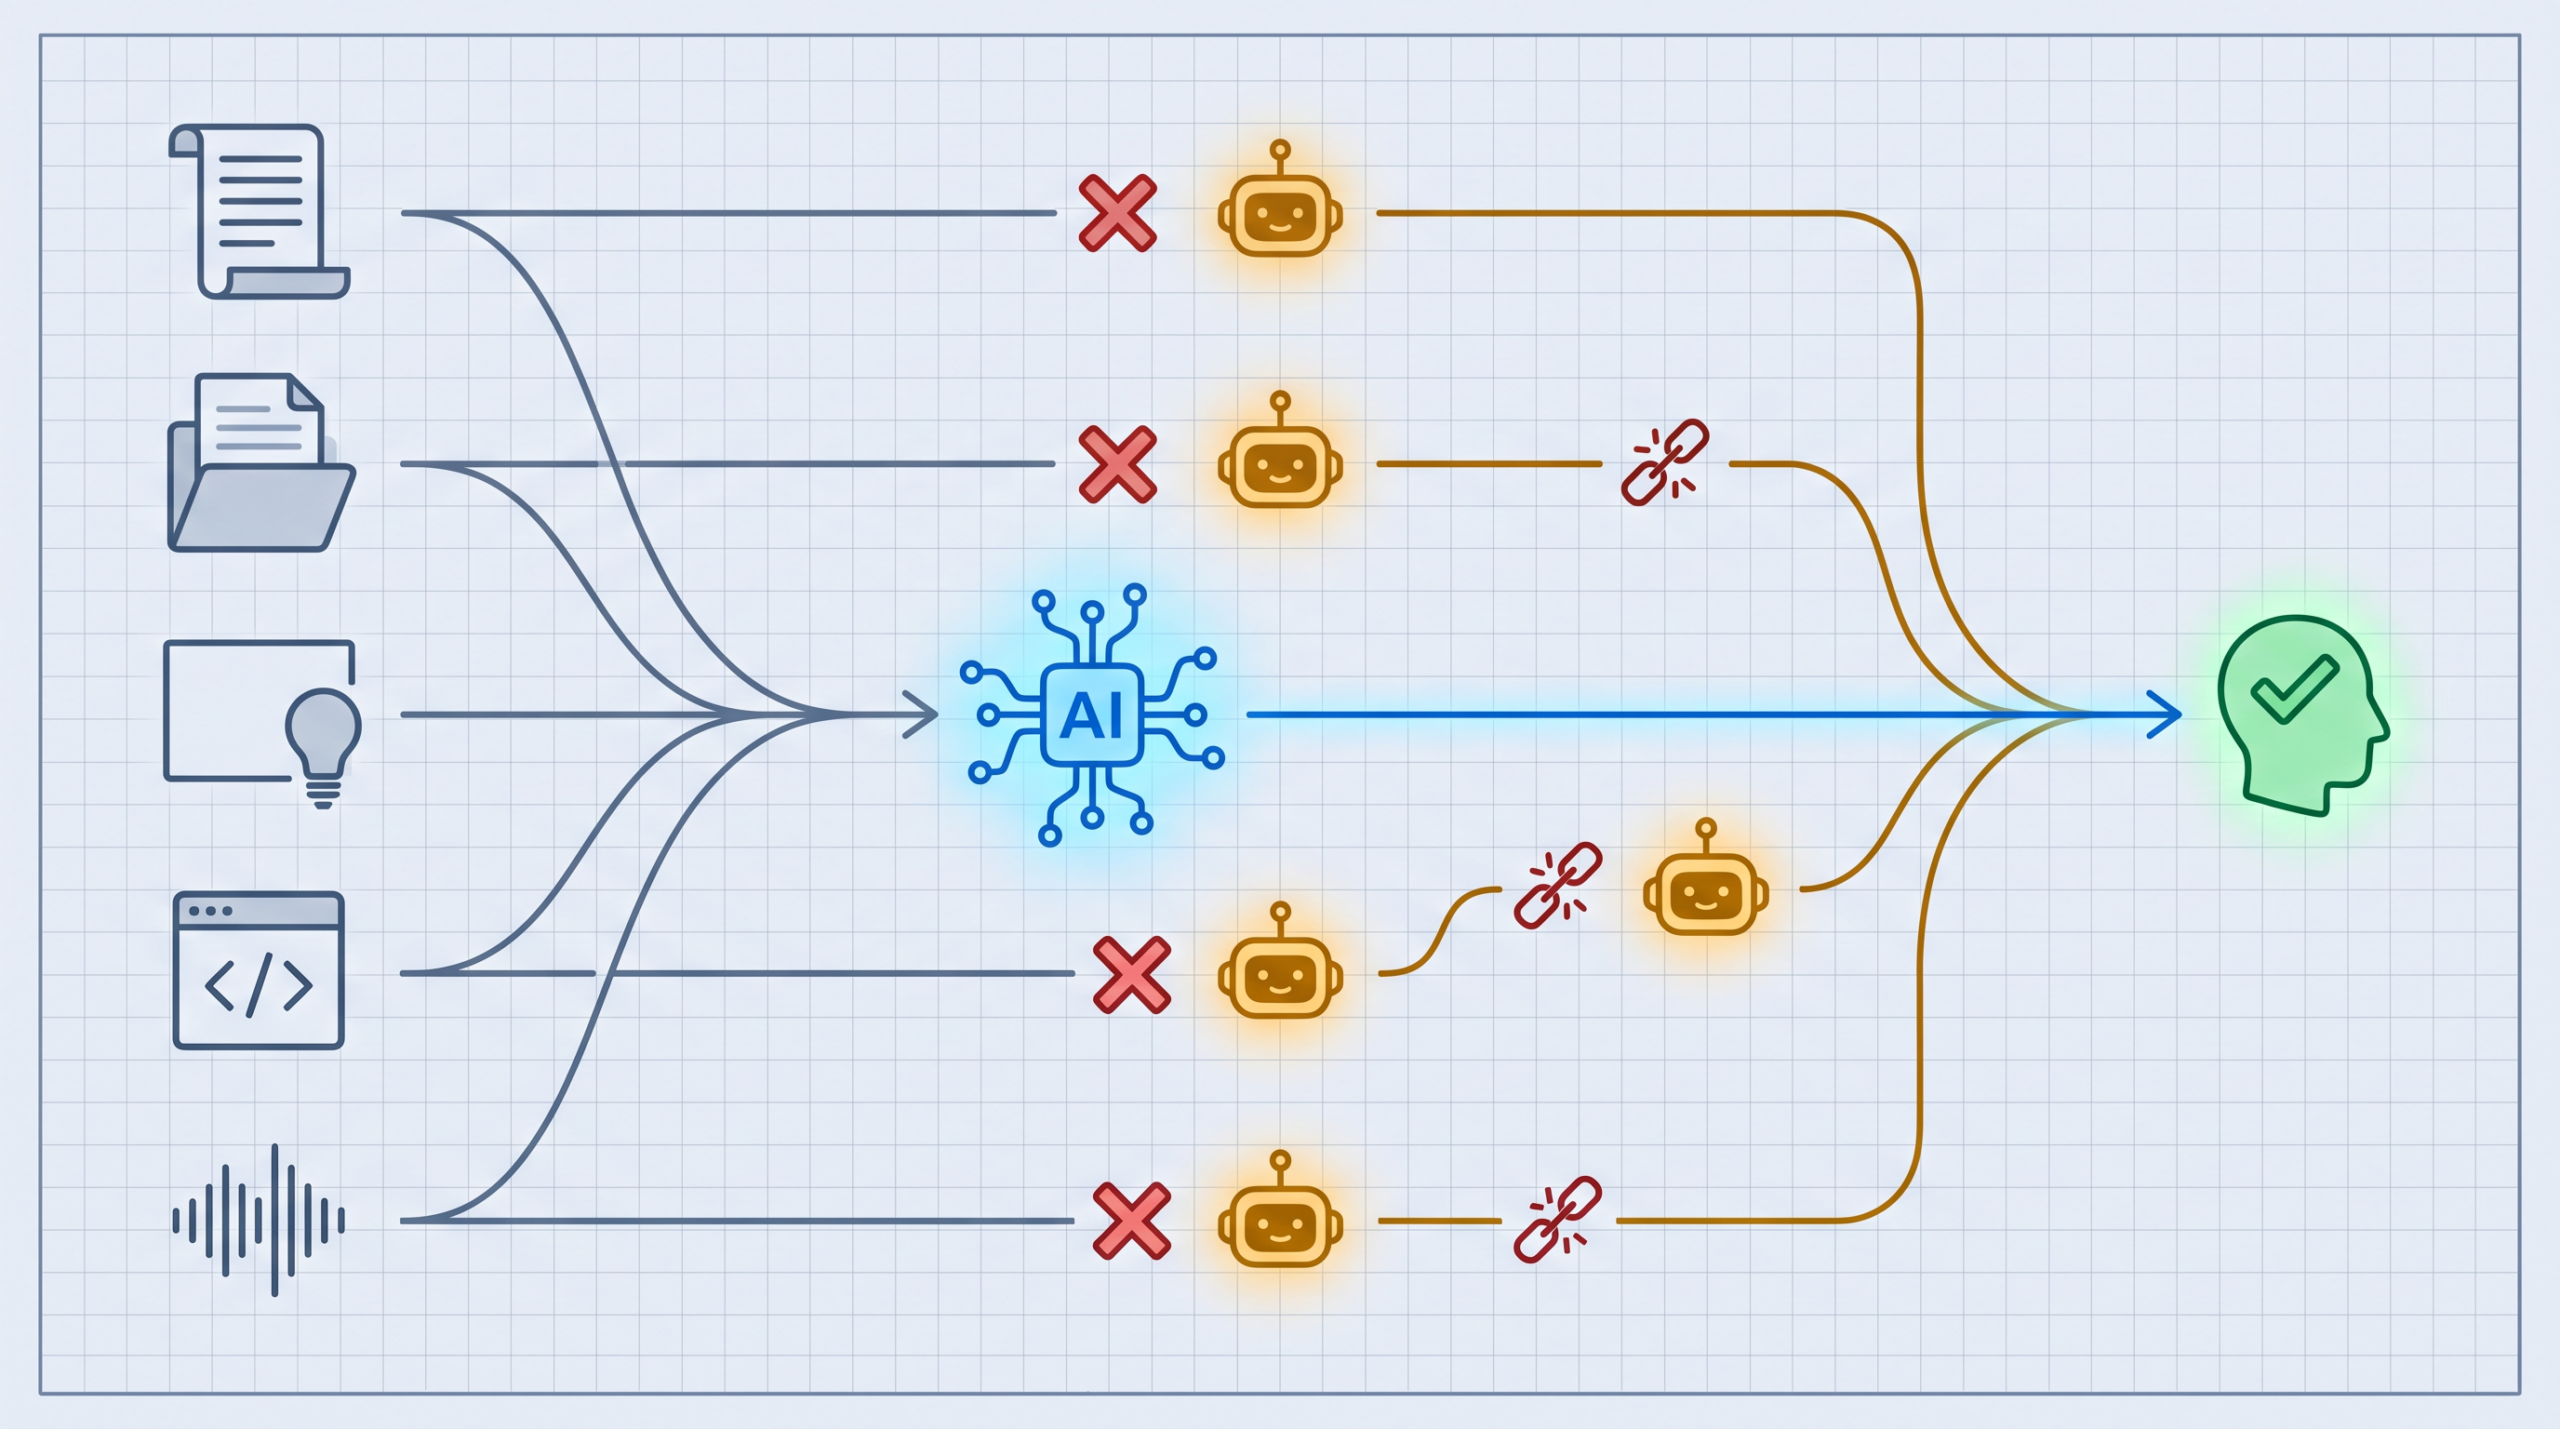
前節では、利用者または承認済みスクリプトが、PC上のClaude CodeとCodexをシェルから順番に実行し、確認済みファイルで工程を渡しました。
ChatGPTやClaudeのWeb画面から外部処理へ仕事を渡す場合は、Webアプリが対応するコネクター、MCP、カスタムアプリなどを別に用意します。MCPは、AIが外部のデータや処理をツールとして呼ぶための接続方法です。
ChatGPT Workにはローカル実行とクラウド実行があります。ローカル実行は利用者の端末でファイルやアプリを扱い、クラウド実行はアプリを閉じた後も処理を続けます。
Claude Coworkは、接続済みのコネクターから外部サービスへアクセスします。目的を達成できない場合はブラウザ、画面操作の順に進みます。WorkとCoworkは製品機能の名前であり、この記事独自の一般分類ではありません。
Claude、Cowork、Claude Desktopでremote MCPを使うには、Anthropicのクラウドから接続できるサーバーが必要です。ChatGPTもMCP対応のカスタムアプリから外部ツールを呼べますが、利用プラン、管理者設定、読み取り・書き込み権限で実行できる操作が変わります。
MCPサーバーから別会社のAIを呼ぶ場合は、接続先の会社が発行したAPI認証をMCPサーバー側に設定します。Webアプリの月額契約を、そのまま別会社のAPI認証には使えません。手動添付・コネクター・ローカルファイル参照・API送信のどれを使うかは、環境名だけでは決めません。送信先と権限を個別に記録します。
同じ共通手順を使う場合でも、実行場所が変われば認証、送信経路、許可できる操作が変わります。接続方法を決めた後、次は公開仕様で候補を絞り、実際の代表タスクで担当モデルを選びます。
現在のモデル特性は担当決めに使う
公開仕様から分かるのは、入力形式、コンテキスト上限、検索やコード実行の有無などです。長文編集、画像理解、検索結果の正確さといった自社業務への適性は、同じ代表タスクで測るまで確定しません。
次の表の中央3列は、公式の性能順位ではありません。公開仕様と料金を基に、本稿が代表タスクへ進める候補を分けたものです。モデル名と仕様は2026年8月24日の調査時点です。
| API基盤 | 難しい判断や長い作業の候補 | 速度と費用の均衡を取る候補 | 大量処理の候補 | 主なコンテキスト上限 |
|---|---|---|---|---|
| OpenAI | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna | 3モデルとも1.05M |
| Anthropic | Claude Fable 5、Opus 5 | Claude Sonnet 5 | Claude Haiku 4.5 | Fable・Opus・Sonnetは1M、Haikuは200k |
| Gemini 3.1 Pro Preview | Gemini 3.7 Flash | Gemini 3.5 Flash-Lite | 3モデルとも1,048,576 | |
| xAI | Grok 4.6 | 代表タスクで判断 | 代表タスクで判断 | 500k |
OpenAIのモデル一覧は、Sol・Terra・Lunaを異なる処理量と費用の選択肢として示しています。Anthropicのモデル一覧には、Fable・Opus・Sonnet・Haikuの用途と上限が掲載されています。
GoogleのGemini 3.7 Flashは、コード、複数形式の入力、多段処理を候補用途に挙げています。Gemini 3.1 ProはPreviewのため、継続運用ではモデルIDと廃止予告を確認します。
Grok 4.6 APIはWeb検索、X検索、コード実行、関数呼び出しを組み合わせられます。X上の発信を調べる工程の候補にはできますが、検索結果の正確さは自社の代表タスクで測ります。公式の用途説明は試す候補を絞る資料であり、4社を横断する性能順位ではありません。
例えば、公開前の記事で引用漏れを減らしたい場合は、本文、参照URL、公開しない情報の条件を同じ入力として各候補へ渡します。依頼文も固定します。
本文中の事実主張を先頭から確認してください。参照URLが直接支えていない主張と、URLがない主張だけを挙げてください。文章の好みは評価せず、該当する一文、理由、確認先を表で返してください。
担当者は元のURLを開き、指摘が正しいかを確認します。「拠点単独では不合格だったが補助追加後に合格した評価項目数」から「拠点単独では合格だったが補助追加後に不合格になった評価項目数」を引き、正味改善を求めます。重大な誤引用と権限外操作は0件、人の確認時間と総費用は事前上限内という条件も満たした場合だけ、補助AIへ引用監査を任せます。
アプリとAPIの費用は分けて考える
Webアプリ、CLI、APIでは、使える認証と課金枠が製品ごとに異なります。ChatGPT Plusの契約にOpenAI API料金は含まれません。Claudeの有料プランについても、AnthropicはAPIとConsoleを契約に含めないと案内しています。
Geminiでは、アプリ向けのGoogle AIプランとGemini Developer APIの料金が分かれています。Grokも、アプリの料金とxAI APIの従量料金を別に確認します。CLIはサブスクリプションのログインに対応する場合と、APIキーを使う場合があるため、CLIという名前だけで課金方法を決めません。
各実行について、料金確認日・契約プラン・認証方式・モデル版・入出力量を同じ台帳へ記録します。検索や保存の追加料金、再試行回数、人の確認時間も加えます。APIの公式単価から見積もった額は、請求画面または利用明細と照合します。契約固定費を複数業務で使う場合は、この案件へどの割合を割り当てたかも残します。
最初から4社すべてを契約するのではなく、主軸のAIで代表タスクを実行し、不合格になった工程だけ補助候補へ渡します。補助AIによって減った不合格が、追加料金、確認時間、再試行、データ移送の負担に見合う場合だけ採用します。重大な誤りが1件でも出た場合や、総費用が事前上限を超えた場合は、採用または更新を見送ります。
よくある質問
主軸AIを変更するとき、既存のSkillはどう移しますか?
共通手順、正解データ、過去の失敗例を先に移します。保存場所・権限・ツール名・出力スキーマだけを、移行先向けに作り直します。現行版と移行版を同じ代表タスクで3回比較し、移行版が合格するまで現行版を削除しません。
共通手順と製品別設定は誰が更新しますか?
業務責任者は、目的・禁止事項・合格条件を承認します。各製品の管理者は、認証・権限・ツール設定を更新します。一人が両方を変更した場合も、公開前には別の担当者が変更差分と実行結果を確認します。
Claude CodeからCodexのサブスクを使えますか?
Claudeの契約をCodexへ移して使うことはできません。Codex側が対応するサブスクリプションのログインまたはOpenAI APIの認証を別に用意します。どちらの課金枠を使ったかは、実行環境の公式案内と請求画面で確認します。
Webアプリから別会社のAIを呼べますか?
Webアプリが公式に対応するコネクター、MCP、カスタムアプリがある場合は、その許可範囲で外部処理を呼べます。対応がなければWebアプリの外に連携処理を用意し、接続先のAPI認証、データ送信許可、別料金を確認します。
モデル更新後に旧版へ戻す条件は何ですか?
重大な誤引用や権限外操作が1件でも出た場合、必須条件達成率が現行版を下回った場合、確認時間または総費用が事前上限を超えた場合は旧版へ戻します。比較に使った入力・モデル版・出力・実行時刻・採点結果を残します。次の更新でも同じ条件を使います。
業務に合うAIシステムの開発をご相談ください
AIを試せても、社内のデータや既存システムにつないで使うには、入力・出力・権限・確認手順を決める必要があります。Deskrexでは、業務に合わせたAIエージェントや自動化システムの開発をご支援しています。

まず、つくりたいシステムと現在の業務、接続するツールやデータを伺います。技術の選定と小規模な試作を通じて、必要な機能と実現方法を確かめ、開発の範囲を整理します。
Difyやn8nを使う自動化、独自のAIエージェント、セルフホスト型システム、既存システムとの連携に対応します。試作から本開発、導入、保守・運用まで、案件の目的に合わせて進めます。
つくりたいシステム、扱うデータ、接続先をお知らせください。受託開発のご案内をご覧ください。
調査手法について
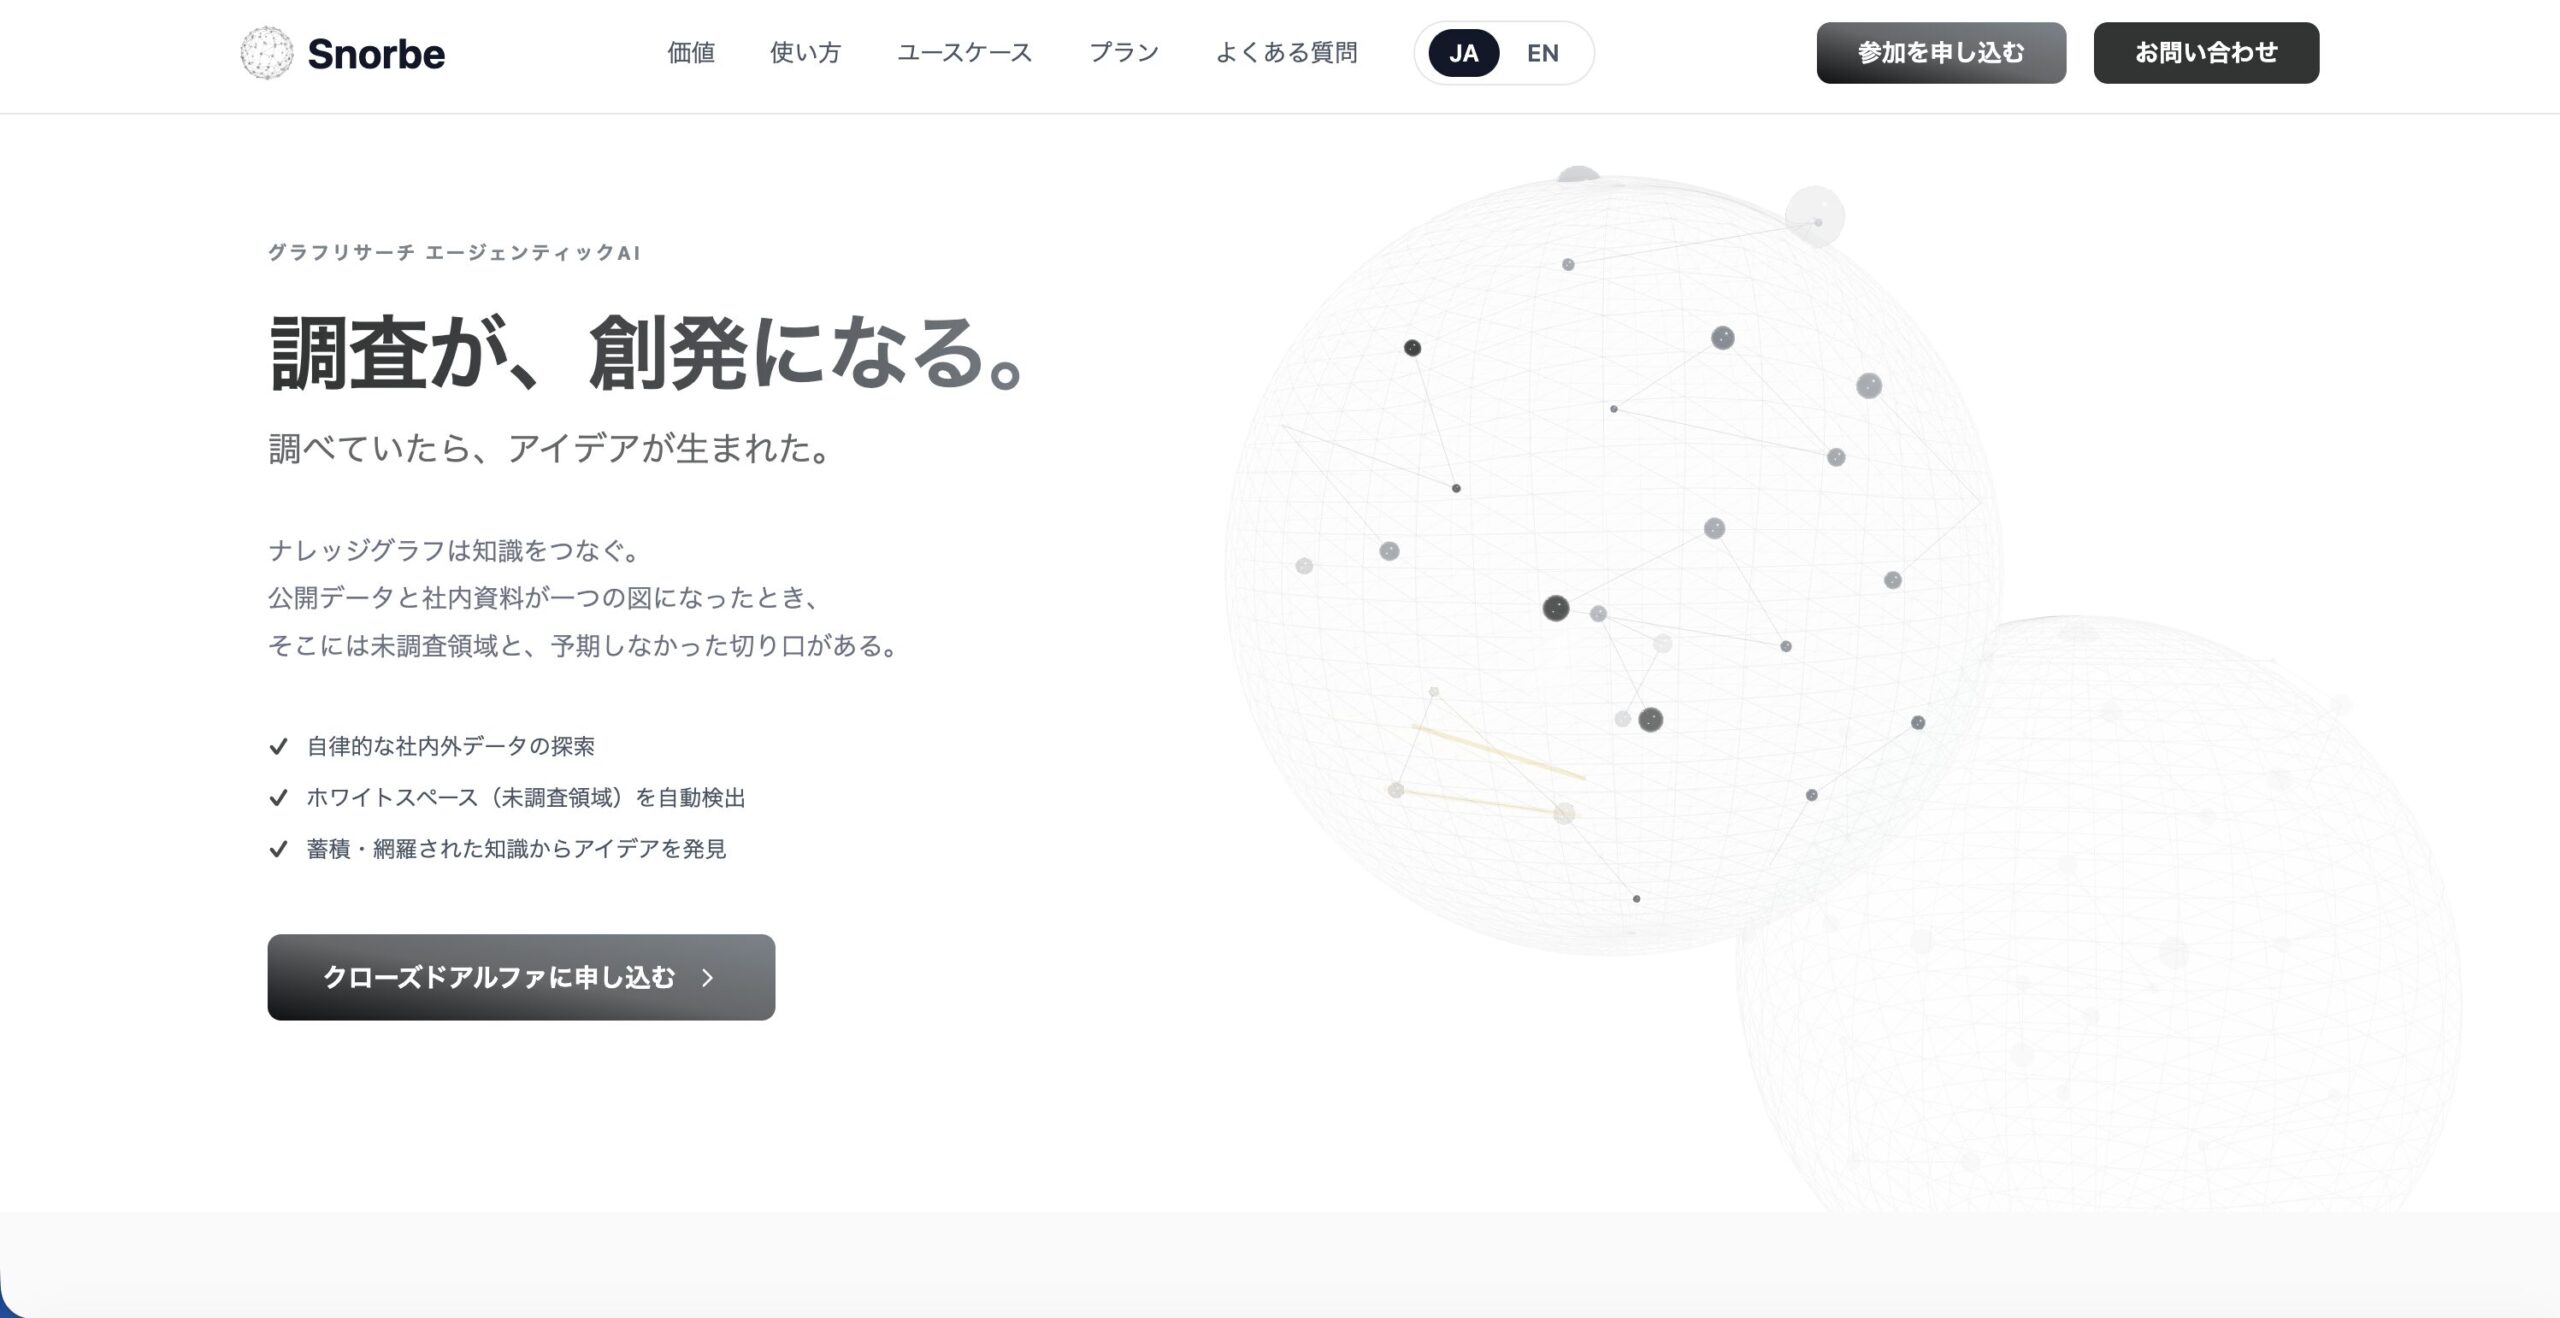
こちらの記事はグラフAIリサーチプラットフォームのSnorbeを使って作られています。Snorbeは研究開発・新規事業向けの調査テーマに応じた幅広い項目のオートリサーチや、ナレッジグラフの構築、構造化レポートの生成ができるAIリサーチツールです。
Screenshot
調査したいテーマを入力するだけで、AIが深堀りすべき観点や広げるべき調査項目をレコメンドしながら、自動でリサーチを進めます。収集した情報はナレッジグラフとして蓄積され、未調査領域(ホワイトスペース)を可視化しながら調査の網羅性を高めていけます。
また、観点マトリクスを30秒・構造化レポートを10分で自動生成する機能があり、出典付きのレポートをMarkdown/PDF形式でエクスポートできます。調査の元データも保存されるため、ファクトチェックや社内共有も容易です。
ご利用をご希望の方は、こちらよりお申し込みください。
また、グラフAIを活用した社内ナレッジ管理や、研究開発・新規事業のリサーチ支援、セルフホスト導入のご相談も受け付けています。お困りの方はお気軽にご連絡ください。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai

コメント