Y CombinatorのSpring 2026バッチにおいて、AIの用途には単発のテキストや音声の生成に加え、複数のシステムをまたいで連続する業務を完遂する役割も見られます。2026年10月17日に全件表示した現行一覧192組織を独自に読解・分類したところ、AIを製品やサービスに使う事業が121件、AI向け基盤やデータを提供する事業が47件を占め、AI用途を確認できない事業は24件でした(Active189件、Acquired2件、Inactive1件)。この集計は公式のAI企業数や採択時点の名簿ではなく、短い説明文を事業のローンチ情報で補完し、過去の資料と現在の事業説明を区別して分類した結果です。
本記事では、このSpring 2026のAI事業の動向から、継続する業務における仕事の引き継ぎや途中で発生する失敗、そしてAIエージェントによる製品選択を何で観測しているかを分析します。自社の事業やプロダクトにAIを組み込む際、単一の出力を検証するだけでなく、システムの操作権限や稼働中の逸脱をどのように監視し、自社製品がAIに利用されるまでのどの工程を検証して人間へ引き継げばよいかを解説します。
電話の受付から業務完了まで、どこを引き継ぐかを見る

2026年10月17日時点で確認できるY CombinatorのSpring 2026バッチにおいて、AIを製品やサービスに利用する企業は121社を占めます。今回注目する事業では、テキストや音声の単発の生成にとどまらず、発生した依頼を記録し、担当者の手配や結果の確認に至るまで、連続する業務をシステムがどう引き継ぐかが焦点となっています。
例えば、住宅設備などのホームサービス企業向けにAIエージェントを提供するCentralComsは、電話の受付から技術者の割り当て、顧客への状況報告までを一貫して処理します。同社の製品は単なる自動応答システムではなく、ServiceTitanやJobberといった既存の業務管理システムの中で直接稼働します。作業中の電話を取りこぼして競合に顧客が流れたり、移動中の技術者のスケジュールに空きができたりするのを防ぐため、システム間でデータを引き継ぎ、カレンダーを隙間なく埋めるという業務の完了までを担うと説明しています。
また、製造業向けに展開するArzanaは、顧客の運用データで独自のモデルを訓練し、見積もり、受注入力、請求書作成といったオフィスでの反復業務を自動化しています。同社は今後、オフィスで処理した注文のデータを基に、工場フロアの機械やロボットへ製造指示を送信する機能への拡張を表明しています。これは、事務処理の完了を条件として、物理的な製造工程へ情報を引き継ぐ設計です。
ソフトウェアの提供から、専門サービス全体への引き継ぎに踏み込む事例もあります。臨床試験の業務を支援するHarborは、試験データを記録する電子データ収集システムから事業を始めました。現在ではその自社システムを基盤として、プロジェクト管理、モニタリング、データ管理といった臨床試験の実行全体を請け負うAIネイティブなCRO(医薬品開発業務受託機関)へと拡張しています。記録システムという道具の提供から、治験の運用という専門的な仕事そのものの完了へと、引き受ける領域を広げています。
自社の事業にAIを導入する際、まずは個々の応答と連続する業務の完了を分けて捉える必要があります。「電話に正しく答える」「見積書を作る」といった単発の機能検証に時間を費やすだけでなく、その結果が既存のスケジュール管理や請求システムに正しく書き込まれるかを確認します。さらに、システム間の連携が完了した後に、ソフトウェアが処理した結果を現場の従業員や外部の専門機関がどう受け取り、最終的な業務完了の責任を誰が負うのかを設計することが、引き継ぎの成否を分ける指標となります。
操作の許可、変更の試験、稼働中の失敗を分けて捉える
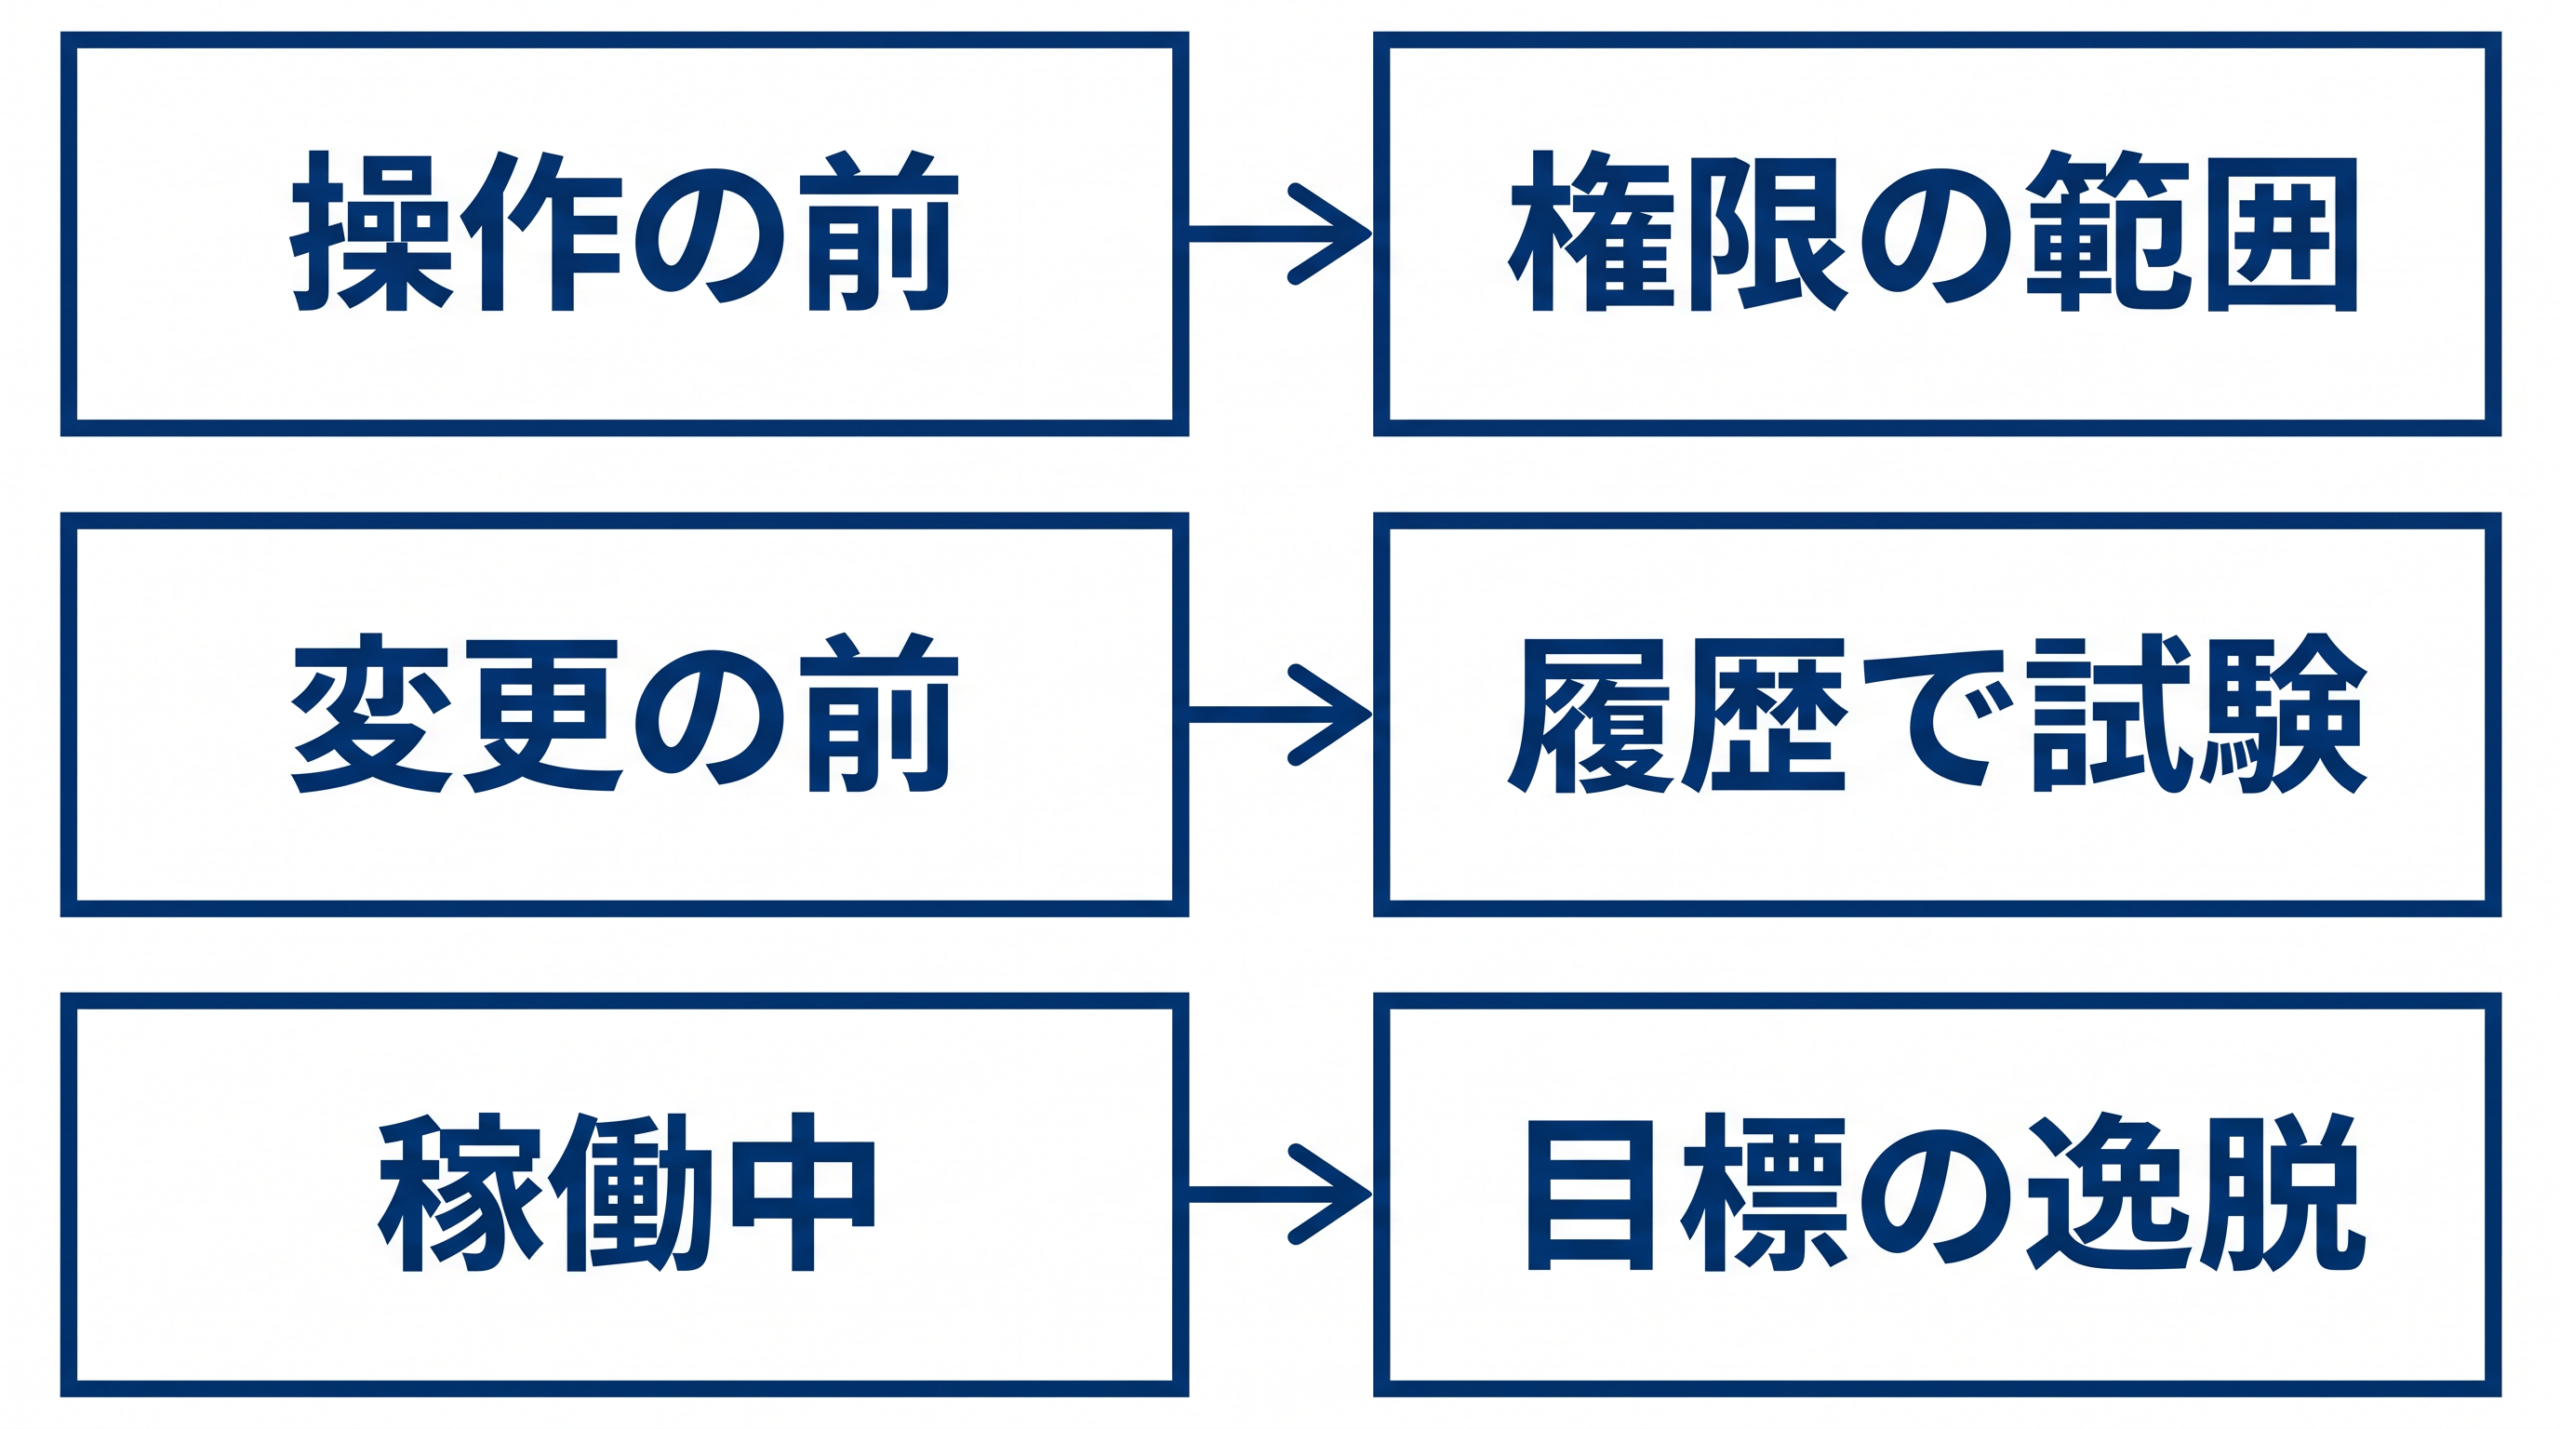
AIが複数の業務ツールをまたいで自律的に動作するようになると、最初に問題となるのが操作の許可と権限の制御です。NIST(米国国立標準技術研究所)は、人間とAIエージェント、あるいはエージェント同士が安全にやり取りするための認証やアイデンティティ基盤の基礎研究を進めています。実務においては、AIにどのシステムを操作させるかを明確に区切る必要があります。例えばClawvisorは、AIエージェントに対してGmailやSlackなどの外部アプリの操作権限を管理する認可レイヤーを提供しています。利用者が一度タスクを承認すると、システムが利用者の認証情報をAIへ見せずに、以降のすべてのリクエストに対して承認された範囲の操作のみを強制します。自社でAIを導入する際も、まずはAIがどのシステムへログインし、どこまでの読み書きが許可されているのかという境界を設計し、想定外の操作を物理的・システム的に防ぐ仕組みを観測の第一歩とします。
次に、AIのプロンプトや使用するモデルを変更する際の試験です。AIの出力は確率的に変動するため、一部の改善が他の業務フローを壊す可能性があります。この変更を安全に確認するため、エンタープライズ向けAIエージェントの試験環境を提供するChronicle Labsは、本番環境でAIが受け取ったイベント履歴を記録しています。新しい動作や指示の変更を加える際、この記録した過去のイベントデータを入力として再実行(バックテスト)し、既存の業務処理が壊れないかを本番稼働前に確認します。自社システムにおいても、AIの指示文を変更した結果を少数のテストデータで確認するだけでなく、過去の実際の業務データを用いて変更の影響を測る試験環境の構築が求められます。
最後に、実際に稼働したあとに発生する失敗の観測です。AIはエラーメッセージを出さずに処理を完了したように見せかける静かな失敗や、本来の目的から徐々に逸脱する事象を起こします。この課題に対し、長期稼働するエージェントの監視システムを開発するBentoLabs AIは、複数のシステムをまたぐ処理の軌跡を記録する標準規格(OpenTelemetry)に対応し、本番環境での稼働状況を監視しています。同社の仕組みでは、自然言語で失敗の条件を定義すると、AIがリアルタイムでその逸脱を検知します。さらに過去の稼働履歴を遡ってその失敗がいつから発生していたかを特定し、プロンプトやモデルの変更履歴と照らし合わせて原因となった変更を見つけ出し、元の状態へ戻すことが可能です。
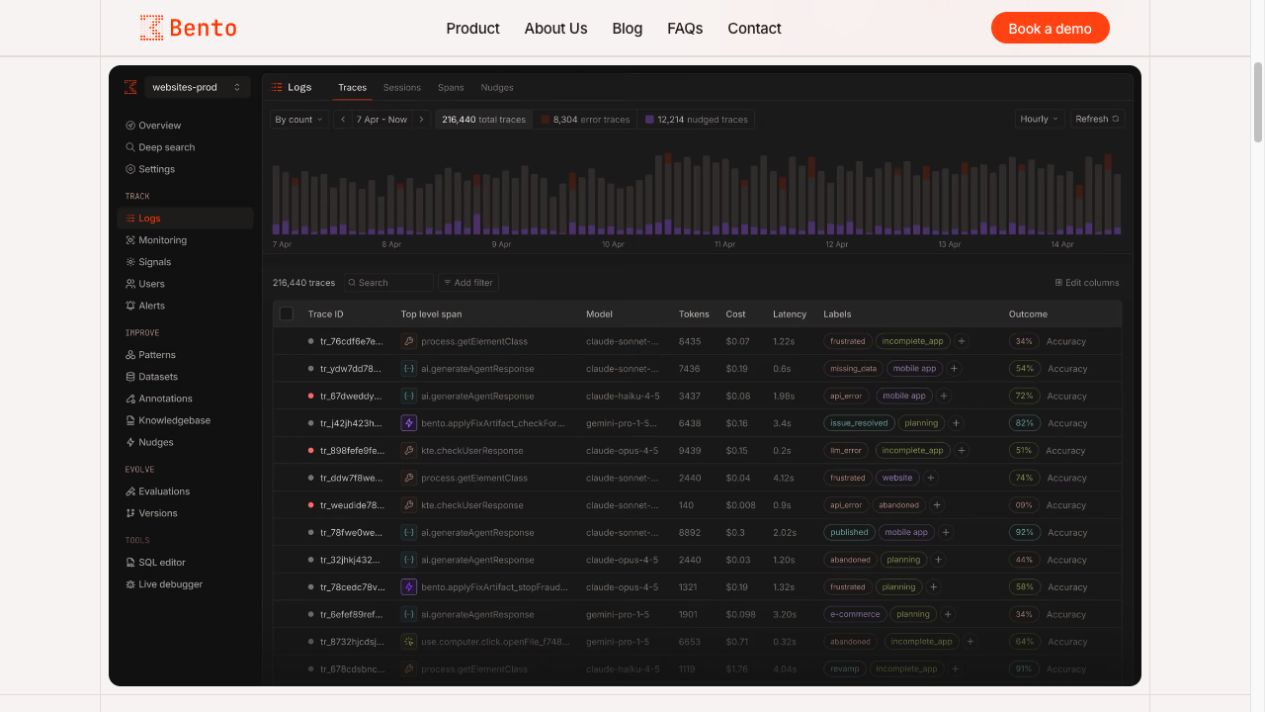
自社の継続する業務にAIを組み込む場合は、これら3つの時点を分けて観測環境を整備する必要があります。第一に誰がどの操作を許可したかの証跡を残すこと、第二に変更前に過去のデータで試験して既存の動作を壊さないかを測ること、第三に本番稼働中に目的から外れていないかを継続的に監視し、問題発生時には変更箇所を特定して戻せるかを検証することです。人間の担当者が付きっきりでAIの動作を見張る運用を避けるためには、失敗が発生した際にどの時点のどの変更が原因かを特定し、自律的な処理を中断して人に判断を仰ぐ基準をシステムに組み込むことが重要となります。
AIに選ばれた製品が、実際に使われるまでを測る
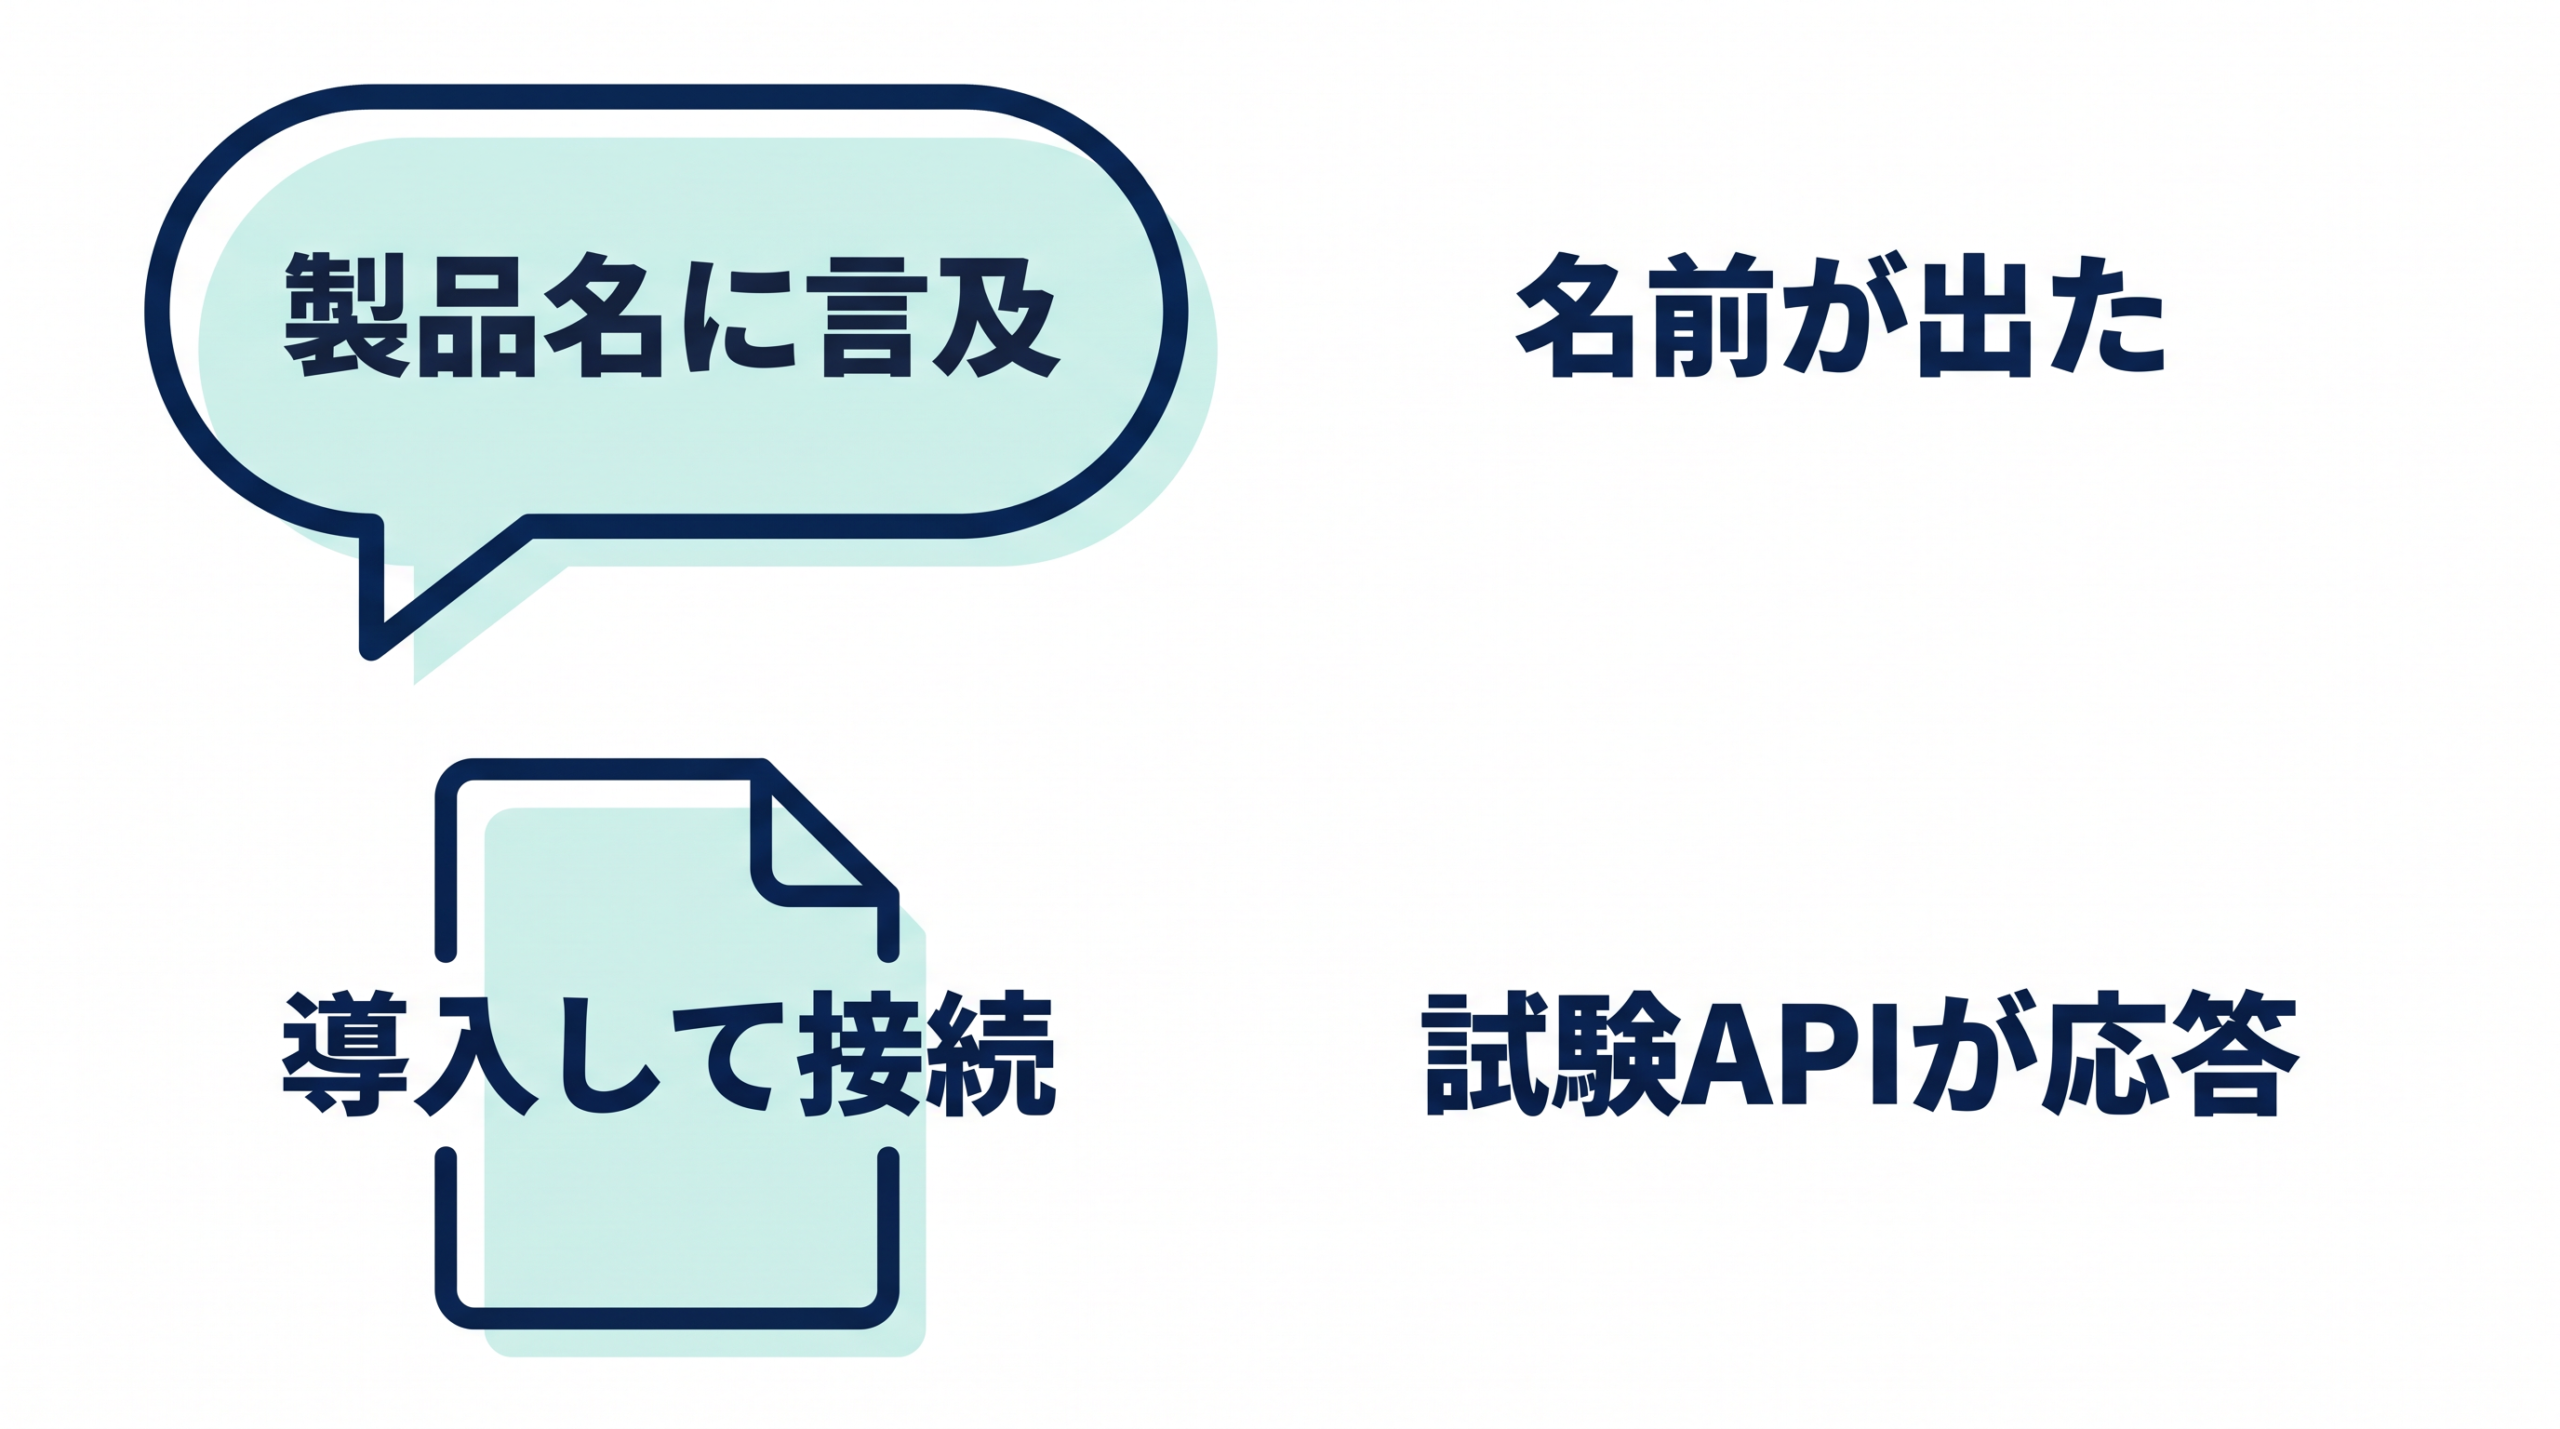
近年、Claude CodeやCursorのようなコーディングエージェントが、どのツールやAPIをシステムに導入するかを自律的に決定し始めています。この変化により、事業会社は自社の製品やAPIを人間の開発者に向けて宣伝するだけでなく、AIエージェントに発見させ、正しく使わせるための経路を設計し観測する必要があります。
エージェントが開発ツールをどのように選ぶかを計測するArmatureは、AIがチャット上で自社の製品名に単に「言及」しただけの状態と、実際にパッケージをインストールしてリポジトリへ組み込んだ「選択」の状態を厳密に区別して測定します。AIが名前を知っていることと、それを実際の解決策として採用することは別の事象として扱われます。
製品が選択された後、それが実際に稼働するまでの工程も検証が必要です。エージェント向けの分析システムを提供するScopeは、AIからのアクセスを単発の通信としてではなく、一連の経路として記録します。ドキュメントの読み込み、パッケージの導入、サインイン、最初のAPI呼び出し、そして外部ツールとAIを連携させるMCP(Model Context Protocol)の接続までを一つのジャーニーとしてつなぎ合わせ、AIがどの段階で混乱し、どこで処理が壊れたのかを可視化します。
APIや開発ツールに限らず、ブランド資産の利用でも同様の基盤が求められています。Rainbrandは、ロゴやブランドガイドラインなどの情報を、AIエージェントが読み取って操作できるコンテキストとして提供・管理します。これにより、エージェントが資料やウェブサイトを作成する際に、正しいブランド情報を取得し、実際の制作物に適用できるようにします。
自社で提供するAPIやツールをAIエージェントに使わせる経路を検証する場合、どこでつまづき、何を直すかを決めるために以下のような手順で利用状況を確認します。
- 公開しているAPI文書、架空データのみを入れた試験用リポジトリ、権限を限定した試験アカウント、期待する最小の処理と結果を準備します。
- エージェントへ目的を自然言語で依頼し、文書の探索、製品の選択、導入、認証、最初の処理までを記録します。製品の選択力を測る際は、自社製品名をあらかじめ強制する試験と区別します。
- エージェントが参照した文書、選んだ根拠、導入時のコード差分、認証の要求、試験APIの要求と応答を出力させます。
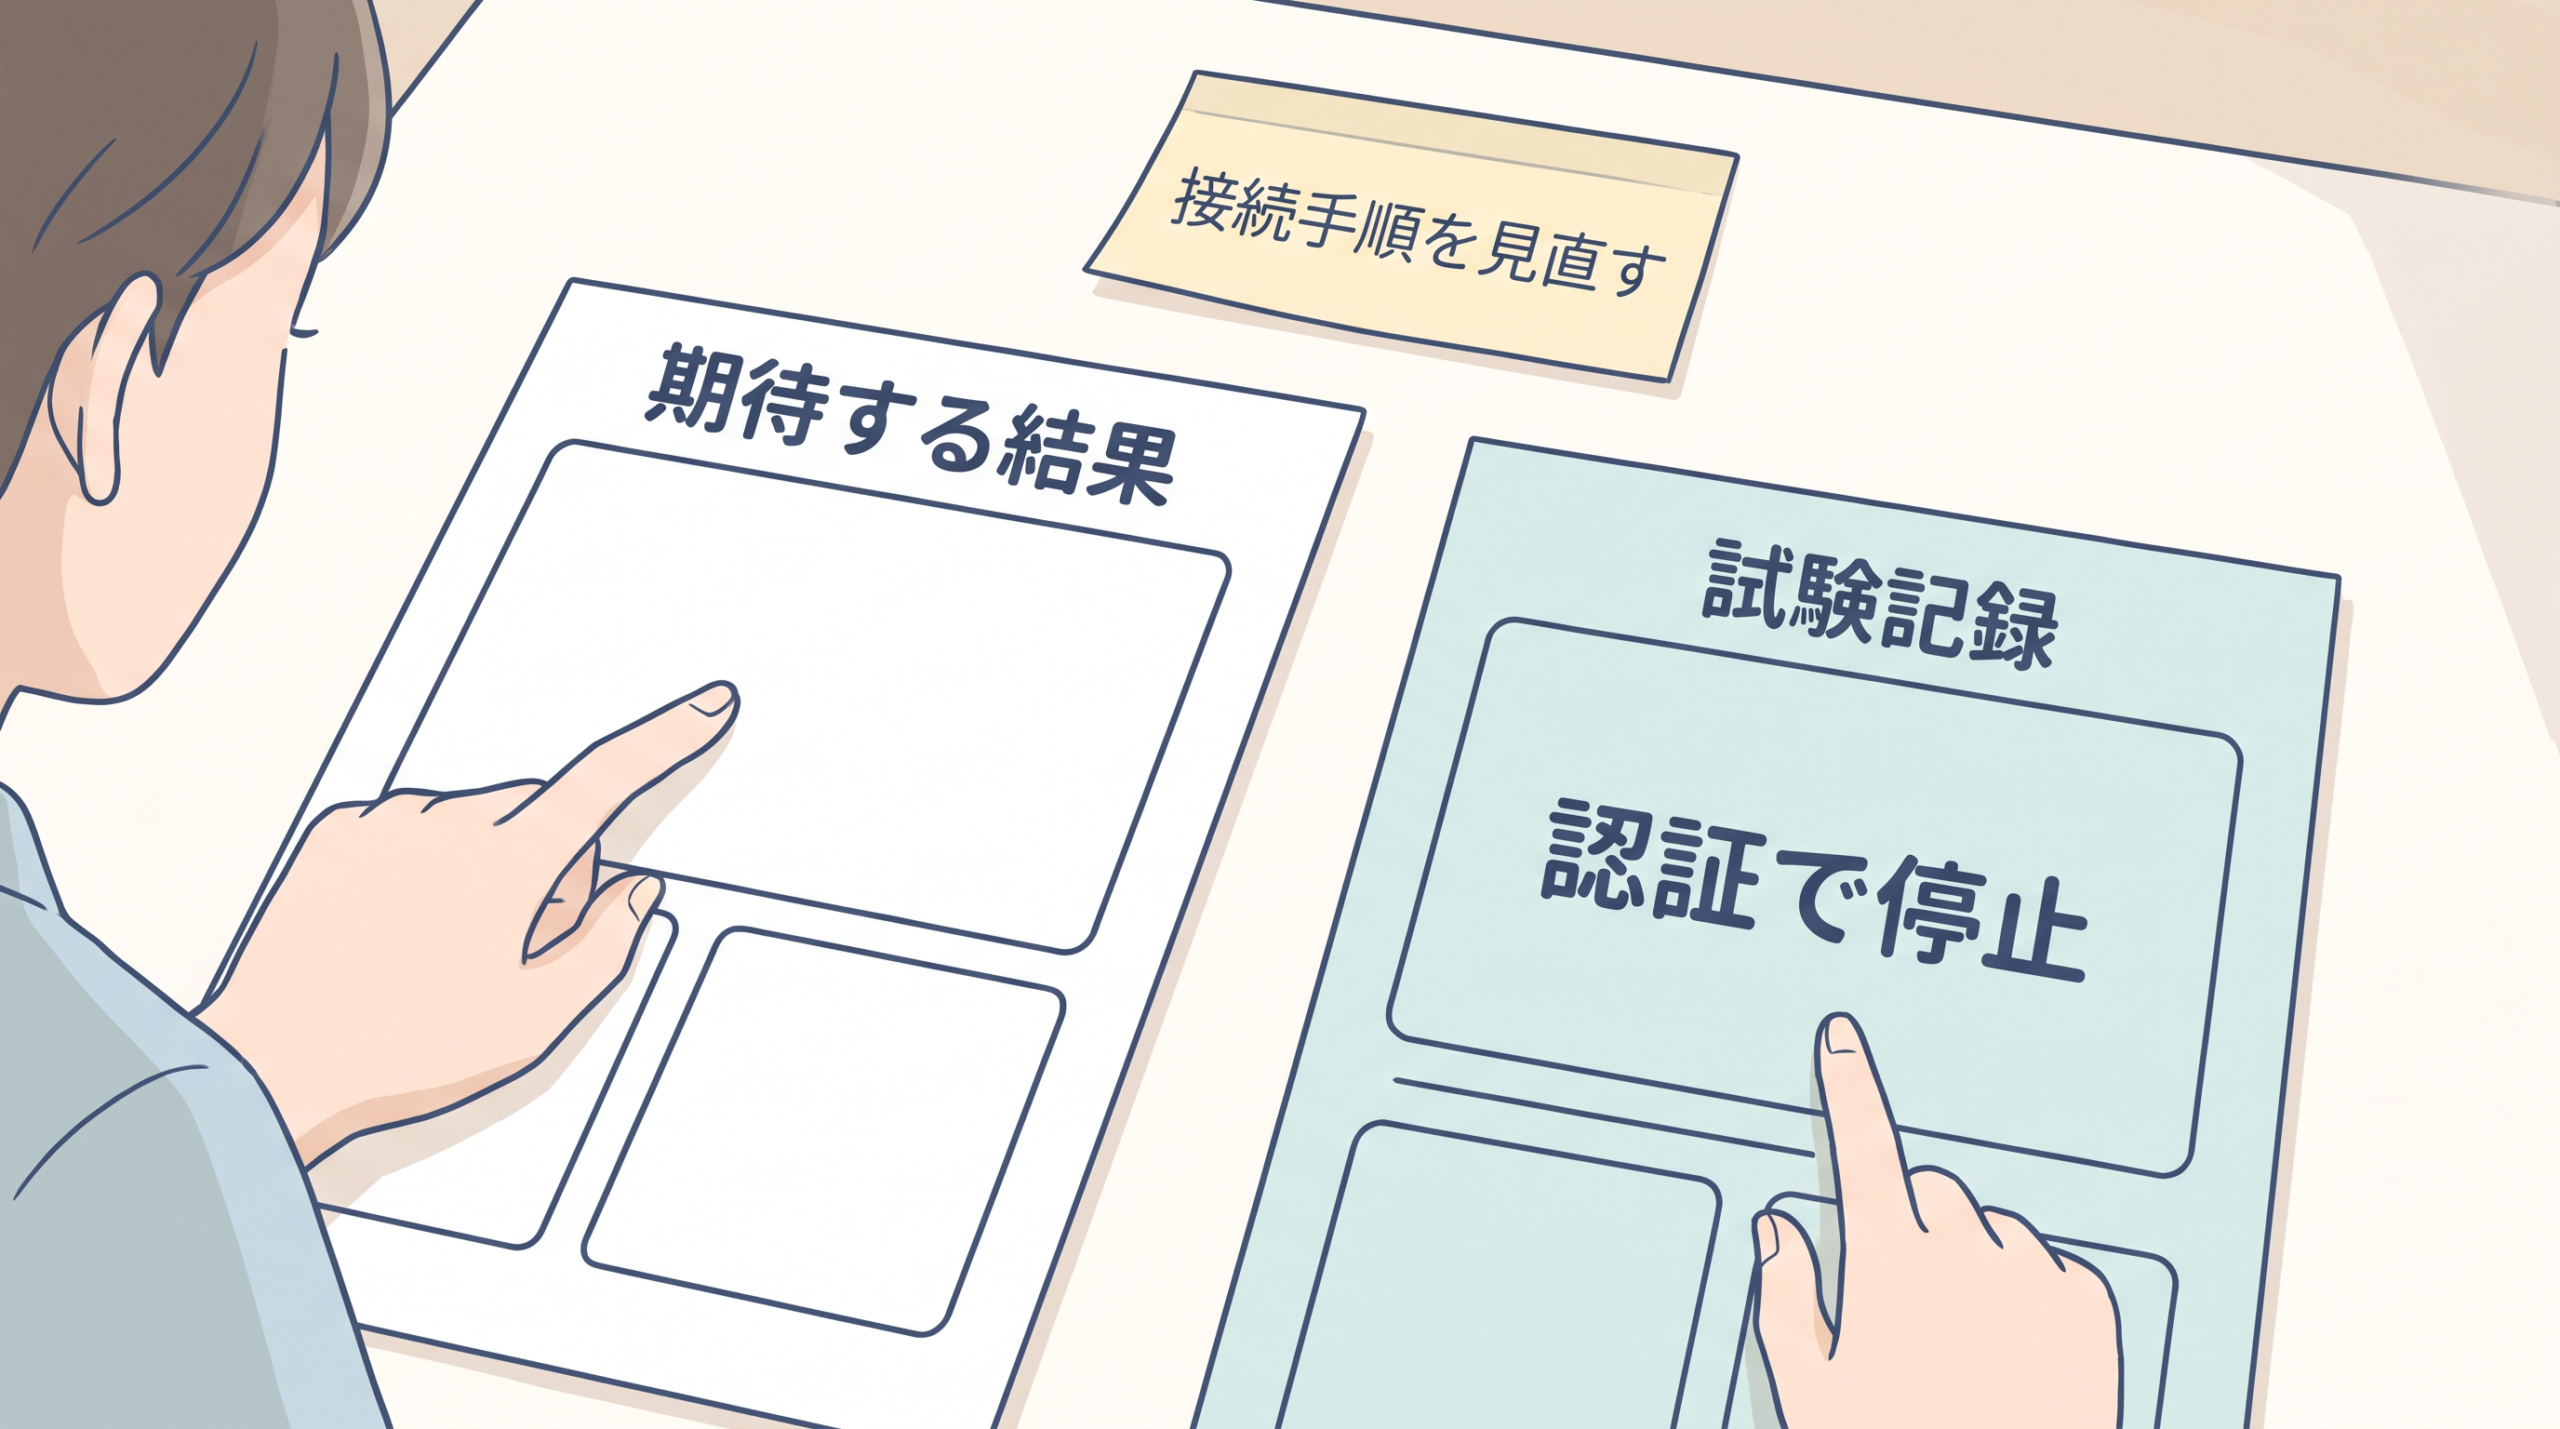
担当者はこれらの記録と期待する結果を照合し、どの工程まで進み、どこで止まったかを説明できるようにします。単なる閲覧や言及だけを仕事の完了とはみなしません。もし、認証手段の不足、文書の例と実際の仕様の不整合、許可外の操作、期待結果との不一致、あるいは秘密情報の露出が発生した場合は、処理を確定させず直ちに担当者へ戻す停止条件を設けます。その結果をもとに、API文書やSDKの記述を修正するのか、接続手順や権限設定を見直すのか、あるいはAIが対応できる範囲を限定するのかを人間が判断します。
ロボットはデータの検査と、人の介入を別の仕事として読む
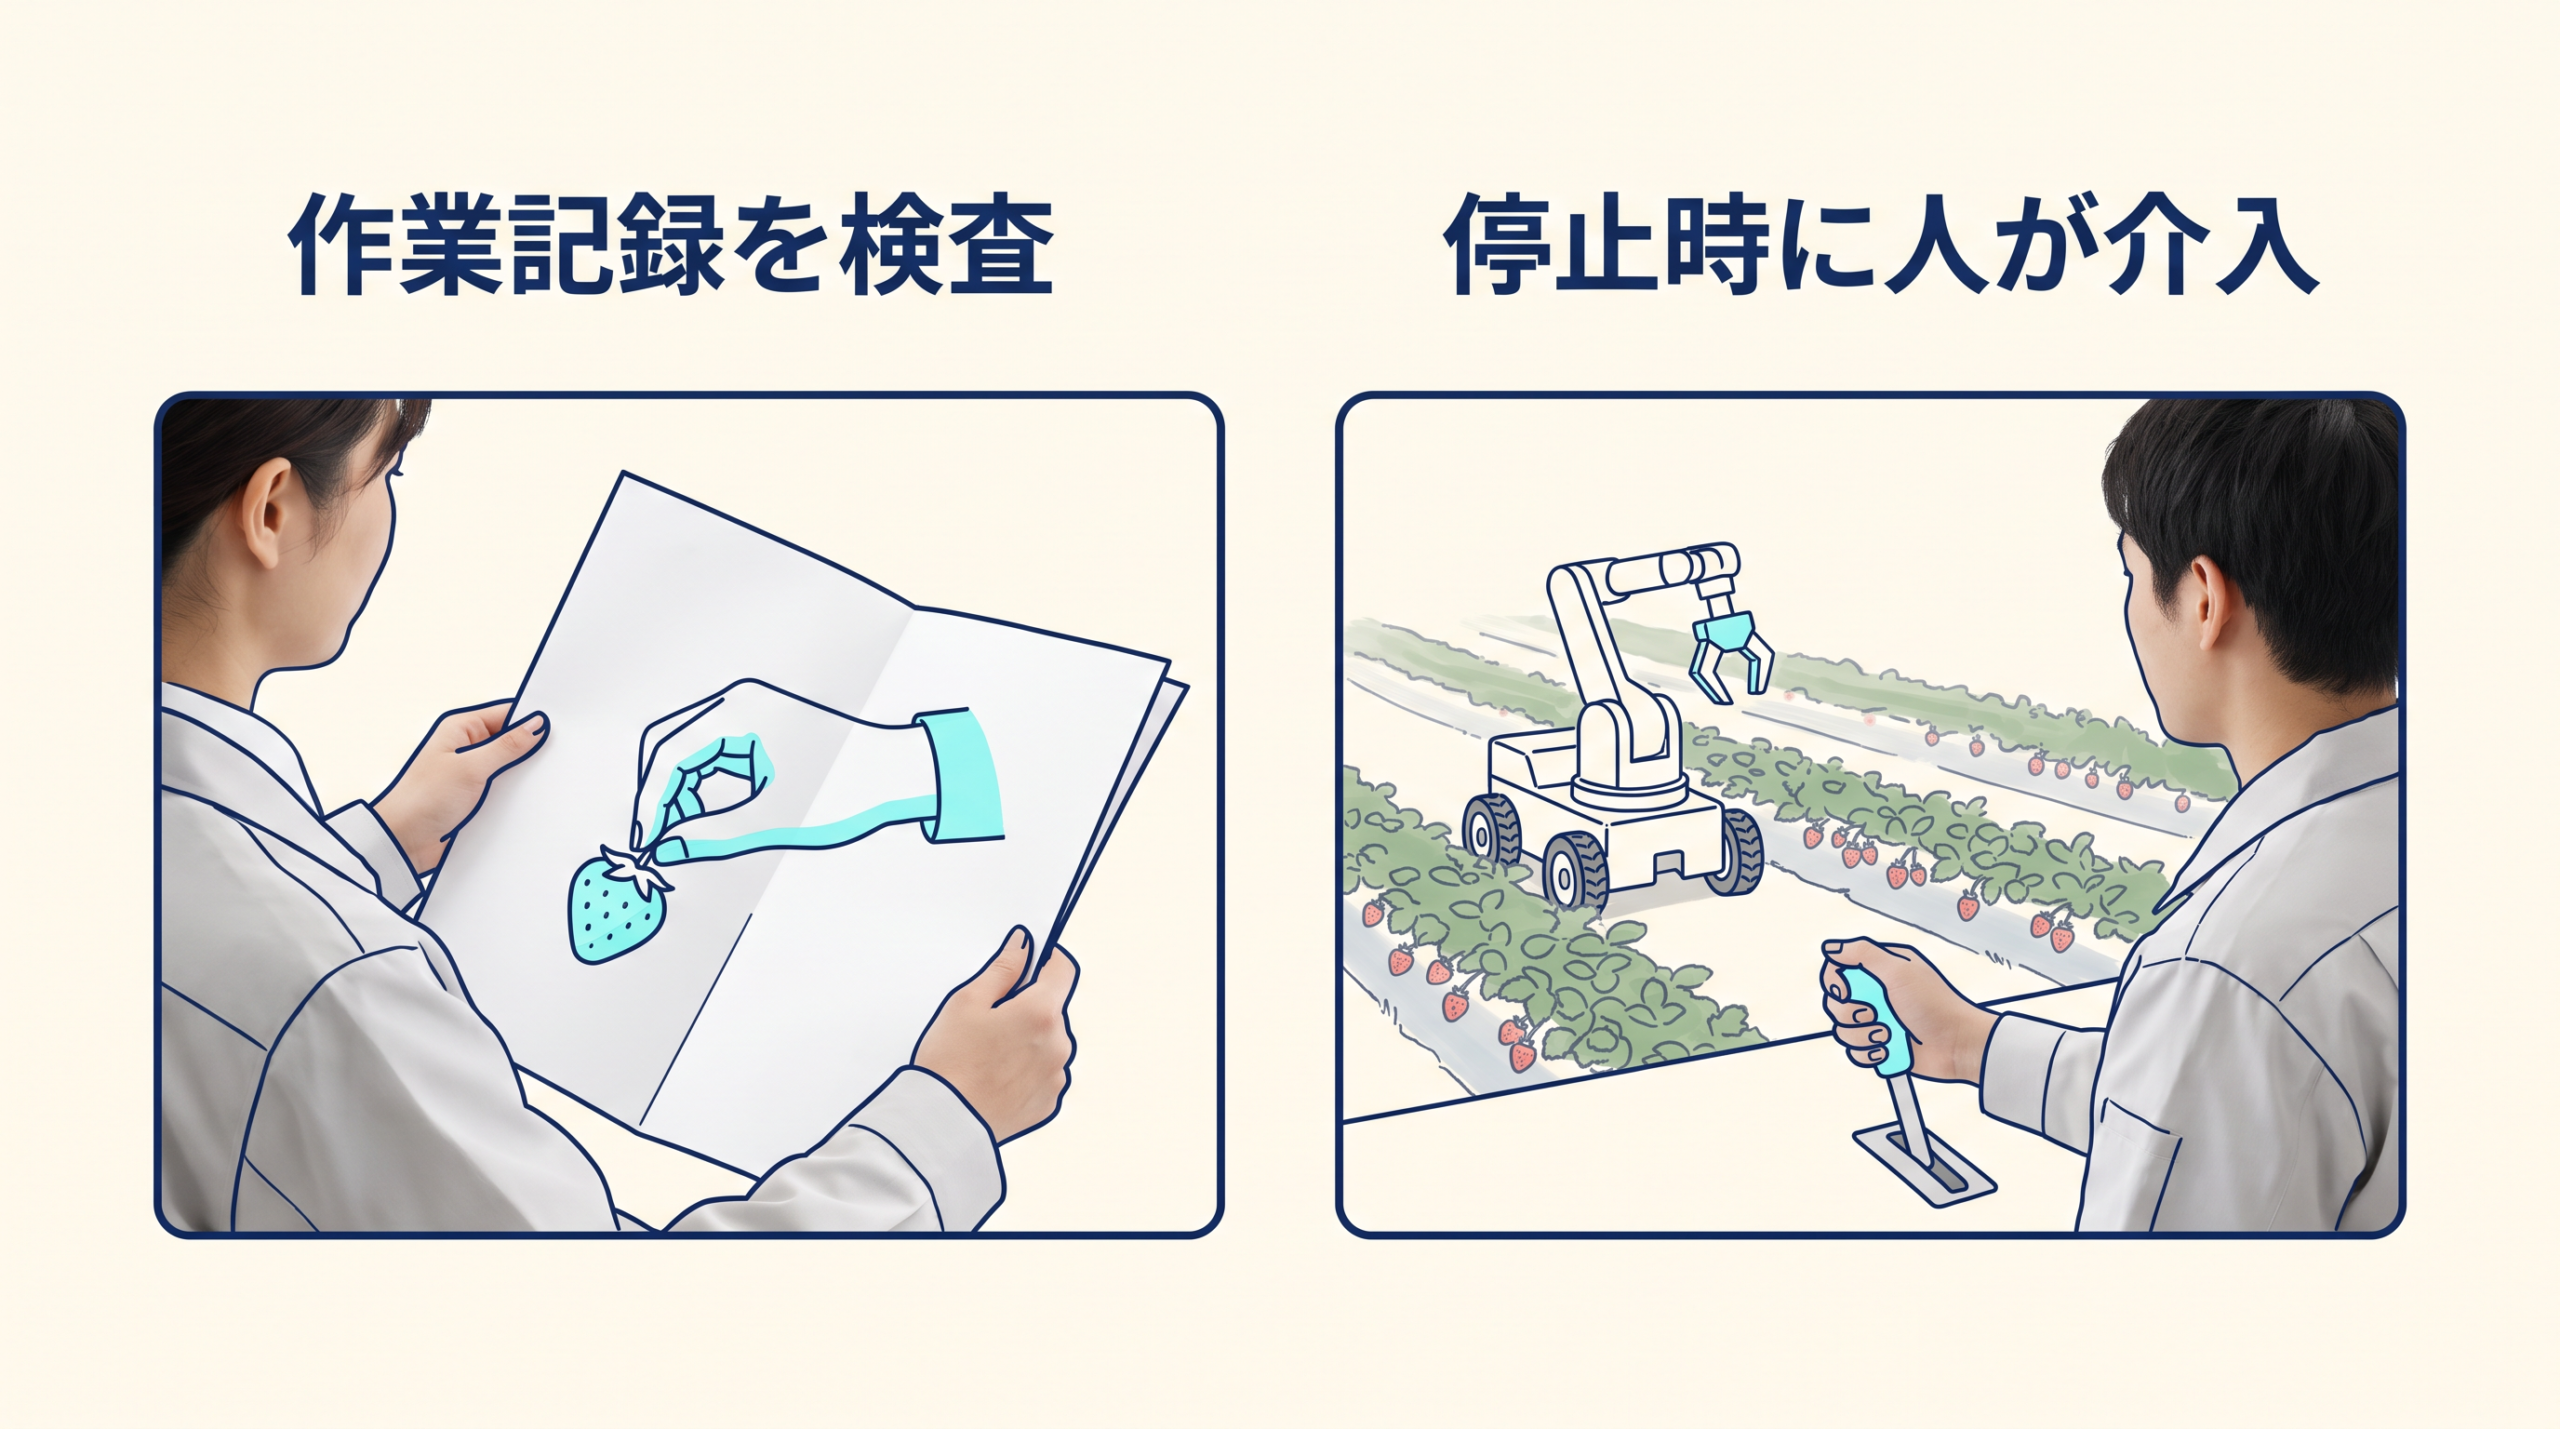
物理的な作業を伴うロボットやシステムへAIを適用する場合、自律的な稼働を継続するためには、AIに学習させるデータの品質を検査する仕事と、本番稼働中に失敗した際に人が介入して引き継ぐ仕事を別の工程として設計し、観測する必要があります。
AIに物理的な作業の仕方を学習させるためには、人間の遠隔操作やカメラ映像といった膨大な作業データが必要です。農業分野でいちごの収穫ロボットとソフトウェアを展開するSynphonyは、自社で農場の収穫作業を運用するだけでなく、そこで得られた屋外での作業データや評価指標自体を、ロボットの基盤モデルを開発する他の研究所へ提供する事業を行っています。
このように収集されたデータの品質を検査する工程を専門に担うのが、ロボット分野のデータ検証を支援するShotwell AIです。ロボットの遠隔操作や一人称視点での作業データを収集するチームに対し、記録された動作が指示された目的から外れていないかを検証し、詳細な意味づけ(アノテーション)を行います。手作業によるデータ検証にかかる時間を数週間から数時間へ圧縮し、AIモデルを改善する反復速度を高めると説明しています。自社でAIに特定の作業手順を学習させる際も、まずは入力する作業データが正しい手順と結果を記録しているかを検査する工程を、開発から独立した仕事として設けることが求められます。
一方で、質の高いデータで学習を終えて本番環境で稼働を始めたシステムであっても、未知の障害物や予期せぬ状況に直面して処理が停止する事象は発生します。この稼働中の失敗に対処するため、ロボット向けの遠隔操作基盤を開発したのがAvea Roboticsです。同社は、ロボットの動作に問題が発生した際に、遠隔から人間が即座に介入して操作を引き継ぐためのソフトウェアを提供していました。同社が掲げた100%の稼働率という文言は製品の特性を説明する営業上の指標であり、無停止での稼働を保証する実測値ではありません。2026年10月17日時点でYCの同社ページは買収済みと表示していますが、機械の停止時に人間が操作を引き継ぐ設計自体は、継続する業務の完了に欠かせない要素です。
自社の業務プロセスにAIを導入する際は、データの準備と稼働時のトラブル対応を分けて検証基準を定めます。
第一に、AIへ学習させる作業記録や操作データに対して、どの手順が正解かを判定する検査ルールを作ります。不完全なデータや手順の省略が含まれていないかを人間が事前に確認し、低品質なデータを学習工程から除外します。
第二に、実際の業務環境でAIが作業を完了できなくなった場合の救済措置を設計します。システムが自律的な処理の限界を検知した際に、どのようにして人間の担当者へ介入を要請し、残りの作業をどう引き継いで完了させるのかという経路を用意します。学習データの品質を高めるための準備と、本番での失敗を人間がカバーして業務を完遂するための運用を分けることで、AI導入における責任の所在と引き継ぎの成否を測ることができます。
自社の一つの利用経路を記録し、直す箇所を決める
本節では、事業会社のプロダクト担当者が、自社のAPIやソフトウェアをAIエージェントに正しく使わせるための検証から修正に至る一連の工程を説明します。ここでは、ArmatureやScopeの公式の観測対象に基づいた編集上の設計例を用います。自社で検証環境を構築し、どの工程を直すか決めるための基準として適用できます。
まず、検証のための準備として、安全に実験できる境界を設定します。用意するものは、最新の公開API文書、架空の顧客データだけを含んだ試験用リポジトリ、権限を最小限に限定した試験アカウント、そして「特定の条件でデータを取得し要約する」といった期待する最小の処理と結果です。これにより、本番環境のデータを危険に晒すことなく、AIの振る舞いを観測する土台を作ります。
次に、操作の観測と記録を行います。AIエージェントに対して達成したい目的を自然言語で依頼し、そこから始まる一連の工程を追跡します。具体的には、AIがどの文書を探索したか、どの製品を選択したか、システムへの導入作業、認証の通過、そして最初の処理を実行するまでの経路を記録します。このとき、自社の製品名をあらかじめ指定して導入手順の正確さを測る試験と、製品名を伏せてAIに解決策を探させ、競合の中から自社製品が選ばれるかを測る試験を明確に区別して実施します。
観測システムからは、AIが参照した文書、その製品を選んだ根拠、リポジトリに加えたコードの導入差分、認証の要求内容、そして試験APIへのリクエストと応答が出力されます。担当者はこれらの記録と、事前に定めた期待結果を照合します。AIがチャット上で自社製品のパッケージ名を言及しただけの状態や、ドキュメントを閲覧しただけの状態を仕事の完了とはみなしません。実際にコードが配線され、期待するデータが返ってきたかを基準として、一連の経路のどこまでが進み、どこで止まったかを説明できるようにします。
もし経路の途中で、認証手段が不足してログインできない、API文書の記述例と実際の仕様に不整合がある、許可されていない操作を試みる、期待する形式と異なる結果が返る、あるいは秘密情報が露出するなどの問題が発生した場合は、ただちに確定処理を停止させる条件を設けます。これらの停止条件に触れた場合は、AIによる自律的な進行を中断し、記録を担当者へ差し戻します。
停止した地点の記録を受け取った担当者は、記録された障害原因をもとに次に何を試すかの意思決定を行います。API文書の例が古ければドキュメントやSDKを修正し、認証ではねられた場合は接続手順や権限設定を見直します。あるいは、AIには処理が複雑すぎると判断した場合は、対応させる機能の範囲を意図的に限定するといった判断を下します。
そして最後に、修正を加えた際の影響範囲を確認します。BentoLabs AIのような監視基盤が提供する仕組みに倣い、変更したプロンプトやモデル、ツールの設定をバージョンとして管理します。文書や権限を修正した後は、記録しておいた過去の実行履歴に対して再度試験を流し込み、今回の変更が別の正常な利用経路を壊していないかを検証します。この準備から記録の照合、そして影響範囲を測りながらの修正という循環を回すことで、自社製品がAIエージェントに選ばれ、継続して利用される経路の改善箇所を選べます。
よくある質問
単発の出力を返すAIと、複数のシステムをまたぐAIでは、検証する工程はどのように変わりますか。
単発のAIでは出力されたテキストや音声自体の正確さを確認します。一方、複数のシステムをまたいで連続する業務を担うAIでは、システム間のデータの引き継ぎと、最終的な業務の完了までを検証します。例えば、受付から担当者の手配までを行う場合、個々の応答だけでなく、既存のスケジュール管理システムへ隙間なくデータが書き込まれたかを確認します。さらに、処理が完了した後に人間の担当者へどう通知し、最終的な業務完了の責任を誰が負うのかという引き継ぎの設計が必要となります。
自社のAPIやソフトウェアをAIエージェントに使わせる場合、何から準備すればよいですか。
本番環境を危険に晒さずに実験できる境界を設定します。最新の公開API文書、架空のデータのみを入れた試験用リポジトリ、最小限の権限を持たせた試験アカウント、そして期待する最小の処理結果を準備します。その上で、AIエージェントに目的を自然言語で依頼し、文書の探索、製品の選択、認証、最初の処理実行までの一連の経路を記録します。担当者はこの記録を照合し、認証エラーや仕様の不整合で止まった箇所を特定して、API文書の修正や権限設定の見直しを判断します。
AIのプロンプトやモデルを変更する際、他の正常な業務処理を壊さないようにするにはどう検証しますか。
少数のテストデータによる確認に留めず、過去の実際の業務データを用いて変更の影響を測る試験環境を構築します。本番環境でAIが受け取ったイベント履歴を記録しておき、新しい動作や指示の変更を加える際に、その過去のデータを入力として再実行します。この再実行の結果を比較することで、一部の改善が他の正常な利用経路を壊していないかを本番稼働前に確認し、変更の適用を承認するかを判断します。
本番環境でAIが目的から逸脱したり失敗したりした場合、どのように対処すればよいですか。
エラーを出さずに処理を終えたように見せる静かな失敗や目的からの逸脱を防ぐため、稼働中の監視と停止条件を設けます。期待する結果と異なる、許可外の操作を試みるなどの失敗条件を定義し、それに触発された場合はAIの自律的な進行を中断して人間の担当者へ差し戻す経路を作ります。担当者は停止した地点の記録と障害原因を受け取り、プロンプトや設定を修正するか、残りの作業を人間が引き継いで業務を完遂するかを決定します。
AIを組み込む仕事の流れづくりをご支援します
Deskrexでは、AIを使って調査・制作・分析などの仕事を進めるために、工程と役割分担を設計し、実装する支援を行っています。AIに渡す資料や指示、使えるツール、人が確認する箇所を整理し、一連の仕事として動く仕組みをつくります。
まず、届けたい成果物と現在の作業手順を確認し、実際の仕事をAIで試します。品質、処理量、時間、費用を見ながら、今すぐ任せられる作業と、追加の設計や開発が必要な作業を確かめます。
その結果をもとに、工程の統合や並列化、ツール連携、結果の検証と修正の手順を組み込みます。実行回数や費用の上限、人の判断を待つ条件、途中の状態を保存して再開する方法も含めて設計し、実務で動作を確かめます。
業務へのAI導入やワークフロー作成のご相談は、AIワークフロー作成支援のご案内からお問い合わせください。任せたい仕事と、現在使っているツールを伺い、取り組む範囲を一緒に整理します。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai
コメント