生成AIの技術革新が急速に進む中、どの国や企業が研究開発をリードしているのかを把握することは、新規事業の企画や市場動向の調査において重要なテーマです。特許データは、各プレイヤーの開発の勢いや技術投資の方向性を客観的に示す指標となります。
世界知的所有権機関(WIPO)が公開した最新のデータでは、生成AI特許の公開動向に大きな変化が起きています。国別では中国が圧倒的な首位を維持する一方で、日本が2024〜2025年の公開分で韓国を抜いて世界3位に浮上しました。さらに企業別では、ソフトバンクが2014〜2025年の公開累計で首位に躍り出るなど、これまでのランキングから様変わりしています。
この記事では、生成AI特許の公開件数においてどの国や企業が多くを占めているのか、最新のランキングとその内訳を解説します。また、件数の背後にある技術トレンドの変化や、特許データから企業の技術力や事業戦略を読み解く際に注意すべきポイントについても紹介します。
生成AI特許の国別ランキングは中国・米国・日本の順
生成AIに関する技術的な優位性や今後の動向を把握するうえで、特許データの分析は参考になります。
特許の件数を正確に把握するため、集計にはパテントファミリーという単位が用いられています。一つの発明が複数の国で出願されることは珍しくありませんが、パテントファミリーはそれらを同一の技術的内容を持つ発明として一つにまとめた指標です。これにより、単なる手続き上の件数ではなく、実質的な発明の数を比較できるようになります。また、特許がどの国から生まれたかについては、特許を出願した企業の所在地ではなく、実際のイノベーションの源泉を示すために発明者の所在地が基準となっています。
今回のデータから国別の動向を読み解く際、過去10年間の累計である2014年から2023年の集計期間と、直近の動向を示す2024年から2025年の集計期間の二つを区別して見ることが重要です。
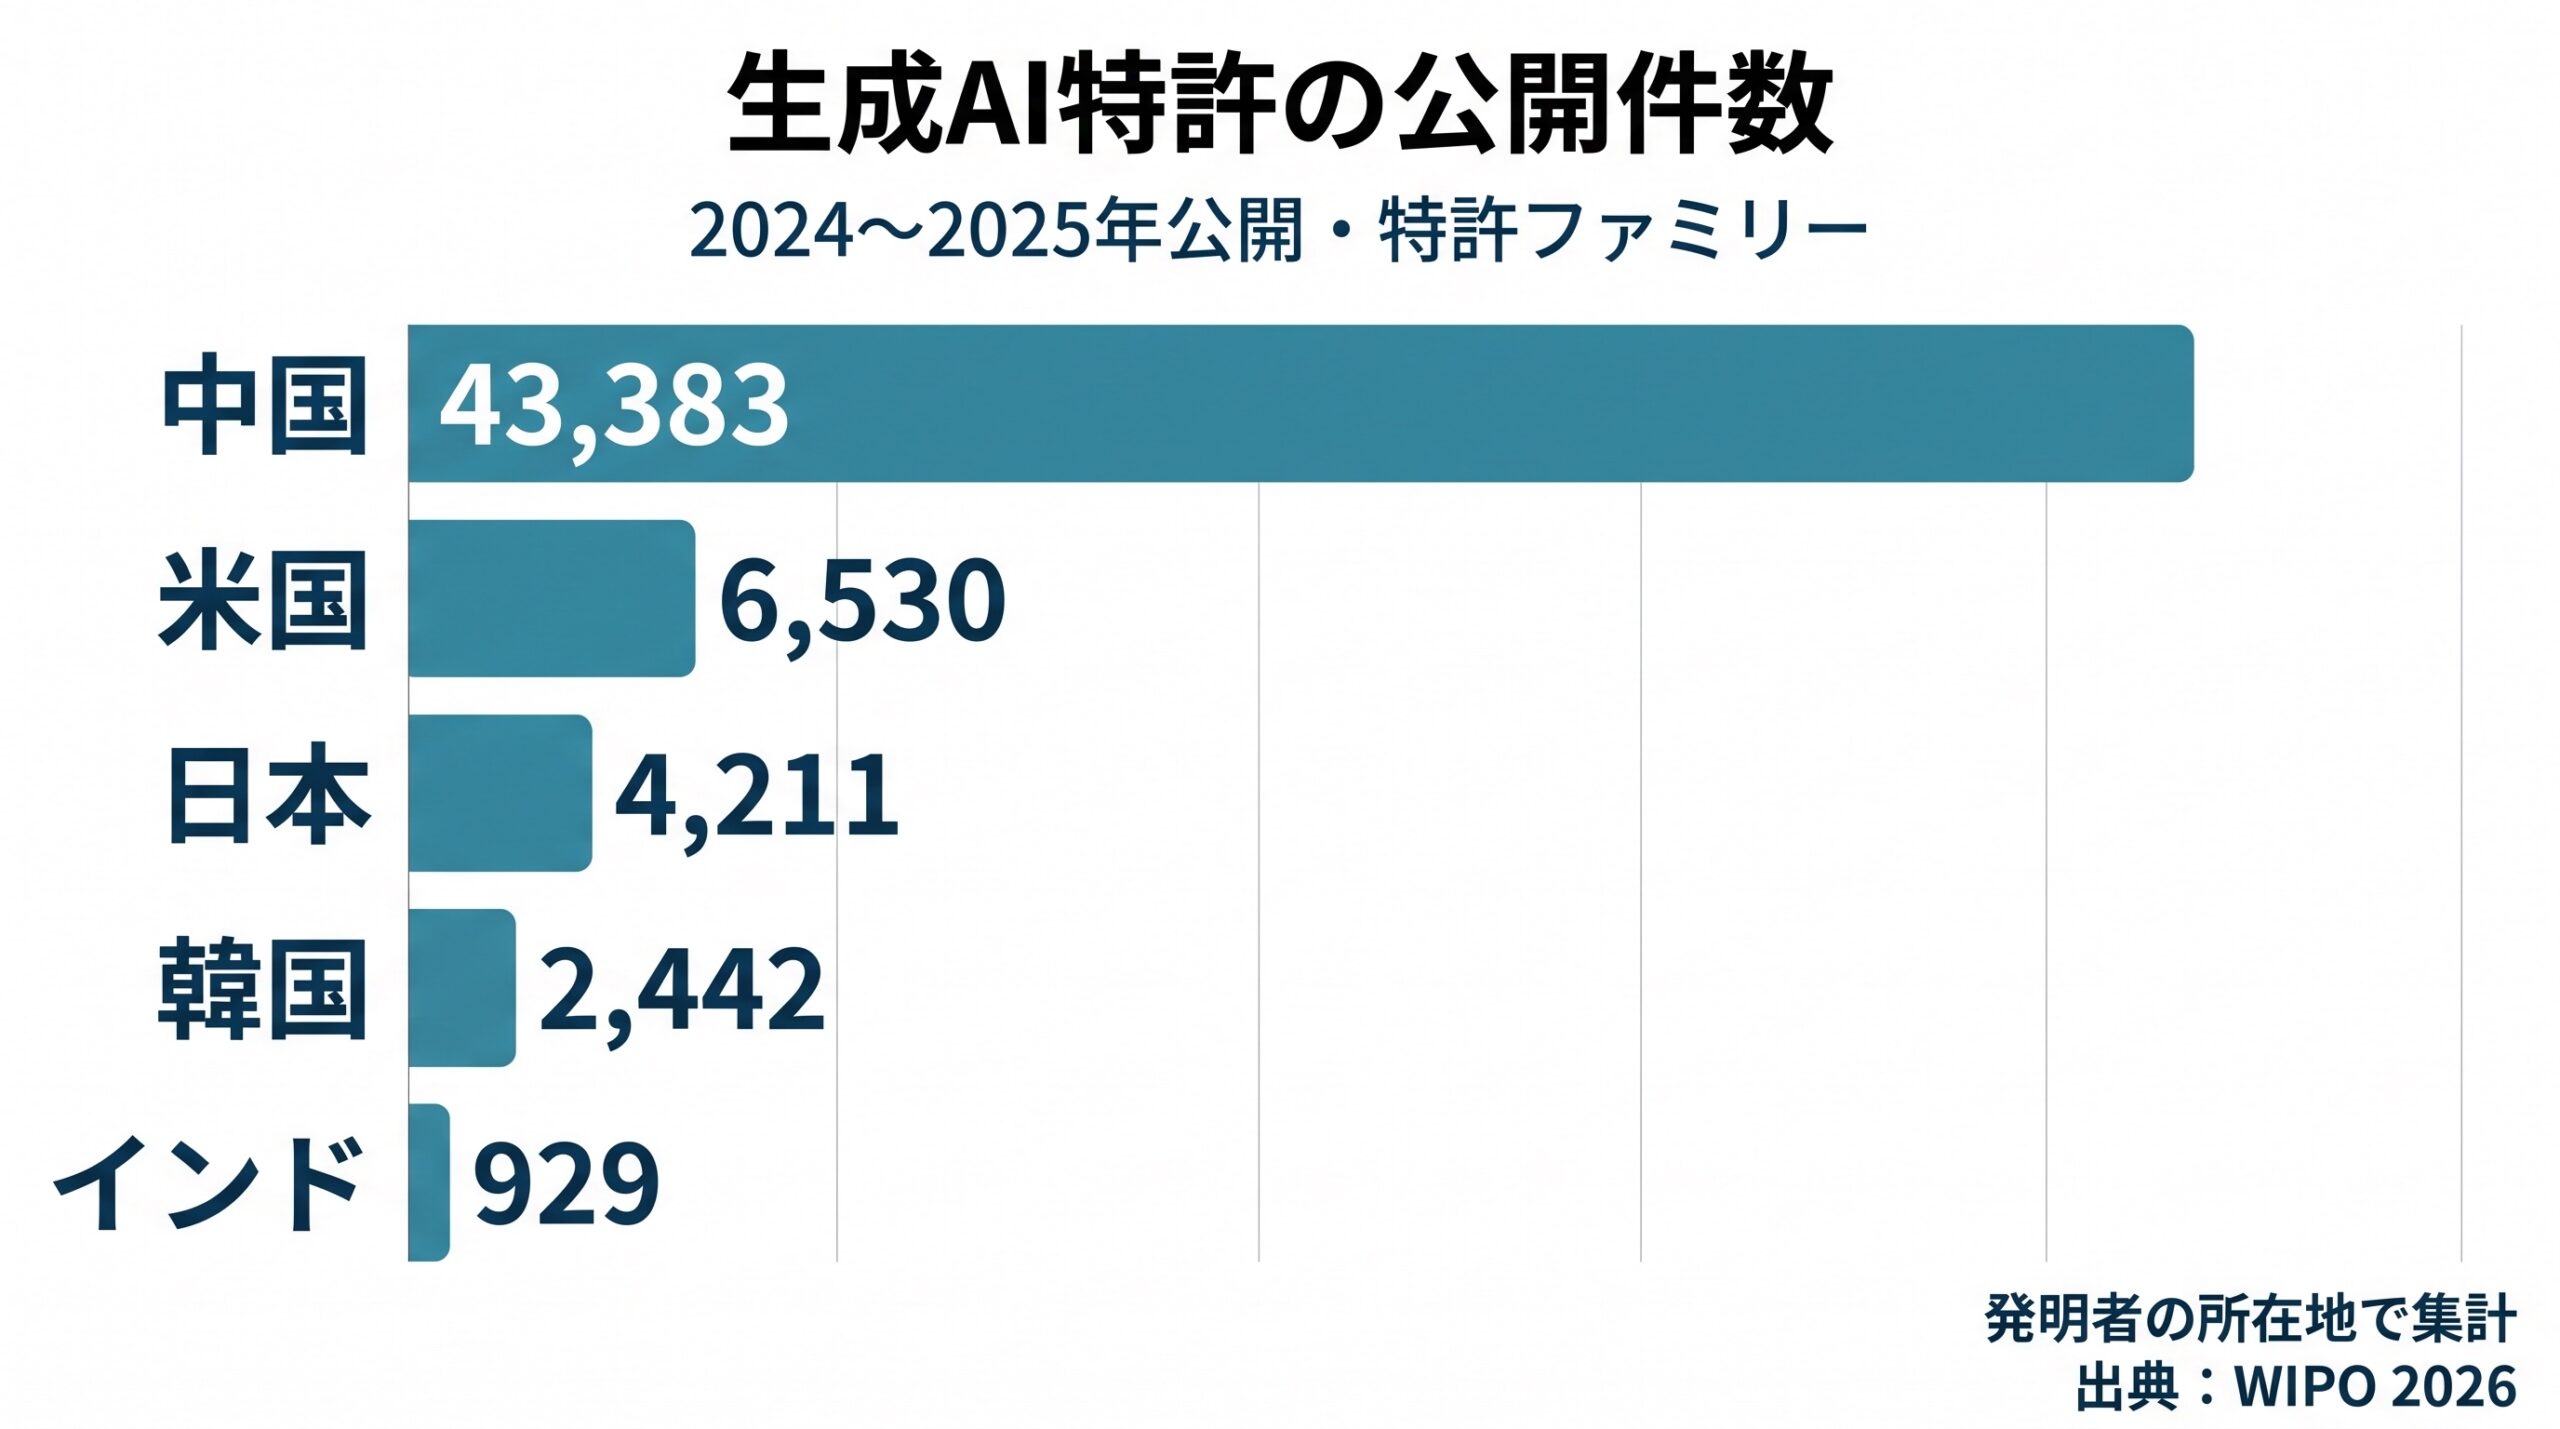
世界を牽引しているのは中国です。中国は2024年から2025年の2年間だけで43,383件のパテントファミリーを公開しており、他国を圧倒して首位を独走しています。この2年間の件数は、過去10年間である2014年から2023年の累計である38,210件をすでに上回る規模です。初期に出願された特許が多いだけでなく、2023年から2025年にかけての年平均成長率も64%と高く、持続的かつ強力な研究開発が行われていることがわかります。
米国は中国に次ぐ2位の研究拠点です。2024年から2025年の公開件数は6,530件でした。2023年の約1,185件から2025年には4,380件超へと急増しており、WIPOは、米国企業が主導する生成AIの商業的開発の波が特許活動の加速につながっている可能性を指摘しています。
さらに直近のデータで注目すべきなのが日本の躍進です。過去10年間の累計では韓国の4,155件に次ぐ3,409件で4位でしたが、2024年から2025年の公開分は4,211件で、2,442件の韓国を抜いて世界3位に浮上しました。日本の2023年から2025年の年平均成長率は210%に達し、主要国の中で群を抜いています。ただし、この急激な伸びはソフトバンクが2024年から2025年にかけて公開した約3,000件のパテントファミリーに大きく依存しており、この貢献を除外すると日本の成長はより緩やかなものになると指摘されています。
4位に後退した韓国のほか、インドは2024年から2025年に929件を公開して5位を維持しています。欧州では、ドイツがイギリスを明確に上回って6位となり、地域内の筆頭に位置づけられました。
全体として生成AI特許は、中国、米国、日本、韓国の上位4カ国に集中する傾向が続いています。しかし一方で、米国や日本、ドイツなどの成長ペースが中国の絶対数による差を相対的に縮めつつあり、WIPOは、特許活動の成長がより広範な地域へ広がっていると分析しています。
企業別ではソフトバンクが首位に浮上
国別の動向に続き、企業別の公開特許ファミリー数を見ていきましょう。なお、特許は売却されたり企業買収によって持ち主が変わったりすることがあるため、世界知的所有権機関のレポートでは、最終的な所有権を持つ企業(アルティメットオーナー)を基準に集計が行われています。
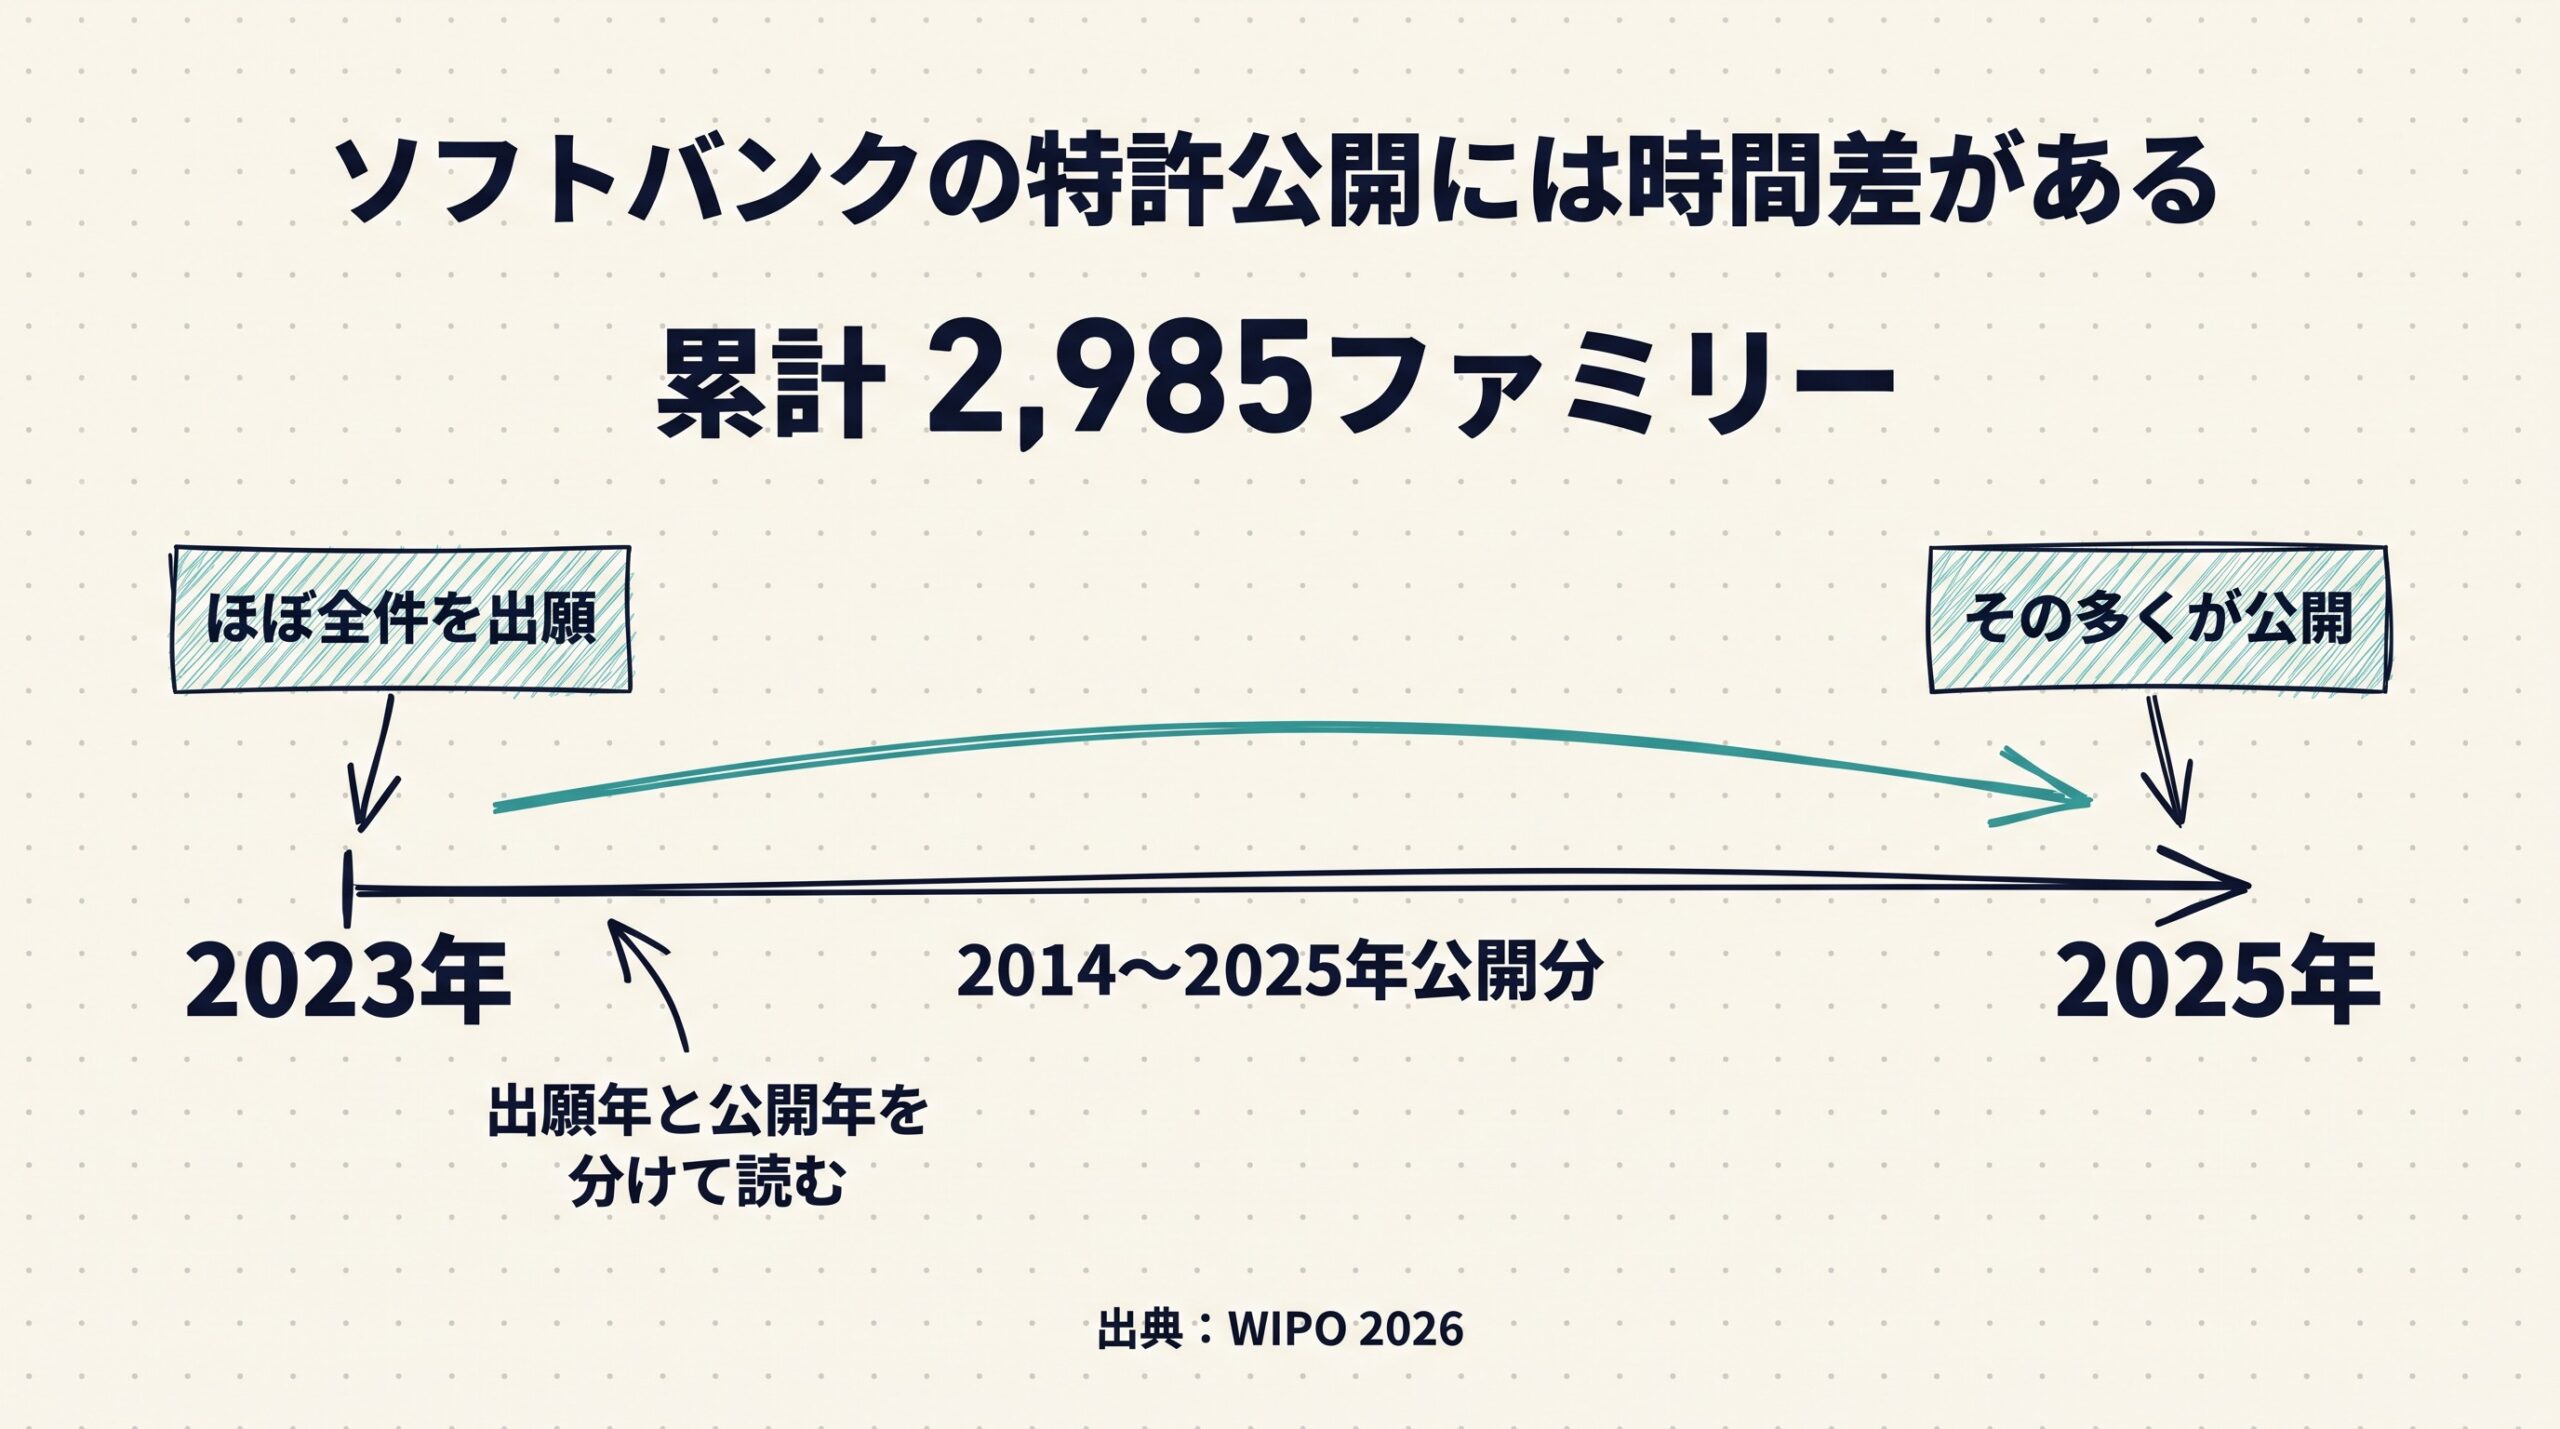
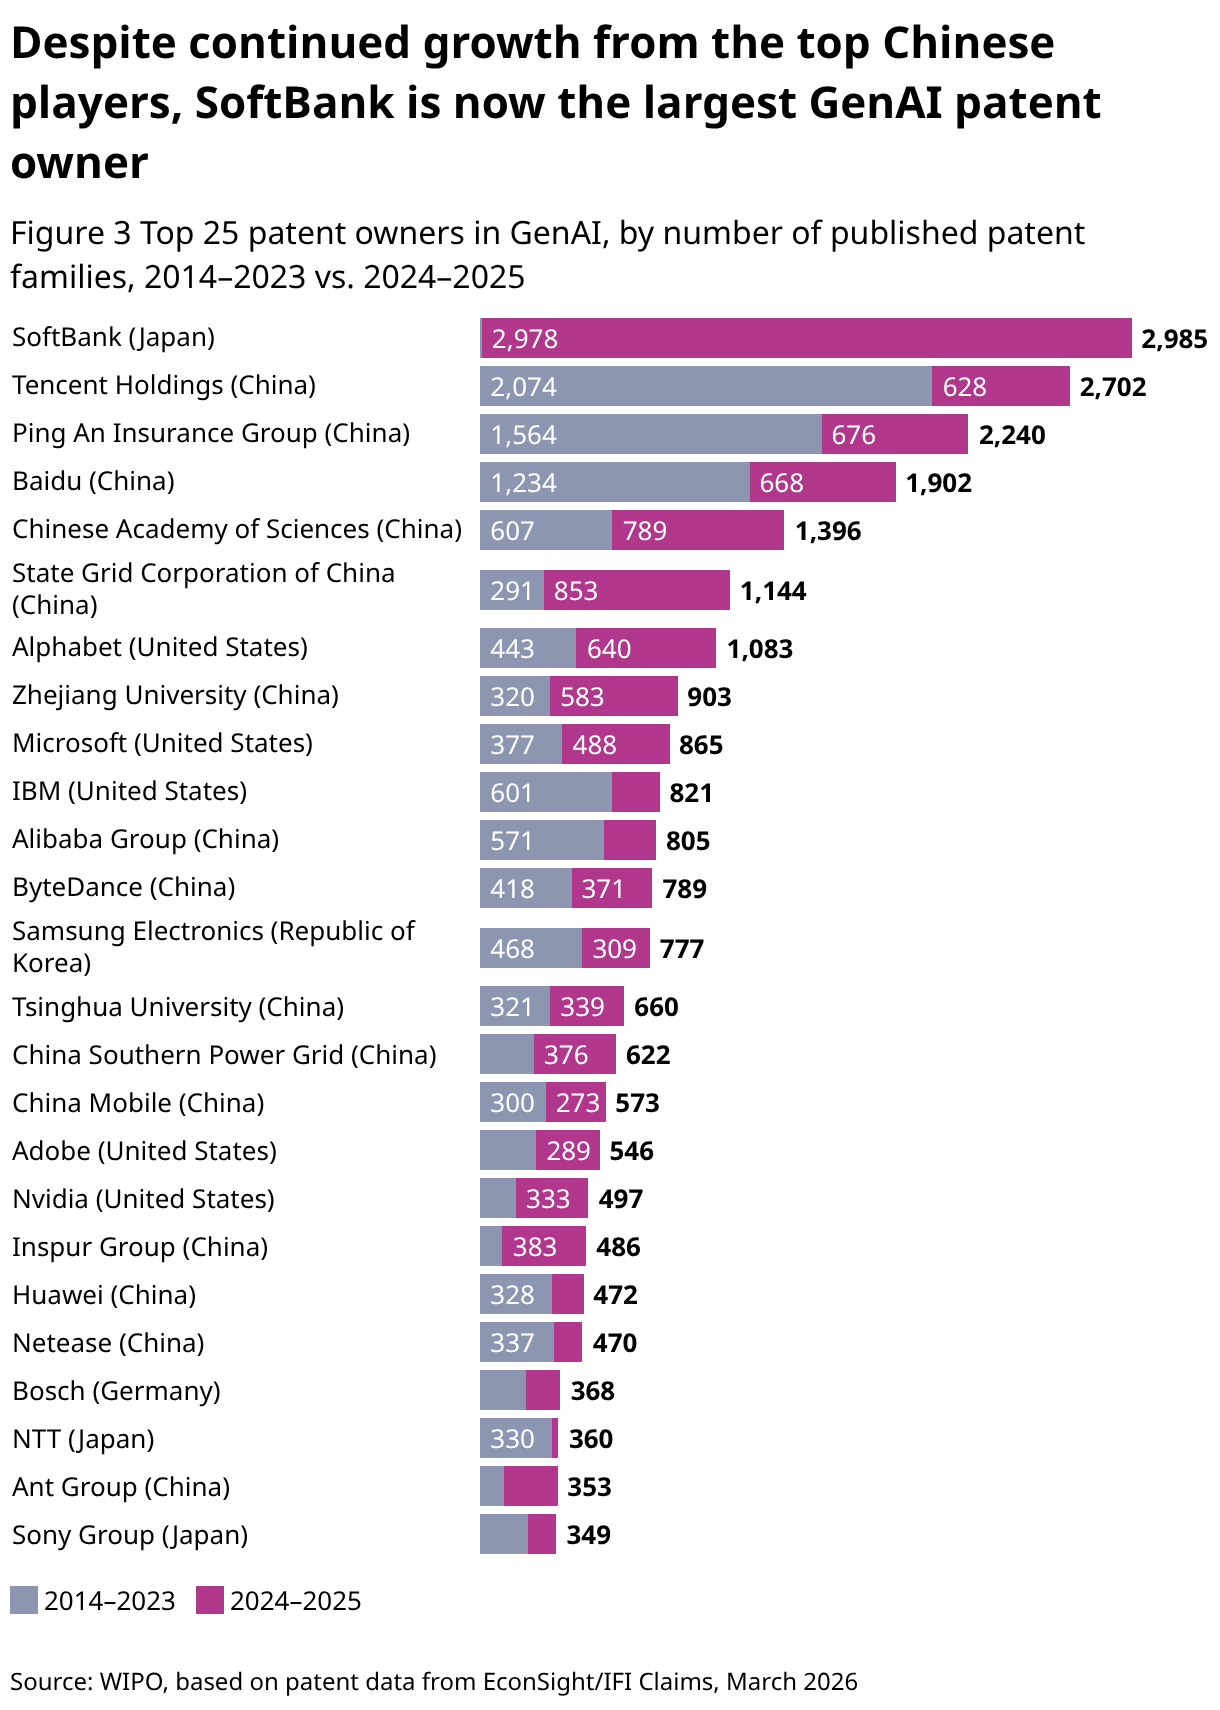
企業別のランキングで今回最も注目されるのが、WIPOが「SoftBank」として集計するソフトバンクが最大の特許保有者として首位に浮上したことです。同社は2014年から2025年の間に2,985件のパテントファミリーを公開していますが、その事実上すべてが2023年に出願され2025年に公開されたものです。前述した日本の国別順位の急上昇は、ソフトバンクの集中的な出願活動に大きく牽引された結果と言えます。
この劇的な特許件数の増加は、ソフトバンクのAI分野への大規模な戦略転換と一致しています。ソフトバンクグループはOpenAIへ出資し、ソフトバンク株式会社は日本でGPU計算基盤を構築するとともに、子会社のSB Intuitionsを通じて独自の日本語大規模言語モデル(LLM)「Sarashina」の開発を進めています。さらに、AIエージェント同士が企業のルールに基づいて安全にデータをやりとりできる「Agent Firewall(仮称)」のプロトタイプを開発して特許を出願し、2026年度ごろの実用化を目指すなど、積極的な動きを見せています。こうした背景からソフトバンクは、インフラからモデル、アプリケーションまでを垂直統合で手がける通信・投資企業という、新しいタイプの特許保有者として台頭しています。
一方、中国企業は引き続き累積件数の上位を占めています。テンセント、平安保険、バイドゥが大きな特許保有者となっているほか、顧客数と従業員数で世界最大の公益企業である中国国家電網がエネルギー網の最適化などに生成AIを活用する特許を急増させ、新たに上位へ食い込みました。
米国企業では、Alphabet(Google)が1,083件のパテントファミリーを保有し、米国内のトップに立っています。次いでMicrosoft、IBMが続きますが、注目すべきはNvidiaが新たに世界の上位25の特許保有者に入った点です。これは同社がGPUというハードウェアの提供にとどまらず、AIソフトウェアやモデルの枠組みへと役割を広げていることを反映しています。
なお、生成AIブームを牽引しているOpenAIの特許出願は2025年後半時点で世界で35件と記載されています。同社は基盤モデルの仕組みそのものより、マルチモーダルインターフェース(画像や音声など複数の入力に対応する窓口)やコード生成といった製品レベルの機能に特許の重点を置いています。これは、競争力の源泉を特許の取得による保護だけでなく、営業秘密と開発スピードに求めているためだと考えられます。
生成AI特許の中心はGANからLLMへ
生成AI技術の発展を正しく理解するためには、特許を単なる件数の足し算として見るのではなく、「どのような仕組みで生成するか(モデル)」と「どのようなデータを扱うか(モード)」という二つの視点に分けて分析することが重要です。
まず、生成の仕組みであるモデルの動向を見ていきましょう。世界知的所有権機関のレポートでは、モデルの種類を特定できる生成AI関連特許を大規模言語モデル(LLM)、敵対的生成ネットワーク(GAN)、拡散モデル、変分オートエンコーダ(VAE)、自己回帰モデルという5つの種類に分類して集計しています。
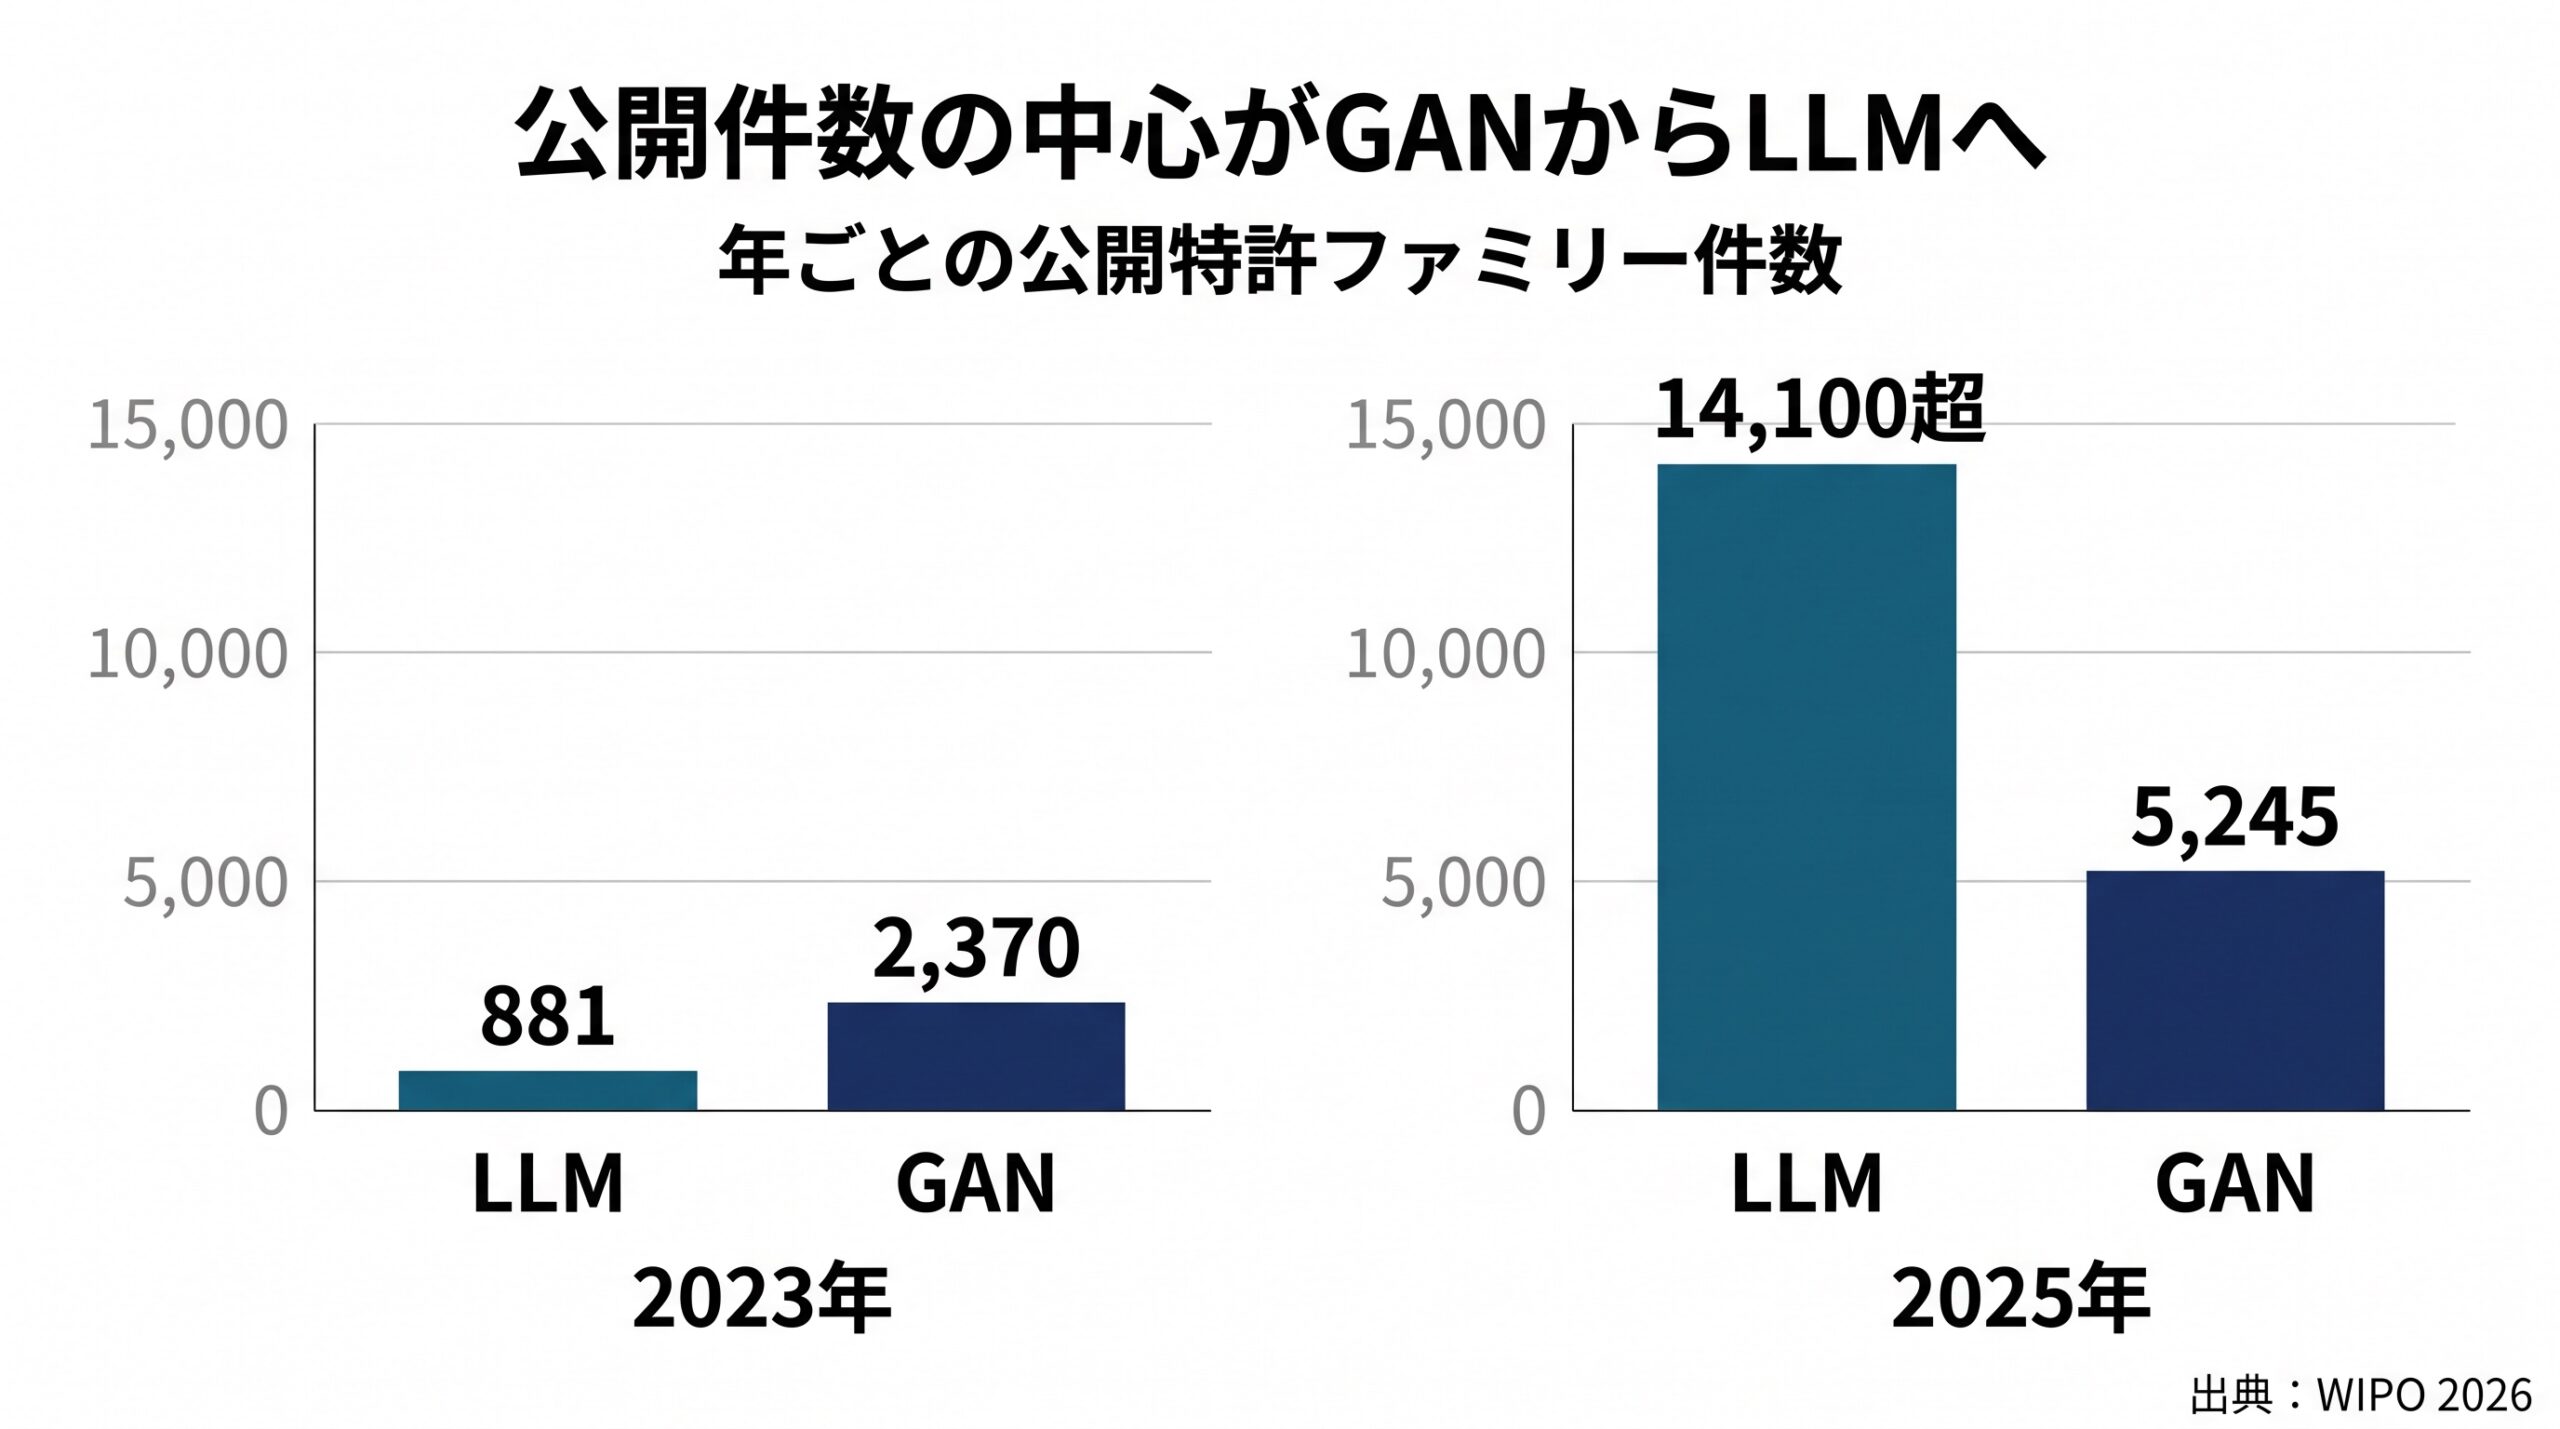
この分類において最も大きな変化は、LLMがGANを抜いて最大の特許カテゴリになったことです。過去長らく、画像合成やデータ拡張を得意とするGANが生成AI分野を主導してきましたが、WIPOはChatGPTをはじめとする商用サービスの成功を背景と位置づけており、技術の中心がテキストなど多様なデータを扱うLLMへと移行したと分析しています。特許件数を見ると、2023年単年ではLLMの公開件数(881件)はGAN(2,370件)を大きく下回っていましたが、2025年にはLLMが14,100件を超え、同年のGAN(5,245件)の約3倍へと急増しています。この結果、2014年から2025年までの累計でもLLM(約20,900件)がGAN(約18,800件)を上回りました。
また、広く画像や動画の生成ツールで利用されている拡散モデルも、2023年の441件から2025年には約4,000件へと大きく成長し、2014〜2025年の累計で3番目に位置づけられるモデルとなっています。
次に、モデルが扱うデータの種類(モード)に目を向けると、興味深い傾向が確認できます。2014年から2025年の累計で最も特許数が多いのは画像や動画を扱う分野で、約40,000件(2025年単年だけでも13,800件超)に上ります。LLMが最大のモデルになったにもかかわらず、テキストではなく画像・動画が最大のデータ種類となっているのには理由があります。画像や動画はGANや拡散モデルだけでなく、複数のデータを同時に処理するマルチモーダルなLLMなど、さまざまな仕組みのなかで幅広く扱われている技術だからです。
一方で、LLMの急激な発展に連動して、テキストを扱う特許も2023年の約3,400件から2025年には約11,800件へと、わずか2年で3倍以上に急増しました。さらに、AIを活用したソフトウェア開発支援の広がりに伴い、プログラムなどのコード生成に関する特許も2023年の339件から2025年には1,616件と急速に伸びています。
なお、音声や音楽の分野はAIによる音声クローンなどの商業化が進んでいるにもかかわらず、2025年の公開件数は3,538件で、WIPOはほかの分野に比べて特許数の伸びが緩やかと分析しています。これは、新しい音声システムが専用の技術ではなくマルチモーダルなLLMの上で構築されるようになり、音声分野ではなくテキストなど別のカテゴリに分類される特許が増えている可能性があるためだと指摘されています。
このように、WIPOは生成AIの開発が画像生成技術(GAN)を中心とした時代から、大規模言語モデル(LLM)を中核に据えつつ、テキストや画像、コードといった多様なデータを横断的に処理する方向へ大きく進化していると分析しています。
特許件数から技術力を判断する前に確認すること
紹介した特許の公開件数やランキングは、研究開発の活発さや企業の投資意欲を測る上で重要な指標です。しかし、企画や調査の担当者が注意すべきなのは、「特許件数の多さが、生成AIの性能の高さや市場シェアをそのまま意味するわけではない」という点です。特許データから実態を正しく読み解くには、前提を理解したうえで追加調査につなげる必要があります。
まず、企業ごとに特許に対する戦略が大きく異なる点を考慮しなければなりません。世界知的所有権機関(WIPO)の分析では、特許保有数首位のソフトバンクとOpenAIの対照的なアプローチが指摘されています。ソフトバンクは半導体からデータセンター、ロボティクスに至るまで、AIのバリューチェーン全体を網羅するプラットフォーム戦略と整合する形で約3,000件の特許ファミリーを公開しています。対照的に、生成AIブームを牽引するOpenAIの特許出願はWIPOが2025年後半に把握した範囲で35件です。同社は特許による保護と併せて、営業秘密や開発スピード、計算インフラへのアクセスを競争力の源泉としており、特許を防御的に利用する方針を表明しています。こうした特許への姿勢は、ビジネス戦略の違いも反映しています。
次に、特許データには公開されるまでのタイムラグがあることを理解しておく必要があります。特許は通常、出願されてから公開されるまでに18ヶ月の期間を要します。WIPOは2024年から2025年にかけての公開件数の急増を、2022年末のChatGPT公開をきっかけとした研究開発ブームが時間差でデータに表れた結果と説明しています。公開件数のランキングは現在の市場シェアではなく、「過去の研究開発の勢い」を反映したものと言えます。
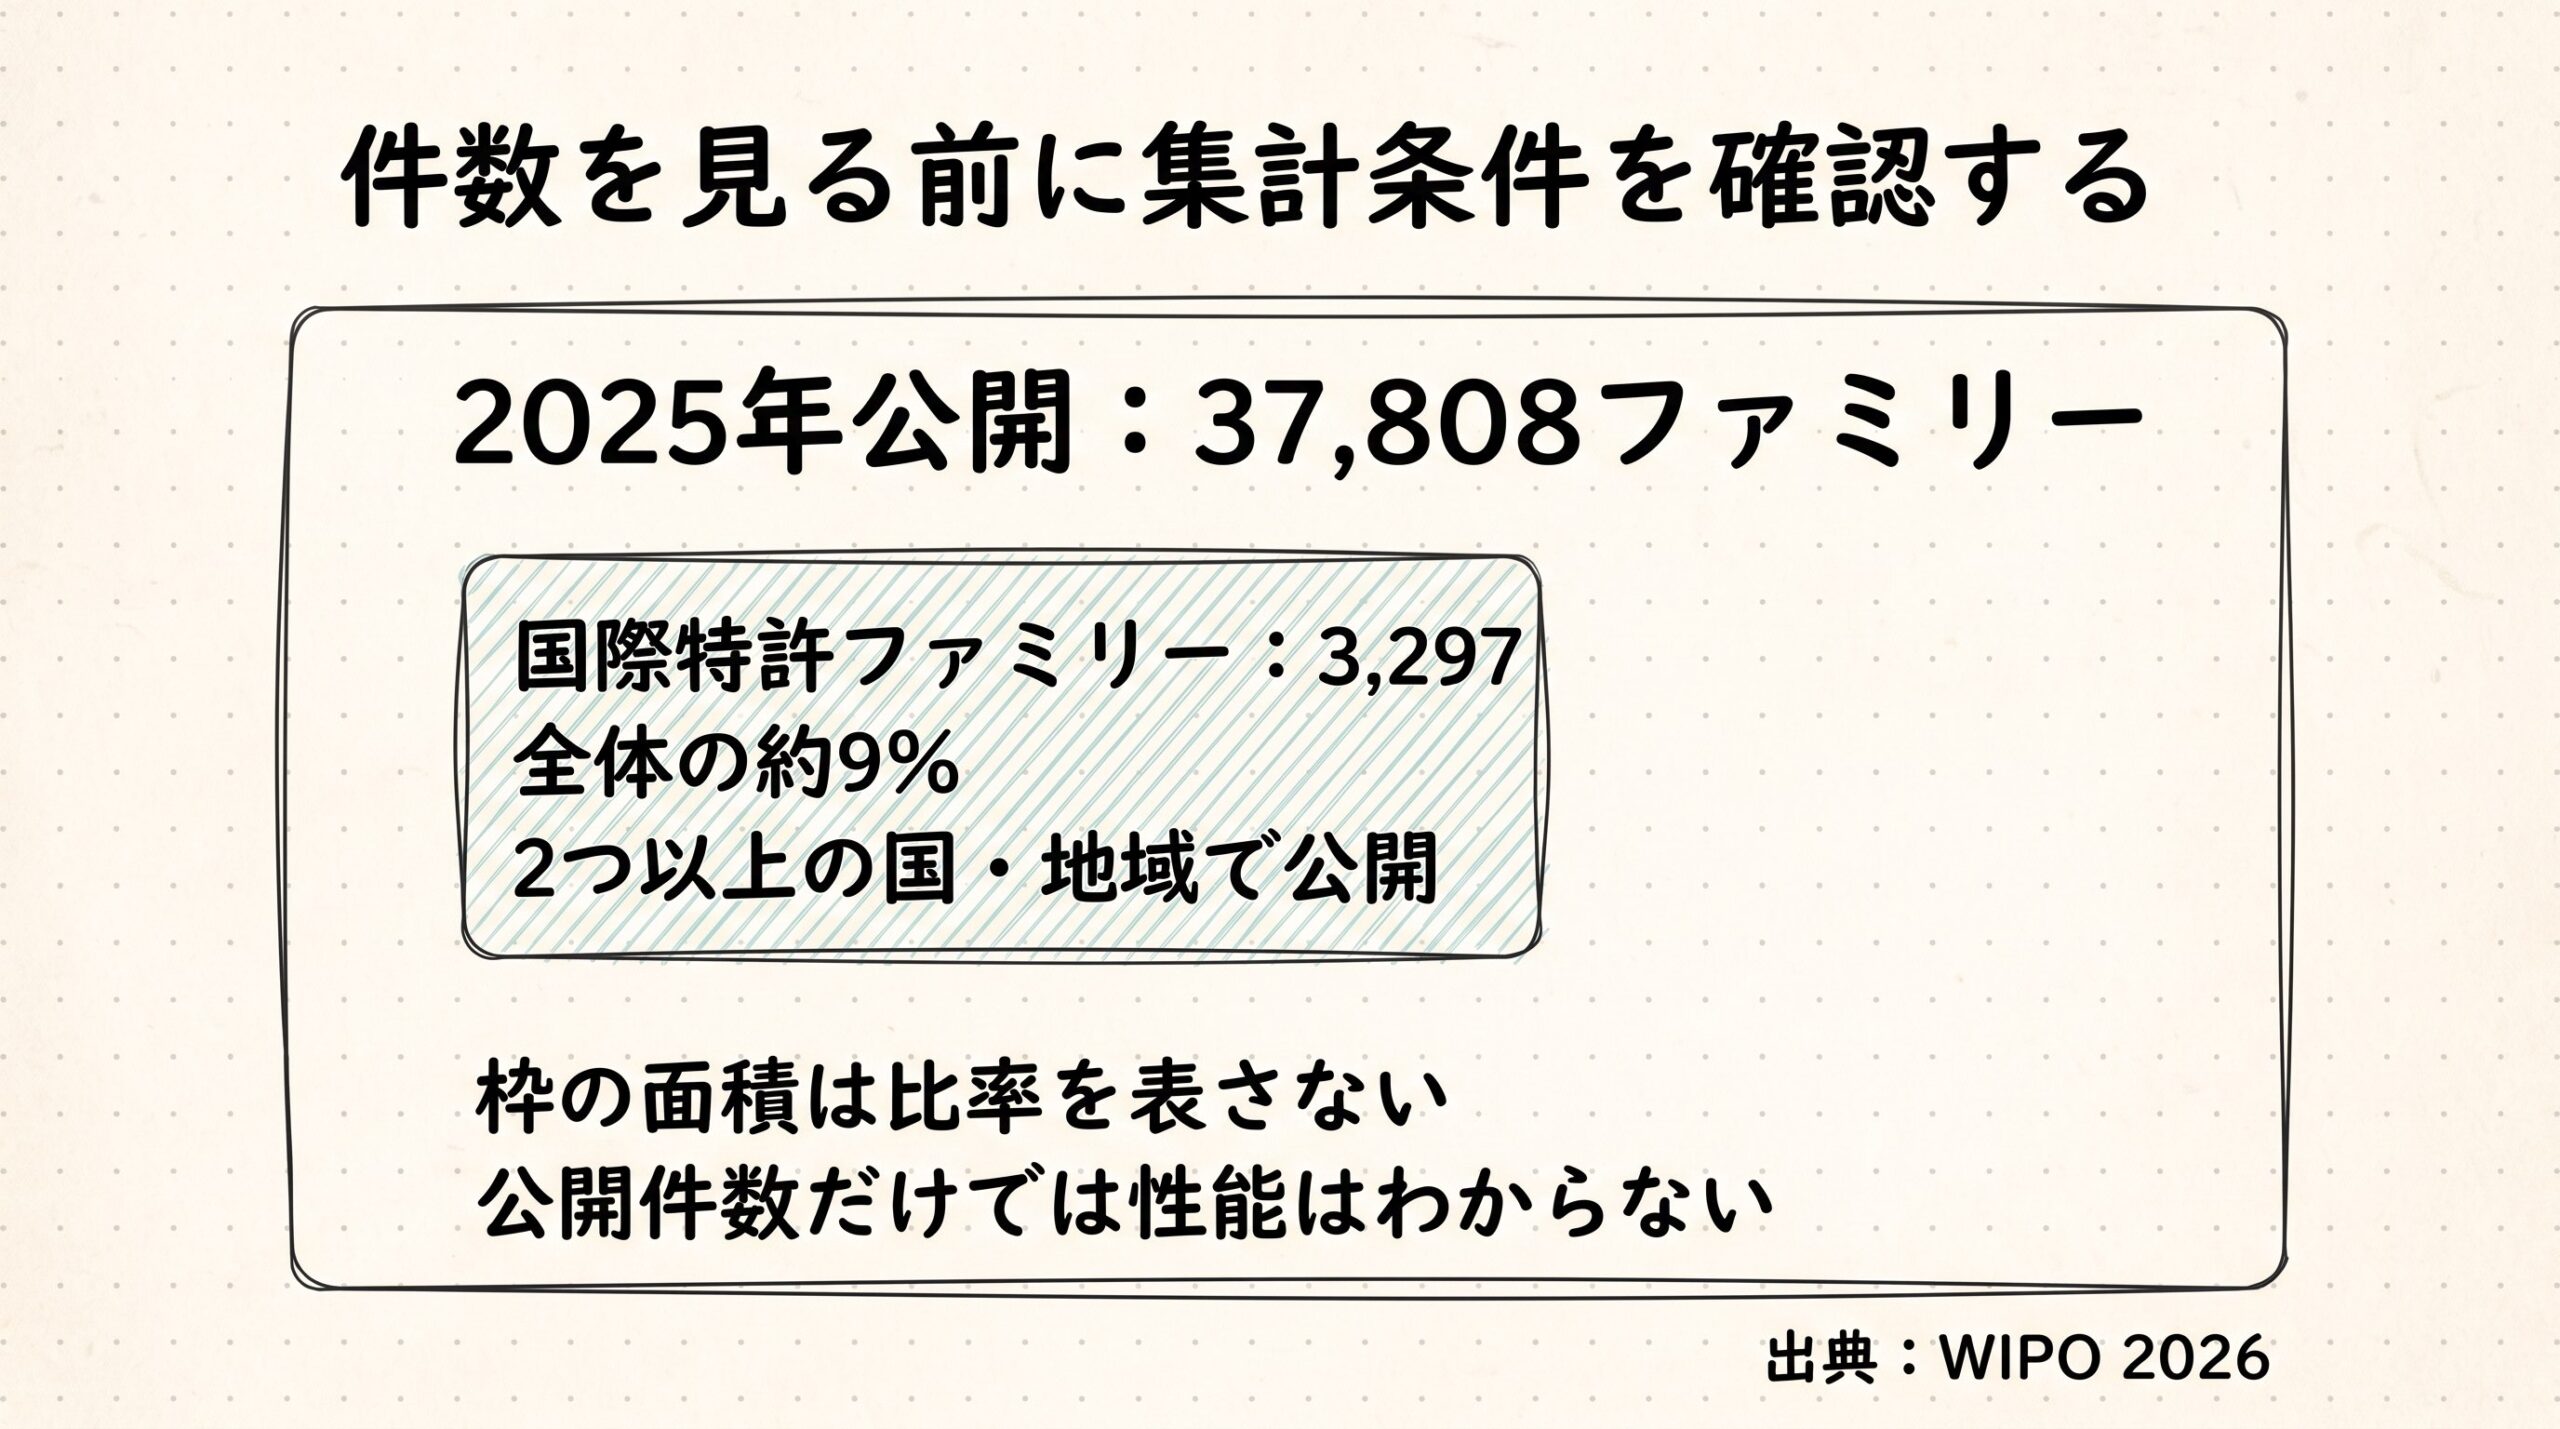
さらに、特許の数だけでなくグローバルな商業的価値にも目を向ける必要があります。その指標となるのが、2つ以上の国や地域で公開された特許を数える「国際パテントファミリー(IPF)」です。複数の国でコストをかけて出願することは、技術を広く商業化する意欲が高いことを示します。生成AI分野におけるIPFの数は2023年の1,931件から2025年には3,297件へ増加していますが、それでも2025年に公開された生成AI特許全体の中では約9%にとどまります。圧倒的な件数で首位に立つ中国の出願人が多くの特許を国内で出願する傾向に加え、新しい特許が国内への最初の出願後に海外へ展開されるまでの時間も、IPFの割合が低い理由としてWIPOは挙げています。国内への出願だけではIPFに該当するかは決まらず、後に海外でも公開されればIPFとなる場合があります。
このように、新規事業の企画や協業先を選定する際、特許の公開件数だけで判断するのは危険です。対象企業が特許をどのように活用しようとしているのか、それが国際的な市場を見据えたものかを確認した上で、実際の製品パフォーマンスや開発スピード、計算資源の確保状況などを含めた追加調査を実施することが不可欠です。特許データをR&Dの投資判断に生かす具体的な6つのステップについては、「特許出願件数 業界別ランキング2026|AIで読むデータ技術投資マップ」でも詳しく解説していますので、併せてご活用ください。
特許の順位と、投資・利用の順位は一致するのか?
前章で、特許の公開件数がそのまま市場シェアや技術力の絶対的な指標にはならない点に触れました。では、特許件数の順位は、生成AIに対する「民間投資額」や実際の「消費者向け製品の利用状況」の順位と一致するのでしょうか。結論から言えば、これらの指標から見えてくる国や企業の勢力図は大きく異なります。企画や調査の現場では、一つの指標に頼らず、複数のデータを組み合わせて市場動向を読み解く必要があります。
まず、資金の動きを示す民間投資額を見てみましょう。世界知的所有権機関(WIPO)のデータによると、2024年から2025年にかけての生成AI特許の公開件数は、中国が43,383件で首位となり、次いで米国の6,530件、日本の4,211件と続きます。特許件数においては中国が他国を圧倒しています。
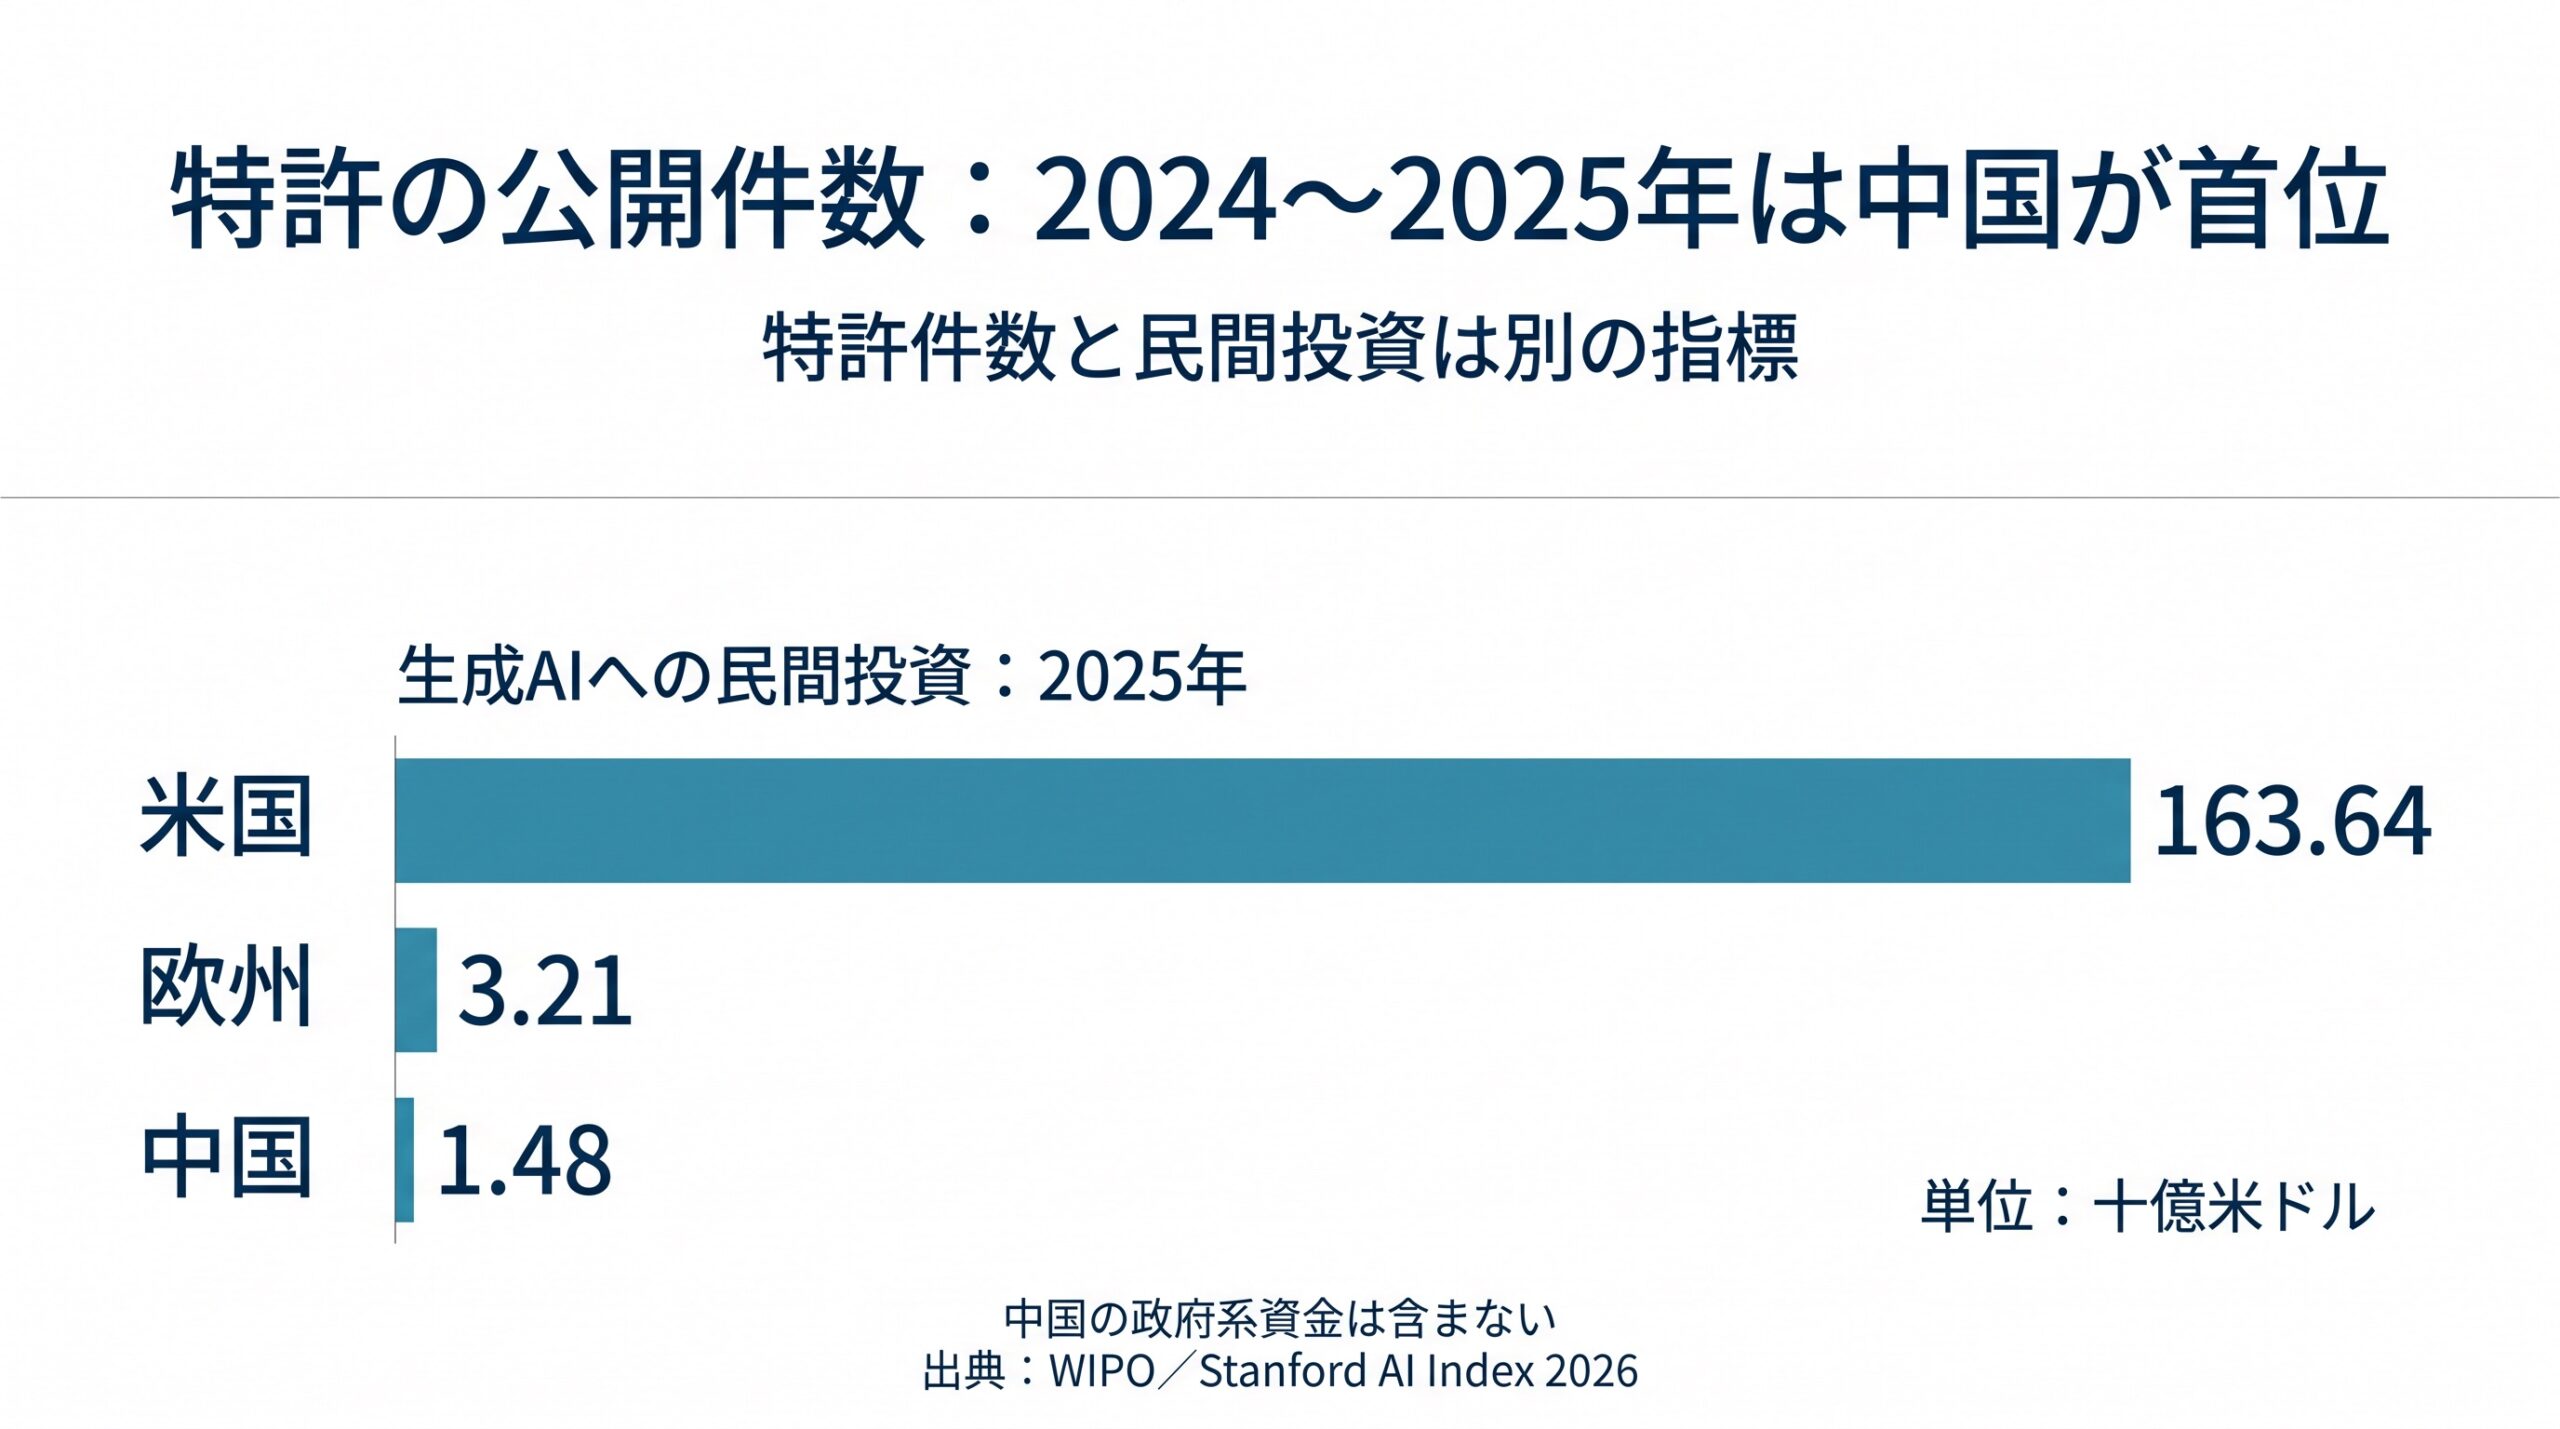
しかし、米国スタンフォード大学がまとめた「AI Index 2026」のレポートによると、2025年における生成AI分野への民間投資額は米国が1,636億4,000万ドルと突出しています。同レポートにおいてヨーロッパは32億1,000万ドル、中国は14億8,000万ドルにとどまっており、民間投資の規模では米国が圧倒的な首位です。ただし、このデータを見る際には前提条件に注意が必要です。民間投資額の集計には中国などが行う政府主導の資金提供が含まれていないため、民間部門のデータだけで比較すると、中国が実際にAIに投下している資本を過小評価してしまう可能性があります。
次に、実際の市場における製品利用の順位を確認します。米国のベンチャーキャピタルであるa16zが2026年3月に公開した消費者向け生成AIアプリのレポートによれば、調査対象製品の2026年1月の利用指標で首位なのはOpenAIの「ChatGPT」です。競合する「Gemini」と比較しても、Webの月間ユニーク訪問数(Similarwebのデータ)で2.7倍、モバイルアプリの月間アクティブユーザー数(Sensor Towerのデータ)で2.5倍の規模を誇っています。特許件数の分析ではWIPOが2025年後半に把握したOpenAIの特許出願が世界で35件だったことを紹介しましたが、a16zが対象とした消費者向け製品では、同社のChatGPTが利用指標で首位となっています。なお、この利用データはWebサイトへの訪問数やモバイルアプリのユーザー数を基にしており、デスクトップネイティブの製品や組み込み型AIの利用状況は完全には捕捉されていない点を考慮する必要があります。
このように、生成AIの動向をどの切り口で評価するかによって、首位となる国や企業は変化します。特許件数では中国やソフトバンクが目立ちますが、民間資金の流入においては米国が中心となり、a16zの製品利用調査ではChatGPTが首位です。調査担当者は特許件数だけでなく、投資規模や実際のサービス利用状況といった別指標を併用し、集計条件の違いも加味しながら多角的に分析することが求められます。
生成AI特許には何が書かれている?三つの公報で見る具体例
前章まで、特許件数などのマクロなデータから国別・企業別の動向を確認しました。しかし、件数や技術分類の集計だけでは、実際にどのような技術が開発されているのかは具体的に見えてきません。そこで本章では、出願公開された三つの特許公報を取り上げ、生成AIがシステムの中で何を「入力」として受け取り、どのような「処理」を行い、何を「出力」するのかを読み解きます。
なお、ここで紹介する三つの公報は、発明の内容を具体的にイメージするための例であり、出願頻度の上位やランダムな抽出による代表的なサンプルではありません。また、ここで参照するのは登録公報ではなく、出願内容が一般に公開された特許出願公開公報です。
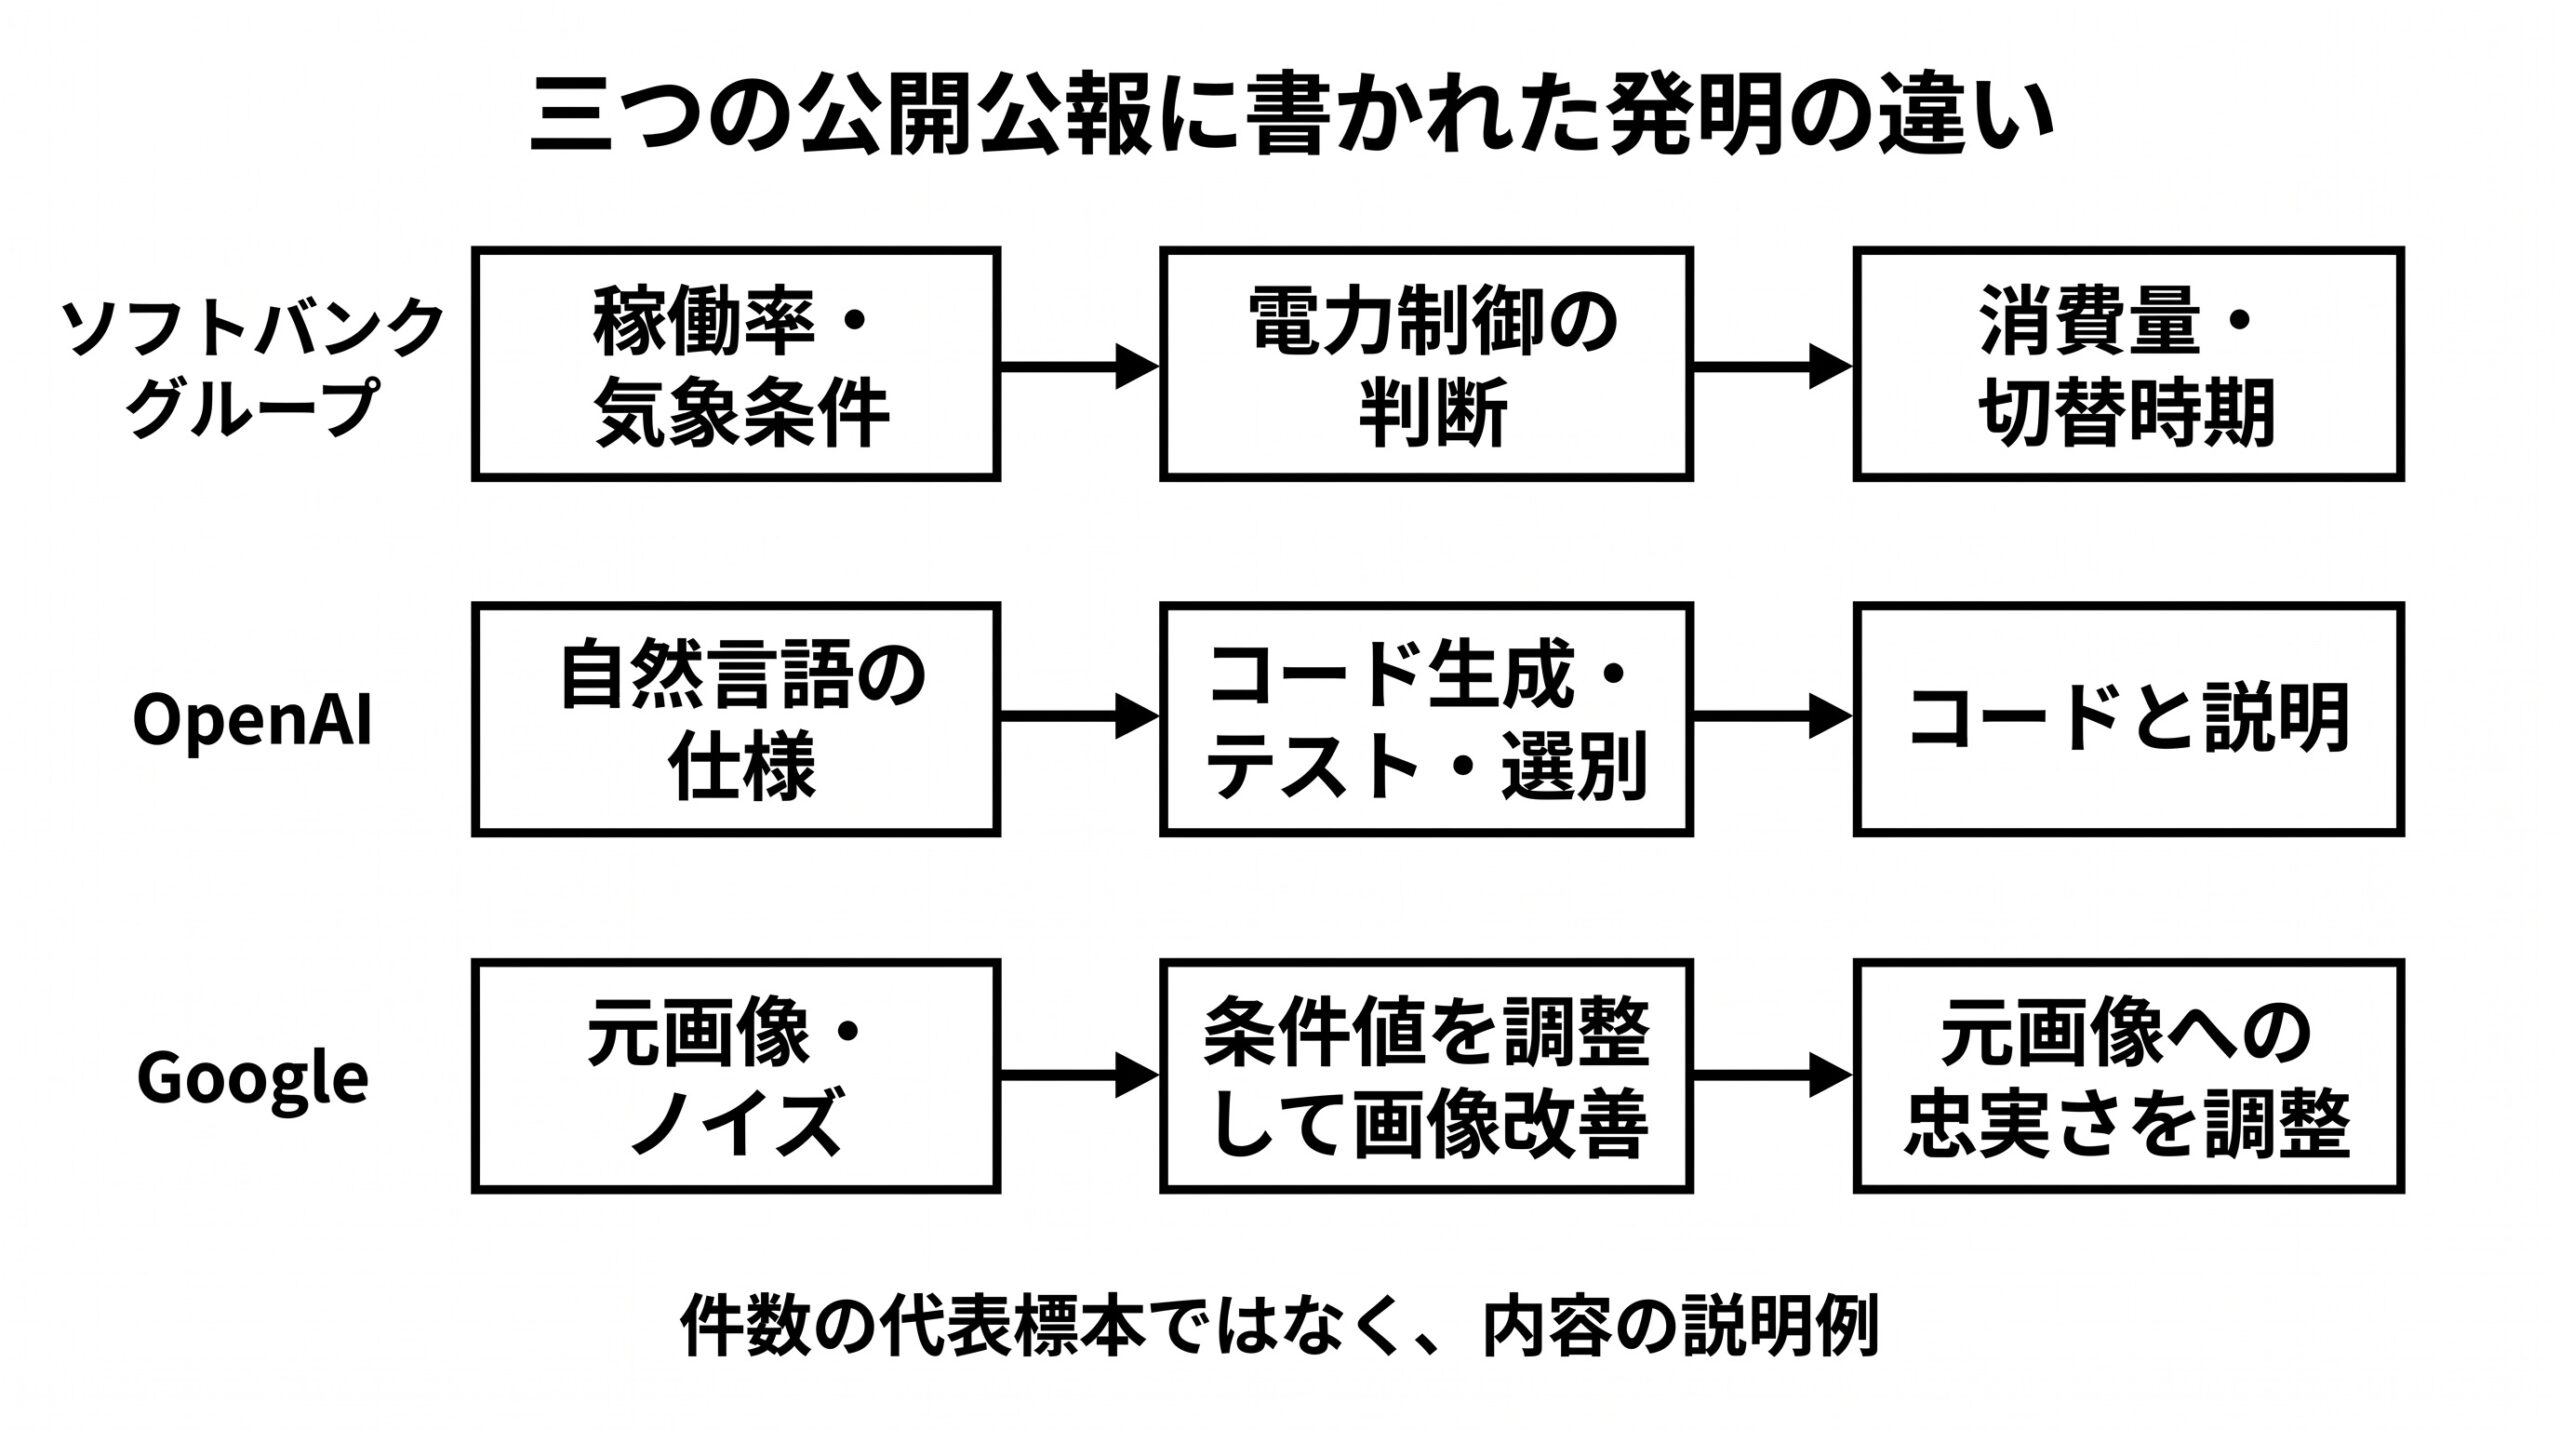
一つ目は、ソフトバンクグループ株式会社の公開公報JP2025047095A(2025年4月3日公開)です。この発明は、モバイル通信基地局の省エネルギー化や再生可能エネルギーの活用を生成系AIを用いて最適化するシステムを提案しています。このシステムでは、基地局の稼働率や気象条件などをAIへの「入力」とします。生成系AIはこれらの情報を「処理」し、考慮した上で、最適な電力消費量や電源を切り替えるタイミングを判断します。そして、再生可能エネルギーの導入や管理を行う手段も備えます。ただし、この公報はシステムの構成を提案するものであり、実際の基地局への導入実績や具体的な節電率を証明するものではありません。
二つ目は、OpenAI Opco LLCの国際公開公報WO2024242700A1(2024年11月28日公開)です。WIPOのデータによると、コンピュータコードを対象とする生成AIの特許公開ファミリー数は、2023年の339件から2025年には1,616件へと増加しています。この発明では、プログラムの仕様や目的を説明した自然言語のテキストを「入力」として受け取ります。次に、機械学習モデルがそのテキストに基づき、一つ以上のコンピュータコードの候補を生成します。ここでの特徴的な「処理」は、生成されたコードの候補をただ提示するだけでなく、テスト環境で実際に実行して結果を検証し、目的に合致するコードを特定する点です。最終的に、特定されたコードとそのコードに関する自然言語の説明をユーザーインターフェースを通じて「出力」します。
三つ目は、Google LLCの国際公開公報WO2024163522A1(2024年8月8日公開)です。画像や動画を対象とする生成AIの公開特許ファミリー数はデータ種類別で最も多く、WIPOの統計でも2014年から2025年にかけて約40,000件、2025年単年でも13,800件超が公開されています。この発明は、拡散モデルと呼ばれる画像生成AIを用いて画像の画質を改善する手法に関するものです。ここでは、元となる画像とノイズ画像に加えて、ノイズ条件値と呼ばれるパラメーターを「入力」とします。機械学習モデルは、このノイズ条件値を基準として画像の変換「処理」を行います。高い数値を設定すると、AIは元画像の情報よりも新たに画像を生成する割合を高め、元画像とは異なる新しい細部のテクスチャを持った画像を「出力」します。逆に低い数値を設定すると、元画像に近い見た目を維持した画像を出力します。このように生成する新しい細部の量と元画像への類似度を制御する技術ですが、これによってかつて撮影された実際の風景や人物の細部が正確に復元されることを保証するものではありません。
これら三つの公報からわかるように、生成AIの特許には、インフラ制御のためのパラメーター判断、コードの自動テスト実行、画像の生成度合いの細やかな制御など、目的を持った具体的な入力・処理・出力の仕組みが記載されています。
よくある質問
生成AI特許はAI全体の特許の中でどのくらいの割合を占めていますか?
2025年に公開された435,000件以上のAI関連のパテントファミリーのうち、生成AIが占める割合は約8.7%です。この割合は2017年の4.2%、2023年の6.1%と比べて増加しています。生成AI技術が多様な製品や用途に組み込まれるにつれて、AI全体の特許活動に対する生成AIの割合は今後も上昇していくと予想されています。
国別ランキングにおいて、複数の国にまたがる発明者がいる場合はどう集計されていますか?
特許に複数の発明者がいる場合、記載されている異なる国の所在地がそれぞれカウントされます。ただし、同じ国の発明者が複数いる場合は、その国について1回のみカウントされます。そのため、国別の件数にはある程度の重複が含まれている点に留意が必要です。
集計された特許件数に実用新案は含まれていますか?
レポート内で集計されているパテントファミリーには、一般的に特許のみが含まれており、実用新案は含まれていません。また、特許の法的な有効状態についての評価も行われていません。企業の特許に関する強みを分析するなどの特定の目的においては、有効な特許ファミリーのみを抽出してカウントする手法が用いられることもあります。
生成AIによる調査にはSnorbeをご活用ください
Snorbeは、研究開発や新規事業の調査を支援するAIリサーチツールです。論文・特許・ニュース・業界レポートや社内資料の情報を集め、出典と情報同士のつながりをナレッジグラフとして整理しながら、調査を深められます。
調べたいテーマをチャットで伝えると、AIがWeb検索や専門データベースなどのツールを選んで調査を進めます。収集した情報をグラフ上で確認し、未調査の領域や気になる論点を見つけて、追加の調査へつなげることができます。
調査結果は比較表や出典付きのレポートにまとめ、MarkdownやPDF形式で出力できます。過去の調査やアップロードした資料を参照して掘り下げられるため、継続して調べるテーマの情報整理や社内共有にも活用できます。
ご利用をご希望の方は、Snorbeのご案内から機能やプランをご確認ください。社内資料を含む調査やセルフホスト導入のご相談も受け付けています。
市場調査やデスクリサーチの生成AIエージェントを作っています 仲間探し中 / Founder of AI Desk Research Agent @deskrex , https://deskrex.ai